Reversa 소개
코딩 에이전트에게 새 기능을 맡기는 것과 10년 된 시스템의 기능을 고치라고 맡기는 것은 난이도가 다릅니다. 새로 만드는 쪽은 사람이 명세를 쓰고 에이전트가 그것을 실행하면 되지만, 오래된 시스템에는 애초에 명세가 없습니다. 업무 규칙은 코드 안에 조건문으로만 남아 있고, 왜 그렇게 설계했는지에 대한 기록은 사라졌고, 아무도 건드리려 하지 않는 파일에 중요한 로직이 들어 있습니다. 지식이 없는 것이 아니라 코드에 갇혀 있는 상태이고, 이 상태에서 에이전트는 무엇을 깨뜨리면 안 되는지를 알 방법이 없습니다.
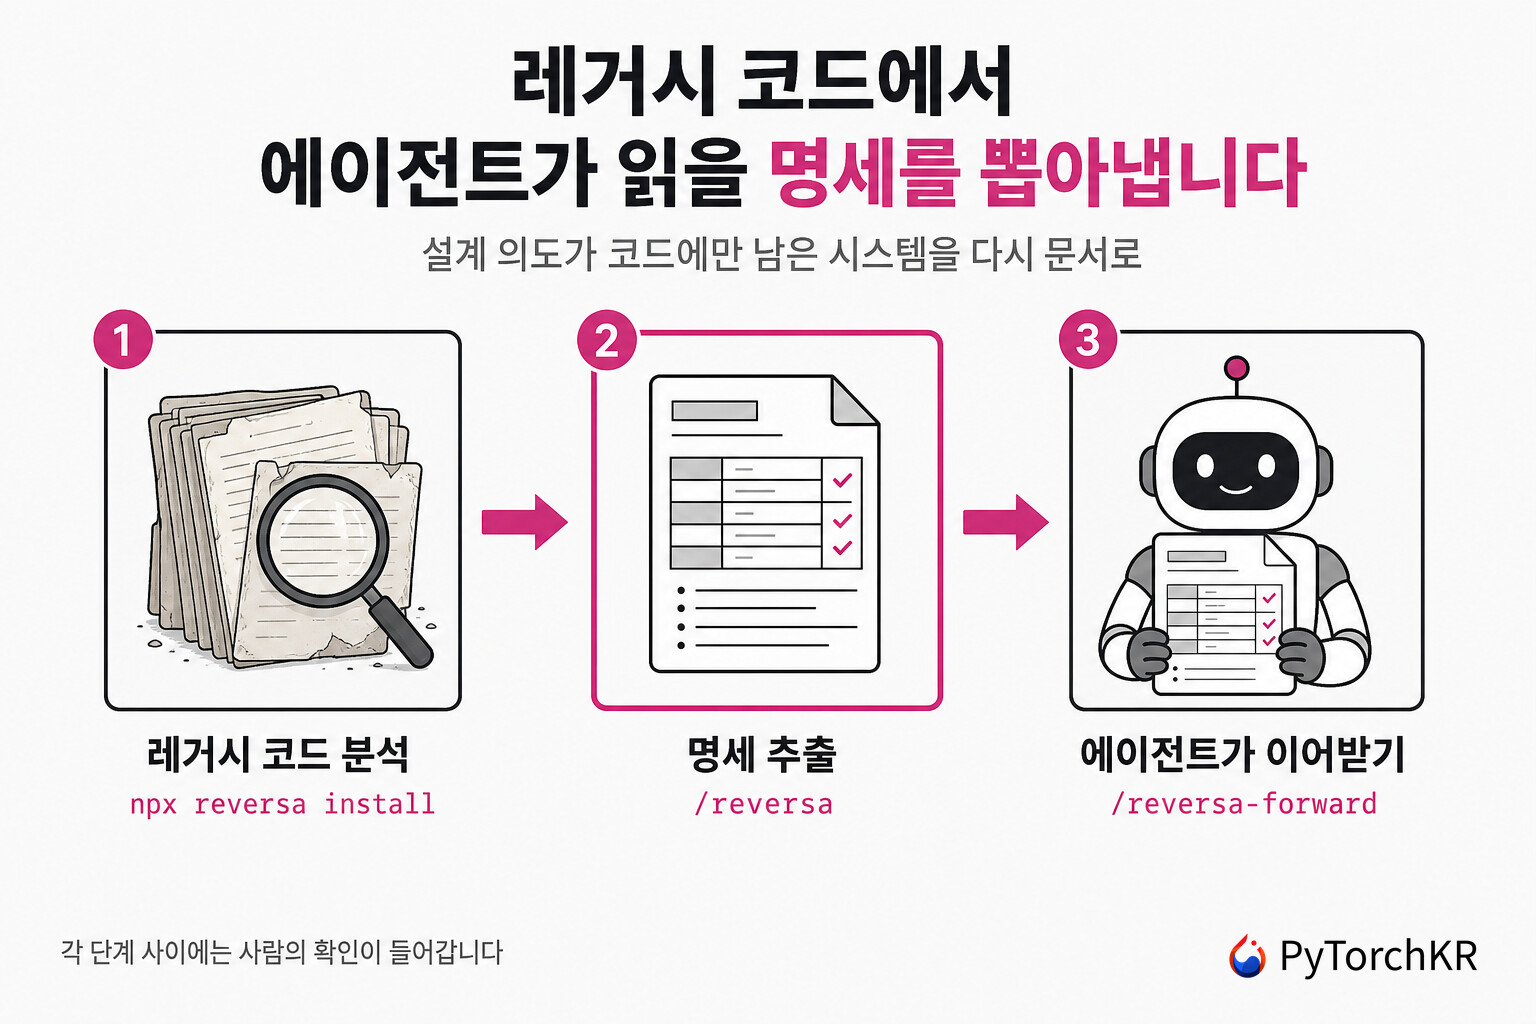
Reversa 는 이 순서를 반대로 진행하는 프레임워크입니다. 레거시 프로젝트 안에 설치하면 전문화된 AI 에이전트 팀을 조율해 기존 코드를 분석하고, 거기서 업무 규칙과 흐름, 모듈 계약, 사후에 재구성한 아키텍처 결정을 추출해 다른 코딩 에이전트가 그대로 쓸 수 있는 명세로 바꿉니다. 저자들은 이 결과물이 사람이 읽을 문서가 아니라 운영 계약(operational contract), 즉 에이전트가 기존 동작에 충실하게 시스템을 발전시킬 수 있게 하는 형태라고 설명합니다. GitHub의 Spec Kit 처럼 명세를 먼저 쓰고 코드를 만드는 도구가 새 프로젝트 쪽을 담당한다면, Reversa 는 이미 코드가 있는 쪽에서 명세를 되찾아 오는 자리에 있습니다.
만든 사람은 브라질의 연구자 두 명입니다. Sanderson Oliveira de Macedo(고이아스 연방공과대학)와 Ronaldo Martins da Costa(고이아스 연방대학교)가 2026년 5월 18일에 이 프레임워크를 정리한 논문 Reversa: A Reverse Documentation Engineering Framework for Converting Legacy Software into Operational Specifications for AI Agents 를 arXiv에 공개했습니다. 문서 사이트는 영어와 포르투갈어, 스페인어로 제공되며, 에이전트 사이의 확인 절차에서 CONTINUAR 라는 포르투갈어 단어를 쓰는 것도 이 배경 때문입니다.
기존 연구가 비워 둔 자리
논문은 Reversa를 아무것도 없던 자리에 놓지 않고, 이미 활발한 네 갈래 연구가 서로 만나지 못한 교차점에 놓습니다. 각 갈래는 문제의 일부를 이미 잘 풀고 있습니다.
첫째는 고전적 리버스 엔지니어링과 프로그램 이해입니다. 프로그램 메타모델과 중간 표현으로 기존 시스템에서 구조와 동작, 현대화 선택지를 복원하는 계열이며, 도메인 지식을 보존하면서 기술 플랫폼을 바꾸는 문제를 오래 다뤄 왔습니다. 다만 산출물의 소비자가 사람 엔지니어와 분석 도구입니다.
둘째는 LLM 기반 저장소 문서화입니다. RepoAgent 처럼 저장소 수준의 코드 문서를 생성하고 유지하는 연구, 함수와 파일과 패키지를 계층적으로 요약하는 연구가 여기에 속합니다. 저장소를 분석 단위로 삼는다는 점에서 Reversa와 가장 가깝지만, 만들어진 설명이 곧바로 안전한 근거가 되지는 않습니다.
셋째는 요구사항과 명세 생성입니다. 주석이나 문서에서 소프트웨어 명세를 생성하는 연구, GPT-4와 CodeLlama로 SRS(Software Requirements Specification) 문서를 만들고 검증하는 연구, 자연어를 구조화된 SRS 산출물로 바꾸는 ReqInOne 같은 모듈형 에이전트가 있습니다. 다만 이 계열은 대부분 이미 존재하는 요구사항, 주석, 문서에서 출발합니다. 레거시는 그 출발점 자체가 없는 경우입니다.
넷째는 소프트웨어 에이전트입니다. SWE-bench 는 실제 이슈와 풀 리퀘스트에서 뽑은 유지보수 문제가 저장소 이해와 파일 간 조율, 테스트를 통한 검증을 요구한다는 것을 보였고, SWE-agent 는 에이전트와 컴퓨터 사이의 인터페이스가 성능을 좌우한다는 것을 보였습니다. 그런데 이 연구들은 보통 과제와 문맥, 정확성 기준이 이미 주어져 있다고 가정합니다.
논문에서는 이 네 갈래와 Reversa의 위치를 다음 표로 정리합니다:
| 연구 계열 | 주된 초점 | 전형적인 소비자 | Reversa의 위치 |
|---|---|---|---|
| 고전적 리버스 엔지니어링 | 구성 요소, 관계, 추상, 설계의 복원 | 엔지니어, 아키텍트, 분석 도구 | 개념적 기반은 그대로 쓰되 산출물을 코딩 에이전트 쪽으로 돌립니다 |
| LLM 기반 저장소 문서화 | 코드와 저장소 수준의 설명 생성과 유지 | 사람 개발자, 기술 문서 | 운영에 쓰려면 추적성, 확신도, 빈틈 표기가 추가로 필요합니다 |
| 요구사항과 명세 생성 | SRS, 형식 계약, 준형식 명세의 산출 | 분석가, 검증자, 요구사항 파이프라인 | 요구사항이나 주석이 아니라 레거시 시스템 자체를 1차 출처로 삼습니다 |
| 소프트웨어 에이전트 | 유지보수, 테스트, 디버깅, 개발 과제의 수행 | 과제와 정확성 기준이 정의된 저장소 | 그 에이전트들에게 줄 운영 계약을 한 단계 앞에서 만듭니다 |
논문에서 이 배치의 근거로 특히 강조하는 실증 결과가 하나 있습니다. Macke와 Doyle은 잘못된 문서가 LLM의 코드 이해를 오히려 해칠 수 있다는 것을, 반면 문서가 없거나 불완전한 경우에는 같은 종류의 해가 반드시 발생하지는 않는다는 것을 실험으로 보였습니다. 자동 생성 문서를 에이전트의 입력으로 쓸 때 "틀린 문장을 자신 있게 적어 두는 것" 이 "빈칸을 남기는 것" 보다 나쁘다는 뜻이며, Reversa가 문장마다 확신 등급을 붙이고 빈틈을 산출물로 보존하는 설계를 택한 이유가 여기에 있습니다.
역방향 문서화 공학이라는 정의
논문에서 제안하는 용어는 역방향 문서화 공학(reverse documentation engineering) 이며, 저자들은 이를 기존 시스템으로부터 동작과 아키텍처, 도메인 규칙, 빈틈, 확신 수준을 명시적으로 드러내는 기술 문서와 운영 명세를 도출하는 과정으로 정의합니다. 저자들이 "리버스 엔지니어링" 이라는 말을 그대로 쓰지 않은 이유도 밝혀 두었습니다. 그 표현은 보통 바이너리에서 코드나 아키텍처를 복원하는 일을 떠올리게 하는데, 여기서의 목표는 기존 시스템을 AI 보조 유지보수와 마이그레이션, 진화를 이끄는 문서적 계약으로 바꾸는 것이기 때문입니다.
사람이 읽을 문서와 에이전트가 쓸 계약이 어떻게 다른지도 구체적으로 적어 두었습니다. 사람을 위한 문서는 서술적이거나 선별적이거나 교육적일 수 있지만, 코딩 에이전트에게는 더 실행 가능한 계약이 필요합니다. 보존해야 할 동작, 주장을 뒷받침하는 증거, 추론으로 얻은 규칙, 안전한 구현을 막는 빈틈, 그리고 분석한 단위마다 도출된 과제가 그 내용입니다. 매끄럽게 읽히는 글이 사람에게는 편해도, 취약한 추론을 사실처럼 제시한다면 자동화의 입력으로는 위험하다는 것이 논문의 판단입니다.
논문이 내세우는 기여는 다섯 가지입니다:
- 레거시 시스템과 AI 에이전트라는 맥락에서 역방향 문서화 공학을 조작적으로 정의합니다.
- 레거시 코드를 추적 가능한 운영 명세로 바꾸는 다중 에이전트 프레임워크로 Reversa를 제시합니다.
- 거짓 확신을 담은 문서가 생기는 위험을 줄이기 위한 확신도와 빈틈 모델을 제시합니다.
- 여러 코딩 에이전트 엔진 사이에서 이식 가능하고, 설치와 갱신이 매니페스트로 통제되는 아키텍처를 설명합니다.
- 평가 프로토콜을 제안하고 COBOL에서 Go로 가는 탐색적 사례 연구에 적용합니다.
이 기여들은 네 개의 연구 질문에 답하는 형태로 배치되어 있습니다. RQ1은 다중 에이전트 프레임워크가 레거시 코드를 에이전트가 소비할 수 있는 운영 명세로 어떻게 바꿀 수 있는지, RQ2는 에이전트가 생성한 명세가 레거시 동작에 대한 불확실성을 숨기지 않게 하려면 어떤 추적성과 확신 장치가 필요한지, RQ3은 에이전트 역할을 나누는 것이 이해와 종합, 명세 작성, 검토라는 서로 다른 단계를 어떻게 나눠 맡는지, RQ4는 생성된 명세가 실제로 유용한지를 어떤 프로토콜로 측정할 수 있는지를 묻습니다.
다섯 가지 설계 목표
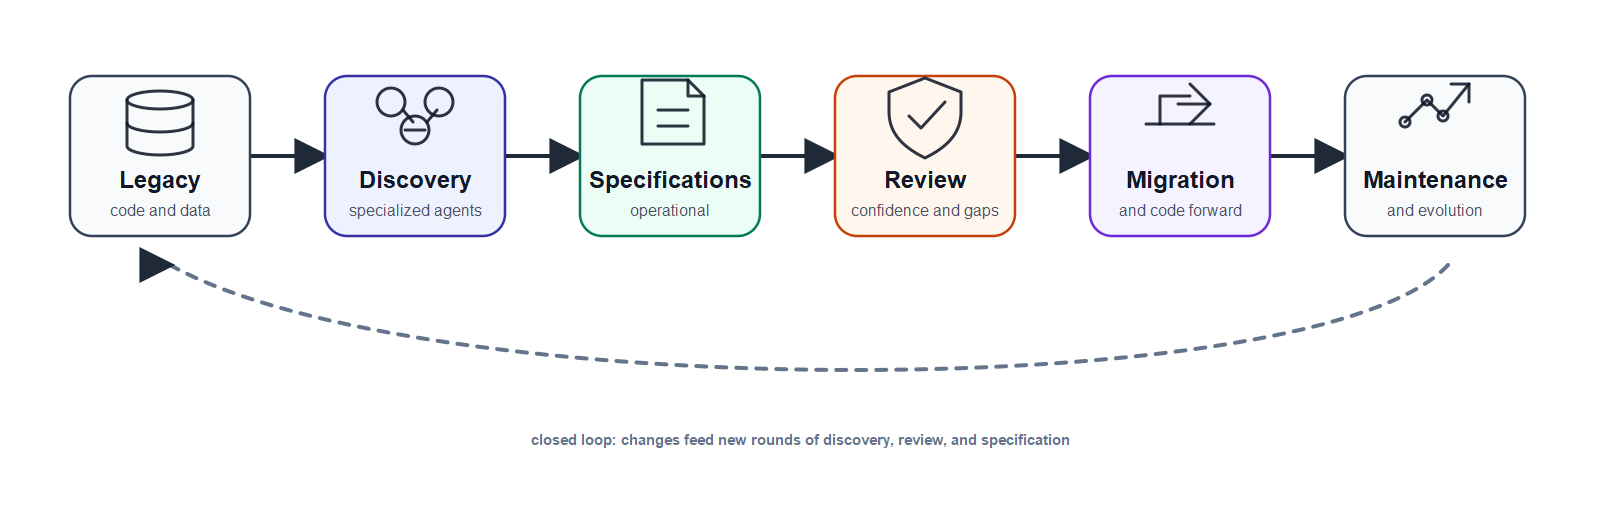
프레임워크의 설계는 다섯 가지 목표에서 출발합니다. 첫째, 산출물은 서술적 설명이 아니라 운영 계약이어야 합니다. 기대 동작, 도메인 규칙, 의존성, 흐름, 재구현 과제, 그리고 다른 에이전트나 개발자가 모호함을 덜 안고 움직일 수 있을 만큼의 근거를 담아야 합니다. 둘째, 의미 있는 모든 주장은 파일, 모듈, 라우트, 스키마, 쿼리처럼 레거시 안의 증거로 되짚을 수 있어야 합니다. 셋째, 불확실성을 명시해야 합니다. 넷째, 설치가 레거시 프로젝트를 파괴하거나 점유하지 않아야 합니다. 다섯째, 특정 도구 선택보다 앞선 문제를 다루므로 여러 코딩 에이전트 엔진 사이에서 이식 가능해야 합니다.
이 목표들은 세 개의 계층으로 구현됩니다. 엔진 감지와 프롬프트, 파일 쓰기, 검증, 매니페스트 처리를 담당하는 설치와 보존 계층, 각자의 지시문과 참조 문서, 템플릿을 가진 설치형 스킬로 이루어진 에이전트 계층, 인벤토리와 분석, 단위별 명세, 추적성 행렬, 빈틈과 확신 보고서가 쌓이는 산출물 계층입니다.
레거시 코드에서 명세를 추출하는 다섯 단계
Reversa의 중심은 /reversa 명령으로 시작하는 Discovery 파이프라인입니다. Reversa 라는 이름의 조율 에이전트가 다섯 단계를 순서대로 진행하며, 단계마다 담당 에이전트가 따로 있습니다:
| 단계 | 담당 에이전트 | 하는 일 |
|---|---|---|
| Reconnaissance | Scout | 폴더 구조, 언어, 프레임워크, 의존성, 진입점을 훑어 표면을 지도로 만듭니다 |
| Excavation | Archaeologist | 모듈 단위로 알고리즘, 제어 흐름, 자료 구조를 깊게 분석합니다 |
| Interpretation | Detective, Architect | 업무 규칙과 사후 아키텍처 결정(ADR), 상태 기계, 권한을 추출하고 C4(Context, Container, Component, Code) 다이어그램과 전체 ERD(Entity Relationship Diagram), 통합 지도, 기술 부채로 종합합니다 |
| Generation | Writer | 코드 추적성을 갖춘 운영 계약 형태의 명세를 작성합니다 |
| Review | Reviewer | 명세의 모순을 찾고 빈틈을 사용자와 함께 검증합니다 |
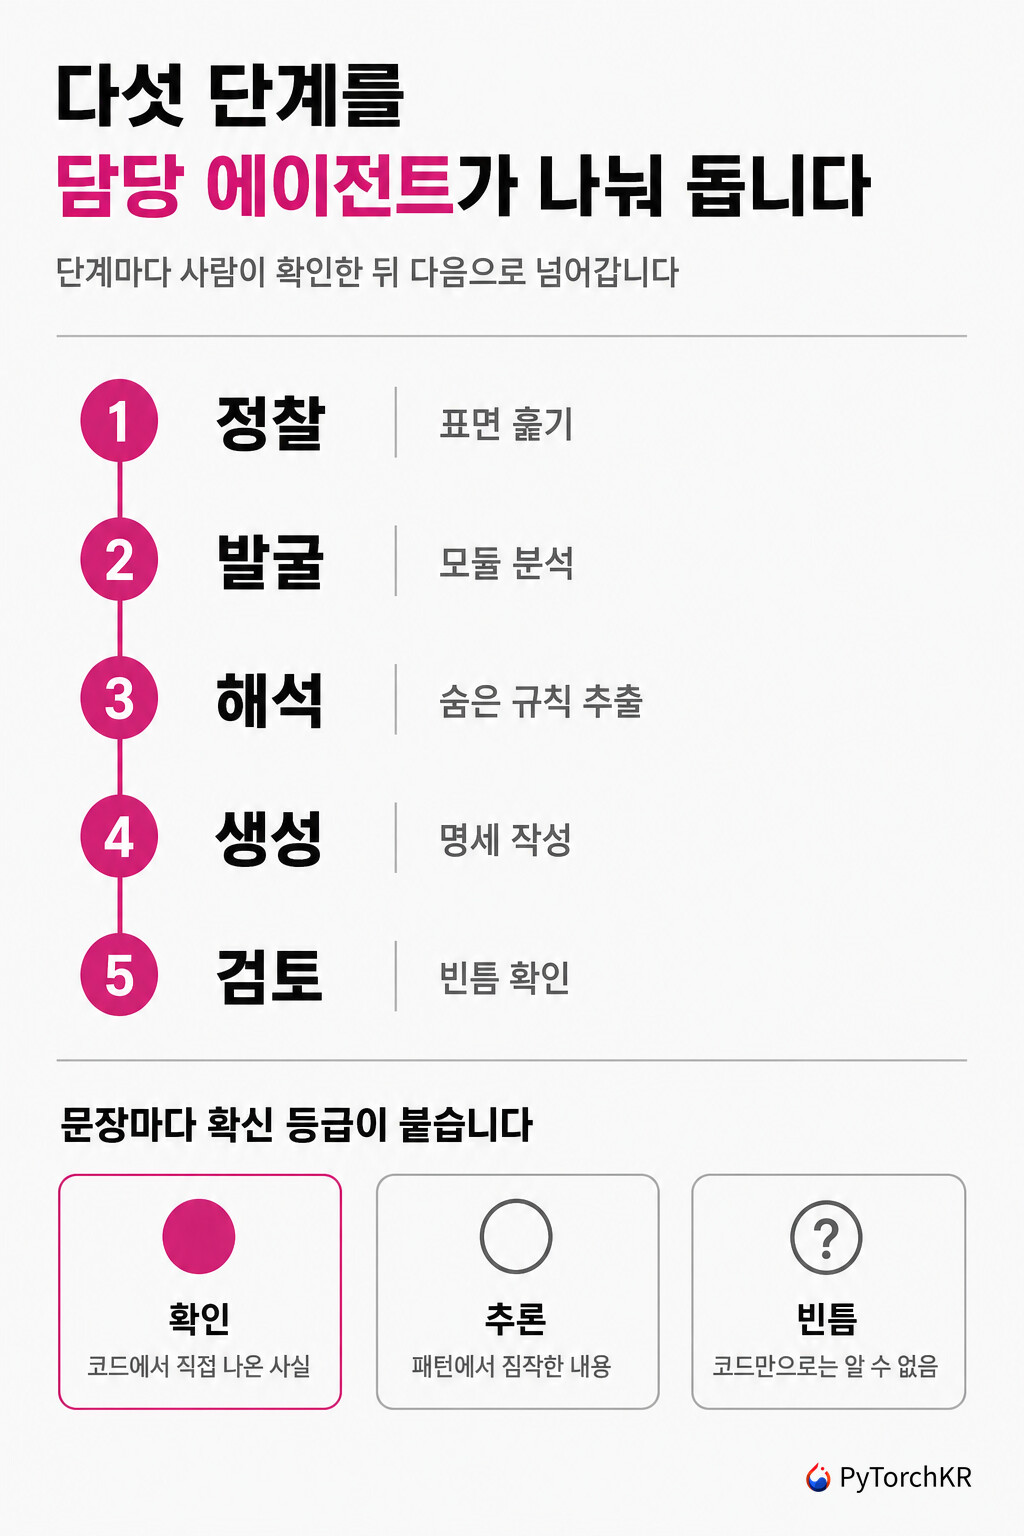
각 조율 에이전트는 다음 에이전트로 넘어가기 전에 멈추고 CONTINUAR 를 입력해 달라고 요청하므로, 모든 단계를 사람이 확인하며 진행합니다. 진행 상황은 단계마다 .reversa/state.json 에 저장되어, 세션이 끊겨도 reversa 를 다시 입력하면 멈춘 자리에서 이어집니다. 아래에서는 각 단계가 코드에서 정확히 무엇을 읽고 무엇을 남기는지를 저장소의 에이전트 스킬 정의를 따라 살펴보겠습니다.
에이전트를 굳이 여섯으로 나눈 이유에 대해서는 논문이 조심스러운 답을 내놓습니다. 다중 에이전트가 언제나 단일 에이전트보다 낫다고 주장하지 않으며, 역할을 나눈 목적은 서로 다른 작업 사이에 검사 지점을 만드는 것이라고 적었습니다. 표면을 지도로 만드는 일과 도메인 규칙을 추론하는 일은 다르고, 아키텍처를 종합하는 일과 단위별 계약을 쓰는 일도 다르며, 확신도를 검토하는 일은 새 텍스트를 생성하는 일과 또 다릅니다. 저장소 하나를 통째로 읽어 최종 문서를 한 번에 내놓게 하는 대신 입력과 출력이 명시된 역할로 나누면, 잘못된 주장이 하나 나왔을 때 그것이 어느 단계에서 들어왔는지 되짚을 수 있어 절차 전체가 감사 가능해집니다.
1단계 정찰: Scout이 표면을 지도로 만든다
Scout은 코드를 해석하지 않고 어디에 무엇이 있는지만 확정합니다. 디렉토리 트리를 나열하되 node_modules, .git, dist, build, coverage, __pycache__, .cache 와 Reversa 자신의 작업 폴더는 제외하고, 파일 확장자별 개수를 세어 언어 구성을 파악합니다. 프레임워크와 라이브러리는 package.json, requirements.txt, pom.xml, go.mod, Gemfile, Cargo.toml, composer.json 같은 설정 파일에서 버전과 함께 뽑고, 진입점은 main, index, app, server, bootstrap 계열 파일과 .env.example, config/, CI 설정(.github/workflows/, Jenkinsfile, .gitlab-ci.yml), Dockerfile, docker-compose.yml, 그리고 package.json 의 스크립트에서 찾습니다. DDL(Data Definition Language)과 마이그레이션, ORM(Object Relational Mapping) 모델은 이 단계에서 목록만 만들고 상세 분석은 Data Master 에이전트에게 넘깁니다. 테스트는 *.test.*, *.spec.* 파일 수를 세어 커버리지를 어림합니다.
Scout이 남기는 가장 중요한 판단은 따로 있습니다. 명세를 어떤 단위로 쪼갤지에 대한 제안을 근거와 함께 surface.json 에 적습니다. 판단은 아래 순서로 진행하다가 신호가 뚜렷하게 우세한 첫 항목에서 멈추는 방식입니다:
| 관찰된 신호 | 어디를 보는가 | 제안하는 단위 |
|---|---|---|
| 중앙집중식 라우팅 | routes.*, urls.py, *Controller.cs, @RestController, app.get/post/..., Router() |
endpoint |
| 도메인 이름을 가진 최상위 폴더 | src/<도메인>/, app/<도메인>/, internal/<도메인>/ |
module |
| 행위 중심의 Gherkin 또는 E2E 명세 | features/*.feature, BDD 형태의 *.spec.*, cypress/e2e/*.cy.* |
use-case |
| 위 신호 둘 이상이 비슷한 무게로 공존 | 두 가지 이상의 조합 | hybrid |
| 뚜렷한 신호 없음 | 폴백 | feature |
각 제안에는 한 문장짜리 근거와, 그 신호를 입증하는 상대 경로 목록이 함께 기록됩니다. 근거 없는 분류를 남기지 않겠다는 규칙이 이 단계부터 적용되는 셈입니다.
Scout이 끝나면 조율 에이전트는 차단형 체크포인트를 겁니다. 발견한 모듈 수와 주요 언어, 외부 통합 개수, 데이터베이스 유무를 요약해 보여준 뒤 문서화 수준(doc_level)을 고르게 하고, 답을 받기 전에는 다음 에이전트로 넘어가지 않습니다. 선택지는 essencial(기본값), completo, detalhado 세 가지이며, 이 값이 이후 모든 단계에서 어떤 산출물을 만들지를 결정합니다. 예를 들어 데이터 사전을 별도 파일로 뺄지 분석 문서 안의 표로 둘지, C4 다이어그램을 세 수준 모두 그릴지 컨텍스트 수준만 그릴지, ADR을 생성할지 건너뛸지가 여기서 갈립니다. 그 다음 명세 조직 방식을 여섯 가지(모듈, 유스케이스, 엔드포인트, 하이브리드, 피처, 커스텀) 중에서 고르게 하여 .reversa/config.toml 의 [specs] 절에 저장하고, 이 결정이 저장된 뒤에야 Archaeologist가 시작됩니다.
또 하나 눈에 띄는 처리는 Scout 결과로 계획서 자체를 다시 쓴다는 점입니다. .reversa/plan.md 의 2단계 항목이 "코드를 분석한다" 같은 일반 항목에서 Archaeologist, auth 모듈 분석, Archaeologist, orders 모듈 분석 처럼 모듈별 항목으로 교체됩니다.
2단계 발굴: Archaeologist가 모듈 단위로 판다
Archaeologist는 해석과 판단을 하지 않고 코드에 실제로 있는 것만 기록합니다. 모듈마다 네 가지를 훑습니다. 제어 흐름에서는 주요 함수와 메서드의 이름, 매개변수, 반환값과 함께 자명하지 않은 논리를 담은 조건문, 업무 논리가 들어간 반복문, 오류와 예외 처리를 잡습니다. 알고리즘과 로직에서는 자명하지 않은 알고리즘, 데이터 변환과 변형, 코드에 들어 있는 계산식과 규칙, 유효성 검사 논리를 추출합니다. 자료 구조에서는 모델과 엔티티, DTO, 인터페이스를 정리하고 필드마다 타입과 필수 여부, 기본값을 담은 데이터 사전을 만듭니다. 마지막으로 메타데이터에서는 도메인 이름을 가진 상수와 열거형, 기능 플래그, 환경별 설정 매개변수를 모읍니다.
이 단계에는 품질을 위한 실행 규칙이 하나 더 있습니다. 분석을 세션 단위로 끊어서 진행합니다. 큰 프로젝트의 모듈을 한 세션에서 계속 읽으면 문맥이 소진되어 뒤쪽 모듈의 분석 품질이 떨어지기 때문입니다. 스킬 정의에는 한 세션에서 모듈 세 개 이상을 처리했거나 방금 끝낸 모듈이 큰 파일을 많이 읽었다면, 다음 모듈을 시작하기 전에 사용자에게 /clear 후 새 세션에서 재개할지 물어보라는 지시가 들어 있습니다. 결정은 사용자에게 맡기되, 물어보기 전에 .reversa/state.json 의 checkpoints.archaeologist.modules_analyzed 에 체크포인트가 저장되었는지 먼저 확인하도록 되어 있습니다.
산출물은 통합 기술 분석인 code-analysis.md 와 다음 에이전트를 위한 구조화 데이터 modules.json 이 항상 나오고, 문서화 수준이 completo 이상이면 data-dictionary.md 와 모듈별 Mermaid 순서도가, detalhado 이면 주요 함수 단위 순서도까지 추가됩니다.
3단계 해석: Detective가 왜를 캐고 Architect가 지도를 그린다
여기서 분석은 서술에서 해석으로 넘어갑니다. Detective 의 임무는 시스템의 "왜" 를 복원하는 것이고, 특징적인 것은 코드가 아닌 곳에서도 증거를 찾는다는 점입니다.
첫 번째 출처는 Git 이력입니다. git log 를 분석해 업무나 기술 결정을 드러내는 커밋 메시지, 기대 동작을 역으로 알려 주는 fix와 hotfix 커밋, 요구사항 변경을 시사하는 대규모 리팩토링, 되돌린 커밋과 그 이유를 모아 사후 ADR(Architecture Decision Record) 의 재료로 씁니다. 아무도 문서로 남기지 않은 결정이 커밋 이력에는 남아 있다는 관찰을 그대로 절차로 만든 부분입니다.
두 번째는 코드 안의 암묵적 업무 규칙입니다. 도메인 논리를 담은 복잡한 조건문, 모델의 유효성 검사와 제약, 업무 용어를 이름으로 가진 상수와 열거형, 오래된 것이라도 증거로 취급하는 주석, 그리고 구현되지 않은 의도를 드러내는 TODO와 FIXME를 훑습니다. 세 번째는 상태 기계입니다. 상태 필드를 가진 엔티티마다 가능한 값 전체와 허용된 전이, 그 전이를 일으키는 계기를 정리해 Mermaid 다이어그램으로 남깁니다. 네 번째는 권한입니다. 사용자 역할과 역할별 권한, 기능과 데이터에 대한 접근 제한을 권한 행렬로 조판합니다. 마지막으로 로그 파일이 있으면 거기서 감시되는 업무 이벤트와 반복되는 오류를 식별합니다.
Detective의 스킬 정의에는 한 줄짜리 경고가 들어 있습니다. "엄격하게 판단하십시오, 여기서 나오는 많은 것이 INFERRED 일 것입니다." 추론에서 나온 규칙을 확정된 규칙처럼 적지 말라는 지시가 이 에이전트에만 따로 들어 있는 이유는, 업무 규칙 복원이 파이프라인 전체에서 추측이 가장 많이 섞이는 자리이기 때문입니다.
Architect 는 지금까지 나온 것을 아키텍처 문서로 종합합니다. C4 모델의 세 수준을 각각 그리는데, 컨텍스트 수준에서는 시스템을 중심에 두고 사용자 페르소나와 연동하는 외부 시스템, 관계와 프로토콜을 배치하고, 컨테이너 수준에서는 애플리케이션과 서비스, 데이터베이스, 큐, 캐시를 각자의 기술과 함께 그리며, 컴포넌트 수준에서는 주요 컨테이너의 내부 구성 요소와 책임을 나눕니다. 여기에 모든 엔티티와 주요 속성, 1:1과 1:N, N:M 카디널리티, 기본 키와 외래 키를 담은 전체 ERD, 소비하고 제공하는 REST와 GraphQL API, 웹훅과 이벤트를 정리한 통합 지도, 그리고 중복 코드와 일관성 없는 패턴, 갱신이 시급한 의존성, 중요 모듈의 테스트 부재를 모은 기술 부채 목록이 더해집니다. 마지막으로 어떤 구성 요소가 어떤 구성 요소에 영향을 주는지를 담은 Spec Impact Matrix 를 만듭니다.
4단계 생성: Writer가 명세를 계약으로 조판한다
Writer의 원칙은 스킬 정의에 한 문장으로 적혀 있습니다. "명세는 예쁜 글이 아니라 운영 계약입니다." 판정 기준도 함께 적혀 있는데, 원본 코드에 접근하지 못하는 AI 에이전트가 그 명세만 보고 기능을 충실하게 재구현할 수 있을 만큼 상세해야 한다는 것입니다.
산출물은 1단계 끝에서 사람이 고른 조직 방식에 따라 단위(unit)별 폴더로 나뉘고, 각 폴더에는 세 개의 정본 파일이 들어갑니다. requirements.md 는 그 단위가 무엇을 하는지, design.md 는 어떻게 구성되어 있는지, tasks.md 는 재구현을 위한 실행 가능한 작업 순서를 담습니다. 단위가 무엇인지는 조직 방식이 결정합니다:
| 조직 방식 | 단위의 정의 | 열거 근거 |
|---|---|---|
module |
레거시의 모듈 하나 | surface.json 의 모듈 목록 |
endpoint |
HTTP나 RPC 계약 하나 | Scout이 찾은 라우트와 컨트롤러 |
use-case |
행위 단위의 유스케이스 하나 | Gherkin과 E2E 명세, 또는 코드 흐름에서 추출한 사례 |
hybrid |
모듈을 상위에 두고 그 안에 유스케이스를 중첩 | 모듈 목록 + 모듈별 유스케이스 |
feature |
Scout이 나열한 피처 하나 | surface.json 의 피처 목록 |
custom |
사용자가 직접 정의한 폴더 | config.toml 의 custom_folders |
문서화 수준과 맥락에 따라 단위 폴더 안에 선택 파일이 더 생깁니다. 외부 계약을 노출하는 단위에는 contracts.md, 서로 다른 흐름이 둘 이상이면 flows.md, 최고 상세 수준에서는 단위마다 최소 두 건의 극단 사례를 담은 edge-cases.md, 아키텍처 결정이 명확한 단위에는 decisions.md, 빈틈(GAP)이 있는 단위에는 questions.md 가 생깁니다. 문서화 수준이 completo 이상이면 단위 폴더 바깥의 최상위에 OpenAPI 명세와 사용자 스토리, 그리고 레거시 파일 하나하나가 어느 단위에 대응하는지를 적은 traceability/code-spec-matrix.md 가 놓입니다. 이 행렬에서 대응 단위가 없는 파일은 n/a 로 남아 추가 분석 후보가 됩니다.
명세를 채우는 방식에도 근거 규칙이 걸려 있습니다. 비기능 요구사항은 발명하지 않고 코드에서 추론합니다. 명시적인 타임아웃은 성능 항목으로, 인증과 인가 미들웨어는 보안 항목으로, 캐시와 큐와 워커 사용은 확장성 항목으로, 재시도 로직과 서킷 브레이커는 가용성 항목으로 옮기며, 증거를 못 찾으면 그 줄을 아예 비웁니다. 각 항목에는 근거가 된 파일:줄 과 확신 등급이 함께 적힙니다. 인수 조건은 design.md 에 기록된 흐름과 업무 규칙에서 유도하되 주요 흐름마다 성공 시나리오와 실패 시나리오를 최소 하나씩 Dado / Quando / Então(Given / When / Then) 형식으로 만듭니다. 우선순위는 MoSCoW로 매기는데, 임계 경로에 있거나 여러 구성 요소가 호출하면 Must, 대안이나 폴백이 있으면 Should, 드물게 호출되거나 경계 사례면 Could, 주석 처리된 코드와 꺼진 플래그와 폐기된 것은 Won't로 두고, 판단은 호출 빈도와 의존성 사슬에서의 위치, 테스트 존재 여부에 근거합니다. tasks.md 의 각 작업에는 그 동작을 추출한 레거시 파일 경로, 완료 판정 기준, 확신 등급이 예외 없이 기록됩니다.
Writer에도 실행 규칙이 있습니다. 한 번에 전부 생성하지 않습니다. 먼저 몇 개 단위에 몇 개 파일을 만들지 계획을 체크리스트로 보여주고 승인을 받은 뒤, 파일 하나를 만들 때마다 진행률을 .reversa/state.json 의 redator_progress 에 저장하고 멈춰 사용자의 응답을 기다립니다. 단위 폴더가 이미 있으면 기존 내용을 보존하고 빠진 파일만 추가하며, 정본 파일이 이미 있으면 확인 없이 덮어쓰지 않습니다.
5단계 검토: Reviewer가 명세를 깨뜨리려 시도한다
Reviewer의 임무는 검수 도장을 찍는 것이 아니라 명세를 깨뜨려 보는 것입니다. 단위 안에서는 정본 세 파일이 모두 있는지, requirements.md 가 정의한 기대를 design.md 의 구조와 tasks.md 의 작업이 실제로 덮는지, 업무 규칙끼리 모순되지 않는지, 당연히 있어야 할 동작이 빠지지 않았는지를 봅니다. 그리고 INFERRED 로 표시된 주장은 원본 코드로 돌아가 다시 확인합니다. 단위 사이에서는 서로 충돌하는 서술, 선언된 의존성과 코드의 실제 의존성 사이의 불일치, 있어야 하는데 생성되지 않은 단위를 surface.json 과 대조해 찾습니다. 마지막으로 두 추적성 행렬이 실제 구조를 반영하는지 검증합니다.
이 단계에는 특이한 선택지가 하나 있습니다. 세션에 Codex 플러그인이 활성화되어 있으면 자기 검토 전에 다른 LLM에게 독립 교차 검토를 맡길 수 있습니다. 문서화 수준이 essencial 이면 이 선택지를 꺼내지 않고, completo 이면 사용자에게 물어보며, detalhado 이면 묻지 않고 반드시 수행합니다. Codex가 없을 때도 언급조차 하지 않습니다. 위임하는 과제는 단위 내부 모순, 단위 사이 충돌, 명세되지 않은 명백한 동작, 그리고 CONFIRMED로 표시되었지만 실제로는 추론으로 보이는 주장을 찾아 cross-review-result.md 에 저장하라는 것입니다. 돌아온 지적은 타당하면 명세를 고치고 출처를 [Revisão Codex] 로 기록하며, 이견이 있는 지적은 INFERRED 로 표시하고 충돌 내용을 주석으로 남깁니다.
사람에게만 물을 수 있는 GAP 항목은 questions.md 로 모입니다. 답변 방식은 두 가지인데, 기본값인 chat 모드는 질문을 대화에서 하나씩 또는 주제별로 묶어 던지고 답을 즉시 반영하며, file 모드는 질문 파일을 만들어 두고 사용자가 답변란을 채운 뒤 reversa 를 다시 입력할 때까지 기다립니다.
단계 밖에서 움직이는 에이전트들
레거시의 지식이 소스 코드에만 있는 것은 아닙니다. 화면과 데이터베이스, 스타일 파일에 흩어진 증거를 다루는 에이전트가 따로 있고, 이들은 특정 단계에 묶이지 않아 필요할 때 호출합니다.
Visor 는 시스템을 실행하지 않고 스크린샷만으로 인터페이스를 문서화합니다. 화면마다 이름과 목적, 상태(로딩, 비어 있음, 채워짐, 오류, 확인)를 적고, 폼의 필드와 라벨과 타입과 필수 여부, 눈에 보이는 유효성 검사, 표의 열과 행 단위 동작, 메뉴와 이동 경로, 성공과 오류 메시지를 정리한 뒤 화면 사이의 이동 흐름을 지도로 만듭니다. 그리고 각 화면이 어느 단위에 속하는지를 앞서 정한 조직 방식에 맞춰 대응시킵니다. 예를 들어 조직 방식이 module 이면 화면의 경로가 어느 모듈 이름과 맞는지로, use-case 이면 그 화면이 수행하는 유스케이스로 연결합니다. 운영 중인 레거시를 띄우지 않고도 화면 명세를 얻게 하려는 설계입니다.
Data Master 는 데이터베이스를 따로 파고듭니다. DDL과 마이그레이션(Laravel, Rails, Flyway, Liquibase, Alembic, Prisma), ORM 모델(Eloquent, ActiveRecord, SQLAlchemy, Hibernate, TypeORM), 데이터베이스 도구의 스크린샷, 그리고 직접 연결까지를 출처로 삼는데, 직접 연결은 읽기 전용이며 INSERT, UPDATE, DELETE, DROP 은 절대 실행하지 않는다는 제약이 스킬 정의에 명시되어 있습니다. 산출물은 테이블별 컬럼과 키와 제약, 카디널리티를 갖춘 관계, 트리거와 저장 프로시저와 체크 제약에 들어 있는 업무 규칙, 그리고 Mermaid ERD입니다. 여기서도 확신 등급이 출처에 따라 갈립니다. DDL과 마이그레이션에서 직접 온 것은 확정, ORM과 스크린샷에서 추론한 것은 추론, 접근하지 못한 것은 빈틈입니다.
Design System 은 CSS와 Sass 변수, tailwind.config.js, MUI와 Chakra UI 같은 라이브러리의 테마, styled-components 테마 객체, Style Dictionary 토큰 파일, Storybook에서 색상 팔레트와 타이포그래피, 간격과 그리드와 중단점, 모서리 반경과 그림자 같은 디자인 토큰을 추출합니다. 화면을 다시 만들어야 하는 마이그레이션에서 쓰이는 자료입니다.
Soul Extractor 는 자동 실행 계획에 들어가지 않고 사용자가 /reversa-extract-soul 로 직접 부르는 가벼운 에이전트입니다. Scout의 surface.json 이 있어야 동작하며, 시스템의 목적과 핵심 엔티티, 지금의 모습을 만든 창립 결정을 한 편의 요약 명세 soul.md 로 냅니다. 파이프라인 전체를 돌릴 시간이 없을 때 시스템의 윤곽만 먼저 잡는 용도이고, 기존 soul.md 가 있으면 덮어쓰지 않고 사용자에게 물어봅니다.
파이프라인이 끝나면 남는 것
지금까지의 산출물을 한자리에 모으면 추출 결과는 두 갈래로 나뉩니다. 조직 방식과 무관하게 프로젝트 전체를 가로지르는 문서는 출력 폴더 최상위에 놓이고, 단위별 계약만 단위 폴더 안에 들어갑니다. 문서화 수준에 따라 일부는 생성되지 않습니다:
_reversa_sdd/
├── inventory.md              # Scout: 프로젝트 인벤토리
├── dependencies.md           # Scout: 의존성과 버전
├── code-analysis.md          # Archaeologist: 모듈별 기술 분석
├── data-dictionary.md        # Archaeologist: 데이터 사전
├── flowcharts/               # Archaeologist: 모듈별 Mermaid 순서도
├── domain.md                 # Detective: 용어집과 도메인 규칙
├── state-machines.md         # Detective: 상태 기계
├── permissions.md            # Detective: 권한 행렬
├── adrs/                     # Detective: 사후 아키텍처 결정 기록
├── architecture.md           # Architect: 아키텍처 개요
├── c4-context.md             # Architect: C4 컨텍스트
├── c4-containers.md          # Architect: C4 컨테이너
├── c4-components.md          # Architect: C4 컴포넌트
├── erd-complete.md           # Architect: 전체 ERD
├── confidence-report.md      # Reviewer: 확신 등급 집계
├── questions.md              # Reviewer: 사람에게 물을 질문
├── gaps.md                   # Reviewer: 남은 빈틈
├── soul.md                   # Soul Extractor: 한 장짜리 요약 명세
├── <단위>/                    # Writer: 단위별 폴더
│   ├── requirements.md
│   ├── design.md
│   └── tasks.md
├── openapi/                  # Writer: API 명세
├── user-stories/             # Writer: 사용자 스토리
├── ui/                       # Visor: 화면 명세
├── database/                 # Data Master: ERD, 관계, 저장 프로시저
├── design-system/            # Design System: 디자인 토큰
└── traceability/
    ├── code-spec-matrix.md   # Writer: 레거시 파일에서 단위로
    └── spec-impact-matrix.md # Architect: 단위 사이의 영향 관계
프로젝트 자체의 상태는 여기가 아니라 .reversa/ 에 따로 쌓입니다. 단계별 진행 상황을 담은 state.json, 설정인 config.toml 과 개인 설정 config.user.toml, 사용자가 직접 고칠 수 있는 탐색 계획 plan.md, Scout과 Archaeologist가 남긴 구조화 데이터 context/surface.json 과 context/modules.json, 그리고 뒤에서 볼 SHA-256 목록 _config/files-manifest.json 이 그것입니다.
확신 등급과 추적성이 실제로 작동하는 방식
이 프로젝트가 신뢰의 근거로 내세우는 장치는 명세의 모든 문장에 붙는 세 등급입니다.  CONFIRMED 는 코드에서 직접 추출해 파일과 줄 번호까지 인용할 수 있는 것,
 INFERRED 는 패턴에서 추론(inference)한 것으로 틀릴 수 있는 것,
 GAP 은 코드만으로는 판단할 수 없어 사람의 검증이 필요한 것입니다. 중요한 것은 이 구분이 느낌이 아니라 판정 기준을 가진 규칙이라는 점입니다:
| 등급 | 이 등급을 붙이는 조건 |
|---|---|
| CONFIRMED |
동작이 코드에 명시적으로 있음(if/else, return, throw), 값이 코드에 정의된 상수나 열거형임, 규칙이 해당 코드 옆의 설명 주석에 있음, 그 동작을 정확히 덮는 자동화 테스트가 있음, DDL이나 마이그레이션이 제약을 직접 정의함 |
| INFERRED |
함수나 변수 이름이 동작을 시사하지만 명시적 로직이 없음, 프레임워크 관례와 일치함(예: Eloquent의 소프트 삭제), 단서는 있지만 전체 로직이 분석 범위 안에 보이지 않음, 하나의 정의가 아니라 여러 유사 사례에서 규칙을 추론함, 현재 상태를 반영하지 않을 수 있는 오래된 주석이나 TODO |
| GAP |
기능이 참조되지만 보이는 코드에 구현되어 있지 않음, 로직이 접근 불가능한 외부 설정(환경 변수, 데이터베이스, API)에 의존함, 기대 동작이 코드와 모순됨(잠재적 버그나 숨은 로직), 원본 소스 없이 생성되거나 컴파일된 코드, 이해관계자의 머릿속에만 있는 업무 규칙 |
등급은 고정되지 않고 검토 과정에서 다섯 가지 방향으로 재분류됩니다. 코드에서 직접 증거를 찾으면 INFERRED에서 CONFIRMED로 올리면서 파일:줄 을 명세에 적고, 합리적 추론이 가능할 만큼의 단서를 찾으면 GAP에서 INFERRED로 올리되 문장을 확정이 아닌 추론 형태로 다시 씁니다. 사용자가 구체적 근거와 함께 확인해 주면 GAP에서 CONFIRMED로 올립니다. 반대로 명세와 실제 코드가 어긋나면 CONFIRMED에서 INFERRED로 내리고, 추론이 틀렸다는 증거가 나오면 INFERRED에서 GAP으로 내리면서 필요하면 사용자 질문을 새로 만듭니다. 그리고 이 모든 판단을 하나의 원칙이 감쌉니다: "의심스러우면 더 낮은 등급을 쓰십시오. 정직한 GAP 하나가 오해를 부르는 INFERRED 하나보다 낫습니다."
논문은 이 설계의 목적을 한 문장으로 정리합니다. 에이전트가 틀리지 않는다고 주장하려는 것이 아니라, 불확실성을 출력 데이터로 보존하는 절차를 만드는 것입니다. 레거시에서는 이 결정이 특히 중요한데, 부분적으로 불확실하더라도 빈틈에 대해 정직한 명세가 가정을 사실처럼 제시하는 매끄러운 문서보다 책임 있는 유지보수에 더 쓸모 있기 때문입니다.
검토가 끝나면 이 분류를 집계한 confidence-report.md 가 나옵니다. 전체 요약과 명세별 분포, 남은 GAP 항목, 우선 검증 권고, 그리고 재분류 이력(어느 등급에서 어느 등급으로, 어떤 근거로 바뀌었는지)이 담깁니다. 전체 확신도는 확정을 1.0, 추론을 0.5로 세는 단순한 식으로 계산합니다:
저장소는 이 계산식만 제시하지만, 논문은 여기에 단서를 하나 더 답니다. 이 값은 파이프라인이 스스로 매긴 분류를 요약한 것일 뿐 사실 정확도가 아니라는 것이며, 외부 감사를 거치지 않았기 때문입니다. 뒤에서 볼 사례 연구의 97.1\% 라는 숫자도 그 전제 아래에서 읽어야 합니다.
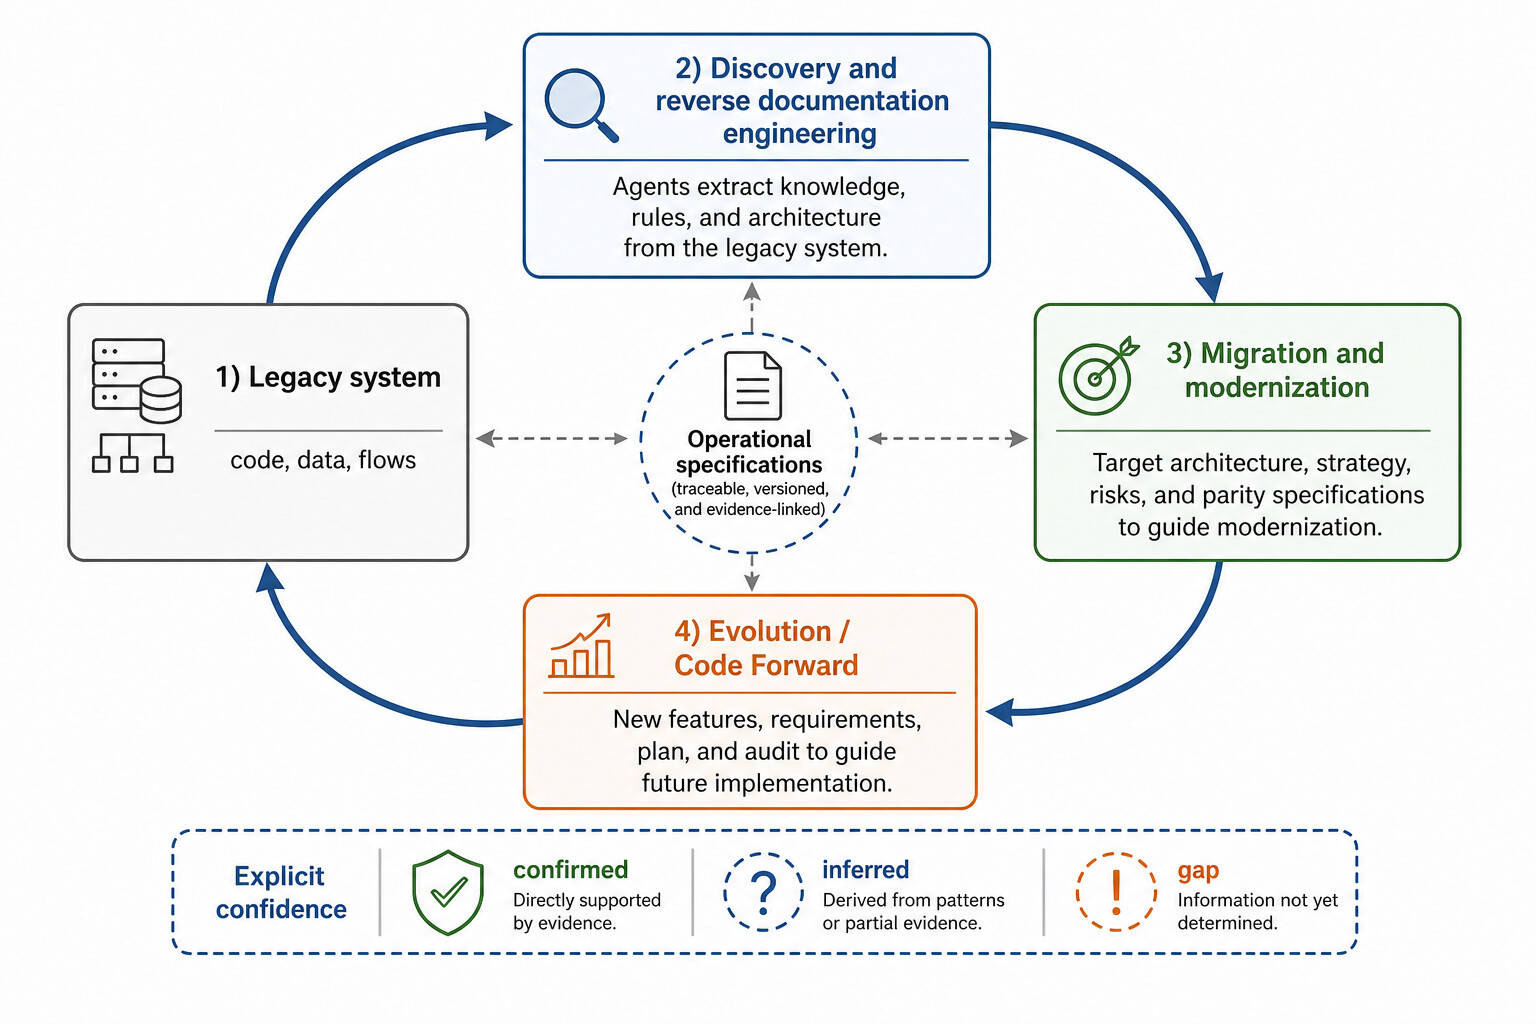
Discovery가 끝난 뒤에는 목표에 따라 세 방향으로 나뉩니다. /reversa-forward 는 명세에서 코드로 나아가 기능을 하나씩 발전시키고, /reversa-migrate 는 레거시를 현대적인 스택으로 다시 만드는 계획을 세우며, /reversa-docs 는 추출한 지식을 오프라인에서 열리는 HTML 미니 사이트로 만듭니다. 논문에서는 이 구조를 닫힌 순환이라고 부릅니다. 역방향 문서가 한 번 만들고 마는 정적 보고서가 아니라 변경을 이끌고, 변경 이후에는 새 추출과 회귀 확인, 계약 갱신의 기준으로 다시 쓰인다는 뜻입니다. 저장소에는 이 순환을 실제로 지탱하는 장치도 있습니다. 기능을 하나 배포할 때마다 전체 재추출을 실행하는 것은 낭비이므로 /reversa-sync 가 배포된 기능을 addenda/ 아래 부록으로 정리해 원본 추출물을 건드리지 않은 채 최신 상태를 유지하고, 재추출이 실제로 일어날 때는 이전 기능의 regression-watch.md 항목을 새 산출물과 대조해 확정, 추론, 빈틈 판정을 매깁니다. 저장소는 이 밖에도 아이디어 정리, 신규 프로젝트, 견적 산정, 버그 추적, 코드 품질 개선, 번역 어댑터를 담당하는 팀을 합쳐 열 개의 팀으로 에이전트를 조직해 두었습니다.
사람이 터미널을 지켜보지 않는 상황을 위한 경로도 따로 있습니다. /reversa-autonomous 는 시작 시점에 모든 질문을 한 번의 인터뷰로 모아 받고 나서 같은 에이전트와 같은 확인 지점으로 파이프라인 전체를 멈추지 않고 진행하며, 중간에 생긴 의문은 흐름을 끊는 대신 INFERRED 표시로 기록해 둡니다. 자동 승인 환경을 전제로 하기 때문에 안전 장치는 오히려 더 엄격합니다. 쓰기는 .reversa/ 와 출력 폴더 안에 머물고, 삭제나 git push, 배포, 의존성 설치처럼 파괴적이거나 외부로 나가는 명령은 스스로 실행하지 않습니다.
Reversa가 레거시 코드를 건드리지 않는 방식
레거시 시스템에 도구를 설치하는 일 자체가 위험 요소이므로, 저장소는 쓰기 범위를 명시적으로 제한해 두었습니다. 설치 프로그램은 CLAUDE.md, AGENTS.md, .agents/skills/ 같은 새 파일만 만들고 기존 파일을 덮어쓰거나 삭제하지 않습니다. 설치 코드를 열어 보면 파일을 쓰는 자리마다 존재 여부 검사가 앞에 놓여 있어, 이미 있는 경로는 건너뜁니다.
예외가 하나 있습니다. 엔진 진입 파일이 이미 있는 경우에는 사용자에게 어떻게 할지 물어보고, 병합을 고르면 기존 내용 뒤에 구분선과 함께 Reversa 블록을 덧붙입니다. 건너뛰기를 고르면 파일을 그대로 둡니다. 이미 CLAUDE.md 를 쓰고 있는 프로젝트라면 설치 중에 이 질문을 만나게 됩니다.
분석 중 에이전트가 쓸 수 있는 범위는 설치 시점에 각 진입 파일로 주입되는 규칙 블록이 정합니다. 기본값 기준으로 .reversa/, 명세 출력 폴더(_reversa_sdd/), _reversa_docs/, _reversa_forward/ 네 곳이고, 버그 팀과 코드 품질 팀은 여기에 각각 _reversa_bugs/ 와 _reversa_refactor/ 를 더 씁니다. 다만 범위가 자기 폴더 안이라는 보장은 추출 파이프라인에 대한 것입니다. 레거시 코드 자체를 고치는 것은 그 뒤의 forward 주기와 버그 수정, 리팩토링 주기이며, 그쪽은 승인된 되돌릴 수 있는 diff 게이트를 통과해야 코드에 손을 댑니다.
업데이트와 삭제 경로에도 같은 원칙이 적용됩니다. 설치 시점에 .reversa/_config/files-manifest.json 에 설치 파일들의 SHA-256 해시를 기록해 두고, 이후 각 파일을 그대로인 것, 수정된 것, 없어진 것으로 분류합니다. npx reversa update 는 그대로이거나 없어진 파일만 갱신하고 사용자가 고친 파일은 보존하며, npx reversa uninstall 은 같은 원리로 Reversa가 만든 파일만 지웁니다. API 키를 다루는 방식도 분명합니다. Reversa는 어떤 LLM 서비스의 API 키도 요청하거나 저장하거나 전송하지 않습니다. 지능은 환경에 이미 설치된 AI 에이전트에 위임하므로 외부 인증 의존성이 없습니다.
다만 저장소 자신이 이 보장의 한계를 함께 적어 두었습니다. Reversa가 프로젝트 파일을 덮어쓰지 않더라도 AI 에이전트는 실수할 수 있으므로, 분석을 시작하기 전에 프로젝트를 Git으로 커밋해 두고, 원격 저장소에 사본을 두고, 폴더를 로컬로 한 번 복사해 두라고 강하게 권고합니다. 문제가 생기면 git restore . 로 되돌리라는 안내까지 함께 적혀 있습니다.
Reversa 설치와 사용
Node.js 18 이상(package.json 의 요구 사항은 18.20.2 이상)이 필요하고, 레거시 프로젝트의 최상위 디렉토리에서 설치합니다:
npx reversa install
설치 프로그램은 여덟 가지를 차례로 묻습니다. 지원할 AI 엔진(환경에서 감지된 엔진이 미리 체크되어 있습니다), 프로젝트 이름, 에이전트가 사용자를 부를 호칭, 대화 언어, 생성 문서의 언어, 명세 출력 폴더, 산출물을 Git에 커밋할지 .gitignore 에 넣을지, 그리고 에이전트의 질문에 대화로 답할지 questions.md 파일로 답할지입니다. 에이전트 자체는 선택 항목이 아니라 전부 설치됩니다. 답을 받으면 에이전트를 .agents/skills/ 에 복사하고 엔진별 진입 파일과 .reversa/ 구조, SHA-256 목록을 만듭니다.
한국어 사용자가 놓치기 쉬운 자리가 언어 항목입니다. 대화 언어의 기본값이 pt-br, 생성 문서 언어의 기본값이 Português 로 잡혀 있어 그냥 넘기면 산출물이 포르투갈어로 나옵니다. 생성 문서 언어는 본문만 정하는 것이 아니라 Writer가 만드는 단위 폴더의 이름까지 정하므로(English 면 orders/, Português 면 pedidos/), 이 항목은 처음에 정확히 답해 두는 편이 낫습니다.
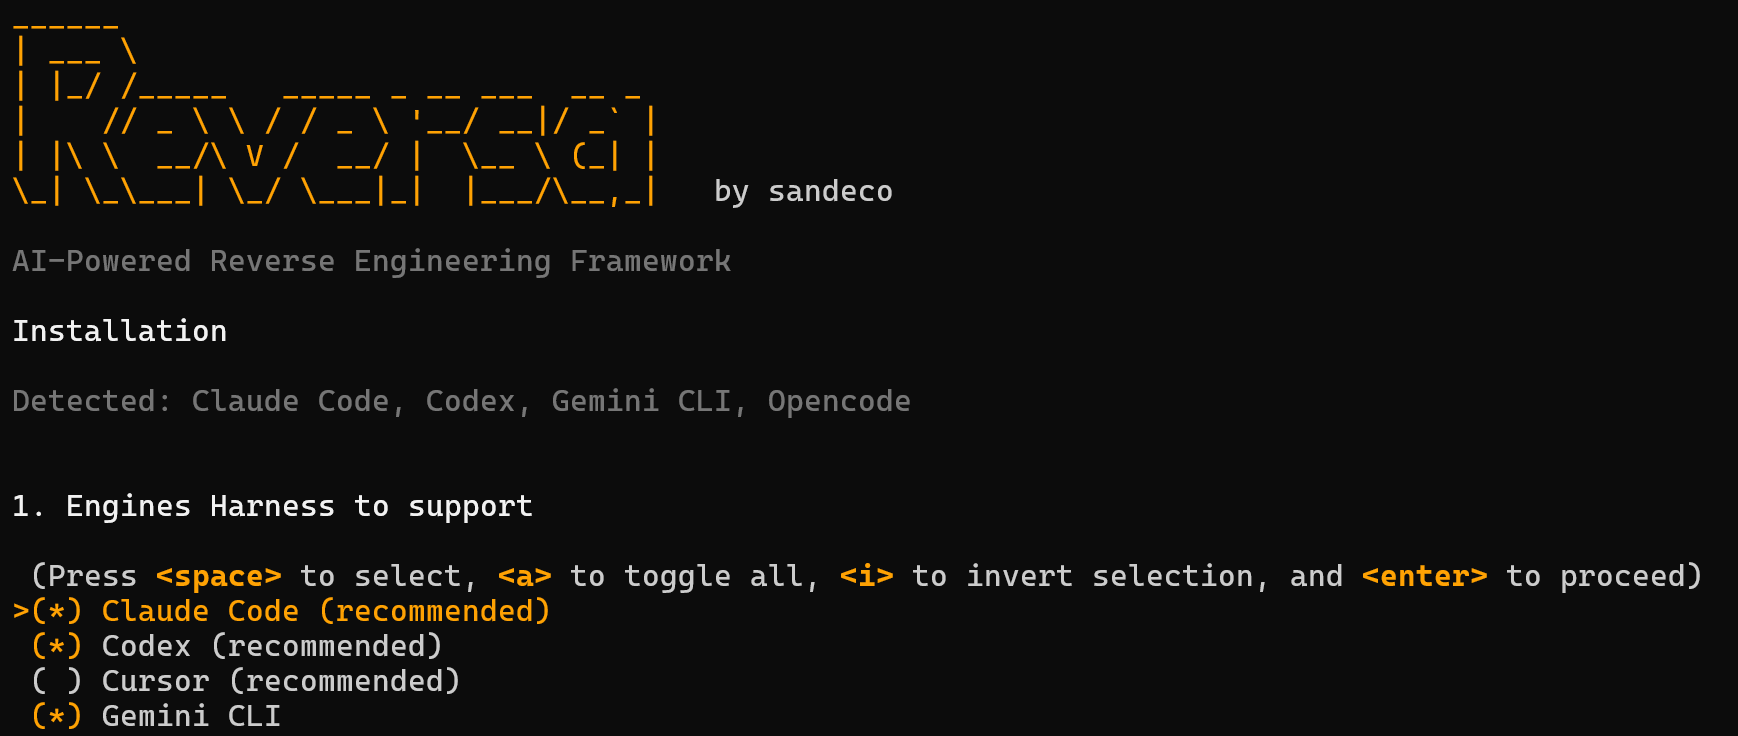
지원하는 엔진은 13종이며, 엔진마다 만들어지는 진입 파일과 활성화 방법이 다릅니다. Claude Code, Codex, Cursor 는 저장소가 별표로 표시해 둔 주 지원 대상이고, 그 밖에 Gemini CLI, Windsurf, Antigravity, Kiro, Opencode, Cline, Roo Code, GitHub Copilot, Aider, Amazon Q Developer 가 목록에 있습니다. 설치 후에는 프로젝트를 에이전트에서 열고 슬래시 명령을 지원하는 엔진이면 /reversa, Codex처럼 지원하지 않는 엔진이면 reversa 를 입력해 시작합니다.
그 밖의 명령줄 진입점은 다음과 같습니다:
npx reversa status            # 현재 분석 상태 확인
npx reversa update            # 최신 버전으로 갱신
npx reversa add-engine        # 새 엔진 지원 추가
npx reversa export-diagrams   # 산출물의 Mermaid 다이어그램을 이미지로 변환
npx reversa uninstall         # 프로젝트에서 Reversa 제거
추출 결과에는 C4 다이어그램과 ERD, 순서도, 상태 기계가 모두 Mermaid로 들어 있으므로 export-diagrams 가 쓸모 있습니다. export-diagrams 는 --format=svg 또는 --format=png 를 받아 출력 폴더의 Mermaid 블록을 이미지 파일로 변환하며, 변환에는 @mermaid-js/mermaid-cli 가 따로 설치되어 있어야 하고 없으면 설치 명령을 알려 주고 멈춥니다. uninstall 은 사용자가 고친 파일을 남기고, remove 를 그대로 입력해야 진행되며, 명세 출력 폴더까지 지울지는 한 번 더 따로 물어봅니다.
논문이 제안한 평가 프로토콜
논문에서 아키텍처 다음으로 비중을 둔 것은 이런 명세를 어떻게 평가할 것인가입니다. 프로토콜은 다섯 단계로 정의됩니다. 먼저 프로젝트의 초기 상태(언어, 의존성, 기존 문서, 테스트 유무, 분석 대상 버전)를 기록하고, npx reversa install 로 엔진과 팀, 출력 설정을 골라 설치하고, Discovery 팀을 실행해 주요 산출물을 만들고, 확신도와 빈틈을 검토하며 확신 보고서와 질문, 빈틈 문서와 추적성 행렬을 수집하고, 마지막으로 사람의 검사와 가능하면 코딩 에이전트가 수행하는 후속 과제로 산출물을 평가합니다.
평가 지표로는 일곱 가지를 제안하는데, 주목할 부분은 각 지표의 해석상 한계와 이번 연구에서의 측정 여부를 함께 적어 두었다는 점입니다:
| 지표 | 무엇을 재는가 | 해석상 주의 | ATM 사례에서 |
|---|---|---|---|
| 파일 커버리지 | 명세와 연결된 관련 파일의 비율 | 추출 범위를 재지만 감사 없이는 품질을 보장하지 않음 | 인벤토리로 관찰 |
| 단위 커버리지 | 자체 명세를 가진 모듈, 엔드포인트, 화면, 엔티티의 비율 | 시스템 조직과 선택한 단위의 정합성을 나타냄 | 모듈별로 관찰 |
| 추적성 밀도 | 요구사항, 규칙, 작업당 평균 증거 참조 수 | 증거가 적절할 때에 한해 감사 가능성을 시사 | 정성적으로 관찰 |
| 확신도 분포 | 확정, 추론, 빈틈 주장의 비율 | 내부 분류를 드러낼 뿐 감사 없이 사실 정확도를 재지 않음 | 측정함 |
| 차단 빈틈 | 안전한 재구현이나 마이그레이션을 막는 빈틈 수 | 후속 작업 전에 사람이 검증할 우선순위를 정하는 데 유용 | 측정함 |
| 전문가 정밀도 | 독립 검토자가 수용한 주장의 비율 | 명세의 실질적 품질을 재는 지표 | 측정하지 않음 |
| 에이전트 유용성 | Reversa 명세가 있을 때와 없을 때 에이전트 성능 차이 | AI 보조 유지보수와 마이그레이션 지원 정도를 평가 | 통제된 방식으로 측정하지 않음 |
여기에 더해 운영 비용도 함께 기록해야 한다고 적어 두었습니다. 실행 시간, 사람과의 상호작용 횟수, 생성된 질문 수, 산출물 크기, 추적성 유지 노력, 검토 노력이 그 대상이며, 유용하지만 유지 비용이 너무 큰 명세는 실제 팀에서 성립하지 않을 수 있다는 것이 이유입니다. 평가를 감사 가능하게 만들려면 사례마다 최소한의 산출물 묶음을 남겨야 한다는 요구도 있습니다. 프로젝트 식별자와 분석한 버전, Reversa 설정, 사용한 엔진과 팀, 출력 폴더의 주요 산출물, 확신도와 빈틈 보고서, 관련 지시문, 있다면 동등성 시나리오, 후속 과제 계획이 그 목록이고, 사람이 개입한 경우에는 내린 결정과 답한 질문, 범위에서 제외한 빈틈까지 함께 기록하라고 적었습니다. 비교 기준선으로는 역할 분해 없는 단일 저장소 문서화 프롬프트, 사전 명세 없이 동작하는 범용 코딩 에이전트, 기존 문서화나 정적 분석 도구 세 가지를 제안하며, Reversa를 텍스트 분량이 아니라 유용성과 추적성, 명시적 불확실성, 후속 행동을 이끄는 능력으로 비교해야 한다고 덧붙입니다.
COBOL ATM을 Go로: 탐색적 사례 연구
논문은 아키텍처 서술과 함께 탐색적 사례 연구 하나를 보고합니다. banco-atm 이라는 이름의 GnuCOBOL 현금자동입출금기 시스템을 Go 재구현으로 옮기는 작업이며, 교육용 프로젝트라 이해관계자가 한 명이고 운영 환경에서 쓰이지 않았습니다. 논문이 정리한 레거시의 특성은 다음과 같습니다:
| 항목 | 관찰된 값 |
|---|---|
| 도메인 | 기본 입출금 계좌 업무를 처리하는 단일 사용자, 단일 프로세스 ATM |
| 언어 | COBOL, 버퍼 없는 키보드 입력을 위한 C 헬퍼 포함 |
| 대상 모듈 | MENU, CONTA, EXTRATO, UTIL, kbdread |
| 영속성 | 색인 및 순차 .DAT 파일 |
| 기존 테스트 | 자동화 테스트 없음 |
| 목표 시스템 | SQLite와 Gherkin 동등성 테스트를 갖춘 Go 재구현 |
동등성 범위에서 두 구성 요소는 제외했습니다. ADD-CLIENTE 는 ATM 도메인 밖의 기술적 작업이라서, x25-communication 은 명세만 있고 대응하는 구현이 없어서 빠졌습니다. 두 번째 사유는 앞의 빈틈 판정 기준 중 "기능이 참조되지만 보이는 코드에 구현되어 있지 않음" 에 해당하는 경우입니다.
파이프라인은 2026년 5월 4일부터 7일까지 실행되었습니다. Discovery 단계에서 인벤토리와 코드 분석, 아키텍처, 도메인 모델, 상태 기계, 의존성, 질문, 빈틈, 확신 보고서가 나왔고, 마이그레이션 단계에서 브리핑과 패러다임 및 토폴로지 결정, 목표 업무 규칙, 마이그레이션 전략, 위험 대장, 전환 계획, 목표 아키텍처, 도메인 모델, 데이터 모델, 데이터 이관 계획, 동등성 명세, Gherkin 테스트, 코딩 인계 문서가 나왔습니다. 저자들이 가장 중요한 중간 결과로 꼽은 것은 테스트가 하나도 없던 시스템에서 53건의 Gherkin 동등성 시나리오가 나왔다는 점이며, 시나리오는 로그인, 잔액 조회, 출금, 입금, 이체, 거래 내역, 금액 서식, 키보드 마스킹에 걸쳐 분포합니다.
확신 보고서가 보고한 수치
활성 범위에서 분류된 주장은 517건이고, 확정 490건, 추론 24건, 빈틈 3건입니다. 앞서 본 계산식을 적용하면 (490 + 24 \times 0.5) / 517 \approx 97.1\% 가 됩니다. 명세별 분포는 다음과 같습니다:
| 명세 | 확정 |
추론 |
빈틈 |
내부 확신 지표 |
|---|---|---|---|---|
menu |
32 | 1 | 0 | 98.5\% |
conta |
129 | 6 | 0 | 97.8\% |
extrato |
124 | 9 | 1 | 95.9\% |
util |
115 | 4 | 2 | 96.7\% |
kbdread |
90 | 4 | 0 | 97.9\% |
| 활성 범위 합계 | 490 | 24 | 3 | 97.1\% |
모듈별로 보면 거래 내역을 담당하는 extrato 와 유틸리티인 util 이 나머지 세 모듈보다 지표가 낮고, 빈틈 3건도 이 두 모듈에만 등록되었습니다. 다만 논문은 이 값 전체를 파이프라인 자신의 분류에서 계산한 것으로 한정하고, 외부 감사가 없었으므로 사실 정확도로 읽어서는 안 된다고 다시 밝혔습니다.
빈틈은 어떻게 처리되었나
주장 수준의 빈틈과 별개로, 프로젝트 수준의 빈틈 10건이 심각도와 함께 등록되었고 처리 결과가 함께 기록되었습니다:
| 빈틈 등급 | 건수 | 이번 연구에서의 처리 |
|---|---|---|
| 치명적 | 3 | 문서화된 사람의 결정으로 해소 |
| 보통 | 3 | 두 건 해소, 한 건은 잔여로 유지 |
| 경미 | 2 | 낮은 심각도의 잔여로 유지 |
| 범위 밖 | 2 | 동등성 범위에서 제외 |
| 합계 | 10 | 5건 해소, 3건 잔여, 2건 범위 제외 |
저자들이 이 표에서 강조하는 것은 문서의 양이 늘었다는 사실이 아니라, 운영상의 불확실성이 눈에 보이고 우선순위를 매길 수 있으며 추적 가능한 항목으로 바뀌었다는 점입니다.
재구성은 어디까지 갔나
마이그레이션 계획은 11개 작업으로 구성되었고, 인벤토리 시점 기준으로 9개가 완료되었습니다. 작업 묶음별 상태는 다음과 같습니다:
| 작업 묶음 | 상태 | 산출된 증거 |
|---|---|---|
| 부트스트랩, 유틸리티, 키보드, 저장소, 거래 내역, 계좌, 로거, 메뉴, CLI 진입점 | 9건 완료 | Go 패키지, SQLite, 진입점, 도메인 모듈 |
| Docker 기반 동등성 검증과 교차 실행 | 진행 중 | 53건의 Gherkin 시나리오와 Parallel Run 전략 |
| 전환(cutover), 최종 검증, Go 릴리스 | 대기 | 전환 계획과 기술 인계 문서 |
논문은 이 부분 실행이 최종 마이그레이션 성공에 대한 강한 결론을 막는다고 인정하면서도, 생성된 산출물이 패키지 구성과 SQLite 영속성, 진입점, 동등성 테스트, 기술 인계로 이어지는 Go 구현 순서를 실제로 구조화했다고 적었습니다.
저자들이 이 사례에서 끌어낸 예비 관찰은 세 가지입니다. 첫째, 테스트가 없는 레거시 시스템을 도메인과 아키텍처, 빈틈, 확신도, 동등성이라는 검증 가능한 산출물로 분해할 수 있었습니다. 둘째, 확신 표기가 확인된 동작과 추론, 그리고 증거의 부재를 서로 갈라 놓는 데 도움이 되었습니다. 셋째, 마이그레이션 단계가 역방향 문서를 다시 사용해 계획과 아키텍처 결정, 실행 가능한 시나리오를 만들어 냈습니다.
이 연구가 주장하지 않는 것
논문은 타당성 위협을 네 갈래로 나눠 스스로 정리해 두었고, 이 부분이 결과 수치를 읽는 전제가 됩니다.
내부 타당성 측면에서, ATM 연구는 단일 에이전트나 기존 문서화 도구, 사전 명세 없는 실행과의 통제된 비교 없이 수행되었습니다. 따라서 관찰된 진전 중 어디까지가 Reversa 덕분이고 어디까지가 이해관계자의 지식, 도메인의 단순함, 마이그레이션 중 사람이 내린 결정 덕분인지 분리할 수 없습니다. 내부 확신 지표 역시 독립 감사가 아니라 파이프라인 자신의 분류에서 계산되었습니다.
구성 타당성 측면에서, 확신도 분포와 빈틈, 완료 작업 수 같은 지표는 산출물의 운영적 속성을 포착하지만 사실 정확도나 에이전트에 대한 유용성, 최종 마이그레이션 성공을 직접 재지 않습니다. 앞의 지표 표에서 전문가 정밀도와 에이전트 유용성이 "측정하지 않음" 으로 남은 것이 그 자리입니다.
외부 타당성 측면에서, 분석 대상은 단순화된 은행 도메인의 교육용 시스템이고 이해관계자가 한 명이며 운영 사용도 기존 테스트도 없고 COBOL 모듈 범위도 축소되어 있습니다. 저자들은 이 결과를 산업용 레거시나 규제 도메인, 큰 팀, 운영 환경에 의존하는 동작을 가진 코드베이스, 복잡한 외부 연동이 있는 프로젝트로 자동 일반화해서는 안 된다고 적었습니다.
결론 타당성 측면에서, Go 재구성은 인벤토리 시점에 부분적이었습니다(11개 중 9개 완료, Docker 동등성 진행 중, 전환 대기). 따라서 이 연구는 타당성과 절차 구조화에 대한 탐색적 증거만 뒷받침하며, 최종 동등성이나 비용 절감, 에이전트 성능 향상, 대안 대비 우월성에 대한 결정적 증거는 되지 않습니다.
프레임워크 자체의 적용 범위에 대한 단서도 있습니다. 논문은 산출물의 품질이 에이전트와 프롬프트, 선택한 엔진, 분석 대상 프로젝트, 증거의 가용성에 달려 있다고 적고, 코드가 매우 동적이거나 규칙이 데이터베이스 안에 숨어 있거나 동작이 운영 환경에 의존하는 프로젝트에는 추가 도구가 필요할 수 있다고 덧붙입니다. Reversa가 그 어려움을 없애 주는 것이 아니라, 눈에 보이고 추적 가능하며 다룰 수 있는 형태로 바꿔 놓을 뿐이라는 것입니다.
논문 본문의 표현으로는 폭넓은 실증적 우위를 주장하지 않는다는 것이며, 사례 연구 한 건으로 레거시 마이그레이션이 해결됐다고 읽을 근거는 논문 안에 없습니다. 향후 과제로는 도메인과 언어, 기존 문서화 정도가 다른 레거시 프로젝트로 사례를 확장하고, 전문가가 산출물을 독립 검토하고, 단일 에이전트 및 기존 문서화 도구와 통제 비교를 하고, 후속 과제에서 유용성을 측정하고, 새 변경이 쌓일 때 명세를 유지하는 비용을 분석하는 것을 제시합니다.
Reversa는 누구에게 유용한가
명세가 없는 시스템을 유지보수하면서 코딩 에이전트를 붙여 보려는 팀에게 Reversa는 시도해 볼 값어치가 있습니다. 추출 파이프라인의 쓰기 범위가 자기 폴더 안으로 제한되어 있고 기존 파일을 덮어쓰지 않으므로 도입 위험이 낮고, 결과물의 문장마다 확신 등급이 붙어 있어 어디까지 믿고 쓸지를 팀이 직접 판단할 수 있습니다. API 키를 따로 준비할 필요 없이 이미 쓰는 코딩 에이전트를 그대로 쓰는 구조라는 점도 도입 문턱을 낮춥니다. 코드베이스 문서화라는 목적이 겹치는 OpenWiki 나 레거시 현대화를 다루는 Legacy2Modern 을 이미 검토했다면, Reversa 쪽의 차이는 산출물이 읽을 문서가 아니라 추적성과 확신 등급을 갖춘 명세라는 점에 있습니다.
반대로 결과물의 정확성을 그대로 신뢰하고 다음 단계로 넘기려는 팀에게 Reversa는 아직 그 단계가 아닙니다. 논문 자체가 최종 동등성 검증을 완료하지 않았고 실증적 우위를 주장하지 않는다고 밝혔으므로, INFERRED 와 GAP 표시가 붙은 항목을 사람이 검증하는 작업량을 일정에 미리 넣어야 합니다. 산출물의 분량도 감안할 필요가 있습니다. 모듈 다섯 개짜리 교육용 ATM 한 건에서 주장 517건이 나왔으므로, 그것을 검토할 사람이 없으면 읽히지 않는 문서가 늘어나는 결과가 됩니다. 에이전트 실행 비용은 사용 중인 코딩 에이전트의 요금제에서 그대로 발생하며, 파이프라인이 모듈마다 그리고 명세 파일마다 세션을 나눠 진행하도록 설계된 것도 그 비용과 문맥 한계를 전제한 결과입니다.
Reversa의 라이선스
Reversa는 MIT 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다.
 Reversa 문서 사이트
 Reversa 논문
 Reversa 프로젝트 GitHub 저장소
더 읽어보기
-
GitHub, 스펙 기반 개발(Spec-Driven Development)를 위한 실험적 프레임워크 Spec Kit 공개
-
[Deep Research] GitHub의 Spec Kit으로 알아보는 Spec-Driven Development(SDD)의 개념 및 활용 (feat. Vibe Coding)
-
lat.md(Agent Lattice): AI 코딩 에이전트와 사람을 위한 마크다운 기반 코드베이스 지식 그래프
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 도구를 직접 설치해 사용해보셨다면,  파이토치 한국 사용자 모임
 회원들을 위해 경험이나 팁을 댓글로 남겨주세요!
