핵심 요약
- Microsoft Research의 StudentSim 소개 블로그와 StudentSim 논문은 학생 한 명의 기록으로 그 학생을 흉내 내는 시뮬레이터를 학습시킵니다. 평가는 학생과 닮은 정도(F)와 튜터 지도에 반응하는 정도(R)로 합니다.
- 체스 30명 평가에서 StudentSim은 F 0.51, R 0.91로 GPT-5.4(0.23, 0.72)와 Maia2(0.45, 0.27)를 앞섰습니다. 다만 영작문과 수학에서 GPT-5.4와의 F 차이는 0.05와 0.03입니다.
- 튜터 강화학습 실험의 보상에는 학생별 시뮬레이터가 아니라 100명의 기록으로 학습한 공용 시뮬레이터를 썼고, 문체와 보드 오류를 판별하는 헤드 2개를 곱했습니다. 이 튜터는 전문가 8명이 매긴 74건의 평가에서 정확도 90.5%를 받았습니다.
- StudentSim GitHub 저장소는 MIT 라이선스의 코드만 담고 있습니다. 2026년 10월 13일 기준으로 체스 데이터는 아직 올라오지 않았고, 영작문과 수학 데이터는 각 제공처와 이용 계약을 맺어야 받을 수 있으며, 학습된 가중치는 배포하지 않습니다.
StudentSim 소개
StudentSim 은 AI 튜터가 실제 학생을 만나기 전에, 개별 학생을 흉내 내는 시뮬레이터로 튜터의 지도가 효과가 있는지 먼저 확인하려는 연구입니다. 튜터의 답이 그럴듯한지만 보아서는 가르치는 일의 품질을 알 수 없습니다. 지도를 받은 학생이 실수를 고쳤는지, 힌트가 정답을 너무 많이 알려 주지는 않았는지, 다른 학생에게는 다른 방식이 필요했는지는 학생의 반응을 보아야 압니다. 그런데 실제 학생을 모아 실험하는 일은 느리고 비싸서, 모델을 빠르게 고쳐 가는 개발 과정에 학생의 피드백을 넣기 어렵습니다.
학생 시뮬레이터를 만드는 방법은 지금까지 크게 두 갈래였습니다. 하나는 대형 언어 모델에게 "수학을 어려워하는 초등학생처럼 답하라"고 시키는 역할극 방식입니다. 이 방식은 말투와 망설임은 흉내 내지만, 그 학생이 실제로 할 수 있는 수준을 넘어서는 지식으로 답하기 쉽습니다. 시뮬레이터 학생이 실제보다 똑똑하면 튜터는 실제보다 잘 가르치는 것처럼 보입니다.
다른 하나는 지식 추적(Knowledge Tracing) 과 행동 예측 모델입니다. 지식 추적은 학생의 과거 풀이 기록으로 지금의 지식 상태를 추정하는 모델입니다. 실제 학습 기록에 근거하지만, 튜터가 자연어로 건네는 설명이나 질문을 입력으로 받는 경로가 없습니다.
StudentSim은 두 요구를 함께 만족하는 시뮬레이터를 학생마다 하나씩 학습시킵니다. 기반 모델은 Qwen3-4B-Instruct-2507이고, 여러 학생의 기록을 합쳐 먼저 학습한 뒤 한 학생의 기록으로 다시 학습합니다. 저자들은 평가 절차인 StudentSimEval 도 함께 제안했습니다. 체스, 제2언어 영작문(L2), 수학의 공개 학습 기록에서 학생 60명을 고정하고, 모든 방법을 같은 학생별 학습 기록으로 맞춘 뒤 같은 평가 기록으로 채점합니다.
논문은 Microsoft Research와 University of Illinois Urbana-Champaign(UIUC) 연구진 7명이 썼습니다. 제1저자 Ke Yang은 UIUC 박사과정생이며, 논문 각주에 따르면 Microsoft Research 인턴십 기간에 수행한 연구입니다. 논문은 2026년 9월 1일 arXiv에 올라왔고, 소개 블로그는 2026년 10월 12일에 나왔습니다. Microsoft는 블로그에서 StudentSim이 제품이 아니고, 교실에 배포하지 않았으며, 교사를 대신하려는 것이 아니라고 밝혔습니다.
무엇을 재는가: 행동 충실도(F)와 지도 반응도(R)
저자들은 교육학의 근접 발달 영역(Zone of Proximal Development) 에서 두 지표를 가져왔습니다. 근접 발달 영역은 학습자가 혼자 할 수 있는 것과 도움을 받아 할 수 있는 것 사이의 차이를 가리키는 Vygotsky의 개념입니다. 여기서 나온 첫 지표는 행동 충실도(Behavioral Fidelity, F) 로, 평가용으로 떼어 둔 문제에서 시뮬레이터의 답이 그 학생이 실제로 낸 답과 얼마나 맞는지를 봅니다. 두 번째 지표는 지도 반응도(Guidance Responsiveness, R) 로, 학생이 틀린 문제에서 튜터의 지도를 읽은 뒤 시뮬레이터가 답을 고치는지를 봅니다.
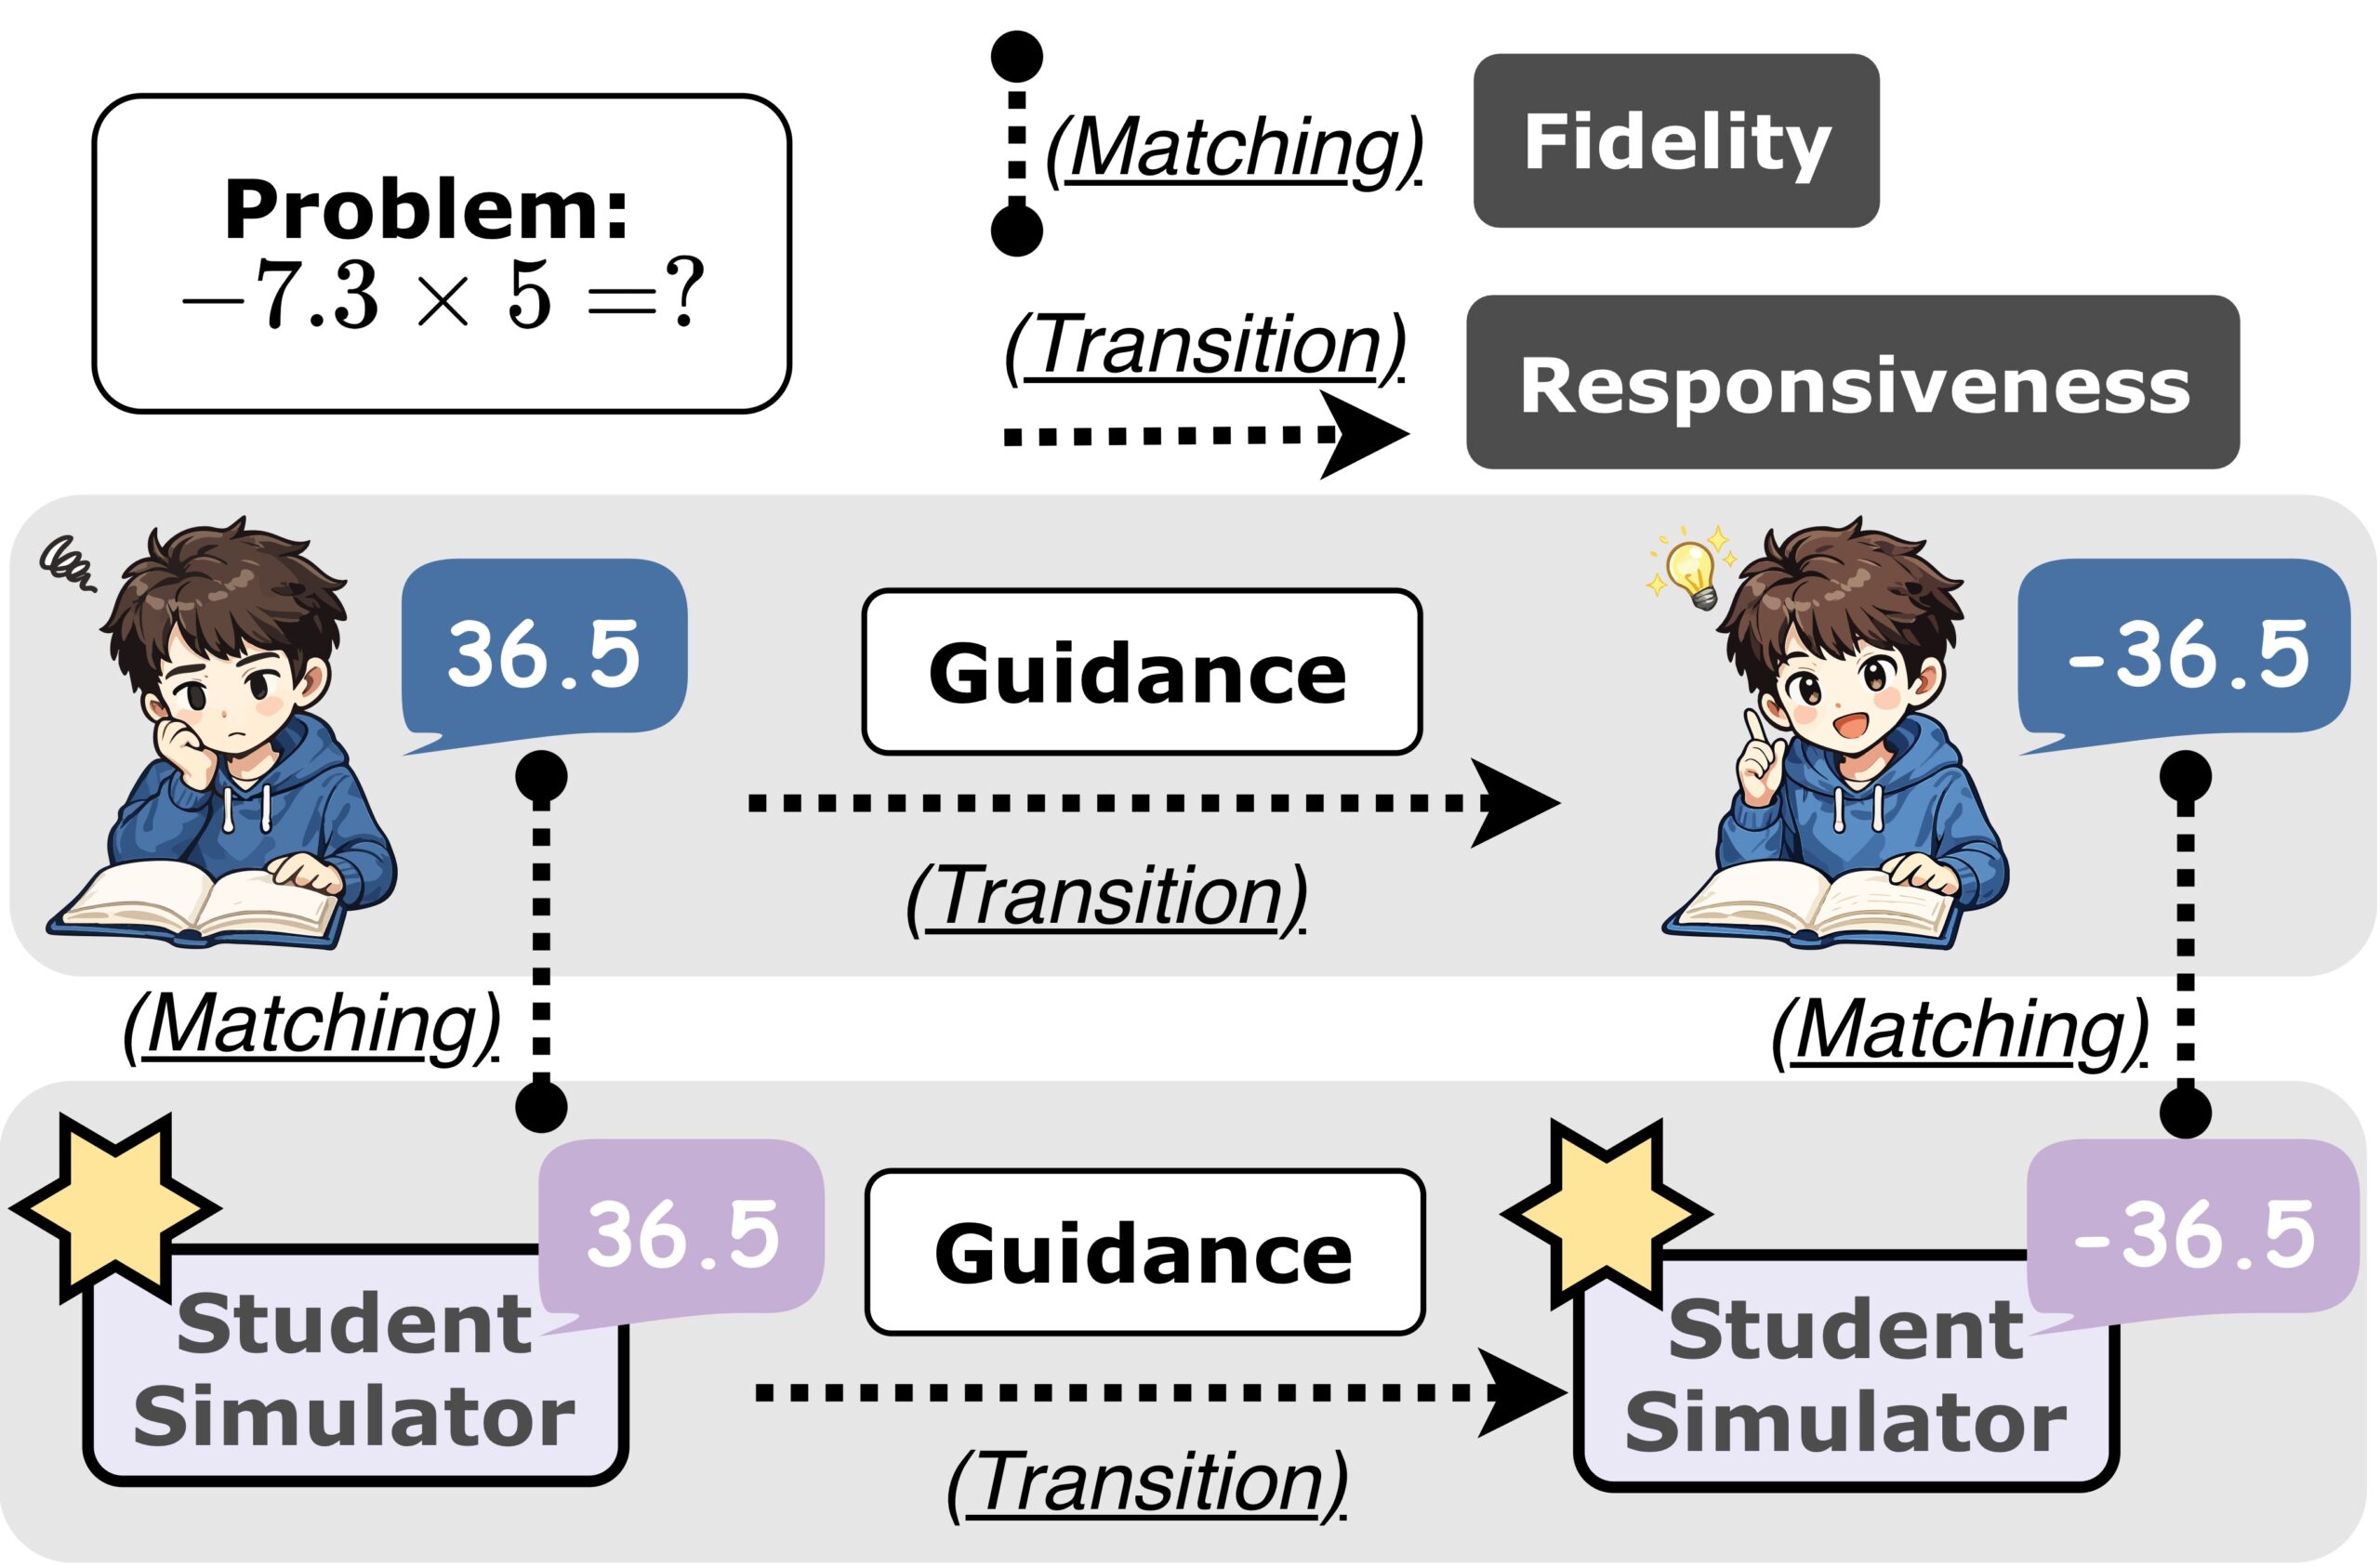
두 지표의 구체적인 계산은 영역마다 다릅니다. 영역별 응답 형태가 다르기 때문입니다.
| 영역 | 데이터 | 평가 학생 | F: 학생과 닮은 정도 | R: 지도 후 정답으로 옮기는 정도 |
|---|---|---|---|---|
| 체스 | Lichess 2025년 5월 대국 | 30명 | 학생이 실제로 둔 수를 1순위로 맞힌 비율 (학생당 5,000개 국면) | 지도를 읽은 뒤 Stockfish 최선수를 두는 비율 (학생당 4,000건) |
| L2 영작문 | EFCAMDAT 오류 주석 하위 말뭉치 | 15명 | 생성한 에세이의 오류 밀도와 7개 오류 유형 분포가 학생 에세이와 얼마나 비슷한지 (학생당 26편) | 교사가 표시한 오류 구간을 교사의 수정안과 똑같이 고친 비율 (학생당 40건) |
| 수학 | FoundationalASSIST | 15명 | 4지선다로 바꾼 문제에서 학생이 실제로 고른 보기를 맞힌 비율 (학생당 66문제) | 지도를 읽은 뒤 정답 보기를 고른 비율 (학생당 21~99건) |
L2의 오류 유형은 오픈소스 문법 검사기 LanguageTool이 내는 분류를 그대로 씁니다. 수학의 4지선다 보기는 그 학생이 실제로 쓴 답 하나와, 같은 문제에서 다른 학생들이 가장 자주 쓴 답 세 개로 만듭니다. 평가 기록은 각 학생의 기록을 시간순으로 나눈 뒤 뒤쪽 기록을 떼어 둔 것이어서, 모든 점수는 과거 기록으로 그 학생의 이후 행동을 예측한 결과입니다.
R이 재는 것은 "그 학생의 실제 반응"이 아닙니다
R을 읽을 때 알아 둘 조건이 하나 있습니다. R의 정답은 학생이 지도를 받고 실제로 고친 답이 아니라, 지도가 이끄는 정답(체스의 엔진 최선수, 수학의 정답, L2의 교사 수정안)입니다. 체스와 수학 데이터에는 애초에 튜터의 지도가 없습니다. Lichess 기록에는 대국 수순만 있고, FoundationalASSIST에는 문제와 학생 답, 정오 표시만 있습니다. 그래서 체스의 지도문은 GPT-4o 또는 GPT-5.1이, 수학의 지도문은 GPT-5.4가 생성했습니다. 실제 교사가 쓴 수정안을 정답으로 쓰는 영역은 L2뿐입니다.
저자들은 부록 F.1에서 이 선택을 설명합니다. 동적 평가(Dynamic Assessment)는 도움을 받은 뒤의 성과를 기준 답에 견주어 채점하므로, R도 기준 답을 쓴다는 것입니다. 학생별 실제 반응을 정답으로 쓰면 R이 F와 얽히고, 그런 기록을 개입마다 모으는 비용도 크다는 이유도 듭니다. 저자들은 앞으로 학생별 실제 반응 데이터가 생기면 그것으로 바꿀 수 있다고 적었습니다.
이 조건에서는 지도를 받으면 언제나 정답으로 옮겨 가는 시뮬레이터가 R 만점을 받습니다. 블로그가 역할극 LLM의 문제로 지적한 "너무 유능한(too capable)" 시뮬레이터 학생은 F 축에서는 감점되지만, R 축에서는 오히려 유리합니다. 따라서 R 0.91은 학생이 지도를 받았을 때 실제로 보일 반응을 맞힌 비율이 아니라, 지도를 읽고 지도가 가리키는 답에 도달한 비율입니다.
학습 방법: 여러 학생의 공용 학습 후 학생별 학습
학생 한 명이 남기는 기록은 많지 않습니다. 논문에 따르면 EFCAMDAT 오류 주석 하위 말뭉치는 학습자 116,312명의 에세이 620,206편으로, 학습자당 중앙값이 3편이고 71.4%가 5편 이하입니다. 이렇게 적은 기록으로 학생마다 모델을 처음부터 학습시키면 과적합이 일어나고, 영역 전체에 공통된 패턴도 학생마다 다시 배워야 합니다. StudentSim은 이 문제를 두 단계로 나누어 풉니다.
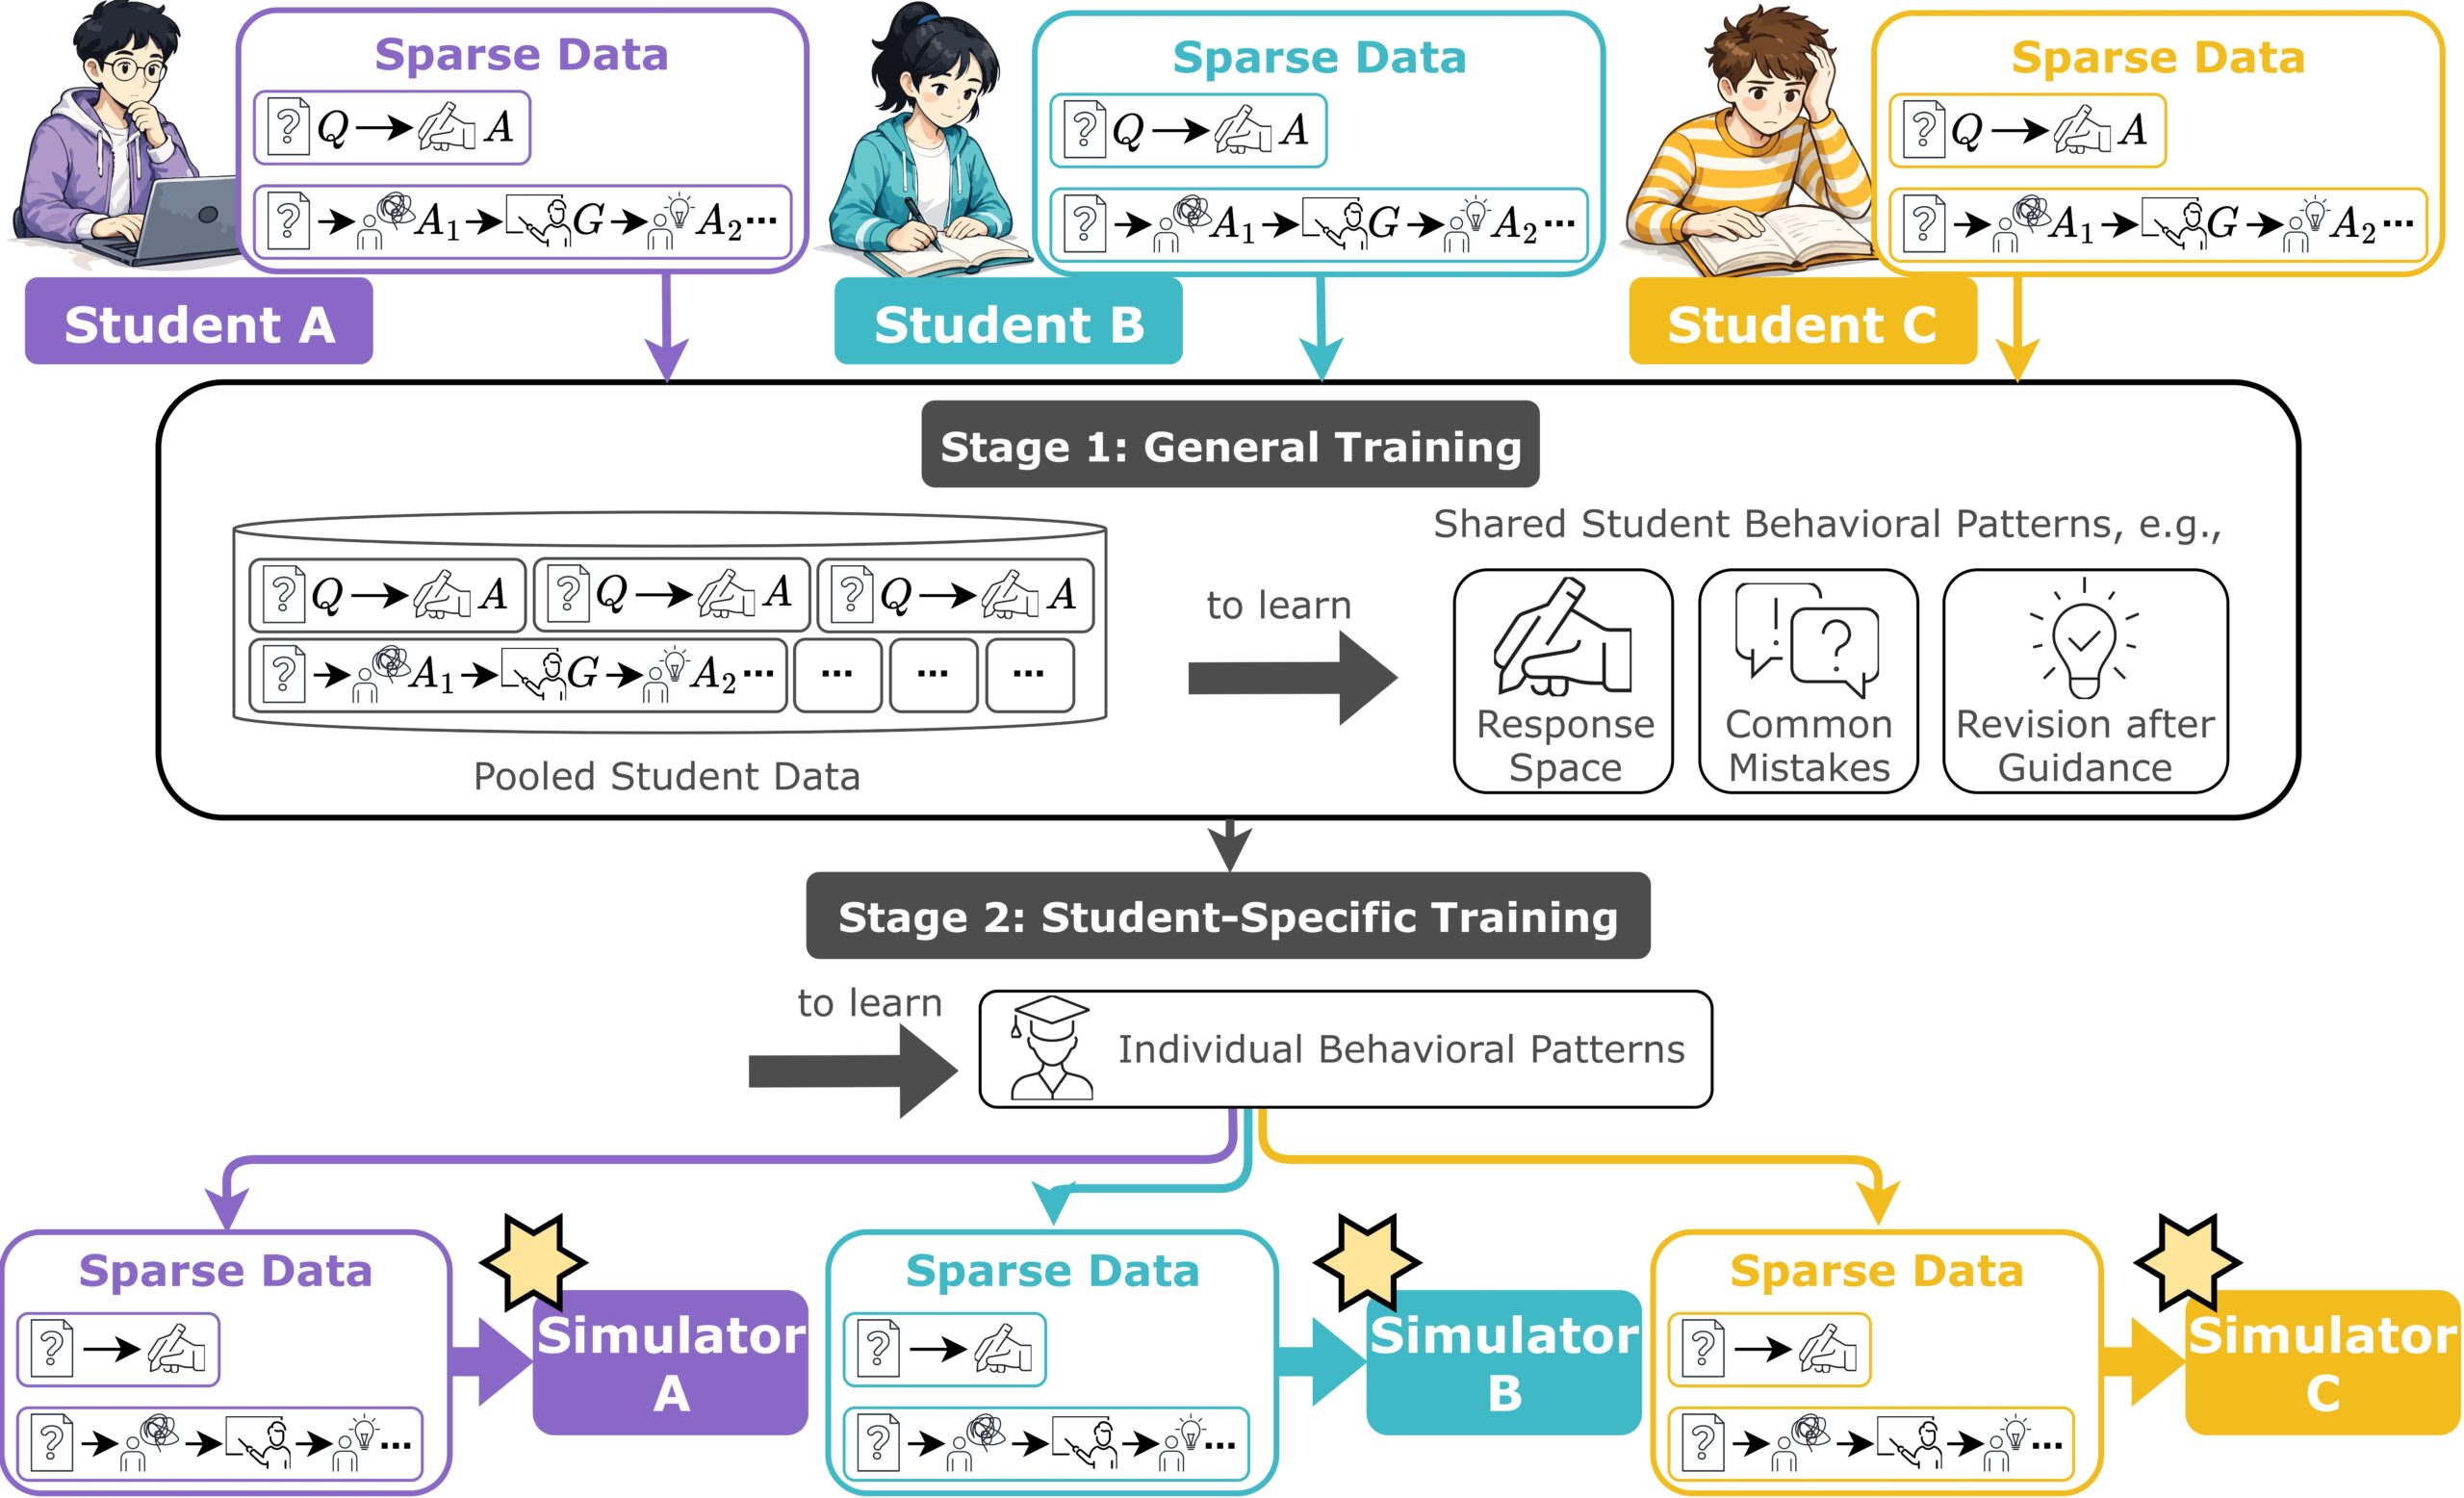
1단계(Stage 1)는 한 영역의 여러 학생 기록을 합쳐 LoRA 어댑터 하나를 학습합니다. LoRA는 기반 모델의 가중치는 그대로 두고 작은 저랭크 행렬만 추가로 학습하는 미세조정 방법입니다. 이 단계에서 모델은 영역의 응답 형식, 흔한 실수, 지도를 받은 뒤 답을 고치는 방식을 배웁니다. 2단계(Stage 2)는 1단계 어댑터를 이어받아 한 학생의 기록으로만 더 학습하고, 그 결과 학생마다 어댑터가 하나씩 생깁니다. 두 단계 모두 혼자 푼 기록(단일 턴)과 지도 후 고친 기록(다중 턴)을 섞어 쓰며, 다중 턴 비율은 0.2입니다.
| 영역 | 1단계 학생 수 / 학습 기록 | 2단계 학생 수 / 학생당 기록 | 2단계 최적화 스텝 |
|---|---|---|---|
| 체스 | 100명 / 100,000건 | 30명 / 1,000건 | 12 |
| L2 | 200명 / 7,800건 | 15명 / 73건 | 약 30 |
| 수학 | 200명 / 23,400건 | 15명 / 153건 | 3 |
LoRA 설정은 랭크 128, α 256이고, 어텐션과 MLP의 모든 선형 투영에 붙입니다. 학습은 ms-swift로 A100 40GB 8장 노드 하나에서 했고, 체스 1단계는 약 75분 걸렸습니다. 저자들의 추정으로는 본문에 보고한 실험 전체에 A100 약 390 GPU 시간이 들었습니다.
평가 학생이 데이터의 평균적인 학생은 아니라는 점도 알아 둘 만합니다. 저자들은 기록이 많은 학습자부터 골랐고, 그래서 L2 2단계 학습자 15명은 1인당 평균 92.4편의 에세이를 썼습니다. 말뭉치 중앙값 3편과는 차이가 큽니다.
1단계가 실제로 기여하는지는 체스에서 확인했습니다(부록 D.1). 저자들은 100명의 기록 100,000건 대신 학생 한 명의 기록 1,000건을 100번 반복해, 같은 스텝 수(391)로 1단계를 학습했습니다. 그러자 무작위로 고른 학생 3명 기준 F가 0.5131에서 0.4602로, R이 0.9003에서 0.8276으로 내려갔습니다. 다중 턴 비율 실험(부록 D.3)에서는 다중 턴 기록을 전혀 넣지 않으면 R이 0.167에 그쳤고, 2.5%만 넣어도 0.826으로 올랐습니다. 같은 실험에서 F는 비율과 상관없이 0.487~0.491에 머물렀습니다.
저자들은 체스에서 학습 방식도 몇 가지 더 비교했습니다(부록 D.2, D.4). 보드를 이미지로 함께 넣는 비전 언어 모델(Qwen3-VL-4B-Instruct)은 학습 비용이 약 2배인데 F는 0.001만 올랐습니다. 그래서 세 영역 모두 텍스트 입력만 씁니다. 학습 데이터에서 소크라테스식 지도의 비중을 4배로 늘리면 그 방식의 R이 0.611에서 0.670으로 올랐고, 전체 R은 거의 그대로였습니다(본문 표와 별도로 돌린 부록 실험 기준). 반대로 4가지 지도 방식 중 하나를 학습 데이터에서 빼는 실험에서는, 4번 중 3번에서 전체 R과 뺀 방식의 R이 함께 올랐습니다. 저자들은 학습 단계에서 지도 방식들이 서로를 일부 대신한다고 해석합니다.
체스 입력에는 학생의 최근 승률, 최선수 비율, 스타일 같은 프로필과 함께 Maia2가 예측한 다음 수 후보 5개와 확률이 들어갑니다. Maia2는 레이팅을 조건으로 사람이 둘 법한 수를 예측하는 체스 모델입니다. 저자들은 GPT-4o와 GPT-5.4 기준선의 프롬프트에서는 이 후보 목록을 뺐습니다. 기준선이 Maia2의 예측에 의존하지 않고 자기 힘으로 학생을 흉내 낸 점수를 보려는 설계라고 설명합니다. 그 결과 체스의 StudentSim은 Maia2의 예측을 입력으로 받고, GPT-5.4는 받지 않은 상태에서 비교됩니다.
결과: 체스에서는 차이가 크고, 영작문과 수학에서는 작습니다
아래 표는 논문 표 2와 표 3의 값을 모두 옮긴 것입니다. 기본 기준선은 체스에서는 Maia2이고, L2와 수학에서는 추가 학습 없이 같은 프롬프트를 넣은 Qwen3-4B-Instruct입니다. StudentSim 값은 학습 시드 3개의 평균입니다.
| 영역 | 지표 | 기본 기준선 | GPT-4o | GPT-5.4 | StudentSim |
|---|---|---|---|---|---|
| 체스 | F | 0.4535 (Maia2) | 0.2163 | 0.2316 | 0.5150 |
| L2 | F | 0.5130 (Qwen3-4B) | 0.4718 | 0.5141 | 0.5624 |
| 수학 | F | 0.4919 (Qwen3-4B) | 0.5121 | 0.6121 | 0.6384 |
| 체스 | R | 0.2721 (Maia2) | 0.7655 | 0.7186 | 0.9067 |
| L2 | R | 0.0200 (Qwen3-4B) | 0.3883 | 0.5950 | 0.6417 |
| 수학 | R | 0.6132 (Qwen3-4B) | 0.6940 | 0.7099 | 0.9181 |
여섯 칸 모두 StudentSim이 가장 높고, 논문은 평균뿐 아니라 대부분의 개별 학생에서도 두 지표가 GPT-5.4보다 높았다고 적었습니다. 다만 차이의 크기는 영역마다 다릅니다. 체스 F에서 GPT-5.4와의 차이는 0.28이지만 Maia2와의 차이는 0.06입니다. L2 F에서는 추가 학습을 하지 않은 Qwen3-4B(0.5130)와 GPT-5.4(0.5141)가 거의 같고, StudentSim은 그보다 0.05 높습니다. 체스 R에서는 GPT-4o(0.77)가 GPT-5.4(0.72)보다 높은데, 블로그와 초록은 LLM 기준선으로 GPT-5.4만 제시합니다.

수학 F는 "항상 정답을 고르는" 기준선과 비교되지 않았습니다
수학 F 수치는 하나를 더 계산해 보아야 합니다. 논문 부록 C.5에 따르면 수학 평가 기록 990건 중 70.6%는 학생이 정답을 적은 기록입니다. 학생마다 평가 기록 수(66건)가 같으므로, 모든 문제에서 정답 보기를 고르는 시뮬레이터는 학생을 전혀 모델링하지 않고도 F 0.706을 받습니다. 이 값은 StudentSim(0.6384)과 GPT-5.4(0.6121)보다 높습니다. 논문은 이 기준선을 보고하지 않습니다. 따라서 수학 F 0.64만으로는 StudentSim이 정답만 고르는 방식보다 학생을 더 잘 흉내 냈다고 말할 수 없습니다. 위 계산은 논문 수치로 편집자가 직접 계산한 것입니다.
이 데이터에서 단순 기준선이 강하다는 점은 데이터셋을 공개한 FoundationalASSIST 논문도 보고했습니다. 프런티어 LLM 4종이 지식 추적 과제에서 단순 기준선에 겨우 도달하는 수준이었다는 것입니다.
지도 방식별 R과 재현할 때의 변동
R은 지도 방식에 따라 크게 달라집니다. 체스의 오류 교정(error remediation) 방식은 실수를 짚고 정답 수를 알려 주며, 이 방식의 R은 0.9959입니다. 정답 수를 말하지 않고 질문으로 이끄는 소크라테스식(Socratic) 방식의 R은 0.7649입니다. 수학도 오류 교정 0.9909, 소크라테스식 0.8783, 개념 설명 0.8851입니다. 저자들은 정답을 알려 주지 않는 방식에서도 StudentSim이 모든 기준선보다 높았다는 점을, 지도문에서 답을 베껴 쓰는 것이 아니라 지도를 따라 추론(reasoning)한다는 근거로 듭니다. 논문의 사례(그림 5)에서는 퀸 체크를 암시만 하고 칸은 말하지 않은 소크라테스식 지도를 읽고, StudentSim은 엔진 최선수 f8b4를, GPT-5.4는 다른 퀸 수 f8f4를 두었습니다.
시드 3개 사이의 표준편차는 체스 F와 R 모두 0.0009로 작고, L2 R은 0.0233으로 가장 큽니다. 부록 C.6에는 재현할 때 알아야 할 메모도 있습니다. bf16 연산의 비결정성 때문에 같은 체크포인트가 수학 평가 기록 315건 표본에서는 한 번은 R 0.565, 다시 실행하면 0.952를 받았습니다. 저자들은 전체 879건에서는 평균이 안정적이라며, 표본이 아니라 전체 평가 세트로 재현하라고 권합니다.
튜터 강화학습 실험: 보상이 무엇이었는지가 중요합니다
논문의 마지막 실험은 시뮬레이터를 보상으로 써서 체스 튜터를 학습시키는 개념 증명(proof of concept)입니다. 튜터 모델은 보드 이미지를 함께 읽는 Qwen3-VL-8B-Instruct이며, 먼저 지도 미세조정(SFT)을 한 뒤 GRPO(Group Relative Policy Optimization)로 20스텝 강화학습을 합니다. GRPO는 같은 입력에 여러 응답을 생성하고 그 묶음 안의 상대 점수로 정책을 갱신하는 강화학습 방법으로, 가치 모델이 필요 없습니다. 구현에는 verl을 썼습니다.
에피소드 하나는 실제 학생이 틀린 국면과 그 오답 수에서 시작합니다. 튜터가 지도문을 쓰면, 가중치를 고정한 시뮬레이터가 지도를 읽고 수를 다시 둡니다. 보상의 기본 항은 학생의 원래 수에서 다시 둔 수로 바뀐 Stockfish 평가값(센티폰, centipawn)의 개선량입니다. 개선량을 ±1500으로 자른 뒤 500으로 나눠 tanh를 씌우며, 둘 수 없는 수나 수가 없는 응답에는 -1을 줍니다.
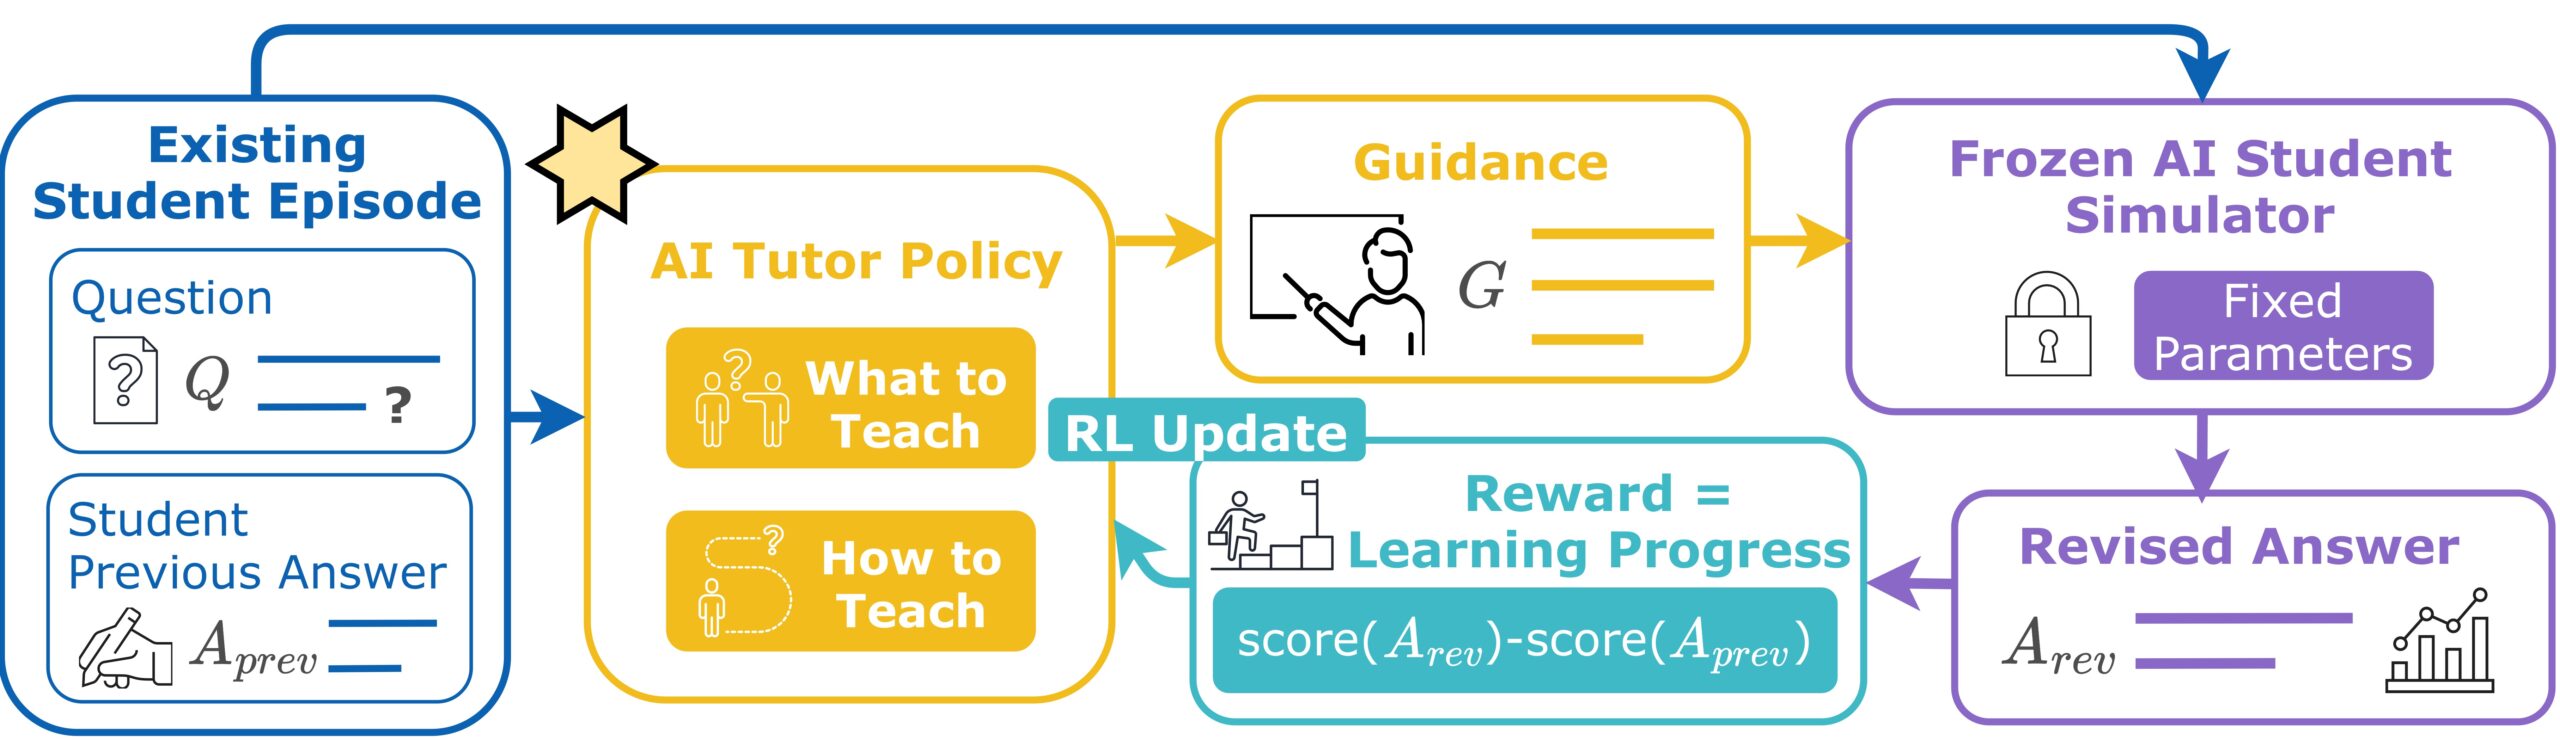
비교한 조건은 세 가지입니다. 강화학습을 하지 않은 SFT 튜터, GPT-5.4에게 학생 역할을 시켜 수를 다시 두게 한 보상, StudentSim 보상입니다. 세 조건은 튜터 모델, SFT 시작점, GRPO 설정이 같습니다. 그런데 StudentSim 보상은 시뮬레이터만으로 만든 값이 아니고, 다음 두 가지가 다릅니다.
- 학생별 시뮬레이터가 아닙니다: 논문 6장은 보상에 학생 100명의 기록을 합쳐 학습한 1단계(Stage 1) 공용 시뮬레이터를 썼다고 밝힙니다. 저장소의
configs/tutor_rl/studentsim_reward.yaml도reward_simulator_path: chess/stage1/adapter입니다. 반면 블로그 그림 5의 대체 텍스트는 이 시뮬레이터를 "frozen, personalized AI student simulator"라고 적고 있어 논문과 다릅니다. 저자들은 공용 시뮬레이터를 쓴 이유로, 튜터가 특정 학생 한 명의 버릇이 아니라 학생 전반에 맞는 지도를 배우게 하려는 것이라고 설명합니다. - 보상 헤드 2개가 곱해집니다: 같은 시뮬레이터의 은닉 상태에 선형 프로브 두 개를 붙였습니다. 문체 헤드는 지도문이 4가지 지도 방식 중 어느 것인지 분류하고, 실험에서 정한 선호 방식(소크라테스식)에 가까울수록 보상을 덜 깎습니다. 인식 헤드는 칸, 기물, 색을 잘못 말하거나 없는 기물을 지어내는 등 6가지 보드 서술 오류의 확률을 내고, 오류가 있을수록 보상을 깎습니다. GPT-5.4 보상 조건에는 이런 헤드가 없습니다.
평가는 레이팅 최대 2200의 체스 선수 8명이 조건을 모른 채 튜터의 지도문을 채점했습니다. 정확도는 심각하게 오도하는 사실 오류가 한 문장도 없는 응답의 비율이고, 지도 품질과 개인화는 1~5점 척도입니다.
| 평가 범위 | 조건 | 정확도 (%) | 지도 품질 (1~5) | 개인화 (1~5) |
|---|---|---|---|---|
| 전체 (74건, 국면 30개, 평가자 8명) | 강화학습 없음 | 75.7 | 2.99 | 2.80 |
| GPT-5.4 보상 | 71.6 | 3.08 | 2.42 | |
| StudentSim 보상 | 90.5 | 3.31 | 3.93 | |
| 평가자 3명이 모두 채점한 국면 (48건) | 강화학습 없음 | 75.0 | 3.10 | 2.65 |
| GPT-5.4 보상 | 70.8 | 3.21 | 2.33 | |
| StudentSim 보상 | 91.7 | 3.44 | 4.00 | |
| 레이팅 2000 이상 평가자 3명 (30건) | 강화학습 없음 | 70.0 | 3.03 | 2.83 |
| GPT-5.4 보상 | 56.7 | 2.97 | 2.37 | |
| StudentSim 보상 | 93.3 | 3.17 | 3.70 |
세 범위 모두에서 StudentSim 보상 튜터가 1위였고, GPT-5.4 보상 튜터는 정확도에서 강화학습을 하지 않은 튜터보다도 낮았습니다. 저자들은 GPT-5.4 보상 튜터에서 심각한 사실 오류가 훨씬 많았다고 적었습니다.
이 결과는 해석의 범위가 정해져 있습니다. 개인화 점수는 "소크라테스식 지도를 선호하는 학생"을 가정하고 매겼습니다. 그리고 StudentSim 보상의 문체 헤드는 바로 소크라테스식을 선호하도록 설정되어 있었습니다. 논문은 이 설정을 평가 조건에 맞춘 것이라고 밝힙니다. 정확도 차이도 보드 서술 오류를 깎는 인식 헤드와 함께 해석해야 합니다. 논문은 헤드 없이 시뮬레이터만 쓴 보상을 따로 보고하지 않으므로, 이 실험은 시뮬레이터의 충실도와 두 헤드의 기여를 나누어 보여 주지 않습니다.
저자들은 이 점을 오히려 설계의 장점으로 설명합니다. 비공개 API 모델은 은닉 상태를 노출하지 않아 같은 헤드를 붙일 수 없고, 작은 공개 시뮬레이터라서 보상 전체를 노드 안에서 계산할 수 있다는 것입니다. 또한 논문은 이 실험을 최고 성능 튜터를 만들었다는 주장이 아니라 개념 증명으로 한정합니다. 실제 학생의 학습 성과는 측정하지 않았습니다.
저장소로 해 볼 수 있는 것과 아직 할 수 없는 것
StudentSim GitHub 저장소는 2026년 9월 2일에 처음 커밋되었고, 마지막 커밋은 9월 21일입니다. 학습, 평가, 데이터 구축, 튜터 강화학습 코드와 설정 파일이 들어 있으며, 패키지 버전은 0.0.1(Alpha)입니다. 설치는 필요한 영역의 extra를 골라 편집 모드로 합니다. 체스 학습과 평가에는 다음 명령을 씁니다.
pip install -e '.[chess,inference]'
언어 모델을 호출하는 단계(GPT 기준선, 수학 데이터 구축, 튜터 지도문 생성과 판정)를 실행하려면 AZURE_OPENAI_ENDPOINT 와 AZURE_OPENAI_API_KEY 를 설정해야 합니다. 튜터 강화학습 extra(tutor_rl)는 verl과 vLLM을 쓰고, 보드 렌더링 때문에 시스템에 libcairo 가 있어야 합니다. 저장소의 학습 설정 파일은 모두 GPU 8장(world_size: 8)을 가정하고, L2 2단계를 뺀 나머지는 유효 배치 256을 씁니다.
데이터가 준비되면 학습과 평가는 README에 적힌 대로 다음 순서로 진행합니다. 1단계는 영역마다 한 번, 2단계는 학생마다 한 번 실행하고, 마지막에 떼어 둔 평가 기록으로 F와 R을 계산합니다.
studentsim-train --config configs/training/stage1_<domain>.yaml
studentsim-train --config configs/training/stage2_<domain>.yaml --roster roster.json
studentsim-eval --domain <domain> --out result.json
지금 바로 재현하기 어려운 이유는 데이터에 있습니다. 영역마다 사정이 다릅니다.
- 체스: Lichess 기록이 CC0이라 학습과 평가 파일을 그대로 배포할 예정이지만,
data/chess/README.md에는 아직<HF_ORG>/<HF_DATASET>자리 표시자와 함께 "The upload has not landed yet"이라고 적혀 있습니다. 제1저자는 저장소 이슈 #6에서 2026년 9월 2일에 데이터셋과 코드가 사내 검토 두 단계를 거치는 중이라고 답했습니다. - L2 영작문: EFCAMDAT은 학술 이용 계약으로 배포되므로 기록을 저장소에 넣지 않았습니다. 사용자가 직접 오류 주석 하위 말뭉치를 받아
data/l2/raw/에 넣고 빌드 스크립트를 돌려야 합니다. - 수학: FoundationalASSIST는 Hugging Face에서 이용 지침에 동의하고 접근 요청 승인을 받아야 내려받을 수 있습니다. 빌드 3단계 중 2단계가 언어 모델을 호출합니다. 하나는 모델이 문제를 직접 풀어 틀린 정답 키를 걸러 내는 단계이고, 다른 하나는 튜터 지도문을 생성하는 단계입니다. 그래서 API 비용이 들고, 생성한 지도문의 표현은 실행할 때마다 달라집니다.
학습된 어댑터 가중치는 배포하지 않습니다. 저장소의 TRANSPARENCY.md 는 이번 공개가 코드만 담았다고 설명하고, 연구 외의 용도와 특정 학습자를 평가하거나 순위를 매기는 용도에는 쓰지 말라고 적었습니다. 같은 문서는 StudentSim을 영어로만 설계하고 시험했으며, 다른 언어에서의 성능은 그 언어의 원어민 전문가가 따로 평가해야 한다고 밝힙니다. 한국어 학습자나 한국어 과목에 적용하려면 데이터 구축부터 직접 해야 합니다.
라이선스
StudentSim 코드는 MIT License로 배포되어 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정할 수 있습니다. 다만 데이터는 코드와 조건이 다릅니다. Lichess 기록은 CC0이고, EFCAMDAT은 학술 이용 계약을, FoundationalASSIST는 CC BY-NC 4.0 라이선스와 연구, 교육 목적의 이용 지침을 따라야 하므로 상업적 이용은 할 수 없습니다. 저장소도 이 두 데이터의 기록은 재배포하지 않습니다. 기반 모델 Qwen3-4B-Instruct-2507은 Apache 2.0 라이선스입니다.
이 연구가 답한 것과 남긴 것
StudentSim은 학생 한 명의 기록이 적어도 그 학생의 다음 답을 맞힐 수 있음을 보였습니다. 여러 학생 기록으로 먼저 학습한 4B 모델이, 프롬프트만 받은 GPT-5.4보다 더 잘 맞혔습니다. 체스에서는 그 차이가 크고, 공용 1단계 학습이 성능에 기여한다는 것도 같은 예산의 비교 실험으로 확인했습니다. 학생을 흉내 내는 능력과 지도에 반응하는 능력을 따로 재야 한다는 문제 설정도, AI 튜터 평가에서 역할극 LLM을 그대로 쓰는 관행에 구체적인 지표를 제시합니다.
남은 질문도 분명합니다. R은 지도가 가리키는 정답으로 옮겨 가는지를 볼 뿐, 그 학생이 실제로 그렇게 반응할지를 보지 않습니다. 수학 F는 항상 정답을 고르는 단순 기준선보다 낮습니다. 튜터 강화학습의 이득은 학생별 시뮬레이터가 아니라 공용 시뮬레이터와 두 보상 헤드를 합친 결과이고, 튜터를 쓴 실제 학생이 더 잘 배웠는지는 측정하지 않았습니다.
블로그도 실제 학생 연구는 여전히 필요하며 시뮬레이터는 그 전 단계에서 쓰는 도구라고 밝힙니다. 저자들은 다음 과제로, 여러 번의 상호작용에 걸쳐 학생이 지식을 익히고 잊는 장기 학습 과정을 재현하는 일을 꼽았습니다. 도구가 결과물의 품질을 높여도 사용자의 실력이 늘었는지는 별개의 질문이라는 점은, 특허 변호사 133명과 AI의 협업 실험에서도 확인된 바 있습니다.
 Simulating student learning for better AI tutoring 소개 블로그
https://www.microsoft.com/en-us/research/blog/simulating-student-learning-for-better-ai-tutoring/
StudentSim: Training LLM-based Student Simulators 논문
 StudentSim GitHub 저장소
 StudentSim 프로젝트 페이지
더 읽어보기
-
Maia-2: A Unified Model for Human-AI Alignment in Chess (arXiv)
-
Google과 NBER이 공개한 특허변호사 133명과 AI의 협업 실험 결과: 특허 초안은 좋아졌지만 주니어의 실력은 늘지 않았음
-
DeepTutor: LLM 기반의 심층 학습 및 연구를 위한 멀티 에이전트 프레임워크 (feat. HKUDS)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
