핵심 요약
- Google Research 블로그 글과 NBER 워킹 페이퍼 w35720은 같은 실험을 다룹니다. 미국 지식재산권 로펌 11곳의 특허 변호사 133명을 AI 사용 그룹과 비사용 그룹으로 무작위 배정하고 3개월 동안 추적했습니다.
- AI와 함께 쓴 특허 초안의 품질은 10일 차에 0.34 표준편차(SD), 90일 차에 0.38 SD 높았고, 향상 폭은 경력 7년 미만의 주니어가 더 컸습니다.
- 90일 차에 모두가 AI 없이 수행한 특허 검토(redlining) 과제에서는 시니어만 0.45 SD 앞섰고, 주니어는 평균 향상이 없었으며 점수 분포가 위아래로 넓어졌습니다.
- AI 도구의 효과를 평가할 때는 도구를 쓴 결과물과 도구 없이 발휘하는 실력을 따로 측정해야 한다는 것이 저자들의 결론입니다. 다만 AI 없이 검토한 주니어는 24명(대조군 7명)이고, 실험 비용과 도구는 Google이 제공했습니다.
특허 변호사 3개월 AI 현장 실험 소개
생성형 AI가 업무 생산성을 높인다는 실험 결과는 이미 많습니다. 글쓰기, 고객 상담, 소프트웨어 개발 실험에서 AI를 쓴 사람의 결과물이 좋아졌고, 특히 경험이 적은 사람이 더 크게 좋아졌다는 결과가 반복해서 나왔습니다. 그런데 이 실험들은 대부분 AI를 켠 상태의 결과물만 측정합니다. 주니어가 몇 년 동안 반복 업무를 하며 쌓아 온 판단력이 AI와 함께 일할 때도 똑같이 쌓이는지는 별개의 질문입니다.
이번에 소개할 연구는 이 질문을 직접 측정한 현장 실험(Field Experiment) 입니다. MIT 경제학자 David Autor와 Google의 AI 및 경제 연구팀이 2026년 9월 미국 국가경제연구소(NBER) 워킹 페이퍼로 논문을 공개했습니다. 제목은 「Does AI Assistance Enhance or Erode Expertise? Evidence from a Three-Month Field Experiment in Patent Drafting」입니다. 10월 7일에는 Google Research 블로그에 요약 글 「Does better work always mean better workers?」를 올렸습니다. 연구진은 실제로 일하는 특허 변호사에게 3개월 동안 AI 초안 작성 도구를 쓰게 한 뒤, 마지막에 AI 없이 수행하는 과제를 따로 주어 실력이 어떻게 달라졌는지 측정했습니다.
특허 업무를 고른 데에도 이유가 있습니다. 특허 청구항(Claim) 은 특허가 보호하는 범위를 문장으로 적은 부분입니다. 그 문구 하나가 법적 권리 범위를 정하므로 결과물의 품질 차이가 분명합니다. 방어 가능한 청구항을 쓰려면 선배의 지도 아래 수년간 연습해야 하고, 결과물은 다른 특허 전문가가 블라인드로 채점할 수 있습니다.
저자들에 따르면 기존 연구는 세 조건을 함께 갖춘 경우가 드뭅니다. 수개월에 걸친 실제 업무 속 AI 사용, AI 없는 실력의 신뢰할 만한 평가, 전문가의 블라인드 채점입니다. 이 실험은 세 조건을 모두 갖췄습니다.
개발자에게도 이 질문은 가깝습니다. 코딩 에이전트가 주니어의 첫 코드를 대신 써 주는 환경에서 그 주니어의 코드 리뷰 실력과 설계 판단력이 같이 자라는지가 같은 구조의 질문이기 때문입니다. 아래에서는 실험 설계, 두 종류 과제의 결과, 결과를 읽을 때 함께 봐야 할 한계를 순서대로 정리합니다.
실험 설계: AI와 함께 쓰는 초안과 AI 없이 하는 검토
참가자와 무작위 배정
연구진은 Google과 정기적으로 특허 업무를 하는 지식재산권 로펌 24곳에 참여를 요청했고, 그중 11곳이 참여했습니다. 한 로펌은 두 달 간격으로 두 그룹이 참여해, 분석에서는 12개 그룹으로 나눠 다룹니다. 로펌이 추천한 변호사 156명 중 133명이 온보딩을 마치고 무작위 배정됐습니다. 배정은 로펌별로, 경력(로펌 안의 경력 중앙값 기준)을 나눠서 2:1 비율로 했고, 최종적으로 90명이 AI 사용 그룹(처치군), 43명이 비사용 그룹(대조군)이 됐습니다. 참가자는 실험 과제에 쓴 시간만큼 계약된 시간당 요금을 받았습니다.
이 설계는 무작위 대조 실험(Randomized Controlled Trial, RCT) 입니다. 참가자를 무작위로 두 그룹에 나누면 두 그룹의 출발점이 평균적으로 같아지므로, 나중에 생긴 차이를 AI 사용의 효과로 해석할 수 있습니다. 연구진은 실험 계획을 2025년 5월 21일 미국경제학회(American Economic Association, AEA)의 RCT 등록소(AEARCTR-0015823)에 미리 등록했습니다. 분석에서는 경력 7년 이상을 시니어, 7년 미만을 주니어로 나눕니다. 이 기준은 Google 사내 변호사의 조언에 따른 업계 관행입니다.
AI 도구: Google Labs의 InFlow
처치군은 Google Labs가 개발 중이던 미공개 글쓰기 도구 InFlow 를 썼습니다. 주요 기능은 네 가지입니다. 선택한 문장을 프롬프트로 고치는 기능, 지정한 위치에 맥락에 맞는 문장을 넣는 기능, 편집자와 전문가와 독자 관점의 피드백을 주는 채팅이 있었습니다. 사용자가 정한 규칙에 따라 문서 안의 불일치를 찾는 비평(Critique) 기능도 있었습니다. 실험 기간(2025년 5월~2026년 2월)에 기본 채팅 모델이 Gemini 2.5 Pro로 바뀌는 등 기능이 여러 번 업데이트됐습니다. 논문에 따르면 InFlow는 독립 제품으로 출시되지 않았고 기능이 Google의 다른 AI 도구에 통합됐으며, 블로그는 이 도구가 현재 Gemini Notebook의 일부라고 적었습니다.
대조군은 실험 기간 동안 생성형 AI 글쓰기 도구를 제공받지 않고 기존 법률 도구로 일했습니다. 두 그룹 모두에게 AI 기초와 프롬프트 엔지니어링을 다루는 선택형 교육 자료가 제공됐고, 처치군에게는 InFlow 사용법과 특허 작성용 프롬프트 라이브러리 자료가 추가로 제공됐습니다. 대조군은 3개월 실험이 끝난 뒤 InFlow를 쓸 수 있었습니다.
세 가지 평가 과제
| 시점 | 과제 | AI 사용 | 측정하는 것 | 완료 인원 (대조군/처치군) |
|---|---|---|---|---|
| 10일 차 | 특허 초안 작성 (종속 청구항 5~7개, 상세 설명, 1,000단어 이내) | 처치군만 허용 | AI를 쓸 때의 결과물 품질 | 35 / 70 |
| 90일 차 | 특허 초안 작성 (다른 발명, 더 어려운 과제) | 처치군만 허용 | 장기 사용 후 결과물 품질 | 31 / 67 |
| 90일 차 | 오류가 많은 특허 초안 검토(redlining) | 모두 금지 | AI 없이 발휘하는 판단력 | 29 / 62 |
초안 작성 과제는 가상의 발명에 대한 발명자 메모와 도면을 주고 특허 문서를 쓰게 합니다. 발명 내용은 AI 모델 학습에 쓰지 않은 별도 데이터에서 골랐습니다. 시간 제한은 10일 차 과제가 2시간, 90일 차는 초안 작성과 검토를 합쳐 4시간이었습니다. 실제 시작일은 연락 지연과 휴일 때문에 온보딩 후 평균 13일, 102일이었습니다.
핵심은 세 번째 과제입니다. 레드라이닝(Redlining) 은 이미 작성된 문서에 직접 수정과 코멘트를 표시하며 고치는 작업입니다. 참가자는 실질적인 오류와 문체 오류가 많이 섞인 가상의 특허 초안(AI로 생성한 문서)을 받아 AI 없이 고쳐야 했습니다. 수정 대상은 제목, 분야, 배경, 요약, 청구항 다섯 부분이었고, 강점과 취약점을 정리한 피드백 5~10개도 함께 제출했습니다.
블로그에 따르면 특허 변호사는 서로의 문서에서 특허 업계가 "patent profanity" 라고 부르는 치명적 실수를 찾아냅니다. 권리 범위를 불필요하게 좁히는 must, essential 같은 단어나, 법정에서 특허를 무력화할 수 있는 과도한 주장이 여기에 해당합니다. 이 과제는 그런 검토 업무를 본뜬 것입니다. 저자들은 이 과제가 시니어 변호사가 평소 AI 없이 하는 판단 업무에 가깝다고 설명합니다.
채점: 블라인드 전문가 평가와 LLM 보조 평가
모든 제출물은 별도 지식재산권 로펌의 변호사 6명 중 무작위로 고른 2명이 블라인드로 채점했습니다. 채점 기준은 Google 사내 변호사와 함께 만든 5개 항목입니다.
- 집행 가능성(Enforceability): 법정에서 권리를 행사할 수 있는가
- 정확성(Technical Accuracy): 발명을 정확히 기술했는가
- 전략적 모호성(Strategic Ambiguity): 미국 특허청의 BRI(Broadest Reasonable Interpretation) 기준을 지키면서 청구항을 넓고 유연하게 썼는가
- 완결성(Completeness & Alignment): 빠진 부분 없이 일관되는가
- 명확성(Clarity): 읽기 쉽고 분명한가
각 항목은 1~5점 리커트 척도이고, 분석에서는 대조군 점수의 평균이 0, 표준편차가 1이 되도록 표준화합니다. 그래서 0.34 SD 상승은 처치군 평균이 대조군 평균보다 대조군 점수 분포의 표준편차 0.34배만큼 높은 것을 가리킵니다. 블로그는 이를 대조군 안의 백분위 순위로 환산해 0.34 SD를 약 10 백분위 포인트 상승으로 설명합니다. 두 채점자의 점수 상관계수는 0.47~0.59였습니다. 연구진은 Gemini 2.5 Flash로 모든 제출물을 한 번 더 채점했는데, 이는 보조 지표로만 씁니다.
AI와 함께 쓴 초안: 낮은 점수가 줄어들며 품질이 올랐다
평균 효과: 주니어가 더 크게 좋아졌다
AI를 쓴 변호사의 초안은 10일 차에 0.34 SD(p=0.03), 90일 차에 0.38 SD(p=0.01) 더 높은 점수를 받았습니다. 5개 채점 항목 모두에서 처치군의 점수가 높았습니다. 경력별로 나누면 주니어는 10일 차 0.58 SD(p=0.04), 90일 차 0.60 SD(p=0.02) 올랐고, 시니어는 10일 차 0.22 SD(p=0.24), 90일 차 0.30 SD(p=0.08) 올랐습니다. 다만 주니어와 시니어의 효과 차이 자체는 통계적으로 구분되지 않았습니다(p>0.1).
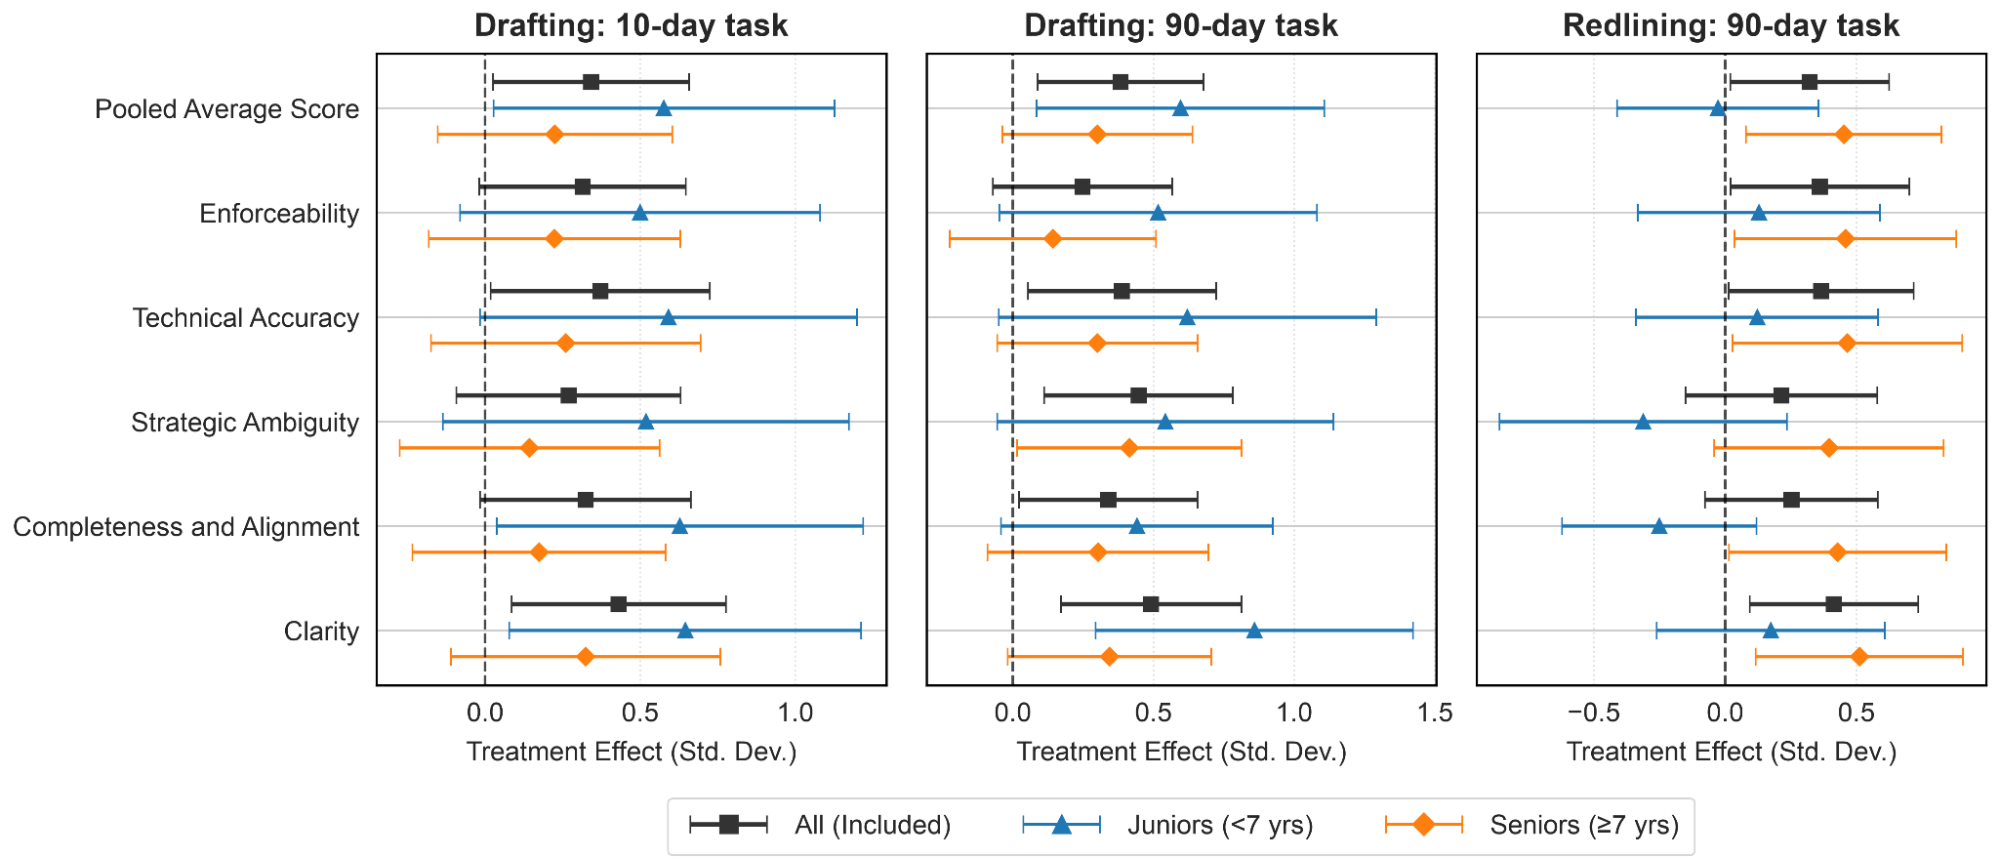
위 그림은 세 과제별로 AI 사용 효과의 추정치와 95% 신뢰구간을 보여줍니다. 검은 사각형은 전체, 파란 삼각형은 주니어, 주황 마름모는 시니어입니다. 왼쪽 두 패널(초안 작성)에서는 모든 항목에서 파란 삼각형이 주황 마름모보다 오른쪽에 있고, 오른쪽 패널(AI 없는 검토)에서는 그 순서가 뒤집힙니다.
90일 차 기준으로 AI를 쓴 주니어의 평균 초안 점수(0.36 SD)는 AI를 쓰지 않은 시니어의 평균(0.13 SD)보다 높았습니다. 논문 본문에 따르면 AI를 쓴 주니어가 AI를 쓰지 않은 시니어의 기준선을 넘어선다는 귀무가설은 기각되지 않았습니다(10일 차 p=0.95, 90일 차 p=0.69). 저자들은 이 검정들의 검정력이 낮다는 점도 함께 밝힙니다.
분포: 낮은 점수가 크게 줄었다
평균보다 흥미로운 것은 점수 분포의 모양입니다. 연구진은 점수를 다섯 구간으로 나누는 5분위(Quintile) 별로 처치군과 대조군의 비율 차이를 계산했습니다. 10일 차 초안에서 최하위 5분위에 속할 확률은 처치군이 0.19 낮았습니다(p=0.00). 90일 차에는 0.11 낮았지만 통계적으로 확실하지는 않았습니다(p=0.12). 블로그는 AI를 쓴 변호사의 점수가 최하위에서 중하위와 중간 구간으로 옮겨 갔고 최상위 점수의 수는 눈에 띄게 늘지 않았다고 요약합니다. 다만 논문 표 5에서 10일 차 초안의 최상위 5분위 비율은 전체 0.11, 주니어 0.21 늘어 유의했고, 최상위 비율 변화가 유의하지 않은 것은 90일 차 초안입니다.
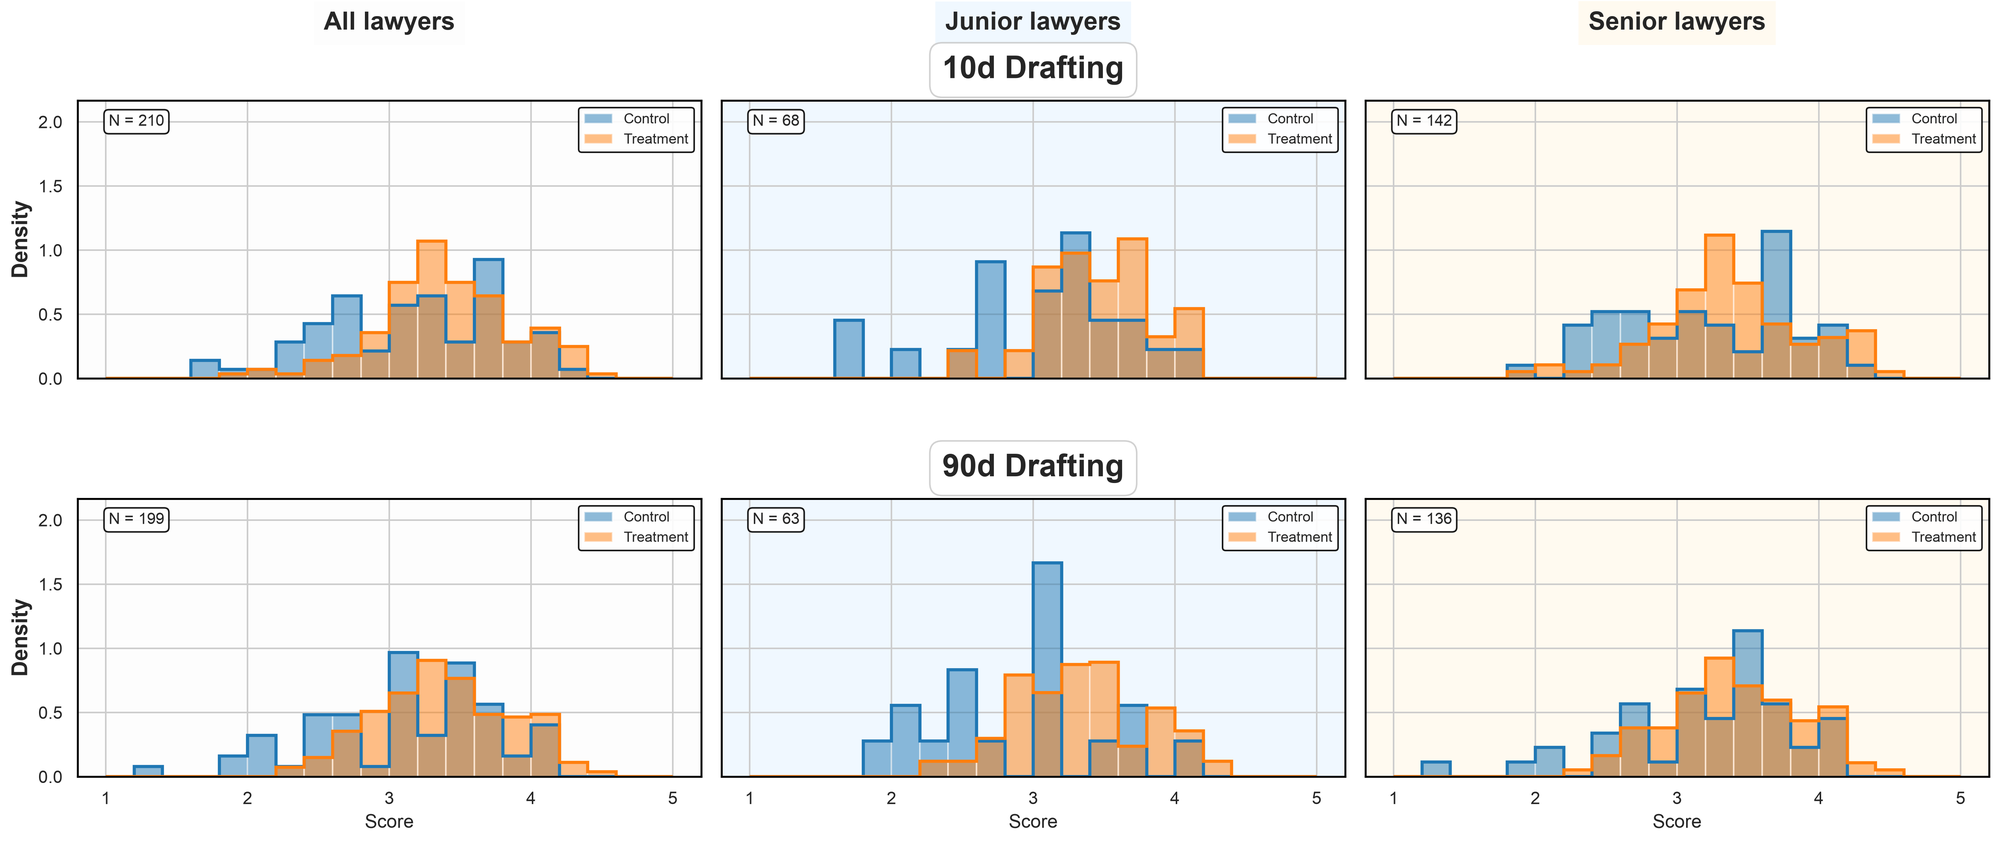
위 그림은 논문의 Figure 2입니다. 주니어 패널에서 대조군(파랑)에 있던 2.5점 아래의 낮은 점수가 처치군(주황)에서는 크게 줄고, 3점 이상 구간이 늘어난 것을 볼 수 있습니다. 주니어는 아래에서 빠진 비율을 위쪽이 흡수했고, 시니어는 최하위 비율이 줄어든 만큼 중간 구간이 늘었습니다.
작업 시간: 주니어만 빨라졌다
참가자가 직접 잰 작업 시간을 보면, 10일 차 초안에서 처치군은 대조군(평균 112분)보다 약 10분 빨랐습니다(p=0.05). 이 단축은 주니어에 몰려 있습니다. 주니어는 대조군 주니어(114분)보다 18분 빨랐고(p=0.05), 시니어는 5분 빨랐지만 통계적으로 0과 구분되지 않았습니다(p=0.35). 90일 차 과제에서는 방향은 같았지만 유의하지 않았습니다. 블로그는 주니어의 18분 단축을 대조군 평균 124분과 비교했는데, 논문 표 8에서 124분은 90일 차 과제 전체의 기준값이고 10일 차 주니어 대조군의 기준값은 114분입니다.
결과적으로 AI를 쓴 주니어는 시니어(AI 사용 여부와 무관)만큼 빠르게, 비슷한 품질의 초안을 냈습니다. 시니어는 AI를 써도 작업 속도가 빨라지지 않았습니다. 실험 과제 밖의 실제 특허 업무(참가자 68명의 자기 보고)에서도 처치군의 특허 완성 시간이 0.76주 짧았지만 유의하지 않아(p=0.35), 실험에서 본 효과가 실제 업무 효율로 이어지는지는 확인되지 않았습니다.
AI 없이 한 검토: 시니어만 실력이 올랐다
평균 효과: 주니어의 효과는 0에 가깝다
90일 동안 AI로 초안을 써 온 처치군은 AI 없이 한 검토 과제에서도 대조군보다 0.32 SD(p=0.04) 높은 점수를 받았습니다. 블로그는 이를 약 9 백분위 포인트 상승으로 환산합니다. 그런데 이 효과는 전부 시니어에게서 나왔습니다. 시니어는 0.45 SD(p=0.02, 약 13 백분위 포인트) 앞섰고, 주니어의 추정치는 -0.03 SD(p=0.89)로 0과 구분되지 않았습니다. 시니어는 5개 항목 모두에서 대조군보다 높았고 그중 4개가 p≤0.10 수준에서 유의했습니다. 주니어는 5개 중 2개 항목(전략적 모호성, 완결성)에서 추정치가 음수였지만 유의하지는 않았습니다.
초안 작성에서 AI의 도움을 가장 크게 받은 그룹(주니어)이 AI 없는 과제에서는 이득이 없었고, 도움을 덜 받은 그룹(시니어)이 AI 없는 과제에서 뚜렷한 향상을 보인 셈입니다. 저자들은 초록에서 이를 "AI의 가장 큰 이득은 가장 적게 남긴 변호사에게 돌아갔다" 고 요약합니다.
분포: 주니어 점수는 위아래로 흩어졌다
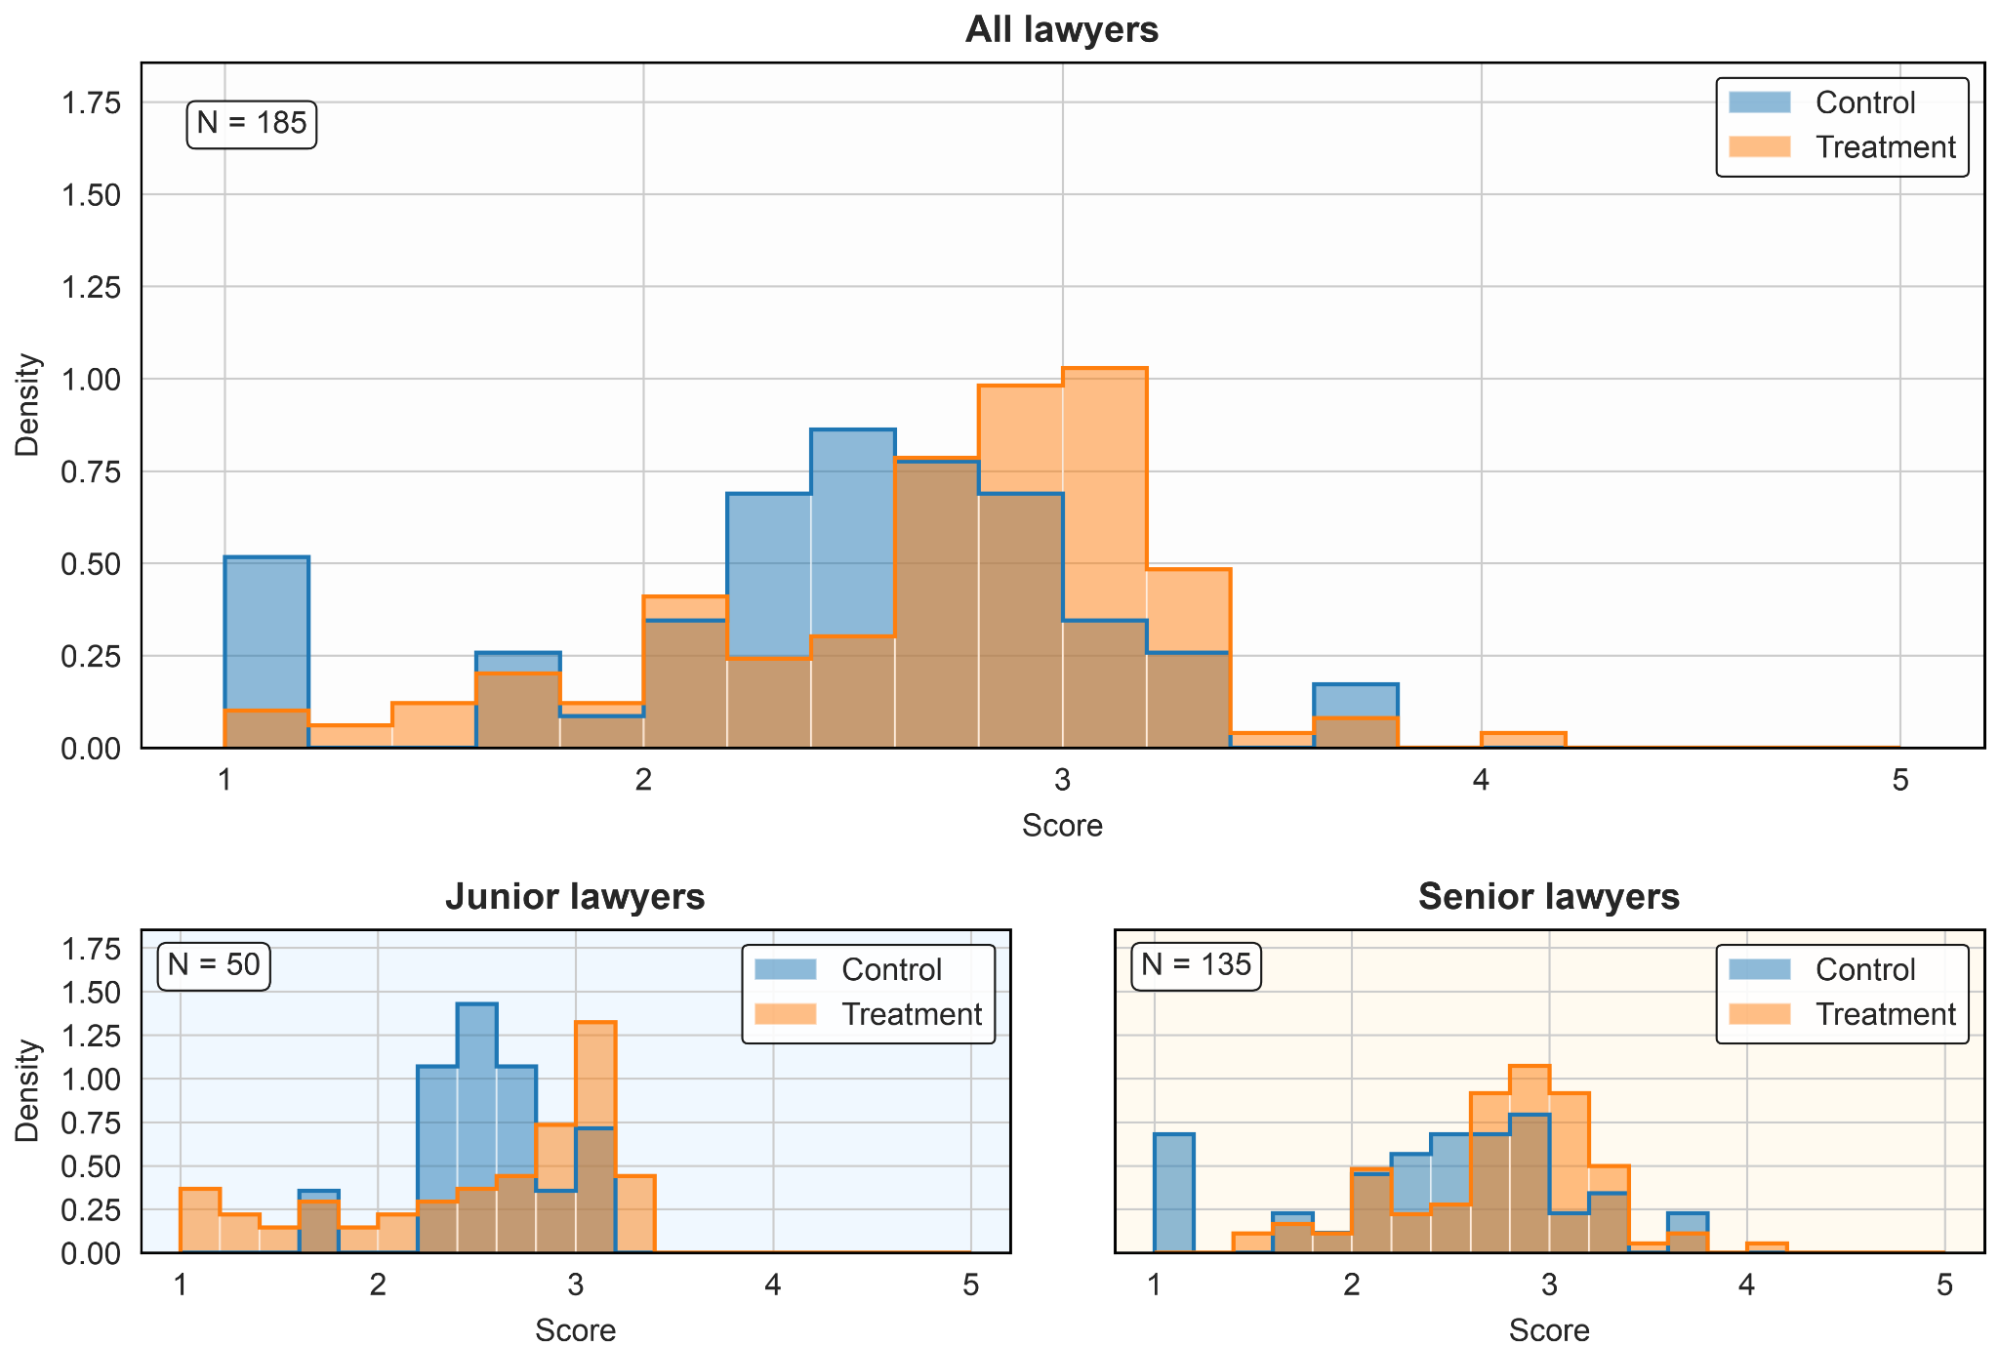
위 그림은 AI 없는 검토 과제의 점수 분포입니다. 시니어(오른쪽 아래)는 대조군에 있던 1점 부근의 최하위 점수가 처치군에는 없고, 3점 근처의 비중이 커졌습니다. 5분위로 보면 시니어 처치군은 상위 두 번째 구간 비율이 0.22 늘었고(p=0.00), 최하위 구간 비율은 0.14 줄었습니다(p<0.1).
주니어(왼쪽 아래)는 모양이 다릅니다. 대조군 주니어는 2점대 중반에 몰려 있지만, 처치군 주니어는 1점대 초반의 낮은 점수와 3점대의 좋은 점수로 나뉘었습니다. 수치로는 아래에서 두 번째 구간 비율이 0.42 줄고(p=0.01), 최하위 구간 비율이 0.22 늘었으며(p=0.04), 위에서 두 번째 구간 비율이 0.19 늘었습니다(p=0.20). 최상위 구간은 늘지 않았습니다. 분산이 같은지 보는 Levene 검정도 주니어 처치군의 분산이 더 크다는 쪽을 가리켰습니다(p=0.06). 시니어 처치군의 분산도 커졌지만(p=0.01), 이는 좋은 점수가 늘고 낮은 점수가 줄어든 결과입니다.
저자들은 이 분포가 일부 주니어에게는 AI가 학습을 앞당기고, 다른 주니어에게는 학습을 대신했다는 해석과 맞는다고 설명합니다. 하지만 어떤 주니어가 어느 쪽으로 갔는지, 그 이유가 무엇인지는 이 실험으로 알 수 없다고 분명히 적었습니다.
결과는 얼마나 단단한가: 강건성 검증
저자들은 AI 없는 검토에서 시니어만 좋아졌다는 결과를 이 연구에서 가장 중요하고 가장 예상하지 못한 발견으로 꼽습니다. 그래서 논문은 여러 방식으로 이 결과를 다시 검증합니다.
순열 검정
순열 검정(Permutation Test) 은 처치군과 대조군 라벨을 무작위로 계속 섞는 방법입니다. 이렇게 하면 AI 효과가 전혀 없을 때 우연히 나올 수 있는 효과 크기의 분포가 생기고, 실제 관측값이 그 분포의 어디에 있는지 볼 수 있습니다. 표본이 작을 때 일반적인 표준오차 계산보다 가정이 적습니다. 연구진은 2,000번 섞어 분포를 만들었습니다.
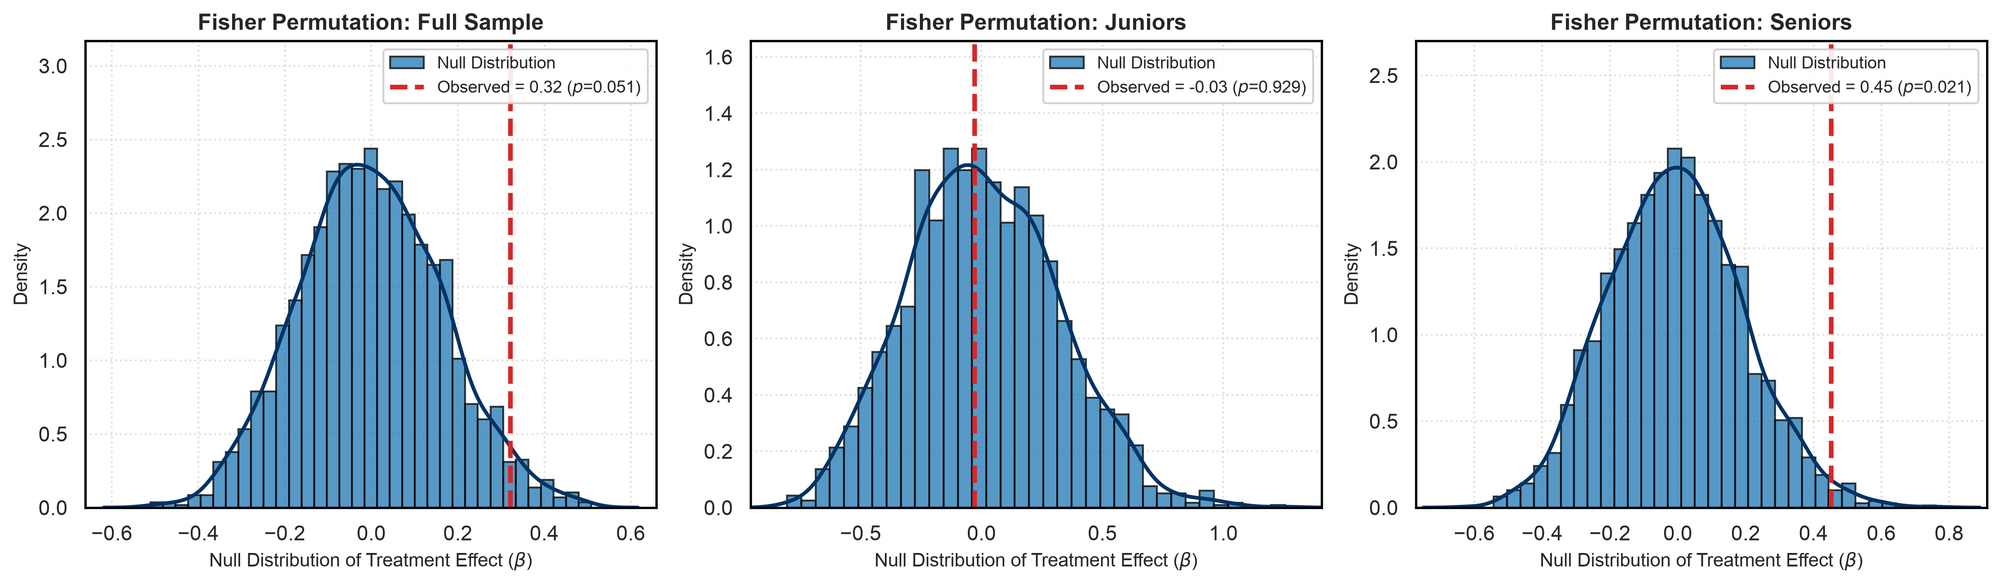
전체 효과 0.32는 귀무 분포의 97.1 백분위(p=0.05), 시니어 효과 0.45는 98.7 백분위(p=0.02)에 있습니다. 주니어 효과 -0.03은 46.8 백분위(p=0.93)로 분포 한가운데에 있습니다.
AI 몰래 사용 가능성
검토 과제에서 AI를 쓰지 말라는 지시는 강제할 방법이 없었습니다. 사용자 개인정보 약속 때문에 개인별 도구 사용 기록을 볼 수 없었기 때문입니다. 시니어 처치군이 검토 과제에서도 AI를 썼다면 결과가 부풀려졌을 수 있습니다.
연구진은 NotebookLM(Gemini 3.0 Pro 기반)에게 AI 사용 흔적을 찾게 했습니다. NotebookLM 주소는 현재 Gemini Notebook 페이지로 연결됩니다. 문단 전체 재작성, 칭찬으로 비판을 감싸는 말투, furthermore, delves 같은 LLM 특유의 연결어가 그 흔적입니다. 연구팀도 제출물을 직접 검토했습니다. 의심되는 쪽으로 넉넉하게 판정해 91건 중 15건을 AI 사용 가능성이 있는 제출물로 표시했습니다.
이 15건을 빼고 다시 추정하면 전체 효과는 0.32에서 0.25 SD(p=0.14)로, 시니어 효과는 0.45에서 0.39 SD(p=0.06)로 줄어듭니다. 주니어 효과는 -0.11 SD(p=0.61)입니다. 정밀도는 떨어지지만 시니어만 좋아졌다는 방향은 유지됩니다. 처치군이 검토 과제에서 시간을 아끼지 않았다는 점(주니어 +4.5분, 시니어 +1.2분, 모두 유의하지 않음)도 저자들은 AI를 쓰지 않았다는 정황으로 듭니다.
LLM 채점과 그 밖의 검증
Gemini 2.5 Flash의 채점은 사람 채점과 같은 방향의 결과를 보였지만, 효과 크기를 더 크게 잡았습니다. 이 결과를 그대로 받아들이기 어려운 이유도 논문에 있습니다. LLM 점수와 전문가 평균 점수의 상관계수는 10일 차 초안에서 0.47이었지만, 90일 차 초안에서 0.19, 검토 과제에서 0.14로 떨어졌습니다. 저자들도 LLM 채점자가 계약한 전문가보다 신뢰도가 낮을 것이라고 밝힙니다. LLM 채점에서는 주니어의 검토 효과가 0.29 SD로 나왔지만 유의하지 않았고, 사람과 LLM 점수를 합쳐도 주니어 효과는 0.12 SD(p=0.57)였습니다. LLM-as-a-judge 방식으로 전문 영역의 결과물을 평가하려는 경우, 과제가 어려워질수록 LLM 평가와 전문가 평가의 상관이 낮아진 이 수치를 함께 볼 수 있습니다.
연구진은 분석 조건을 바꿔 가며 같은 결론이 나오는지도 확인했습니다. 로펌 고정효과를 빼도, 가장 큰 로펌(검토 과제 참가자 91명 중 37명)을 포함해 로펌을 하나씩 빼도 결론은 같았습니다. 주니어와 시니어의 경계를 3년~9년으로 바꾸고 중간 경력 그룹을 따로 떼어 보아도 마찬가지였습니다. 중간 경력 그룹은 초안 작성에서 약간 좋아졌지만 AI 없는 검토에서는 좋아지지 않았습니다.
주니어와 시니어는 검토를 어떻게 다르게 했나
숫자만으로는 왜 시니어만 좋아졌는지 알 수 없습니다. 연구진은 NotebookLM으로 검토 제출물 91건 전체의 수정 내용과 코멘트를 분석해, 상위 점수와 하위 점수 제출물을 가르는 행동 패턴을 뽑았습니다. 사전 등록한 가설 없이 한 분석이므로 저자들은 이 결과를 통계 추정이 아닌 정성적 관찰로만 보고합니다.
AI를 쓴 시니어의 검토 방식: 문장을 다듬기보다 초안의 구조를 다시 짰습니다. 제목, 분야, 배경 같은 중요도가 낮은 부분을 건너뛰고 청구항을 새로 쓰는 데 시간을 썼습니다. 권리 범위를 좁히는 표현을 지웠고, 수정마다 근거가 되는 법리를 코멘트로 달았습니다. 부록에 실린 상위 점수 제출물(경력과 무관하게 주로 처치군)의 예로는, generally 같은 모호한 표현을 지우면서 그런 표현이 균등론(Doctrine of Equivalents) 주장을 어렵게 만든다고 이유를 적은 경우가 있습니다.
주니어의 검토 방식(처치군, 대조군 공통): 문서를 처음부터 순서대로 읽으며 중요도가 낮은 서론부 문장을 고치는 데 시간을 다 쓰고, 정작 법적 비중이 가장 큰 청구항에 도달하지 못하는 경우가 많았습니다. 동의어 바꾸기 같은 표면적인 수정이 많았고, 심각한 결함을 찾아도 "청구항에 불명확한 표현이 있음" 처럼 문제를 지적하는 코멘트만 남기고 직접 고치지는 않았습니다. 연구진은 이를 진단만 하고 실행하지 않는(Diagnose-without-execute) 태도라고 부릅니다.
이 태도가 AI 때문에 생겼는지가 중요한 질문인데, 연구진은 대조군 주니어에게서도 똑같이 흔했다는 점을 근거로 AI가 만든 습관이 아니라 주니어 단계의 원래 약점이라고 판단합니다. 3개월 동안 AI에게 수정을 맡긴 경험이 이 약점을 고쳐 주지 못했다는 것이 저자들의 해석입니다.
사후 인터뷰
연구진은 처치군 4명(주니어 2명, 시니어 2명)을 인터뷰했습니다. 한 시니어는 AI의 출력을 주니어 어소시에이트의 첫 결과물에 버금가는 "훌륭한 초안(formidable first draft)" 으로 표현했지만, 두 시니어 모두 그 문장을 그대로 받아들이지 않았다고 답했습니다. 한 시니어는 AI를 전략적 판단을 검증하는 "논리 감사관(logic auditor)" 으로 썼다고 했습니다. 두 시니어 모두 구조는 갖췄지만 결함이 있는 초안을 앞에 두니, 평소라면 넘겼을 논리의 빈틈을 따지게 됐다고 답했습니다. 두 사람은 주니어에게 더 세밀한 피드백을 주게 됐다고도 했지만, 연구진은 주니어가 실제로 받은 피드백을 측정하지 않았습니다. 블로그는 이 경험이 기존 문장에 대한 집착을 줄이고 구조 수정의 이유를 말로 설명하게 만들었다고 정리합니다.
자기 보고와 측정치가 엇갈린 것은 시니어도 마찬가지입니다. 시니어 처치군은 작업이 빨라졌다고 느낀 정도가 10일 차 0.58 SD, 90일 차 0.99 SD 높았지만, 실제로 잰 초안 작성 시간은 대조군과 구분되지 않았습니다.
주니어는 AI가 "빈 페이지 문제(blank page problem)" 를 없애 주는 "초안 시동 효과(drafting jumpstart effect)" 를 이야기했습니다. 설문에서도 처치군 주니어는 90일 차 초안 작업 만족도가 대조군보다 1.48 SD 높았고(p=0.00), 이는 자기 보고 지표 중 가장 큰 효과였습니다. 그러나 저자들은 주니어 스스로 느낀 성장이 AI 없는 과제 점수에서는 확인되지 않았다고 적었습니다.
결과를 읽을 때 함께 볼 한계
저자들이 직접 밝힌 한계와 논문 표에서 확인할 수 있는 조건을 정리하면 다음과 같습니다.
-
표본이 작고, 특히 주니어가 적습니다: 무작위 배정 133명 중 검토 과제까지 마친 사람은 91명(누적 이탈 32%)입니다. 부록 표 A5(제출물마다 LLM 채점 1건)로 세면 검토 과제의 주니어는 대조군 7명, 처치군 17명입니다. 주니어 분포가 위아래로 흩어졌다는 결과는 이 정도 규모의 비교에서 나온 것입니다. 부록의 정성 분석에서도 저자들은 주니어 수가 적어 처치군과 대조군 주니어의 차이를 견고하게 비교하기 어렵다고 적었습니다.
-
시작 시점의 실력을 재지 않았습니다: 원래 설계에는 실험 시작 시점의 실력 평가가 있었지만 로펌들이 거부해 빠졌습니다. 그래서 90일 차 차이를 실력 습득으로 해석하는 근거는 무작위 배정으로 두 그룹의 출발점이 같았다는 가정뿐입니다. 경력 연수, 자기 평가 같은 몇 가지 사전 특성에서 유의한 차이는 없었습니다. 다만 평균 경력은 대조군이 13.2년으로 처치군(12.0년)보다 1.2년 길었습니다.
-
사전 등록 계획과 실제 보고 범위가 다릅니다: 사전 등록 문서는 두 차례 실험 모두에서 초안 작성 뒤 샘플 초안 2건을 검토(redline)하는 과제를 계획했습니다. 논문에 실린 검토 과제는 90일 차의 AI 없는 검토 하나입니다. 논문은 검토 과제가 첫 로펌의 참여가 끝난 뒤에 확정됐고, 시작 시점 평가는 로펌들이 거부했다고 설명합니다. 등록 문서의 2부(실제 업무 초안을 Google 사내 변호사가 블라인드로 평가하는 현장 실험)도 이번 논문에는 실리지 않았고, 실제 업무 결과는 참가자 자기 보고로만 나옵니다.
-
기간이 3개월입니다: 특허 전문성이 쌓이는 수년에 비하면 짧습니다. 주니어 점수의 분산이 시간이 지나며 다시 모일지, 더 벌어질지는 알 수 없습니다.
-
Google과 이해관계가 있습니다: 실험 비용은 Google이 냈습니다. 공저자 7명 중 5명이 Google 정규직이고 1명은 Google과 유급 계약 관계이며, Autor도 Google의 Technology and Society Visiting Fellow입니다. 사전 등록 문서는 처치군을 대조군의 두 배로 둔 이유로 참가자 모집 제약과 Google 제품의 사용자 확보 목표를 들었습니다. 논문에서 저자들은 더 많은 변호사가 AI를 일찍 쓰기를 바란 로펌의 선호를 이유로 적었습니다. 실험 도구는 Google 제품이고, 참가 로펌은 Google과 정기적으로 일하는 곳이라 전문 서비스 전반을 대표하지 않습니다. 자금 출처는 논문 앞부분에, 공저자별 이해관계는 NBER 논문 페이지에 공개돼 있습니다.
-
피어 리뷰 전 워킹 페이퍼입니다: NBER 워킹 페이퍼는 토론용으로 배포되며 피어 리뷰를 거치지 않았습니다. 논문 안에는 서술이 엇갈리는 곳도 있습니다. 강건성 절(4.4)은 주니어가 AI가 없는데도 AI에게 지시하듯 코멘트를 남겼다며, AI 사용이 오히려 검토 성과를 낮추는 쪽으로 번졌다고 씁니다. 반면 정성 분석 절(4.3)과 결론은 같은 태도가 대조군 주니어에게도 똑같이 흔했으므로 AI가 만든 습관이 아니라고 씁니다.
-
블로그와 논문의 세부 차이: 블로그는 주니어의 시간 단축 비교 기준을 124분으로 적었지만 논문 기준으로는 114분입니다.
다른 연구와 이어 보기: AI는 언제 실력을 키우고 언제 대신하나
논문은 기존 연구를 두 갈래로 정리합니다. 한쪽은 AI가 실력을 키운 사례입니다. 초보 영상의학과 의사의 업무 흐름에 예측 AI를 넣었더니 이후 혼자 판독하는 정확도가 올라간 연구, AI와 함께 자기소개서(cover letter) 쓰기를 연습한 참가자가 AI 없는 작문 시험에서 더 좋은 글을 쓴 연구가 여기에 속합니다.
다른 쪽은 AI를 빼면 효과가 사라진 사례입니다. 경영 컨설턴트 실험에서는 AI의 도움으로 낯선 데이터 과학 과제를 해냈지만 도구를 빼자 실력이 남지 않았고, NBER 논문은 이 결과를 "일시적 외골격(temporary exoskeleton)" 이라는 표현으로 소개합니다. Anthropic 연구진의 How AI Impacts Skill Formation에서는 새 프로그래밍 라이브러리를 AI와 함께 배운 개발자의 개념 이해, 코드 읽기, 디버깅 능력이 떨어졌습니다. 이 Anthropic 논문은 PyTorchKR의 주간 AI/ML 논문 모음에서도 소개됐습니다.
저자들이 정리한 공통점은 이렇습니다. AI의 출력을 해석, 평가, 검증해야 하는 업무 흐름은 실력을 키웁니다. 반면 출력을 그대로 받아들여도 되는 흐름은 실력이 쌓이는 데 필요한 수고를 건너뛰게 합니다. 고등학생 약 1,000명을 대상으로 한 미국국립과학원회보(Proceedings of the National Academy of Sciences, PNAS) 실험에서는 GPT-4를 제한 없이 쓰게 하자 연습 성적은 올랐지만 이후 AI 없는 시험 성적은 떨어졌습니다. 같은 모델에 학습 보호 장치를 넣어 정답을 바로 주지 않는 튜터로 바꾸자 그 손해가 대부분 줄었습니다.
이번 연구의 차별점은 학생이나 자기 전문 분야 밖의 과제를 하는 사람이 아니라, 자기 전문 분야의 핵심 업무를 하는 현직자를 실제 업무 속에서 3개월 동안 관찰했다는 데 있습니다. 그리고 결과는 경력에 따라 갈렸습니다. 저자들은 조심스러운 해석이라는 전제를 달고, 결과물을 높이는 것과 전문성을 쌓는 것이 경험이 적은 사람에게는 서로 충돌하고 판단력을 갖춘 사람에게는 서로 보완할 수 있다고 봅니다. 기초 전문성이 AI와의 반복 작업에서 오래가는 실력을 얻는 전제 조건일 수 있다는 것입니다. 저자들은 이 긴장이 중요한 이유로, 고객 미팅이나 법정처럼 AI를 실시간으로 쓰기 어려운 자리에서는 변호사가 여전히 혼자 판단해야 한다는 점을 듭니다.
저자들은 시간 투자를 가능한 경로로도 언급합니다. AI를 쓴 주니어는 빨라졌지만 AI 없는 실력은 늘지 않았습니다. 시니어는 AI를 써도 빨라지지 않았고, AI 없는 검토에는 주니어보다 더 많은 시간을 썼습니다. 중국 중고등학생 연구에서는 생성형 AI를 도입한 학생의 이후 진학 시험 성적이 1.3~1.5 SD 떨어졌는데, 손실은 공부 시간이 줄어든 학생에게서 나타났고 공부 시간을 유지한 학생은 비도입자와 비슷했다고 합니다. 다만 두 연구 모두 작업 시간을 직접 조작하지 않았으므로 시간 투자가 원인이라고 확정할 수는 없다고 저자들은 덧붙입니다.
개발 조직에 이 결과를 옮기려면 조심해야 합니다. 이 실험은 특허 변호사 91명을 3개월 동안 본 결과이고, 코딩 업무에서 같은 패턴이 나온다는 근거는 아닙니다. 그래도 논문의 마지막 문장은 분야와 관계없이 적용할 수 있는 측정 원칙입니다. AI 도구가 실력에 미치는 영향을 알려면 도구가 기여한 부분과 사용자의 전문성을 분리하는 평가가 필요하다는 것입니다. 사내에서 코딩 에이전트 도입 효과를 측정한다면, 에이전트를 켠 상태의 처리량뿐 아니라 에이전트 없이 수행하는 코드 리뷰나 장애 분석 같은 과제를 따로 두는 방식이 이 원칙을 적용한 예입니다.
현장의 체감과 비교하려면 AI는 기존 기술 역량에 곱셈 효과를 준다는 글을 함께 읽을 수 있습니다. 주니어가 기초를 익힐 기회를 잃는다는 증언을 담은 AI Workers' Inquiry 2026 보고서도 같은 주제를 다룹니다.
 Does better work always mean better workers? 소개 블로그
Does AI Assistance Enhance or Erode Expertise? 논문 (NBER Working Paper 35720)
더 읽어보기
-
OpenAI, 자동화 연구 인턴 목표 달성 발표와 함께 공개한 사내 측정치: 에이전트 노동이 사람의 3.1배
-
빌 게이츠가 본 AI 전환기의 세 가지 위험과 대응책: 인간만을 위한 영역(Human Reserved)과 AI 토큰세 제안
-
Anthropic 경제 시나리오 탐색기: 극단 시나리오에서 지식 노동 실업률 17.9%, GDP는 32% 증가
-
AI Workers' Inquiry 2026: 영국 AI 기술자들의 업무 강도와 역량 변화에 대한 보고서 [영문/PDF/36p]
-
Anthropic Economic Index(2026/02): AI 활용의 학습 곡선과 경제적 파급 효과에 대한 분석
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
