핵심 요약
- NVIDIA가 기술 블로그 튜토리얼에서 DGX Spark 64GB에 TensorRT Edge-LLM 0.11.1을 설치해 Nemotron 3.5 Lightning(전체 30B, 활성 3B, NVFP4)을 실행하는 절차를 공개했습니다.
trtedge chat명령 하나로 약 21GB 모델 다운로드, 엔진 빌드, 채팅이 이어지고,trtedge serve로 OpenAI 호환 API 서버를 띄웁니다(문서상 실험 단계, 기본 동시 요청 1개).- NVIDIA 측정(배치 1, 출력 128토큰 제한)에서 DSpark 추측 디코딩은 생성 속도를 1.45~1.73배 높였고, 첫 토큰 지연은 거의 그대로였습니다.
- Jetson Thor 같은 배포 장치로 옮길 때는 엔진을 그 장치에서 다시 빌드해야 하며, 모델 카드의 지원 언어에 한국어는 없습니다.

TensorRT Edge-LLM 소개
TensorRT Edge-LLM은 NVIDIA가 Jetson, DRIVE, DGX Spark 같은 엣지 플랫폼용으로 만든 C++ 추론(Inference) 런타임으로, 텍스트, 비전, 오디오, 음성, 행동(Action) 모델을 다룹니다. NVIDIA는 2026년 10월 30일 이 런타임의 튜토리얼을 공개했습니다. 튜토리얼은 DGX Spark에서 명령 몇 줄로 Nemotron 3.5 Lightning을 터미널 채팅과 로컬 API 서버로 띄웁니다.
NVIDIA는 배경으로 데이터센터 밖에서 동작하는 에이전트를 듭니다. 운전자의 주의 상태를 살피는 차량 시스템, 주변을 이해하고 작업을 계획하는 로봇, 생산 라인의 장비를 조율하는 시스템이 그 예입니다. 이런 피지컬 AI(Physical AI) 애플리케이션은 메모리, 전력, 지연 시간 예산이 빠듯한 장치에서 동작해야 합니다. 그런데 모델을 실행 가능한 상태로 준비하는 데에는 설정 작업이 많이 필요합니다.
원문은 이 준비를 trtedge 명령줄 도구(CLI) 하나로 줄인 경로를 소개합니다. 이 도구는 지정한 모델을 내려받고, 그 장치에 맞춘 TensorRT 엔진(Engine) 을 빌드합니다. 엔진은 모델 연산을 특정 GPU 구조에 맞게 최적화한 추론용 실행 계획입니다.
원문의 실습 환경은 NVIDIA가 10월에 발표한 DGX Spark 64GB 구성입니다. 128GB 모델과 같은 GB10 Grace Blackwell 칩과 DGX OS를 쓰고, 통합 메모리만 64GB로 줄였습니다. Acer, ASUS, Dell, Gigabyte, HP, MSI가 10월 23일부터 4,999달러부터 판매합니다. NVIDIA는 DGX Spark를 모델과 에이전트의 프로토타입 제작, 미세조정, 시험용 플랫폼으로 소개합니다. 배포 대상은 Jetson Thor, DRIVE AGX Thor, IGX Thor이며, 양쪽에서 같은 추론 런타임을 씁니다.
실습 모델인 Nemotron 3.5 Lightning은 2026년 8월 11일 공개된 모델로, 전체 30B 파라미터 중 3B만 활성화하는 MoE 구조입니다. 모델 카드에 따르면 Mamba-2 층과 MoE 층을 번갈아 쌓고 일부 어텐션(Attention) 층을 섞은 하이브리드 구조이며, 최대 1M 토큰 컨텍스트를 지원합니다. 원문은 이 모델을 텍스트 전용 모델로 소개합니다. 같은 Lightning 30B-A3B 계열 모델은 Nemotron 3.5 Transcribe에서 글을 쓰는 언어 모델로도 쓰였습니다.
DGX Spark에서 모델을 돌려 보는 것만이 목적이라면 다른 길도 있습니다. 같은 모델 카드는 DGX Spark용 vLLM과 SGLang 실행 명령, Ollama와 llama.cpp 안내를 함께 제공합니다. 필자가 보기에 TensorRT Edge-LLM 경로를 고를 이유는 최종 배포 대상이 Jetson Thor 같은 임베디드 장치일 때입니다. 개발 장치와 배포 장치에서 같은 런타임과 같은 명령을 쓸 수 있기 때문입니다.
시작 전에 확인할 조건
원문과 공식 문서가 요구하는 조건은 다음과 같습니다:
-
하드웨어와 소프트웨어: 지원되는 NVIDIA 소프트웨어 스택이 깔린 DGX Spark, CUDA 13, TensorRT 10.16.1.11 이상의 10.x 버전, Python 3.10~3.12가 필요합니다. 원문 예제는 TensorRT Edge-LLM 0.11.1과 TensorRT 10.16.1.11로 시험했습니다.
-
배포 휠(Wheel)의 범위: PyPI의 tensorrt-edgellm 0.11.1은 10월 28일 배포되었습니다. CPython 3.10~3.12용 x86_64(glibc 2.35 이상)와 aarch64(glibc 2.39 이상) 휠을 제공합니다. 지원 매트릭스에서 DGX Spark는 aarch64, SM121, 플랫폼 제공 TensorRT 10 행에 해당합니다. 문서는 GPU의 SM이 목록과 맞지 않으면 다른 GPU용 구성 요소로 대체하지 않으므로 소스에서 빌드하라고 안내합니다.
-
디스크와 메모리: 첫 실행에서 모델 약 21GB를 내려받고 엔진을 빌드합니다. 둘 다 기본적으로
~/.cache/tensorrt-edgellm에 저장되며,--cache-dir로 위치를 바꿀 수 있습니다. 서버가 만든 엔진 묶음은 기본 50GiB 한도의 LRU(Least Recently Used) 캐시로 관리됩니다. 한도를 넘으면 가장 오래 쓰지 않은 묶음부터 지웁니다. 설치 문서는 배포할 모델 크기에 2GB를 더한 여유 장치 메모리를 최소 조건으로 둡니다. -
언어: Nemotron 3.5 Lightning 모델 카드의 지원 언어는 영어, 스페인어, 프랑스어, 독일어, 이탈리아어, 일본어입니다. 사후 학습 언어 목록에는 중국어가 더해졌지만 한국어는 없습니다. 한국어는 사전 학습 데이터의 15개 언어에만 포함됩니다. 한국어 프롬프트를 쓸 계획이라면 응답 품질을 직접 확인해야 합니다.
설치에서 첫 채팅까지
아래 절차는 원문을 따릅니다. 모든 명령은 DGX Spark의 터미널에서 실행합니다.
-
가상 환경을 만들어 켜고, TensorRT Edge-LLM을 설치합니다.
python3 -m venv --system-site-packages .venv-edgellm source .venv-edgellm/bin/activate python -m pip install --upgrade pip python -m pip install "tensorrt-edgellm[server]==0.11.1"--system-site-packages옵션은 새로 설치하는 패키지를 따로 두면서도 시스템에 설치된 Python 패키지(TensorRT 포함)를 그대로 쓰게 합니다. 설치 문서에 따르면 TensorRT Python 바인딩은 가상 환경의 Python 버전과 맞아야 합니다.[server]추가 설치 항목(Extra)은 채팅과 HTTP 서빙에 필요한 의존성이며, ONNX 내보내기에는[export], 양자화(Quantization)에는[tools]가 따로 필요합니다. -
TensorRT 버전이 조건에 맞는지, TensorRT Edge-LLM 런타임이 로드되는지 확인합니다.
python -c "import tensorrt as trt; v = tuple(map(int, trt.__version__.split('.'))); assert (10, 16, 1, 11) <= v < (11,), f'TensorRT >=10.16.1.11 and <11 required; found {trt.__version__}'; from tensorrt_edgellm import runtime; runtime.load()"호환되는 시스템 TensorRT 바인딩이 없다면, NVIDIA TensorRT pip 설치 안내대로 활성화된 가상 환경에 TensorRT 10.x를 설치한 뒤 이 명령을 다시 실행합니다.
-
가상 환경이 켜진 상태에서 Nemotron 3.5 Lightning과 채팅을 시작합니다.
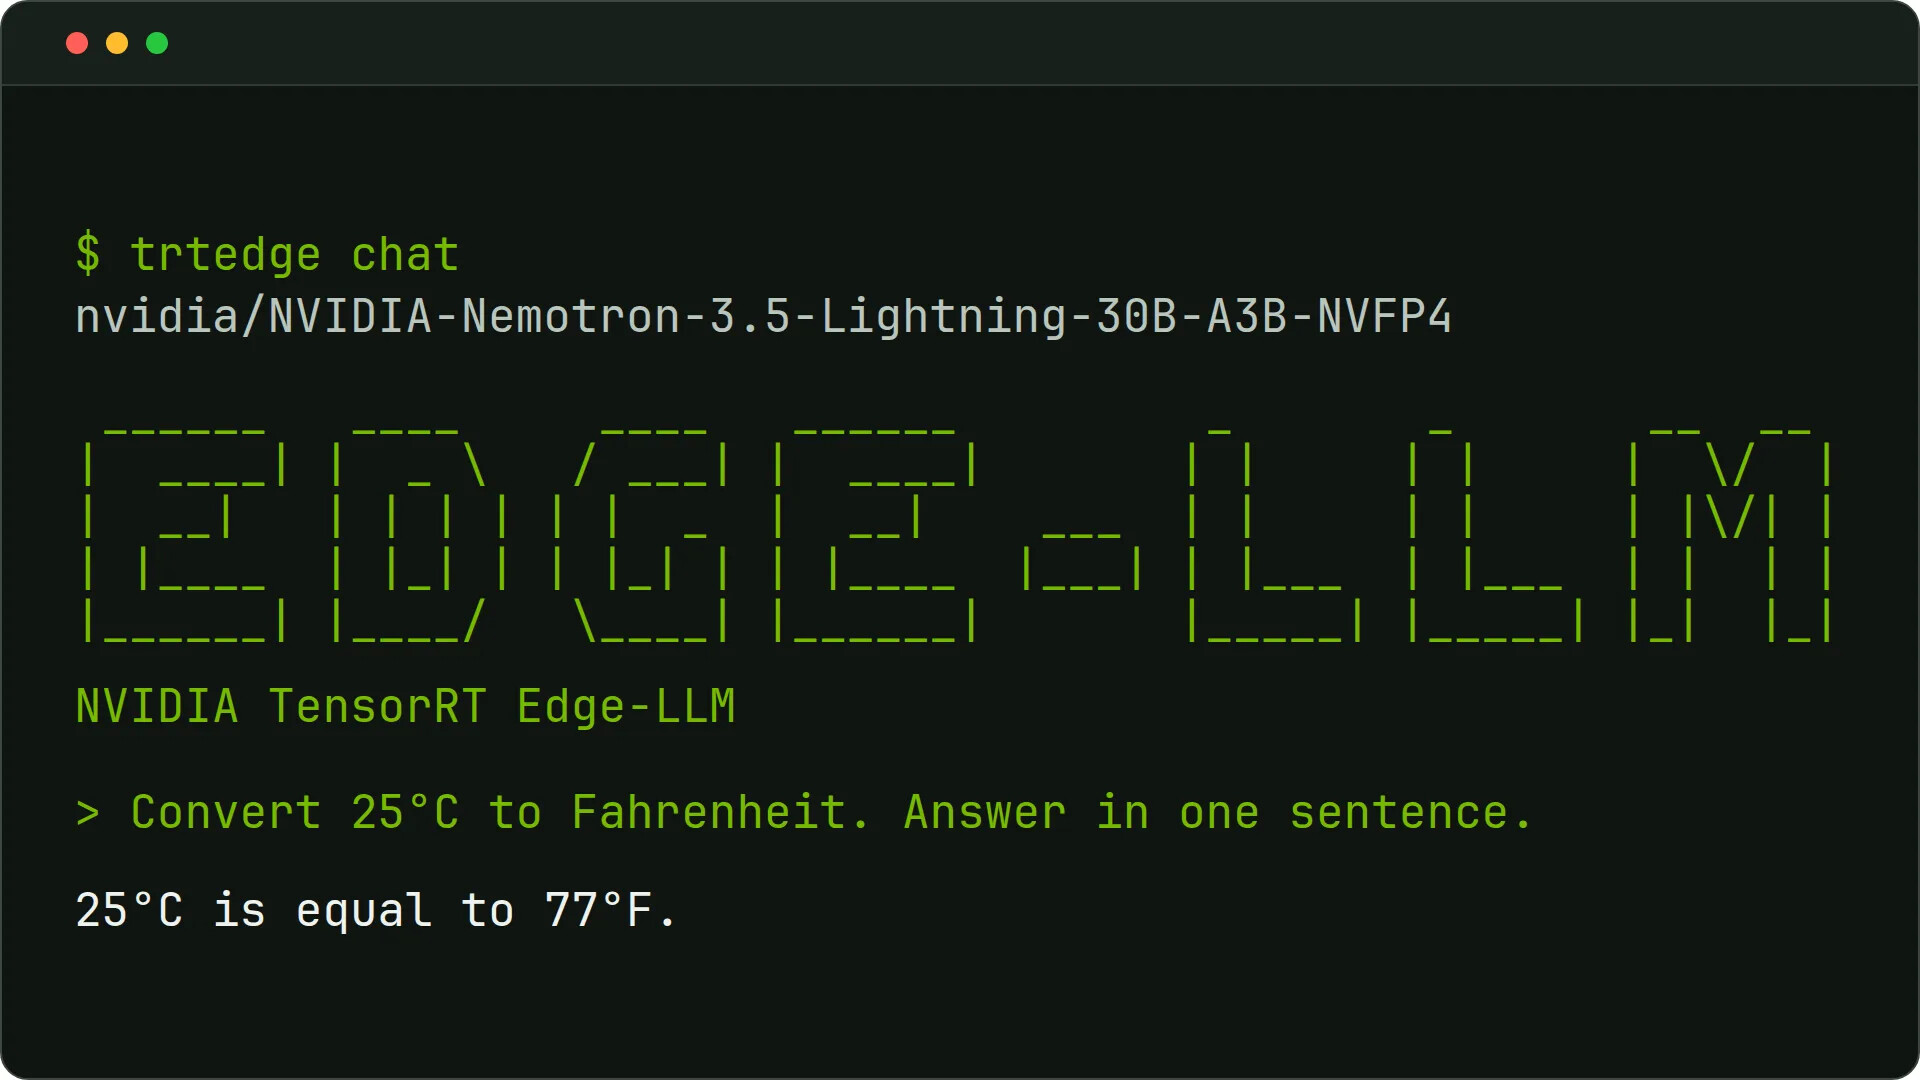
trtedge chat nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4첫 실행에서는 모델 다운로드(약 21GB)와 엔진 빌드가 끝날 때까지 기다립니다. 이후 실행에서는 조건이 같은 캐시 엔진을 다시 씁니다.
-
채팅 프롬프트가 나타나면 질문을 입력합니다. 원문은
Convert 25°C to Fahrenheit. Answer in one sentence.를 입력해25°C is equal to 77°F.라는 응답을 받았습니다. 이어서 질문을 계속하거나,/exit를 입력해 세션을 끝냅니다.
OpenAI 호환 API 서버로 띄우기
애플리케이션 프로토타입에 연결하려면 같은 모델을 로컬 HTTP 서버로 띄웁니다.
-
가상 환경이 켜진 상태에서 서버를 시작합니다. 서버는 이 설정에 맞는 엔진을 빌드하거나, 캐시에 있으면 다시 씁니다.
trtedge serve nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 \ --host 127.0.0.1 \ --port 8000 -
시작이 끝나면 DGX Spark에서 두 번째 터미널을 열고 준비 상태를 확인합니다. 응답에
"status":"ready"가 있으면 요청을 받을 수 있습니다.curl -fsS http://127.0.0.1:8000/health/ready -
채팅 완성(Chat Completions) 엔드포인트로 첫 요청을 보냅니다. 응답은 JSON 이벤트 스트림으로 옵니다.
curl -fsS -N http://127.0.0.1:8000/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{ "model": "nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4", "messages": [ { "role": "user", "content": "Convert 25°C to Fahrenheit. Answer in one sentence." } ], "stream": true, "temperature": 0, "max_tokens": 128 }' -
서버를 멈추려면 서버 터미널에서 Ctrl+C를 누릅니다.
원문은 이 서버의 동작 조건을 다루지 않습니다. 서버 문서는 제목(Experimental Python API and Server)대로 이 서버를 실험 단계 기능으로 둡니다. 기본 설정에서 서버는 한 번에 요청 하나만 처리하고, 나머지는 대기열에서 기다리며, 대기열 크기는 --max-queued-requests로, 대기 시간 한도는 --queue-timeout으로 정합니다. 대기열이 넘치거나 시간이 지나면 HTTP 429를 돌려줍니다. 여러 요청을 함께 디코딩하려면 --enable-in-flight-batching --max-batch-size 4처럼 인플라이트 배칭(In-Flight Batching) 을 켜야 합니다. 인플라이트 배칭 문서의 지원 표에 따르면 이 모델이 속한 Nemotron-H 하이브리드 모델은 이 옵션으로 실행되지만, 추측 디코딩(MTP, EAGLE, DFlash, DSpark)을 켠 서버는 시작 단계에서 이 옵션을 거부합니다.
엔드포인트는 OpenAI 형식의 /v1/chat/completions 외에 Anthropic Messages 형식의 /v1/messages도 있습니다. 반면 Completions, Responses, 임베딩 엔드포인트는 없습니다. 문서는 Messages 엔드포인트에 Claude Code를 연결하는 예도 싣고 있으며, 아래는 문서의 Qwen3.5-0.8B 예시를 그대로 옮긴 것입니다. Nemotron 3.5 Lightning으로 이 연결을 시험한 결과는 원문과 서버 문서에 없습니다.
trtedge serve Qwen/Qwen3.5-0.8B \
  --cache-dir /data/edgellm-cache \
  --served-model-name qwen35-local

ANTHROPIC_BASE_URL=http://localhost:8000 \
ANTHROPIC_API_KEY=local \
ANTHROPIC_DEFAULT_OPUS_MODEL=qwen35-local \
ANTHROPIC_DEFAULT_SONNET_MODEL=qwen35-local \
ANTHROPIC_DEFAULT_HAIKU_MODEL=qwen35-local \
claude
DSpark 추측 디코딩으로 생성 속도 높이기
추측 디코딩(Speculative Decoding) 은 생성을 가속하는 방식입니다. 작은 초안 모델(Draft Model) 이 다음 토큰 여러 개를 먼저 제안하고, 본 모델이 이 토큰들을 한 번의 순전파로 검증합니다. 본 모델이 토큰을 하나씩 만드는 횟수를 줄여 생성 속도를 높입니다.
DSpark는 2026년 7월 공개된 논문 DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation의 방법입니다. Lightning 모델 카드는 DSpark를 병렬 백본(Parallel Backbone)이 순전파 한 번에 후보 토큰 블록 전체를 제안하는 반자기회귀(Semi-Autoregressive) 초안 모델로 설명합니다. 논문 초록에 따르면 저자들은 DSpark를 DeepSeek-V4 서빙 시스템에 적용했고, 기존 운영 기준선(MTP-1) 대비 같은 처리량에서 사용자당 생성 속도가 60~85% 빨라졌다고 보고합니다. DeepSeek의 초안 모델 학습 코드베이스인 DeepSpec에도 DSpark가 들어 있으며, Liquid AI는 LFM2.5-VL-3B-DSpark로 같은 방식을 비전 언어 모델에 적용했습니다.
Nemotron 3.5 Lightning용 초안 모델은 별도 체크포인트로 공개되어 있습니다. 파라미터는 967M(임베딩 제외 615M)이고 파일 크기는 약 1.35GB입니다. 초안 모델 카드는 SPEED-Bench 평균 수락 길이를 3.75로 보고합니다(BF16 본 모델, temperature 1.0, 초안 길이 7). 분야별로는 가장 낮은 글쓰기 2.83부터 가장 높은 다국어 4.55까지 차이가 나고, 코딩은 4.38입니다. 수락 길이는 본 모델이 한 번 검증할 때 받아들인 토큰 수의 평균입니다.
DSpark를 켜는 절차는 다음과 같습니다:
-
서버 터미널에서 Ctrl+C를 눌러 실행 중인 서버를 멈춥니다.
-
초안 토큰 3개로 DSpark를 켜고 서버를 다시 시작합니다.
trtedge serve nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 \ --host 127.0.0.1 \ --port 8000 \ --speculative-config '{ "method": "dspark", "model": "nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4-DSpark", "num_speculative_tokens": 3 }' -
서버가 준비되면 앞의
curl요청을 다시 보냅니다.
서버 문서에 따르면 DSpark에서 num_speculative_tokens는 제안 토큰 수이고, 본 모델의 검증 토큰 하나가 따로 더해집니다. 본 모델, 초안 모델, 보조 구성 요소는 하나의 런타임 묶음으로 빌드되고 캐시되므로, DSpark를 처음 켤 때는 초안 모델 다운로드와 엔진 빌드가 다시 일어납니다. 원문과 모델 카드의 DGX Spark용 vLLM 실행 명령이 모두 3을 쓰며(GB200용 명령은 5), NVIDIA는 작업에 맞게 이 값을 바꿔 보라고 권합니다. 다른 설정은 추측 디코딩 문서에 있습니다.
DGX Spark 64GB 측정값과 그 조건
원문이 공개한 측정값은 다음과 같습니다. 배율 열은 필자가 생성 속도를 나눠 계산한 값입니다:
| 워크로드 | 평균 입력 길이 | 첫 토큰 지연 중앙값, DSpark 끔 (ms) | 켬 (ms) | 평균 생성 속도, DSpark 끔 (tokens/s) | 켬 (tokens/s) | 배율 |
|---|---|---|---|---|---|---|
| SpeedBench 1K | 1,153 | 201.0 | 203.0 | 73.3 | 108.5 | 1.48배 |
| SpeedBench 2K | 2,247 | 329.5 | 331.6 | 72.8 | 105.3 | 1.45배 |
| HumanEval 프롬프트 | 139 | 98.1 | 98.7 | 73.4 | 126.9 | 1.73배 |
측정 조건은 DGX OS 7.6.0(Ubuntu 24.04.4 LTS)을 쓰는 DGX Spark 64GB, NVFP4, 사고(Thinking) 모드 켬, 배치 크기 1, 스트리밍 요청 1개, 출력 128토큰 제한입니다. 생성 속도는 첫 토큰까지의 시간을 뺀 요청당 평균 토큰 생성률이고, DSpark는 초안 토큰 3개를 썼습니다. DSpark를 켰을 때 추론 중 시스템 전체 메모리 사용량의 최고치는 운영체제를 포함해 27.9GB였습니다. 원문은 SpeedBench라고만 적었는데, NVIDIA가 공개한 SPEED-Bench 데이터셋에 throughput_1k와 throughput_2k 구성이 있습니다.
표에서 확인할 수 있는 것은 세 가지입니다:
-
첫 토큰 지연은 거의 그대로입니다. 세 워크로드 모두 0.6~2.1ms만 늘었으므로, 이 조건에서 DSpark의 비용은 입력 처리 단계에 거의 드러나지 않았습니다.
-
가속 폭은 워크로드에 따라 다릅니다. HumanEval 프롬프트가 1.73배로 가장 컸습니다. 초안 모델 카드에서도 코딩의 수락 길이(4.38)가 전체 평균(3.75)보다 길었습니다. 다만 본 모델 정밀도(BF16), 샘플링 설정, 초안 길이가 다르므로 같은 방향이라는 정도로만 읽어야 합니다.
-
측정 범위는 짧은 출력, 단일 요청입니다. 출력이 128토큰으로 잘렸으므로, 사고 모드에서 긴 응답을 끝까지 생성할 때의 속도는 이 표에 없습니다.
여러 요청을 동시에 처리할 때는 다른 결과가 나올 수 있습니다. 공식 성능 문서의 v0.10.0 DGX Spark 런타임 표(프리필 길이 66토큰, 배치 8은 8개 요청 합계 470토큰)에는 DSpark 행이 없지만, 같은 모델의 다른 추측 디코딩 방식이 있습니다:
| 디코딩 방식 | 배치 1 생성 속도 (tok/s) | 배치 8 생성 속도 (tok/s) |
|---|---|---|
| 추측 디코딩 없음 | 75.6 | 244.9 |
| MTP | 93.2 | 185.0 |
| DFlash | 61.5 | 149.2 |
배치 8에서는 두 방식 모두 추측 디코딩을 끈 쪽보다 느렸고, DFlash는 배치 1에서도 느렸습니다. NVIDIA는 모델 카드에서도 DSpark를 동시 요청이 적은 환경의 기본값으로 권하고, H100의 최대 처리량 서빙에서는 추측 디코딩을 쓰지 않는 쪽이 가장 빠르다고 적었습니다. 따라서 여러 사용자가 함께 쓰는 서버라면, 함께 켤 수 없는 DSpark(요청 하나씩 처리)와 인플라이트 배칭 중 하나를 실제 동시 요청 수에서 측정해 골라야 합니다.
Jetson Thor로 옮길 때 알아둘 점
원문은 DGX Spark에서 개발한 것을 Thor 계열 장치로 옮기는 과정을 공식 문서 참고로 안내합니다. 문서에서 확인한 조건은 다음과 같습니다:
-
엔진은 배포 장치에서 다시 빌드합니다. 휠 지원 표에서 DGX Spark는 SM121, Jetson Thor는 SM110으로 GPU 구조가 다릅니다. 설치 문서는 플러그인 바이너리를 공유하더라도 TensorRT 엔진은 아키텍처별로 다르다고 밝히고, 퀵스타트 문서도 엔진 빌더를 대상 장치에서 실행하라고 안내합니다. 그대로 가져갈 수 있는 것은 체크포인트, 명령, 서버 설정이고, DGX Spark에서 만든 엔진 파일은 아닙니다.
-
원문의 서버 경로는 실험 단계 빌더를 씁니다. 서버 문서에 따르면 캐시에 엔진이 없을 때 서버는 내부적으로
trtedge build를 실행합니다. 개요 문서는 이 직접 빌더를 실험 단계로,trtedge export로 ONNX를 만든 뒤 C++ 빌더로 엔진을 만드는 경로를 지원되는 배포 경로로 구분합니다. NVIDIA는 개요 문서에서 C++ 런타임을 Python 의존성이 없는 구조로 소개합니다. -
Jetson Orin에서는 이 체크포인트를 쓸 수 없습니다. 지원 모델 문서에 따르면 Jetson Orin은 FP16, INT8, INT4만 실행하며, FP8, MXFP8, FP4, NVFP4 체크포인트를 고르지 말라고 안내합니다. 원문 모델은 NVFP4 체크포인트입니다.
-
Thor와 DGX Spark의 디코딩 속도는 비슷한 범위였습니다. 성능 문서의 v0.10.0
llm_bench표를 보면, 배치 1 디코딩 속도는 Jetson AGX Thor 80.7 tok/s, DGX Spark 74.3 tok/s였습니다. 2,048토큰 입력 처리 시간은 각각 376.5ms와 280.0ms였습니다. 한 모델, 한 설정의 결과이므로 다른 모델에도 같은 비율이 성립한다고 볼 수는 없습니다.
텍스트 생성 모델은 trtedge chat 뒤의 체크포인트 ID를 바꿔 시험할 수 있습니다. trtedge chat은 텍스트 채팅용이므로, 음성 인식, 음성 합성, 행동 모델은 문서의 모델별 예제 절차를 따라야 합니다. 접근 제한(Gated) 모델은 제공자 약관에 동의하고 hf auth login을 먼저 실행해야 합니다. 지원 모델 목록에는 Qwen3.5, Gemma 4 같은 텍스트와 비전 언어 모델이 있습니다. Qwen3-ASR, Nemotron-3.5-ASR 같은 음성 인식 모델과 Qwen3-TTS 음성 합성 모델, pi0.5와 Alpamayo 같은 행동 모델도 있습니다.
0.11.1에서는 Nemotron 3.5 Bolt E4B와 그 DFlash 초안 모델도 추가되었습니다. 다만 문서는 MoE, 멀티모달, 음성 모델은 목록에 있는 행만 지원하고, 목록의 모든 체크포인트를 모든 플랫폼과 정밀도에서 검증하지는 않았다고 밝힙니다.
TensorRT Edge-LLM과 Nemotron 3.5 Lightning의 라이선스
TensorRT Edge-LLM은 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. Nemotron 3.5 Lightning과 DSpark 초안 모델은 OpenMDW-1.1 라이선스를 따르며, 모델 카드는 상업적 사용이 가능하다고 밝힙니다.
 원문 블로그: Run AI Models for Edge Application Development with Just a Few Commands
 TensorRT Edge-LLM GitHub 저장소
 TensorRT Edge-LLM 공식 문서
TensorRT Edge-LLM 지원 모델 목록
 Nemotron 3.5 Lightning 30B-A3B NVFP4 모델 (Hugging Face)
Nemotron 3.5 Lightning용 DSpark 초안 모델 (Hugging Face)
DSpark 논문
더 읽어보기
-
NVIDIA, 40개 언어 받아쓰기와 화자 구분, 번역을 한 모델로 처리하는 Nemotron 3.5 Transcribe 공개 (feat. Granary v2)
-
NVIDIA, 4GB VRAM에서 동작하는 대화형 에이전트용 소형 모델 Nemotron 3.5 Bolt E4B 공개 (feat. Gemma 4)
-
NVIDIA가 정리한 AI 에이전트 평가: 도구 호출 정확도 대신 과업 완수를 채점하는 지표들과 트레이스 읽는 법
-
Liquid AI, VLM 디코딩 속도를 2.66~3.13배 가량 높인 LFM2.5-VL-3B-DSpark 모델 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
