핵심 요약
- NVIDIA가 2026년 10월 28일 Nemotron 3.5 Transcribe 소개 글과 함께 음성 모델을 OpenMDW-1.1 라이선스로 공개했습니다. 녹음된 음성의 받아쓰기, 화자 구분, 번역, 오디오 질의응답을 체크포인트 하나로 처리합니다.
- 40개 언어를 받아쓰고, 31개 언어를 영어와 상호 번역하며, 13개 언어에서 화자를 구분합니다. 한국어는 이 작업을 모두 지원하며 모델 카드의 최상위 품질 등급(Leading)입니다.
- 실시간 스트리밍 모델이 아니라 최대 1시간 길이의 녹음 파일을 처리하는 오프라인 모델입니다. 공식 예제는 H100 80GB 1장 기준이고, RTX 5090 같은 소비자 GPU에서는 NVFP4 체크포인트만 지원합니다.
- 함께 공개한 Granary v2는 48개 언어 463,062시간의 라벨 매니페스트입니다. 다만 한국어 매니페스트는 FLEURS와 Common Voice 두 출처의 약 8.9시간뿐이라, 한국어 미세조정 데이터로 쓰기에는 부족합니다.
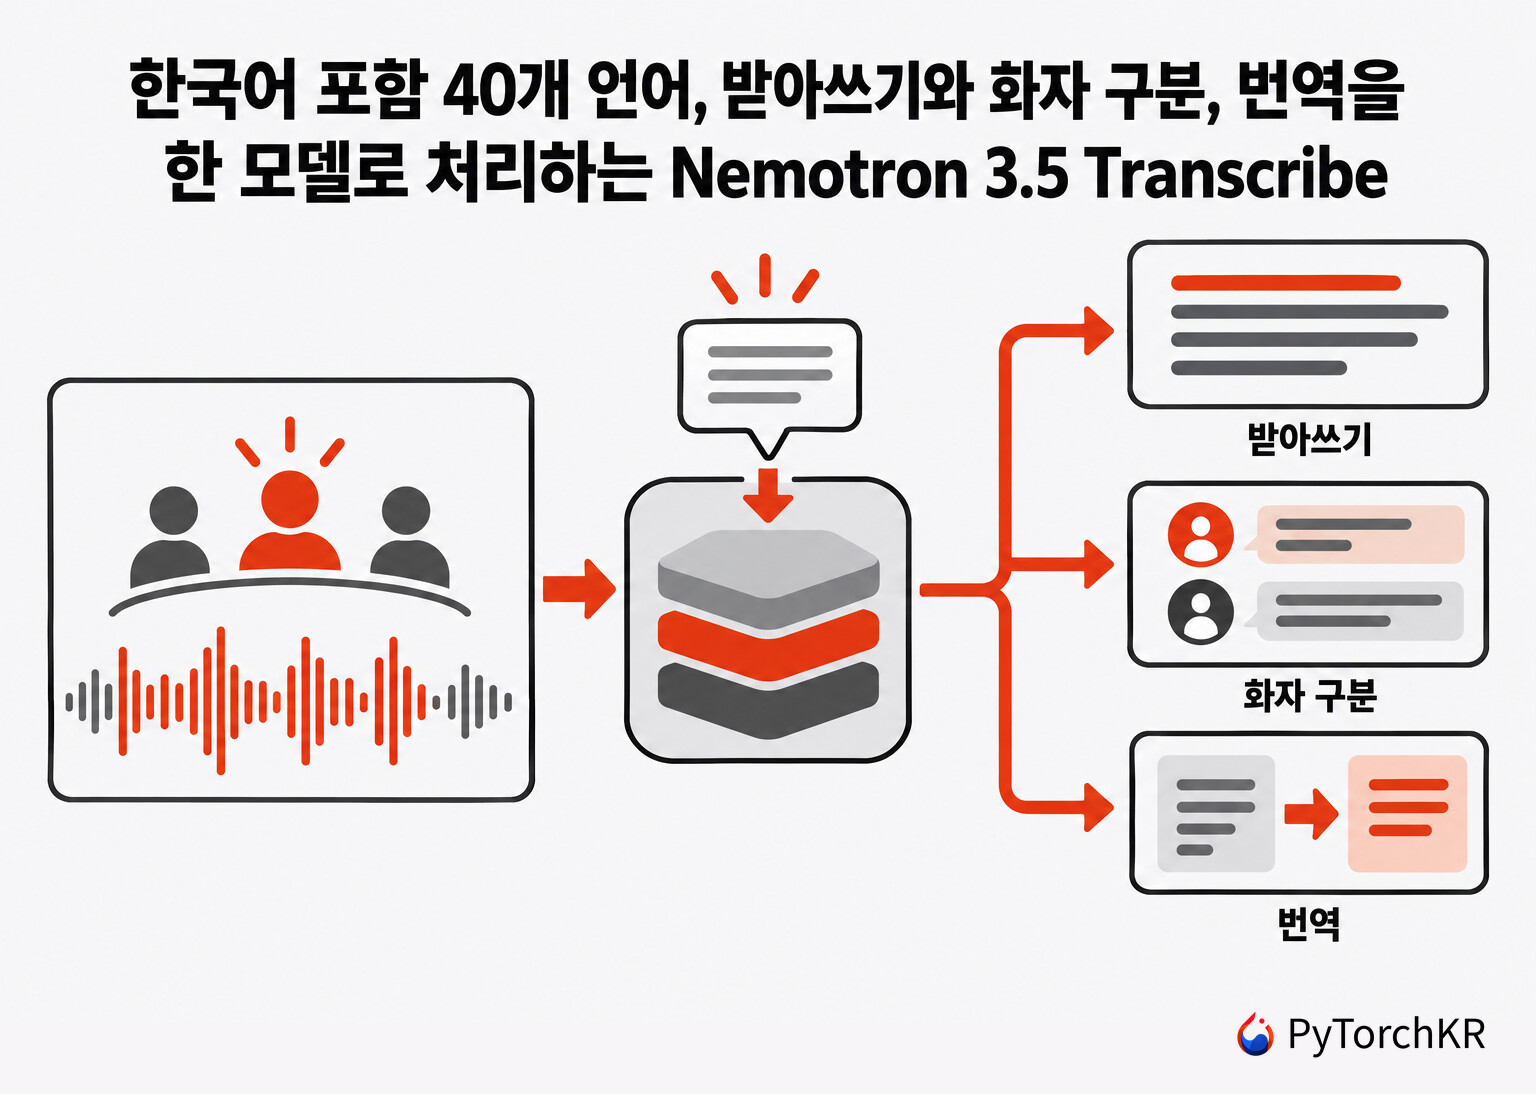
Nemotron 3.5 Transcribe 소개
Nemotron 3.5 Transcribe는 녹음 파일과 자연어 지시문을 함께 받아, 지시문이 요구하는 형태의 텍스트를 돌려주는 NVIDIA의 가중치 공개 음성 모델입니다. 같은 회의 녹음이라도 "화자를 구분해 받아써 줘", "영어로 번역해 줘", "이 회의에서 무엇이 결정됐어?" 처럼 지시문만 바꾸면 서로 다른 결과물을 얻을 수 있습니다.
지금까지 녹음 파일에서 쓸 만한 회의록을 만들려면 여러 모델을 이어 붙여야 했습니다. Whisper나 Parakeet 같은 음성 인식(Automatic Speech Recognition, ASR) 모델로 받아쓰고, pyannote 같은 화자 분리(Speaker Diarization) 모델로 누가 언제 말했는지 찾습니다. 그다음 강제 정렬기로 단어마다 시간을 붙이고, 번역 모델을 따로 실행합니다. 화자 분리는 녹음 안에서 서로 다른 목소리를 나누어 구간마다 화자 표시를 붙이는 작업입니다. 단계가 늘어날수록 배포할 모델이 늘고, 앞 단계의 오류가 뒤 단계로 그대로 넘어갑니다.
Nemotron 3.5 Transcribe는 이 단계들을 음성 증강 언어 모델(Speech-Augmented Language Model, SALM) 하나로 합칩니다. SALM은 음성 인코더의 출력을 대규모 언어 모델(LLM)의 입력으로 넣어, LLM이 지시문을 읽고 음성을 텍스트로 풀어 쓰게 하는 구조입니다. 기존 ASR 모델은 숫자를 twenty-five 로 쓸지 25 로 쓸지, 머뭇거림을 남길지 같은 표기 규칙을 학습할 때 하나로 고정합니다. SALM은 이 규칙을 요청할 때마다 지시문으로 바꿀 수 있습니다. 기술 보고서는 이 점을 "녹음에 대한 하나의 정답 대본은 없다" 는 문장으로 시작합니다.
NVIDIA는 모델과 함께 학습 데이터 파이프라인과 데이터 일부, 그리고 미세조정(Fine-tuning) 도구를 같이 공개했습니다. 학습 데이터를 만든 Granary v2 의 매니페스트와 NeMo Curator 파이프라인, 그리고 NeMo Speech의 미세조정 튜토리얼과 에이전트 스킬입니다. 이 글은 모델의 구조와 한국어 지원 수준, 벤치마크의 측정 조건, 실제로 실행하는 방법, Granary v2와 의료 도메인 미세조정 사례를 차례로 정리합니다. 같은 범주의 모델로는 앞서 소개한 Cohere Transcribe와 가중치를 공개하지 않은 Microsoft MAI-Transcribe-2가 있습니다.
Nemotron 3.5 Transcribe의 모델 구성
모델은 크게 세 부분으로 이뤄집니다. 오디오를 받는 병렬 전문가 인코더(Parallel Expert Encoder), 글을 쓰는 Nemotron 3.5 Lightning 30B-A3B 언어 모델, 그리고 생성이 끝난 뒤 단어마다 시간을 붙이는 CTC(Connectionist Temporal Classification) 타임스탬프 헤드입니다.
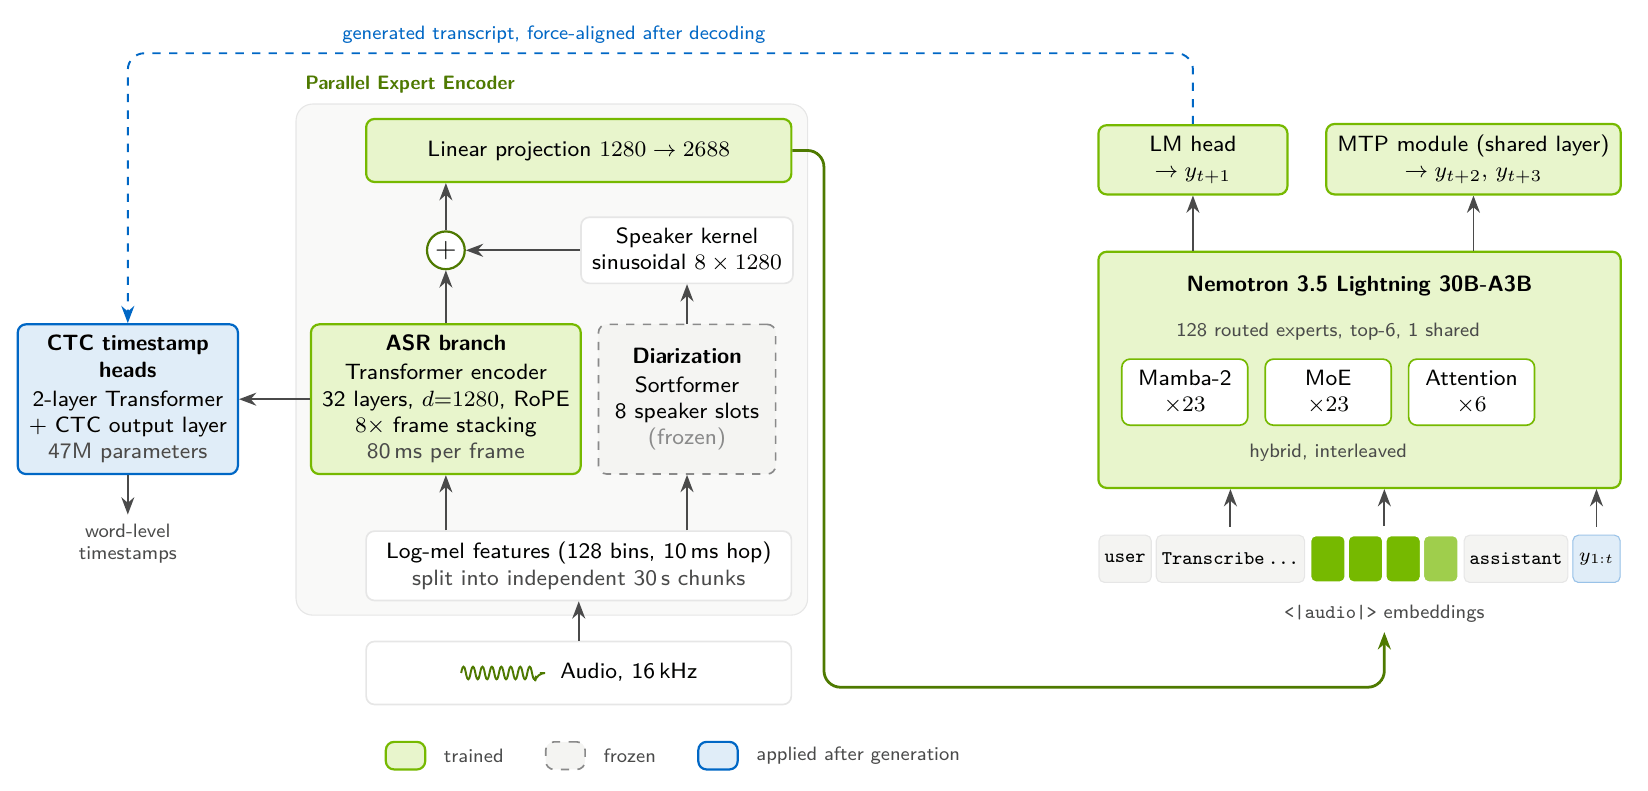
인코더 안에는 두 갈래가 있습니다. 32층 Transformer로 된 ASR 브랜치는 소리의 내용을 담은 특징을 만듭니다. 학습 중에 고정해 둔 Nemotron 3 Diarization 모델(Sortformer 구조, 화자 슬롯 8개)은 누가 말하는지에 대한 신호를 만듭니다. 두 신호를 더한 뒤 언어 모델로 넘기기 때문에, 언어 모델은 글자를 생성하는 동안 화자 표시(<spk:0>, <spk:1> 등)를 직접 붙일 수 있습니다. 받아쓰기를 먼저 끝낸 뒤 별도 단계에서 화자를 단어에 맞추는 기존 방식과 다른 점입니다.
언어 모델 쪽은 Mamba-2 층과 전문가 혼합(Mixture of Experts, MoE) 층, Attention 층을 섞은 하이브리드 구조입니다. MoE는 토큰마다 여러 전문가 하위 네트워크 중 일부만 골라 계산하는 방식이라, 전체 매개변수보다 훨씬 적은 수만 실제로 계산에 쓰입니다. 모델 카드 기준 전체 매개변수는 오디오 인코더를 포함해 34B이고, 토큰마다 계산에 쓰이는 활성 매개변수는 약 4.3B(언어 모델 약 3.5B, 오디오 인코더 약 0.8B)입니다. 블로그는 30B 중 약 4B가 활성이라고 적었는데, 이 30B는 언어 모델인 Nemotron 3.5 Lightning의 크기입니다.
| 항목 | 내용 |
|---|---|
| 매개변수 | 전체 34B, 활성 약 4.3B (오디오 인코더 포함) |
| 입력과 출력 | 오디오와 텍스트 입력, 텍스트 출력 (선택적으로 단어 타임스탬프) |
| 길이 한도 | 최대 1시간 녹음, 컨텍스트 65,536 토큰 |
| 화자 구분 | 최대 8명 |
| 정밀도 | BF16, FP8, NVFP4 |
| 투기적 디코딩 | 내장 MTP, 선택적으로 DFlash2 초안 모델 |
| 라이선스 | OpenMDW-1.1 |
투기적 디코딩(Speculative Decoding) 은 작은 초안 모듈이 다음 토큰 여러 개를 먼저 제안하고, 본 모델이 한 번에 검증해 생성 속도를 높이는 방법입니다. 이 모델은 체크포인트 안에 다중 토큰 예측(Multi-Token Prediction, MTP) 모듈을 갖고 있어 별도 초안 모델 없이도 이 방법을 쓸 수 있습니다.
모델 카드는 이 모델이 오프라인 모델이라는 점을 반복해서 강조합니다. 인코더가 내부적으로 오디오를 30초 단위로 나눠 처리하지만, 이것은 처리 방식일 뿐 실시간 스트리밍 음성 인식을 지원한다는 뜻이 아닙니다. 실시간 자막이나 음성 비서처럼 말하는 도중에 결과가 필요하다면 NVIDIA의 별도 스트리밍 모델인 Nemotron 3.5 ASR Streaming(600M, 한국어 지원)을 봐야 합니다.
지시문으로 결과 형식을 고르는 방법
이 모델을 쓰는 방식의 핵심은 지시문입니다. 모델 카드는 받아쓰기와 번역에서는 시스템 프롬프트를 비워 두고, 지시문을 오디오와 함께 사용자 메시지에 넣으라고 안내합니다. 아래 표는 모델 카드의 프롬프트 가이드에서 자주 쓸 항목만 옮긴 것입니다.
| 필요한 결과 | 사용자 메시지에 넣는 지시문 (모델 카드 원문) |
|---|---|
| 들리는 그대로의 대본 | Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only. |
| 읽기 쉽게 다듬은 대본 | Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only. |
| 도메인 용어 반영 | Transcribe with punctuation and capitalization. Context terms: <names and terms>. |
| 누가 언제 말했는지 | Transcribe this audio with punctuation and capitalization. Include all spoken words and verbal fillers. Write numbers in their standard written form. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription. (요청에서 단어 타임스탬프도 켬) |
| 다른 언어로 번역 | Please translate the given speech to <target language>. |
| 녹음에 대한 답변 | 오디오에 대한 구체적인 질문을 쓰고 추론(reasoning)을 켬 |
모델 카드는 받아쓰기, 번역, 언어 식별에는 온도 0과 추론 끄기(enable_thinking=False)를, 오디오 질의응답에는 온도 0.6, top-p 0.95와 추론 켜기를 권장 설정으로 제시합니다. 원문 블로그는 학습 전에 지시문으로 먼저 해결해 보라고 권하며 의료 대화 예시를 듭니다. 후보 용어를 주면서, 오디오가 뒷받침할 때만 그 용어를 쓰라는 조건을 함께 붙이는 형식입니다.
Transcribe this medical discussion in the original language. Possible terms: HbA1c, metformin. Use these terms only when supported by the audio. Preserve standard medical spelling and write numbers in conventional written form.
용어 힌트의 효과는 모델 카드의 문맥 ASR 결과에서 확인할 수 있습니다. ContextASR-Bench에서 고유명사 단어 오류율은 힌트가 없을 때 12.21%, 세부 용어 목록을 줬을 때 2.20%입니다. 기술 보고서 초록이 고유명사 오류를 6배 줄였다고 적은 것이 이 ContextASR-Bench 결과입니다. Contextual Earnings22의 키워드 재현율은 힌트 없이 58.16%, 녹음별 용어를 줬을 때 96.05%입니다.
다음 영상은 NVIDIA가 원문에 올린 데모입니다. 대사가 빠르게 겹치는 것으로 유명한 1940년 영화 'His Girl Friday'의 한 장면을 받아쓰면서 겹치는 발화까지 화자별로 표시합니다.
https://huggingface.co/buckets/nvidia/nemotron-transcribe-storage/resolve/blog/piotr-demo.mp4
원문은 다른 음성 모델과 마찬가지로 이름, 화자 전환, 답변은 녹음과 대조해 확인하라고 적고 있습니다. 모델 카드의 사용 사례 절도 화자 표시는 녹음 안에서 화자를 구별할 뿐 실제 인물의 신원을 확인하지 않는다고 밝힙니다.
Nemotron 3.5 Transcribe의 한국어 지원 수준
한국어 사용자에게 가장 중요한 정보는 모델 카드의 언어 지원표입니다. 모델 카드는 40개 언어를 Leading(별도 조정 없이 최고 수준 또는 그에 근접), Production-ready(제품 수준), Supported(지원하지만 미세조정이 필요할 수 있음) 세 등급으로 나눕니다. 한국어는 받아쓰기, 영어와의 상호 번역, 다화자 받아쓰기, 코드 스위칭(Code-switching) 네 항목을 모두 지원하는 Leading 등급입니다. 코드 스위칭은 한 녹음 안에서 두 언어 이상을 섞어 말하는 경우를 뜻합니다. 같은 Leading 등급에는 영어, 독일어, 프랑스어, 스페인어, 힌디어 등 13개 언어가 있고, 일본어는 Production-ready, 중국어(만다린)는 Supported 등급입니다.
| 한국어 항목 | 결과 | 출처 |
|---|---|---|
| FLEURS 받아쓰기 | CER 2.78% | 모델 카드 |
| FLEURS 언어 식별 | 정확도 100% | 모델 카드 |
| FLEURS 음성 번역 (한국어 → 영어) | BLEU 24.23 (번역 품질 지표, 높을수록 좋음) | 모델 카드 |
| FLEURS 음성 번역 (영어 → 한국어) | BLEU 27.68 | 모델 카드 |
| 대화 음성 단어 타임스탬프 F1 (200ms 허용) | 83.78% (Qwen3-ASR-1.7B + Qwen3-ForcedAligner 79.44%, Whisper-large-v3 + FasterWhisper DTW 49.15%) | 기술 보고서, NVIDIA 비공개 평가셋 MCS |
| 두 화자 대화의 화자 분리 DER | 19.35% (Nemotron 3 Diarization 19.32%) | DAI-ASR-I18N 리더보드 |
| 두 화자 대화의 화자별 받아쓰기 cpCER | 8.28% (MAI-Transcribe-2 4.44%) | DAI-ASR-I18N 리더보드 |
| 학습에 쓴 한국어 오디오 | 고유 약 22.9천 시간, 전체 노출의 1.77% | 기술 보고서 Table 2 |
타임스탬프 행의 MCS는 NVIDIA 내부 평가셋이고, 기술 보고서는 일부 정답 타임스탬프를 Qwen 정렬기로 만들었다고 밝혀 두었습니다.
한국어 받아쓰기 오류는 단어가 아니라 문자 오류율(Character Error Rate, CER) 로 측정했습니다. 모델 카드는 중국어, 일본어, 한국어, 태국어, 베트남어에 CER을, 나머지 언어에 WER을 씁니다. 따라서 영어 WER 수치와 한국어 CER 수치를 나란히 놓고 비교하면 안 됩니다.
모델 카드와 기술 보고서의 공개 다화자 벤치마크는 영어와 만다린뿐이라, 위 표의 한국어 화자 구분 수치는 David AI의 리더보드 데이터에서 옮겼습니다. 이 평가셋은 두 사람이 각자 마이크로 녹음한 대화를 한 채널로 합친 오디오이므로, 여러 사람이 마이크 하나를 쓰는 회의실 녹음과는 조건이 다릅니다. 또한 오디오 질의응답, 추론, 음성 지시 수행은 영어로만 평가했고, 모델 카드는 "다른 언어에서는 안정적으로 동작하지 않을 수 있다" 고 적었습니다. 한국어 회의 녹음을 받아쓰는 용도와 한국어로 녹음 내용을 질문하는 용도는 따로 검증해야 합니다.
벤치마크 결과와 측정 조건
NVIDIA는 무엇을 말했는지(받아쓰기)와 누가 말했는지(화자 구분) 양쪽에서 외부 리더보드와 모델 카드의 자체 측정 결과를 제시합니다. 숫자마다 측정 주체와 비교 대상이 달라서, 출처를 나눠 정리합니다.
| 벤치마크 | Nemotron 3.5 Transcribe | 비교 대상 | 측정 주체 |
|---|---|---|---|
| Hugging Face Open ASR, 영어 평균 WER | 5.33% | 가중치 공개 모델 중 1위 (API 모델 제외) | Hugging Face 리더보드 |
| Open ASR 영어 9개 데이터셋 평균 WER | 4.71% | Qwen3-ASR-1.7B 4.94% | NVIDIA 모델 카드 |
| Open ASR 다국어 7개 언어 평균 WER | 4.62% | Qwen3-ASR-1.7B 6.49% | NVIDIA 모델 카드 |
| Open ASR 장문 평균 WER | 10.98% | Parakeet-TDT-0.6B-v3 13.37% | NVIDIA 모델 카드 |
| Artificial Analysis AA-WER | 2.8% | 활성 24B 모델과 가중치 공개 모델 공동 1위 | Artificial Analysis |
| DAI-ASR-I18N 21개 언어 DER | 18.26% | Nemotron 3 Diarization 18.38% (15개 시스템 중) | David AI |
| VoiceArena Diarization-Bench 영어 cpWER | 32.4% | Multitalker Parakeet + Nemotron 3 Diarization 34.2% (14개 시스템 중) | VoiceArena |
영어 Open ASR 수치가 두 개인 점에 주의해야 합니다. 원문 블로그의 Figure 1은 리더보드 화면의 평균 WER 5.33%를 보여 주고, 모델 카드는 NVIDIA가 2026년 10월 12일에 측정한 9개 데이터셋 동일 가중 평균 4.71%를 적었습니다. 원문은 두 값의 차이를 설명하지 않으므로, 다른 모델과 비교할 때는 같은 출처의 수치끼리만 놓고 봐야 합니다.
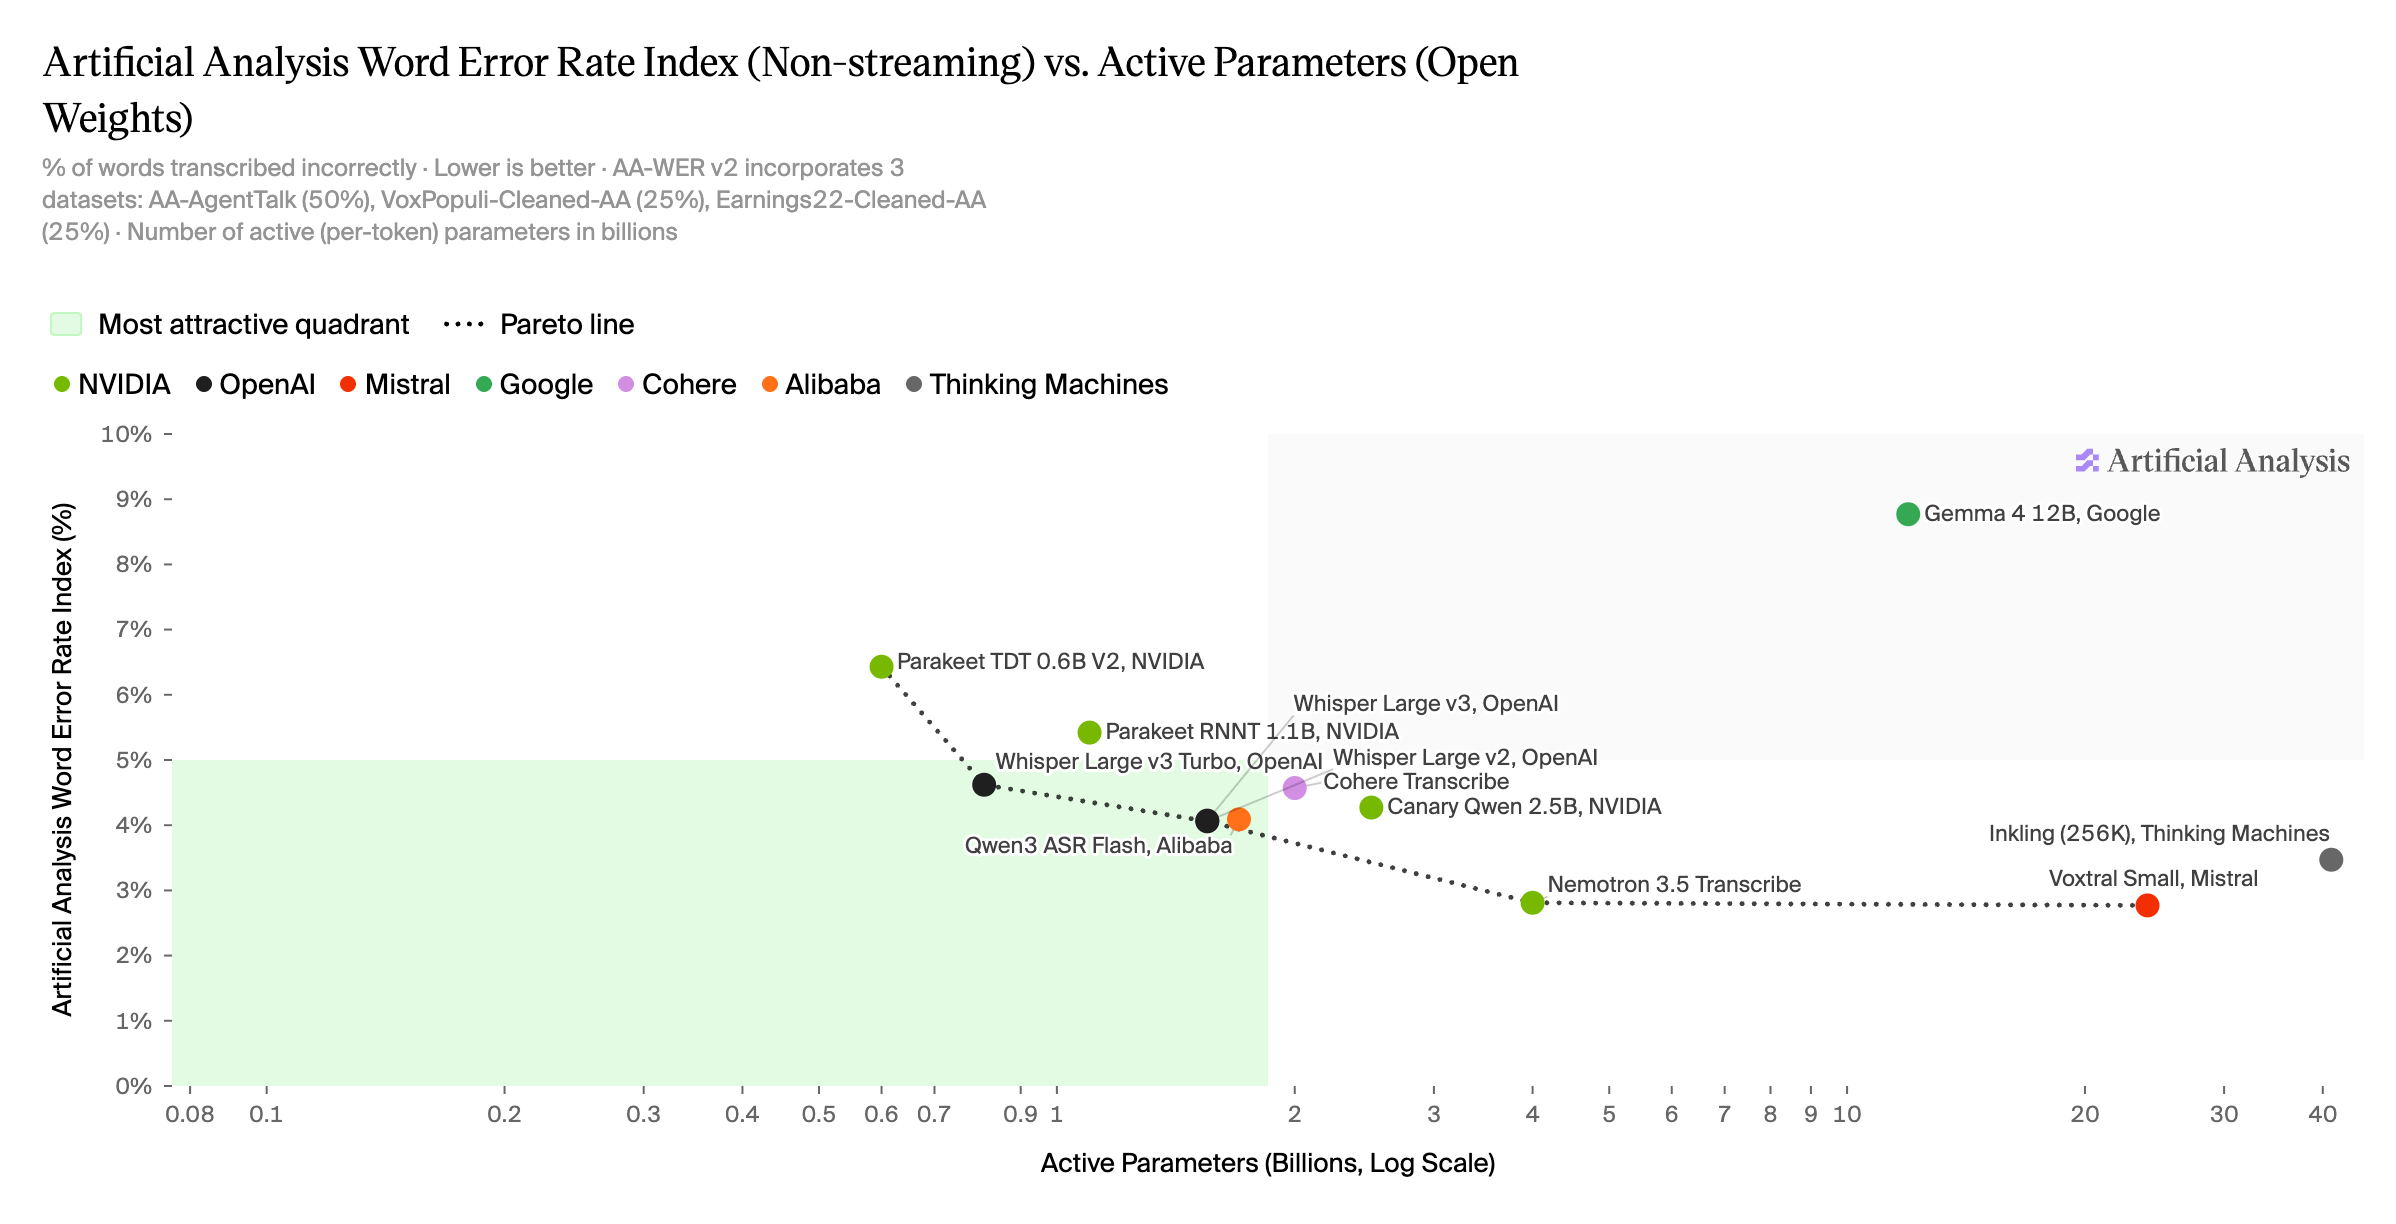
Artificial Analysis의 AA-WER은 음성 에이전트 대화 데이터인 AA-AgentTalk(50%)와 VoxPopuli, Earnings22 정제본(각 25%)을 합친 지수입니다. Nemotron 3.5 Transcribe는 2.8%로 활성 매개변수가 약 24B인 Mistral Voxtral Small과 같은 수준이고, AA-AgentTalk 단독으로는 1.8%(다음 가중치 공개 모델 2.3%)입니다. 같은 날 나온 NVIDIA 로컬 AI 블로그는 같은 결과를 1위 모델보다 활성 매개변수가 80% 적은 가중치 공개 모델 2위로 적었습니다.
화자 구분 결과에는 측정 지표 두 가지가 나옵니다. 화자 분리 오류율(Diarization Error Rate, DER) 은 화자별 발화 시간을 얼마나 잘못 배정했는지 잽니다. cpWER(concatenated minimum-permutation WER) 은 예측한 화자 표시를 정답 화자와 가장 잘 맞게 짝지은 뒤 단어 오류율을 계산합니다. cpWER은 받아쓰기와 화자 배정 오류를 함께 반영합니다.
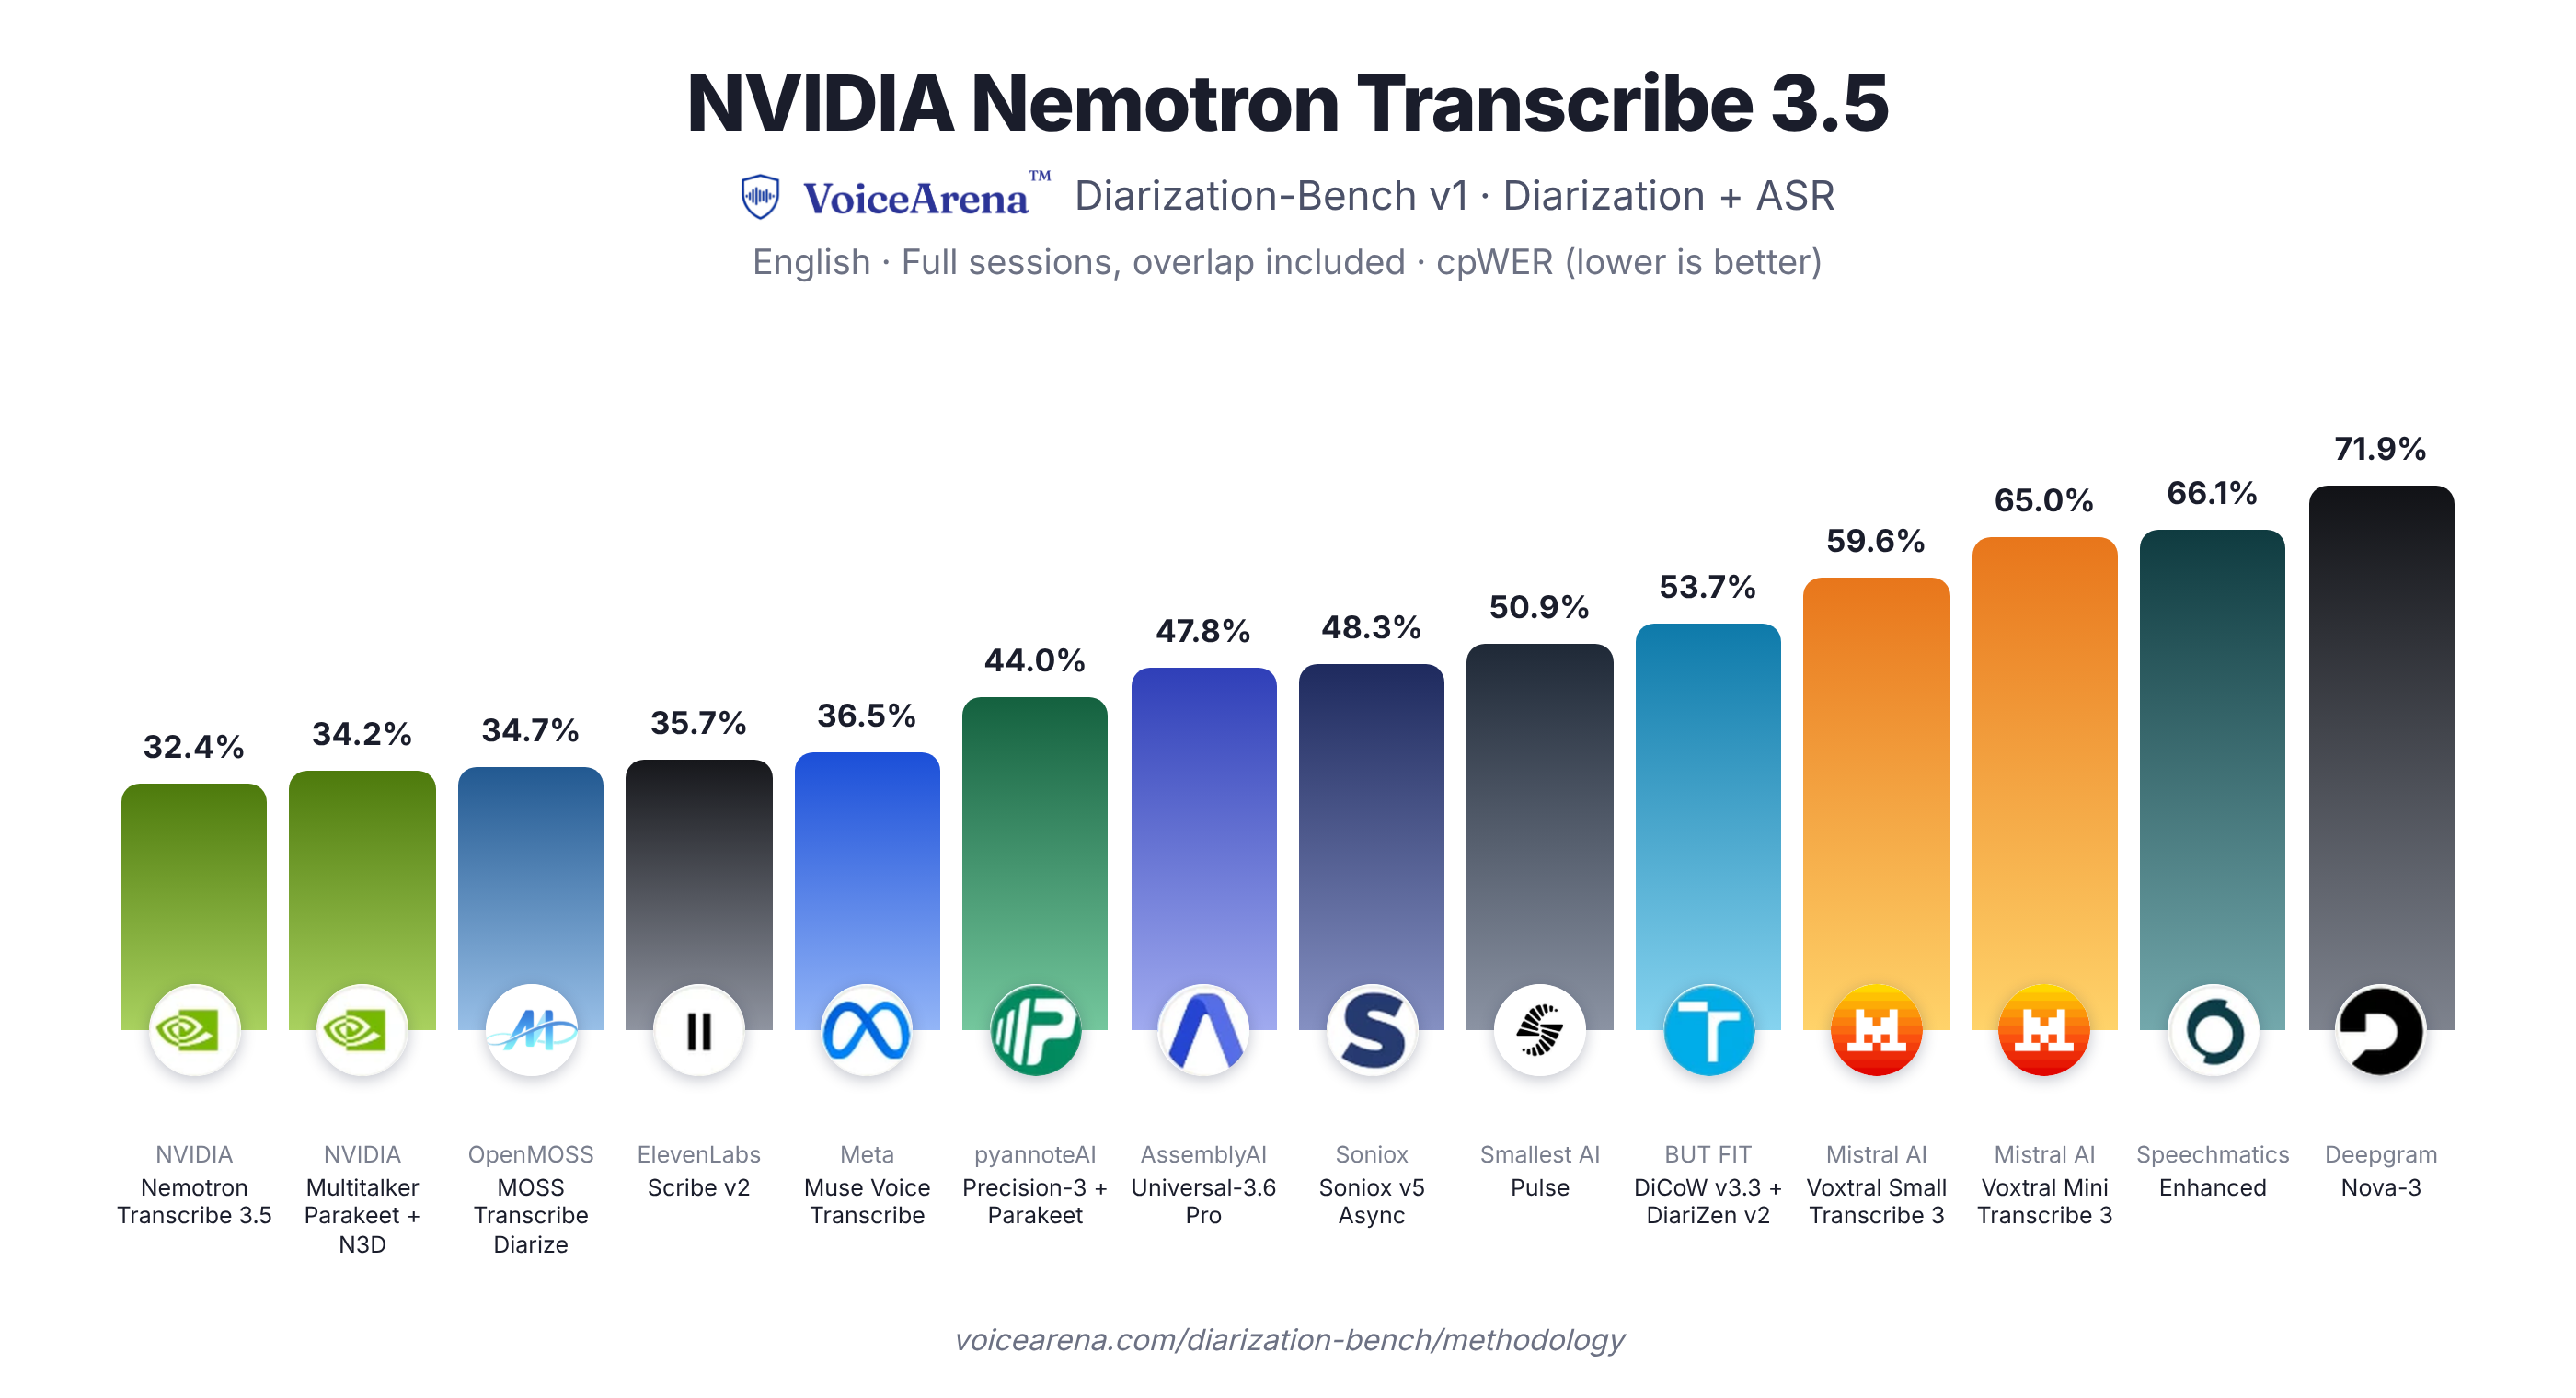
VoiceArena 결과에서 원문은 Nemotron 3.5 Transcribe가 대면 회의와 온라인 회의 조건 모두 1위였고, 누락한 단어가 정답 단어의 8.32%로 14개 시스템 중앙값(약 31%)보다 적었다고 설명합니다. DAI-ASR-I18N에서는 받아쓰기와 화자 구분을 함께 보는 통합 트랙에서 가중치 공개 모델 1위, 전체 2위였습니다. 21개 언어 평균 순위 기준이고, 1위는 가중치를 공개하지 않은 MAI-Transcribe-2입니다. 모델 카드는 학습 데이터에 David AI에서 라이선스를 받은 데이터가 들어 있지만 DAI-ASR-I18N 평가셋은 포함하지 않았다고 밝혀 두었습니다.
이 밖에 원문은 Ocular AI의 Converse-STT 평가에서 가중치 공개 모델 1위였다는 결과와, Josh Talks의 인도어 리더보드 Voice of India를 언급합니다. 호스팅 파트너인 DeepInfra는 Cekura의 비공개 평가셋 Ocular에서 WER 2.48%로 1위였다고 적었습니다.
Nemotron 3.5 Transcribe 실행 방법: vLLM, SGLang-Omni, Transformers, NeMo-Speech.cpp
자체 서버에서 실행하는 경로는 네 가지이고, 경로마다 지원하는 기능이 다릅니다. 단어 타임스탬프와 화자 구분까지 쓰려면 vLLM 경로를 써야 합니다.
| 실행 경로 | 쓰임새 | 제약 |
|---|---|---|
| vLLM 0.32.0 + NeMo Speech 플러그인 | OpenAI 호환 서버, 모든 작업과 단어 타임스탬프 | NeMo Speech main 브랜치 필요 |
| SGLang-Omni 0.2.0 | /v1/audio/transcriptions 파일 단위 받아쓰기, NeMo 불필요 |
타임스탬프, 화자 구분, 번역, 투기적 디코딩 미지원 |
| Hugging Face Transformers | 파이썬 프로세스 안에서 직접 호출 | 소스 설치(pip install git+...) 필요 |
| NeMo-Speech.cpp | ggml 기반 로컬 C++ 런타임, 네이티브 Windows 지원 | GGML 경로는 RTX 5090, RTX PRO 6000에서 지원 |
모델 카드의 빠른 시작 예제는 H100 80GB 1장에서 vLLM 0.32.0과 NeMo Speech main 브랜치로 서버를 띄웁니다. 먼저 모델 카드의 환경 설정 절차대로 NeMo Speech 저장소를 받아 uv로 가상 환경을 만들고 체크포인트를 내려받아야 합니다. 그 상태에서 아래 명령으로 서버를 실행합니다.
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
# Word timestamps require the V1 model runner.
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
vLLM은 기본값으로 600초가 넘거나 25MB가 넘는 오디오를 거부하므로, 1시간 녹음을 처리하려면 위의 두 환경 변수를 서버 쪽에 설정해야 합니다. --use-replayssm 은 Mamba 층의 상태를 매 단계 쓰지 않고 주기적으로만 저장해 투기적 디코딩을 빠르게 하는 옵션입니다. 자세한 원리는 앞서 정리한 ReplaySSM 글에 있습니다. 서버가 뜨면 OpenAI 호환 클라이언트로 요청을 보냅니다.
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("audio.wav", "rb").read()).decode()
response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
화자 표시를 받으려면 skip_special_tokens 를 False 로 둬야 합니다. 단어 타임스탬프가 필요하면 요청의 mm_processor_kwargs 에 capture_ctc_timestamps: True 를 넣고, 응답의 ctc_timestamps 객체에서 단어별 시작과 끝 시간, 화자 표시, 화자 분리 구간을 읽습니다. 모델 카드는 이 객체의 error 필드를 먼저 확인하라고 안내합니다. 밀도 높은 1시간 대화는 출력이 약 2만 토큰에 이를 수 있으므로, 긴 녹음에서는 max_tokens 를 늘리거나 빼야 대본이 잘리지 않습니다.
모델 카드는 드물게 생성이 끝나지 않고 같은 내용을 반복하는 경우가 있다고 밝히고, 최종 출력에 한 번 적용할 정규식 정리 함수(cleanup_generation_loops)를 제공합니다. 모델 카드의 받아쓰기, 번역, 언어 식별 결과도 이 함수를 적용한 수치입니다. SGLang-Omni 문서 역시 1시간짜리 녹음에서 문장이 16,384 토큰 한도까지 반복될 수 있고, 이때 HTTP 상태는 200이지만 finish_reason 이 length 로 표시된다고 경고합니다.
하드웨어와 양자화 체크포인트 선택
모델 카드의 하드웨어 표에 따르면 A100 80GB는 BF16, H100과 H200은 BF16과 FP8, Blackwell 데이터센터 GPU와 DGX Spark, Jetson Thor는 BF16, FP8, NVFP4를 모두 지원합니다. 소비자 GPU인 RTX 5090은 NVFP4만 지원하고, 기술 보고서는 RTX Spark 노트북도 NVFP4만 지원한다고 적었습니다. NVFP4 모델 카드는 이 체크포인트가 Blackwell GPU 전용이고 SGLang-Omni에서는 쓸 수 없다고 밝히며, FP8과 NVFP4 커널을 vLLM에서 쓰려면 CUDA 13 툴킷의 nvcc 가 PATH 에 있어야 합니다. 양자화(Quantization) 는 가중치를 더 적은 비트로 표현해 메모리와 계산량을 줄이는 방법인데, 비트를 줄일수록 정확도가 조금씩 떨어집니다.
기술 보고서는 GB300 1장에서 세 체크포인트를 같은 조건으로 비교했습니다. FP8은 77개 테스트셋에서 오류율이 BF16보다 평균 1.0%(상대값) 높았고, NVFP4는 평균 3.6% 높았습니다. 영어 Open ASR 평균은 세 정밀도가 4.70%, 4.74%, 4.73%로 거의 같지만, 다국어 Open ASR 평균은 4.63%, 4.75%, 4.90%로 NVFP4에서 차이가 커집니다. 기술 보고서는 "영어 외 언어의 정확도가 중요하면 FP8, 메모리나 처리량이 우선이면 NVFP4" 를 권합니다. 한국어 받아쓰기가 목적이라면 RTX 5090 같은 소비자 GPU에서는 정확도 손실이 더 큰 NVFP4만 쓸 수 있다는 점을 고려해야 합니다.
처리 속도 수치의 조건
원문 블로그는 RTX PRO 6000 Blackwell Server Edition GPU 1장이 NVFP4 버전으로 100시간 분량의 오디오를 3분 안에 처리했다고 밝혔습니다. 30초 길이 클립을 높은 동시 요청으로 보낸 결과입니다. 모델 카드는 같은 GPU에서 NVFP4와 DFlash2 조합이 초당 최대 2,238초 분량의 오디오를 처리하고, 30초 녹음의 대본을 0.13초에 돌려준다고 적었습니다.
모델 카드의 2,238 수치는 NVIDIA의 상용 추론 서비스인 Nemotron Transcribe NIM에 들어간 vLLM 최적화로 잰 결과이고, 원문은 100시간 측정에 쓴 서빙 구성을 밝히지 않았습니다. 모델 카드와 기술 보고서는 이 최적화가 아직 오픈소스에 포함되지 않았고, 공개일에 NeMo Speech로 배포된 vLLM 통합은 "대략 2배 느릴 것" 이라고 밝힙니다. 모델 카드의 vLLM 설정 절은 H100 80GB 1장, BF16, 조정한 서빙 설정에서 영어 일괄 처리 시 초당 처리한 오디오 시간(RTFx)을 MTP 2토큰 약 410, MTP 8토큰 약 270, DFlash2 7토큰 약 340으로 적었습니다.
자체 서빙 대신 호스팅 API를 쓸 수도 있습니다. DeepInfra는 OpenAI 호환 음성 인식 API로 제공하며 오디오 1분에 0.002달러(1시간에 0.12달러)를 받고, Baseten과 Simplismart에서도 쓸 수 있습니다. Simplismart는 자체 최적화로 H100 1장, FP8, 768개 동시 요청에서 RTFx 3,747을 얻었다고 밝혔습니다.
Granary v2: Transcribe를 학습시킨 데이터 파이프라인
지시문으로 표기 방식을 고를 수 있는 모델을 만들려면, 학습 데이터에도 같은 녹음에 대한 여러 표기의 정답이 있어야 합니다. Granary v2는 이 목적으로 만든 다국어 라벨 데이터입니다. 공개된 매니페스트는 16개 원천 코퍼스에서 48개 언어, 463,062시간 분량의 음성을 다루고, 이전 버전인 Granary v1의 25개 언어에서 늘었습니다. 원문은 이 수치가 공개 데이터셋의 규모일 뿐, Transcribe 전체 학습 데이터의 구성이나 표집 비율이 아니라고 밝힙니다.
Granary v2는 녹음마다 세 가지 대본을 만듭니다. 원문의 영어 예시와 함께, 실제 Granary v2 한국어 매니페스트에서 같은 차이를 보이는 한 줄을 옮겼습니다.
| 대본 형태 (필드 이름) | 원문 예시 | 한국어 매니페스트 예시 (Common Voice) |
|---|---|---|
들리는 그대로 정규화 (tn_raw) |
I paid, uh, twenty-five euros. | 안방에 모였던 다른 청년들도 서너 명이나 원재의 뒤를 따라 들어왔다. |
숫자와 기호로 바꾸고 머뭇거림 유지 (itn_raw) |
I paid, uh, €25. | 안방에 모였던 다른 청년들도 3~4명이나 원재의 뒤를 따라 들어왔다. |
숫자와 기호로 바꾸고 머뭇거림 제거 (itn_clean) |
I paid €25. | 안방에 모였던 다른 청년들도 3~4명이나 원재의 뒤를 따라 들어왔다. |
두 번째와 세 번째 형태는 역 텍스트 정규화(Inverse Text Normalization, ITN) 를 적용한 결과입니다. ITN은 서너 명 처럼 말로 읽은 표현을 3~4명 처럼 글로 쓰는 표기로 되돌리는 처리입니다. 대본 외에도 짧은 오디오 설명, 코드 스위칭 대본, 오디오에 근거한 질의응답 쌍, 문맥 ASR용 용어 목록, 품질 점수가 붙은 번역문을 함께 만듭니다.

파이프라인은 네 단계로 나뉩니다.
- 오디오 준비: 긴 녹음을 자르고, 녹음 전체에서 화자를 추적하고, 소리 이벤트와 언어를 표시합니다. Granary v2의 원천 데이터는 이미 잘려 있어 이번 공개에서는 이 단계를 건너뛰었습니다.
- 받아쓰기: 언어마다 주 ASR 모델과 복구용 모델을 정하고, 주 모델 결과가 환각(Hallucination) 검사를 통과하지 못하면 복구 모델로 넘어갑니다. 여기서 환각은 오디오에 없는 말을 대본에 지어내는 오류를 뜻합니다. 사람이 쓴 정답 대본이 있으면 그 철자를 살리면서 구어 형태와 머뭇거림을 더합니다.
- 작업 라벨 생성: 대본 변형을 만든 뒤 글자 속도, 환각 패턴, 모델 결과와 사람 정답의 일치도를 검사합니다. 검사를 통과한 레코드에만 문맥 ASR 용어와 번역을 붙입니다.
- 고품질 선별(HiFi): 잡음이 많거나, 잘렸거나, 여러 화자가 섞인 구간을 걸러 냅니다. VoxPopuli에서는 354k 시간을 22개 유럽 언어 111k 시간으로 줄였습니다.
4단계 결과는 Granary-HiFi로 따로 공개됐습니다. 데이터셋 카드는 음질 예측 점수(UTMOS), 화자 표시, 발음 기호 표기(IPA), 같은 화자의 참고 구간을 함께 제공한다고 적었고, 원문은 ASR 이외의 용도를 위한 데이터라고 설명합니다. 다만 VoxPopuli만 처리한 결과라 한국어는 없습니다.
파이프라인 코드는 NeMo Curator의 Granary v2 튜토리얼로 공개돼 있고, 원문은 Ray와 NVIDIA Dynamo 백엔드로 자체 녹음이나 이용 허락을 받은 공개 코퍼스에 돌릴 수 있다고 설명합니다. 튜토리얼은 메타데이터 추출, 인도어 ASR, Qwen3-Omni 기반 ASR, 텍스트 처리 네 갈래로 나뉩니다.
Granary v2를 쓸 때 확인할 점
Granary v2 저장소에는 오디오가 없고 라벨 매니페스트(압축된 JSONL)만 있습니다. 오디오는 각 원천 코퍼스의 배포처에서 그 라이선스에 따라 따로 받아야 합니다. NVIDIA가 만든 라벨은 OpenMDW-1.1을 따르지만, People's Speech 부분집합의 라벨은 CC BY-SA 4.0을 따릅니다. 또한 데이터셋 카드는 translations 필드에 키가 있어도 품질 검사에서 탈락하면 translation_raw 가 빈 문자열이라고 경고합니다. 번역 데이터로 쓰려면 이 값이 비어 있지 않은지 확인해야 합니다.
한국어로 쓰려는 독자라면 규모를 먼저 확인해야 합니다. Granary v2 저장소의 ko/ 디렉터리에는 FLEURS와 Common Voice 26.0 매니페스트 두 개만 있습니다. 이 글을 쓰며 두 파일을 내려받아 duration 필드를 합산해 보니 FLEURS 2,278개 레코드 약 7.85시간, Common Voice 624개 레코드 약 1.05시간으로 모두 약 8.9시간이었습니다. 그중 high_quality 표시가 붙은 레코드는 약 3.4시간입니다. 기술 보고서가 밝힌 한국어 학습 오디오 약 22.9천 시간의 대부분은 Granary v2 공개분 밖의 데이터입니다. 영어에서 한국어로 가는 번역 라벨은 영어 오디오 쪽 레코드에 31개 대상 언어 중 하나로 들어 있습니다.
도메인 적응: 인도 의료 음성 미세조정 사례
지시문만으로 해결되지 않는 전문 용어와 표기 규칙은 미세조정으로 다룹니다. NeMo Speech는 이 과정을 의료 ASR 사례 연구로 공개했습니다. 대상은 인도의 의사와 의대생이 녹음한 Eka Care 의료 ASR 평가셋으로, 3,619개 클립(8.4시간)이 있지만 학습용 분할이 없는 평가 전용 데이터입니다.
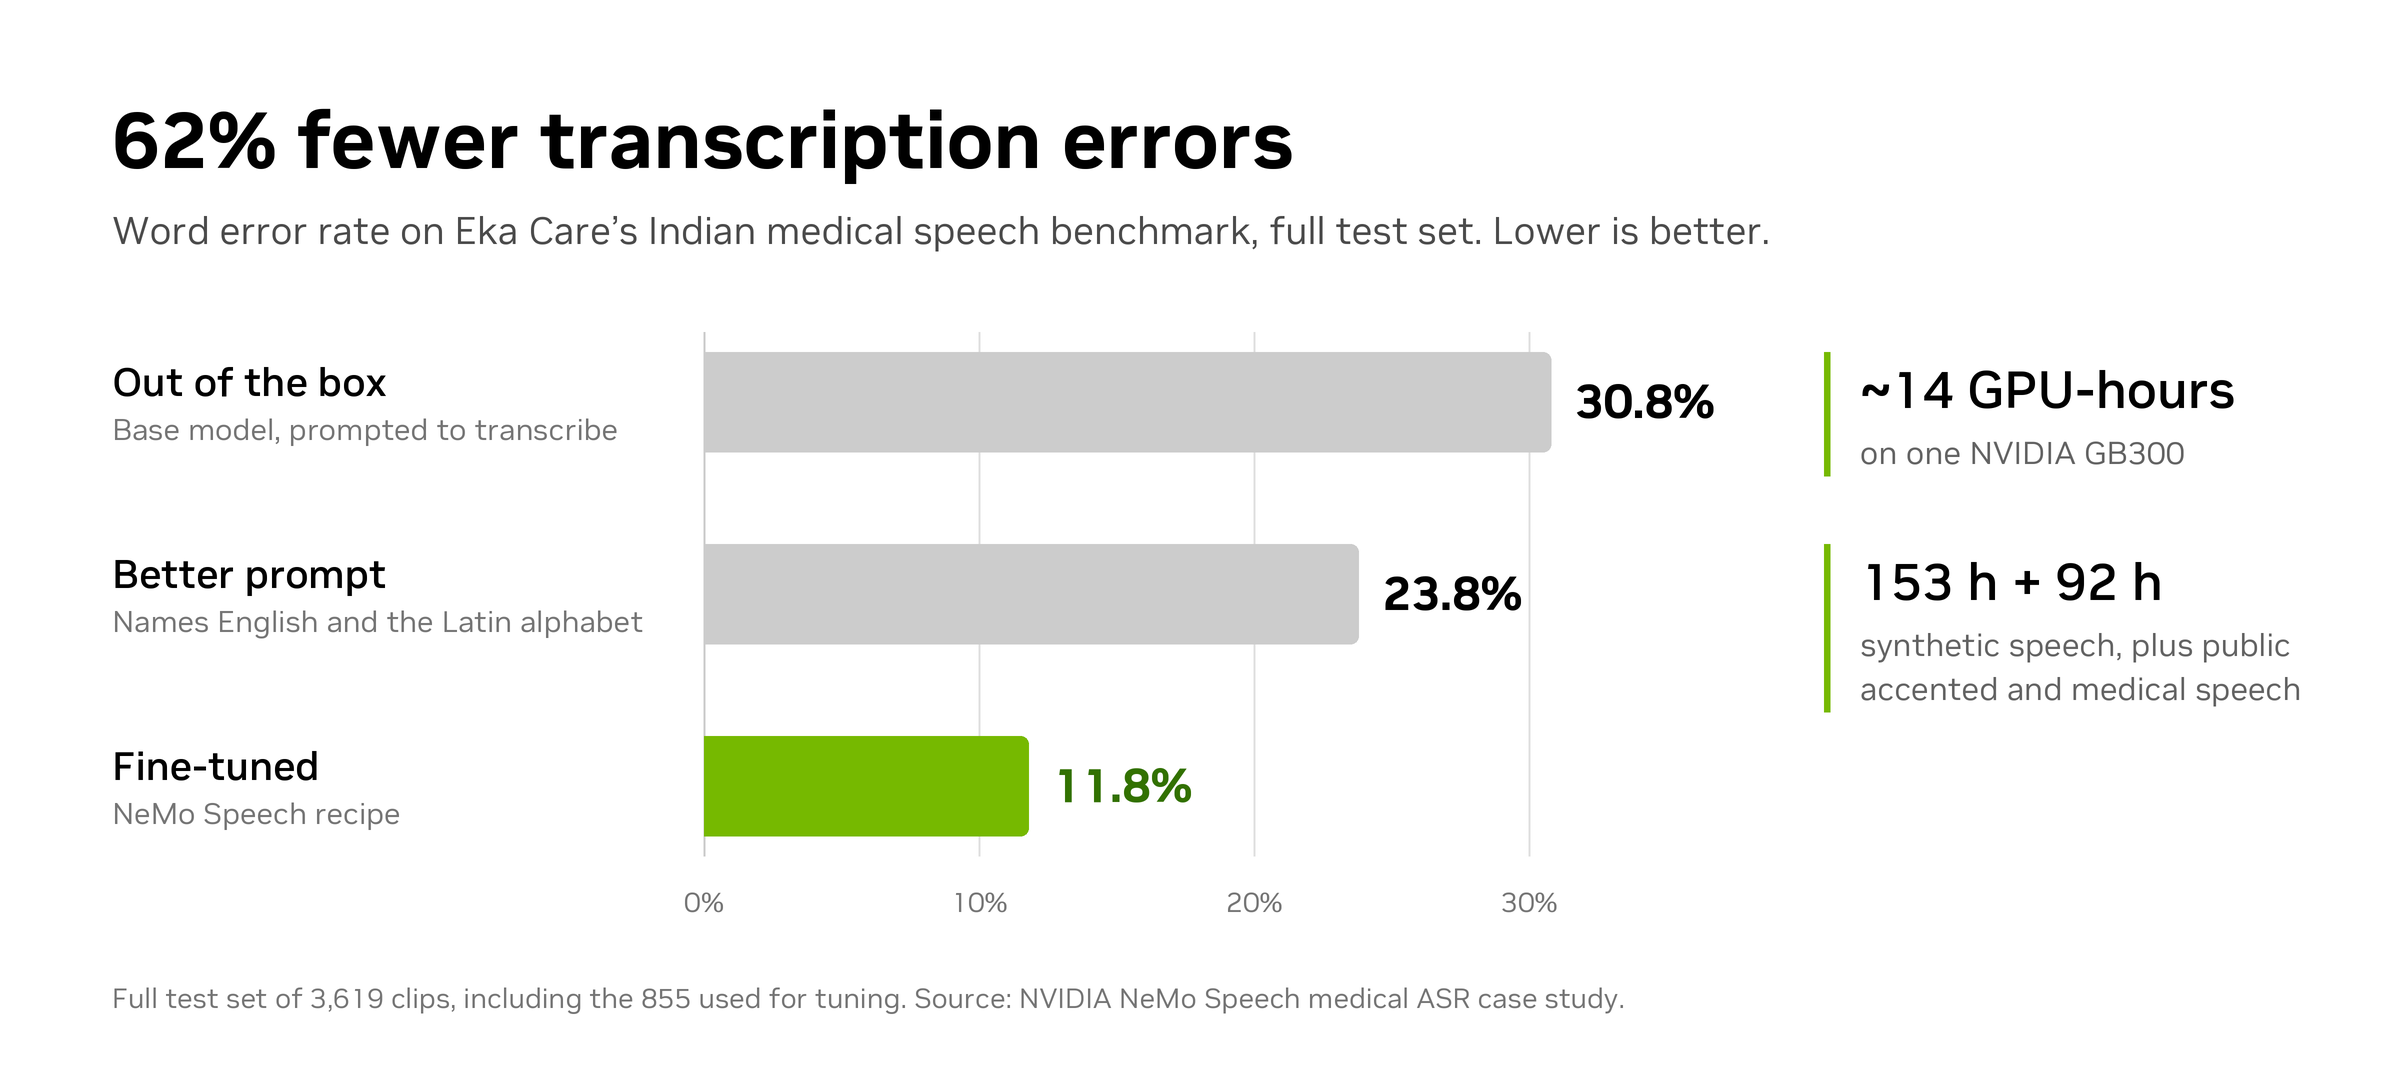
출발점은 지시문입니다. 기본 지시문으로 받아쓰면 WER이 30.8%였는데, 사례 연구에 따르면 모델이 인도 억양 영어 단어를 데바나가리나 타밀 문자로 쓰는 일이 잦았습니다. 지시문에 영어와 라틴 문자를 명시하자 23.8%로 내려갔습니다. 학습 데이터는 세 출처를 섞었습니다.
- 합성 음성 약 153시간: 오픈 LLM(gpt-oss-120b)이 쓴 의료 문장과 공개 인도 의약품 목록의 제품명으로 텍스트를 만들고, 여러 음성 합성(Text-to-Speech, TTS) 음성으로 읽혔습니다. 라벨은
HbA1c로 두고 TTS에는H B A one C처럼 읽는 형태를 넣어, 쓰는 형태와 말하는 형태를 분리했습니다. - 실제 음성 약 92시간: Common Voice의 인도 억양 영어 29시간과 MultiMed의 의료 강의와 인터뷰 63시간입니다.
- 표기 규칙을 바꾼 라벨: 숫자를 아라비아 숫자로 쓸지, 용량 단위를 붙여 쓸지, 브랜드명 하이픈을 남길지 같은 규칙을 레코드마다 바꾸고, 그 규칙을 지시문에 적었습니다. 일부 지시문에는 정답 철자와 비슷한 오답 후보를 섞은 용어 목록을 넣어, 오디오가 뒷받침할 때만 철자를 따라 쓰도록 학습시켰습니다.
평가셋 오염을 막기 위해 테스트 정답과 같거나 8단어 연속 구간이 겹치는 학습 텍스트는 모두 걸러 냈습니다. 학습은 음성 인코더와 투영층을 학습하고 언어 모델에는 LoRA를 적용했으며, 데이터 혼합 비율만 다른 두 모델을 평균해 최종 모델을 만들었습니다. 텍스트 생성부터 평가까지 GB300 1장으로 약 14 GPU 시간(사례 연구 기준 약 125달러)이 들었습니다.
평가는 화자를 기준으로 평가셋을 나눠, 지시문과 체크포인트 선택에 쓴 855개 클립과 한 번만 디코딩한 2,764개 클립으로 진행했습니다. 아래는 선택에 쓰지 않은 2,764개 클립의 결과입니다.
| 시스템 | WER | 키워드 WER | 브랜드 의약품명 정확히 맞춘 비율 |
|---|---|---|---|
| 기본 체크포인트, 최적 지시문 | 22.44% | 9.2% | |
| Whisper-large-v3 | 14.92% | 8.0% | |
| Parrotlet-a-en-5b (의료 특화 공개 모델) | 13.79% | 7.4% | 38.3% |
| 미세조정 모델 | 12.17% | 6.5% | 36.6% |
WER은 22.44%에서 12.17%로 45.8% 줄었고, 일반 영어 성능을 보는 LibriSpeech test-clean WER은 1.54%에서 1.69%로 조금 올랐습니다. 사례 연구는 한계도 함께 적었습니다. 브랜드 의약품명과 진단명에서는 의료 특화 모델이 여전히 앞섰고, 연구진은 의사가 브랜드명을 실제로 말하는 녹음이 다음 단계로 필요하다고 봅니다. 또한 합성 텍스트로 만든 개발셋은 엉뚱한 것을 보상할 수 있으므로, 체크포인트 선택에는 실제로 라벨을 단 도메인 클립을 최소 100개 남겨 두라고 권합니다.
NeMo Speech 미세조정 도구의 조건
NeMo Speech 미세조정 튜토리얼은 새 언어 ASR(스와힐리어), 음성 번역, 음성 질의응답, 감정 인식, 코드 스위칭 ASR 등 16개 과제를 노트북으로 다룹니다. 노트북마다 지시문 기준선을 먼저 재고, 학습과 체크포인트 선택을 거쳐 테스트를 한 번만 평가하는 같은 흐름을 따릅니다. 함께 공개한 미세조정 에이전트 스킬은 코딩 에이전트가 기준선 선정부터 데이터 점검, 학습 검증, LoRA 어댑터 병합, 평가까지 진행하도록 만든 절차서입니다. 이 스킬은 설정이 체크포인트와 맞지 않을 때 경고 없이 일부 모듈이 무작위 가중치로 만들어지는 문제처럼, 오류 없이 실패하는 경우를 단계별 점검 항목으로 정리해 두었습니다.
하드웨어 요구 사항은 추론보다 훨씬 큽니다. 튜토리얼의 기대 결과는 GB300 1장에서 측정했고 학습에 70~160GB의 GPU 메모리를 씁니다.
또 하나 확인할 점은 vLLM 버전입니다. 미세조정 튜토리얼과 에이전트 스킬은 디코딩용으로 vLLM 0.28.0을 고정하고 0.29가 SpeechLM 플러그인과 호환되지 않는다고 적었습니다. 반면 모델 카드와 서빙 문서는 vLLM 0.32.0을 요구합니다. 에이전트 스킬은 학습용 NeMo 환경과 서빙용 vLLM 환경을 분리하라고 안내합니다. ModelScope 쪽에서는 ms-swift로도 미세조정할 수 있다고 원문이 밝혔습니다.
라이선스
모델 가중치는 OpenMDW-1.1로 배포되고, 모델 카드는 상업적, 비상업적 용도 모두에 쓸 수 있다고 밝힙니다. OpenMDW-1.1은 모델과 관련 자료를 제한 없이 사용, 수정, 배포할 수 있도록 허락하고, 모델로 만든 출력물에도 제한을 두지 않습니다. 배포할 때는 라이선스 사본과 저작권 고지를 함께 넣어야 합니다. 이 모델 자료가 특허나 저작권을 침해한다는 소송을 먼저 제기하면 권리가 종료됩니다.
Granary v2 라벨은 OpenMDW-1.1(People's Speech 부분집합은 CC BY-SA 4.0)을 따릅니다. NeMo Speech와 NeMo Curator, NeMo-Speech.cpp 코드는 Apache License 2.0입니다. Granary v2의 원천 오디오는 각 코퍼스의 라이선스를 따로 따라야 합니다.
 NVIDIA Nemotron 3.5 Transcribe and Granary v2 소개 블로그
 NVIDIA-Nemotron-3.5-Transcribe-30B-A4B (Hugging Face)
Nemotron 3.5 Transcribe 기술 보고서
Nemotron 3.5 Transcribe 데모 (Hugging Face Space)
Granary v2 데이터셋 (Hugging Face)
https://huggingface.co/datasets/nvidia/Granary-v2
 NVIDIA NeMo Speech GitHub 저장소
NeMo Curator Granary v2 파이프라인 튜토리얼
더 읽어보기
-
ReplaySSM: 상태-공간 모델(SSM)의 상태 쓰기를 줄여 하이브리드 모델 디코딩을 가속하는 NVIDIA 블로그 글 정리
-
Cohere, HuggingFace Open ASR 리더보드 1위를 차지한 오픈소스 음성 인식 모델 Transcribe 공개
-
Microsoft, 1시간분량 오디오를 10초만에 전사하는 60개 언어 음성 인식 모델 MAI-Transcribe-2 출시 (가중치 공개 X)
-
NVIDIA, 4GB VRAM에서 동작하는 대화형 에이전트용 소형 모델 Nemotron 3.5 Bolt E4B 공개 (feat. Gemma 4)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
