
Ternary Bonsai 2 27B 소개
PrismML이 Ternary Bonsai 2 27B 를 공개했습니다. 270억 파라미터급 멀티모달 언어 모델의 행렬 가중치를 \{-1, 0, +1\} 세 값으로만 저장해서, FP16으로 53.80GB를 차지하던 언어 모델을 5.93GB 로 줄인 모델입니다. 20종 벤치마크 평균 83.9점으로 원본인 Qwen3.8-27B FP16의 85.4점 대비 98.2% 를 유지했고, 가중치는 Apache License 2.0으로 공개되었습니다.
이 모델이 어떤 맥락에서 나왔는지는 두 달 전 글에서 이미 다룬 적이 있습니다. PyTorchKR에서도 Bonsai 27B: 노트북과 폰에서 실행되는 27B급 이진 및 삼진 저비트 LLM으로 소개했는데, 당시 핵심 주장은 "4비트 아래에서 기존 양자화(quantization)는 점진적으로 나빠지는 게 아니라 질적으로 붕괴한다" 는 것이었습니다. 연쇄적 사고(chain-of-thought)가 흔들리고 도구 호출(tool calling) 파싱이 깨지는 방식으로 무너지기 때문에, 짧은 대화만 해 보면 멀쩡해 보이고 운영에 올린 뒤에야 문제가 드러납니다. Bonsai는 밑바닥부터 저비트로 학습하는 BitNet 계열과 달리, 이미 신뢰받는 사전 학습 모델을 그대로 가져와 표현만 바꾸는 쪽을 택합니다.
그러니까 이번 릴리즈에서 새로운 것은 방향이 아니라 간극이 얼마나 좁혀졌는가 입니다. 1세대 Ternary Bonsai 27B는 FP16 대비 95%를 유지했고, 배포되는 파일은 이상적 크기 5.9GB보다 큰 약 7.2GB였습니다. 삼진 값 하나를 2비트 슬롯에 넣는 것 말고는 방법이 없었기 때문입니다. Bonsai 2는 이 두 가지를 동시에 정리합니다. 유지율은 98.2%로 올라갔고, 삼진 값을 촘촘히 채워 넣는 PTQ1_0 패킹이 들어오면서 배포 파일이 5.93GB, 가중치당 1.76비트가 되었습니다. 1세대 백서가 "향후 과제" 로 남겨 두었던 두 항목이 그대로 이번 릴리즈의 내용인 셈입니다.
한편 이 글에서 인용하는 수치는 문서마다 조금씩 다릅니다. 아래 본문은 2026년 9월 백서와 공식 문서를 기준으로 삼았고, Hugging Face 모델 카드와 어긋나는 부분은 마지막 절에 따로 모아 두었습니다.
두 달 사이에 달라진 것: 95%에서 98.2%로
1세대와 2세대를 나란히 놓으면 변화가 분명해집니다. 다만 두 세대는 베이스 모델도 벤치마크 구성도 다르기 때문에, 아래 표의 유지율은 같은 자로 잰 값이 아니라 각자의 기준선에 대한 값입니다.
| 항목 | Ternary Bonsai 27B (1세대) | Ternary Bonsai 2 27B |
|---|---|---|
| 베이스 모델 | Qwen3.6-27B | Qwen3.8-27B |
| 기준선 대비 평균 유지율 | 95% (15종 벤치마크) | 98.2% (20종 벤치마크) |
| 가중치당 비트 | 1.71비트 (이상값) | 1.72비트 (이상값), 1.76비트 (PTQ1_0 배포) |
| 배포 파일 크기 | 약 7.2GB | 5.93GB (PTQ1_0) |
| 가중치 기저 | 원래 기저 | 블록 단위 하다마드 회전(Hadamard rotation) |
| 장기 에이전트 평가 | 없음 | Terminal-Bench 2.1, SWE-bench Verified |
백서가 직접 짚는 부분은 두 번째 줄이 아니라 마지막 줄입니다. 1세대 보고서는 "장기 호흡의 도구 기반 소프트웨어 엔지니어링" 을 다음 과제로 지목했는데, 이번에는 그 축을 실제로 측정했습니다. 뒤에서 보겠지만 이 축의 숫자는 20종 평균이 주는 인상보다 훨씬 보수적입니다.
삼진 가중치와 회전된 기저: 1.72비트는 어떻게 구성되는가
그룹 단위 스케일을 공유하는 삼진 형식
각 가중치는 \{-1, 0, +1\} 중 하나이고, 128개 가중치로 이루어진 그룹마다 FP16 스케일 하나를 공유합니다. 회전된 기저에서의 가중치는 다음과 같이 표현됩니다.
삼진 값 하나가 담는 정보량은 \log_2 3 \approx 1.585 비트이므로, 128개마다 FP16 스케일 하나를 얹으면 유효 저장 비용은 다음과 같습니다.
이 값은 삼진으로 저장된 텐서만 센 것입니다. 아래에서 설명할 고정밀 텐서까지 포함해 언어 모델 전체 파라미터에 대해 평균을 내면 가중치당 1.72비트 가 되고, FP16 대비 약 9.3\times 축소에 해당합니다.
고정밀로 남긴 0.0976%
1세대는 이 텐서들까지 전부 삼진으로 밀어 넣었지만, Bonsai 2는 일부를 저비트 표현 위에 남겨 둡니다. 회전도 양자화도 적용하지 않는 텐서들입니다.
| 텐서 그룹 | 파라미터 | 비중 |
|---|---|---|
선형 어텐션 레이어의 순환 상태 경로 (in_proj_a, in_proj_b) |
23,592,960 | 0.0878% |
conv1d.weight |
1,966,080 | 0.0073% |
A_log, dt_bias, norm.weight |
10,752 | 0.00004% |
정규화 (input/post_attention_layernorm, final) |
660,480 | 0.0025% |
q_norm, k_norm |
8,192 | 0.00003% |
| 고정밀 합계 | 26,238,464 | 0.0976% |
추가 비용은 bf16 기준 52MB이고, 이것이 1.71비트를 1.72비트로 올립니다. 이 대목이 중요한 이유는 1세대 글에서 이미 다룬 "저비트라는 이름의 함정" 때문입니다. 흔히 "2비트" 라 불리는 빌드가 실제로는 가중치당 2.2비트에서 2.8비트를 쓰는 이유는 디코딩 경로 곳곳에 고정밀 텐서를 남겨 두기 때문인데, Bonsai는 그 탈출구가 전체의 0.1% 미만이라는 것을 표로 공개합니다. 임베딩, 어텐션과 선형 어텐션 프로젝션, MLP 프로젝션, LM 헤드는 모두 삼진입니다.
블록 단위 하다마드 회전
2세대에서 새로 들어온 것이 회전된 가중치 기저(rotated weight basis) 입니다. 삼진 가중치 W 는 메모리에 저장된 뒤 블록 단위로 다음 변환을 거칩니다.
여기서 H_n 은 월시 하다마드 행렬(Walsh-Hadamard matrix)이고 S 는 \pm 1 부호로 이루어진 고정 대각 행렬입니다. 각 레이어의 추론(inference)은 이전 레이어 출력 x 에 대해 다음과 같이 수행됩니다.
이 아이디어의 뿌리는 SpinQuant입니다. 회전을 거치면 활성값의 이상치(outlier)가 여러 차원으로 퍼져서 거친 격자로도 표현하기 쉬워집니다. 회전 자체는 오프라인에서 저장 가중치에 미리 접어 넣기 때문에 추가 비트도, 추가 가중치 트래픽도 들지 않습니다. 대신 런타임에서 활성값 쪽에 같은 변환을 걸어야 하고, 이 비용이 뒤에서 이야기할 디코딩 지연의 주요 항목으로 남습니다.
한 가지 실무적 함의가 있습니다. 패킹된 모델은 자신이 회전된 기저임을 메타데이터로 선언하므로, 런타임(runtime)은 대응하는 변환을 적용하거나 파일 로드를 거부하거나 둘 중 하나를 합니다. 아래에서 볼 상류 llama.cpp 비호환 문제의 배경이 바로 이 선언입니다.
두 가지 패킹: PTQ1_0과 PQ2_0
표현이 1.72비트라고 해서 파일이 그 크기로 떨어지는 것은 아닙니다. 커널이 효율적으로 읽을 수 있는 패킹 형식이 필요하고, 이번 릴리즈는 두 가지를 함께 내놓았습니다.
| 형식 | 가중치당 비트 | 언어 모델 크기 | FP16 대비 축소 |
|---|---|---|---|
| FP16 (기준) | 16.0 | 53.80GB | 1.0\times |
| 순수 삼진 (이상값) | 1.72 | 5.80GB | 약 9.3\times |
PTQ1_0 (삼진 값을 촘촘히 채움) |
1.76 | 5.93GB | 약 9.1\times |
PQ2_0 (삼진 값 하나를 2비트 슬롯에) |
2.16 | 7.25GB | 약 7.4\times |
PTQ1_0 은 정보 이론적 하한에 거의 붙었고, PQ2_0 은 풀어내는 연산이 단순해서 프롬프트 처리가 빠릅니다. 어느 쪽도 일률적으로 빠르지 않다는 점이 이 릴리즈의 솔직한 부분인데, 뒤의 처리량 표에서 그 이유가 드러납니다.
비전 타워는 언어 모델과 별도로 배포됩니다. 텍스트만 쓸 거라면 받을 필요가 없습니다. GGUF 저장소는 mmproj 를 HQQ(Half-Quadratic Quantization) 4비트(0.63GB)와 BF16 참조본(0.93GB) 두 가지로 제공하고, MLX 패키지는 비전 타워를 전체 정밀도로 그대로 담습니다. MLX 쪽 패키지가 8.49GB로 큰 이유는 표현이 달라서가 아니라 컨테이너 때문입니다. MLX의 그룹 저비트 형식은 그룹마다 스케일과 바이어스를 함께 저장하는데, 삼진 가중치에는 스케일만 있으면 되므로 바이어스는 중복 정보입니다. 그 결과 128개 가중치당 34바이트면 될 것이 36바이트가 되어 가중치당 2.125비트에서 2.250비트로 올라갑니다.
하이브리드 어텐션을 위한 저비트 커널
가중치를 작게 만드는 것과 그 가중치를 그대로 실행하는 것은 다른 문제입니다. 기존 저비트 추론 경로는 대부분 표준 완전 어텐션(full attention) 트랜스포머를 대상으로 하는데, Qwen3.8-27B는 선형 어텐션(linear attention)과 완전 어텐션을 번갈아 배치한 하이브리드 구조입니다. 모델 카드에 따르면 64개 레이어가 16 × (3 × (Gated DeltaNet → FFN) → 1 × (Gated Attention → FFN)) 로 구성되어 약 75%가 선형 어텐션이고, 이 덕분에 262,144 토큰 컨텍스트가 온디바이스에서도 현실적인 KV 캐시 크기로 유지됩니다.
그래서 PrismML은 이 백본을 위한 커널을 Apple Silicon과 CUDA 양쪽에 직접 작성했습니다. 커널은 패킹된 삼진 가중치를 그대로 읽어 들이고, FP16 밀집 가중치로 되돌려 펼치지 않습니다. 되돌려 펼치는 순간 메모리 대역폭 이점이 사라지기 때문입니다. CUDA 백엔드는 삼진 코드를 풀고 그룹 스케일을 적용하는 과정을 행렬 곱 안으로 융합한 저비트 일반 행렬 곱(GEMM, General Matrix Multiply) 커널을 쓰고, 활성값과 수치적으로 민감한 연산은 더 높은 정밀도로 남깁니다.
회전 기저의 대가는 배치 크기 1에서 가장 크게 드러납니다. 모든 프로젝션 앞에 부호 반전과 블록 단위 고속 월시 하다마드 변환이 들어가고, 이 변환은 활성값 길이에 대해 O(n \log n) 이라 행렬 곱 자체에 비하면 무시할 만하지만 디코딩 경로에서는 매 토큰마다 걸립니다. Metal에서는 부호 반전을 변환의 로드 경로에 융합해 활성값을 한 번 더 훑는 패스를 없앴고, CUDA에서는 변환을 단일 워프가 아닌 스레드 블록 전체로 병렬화해 하다마드 단계 간 직렬화를 줄였습니다. 프롬프트 처리는 변환 비용이 여러 입력 토큰에 걸쳐 상쇄되고 행렬 곱 자체가 연산 바운드라 이 오버헤드에 덜 민감합니다.
처리량: 두 패킹이 하드웨어마다 순서를 바꿉니다
백서는 tg128 (128 토큰 생성 처리량)과 pp512 (512 입력 토큰 프롬프트 처리량)를 표준 지표로 씁니다. 전자는 메모리 대역폭 바운드인 대화형 구간, 후자는 연산 바운드인 구간을 각각 대표합니다. 2026년 9월 16일 기준 릴리즈 아티팩트로 측정한 값에서 일부를 옮기면 다음과 같습니다.
| 하드웨어 | PQ2_0 TG128 |
PQ2_0 PP512 |
PQ2_0 mWh/토큰 |
PTQ1_0 TG128 |
PTQ1_0 PP512 |
|---|---|---|---|---|---|
| RTX 5090 (32GB) | 142.5 | 4121 | 0.582 | 134.4 | 1901 |
| RTX PRO 6000 Blackwell | 140.6 | 4520 | 0.637 | 136.8 | 2290 |
| H100 SXM (80GB) | 103.2 | 2467 | 0.584 | 77.3 | 1097 |
| RTX 4090 (24GB) | 90.9 | 3134 | 0.714 | 96.7 | 1634 |
| L40S (48GB) | 74.6 | 2827 | 0.812 | 82.8 | 1601 |
| A100 SXM (80GB) | 74.0 | 1328 | 0.776 | 54.6 | 703 |
| L4 (24GB, 72W) | 29.7 | 778 | 0.629 | 32.1 | 468 |
| 노트북 (M5 Pro, Metal) | 27.7 | 397 | 측정 없음 | 27.1 | 369 |
위 표에서 세 가지를 확인할 수 있습니다. 첫째, PTQ1_0 은 단계마다 가중치 데이터를 18% 덜 옮기지만 촘촘히 채운 삼진 값을 풀어내는 데 연산이 듭니다. 그래서 메모리가 병목인 Ada 세대와 L4에서는 PTQ1_0 이 이기고, 배치 크기 1 디코딩이 명령 처리량과 커널 실행 오버헤드에 묶이는 H100과 A100, Blackwell 계열에서는 PQ2_0 이 이깁니다. 둘째, 프롬프트 처리는 연산 바운드라서 어느 하드웨어에서나 PQ2_0 이 앞섭니다. 셋째, PTQ1_0 을 모든 환경에서 PQ2_0 만큼 빠르게 만드는 것이 백서가 밝힌 현재 엔지니어링 과제입니다.
Apple Silicon 노트북은 별도 표로 정리되어 있습니다. M5 Max에서 46.8 tok/s, M5 Pro에서 27.7 tok/s, M4 Pro에서 18.0 tok/s입니다. M4 Pro 수치는 회전 도입 이전 빌드에서 측정한 것이라 릴리즈 스택과의 직접 비교가 아니라 Apple Silicon 사이의 확장 경향을 보는 용도로 읽어야 합니다. M5 Pro에서 27.7 tok/s는 초당 약 201GB의 가중치 트래픽에 해당하고, 이는 디코딩 경로가 메모리 대역폭에 지배된다는 것을 보여 줍니다.
에너지 쪽은 플랫폼 사이의 비교가 성립하지 않는다는 점을 백서가 먼저 밝힙니다. NVIDIA에서 nvidia-smi 가 보고하는 보드 전력에는 HBM과 GDDR이 포함되지만, Apple의 powermetrics 는 CPU와 GPU, ANE만 보고할 뿐 DRAM 레일이 없습니다. 배치 크기 1 디코딩이 메모리 대역폭에 묶여 있으므로 메모리 전력을 빼면 Apple 쪽 수치가 체계적으로 낮게 나옵니다. 그래서 Apple 행에는 토큰당 에너지를 적지 않고 절대 소비 전력만 보고합니다. M5 Pro에서 27.0 tok/s로 지속 디코딩할 때 GPU 레일 27.0W, CPU와 GPU 합계 32.8W이고, 유휴 상태는 각각 0.17W와 1.47W입니다. 이 유휴값을 빼지 않고 그대로 보고한다는 점도 명시되어 있습니다.
참고로 발표 글은 "RTX 4090에서 토큰당 0.714 mWh를 소비하며, 이는 전체 정밀도로 실행되는 8B 모델보다 40% 더 에너지 효율적" 이라고 밝히고 있습니다. 앞의 수치는 백서 표와 일치하지만 8B 모델과의 비교는 백서에 대응하는 측정이 없으므로, 발표 글의 주장으로 읽는 편이 안전합니다.
벤치마크: 무엇을 지켰고 어디를 내줬는가
평가는 EvalScope 하네스와 vLLM 서빙 경로를 NVIDIA H100에서 동일하게 적용해 수행했습니다. 전부 사고 모드(thinking mode)이고 추론 강도는 xhigh, 샘플링은 Qwen3.8 모델 카드 권장값인 temperature 1.0, top-p 0.95, top-k 20입니다. 대부분 단일 샘플 pass@1이고 GPQA Diamond는 문항당 5회, AIME25와 AIME26은 문항당 8회 샘플링한 평균입니다. 규칙 기반 채점이 어려운 항목에는 gemini-3-flash-preview 를 고정 심판으로 두었습니다.
카테고리별 결과는 다음과 같습니다. Qwen3.6-27B FP16을 함께 둔 이유는, 압축된 모델이 한 세대 전 전체 정밀도 모델과 어디서 갈리는지가 이 표에서 가장 잘 보이기 때문입니다.
| 카테고리 | 포함 벤치마크 | Qwen3.8-27B FP16 | Ternary Bonsai 2 27B | Qwen3.6-27B FP16 |
|---|---|---|---|---|
| 에이전트 및 도구 호출 | τ²-Bench, BFCL v3 | 79.74 | 77.57 | 80.05 |
| 코딩 | HumanEval+, LiveCodeBench v6, MBPP+, BigCodeBench | 82.17 | 81.58 | 82.57 |
| 수학 | AIME 2026, AIME 2025, GSM8K, MATH-500 | 97.06 | 96.57 | 94.64 |
| 지식 및 추론 | MMLU-Redux, GPQA Diamond, AA-LCR | 86.66 | 83.95 | 84.71 |
| 지시 따르기 | IFBench, IFEval | 81.25 | 82.66 | 74.53 |
| 비전 | CharXiv, A-OKVQA, OmniDocBench v1.6, RealWorldQA, OCRBench v2 | 81.64 | 78.59 | 79.82 |
| 전체 (20종) | 85.4 | 83.9 | 83.6 |
위 표를 통해 세 가지를 알아볼 수 있습니다. 첫째, 수학과 코딩은 전체 정밀도에서 각각 0.49점과 0.59점 떨어지는 데 그칩니다. 지시 따르기는 오히려 1.41점 높습니다. 둘째, 손실은 지식 및 추론과 비전에 몰려 있습니다. 세부 항목으로 내려가면 GPQA Diamond가 90.51에서 85.76으로, OmniDocBench v1.6이 92.46에서 89.13으로, OCRBench v2가 60.99에서 56.88로 떨어집니다. 셋째, 에이전트와 코딩 두 카테고리에서는 한 세대 전인 Qwen3.6-27B FP16이 여전히 앞섭니다. 전체 평균 83.9가 83.6을 넘긴 것은 주로 지시 따르기 카테고리에서 벌어진 8점 차이 덕분입니다.
대조군인 IQ2_XXS 빌드와 비교하면 저비트 붕괴가 어떤 모양인지 드러납니다. 이 빌드는 7.3GB로 Bonsai 2보다 1.23배 크면서 평균 75.2점에 그치는데, 흥미로운 것은 평균이 아니라 분포입니다. AIME26에서 78.6, LiveCodeBench에서 70.05로 무너지는 동안 MMLU-Redux는 85.79를 유지합니다. 지식 질의응답만 몇 개 던져 보면 멀쩡해 보이는 이유가 여기 있습니다. 같은 두 항목에서 Bonsai 2는 95.83과 90.07을 기록합니다.
장기 호흡 에이전트 작업: 20종 평균 바깥의 숫자
여기서부터가 이 릴리즈를 읽을 때 가장 주의해야 할 부분입니다. Terminal-Bench 2.1과 SWE-bench Verified는 20종 평균에 포함되지 않는 별도 측정입니다.
| 벤치마크 | Qwen3.8-27B FP16 | Ternary Bonsai 2 27B | 유지율 |
|---|---|---|---|
| Terminal-Bench 2.1 | 69.7 | 52.8 | 약 75.8% |
| SWE-bench Verified | 80.6 | 60.8 | 약 75.4% |
20종 평균의 98.2%와 이 두 항목의 약 75%는 같은 모델의 같은 릴리즈에서 나온 수치입니다. 백서도 이 격차를 감추지 않고, 장기 호흡 에이전트 평가가 공격적 압축에 특히 가혹하다는 점을 명시합니다. 작은 오차가 수십 단계에 걸쳐 누적되는 구조이기 때문입니다. 다만 해석의 기준점은 붕괴 여부입니다. 기존 저비트 양자화에서는 이 영역의 점수가 의미 있는 진전을 만들지 못하는 수준으로 주저앉는 반면, Bonsai 2는 종단간 소프트웨어 엔지니어링 과제를 완주하는 능력 자체는 유지합니다. 그 밖에 τ²-Bench는 1세대의 73.6에서 80.2로 올랐고, BFCL v3는 74.9, AA-LCR은 전체 정밀도와 1점 이내인 77.0입니다.
Terminal-Bench 2.1의 기준선 69.7은 PrismML이 Harbor 프레임워크와 Terminus-2 에이전트로 89개 과제를 과제당 1회 시도해 직접 측정한 값입니다. Qwen 팀이 자사 모델 카드에 올린 같은 벤치마크 점수는 73.0으로, 하네스와 시도 횟수가 다르면 기준선 자체가 달라진다는 점을 염두에 두는 편이 좋습니다.
추론 강도를 낮추면 유지율도 낮아집니다
98.2%는 xhigh 추론 강도에서의 값입니다. 백서 부록은 medium 강도 결과도 함께 싣는데, 여기서는 Qwen3.8-27B FP16이 82.6, Bonsai 2가 79.3으로 유지율이 약 96.0%로 내려갑니다. 항목별로 보면 AIME25가 86.25에서 74.58로, GPQA Diamond가 84.34에서 75.56으로, τ²-Bench가 79.50에서 70.86으로 벌어집니다. 즉 "거의 무손실" 이라는 표현은 모델이 충분히 생각할 시간을 받았을 때 성립합니다. 참고로 이 모델은 Qwen3.8-27B에서 xhigh 와 medium 두 가지 추론 강도만 물려받았고, low 를 골라도 사고량이 줄지 않으므로 응답을 짧게 하려면 토큰 예산으로 제한해야 합니다.
지능 밀도: 자기 형제에게 1위를 내준 지표
PrismML은 1비트 Bonsai 보고서에서 도입한 지능 밀도(intelligence density) 라는 지표를 계속 씁니다. 20종 평균을 \text{avg}, 오차 확률을 P_e = 1 - \text{avg}/100 이라 할 때, N 기가바이트를 차지하는 모델의 지능 밀도는 다음과 같이 정의됩니다.
로그 항이 높은 정확도를 지키는 쪽에 가중치를 주고, 크기로 나누는 항이 작은 표현에 유리하게 작용합니다. Ternary Bonsai 2 27B는 0.444 1/GB로 IQ2_XXS 의 0.276과 FP16의 0.051을 크게 앞섭니다.
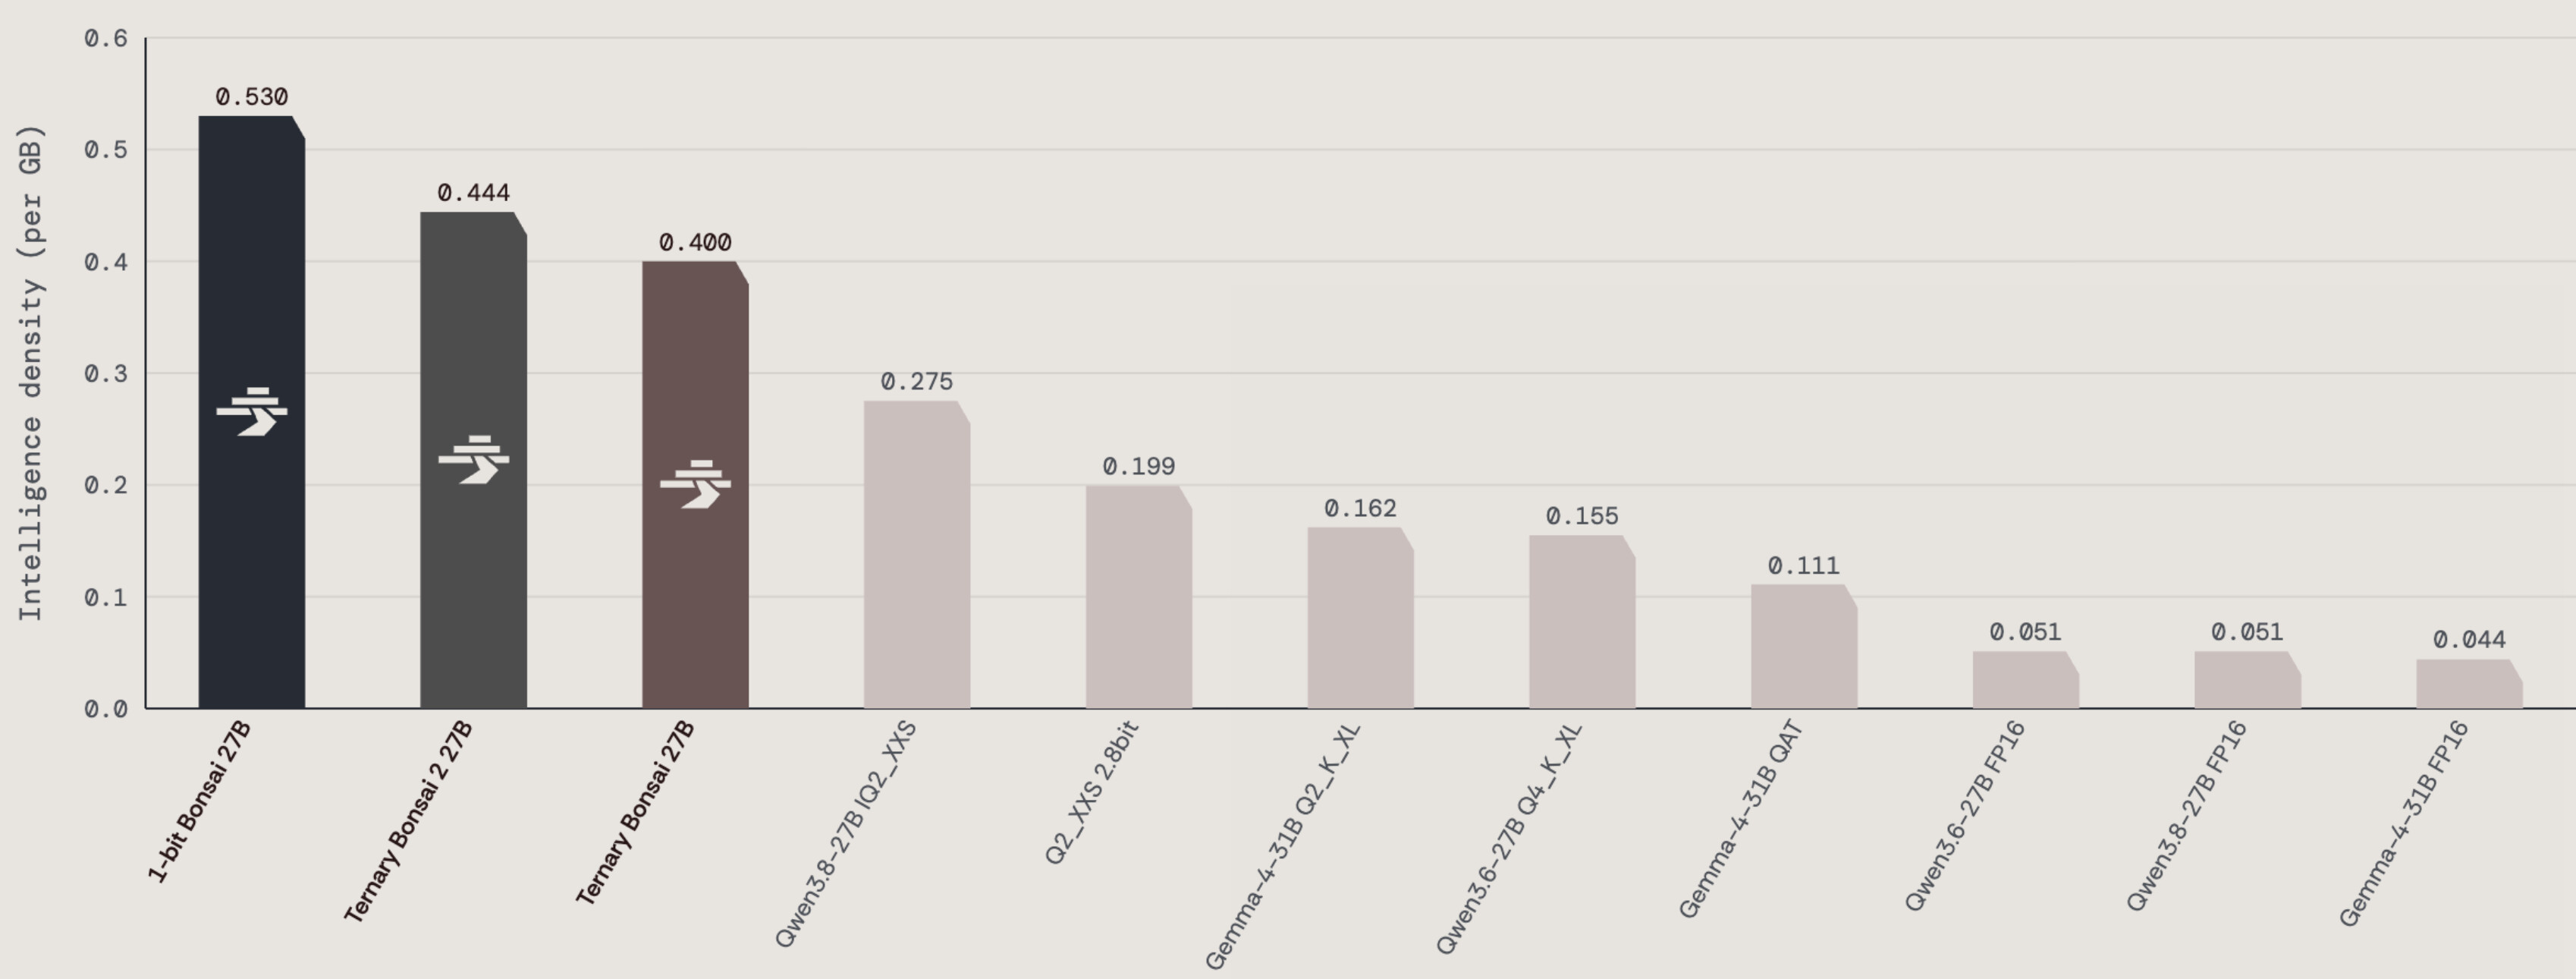
다만 발표 글이 이 지표를 두고 "지능 밀도에서 두드러진 이상치" 라고 표현한 부분은 그림과 함께 읽는 편이 정확합니다. 그래프에서 가장 높은 막대는 Bonsai 2 27B(0.444)가 아니라 1비트 Bonsai 27B(0.530)입니다. 3.9GB라는 더 작은 발자국이 분모에서 유리하게 작용하기 때문인데, 이 지표가 크기에 얼마나 민감한지를 보여 주는 동시에, 품질을 원하면 삼진이고 밀도를 원하면 이진이라는 계열 내부의 역할 분담을 그대로 드러냅니다.
로컬에서 직접 실행하기
데모 저장소가 실행 방법의 정본입니다. Ternary Bonsai 2 27B가 기본값이라 별도 플래그 없이 설치 스크립트만 실행하면 됩니다.
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
./setup.sh
setup.sh 는 시스템 빌드 도구와 uv를 설치하고, Hugging Face에서 가중치를 내려받고, 플랫폼에 맞는 llama.cpp 바이너리를 가져오고, Apple Silicon에서는 MLX를 소스에서 빌드합니다. 기본 다운로드는 PQ2_0 패킹과 비전 프로젝터를 합쳐 7.8GB이며, Open WebUI와 코드 인터프리터 환경까지 설치하느라 몇 GB가 더 추가됩니다. 이 둘은 BONSAI_OPENWEBUI=0 과 BONSAI_CODE_INTERPRETER=0 으로 건너뛸 수 있습니다.
설치가 끝나면 서버를 띄우거나 한 번만 질문할 수 있습니다.
./scripts/start_llama_server.sh          # http://localhost:8080 에서 채팅, 비전, 도구 호출
./scripts/run_llama.sh -p "What is the capital of France?"
Windows에서는 setup.ps1 과 scripts\start_llama_server.ps1 을 씁니다. 모델 계열과 크기는 환경 변수로 고릅니다.
| 변수 | 기본값 | 값 | 용도 |
|---|---|---|---|
BONSAI_MODEL |
27B |
27B, 8B, 4B, 1.7B |
모델 크기. Bonsai 2는 27B 뿐입니다 |
BONSAI_FAMILY |
bonsai2 |
bonsai2, ternary, bonsai |
계열 선택 |
BONSAI_NGL |
자동 감지 | 정수, 0 은 CPU 전용 |
GPU 레이어 오프로드 |
BONSAI_CTX |
RAM 기반 자동 | 0 또는 262144 이하 |
컨텍스트 길이 |
BONSAI_KV4 |
0 |
1 |
4비트 KV 캐시 |
BONSAI_SPECULATIVE |
0 |
1 |
dspark 드래프터를 쓰는 추측 디코딩. Apple Silicon에서는 대체로 느려져 권장되지 않습니다 |
전체 24개 변수는 저장소의 environment_variables.md 에 정리되어 있습니다.
상류 llama.cpp에서는 아직 돌아가지 않습니다
이것이 지금 시점에 가장 중요한 제약입니다. 회전 기저에 필요한 활성값 쪽 월시 하다마드 변환이 아직 상류에 들어가 있지 않아서, Bonsai 2 파일은 PrismML의 llama.cpp 포크 바이너리를 요구합니다. CPU용 F16 입력 FWHT는 ggml-org/llama.cpp#27779로 열려 있는 상태입니다.
실패 양상이 형식마다 다르다는 점을 알아 두는 편이 좋습니다. 상류 llama.cpp는 PQ2_0 과 PTQ1_0 을 알 수 없는 타입으로 보고 곧장 거부하지만, Q2_0 은 경고 없이 로드한 뒤 의미 없는 출력을 내놓습니다. 그래서 PrismML은 Q2_0 대역을 별도 저장소로 분리해 두었습니다.
반면 1세대 형식들은 상황이 낫습니다. 1비트 Q1_0 은 CPU와 Metal, CUDA, Vulkan 전 백엔드에서 상류에 병합되었고, 삼진 Q2_0 도 그룹 크기 64 파일(*-Q2_0_g64.gguf)이면 상류 빌드에서 그대로 돌아갑니다. MLX 쪽은 2비트 삼진 패킹이 순정 MLX에서 동작하고, 1비트만 mlx#3161이 병합되기 전까지 PrismML MLX 포크가 필요합니다.
메모리 예산 잡기
27B 모델은 262,144 토큰까지 지원하지만, FP16 키 값 캐시(KV Cache) 가 토큰당 64KiB를 쓰므로 100K 컨텍스트에서만 약 6.3GiB가 추가로 필요합니다. 실행 스크립트는 기계의 RAM에 맞춰 8K에서 131K 사이로 기본 컨텍스트를 자동 설정하고, BONSAI_CTX 로 덮어쓸 수 있습니다. BONSAI_KV4=1 을 켜면 캐시가 토큰당 약 18KiB로 줄어 100K에서 약 1.8GiB가 됩니다. 저장소 FAQ에 따르면 예전 리비전이 llama.cpp의 -c 0 을 기본값으로 써서 가용 메모리와 무관하게 전체 학습 컨텍스트를 잡는 바람에 메모리를 고갈시키는 문제가 있었고, 지금은 RAM 기반 기본값으로 바뀌었습니다.
브라우저에서 WebGPU로 돌려보기
이번 릴리즈에서 눈에 띄는 것 중 하나가 webml-community의 WebGPU 데모 Space입니다. 서버에 추론을 보내는 것이 아니라, Ternary-Bonsai-2-27B-PTQ1_0.gguf 파일을 브라우저로 내려받아 사용자의 GPU에서 직접 실행합니다. 5.93GB라는 크기가 만든 가능성인데, 첫 방문 이후에는 캐시되므로 다시 받지 않습니다.
구현은 전부 WebGPU 컴퓨트 셰이더입니다. Space 코드에는 WGSL(WebGPU Shading Language)로 작성한 @compute 진입점이 50개 이상 들어 있습니다. 하다마드 회전은 BlockHadamard 연산으로 들어가 있고, 이식성 위주의 워크그룹 버전과 레인 셔플을 쓰는 서브그룹 버전, RMSNorm과 융합한 버전 세 가지 변형을 갖추고 있습니다. 로더가 GGUF 메타데이터의 prism.hadamard.transform 값을 확인해 정규화된 실베스터 월시 하다마드 변환이 아니면 로드를 거부한다는 점도 코드에서 확인됩니다. shader-f16 확장과 서브그룹 기능은 기기가 지원할 때만 쓰고, 브라우저가 WebGPU를 노출하지 않으면 최신 Chrome이나 Edge를 안내합니다. 저비트 표현의 값어치가 파일 크기 자체가 아니라 실행 가능한 장소의 범위에 있다는 주장을 가장 직접적으로 보여 주는 데모입니다.
설치 없이 시험해 볼 다른 경로도 있습니다. Colab 노트북과 iOS/iPadOS용 Locally AI 앱이 문서에 안내되어 있습니다. 다만 설치 없이 시험해 보는 방법을 모아 둔 문서 페이지는 7월에 갱신된 뒤 그대로라, 링크된 호스팅 데모와 WebGPU Space가 모두 1세대를 가리키고 있습니다. Bonsai 2를 보려면 위 Space 주소를 직접 쓰는 편이 확실합니다.
에이전트 데모 영상
발표 글에는 RTX 5090 한 장에서 돌린 데모 두 편이 실려 있습니다. 첫 번째는 Cline을 Ternary Bonsai 2 27B로 구동한 코딩 에이전트 루프입니다.
두 번째는 같은 모델로 화면을 직접 조작하는 컴퓨터 사용(computer use) 데모입니다.
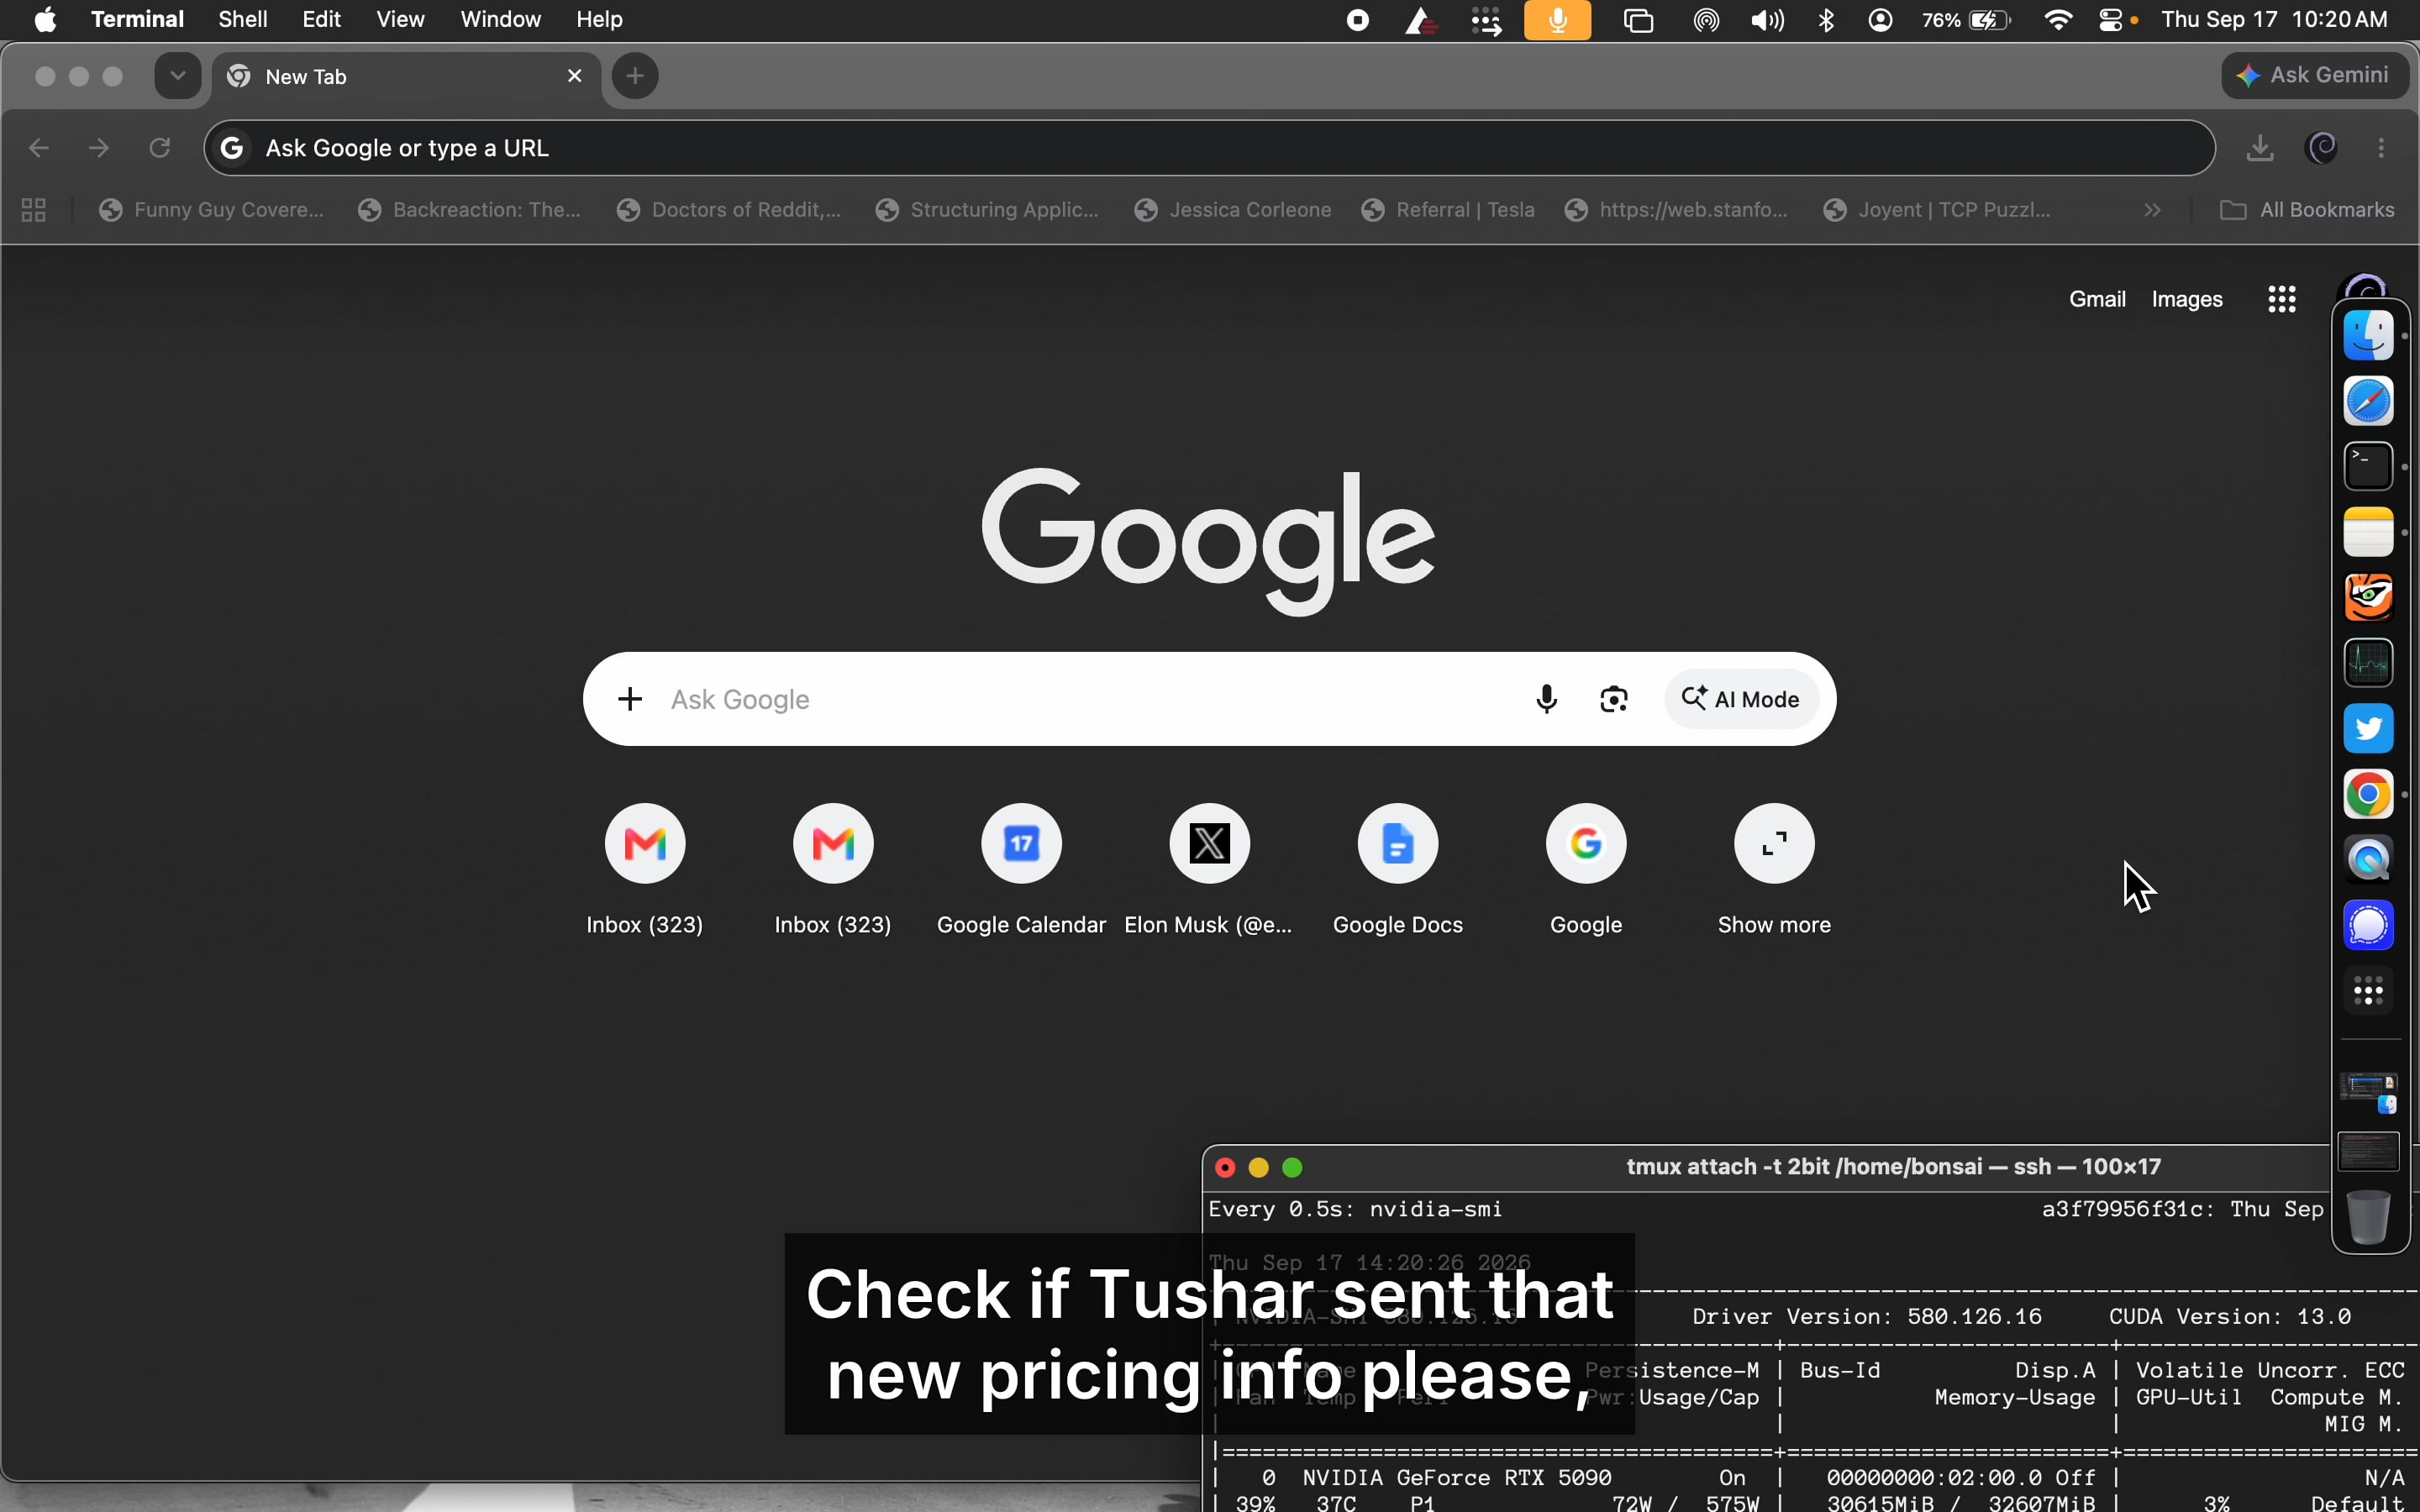
모델 자체는 OpenAI 스타일의 네이티브 tool_calls 를 왕복까지 지원하고, 데모의 채팅 UI에는 Hugging Face와 DeepWiki가 미리 등록된 MCP 클라이언트가 포함되어 있습니다. 터미널 에이전트를 연결하고 싶다면 문서가 Hermes Agent 연동 절차를 안내합니다. http://localhost:8080/v1 을 커스텀 OpenAI 호환 엔드포인트로 등록하면 됩니다.
읽을 때 유의할 점
같은 모델을 설명하는 문서가 여러 개이고, 숫자가 서로 어긋나는 자리가 있습니다. 글을 쓰면서 확인한 것들을 정리해 둡니다.
백서와 Hugging Face 모델 카드의 벤치마크 묶음이 다릅니다. 백서는 20종 평균으로 FP16 85.4 대 Bonsai 83.9를 보고하고, 모델 카드는 MuSR과 MMMU-Pro가 들어간 14종 평균으로 FP16 86.32 대 Bonsai 84.78을 보고합니다. 유지율이 양쪽 모두 98.2%로 떨어지는 것은 우연입니다.
크기와 비트 폭 표기도 문서마다 미세하게 다릅니다. 백서와 공식 문서는 PTQ1_0 을 1.76비트, 5.93GB로 적고 PQ2_0 을 2.16비트, 7.25GB로 적습니다. 모델 카드는 같은 파일을 각각 1.75비트, 5.95GB와 2.13비트, 7.21GB로 적습니다. 저장소 README도 1.75비트 쪽을 따릅니다. Hugging Face에 올라온 실제 파일은 PTQ1_0 이 5,946,648,928바이트(5.95GB), PQ2_0 이 7,206,168,928바이트(7.21GB)로 모델 카드 쪽 표기와 맞습니다. 백서의 5.93GB와 7.25GB는 비트 폭에서 역산한 값으로 보입니다.
처리량 수치는 측정 시점이 다릅니다. 모델 카드의 RTX 5090 PQ2_0 은 129.9 tok/s인데 백서는 142.5 tok/s입니다. 백서는 2026년 9월 16일 기준 릴리즈 아티팩트로 재측정했다고 밝히고 있으므로, 최신값은 백서 쪽입니다.
대조군 IQ2_XXS 의 정체도 문서마다 다릅니다. 백서는 2.2비트, 7.3GB, 75.2점짜리 빌드를 쓰고, 모델 카드는 2.8비트, 9.4GB, 72.59점짜리 빌드를 씁니다. 발표 글의 지능 밀도 그래프에는 두 빌드가 각각 다른 막대로 들어가 있습니다.
한국어 성능은 어느 문서에도 평가가 없습니다. 20종 벤치마크에 다국어 항목이 없고, OCRBench v2만 영어와 중국어 서브셋을 다룹니다. PrismML의 모델 카드에도 베이스 모델인 Qwen3.8-27B 카드에도 language 필드가 없어서, 한국어 능력은 베이스 모델에서 물려받되 별도로 검증되지 않았다고 보는 편이 맞습니다. 양자화가 언어별로 고르게 영향을 주는지도 공개된 자료로는 확인할 수 없습니다.
라이선스
Ternary Bonsai 2 27B의 가중치는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. GGUF와 MLX 두 저장소 모두 동일하며, 실행에 필요한 llama.cpp 포크와 MLX 포크도 원본 프로젝트의 라이선스를 따릅니다.
 Ternary Bonsai 2 27B 소개 블로그
 Ternary Bonsai 2 27B 백서 [영문/PDF/14p]
 Bonsai 2 Hugging Face 컬렉션
 Bonsai 데모 GitHub 저장소
 Bonsai 공식 문서
 브라우저 WebGPU 데모 Space
더 읽어보기
-
Bonsai 27B: 노트북과 폰에서 실행되는 27B급 이진 및 삼진 저비트 LLM (feat. PrismML)
-
BitNet.cpp, Microsoft가 공개한 x86 및 ARM 기반 CPU에 최적화한 BitNet 추론 프레임워크
-
TurboFieldfare: 8GB 맥북에서 Gemma 4 26B를 약 2GB 메모리로 돌리는 Swift 런타임
-
Qwen3.8-Flash-Next, 1/9의 학습 비용으로 Qwen3.7-Plus(397B-A17B) 수준에 도달한 125B-A6B 모델
-
turboquant-pytorch: Google의 TurboQuant를 PyTorch로 처음부터 직접 구현한 LLM KV 캐시 양자화 라이브러리
-
Rapid-MLX: Apple Silicon 맥에서 로컬 LLM을 OpenAI 호환 서버로 띄우는 추론 엔진
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
