edge0 소개
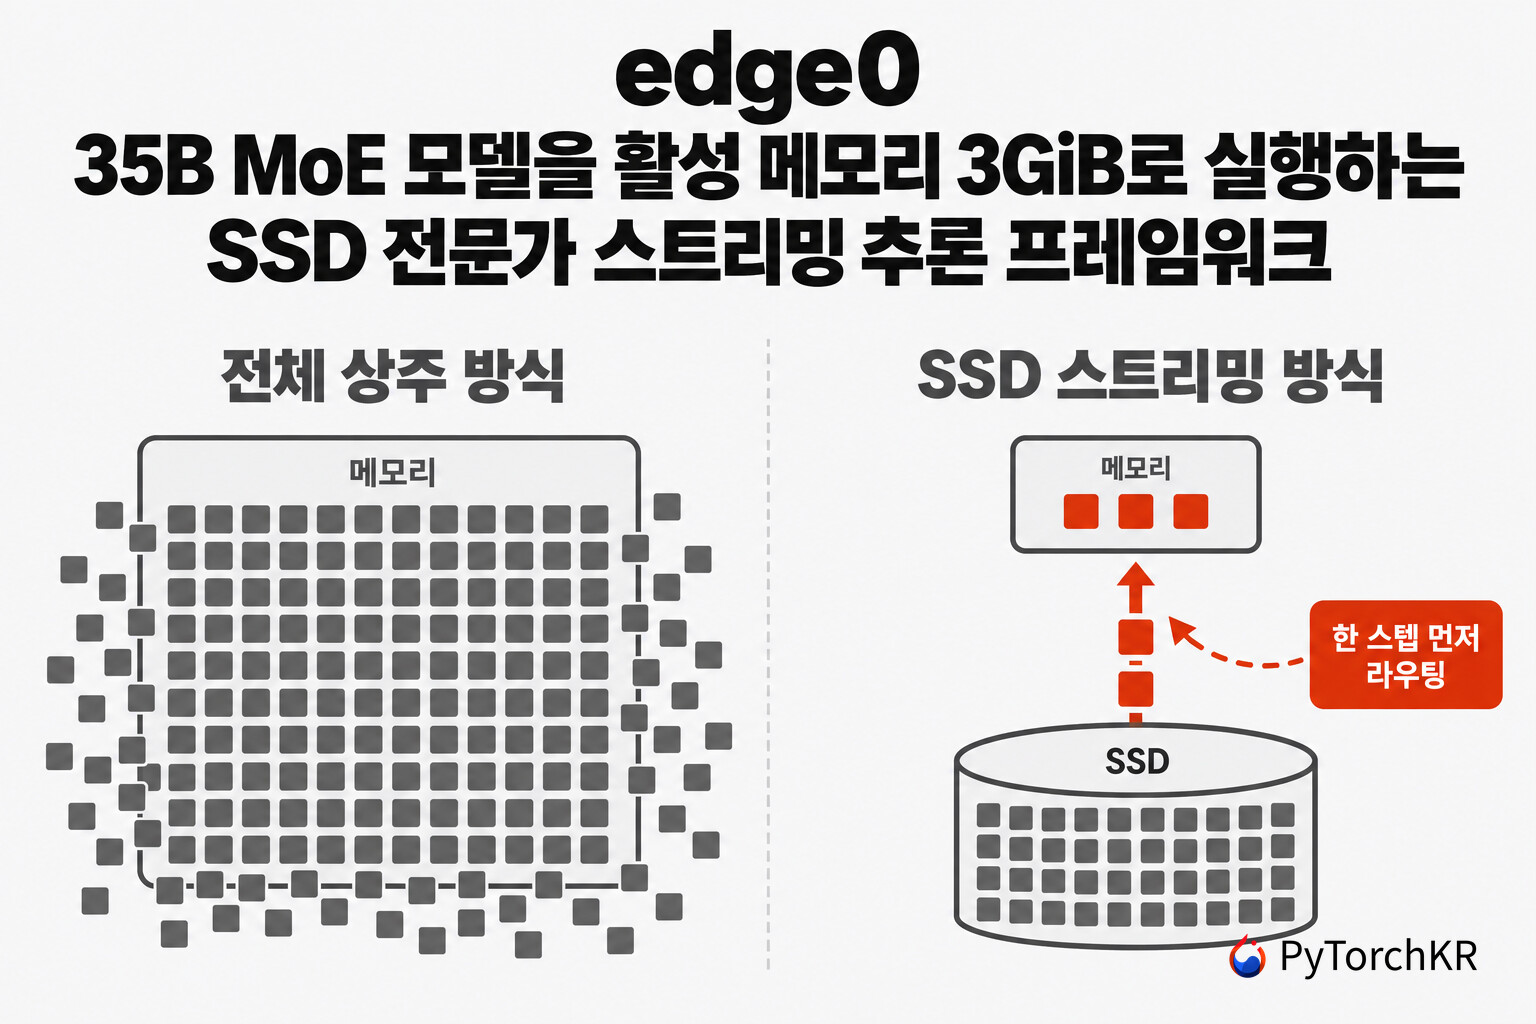
희소 전문가 혼합(Sparse Mixture-of-Experts, MoE) 구조는 토큰 하나를 만들 때 전체 전문가 중 일부만 계산에 참여시키므로 연산량이 작습니다. 그런데 이 구조를 개인 기기에서 실행하려고 하면 연산량보다 메모리가 먼저 막힙니다. edge0가 기준 모델로 삼은 Qwen3.6-35B-A3B는 40개 층에 층마다 전문가가 256개 있고, 4비트로 양자화(Quantization)한 뒤에도 한 층의 MoE 가중치가 약 310MB입니다. 실제로 쓰이는 것은 그중 극히 일부인데도 전부 상주시켜야 하므로 단순 합산만으로 12GB를 넘고, Apple Silicon의 통합 메모리 예산을 크게 초과합니다.
이번에 소개할 edge0 는 이 간극을 메우기 위해 전문가 가중치를 저장장치에 남겨 두고 필요한 것만 GPU로 끌어오는 스트리밍 MoE 추론(Inference) 프레임워크입니다. 개발사 Edge0는 자사의 배포에서 검증했다고 밝힌 세 가지 기법, 즉 SSD 전문가 오프로딩과 Recover-LoRA, 프리라우터(prerouter) 라우팅 예측을 하나의 확장 가능한 프레임워크로 묶었다고 설명합니다. 회사는 같은 이름의 온디바이스 모델 제품군을 자사 사이트에서 소개하고 있고, 이 글에서 다루는 프레임워크와 두 모델 체크포인트는 GitHub와 Hugging Face에 함께 공개되어 있습니다.
edge0는 백엔드를 분리하도록 설계되어 있어서, 현재 공개된 MLX 백엔드는 Apple Silicon에서 동작하고 CUDA 백엔드 자리는 같은 인터페이스로 비워 두었습니다. 함께 공개된 모델은 두 등급입니다. edge0-35b는 Qwen3.6-35B-A3B를 기반으로 40개 층, 전문가 256개, 프리라우터 K=4 설정이고, edge0-8b는 Ling-3.0-tiny-base의 bailing 하이브리드 백본을 기반으로 24개 층, 전문가 128개, K=8 설정입니다. 두 모델 저장소 모두 4비트 기본 체크포인트와 이 프레임워크용으로 학습한 LoRA 및 프리라우터 가중치를 한 디렉토리에 담고 있어서, 내려받은 폴더를 그대로 가리키면 학습된 파이프라인이 바로 동작합니다.
edge0와 기존 로컬 MoE 실행 방식의 차이
로컬에서 MoE 모델을 실행하는 일반적인 방식은 양자화한 가중치를 전부 메모리에 올려 두고 라우팅 결과에 따라 그중 일부만 계산하는 것입니다. 이 방식은 구현이 단순하고 층마다 대기가 없다는 장점이 있지만, 필요한 메모리가 활성 파라미터가 아니라 전체 파라미터에 비례합니다. 반면 edge0는 그 비례 관계를 끊는 쪽을 택했고, 대신 저장장치에서 가중치를 읽어 오는 지연을 감춰야 하는 부담을 떠안았습니다. 두 방식의 차이는 다음과 같습니다:
| 항목 | edge0 | 전체 상주 방식 |
|---|---|---|
| 전문가 가중치 위치 | SSD에 두고 필요한 것만 mmap | 전부 메모리에 상주 |
| 필요한 메모리 | 활성 집합 크기에 비례 | 전체 파라미터 크기에 비례 |
| 실측 피크 활성 메모리 | 2.9 GiB (edge0-35b), 1.0 GiB (edge0-8b) |
모델 전체 크기만큼 |
| 새로 생기는 병목 | 전문가 가중치를 읽어 오는 저장장치 지연 | 없음 |
| 지연을 감추는 장치 | 프리라우터 예측, LRU(Least Recently Used) 캐시, 고정 슬롯 | 해당 없음 |
| 4비트 품질 손실 대응 | Recover-LoRA 어댑터 | 별도 대응 없음 |
같은 문제를 다른 각도에서 푼 프로젝트도 있습니다. flash-moe는 순수 C와 Metal 구현으로 큰 MoE 모델을 맥북에서 실행하는 쪽에 집중했고, FreeToken은 게이밍 데스크톱 수준의 하드웨어에서 프론티어급 MoE를 서빙하는 조건을 연구로 정리했습니다. edge0가 이들과 구분되는 점은 전문가 로딩을 기다리지 않도록 라우팅을 한 스텝 먼저 예측하는 장치를 모델과 함께 학습해 배포한다는 것입니다.
edge0는 누구에게 맞는가
Apple Silicon 맥에서 35B급 MoE 모델을 직접 실행해 보고 싶은데 통합 메모리가 24GB 안팎이라면 edge0가 맞는 선택입니다. 4비트 체크포인트가 edge0-35b 기준 약 23GB로 디스크를 많이 쓰지만, 전문가 가중치는 mmap으로 필요할 때만 읽으므로 램에 미리 올리지 않습니다. OpenAI 호환 엔드포인트를 제공하므로 기존 클라이언트를 그대로 붙여 볼 수도 있습니다.
반대로 CUDA GPU 서버에 배포하려는 팀에게는 현재 시점의 edge0가 적절한 선택이 아닙니다. 프로젝트는 MLX 백엔드만 구현되어 있고 CUDA 백엔드는 자리만 예약된 상태라고 명시하고 있으며, 그 밖의 플랫폼은 지원하지 않는다고 적어 두었습니다. 두 모델 모두 미리보기(preview) 단계로 공개된 점, 그리고 두 모델 카드 어디에도 지원 언어 목록이 적혀 있지 않고 공개된 평가가 모두 영어 벤치마크라는 점도 감안해야 합니다. 한국어 작업에 쓰려면 기반 모델의 한국어 능력을 직접 확인해 보는 편이 안전합니다.
edge0의 동작 원리
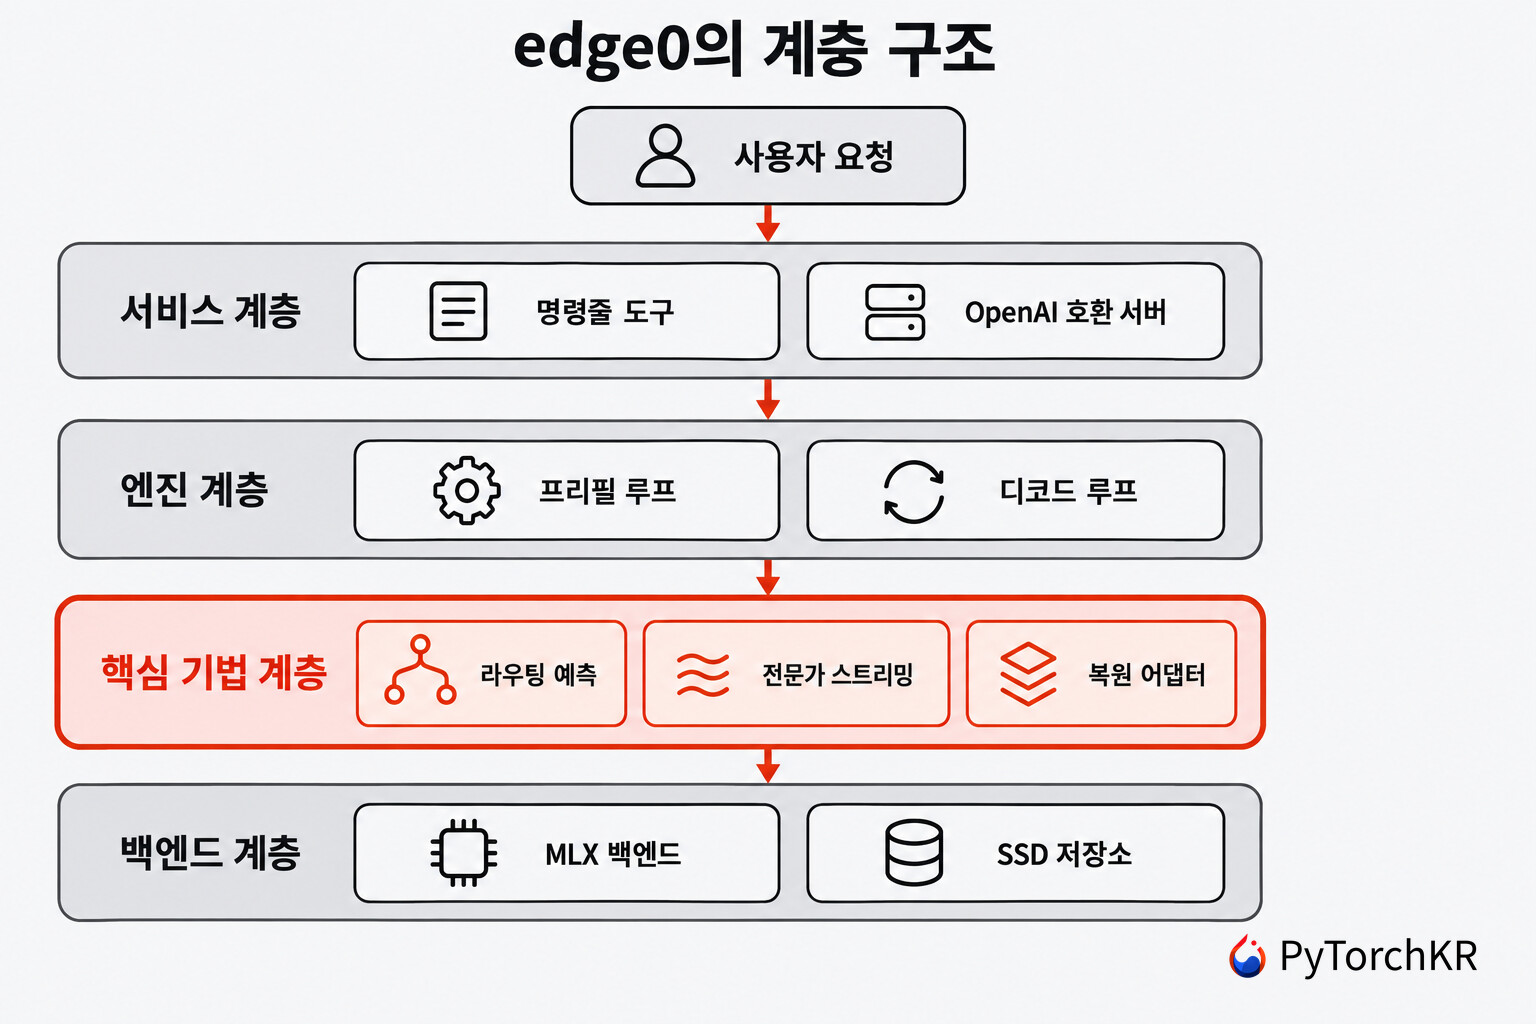
edge0의 코드는 요청을 받는 서비스 계층부터 MLX 백엔드까지 계층으로 나뉘어 있고, 프레임워크의 성격을 결정하는 것은 그 가운데에 놓인 세 가지 기법입니다:
SSD 전문가 스트리밍
전문가 가중치는 단일 파일 안의 바이트 범위를 mmap으로 읽는 SafetensorsMmap, 층을 가로질러 공유되는 LRU 캐시 SharedExpertCache, 층마다 하나씩 놓이는 상태 기계 StreamingSwitchGLU로 다뤄집니다. 양자화 레이아웃은 4비트 어파인 양자화에 그룹 크기 64이고, 계산은 MLX의 양자화 게더 행렬곱 커널인 gather_qmm이 맡습니다. 프로젝트는 역양자화 이후의 상대 L2 오차가 약 0.24%라고 밝히고, 테스트 허용 오차를 이 값에 맞춰 두었습니다.
실행 경로는 상황에 따라 네 가지로 갈립니다:
| 경로 | 하는 일 | 주로 쓰이는 구간 |
|---|---|---|
| exact | 라우팅 인덱스를 중복 제거한 뒤 전문가별로 읽어 쌓아 계산 | 가장 느리지만 다른 경로의 정확성 기준선 |
| staged | 고정 슬롯 이중 버퍼링, 인덱스가 GPU를 벗어나지 않음 | 디코드 단계의 주력 |
| hot | 층마다 상위 N개 전문가를 LRU에 상주시킴 | 자주 쓰이는 전문가 처리 |
| full-layer | 층의 9개 텐서를 한 번에 올려 정렬 게더로 계산 | 프리필 단계의 주력 |
tests/test_streaming_math.py는 네 경로를 각각 역양자화 기준 구현과 원소 단위로 비교해 상대 L2 오차 1% 미만을 요구합니다. 게이트와 업 가중치가 뒤바뀌거나 행이 어긋나면 이 오차가 약 0.2%에서 약 100%로 튀기 때문에, 번들 순서 실수가 조용히 지나가지 않습니다.
라우팅을 한 스텝 먼저 예측하는 프리라우터
MoE 디코드는 매 스텝마다 이전 층의 출력에서 다음 층의 전문가 선택이 나옵니다. 가중치가 SSD에 있으면 라우팅 결과가 나올 때까지 기다렸다가 읽어야 하므로, 스텝마다 저장장치 대기가 생깁니다. edge0는 층마다 작은 예측 헤드를 붙여 이 순서를 뒤집었습니다. 층 N이 소유한 프리라우터 헤드는 토큰 t에서 층 N의 MoE 입력을 받아 층 N+1의 라우팅을 예측하고, 층 N+1은 토큰 t-1에 만들어진 예측을 소비합니다. 층과 토큰 양쪽으로 한 칸씩 당겨 둔 덕분에 전문가 로딩이 생성과 겹쳐 돌아갑니다.
헤드의 입력 특징은 은닉 상태와 현재 토큰 상위 K개 원핫, 이전 토큰 상위 K개 원핫을 이어 붙인 벡터이고, 구조는 fc1 다음에 erf 기반 gelu, 그다음 fc2에 linear_init을 더한 형태입니다. 두 등급의 설정은 서로 다릅니다. edge0-35b는 소프트맥스 상위 K 라우팅에 헤드 33개(6번부터 38번 층), edge0-8b는 그룹 제한 시그모이드 라우팅에 헤드 16개(7번부터 22번 층)이고, 두 등급 모두 첫 소비 층은 7번이며 은닉 차원은 512입니다. 저장소는 이 예측으로 디코드 처리량이 최대 59%까지 올라간다고 밝히면서, 저장장치 지연과 모델 크기, 라우팅 폭 K가 커질수록 이득도 커진다고 덧붙였습니다.
4비트 품질을 되돌리는 Recover-LoRA
4비트로 줄인 기본 가중치는 그대로 얼려 두고, 부동소수점 교사 모델에서 증류(Distillation)해 학습한 LoRA 어댑터로 양자화 손실을 되돌리는 방식입니다. 어댑터를 기본 가중치에 병합하지 않는 것이 설계상의 선택인데, 읽기 전용 기본 체크포인트 하나로 여러 어댑터 집합을 서비스할 수 있고 어댑터를 갱신할 때 파일만 교체하면 되기 때문입니다. LoRA와 프리라우터 가중치는 모두 출처 메타데이터를 담은 .safetensors 파일이며, 모델 디렉토리 또는 저장소 루트의 artifacts/에서 자동으로 찾습니다. 두 파일 중 하나라도 없으면 실행이 중단되고, --no-prerouter나 --no-lora를 주면 기본 모델만으로 돌릴 수 있습니다.
edge0의 품질과 속도 측정값
품질 수치는 개발사 Edge0가 OpenCompass로 직접 측정해 공개한 값입니다. edge0 모델(4비트에 학습된 어댑터와 프리라우터 라우팅 적용)과 원본 fp16 기본 모델을 같은 설정과 파라미터로 돌린 결과이며, 저장소는 평균 손실을 edge0-35b 3.9점, edge0-8b 2.8점으로 정리했습니다. 100점 만점 기준입니다:
| 벤치마크 | edge0-35b (int4) | Qwen3.6-35B-A3B (fp16) | edge0-8b (int4) | Ling 3.0 tiny (fp16) |
|---|---|---|---|---|
| AIME 2026 | 86.6 | 92.7 | 63.3 | 73.3 |
| HumanEval | 90.9 | 95.1 | 91.5 | 92.7 |
| GPQA-Diamond | 79.8 | 81.8 | 70.7 | 71.2 |
| MMLU-Pro | 81.0 | 84.6 | 70.1 | 65.8 |
| IFBench | 57.9 | 61.7 | 53.9 | 60.6 |
| 평균 | 79.2 | 83.2 | 69.9 | 72.7 |
다만 항목별로 보면 손실 폭이 고르지 않습니다. AIME 2026에서 edge0-35b가 6.1점, edge0-8b가 10.0점 떨어져 두 등급 모두 낙폭이 가장 큽니다. 반대로 MMLU-Pro에서는 edge0-8b가 기본 모델보다 4.3점 높고, HumanEval에서도 edge0-8b가 기본 모델과 1.2점 차이로 가장 가깝습니다.
속도는 examples/bench.py로 측정한 값입니다. 3.3k 토큰 프롬프트를 프리필한 뒤 10스텝을 예열하고 200개 토큰을 시간 측정하며 디코드하는 절차를 등급마다 2회 반복했고, 테스트 기기는 24GB 메모리의 Mac mini M4 Pro입니다:
| 등급 | 디코드 속도 | 프리필 처리량(콜드/웜) | 피크 활성 메모리 |
|---|---|---|---|
edge0-35b |
14.9~17.7 tok/s | 113 / 140 tok/s | 2.9 GiB |
edge0-8b |
23.9~25.3 tok/s | 500 / 1428 tok/s | 1.0 GiB |
여기서 콜드는 프로세스를 시작한 뒤의 첫 요청으로, 전문가 가중치를 SSD에서 처음 읽어 오는 상태입니다. 웜은 페이지 캐시에 데이터가 남아 있는 이후 요청이고, 프리필 처리량은 약 3.3k 토큰 프롬프트 전체에 대한 값입니다.
edge0 설치와 사용
MLX 백엔드는 Apple Silicon(M1/M2/M3/M4) 맥에서만 동작하고, Python은 3.10 이상(3.12 권장)이 필요합니다. mlx==0.30.6과 mlx-metal==0.30.6, mlx-lm==0.31.0 조합을 쓰며, Apple A18 계열에서 여러 언어가 섞인 깨진 출력이 나오면 mlx 버전이 낮은 경우라고 저장소가 안내하고 있습니다. 설치는 저장소를 받아 가상환경에 편집 모드로 넣는 방식입니다:
python3.12 -m venv .venv && .venv/bin/pip install -e '.[dev,fetch]'
모델은 저장소가 제공하는 헬퍼로 내려받습니다. 4비트 체크포인트는 edge0-35b가 약 23GB, edge0-8b가 약 4.2GB이고, 각 저장소에 기본 체크포인트와 어댑터가 함께 들어 있어 한 번의 다운로드로 실행 준비가 끝납니다:
.venv/bin/python scripts/fetch_models.py --tier edge0-35b --target-dir models
.venv/bin/python scripts/fetch_models.py --tier edge0-8b --target-dir models
등급 이름은 환경 변수로 로컬 디렉토리에 연결하거나, 디렉토리를 직접 넘기면 체크포인트의 config.json에서 자동으로 판별됩니다. 데모 실행과 서버 구동, 한 번짜리 대화는 각각 다음 명령으로 합니다:
export EDGE0_35B_MODEL=$PWD/models/edge0-35b
export EDGE0_8B_MODEL=$PWD/models/edge0-8b

edge0 demo edge0-35b
edge0 serve edge0-35b
edge0 chat edge0-35b --prompt "Explain streaming inference in one sentence."
edge0 serve는 OpenAI 호환 /v1/chat/completions 엔드포인트를 띄우므로 다음과 같이 확인할 수 있습니다:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"messages":[{"role":"user","content":"Hello!"}],"max_tokens":32}'
파이썬에서 직접 쓸 때는 transformers와 비슷한 형태의 AutoEngine으로 시작합니다. 아래는 저장소가 제공하는 최소 예시이며, examples/demo.py가 같은 경로를 따릅니다:
from edge0 import AutoEngine
from edge0.server.chat import ChatMessage, ChatRequest, ChatSession

engine = AutoEngine.from_pretrained("/path/to/model")  # tier auto-detected
req = ChatRequest(
    model=engine.name,
    messages=[ChatMessage(role="user", content="Hello!")],
    max_tokens=64,
)
tokens, meta = ChatSession(engine, req).run()
print(engine._tok.decode(tokens))
engine.close()   # release mmaps / expert cache
구조를 더 알아보려면 저장소의 docs/ 디렉토리에 아키텍처 개요와 어텐션, MoE, SSD 스트리밍, 프리라우터 문서, 그리고 새 모델을 붙이는 방법이 각각 정리되어 있습니다.
edge0의 라이선스
edge0는 Apache-2.0으로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다. 함께 공개된 두 모델 체크포인트도 모델 카드에 같은 Apache-2.0으로 표기되어 있습니다.
단, 저장소 안에는 다른 프로젝트에서 가져온 파일이 함께 들어 있습니다. NOTICE 파일은 qwen3_next.py가 mlx-lm(MIT)에서, bailing_hybrid.py가 Ling 3.0 MLX 구현(Apache-2.0)에서 왔다고 밝히고 있으므로, 코드를 가져다 재배포하기 전에 이 파일을 먼저 확인해야 합니다.
 Edge0 홈페이지 (edge0를 공개한 개발사의 공식 사이트)
 edge0 문서
 edge0 프로젝트 GitHub 저장소
 edge0 모델 다운로드
더 읽어보기
-
FreeToken: 프론티어급 MoE 모델을 게이밍 데스크톱 수준에서 서빙하기 위한 Edge-Serving에 대한 연구
-
flash-moe: 순수 C와 Metal로 구현한, M3 Max 맥북 프로에서 397B 파라미터 MoE 모델을 실행하는 고성능 추론 엔진
-
Rapid-MLX: Apple Silicon 맥에서 로컬 LLM을 OpenAI 호환 서버로 띄우는 추론 엔진
-
cider: Apple Silicon M5의 INT8 TensorOps로 LLM prefill 속도를 끌어올리는 MLX W8A8 추론 SDK
-
Bonsai 27B: 노트북과 폰에서 실행되는 27B급 이진 및 삼진 저비트 LLM (feat. PrismML)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
