핵심 요약
- 브라질의 Dharma AI가 Hugging Face 블로그 글에서 소형 모델의 토크나이저 어휘를 도메인에 맞게 다시 만드는 방법인 VocabX의 결과 일부를 먼저 공개했습니다. 논문은 아직 심사 중이며 공개 전이고, 이번 글에 코드는 포함되지 않았습니다.
- VocabX는 토큰의 등장 빈도가 아니라 그 토큰을 줄였을 때 아끼는 비용으로 어휘를 고릅니다. 채점 모델에서 잰 비용 비율(출력 토큰 하나가 입력 토큰 하나의 7.4배)을 가중치로 씁니다.
- 포르투갈어 에세이 채점 모델(Qwen3-4B 기반)에서 응답 길이는 평균 350토큰에서 101토큰으로, 실측 추론(inference) 비용은 77.0% 줄었고 자체 품질 점수는 0.703에서 0.810으로 올랐습니다. RTX 5090과 vLLM에서 요청 500건으로 잰 결과입니다.
- 5개 공개 도메인과 3개 모델 계열 비교에서는 15개 조합 모두 가장 강한 기존 방법보다 토큰을 더 줄였습니다. 다만 이 비교의 비용 수치는 실측이 아니라 계산으로 낸 추정치입니다.
VocabX 소개
토크나이저(tokenizer) 는 텍스트를 모델이 읽고 쓰는 단위인 토큰으로 나누는 구성 요소입니다. 보통은 기반 모델의 고정된 속성으로 취급해 미세조정(fine-tuning) 때도 그대로 물려받습니다. Qwen이나 Gemma 같은 범용 공개 모델의 토크나이저는 여러 언어와 코드, 계약서까지 아우르도록 만들어졌습니다. 그런데 이 모델을 한 가지 작업에만 쓰도록 특화하면, 그 작업이 가장 자주 쓰는 표현이 여러 토큰으로 잘게 쪼개지는 일이 생깁니다.
이번에 소개할 VocabX는 이 문제를 다루는 방법입니다. 브라질 리우데자네이루에서 도메인 특화 소형 언어 모델을 만드는 Dharma AI가 2026년 10월 21일 블로그 글로 결과 일부를 먼저 공개했습니다. Dharma AI는 이전에 PyTorchKR에서 소개한 DharmaOCR의 DPO 연구를 낸 곳이기도 합니다. 저자들은 VocabX를 "토큰의 빈도가 아니라 비용을 기준으로 어휘를 특화하는 방법"이라고 설명합니다.
실험 대상은 Dharma AI가 실제 서비스에 쓰는 포르투갈어 에세이 자동 채점 모델입니다. 이 모델은 에세이와 문제, 참고 지문을 받아 역량(Competência)마다 점수와 코멘트를 담은 JSON을 돌려줍니다. 이미 4B 규모로 작고 작업에 맞게 학습도 마친 모델이었지만, 토크나이저는 Qwen3-4B 원본 그대로였습니다. 저자들은 기반 모델과 데이터, 학습 방법은 그대로 두고 어휘만 다시 만들었습니다.
먼저 이 글의 성격을 밝혀 둡니다. 원문은 곧 공개할 논문의 미리보기이며, 저자들은 수치가 심사 중인 현재 판의 것이라 발표 전에 바뀔 수 있다고 적었습니다. 이 게시물은 그 블로그 글과 그림을 정리하고, 원문 그림의 토큰 수를 PyTorchKR이 Qwen3 토크나이저로 다시 세어 본 결과를 더했습니다. VocabX의 학습이나 추론은 직접 재현하지 않았습니다.
범용 어휘가 특화 모델에 만드는 두 가지 낭비
저자들은 범용 어휘가 단일 도메인 모델에 두 종류의 낭비를 동시에 만든다고 설명합니다.
첫째는 조각화(fragmentation) 입니다. 도메인이 가장 자주 반복하는 표현이 여러 토큰으로 나뉩니다. 채점 모델의 응답은 매번 같은 JSON 틀, 같은 역량 이름, 같은 평가 문구로 시작합니다. 계약서라면 정형 조항, 코드라면 식별자가 같은 역할을 합니다. 하나로 충분한 자리에 여러 토큰을 쓰고, 그 비용을 요청마다 냅니다.
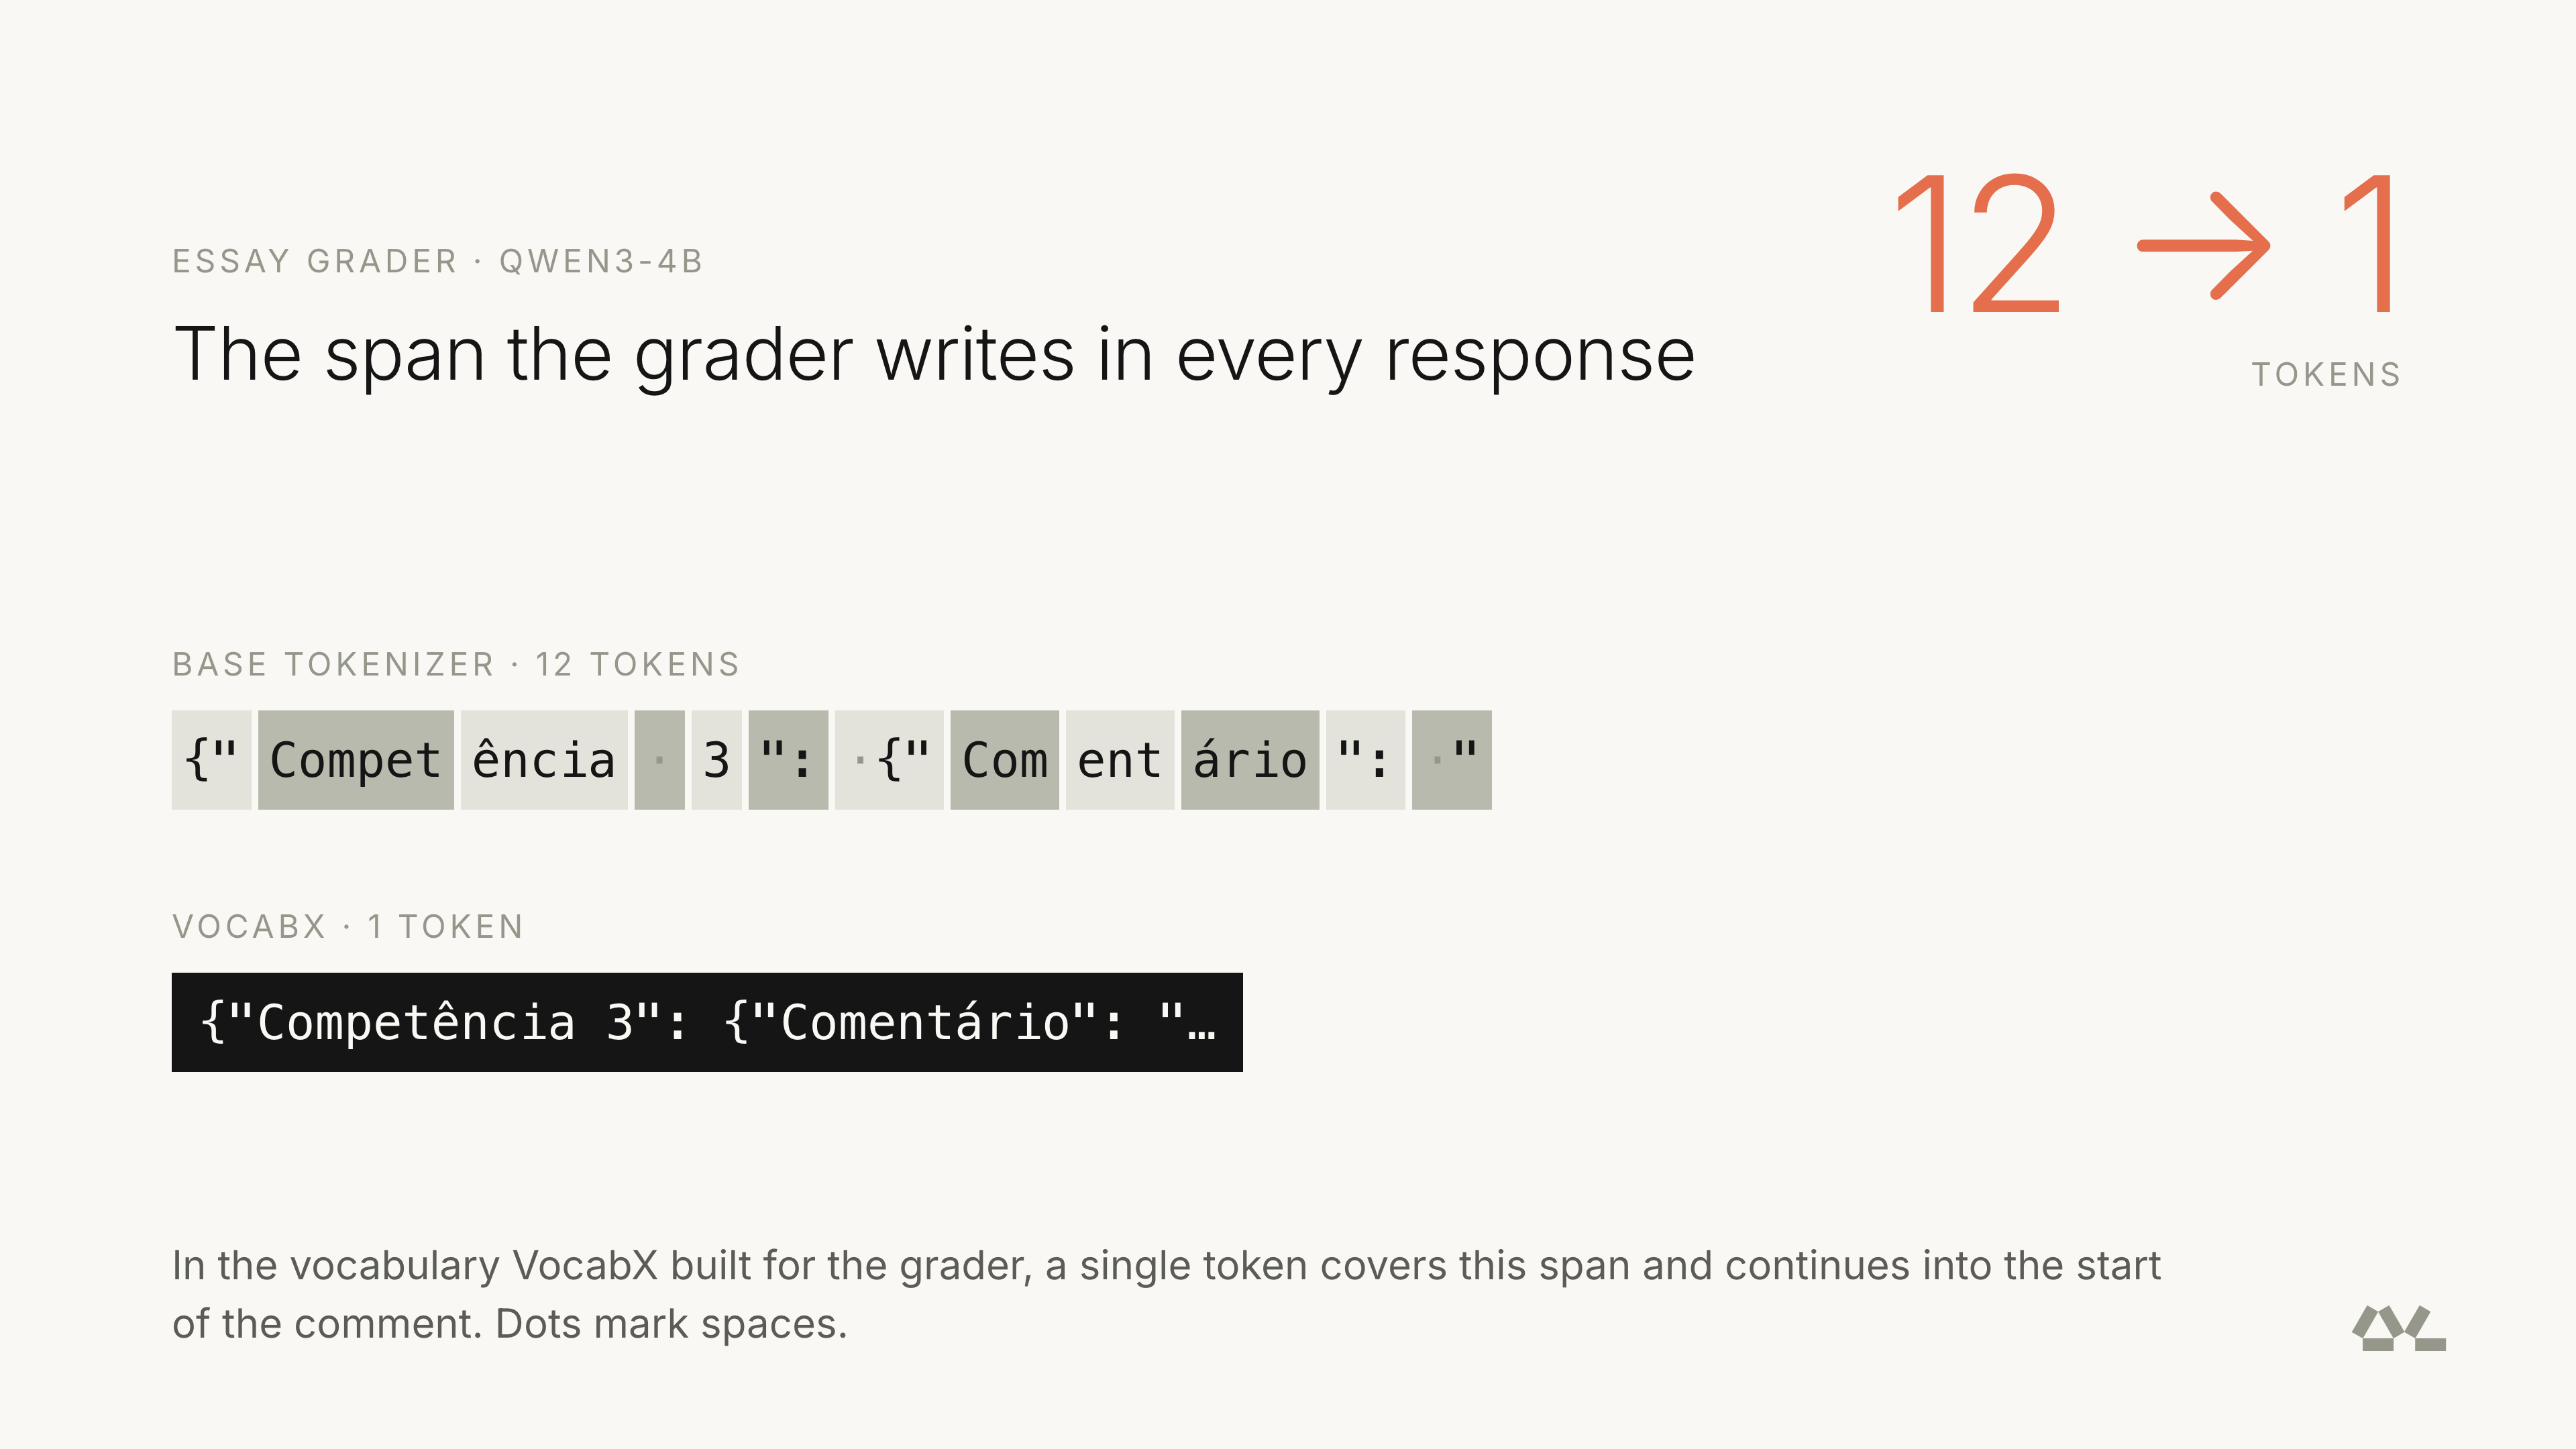
위 그림은 채점 모델이 모든 응답에 쓰는 {"Competência 3": {"Comentário": " 구간입니다. 기본 토크나이저로는 12토큰이지만, VocabX가 만든 어휘에서는 이 구간과 코멘트 앞부분까지가 토큰 하나입니다.
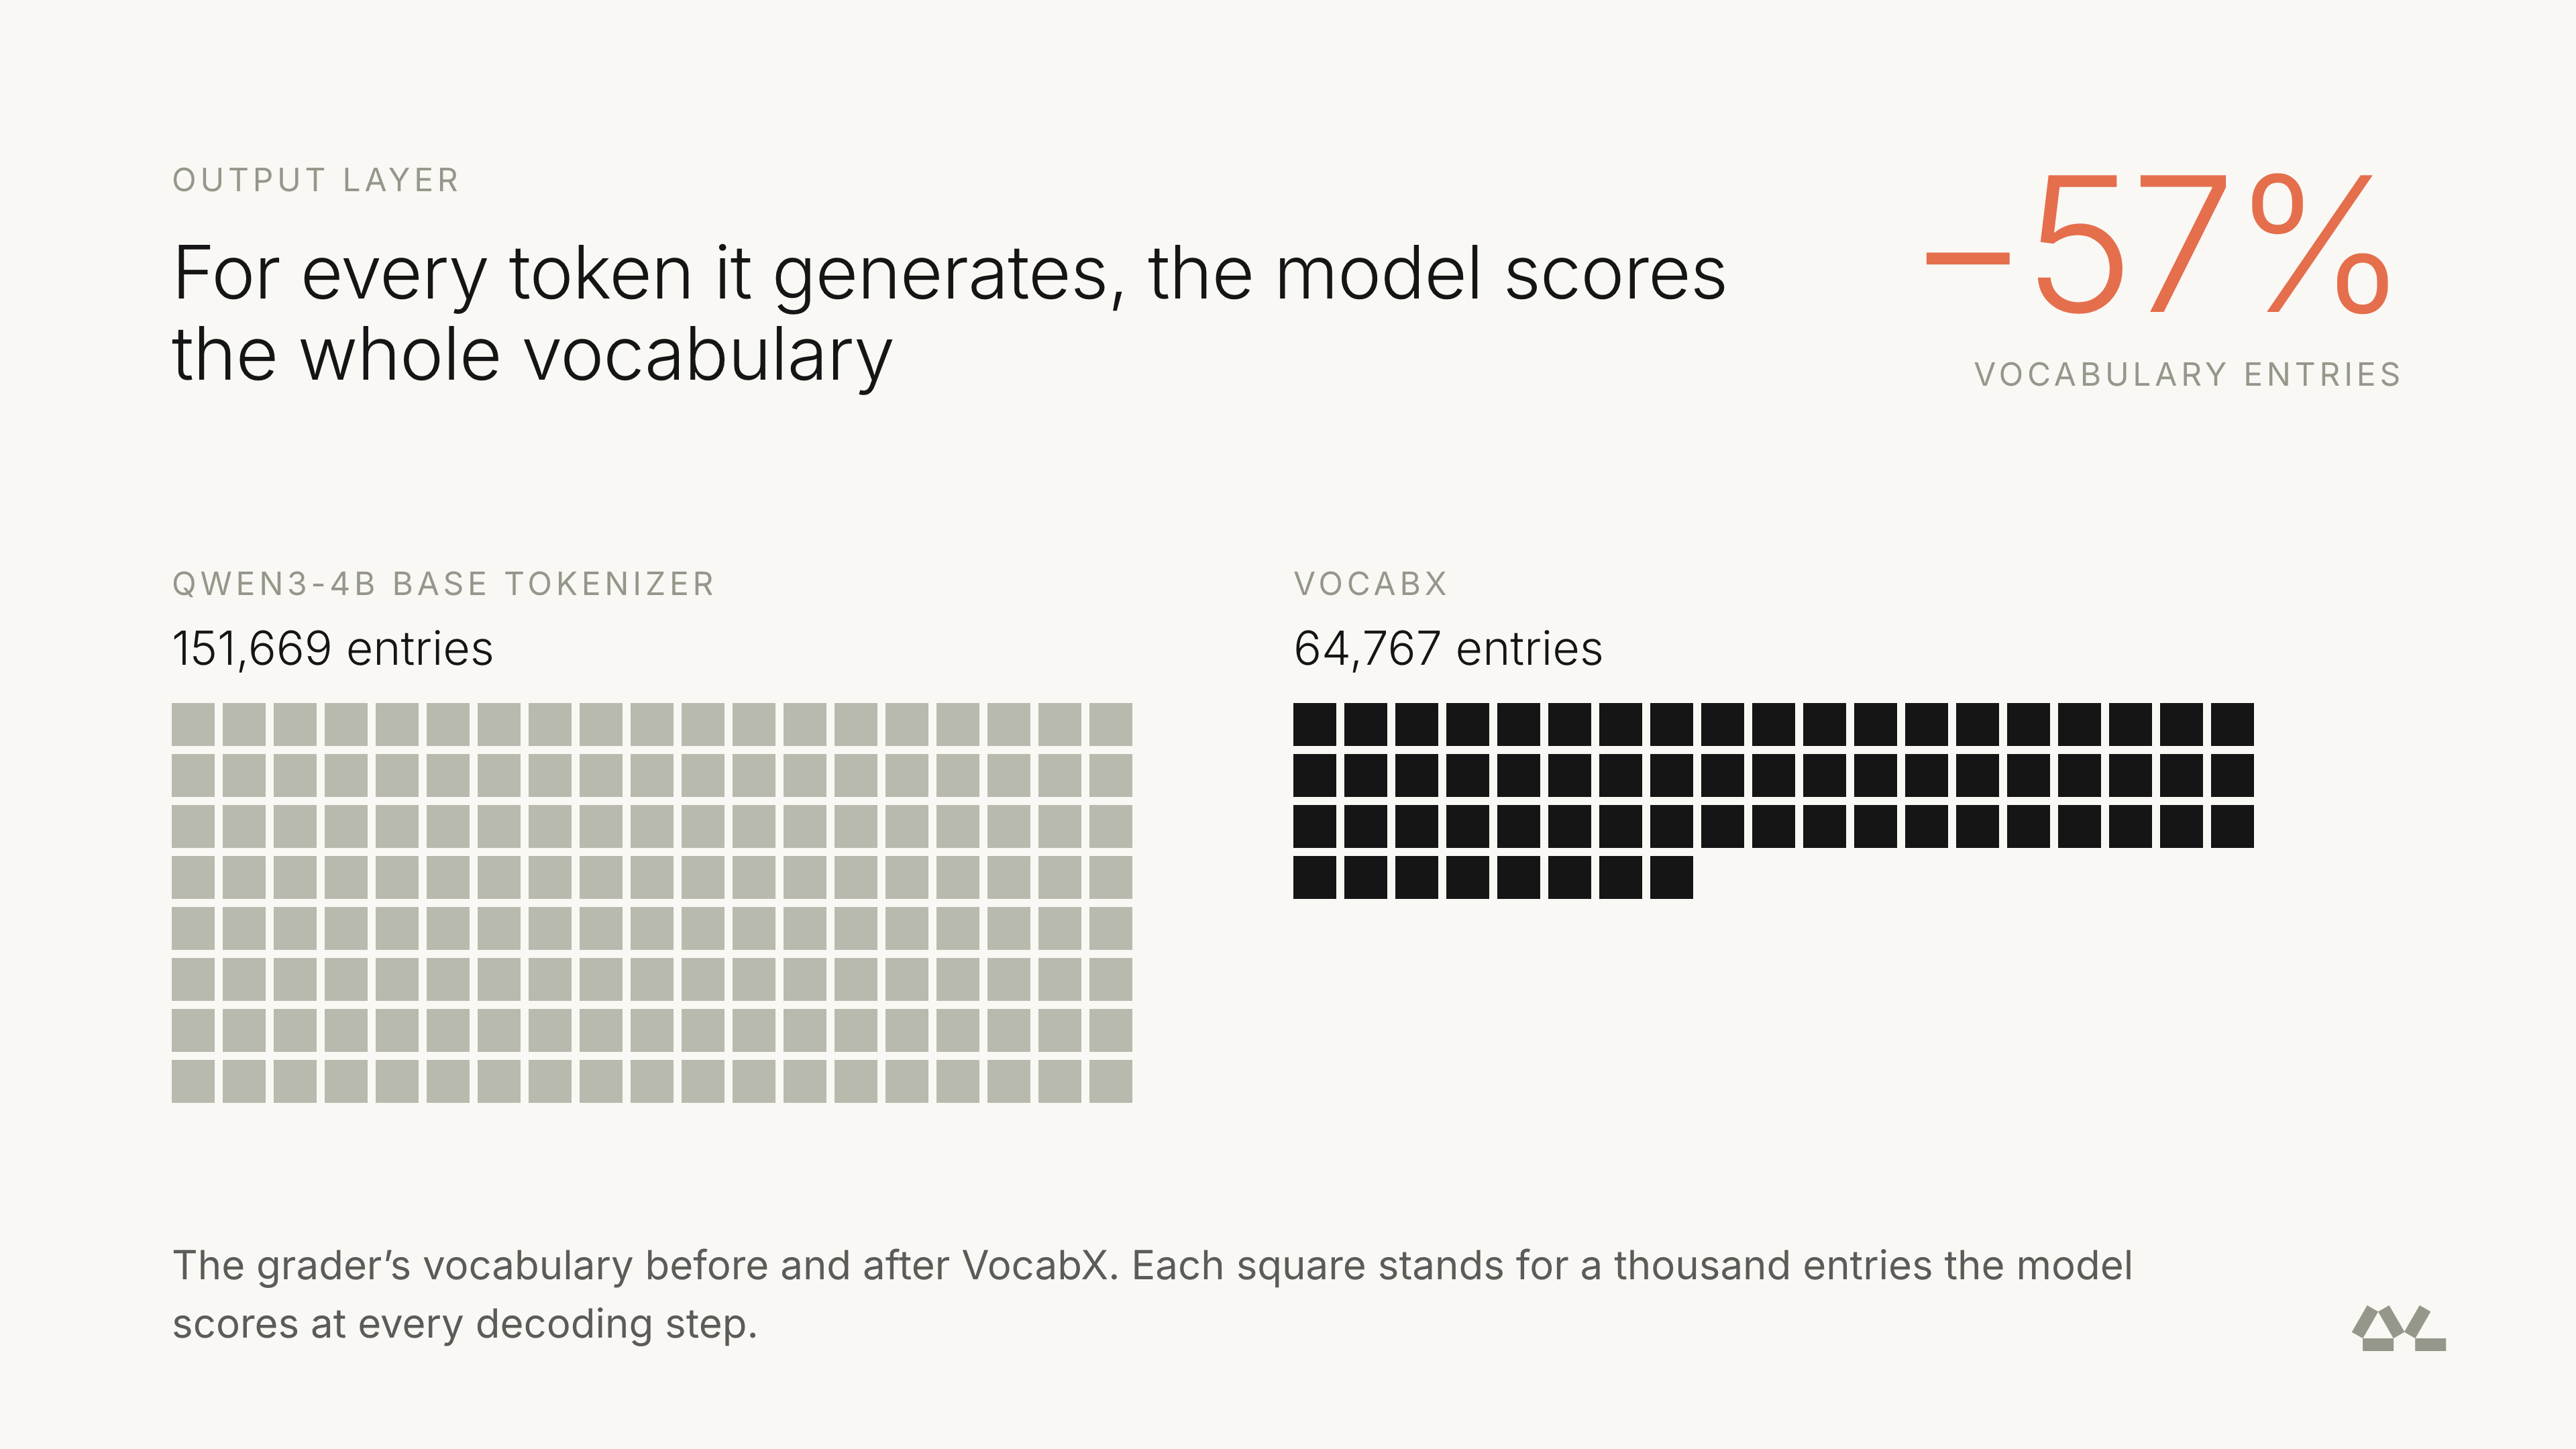
둘째는 과잉(excess) 입니다. 어휘에는 그 도메인이 거의 쓰지 않는 항목이 수만 개 들어 있고, 모델은 토큰을 하나 생성할 때마다 이 모든 항목의 점수를 계산합니다. 저자들의 예를 빌리면, 미국 학교의 생물 시험을 채점하도록 조정한 모델은 중국어를 거의 쓰지 않는데도 매 단계 모든 중국어 토큰의 확률을 계산합니다. 채점 모델의 어휘는 VocabX를 거쳐 151,669개에서 64,767개로 57% 줄었습니다.
원문의 토큰 수를 Qwen3 토크나이저로 다시 세어 본 결과
원문 그림의 토큰 수가 실제 Qwen3 토크나이저와 맞는지, 같은 현상이 한국어에서는 어떻게 나타나는지 확인했습니다. 2026년 10월 26일 Qwen/Qwen3-4B 저장소의 tokenizer.json을 tokenizers 0.23.2로 불러와 특수 토큰 없이 인코딩했습니다. 한국어 행은 원문 예시를 PyTorchKR이 옮긴 문장이며, 원문은 한국어를 실험하지 않았습니다.
| 입력 | Qwen3 토큰 수 | 비고 |
|---|---|---|
{"Competência 3": {"Comentário": " |
12 | 원문 그림과 같음 |
Repertório Sociocultural: |
7 | 원문 그림과 같음 |
This Agreement shall be enforceable to the fullest extent allowed by law. |
14 | 원문 그림과 같음 (VocabX는 4토큰) |
{"역량 3": {"코멘트": " |
12 | 역, 량, 코, 멘, 트가 각각 한 토큰 |
본 계약은 법률이 허용하는 최대 범위 내에서 집행될 수 있다. |
24 | 허와 범은 바이트 조각 3개로 나뉨 |
원문 그림의 세 가지 토큰 수는 모두 그대로 재현되었습니다. 같은 뜻의 계약 문장은 영어 14토큰, 한국어 24토큰이었습니다. 이 결과는 Qwen3 어휘가 한국어 도메인 문장도 잘게 나눈다는 것까지만 보여줍니다. VocabX가 한국어에서 얼마나 줄일지는 원문에 근거가 없습니다. 여러 공개 모델 토크나이저의 한국어 효율은 LFM2.5-24B-A2B 게시물에서 위키백과 문서로 비교한 적이 있습니다.
출력 토큰이 입력 토큰보다 비싼 이유: 프리필과 디코드
토큰 수를 줄이면 비용도 줄어든다고 생각하기 쉽지만, 저자들은 "토큰 수가 곧 청구서는 아니다"라고 말합니다. 추론은 두 단계로 나뉩니다. 프리필(prefill) 은 입력 전체를 한 번에 처리하는 단계로, GPU 메모리에서 읽은 가중치를 모든 입력 토큰에 재사용하므로 연산량이 한계입니다. 디코드(decode) 는 응답을 한 토큰씩 생성하는 단계입니다. 토큰마다 네트워크 전체를 한 번 통과해야 해서, GPU는 대부분의 시간을 메모리에서 데이터가 오기를 기다리며 보냅니다. 이때 한계는 메모리 대역폭(memory bandwidth) 입니다.
저자들은 이 효과가 자신들이 서비스하는 조건, 즉 작은 모델을 중간 크기의 배치로 서빙할 때 가장 크다고 설명합니다. 배치로 묶으면 가중치 읽기를 요청끼리 나눠 부담하지만 문제가 사라지지는 않습니다. 디코드는 매 단계 KV(Key-Value) 캐시(이미 처리한 맥락을 담는 어텐션 메모리)도 읽어야 하고, 이 캐시는 맥락이 길어질수록 커집니다. 프리필과 디코드가 서빙 엔진에서 어떻게 나뉘어 처리되는지는 Nano-vLLM 내부 구조 게시물에 자세히 정리되어 있습니다.
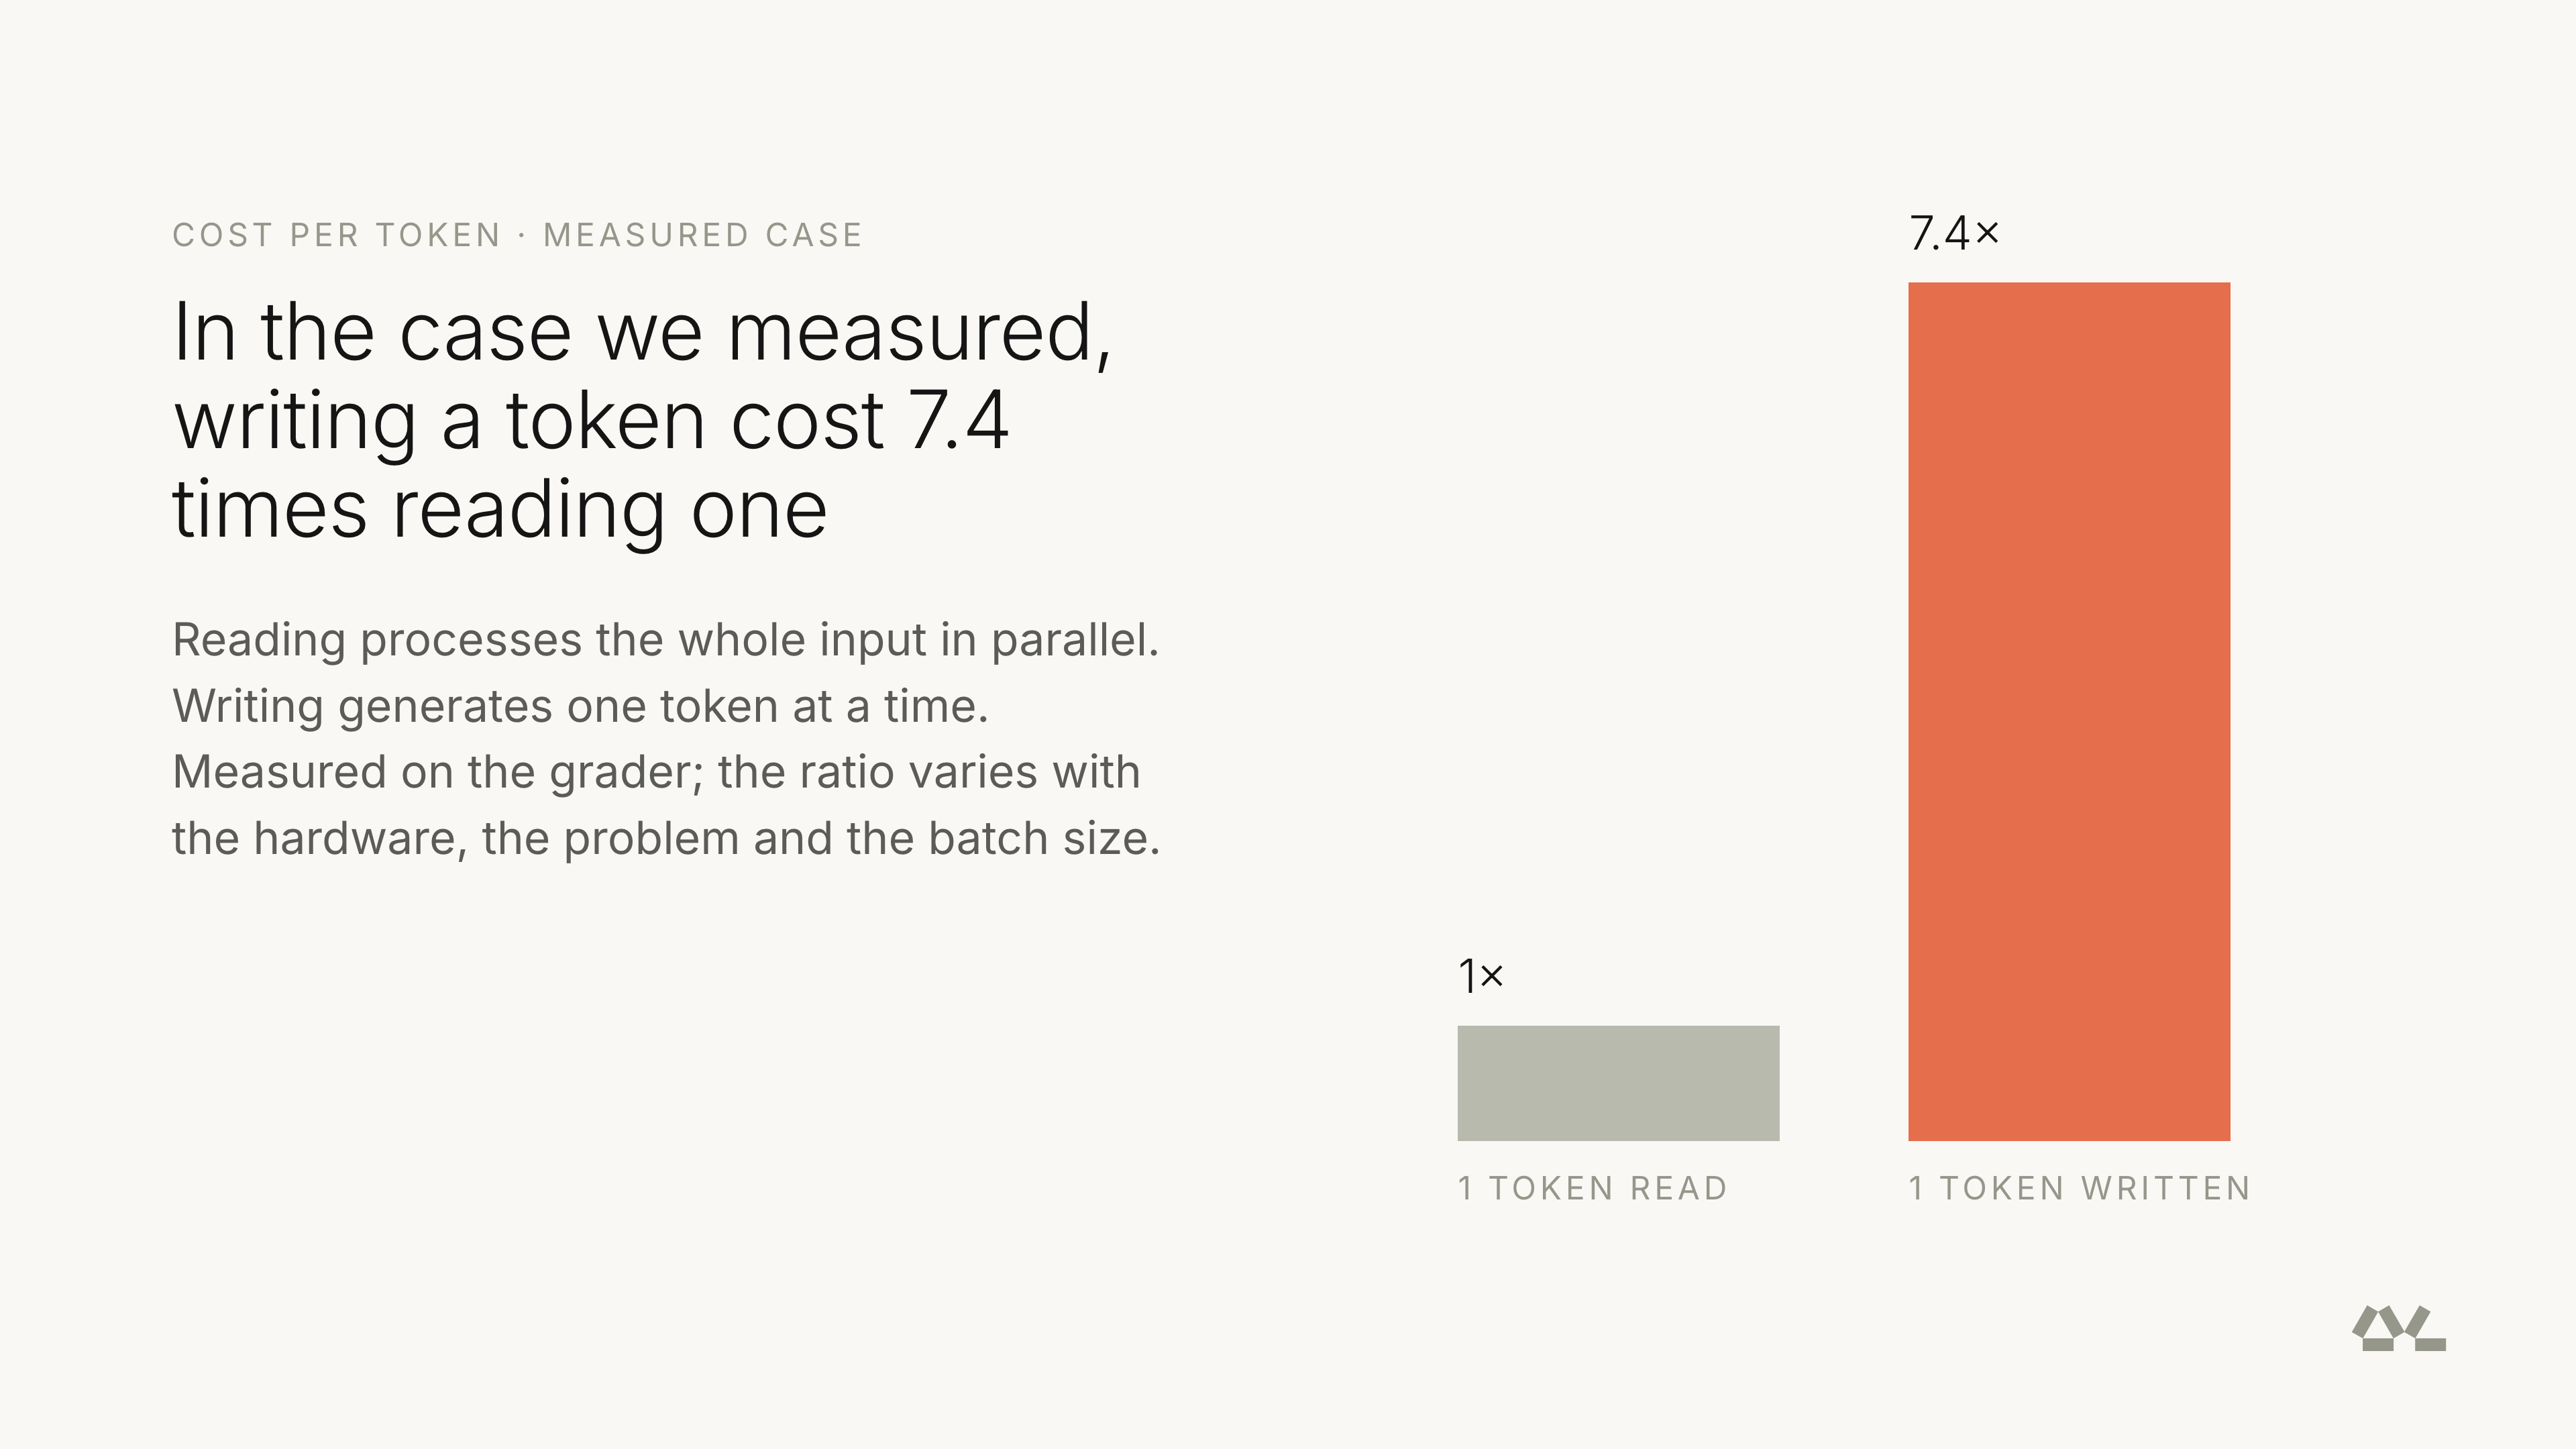
채점 모델에서 잰 값으로는 토큰 하나를 생성하는 비용이 읽는 비용의 7.4배였습니다. 저자들은 이 비율이 하드웨어, 문제, 배치 크기, 맥락 길이에 따라 달라지고 더 커질 수도 있다고 덧붙입니다. 원문은 이를 택배에 빗댑니다. 나가는 상자를 들어오는 상자보다 7배 비싸게 받는 택배 회사라면, 나가는 상자를 줄이는 쪽이 7배 더 이득입니다. 따라서 입력과 출력을 똑같이 압축하는 방법으로는 아낄 수 있는 비용의 대부분을 줄이지 못합니다.
여기에 더해, 비용의 세 번째 항목은 어휘 크기 자체입니다. 모델의 마지막 층인 LM 헤드(LM head) 는 내부 상태를 어휘의 모든 토큰에 대한 점수로 바꾸며, 어휘 항목마다 파라미터 한 행을 둡니다. Qwen3-4B의 공개 설정값으로 계산하면 이 행렬은 151,936행(토크나이저 항목 151,669개보다 큰 설정값) × 2,560열, 약 3.9억 개로 전체 4,022,468,096개 파라미터의 약 9.7%입니다. Qwen3-4B는 입력 임베딩과 이 행렬을 공유(tie_word_embeddings: true)하지만, 입력 쪽은 읽는 토큰의 행만 조회하는 반면 LM 헤드는 토큰을 생성할 때마다 행렬 전체를 읽고 곱합니다. 그래서 도메인이 쓰지 않는 항목도 자주 쓰는 항목과 똑같은 비용을 냅니다. 저자들은 바로 이 때문에 토큰을 더 넣으면 토큰 수는 줄어도 비용은 오를 수 있다고 지적합니다.
다만 VocabX의 선택 기준 자체에는 이 어휘 크기 항목이 들어가지 않습니다. 대신 어휘 크기를 두 단계에서 제한합니다. 하위 단어 병합 단계가 기본 어휘를 더 작은 도메인 전용 어휘로 바꾸고, 매크로 토큰은 정해진 예산 안에서만 추가합니다. 그 결과 채점 모델의 출력층은 약 152,000행에서 약 65,000행으로 줄었습니다.
FVT, MWT, In-place BPE의 두 가지 한계
어휘를 도메인에 맞추는 연구는 이전에도 있었습니다. 저자들은 세 가지를 기준 방법으로 삼았습니다. 빠른 어휘 전이(Fast Vocabulary Transfer, FVT)는 모델을 도메인 전용 하위 단어 어휘로 옮기는 압축 방법입니다. 다중 단어 토큰화(Multi-Word Tokenization, MWT)는 자주 나오는 여러 단어 표현을 토큰 하나로 묶는 방법입니다. 세 번째는 Liquid AI의 제자리 토크나이저 확장(In-Place Tokenizer Expansion)입니다.
마지막 방법은 원래 어휘의 병합 규칙을 고정한 채 바이트 쌍 인코딩(Byte Pair Encoding, BPE) 학습을 이어 가는 방식으로, 원문은 이를 in-place BPE라고 부릅니다. BPE는 자주 붙어 나오는 문자 조각 쌍을 하나로 합치는 규칙을 반복해 어휘를 만드는 방법입니다.
세 방법 모두 조각화를 줄입니다. 다만 저자들은 자신들의 문제에 적용했을 때 한계 두 가지를 발견했다고 말합니다.
빈도로 고르는 문제: 기존 방법은 토큰을 빈도로 고릅니다. 입력에 자주 나오는 표현이 응답에 덜 나오는 표현보다 높은 점수를 받습니다. 서빙 비용은 응답 쪽 표현이 더 큰데도 그렇습니다.
한 층만 다루는 문제: 기존 방법은 단어를 조각내는 방식을 조정하거나, 여러 단어로 된 구를 토큰 하나로 합치는 것 중 하나만 합니다. 세 방법 중 두 층을 같은 기준으로 함께 다루는 방법은 없습니다. 채점 모델의 가장 큰 낭비는 JSON 틀처럼 길게 반복되는 구간이었고, 하위 단어 방법은 각 부분을 하나씩 병합한 뒤에야 이 구간을 토큰 하나로 만들 수 있습니다.
VocabX의 세 가지 설계
필드별 가격을 곱한 비용 기준
VocabX는 후보 토큰이 토큰을 몇 개 줄이는지 대신, 비용과 시간을 얼마나 줄이는지를 묻습니다. 후보가 없앤 토큰 하나하나에, 그 토큰이 나온 필드의 가격을 곱합니다. 필드는 시스템 프롬프트, 사용자 메시지, 모델 응답 세 가지입니다. 채점 모델에서는 응답에서 줄인 토큰 하나가 입력에서 줄인 토큰 하나보다 7.4배 가치가 있으므로, 어휘도 그 비율에 맞춰 만들어집니다.
하위 단어 층과 다중 단어 층을 같은 기준으로
VocabX는 두 층을 함께 다룹니다. 하위 단어 층(sub-word layer) 에서는 도메인 단어를 조각내는 방식을 다시 만듭니다. 다중 단어 층(multi-word layer) 에서는 짧은 표현부터 줄 전체, JSON 틀까지 반복되는 구간을 찾아 각각 토큰 하나로 바꿉니다. 저자들은 이렇게 만든 토큰을 매크로 토큰(macro token) 이라고 부릅니다. 두 층의 후보는 같은 비용 기준으로 고르되, 층마다 따로 정한 예산 안에서 고릅니다.
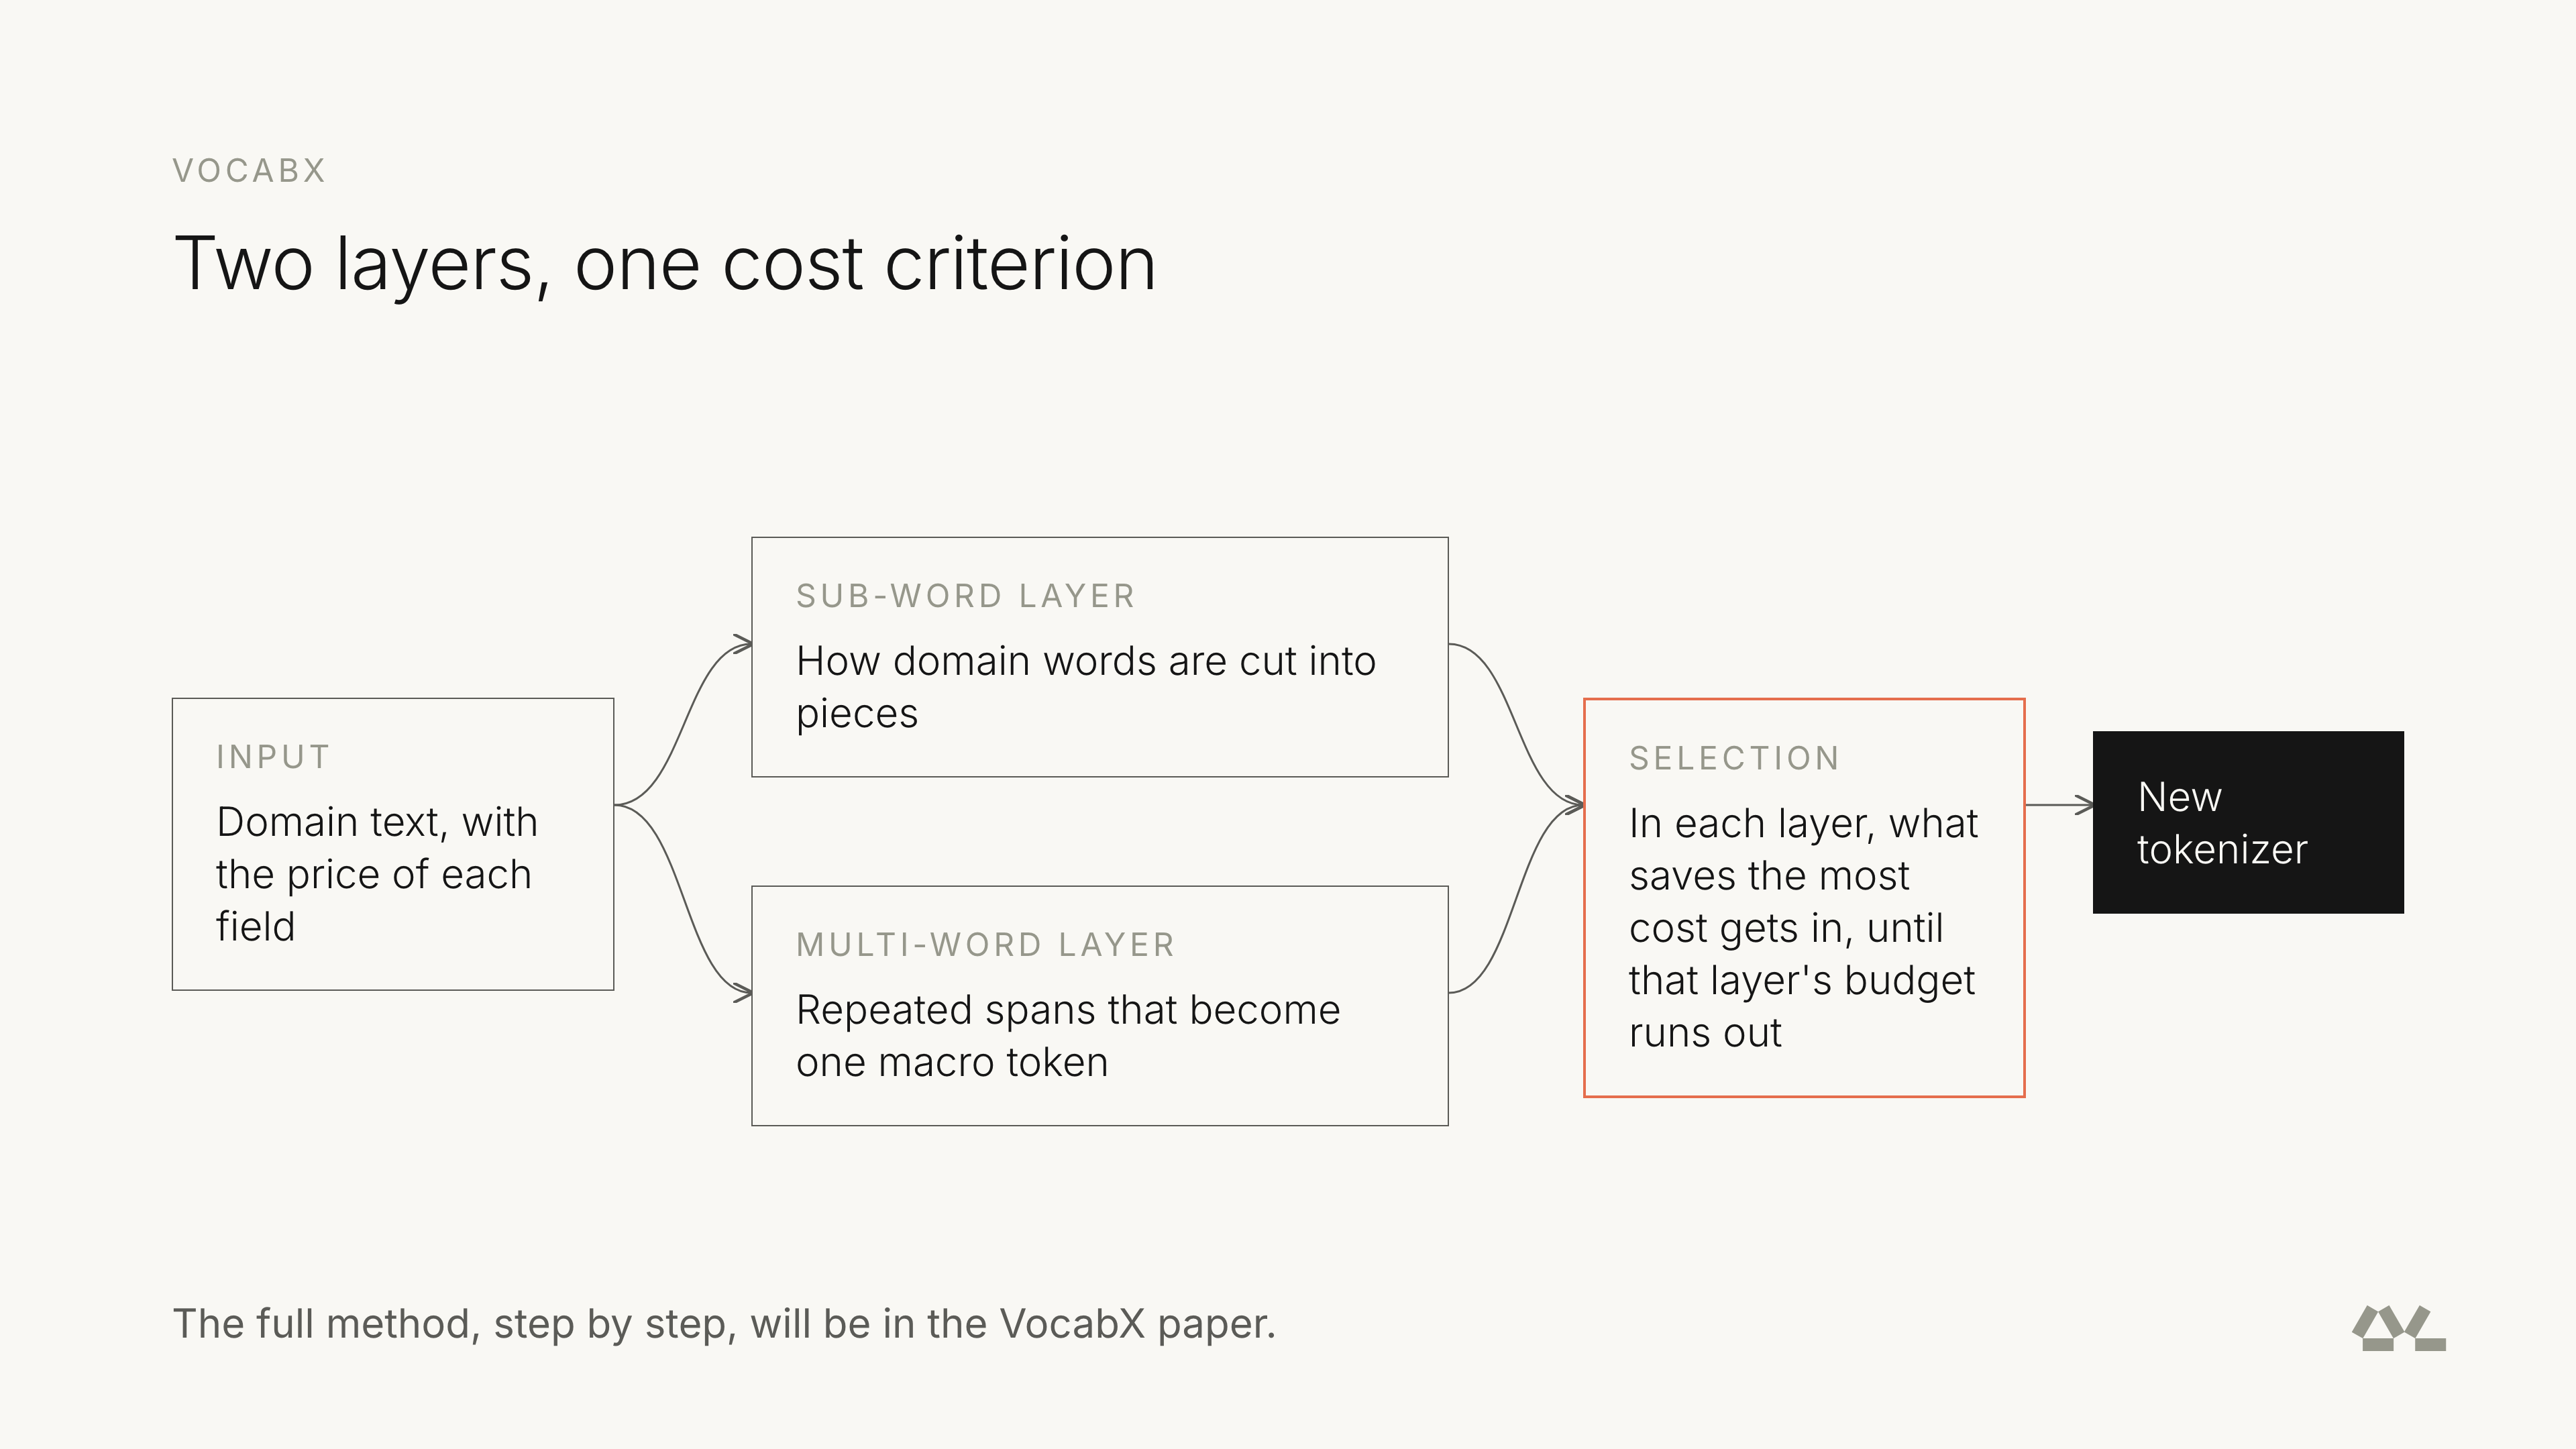
아래 애니메이션은 채점 모델의 Repertório Sociocultural: 구간이 기본 토크나이저로 7토큰, VocabX로 매크로 토큰 1개가 되는 과정을 택배 상자 비유와 함께 보여줍니다.

반복 구간은 마이너(miner) 다섯 개가 찾습니다. 마이너는 말뭉치 전체에서 반복되는 구간을 자동으로 찾는 탐색기로, 각각 긴 단어, 줄 전체, 표현, 완결된 문장, JSON과 태그처럼 구두점이 섞인 구조를 맡습니다. 8개 말뭉치 평균으로는 마지막 구조 마이너의 기여가 가장 컸고, 코드 말뭉치에서는 이 마이너 하나가 17.5%p를 차지했습니다. 다섯 마이너를 모두 빼면 채점 모델의 토큰 감소율이 55.6%p 떨어진다고 저자들은 밝힙니다.
표본에 없는 후보의 이득 추정
비용으로 토큰을 고르려면, 이미 고른 토큰들을 빼고 나서 각 후보가 아직 얼마나 아끼는지 알아야 합니다. 이를 정확히 재려면 토큰을 하나 고를 때마다 말뭉치 전체를 다시 처리해야 하고, 이 작업을 수만 번 반복해야 합니다. 규모가 크면 흔히 일부 문서 표본에서만 재는데, 그러면 표본에 없는 후보는 이득이 0으로 계산됩니다.
저자들의 예로, 문서 50,000개 중 37개에 나오는 표현은 400개 문서 표본에 들어갈 확률이 약 26%에 그칩니다. 계약서 말뭉치에서는 후보의 16.6%만 400개 문서 표본에 나타났고, 나머지는 평가조차 받지 못했습니다.
VocabX는 후보의 이득을 두 부분으로 나눕니다. 말뭉치 전체에서 아끼는 양은 표본 없이 정확히 셀 수 있습니다. 그중 이미 고른 토큰이 아직 덮지 않은 비율만 추정하면 됩니다. 표본에 없는 후보에는 0 대신, 표본에 있는 후보들의 행동을 바탕으로 한 통계적 추정치를 씁니다. 같은 표본과 같은 어휘 예산에서 이 변경만으로 계약서 말뭉치의 토큰 감소율이 44.7%에서 52.8%로 올랐습니다.
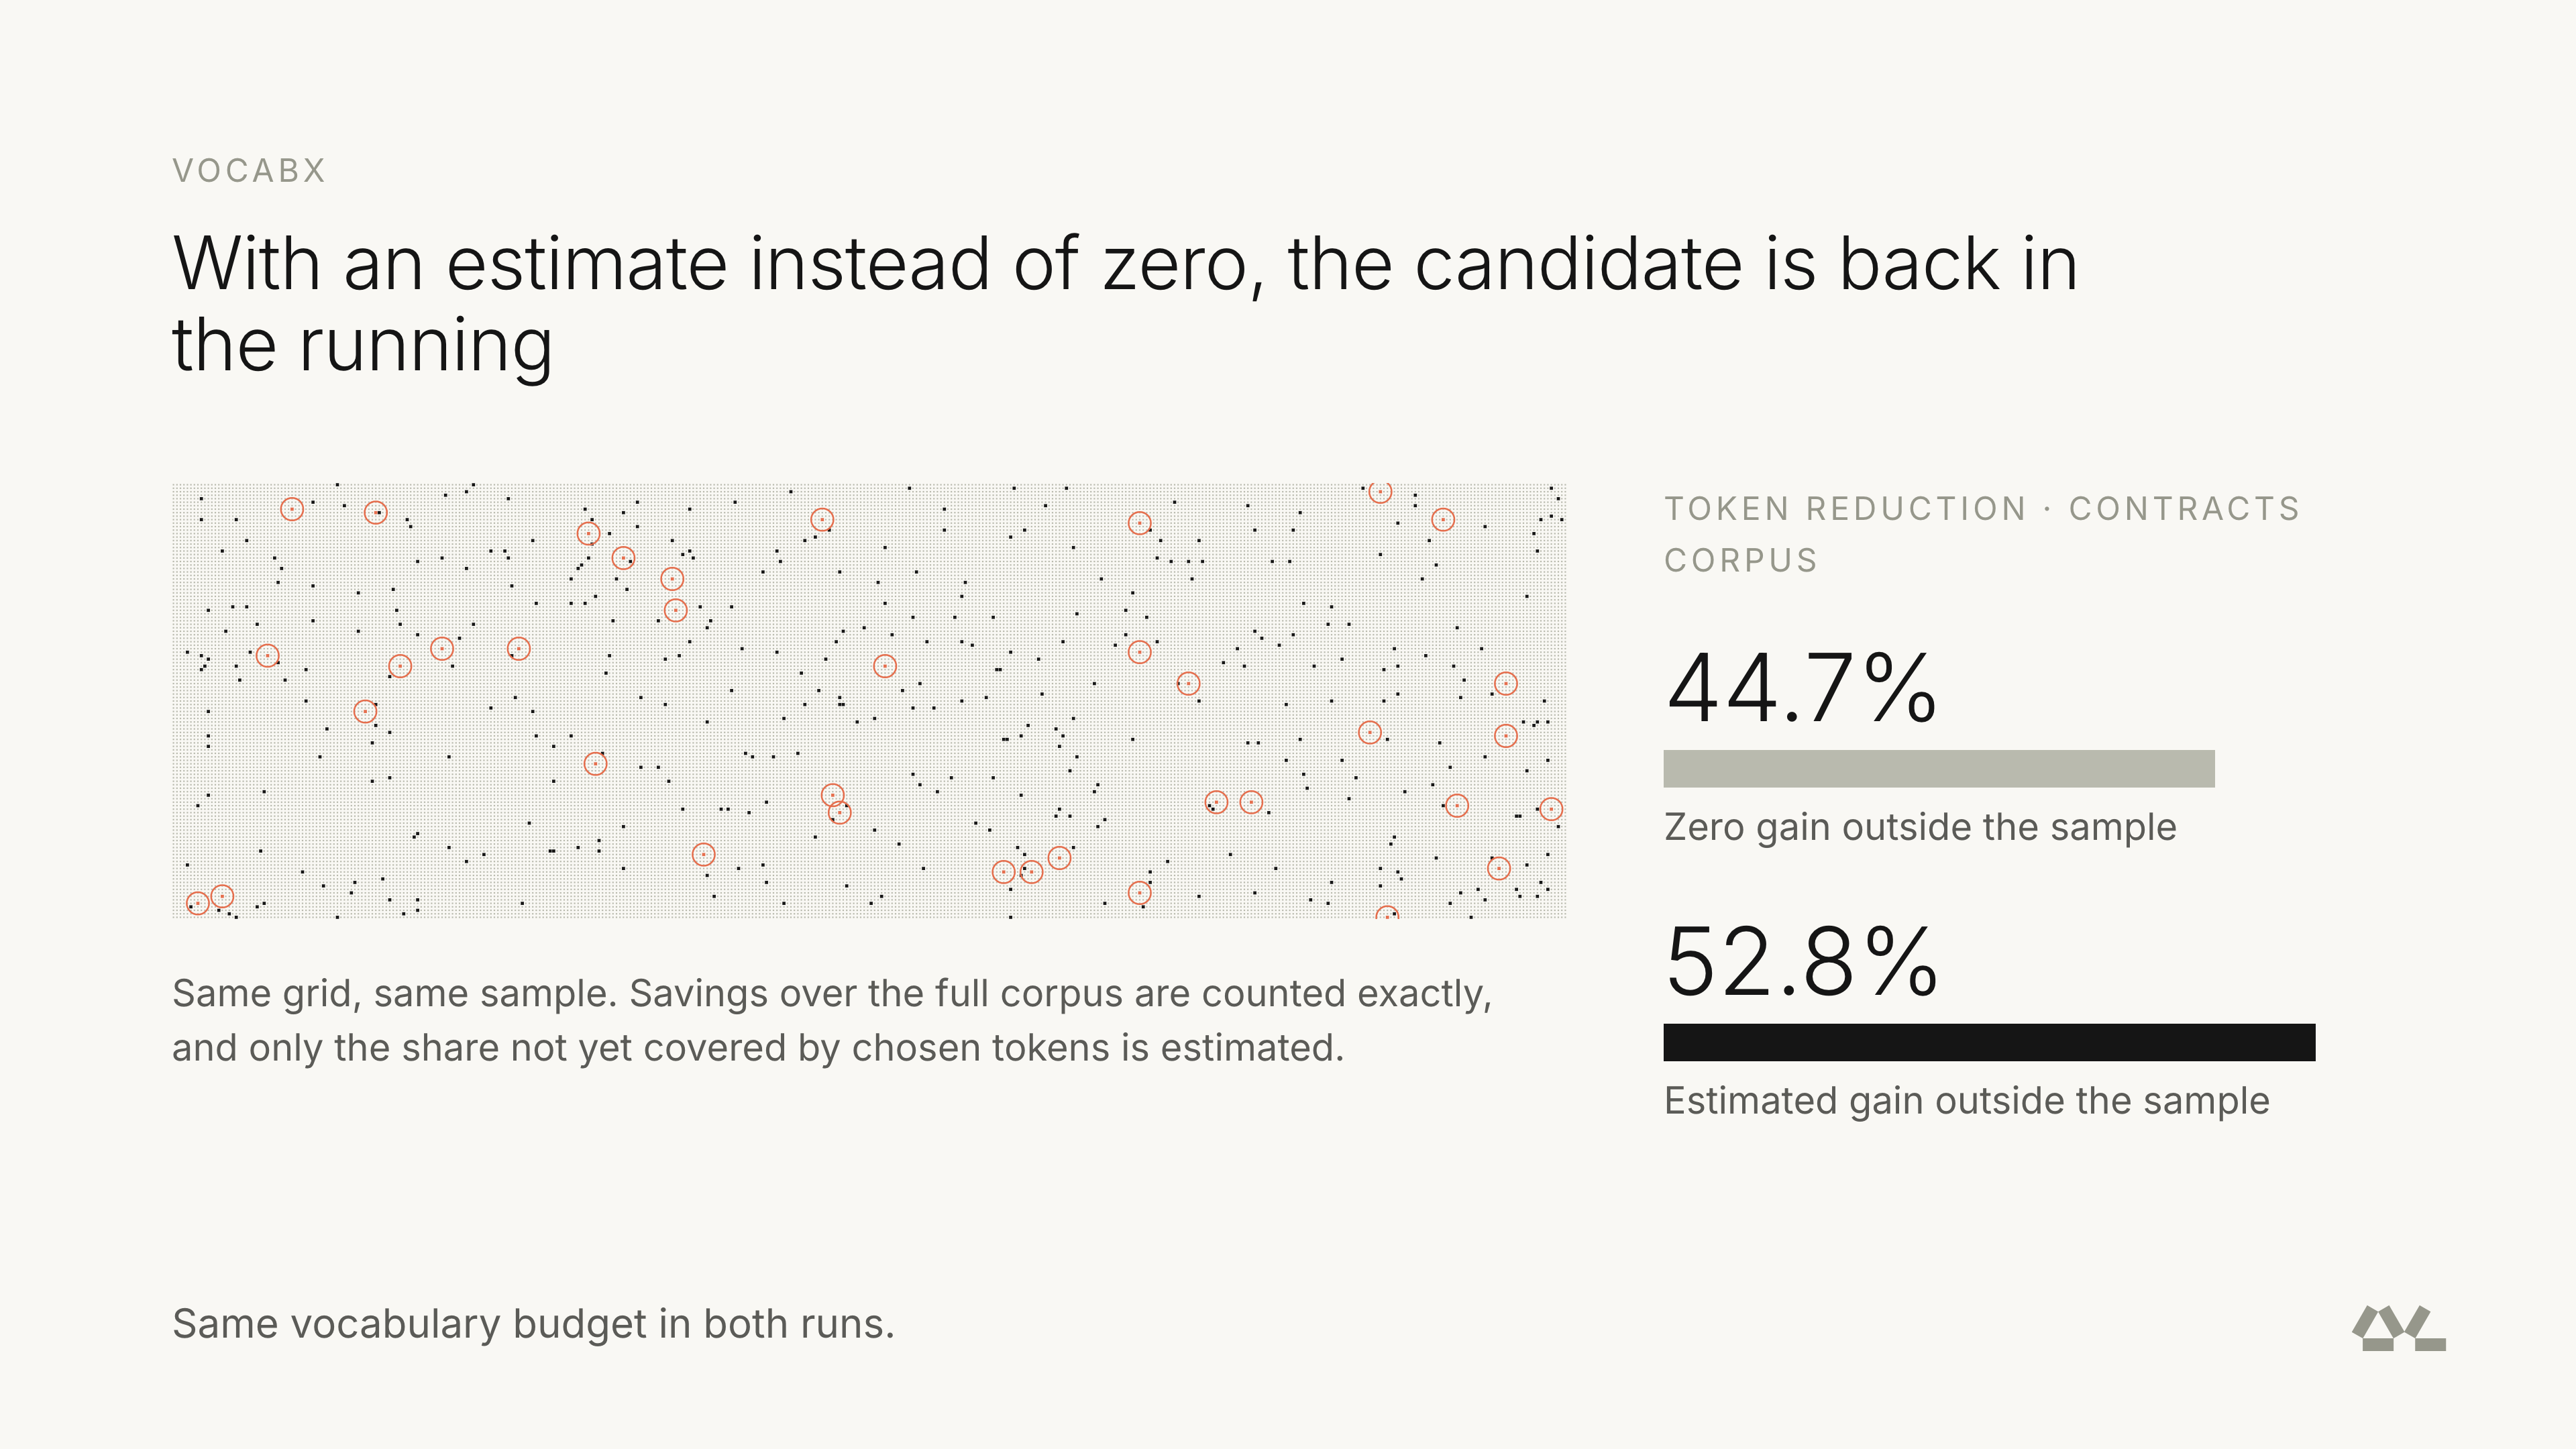
Qwen3-4B 에세이 채점 모델의 실측 결과
저자들은 기반 모델, 데이터, 학습 방법, 시드를 모두 같게 하고 토크나이저만 다른 채점 모델 7개를 학습했습니다. 모두 같은 시험 장비(RTX 5090 GPU, vLLM 추론 서버)에서 같은 요청 500건을 처리했고, 비용은 측정한 실행 시간으로 계산했습니다. 품질은 자체 지표인 벤치 점수(bench score)로 쟀습니다. 채점 정확도와, 주제에서 벗어나거나 규칙을 어긴 에세이를 걸러내는 정확도를 합친 점수입니다.
| 모델 | 응답당 토큰 | 응답 토큰 감소 | 실측 비용 감소 | 벤치 점수 |
|---|---|---|---|---|
| 운영 중인 채점 모델 (기본 토크나이저) | 350 | 기준 | 기준 | 0.703 |
| 가장 강한 기준 방법 (In-place BPE) | 136 | 61.1% | 62.1% | 0.746 |
| VocabX | 101 | 71.1% | 77.0% | 0.810 |
위 표의 수치는 원문 결과 그림의 값이며(In-place BPE 행은 그림에만 있음), 응답 토큰 감소율만 PyTorchKR이 계산했습니다. 학습한 7개 중 나머지 모델의 수치는 원문에 없습니다. 원문은 VocabX에서 비용 감소율(77.0%)이 응답 토큰 감소율(71.1%)보다 큰 이유를 항목별로 나누어 보여주지 않으며, 토크나이저만 바꿨는데 벤치 점수가 오른 이유도 설명하지 않습니다. 저자들은 결론에서 VocabX가 모델을 더 똑똑하게 만들지는 않는다고 적었습니다.
점수를 매크로 토큰에 넣었던 첫 번째 어휘
이 결과에 이르기 전에 방향을 한 번 바꿨습니다. 첫 번째 어휘는 역량별 점수와 그 주변 JSON을 매크로 토큰 하나로 합쳤습니다. 가장 압축률이 높은 선택이었지만 벤치 점수가 0.689로, 운영 중인 모델의 0.703보다 낮았습니다. 점수가 매크로 안에 들어가자 점수와 구조의 조합마다 같은 토큰의 다른 변형이 생겼고, 모델은 점수와 구조를 한 단계에서 함께 골라야 했습니다.
반면 점수를 별도 토큰으로 떼어 내자 응답당 토큰이 2개 늘었지만 벤치 점수는 0.810으로 올랐습니다. 측정 비용도 오히려 줄어, 합친 버전의 73.3%보다 큰 77.0% 감소를 기록했습니다. 저자들은 이 경험에서 압축한 구간이 모델이 내려야 할 결정 자체를 담고 있으면 압축에도 대가가 따른다고 정리합니다. 목표는 가장 싼 어휘가 아니라 중요한 토큰을 지키는 범위에서 가장 싼 어휘라는 것입니다.
5개 공개 도메인과 3개 모델 계열에서의 비교
저자들은 효과가 채점 모델에만 해당하는지 보려고 공개 데이터로 비교 실험을 했습니다. 도메인은 계약서, 의학 논문, 과학 논문, 뉴스, Python 코드 5개이고, 모델 계열은 Qwen3, Llama-3.1, Gemma-3 3개입니다. 여기서 VocabX를 세 기준 방법과 비교했습니다. 모든 방법이 같은 탐색용 문서와 시험 문서, 같은 어휘 상한을 썼습니다.
| 비교 항목 | 결과 |
|---|---|
| 토큰 감소율 | 15개 조합 모두에서 가장 강한 기준 방법보다 1.2~9.3%p 높음 |
| 추정 추론 비용 감소 (가지치기 버전) | 15개 조합 모두에서 앞섬. 평균 차이 Qwen3 10.2%p, Llama-3.1 7.5%p, Gemma-3 13.6%p |
| 계약서 도메인 | 가지치기 버전이 어휘 113,426개로 토큰 62.6% 감소, In-place BPE 최고 설정은 어휘 207,803개로 61.8% 감소 |
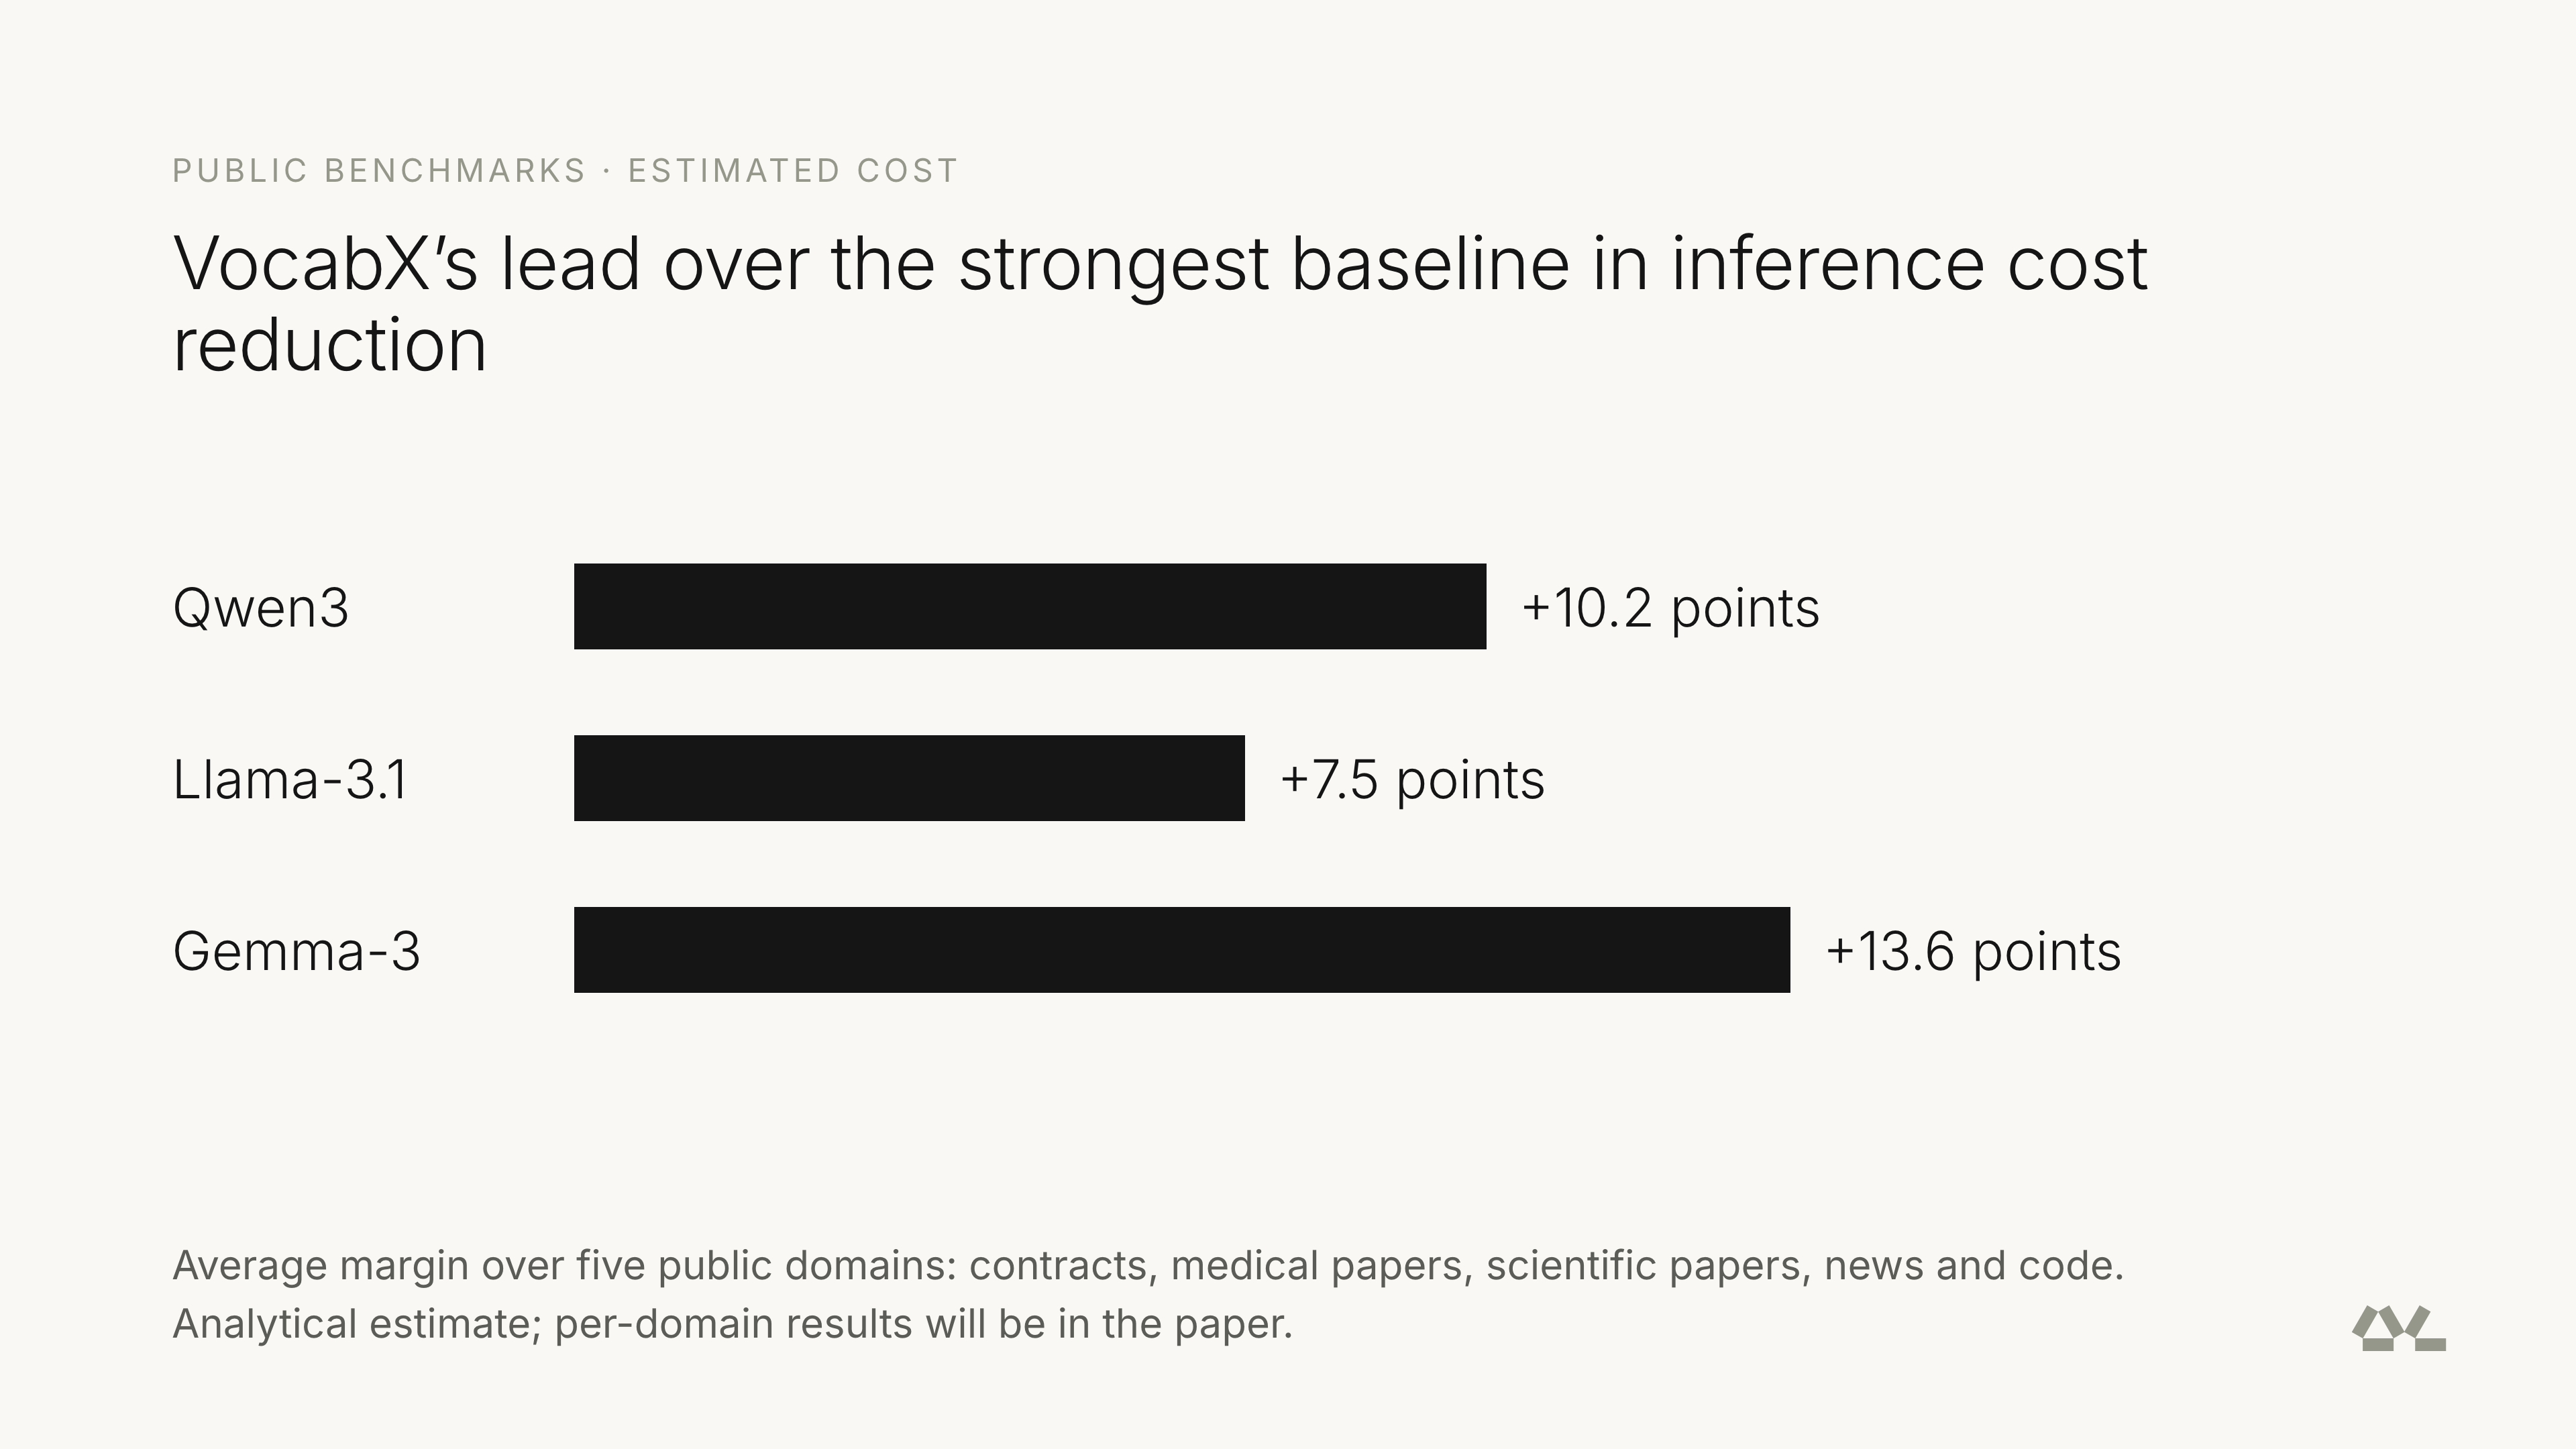
위 그림 아래의 원문 설명은 이 비용 수치를 "분석적 추정(Analytical estimate)"이라고 밝힙니다. 즉, 채점 모델처럼 학습 후 실제 실행 시간을 잰 값이 아닙니다. 원문은 "가지치기(pruned) 버전"이 무엇을 뺀 것인지 설명하지 않고, 도메인별 결과는 논문으로 미룹니다.
VocabX를 검토할 때 확인할 조건
자기 모델에 적용하기 전에 확인할 조건은 다음과 같습니다.
- 논문과 코드가 아직 없습니다: 원문은 "곧 공개할" 논문의 미리보기입니다. 참고문헌에 오른 논문 제목은 VocabX: Cost-Weighted Vocabulary Adaptation for Domain-Specific Language Models(준비 중)입니다. 2026년 10월 28일 기준 arXiv에서 VocabX 논문을 찾지 못했고, Dharma AI의 Hugging Face 조직에도 VocabX 관련 모델이나 코드가 없습니다.- 어휘를 바꾸면 다시 학습해야 합니다: 저자들은 토크나이저마다 채점 모델을 따로 학습했습니다. 새 토큰의 임베딩 초기화 방식은 원문에 나오지 않습니다. 참고로 Liquid AI의 원래 In-place 방법은 하위 토큰 임베딩의 평균을 씁니다. 이미 도메인 미세조정을 하고 있는 팀이 그 단계에 함께 넣을 수 있는 방법에 가깝습니다.
- 7.4배는 이 채점 모델의 값입니다: 같은 가중치 방식을 쓰려면 자기 서빙 환경의 출력과 입력 비용 비율을 먼저 재야 합니다.
- 실측 비용 절감은 응답 형식이 고정된 작업 하나의 결과입니다: 원문은 채점 모델의 가장 큰 낭비가 매번 반복되는 JSON 틀이었다고 설명합니다. 공개 도메인 비교의 비용은 추정치이고, 형식이 자유로운 대화형 서비스의 실측 결과는 원문에 없습니다.
- 결정을 담은 토큰은 압축에서 빼야 합니다: 위 첫 번째 어휘처럼 점수가 매크로 토큰에 섞이면 품질이 떨어졌으므로, 매크로 토큰 후보에 이런 값이 들어가지 않았는지 확인해야 합니다.
 How Specializing the Vocabulary of SLMs Can Cut Inference Cost by 77% in Real Applications 블로그
 Dharma AI Hugging Face 조직
더 읽어보기
-
Fast Vocabulary Transfer for Language Model Compression (EMNLP 2022 Industry Track, 영문)
-
Multi-word Tokenization for Sequence Compression (EMNLP 2023 Industry Track, 영문)
-
In-Place Tokenizer Expansion for Pre-trained LLMs (arXiv, 영문)
-
Liquid AI, 활성 2B로 로컬 에이전트를 돌리는 MoE 추론 모델 LFM2.5-24B-A2B 공개 (feat. Hermes Agent)
-
DPO로 텍스트 퇴화 줄이기: 모델의 실패 출력을 거부 쌍으로 쓰는 방법에 대한 연구 (feat. DharmaOCR)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
