Weave Router 소개
코딩 에이전트를 한 시간만 켜 두어도 상위 모델로 나가는 API 요청 수는 사람이 대화한 횟수와 전혀 다른 규모로 늘어납니다. 사용자가 질문을 한 번 던지면 에이전트는 파일을 읽고 명령을 실행하고 그 결과를 다시 판단하면서 요청을 여러 번 보냅니다. 문제는 이 요청들의 성격이 균일하지 않다는 것입니다. 도구 실행 결과를 정리하는 요청과 설계를 새로 세우는 요청이 같은 최고 성능 모델로 나가는 것이 기본 동작이고, 요금은 그 기본 동작을 따라 쌓입니다. 요청마다 알맞은 모델을 지정하면 되지만, 사람이 매번 판단해서 모델을 바꾸는 방식은 에이전트가 초 단위로 요청을 보내는 환경에서는 성립하지 않습니다.
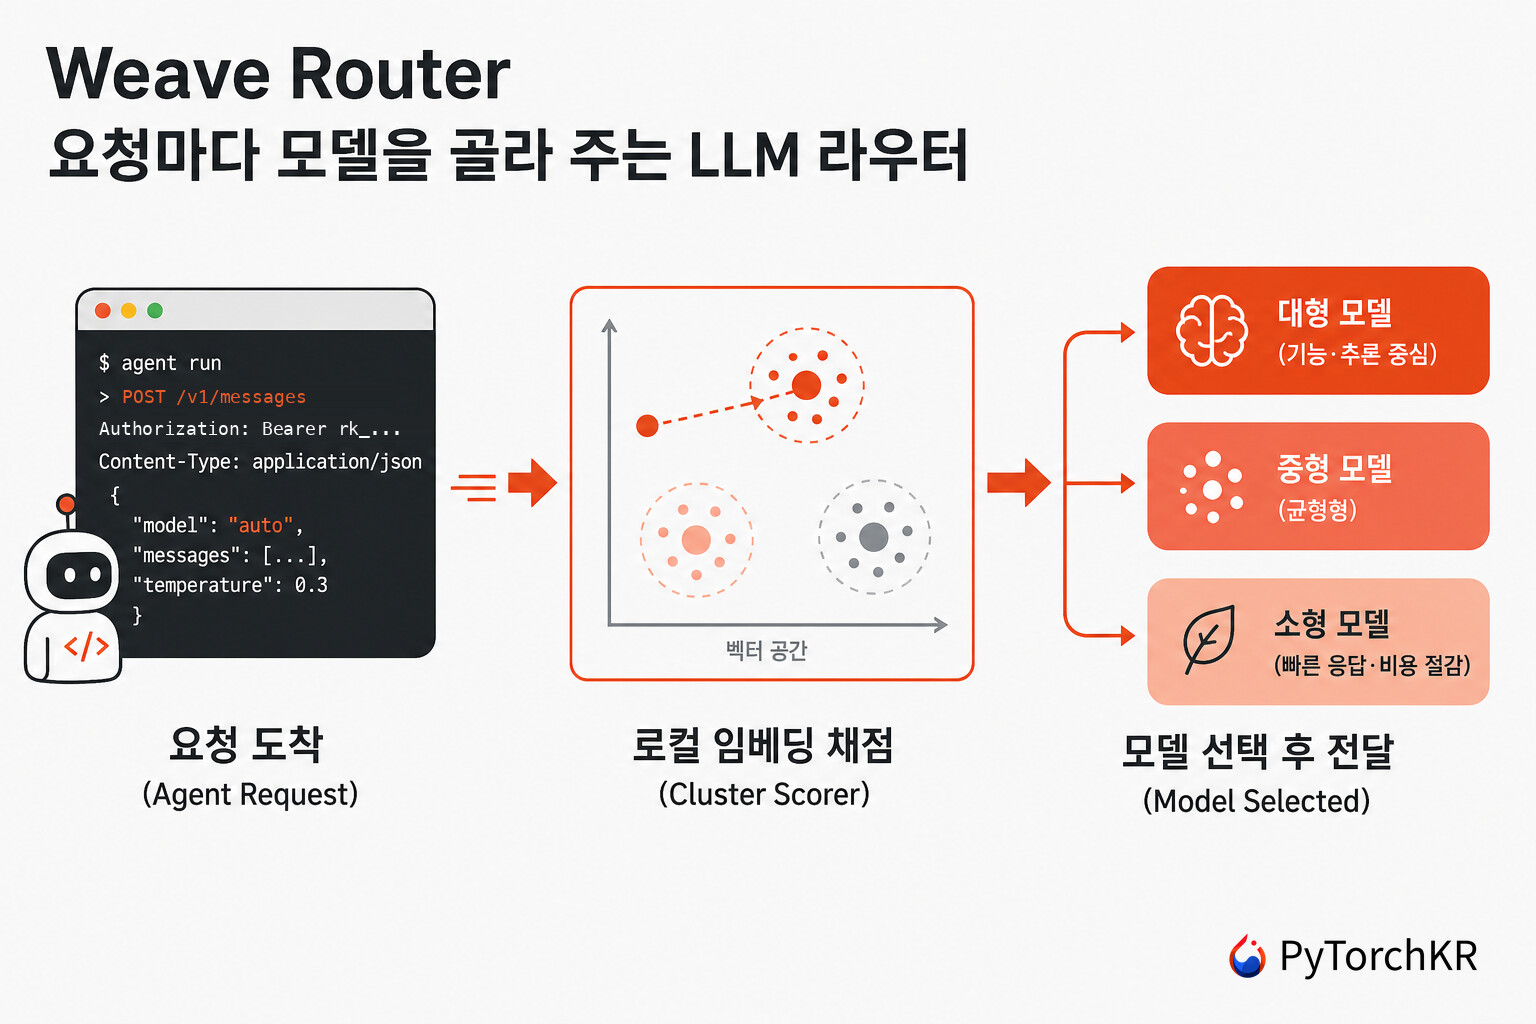
이번에 소개할 Weave Router는 그 판단을 요청 단위로 자동화하는 라우팅 프록시(Routing Proxy) 프로젝트입니다. 에이전트가 바라보는 API 주소를 라우터로 바꿔 두면, 라우터가 요청을 하나씩 받아 어떤 모델로 보낼지 결정한 뒤 해당 제공자에게 그대로 중계합니다. 결정 근거는 프롬프트를 다시 LLM에 물어보는 방식이 아니라 라우터 프로세스 안에서 실행되는 작은 임베딩 모델이며, Weave는 이 선택을 "a tiny on-box embedder, not a vibes-based prompt"라고 설명하고 있습니다. 요청을 임베딩한 벡터를 미리 계산해 둔 클러스터 중심(Centroid)과 비교하고, 그 클러스터에 딸린 순위표에서 모델을 고르는 구조입니다.
Weave Router는 Go 1.25 이상에서 빌드되는 서버이고, 엔지니어링 활동 분석 도구를 만드는 Weave가 공개했습니다. 저장소 코드를 내려받아 자체 호스팅할 수 있으며, Weave가 같은 라우터를 관리형 서비스로도 운영하기 때문에 명령 한 줄로 그 호스팅 라우터에 연결하는 경로도 함께 제공됩니다. Weave는 요청당 라우팅 판단이 50밀리초 안에 끝나고 비용이 40에서 70퍼센트까지 줄어든다고 저장소 설명에 적어 두었습니다. 이 수치는 Weave가 자체적으로 밝힌 값이고, 재현 절차나 측정 조건은 저장소에 공개되어 있지 않습니다.
기존 LLM 라우팅 도구와 Weave Router의 결정 방식 차이
여러 모델을 번갈아 쓰는 도구는 이미 여러 갈래로 나와 있고, 서로 다른 점은 무엇을 근거로 모델을 고르는가입니다. 세 가지 접근을 나란히 놓으면 다음과 같습니다:
| 접근 | 모델 선택 근거 | 대표 프로젝트 |
|---|---|---|
| 설정 파일에 규칙 작성 | 사람이 시나리오별로 쓸 모델을 미리 지정 | Claude Code Router |
| 별도 분류 모델 사용 | 파인튜닝한 분류 모델이 요청의 의도와 복잡도를 판정 | vLLM Semantic Router |
| 임베딩과 클러스터 순위표 | 요청 임베딩을 클러스터 중심과 비교한 뒤 그 클러스터의 순위표에서 선택 | Weave Router |
위 표에서 첫 번째 접근과 나머지 둘의 차이가 먼저 눈에 띕니다. Claude Code Router는 ~/.claude-code-router/config.json에 background, think, longContext 같은 시나리오별로 쓸 모델을 사람이 적어 두는 방식이라 결과를 예측하기 쉽지만, 모델 목록이 바뀌면 그 파일을 다시 손봐야 합니다. vLLM Semantic Router는 ModernBERT를 파인튜닝한 분류 모델로 요청의 의미를 판정하므로 규칙을 직접 유지할 필요가 없고, 대신 분류 모델을 함께 운영해야 합니다. Weave Router는 판정을 임베딩 비교와 미리 계산해 둔 순위표로 옮겨서, 요청당 추가 LLM 호출 없이 라우터 프로세스 안에서 결정을 끝냅니다. 이 클러스터 채점 방식은 성능과 효율을 함께 최적화하는 라우팅을 다룬 Avengers-Pro 논문에서 파생된 것이라고 Weave Router가 README에 밝히고 있습니다.
같은 문제를 프록시 계층에서 다루는 프로젝트도 커뮤니티에 여러 편 소개되어 있습니다. 에이전트 루프를 더 저렴한 백엔드에서 실행하는 deepclaude, 여러 제공자를 하나의 프록시로 묶는 Free Claude Code, 에이전트 앱용 데이터 플레인을 목표로 하는 Plano가 그 예입니다.
Weave Router가 라우팅을 결정하는 단위, 액션(Action)
Weave Router에서 가장 먼저 확인할 부분은 라우터가 무엇을 한 번의 결정 단위로 보는지입니다. 이 프로젝트는 docs/SEMANTICS.md에서 관련 용어를 다섯 단계로 정의해 두었습니다:
| 용어 | 정의 |
|---|---|
| 세션(Session) | 사용자와 에이전트가 주고받는 대화 전체 |
| 라운드(Round) | 세션 안에서 사용자와 에이전트가 한 번 주고받는 상호작용 |
| 턴(Turn) | 라운드 안의 사용자 입력 하나 또는 에이전트 출력 하나 |
| 액션(Action) | 에이전트가 상위 모델에 보내는 API 요청 하나 |
| 스텝(Step) | 한 턴 안에서 그 액션이 몇 번째인지를 가리키는 순서 |
이 중에서 Weave Router가 모델을 고르는 단위는 액션입니다. 턴이나 라운드가 아니라 API 요청 하나가 결정 단위라는 뜻이므로, 에이전트가 한 번 답하는 동안에도 단계마다 다른 모델이 쓰일 수 있습니다. 대신 대화 도중 모델이 바뀌면 맥락이 흔들릴 수 있어서, ROUTER_SESSION_PIN_ENABLED가 기본값 true로 세션의 첫 라우팅 결과를 고정해 여러 턴에 걸친 대화의 일관성을 유지합니다. 판단 결과만 돌려주고 상위 모델을 호출하지 않는 POST /v1/route 엔드포인트도 따로 있어서, 어떤 요청이 어떤 모델로 갈지 미리 확인할 수 있습니다.
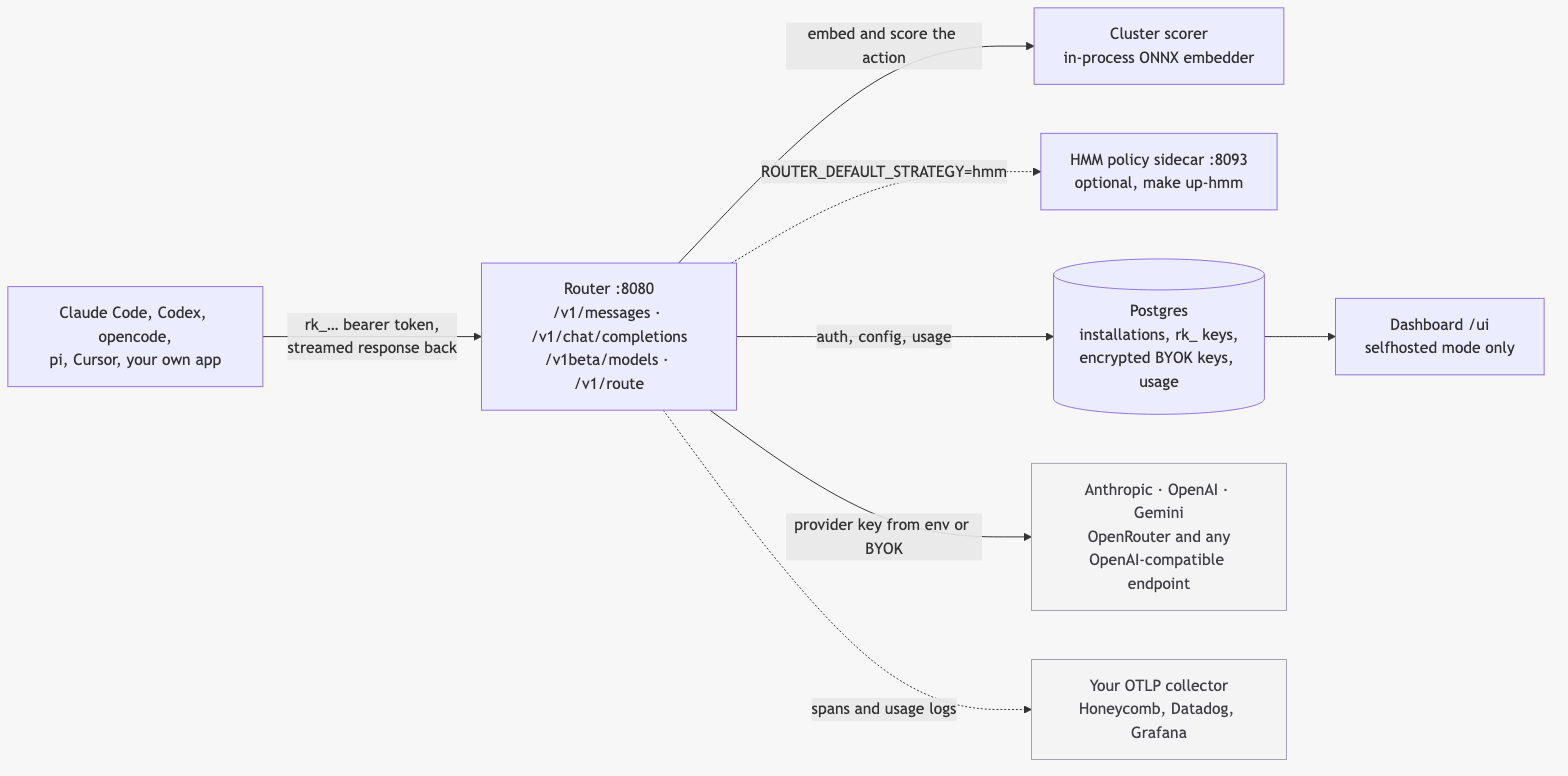
위 그림은 저장소 README가 제공하는 구조도이며, 회색 상자만 사용자 장비 밖에 있는 구성 요소입니다. 라우터와 클러스터 스코어러, Postgres, 제공자 키는 모두 로컬에 남고 프롬프트는 라우터에서 설정한 제공자로 바로 나갑니다. 여러 복제본으로 배포할 때는 캐시 무효화를 위해 Pub/Sub 설정이 추가로 필요하며, docker compose가 그 에뮬레이터를 함께 띄웁니다.
Weave Router의 클러스터 스코어러와 임베딩 자산
라우팅 판단을 실제로 수행하는 임베딩 모델은 저장소에 커밋되어 있지 않고, 실행 시점에 model.onnx와 tokenizer.json 두 파일을 임베더별 디렉토리에 두는 방식으로 불러옵니다(docs/CONFIGURATION.md의 Cluster-routing artifacts 항목). 선택할 수 있는 임베더는 두 가지입니다. 하나는 Jina AI가 직접 내보낸 8비트 정수 양자화(INT8 Quantization) 모델 jina-embeddings-v2-base-code이고, 다른 하나는 마지막 토큰 풀링(Last-token Pooling)을 그래프 안에 넣어 내보낸 Qwen3-Embedding-0.6B 변환본입니다. Docker 이미지를 빌드할 때 두 저장소에서 파일을 받아 가고, 두 저장소 모두 공개되어 있어 토큰이 필요하지 않습니다.
한편 클러스터 중심과 순위표, 모델 레지스트리, 메타데이터는 internal/router/cluster/artifacts/ 아래에 버전별로 커밋되어 있고, artifacts/latest 포인터가 기본으로 쓰이는 버전을 가리킵니다. 특정 버전을 고정하려면 ROUTER_CLUSTER_VERSION에 버전을 적습니다. 임베딩 계산에 걸리는 시간은 ROUTER_CLUSTER_EMBED_TIMEOUT_MS로 제한되며 기본값이 200밀리초입니다. 채점 대상은 기본적으로 사용자 역할의 텍스트뿐이고, ROUTER_EMBED_ONLY_USER_MESSAGE를 false로 두면 턴 전체를 이어 붙여 임베딩합니다.
여기서 눈여겨볼 설계 결정은 실패를 다루는 방식입니다. 임베딩 모델이 없거나 시간 제한을 넘겨 클러스터 스코어러를 실행할 수 없으면, Weave Router는 기본 모델로 조용히 넘기지 않고 HTTP 503을 돌려줍니다. Weave Router는 이 동작을 "Failures are loud by design"이라고 설정 문서에 적어 두었습니다. 모델을 직접 지정하는 /force-model 명령이 이름을 정확히 일치시켜야만 동작하는 것도 같은 방향의 결정입니다. 예전에는 근사 일치를 허용해서 /fm qwen 3.8이 qwen 별칭을 거쳐 qwen/qwen3-coder로 해석되고도 고정이 성공한 것처럼 응답했는데, 지금은 인식하지 못하는 이름을 근사 일치로 처리하지 않고 거부합니다.
Weave Router 설치와 사용법
관리형 라우터에 붙이는 경로가 가장 짧습니다. 설치 스크립트가 어떤 도구에 연결할지 물어보고 해당 설정 파일을 대신 고쳐 줍니다:
npx @workweave/router                    # 대화형 선택
npx @workweave/router --claude           # Claude Code
npx @workweave/router --codex            # OpenAI Codex CLI
npx @workweave/router --opencode         # opencode
npx @workweave/router --local            # 자체 호스팅한 localhost:8080
npx @workweave/router --scope project    # 저장소 단위 설정
다만 Node 18 이상이 필요하고, Claude Code와 opencode 경로에서는 jq도 함께 필요합니다. 라우터 전체를 자체 호스팅하려면 제공자 키를 넣고 Postgres와 라우터를 함께 띄웁니다:
echo "OPENROUTER_API_KEY=sk-or-v1-..." >> .env.local
make full-setup
이렇게 하면 라우터가 http://localhost:8080에서, 대시보드가 http://localhost:8080/ui/에서 열리고 로그에 rk_로 시작하는 라우터 키가 출력됩니다. 여기서 키를 두 종류로 구분해야 합니다. sk-or-..., sk-ant-... 처럼 시작하는 키는 상위 제공자에게 쓰는 키로 .env.local에 두고, rk_로 시작하는 키는 클라이언트가 라우터에 보내는 Bearer 토큰입니다. 호출 형식은 기존 API 규격을 그대로 씁니다:
# Anthropic Messages 규격
curl -sS http://localhost:8080/v1/messages \
  -H "Authorization: Bearer rk_..." \
  -d '{"model":"claude-sonnet-4-5","max_tokens":256,
       "messages":[{"role":"user","content":"hi"}]}'

# OpenAI Chat Completions 규격
curl -sS http://localhost:8080/v1/chat/completions \
  -H "Authorization: Bearer rk_..." \
  -d '{"model":"gpt-4o-mini",
       "messages":[{"role":"user","content":"hi"}]}'
라우터가 받는 주요 엔드포인트는 다음과 같습니다:
| 엔드포인트 | 규격 |
|---|---|
POST /v1/messages |
Anthropic Messages, 라우팅 적용 |
POST /v1/chat/completions |
OpenAI Chat Completions, 라우팅 적용 |
POST /v1beta/models/:action |
Gemini generateContent, 라우팅 적용 |
POST /v1/route |
라우팅 결정만 반환, 상위 호출 없음 |
GET /health, GET /readyz |
생존 확인과 의존성 준비 확인 |
GET /v1/analytics/routing-decisions |
라우팅 결정 원본을 NDJSON으로 내보내기 |
라우터를 연결한 뒤에도 원래 제공자로 되돌릴 수 있습니다. npx @workweave/router off --claude는 설정을 지우지 않고 해당 클라이언트만 원래 제공자로 되돌리며, on이 다시 켜고 status가 현재 상태를 알려줍니다. Claude Code에서는 /router-off, /router-on, /router-status 명령으로 같은 일을 합니다. OpenAI 계열 모델을 고르는 경우 Codex CLI의 기존 로그인을 그대로 쓰고, 다른 모델은 각자의 배포나 사용자 키로 호출합니다.
Weave Router가 맞는 팀과 맞지 않는 팀
판단의 근거는 세 가지입니다. 라우팅 결정이 액션 단위라는 점, 임베딩 모델과 클러스터 자산이 로컬에서 돌아 요청당 추가 LLM 호출이 없다는 점, 그리고 스코어러가 실패하면 503으로 끊긴다는 점입니다. 에이전트가 하루에 수천 건의 요청을 보내고 그 요청의 난이도가 실제로 섞여 있는 팀, 그리고 제공자 키를 자기 인프라 안에 두어야 하는 팀에게는 Weave Router가 검토할 값어치가 있습니다. 대시보드와 OTLP(OpenTelemetry Protocol) 추적이 함께 들어 있어 어떤 요청이 어디로 갔는지 확인할 수 있고, 결정 원본을 NDJSON으로 내보내 자체 분석에 쓸 수도 있습니다.
반대로 모든 요청이 한 모델이면 충분한 개인 사용자나, 라우터가 잠깐 판단하지 못할 때에도 응답이 끊기지 않아야 하는 서비스에는 지금의 Weave Router가 적절한 선택이 아닙니다. 후자는 스코어러 실패 시 기본 모델로 넘기지 않고 503을 돌려주는 동작이 그대로 서비스 오류가 되기 때문입니다. Cursor 연결은 저장소가 스스로 초기 베타이며 성능이 최선이 아닐 수 있다고 적어 둔 상태이므로, Cursor를 주 편집기로 쓰는 경우에는 자체 검증을 먼저 해 보는 것이 좋습니다.
Weave Router의 라이선스
Weave Router는 Elastic License 2.0으로 공개되어 있습니다. 라이선스 원문은 사용과 복제, 배포, 파생 저작물 작성을 무상으로 허용하되 몇 가지 제한을 함께 두는 형태이고, 회사 안에서 쓰거나 직접 고쳐 쓰는 데는 제약이 없습니다.
단, 이 라이선스는 소프트웨어의 주요 기능을 제3자에게 호스팅 서비스나 관리형 서비스로 제공하는 것을 금지하고 라이선스 키 기능을 우회하거나 제거하는 것도 금지합니다. 라우터를 감싸 외부 고객에게 서비스로 판매할 계획이 있다면 도입 전에 라이선스 원문의 Limitations 항목을 직접 확인해야 합니다.
 Weave Router 관리형 서비스 소개 페이지 (Weave가 운영하는 호스팅 라우터)
 Weave Router 설정 문서
 Weave Router의 클러스터 채점 방식이 참고한 Avengers-Pro 논문
 Weave Router 프로젝트 GitHub 저장소
더 읽어보기
-
Claude Code Router: 다양한 LLM 환경에서 Claude Code를 효율적으로 사용하는 라우팅 도구
-
Free Claude Code: 다양한 LLM 제공자를 Claude Code 프록시로 묶는 오픈소스 게이트웨이
-
deepclaude: Claude Code의 에이전트 루프를 DeepSeek 등 더 저렴한 백엔드로 돌리는 도구
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 도구를 직접 설치해 사용해보셨다면,  파이토치 한국 사용자 모임
 회원들을 위해 경험이나 팁을 댓글로 남겨주세요!
