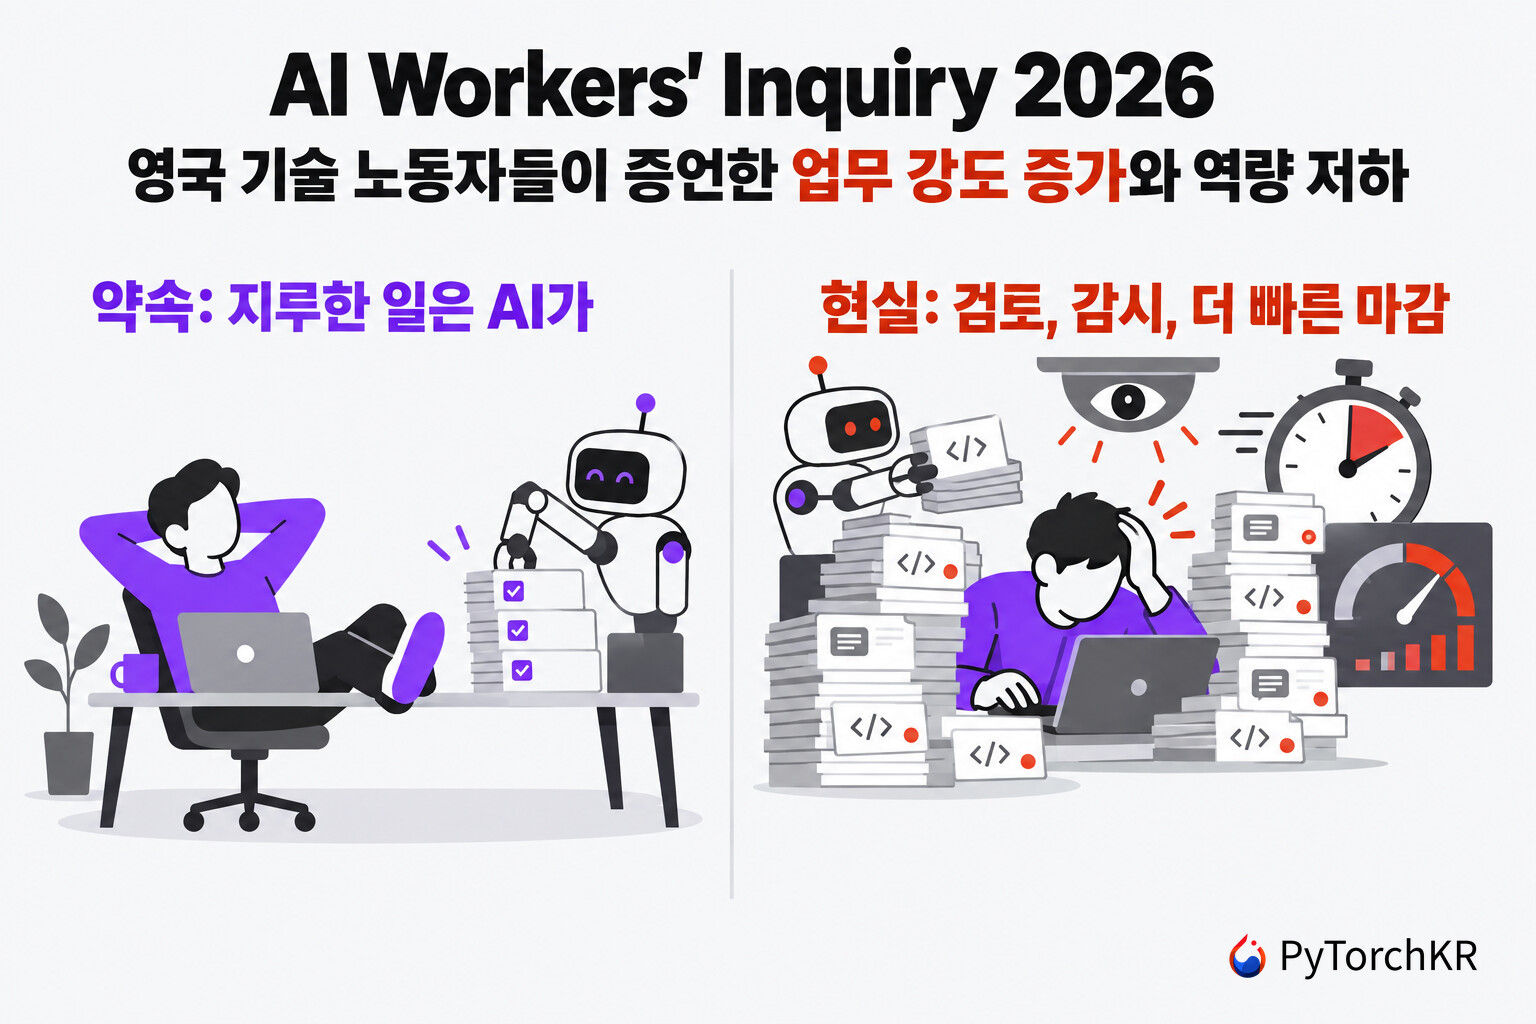
AI Workers' Inquiry 2026 소개
AI Workers' Inquiry 2026 은 영국의 기술 노동자 노동조합 UTAW(United Tech & Allied Workers)가 2026년 9월 24일 공개한 36쪽 분량의 보고서로, AI 시스템을 직접 만들고 배포하고 평가하고 사용하는 기술 노동자들의 증언을 모아 생성형 AI가 실제 업무를 어떻게 바꾸고 있는지 정리한 문서입니다. 이 보고서의 결론은 "AI 애플리케이션은 일을 없애는 경우가 드물고, 일을 재분배하고 강화한다(AI applications rarely remove work; they redistribute and intensify it)"는 한 문장으로 요약되며, 이를 바탕으로 8개 영역 32개 항목의 정책 제안을 내놓습니다.
AI가 일과 노동에 미치는 영향에 대한 자료는 지금까지 주로 두 방향에서 나왔습니다. 하나는 모델을 만드는 기업이 자사 서비스 사용 데이터를 분석해 공개하는 보고서로, PyTorchKR에서도 Anthropic Economic Index 시리즈나 Claude 사용자 8만여 명 설문을 소개한 바 있습니다. 다른 하나는 경제협력개발기구(OECD)나 국제노동기구(ILO)처럼 생산성과 고용을 거시 지표로 추적하는 연구입니다. 두 방향 모두 중요하지만, 조직 안에서 AI 도구가 어떻게 도입되고 측정되고 강제되는지 는 잘 드러나지 않습니다.
이번에 소개하는 보고서는 그 빈자리를 노동자의 관점에서 채우려는 시도입니다. 보고서는 "AI에 대해 우리가 안다고 생각하는 것은 거의 언제나 기술에 밝지 않은 미디어 논평가와 AI 기업을 소유한 창업자들이 만들어 왔다"고 지적하고, 고객 지원 상담원부터 연구 과학자, 소프트웨어 개발자, 보안 분석가, 기술 교육자까지 영국 기술 산업 공급망 전반의 노동자 경험을 체계적으로 모은 첫 시도라고 스스로를 소개합니다. 인터뷰 대상에는 최첨단 모델을 개발하는 프런티어 랩(Frontier Lab) 소속 연구자도 포함되어 있습니다.
발행 주체인 UTAW는 영국 통신노조 CWU(Communication Workers Union)의 전국 지부로, 2020년에 결성되었고, 스스로를 영국에서 유일하게 기술 산업의 모든 노동자를 대상으로 하는 노동조합이라고 소개합니다. 따라서 이 보고서는 중립적인 학술 조사가 아니라 노동조합의 관점과 정책 요구를 담은 문서임을 감안하고 봐야 합니다. 특히, 이 보고서는 참여자 수나 응답 비율 같은 정량 지표도 공개하지 않습니다. 그럼에도 토큰 사용량이 성과 지표가 되고, 사람이 확인할 수 있는 속도보다 코드가 더 빨리 생성된다는 증언은 코딩 어시스턴트와 에이전트가 일상 도구가 된 한국의 개발 현장에서도 낯설지 않은 이야기라서, 조직에서 AI 도입을 결정하거나 그 결정의 영향을 받는 사람이라면 한 번 읽어볼 만한 자료입니다.
보고서의 구성과 노동자 조사(Workers' Inquiry) 방법론
AI Workers' Inquiry 2026 보고서 목차
AI Workers' Inquiry 2026 보고서는 웹 페이지(techworkersinquiry.org/ai)와 PDF의 두가지 형식으로 공개되어 있고 내용은 거의 같습니다. PDF 문서를 기준으로, 주요 내용은 아래와 같이 구성되어 있습니다:
| 장 | 시작 쪽 | 주요 내용 |
|---|---|---|
| 요약(Executive Summary) | 4 | 핵심 결론과 5가지 정책 방향 |
| 정책 제안(Policy Proposals) | 7 | 8개 영역 32개 항목의 규제 및 제도 제안 |
| 도입(Introduction) | 13 | 조사 동기, "AI"라는 용어의 문제, AI를 둘러싼 담론, AI를 이유로 한 정리해고 |
| 조사에서 드러난 문제(Issues the Inquiry Surfaced) | 18 | 8가지 주제별 노동자 증언과 분석 |
| 용어집(Glossary of Terms) | 28 | 에이전트, 탈숙련, 아첨, 토큰 등 용어 정의 (웹 버전 기준 14개) |
| 방법론(Methodology) | 30 | 워크숍 방식 인터뷰, 설문지, 참여자 구성 |
| 미주(Endnotes) | 32 | 미주 15건 |
| 감사의 말(Acknowledgments) | 35 | 저자와 제작자 |
보고서 앞부분에 정책 제안을 먼저 두고 근거가 되는 증언을 뒤에 배치한 구성인데, 이 글에서는 이해하기 쉽도록 조사 방법과 관점 → 8가지 문제 → 정책 제안 순서로 재배치했습니다.
워크숍과 짝 인터뷰로 이루어진 질적 조사
조사는 2026년 8월과 9월 UTAW 조합원들이 직접 진행했습니다. 대면과 화상 워크숍을 열고, 참여자 두 명씩 짝을 지어 서로를 인터뷰하는 반구조화 인터뷰(Semi-structured Interview) 방식으로 질적 데이터를 모았습니다. 각 짝에게는 공통 질문지가 주어졌고, 참여자는 관심 있는 질문을 골라 더 깊이 이야기할 수 있었습니다. 소그룹 인터뷰가 끝나면 전체 그룹으로 돌아와 나온 주제를 함께 토론했고, 진행자가 이를 기록했습니다. 이후 질문지를 익명화해 취합한 것이 이 보고서입니다.
참여자의 직군은 소프트웨어 개발, 사이버 보안, IT 지원, 데이터 과학과 데이터 엔지니어링, 고객 서비스, 코칭과 교육, 연구 등으로 넓고, 소속도 자영업자부터 중소기업, 다국적 빅테크까지 다양합니다. 보고서의 저자이자 조사 설계와 진행을 맡은 사람은 Lynda Ouazar, Eleanor Payne, Lamian Pheres 세 명이며, 인쇄용 디자인은 Adam Evans가 맡았습니다.
마르크스주의 전통의 '노동자 조사'
이 조사 방식의 이름인 노동자 조사(Workers' Inquiry) 는 1880년 카를 마르크스가 프랑스 노동자들을 대상으로 잡지 La Revue socialiste에 발표한 100개 문항의 설문 A Workers' Inquiry에서 이어지는 전통으로, 연구자가 노동자를 관찰하는 대신 노동자가 자신의 노동 조건을 스스로 조사하고 기록하는 방법입니다. 보고서는 UTAW가 정식 노조가 되기 전 Tech Workers Coalition 런던 지부의 워킹 그룹이던 시절부터 이 방식으로 조사를 해 왔다고 밝힙니다.
보고서가 방법론의 근거로 인용한 Miceli 외(2025)의 AAAI/ACM AI 윤리 및 사회 학회(AIES) 논문은 "전 세계 AI 산업은 숨겨지고 불안정한 노동으로 움직이지만, 정작 그 노동을 연구하는 연구에서 노동자의 목소리는 대부분 빠져 있다"고 지적합니다. 이 보고서는 그 문제의식에 대한 현장 쪽의 응답이라고 볼 수 있습니다. 다만 참여자 수와 직군별 분포는 공개하지 않았으므로, 이후 소개하는 증언은 기술 산업 전체를 대표하는 통계라기보다 조직된 노동자들이 공통으로 겪는 문제의 목록으로 읽는 것이 적절합니다.
'AI'라는 여행가방 단어: 보고서가 먼저 정리하는 용어와 관점
서로 다른 기술을 하나의 이름으로 부르는 문제
보고서는 도입부에서 AI를 "무엇이든 넣을 수 있을 만큼 넉넉한 여행가방 단어(suitcase word)"라고 부르며, 이 모호함이 논의를 흐린다고 지적합니다. 정신 건강, 사이버 보안, 일자리 자동화의 위험을 말할 때 가리키는 대상은 대규모 언어 모델(LLM)과 LLM 기반 에이전트이고, 이것이 에너지를 가장 많이 쓰는 기술입니다. 반면 노벨상을 받은 AlphaFold나 기상 예측 모델처럼 AI의 성과로 자주 거론되는 사례는 좁고 잘 정의된 문제를 푸는 작은 모델이고, 에너지 요구량도 무시할 만한 수준이라는 것입니다.
| 구분 | 대표 예 | 보고서의 평가 |
|---|---|---|
| 범용 생성형 AI | LLM, VLM, 에이전트, 어시스턴트 | 정신 건강, 보안, 일자리 위험의 주된 대상. 에너지 사용량이 가장 큼 |
| 작업 특화 모델 | AlphaFold, 기상 예측 모델 | 유익한 활용 사례의 대부분. 모델이 작고 에너지 요구량이 적음 |
그래서 보고서는 LLM, 시각 언어 모델(Vision-Language Model, VLM), 그리고 학습 데이터를 바탕으로 출력을 합성하는 기계 학습 기술 전반을 생성형 AI(Generative AI, genAI) 라고 부르고, 가능한 한 이 구분을 지켜 서술합니다. 이 용어의 근거로는 Emily M. Bender와 Alex Hanna의 책 The AI Con을 인용합니다. 이러한 구분은 이 글을 읽는 ML 엔지니어에게도 유용합니다. 보고서가 비판하는 대상은 머신러닝 전체가 아니라, 특정 방식으로 조직에 강제되는 생성형 AI 도구라는 점이 분명해지기 때문입니다.
AGI 논쟁 대신 지금의 배치를 보자는 주장
보고서는 AI 논의의 상당 부분이 정의조차 합의되지 않은 범용 인공지능(Artificial General Intelligence, AGI) 을 중심으로 돌아간다고 보고, 이를 현실의 문제를 가리는 논쟁으로 규정합니다. 근거로는 Hanna와 Bender가 Tech Policy Press에 기고한 The Myth of AGI를 인용합니다. AGI의 위험을 막연한 미래로 미루는 사이, 이미 사회 시스템에 통합되고 있는 생성형 AI의 즉각적인 위험이 가려진다는 것입니다.
보고서는 또 생성형 AI가 먼 미래의 약속과 달리 지금은 극소수 억만장자에게 이익을 몰아주고 있으며, 노동자와 소규모 사업자 모두 노동자에게 생성형 AI 사용을 강요하면서 점점 비싼 값에 모델을 빌려주는 프런티어 모델 소유 빅테크와 마주하고 있다고 주장합니다. 낙관론과 비관론의 대립에 대해서는 "기술 노동자들의 의견이 하나로 모이지는 않지만, 최전선의 생성형 AI 도입에 대한 반응은 대체로 비관적"이라고 정리합니다. 또한 지지자와 비판자 모두 생성형 AI를 "이미 자리 잡은 기술(here to stay)"로 전제하는 불가피성 프레임 을 문제 삼습니다. 이 프레임이 정치적 선택의 문제를 "시장"의 문제로 바꿔 놓는다는 이유에서입니다. 보고서의 입장은 생성형 AI가 이해하고, 따져 보고, 규제하고, 필요하면 금지할 수 있는 대상이며, 어떤 배치도 주어진 것으로 받아들일 필요가 없다는 것입니다.
AI를 이유로 한 정리해고에 대한 노트
도입부에서 가장 날카로운 대목은 AI를 이유로 한 정리해고를 다룬 부분입니다. 보고서는 AI 낙관론자들이 말하는 생산성 향상을 업무 강화(Work Intensification) 라고 부르겠다고 밝힙니다. 효율이 오르면 오히려 수요가 늘어난다는 제번스의 역설(Jevons Paradox)을 근거로 AI가 일자리를 늘릴 것이라는 주장에 대해서는, 그 역설이 실제로 적용되는 것은 품질과 무관하게 문장을 최대한 많이 찍어내는 텍스트 합성 작업 정도라고 반박합니다.
조직 내부의 노동자들은 기업이 "AI가 사람의 필요를 대체하고 있다"며 정리해고를 발표하지만, 실제 이유는 인플레이션 속에서 수익을 유지하거나, 재무 지표를 조작해 기업 가치를 높이거나, 심지어 생성형 AI 플랫폼 구독료를 충당하기 위한 경우가 더 많다고 증언합니다. 남은 인원은 더 빠듯한 마감 속에서 늘어난 일을 떠안게 됩니다. 보고서는 이를 두고 "AI가 지루한 일을 맡고 재미있는 일은 사람에게 남겨 줄 것"이라는 약속과 정반대의 결과, 곧 덜 즐거운 일을 더 힘들게 하는 상황이라고 정리합니다.
결론으로서의 노동자 통제
도입부의 마지막 절은 생성형 AI를 규제하기에 가장 적합한 사람은 그것을 만들고 쓰는 노동자라고 주장합니다. 이익과 피해를 가장 먼저 겪는 사람이 그들이기 때문입니다. 보고서는 Daron Acemoglu, David Autor, Simon Johnson이 제안한 "노동자 친화적 AI(pro-worker AI)"라는 전제를 경제학자 Joshua Gans의 비판(WTF is Pro-Worker AI)을 근거로 이미 반박된 전제라며 거부하고, 기술 자체가 아니라 기술에 대한 권한을 누가 갖는지가 핵심이라고 봅니다. 150여 년 전 미국의 노예제 폐지론자이자 노동 개혁가 웬델 필립스(Wendell Phillips)의 "노동은 자신이 만든 모든 것에 대한 권리가 있다"는 말을 인용하며 도입부를 닫습니다.
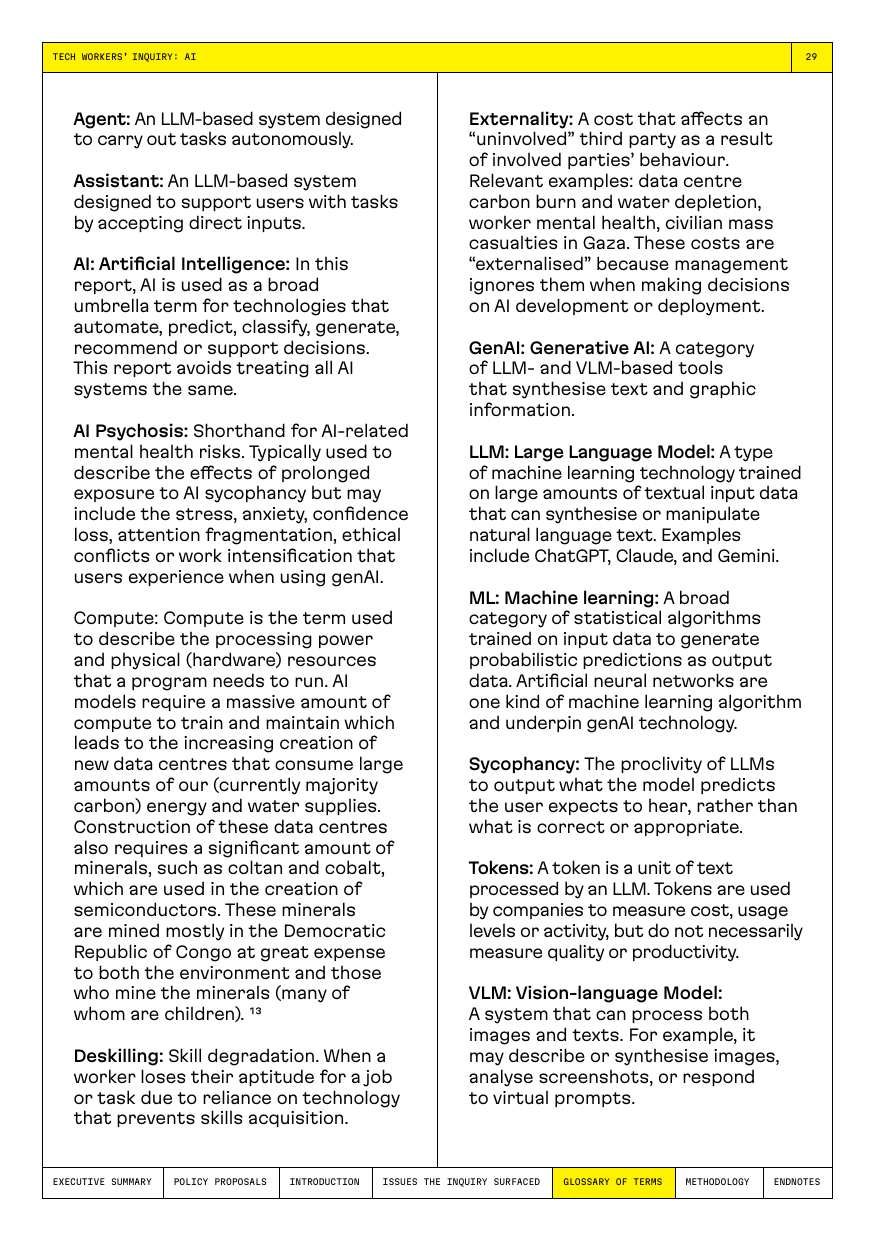
보고서 용어집의 주요 정의
보고서 뒷부분의 용어집은 이후 증언을 읽는 데 필요한 개념을 정리해 둡니다. 이 중 이 글에서 자주 등장하는 용어는 다음과 같습니다.
-
탈숙련(Deskilling): 노동 관행이 바뀌어 어떤 일을 하는 데 필요한 훈련이나 경험의 양이 줄어드는 현상입니다. 보고서는 이것이 임금과 노동 조건을 끌어내리는 압력으로 이어진다고 설명합니다.
-
역량 저하(Downskilling): 기술에 의존하느라 기술을 익힐 기회를 잃어, 노동자 개인이 원래 갖고 있던 능력이 퇴화하는 현상입니다. 웹 버전은 두 용어를 따로 정의하지만, PDF 용어집에는 역량 저하의 정의가 탈숙련 항목에 들어가 있습니다.
-
아첨(Sycophancy): LLM이 옳거나 적절한 답 대신 사용자가 듣고 싶어 할 것으로 예측되는 답을 출력하는 경향입니다.
-
AI 정신증(AI Psychosis): AI와 관련한 정신 건강 위험을 가리키는 약칭으로, 주로 AI의 아첨에 장기간 노출된 영향을 말하지만 스트레스, 불안, 자신감 하락, 주의력 분산, 윤리적 갈등, 업무 강화까지 포함할 수 있다고 정의합니다.
-
외부효과(Externality): 의사결정에 참여하지 않은 제3자가 떠안는 비용입니다. 보고서는 데이터센터의 탄소 배출과 물 소비, 노동자의 정신 건강, 가자 지구의 민간인 희생을 예로 듭니다.
-
토큰(Token): LLM이 처리하는 텍스트 단위입니다. 보고서는 기업이 토큰으로 비용, 사용량, 활동량을 측정하지만 토큰이 품질이나 생산성을 반드시 측정하지는 않는다는 점을 정의 자체에 적어 둡니다.
기술 노동자들의 증언으로 드러난 8가지 문제
보고서의 본론인 "조사에서 드러난 문제(Issues the Inquiry Surfaced)" 장은 8개 주제로 나뉘고, 각 주제는 직군이 표기된 익명 인용문과 분석으로 구성됩니다. 전체 내용을 먼저 표로 정리하면 다음과 같습니다.
| # | 주제 | 핵심 내용 |
|---|---|---|
| 1 | 일의 만족도 하락 | 문제 해결이던 일이 LLM 출력의 감독과 수정으로 바뀜 |
| 2 | 탈숙련과 역량 저하 | 주니어는 기초를 익힐 기회를 잃고, 시니어도 스스로 코드를 읽고 쓰는 능력의 퇴화를 느낌 |
| 3 | 모니터링, 징계, 승진 | 토큰 사용량이 성과 지표가 되고, 데이터 수집 방식은 불투명함 |
| 4 | 외부효과와 더 넓은 피해 | 환경, 군사적 활용, 정신 건강 비용이 의사결정에서 빠짐 |
| 5 | 일방적인 의사결정 | 대부분의 도입에서 현장 전문가와의 협의가 없었음 |
| 6 | 직장 내 분열의 심화 | 주니어와 시니어, 생산하는 쪽과 검토하는 쪽, 관리자와 실무자 사이의 골이 깊어짐 |
| 7 | 업무량 | 산출량 기대와 검토 부담이 서로를 키우는 업무 강화 루프 |
| 8 | 건강과 안전 | 스트레스 증가, 자신감과 주의력 하락, 일과 삶의 균형 붕괴 |
아래에서는 보고서의 순서대로 각 주제를 정리합니다.
1. 일의 만족도 하락: 문제 해결에서 LLM 감독으로
"AI로 코딩하는 걸 그만두자마자 일이 다시 즐거워지기 시작했어요."
"I started enjoying my job again as soon as I stopped using AI to code."
(소프트웨어 엔지니어, Software Engineer)
노동자들은 지적으로 자극이 되던 일에서 밀려나 프롬프트를 쓰고, 품질이 낮은 출력을 검토하고 고치는 일로 옮겨 가고 있다고 말합니다. 코드를 작성하는 직군에서는 일의 성격 자체가 문제 해결에서 LLM 감독으로 바뀌고 있습니다. 많은 참여자가 더 이상 코딩의 몰입(flow) 상태에 들어가지 못하고, 모델을 감독하고 출력을 평가하는 데 시간을 쓴다고 답했습니다. 보고서는 품질이 낮은 출력을 승인하지 않으려면 검토와 수정이 워낙 많이 필요해서, 시간이 절약되기보다 오히려 낭비되는 경우가 잦다고 정리합니다.
2. 탈숙련(Deskilling)과 역량 저하(Downskilling): 배울 기회가 사라지는 구조
"코딩 어시스턴트를 쓰면 쓸수록 직접 하는 실력은 떨어집니다."
"The more you use a coding assistant, the worse you get at doing it yourself."
(소프트웨어 엔지니어, Software Engineer)
역량 저하는 직군을 가리지 않고 나온 주요 우려였습니다. 참여자들은 생성형 AI를 오래 쓴 뒤로는 예전에는 찾아볼 필요가 없던 방법을 다시 검색해야 한다고 말했고, 이런 현상은 코딩 업무에서 특히 두드러졌습니다.
가장 큰 영향을 받는 쪽은 주니어입니다. 기초가 탄탄하지 않은 노동자는 에이전트와 어시스턴트에 과도하게 의존하게 되고, 업무 강화 때문에 필요한 기술과 비판적 사고를 익힐 시간도 동기도 없습니다. 업무 강도가 올라가면서 문제를 함께 논의할 상대를 찾기도 어려워졌습니다. 전문성이 없으니 LLM 출력의 품질을 판단하기도 어렵다는 것이 보고서의 진단입니다.
시니어의 경험은 조금 다릅니다. 일부 시니어는 LLM을 자기 사고를 대신하는 것이 아니라 코딩을 돕는 도구로 쓸 때 더 자신감을 느낀다고 답했습니다. AI가 확산되기 전에 이미 역량을 쌓았기 때문에 인지적 항복(Cognitive Surrender) 에 더 잘 저항할 수 있다는 것입니다. 이 개념은 Shaw와 Nave의 2026년 프리프린트 Thinking: Fast, Slow, and Artificial에서 가져온 것입니다. 그러나 시니어들도 LLM을 쓰면서 스스로 코드를 검토하고 작성하는 능력이 떨어지고 있다는 점은 인정했습니다.
"AI는 정보를 모으고 압축하면서 중요한 세부와 뉘앙스를 놓치는 경우가 많아서, 직접 부딪히고 실수하면서 배울 기회가 없습니다."
"Because AI aggregates and distills information, often missing important details and nuance, there is no opportunity to learn through exposure and mistakes."
(데이터 분석가, Data Analyst)
보고서는 고용주가 직원 교육의 대체재로 LLM을 쓰고 있으며, 그 결과 전문성과 역량의 공백이 가려진다고 지적합니다. LLM 리서치 어시스턴트 사용이 의무화된 곳에서는 도구가 학습 과정을 대신하면서, 누구나 짧은 시간 안에 전문가가 될 수 있다는 비현실적인 기대가 생깁니다. 장기적으로는 산업 전반의 전문성과 역량이 줄어들 것이고, 오픈소스 라이브러리에 LLM이 생성한 문서가 늘어나면서 문서의 양은 늘지만 품질은 떨어지는 현상이 모든 경력 단계의 학습을 방해한다는 우려도 덧붙입니다.
이 주제는 PyTorchKR에서도 여러 번 다룬 바 있습니다. AI 시대에 기술 쇠퇴를 피하는 방법이나 AI 보조 코딩 중 의도적인 학습을 끼워 넣는 Learning Opportunities 스킬은 개인 차원의 대응을 다루는 반면, 이 보고서는 같은 문제를 조직과 제도의 문제로 봅니다.
3. 모니터링, 징계, 승진: 성과 지표가 된 토큰
"이제 AI가 KPI에 들어가 있어요. 보상과 보너스가 AI 사용에 달려 있습니다."
"AI is baked into our KPIs now. Remuneration and bonuses are contingent on AI use."
(주니어 소프트웨어 엔지니어, Junior Software Engineer)
경영진이 생성형 AI 도구 사용량을 모니터링하는 일은 널리 퍼져 있고, 때로는 감시라고 불릴 정도이며 형태도 다양합니다. 보고서가 짚는 모순은 노동자들이 AI를 너무 적게 써서, 그리고 너무 많이 써서 모두 불이익을 받는다 는 점이고, 이런 일이 같은 회사 안에서 벌어지기도 합니다.
"토큰을 최대한 많이 쓰라고 해 놓고, 동료는 너무 많이 썼다고 주의를 받았어요."
"We were told to use as many tokens as possible, then my colleague was slapped on the wrist for using too many."
(시니어 데이터 엔지니어, Senior Data Engineer)
보고서에 따르면 토큰이 출력 품질을 대신해 성과 지표가 되었고, 경력 성장이 실제 역량이 아니라 도구 사용량에 연동되고 있습니다. 일부 조직에서는 생성형 AI로 한 작업을 다시 LLM 기반 평가기가 평가하는데, 평가기가 사람의 답을 정확히 이해하지 못해 불공정한 평가 결과로 이어진다는 증언도 있었습니다. 대부분의 참여자는 어떤 사용 데이터가 수집되고 어떻게 분석되는지 알 수 없다고 답했습니다. 보고서는 이 불투명성이 성과 평가와 징계 절차에서 직원과 관리자 사이의 정보 비대칭을 키우며, 노동자들이 보이지 않는 과녁을 향해 활을 쏘는 셈이라고 표현합니다.
토큰 사용량을 성과와 연결하는 관행은 영국만의 이야기가 아닙니다. PyTorchKR에서 소개한 Amazon 직원들이 AI 사용 압박에 불필요한 작업으로 토큰 소비량을 부풀리고 있다는 글과 Tokenmaxxing은 죽었다, Tokenmaxxing 만세도 같은 현상을 다룹니다.
4. 외부효과와 더 넓은 피해: 환경, 군사적 활용, 윤리적 부담
"잘 작동할 때조차, 전체적으로 보면 여전히 나쁜 게 아니라고 말하기 어렵습니다."
"Even when it is good, it is not clear that it isn't still bad overall."
(소프트웨어 엔지니어, Software Engineer)
요약 장은 기술 노동자들이 AI가 환경, 군사 및 국가 감시 분야, 정신 건강에 미치는 해악을 깊이 우려하고 있으며, 그래서 정책 제안도 AI의 기능보다 누가 AI를 통제하고 그 이익을 가져가는지에 초점을 맞췄다고 설명합니다. 참여자들은 기업에 좋은 것이 사회에도 좋다는 생각에 거듭 의문을 제기했고, 도입 결정에 환경적, 심리적, 정치적 영향이 포함되어야 한다고 주장했습니다. 특정 도구의 도입이 합리적이고 근거에 기반한 경우에도 외부효과는 무시된다는 것입니다. 많은 참여자가 개인적 신념과 맞지 않는 생성형 AI 사용을 업무상 강요받으며 죄책감을 느낀다고 답했고, 보고서는 이 인지 부조화 가 근무 시간 이후까지 이어지는 스트레스를 만든다고 설명합니다.
"제가 만드는 AI가 인류에 도움이 되기를 바랍니다. 집단 학살을 돕는 데 쓰이기를 원하지 않아요."
"I want the AI I build to benefit humanity, not to facilitate a genocide."
(연구 과학자, Research Scientist)
최첨단 모델을 개발하는 프런티어 랩 참여자들은 자신의 작업이 군사적으로 쓰이는 방식에 깊은 불안을 드러냈습니다. 여러 차례의 내부 문제 제기, 외부 내부고발, 공개 시위에도 경영진이 문제의 존재와 규모를 부정하거나 외면한다는 증언입니다. 보고서는 관련 근거로 여러 프런티어 랩 직원들의 모임인 Coalition of Concerned AI Staff의 성명과, 미국과 이스라엘 정부의 AI 활용에 대한 직원들의 우려 속에서 Google DeepMind가 영국 노조와 협의에 들어갔다는 The Guardian 기사를 인용합니다. 기사에 따르면 DeepMind는 런던 본사 직원들이 노조 결성을 추진하기로 투표한 뒤 노조의 자발적 인정 요청은 거절했지만 CWU, Unite와 영국 조정중재위원회(Acas)에서 만나기로 했으며, UTAW는 현재 이 사안을 Google DeepMind 노조 인정(GDM Recognition) 캠페인으로 진행하고 있습니다.
환경 문제에 대해서 노동자들은 데이터센터 컴퓨팅이 인간의 지능과 달리 환경 비용을 전혀 고려하지 않는다고 지적하며, 더 빠르게 더 많은 일을 더 낮은 품질로 하기 위해 화석 연료를 더 태우는 논리 자체에 의문을 던졌습니다. 보고서는 영국 의회 과학기술처의 POSTnote 762: 데이터센터란 무엇이고 얼마나 지속 가능한가를 근거로 인용하고, 용어집의 컴퓨팅(Compute) 항목에서는 반도체 제조에 쓰이는 콜탄과 코발트가 주로 콩고민주공화국에서 아동 노동을 포함한 큰 인적, 환경적 비용을 치르며 채굴된다는 점도 함께 적어 둡니다. LLM 사용의 에너지 비용에 관해서는 PyTorchKR의 LLM 환각과 에이전트 토큰 낭비의 에너지 비용 글도 참고할 수 있습니다.
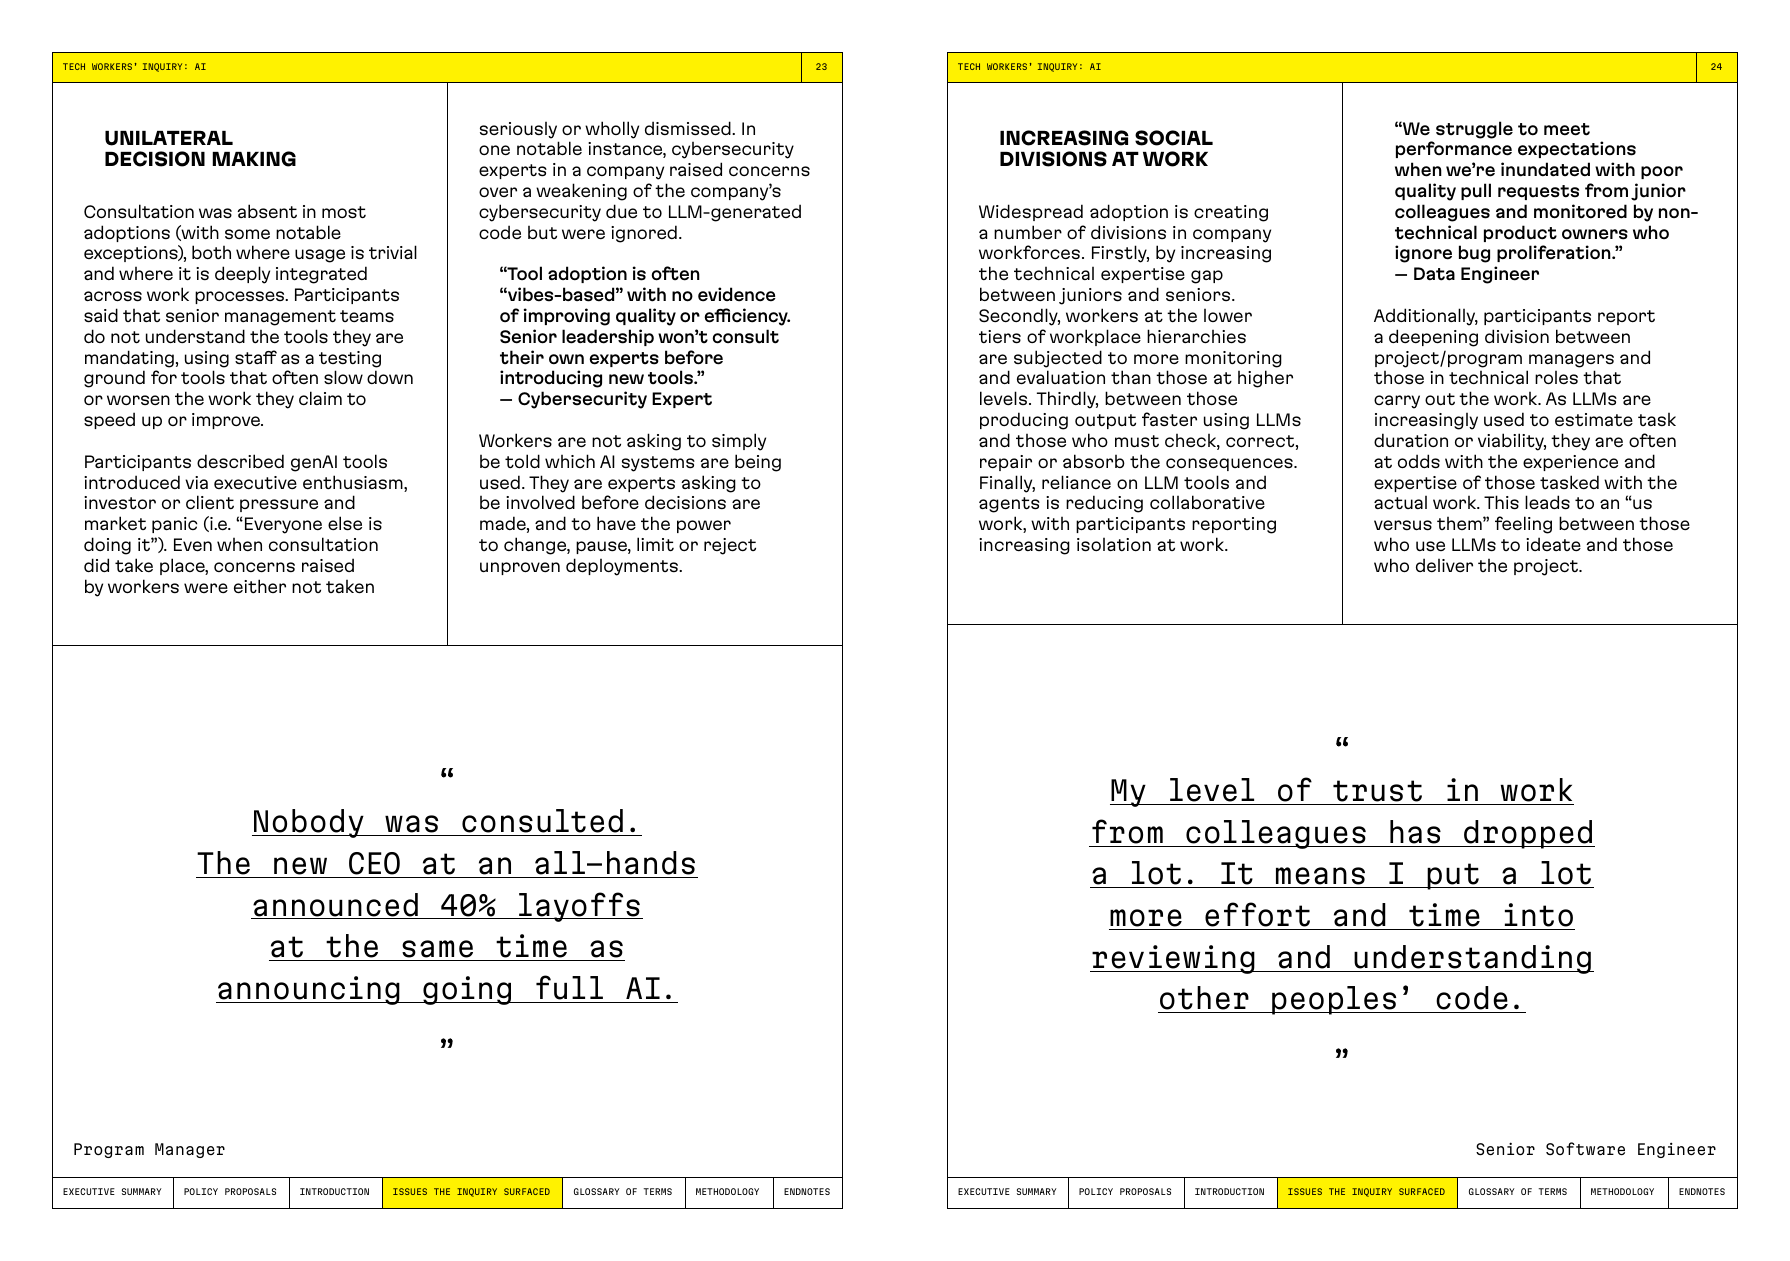
5. 일방적인 의사결정: 협의 없는 도입
"아무도 의견을 묻지 않았어요. 새로 온 CEO가 전사 회의에서 'AI 전면 도입'을 발표하면서 동시에 40% 감원을 발표했습니다."
"Nobody was consulted. The new CEO at an all-hands announced 40% layoffs at the same time as announcing going full AI."
(프로그램 매니저, Program Manager)
일부 예외를 제외하면 대부분의 도입 과정에 협의가 없었고, 이는 가볍게 쓰이는 도구든 업무 프로세스 전반에 깊이 통합된 도구든 마찬가지였습니다. 참여자들은 경영진이 자신들이 의무화하는 도구를 이해하지 못한 채, 직원을 도구의 시험장으로 쓰고 있다고 말했습니다. 속도와 품질을 높인다던 도구가 실제로는 일을 느리게 하거나 나쁘게 만드는 경우가 많다는 것입니다.
"도구 도입이 품질이나 효율 개선의 근거 없이 '분위기(vibes)'로 결정되는 경우가 많습니다. 경영진은 새 도구를 들이기 전에 사내 전문가에게 묻지도 않아요."
"Tool adoption is often "vibes-based" with no evidence of improving quality or efficiency. Senior leadership won't consult their own experts before introducing new tools."
(사이버 보안 전문가, Cybersecurity Expert)
보고서는 생성형 AI 도구가 경영진의 열의, 투자자나 고객의 압박, 그리고 "다들 하니까"라는 시장의 공포를 통해 도입된다고 설명합니다. 협의가 이루어진 경우에도 노동자의 우려는 진지하게 다뤄지지 않거나 완전히 묵살되었습니다. 한 회사에서는 사이버 보안 전문가들이 LLM이 생성한 코드 때문에 회사의 보안 수준이 약해지고 있다고 경고했지만 무시되었다는 사례도 소개됩니다. 보고서는 노동자들이 원하는 것이 어떤 AI 시스템을 쓰는지 통보받는 것이 아니라, 결정 이전에 참여하고 검증되지 않은 도입을 바꾸거나, 중단하거나, 제한하거나, 거부할 수 있는 권한 이라고 강조합니다.
6. 직장 내 분열의 심화: 생산하는 쪽과 검토하는 쪽
"동료가 한 작업에 대한 신뢰가 많이 떨어졌어요. 다른 사람의 코드를 검토하고 이해하는 데 훨씬 더 많은 노력과 시간을 씁니다."
"My level of trust in work from colleagues has dropped a lot. It means I put a lot more effort and time into reviewing and understanding other peoples' code."
(시니어 소프트웨어 엔지니어, Senior Software Engineer)
보고서는 생성형 AI의 광범위한 도입이 조직 안에 여러 겹의 분열을 만든다고 봅니다.
-
주니어와 시니어 사이의 전문성 격차: 2번 주제에서 본 것처럼 주니어가 기초를 익힐 기회를 잃으면서 두 집단의 기술적 격차가 더 벌어집니다.
-
직급에 따른 감시의 차이: 조직 위계의 아래쪽에 있는 노동자일수록 위쪽보다 더 많은 모니터링과 평가를 받습니다.
-
생산하는 쪽과 뒷수습하는 쪽: LLM으로 산출물을 빠르게 만들어 내는 사람과, 그 결과물을 확인하고, 고치고, 복구하고, 그 결과를 떠안아야 하는 사람 사이에 골이 생깁니다.
-
협업의 감소와 고립: LLM 도구와 에이전트에 의존하면서 함께 일하는 시간이 줄고, 참여자들은 직장에서 점점 더 고립된다고 느낍니다.
"주니어 동료들이 올리는 품질 낮은 풀 리퀘스트가 쏟아지고, 버그가 늘어나는 걸 무시하는 비기술직 프로덕트 오너에게 모니터링까지 받으니 성과 기대치를 맞추기가 힘듭니다."
"We struggle to meet performance expectations when we're inundated with poor quality pull requests from junior colleagues and monitored by non-technical product owners who ignore bug proliferation."
(데이터 엔지니어, Data Engineer)
여기에 더해 프로젝트/프로그램 매니저와 실제 작업을 수행하는 기술직 사이의 골도 깊어지고 있습니다. 작업 기간이나 실현 가능성을 추정하는 데 LLM을 쓰는 일이 늘면서, 그 추정치가 실제로 일을 맡은 사람의 경험과 자주 어긋나기 때문입니다. 보고서는 이것이 LLM으로 아이디어를 내는 사람과 프로젝트를 실제로 완수하는 사람 사이에 "우리 대 그들"이라는 감정을 만든다고 설명합니다.
7. 업무량(Workload): 보이지 않는 검토 노동과 업무 강화 루프
"에이전트와 일하는 건 슬롯머신을 당기는 것과 같아요. 결과가 1분 만에 나올지 1시간 뒤에 나올지 모르고, 그게 제대로 동작할지도 모릅니다."
"Working with agents is like using a slot machine, output could take a minute or an hour to arrive, and you don't even know if it'll work."
(3차 기술 지원 엔지니어, Third Line Support Engineer)
"문제가 나오자마자 한 시간 안에 해결책을 내놓으라는 기대를 받습니다."
"No sooner is the problem stated than you're expected to have a solution within an hour."
(소프트웨어 엔지니어, Software Engineer)
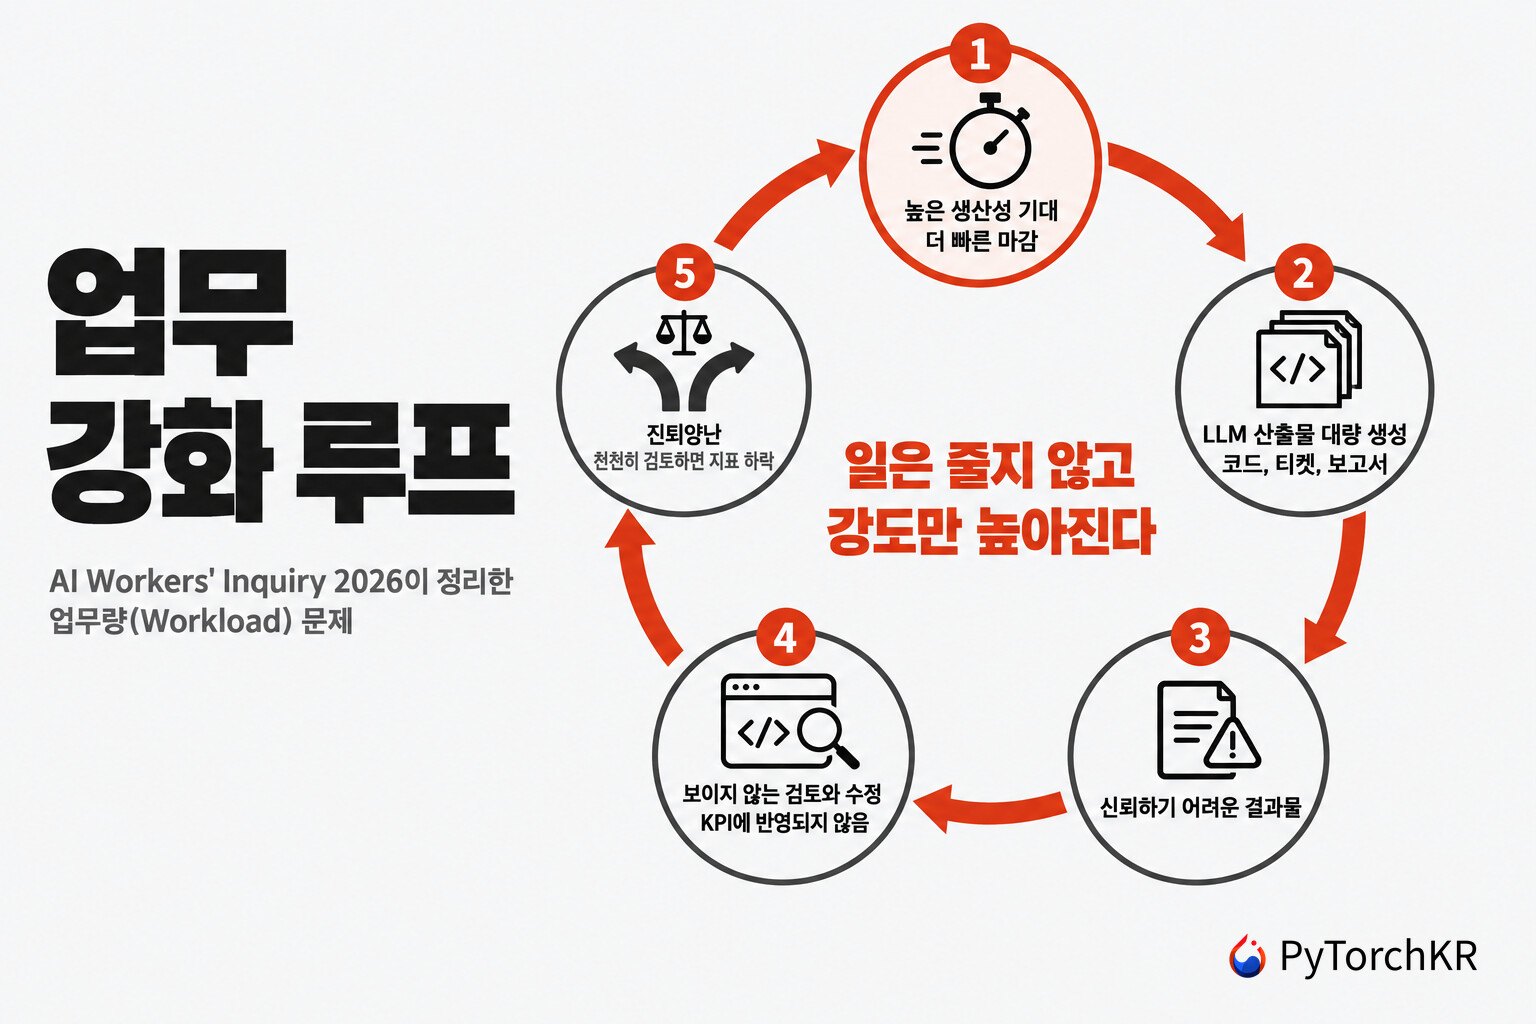
조사 전반에 걸쳐 생성형 AI가 업무량을 줄였다고 말한 노동자는 없었습니다. 참여자들이 보고한 것은 산출량 증가, 더 빠듯한 마감, 더 높은 생산성 기대로 이루어진 업무 강화였습니다. 코드는 사람이 확인할 수 있는 속도보다 훨씬 빨리 생성되고, 노동자는 LLM이 만든 코드를 검토하고, 문제를 디버깅하고, 출력을 확인하고, 문제를 수습하는 추가 노동을 떠안습니다. 대부분의 경우 이 추가 노동은 경영진에게 보이지 않고 KPI에도 반영되지 않습니다.
직군별로도 양상이 비슷합니다. 교육과 학계에서는 학생이나 동료의 생성형 AI 오용 때문에 오용을 입증하는 상세 보고서 작성, 이의 신청과 재시험 처리, 품질 낮은 자료 수정 같은 무급 추가 업무가 생긴다고 합니다. 소프트웨어와 사이버 보안 분야에서는 생성형 AI가 숙련된 노동자가 검토하고 고칠 수 있는 양보다 많은 코드, 티켓, 보고서, 사고 기록을 만들어 냅니다. 고객 지원에서는 텍스트 생성 속도가 곧 추가 편집과 품질 관리 업무가 됩니다. 이런 감독 업무를 다시 생성형 AI에 맡기고 싶은 유혹은 크지만, 나쁜 결과에 대한 책임은 도구가 아니라 언제나 노동자에게 돌아온다는 점을 보고서는 분명히 합니다.
보고서는 이 과정 전체를 높은 생산성 기대가 신뢰하기 어려운 산출물을 대량으로 만들고, 그 산출물을 사람이나 다른 어시스턴트 도구가 다시 검토해야 하는 양의 피드백 루프(Positive Feedback Loop) 로 설명합니다. 이 루프는 진퇴양난(Catch-22) 상황을 만듭니다. 성실한 직원은 속도를 늦춰 출력을 제대로 검토해야만 루프를 끊을 수 있지만 그러면 자신의 성과 지표가 위험해지고, 저항이 가장 적은 길을 택하면 제대로 검토되지 않은 LLM 출력에 대한 책임을 떠안게 됩니다. 아래 그림은 보고서의 이 설명을 순환 구조로 정리한 것입니다.
PyTorchKR에서 소개한 AI 보조 코딩이 당신의 업무에 어떤 영향을 주고 있나요? (via HackerNews)나 Agentic Coding은 함정이다에서도 개발자들이 비슷한 검토 부담을 이야기합니다. 이 보고서가 다른 점은 이 부담을 개인의 도구 사용 습관이 아니라 성과 지표와 책임 소재의 문제로 본다는 점입니다.
8. 건강과 안전: 스트레스는 오르고 자신감과 주의력은 떨어진다
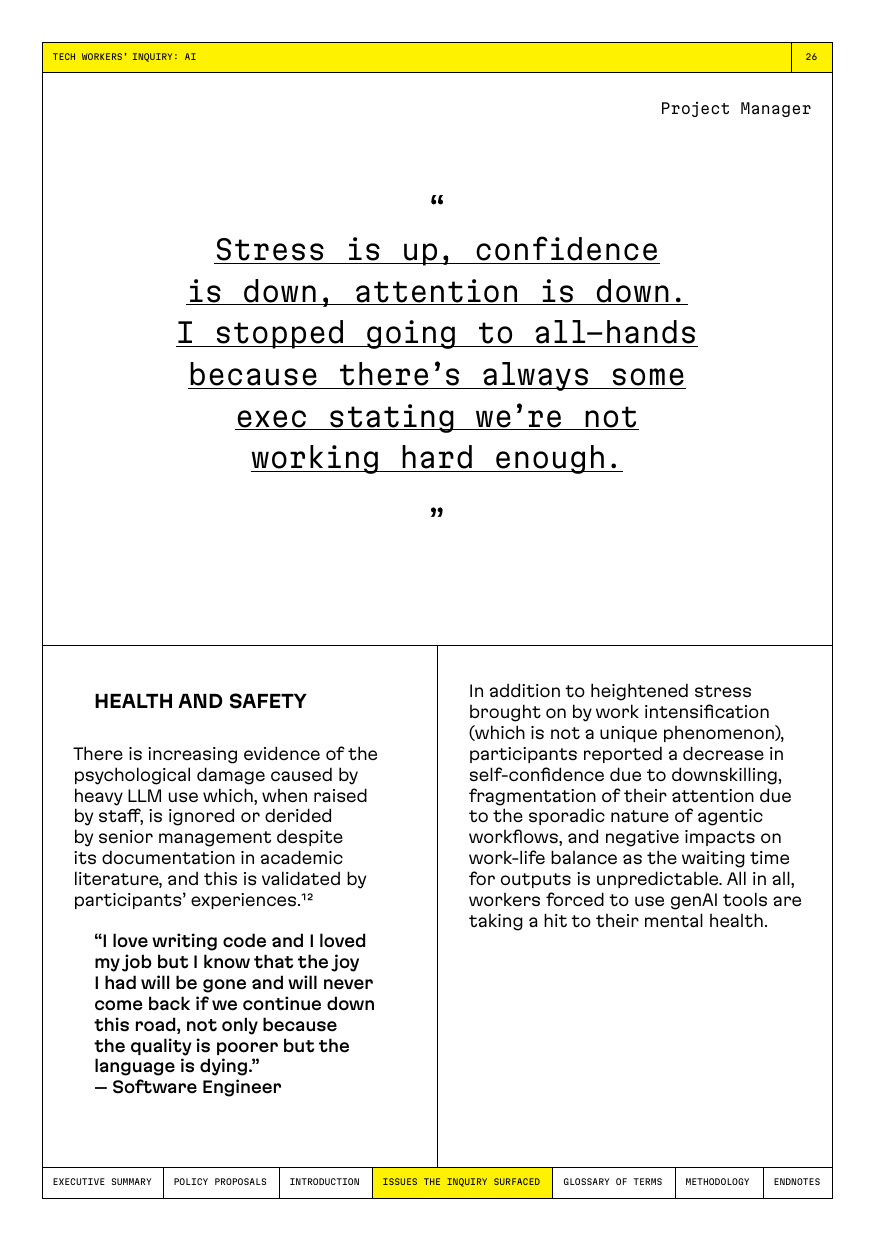
"스트레스는 올라가고, 자신감은 떨어지고, 집중력도 떨어졌어요. 전사 회의에는 이제 안 갑니다. 항상 어떤 임원이 나와서 우리가 충분히 열심히 일하지 않는다고 말하거든요."
"Stress is up, confidence is down, attention is down. I stopped going to all-hands because there's always some exec stating we're not working hard enough."
(프로젝트 매니저, Project Manager)
"저는 코드를 쓰는 걸 좋아했고 제 일을 사랑했어요. 하지만 이 길을 계속 간다면 그 즐거움은 사라지고 다시는 돌아오지 않을 거라는 걸 압니다. 품질이 나빠져서만이 아니라 언어가 죽어 가고 있기 때문이에요."
"I love writing code and I loved my job but I know that the joy I had will be gone and will never come back if we continue down this road, not only because the quality is poorer but the language is dying."
(소프트웨어 엔지니어, Software Engineer)
보고서는 LLM을 많이 사용할 때 생기는 심리적 피해에 대한 근거가 늘고 있다고 말합니다. 대표 근거로 인용한 것은 Kosmyna 외(2025)의 Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task로, AI 어시스턴트를 쓴 에세이 작성 과제에서 인지 부채(Cognitive Debt) 가 쌓인다는 연구입니다(참가자 54명의 뇌파(EEG)를 측정한 결과 LLM 사용 그룹의 뇌 연결성이 가장 약했습니다). 보고서에 따르면 직원들이 이런 문제를 제기해도 경영진은 학술 문헌에 기록되어 있음에도 무시하거나 조롱하며, 참여자들의 경험이 그 연구 결과를 뒷받침합니다.
참여자들이 보고한 영향은 네 가지입니다. 업무 강화로 인한 스트레스 증가(보고서는 이것이 AI만의 현상은 아니라고 덧붙입니다), 역량 저하로 인한 자신감 하락, 산발적으로 결과가 도착하는 에이전트 워크플로우 때문에 생기는 주의력 분산, 그리고 출력 대기 시간을 예측할 수 없어 일과 삶의 균형이 무너지는 문제입니다. 보고서는 이를 종합해 생성형 AI 도구 사용을 강요받는 노동자들의 정신 건강이 타격을 받고 있다고 결론짓습니다. 용어집에서 AI 정신증의 주된 원인으로 든 LLM의 아첨 문제는 PyTorchKR의 LLM의 첫 번째 다크 패턴은 아첨이다에서도 다룬 바 있습니다.
증언들 사이의 긴장 관계: 생산성의 약속과 노동의 현실
8가지 주제를 나란히 놓고 보면, 개별 불만의 목록이라기보다 몇 가지 반복되는 긴장 관계가 드러납니다.
생산성 향상과 업무 강화는 같은 현상의 두 이름입니다. 경영진과 AI 기업이 생산성 향상이라고 부르는 것을 노동자는 업무 강화로 경험합니다. 산출물은 늘었지만 그 산출물을 검증하는 노동은 지표에 잡히지 않기 때문에, 조직 수준의 숫자와 개인의 체감이 서로 다른 방향을 가리킵니다. 보고서가 기업의 생산성 주장을 받아들이지 않는 이유도 여기에 있습니다. Claude 사용자 8만여 명 설문이 "생산성은 늘었지만 일자리 불안도 함께 커지는 중"이라는 결과를 내놓은 것과 비교하면, 이 보고서는 같은 현상을 불안이 아니라 노동 조건의 문제로 번역한다고 볼 수 있습니다.
AI 사용량은 강제되면서 동시에 처벌됩니다. 토큰을 최대한 쓰라는 지시와 너무 많이 썼다는 질책이 한 회사 안에서 공존한다는 증언은, 사용량 지표가 무엇을 측정하려는 것인지 조직 스스로도 정하지 못했다는 점을 보여 줍니다. 보고서가 정책 제안에서 "AI 관련 지표가 활동량, 비용, 분량, 속도가 아니라 유용하고 안전하며 품질 높은 작업을 측정한다는 것을 고용주가 입증하라"고 요구하는 것도 이 모순을 겨냥합니다.
속도는 도구가 내고, 책임은 사람이 집니다. 보고서 전반에 걸쳐 반복되는 구조입니다. 코드는 더 빨리 생성되지만 결함에 대한 책임은 리뷰를 승인한 사람에게, 추정은 LLM이 하지만 일정 지연의 책임은 실무자에게 돌아갑니다. 요약에서 말한 "책임의 이동(shifting accountability)"은 이러한 구조를 가리킵니다.
시니어의 경험이 모두의 경험은 아닙니다. 이미 역량을 갖춘 시니어는 LLM을 보조 도구로 활용하며 자신감을 느끼기도 하지만, 그 역량을 쌓아야 할 주니어는 같은 도구 때문에 배울 기회를 잃습니다. AI 도입의 효과를 경험 많은 사용자 중심으로 평가하면 이 격차가 보이지 않습니다. 기업 쪽 분석인 Anthropic의 Claude Code 세션 40만 건 분석이 "코딩 실력보다 도메인 전문성"을 강조한 것과 함께 읽으면, 전문성을 쌓는 경로 자체를 누가 보장하느냐는 질문이 남습니다.
선택권이 있을 때만 유용합니다. 보고서의 모든 긴장 관계는 요약의 한 문장으로 수렴합니다. 노동자들은 AI의 긍정적인 활용이 스스로 AI를 어떻게 쓸지 결정할 수 있는 능력에 달려 있다고 강조했고, 보고서는 이를 "자신이 쓸지 말지, 어떻게 쓸지 선택할 수 있을 때만 유용하다"고 요약합니다. 이 때문에 보고서는 문제의 원인을 오늘날 모델의 기술적 한계에서 찾지 않습니다. 저품질 출력과 환각(Hallucination), 취약한 코드도 영향을 주지만 그것은 일부일 뿐이고, 더 큰 원인은 고용주가 AI를 업무 강화, 정리해고의 명분, 주니어 채용 중단, 감시 확대, 탈숙련과 역량 저하, 위험의 노동자 전가, 노동자의 주체성 약화에 쓰고 있다는 데 있다고 봅니다. 따라서 모델이 좋아져도 노동자가 AI 사용 방식에 대한 강제력 있는 권리를 얻지 못하면 근본적인 문제는 남는다 는 것이 보고서의 핵심 주장입니다.
8개 영역 32개 항목의 정책 제안: 강제력 있는 규제 체계
5가지 정책 방향과 TUC 동의안
보고서의 정책 제안은 2026년 영국 노동조합회의(Trades Union Congress, TUC) 연차 총회에서 채택된 복합 동의안 C13 Artificial Intelligence at work를 확장한 것입니다. 이 동의안은 CWU가 발의하고 Aegis가 재청했으며, 공공 부문 노조 UNISON, 전국교육노조(National Education Union), 유통업 노조 USDAW(Union of Shop, Distributive and Allied Workers)가 지지했습니다. 동의안은 AI 도입 전 노조와의 협의 및 교섭 의무화, 공정노동청(Fair Work Agency)의 집행 권한을 갖춘 새 규제 체계, 견습과 신입 일자리 보호 등을 요구하고 있으며, 보고서는 이를 더 구체적인 항목으로 풀어 씁니다. 요약 장은 제안 전체를 다음 5가지 방향으로 정리합니다.
-
투명성만으로는 부족합니다: 노동자에게는 AI 도입에 대한 실질적인 협의와 교섭이 필요합니다.
-
AI 사용은 의무가 되어서는 안 됩니다: AI 사용을 거부해도 불이익을 받지 않도록 법적으로 보호하고, AI 기반 경영 의사결정을 제한해야 합니다.
-
AI 외부효과에 대한 안전장치: 우리가 만드는 AI가 사람과 지구에 해를 끼치지 않도록 강력한 규제가 필요합니다.
-
두뇌 유출을 멈춰야 합니다: 주니어와 신입 노동자를 위해 AI 없이 배우는 학습 경로를 만들고 지켜야 합니다.
-
최종 결정은 노동자가 합니다: 직장 내 AI에 대한 단체교섭을 제도화해야 합니다.
보고서가 반복해서 강조하는 원칙은 "결과가 따르지 않는 공개는 문제를 덮을 뿐"이라는 것입니다. 협의와 투명성은 실제 책임과 효과적인 조치로 이어질 때만 의미가 있습니다. 이 원칙이 32개 항목 곳곳에서 규제 기관의 제재 권한, 도입 중단 요청권, 노동자 대표의 동수 참여 같은 강제 장치로 구체화됩니다.
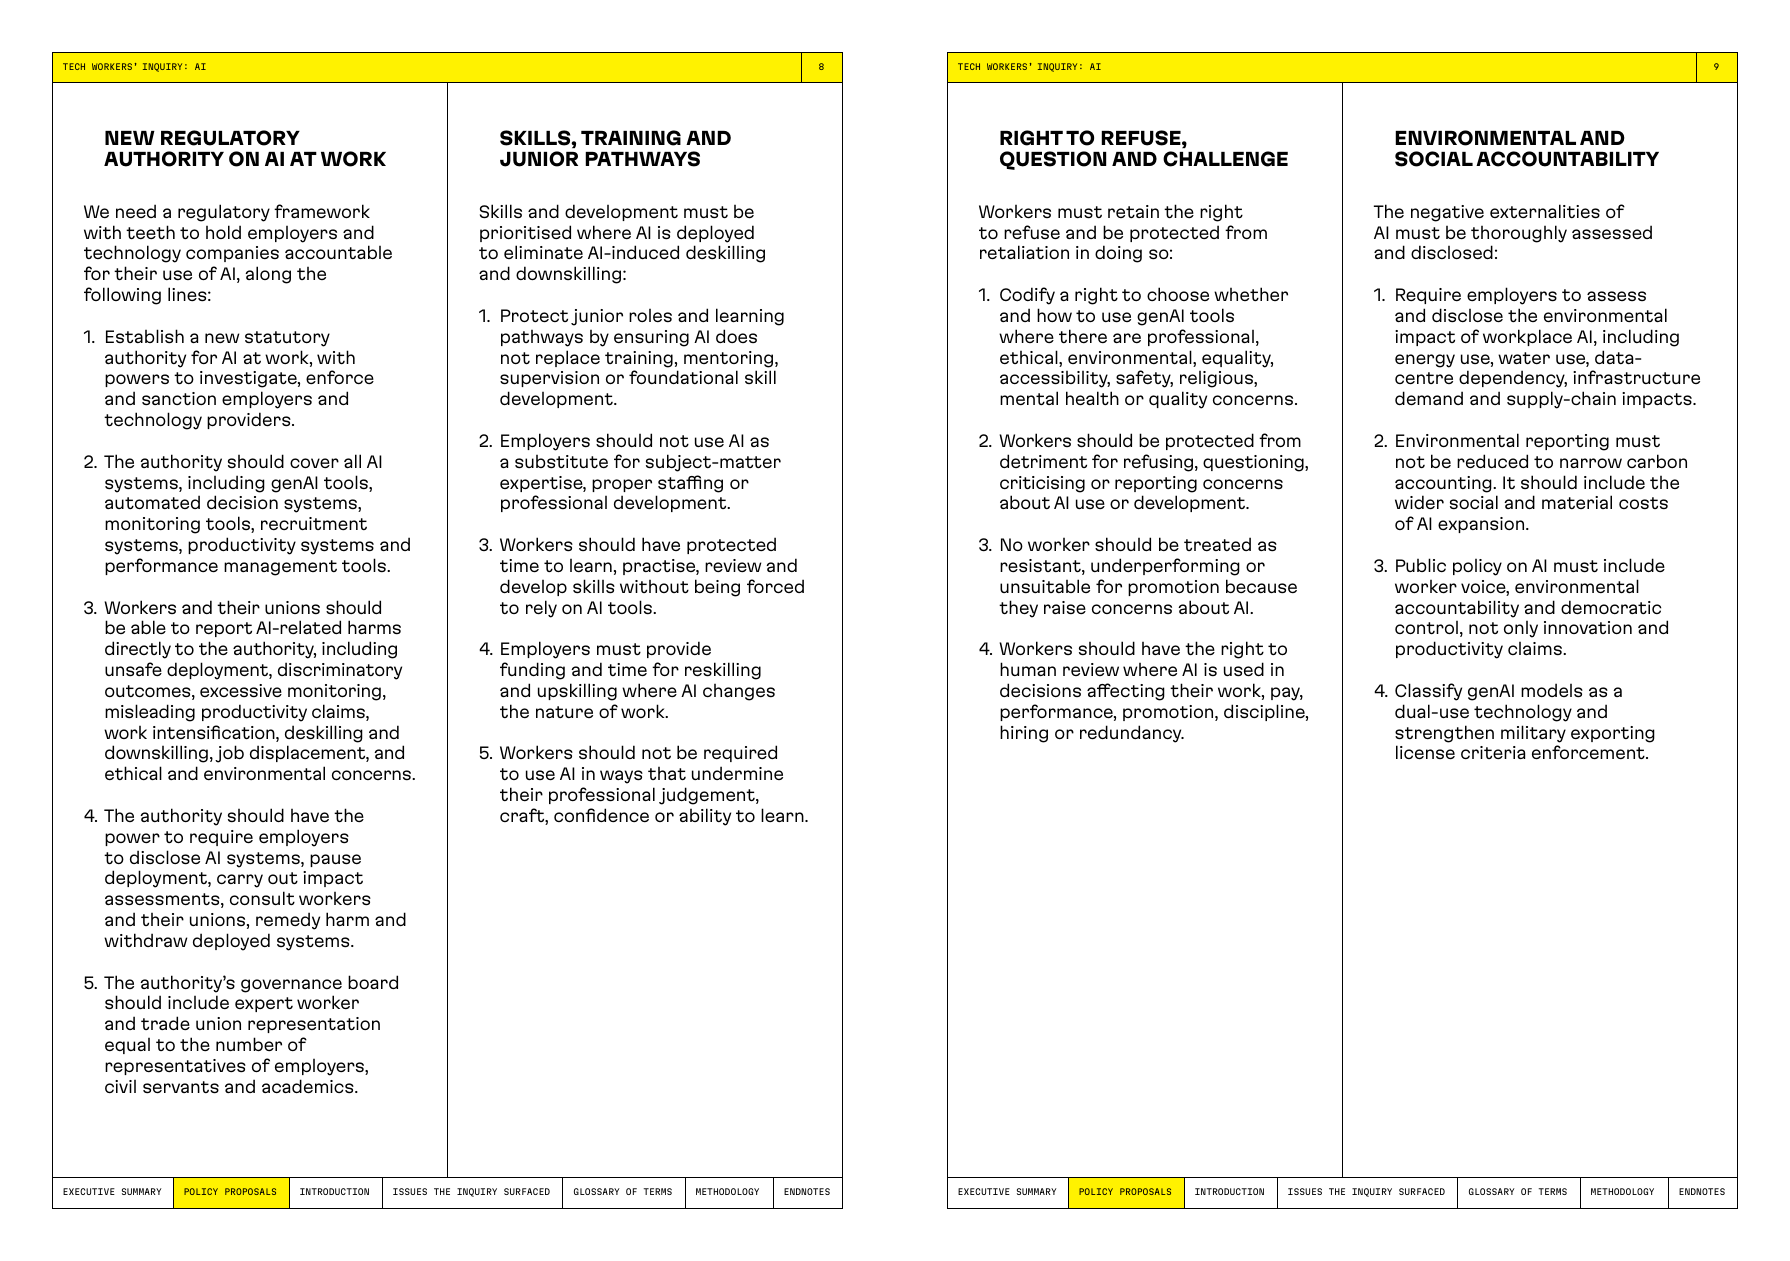
1. 직장 내 AI를 전담하는 새로운 규제 기관
보고서는 고용주와 기술 기업이 AI 사용에 책임을 지도록 하는 "실효성 있는(with teeth)" 규제 체계가 필요하다며 다음을 제안합니다.
- 고용주와 기술 공급자를 조사하고, 법을 집행하고, 제재할 권한을 가진 직장 내 AI 전담 법정 기관을 새로 설립합니다.
- 이 기관은 생성형 AI 도구뿐 아니라 자동화된 의사결정 시스템, 모니터링 도구, 채용 시스템, 생산성 시스템, 성과 관리 도구 등 모든 AI 시스템을 관할합니다.
- 노동자와 노조가 안전하지 않은 도입, 차별적 결과, 과도한 모니터링, 오해를 부르는 생산성 주장, 업무 강화, 탈숙련과 역량 저하, 일자리 대체, 윤리와 환경 문제 같은 AI 관련 피해를 기관에 직접 신고할 수 있어야 합니다.
- 기관은 고용주에게 AI 시스템 공개, 도입 중단, 영향 평가, 노동자와 노조와의 협의, 피해 구제, 이미 도입한 시스템의 철회를 요구할 수 있어야 합니다.
- 기관의 운영위원회에는 고용주, 공무원, 학계 대표와 같은 수의 노동자와 노조 전문가 대표가 참여해야 합니다.
2. 역량, 훈련, 그리고 주니어의 성장 경로
AI가 도입되는 곳에서는 AI로 인한 탈숙련과 역량 저하를 없애기 위해 역량 개발을 우선해야 한다는 제안입니다.
- AI가 교육, 멘토링, 지도, 기초 역량 개발을 대체하지 않도록 해 주니어 직무와 학습 경로를 보호합니다.
- 고용주는 AI를 주제 전문성(Subject-matter Expertise), 적정 인력 배치, 직무 역량 개발의 대체재로 써서는 안 됩니다.
- 노동자에게는 AI 도구에 의존하도록 강요받지 않고 배우고, 연습하고, 검토하고, 역량을 키울 수 있는 보호된 시간이 주어져야 합니다.
- AI가 일의 성격을 바꾸는 곳에서 고용주는 재교육(Reskilling)과 역량 향상(Upskilling)을 위한 예산과 시간을 제공해야 합니다.
- 노동자의 전문적 판단, 숙련, 자신감, 학습 능력을 해치는 방식으로 AI 사용을 요구해서는 안 됩니다.
3. 거부하고, 질문하고, 이의를 제기할 권리
노동자가 AI 사용을 거부할 권리를 유지하고, 그로 인한 보복에서 보호받아야 한다는 제안입니다.
- 직업적, 윤리적, 환경적, 평등, 접근성, 안전, 종교, 정신 건강, 품질상의 우려가 있을 때 생성형 AI 도구를 쓸지, 어떻게 쓸지 선택할 권리를 법으로 명시합니다.
- AI 사용이나 개발에 대해 거부하고, 질문하고, 비판하고, 우려를 신고한 노동자가 불이익을 받지 않도록 보호합니다.
- AI에 대한 우려를 제기했다는 이유로 저항적이거나, 성과가 낮거나, 승진에 부적합한 사람으로 취급받아서는 안 됩니다.
- 업무, 임금, 성과, 승진, 징계, 채용, 정리해고에 영향을 주는 결정에 AI가 쓰이는 경우 사람의 검토를 받을 권리가 있어야 합니다.
4. 환경적, 사회적 책임
AI의 부정적 외부효과를 철저히 평가하고 공개해야 한다는 제안입니다.
- 고용주가 직장 내 AI의 에너지 사용, 물 사용, 데이터센터 의존도, 인프라 수요, 공급망 영향을 포함한 환경 영향을 평가하고 공개하도록 의무화합니다.
- 환경 보고는 좁은 의미의 탄소 회계로 축소되어서는 안 되며, AI 확산의 더 넓은 사회적, 물질적 비용을 포함해야 합니다.
- AI에 관한 공공 정책은 혁신과 생산성 주장뿐 아니라 노동자의 목소리, 환경적 책임, 민주적 통제를 포함해야 합니다.
- 생성형 AI 모델을 이중 용도 기술(Dual-use Technology)로 분류하고, 군사 수출 허가 기준의 집행을 강화합니다.
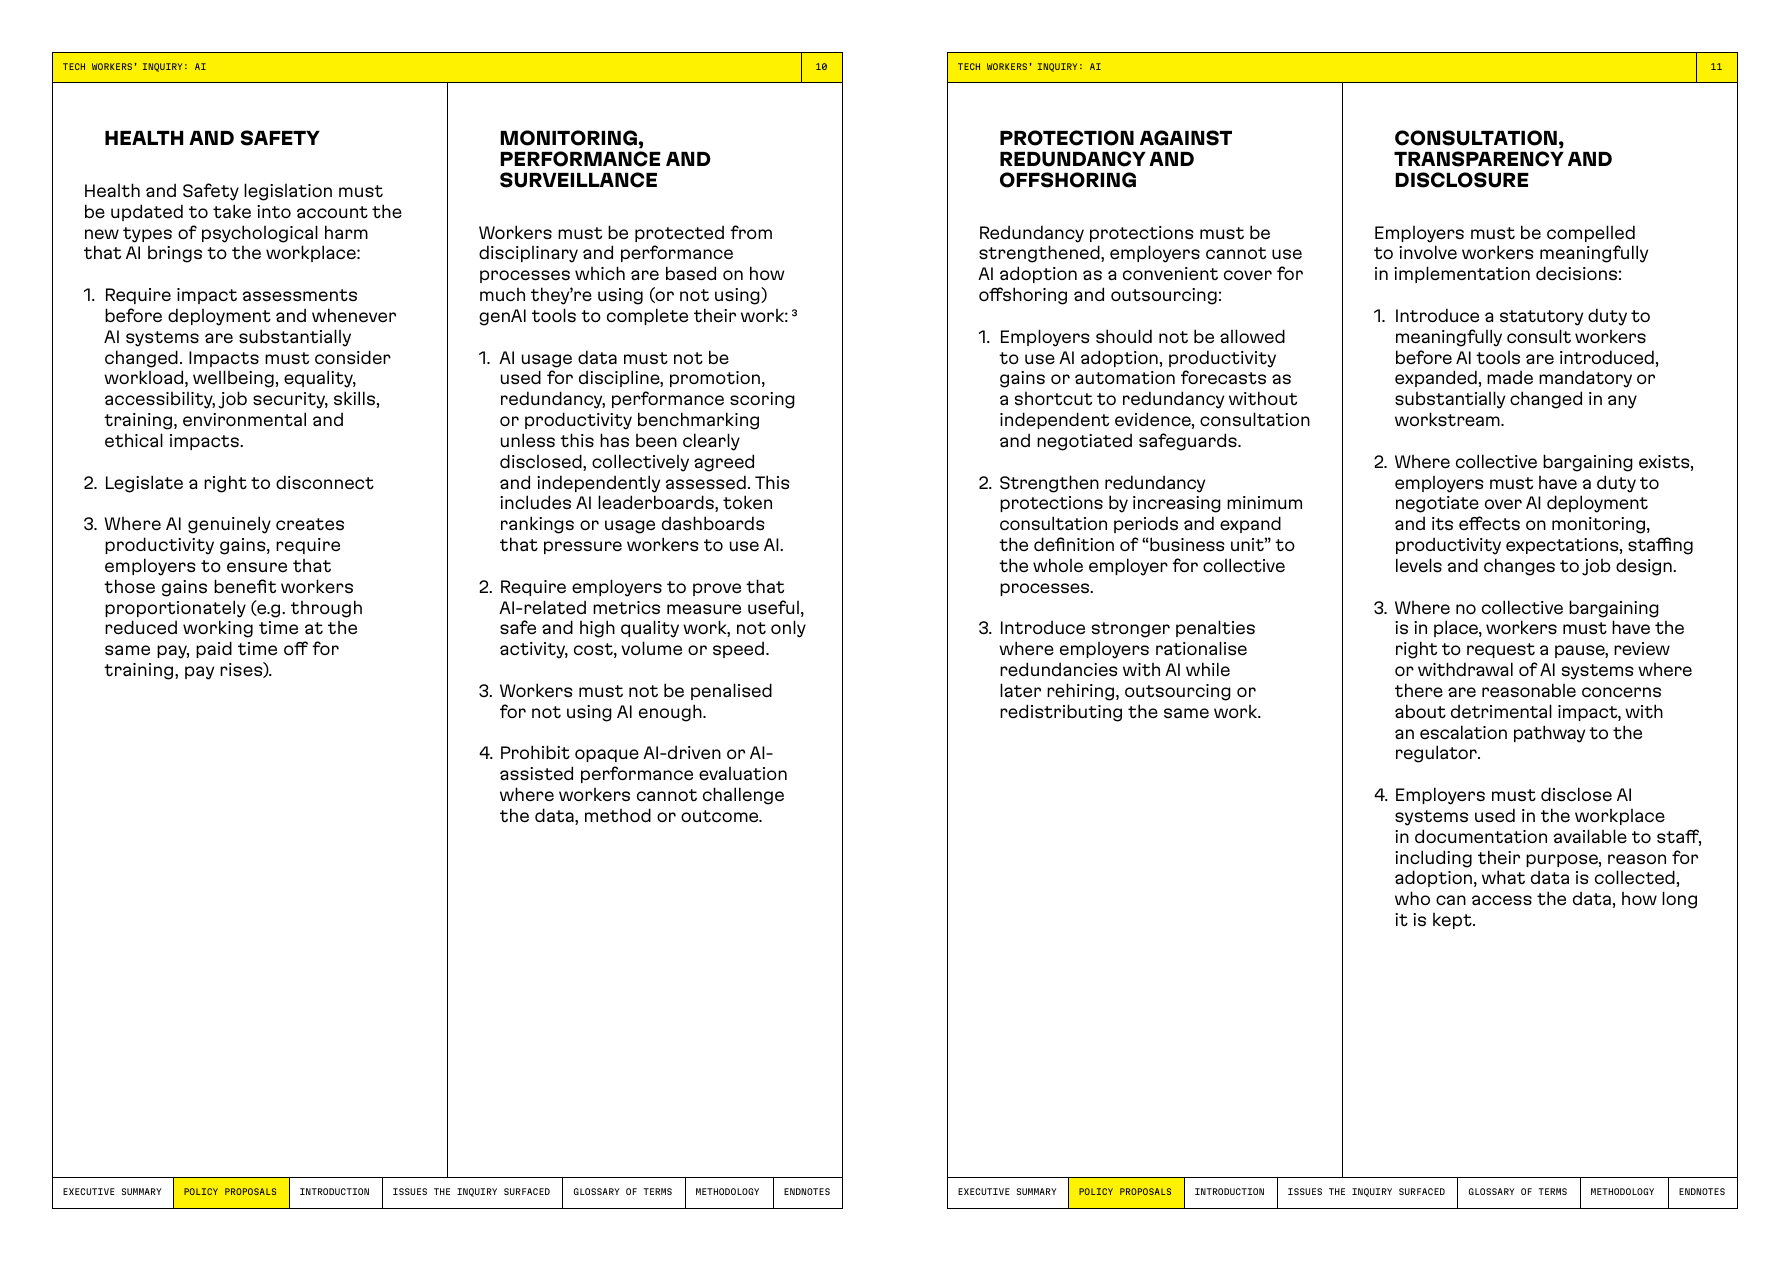
5. 건강과 안전
AI가 직장에 가져오는 새로운 유형의 심리적 피해를 반영하도록 산업안전보건 법제를 개정해야 한다는 제안입니다.
- AI 시스템을 도입하기 전과 크게 변경할 때마다 영향 평가를 의무화합니다. 평가에는 업무량, 웰빙, 평등, 접근성, 고용 안정, 역량, 훈련, 환경과 윤리적 영향이 포함되어야 합니다.
- 연결되지 않을 권리(Right to Disconnect)를 법제화합니다.
- AI가 실제로 생산성을 높인 경우, 고용주는 그 이익이 노동자에게 비례적으로 돌아가도록 해야 합니다. 보고서는 같은 임금에 근로 시간 단축, 유급 교육 휴가, 임금 인상을 예로 듭니다.
6. 모니터링, 성과 평가, 감시
생성형 AI 도구를 얼마나 쓰는지 또는 쓰지 않는지를 근거로 한 징계와 성과 평가 절차에서 노동자를 보호해야 한다는 제안입니다. 보고서는 이것이 HR 도구나 "스마트" 칸반처럼 AI 기능이 들어간 도구를 쓰는 것 자체와는 다른 문제라고 각주에서 구분합니다.
- AI 사용 데이터는 명확히 공개되고, 단체로 합의되고, 독립적으로 평가된 경우가 아니라면 징계, 승진, 정리해고, 성과 점수, 생산성 벤치마킹에 쓰여서는 안 됩니다. AI 사용을 압박하는 AI 리더보드, 토큰 순위, 사용량 대시보드도 여기에 포함됩니다.
- 고용주는 AI 관련 지표가 단순한 활동량, 비용, 분량, 속도가 아니라 유용하고 안전하며 품질 높은 작업을 측정한다는 것을 입증해야 합니다.
- AI를 충분히 쓰지 않았다는 이유로 노동자가 불이익을 받아서는 안 됩니다.
- 노동자가 데이터, 방법, 결과에 이의를 제기할 수 없는 불투명한 AI 기반 또는 AI 보조 성과 평가를 금지합니다.
7. 정리해고와 오프쇼어링으로부터의 보호
고용주가 AI 도입을 오프쇼어링(Offshoring)과 외주화의 편리한 구실로 쓰지 못하도록 정리해고 보호를 강화해야 한다는 제안입니다.
- 독립적인 근거, 협의, 교섭을 거친 안전장치 없이 AI 도입, 생산성 향상, 자동화 전망을 정리해고의 지름길로 쓰는 것을 허용하지 않습니다.
- 최소 협의 기간을 늘리고, 집단 해고 절차에서 "사업 단위(business unit)"의 정의를 고용주 전체로 확대해 정리해고 보호를 강화합니다.
- AI를 이유로 정리해고를 한 뒤 같은 업무를 다시 채용하거나, 외주화하거나, 재분배하는 고용주에게 더 강한 처벌을 도입합니다.
8. 협의, 투명성, 공개
고용주가 도입 결정에 노동자를 실질적으로 참여시키도록 강제해야 한다는 제안입니다.
- 어떤 업무 영역에서든 AI 도구를 도입, 확대, 의무화하거나 크게 변경하기 전에 노동자와 실질적으로 협의할 법적 의무를 도입합니다.
- 단체교섭이 있는 곳에서 고용주는 AI 도입과, 그것이 모니터링, 생산성 기대, 인력 수준, 직무 설계에 미치는 영향에 대해 교섭할 의무를 져야 합니다.
- 단체교섭이 없는 곳에서도 노동자는 불이익에 대한 합리적 우려가 있을 때 AI 시스템의 중단, 검토, 철회를 요청할 권리를 가지며, 규제 기관으로 문제를 제기할 수 있는 경로가 있어야 합니다.
- 고용주는 직장에서 쓰는 AI 시스템의 목적, 도입 이유, 수집하는 데이터, 데이터 접근 권한자, 보관 기간을 직원이 볼 수 있는 문서로 공개해야 합니다.
보고서를 읽을 때 함께 고려할 점과 시사점
보고서의 성격과 한계
이 보고서를 균형 있게 읽으려면 몇 가지를 함께 고려해야 합니다. 먼저 발행 주체가 노동조합이고, 조사도 조합원이 조합원을 인터뷰하는 방식으로 진행되었습니다. 보고서는 이를 숨기지 않고 오히려 방법론의 장점으로 내세우지만, 참여자 선정 과정에서 AI 도입에 비판적인 목소리가 더 많이 모였을 가능성은 배제하기 어렵습니다. 둘째로 참여자 수, 직군별 분포, 응답 비율 같은 정량 정보가 없어서 "대부분의 도입에서 협의가 없었다"와 같은 서술이 어느 정도의 비중을 말하는지 확인할 수 없습니다. 셋째로 도입부와 결론의 상당 부분은 조사 결과라기보다 빅테크와 AI 산업에 대한 노조의 정치적 입장입니다.
반대로, 보고서가 제기한 문제 중 상당수는 입장과 무관하게 검증할 수 있는 조직 운영의 문제입니다. AI 사용량을 성과 지표로 쓰는지, 그 지표가 품질을 측정하는지, AI가 만든 산출물의 검토 시간이 업무량 산정에 반영되는지, 주니어가 도구 없이 기초를 익힐 시간이 있는지는 어느 조직이든 스스로 확인할 수 있는 질문입니다.
AI를 도입하고 사용하는 개발 조직에 주는 시사점
보고서의 정책 제안은 영국의 법과 제도를 전제로 하지만, 개발 조직의 운영 관점에서 옮겨 볼 수 있는 내용이 많습니다.
-
지표를 먼저 점검합니다: 토큰 사용량이나 AI 도구 사용 빈도를 개인 성과와 연결하고 있다면, 그 지표가 결과물의 품질과 어떤 관계인지 설명할 수 있어야 합니다. 보고서의 증언처럼 사용량을 늘리라는 신호와 비용을 줄이라는 신호가 동시에 존재하면 구성원은 어느 쪽도 따를 수 없습니다.
-
검토 노동을 드러냅니다: AI가 생성한 코드와 문서의 리뷰, 디버깅, 수정 시간을 업무량과 일정 추정에 포함하지 않으면, 생산성 향상으로 보이는 숫자 뒤에 보이지 않는 초과 노동이 쌓입니다.
-
주니어의 학습 경로를 따로 설계합니다: 신입 개발자와 연구자가 도구 없이 문제를 풀고, 선배와 함께 코드를 읽고, 실수하며 배울 시간을 명시적으로 확보해야 합니다. 도구를 잘 쓰는 시니어의 경험만으로 도입 효과를 평가하면 이 비용이 보이지 않습니다.
-
도입 전에 현장 전문가에게 묻습니다: 보안 담당자의 경고가 무시되었다는 사례처럼, 도구 도입 결정에서 실제로 그 결과를 감당할 사람의 의견을 듣는 절차가 필요합니다.
-
선택권을 남겨 둡니다: 보고서가 모든 증언의 결론으로 제시한 것은 AI를 쓸지, 어떻게 쓸지 스스로 선택할 수 있을 때 AI가 유용하다는 점입니다. 사용을 강제하는 대신 결과로 평가하는 편이 도구의 실제 효용도 더 정확히 드러냅니다.
AI 도구를 만드는 쪽에 있는 ML 엔지니어에게도 이 보고서는 참고가 됩니다. 사용량 대시보드, LLM 기반 평가기, 에이전트 워크플로우처럼 보고서에서 문제로 지목된 기능은 결국 누군가 설계하고 구현한 것이기 때문입니다. 보고서가 AI를 만들고 배포하는 노동자에게 권한을 요구하는 이유도, 이런 기능이 조직 안에서 어떻게 쓰일지를 가장 먼저 알 수 있는 사람이 그들이기 때문입니다.
 AI Workers' Inquiry 2026 웹 페이지
AI Workers' Inquiry 2026 보고서 PDF 파일
 UTAW(United Tech & Allied Workers) 홈페이지
TUC Congress 2026 동의안 C13: Artificial Intelligence at work
더 읽어보기
-
Doctorow, C. (2026) The Reverse Centaur's Guide to Life After AI (Verso)
-
ILO (2026) The impact of GenAI on jobs, productivity and work organization
-
Anthropic 81k Interviews: 159개국, 70개 언어 사용자 80,508명이 말하는 ‘AI가 가져올 미래와 우려사항’
-
Anthropic Economic Index: Claude 사용에 새겨진 일상의 리듬과 노동자들의 AI 인식에 대한 연구
-
AI가 노동 시장에 미치는 영향: 새로운 측정 지표 '관측된 노출도'와 초기 증거 (feat. Anthropic)
-
'코딩 실력보다 도메인 전문성', Anthropic이 Claude Code 세션 40만 건으로 분석한 연구 보고서
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
