핵심 요약
- Ai2(AllenAI)가 연구 질문과 검색된 논문 발췌문을 받아 인용이 달린 문헌 보고서를 한 번에 쓰는 8B 모델 AstaBrief를 Apache 2.0으로 공개했습니다. Qwen3-8B에 SFT와 DPO만 적용했고, 학습 데이터(SFT 39.5K건, DPO 6.6K건)는 CC BY-NC 4.0입니다.
- Asta의 보고서 생성 기능에 Fast 모드로 들어가 있으며, 검색까지 포함한 전체 파이프라인 기준 보고서당 평균 51.1초로 Claude 기반 Thinking 모드(178.5초)보다 약 3.5배 빠릅니다.
- Ai2의 자체 벤치마크 SQABench-CS2에서는 Thinking 모드, DR Tulu와 비슷한 점수였지만, 외부 벤치마크 DeepScholarBench에서는 세 시스템 중 평균이 가장 낮았고 인용 정밀도도 45로 가장 낮았습니다(DR Tulu 63, Thinking 모드 61).
- 학습 단계에서 영어가 아닌 질의를 걸러냈고 모델 카드의 언어도 영어뿐이라, 한국어 질의와 한국어 문헌에서의 동작은 검증되지 않았습니다.
- 모델 카드의 추론(inference) 예제는 SFT 체크포인트를 불러오고 vLLM에 없는 호출 방식을 쓰고 있어, 그대로 복사하면 최종 모델이 아닌 SFT 모델을 내려받은 뒤 생성 호출에서 오류가 납니다.

AstaBrief 소개
AstaBrief는 Ai2(Allen Institute for AI)가 공개한 80억(8B) 파라미터 언어 모델로, 연구 질문과 미리 검색해 둔 논문 발췌문을 입력받아 문장마다 출처가 붙은 문헌 종합 보고서를 한 번의 생성으로 써냅니다. 검색은 모델 밖의 파이프라인이 맡고, 모델은 주어진 근거를 바탕으로 여러 절로 된 보고서를 구성하는 역할에 특화되어 있습니다.
이 모델이 나온 배경은 Ai2의 과학 연구용 에이전트 플랫폼 Asta에 있습니다. Asta의 Generate a report 기능은 그동안 Claude 기반의 다단계 파이프라인(현재의 Thinking 모드)으로 보고서를 만들어 왔습니다. Ai2에 따르면 Asta 사용자들은 짧은 키워드 대신 특정 방법론, 모집단, 실험 환경 같은 조건을 길게 붙여 질문하는 경우가 많고, 생성된 보고서를 일회성 답변이 아니라 나중에 다시 꺼내 보는 작업 자료로 다룹니다. 그만큼 보고서 품질과 인용의 정확성이 중요하지만, 상용 모델 API에 의존하는 다단계 파이프라인은 느리고 비용이 큽니다.
그래서 Ai2는 "과학 보고서 생성에 특화해 학습한 작은 오픈 모델이 당시 쓰던 상용 모델의 보고서 품질을 따라잡으면서 생성 시간과 서빙 비용을 줄일 수 있는가"를 실험했고, 그 결과물이 AstaBrief입니다. 지금은 Asta의 보고서 생성 기능에서 Claude 기반 Thinking 모드와 나란히 Fast 모드 로 제공되고 있습니다. 가중치가 공개되어 있으므로, 아직 출판하지 않은 연구나 민감한 주제를 다루는 기관이 외부 API로 질의를 보내지 않고 자체 인프라에서 돌릴 수 있다는 점도 Ai2가 강조하는 공개 이유입니다.
한 가지 짚어 둘 점은 원문이 스스로 밝힌 시점의 한계입니다. 학습과 평가의 대부분은 2025년에 끝났고, 학습 데이터 생성과 비교 대상에 쓴 상용 모델도 당시의 최상위 모델입니다. Ai2는 현재의 최신 모델을 상대로 전체 평가를 다시 돌리지 않았다고 밝히며, 아래 결과를 "특정 학습 및 시스템 설계 선택에 대한 근거"로 읽어 달라고 적고 있습니다. 이 글도 같은 관점에서 학습 레시피와 평가 결과를 정리하고, 모델 카드와 공개 데이터셋, 예제 코드를 직접 열어 본 내용을 덧붙입니다.
다단계 파이프라인을 한 번의 생성으로: Fast 모드의 구조
Thinking 모드의 바탕은 Ai2의 Ai2 Scholar QA(ScholarQA) 파이프라인입니다. 저장소 README에 따르면 ScholarQA는 Semantic Scholar API의 스니펫 검색으로 논문 본문 조각을 가져와 리랭커로 추린 뒤, 생성 단계를 세 번에 나눠 처리합니다. 먼저 질문에 답하는 데 필요한 인용구를 원문 그대로 추출하고, 보고서 개요를 만들어 인용구를 절마다 배정한 다음, 앞서 쓴 절을 참고하며 절마다 따로 본문을 씁니다. README 기준 기본 생성 모델은 Claude 3.7 Sonnet이고, 각 단계가 모두 대형 모델 호출이므로 보고서 하나에 여러 번의 긴 호출이 쌓입니다.
AstaBrief는 이 중 인용구 요약과 절 단위 묶기를 건너뜁니다. 사용자 질의와 검색된 스니펫을 그대로 받아 최종 보고서 전체를 한 번의 생성(one pass) 으로 쓰도록 학습했습니다. Ai2는 이렇게 단계를 줄이고도 성능을 희생하지 않았다는 점을 흥미로운 발견으로 꼽습니다. 원문이 예제 워크플로로 링크한 저장소의 scholarqa/lite 모듈을 보면, 검색 결과를 논문별 참고문헌 사전으로 정리해 프롬프트를 만들고 모델을 한 번 호출해 보고서를 받은 뒤, 절 제목을 추출해 보고서 제목만 같은 모델로 한 번 더 생성하는 구조입니다.
속도 개선 수치는 두 가지가 나오므로 구분해서 읽어야 합니다. 원문은 보고서 생성 시간이 Ai2가 추적한 상용 모델 대비 "10배 가까이(nearly an order-of-magnitude)" 줄었다고 씁니다. 측정 범위는 따로 밝히지 않았지만, 바로 이어서 전체 파이프라인 수치를 별도로 제시하므로 생성 단계만 놓고 본 표현으로 읽힙니다. 검색과 후처리까지 포함한 Asta 전체 파이프라인 기준으로는 Fast 모드가 보고서당 평균 51.1초, Thinking 모드가 178.5초로 약 3.5배 차이입니다. 사용자가 체감하는 시간은 후자에 가깝습니다.
모델이 학습한 입력과 출력 형식
AstaBrief는 학습에 쓴 프롬프트를 그대로 써야 제대로 동작한다고 모델 카드가 안내합니다. 이 프롬프트는 질의를 [QUERY] 자리에, 참고문헌을 [SECTION_REFERENCES] 자리에 넣는 템플릿입니다. 참고문헌은 "[ID]": "인용구" 형태의 키와 값 목록이고, 모델은 본문 문장 뒤에 [ID]를 붙여 출처를 표시합니다. 출력은 절마다 SECTION; 표식과 절 이름, 두 문장짜리 TLDR;, 본문 순서로 구성됩니다. 인용 규칙 부분은 다음과 같습니다.
- Please write the answer, making sure to cite the relevant references inline using the corresponding reference key in the format: [ID]. You may use more than one reference key in a row if it's appropriate. In general, use all of the references that support your written text.

- You can add something from your own knowledge. This should only be done if you are sure about its truth and/or if there is not enough information in the references to answer the user's question. Cite the text from your knowledge as (LLM Memory). The citation should follow AFTER the text. Don't cite LLM Memory with another evidence source.
두 번째 규칙이 실사용에서 중요합니다. 이 프롬프트는 근거가 부족할 때 모델이 자기 지식으로 문장을 보태고 (LLM Memory)라고 표시하는 것을 허용합니다. 즉 AstaBrief 보고서의 모든 문장이 검색된 논문에 근거하는 것은 아니며, 출력을 검토할 때 (LLM Memory) 표시가 붙은 문장은 따로 확인해야 합니다. 같은 프롬프트에는 "Note that the current year is 2025."라는 문장도 고정되어 있어, 최신 연구를 다룰 때 연도 판단이 어긋날 여지가 있습니다.
학습 레시피: 강화학습 대신 SFT와 DPO, 그리고 데이터 품질
AstaBrief는 Qwen3-8B에서 출발해 지도 미세조정(Supervised Fine-Tuning, SFT) 과 직접 선호 최적화(Direct Preference Optimization, DPO) 두 단계만 거쳤습니다. Ai2는 앞서 공개한 DR Tulu에서 심판 모델을 학습 루프에 넣은 강화학습(Reinforcement Learning, RL)으로 긴 보고서 생성 품질을 끌어올린 바 있습니다. AstaBrief에서도 그 경로를 검토했지만, RL 기반 학습은 불안정하고 비용이 크다는 이유로 더 단순한 레시피를 택했습니다. 대신 복잡한 최적화로 잡음 섞인 데이터를 보정하기보다, 원하는 보고서 작성 행동을 실제로 보여 주는 예제를 고르고 걸러내는 데 프로젝트 시간 대부분을 썼다고 설명합니다. 범용 모델을 과학 작업에 맞게 고치는 이런 작업은 Ai2가 주도하는 미국 국가 과제 NSF OMAI(Open Multimodal AI Infrastructure to Accelerate Science, 미국 국립과학재단(NSF) 지원으로 과학 발견을 위한 완전 공개 AI 인프라와 모델을 만드는 과제)의 일환으로도 진행되고 있습니다.

 DPO와 사후 학습 전반에 대해서는 다음 글(RLHF Book)을 참고해주세요:
실제 연구자 질의 9만 건에서 시작한 SFT 데이터
학습 데이터의 출발점은 합성 프롬프트나 벤치마크형 과제가 아니라 Ai2의 OpenScholar와 Asta ScholarQA에 실제 사용자가 입력한 질의입니다. SFT 데이터셋 카드에 따르면 2025년 6월까지의 질의 중 데이터 공유에 동의한 사용자의 것만 썼습니다. 베타 테스터와 봇 트래픽, 지나치게 짧은 질의를 먼저 지우고, 이어서 GPT-4o로 영어가 아닌 질의, 과학이나 인문학 연구 주제가 아닌 요청, 개인 의료 정보가 담긴 프롬프트를 걸러냈습니다. 다만 공개된 필터 프롬프트에는 앞의 두 기준만 적혀 있습니다. 그 결과 약 9만 건의 연구 질의가 남았습니다.
Ai2가 이렇게 실제 질의에 공을 들인 이유는 연구자의 질문 방식이 일반 챗봇 사용자와 다르기 때문입니다. Ai2가 Asta 질의 25만 8천여 건을 분석한 이전 연구에서 전문 연구자들은 짧은 키워드 대신 상당한 맥락과 여러 제약 조건, 개념 사이의 관계를 함께 제시하는 경향을 보였습니다. 이후의 사용자 연구에서도 연구자들은 출처 추적이 명확하고, 모델이 무엇을 하는지 보이며, 모델이 쓰는 맥락을 직접 통제할 수 있기를 원했다고 합니다.
정답 보고서는 필터링된 질의를 다단계 ScholarQA 파이프라인에 넣어 만들었습니다. 파이프라인의 생성 모델로는 Claude 3.5 Sonnet, Claude 3.7 Sonnet, o3, o4-mini, GPT-4.1을 섞어 썼고, 품질 필터링을 거쳐 4만 7천 건의 학습 예제를 얻었습니다. 이 글의 관점에서 보면 AstaBrief는 상용 모델이 다단계로 만든 보고서를 단일 패스로 재현하도록 배운 증류(distillation) 에 가까운 구조입니다.
인용 밀도 필터 하나가 가장 효과적이었다
첫 SFT 실험은 전반적인 내용 품질을 올렸지만, 답변 정밀도와 인용 품질에서 여전히 Claude 기반 파이프라인에 못 미쳤습니다. 보고서를 쓰는 능력은 좋아졌지만, 과학 문헌 종합에 필요한 만큼 일관되게 근거에 기반하지는 못했던 것입니다. 그래서 Ai2는 약한 합성 예제를 골라내기 위한 통계 기반 필터 네 가지를 시험했습니다.
- 출력 대 입력 토큰 비율(Output-to-input token ratio): 비율이 매우 높은 답변은 적은 근거로 많은 텍스트를 만들어 내는 경우가 많아 잡음이 컸습니다.
- 인용 관련도(Citation relevance): 보고서가 인용한 논문들의 검색 관련도 점수 평균입니다. 평균이 낮으면 하위 순위의 근거에 과하게 기댄 보고서로 봤습니다.
- 인용 밀도(Citation density): 인용이 하나 이상 붙은 문장의 비율입니다. 밀도가 낮은 보고서에는 근거 없는 긴 구간이 많았습니다.
- 인용 다양성(Citation diversity): 검색 파이프라인이 돌려준 논문 중 실제로 인용한 논문의 비율입니다. 낮으면 소수 논문에 과하게 의존한 보고서로 봤습니다.
가장 큰 개선은 인용 밀도가 낮은 합성 보고서를 지웠을 때 나왔습니다. 데이터셋 카드에 따르면 기준은 밀도 0.25 미만이었고, 이 필터로 4만 7천 건이 3만 9,500건으로 줄었습니다. 반면 더 공격적인 필터링, 필터 조합, 학습률 탐색은 의미 있는 추가 개선을 주지 못했습니다. Ai2는 이를 프로젝트의 가장 분명한 교훈으로 꼽으며, 과학 분야 특화가 반드시 사전 학습에 과학 텍스트를 더 넣는 문제는 아니고 사후 학습 데이터가 근거 제시와 출처 표시 같은 행동을 보여 주는지가 모델 성능을 실질적으로 바꿀 수 있다고 정리합니다.
이 효과는 모델 카드의 단계별 점수에서도 확인됩니다. SQABench-CS2 테스트 세트(모델 카드 기준 100문항)에서 기반 모델, SFT 체크포인트, 최종 DPO 모델을 비교하면 다음과 같습니다.
| 모델 | 평균 | 필수 내용 재현율 | 답변 정밀도 | 인용 정밀도 | 인용 재현율 |
|---|---|---|---|---|---|
| Qwen3-8B (기반 모델) | 77.3 | 77.8 | 90.6 | 76.2 | 64.6 |
| AstaBrief-8B-SFT | 83.7 | 85.2 | 90.4 | 87.7 | 71.3 |
| AstaBrief-8B (SFT + DPO) | 87.0 | 90.2 | 89.0 | 90.5 | 78.2 |
인용 정밀도가 SFT 단계에서 76.2에서 87.7로 가장 크게 올랐고, DPO는 필수 내용 재현율과 인용 재현율을 추가로 끌어올렸습니다. 답변 정밀도는 세 모델이 거의 같거나 오히려 조금 내려갔습니다.
두 심판이 합의한 쌍만 남긴 DPO 데이터
DPO에는 질의 하나에 보고서 두 개와 어느 쪽이 나은지에 대한 판정이 필요합니다. Ai2는 SFT 데이터 생성에 쓰지 않은 별도의 질의(데이터셋 카드 기준 1만 2천 건)로 쌍을 만들었습니다. 한쪽은 기존 ScholarQA 파이프라인의 보고서이고, 다른 쪽은 ScholarQA가 검색한 같은 발췌문을 다른 모델에 한 번에 넣어 만든 보고서입니다. 이 두 보고서를 GPT-4.1과 DeepSeek-R1 두 심판 모델이 완결성, 관련성, 인용, 구성 등을 묻는 비교 프롬프트로 각각 비교했고, 두 심판의 판정이 일치한 쌍만 남겼습니다. Ai2는 이 LLM 심판들이 사람의 선호와 95% 일치함을 확인했다고 밝혔으며, 최종 DPO 데이터는 6,622건입니다.
공개된 DPO 데이터의 chosen_model과 rejected_model 열을 Hugging Face 데이터셋 통계로 집계해 보면 흥미로운 점이 보입니다(전체 6,622행 기준).
| 보고서 생성 방식 | 선택됨 | 거부됨 | 선택 비율 |
|---|---|---|---|
ScholarQA 다단계 파이프라인 (sqa+claude37) |
3,404 | 3,216 | 51% |
o3 단일 패스 (llm-only_o3-*) |
1,998 | 181 | 92% |
| o4-mini 단일 패스 | 684 | 1,415 | 33% |
| DeepSeek-V3 단일 패스 | 534 | 1,810 | 23% |
선택 쪽 생성 방식이 unknown인 2행은 표에서 뺐습니다. Claude 기반 다단계 파이프라인의 보고서가 언제나 정답 쪽에 놓인 것이 아니라 절반 정도만 선택되었고, 같은 근거를 한 번에 받은 o3 보고서는 대부분 선택되었습니다. 원문의 "단계를 줄여도 성능을 희생하지 않았다"는 관찰과 같은 방향의 신호로 볼 수 있지만, 이는 이 글의 해석이며 원문이 직접 제시한 분석은 아닙니다. 또한 원문은 경쟁 보고서 생성 모델로 DeepSeek-R1도 꼽지만, 공개 데이터의 생성 모델 표기에는 R1이 나타나지 않습니다.
데이터를 다룰 때 참고할 실무 정보도 있습니다. DPO 데이터 프롬프트는 검색 발췌문이 통째로 들어가 평균 약 7만 7천 자, 최대 약 26만 자에 이릅니다. 학습 설정은 두 모델 카드에 다음과 같이 공개되어 있으며, 두 단계 모두 open-instruct로 H100 8장에서 학습했습니다.
| 하이퍼파라미터 | SFT | DPO |
|---|---|---|
| 에폭 | 5 | 7 |
| 학습률 / 스케줄러 | 5e-6 / Linear | 5e-6 / Linear |
| 워밍업 비율 | 0.03 | 0.1 |
| 장치당 배치 / 그래디언트 누적 | 1 / 4 | 1 / 8 |
| 최대 시퀀스 길이 | 32,768 | 16,000 |
| 기타 | BF16 | BF16, DPO Norm 손실, beta 10 |
평가 결과: 자체 벤치마크에선 근접, 외부 벤치마크에선 격차
Ai2의 주 평가 대상은 사용자가 직접 쓴 컴퓨터 과학 연구 질문으로 이루어진 SQABench-CS2(모델 카드 표기 ScholarQA-CS2)입니다. 원문은 200문항이라고 쓰고, 그래프는 개발에 쓴 dev 분할과 테스트 분할을 나눠 보여 줍니다. 개발 내내 추적한 지표는 네 가지입니다.
- 루브릭 점수(Rubric score): 보고서가 필요한 내용을 얼마나 담았는지 측정합니다. 그래프에서는 필수 내용 재현율(Ingredient recall)로 표기됩니다.
- 답변 정밀도(Answer precision): 각 문단이 질문과 관련 있는지 측정합니다.
- 인용 정밀도(Citation precision): 각 인용이 그것이 붙은 주장을 실제로 뒷받침하는지 측정합니다.
- 인용 재현율(Citation recall): 보고서의 주장이 제시된 인용으로 완전히 뒷받침되는지 측정합니다.
비교 대상은 Claude 기반 Thinking 모드와, RL로 학습한 Ai2의 8B 딥리서치 모델 DR Tulu입니다. 아래 그래프는 SQABench-CS2의 결과입니다.
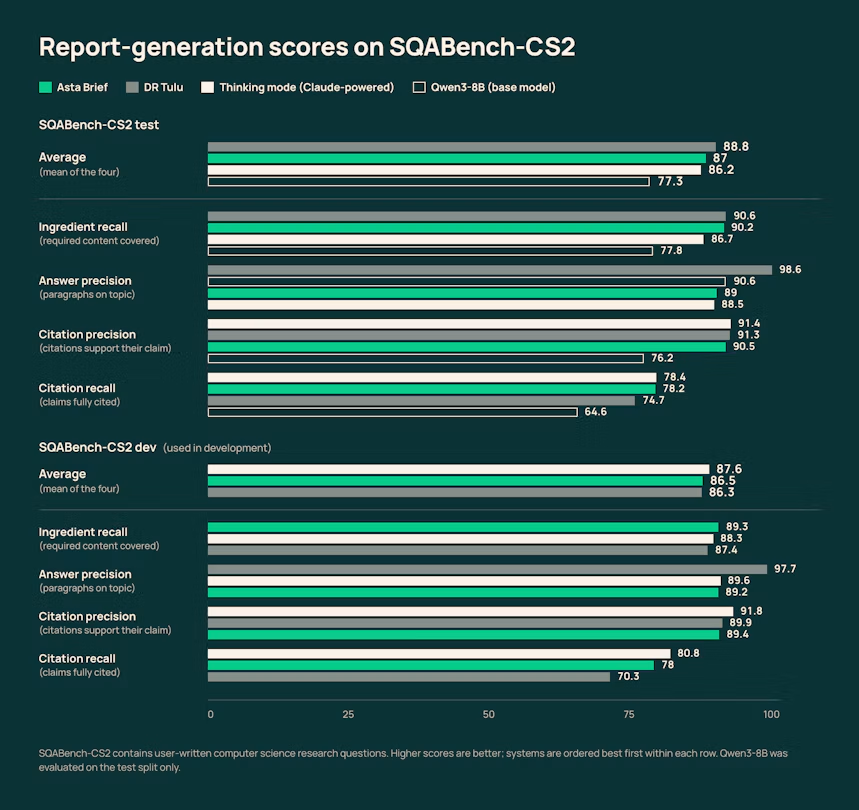
테스트 분할 평균은 DR Tulu 88.8, AstaBrief 87.0, Thinking 모드 86.2, 기반 모델 Qwen3-8B 77.3입니다. AstaBrief가 테스트 분할에서 1위를 한 세부 지표는 없습니다. 1위와의 차이는 필수 내용 재현율 0.4점, 인용 정밀도 0.9점, 인용 재현율 0.2점으로 작지만, 답변 정밀도는 DR Tulu 98.6 대 89.0으로 9.6점 차이가 납니다. dev 분할 평균은 Thinking 모드 87.6, AstaBrief 86.5, DR Tulu 86.3입니다.
여기서 모델 카드와 그래프가 어긋나는 곳이 하나 있습니다. 모델 카드의 비교 표는 dev 평균을 DR-Tulu 86.5, AstaBrief 86.3으로 적고 있지만, 그래프의 세부 지표로 평균을 다시 계산하면 AstaBrief는 (89.3 + 89.2 + 89.4 + 78.0) / 4 = 86.475, DR Tulu는 (87.4 + 97.7 + 89.9 + 70.3) / 4 = 86.325입니다. 그래프 쪽이 맞고 모델 카드 표의 두 값이 서로 뒤바뀐 것으로 보입니다. 차이가 0.2점이라 결론을 바꾸지는 않지만, 모델 카드 표를 인용할 때는 주의가 필요합니다.
외부 벤치마크 DeepScholarBench에서는 인용 지표가 가장 낮았다
최종 모델에 대해서는 개발 과정에 쓰지 않은(held-out) 보조 평가도 돌렸습니다. DeepScholarBench는 Stanford와 UC Berkeley 연구진(Liana Patel, Ion Stoica, Matei Zaharia, Carlos Guestrin 등)이 만든 벤치마크로, 최근 arXiv 논문 63편을 골라 각 논문의 관련 연구(related work) 절을 선행 연구 검색과 인용을 거쳐 다시 쓰게 합니다. 질문에 답하는 SQABench-CS2와 과제 형식부터 다르고 지표 체계도 달라 두 점수를 직접 비교할 수는 없습니다. 원 벤치마크에는 참고문헌 포괄(Reference Coverage) 같은 검색 품질 지표도 있지만, Ai2 그래프에는 종합과 검증 가능성 쪽 네 지표만 실려 있습니다.
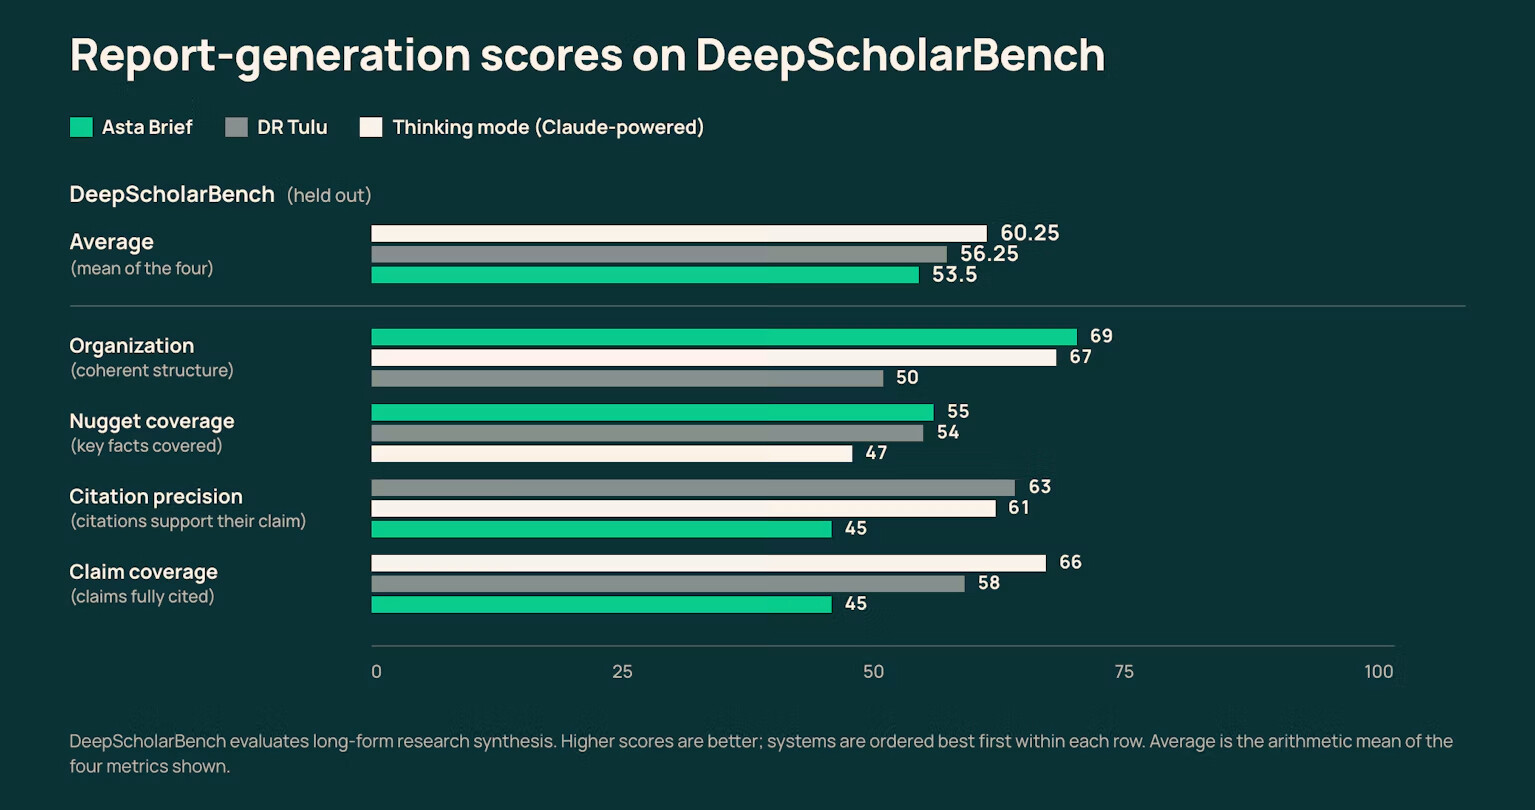
결과는 SQABench-CS2와 다른 그림입니다. AstaBrief는 구성(Organization) 69, 핵심 사실 포괄(Nugget coverage) 55로 두 지표에서 1위였지만, 인용 정밀도 45(DR Tulu 63, Thinking 모드 61)와 주장 포괄(Claim coverage) 45(Thinking 모드 66, DR Tulu 58)에서 가장 낮았고, 네 지표 평균도 53.5로 세 시스템 중 가장 낮았습니다(Thinking 모드 60.25, DR Tulu 56.25). 원문 본문은 이 결과를 따로 해설하지 않지만, 인용 품질을 개선한 레시피가 핵심 메시지인 만큼 독자가 가장 먼저 확인해야 할 그래프입니다. 개발에 쓴 벤치마크에서는 인용 지표가 상위권과 비슷했는데 처음 보는 벤치마크에서는 인용 지표가 가장 크게 떨어졌다는 점에서, 과제 형식의 차이를 감안하더라도 인용 품질 개선이 다른 질의 분포로 얼마나 일반화되는지는 아직 열린 질문입니다. 자체 벤치마크와 외부 벤치마크의 순위가 갈리는 현상 일반에 대해서는 벤치마크를 믿기 어려운 이유 - 홈 어드밴티지에서 다룬 바 있습니다.
쌍대 비교 승률과 소규모 인간 평가
마지막으로 같은 질문에 대한 보고서를 Thinking 모드의 보고서와 짝지어 LLM 심판이 승패를 가린 쌍대 비교(pairwise comparison) 결과입니다. 50%가 Thinking 모드와 동률을 뜻합니다.
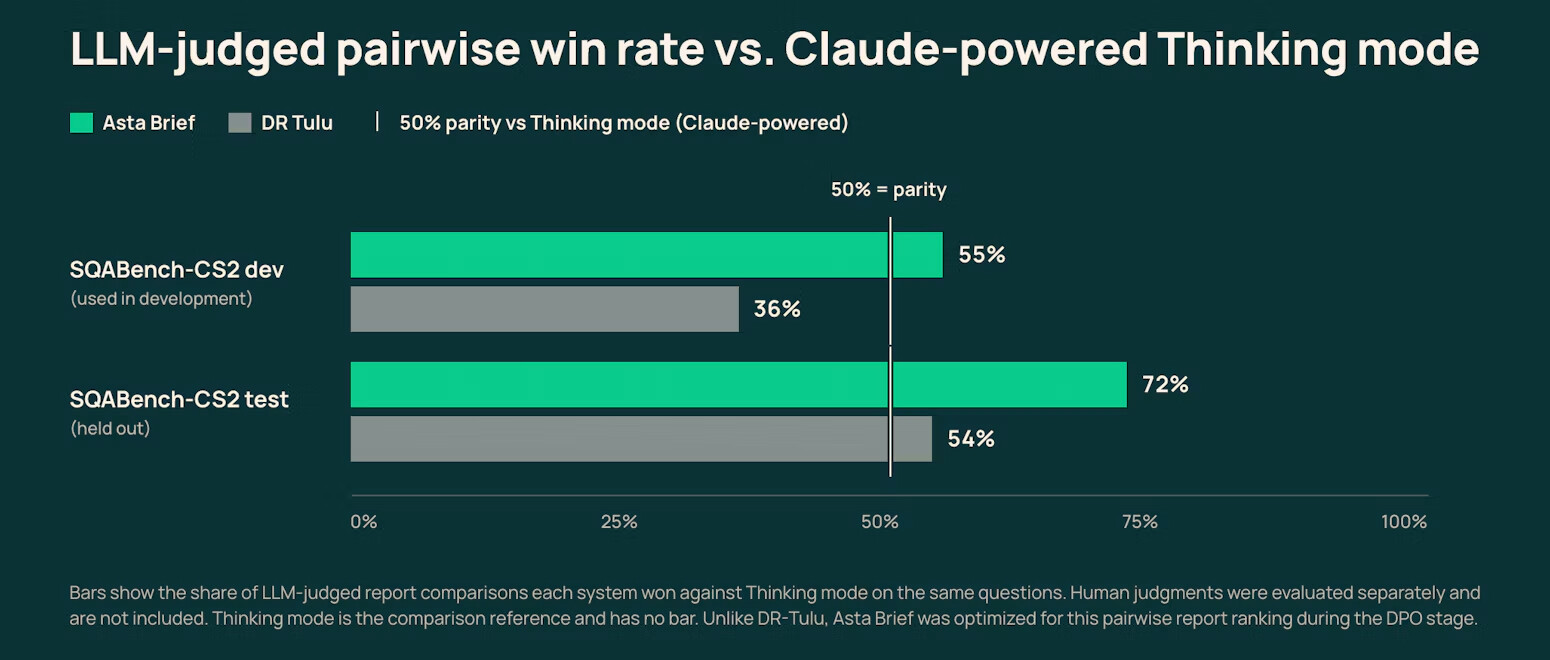
AstaBrief는 dev 분할에서 55%, 테스트 분할에서 72%로 Thinking 모드를 앞섰고, DR Tulu는 각각 36%와 54%였습니다. 다만 그래프 캡션에 적힌 대로 AstaBrief는 DPO 단계에서 바로 이런 쌍대 보고서 순위에 맞춰 최적화되었고 DR Tulu는 그렇지 않습니다. 평가에 쓴 심판 모델이 무엇인지는 원문에 나오지 않습니다. 따라서 이 승률에는 학습 목표와 평가 방식이 겹치는 효과가 섞여 있다고 보는 편이 안전합니다. Ai2가 같은 벤치마크로 진행한 메타 평가 연구 Deep Research, Shallow Evaluation도 쌍대 선호 순위는 시스템 수준 비교에 적합하고, 지표 수준의 판단에는 지표별 명시적 주석과 전문가 주석자가 필요하다고 결론 내립니다.
사람이 직접 판단한 평가는 규모가 작습니다. 연구자 3명이 각자 4~5개씩 낸 14개 질문에 대해 세 시스템의 보고서를 전반적 선호, 완결성, 관련성, 구성, 인용 정확도 기준으로 순위를 매겼습니다(동순위 허용). 전반적 선호에서는 DR Tulu가 이겼고, 인용 정확도에서는 3명 중 2명이 AstaBrief를 가장 선호했습니다. Ai2는 이를 SFT 데이터 품질 필터의 효용을 보여 주는 결과로 해석합니다.
원문의 결론은 이 수치들이 "개발 당시의 엔지니어링 접근을 검증한 것"이지 현재 최신 모델과 비교한 이 기반 모델의 위치를 주장하는 것은 아니라는 것입니다. 일반화될 것으로 기대하는 부분은 데이터 구성, 출처 표시 필터링, 서빙에서 얻은 교훈이라고 덧붙입니다.
Asta에서의 초기 사용 지표
Ai2는 Asta에서 Fast 모드의 초기 사용 데이터도 공개했습니다. Fast 모드를 써 본 Asta 사용자는 374명이고, 이 중 29.1%가 이틀 이상 사용했으며 사용자당 평균 3.67개의 보고서 스레드를 만들었습니다. Fast 모드를 써 본 사용자의 23%는 이후 Thinking 모드로 돌아가지 않았고, 18%는 목적에 따라 두 모드를 오가며 스레드의 약 40%에 Fast 모드를 썼습니다. 긍정 피드백 비율은 Fast 모드 84.2%, Thinking 모드 85.2%로 비슷했지만, Ai2 스스로 피드백이 드물어 강한 결론을 내리기 어렵다고 밝힙니다.
인용이 맞아도 주장은 부풀 수 있다: 원문이 짚은 평가의 빈칸
원문에서 평가 방법론에 관해 가장 중요한 대목은 인용 지표의 한계를 인정한 부분입니다. 보고서는 그럴듯하고 완결된 것처럼 보이면서도 질문에서 벗어나거나, 근거가 뒷받침하지 않는 주장에 인용을 붙일 수 있습니다. 그런데 인용이 맞는 연구를 가리켜도, 문장이 그 연구가 실제로 보인 것보다 강한 주장을 할 수 있습니다. Ai2가 인용한 Peters와 Chin-Yee의 2025년 연구(Generalization bias in large language model summarization of scientific research)가 다룬 일반화 편향(generalization bias) 이 그 예입니다. 이 연구는 LLM 10종이 만든 과학 논문 요약 4,900건을 원문과 비교해, 정확하게 요약하라고 지시해도 대부분의 모델이 원문보다 넓게 일반화했고 LLM 요약이 사람이 쓴 요약보다 넓은 일반화를 담을 가능성이 약 5배(오즈비 4.85)라고 보고했습니다. 이 연구가 분류한 일반화 유형은 다음 세 가지입니다.
- 특정 표본에서 얻은 결과를 모집단 전체에 대한 일반 주장으로 바꾸는 경우
- 과거 시제로 보고된 결과를 보편적 사실처럼 들리는 현재 시제 문장으로 바꾸는 경우
- 기술적(descriptive) 발견을 임상의, 정책 결정자, 연구자가 해야 할 일에 대한 권고로 바꾸는 경우
각 단계는 명백히 틀린 문장을 만들지 않으면서 근거의 범위를 조금씩 넓히기 때문에, 인용이 붙은 문장이 출처와 관련은 있되 연구 결과를 과장하는 상태가 됩니다. Ai2는 AstaBrief 개발에 쓴 지표가 관련성, 포괄성, 인용 근거에 집중했고 이런 범위 보존은 측정하지 않았다고 밝힙니다. 앞으로의 과제로는 더 세밀한 선호 학습, RAG와 RL을 결합한 접근, 다중 턴과 다중 도구 능력, 추가 과학 데이터 소스, 질의 분해를 꼽았고, 인용 여부를 넘어 출처의 증거 범위를 보존하는지와 간결성, 구성까지 보는 평가에 관심이 있다고 적었습니다. Ai2는 AstaBrief를 ScholarQA와 DR Tulu에서 앞으로의 Olmo 버전으로 이어지는 과학용 언어 모델 연구의 한 실험으로 자리매김하며, 학습 데이터, 필터링, 평가에서 얻은 교훈을 다음 모델에 반영하겠다고 밝혔습니다.
모든 주장을 증거에 연결하는 다른 접근으로는 다음 글(ScientistOne)을 참고해주세요:
직접 써 보려면: 모델 카드 예제와 로컬 워크플로에서 확인할 것
AstaBrief 8B는 Qwen3ForCausalLM 구조(36층, BF16, 최대 위치 임베딩 40,960)이고, 저장소에는 safetensors 샤드 4개(약 16.4GB)와 같은 크기의 .bin 샤드 4개가 함께 올라가 있습니다. 내려받을 때 allow_patterns로 safetensors만 받으면 두 배 용량을 피할 수 있습니다.
모델 카드의 추론 예제는 그대로 쓰면 안 됩니다
2026년 10월 3일 기준으로 AstaBrief_8B 모델 카드의 추론 예제에는 세 가지 문제가 있습니다.
model_name = "allenai/AstaBrief_8B_SFT"로 되어 있어 최종 DPO 모델이 아니라 중간 SFT 체크포인트를 불러옵니다. SFT 모델 카드의 예제를 그대로 복사한 것으로 보입니다.outputs = llm(text, sampling_params)로 호출하는데, vLLM의LLM클래스와 상속 믹스인에는__call__메서드가 없습니다(vLLM main 브랜치 소스 기준). 생성은llm.generate()로 호출해야 합니다.- 토크나이저만 필요한데
AutoModelForCausalLM.from_pretrained()로 전체 모델을 GPU에 올린 뒤 vLLM으로 같은 모델을 한 번 더 올립니다.
아래는 이 세 가지만 고친 형태입니다. vLLM의 공개 API에 맞춰 정리한 것이며, 이 글에서 직접 실행해 보지는 않았습니다. formatted_sft_prompt는 앞서 본 SFT 프롬프트의 [QUERY]와 [SECTION_REFERENCES]를 채운 문자열입니다.
from transformers import AutoTokenizer
from vllm import LLM, SamplingParams

model_name = "allenai/AstaBrief_8B"
tokenizer = AutoTokenizer.from_pretrained(model_name)

# formatted_sft_prompt: sft_prompt.txt with [QUERY] and [SECTION_REFERENCES] filled in
messages = [{"role": "user", "content": formatted_sft_prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)

llm = LLM(model=model_name)
sampling_params = SamplingParams(
    temperature=0.7,
    top_p=0.95,
    max_tokens=4096,
    stop_token_ids=[tokenizer.eos_token_id],
)
outputs = llm.generate([text], sampling_params)
print(outputs[0].outputs[0].text.strip())
"내 PDF로 보고서 만들기" 예제의 실제 범위
원문은 모델과 함께 "연구자가 자신의 PDF로 보고서를 만들도록 고칠 수 있는 예제 워크플로"를 공개했다고 소개하며 scholarqa/lite 디렉터리를 링크합니다. 2026년 10월 3일 기준 main 브랜치에서 이 디렉터리는 파이썬 파일 4개(scholar_qa_lite.py, prompt_utils.py, response_parser.py, __init__.py)로 이루어져 있고, 별도 README나 PDF 처리 코드는 없습니다. ScholarQALite는 기존 ScholarQA 클래스를 상속해 보고서 생성 단계만 단일 호출로 바꾼 것이라, 검색은 기본적으로 Semantic Scholar API를 쓰는 FullTextRetriever가 맡고 S2_API_KEY가 필요합니다.
따라서 자기 PDF로 쓰려면 PDF를 텍스트로 바꾸고, 저장소의 AbstractRetriever 인터페이스(retrieve_passages, retrieve_additional_papers)를 직접 구현해 그 텍스트를 검색하도록 연결하는 작업이 필요합니다. PDF 변환에는 같은 Ai2의 olmOCR을 쓸 수 있겠지만, 이는 이 글의 제안이며 원문이 제시한 구성은 아닙니다. 로컬 문서 기반 딥리서치 도구를 찾고 있다면 DeepDoc이나 Local Deep Research 같은 기존 프로젝트와 비교해 보는 것도 방법입니다.
한국어 사용자가 알아 둘 점
학습 질의를 고르는 단계에서 영어가 아닌 질의는 물론 영어와 다른 언어를 섞어 쓴(code-mixed) 질의도 GPT-4o 필터로 제거되었고, 모델 카드와 두 데이터셋 카드의 언어 필드도 모두 en입니다. 기반 모델인 Qwen3-8B는 다국어를 지원하지만, AstaBrief가 한국어 질의나 한국어 논문 발췌문으로 보고서를 쓸 때의 품질은 원문 어디에서도 평가되지 않았습니다. 한국어 환경에서 쓰려면 영어 질의와 영어 문헌으로 시작하거나, 자체 평가를 먼저 해 보는 것이 안전합니다.
라이선스
AstaBrief-8B와 AstaBrief-8B-SFT 모델 가중치는 Apache License 2.0으로 배포되어 연구 목적은 물론 상업적 용도로도 사용 및 수정이 가능하며, 기반 모델 Qwen3-8B도 Apache 2.0입니다. 반면 SFT 데이터, DPO 데이터, 프롬프트 모음은 CC BY-NC 4.0으로 상업적 이용이 금지되며, 데이터에 포함된 서드파티 모델의 합성 출력은 각 모델 제공사의 약관도 따릅니다. 모델 카드와 데이터셋 카드는 모두 Ai2의 Responsible Use Guidelines에 따른 연구 및 교육 목적 사용을 의도한다고 밝히고 있습니다. ScholarQA 코드 저장소는 Apache 2.0입니다.
 Open-sourcing AstaBrief, the fast report-generation model in Asta 소개 블로그
 AstaBrief 8B 모델
 Ai2 Scholar QA GitHub 저장소
 Asta 홈페이지
더 읽어보기
-
DR Tulu: An open, end-to-end training recipe for long-form deep research (Ai2)
-
DPO로 텍스트 퇴화 줄이기: 모델의 실패 출력을 거부 쌍으로 쓰는 방법에 대한 연구 (feat. DharmaOCR)
-
RLHF Book: 인간 피드백 기반 강화학습(RLHF)과 사후 학습(Post-training) 전반을 다루는 오픈소스 교재 및 코드 라이브러리
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
