핵심 요약
- ServiceNow CoreAI가 대상 모델이 실패하고 교사 모델이 성공한 과제를 분석해, 환경에서 실행 검증을 통과한 새 학습 과제를 만드는 합성 데이터 파이프라인 AutoSynthData를 Huggign Face 블로그에 소개했습니다.
- EnterpriseOps-Gym의 Hybrid 도메인에서 합성 샘플 2,000개로 지도 미세조정한 Gemma-4-26B-A4B-it의 평균 Pass@1이 20.45%에서 27.65%로, ITSM 도메인에서는 18.77%에서 27.18%로 올랐습니다.
- 평가에 쓴 과제가 무엇을 가르칠지 정하는 진단 과제이기도 하고 최적 체크포인트도 같은 벤치마크로 골랐기 때문에, 이 결과는 같은 환경 안에서 거둔 개선이며 처음 보는 환경으로 일반화된다는 근거는 아닙니다. 블로그도 결과의 범위를 실험에 쓴 환경으로 한정합니다.
- 파이프라인 코드와 생성된 학습 데이터는 이번 발표에 포함되지 않았고, 직접 실행해 볼 수 있는 것은 Apache 2.0으로 공개된 EnterpriseOps-Gym 벤치마크입니다.
AutoSynthData 소개
AutoSynthData 는 기업 환경에서 동작하는 에이전트가 약한 지점을 찾아, 그 약점을 연습시키는 학습 과제를 자동으로 만들어 내는 ServiceNow CoreAI 팀의 합성 데이터(Synthetic Data) 파이프라인입니다. 대상 모델의 실패와 더 강한 교사 모델(Teacher Model)의 성공을 함께 보고 다음에 무엇을 가르칠지 정한 뒤, 새 과제를 생성하고 실제 환경에서 실행해 검증된 것만 학습 데이터로 남깁니다. 모델이 나아지면 커리큘럼(curriculum)도 아직 어려워하는 쪽으로 옮겨 갑니다.
블로그는 기업이 개선해야 할 약점을 "전반적으로 유능한 모델도 특정 환경에서는 어려움을 겪을 수 있다" 는 데서 찾고, 잘 처리하지 못하는 워크플로, 잘못 조합하는 도구, 지키지 못하는 제약을 예로 듭니다. 문제는 이런 약점을 학습 데이터로 바꾸는 일입니다. 실패 사례 하나는 단서일 뿐이고, 모델을 학습시키려면 같은 능력을 다른 상황에서 반복해서 요구하는 과제가 많이 필요합니다. 게다가 그 과제들은 환경에서 실제로 완료할 수 있어야 하고, 누군가 실제로 요청할 법한 일이어야 하며, 성공 여부를 믿을 만하게 판정할 수단도 갖춰야 합니다.
일반적인 질의응답 데이터라면 그럴듯한 질문과 답을 만들어 내는 것으로 충분할 수 있지만, 상태를 바꾸는 도구 호출 과제는 사정이 다릅니다. 과제에 등장하는 레코드가 데이터베이스에 실제로 있어야 하고, 정책이 허용하는 행동으로 풀 수 있어야 하며, 채점 로직이 잘못된 최종 상태를 통과시키지 않아야 합니다. AutoSynthData가 생성 자체보다 생성된 과제를 걸러 내고 고치는 단계에 더 많은 설명을 할애하는 이유가 여기에 있습니다. 비슷한 문제를 벤치마크 분포에 맞춘 합성으로 접근한 사례로는 PyTorchKR에서 소개한 Auto-BenchMax가 있는데, AutoSynthData는 분포를 맞추는 대신 모델의 실패를 출발점으로 삼는다는 점이 다릅니다.
이 글에서는 블로그 본문과 함께, 실험 무대인 EnterpriseOps-Gym 논문과 공개 데이터셋, GitHub 저장소의 README를 함께 대조해 결과를 읽을 때 필요한 조건까지 정리합니다.
학습에 쓸 만한 에이전트 과제의 조건: 시스템 명세, 사용자 프롬프트, 검증기
AutoSynthData는 에이전트 과제를 세 요소의 묶음으로 정의합니다. 에이전트가 동작하는 환경은 관찰하고 수정할 수 있는 상태, 호출할 수 있는 도구와 API, 그리고 행동이 만들어 내는 상태 전이로 이루어지고, 과제는 이 환경 위에서 만들어집니다.
task = (system specification, user prompt, verifier)
시스템 명세(System Specification) 는 에이전트가 따라야 하는 제약입니다. 시스템 지시문, 환경 정책, 그리고 필요한 경우 미리 채워 둔 데이터베이스 상태나 지식 문서 같은 과제별 초기화가 여기에 들어갑니다. 명세는 환경의 도구, 상태, 지원 동작과 맞아야 하고, 블로그는 "난이도를 만들어 내기 위해서만 도입한 임의의 제약" 을 피해야 한다고 적고 있습니다.
사용자 프롬프트(User Prompt) 는 사용자가 에이전트에게 원하는 일을 담습니다. 생성된 프롬프트는 세 가지 성질을 갖춰야 합니다. 첫째는 실행 가능성(Feasibility)으로, 현재 환경에서 시스템 명세를 지키면서 요청을 만족하는 궤적(trajectory)이 적어도 하나 존재해야 합니다. 없는 도구, 접근할 수 없는 지식, 불가능한 상태 전이, 정책이 금지한 행동에 기대는 과제는 여기서 걸러집니다. 둘째는 현실성(Realism)으로, 실행 가능한 행동의 공간은 현실적인 워크플로의 공간보다 훨씬 넓기 때문에 실제로 요청할 법한 일인지를 따로 따져야 합니다. 셋째는 난이도(Difficulty)입니다. 이미 안정적으로 푸는 과제는 새로운 학습 신호를 거의 주지 못하므로, 쓸모 있는 영역은 실행 가능하고 현실적이지만 아직 꾸준히 풀지 못하는 과제입니다.
검증기(Verifier) 는 에이전트의 궤적이 과제를 완수했는지 판정합니다. 검증기는 사용자 프롬프트, 시스템 명세, 과제별 환경 상태와 어긋나지 않는 일관성(Consistency), 과제를 만족하지 못하거나 제약을 어긴 궤적을 거부하는 건전성(Soundness), 그리고 특정 참조 궤적 하나만이 아니라 유효한 해법을 모두 받아들이는 완전성(Completeness)을 갖춰야 합니다. 이 성질들은 학습에 직접 영향을 줍니다. 느슨한 검증기는 잘못된 행동에 보상을 주고, 지나치게 까다로운 검증기는 올바른 해법에 벌점을 줍니다.
실험 무대 EnterpriseOps-Gym: 최종 상태를 SQL로 채점하는 기업 업무 벤치마크
AutoSynthData의 실험은 ServiceNow Research가 2026년 3월 공개한 EnterpriseOps-Gym 위에서 진행되었습니다. 이 벤치마크를 먼저 이해해야 실험 결과의 의미가 보입니다.
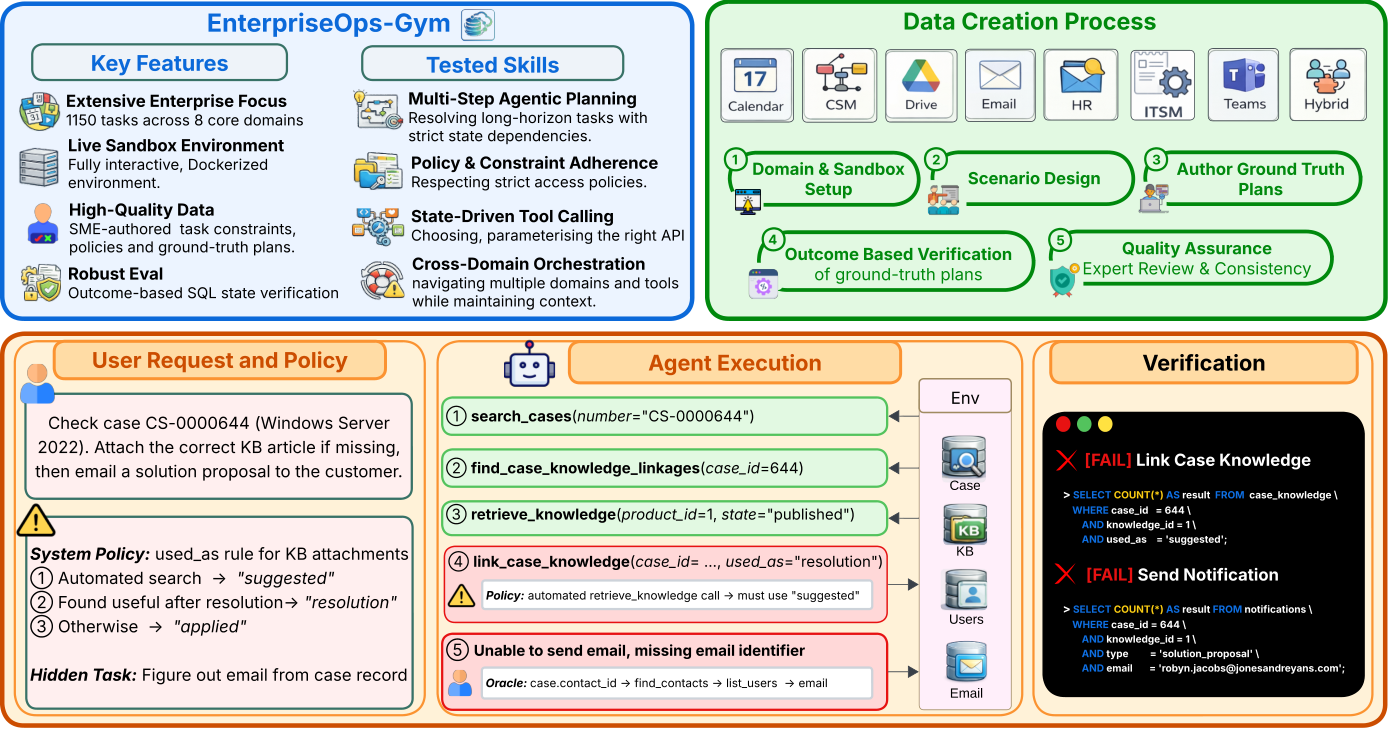
EnterpriseOps-Gym은 Docker로 컨테이너화된 샌드박스에 164개의 데이터베이스 테이블과 512개의 도구를 갖추고, 8개 도메인에 걸친 1,150개의 과제를 제공합니다(정책상 수행할 수 없는 요청을 부작용 없이 거절해야 하는 과제 30개 포함). 도메인은 고객 서비스 관리(CSM, Customer Service Management), 인사(HR), IT 서비스 관리(ITSM, IT Service Management) 같은 운영 시스템과 Email, Calendar, Teams, Drive 같은 협업 도구, 그리고 여러 도메인을 넘나드는 Hybrid로 나뉩니다. 환경과 과제는 160명 이상의 기여자가 참여해 만들었고, 각 과제의 성공 여부는 전문가가 작성한 SQL 검증 스크립트가 환경의 최종 상태 를 조회해 판정합니다. 행동 순서를 맞추는 방식이 아니어서 다른 경로로 같은 결과에 도달해도 인정되지만, 목표 달성 외에 외래 키 무결성, 권한 준수, 의도하지 않은 부작용까지 검사합니다.
논문이 14개 최신 모델을 평가한 결과에서 가장 높은 Claude Opus 4.5의 평균 성공률은 37.4%였고, 정책이 촘촘한 ITSM(최고 28.5%)과 도메인을 넘나드는 Hybrid(최고 30.7%)가 가장 어려운 영역이었습니다. 수행할 수 없는 과제를 깨끗하게 거절한 비율도 가장 높은 모델이 53.9%에 그쳤습니다. 논문은 약한 모델 3종에 사람이 작성한 계획을 주면 CSM, ITSM, HR에서 성능이 14~35%p 오르고, Claude Sonnet 4.5에 방해 도구를 추가해도 성능이 거의 변하지 않는다는 점을 들어, 병목이 도구 사용보다 전략적 계획(Planning) 에 있다고 결론짓습니다.
여기서 확인해 둘 점이 있습니다. 블로그는 "공개된 데이터셋을 사용했다" 고 적었는데, GitHub README에 따르면 공개 분할(public split)은 전체 벤치마크 샘플의 60%입니다. Hugging Face 데이터셋의 oracle 구성은 649개 행이고, 그중 Hybrid는 88개, ITSM은 103개입니다. README는 공개 분할 기준 표를 따로 싣고 있으며(Claude Opus 4.5 평균 36.6%, Hybrid 30.7%, ITSM 28.2%), 데이터셋 카드에 적힌 최고 성능 34.1%는 논문의 37.4%와도, 이 공개 분할 표와도 일치하지 않습니다.
from datasets import load_dataset

ds = load_dataset("ServiceNow-AI/EnterpriseOps-Gym", "oracle", split="teams")
데이터셋은 도메인이 분할(split)이고, 에이전트에게 노출하는 도구 집합이 구성(config)입니다. oracle 은 과제에 필요한 도구만, plus_5_tools, plus_10_tools, plus_15_tools 는 여기에 무작위 방해 도구를 5개, 10개, 15개 더한 구성입니다. 각 행에는 system_prompt, user_prompt, SQL 기반 verifiers, 연결할 MCP 서버 설정인 gym_servers_config 가 들어 있어, AutoSynthData가 정의한 과제 3요소(시스템 명세, 사용자 프롬프트, 검증기)와 그대로 대응합니다.
실패에서 커리큘럼으로: 원본 과제를 숨긴 능력 명세 카드
AutoSynthData의 첫 단계는 대상 모델이 무엇을 배워야 하는지 정하는 일입니다. EnterpriseOps-Gym 실험에서는 대상 모델과 더 강한 교사 모델을 평가 과제에 모두 돌려 본 뒤, 그 실행 기록을 분석해 다음을 찾아냅니다.
- 과제가 시험하는 능력
- 관련된 도구와 워크플로 구조
- 대상 모델이 실패한 지점과 교사 모델이 성공한 방식
- 올바른 최종 상태가 만족해야 하는 성질
- 시험하는 능력은 유지하면서 바꿀 수 있는 차원
이 분석 결과는 능력 명세 카드(Capability Specification Card) 로 정리됩니다. 블로그가 강조하는 부분은 정보의 차단입니다. 평가 과제는 모델이 무엇을 배워야 하는지 안내할 뿐이고, 생성기는 원래 프롬프트, 엔터티, 궤적, 검증기 세부를 받지 않습니다. 생성기가 받는 것은 카드뿐이며, 카드를 바탕으로 프롬프트, 상태, 풀이 경로가 다른 새 과제를 만듭니다.
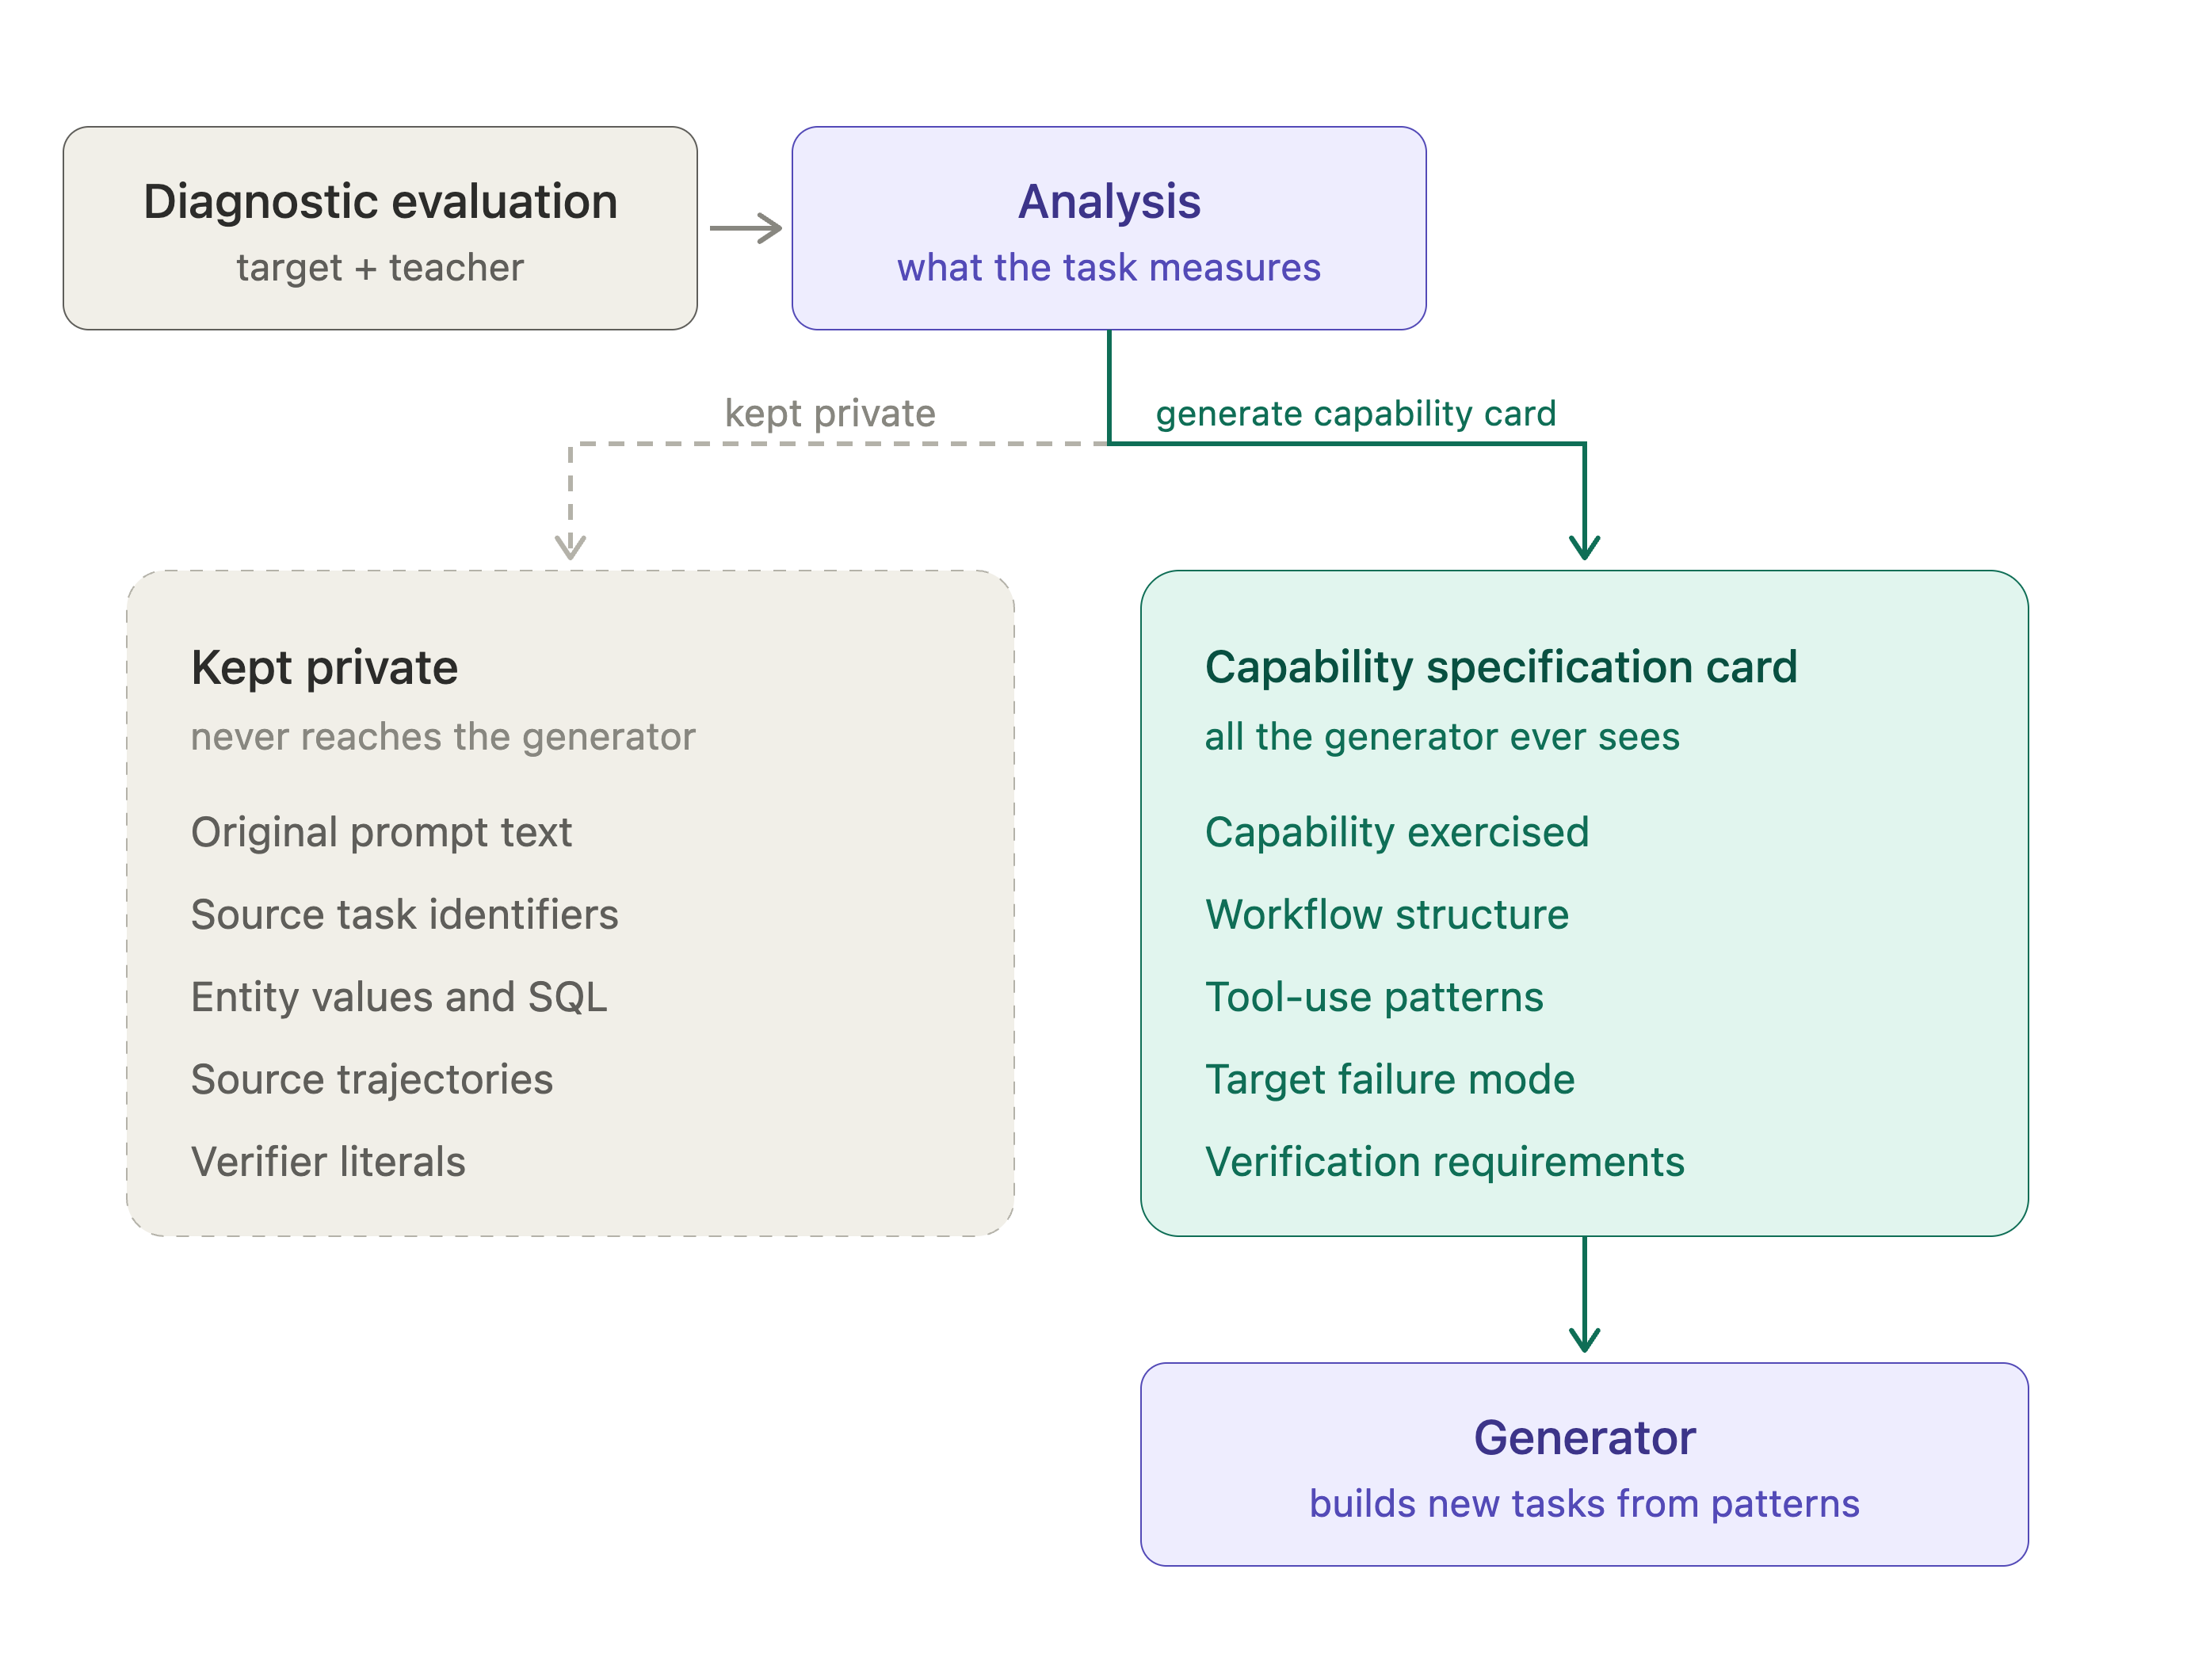
예를 들어 대상 모델이 관련 레코드 조회, 레코드 상태 판단, 올바른 워크플로 선택, 여러 도구 연산 수행, 요구되는 최종 상태로 환경 정리 로 이어지는 워크플로에서 자주 실패한다면, 생성기는 엔터티, 초기 환경 상태, 워크플로 구성, 도구 조합, 문구, 난이도를 바꿔 가며 같은 워크플로를 연습시키는 과제를 만듭니다. 그다음 교사 모델이 각 과제에서 성공한 궤적을 시연하고, 지도 미세조정(SFT, Supervised Fine-Tuning)에서는 이 시연이 대상 모델에게 새 상황에서 능력을 적용하는 방법을 가르치는 데이터가 됩니다.
Target과 Multiply: 과제를 만들고 늘리는 두 단계
AutoSynthData는 데이터셋을 두 단계로 쌓습니다. 먼저 핵심 샘플을 생성하고 검증한 뒤, 그 샘플을 새로운 변형으로 확장합니다.
Target 단계 는 능력 명세로부터 핵심 학습 샘플을 만듭니다. 여러 워커가 독립적인 과제를 병렬로 생성하고, 하나를 끝내면 다음 목표를 가져갑니다. 각 후보는 유효성 검사, 실행, 풀이 모델 평가, 수리를 거쳐야 채택됩니다.
Multiply 단계 는 채택된 Target 샘플의 변형을 만들어 데이터셋을 키웁니다. 각 변형은 사용자 요청, 환경 상태, 엔터티 구성, 참조 궤적, 검증기를 모두 새로 가지며, 같은 유효성 검사와 실행 검사를 통과해야 합니다. 중요한 제약은 Multiply로 만든 샘플이 다시 다른 Multiply 샘플의 씨앗이 될 수 없다 는 점입니다. 블로그는 이 규칙이 확장을 검증된 Target 집합에 묶어 두고, 세대를 거듭하며 분포가 표류(drift)하는 것을 제한한다고 설명합니다.
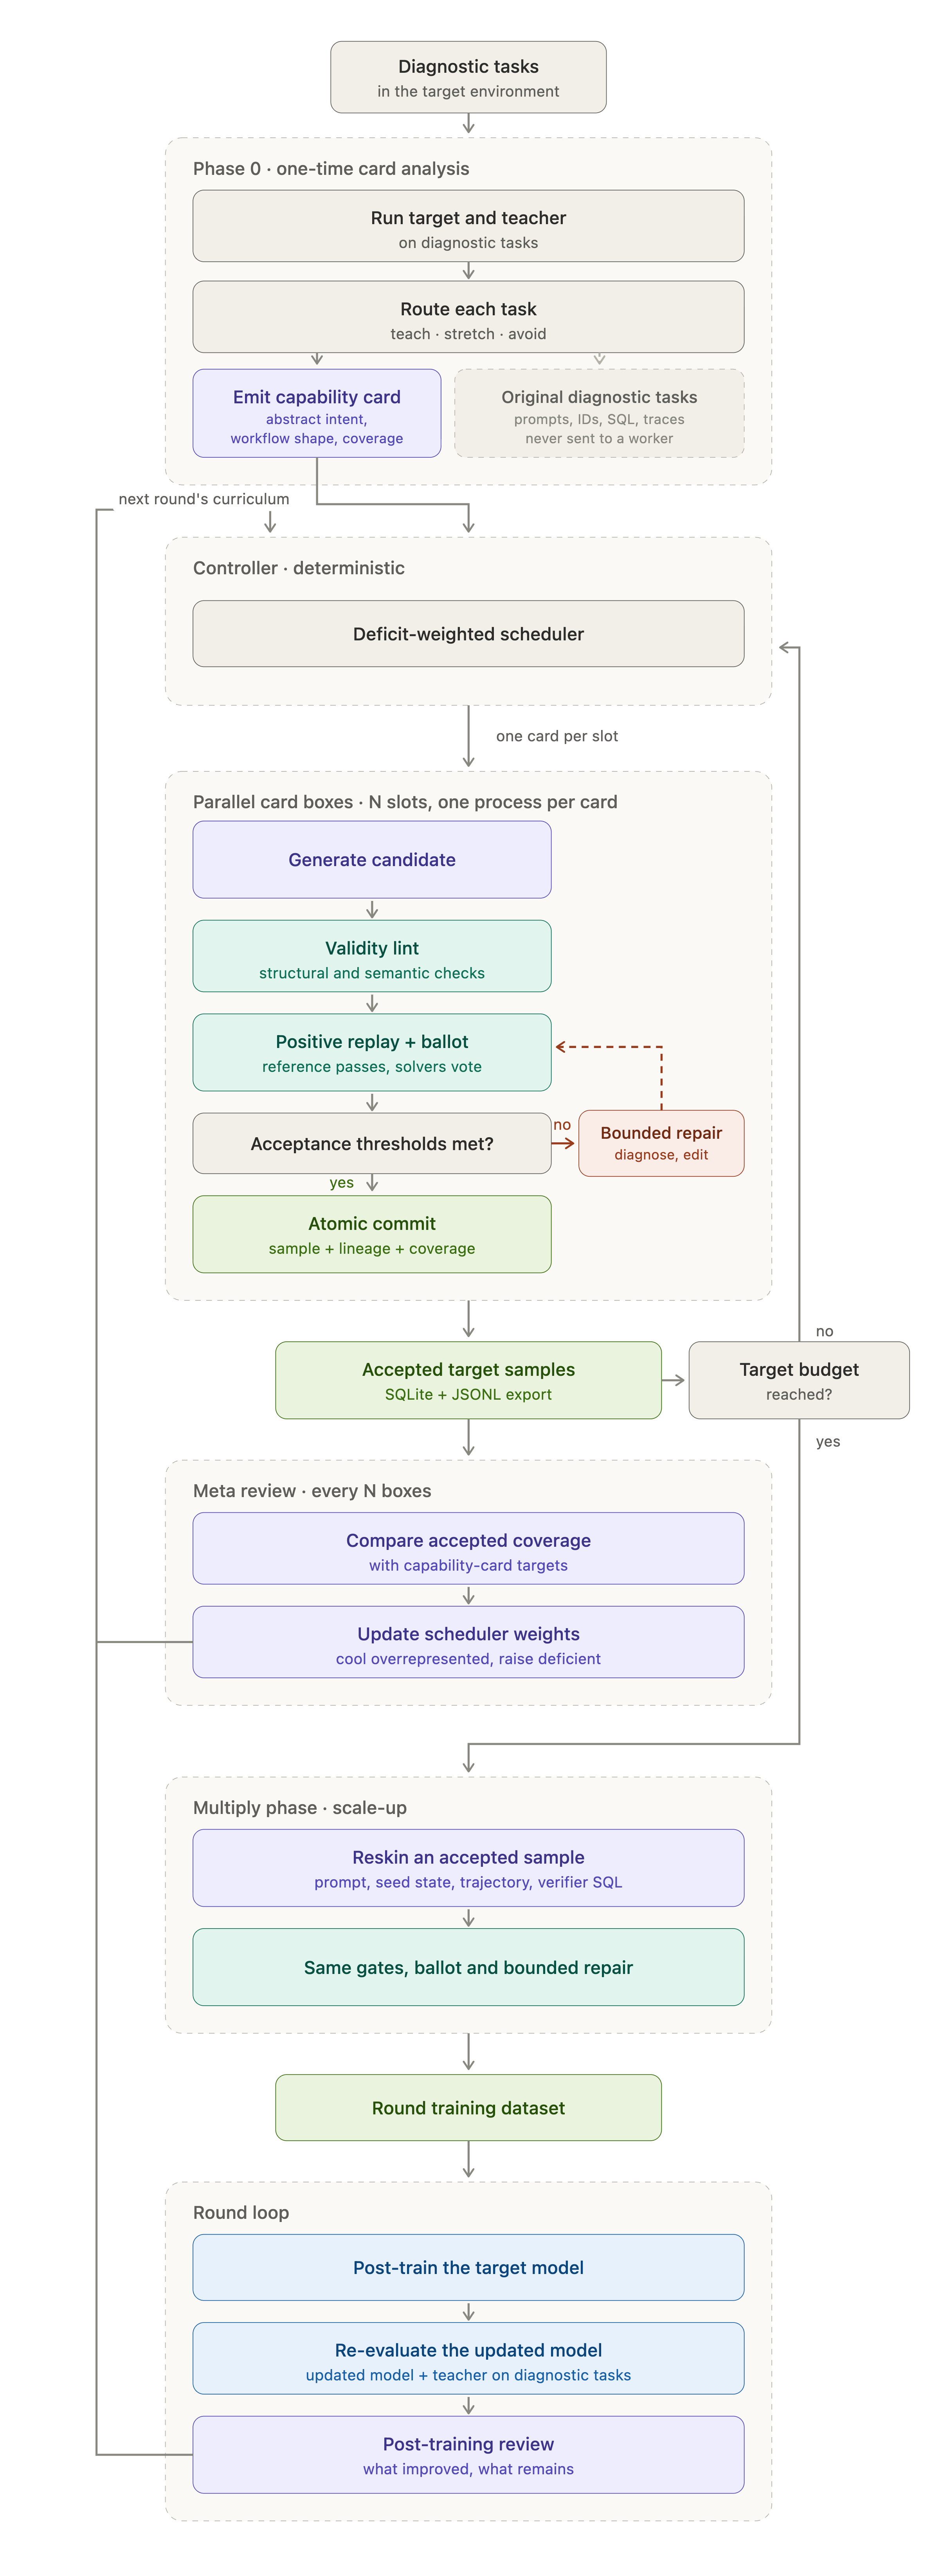
위 전체 흐름도에는 본문에 나오지 않는 세부도 담겨 있습니다. 그림에 따르면 0단계에서 각 진단 과제를 teach, stretch, avoid 로 분류하고, 결정적(deterministic) 컨트롤러의 결핍 가중 스케줄러(Deficit-weighted Scheduler) 가 슬롯마다 카드 하나씩을 배정합니다. 각 카드 박스 안에서는 후보 생성, 구조와 의미 검사(validity lint), 참조 궤적 재실행과 풀이 모델 투표(ballot), 수락 기준 판정, 제한된 수리가 차례로 이어지고, 통과한 샘플은 계보(lineage)와 커버리지 정보와 함께 SQLite에 쌓이고 JSONL로도 내보내집니다. 메타 리뷰는 N개 박스마다 수락된 샘플의 커버리지를 카드 목표와 비교해, 과대 대표된 영역의 스케줄러 가중치는 낮추고 부족한 영역은 높입니다. teach, stretch, avoid 각각의 기준은 블로그에 설명되어 있지 않습니다.
구현 측면에서는 생성 제어와 환경별 실행을 분리했습니다. 공용 컨트롤러가 생성, 품질 관리, 커버리지, 데이터셋 구성을 조율하고, 어댑터(adapter)가 환경 실행, 과제와 상태 관리, 참조 궤적 재실행, 결정적 검증, 풀이 모델 실행, 과제 프로파일링을 맡습니다. 이 구조라면 다른 환경으로 옮길 때 어댑터만 새로 작성하면 될 것으로 보이지만, 블로그가 보여 준 환경은 EnterpriseOps-Gym 하나뿐입니다.
생성만으로는 부족하다: 샘플 단위 검증과 배치 단위 리뷰
그럴듯한 요청을 만드는 것만으로는 쓸모 있는 학습 데이터가 되지 않습니다. 과제가 환경에서 불가능할 수도 있고, 참조 풀이가 실행해 보면 실패할 수도 있으며, 검증기가 엉뚱한 최종 상태에 보상을 줄 수도 있습니다. AutoSynthData는 이 성질들을 두 수준에서 점검합니다.
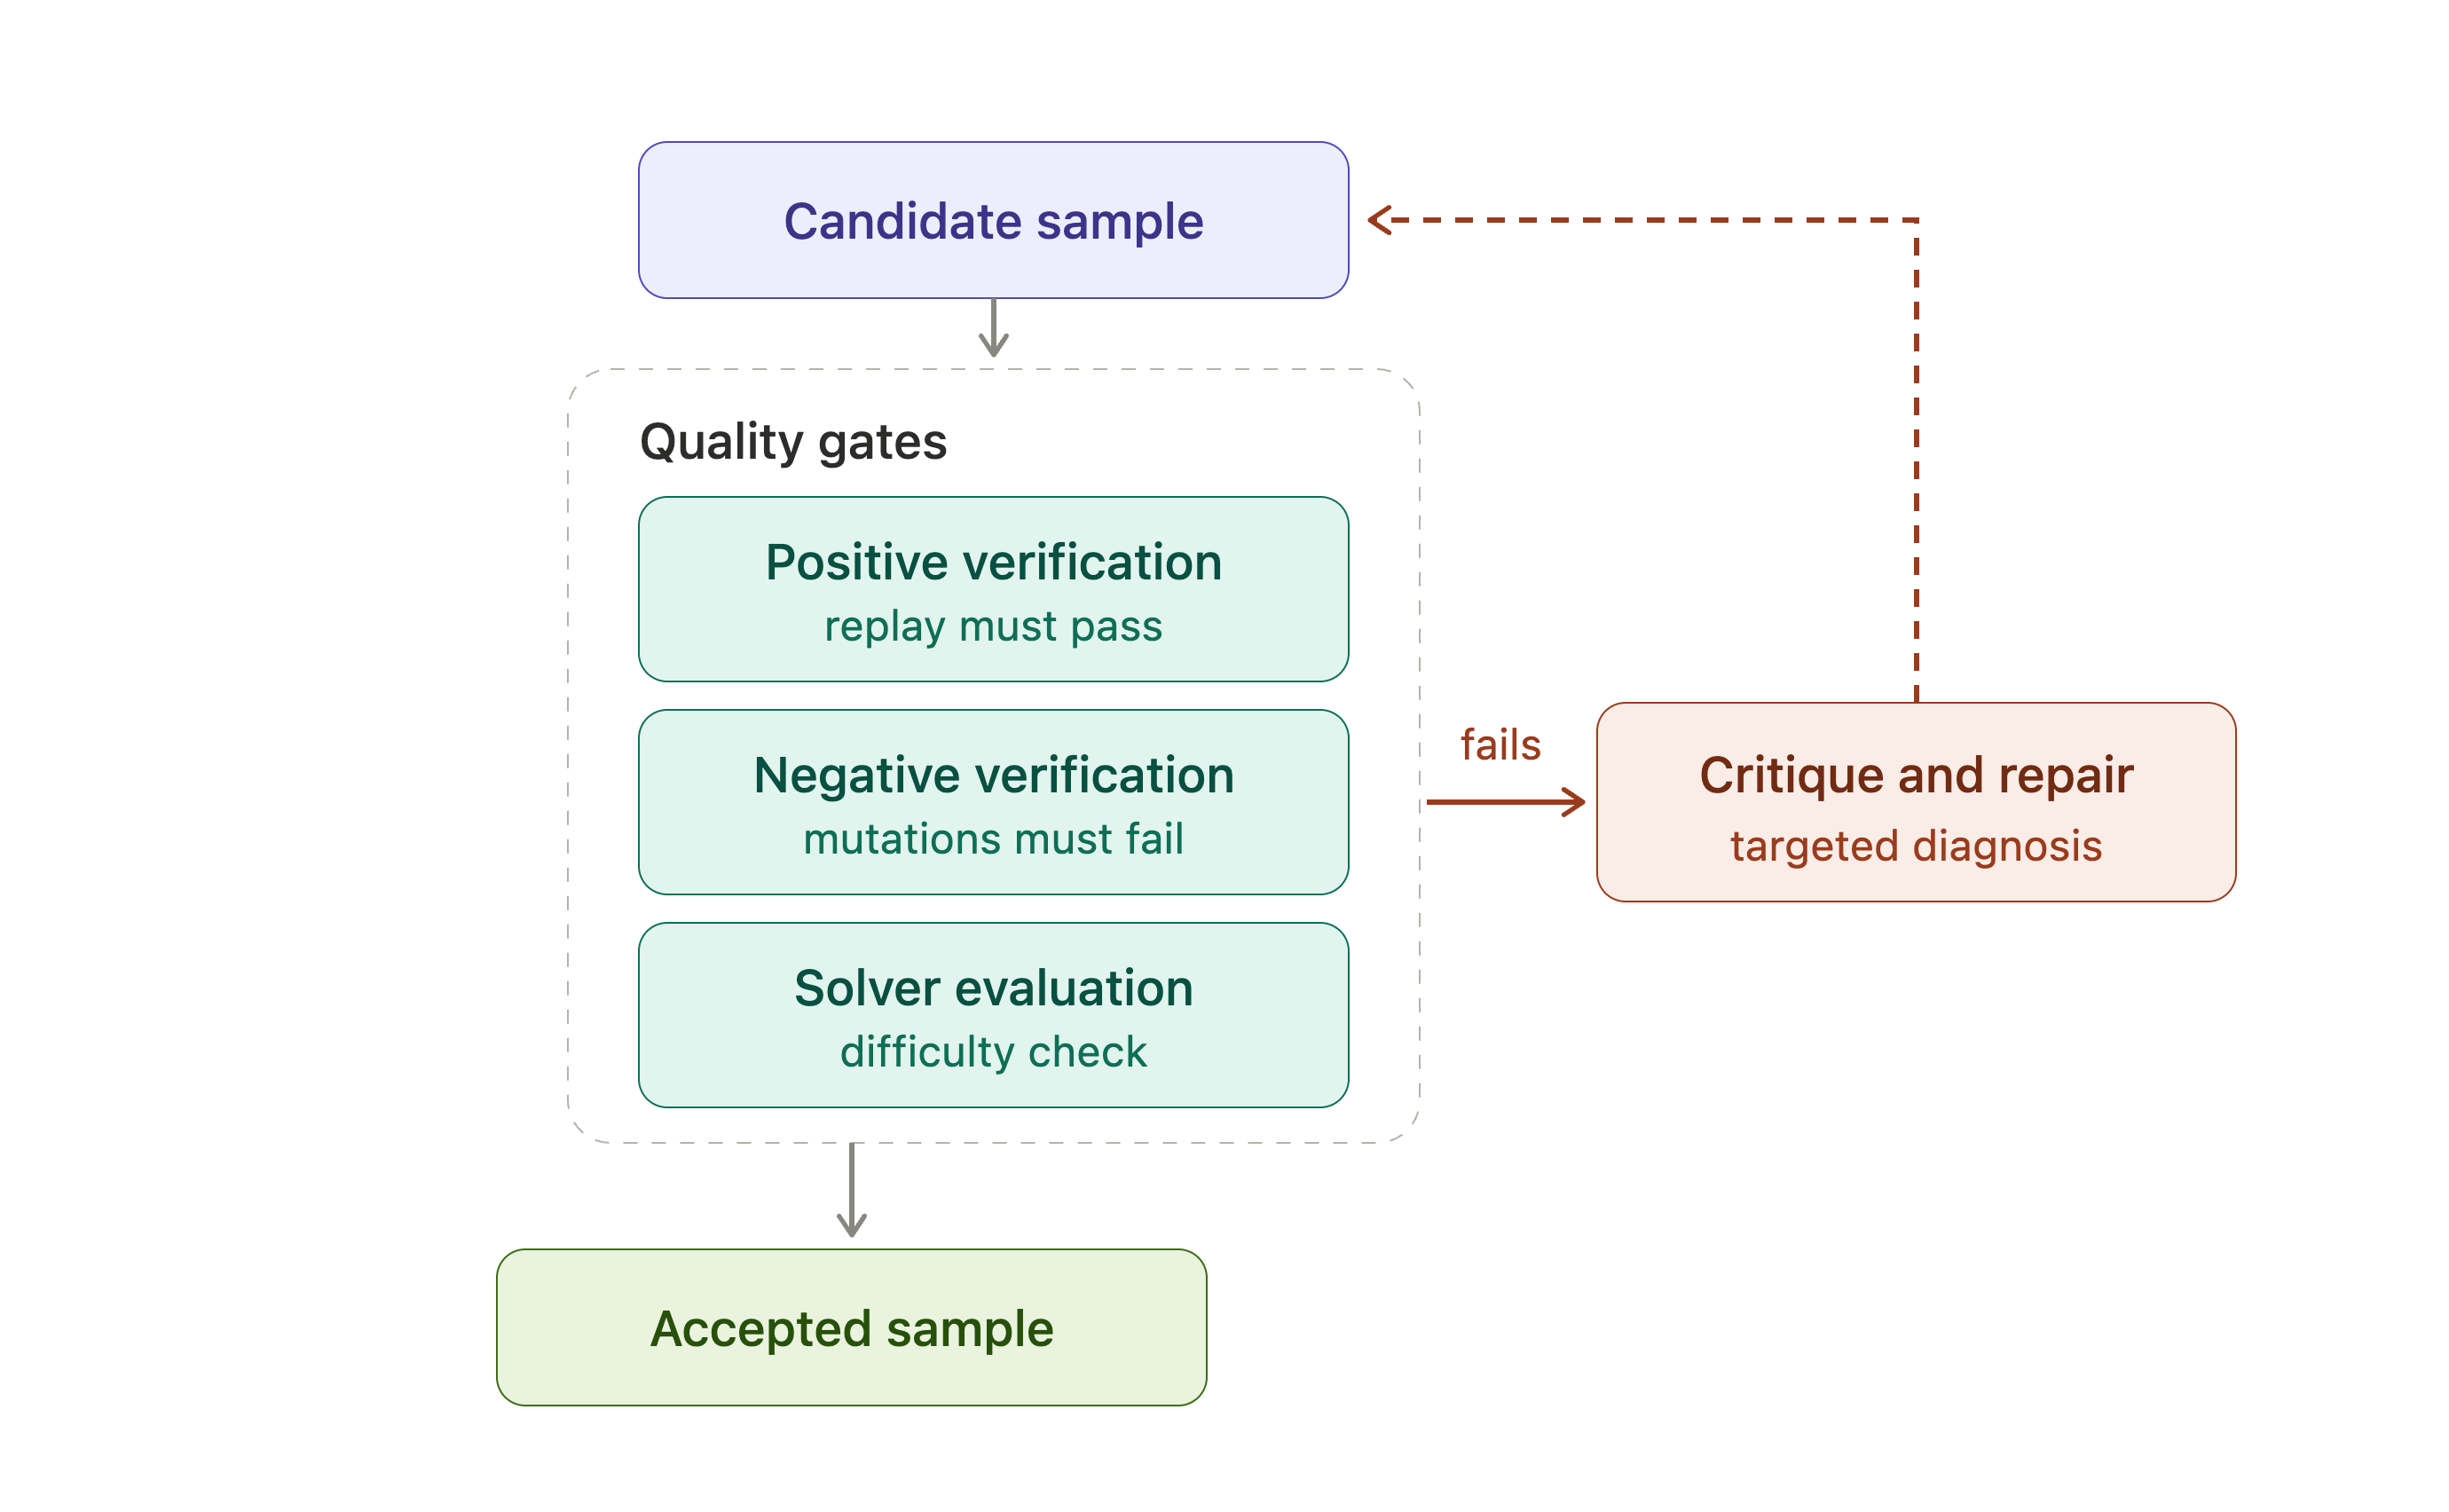
샘플 단위: 난이도 판정, 긍정과 부정 검증, 제한된 수리
각 후보는 학습 데이터셋에 들어가기 전에 품질 관리 루프를 통과해야 합니다. 먼저 풀이 모델 평가(Solver Evaluation) 로 난이도를 잽니다. 블로그가 공개한 설정에서는 대상 모델이 3번 중 1번 이하로 풀고, 더 강한 풀이 모델이 3번 중 2번 이상 푸는 과제 를 우선합니다. 대상 모델에게는 어렵지만 더 강한 모델은 믿을 만하게 풀 수 있는 구간을 숫자로 정한 것입니다.
긍정 검증(Positive Verification) 은 "의도한 풀이가 생성된 과제를 실제로 푸는가" 를 묻습니다. 참조 궤적을 환경에서 실행하고 그 결과 상태를 후보의 검증기로 확인해, 프롬프트, 초기 상태, 풀이, 성공 기준 사이의 불일치를 드러냅니다. 반대로 부정 검증(Negative Verification) 은 "관련된 잘못된 결과는 실패하는가" 를 묻습니다. 기대 결과의 일부를 변형(mutate)한 상태가 더 이상 검증을 통과하지 않는지 확인해, 의도한 행동 없이도 성공을 주는 약한 검증기를 잡아냅니다. 앞서 말한 검증기의 건전성을 실행으로 시험하는 셈입니다.
검증에 실패한 후보는 바로 버려지지 않고 비평자(Critic) 에게 넘어갑니다. 비평자는 샘플과 실패 내용을 보고 상태 불일치, 불가능한 워크플로, 잘못된 과제 구성, 나쁜 참조 궤적, 약한 검증기 로직, 의도한 능력과의 불일치를 찾고, 그 진단에 따라 정해진 재시도 한도 안에서 수리가 이루어집니다.
candidate
↓
failure
↓
critique / diagnosis
↓
targeted repair
↓
run the gates again
↓
accept or retry
수리된 과제는 관련 검사를 다시 통과해야 합니다. 진단이 처음부터 다시 생성하는 대신 기존 후보를 고치는 방향으로 수리를 이끈다는 것이 블로그의 설명입니다.
배치 단위: 커버리지와 다양성을 보는 메타 리뷰
개별 샘플이 모두 유효해도 데이터셋 전체는 반복적이거나 치우칠 수 있습니다. 쉬운 과제 유형 몇 개가 과대 대표되거나, 어떤 능력이 빠지거나, 수확이 적은 패턴에 생성 예산을 너무 많이 쓸 수 있습니다. 그래서 메타 리뷰(Meta-review) 가 배치마다 수락된 샘플, 거부된 샘플, 생성 과정의 행태를 함께 보며 다음을 점검합니다.
- 어떤 과제 유형이 과대 대표되었고, 어떤 능력 차원이 빠졌는가?
- 같은 종류의 예시가 반복해서 나오는가?
- 특정 목표가 생성에 계속 실패하는가?
- 비평 결과에 체계적인 문제가 드러나는가?
- 다음 배치에서 어떤 지침을 바꿔야 하는가?
컨트롤러는 수락된 데이터셋의 커버리지를 추적해 과대 대표된 영역의 생성을 줄이고 빈 곳에 더 많은 작업을 배정합니다. 어떤 영역이 계속 나쁜 후보를 만들면 비평과 메타 리뷰가 생성 전략 변경을 이끕니다. 즉, 샘플 단위 검사는 후보 수리를, 배치 단위 리뷰는 이후의 생성 방향을 이끄는 두 개의 피드백 루프가 함께 돕니다.
모델과 함께 움직이는 학습 경계
AutoSynthData는 합성 데이터 생성을 대상 모델의 능력 경계 근처에 있는 과제를 찾는 탐색 으로 봅니다. 약점을 드러낼 만큼 어렵지만, 교사 모델이 믿을 만한 시연을 제공할 수 있을 만큼은 풀 수 있는 과제입니다.
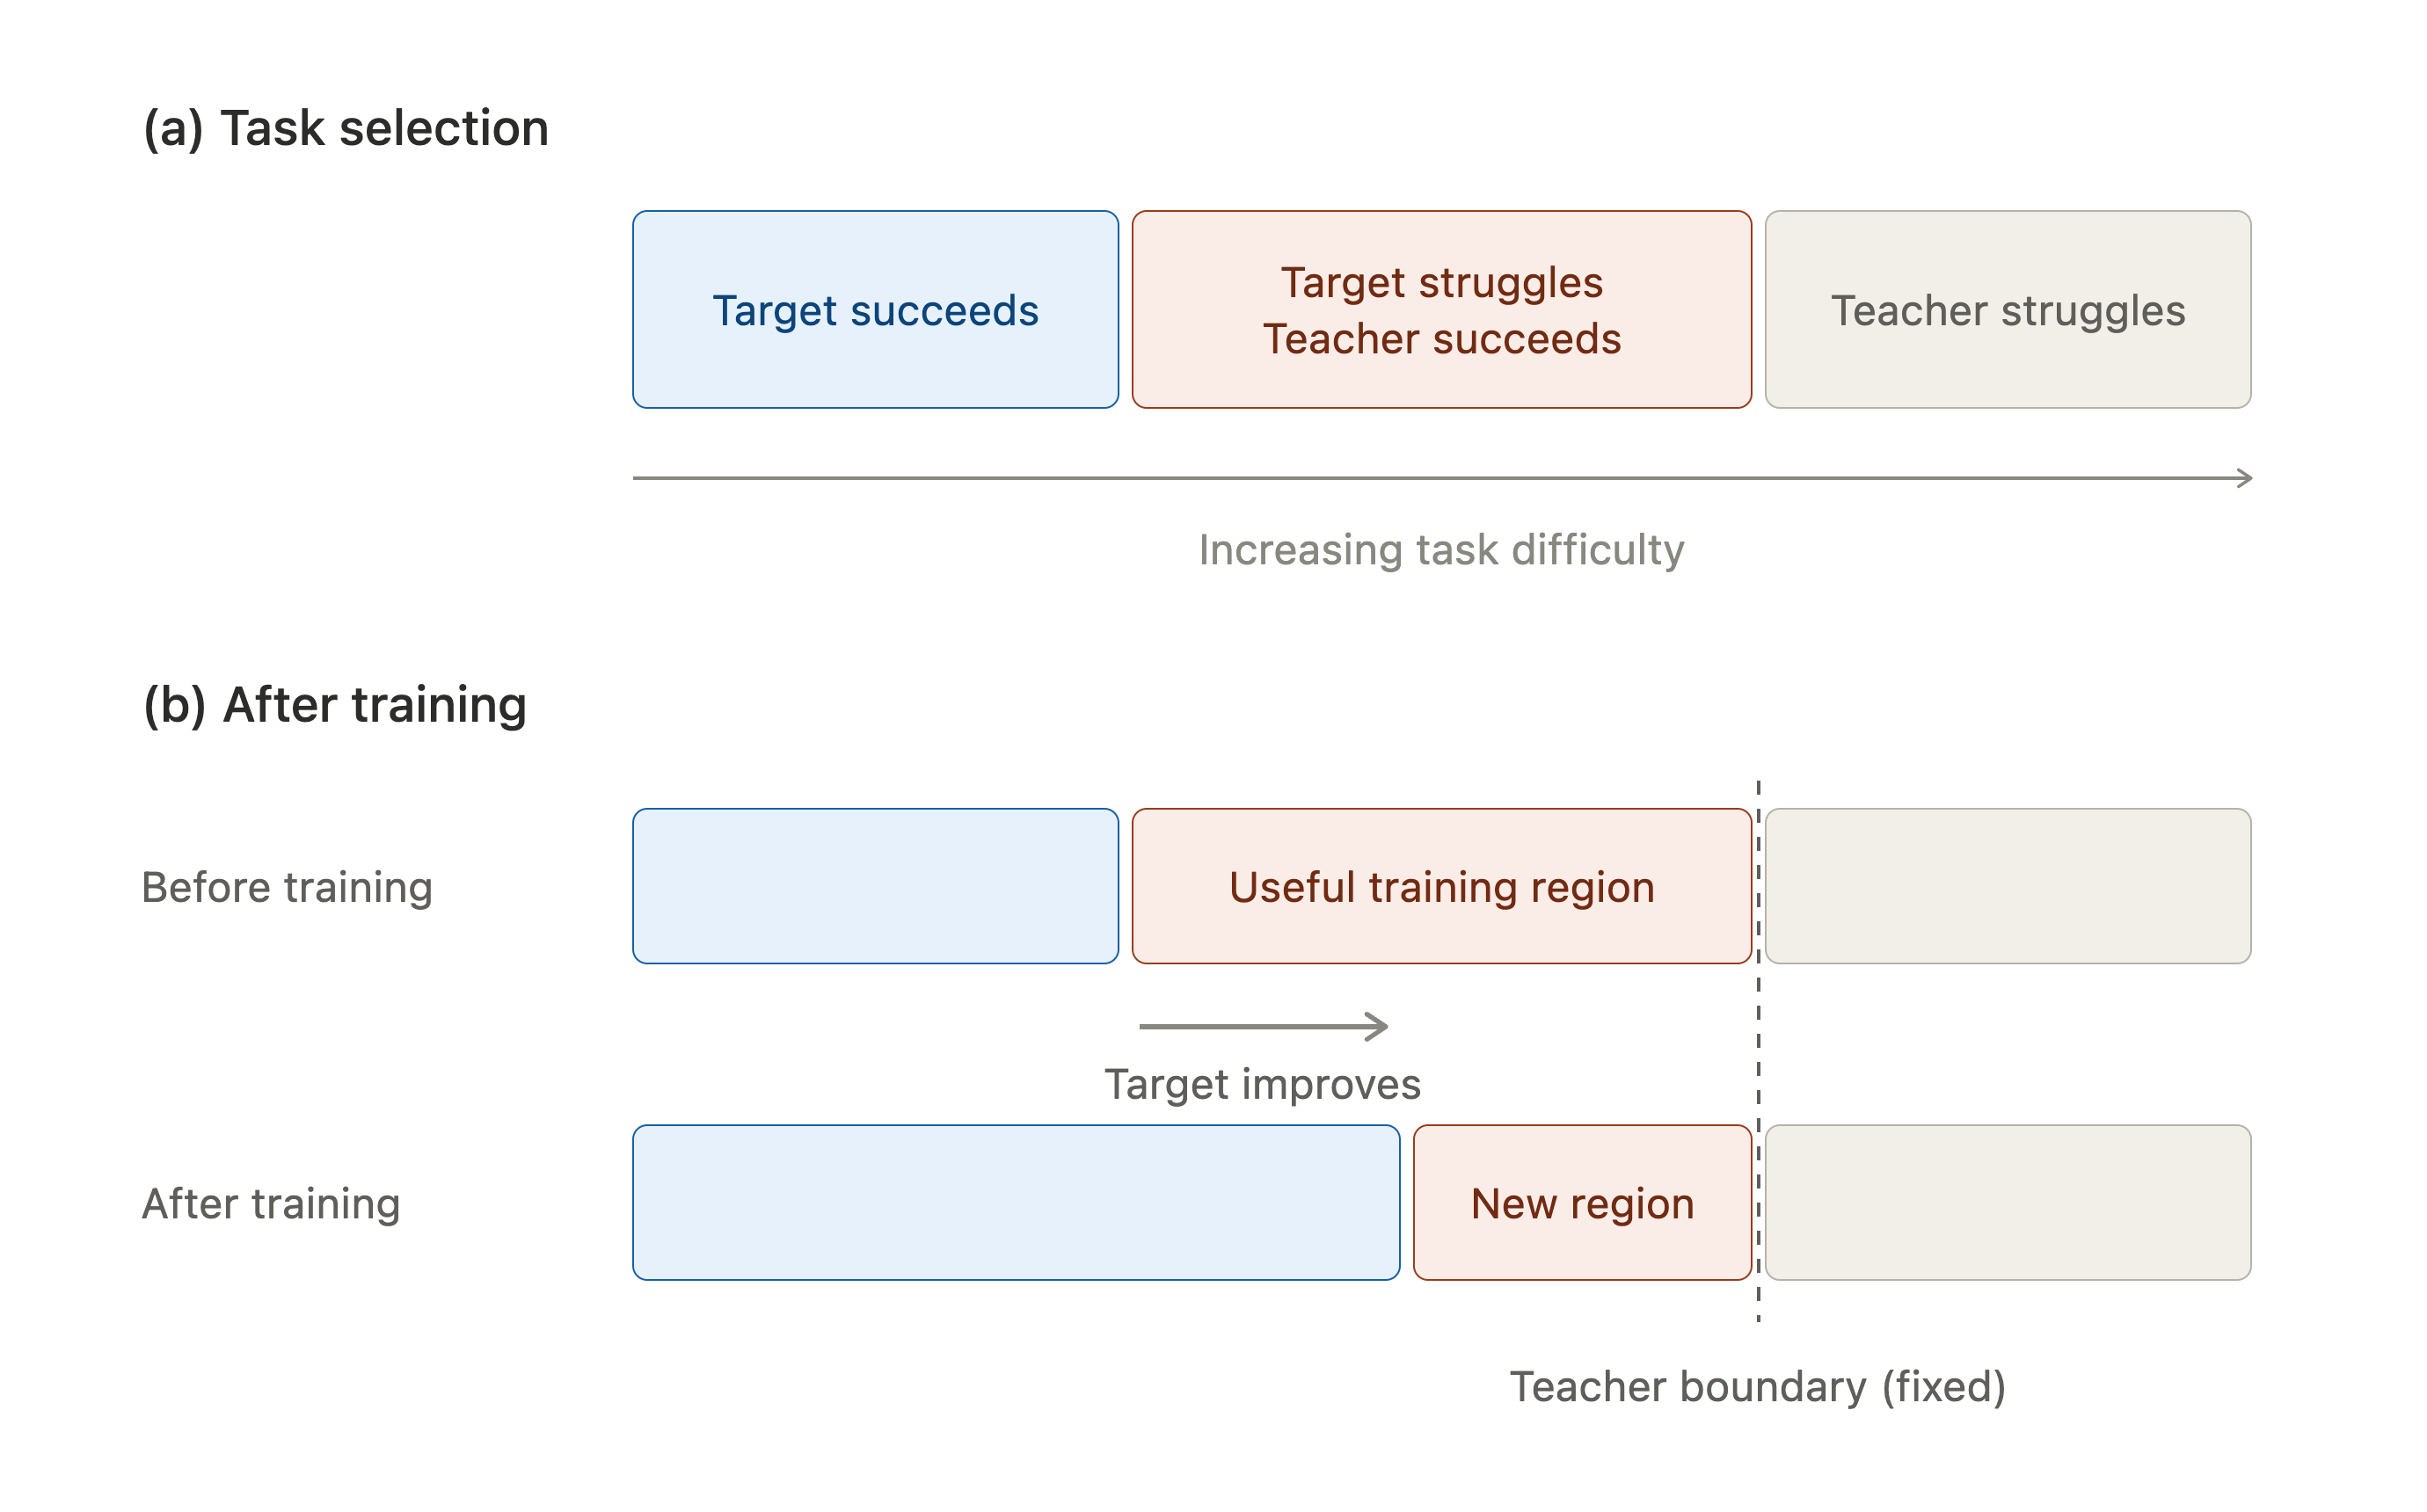
사후 학습(Post-training)이 끝나면 갱신된 모델을 같은 환경에서 다시 평가합니다. 이제 안정적으로 푸는 과제는 다음 라운드에서 쓸모가 줄고, 계속 실패하는 과제는 아직 손봐야 할 능력을 가리킵니다. 위 그림에서 볼 수 있듯이 교사 경계는 고정되어 있으므로, 대상 모델이 나아질수록 유용한 학습 구간은 좁아집니다. 이 구조에서는 대상 모델이 교사 모델을 넘어서는 지점까지 데이터를 만들기 어렵다는 한계도 함께 읽힙니다. 또한 블로그가 보고한 실험은 두 도메인 모두 한 라운드의 결과이고, 재평가 뒤 다음 라운드를 돌린 결과는 실려 있지 않습니다.
블로그의 실험은 SFT에 한정되어 있지만, 저자들은 같은 방식이 강화학습(RL, Reinforcement Learning)에도 쓰일 수 있다고 봅니다. 현재 정책을 시험하면서 믿을 만한 학습 신호를 주는 과제를 생성하고, 학습한 뒤, 갱신된 정책에 맞춰 생성 목표를 옮기는 방식입니다. 저자들은 이 움직이는, 난이도가 보정된 경계 를 SFT 너머에서 시험할 계획이라고 밝혔습니다.
EnterpriseOps-Gym 실험 결과: Hybrid와 ITSM 도메인에서 Gemma 4 미세조정
두 실험 모두 대상 모델은 Google의 MoE(Mixture-of-Experts) 모델 Gemma-4-26B-A4B-it입니다(
 Gemma 4 모델군은 PyTorchKR의 Gemma 4 공개 소식을 참고해주세요). 교사 모델은 실험마다 다르고, 블로그는 결과 그래프에서 교사 모델을 참조 모델로 함께 표시했습니다.
| 항목 | Hybrid | ITSM |
|---|---|---|
| 교사 모델 | Qwen3.8-27B | DeepSeek-V4.1-Flash (본문 기준) |
| 생성한 합성 샘플 | 2,000개 | 1,994개 |
| 생성 소요 시간 | 약 18시간 | 66시간 |
| Gemma 기준 Pass@1 | 20.45% | 18.77% |
| 합성 데이터 SFT 후 Pass@1 | 27.65% (5 에폭) | 27.18% (5 에폭) |
| 향상 폭 | +7.20%p (상대 +35%) | +8.41%p (상대 +45%) |
| 참조 모델 Pass@1 | 32.58% | 41.75% |
| 참조 모델과의 격차 중 줄어든 비율 | 59% | 약 37% (그래프 수치로 계산) |
위 표의 수치는 블로그 본문과 결과 그래프에서 옮긴 것이며, ITSM의 상대 향상과 격차 감소 비율은 그래프 수치로 직접 계산했습니다.
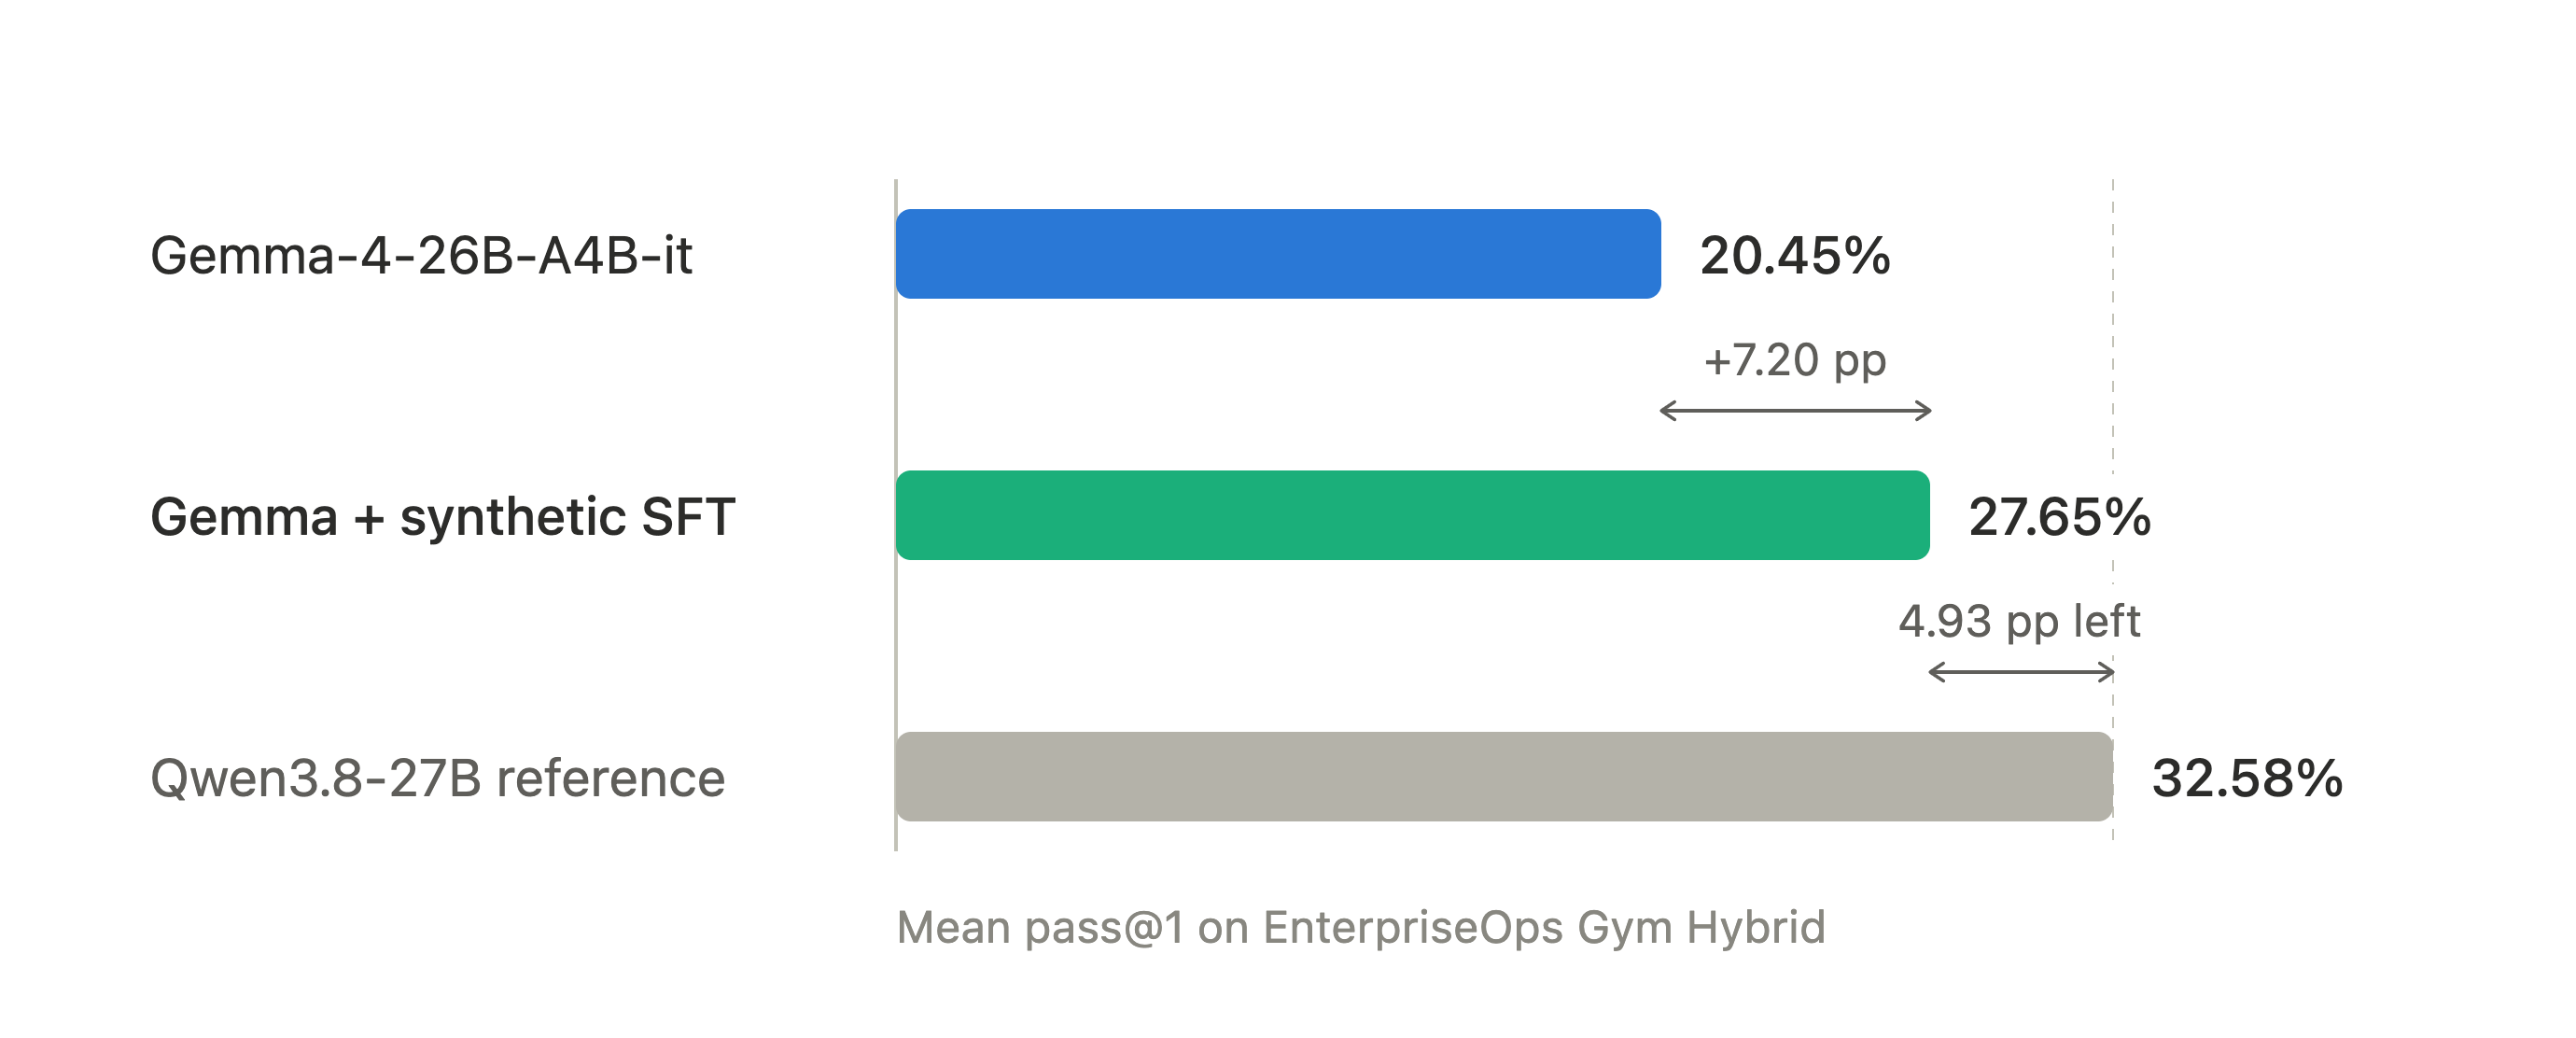
Hybrid 에서는 2,000개 합성 샘플을 약 18시간 만에 생성했고, 이 데이터로 미세조정한 체크포인트 가운데 5 에폭이 가장 좋았습니다. 평균 Pass@1은 7.2%p(상대 35%) 올랐고, 개별 검증 조건의 통과율을 뜻하는 검증기 성공률도 63.01%에서 68.55%로 높아졌습니다. Gemma와 참조 모델 사이에 원래 있던 Pass@1 격차의 59%를 메운 결과입니다. 블로그는 학습 과제가 능력 명세로부터 새로 생성되었고 생성기가 원래 평가 과제를 받지 않았다고 밝히면서도, 이 결과가 "실험에 사용한 환경인 EnterpriseOps Gym Hybrid의 개선" 을 보여 준다고 범위를 한정합니다.
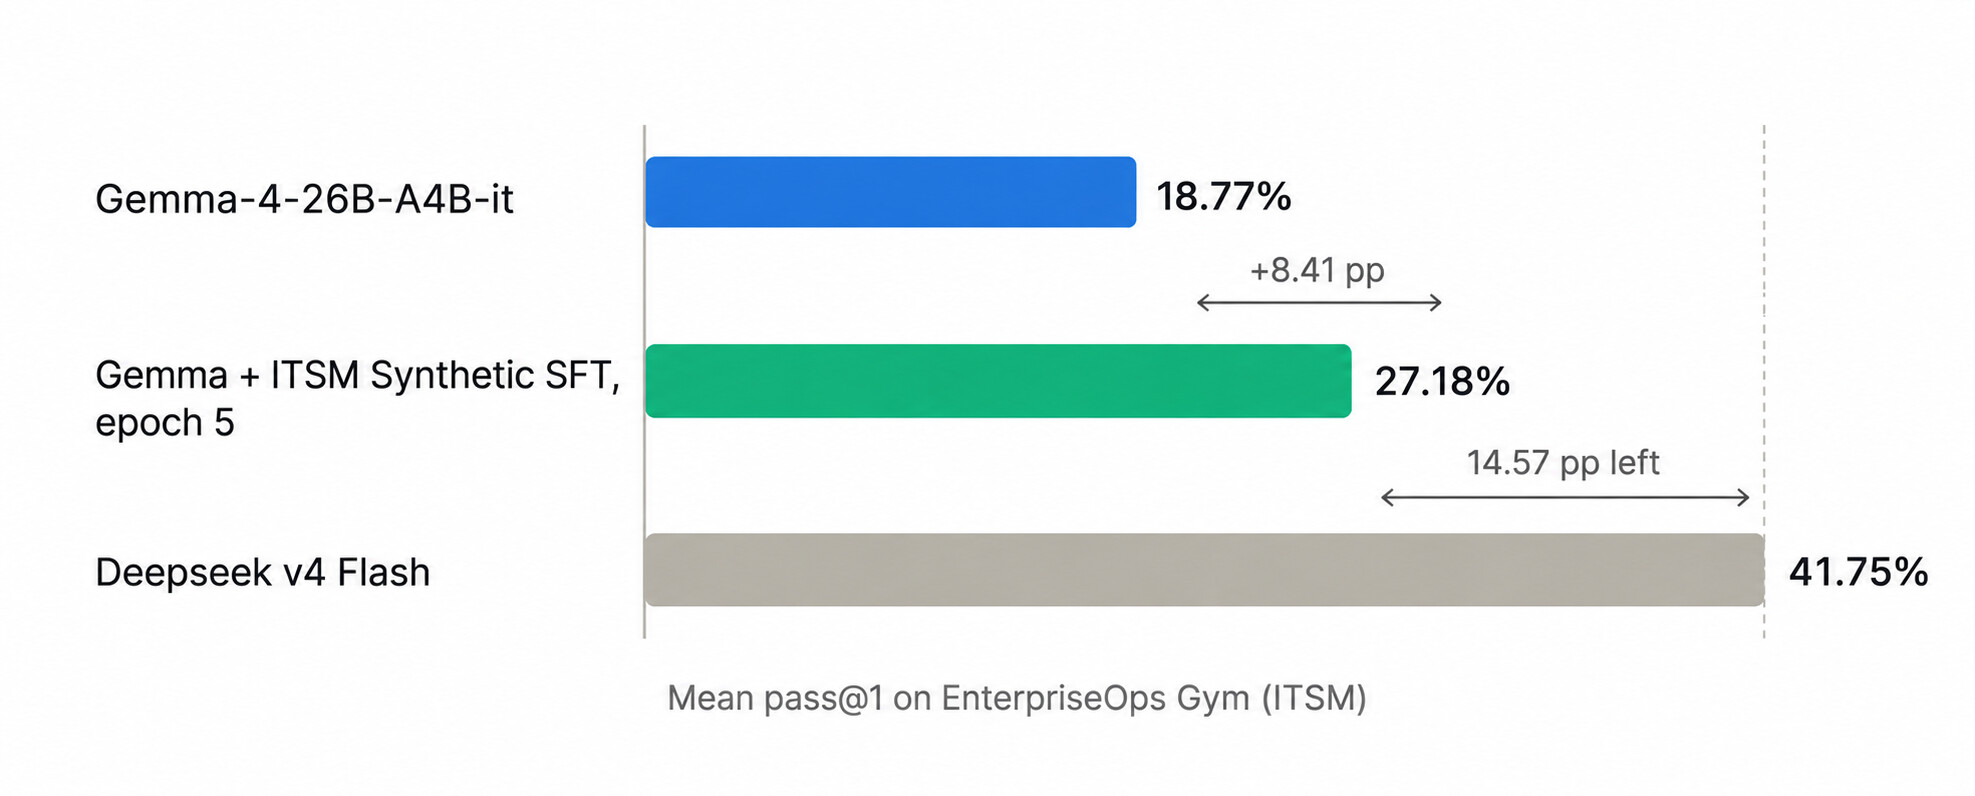
ITSM 에서는 1,994개 샘플을 생성하는 데 66시간이 걸렸습니다. 블로그는 Hybrid보다 오래 걸린 이유로 더 큰 교사 모델을 썼다는 점과, 처리량을 높인 파이프라인 최적화 이전에 진행된 실험이라는 점을 듭니다(DeepSeek-V4.1-Flash의 구조는 PyTorchKR의 DeepSeek-V4.1-Flash 소개 글을 참고해주세요). 평균 Pass@1은 18.77%에서 27.18%로 올라 절대 향상 폭은 Hybrid보다 컸지만, 참조 모델이 41.75%로 높아 격차는 여전히 14.57%p 남았습니다. 블로그 본문은 ITSM의 교사 모델을 DeepSeek-V4.1-Flash로 적었지만, 결과 그래프의 참조 막대에는 Deepseek v4 Flash 로 표기되어 있어 둘 중 어느 쪽인지 원문만으로는 확정할 수 없습니다.
참고로 GitHub README의 공개 분할 기준 표에서 Claude Opus 4.5의 점수는 Hybrid 30.7%, ITSM 28.2%입니다. 미세조정한 Gemma의 27.65%와 27.18%는 이 값과 가까운 수준이지만, 블로그가 평가 하네스, 실행 횟수, 추론(inference) 설정을 README의 측정과 맞췄다는 설명은 없으므로 두 값을 직접 비교할 수는 없습니다.
결과를 읽을 때 확인할 조건
AutoSynthData의 결과는 의미 있는 개선이지만, 블로그가 밝힌 실험 설계 안에서 읽어야 합니다. 원문과 관련 자료를 대조하면 다음 조건이 드러납니다.
진단 과제와 평가 과제가 같은 집합입니다. 블로그는 "대상 모델과 교사 모델을 평가 과제에 돌려" 능력 명세 카드를 만든다고 설명하고, 같은 벤치마크로 개선을 측정합니다. 생성기가 원본 프롬프트와 엔터티, 검증기를 받지 않도록 막았다는 점은 단순 암기를 줄이는 장치이지만, 무엇을 가르칠지는 평가 과제의 실패에서 나왔습니다. 따라서 이 결과는 평가 집합과 분리된 보류(held-out) 과제나 다른 환경으로 일반화된다는 것을 보여 주지 않습니다.
최적 체크포인트를 같은 벤치마크로 골랐습니다. 블로그는 체크포인트들을 벤치마크에서 평가했고 5 에폭이 가장 좋았다고 적었습니다. 별도 검증 집합 없이 시험 점수로 체크포인트를 고르면 보고된 수치가 다소 낙관적으로 나올 수 있습니다.
대조 실험이 없습니다. 실패 기반 커리큘럼, Multiply 단계, 부정 검증, 메타 리뷰가 각각 얼마나 기여했는지에 대한 절제 실험(ablation)이나, 같은 교사 모델로 무작위 과제를 같은 양만큼 증류(distillation)했을 때와의 비교는 블로그에 없습니다. 평균 Pass@1을 몇 번의 실행으로 계산했는지와 분산도 밝히지 않았습니다.
공개 분할로 진행한 실험입니다. 블로그가 사용했다고 밝힌 공개 데이터셋은 전체 벤치마크의 60%이고, 공개 oracle 구성 기준으로 Hybrid는 88개, ITSM은 103개 과제입니다. 블로그는 어느 도구 구성(oracle 또는 방해 도구 추가 구성)으로 평가했는지 적지 않았습니다.
재현할 수 있는 부분은 벤치마크까지입니다. 블로그에는 AutoSynthData 코드나 생성된 학습 데이터의 링크가 없고, 2026년 10월 2일 기준 ServiceNow의 GitHub와 Hugging Face 조직에서도 관련 저장소를 찾을 수 없었습니다. 공개된 것은 EnterpriseOps-Gym 저장소와 데이터셋이며, 둘 다 Apache 2.0 라이선스입니다.
이런 조건을 감안해도 블로그가 정리한 설계 원칙은 자체 환경에서 에이전트 학습 데이터를 만드는 팀이 그대로 참고할 수 있는 체크리스트입니다. 과제를 시스템 명세, 사용자 프롬프트, 검증기의 묶음으로 보고, 참조 풀이를 실제로 실행하는 긍정 검증과 일부러 망가뜨린 상태가 실패하는지 보는 부정 검증을 함께 두며, 대상 모델과 더 강한 모델의 성공률로 난이도 구간을 정하는 방식입니다. 특히 부정 검증은 검증기 품질이 곧 보상 품질이 되는 강화학습 환경을 만들 때도 바로 적용할 수 있는 점검 방법입니다. 저자들이 예고한 RL 실험과 다른 환경의 결과가 나오면 이 접근이 같은 환경 밖에서도 통하는지 판단할 수 있을 것입니다.
라이선스
EnterpriseOps-Gym 벤치마크 코드와 데이터셋은 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. AutoSynthData 파이프라인 코드는 이번 발표에 포함되지 않았습니다.
 AutoSynthData: Generating Training Data for Enterprise Agents 블로그
EnterpriseOps-Gym 논문
 EnterpriseOps-Gym 데이터셋
 EnterpriseOps-Gym GitHub 저장소
 EnterpriseOps-Gym 홈페이지
더 읽어보기
-
Auto-BenchMax: 벤치마크와 같은 분포로 데이터를 합성해 MCP-Atlas 점수를 2배로 올린 파이프라인
-
Google DeepMind, 모바일 기기부터 클라우드까지 사용 가능한, 통합 멀티모달 모델 Gemma 4 공개
-
DeepSeek-V4.1-Flash, KV 캐시를 토큰당 890바이트로 줄이고 플래그십 V4-Pro를 대체하는 552B 규모의 MoE 모델
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
