Auto-BenchMax 소개
도구를 호출하는 에이전트를 학습시킬 때 가장 먼저 막히는 것은 데이터입니다. 벤치마크가 제공하는 과제는 보통 수십 개 수준이고, 이 정도로는 지도 미세조정(SFT, Supervised Fine-Tuning)을 돌릴 분량이 나오지 않습니다. 그래서 비슷한 과제를 합성해 수를 불리는데, 도구 호출 과제는 일반적인 질의응답 데이터와 사정이 다릅니다. 과제에 등장하는 주문 번호나 저장소 이름 같은 대상이 환경 안에 실제로 존재하고 도구로 닿을 수 있어야 하고, 그 과제를 벤치마크가 채점할 수 있어야 합니다. 존재하지 않는 대상을 끼워 넣으면 과제 자체가 풀리지 않고, 남는 것은 쓸모없는 궤적뿐입니다.
이번에 소개할 Auto-BenchMax는 그 합성 과정을 하나의 방법론으로 정리해 공개한 프로젝트입니다. 데이터 구축 파이프라인과 학습 코드, 평가 환경, 그리고 실제로 만들어 낸 데이터까지 함께 열어 두었습니다. 특히 눈에 띄는 것은 합성 방식을 벤치마크의 채점 방식에 따라 둘로 나눈다는 점입니다. 규칙으로 채점하는 벤치마크와 심판 모델이 채점하는 벤치마크는 정답을 만들어야 하는 시점이 다르고, 저자는 이 갈림길을 잘못 고르면 며칠을 버린다고 적고 있습니다.
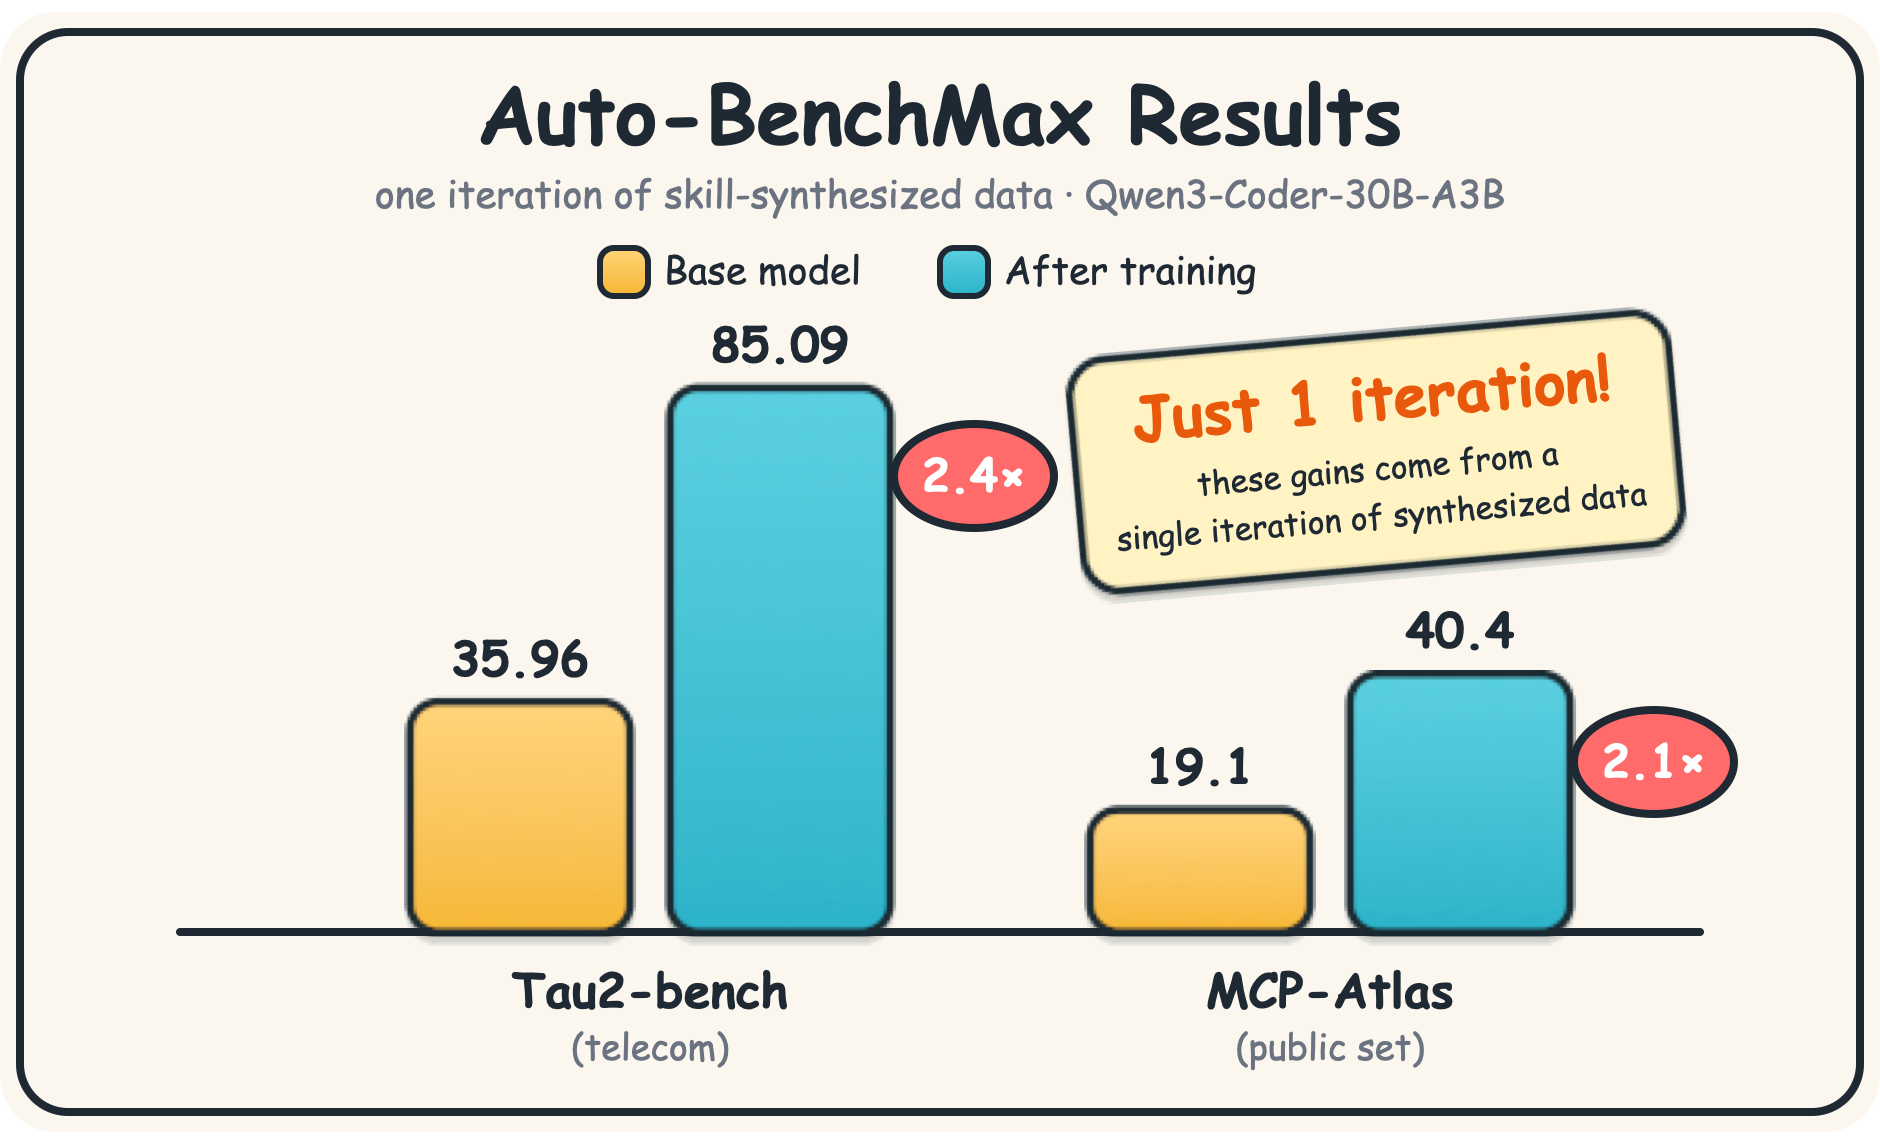
공개된 결과는 Qwen3-Coder-30B-A3B를 기준 모델로 삼아 한 번의 반복으로 합성한 데이터를 학습시킨 것입니다. 위 그래프에서 MCP-Atlas 공개 세트 점수가 19.1에서 40.4로, Tau2-bench의 통신(telecom) 영역이 35.96에서 85.09로 올라간 것을 볼 수 있습니다. 저자는 반복을 더 수행하면 MCP-Atlas에서 50을 넘길 수 있다고 밝히고 있으며, 저장소에 들어 있는 데이터는 첫 번째 반복의 산물입니다.
Auto-BenchMax와 기존 합성 방식의 차이
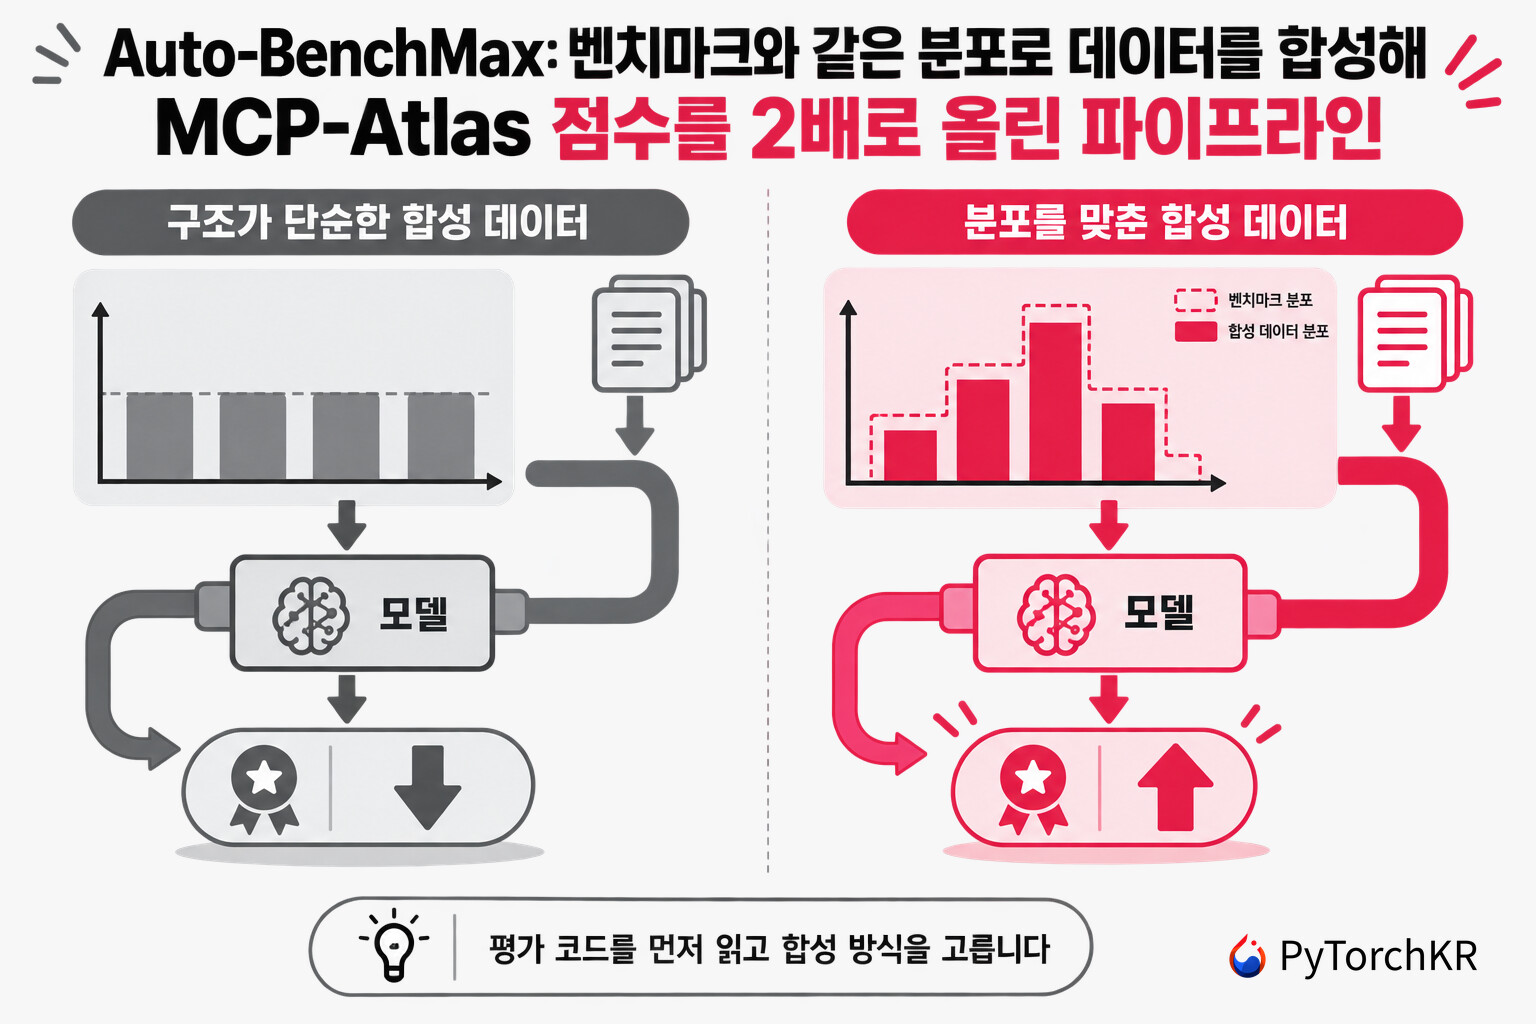
합성 데이터를 만들 때 흔히 하는 선택은 원본 과제보다 단순한 과제를 대량으로 찍어 내는 것입니다. 구조가 깔끔해지니 학습도 잘 될 것 같지만, 저자가 측정한 결과는 반대였습니다. 규칙 기반 소매 과제 벤치마크에서 첫 번째 합성본 1,000건을 만들어 학습시켰더니 점수가 오히려 떨어졌습니다.
원인은 구조 분포가 원본과 어긋난 데 있었습니다. 공식 과제 114건과 첫 번째 합성본의 통계를 나란히 놓으면 다음과 같습니다:
| 지표 | 공식 과제 (114건) | 첫 합성본 (1,000건) |
|---|---|---|
| 과제당 평균 쓰기 연산 | 1.56 | 1.00 |
| 쓰기 연산이 2회 이상인 과제 | 39% | 0% |
| 정보를 되돌려 주는 과제 | 33% | 0% |
위 표에서 합성본이 원본보다 단순해진 방향이 뚜렷하게 보입니다. 여러 단계를 묶은 복합 작업과 값을 계산해 사용자에게 되돌려 주는 과제가 통째로 빠지면서, 모델은 "사용자를 찾고, 주문 하나를 읽고, 한 단계만 처리하고 멈춘다" 는 쪽으로 기울었습니다. 저자는 여기서 한 걸음 더 들어가, 상위 지표를 맞춘 뒤에도 점수가 65.79%에 머물렀던 경험을 함께 적어 두었습니다. 공식 벤치마크의 정보 전달 항목에는 하위 유형이 네 가지 있었고 쓰기 과제에도 두 상태가 섞인 사례가 있었는데, 합성본이 그 하위 유형을 하나도 담지 못했기 때문입니다.
그래서 이 프로젝트가 내세우는 원칙은 하나로 압축됩니다. 생성하기 전에 대상 벤치마크의 구조 히스토그램을 계산하고, 생성한 뒤 같은 히스토그램을 합성본에서 다시 계산해 차이를 확인하며, 그 차이를 버그로 취급하는 것입니다.
Auto-BenchMax는 누구에게 맞는가
자체 도구 호출 벤치마크를 이미 갖고 있고 그 위에서 모델을 학습시키려는 팀에게 값어치가 큽니다. 이 저장소가 제공하는 것은 특정 데이터셋이 아니라 "평가 코드를 읽고 채점 방식을 판정한 뒤 그에 맞는 합성 경로를 고르라" 는 절차이고, 그 절차는 벤치마크가 달라져도 그대로 적용됩니다. 합성 데이터가 이유 없이 점수를 떨어뜨리는 상황을 진단할 때 특히 쓸모가 있습니다.
반면 결과를 그대로 재현하려는 사람에게는 준비물이 가볍지 않습니다. 학습 스크립트가 단일 노드 8 GPU를 기본값으로 잡고 있고 문맥 길이 131,072에 DeepSpeed ZeRO-3 설정이라, 로컬 워크스테이션에서 돌려 볼 규모가 아닙니다. 저장소에 LICENSE 파일이 없다는 점도 함께 고려해야 합니다. 사내 파이프라인에 코드를 가져다 쓸 계획이라면 저장소 관리자에게 이용 조건을 먼저 확인하시기 바랍니다.
이 프로젝트는 벤치마크 점수를 올리는 방법을 공개하면서 동시에 그 점수를 믿지 말라고 말합니다. 저자는 공개 벤치마크가 "공정한 측정을 위한 신뢰할 만한 잣대가 더 이상 아니다" 라고 적으면서, 벤치마크를 쓰는 쪽에는 내부 평가를 더 갖추라고 권하고, 벤치마크를 만드는 쪽에는 실제 업무의 필요를 반영하는 평가를 만들어 달라고 요청합니다. 저자가 중국어권 실무자로서 중국 자국 모델(国模)의 상황을 두고 쓴 글이라는 맥락도 함께 읽을 필요가 있습니다.
Auto-BenchMax의 두 가지 합성 방식
작업의 첫 단계는 생성이 아니라 읽기입니다. 벤치마크의 채점 코드를 먼저 찾아 열고, 최종 보상이 결정론적인 규칙으로 계산되는지 아니면 심판 모델이 자유 형식 답변을 평가하는지 판정합니다. 저장소는 이 판정을 벤치마크 단위가 아니라 과제 유형 단위로 하라고 안내합니다. 한 벤치마크 안에서도 유형에 따라 채점 방식이 섞여 있을 수 있기 때문입니다.
규칙 기반 채점이면 방식 B, 만들고 나서 검증
규칙으로 채점하는 평가기는 미리 정해진 목표와 비교합니다. 데이터베이스 상태의 해시, 문자열 일치, 최종 상태에 대한 단정문이 그런 목표입니다. 비교할 대상이 먼저 있어야 하므로 정답을 앞서 만들어 두고, 그 정답을 평가기에 그대로 흘려보내 실제로 점수가 나오는지 확인한 뒤에야 과제로 채택합니다.
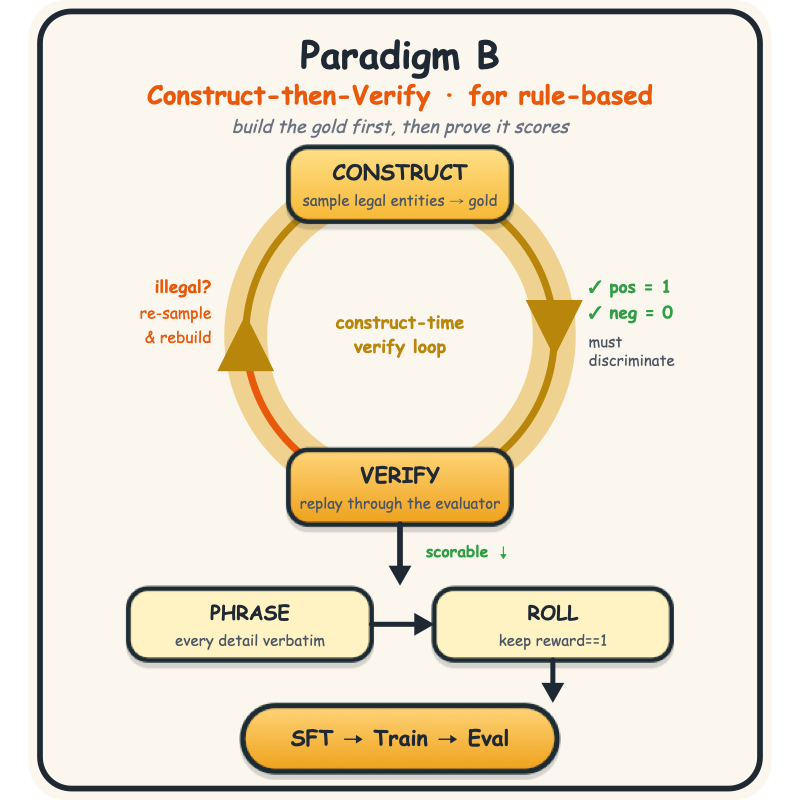
위 그림에서 순환 구조가 이 방식의 핵심입니다. 환경에서 유효한 대상을 골라 정답을 구성하고, 평가기로 되돌려 검증해 정답이 1점을 받고 오답이 0점을 받는지까지 확인합니다. 통과하지 못하면 대상을 다시 골라 처음부터 만듭니다. 검증을 통과한 뒤에야 문장을 다듬고 궤적을 실행해 보상이 1인 것만 남깁니다.
심판 모델 채점이면 방식 A, 실행하고 나서 추출
심판 모델이 자유 형식 답변을 평가하는 경우에는 미리 맞혀야 할 목표가 없습니다. 그래서 순서가 뒤집힙니다. 정답 없이 지시문과 도구만 만들어 실제 환경에서 먼저 실행하고, 강한 모델이 내놓은 답변에서 확인 가능한 사실을 추출해 정답으로 삼습니다.
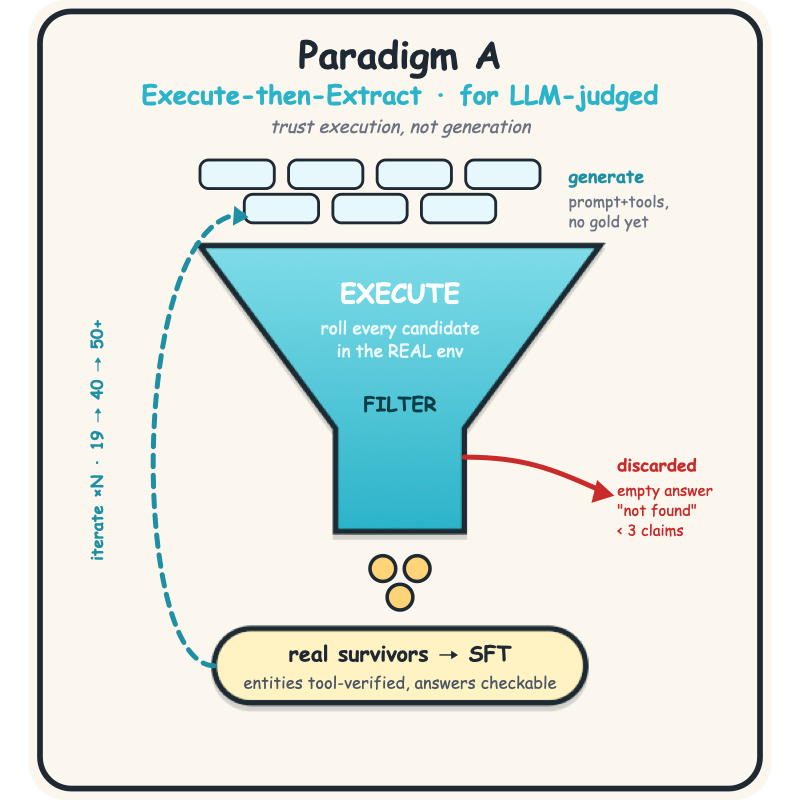
대상이 실재하는지는 별도로 검사하지 않고 실행과 걸러내기로 처리합니다. 존재하지 않는 대상을 넣으면 답변이 비거나 찾을 수 없다는 응답이 나오고, 그런 후보는 버려집니다. 위 그림의 깔때기 오른쪽에 적힌 폐기 조건이 그것으로, 빈 답변과 찾을 수 없음, 그리고 추출된 사실이 세 개 미만인 경우가 걸러집니다.
Auto-BenchMax를 자신의 벤치마크에 적용하기
저장소가 안내하는 가장 짧은 사용법은 스킬을 지원하는 에이전트에게 평가 실행 명령을 알려 주고 맡기는 것입니다. 스킬은 skills/tool-use-data-synthesis/에 들어 있고, 문서에 적힌 요청 형태는 다음과 같습니다:
My eval launch command is <your eval command>.
Read this skill and synthesize training data for this benchmark.
스킬이 평가기를 읽어 채점 방식을 판정하고, 방식 A와 B 중 하나를 고르고, 벤치마크의 구조 분포에 맞춘 뒤, 실제 궤적을 실행해 학습 데이터를 내놓는 순서로 진행됩니다.
공개된 결과를 그대로 재현하려면 저장소의 학습 코드를 씁니다. 학습 코드는 axolotl을 가져와 맞춘 것이고, 평가 환경은 Scale AI의 MCP-Atlas 벤치마크를 이 파이프라인에 맞춰 고친 것입니다. 첫 반복 데이터는 도구 호출 학습 표본 1,312건으로 저장소에 이미 들어 있습니다:
# 설정 파일에서 기준 모델 경로를 자신의 체크포인트로 바꾼 뒤 실행합니다
bash codes/axolotl/benchmax_scripts/train.sh
bash codes/axolotl/benchmax_scripts/train.sh ./benchmax_configs/qwen3_exp0.yaml
설정 파일에 이미 잡혀 있는 주요 학습 값은 문맥 길이 131,072, 표본 패킹 사용, 2 에폭, 학습률 5e-5, DeepSpeed ZeRO-3입니다. 체크포인트는 output/exp0/에 쌓이고, 실행마다 설정과 전체 로그가 temp_log/<시각>/에 복사되어 재현에 쓰입니다. GPU 수가 다르면 benchmax_scripts/train.sh의 --nproc_per_node 값을 조정하면 됩니다.
저자는 현재 범위가 도구 호출에 한정되어 좁다는 점을 한계로 인정하면서, 저장소를 계속 유지하고 순수 텍스트와 멀티모달 방향의 비슷한 파이프라인 기여를 환영한다고 밝히고 있습니다.
 Auto-BenchMax 데이터 합성 스킬 문서
 Auto-BenchMax 프로젝트 GitHub 저장소
더 읽어보기
-
The LLM Evaluation Guidebook: Hugging Face가 공개한 LLM 평가를 위한 종합적이고 실질적인 안내서
-
FrontierCode: 정확성을 넘어 "병합 가능한 코드 품질"을 측정하는 벤치마크 (feat. Cognition)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 도구를 직접 설치해 사용해보셨다면,  파이토치 한국 사용자 모임
 회원들을 위해 경험이나 팁을 댓글로 남겨주세요!
