핵심 요약
- Google은 10월 28일 Gemini 4 Carbon 발표 글에서 Argon 일반 출시 2주 만에 후속 프런티어 모델을 공개했습니다. Artificial Analysis Intelligence Index v5.0에서 59점으로 1위이고, 2위 Claude Opus 5.5와는 1점 차입니다.
- 이번 주부터는 일부 사이버 방어 기관만 쓸 수 있습니다. 개발자, 기업, 소비자 공개 날짜는 정해지지 않았고, 가격은 Argon과 같은 도입가(입력 $2, 출력 $10, 100만 토큰당)입니다.
- 사이버 방어 벤치마크는 SEC-bench Pro 88.2%, ExploitGym 54.8%(과제당 10시간 제한), CWE-bench 71.0%로 모두 1위입니다. 모두 가드레일을 끈 상태의 점수이고, 앞의 두 개는 Google이 자체 하네스로 측정했습니다.
- 평가 방법론 문서의 표 17개 항목 중 FrontierSWE 2(GPT-6 Astra)와 OSWorld-2.1(Claude Opus 5.5)은 다른 모델이 앞섭니다. Terminal-Bench 두 항목은 Argon 때와 다른 측정 출처를 씁니다.
Gemini 4 Carbon 소개
Gemini 4 Carbon 은 Google DeepMind가 Gemini 4 Argon 다음으로 내놓은 프런티어 모델로, 오래 이어지는 에이전트 작업과 사이버 보안 방어에 맞춰 만들었습니다. 다만 지금은 API로 쓸 수 없고, 선정된 사이버 방어 기관이 먼저 씁니다. 발표 글은 Google DeepMind SVP이자 Google 최고 AI 아키텍트(Chief AI Architect)인 Koray Kavukcuoglu가 썼습니다.
출시 순서는 한 달 전 Argon과 같습니다. Google은 9월 30일 Gemini 4 Argon을 발표하면서 사이버 방어 기관에 먼저 제공했습니다. 이어 10월 13일 AI Studio와 Gemini 앱 등으로 일반 출시했습니다(Carbon 발표 글이 말하는 "2주 전 출시" 가 이 날짜입니다). Carbon은 일반 출시를 기다리지 않고 방어 기관용 단계에 바로 들어갔습니다.
Google은 출시를 신중하게 진행한다며, 미국 정부의 자발적인 출시 전 모델 테스트 절차에도 참여하고 있다고 밝혔습니다. 이번 주부터 일부 사이버 방어 기관에 Carbon을 제공하고, 이후 Fairwind Program으로 신뢰할 수 있는 파트너를 단계적으로 늘린다는 계획입니다. Fairwind Program은 정부, 의료, 통신처럼 우선순위가 높은 방어자에게 프런티어 모델을 먼저 제공하는 Google의 프로그램입니다. 그 뒤 가드레일(guardrail)을 다듬어 개발자, 기업, 소비자에게 "가능한 한 빨리" 공개하겠다고 했지만 날짜는 밝히지 않았습니다.
Anthropic도 비슷한 방식을 쓰고 있습니다. Anthropic은 10월 Cyber Verification Program을 개편해 검증된 보안팀에 Mythos 5.1을 열었습니다. 사이버 능력이 높은 모델을 방어자에게 먼저 주는 출시 방식이 두 회사에서 반복되고 있습니다.
긴 에이전트 작업과 코딩: 표에서 앞선 항목과 뒤진 항목
Google에 따르면 내부 팀은 Carbon이 막다른 길을 만나도 며칠 동안 작업을 이어 가는 것을 확인했습니다. 예로 든 작업은 큰 코드베이스와 저수준 시스템에서 미묘한 버그의 근본 원인을 찾아 패치하는 일입니다. Google은 사용자 피드백을 반영해 코딩, 에이전트, 과학 작업과 풀스택 웹 개발, 멀티모달 이해를 개선했다고 밝혔습니다. 웹 개발 결과물의 품질이 좋아져 WebDev Arena에서 Elo 점수가 89점 올라 1768점으로 4위라고 합니다.
아래 그림은 Google이 공개한 전체 벤치마크 표입니다. 파란색 칸은 Carbon이 1위인 항목, 회색 칸은 다른 모델이 1위인 항목입니다. 비교 대상은 Gemini 4 Argon, OpenAI GPT-6 Astra, Anthropic Claude Opus 5.5와 Claude Fable 5.1입니다.
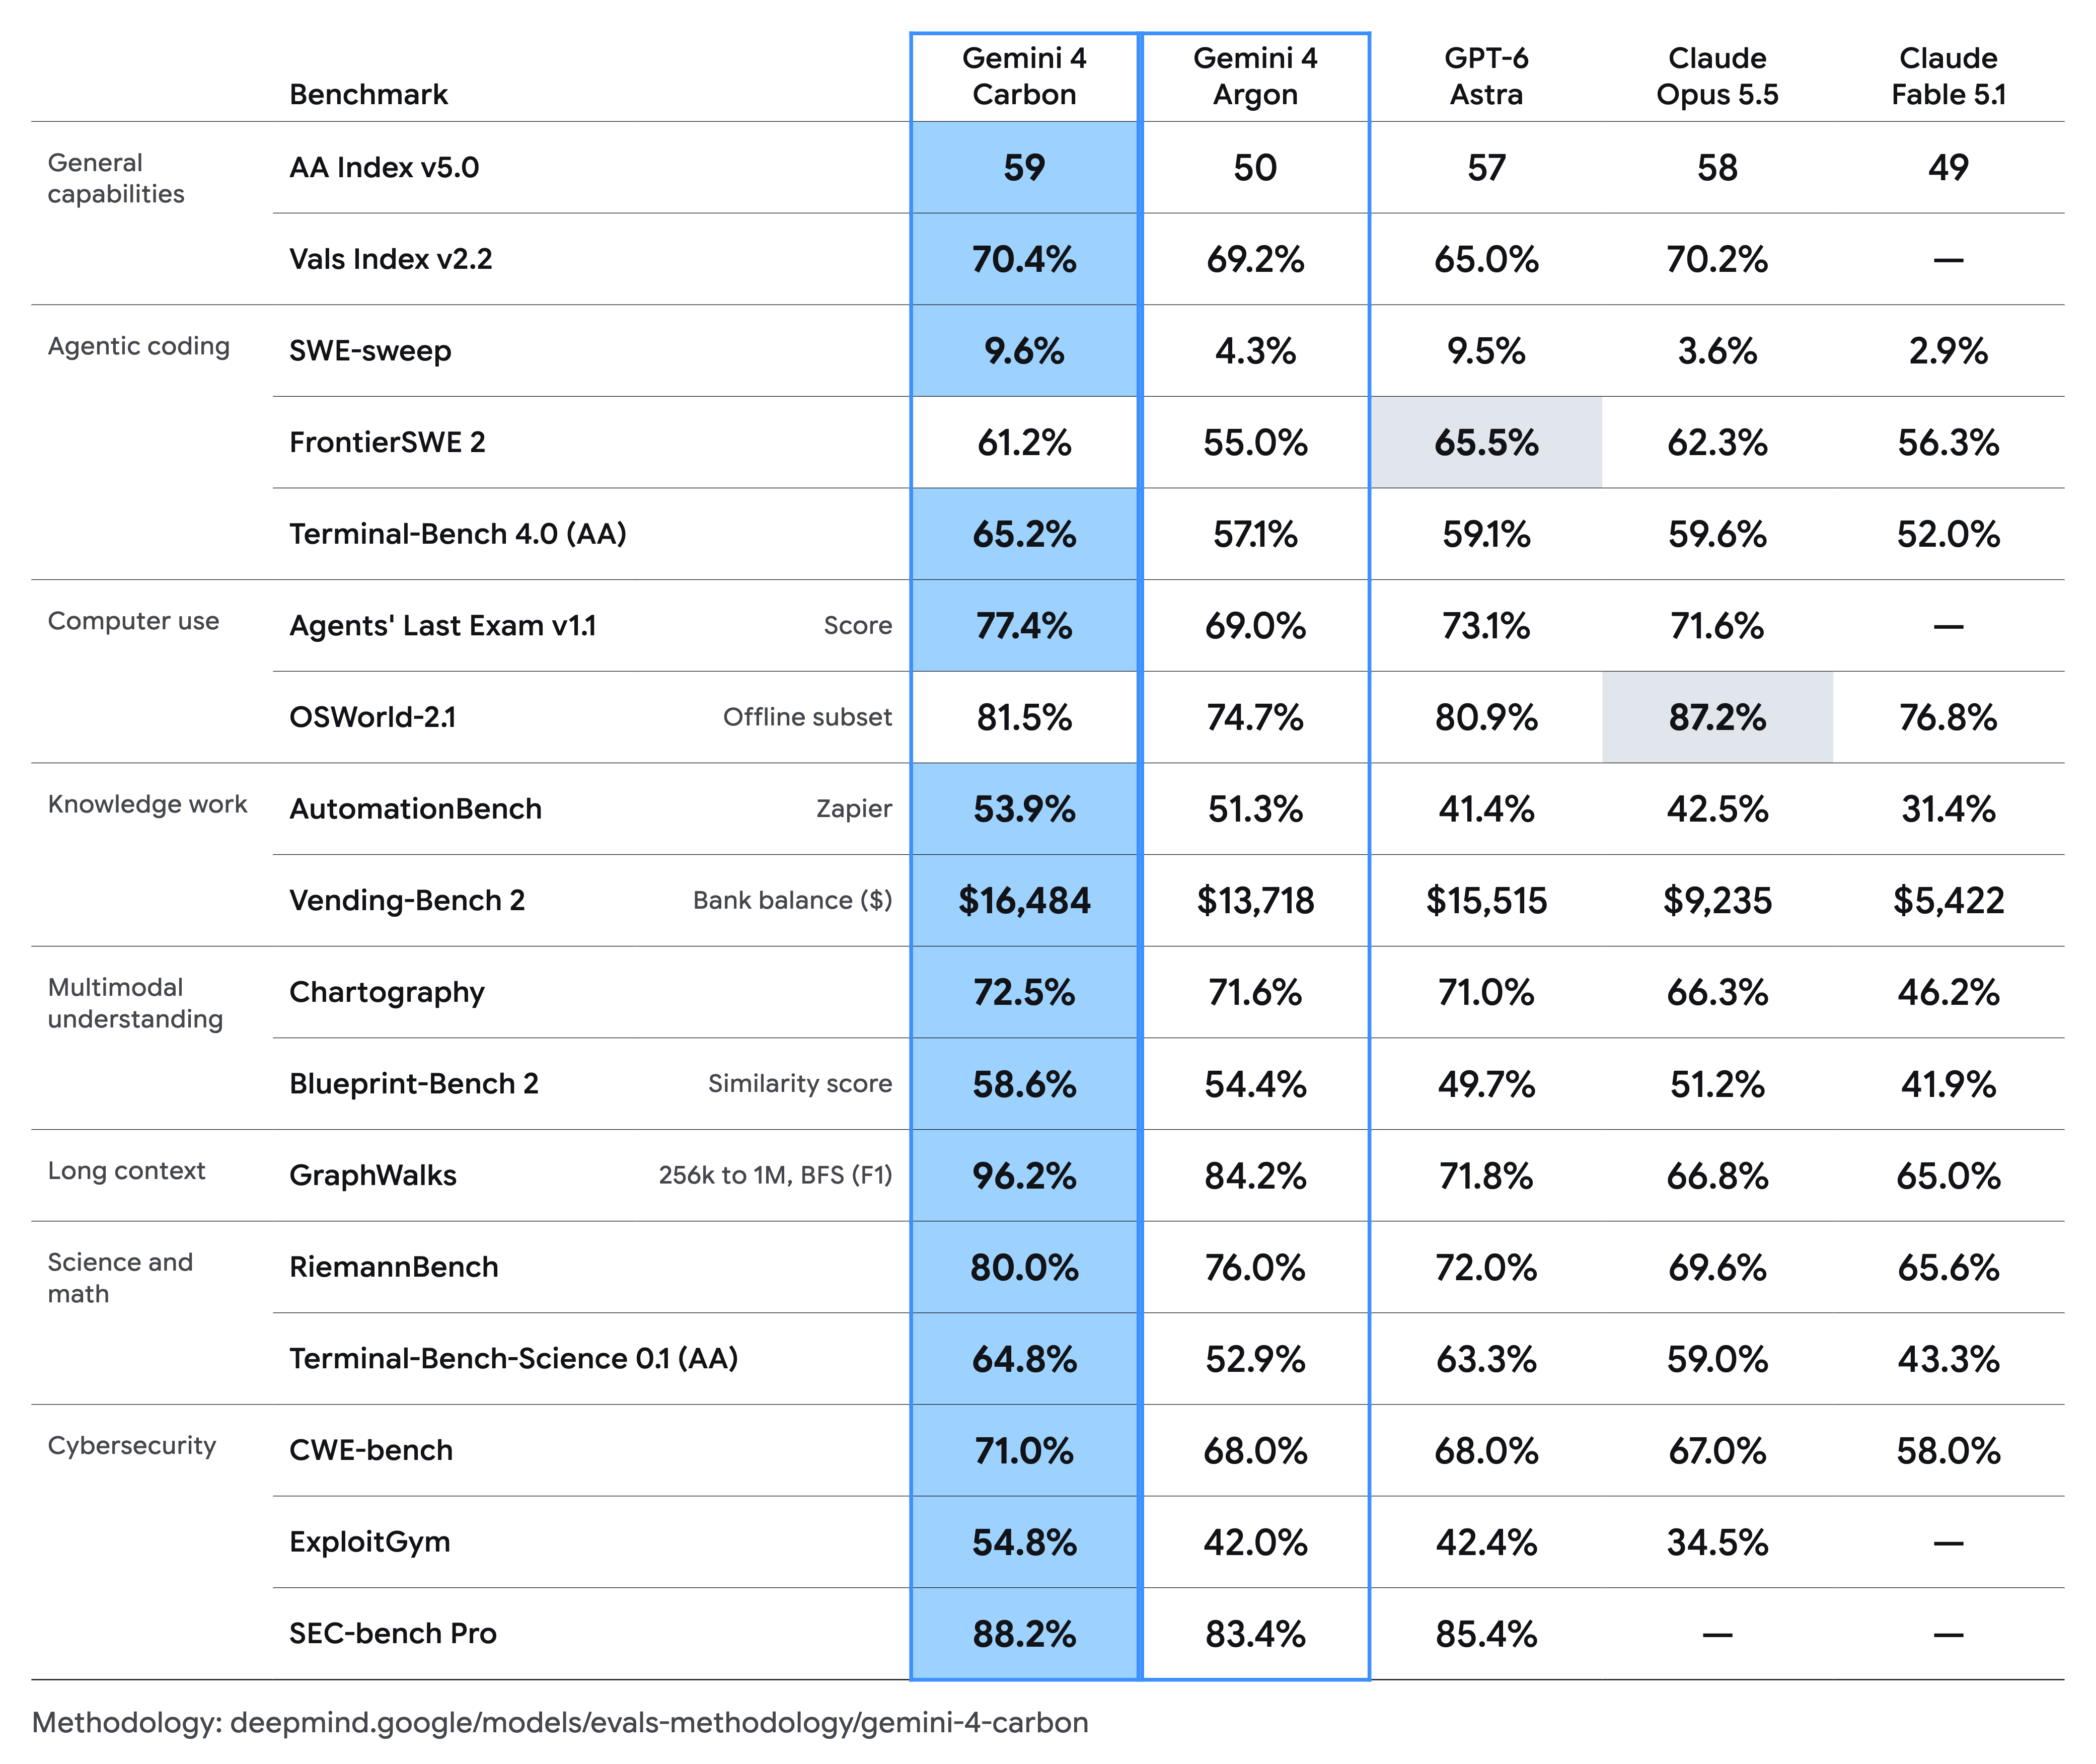
표에서 판단에 필요한 항목을 골라 정리하면 다음과 같습니다.
| 벤치마크 | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 |
| Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% |
| SWE-sweep | 9.6% | 4.3% | 9.5% | 3.6% |
| FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% |
| Terminal-Bench 4.0 (AA) | 65.2% | 57.1% | 59.1% | 59.6% |
| OSWorld-2.1 (오프라인 82개 과제) | 81.5% | 74.7% | 80.9% | 87.2% |
| Vending-Bench 2 (최종 잔고) | $16,484 | $13,718 | $15,515 | $9,235 |
| GraphWalks (256k~1M, BFS F1) | 96.2% | 84.2% | 71.8% | 66.8% |
표에서 Argon 대비 상승 폭이 큰 항목은 ExploitGym(12.8%p), 긴 컨텍스트 벤치마크 GraphWalks(12.0%p), Terminal-Bench Science 0.1(11.9%p)입니다. GraphWalks 점수는 컨텍스트 길이가 25만 6천에서 100만 토큰인 문제 200개에서 측정한 너비 우선 탐색(Breadth-First Search, BFS) 문제의 F1입니다. Carbon은 2위 GPT-6 Astra보다 24.4%p 높습니다. 다만 이 항목은 모든 모델을 Google이 직접 측정했습니다. 반대로 종합 지표의 격차는 작습니다. AA Index는 Opus 5.5와 1점, Vals Index는 0.2%p, SWE-sweep은 GPT-6 Astra와 0.1%p 차이입니다.
Carbon이 1위가 아닌 항목도 2개 있습니다. 코딩 에이전트 벤치마크인 FrontierSWE 2에서는 GPT-6 Astra(65.5%)와 Opus 5.5(62.3%)가 Carbon(61.2%)보다 높습니다. 컴퓨터 사용 벤치마크인 OSWorld-2.1에서도 Opus 5.5(87.2%)가 Carbon(81.5%)보다 5.7%p 높습니다.
Argon 발표 때의 표와 달라진 측정 출처
Argon 발표 때의 표는 Terminal-Bench 4.0과 Terminal-Bench Science 0.1에서 Argon만 Google이 직접 측정하고 나머지는 공식 리더보드 값을 썼습니다. 이번 표는 두 항목 모두 Artificial Analysis가 측정한 값(AA)을 씁니다. 그래서 Terminal-Bench 4.0의 Opus 5.5는 66.4%에서 59.6%로, Terminal-Bench Science의 GPT-6 Astra는 68.1%에서 63.3%로 바뀌었습니다.
Carbon의 두 점수(65.2%, 64.8%)는 AA 기준으로 1위이지만, Argon 표의 공식 리더보드 값(66.4%, 68.1%)보다는 낮습니다. 측정 주체와 하네스가 달라 두 출처의 숫자를 바로 비교할 수는 없지만, 출처를 어느 쪽으로 고르느냐에 따라 두 칸의 1위 표시가 달라질 수 있습니다. Vals Index도 이번 표는 v2.2 값을 씁니다. Argon 표와 비교하면 Argon은 68.9%에서 69.2%로, Opus 5.5는 67.0%에서 70.2%로 바뀌었습니다.
평가 방법론 문서의 측정 조건
함께 공개한 평가 방법론 문서에는 숫자를 읽을 때 필요한 조건이 있습니다. Carbon과 Argon 점수는 별도 표기가 없으면 Pass@1이고, Gemini API에서 가장 높은 사고(thinking) 설정으로 측정했습니다. 경쟁 모델 수치는 별도 표기가 없으면 각 제공사가 스스로 보고한 값입니다.
- SWE-sweep: Carbon은 Google이 mini-swe-agent 하네스로 직접 측정했고, 다른 모델은 공식 리더보드 값입니다.
- OSWorld-2.1: Carbon과 Argon 점수는 3회 실행 중 최고값입니다. 인터넷 없이 도는 82개 오프라인 과제만 쓰고, 부분 점수를 보고합니다.
- Agents' Last Exam v1.1: Carbon과 Argon은 5시간 제한으로 직접 측정했고, 10월 17일판 과제를 쓰고 10월 26일 업데이트는 적용하지 않았습니다. Fable 5.1은 공개 리더보드에 없어 빠졌습니다.
사이버 방어 3단계: 취약점 찾기, 공격 가능성 검증, 근본 원인 패치
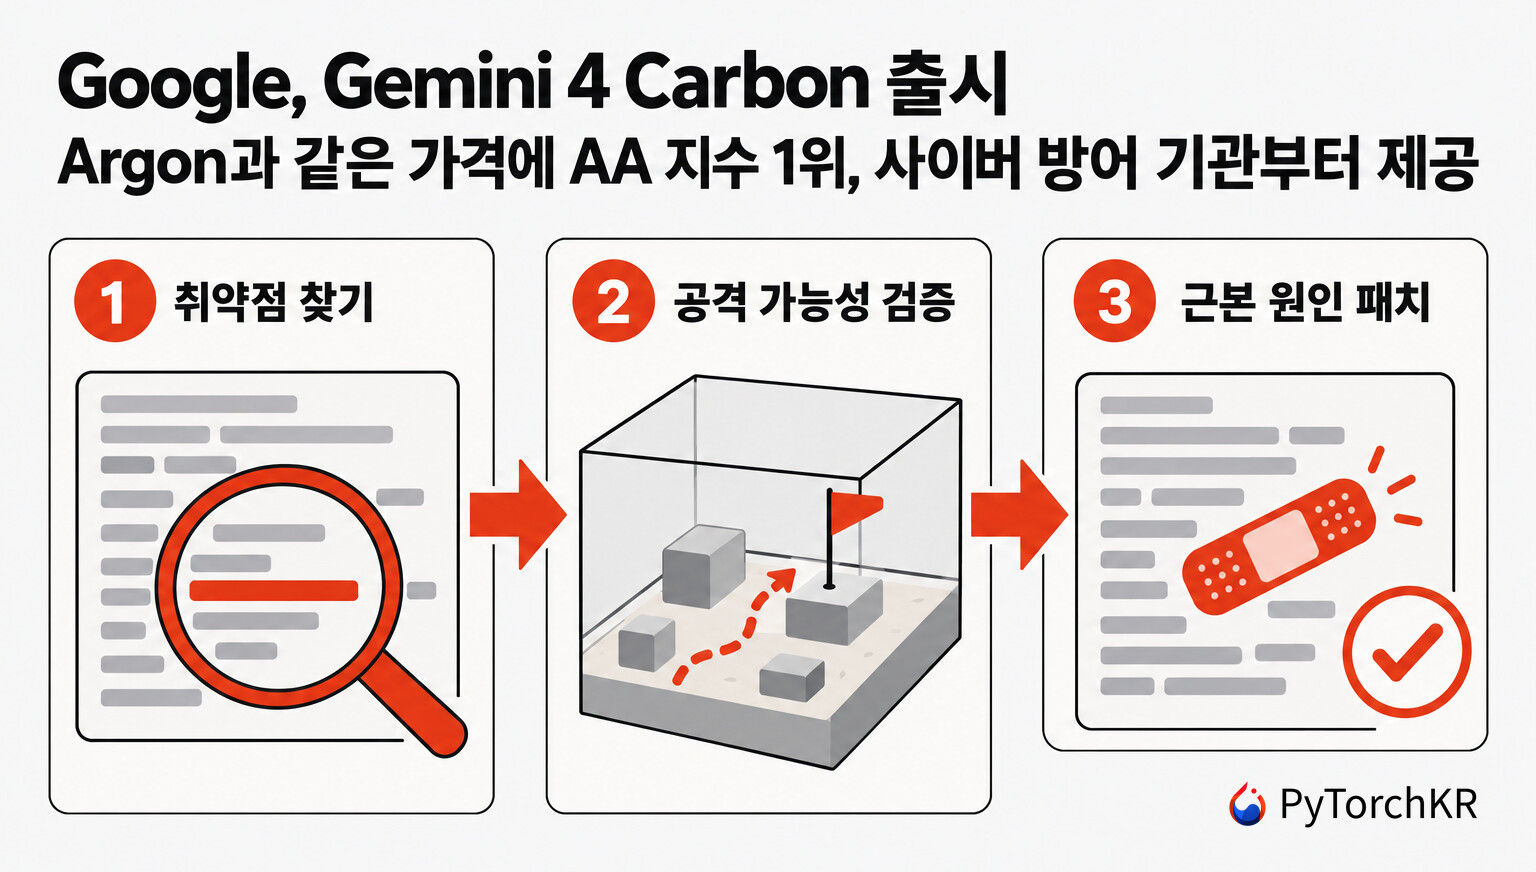
Google은 Carbon이 사이버 방어의 전체 흐름에서 최고 성능을 낸다고 설명합니다. 그 흐름은 취약점을 찾고, 실제로 공격할 수 있는지 검증하고, 근본 원인을 고치는 3단계입니다. 아래 세 벤치마크는 모두 가드레일을 끈 상태 로 평가했습니다.
취약점 찾기: SEC-bench Pro 88.2%
SEC-bench Pro는 실제 소프트웨어에 숨어 있는 취약점을 모델이 스스로 찾아내는지 측정합니다. Google은 2026년 5월판 JavaScript 엔진 분할(183개 과제)을 썼고, 과제마다 독립 시도 3회의 평균 Pass@1을 보고했습니다. 모델이 만든 개념 증명(Proof-of-Concept, PoC) 입력이 취약한 빌드는 죽이고 패치된 빌드는 죽이지 않으면 성공입니다. 둘 다 죽으면 LLM 심사자가 소스 코드를 보고 의도한 취약점 때문인지 판정합니다.
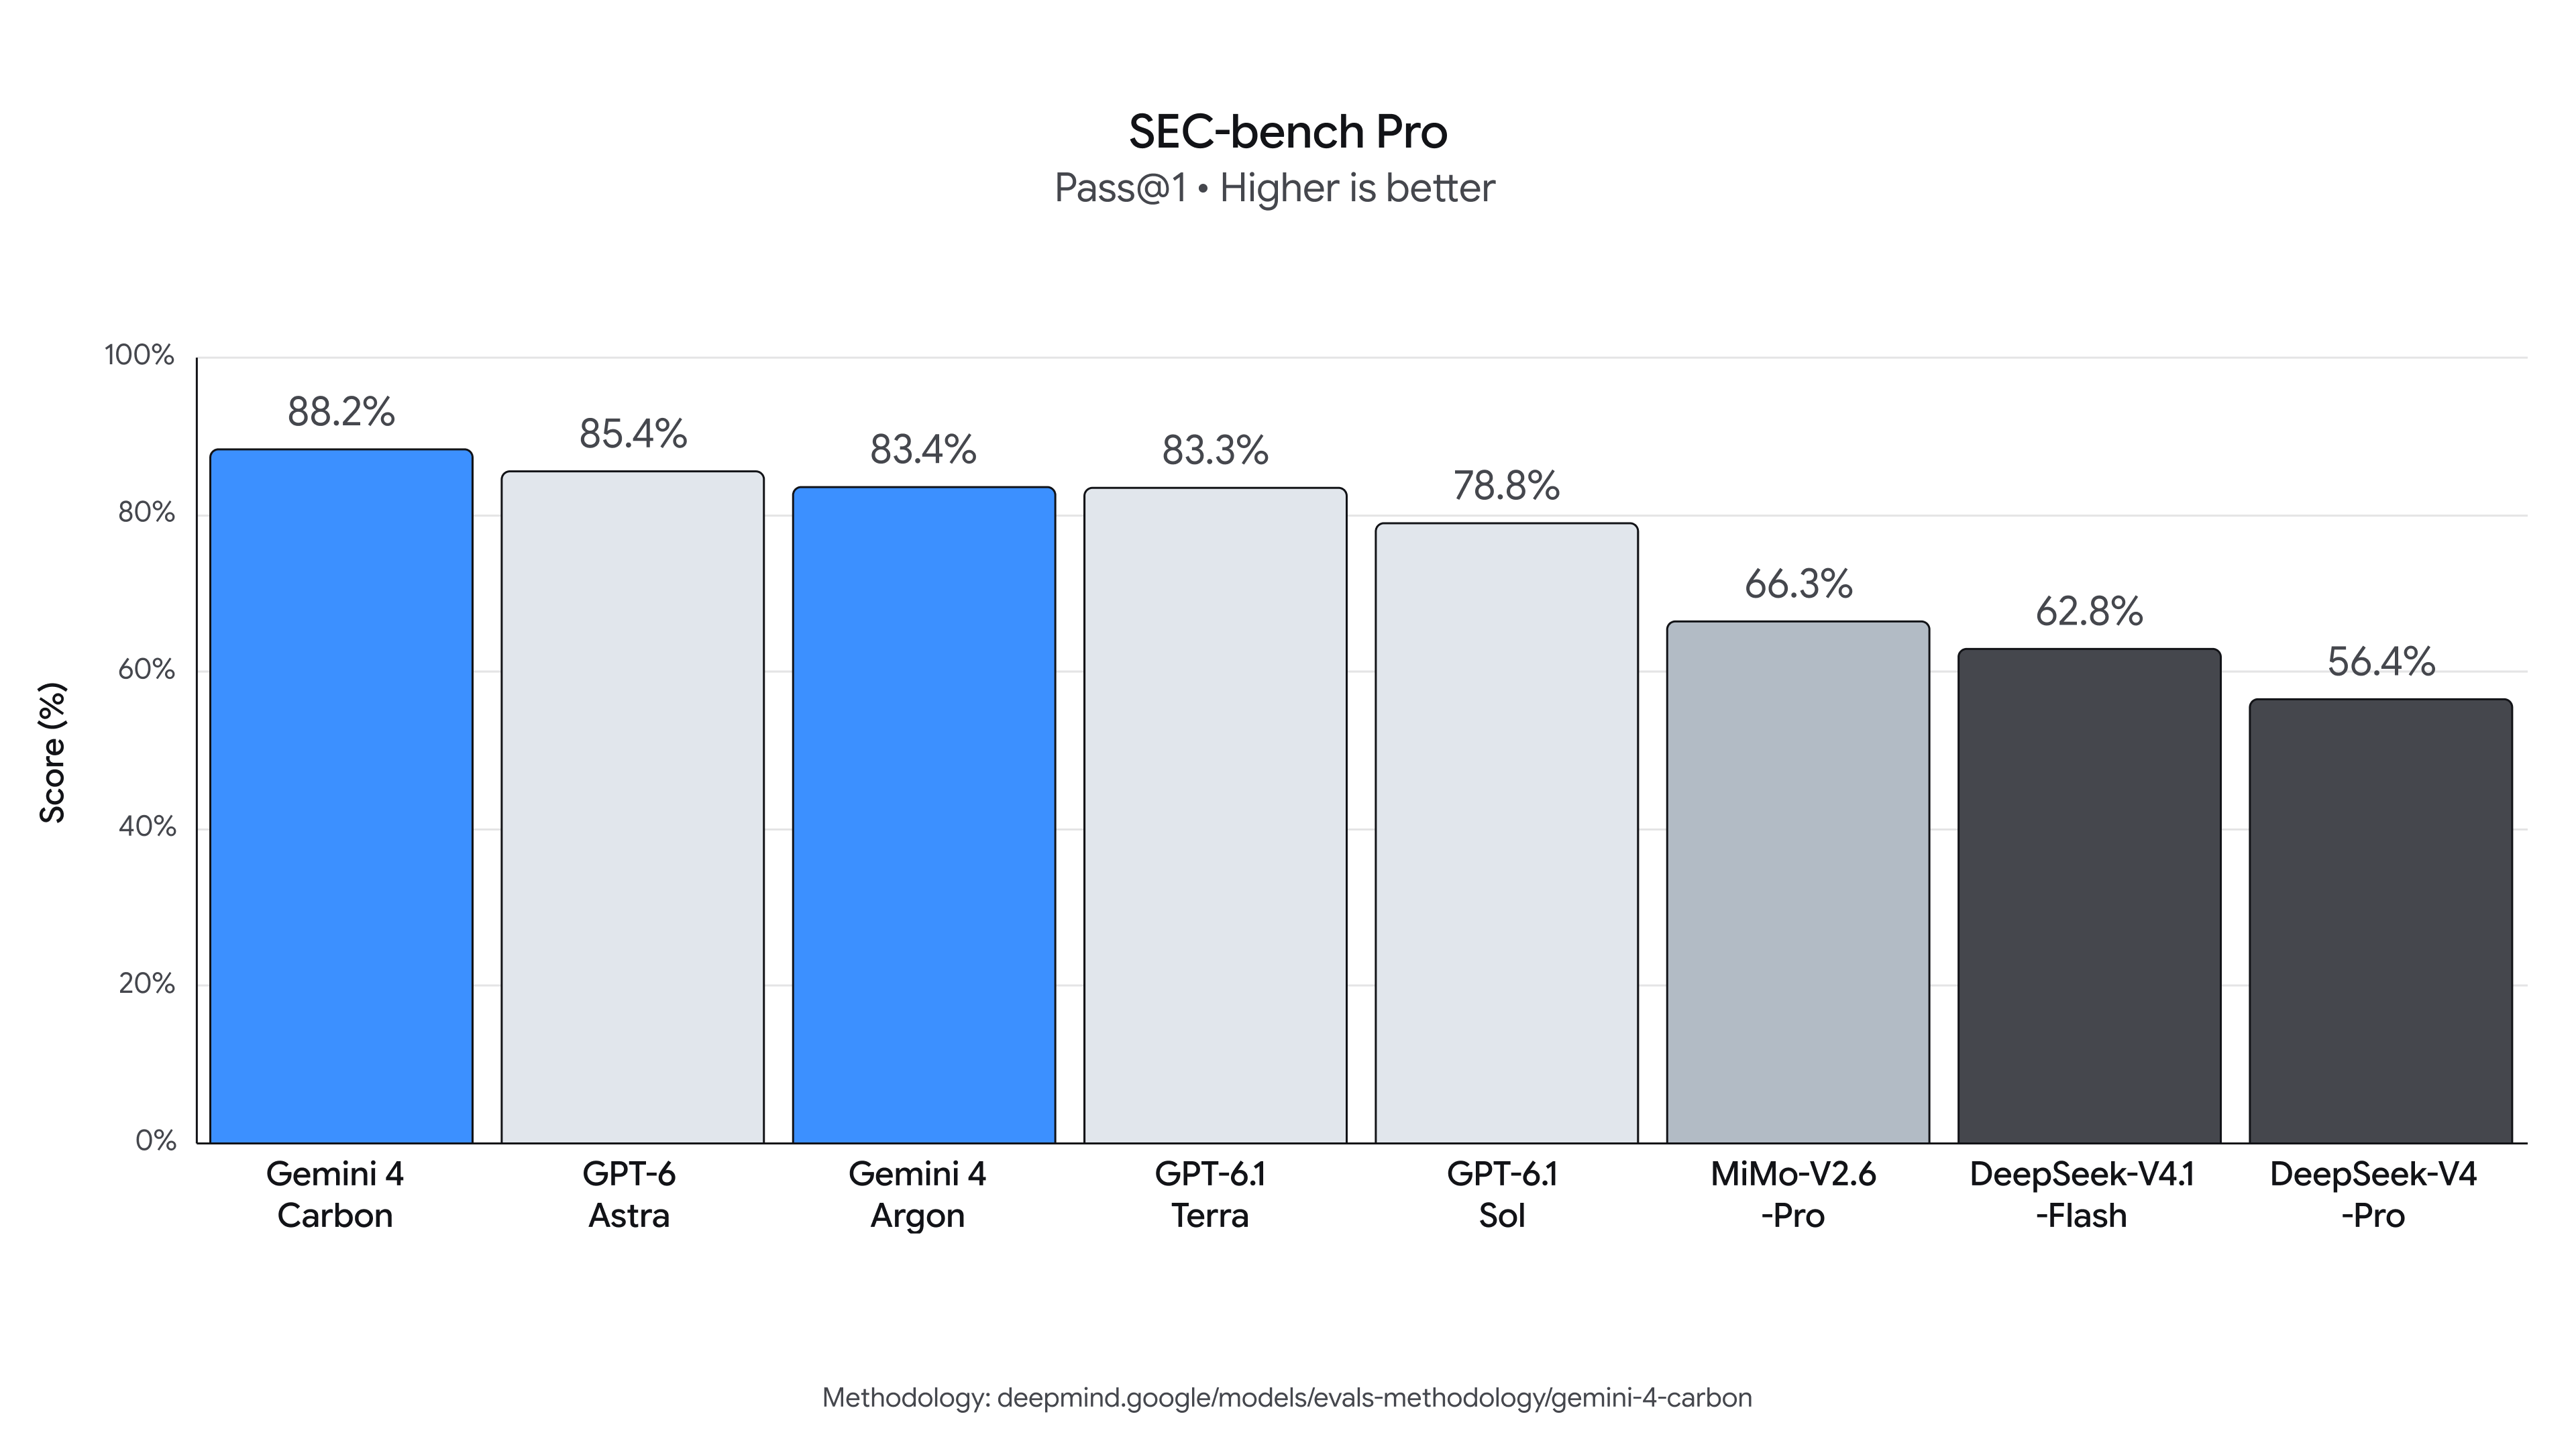
Carbon(88.2%)은 GPT-6 Astra(85.4%)보다 2.8%p 높습니다. 이 점수는 Google이 Antigravity 하네스로 직접 측정했고, 경쟁 모델 값은 각 회사의 시스템 카드와 기술 보고서에서 가져왔습니다. 또한 이 그래프와 앞의 표에는 Claude 계열 점수가 없는데, SEC-bench Pro 사이트는 안전장치 제한 때문에 최신 Claude Opus와 Mythos 결과는 제공되지 않는다고 적고 있습니다.
공격 가능성 검증: ExploitGym 54.8%
방어자는 어떤 취약점부터 고칠지, 고칠 필요가 있는지 정하려고 실제로 공격(exploit)할 수 있는지 확인합니다. Google은 이 확인을 모델에게 맡기는 방어자가 늘고 있다고 설명합니다. ExploitGym은 UC Berkeley 연구진 등이 사용자 공간 프로그램, V8 엔진, 리눅스 커널의 실제 취약점 869개로 만든 오픈소스 벤치마크입니다. Google 평가에서는 모델이 만든 공격 코드가 목표 플래그를 탈취하고, LLM 심사자가 의도한 취약점을 이용했다고 확인할 때만 성공으로 셉니다.
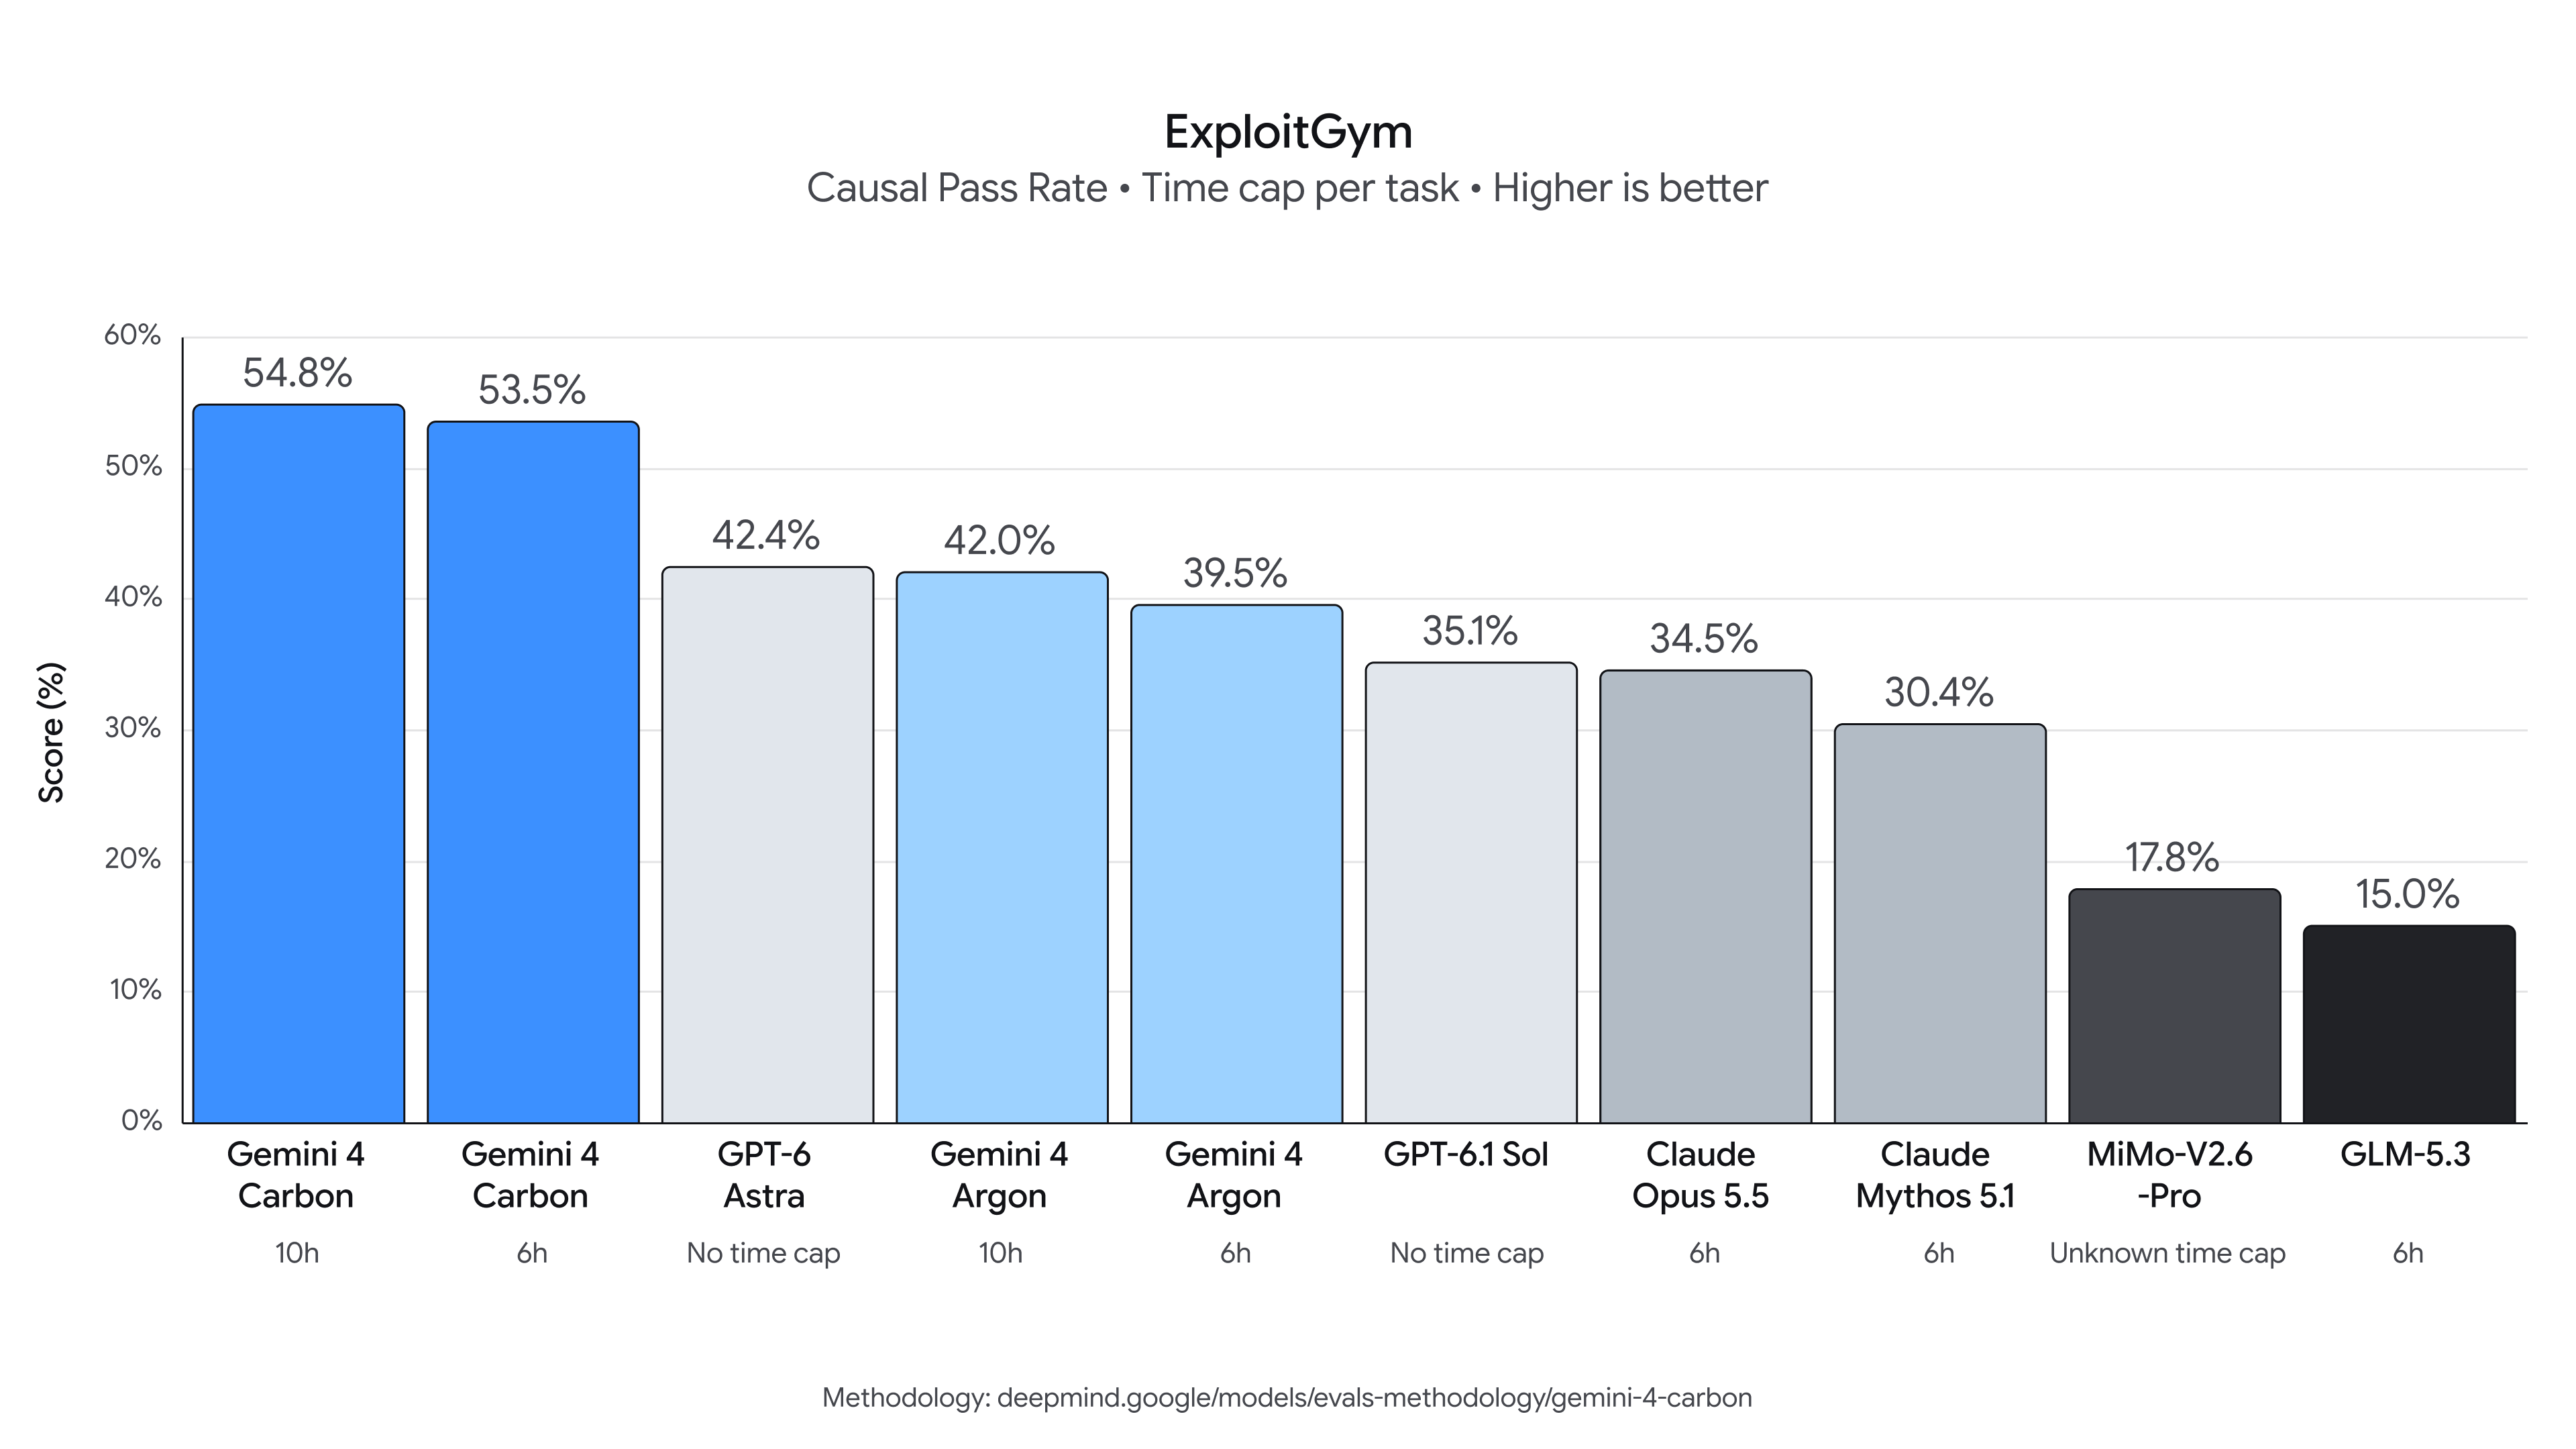
헤드라인 수치 54.8%는 과제당 시간 제한을 10시간으로 늘린 설정입니다. 기본 설정인 6시간 제한에서는 53.5%입니다. 그래프의 비교 모델은 시간 제한 조건이 서로 다릅니다. GPT-6 Astra(42.4%)와 GPT-6.1 Sol(35.1%)은 시간 제한이 없고, Claude Opus 5.5(34.5%)와 Claude Mythos 5.1(30.4%)은 6시간입니다. 같은 6시간 조건끼리 보면 Carbon은 Opus 5.5보다 19.0%p 높습니다. Google은 Carbon과 Argon을 인터넷 없이 Antigravity 하네스로 과제당 1회만 시도하게 했고, 경쟁 모델 값은 각 회사의 발표 자료에서 가져왔습니다.
근본 원인 패치: CWE-bench 71.0%
CWE-bench는 Collinear AI가 운영하는 감사와 패치 벤치마크입니다. CWE(Common Weakness Enumeration)는 소프트웨어 취약점 유형을 분류한 표준 목록입니다. 앞의 두 벤치마크와 달리 이 점수는 Collinear AI가 모든 모델을 직접 평가했습니다. 순위는 Pass@1로 정하고, 동점이면 Pass@4로 가릅니다.
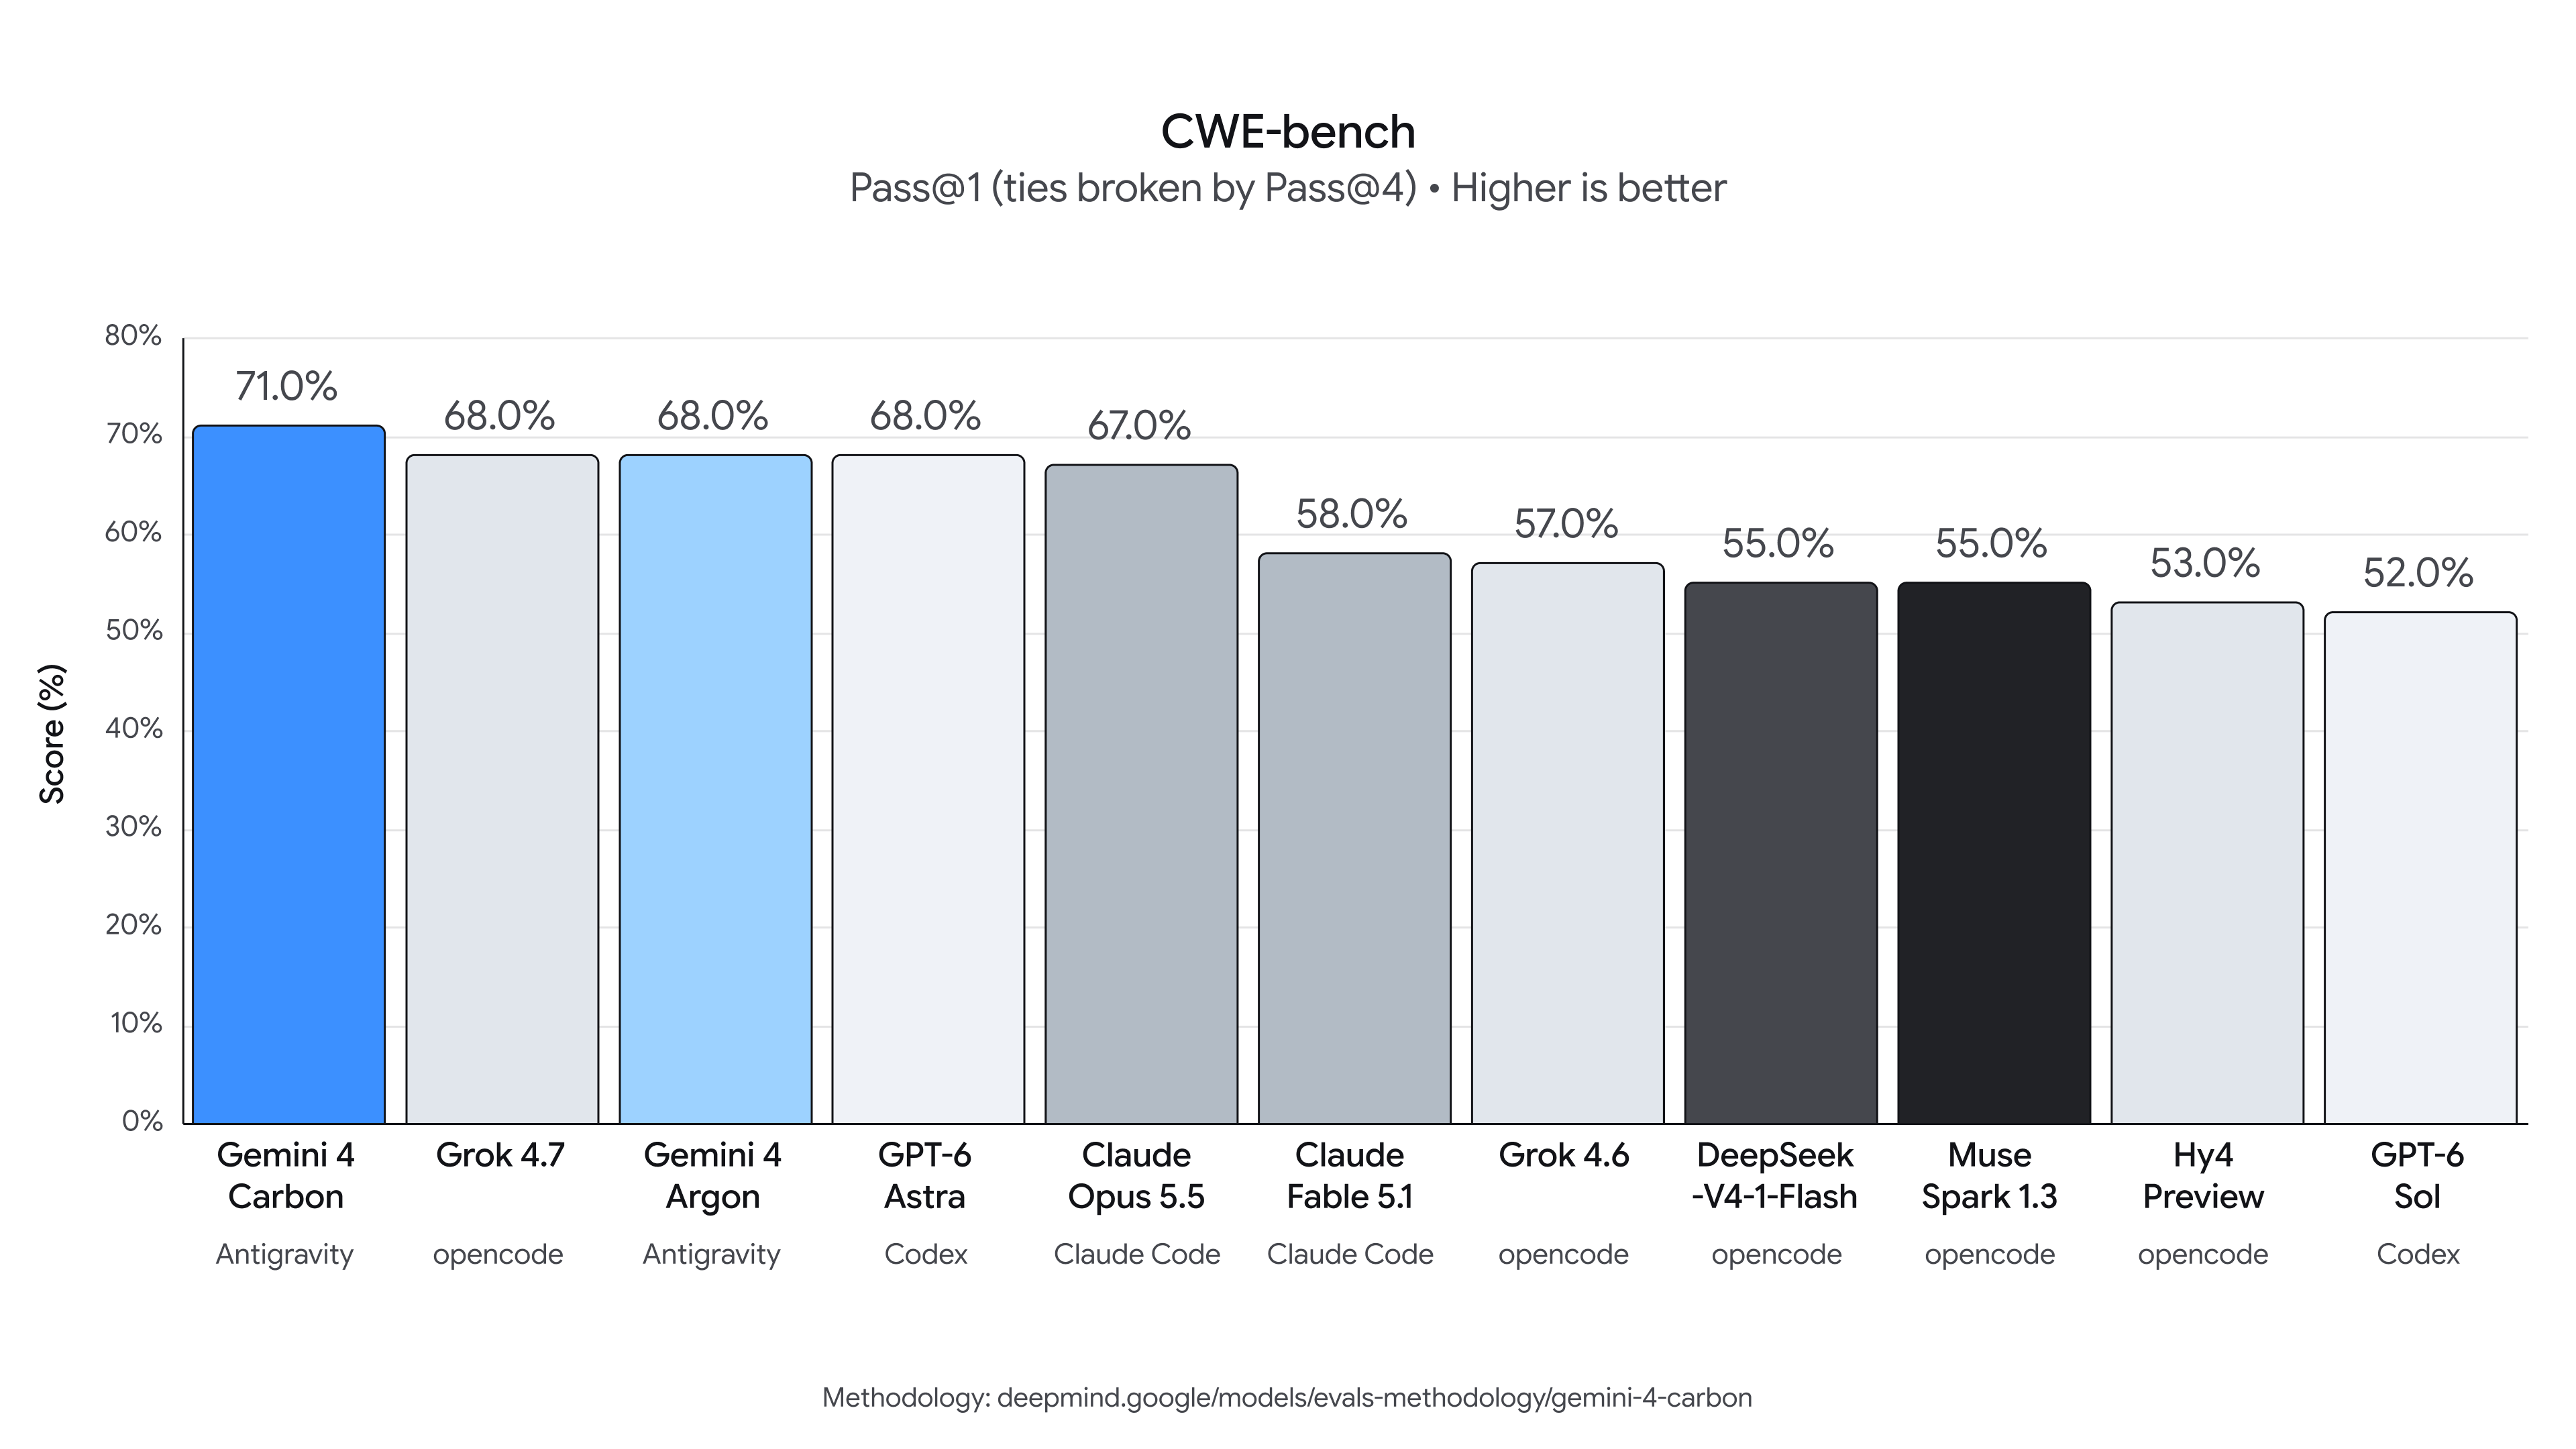
Argon 발표 때는 Grok 4.7, Argon, GPT-6 Astra가 68.0%로 공동 1위였습니다. 이번에는 Carbon이 71.0%로 단독 1위이고, 공개 리더보드에도 같은 값으로 올라 있습니다. 다만 4회 시도 기준 Pass@4는 81%로 Grok 4.7과 같습니다. 그래프 아래에 적힌 것처럼 실행 하네스는 모델마다 다릅니다. Gemini는 Antigravity, GPT 계열은 Codex, Claude 계열은 Claude Code, 나머지는 opencode로 측정했습니다.
Google 내부와 파트너가 보고한 결과
Google 내부 벤치마크에서는 Carbon이 안전한 코드를 생성하는 성공률이 Argon보다 2배 넘게 높았습니다. Chrome 팀은 고품질 패치를 만드는 작업에서 Carbon이 "다른 연구소의 대형 프런티어 모델" 보다 10배 넘게 좋았다고 보고했지만, 그 모델이 무엇인지는 밝히지 않았습니다. Google 산하 클라우드 보안 기업 Wiz도 웹 침투 테스트 벤치마크에서 Carbon이 앞선다고 밝혔습니다. 웹 침투 테스트는 Wiz가 공공 인프라의 노출을 무료로 찾아 주는 Scan for Good 활동의 핵심 능력입니다. 이 세 결과는 측정 데이터와 방법이 공개되지 않아 외부에서 확인할 수 없습니다.
정렬(Alignment) 개선: 지름길, 근거 없는 주장, 프롬프트 인젝션
Carbon은 Argon과 같은 다층 안전 스택을 씁니다. 모델 학습, 실시간 오남용 방어, 프롬프트 인젝션 방어, 사고 사슬(Chain of Thought, CoT) 모니터링을 함께 쓰는 구조입니다. Google은 Argon의 정렬 성향을 Safety and Security 보고서에 정리했고, Carbon에서는 복잡하거나 압박이 큰 작업에서 올바르게 대응하도록 한 단계 더 학습했다고 밝혔습니다. 정렬(Alignment) 은 모델이 사용자와 개발자가 의도한 방식대로 행동하는 성질입니다. 이번 발표에는 Carbon 전용 안전 보고서나 모델 카드가 포함되지 않았습니다.
지름길과 허점 이용 줄이기: Carbon은 Terminal-Bench 4.0에서 부정행위에 성공한 비율이 0.0%, 부정행위를 시도한 비율이 0.4%였고, 정확도도 함께 올랐습니다. Google 내부 팀과 함께 쓴 실제 코딩 환경에서는 심각도가 높은 비정렬(misalignment) 경보가 80% 가까이 줄었지만, 비교 기준은 밝히지 않았습니다. 참고로 Argon 때는 "모델이 자제할 동기가 없는 코딩 벤치마크" 에서 지름길이나 부정행위 시도가 2%라고 했는데, 벤치마크 이름을 밝히지 않아 이번 0.4%와 직접 비교할 수는 없습니다.
투명성과 정직성: Google 내부 테스트에서 근거 없는 주장이 Argon보다 약 2배 줄었습니다. 증거가 부족하면 꾸며 내거나 얼버무리는 대신, 방법상의 한계를 결과물에 직접 적습니다. 막힌 작업은 실행하지 않고 남은 필요 조건을 목록으로 알려 줍니다.
모호할 때 사용자와 협업: 추측하거나 억지로 진행하지 않고, 관련 자료를 찾아 서로 어긋나는 부분을 먼저 사용자에게 보여 준 뒤 행동합니다.
지나치지도 모자라지도 않게: 요청 범위를 넘어서는 행동(overreach)이 26%, 요청한 일을 덜 하는 경우(under-service)가 29% 줄었습니다. Google은 그 결과 여러 단계로 된 계획을 프로젝트 제약과 범위 안에서 끝까지 실행하는 신뢰도가 높아졌다고 설명합니다. 이 비율의 비교 기준 모델은 원문에 적혀 있지 않습니다.
프롬프트 인젝션 저항: 간접 프롬프트 인젝션(Indirect Prompt Injection, IPI) 은 웹 페이지나 문서에 숨긴 악성 지시로 에이전트의 작업을 가로채는 공격입니다. Gray Swan의 IPI 벤치마크에서 Argon은 공격 15회 기준 성공률 0.7%로 이미 1위였고, Carbon은 0.0%로 평가한 공격을 모두 막았습니다.
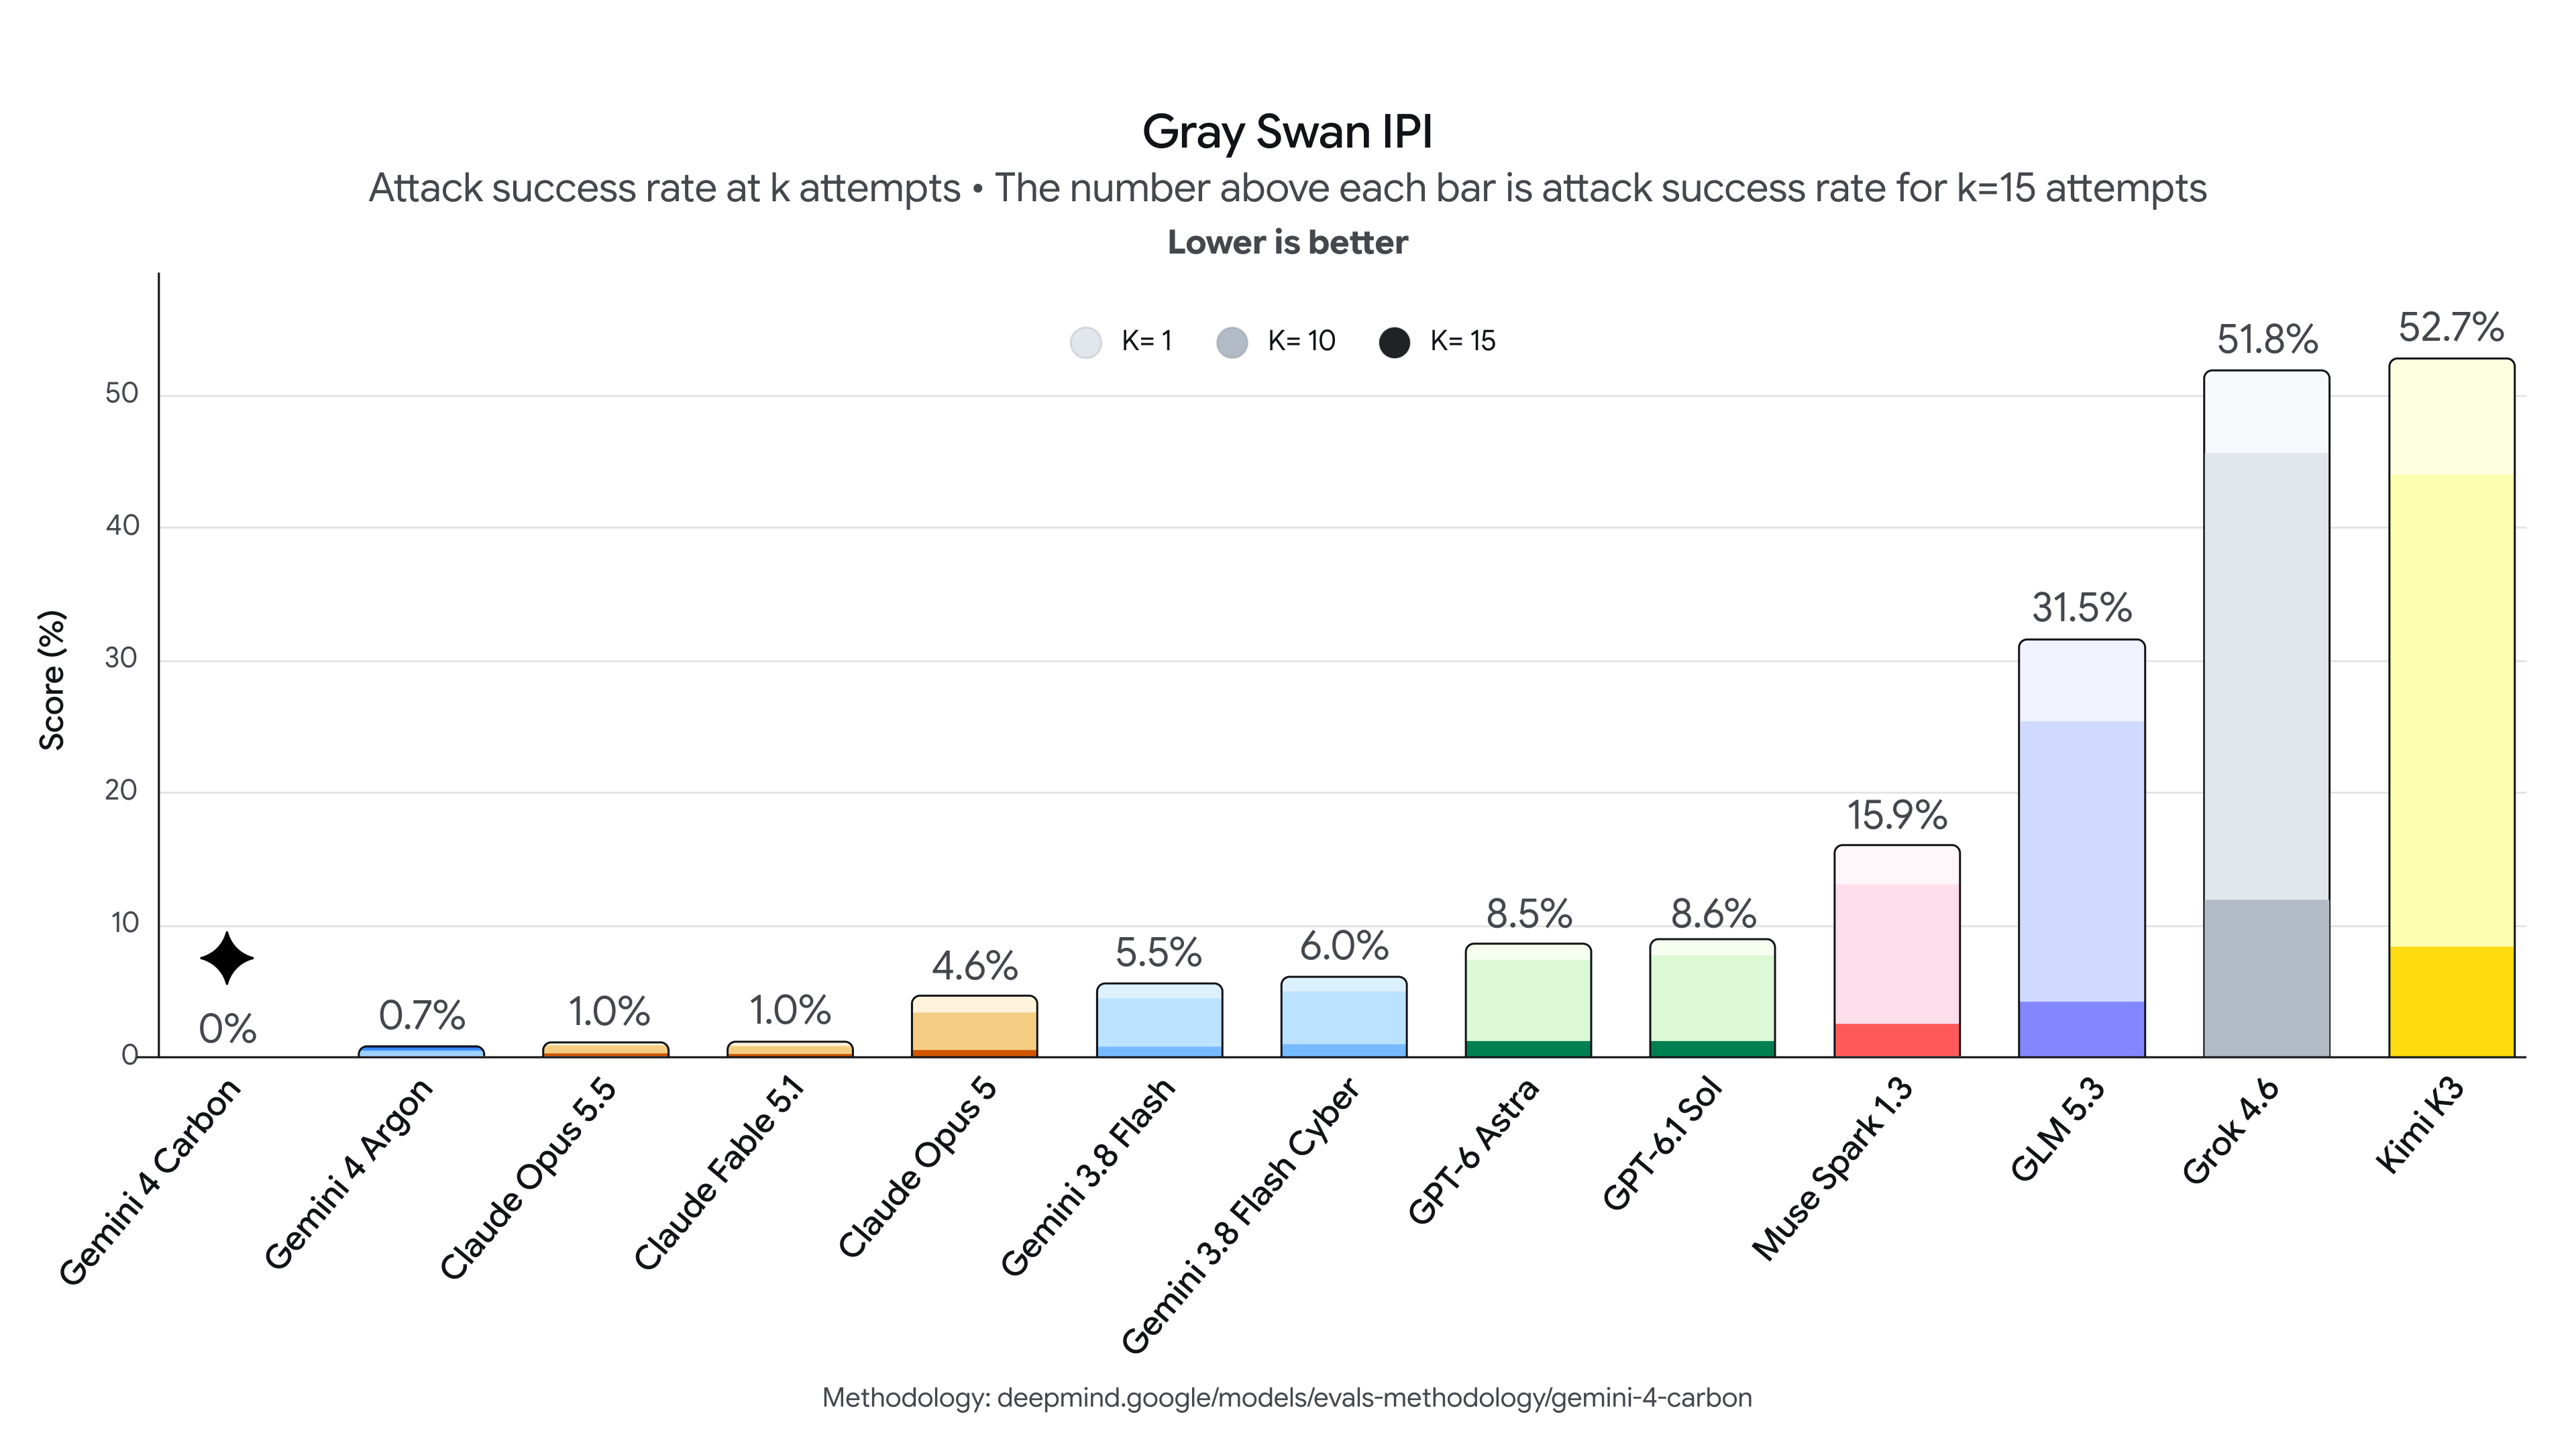
이 다섯 항목 가운데 Terminal-Bench 4.0의 부정행위 비율과 Gray Swan IPI는 공개 벤치마크에서 잰 값이고, 나머지는 Google 내부 테스트 결과입니다.
가격과 이용 방법
Carbon의 가격은 Argon과 같습니다. 출시 때는 도입가를 적용하고, 도입 기간이 끝나면 원문 각주의 정가를 적용합니다. 도입 기간의 길이는 공개하지 않았습니다.
| 구분 | 도입가 (100만 토큰당) | 도입 기간 이후 (100만 토큰당) |
|---|---|---|
| 입력 토큰 | $2 | $4 |
| 출력 토큰 | $10 | $20 |
| 캐시된 입력 토큰 | 입력 가격의 95% 할인 | 원문에 별도 표기 없음 |
현재 Carbon을 쓸 수 있는 곳은 일부 사이버 방어 기관뿐입니다. 10월 31일 기준 Fairwind Program 페이지는 아직 Argon만 제공 모델로 안내합니다. 이 프로그램에 참여하려는 기관은 Google Cloud 계정 담당 팀에 연락해야 합니다. 개발자는 Carbon이 공개될 때까지 10월 13일부터 Gemini API 유료 등급에서 쓸 수 있는 Argon을 쓸 수 있습니다.
 Gemini 4 Carbon 소개 블로그
 Gemini 4 Carbon 평가 방법론 문서 (PDF)
 Fairwind Program 홈페이지
더 읽어보기
-
Google, Gemini 4 Argon 출시: 출력 한도 1M 토큰, 일반 출시에 앞서 사이버 방어 기관에 먼저 제공
-
Anthropic, Cyber Verification Program 3단계 개편: 검증된 보안팀에 Mythos 5.1 개방
-
OpenAI DevDay 2026 발표 25가지 총정리: 상시 에이전트 dots부터 GPT-6.1 Sol, 플러그인 확장까지
-
OpenAI GPT-6 Astra 출시: 사이버보안 Critical 등급 첫 도달과 낮아진 CoT 모니터링 가능성
-
Anthropic, Claude Opus 5.5 출시: Fable 5.1급 성능에 Opus 5보다 40% 낮은 실행 비용
-
Artificial Analysis가 공개한 코딩 에이전트 벤치마크: 모델 + 하네스의 조합으로 평가한 벤치마크 결과
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
