핵심 요약
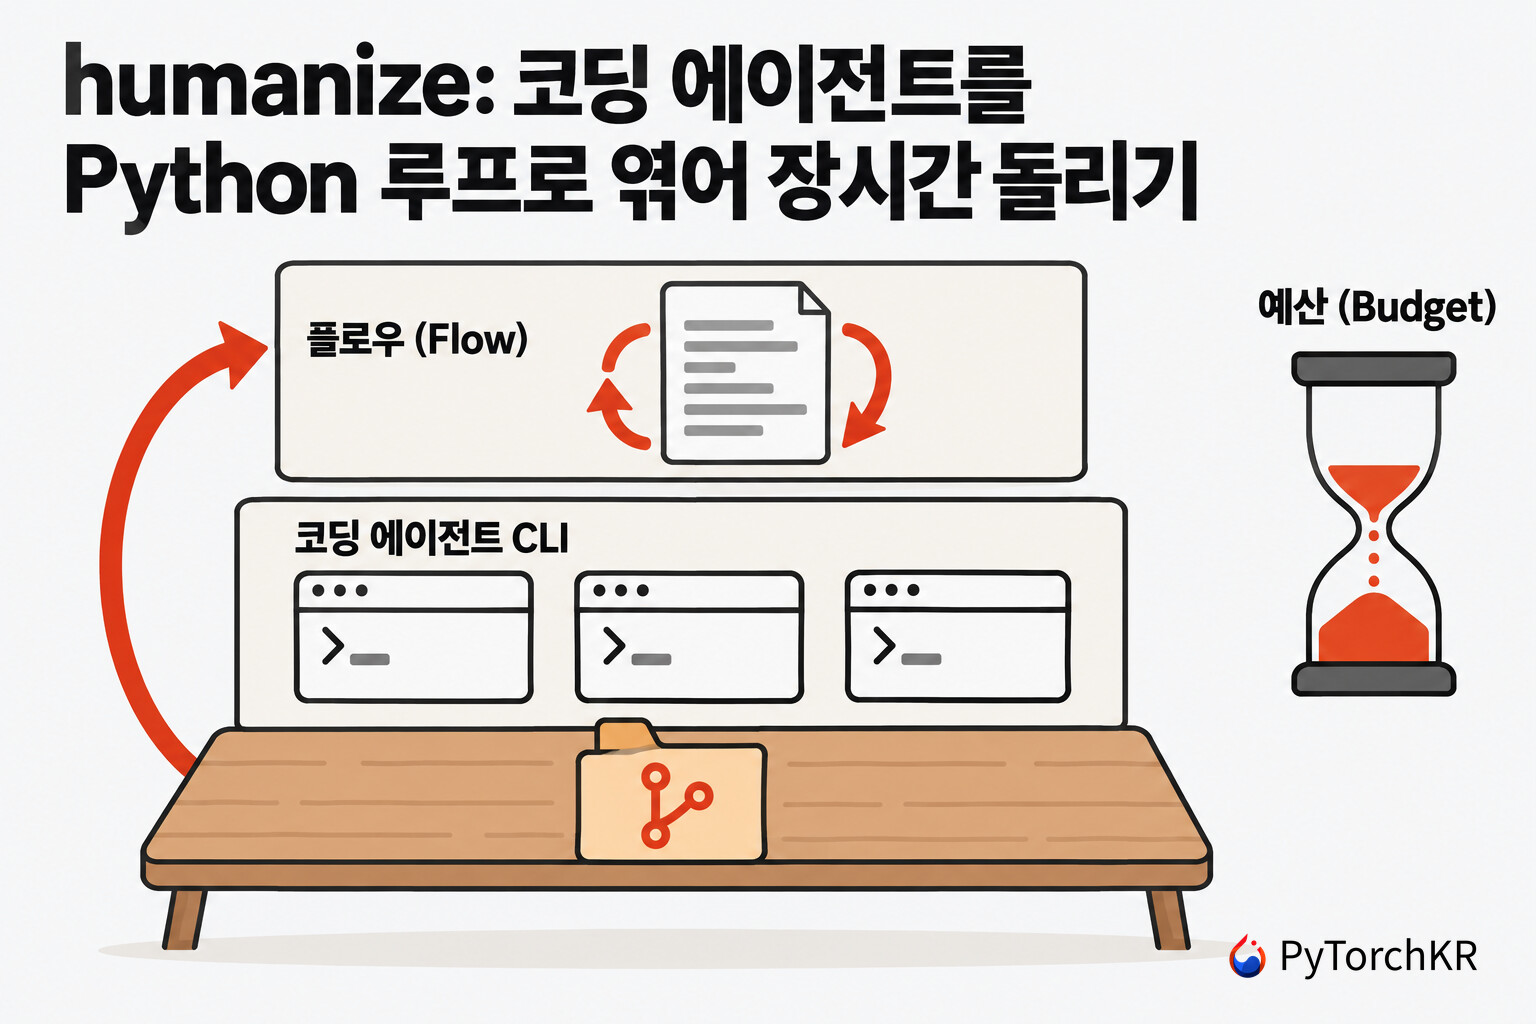
- humanize는 Claude Code, Codex 같은 코딩 에이전트 CLI를 직접 대체하지 않고, 사람이 Python으로 작성한 루프(플로우, flow)에 따라 이 CLI들에게 턴을 차례로 맡기며 실행 전체를 기록하는 런타임(runtime)입니다.
- 한 에이전트를 매 라운드 새 세션으로 반복시키는
ralph_loop, 작업자와 별도의 검토자를 붙이는rlar, 세 갈래를 동시에 실행하는parallel_flame_chase등 14종의 플로우를 문서화해 두었고, 역할마다 다른 CLI와 모델을 지정할 수 있습니다. chat을 뺀 모든 플로우는 시간, 비용, 출력 토큰 중 하나 이상의 예산이 있어야 실행되며, 가장 먼저 소진된 한도가 실행을 멈춥니다.- 모든 에이전트는 승인 절차 없이 파일을 고치고 명령을 실행하고 커밋하므로, 개발팀은 실험용 저장소에서 시작하라고 안내합니다. 역할별 권한은 Linux의 Landlock(커널 5.13 이상)과 macOS의 Seatbelt로 강제됩니다.
humanize 소개
코딩 에이전트에게 몇 시간짜리 작업을 맡기면 대화가 길어질수록 컨텍스트가 무거워지고, 에이전트가 스스로 "다 했다"고 판단한 시점과 실제로 끝난 시점이 어긋나는 일이 잦습니다. 그래서 같은 프롬프트를 셸 while 루프로 계속 다시 넣는 Ralph 루프나, 한 모델이 만든 결과를 다른 모델에게 검토시키는 방식이 실무에서 쓰여 왔지만, 대개는 스크립트와 플러그인으로 흩어져 있어 비교하거나 다시 실행하기 어렵습니다. 이번에 소개하는 humanize는 이런 루프를 Python 함수로 작성하게 하고, 그 루프를 이미 로그인해 둔 코딩 에이전트 CLI 위에서 실행해 주는 Humanfia 팀의 에이전트 플로우 실행기입니다.
humanize에서 작업 방식은 플로우(flow) 라는 Python 코드로 정의됩니다. 플로우는 어떤 역할의 에이전트가 몇 명 필요한지, 각자에게 무엇을 물을지, 언제 멈출지를 선언하고, humanize는 그 선언에 따라 세션을 열고 턴을 실행하며 예산을 지키고 실행 기록을 남깁니다. 개발팀은 humanize가 모델도, API 클라이언트도, 코딩 에이전트도 아니라고 밝히고 있습니다. humanize에는 자체 API 키가 없고 모델 제공자와 직접 통신하지도 않으며, 사용자가 구독이나 키로 로그인해 둔 claude, codex 같은 CLI를 사람이 쓰듯 실행하고 그 결과를 읽습니다.
humanize는 PolyArch/humanize라는 Claude Code 플러그인에서 출발했습니다. 이 플러그인은 Claude가 구현하고 Codex가 검토하는 RLCR(Ralph-Loop with Codex Review) 루프를 제공했고, humanize는 이 루프를 humanize1 플로우로 옮기면서 Claude Code 밖의 독립 런타임이 되었습니다. 명령어 이름은 hmz이고 Python 3.12 이상이 필요하며, 터미널 인터페이스(hmz), 한 줄 실행(hmz exec), Python SDK(hmz.sdk) 세 가지 방식으로 같은 플로우를 실행할 수 있습니다. 문자열을 사람이 읽기 좋게 바꿔 주는 Python 라이브러리 humanize나, AI가 쓴 글을 사람이 쓴 것처럼 다듬는 이른바 휴머나이저 도구와는 관계가 없습니다.
humanize vs. Humanize 1 플러그인과 셸 Ralph 루프
humanize가 기존에 쓰이던 두 가지 방식과 어떻게 다른지는 아래 표로 정리할 수 있습니다. 셸 Ralph 루프는 Ralph Playbook에서 소개한 것처럼 같은 프롬프트를 반복해서 에이전트에 넣는 방식을 말합니다:
| 항목 | humanize | Humanize 1 플러그인 | 셸 Ralph 루프 |
|---|---|---|---|
| 형태 | 독립 실행 런타임 (hmz) |
Claude Code 플러그인 | while 루프 스크립트 |
| 루프 정의 | Python 플로우, 문서화된 14종 + 직접 작성 | RLCR 고정 (아이디어, 계획, 구현과 검토) | 프롬프트 한 개 반복 |
| 에이전트 | 역할마다 12종 백엔드 중 선택, ACP CLI 추가 가능 | Claude 구현, Codex 검토 | 한 CLI |
| 종료 조건 | 예산 필수 + 플로우별 조건 (검토자 승인, 연속 실패 등) | 검토자가 남은 문제 없음 판정, 최대 반복 | 사람이 멈출 때까지 |
| 실행 기록 | 모든 에이전트의 턴과 도구 호출을 Perfetto 트레이스 하나로 | .humanize/rlcr/ 아래 라운드별 요약과 리뷰 |
CLI 로그 |
Humanize 1 사용자는 humanize1:gen-idea, humanize1:gen-plan, humanize1:rlcr 세 플로우로 같은 단계를 이어 갈 수 있고, 각 단계에 다른 모델을 배정할 수 있습니다. 실행 결과도 플러그인과 같은 .humanize/rlcr/<timestamp>/ 위치에 같은 형식으로 남으므로 기존 humanize monitor rlcr 명령으로 읽을 수 있습니다. 반대로 플러그인의 codex review --base 호출은 검토자로 지정한 아무 에이전트에게 같은 [P0-9] 형식의 지적을 요청하는 프롬프트로 바뀌었고, 구현 중에 Codex에게 바로 묻던 /humanize:ask-codex는 라운드 요약에 질문을 적어 검토자가 답하는 방식으로 바뀌었습니다.
Humanfia 팀은 이런 작업자와 검토자 구성의 효과를 보여 주는 자체 측정치도 공개했습니다. ProgramBench 실험 글에 따르면 단독으로는 문제의 0%(Opus-4.8)와 0.5%(GPT-5.5)를 푸는 두 모델을, Opus-4.8이 구현하고 GPT-5.5가 검토하는 루프로 묶었을 때 3.5%를 풀었습니다(같은 글에 적힌 보고된 최고 기록은 Opus-5의 4.5%). 다만 이 값은 4시간 예산에서 끊은 중간 집계이고, 후반 라운드에서도 점수가 라운드당 약 1.2%씩 오르던 중이었다고 Humanfia 팀 스스로 밝히고 있어, 루프 구성의 최종 효과로 읽기는 이릅니다.
humanize를 사용하면 좋을 사용자
humanize는 Claude Code, Codex 등 여러 코딩 에이전트 구독을 이미 가지고 있고, 테스트 통과나 벤치마크 수치처럼 결과를 기계적으로 확인할 수 있는 작업을 몇 시간에서 며칠 단위로 맡기려는 개발자에게 맞습니다. 서로 다른 모델이 번갈아 작업하거나 서로를 검토하게 하는 실험을 해 보고 싶은 경우에도, 역할별로 CLI와 모델만 바꿔 같은 플로우를 다시 실행할 수 있다는 점이 유용합니다. 루프를 직접 설계하려는 사용자는 실제 모델 호출 없이 가짜 에이전트로 플로우를 테스트하는 기능도 함께 쓸 수 있습니다.
에이전트의 모든 파일 수정과 명령 실행을 하나씩 승인하고 싶은 팀에게는 humanize가 적절한 선택지가 아닙니다. 승인 절차를 다시 켜는 옵션이 없고, 보호 수단은 실행 전에 플로우가 선언한 권한뿐입니다. 또한 현재 버전이 0.1.0이고 GitHub 저장소에서 직접 설치하는 초기 단계 프로젝트이므로, 이를 감안해 살펴보시기 바랍니다.
humanize의 동작 구조
humanize의 구성 요소는 아래 그림처럼 네 층으로 나뉩니다. 위에서부터 Flows(무엇을 시킬지), humanize(실행과 기록), Coding agents(실제로 모델을 부르는 CLI), Environment(작업이 이루어지는 위치) 순서입니다:
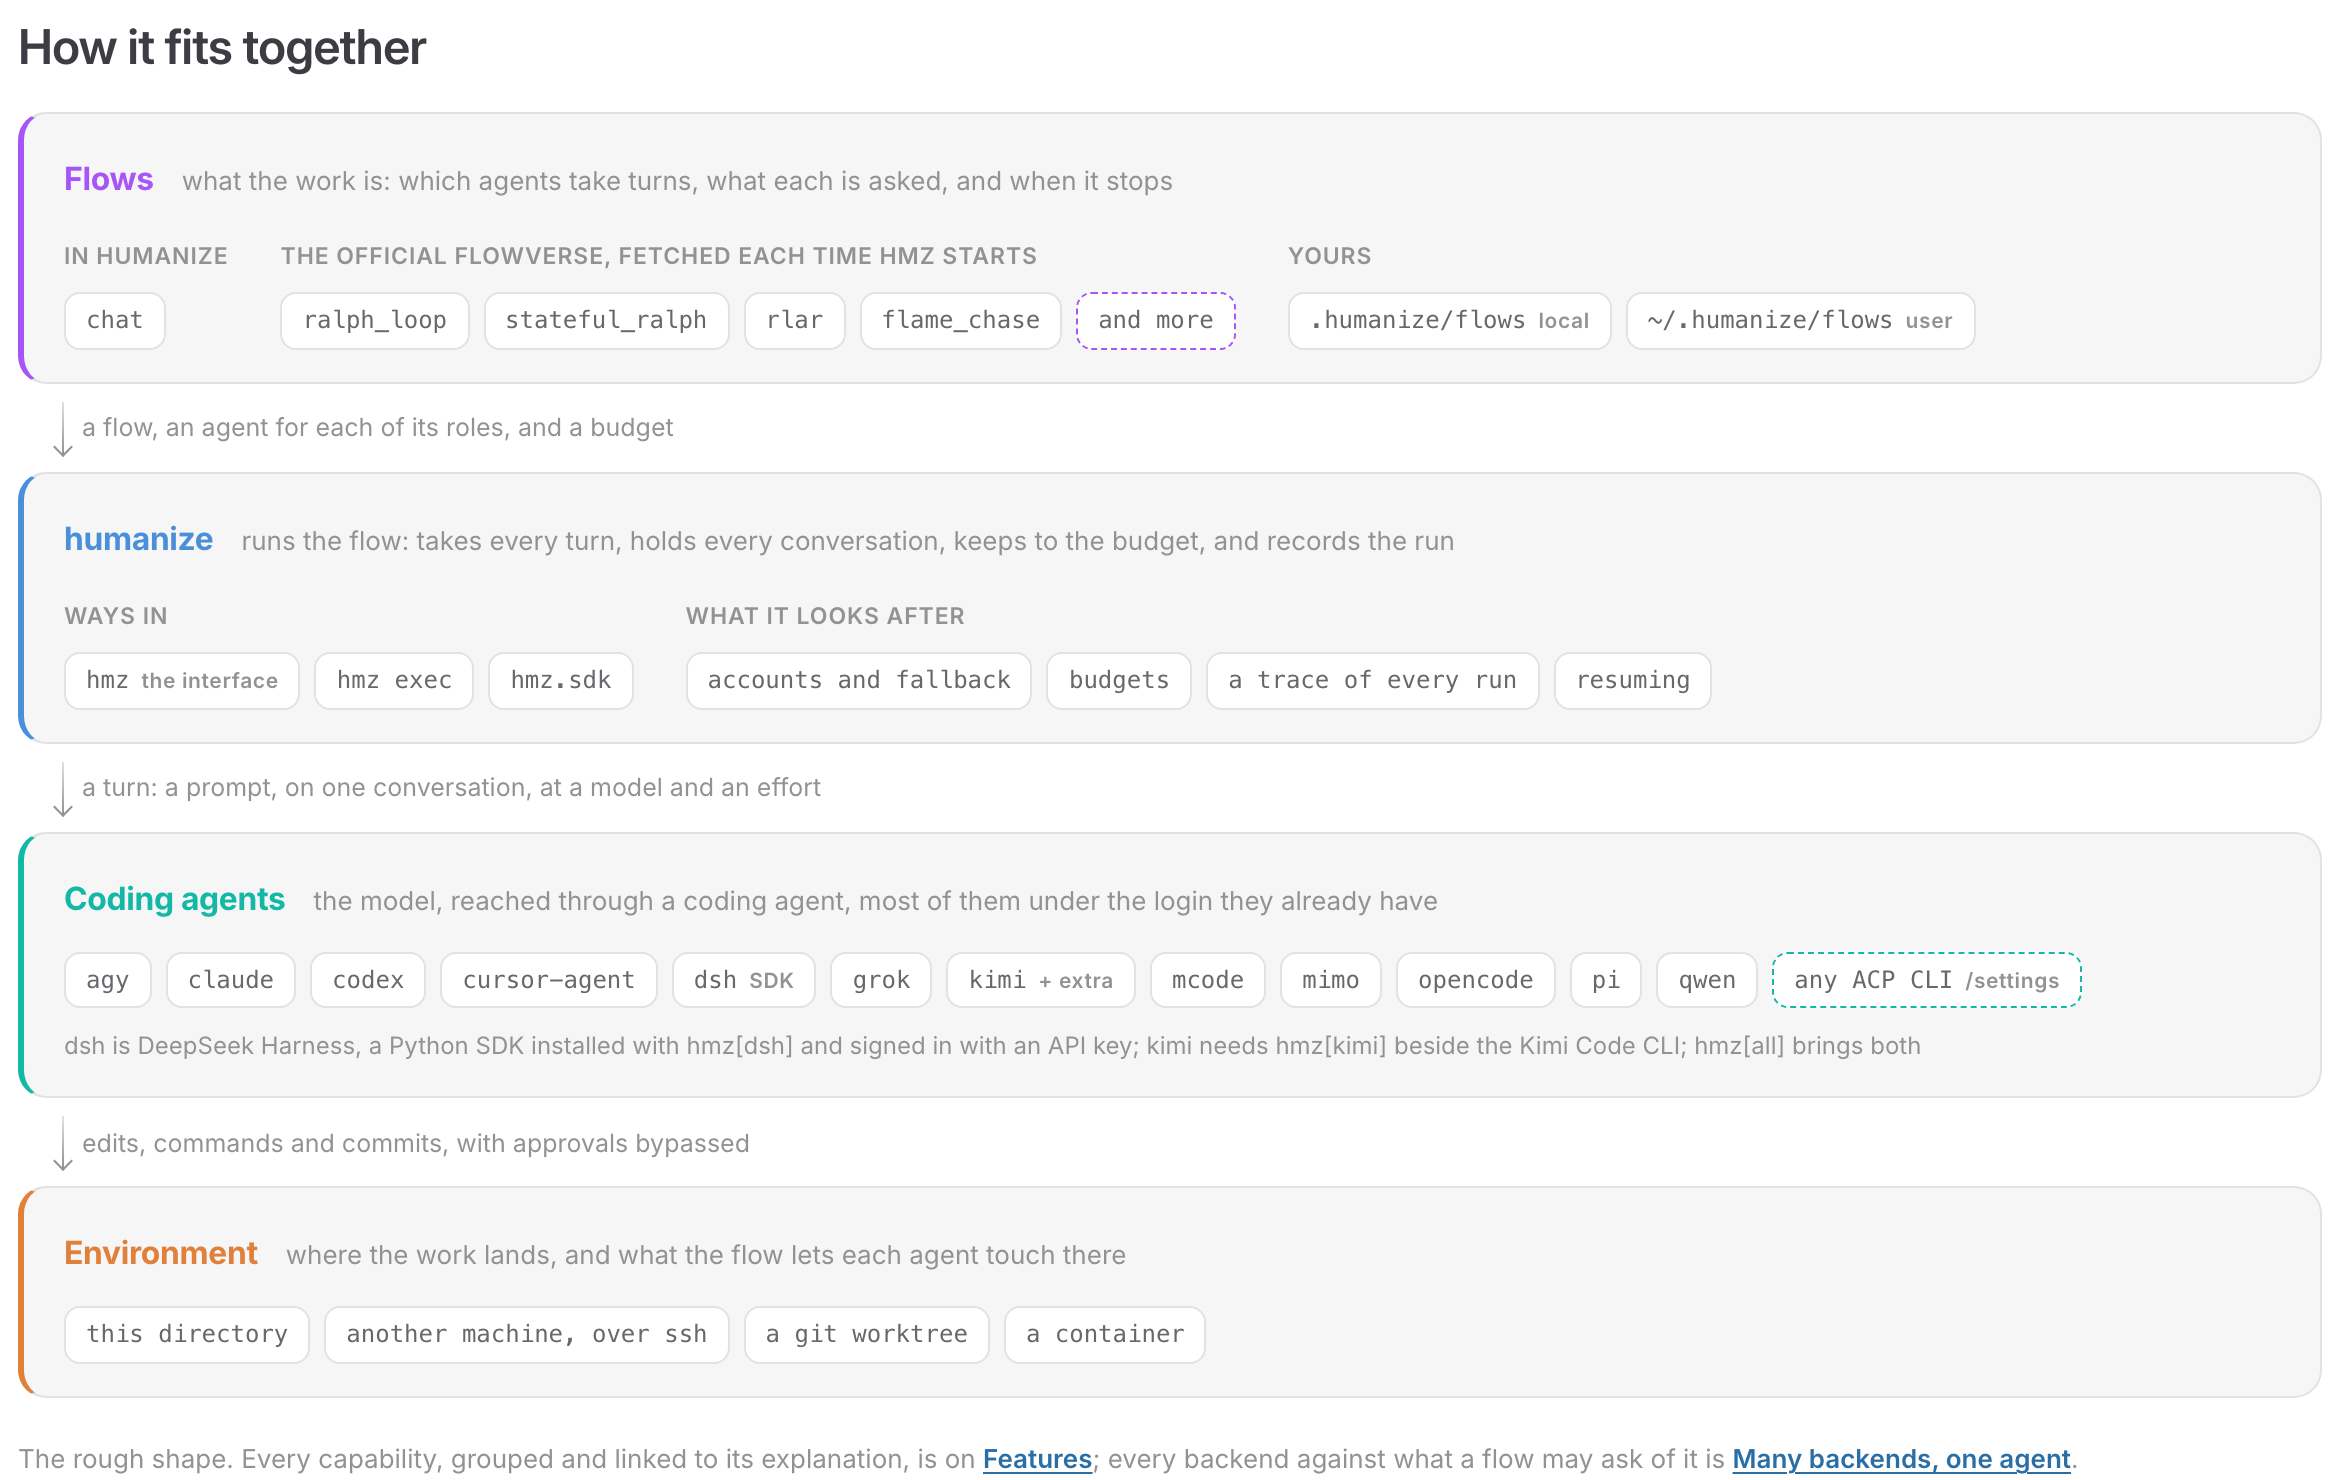
플로우 층에서 humanize에 넘어가는 것은 플로우 하나와 역할별 에이전트, 그리고 예산입니다. humanize는 이것을 받아 턴 단위(프롬프트 하나, 대화 하나, 모델 하나, 추론 강도(effort) 하나)로 코딩 에이전트에게 일을 맡기고, 에이전트는 승인 없이 파일 수정, 명령 실행, 커밋을 수행합니다. 작업 위치는 현재 디렉토리 외에도 git 워크트리, 컨테이너, SSH로 접속한 다른 머신을 고를 수 있습니다.
지원하는 백엔드는 claude(Claude Code), codex(Codex), kimi(Kimi Code), pi, dsh(DeepSeek Harness), agy(Antigravity), grok(Grok Build), mimo(MiMo Code), mcode(MiniMax Code), opencode, qwen(Qwen Code), cursor-agent(Cursor Agent)의 12종입니다. 이 중 DeepSeek Harness는 CLI가 아니라 Python SDK로 연결되며 hmz[dsh] 추가 설치가 필요하고, Kimi Code CLI는 hmz[kimi]가 함께 필요합니다. 그 밖에 Agent Client Protocol(ACP)을 구현한 CLI도 설정에서 직접 추가할 수 있습니다.
백엔드마다 지원하는 기능의 폭은 다릅니다. 실행 중인 턴에 사용자가 입력한 문장을 바로 끼워 넣는 기능은 claude, codex, kimi, pi만 지원하고, 모델이 목표 달성 여부를 스스로 판단하는 목표(goal) 기능은 claude, codex, dsh, kimi에만 있습니다. cursor-agent와 직접 추가한 ACP CLI는 실행 트레이스를 읽어 올 수 없습니다. 플로우가 필요로 하는 기능을 백엔드가 갖추지 못했으면 humanize는 첫 턴을 시작하기 전에 실행을 거부합니다.
며칠씩 이어지는 실행을 위한 장치도 있습니다. 터미널 인터페이스에서 시작한 실행은 터미널을 닫아도 계속되고 같은 디렉토리에서 hmz를 다시 열면 이어서 볼 수 있지만, 재부팅하면 끝나고 hmz exec처럼 화면 없이 시작한 실행은 프로세스와 함께 끝납니다. 실패한 턴은 지정한 횟수만큼 다시 시도한 뒤 미리 정해 둔 순서대로 다른 계정, CLI, 모델로 넘겨 새 대화에서 이어 가며, 실행 기록은 모든 에이전트와 하위 에이전트의 도구 호출을 한 타임라인에 담은 트레이스 파일로 남아 어디에도 업로드되지 않습니다.
humanize의 플로우 종류
humanize의 공식 플로우는 chat만 humanize에 내장되어 있고, 나머지는 humanfia/flowverse 저장소에서 hmz를 열 때마다 내려받습니다. 문서에 정리된 플로우는 다음과 같습니다:
| 형태 | 플로우 | 동작 | 끝나는 조건 (예산 외) |
|---|---|---|---|
| 대화 | chat |
사용자와 에이전트 하나가 번갈아 대화, 예산 불필요 | 사용자가 멈출 때 |
| 에이전트 하나, 반복 | ralph_loop |
매 라운드 새 세션으로 같은 작업 지시, 이어지는 것은 저장소뿐 | 3라운드 연속 응답 없음 |
stateful_ralph |
세션 하나를 유지하며 매 라운드 작업을 다시 지시 | 3라운드 연속 응답 없음 | |
continue_loop |
세션 하나에 작업을 한 번 주고 이후엔 "continue"만 전송 | 3턴 연속 실패 | |
goal |
CLI 자체의 /goal 기능에 작업을 넘김 |
모델이 목표 달성을 선언 | |
| 두 에이전트 교대 | flame_chase |
두 에이전트가 매번 새 세션으로 번갈아 작업, 서로의 말은 전달되지 않음 | 3턴 연속 실패 |
| 작업자와 검토자 | rlar |
작업자는 세션 유지, 검토자는 매번 새 세션으로 저장소를 읽고 검토 | 검토자가 done 판정 |
humanize1 |
아이디어 초안, 두 에이전트가 합의한 계획, 검토 하의 구현(rlcr) 3단계 |
단계별 파일 작성, rlcr은 검토 통과 |
|
aot |
설명을 받아 새 플로우를 작성하고 가짜 에이전트로 시험한 뒤 비평가가 승인 | 플로우 저장 또는 수정 횟수 소진 | |
| 정리 담당 추가 | ralph_loop_agent_cleanup, flame_chase_agent_cleanup |
몇 턴마다 정리 담당이 작업 트리를 정리하고 git 이력을 커밋 하나로 재작성 | 3턴 연속 실패 |
| 여러 갈래 동시 | parallel_flame_chase |
조정자가 3개 레인을 계획, 레인마다 두 에이전트가 교대, 레인 1만 원본 트리에 기록 | 예산 또는 사용자 |
parallel_flame_chase_git_pr |
레인마다 별도 클론에서 PR을 열고, 평가 명령의 측정값이 main보다 좋을 때만 병합 |
예산 또는 사용자 | |
| 분할 정복 | recursive_lean_prover |
Lean 정리를 하위 보조정리로 나눠 각각 증명하고 비교기와 검토자가 확인 | 증명 완료 또는 거부 |
이 중 ralph_loop, stateful_ralph, continue_loop, goal, flame_chase, rlar 여섯 개는 Humanfia 팀이 루프 방식 자체를 비교하려고 만든 FlowBench의 채점 대상과 이름이 같습니다. 개발팀은 FlowBench에서 지는 루프는 기본값이 되지 못하고 flowverse에도 남지 않는다고 설명합니다. flowverse에는 문서에 아직 없는 fixed_interrupt_flame_chase도 2026년 10월 3일 추가되었는데, flame_chase에 평가기가 받아들인 실험이 정해진 수(기본 5개)에 이르면 작업을 끊는 장치를 더한 플로우입니다.
두 정리 담당 플로우는 정리할 때마다 저장소의 git 이력을 epoch N: distilled tree라는 커밋 하나로 바꿉니다. 이전 이력은 저장소 밖에 보관되고 삭제되지는 않지만, 이력이 재작성되어도 괜찮은 클론에서만 실행해야 합니다. 한국어 사용자라면 humanize1:gen-plan의 alternative_plan_language 옵션에 ko를 주어 계획 문서의 한국어 번역본을 함께 받을 수 있다는 점도 참고할 만합니다.
humanize의 예산과 권한 모델
humanize의 예산은 duration(시간), cost(비용), output_tokens(출력 토큰) 세 가지이며, 이 중 가장 먼저 소진된 한도가 실행을 끝냅니다. 기본적으로는 진행 중인 턴이 마무리될 때까지 기다리고, -b graceful=false를 주면 한도에 닿는 순간 턴을 끊습니다. 가격 정보가 없는 모델은 비용이 0달러로 계산되므로, 비용 한도만 걸어 두면 실제로는 멈추지 않을 수 있습니다. 개발팀이 시간이나 토큰 한도를 함께 걸라고 안내하는 이유입니다. 예산이 다 된 실행은 끝난 것이 아니어서, 같은 명령에 --resume과 새 예산을 주면 플로우가 보존하는 상태(라운드 수, 마지막 검토 등)부터 다시 시작합니다(단, chat, goal, aot는 보존하는 상태가 없어 처음부터 다시 실행됩니다).
권한은 실행 중에 묻지 않고, 플로우가 역할마다 미리 선언합니다. 선언은 local(작업 디렉토리), user(홈 디렉토리의 나머지), system(그 밖의 시스템), online(CLI의 웹 검색과 가져오기) 네 범위에 각각 NONE, READ, ALL 중 하나를 줍니다. 아무것도 선언하지 않은 역할은 작업 디렉토리만 쓰고 나머지는 읽기만 할 수 있으며, 이 제한은 Linux에서는 Landlock, macOS에서는 Seatbelt로 에이전트와 그 에이전트가 실행한 모든 명령에 적용됩니다.
이 격리를 걸 수 없는 환경에서는 권한을 넓혀 실행하지 않고 해당 역할을 거부합니다. Landlock이 없는 커널(5.13 미만)이나 다른 샌드박스 안에서 humanize를 실행한 Mac에서는 모든 범위가 ALL인 역할만 실행되고, online을 NONE으로 두는 네트워크 차단은 Linux 커널 6.7 이상이 필요합니다. 개발팀은 Unix 소켓과 macOS의 Mach 서비스는 Landlock과 Seatbelt가 막지 못한다는 점, 그리고 dsh 에이전트는 플로우 선언과 무관하게 전체 권한으로 동작한다는 점도 밝혀 두었습니다.
플로우가 Python 코드라는 점도 보안상 고려해야 합니다. humanize는 플로우 목록을 보여 주기 위해 등록된 flowverse의 플로우 파일을 모두 실행하므로, flowverse를 추가하는 것은 그 저장소의 코드를 이 머신에서 실행하도록 허용하는 것과 같습니다. 공식 flowverse도 hmz를 열 때마다 새로 받아 오기 때문에, 내용을 확인한 플로우를 그대로 쓰려면 /flow 메뉴의 copy <flow> here로 프로젝트의 .humanize/flows/에 복사해 두라고 안내합니다. 오류 보고는 처음 실행할 때 한 번 묻고, 동의하기 전에는 아무것도 전송하지 않으며, 동의해도 입력한 작업과 프롬프트, 에이전트 출력, 파일, 키는 보내지 않는다고 명시되어 있습니다.
humanize 설치와 사용
humanize를 설치하려면 Python 3.12 이상과 uv(또는 pipx, pip), 그리고 로그인해 둔 코딩 에이전트 CLI가 하나 이상 필요합니다. 역할별 권한 격리는 Linux(Landlock)와 macOS(Seatbelt)에서 동작하며, 공식 문서에는 Windows 지원에 대한 안내가 없습니다. Claude Code 하나로 시작하는 전체 과정은 다음과 같습니다:
uv tool install git+https://github.com/humanfia/humanize.git
npm i -g @anthropic-ai/claude-code && claude auth login
hmz --version
DeepSeek Harness나 Kimi Code를 쓰려면 추가 패키지를 함께 설치합니다:
uv tool install 'hmz[all] @ git+https://github.com/humanfia/humanize.git'
설치는 반드시 위와 같이 GitHub 저장소 주소로 합니다. PyPI에 올라 있는 hmz 패키지는 버전 0.0.1의 placeholder 패키지이고, humanize 패키지는 앞서 언급한 별개의 Python 라이브러리이므로 pip install hmz나 pip install humanize로는 이 프로젝트가 설치되지 않습니다.
공식 빠른 시작은 일부러 버그를 넣은 실험용 저장소를 만들고 ralph_loop으로 고치게 하는 예제입니다. calc.py의 덧셈 함수가 뺄셈을 하도록 만든 뒤, 되돌릴 수 있게 before 태그를 붙여 둡니다:
mkdir -p ~/tmp/humanize-demo && cd ~/tmp/humanize-demo && git init -q
printf 'def add(a, b):\n    return a - b\n' > calc.py
git add -A && git commit -qm "a calculator with a bug in it" && git tag before
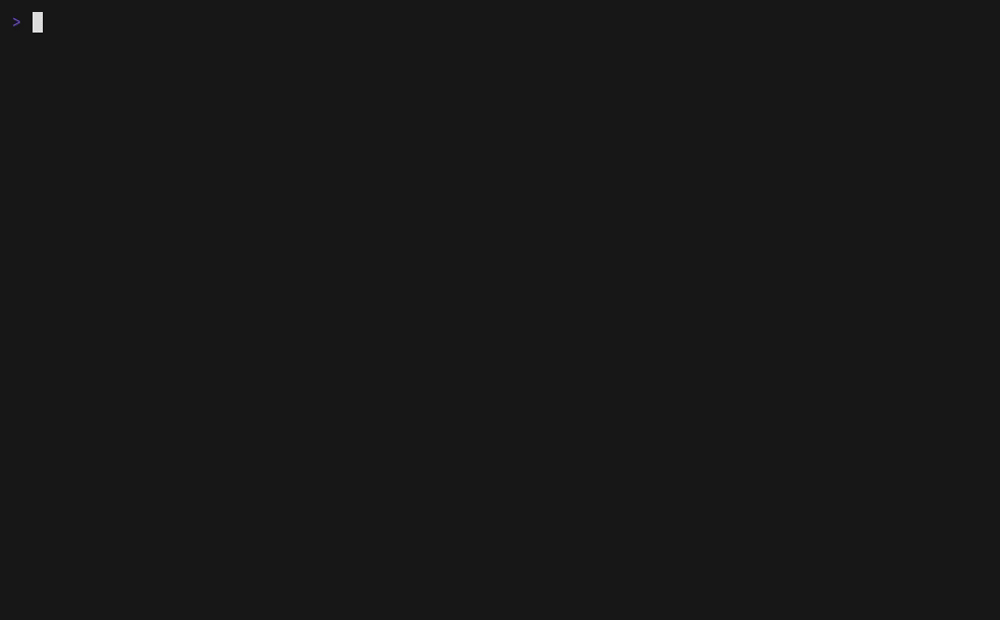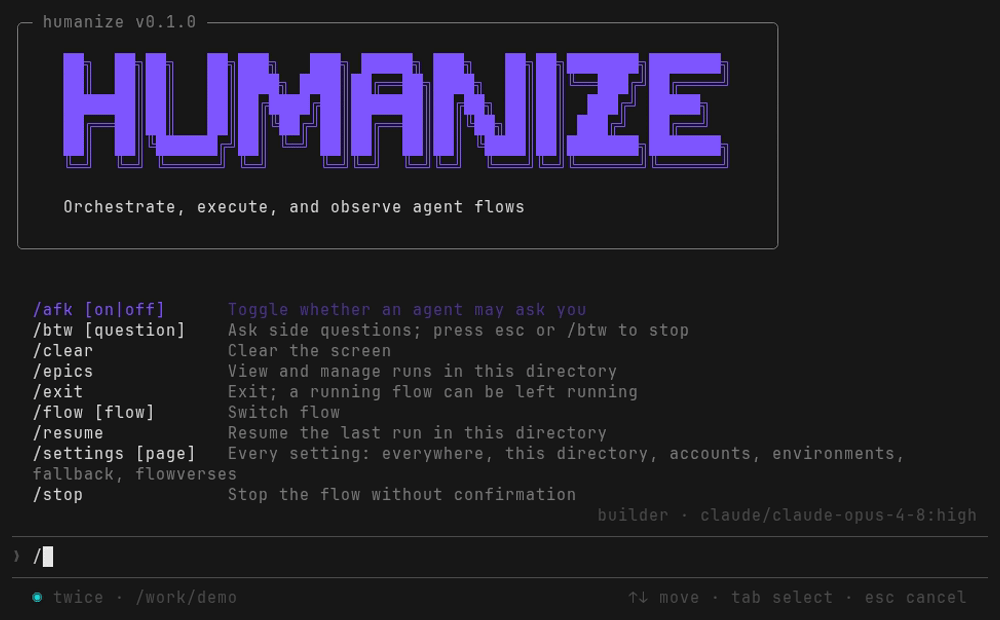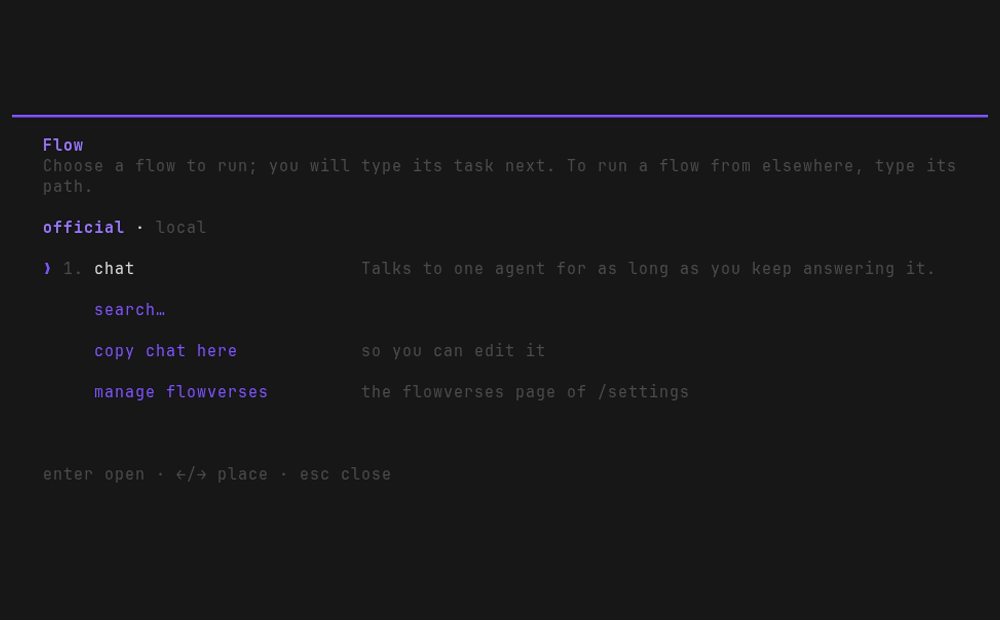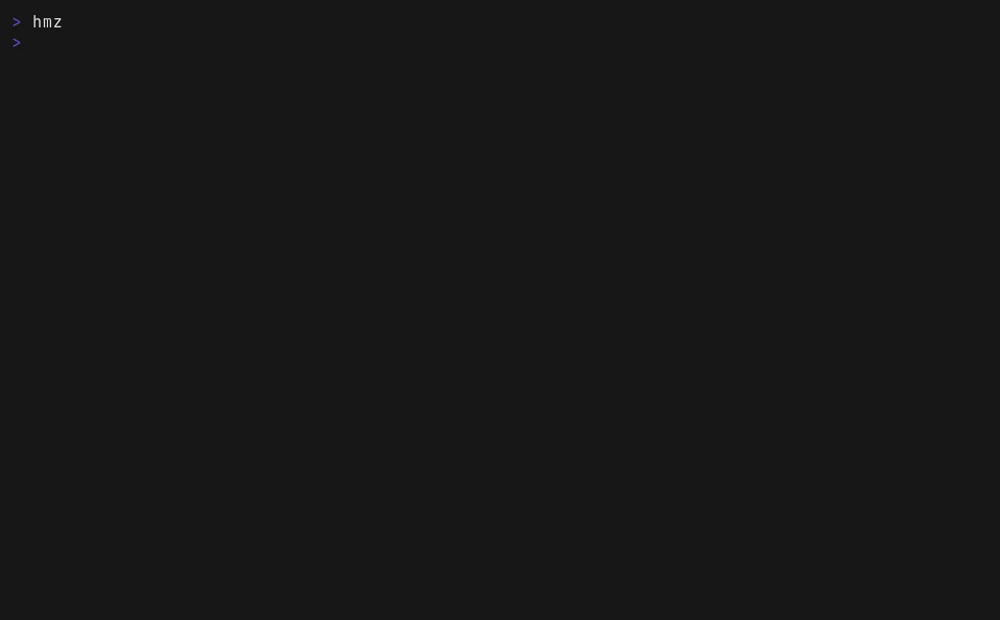
이 저장소에서 hmz로 터미널 인터페이스를 열고 $ralph_loop Fix the bug in calc.py.를 입력하면, 처음 한 번은 agent 역할에 쓸 CLI와 모델, 추론 강도, 예산을 고르는 메뉴가 열립니다. 이 설정은 디렉토리별로 저장되어 다음부터는 같은 입력으로 바로 실행됩니다. ralph_loop은 작업이 끝나도 스스로 멈추지 않으므로, 예산이 소진되거나 사용자가 ctrl+c를 두 번 눌러야 멈춥니다. 아래는 개발팀이 실제 에이전트 대신 대역 CLI로 녹화한 인터페이스 화면입니다:
실행이 끝난 뒤에는 git diff before로 에이전트가 바꾼 내용을 확인합니다. 셸 스크립트나 cron, CI처럼 화면 없이 같은 실행을 한 줄로 하려면 hmz exec에 플로우(-f), 역할별 에이전트(-a 역할=CLI/모델:강도), 예산(-b)을 줍니다. 아래는 작업자와 검토자를 서로 다른 CLI로 지정한 rlar 실행 예시입니다:
hmz exec -f rlar \
    -a actor=claude/claude-opus-5:high -a reviewer=codex/gpt-5.6-sol:high \
    -b duration=6h,cost=60 "$(cat TASK.md)"
처음 설치한 상태에서는 hmz exec가 공식 flowverse를 내려받지 않으므로, hmz를 한 번 열어 두거나 /settings의 flowverses 페이지에서 official을 직접 받아야 합니다. 모델 ID는 CLI 버전과 계정에 따라 달라지므로, 모델이 거부되면 /flow ralph_loop의 agent 항목에서 쓸 수 있는 모델 목록을 확인합니다.
직접 플로우를 작성할 때는 에이전트 역할과 작업 환경을 선언한 async 함수를 .humanize/flows/<이름>/__init__.py에 둡니다. 아래는 공식 문서의 예제로, 에이전트가 작업을 한 뒤 같은 대화에서 자기 작업을 다시 검토하게 하는 플로우입니다:
from hmz.flows import Agent, AgentCollection, EnvCollection, FlowContext, FlowParams
from hmz.flows import LocalEnv, flow

class Agents(AgentCollection):
    builder: Agent  # a role: -a builder=… fills it

class Envs(EnvCollection):
    workspace: LocalEnv  # the directory you run it in

@flow(agents=Agents, envs=Envs, params=FlowParams)
async def twice(
    task: str, *, agents: Agents, envs: Envs, params: FlowParams, ctx: FlowContext
) -> None:
    """Does the work, then reads it back and fixes what is wrong."""
    builder = agents["builder"]
    session = await builder.spawn(env=envs["workspace"])  # one conversation
    await builder.run(task, session=session)
    await builder.run(  # the same one, so this turn remembers the last
        "Now review what you just did, and fix anything that is wrong.", session=session
    )
이렇게 저장한 플로우는 셸에서 hmz exec -f twice -a builder=claude/claude-opus-5:high -b cost=5 "..."로, 터미널 인터페이스에서는 $local/twice로 실행합니다. 같은 세션을 두 번 쓰기 때문에 두 번째 턴은 첫 번째 턴에서 한 일을 기억한 채 검토합니다.
humanize의 라이선스
humanize는 Apache-2.0 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다.
단, chat을 제외한 공식 플로우가 들어 있는 humanfia/flowverse 저장소에는 LICENSE 파일이 없으므로, 공식 플로우를 수정해 재배포하거나 사내 도구에 포함하려면 사용 조건을 먼저 확인해야 합니다.
 Humanfia 홈페이지 (humanize 개발 조직)
 humanize 공식 문서
의 플로우 목록
 humanize GitHub 저장소
humanize 공식 플로우 저장소 (flowverse)
더 읽어보기
-
과학 컴퓨팅을 위한 Claude 장기 실행에 대한 연구: Ralph 루프 및 실질적인 연구 방법 공유 (feat. Anthropic)
-
장시간 자율 코딩을 위한 에이전트 하네스 설계: GAN에서 영감 받은 멀티 에이전트 아키텍처 (feat. Anthropic)
-
HarnessTax: 7가지 모델 x 3가지 하네스로 실험한, 모델과 하네스에 따른 성능과 비용에 대한 연구 (feat. UC Berkeley)
-
Emdash: 여러 AI 코딩 에이전트를 Git 워크트리별로 격리하여 병렬 실행하는 오픈소스 에이전틱 개발 환경 (ADE)
-
OpenShell: AI 에이전트의 파일, 네트워크, 자격증명 접근을 선언형 정책으로 제한하는 NVIDIA 샌드박스 런타임
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
