핵심 요약
- jev-chat은 채팅 앱 위에 떠서 대화를 읽고, TypeSafe의 결정 모델 Jev로 상대의 의도와 대화의 위험도를 먼저 판정한 뒤 언어 모델이 쓴 답장 후보를 다시 Jev로 검사해 입력창에만 채워 주는 안드로이드 앱입니다. 전송 버튼을 누르는 코드 경로는 없습니다.
- 저장소에는 영어 WhatsApp 1:1 대화용 글로벌판(v0.1.0 미리보기)과 QQ, X, Feishu, WhatsApp용 중국어판(v1.7) 두 앱이 들어 있습니다. 두 앱 모두 한국어 대화를 지원 대상으로 내세우지 않으며, 한국어 사용자에게는 카카오톡과 한국어 화면을 지원하는 별도의 Windows 자매 프로젝트가 현실적인 경로입니다.
- 글로벌판의 판정 기준표와 사과 수준표는 사람이 승인한 명세로 고정되어 있고, 답장 점수는 목표 달성도와 전달력을 0.7 대 0.3으로 합산합니다. 다만 공개된 평가 수치는 문턱값을 맞출 때 쓴 37개 예제에서 작성자 라벨과의 일치율이며, 저자도 독립 검증이 아니라고 밝힙니다.
- 앱은 무료이고 모델 호출은 사용자의 API 키로 결제합니다. 상대방의 메시지까지 OpenRouter와 모델 제공사로 전송되며, 저자는 제3자 채팅 앱 약관 위반으로 계정이 제한될 수 있다고 경고합니다.
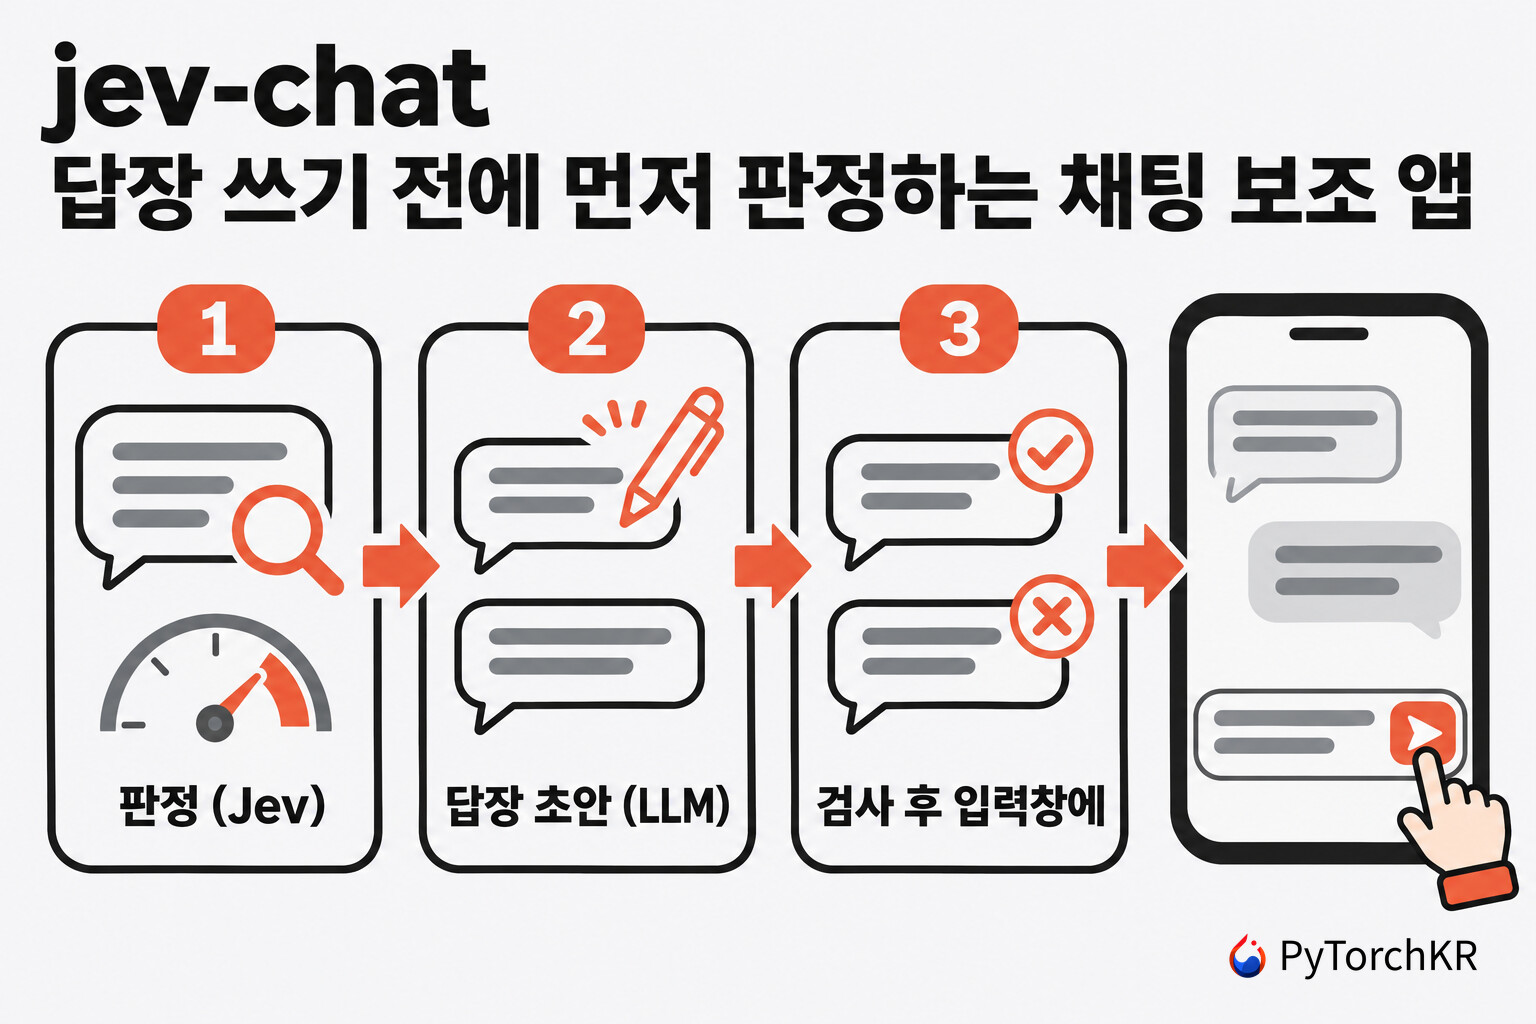
jev-chat 소개
메시지를 받았을 때 어려운 부분은 답장을 타이핑하는 일보다 상대가 무엇을 원하는지 읽는 일인 경우가 많습니다. 상사가 일정을 묻는 메시지가 단순한 확인인지 압박인지, 연인의 짧은 "응"이 괜찮다는 뜻인지 서운하다는 뜻인지에 따라 좋은 답장이 달라집니다. jev-chat 저자는 대부분의 AI 도구가 이 판단 단계를 건너뛰고 곧바로 답장을 쓴다고 지적합니다. 그렇게 생성된 답장이 내가 하지 않은 약속을 하거나 다른 사람 몫까지 대신 약속해도, 답장 생성만 하는 도구에는 그 문제를 잡아내는 단계가 따로 없습니다. 이번에 소개하는 jev-chat은 답장을 쓰기 전에 상대의 의도와 위험도를 먼저 판정하고, 쓴 답장도 그 판정에 비춰 검사한 뒤 입력창에만 채워 주는 채팅 보조 앱입니다.
jev-chat이 판정에 쓰는 모델은 TypeSafe의 Jev (
 Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI))입니다. Jev는 문장을 생성하지 않고 예/아니오, 객관식, 단계별 점수 질문에 확률로만 답하는 결정 모델입니다. jev-chat은 이 성질을 두 번 사용합니다. 먼저 대화를 읽고 상대가 무엇을 요구하는지, 경계를 긋는지, 갈등이 얼마나 커졌는지를 묻고, 그 결과로 사용자가 고를 대응 방향을 제시합니다. 답장 초안은 DeepSeek 같은 일반 언어 모델이 쓰고, 글로벌판에서는 다시 Jev가 각 초안이 목표를 지켰는지, 허락하지 않은 약속을 했는지를 검사해 점수를 매깁니다.
아래는 글로벌판이 앱 안의 미리보기 화면에서 예시 데이터로 그린 패널입니다. 왼쪽부터 상대 메시지 분석과 대응 방향 선택, 점수가 매겨진 답장 두 개, 점수 세부 내역, 검사에서 차단된 답장입니다:
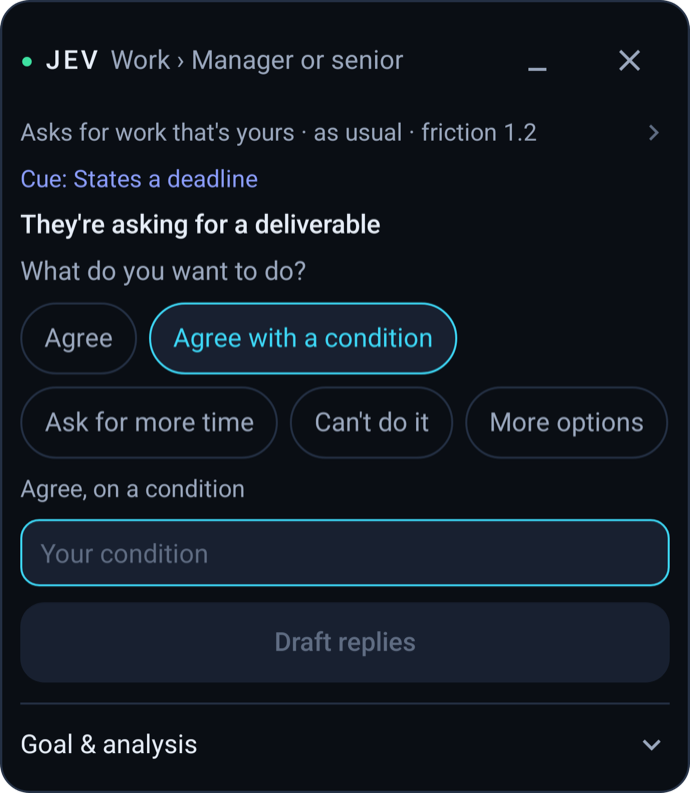
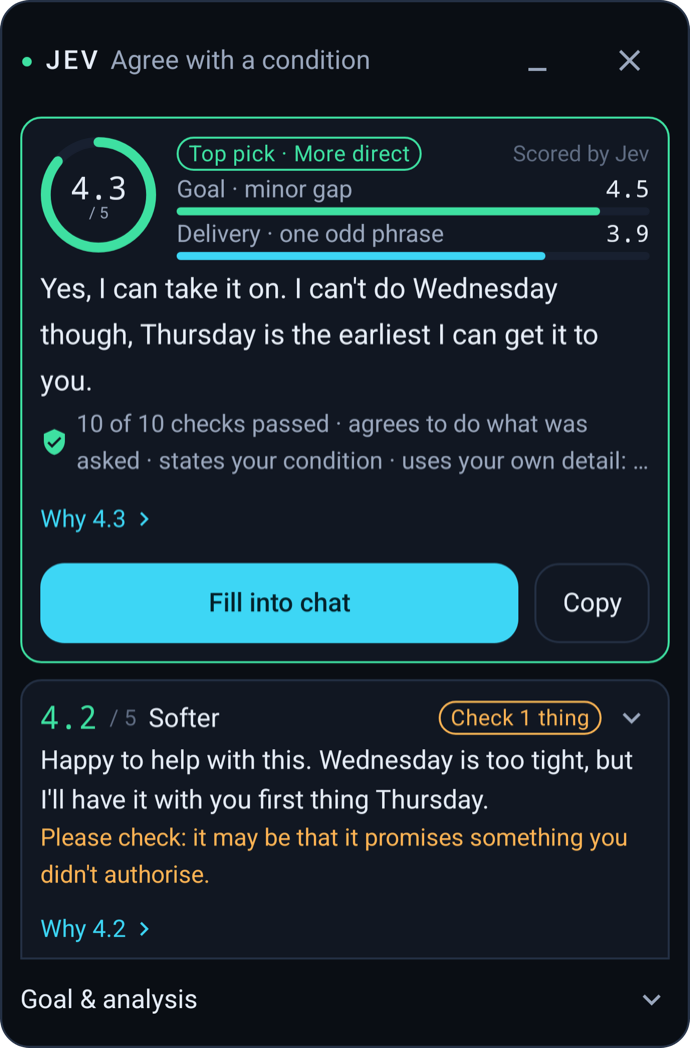
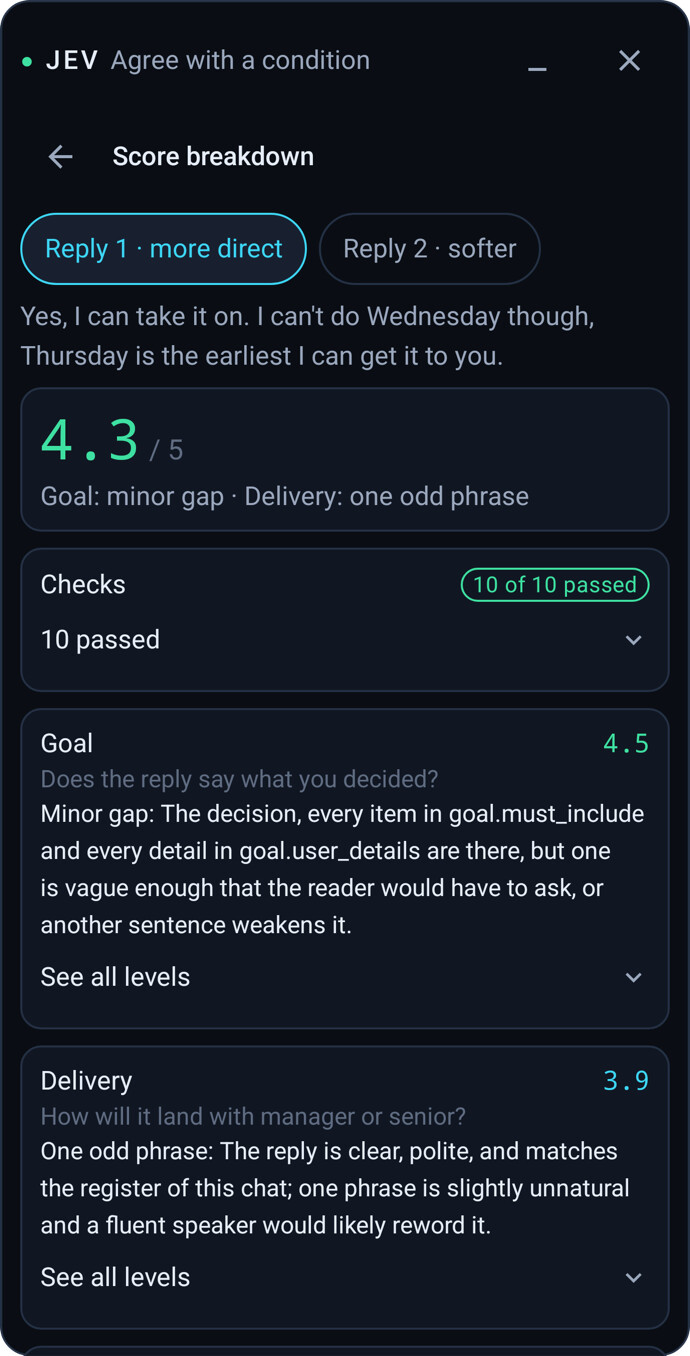
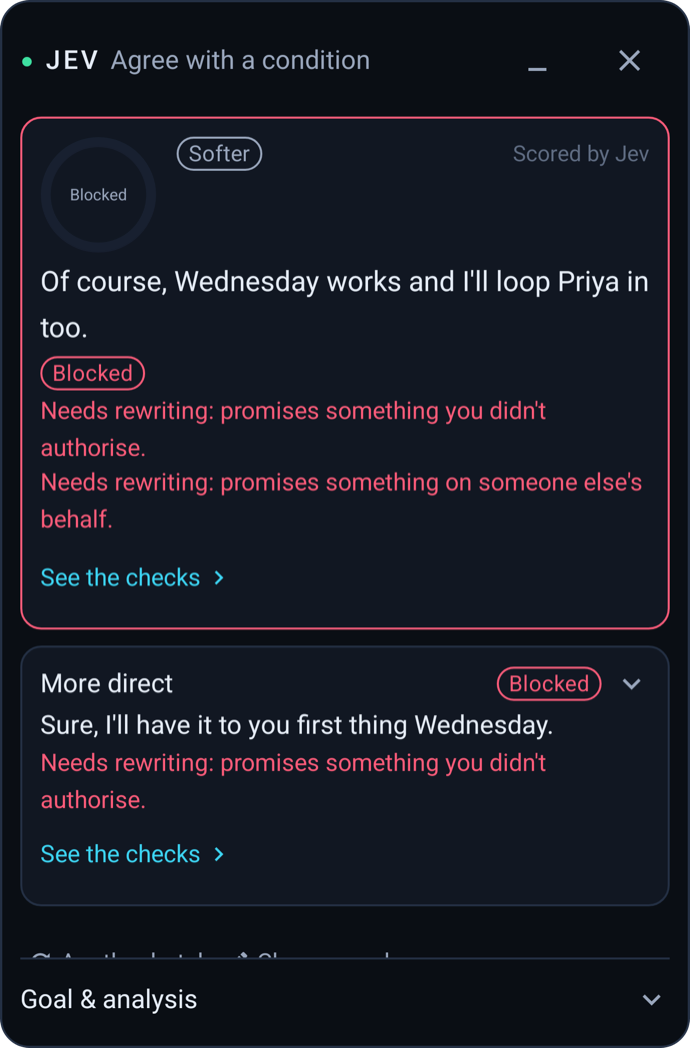
jev-chat은 Finderchangchang이 2026년 9월 21일 중국어판 v1.0을 공개하며 시작했고, 영어 WhatsApp용 글로벌판은 기여자 smgonthebeat가 만들었습니다. 두 앱 모두 Kotlin으로 작성되었고 안드로이드 접근성 서비스(Accessibility Service)로 화면의 대화를 읽습니다. 채팅 앱을 개조하거나 루팅할 필요가 없고, 앱의 API나 계정, 데이터베이스에도 접근하지 않습니다. 같은 조직(jev-chat) 아래에 Windows, macOS, iOS용 자매 프로젝트가 별도 저장소로 있으며, 프로젝트 소개 페이지 chatjevs.com은 중국어로 작성되어 있습니다.
jev-chat과 기존 방식 비교
채팅 답장을 돕는 방식은 크게 넷으로 나눌 수 있습니다. 아래 표는 jev-chat 저장소 문서와 각 방식의 일반적인 형태를 기준으로 정리한 것입니다:
| 구분 | 범용 챗봇에 대화 붙여 넣기 | 키보드, 메신저 내장 AI 답장 | 화면을 조작하는 모바일 에이전트 (DroidRun 등) | jev-chat |
|---|---|---|---|---|
| 대화를 읽는 방법 | 사용자가 복사 | 제품마다 다름 | 접근성 트리와 화면 | 접근성 트리(일부 앱은 OCR) |
| 답장 전 의도 판정 | 프롬프트에 따라 다름 | 대체로 없음 | 목적이 다름 | Jev로 의도, 경계, 갈등 수준 판정 |
| 생성된 답장 검사 | 없음 | 없음 | 없음 | 글로벌판은 Jev로 약속 남발, 목표 이탈, 근거 없는 사실 검사(중국어판은 순위만) |
| 전송 | 사용자 | 사용자 | 에이전트가 직접 누를 수 있음 | 입력창만 채우고 사용자 전송 |
jev-chat이 접근성 서비스로 화면을 읽는 방식 자체는 DroidRun 같은 모바일 에이전트와 같습니다. 차이는 권한의 사용 범위입니다. 저자는 메시지를 보내는 경로를 추가하지 말 것을 기여 규칙 첫 줄에 두었고, 글로벌판 아키텍처 문서에도 전송 버튼을 누르거나 키보드의 엔터 동작을 일으키는 코드 경로가 없다고 명시합니다.
jev-chat을 사용하면 좋을 사용자
jev-chat은 영어로 업무, 연인, 가족 대화를 자주 나누면서 답장 표현 때문에 고민하는 안드로이드 사용자에게 맞습니다. 결정 모델을 생성 모델의 앞단 판정기와 뒷단 검사기로 함께 쓰는 설계를 실제 앱 코드로 보고 싶은 개발자에게도 참고가 됩니다. 특히 글로벌판의 core/ 모듈은 안드로이드 타입 없이 순수 Kotlin으로 작성되어 있고, 질문 설계와 문턱값, 승인된 판정표가 테스트로 고정되어 있어 Jev 기반 애플리케이션의 참고 구현으로 읽을 만합니다.
반대로 한국어 대화가 주된 사용 환경이라면 상황이 다릅니다. 글로벌판은 상대가 비라틴 문자로 주로 쓰는 대화를 분석하지 않고, 중국어판은 중국어 대화와 중국 앱에 맞춰져 있습니다. 카카오톡에서 한국어로 대화하는 사용자에게는 안드로이드용 jev-chat이 아직 적절한 선택지가 아니며, 한국어 화면과 카카오톡 읽기를 지원하는 Windows 자매 프로젝트를 먼저 살펴보는 편이 맞습니다. 업무용 메신저나 회사 계정에서 쓰려는 경우에는 상대방의 메시지가 외부 모델 제공사로 전송된다는 점과 앱 약관 위반 위험을 먼저 검토해야 합니다.
jev-chat의 동작 흐름: 판정, 초안, 검사, 채우기
글로벌판(Jev for WhatsApp)은 저장소에서 설계 문서가 가장 자세한 앱입니다. 사용자가 WhatsApp 대화 화면에서 떠 있는 버튼을 누르면 한 번의 처리 과정이 시작되고, 순서는 다음과 같습니다:
버튼 누름 → 대화 읽기 → 대화 상대 유형 선택(처음 한 번) → 분석(Jev)
  → 대응 방향 선택과 세부 내용 입력 → 답장 2개 초안 작성 → 검사와 채점(Jev) → 입력창에 채우기
  → 전송은 사용자
대화 읽기
앱은 접근성 트리를 메시지 목록으로 바꾸는 WhatsApp 어댑터를 쓰며, 화면을 위로 넘겨 가며 최근 메시지를 최대 24개까지 모읍니다. 24개를 채우거나, 대화의 처음에 닿거나, 5화면 또는 8초를 넘기면 멈추고 맨 아래로 돌아갑니다. 겹치는 화면은 하나의 순서 있는 목록으로 이어 붙이고, 읽는 도중 대화가 바뀌면 이를 감지해 두 대화를 섞지 않습니다. 그룹 대화는 메시지 위의 다른 멤버 이름으로 식별해 거부합니다. 어댑터는 WhatsApp의 뷰 ID에 의존하므로, 저장소의 화면 녹화 픽스처가 WhatsApp 2.26.38.73 기준의 기대 동작을 고정합니다.
장면과 Jev 분석
사용자는 대화마다 한 번 업무, 연인, 친구, 가족, 일반 다섯 가지 장면(scene)과 관계 유형(예: 업무 > 상사, 가족 > 부모)을 고릅니다. 이 선택은 대화 이름이 아니라 설치마다 다른 솔트를 붙인 해시로 저장됩니다. 각 장면은 Jev에게 물을 예/아니오 질문(마감을 요구하는가, 경계를 긋는가 등)과 판정표(matrix)를 정의합니다. 판정표는 질문과 관계의 조합마다 대화의 위치와 다음 단계를 정하며, 다섯 장면의 표는 사람이 셀 단위로 승인해 approved/matrix.tsv에 165행으로 고정되어 있습니다.
분석 단계는 OpenRouter의 결정 모델용 엔드포인트로 Jev(기본값 typesafe/jev-1.13)에 요청 두 개를 병렬로 보냅니다. 하나는 대화 전체에 대한 행동, 어조, 필수 선택 질문이고, 다른 하나는 마지막 차례와 그 앞 메시지 4개에 대한 갈등(friction) 질문입니다. Jev의 답은 확률이고, 문턱값을 거쳐 감지, 불확실, 없음으로 나뉩니다. 답장에 영향을 주는 질문이 불확실하면 앱이 추측하지 않고 사용자에게 고르게 합니다.
목표와 초안
사용자가 고른 대응 방향(예: 조건부 동의, 시간 더 요청)은 목표(goal)로 바뀝니다. 목표에는 꼭 들어가야 할 항목, 피할 것, 약속, 그리고 장면과 관계와 방향에 따라 정해지는 사과 수준이 들어갑니다. 사용자가 직접 입력한 세부 내용(예: "목요일")은 별도의 필수 항목이 되므로, 그 내용을 빠뜨린 답장은 1위가 될 수 없습니다. 초안은 언어 모델(기본값 deepseek/deepseek-chat-v3.1)이 OpenRouter의 채팅 완성 API로 두 개를 JSON 형식으로 작성하며, 대화 내용은 지시가 아니라 데이터로 프롬프트에 들어갑니다.
Jev 검사와 점수
검사 단계가 jev-chat의 핵심입니다. Jev는 각 답장에 대해 세 종류의 질문에 답합니다:
- 차단 검사: 사용자가 요청하지 않은 새 약속, 다른 사람 몫의 약속, 목표 범위를 넘는 결정, 반대 입장, 상대가 그은 경계 침범, 아무도 말하지 않은 사실 진술이 있으면 답장을 막습니다.
- 확인 요청 검사: 잘못을 인정하는 표현, 앞서 말한 날짜와 시간과 금액에 어긋나는 표현이 있으면 사용자가 먼저 읽고 확인하게 합니다.
- 채점: 목표 달성도 G를 "반대이거나 없음"부터 "완전"까지 6단계로, 관계에 맞는 어조와 전달력 E를 따로 매깁니다. 필수 항목이 빠지면 G는 3에서 막힙니다.
최종 점수는 다음 식으로 계산되며, 5점 만점에 소수 한 자리로 표시됩니다:
위 패널 화면의 1위 답장은 목표 4.5, 전달력 3.9로 0.7 \times 4.5 + 0.3 \times 3.9 \approx 4.3 이 되어 식과 일치합니다. "Top pick" 표시는 모든 검사를 통과했고, Jev의 판정이 갈리지 않았으며, 2위보다 0.2점 넘게 앞선 답장에만 붙습니다. 점수가 높아도 차단 검사에 걸린 답장은 1위가 될 수 없습니다. 한 번의 처리는 모델 요청 17회와 대기 90초로 제한되고, 실패한 요청은 같은 본문으로 한 번만 재시도합니다.
입력창에 채우기
"Fill into chat"을 누르면 같은 대화가 아직 열려 있는지 대화 제목의 해시로 확인한 뒤 WhatsApp 입력창의 텍스트를 설정합니다. 입력창에 이미 쓴 글이 있으면 덮어쓰기 전에 묻습니다. 앱은 여기서 멈추고, 전송은 사용자가 직접 누릅니다.
jev-chat의 두 안드로이드 앱과 자매 프로젝트
저장소 하나에 성격이 다른 안드로이드 앱 두 개가 들어 있고, 다른 플랫폼은 별도 저장소입니다. 플랫폼별 차이는 다음과 같습니다:
| 앱 | 플랫폼과 위치 | 지원 대화 | 판정과 초안 | 상태 |
|---|---|---|---|---|
| Jev for WhatsApp (글로벌판) | 안드로이드, global/ |
WhatsApp 영어 1:1 | OpenRouter 키 하나로 Jev와 DeepSeek | v0.1.0 미리보기 |
| Jev Chat Assistant (중국어판) | 안드로이드, cn/ |
QQ, X, Feishu, WhatsApp 1:1, 그 외 앱은 수동 OCR | 판정, 답장, 비전 API를 각각 설정 | v1.7 |
| Jev for Windows | jev-chat-windows | WeChat, KakaoTalk | Jev(OpenRouter 또는 TypeSafe 직접 연결)와 12개 초안 모델 프리셋 | v0.1.12 |
| Jev for macOS | jev-chat-jarvis-mac | 화면 캡처 또는 시스템 텍스트 API | Jev 또는 로컬 결정 모델 decider-2b |
Apple Silicon 전용 |
| Jev Keyboard | jev-chat-jarvis-ios | 복사한 메시지 | Jev와 OpenAI, Anthropic 호환 초안 모델 | 소스만 공개, 직접 빌드 |
중국어판은 글로벌판보다 기능 범위가 넓은 대신 구조가 단순합니다. Jev에게 의도, 위험 등급, 상대가 원하는 것, 지금 답해야 하는지, 다음 행동 등 7개 질문을 한 번에 묻고, 언어 모델이 쓴 답장 3개를 Jev가 순위로 정렬합니다. 저장소의 개발 지침 문서에 따르면 이 7개 질문은 한 번에 약 900ms, 입력 약 1,000토큰, 0.00004달러가 들었습니다. Feishu처럼 메시지 텍스트가 접근성 트리에 없는 앱은 Google ML Kit의 오프라인 중국어 OCR로 말풍선을 읽으며, 이 모델 때문에 v1.7 APK는 25.8MB이고 arm64 기기만 지원합니다. 로컬 지식 베이스와 연락처 프로필을 분석에 함께 넣는 기능도 두 안드로이드 앱 중 중국어판에만 있습니다.
중국어판의 판정 API는 OpenRouter, Bocha의 Bocha Jev, TypeSafe 직접 연결, Vercel AI Gateway, OpenCode Zen 등을 고를 수 있습니다. 이 중 Bocha는 프로젝트 후원사이고, Bocha Jev 프리셋은 한정 기간 무료로 안내됩니다. 문서와 코드가 어긋나는 부분도 있습니다. 중국어판 영어 README에는 새로 설치하면 Bocha Jev가 기본값이 된다고 적혀 있지만, 중국어 원본 README와 설정 코드(Prefs.kt)는 v1.4.1부터 OpenRouter를 기본값으로 쓰고 Bocha Jev를 두 번째 선택지로 둡니다. Jev가 주로 영어로 학습되었기 때문에, 중국어판은 질문 지시문을 영어로 쓰고 대화 원문은 중국어 그대로 넣습니다.
한국어 사용자에게 의미 있는 것은 Windows 자매 프로젝트입니다. v0.1.12부터 설정 화면에서 한국어 인터페이스를 고를 수 있고, KakaoTalk 대화 창을 읽습니다. 기존 OCR인 RapidOCR은 중국어와 영어 모델만 갖고 있어 KakaoTalk 창의 말풍선 9개 중 하나도 읽지 못했습니다. 저자들은 Windows 기본 OCR(Windows.Media.Ocr)로 바꾼 뒤 9개를 모두 읽고 발신자도 구분했다고 한국어 지원 문서에 적었습니다. 한 프레임 처리 시간은 2.0초에서 0.20초로 줄었습니다. 이 결과는 1:1 대화 한 창에서 측정한 값이고, Windows에 한국어 언어 팩이 설치되어 있어야 하며, 작은 글씨의 오타(헷갈리던데 → 혯갈리던데)는 남는다고 함께 밝혔습니다.
jev-chat의 평가 수치와 알려진 한계
글로벌판은 키나 네트워크 없이 도는 단위 테스트와, 실제 모델을 호출하는 유료 평가를 나눠 둡니다. 단위 테스트는 승인된 판정표 165행과 사과 수준표 85행을 셀 단위로 검사하고, 무작위 스크립트 200개로 요청 한도를 넘지 않는지도 확인합니다. 실제 모델 평가 결과는 docs/TESTING.md에 다음과 같이 공개되어 있습니다:
| 평가 | 결과 |
|---|---|
| 분석 | 있어야 할 행동 48/48 감지, 없어야 할 행동 54개 중 51개 정확(불확실 3, 오답 0), 갈등 73/74, 어조 37/37 |
| 답장 검사 | 위반이 있는 답장 6/6 차단, 문제없는 답장 12개 중 11개 통과 |
| 초안부터 검사까지 | 목표 7개 모두 해석 가능한 답장 2개 생성, 요청 21회에 0.0038달러 |
| 특이 입력 | 13개 중 12개가 기대대로 동작, 요청 22회에 0.0035달러 |
이 수치를 읽을 때는 조건을 함께 봐야 합니다. 저자는 이것이 문턱값을 맞출 때 쓴 같은 37개 시범 예제에서 예제 작성자의 기대 라벨과 일치한 비율이며, 정확도가 아니고 독립된 평가자가 확인하지 않았다고 명시합니다. 예제도 실제 대화가 아니라 직접 작성한 영어 대화입니다.
저자가 밝힌 한계도 구체적입니다. 테스트는 한 대의 휴대폰과 한 버전의 WhatsApp에서만 이뤄졌고, WhatsApp이 업데이트되면 뷰 ID가 바뀌어 읽기가 깨질 수 있습니다. 표시 이름이 같은 두 연락처는 기억된 장면을 공유합니다. 상대가 "그만 연락해 달라"고 경계를 그은 상황에서 "알겠어, 그만할게"라는 짧은 답장이 허락하지 않은 약속으로 잡혀 보류되거나 차단되는 사례도 특이 입력 평가에서 발견되었습니다.
jev-chat의 개인정보 처리와 계정 위험
jev-chat은 자체 서버가 없고 분석이나 오류 보고 수집도 하지 않는다고 밝힙니다. 다만 대화 내용이 휴대폰 밖으로 나가지 않는다는 뜻은 아닙니다. 글로벌판은 버튼을 누를 때마다 읽은 메시지 약 24개와 사용자가 고른 장면, 목표, 초안을 OpenRouter로 보내고, OpenRouter는 이를 모델 제공사(기본값 TypeSafe와 DeepSeek)로 전달합니다. 여기에는 상대방이 보낸 메시지도 포함되며, 각 회사의 정책에 따라 처리됩니다.
휴대폰에 남는 정보는 Android Keystore의 AES-GCM 키로 암호화한 OpenRouter 키, 설정값, 대화별 장면 해시, 그리고 기본으로 꺼져 있는 진단 로그입니다. 진단 로그에는 개수, 점수, 시간만 남고 메시지 본문은 남지 않습니다. 대화 본문과 초안은 한 번의 처리 동안(최대 15분) 메모리에만 있습니다.
계정 위험도 있습니다. 저자는 QQ, Feishu, X, WhatsApp 같은 제3자 앱 안에서 jev-chat을 쓰는 것이 그 앱의 서비스 약관에 맞지 않을 수 있고, 계정이 제한되거나 정지될 수 있다고 README와 FAQ에서 반복해 경고합니다. 글로벌판은 WhatsApp이나 Meta와 관계없는 독립 프로젝트라는 점도 밝힙니다.
jev-chat 설치와 사용
글로벌판은 Android 11 이상에서 동작하며, 릴리스 페이지의 서명된 APK(10.6MB)를 설치하면 됩니다. adb를 쓰는 경우는 다음과 같습니다:
adb install -r jev-whatsapp-v0.1.0-release.apk
설치 후 순서는 다음과 같습니다:
- Jev 앱을 열고 OpenRouter API 키를 붙여 넣은 뒤 "Test connection"을 누릅니다. 기본 모델은 판정에
typesafe/jev-1.13, 초안에deepseek/deepseek-chat-v3.1이며 설정의 Models에서 바꿀 수 있습니다. - "Open accessibility settings"를 눌러 "Jev reply assistant" 접근성 서비스를 켭니다. Android 13 이상에서는 파일로 설치한 앱이므로 먼저 설정 › 앱 › Jev › ⋮ › 제한된 설정 허용을 해야 합니다.
- 영어로 대화하는 WhatsApp 1:1 대화를 열고 Jev 버튼을 누릅니다. 처음에는 대화 상대가 누구인지 묻습니다.
앱 자체는 무료이고, 저자에 따르면 한 번의 처리 비용은 보통 1센트에 훨씬 못 미칩니다. 소스에서 직접 빌드하려면 JDK 17과 Android SDK(플랫폼 35)가 필요하며, global/ 디렉터리에서 실행합니다:
./gradlew test               # 키와 네트워크 없이 도는 단위 테스트
./gradlew assembleDebug      # assistant/build/outputs/apk/debug/assistant-debug.apk
중국어판 APK와 설정 방법은 중국어판 영어 README에 정리되어 있습니다.
jev-chat의 라이선스
jev-chat은 MIT 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다.
단, 저자는 NOTICE 파일에서 배포하거나 상업적으로 사용할 때 LICENSE와 NOTICE를 함께 두고 제품의 정보 화면, 문서, 릴리스 페이지에 출처를 적어 달라고 요구합니다. "Jev Chat Assistant", "jev-chat" 이름과 chatjevs.com 도메인을 원저자가 만들었거나 보증한 것처럼 쓰는 것도 금지하므로, 파생 앱을 배포하려면 이름과 출처 표기를 먼저 정해야 합니다.
 jev-chat 프로젝트 소개 페이지 (중국어)
 jev-chat 프로젝트 GitHub 저장소
https://github.com/jev-chat/jev-chat-jarvis
jev-chat Windows 자매 프로젝트 GitHub 저장소 (KakaoTalk 지원)
https://github.com/jev-chat/jev-chat-windows
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
Jev와 유사한 오픈소스 결정 모델에 대한 정리: Decision Index와 JevBench로 비교한 결정 모델 성능 비교
-
Liquid AI, 문장 생성 대신 Jev 호환 API로 분류 / 라우팅 / 점수를 처리하는 결정 모델 d1 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
파이토치 한국 사용자 모임 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
