핵심 요약
- LLM-as-Jev 논문은 범용 LLM을 구조 변경 없이 Jev식 결정 모델로 쓰는 방법을 제안합니다. 선택지에
[1]부터[K]까지 번호를 붙이고 답을Best answer: [로 미리 채운 뒤,k]꼴 답의 토큰 확률만 읽습니다. - 학습 없이도 Qwen3.5-4B는 JevBench 공개 항목 231개 중 188개(81.4\%)를 맞혔습니다. 같은 모델에서 선택지 글자의 로짓을 읽는 SemIf(186개)와 통계적으로 차이가 없었고, 선택지 77개인 Banking77과 이미지 문제도 같은 형식으로 처리했습니다.
- 미세조정의 효과는 모델이 약한 곳에 한정됐습니다. Qwen3-0.6B의 확률 보정과 다수 선택지 의도 분류는 크게 좋아졌지만, JevBench 정확도는 두 모델 모두 거의 그대로였고 4B LoRA만 84.0\% 로 올랐습니다(통계적으로 유의하다고 보고되지는 않았습니다).
- KL 앵커 없이 학습하면 벤치마크 점수는 유지되는데 답 뒤에 문장을 계속 쓰거나 대화 응답이 끝나지 않는 문제가 생겼습니다. 저자들은 앵커 가중치 \lambda = 1 을 기본값으로 권합니다.
- 평가는 JevBench의 공개 항목만 사용했고 모든 학습은 단일 시드입니다. 논문에는 코드 공개 링크가 없습니다.
LLM-as-Jev 소개
고객 문의를 어느 팀으로 보낼지, 사용자의 의도가 무엇인지, 제출된 근거가 규칙을 충족하는지처럼 소프트웨어가 내리는 판단은 대부분 정해진 선택지 중 하나를 고르는 일입니다. 이번에 소개하는 LLM-as-Jev 는 이런 판단에 범용 LLM을 구조 변경 없이 결정 모델로 쓰는 방법을 제안하고, 미세조정(Fine-tuning)이 실제로 필요한 조건을 실험으로 정리한 연구입니다.
Jev와 Jev식 결정 모델
일반 채팅 모델도 이런 판단을 할 수 있습니다. 다만 답을 문장으로 생성하므로, 프로그램이 그 문장을 다시 파싱해 값으로 바꿔야 합니다. 생성에 시간이 들고, 형식이 어긋난 출력이 나올 위험도 남습니다.
TypeSafe AI가 공개한 Jev (
 Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI))는 이 문제를 다른 방식으로 풉니다. 앱이 현재 상태와 후보 선택지를 보내면, Jev는 문장을 생성하지 않고 선택지마다 확률을 돌려줍니다. 새 작업을 위해 전용 분류기를 학습할 필요 없이 지시문과 선택지만 바꾸면 됩니다. Jev의 가중치와 학습 방법은 공개되지 않았는데도, 논문에 따르면 Jev식 모델을 비교하는 JevBench 리더보드 ( Jev와 유사한 오픈소스 결정 모델에 대한 정리: Decision Index와 JevBench로 비교한 결정 모델 성능 비교)에는 이미 커뮤니티가 만든 Jev식 모델이 60개 넘게 올라와 있습니다.
Jev가 다루는 작업은 세 가지 형식입니다: K개 중 하나를 고르는 choice, 예와 아니오를 판정하는 noul, 순서가 있는 등급을 매기는 score 입니다. LLM-as-Jev 논문은 세 형식을 모두 "상태 하나와 후보 선택지 K개가 주어졌을 때 선택지별 확률 분포를 내는 문제" 하나로 정리합니다. 예와 아니오 판정은 선택지가 2개인 경우이고, 등급은 순서대로 늘어놓은 선택지입니다.
커뮤니티 Jev식 모델의 세 가지 접근과 한계
커뮤니티 모델들이 갈리는 지점은 모델 파라미터를 학습하느냐 여부입니다. 논문이 정리한 접근은 크게 세 가지로 나뉩니다.
첫째는 학습하지 않은 모델에서 선택지 글자(A, B, C …)의 로짓(logit)을 읽는 방식입니다. SemIf가 대표적이며, Qwen3.5-4B를 그대로 쓰고도 JevBench 공개 항목에서 81.0\% 를 기록했습니다. 그러나 글자 하나로 답을 읽으므로 선택지가 알파벳 개수(16개 또는 26개)를 넘으면 쓸 수 없습니다. 선택지를 하나씩 따로 평가하는 방식은 이 제한이 없습니다. LLM2Jev는 선택지마다 프롬프트를 만들어 "이 선택지가 맞는가"를 묻고, jev-local은 선택지마다 별도의 순전파로 로그 확률을 계산합니다. 그러나 이 방식은 선택지를 서로 비교하지 못합니다.
"가장 저렴한 요금제"나 "해당 없음"처럼 후보 전체를 놓고 판단해야 하는 질문에서 불리합니다. 실제로 jev-local은 더 큰 Qwen3.5-9B를 쓰고도 JevBench 공개 항목에서 74.9\% 에 그쳤습니다.
둘째는 LoRA 어댑터를 학습하는 방식입니다. 교사 모델이 만든 합성 질문과 어려운 오답 사례를 여러 차례 학습한 Plumb은 공개 항목에서 89.6\% 를 기록했습니다. 그런데 같은 Qwen3.5-4B를 LoRA로 학습한 Hopper와 reflex는 82.3\% 와 79.2\% 로, 학습하지 않은 SemIf와 비슷했습니다. reflex 저장소는 이후 시도한 미세조정이 모두 도움이 되지 않았다고 밝히고, 지금은 학습하지 않은 모델을 배포합니다.
셋째는 분류용 헤드나 전용 토큰을 새로 붙이는 방식입니다. 기반 모델에 포인터 헤드를 붙이는 kev ( kev: 비공개 모델 Jev를 Qwen과 LoRA로 재현해 맥북에서 학습하고 실행하는 결정 모델)가 이 부류에 속합니다. 논문이 비교한 버전은 Qwen3-0.6B 기반이고, 현재 저장소는 Qwen3.5와 Qwen3.8 기반의 0.8B부터 27B까지 제공합니다. 이 방식은 기반 모델이 바뀔 때마다 헤드를 다시 학습해야 합니다.
이 연구의 질문과 접근
이런 결과 차이에서 저자들은 두 가지 질문을 던집니다: 사전 학습된 LLM은 결정 모델로서의 능력을 이미 어느 정도 가지고 있는가, 그리고 미세조정은 어떤 조건에서 실제로 이득이 되는가입니다.
답을 찾기 위해 저자들은 LLM의 구조, 토크나이저, 어휘를 전혀 바꾸지 않는 방식을 택했습니다. 선택지에 대괄호 번호를 붙이고, 모델이 그 번호를 말할 확률을 그대로 결정 확률로 씁니다. 같은 인터페이스 위에 학습이 필요 없는 방법과 미세조정 방법을 함께 둡니다. 새 모델이 나오면 바로 평가할 수 있고, 시각 인코더가 있는 모델이면 이미지 문제도 같은 형식으로 풀 수 있다는 것이 저자들이 꼽는 장점입니다.
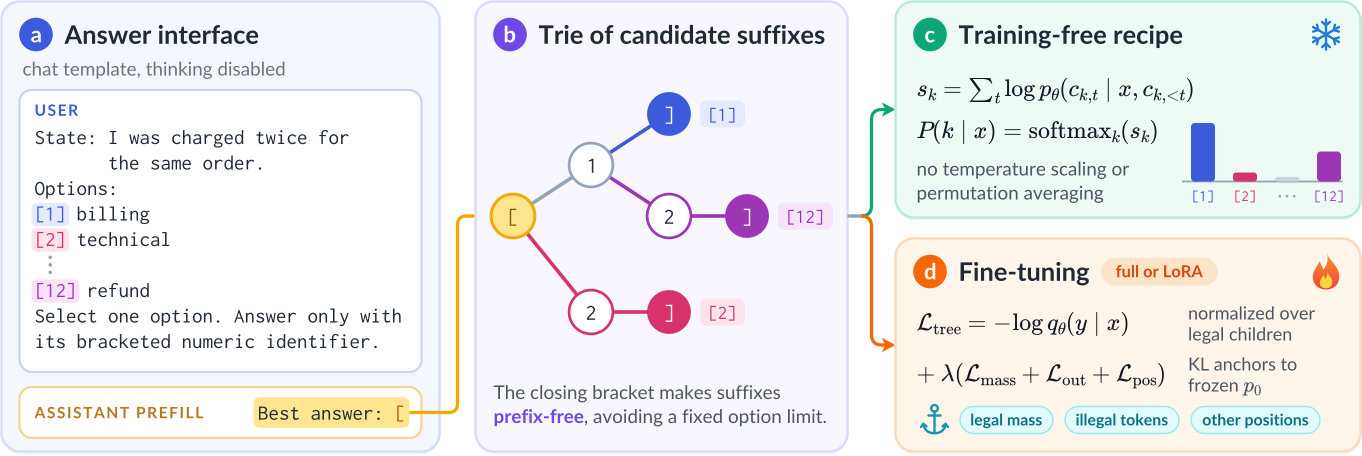
위 그림은 논문의 그림 1로, (a) 답변 인터페이스, (b) 후보 접미어의 트리, (c) 학습 없는 방법, (d) 미세조정 방법을 보여줍니다. 실험 결과, 학습하지 않은 Qwen3.5-4B는 저자들이 다시 실행한 SemIf, reflex 4B와 비슷하거나 더 나은 정확도를 냈습니다. 교사 모델의 합성 데이터로 학습한 Plumb 같은 모델은 공개 항목에서 더 높았습니다. 미세조정은 작은 모델과 특정 작업에서만 뚜렷한 이득을 줬습니다.
LLM-as-Jev의 답변 인터페이스와 학습 없는 방법
번호 붙인 선택지와 Best answer: [ 프리필
LLM-as-Jev는 모델의 기본 채팅 템플릿을 그대로 쓰고, 사고(thinking) 모드는 끕니다. 사용자 프롬프트는 다음 형식입니다.
State: {상태}
Options:
[1] {선택지 1}
[2] {선택지 2}
…
[K] {선택지 K}
Select one option. Answer only with its bracketed numeric identifier.
그리고 어시스턴트 응답을 Best answer: [ 로 미리 채웁니다. 이렇게 응답 앞부분을 고정해 두는 것을 프리필(Prefill)이라고 합니다. 이 상태에서 모델이 1] 을 이어 쓰면 1번, 12] 를 이어 쓰면 12번을 고른 것이 됩니다. 저자들은 이 k] 를 후보 접미어(Candidate Suffix) 라고 부릅니다.
닫는 괄호가 만드는 접두사 트리
닫는 괄호가 이 설계의 핵심입니다. 모든 후보 접미어가 ] 로 끝나므로, 어떤 완성된 접미어도 다른 접미어의 앞부분이 될 수 없습니다. 예를 들어 1] 은 12] 의 앞부분이 아닙니다. 이 성질 덕분에 선택지 개수에 상한이 없습니다. 참고로 TypeSafe의 Jev 소개 글에 따르면 Jev 자체는 선택지를 255개까지 지원합니다.
후보 접미어들은 자연스럽게 접두사 트리(트라이, Trie)를 이룹니다. 트리의 깊이는 토크나이저가 숫자를 어떻게 자르는지에 따라 다릅니다. Qwen처럼 숫자를 한 자리씩 자르는 토크나이저에서는 깊이가 \lfloor \log_{10} K \rfloor + 2 이하입니다. Phi-4처럼 세 자리까지 묶는 토크나이저에서는 999 이하의 번호가 토큰 하나가 되어 깊이가 2입니다. 저자들은 세 가지 토크나이저 계열에서 번호 1부터 1,000까지 모두 접두사 충돌이 없음을 확인했습니다 (세부 내용은 논문의 Appendix C를 참고해주세요).
후보 점수 계산과 병렬 평가
학습 없는 방법은 단순합니다. 입력 x 가 Best answer: [ 로 끝날 때, 후보 k 의 점수 s_k 는 접미어 토큰들의 로그 확률 합이고, 이를 소프트맥스로 정규화해 선택지 분포를 얻습니다.
여기서 c_{k,t} 는 후보 k 의 t 번째 접미어 토큰입니다. 온도 조정(Temperature Scaling)이나 선택지 순서를 바꿔 평균 내는 처리는 하지 않습니다.
모든 선택지가 한 프롬프트 안에 있으므로, 모델은 각 선택지를 다른 선택지와 비교한 상태에서 점수를 매깁니다. 앞에서 본 선택지별 개별 평가 방식과 가장 크게 다른 부분입니다.
계산 비용도 낮습니다. 후보 접미어는 미리 알고 있으므로 한 토큰씩 생성할 필요가 없습니다. 프롬프트의 키-값(Key-Value, KV) 캐시를 한 번 계산해 두고, 각 후보 분기를 교사 강제(Teacher Forcing)로 병렬 평가합니다. 저자들에 따르면 선택지가 151개인 작업도 프롬프트 프리필 한 번에, 숫자를 한 자리씩 자르는 토크나이저 기준으로 짧은 순전파 최대 세 번이면 끝납니다.
선택지 순서에 따른 위치 편향
모든 선택지를 한 프롬프트에 넣으면 선택지 순서가 결과에 영향을 줍니다. LLM에서 널리 보고된 위치 편향(Position Bias)입니다. 저자들은 미세조정할 때 학습 예제마다 선택지 순서를 무작위로 섞어, 번호 자체에 의미가 붙지 않게 했습니다. 추론(Inference) 시점에 순서를 바꿔 여러 번 평균 내면 편향을 더 줄일 수 있지만, 그만큼 계산량이 늘어나므로 효율을 위해 쓰지 않았습니다.
미세조정 방법: 트리 분해 리스트와이즈 손실과 KL 앵커
미세조정의 목표는 결정 정확도를 높이면서 범용 모델을 좁은 분류기로 망가뜨리지 않는 것입니다. 저자들은 학습이 바꾸는 범위를 "후보 번호 사이의 상대적 선호"로 한정하고, 나머지 출력 분포는 원래 모델과 같게 유지하려 했습니다. 이를 위해 손실 함수 하나와 정규화 항 세 개를 결합합니다.
허용 토큰 안에서만 재정규화하는 리스트와이즈 손실
트리의 각 노드에서 완성된 후보로 이어지는 토큰을 허용 토큰(Legal Token), 나머지 어휘를 비허용 토큰(Illegal Token) 이라고 합니다. 예를 들어 [ 다음 노드에서는 1, 2 같은 숫자가 허용 토큰이고, A 나 줄바꿈은 비허용 토큰입니다. 노드 v 에서 허용 토큰 확률의 합을 m_\theta(v) 라고 하면, 후보 k 의 확률은 각 단계에서 허용 토큰끼리만 다시 정규화한 값의 곱입니다.
\mathcal{L}_{\text{tree}} 는 정답 후보 y 의 음의 로그 우도로, K개 후보 전체에 대한 정확한 교차 엔트로피(Cross-entropy)와 같습니다. 이렇게 후보 목록 전체를 한 번에 놓고 정답을 고르게 하는 손실을 리스트와이즈 손실(Listwise Loss)이라고 합니다. 계산은 정답 번호를 적어 나가는 정답 경로(Gold Path) 를 따라서만 하면 되므로, 선택지가 151개여도 비용이 크지 않습니다.
세 가지 KL 앵커
\mathcal{L}_{\text{tree}} 는 허용 토큰 안에서만 정규화하므로 허용 토큰 사이의 상대적 선호만 학습합니다. 허용 토큰 전체의 확률이 크게 줄어도 손실은 낮게 유지될 수 있고, 비허용 토큰과 답 바깥 위치의 분포는 아무 제약을 받지 않습니다. 저자들은 학습하지 않은 원래 모델 p_0 와의 KL 발산(KL Divergence)으로 이 부분을 붙잡아 두는 KL 앵커(KL Anchors) 세 개를 추가했습니다.
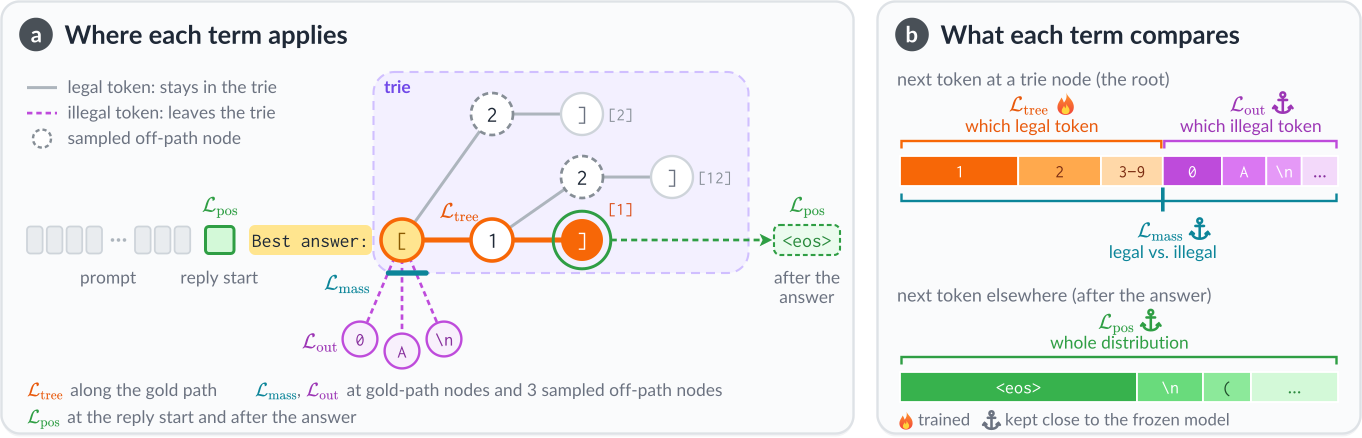
위 그림은 정답이 [1] 인 예제에서 각 손실 항이 어디에 작용하는지 보여줍니다.
- \mathcal{L}_{\text{mass}}: 트리 노드에서 허용 토큰과 비허용 토큰의 확률 비율을 원래 모델과 같게 유지합니다 (두 값만 있는 베르누이 분포 사이의 KL).
- \mathcal{L}_{\text{out}}: 비허용 토큰들 사이의 분포를 원래 모델과 같게 유지합니다.
- \mathcal{L}_{\text{pos}}: 응답이 시작되는 위치와 닫는 괄호 바로 다음 위치에서, 다음 토큰 분포 전체를 원래 모델과 같게 유지합니다.
최종 학습 목표는 \mathcal{L} = \mathcal{L}_{\text{tree}} + \lambda(\mathcal{L}_{\text{mass}} + \mathcal{L}_{\text{out}} + \mathcal{L}_{\text{pos}}) 이고, 기본값은 \lambda = 1 입니다. 앵커를 거는 노드는 정답 경로 전체와, 무작위로 뽑은 정답 경로 밖 노드(Off-path Node) 3개입니다.
계산량을 줄이는 장치도 있습니다. 앵커 분포는 원래 모델의 상위 64개 토큰만 남기고 나머지는 한 덩어리로 합쳐 계산합니다. 저자들은 상위 64개가 각 분포의 94.5\% 이상을 차지한다고 측정했습니다. 원래 모델의 이 통계를 학습 전에 미리 계산해 캐시해 두므로, 학습 중에 두 번째 모델을 메모리에 올릴 필요가 없습니다. 앵커를 걸고 경로 밖 노드 3개까지 평가하면 학습이 앵커 없는 학습보다 약 2.2\times 느려집니다.
저자들은 앵커 위치를 하나씩 빼는 실험도 했습니다. 어느 것을 빼도 JevBench 정확도는 유의하게 변하지 않았지만, 뺀 앵커가 맡던 분포가 흔들렸습니다. 응답 시작 위치와 답 뒤 위치의 앵커를 빼면 응답 시작 위치의 KL 발산이 4B에서 9.4\times, 0.6B에서 12.6\times 로 커졌습니다. 허용 토큰 질량만 붙잡고 분포 앵커 둘을 빼면, 텍스트 모드에서 4B는 16개 항목이 번호 뒤로 계속 썼고 0.6B는 39개가 길이 상한에 걸렸습니다.
학습 설정과 데이터
학습은 전체 파라미터 미세조정과 LoRA 두 가지로 했습니다. LoRA는 디코더 블록의 모든 선형 층에 rank 16으로 붙이고, 학습 뒤 기반 모델에 병합해 추론 지연 시간이 같도록 했습니다. 최적화는 AdamW와 FSDP로 하고, 데이터는 한 번만 훑습니다(1 에폭). 허용 토큰의 확률 질량이 원래 모델보다 크게 떨어지면 학습을 자동으로 멈추는 점검도 넣었습니다.
학습 데이터는 사람이 레이블을 단 공개 데이터셋만 썼고, 교사 모델이 만든 레이블은 쓰지 않았습니다. 평가 데이터와 13단어 n-gram이 겹치는 학습 예제는 제거했고, 긴 입력 데이터에 남은 우연한 중복 몇 건은 부록에 따로 밝혔습니다. 다만 데이터 구성을 바꿔 가는 과정이 JevBench 공개 항목의 오류 분석에서 출발했기 때문에, 저자들은 데이터 구성 비교 결과를 탐색적인 결과로 다룬다고 밝혔습니다.
LLM-as-Jev 실험 설계
기반 모델은 Qwen3.5-4B ( Qwen3.5: 초기부터 멀티모달 데이터로 학습한, 에이전트 중심의 워크플로우에 최적화된 Native Multimodal Agent Model, 사고 모드 끔)와 Qwen3-0.6B 두 가지입니다. 학습 설정은 데이터 구성과 스텝 수를 달리한 여섯 가지입니다.
| 설정 | 데이터 | 예제 수 | 스텝 |
|---|---|---|---|
| Intent-100 | 의도 분류 세트 | 3,000 | 100 |
| Intent-1ep | 의도 분류 세트 | 95,461 | 2,984 |
| Reason-9k | 추론(Reasoning) 6종 + 의도 분류 3종 (각 1천) | 9,000 | 282 |
| Reason-21k | 추론 6종 (각 3천) + 의도 분류 3종 (각 1천) | 21,000 | 657 |
| Reason-30k | Reason-21k + 추론 3종 (각 3천) | 30,000 | 938 |
| Reason+Long-12k | Reason-9k + 긴 입력 3종 | 12,000 | 375 |
평가는 다섯 축으로 했습니다.
- External: BoolQ, MMLU, MMLU-Pro, ARC-Challenge, WinoGrande, SciQ의 매크로 평균 정확도와, 선택지가 77개인 의도 분류 벤치마크 Banking77
- JevBench: 공개된 231개 항목(쉬움 48, 보통 72, 어려움 111)을 분포 밖(Out-of-Distribution) 진단용으로만 사용
- General: GSM8K, IFEval, TriviaQA, LAMBADA, WikiText-2로 범용 언어 능력이 유지되는지 확인
- Image: MMBench, MMStar로 학습에 없던 이미지 문제를 확인
- Behavior: Dolly-15k와 MT-Bench 프롬프트로 대화 응답이 정상적으로 끝나는지 확인
확률이 실제 정답률과 맞는 정도는 기대 보정 오차(Expected Calibration Error, ECE)와 브라이어 점수(Brier Score)로 측정했습니다. ECE는 예측을 확신도 구간으로 나눠 평균 확신도와 실제 정확도의 차이를 잰 값이고, 낮을수록 모델이 말한 확률을 믿을 수 있습니다. 브라이어 점수는 예측 확률 벡터와 정답(원-핫 벡터) 사이의 평균 제곱 오차로, 역시 낮을수록 좋습니다. 두 모델 비교는 예측이 서로 다른 항목만 놓고 양측 정확 부호 검정(Sign Test)으로 판정했습니다. 비교 대상은 SemIf, reflex 4B, open-alternative-jev, Winnow-12B이며, 저자들이 공식 구현으로 다시 실행한 결과는 공식 리더보드 값과 4개 항목 이내로 일치했습니다.
실험 결과 1: 학습 없이도 결정 모델로 동작하는 Qwen3.5-4B
아래 표는 논문의 주요 결과에서 비교 대상과 LLM-as-Jev의 대표 설정을 옮긴 것입니다 (정확도는 %). LLM-as-Jev의 미세조정 행은 모두 Reason+Long-12k 데이터로 학습했고, 0.6B LoRA만 \lambda = 0.01 입니다. Winnow-12B는 8비트 양자화(Q8)로, GPT-5.6 Sol은 텍스트 생성 방식으로 평가했습니다.
| 시스템 | JevBench 정확도 | JevBench 어려움 | JevBench ECE | External 평균 | Banking77 |
|---|---|---|---|---|---|
| GPT-5.6 Sol (텍스트 생성) | 94.4 | 88.3 | - | 91.5 | 86.0 |
| Winnow-12B (미세조정) | 86.6 | 74.8 | .058 | 82.2 | - |
| LLM-as-Jev 4B, 학습 없음 | 81.4 | 64.9 | .057 | 78.6 | 69.0 |
| LLM-as-Jev 4B, 전체 미세조정 | 80.1 | 61.3 | .070 | 78.9 | 75.2 |
| LLM-as-Jev 4B, LoRA | 84.0 | 68.5 | .050 | 78.9 | 75.4 |
| SemIf (학습 없음) | 80.5 | 60.4 | .061 | 75.4 | - |
| reflex 4B (미세조정) | 79.7 | 59.5 | .070 | 78.8 | - |
| open-alternative-jev (학습 없음) | 75.8 | 59.5 | .108 | 75.5 | - |
| LLM-as-Jev 0.6B, 학습 없음 | 56.7 | 33.3 | .278 | 57.9 | 22.2 |
| LLM-as-Jev 0.6B, 전체 미세조정 | 58.0 | 37.8 | .118 | 59.1 | 60.5 |
| LLM-as-Jev 0.6B, LoRA | 61.0 | 39.6 | .121 | 58.5 | 59.0 |
선택지 글자 하나로 답을 읽는 방식은 선택지가 77개인 Banking77을 평가할 수 없어 빈칸입니다.
같은 기반 모델의 커뮤니티 모델과 비슷한 정확도
학습하지 않은 Qwen3.5-4B는 JevBench 공개 항목 231개 중 188개를 맞혔습니다(81.4\%). 같은 모델로 글자 로짓을 읽는 SemIf는 186개, 미세조정한 reflex 4B는 184개였습니다. SemIf와의 차이는 이긴 항목 15개, 진 항목 13개로 통계적으로 의미가 없었습니다(p = 0.85). 평가한 비교 대상 중 이보다 높은 것은 훨씬 큰 Winnow-12B(86.6\%)와 상용 모델 GPT-5.6 Sol(94.4\%)뿐이었습니다.
External 벤치마크에서는 차이가 분명했습니다. 매크로 정확도가 SemIf보다 3.2 퍼센트포인트 높았습니다. 이긴 항목은 313개, 진 항목은 154개였습니다(p < 10^{-12}). MMLU(이긴 123, 진 56), MMLU-Pro(96 대 41), ARC-Challenge(28 대 8)에서 차이가 컸습니다. 두 방식은 가중치가 같으므로, 저자들은 이 차이를 선택지를 함께 보고 점수를 매기는 방식과 접두사 충돌 없는 번호 체계의 효과로 해석합니다.
77개 선택지와 확률 보정
Banking77의 77개 의도를 한 번의 추론으로 처리해 69.0\% 를 기록했습니다. 확률의 품질도 양호했습니다. 학습 없는 4B 모델의 JevBench ECE는 0.057 로, SemIf(0.061)와 공식 보정 파일을 적용한 reflex 4B(0.070)보다 낮았습니다. 별도의 온도 조정 없이 나온 값입니다.
같은 프롬프트로 탐욕적 디코딩(Greedy Decoding)을 해서 답을 생성하게 해도 정확도는 81.4\% 로 같았습니다. 231개 항목 모두에서 점수 계산 방식과 같은 선택지를 골랐고, 형식이 깨진 출력은 하나도 없었습니다. 저자들은 이를 프롬프트 형식이 모델의 자연스러운 생성 습관과 맞는다는 근거로 봅니다.
학습 없이 동작하는 이미지 결정
분류 헤드를 따로 붙이지 않으므로, 시각 인코더가 있는 모델은 같은 인터페이스로 이미지 문제를 풉니다. 이미지 토큰을 프롬프트 앞에 넣기만 하면 됩니다. Qwen3.5-4B는 MMBench에서 82.4\%, MMStar에서 64.6\% 를 기록했습니다. MMBench 점수는 선택지 순서를 돌려 가며 모두 맞혀야 정답으로 치는 CircularEval 기준입니다. 이미지를 빼면 점수가 15.2\% 와 28.8\% 로 떨어져, 모델이 실제로 이미지를 보고 답했음을 확인했습니다. Qwen 팀이 텍스트 생성 방식으로 보고한 값(MMBench 89.4, MMStar 78.3)과는 평가 방식이 달라 직접 비교할 수 없다고 저자들은 밝혔습니다.
작은 모델의 형식 문제
Qwen3-0.6B는 사정이 달랐습니다. JevBench 정확도 56.7\% 는 리더보드의 원시 로짓 기준선(48.1\%)보다 높지만, ECE가 0.278 로 확률을 믿기 어렵고 Banking77에서는 22.2\% 에 그쳤습니다. 선택지 151개인 CLINC150 검증 세트에서는 초기 교차 엔트로피가 6.9 nats로, 무작위로 고를 때(\ln 151 \approx 5.0)보다도 나빴습니다. 텍스트 생성 모드에서는 231개 중 219개 항목에서 번호 뒤에 선택지 설명을 덧붙였습니다. 저자들은 이런 형식 문제가 바로 파라미터 학습이 필요한 자리라고 봅니다.
실험 결과 2: 미세조정이 도움이 되는 조건
그렇다면 미세조정은 언제 효과가 있었을까요? 저자들의 결론은 세 조건이 함께 맞을 때입니다: 기반 모델이 해당 작업에서 약하고, 그 작업에 맞는 레이블 데이터가 있으며, 학습 데이터의 답 형식과 입력 길이가 실제 평가와 비슷할 때입니다.
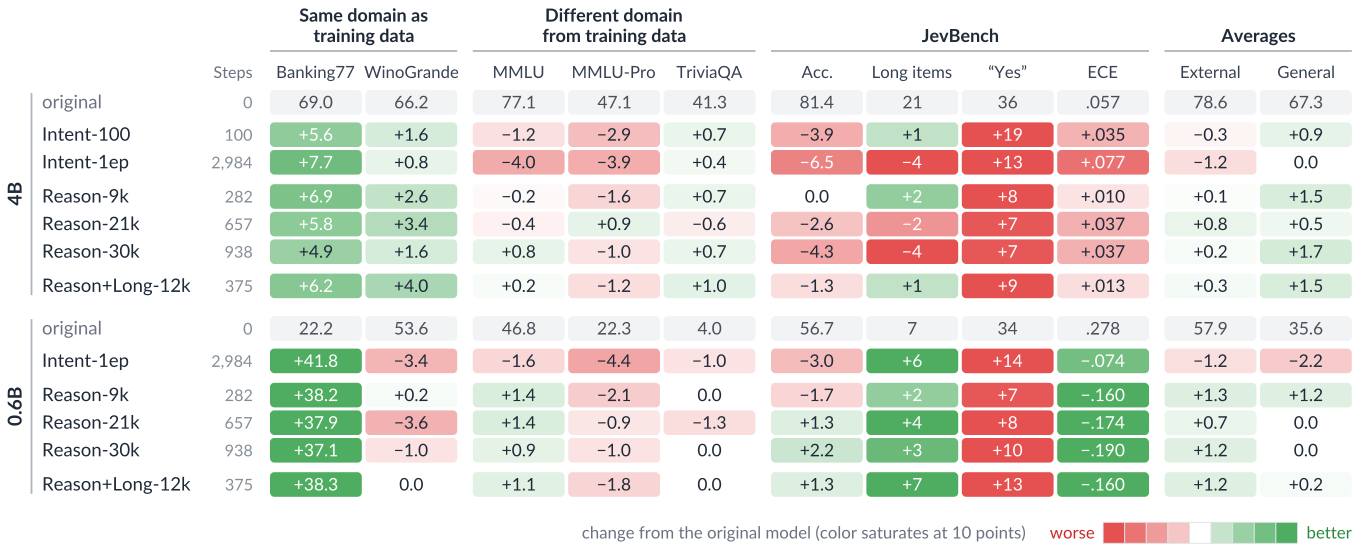
위 그림은 여섯 가지 학습 설정이 원래 모델 대비 각 지표를 얼마나 바꿨는지 보여줍니다. 초록색이 개선, 빨간색이 악화입니다. 학습 데이터에 있는 유형의 작업(Banking77, 4B의 WinoGrande)은 대체로 올랐고, 학습 데이터에 없는 지식 중심 작업(MMLU, MMLU-Pro, TriviaQA)은 거의 변하지 않았습니다. 저자들은 학습 데이터와 평가 데이터의 어휘 유사도도 측정했는데, 어휘가 가장 비슷한 MMLU 계열이 오르지 않은 것을 근거로 성능 향상은 어휘 공유보다 작업 형식 공유에서 온다고 해석합니다.
의도 분류 데이터만으로 학습할 때 생긴 지름길 학습
첫 시도는 의도 분류(Intent Classification) 데이터셋 3종(CLINC150, MASSIVE, Bitext)과 CommonsenseQA, HellaSwag을 섞은 의도 분류 세트였습니다. Banking77은 크게 올랐지만 JevBench는 오히려 떨어졌습니다. 4B 모델 기준으로 원래 81.4\% 에서 100스텝 뒤 77.5\%, 1 에폭 뒤 74.9\% 가 됐습니다(이긴 8, 진 23, p = 0.01). 그동안 학습 분포 안의 검증 손실은 계속 떨어졌습니다(Bitext 기준 0.65 \to 0.001).
오류 분석에서는 네 가지 지름길이 드러났습니다.
- 긍정 답변 편향: 예와 아니오 문제 74개에서 "예" 예측이 36개에서 49개로 늘었습니다. 실제 정답이 "예"인 문제는 35개입니다.
- 포괄 선택지 회피: "해당 없음" 같은 포괄 선택지에 주는 평균 확률이 줄었습니다.
- 키워드 일치: 어려운 객관식 문제에서 겉보기 단어가 겹치는 오답을 더 자주 골랐습니다.
- 과신: ECE가 0.057 에서 0.134 로 올랐습니다.
저자들은 데이터 구성에서 그럴듯한 원인을 찾습니다. 의도 분류 세트에는 예와 아니오 검증 문제가 없었습니다. 대부분의 예제는 키워드만 보고 풀 수 있었고, 지시문 템플릿은 4개뿐이었습니다. "해당 없음"이 정답인 예제는 95,461개 중 250개였습니다.
100스텝만 학습해도 긍정 답변 편향이 나타났으므로, 저자들은 학습 기간보다 데이터 구성이 전이(Transfer) 성능을 좌우한다고 봅니다. KL 앵커도 이 문제는 막지 못합니다. 앵커는 허용 토큰 사이의 확률 재배분을 제약하지 않기 때문입니다.
형식을 다양화한 추론 데이터와 짧은 입력의 함정
다음으로 저자들은 CommonsenseQA와 HellaSwag을 빼고, 형식이 다양한 추론 데이터셋 6종(ProofWriter, CosmosQA, ReClor, LogiQA 2.0, PIQA, αNLI)을 넣었습니다. 참, 거짓, 알 수 없음이 균형 잡힌 규칙 검증, "해당 없음"이 정답인 문제, 선택지 2개짜리 문제가 들어 있습니다. 이 Reason-9k 설정은 긍정 답변 편향을 줄이고(44개), JevBench에서 원래 모델과 같은 81.4\% 를 기록했습니다(이긴 14, 진 14). 전체 미세조정 4B 설정 중 가장 좋은 결과입니다.
그런데 4B 모델에서는 데이터를 늘리자 다시 나빠졌습니다(0.6B 모델은 떨어지지 않았습니다). 같은 종류의 추론 데이터를 2만 1천 개와 3만 개로 늘린 Reason-21k와 Reason-30k는 JevBench가 78.8\% 와 77.1\% 로 떨어졌습니다. Reason-9k와 비교하면 Reason-30k는 이긴 항목 없이 10개를 졌습니다(p = 0.002). 손실은 1,500 토큰이 넘는 긴 항목 37개에 몰렸습니다. 학습 데이터의 프롬프트는 길어야 약 570단어였던 반면, JevBench 어려운 항목에는 긴 정책 문서와 여러 단계 추론 문제가 있었습니다.
긴 입력 데이터셋 3종(ContractNLI, MuSiQue, QuALITY, 중간 길이 2.1천에서 6.8천 토큰)을 추가한 Reason+Long-12k는 이 하락을 멈췄습니다. 4B 모델은 긴 항목 22개를 맞혀 원래 수준(21개)으로 돌아왔습니다. 다만 JevBench 정확도는 80.1\% 로 Reason-9k에 못 미쳤고, 저자들은 학습 스텝이 더 적었던 점(375 대 938)도 회복에 기여했을 수 있다고 봅니다. 0.6B 모델은 긴 항목 정답이 7개에서 14개로 두 배가 됐습니다(이긴 7, 진 0, p = 0.02). 저자들은 결정 모델 학습에서 작업 형식뿐 아니라 입력 길이 분포도 평가 환경과 맞아야 한다고 정리합니다.
모델 크기에 따라 달라지는 미세조정의 효과
0.6B 모델은 JevBench 정확도(53.7\% 에서 58.9\%, 원래 56.7\%)를 빼면 대부분의 지표에서 좋아졌습니다. Banking77은 37.1 에서 41.8 포인트 올랐고, JevBench ECE는 0.278 에서 0.088 에서 0.204 사이로 내려갔습니다. 원래 모델이 답 형식을 제대로 따르지 못했기 때문에, 그 약점이 학습으로 메워진 효과가 컸습니다.
4B 모델은 약한 곳에서만 좋아졌습니다. 전체 미세조정 설정 중 JevBench에서 원래 모델을 넘은 것은 없었습니다(74.9\% 에서 81.4\%, 원래 81.4\%). Banking77은 4.9 에서 7.7 포인트 올랐습니다. 4B 모델은 이미 형식을 잘 따르고 확률도 잘 맞으므로, 넓은 범위의 결정 작업에서 공개 데이터로 메울 수 있는 빈틈이 적다는 것이 저자들의 해석입니다.
범용 능력은 유지됐습니다. General 평균이 유의하게 떨어진 설정은 없었고, 유일한 유의미한 변화는 4B Reason-30k의 1.7 포인트 상승이었습니다. 개별 작업 중에서는 0.6B Intent-1ep의 IFEval이 7.0 포인트 떨어진 것이 유일한 유의미한 하락입니다. 텍스트로만 학습했는데도 4B 모델의 MMBench 정확도는 원래 82.4\% 에서, 평가한 세 설정 모두 84.1\% 에서 85.3\% 사이로 올랐습니다. 늘어난 정답 대부분은 원래 모델이 선택지 회전에 따라 맞히기도 틀리기도 하던 문항이었고, 저자들은 이 결과가 선택지 순서를 섞어 학습한 것과 맞는다고 봅니다.
실험 결과 3: KL 앵커와 LoRA의 효과
마지막 질문은 어떻게 미세조정할지입니다. 저자들은 Reason+Long-12k 데이터로 앵커 가중치 \lambda 를 1, 0.1, 0.01, 0으로 바꾸며 전체 미세조정과 LoRA를 각각 다시 학습했습니다. \lambda = 0 은 앵커 없이 리스트와이즈 손실만 쓴 경우입니다.
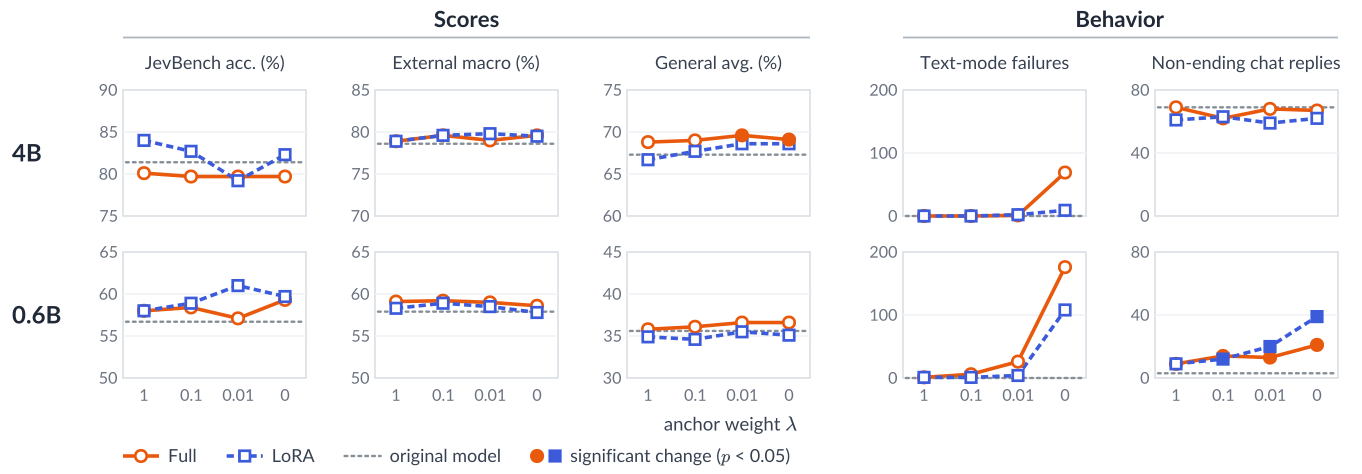
위 그림의 왼쪽 세 열(점수)은 앵커 가중치에 따라 거의 변하지 않습니다. 반면 오른쪽 두 열(동작)은 앵커가 약해질수록 나빠집니다.
KL 앵커가 없으면 생기는 생성 이탈
\mathcal{L}_{\text{tree}} 는 답 번호 이전 위치와 닫는 괄호 이후 위치에 학습 신호를 주지 않습니다. 그래서 앵커가 없으면 이 위치들의 분포가 가중치 공유의 부수 효과로 제멋대로 움직입니다. 앵커가 없을 때 응답 시작 위치와 답 뒤 위치의 KL 발산은 \lambda = 1 대비 4B에서 44\times 와 35\times, 0.6B에서 51\times 와 16\times 로 커졌습니다.
문제는 표준 벤치마크가 이 변화를 전혀 잡지 못한다는 점입니다. 앵커가 없는 4B 모델은 텍스트 생성 모드에서 JevBench 231개 중 69개 항목에 번호 뒤로 문장을 계속 썼고(44개는 32토큰 상한까지), 0.6B 모델은 176개가 상한에 걸렸습니다. 그런데도 JevBench 정확도와 General 점수는 떨어지지 않았습니다. 앵커 없는 0.6B 모델은 오히려 General 평균이 원래보다 1.0 포인트 높았는데, General 작업은 우도를 채점하거나 최종 답만 뽑아 보기 때문입니다. 작은 앵커(\lambda \geq 0.01)만 걸어도 형식을 깨는 생성은 거의 사라졌습니다.
대화 응답에서도 차이가 났습니다. 4B 모델은 모든 설정에서 새로 끝나지 않게 된 응답과 새로 끝나게 된 응답의 수가 비슷했습니다(앵커 없이 19개 대 21개). 0.6B 모델은 앵커가 약할수록 끝나지 않는 응답이 늘었습니다. 전체 미세조정 기준으로 새로 끝나지 않게 된 응답은 \lambda = 1 에서 7개, 0.1에서 13개, 0.01에서 12개, 0에서 20개였습니다. \lambda = 1 미만은 모두 통계적으로 유의했습니다. 대부분 브레인스토밍처럼 긴 답을 요구하는 프롬프트에서 번호 목록이 끝없이 이어지는 형태였습니다.
참고로 저자들은 초기 실험에서 리스트와이즈 손실만으로 학습한 모델이 완전히 무너진 사례도 보고합니다. 허용 토큰 확률이 약 e^{-17} 까지 떨어지고 JevBench가 52.8\% 가 됐으며, 텍스트 모드 답 231개 중 파싱 가능한 것이 없었습니다. 다만 이 실험은 학습률, 워밍업, 배치 크기가 달라서 원인을 앵커 부재 하나로 돌릴 수는 없다고 밝혔습니다.
앵커 가중치 \lambda 의 선택
4B 모델에서는 가장 강한 앵커(\lambda = 1)가 전체 미세조정과 LoRA 모두에서 가장 높은 JevBench 정확도와 가장 낮은 ECE를 냈습니다. 다만 다른 가중치와의 차이는 대부분 몇 개 항목 수준입니다. 0.6B 모델에서는 앵커를 약하게 하면 Banking77이 조금 올랐습니다(전체 미세조정 \lambda = 0.01 에서 62.4\% 대 \lambda = 1 에서 60.5\%). 대신 끝나지 않는 대화 응답이 유의하게 늘었습니다. 저자들은 대화 기능보다 분류 정확도가 확실히 중요한 경우가 아니면 두 크기 모두 \lambda = 1 을 쓰라고 권합니다.
LoRA vs 전체 미세조정
4B 모델에서는 LoRA가 앞섰습니다. \lambda = 1 의 LoRA 모델은 JevBench 84.0\% 로 이 논문의 4B 모델 중 가장 높았고(학습 없는 모델 대비 이긴 13, 진 7로, 유의성은 보고되지 않았습니다), ECE 0.050 과 브라이어 점수 0.240(원래 모델 0.247)도 가장 좋았습니다. 같은 \lambda 의 전체 미세조정보다 3.9 포인트 높았고(이긴 10, 진 1, p = 0.01), General 평균(66.7\% 대 원래 67.3\%)과 대화 동작에서 유의한 악화는 없었습니다. LoRA는 4개 앵커 설정 중 3개에서 학습 없는 모델보다 높았고(82.3\% 에서 84.0\%), \lambda = 0.01 만 79.2\% 로 낮았습니다.
0.6B 모델에서는 두 방식이 비슷했습니다. \lambda 가 1, 0.1, 0일 때 JevBench 차이는 1개 항목 이내였고, 0.6B 최고 기록은 \lambda = 0.01 의 LoRA(61.0\%)였습니다.
LoRA가 앵커를 대신하지는 못했습니다. 앵커 없는 4B LoRA는 텍스트 모드에서 9개 항목이 번호 뒤로 계속 썼고, 0.6B LoRA는 108개가 길이 상한에 걸렸습니다. 0.6B에서는 앵커가 약할 때 LoRA의 대화 이탈이 전체 미세조정보다 더 심했습니다(\lambda = 0 에서 새로 끝나지 않는 응답 38개 대 20개).
저자들이 제안하는 실무 지침
저자들은 실험 결과를 바탕으로 범용 LLM을 결정 모델로 쓸 때의 지침을 여섯 가지로 정리했습니다.
-
학습 없는 방법에서 시작합니다. 성능 좋은 기반 모델과 번호 붙인 인터페이스만으로 보정이 잘 된 출발점을 얻을 수 있고, 새 모델도 바로 평가할 수 있습니다.
-
확인된 약점에만 미세조정합니다. 작은 모델이나 선택지가 많은 라우팅처럼 기반 모델이 분명히 약하고, 해당 도메인의 레이블 데이터가 있을 때입니다. 다양한 결정 작업 전반의 정확도가 오를 것이라고 기대하지 않습니다.
-
학습 데이터를 실제 사용 분포에 맞춥니다. 예와 아니오 검증, "해당 없음" 선택지, 실제 프롬프트 길이 분포를 포함하고, 지시문 표현을 다양하게 하며, 키워드만으로 풀리는 쉬운 예제는 덜어냅니다. 저자들에 따르면 수백 스텝 정도면 충분합니다.
-
KL 앵커를 유지합니다. \lambda = 1 이 두 크기 모두에서 안정적인 기본값입니다.
-
성능 좋은 기반 모델에는 LoRA를 씁니다. 최고 정확도가 더 높고 원래 모델에서 덜 벗어납니다.
-
분포 안 지표 밖의 동작을 확인합니다. 체크포인트는 학습 분포의 손실이 아니라 분포 밖 전이 성능으로 고르고, 열린 프롬프트에 대한 생성 결과를 직접 확인합니다. 우도 기반 지표로는 형식 이탈과 끝나지 않는 생성을 잡지 못합니다.
LLM-as-Jev의 한계와 결과를 해석할 때 주의할 점
JevBench 수치는 공개 항목 기준의 진단 결과입니다. 저자들은 JevBench의 공개 항목 231개만 썼고, 이 값을 공식 순위 대신 진단용 정확도로 보고한다고 밝혔습니다. JevBench 순위표에는 비공개 항목 308개의 정확도도 함께 나오는데, 여기서는 Jev 1.13.0도 36.7\% 이고 무작위로 고를 때 약 29.3\% 입니다. 논문이 정리한 커뮤니티 모델들은 공개 항목에서 63.2\% 에서 89.6\% 였지만, 비공개 항목에서는 24.0\% 에서 38.0\% 사이였습니다. LLM-as-Jev는 비공개 항목 점수가 없으므로, 공개 항목에서의 순위가 비공개 항목에서도 유지되는지는 알 수 없습니다. JevBench 하네스 저장소도 공개 항목은 학습에 쓰이거나 그에 맞춰 선택될 수 있다고 밝히고 있습니다.
데이터 구성 비교는 탐색적 결과입니다. 학습 데이터 구성을 바꾼 계기가 JevBench 공개 항목의 오류 분석이었기 때문입니다. 저자들은 하이퍼파라미터 조정과 체크포인트 선택에는 JevBench를 쓰지 않았다고 밝혔습니다. 또한 모든 설정을 단일 시드로 학습했으므로, Banking77 같은 개별 벤치마크에서 1에서 2 퍼센트포인트 차이는 실행 간 편차일 수 있습니다.
속도는 최적화하지 않았습니다. 참조 구현은 FP32로 동작하며, RTX A5500 한 장에서 응답 지연 시간 중앙값이 4B 모델 194ms, 0.6B 모델 76ms였습니다. BF16으로 동작하는 SemIf는 46ms입니다. 저자들은 지연 시간 최적화가 이 연구의 범위 밖이라고 밝혔습니다.
학습 데이터 라이선스를 확인해야 합니다. 저자들이 쓴 데이터셋 중 ReClor는 비상업 연구용으로만 허용되고, LogiQA 2.0과 QuAIL은 CC BY-NC-SA 4.0입니다. αNLI와 ProofWriter는 공식 배포본에 라이선스 표기가 없습니다. 같은 데이터 구성을 상업 서비스에 그대로 쓰기는 어렵습니다.
두 자리 번호에서 생기는 쏠림이 있습니다. 숫자를 한 자리씩 자르는 토크나이저에서는 선택지 1과 10의 첫 토큰이 같습니다. 학습 뒤 4B 모델은 MMLU-Pro에서 10번 답을 덜 고르고 1번으로 옮겨 갔고, 이 문항들에서 잃은 문제 수가 MMLU-Pro 전체 손실보다 컸습니다. 저자들은 원인을 아직 찾지 못했다고 밝혔습니다.
재현 경로가 아직 없습니다. 논문에는 코드나 학습한 가중치의 공개 링크가 없습니다. 인터페이스와 점수 계산은 논문의 설명과 부록의 하이퍼파라미터로 구현할 수 있지만, 앵커 통계 캐시와 학습 중단 점검 같은 세부는 직접 만들어야 합니다.
이 연구에 따르면, 결정 모델을 만들 때 별도 아키텍처나 대량의 합성 데이터 없이도 쓸 만한 출발점을 얻을 수 있습니다. 새 기반 모델이 나오면 번호 붙인 프롬프트로 먼저 측정하고, 약점이 확인된 작업에만 KL 앵커를 건 LoRA로 보완하는 순서가 저자들이 제안하는 흐름입니다. 또한 정확도와 퍼플렉서티(Perplexity) 같은 표준 지표가 멀쩡해도 생성 동작은 망가질 수 있다는 결과는, 분류 목적으로 LLM을 미세조정할 때 생성 결과를 직접 확인해야 하는 이유입니다.
 LLM-as-Jev: LLMs Are Already Jev-Style Decision Models, When and How to Fine-Tune Them 논문
Introducing System One Models & Jev 소개 블로그
 JevBench v1.4.2.2 리더보드
 JevBench GitHub 저장소
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
Jev와 유사한 오픈소스 결정 모델에 대한 정리: Decision Index와 JevBench로 비교한 결정 모델 성능 비교
-
Laya: 텍스트 생성 없이 한 번의 순전파로 결정을 내리는 Jev 호환 오픈 가중치 모델과 로컬 실행 도구들
-
Liquid AI, 문장 생성 대신 Jev 호환 API로 분류 / 라우팅 / 점수를 처리하는 결정 모델 d1 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글은 파이토치 한국 사용자 모임 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
