핵심 요약
- Modular는 2022년 초 Chris Lattner와 Tim Davis가 세운 회사입니다. Democratizing AI Compute 연재에서 밝힌 목표는 CUDA에 묶인 AI 소프트웨어 스택을 여러 하드웨어가 함께 쓰는 공용 계층으로 다시 만드는 것입니다.
- 그 결과물이 시스템 프로그래밍 언어 Mojo 와 추론(Inference) 프레임워크 MAX 이며, 두 프로젝트의 코드는 modular/modular GitHub 저장소에 함께 공개되어 있습니다.
- Mojo는 2026년 8월 11일 1.0에 도달했고, 같은 달 18일에 컴파일러까지 Apache 2.0(LLVM 예외 포함)으로 공개되었습니다. 10월 22일 나온 1.2에는 패턴 매칭이 추가되었습니다.
- 현지 시각 10월 22일에는 MAX 26.7과 함께 그래프 컴파일러, 런타임, 하드웨어 백엔드까지 소스 코드 전체를 공개하였습니다. 다만 이 핵심부와 배포 바이너리에는 Apache 2.0이 아닌 MAX License가 적용되어, 수정한 소스는 기여 목적의 포크에서만 공개할 수 있는 소스 공개(Source-Available) 방식입니다.
- 2026년 7월 Qualcomm이 Modular 인수를 마쳤고, Modular는 Mojo와 MAX를 계속 유지하며 Qualcomm과 경쟁하는 하드웨어도 지원하겠다고 밝혔습니다.
Modular 프로젝트 소개
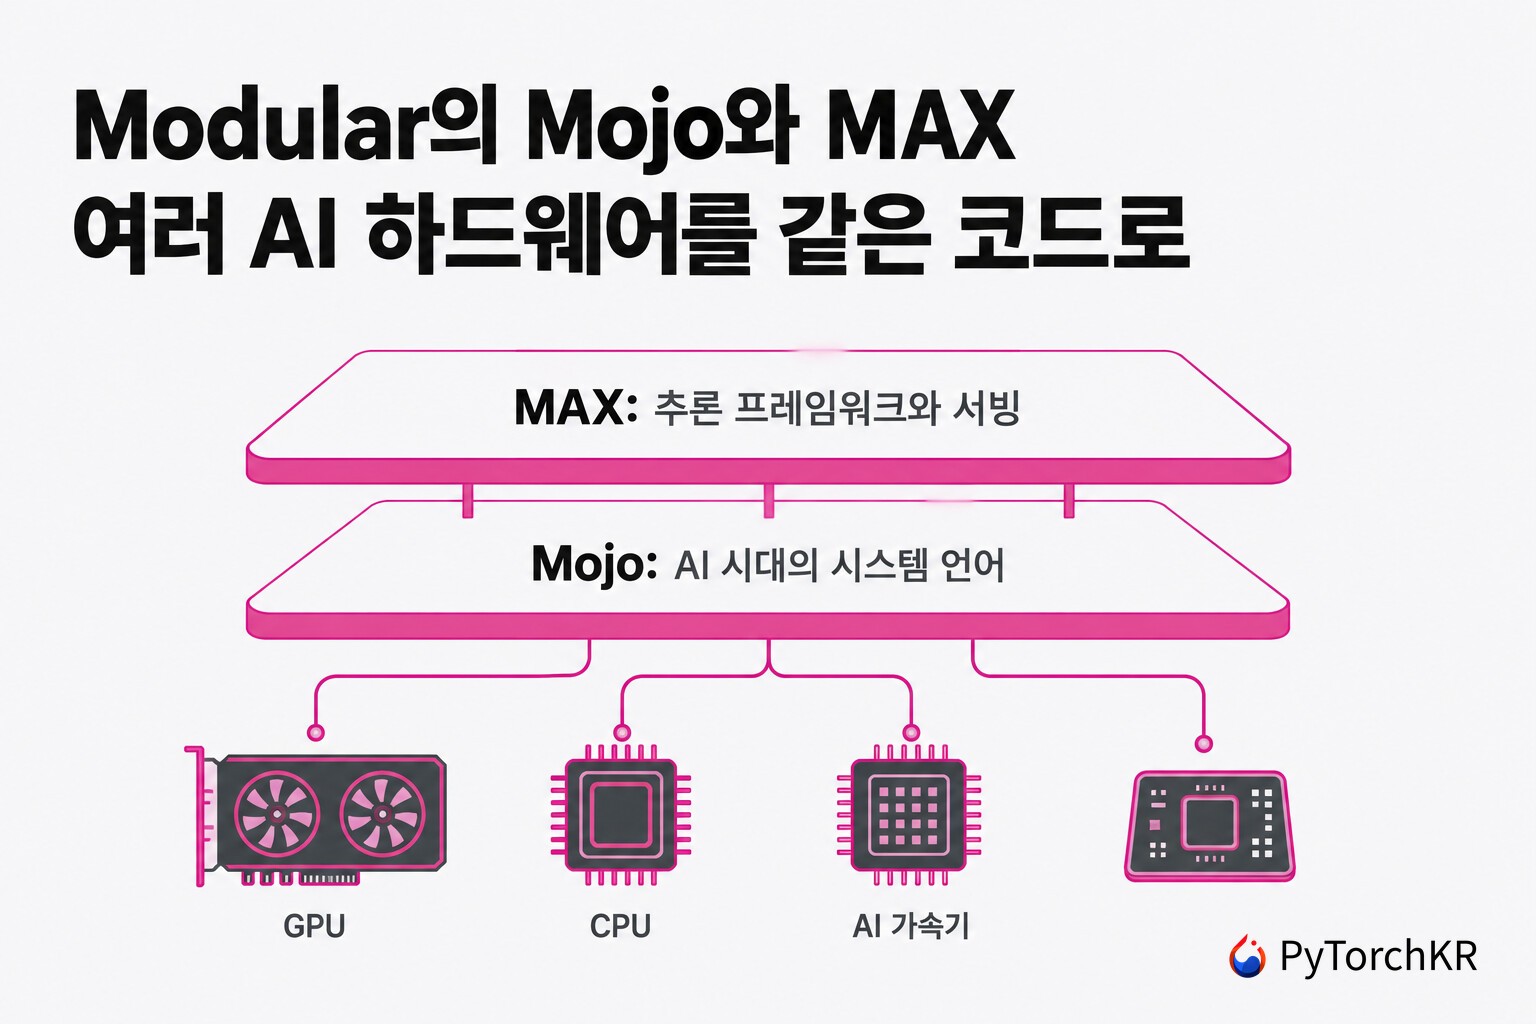
Modular는 AI 모델을 여러 종류의 하드웨어에서 같은 코드로 실행할 수 있도록, 프로그래밍 언어부터 모델 서빙까지의 소프트웨어 스택을 처음부터 다시 만들고 있습니다. 지금의 AI 소프트웨어는 대부분 NVIDIA의 CUDA를 전제로 작성되어 있습니다. 그래서 AMD GPU나 Apple 실리콘, 클라우드 업체의 자체 가속기로 옮기려면 커널과 서빙 코드를 상당 부분 다시 작성해야 합니다. Modular는 하드웨어마다 소프트웨어 스택을 따로 만드는 대신, 모든 하드웨어가 공유하는 하나의 계층으로 이 문제를 풀겠다는 입장입니다.
이번에 소개할 Modular의 프로젝트는 크게 두 가지입니다. 하나는 Python 문법으로 CPU와 GPU 커널을 직접 작성할 수 있는 시스템 프로그래밍 언어 Mojo입니다. 다른 하나는 Mojo 커널과 그래프 컴파일러로 모델을 실행하고 OpenAI 호환 API로 서빙하는 프레임워크 MAX입니다. 그 위에서 Modular는 관리형 추론 서비스인 Modular Cloud를 상용 제품으로 운영합니다. 이 글은 회사보다 두 프로젝트에 초점을 두고, 왜 시작했는지, 어떻게 구현되어 있는지, 어떤 특징과 한계가 있는지를 공식 홈페이지, 문서, 블로그, GitHub 저장소의 내용으로 정리합니다.
Modular의 공동 창업자인 Chris Lattner는 LLVM 프로젝트를 만들고 Apple에서 Swift 언어 개발을 이끌었습니다. 이후 Google에서 TPU 소프트웨어와 MLIR(Multi-Level Intermediate Representation) 컴파일러 인프라 개발을 이끌었습니다. 아래에서 살펴볼 연재에서도 Modular가 만드는 계층을 LLVM의 설계에서 영감을 받은 것으로 설명합니다. 한편 Modular는 2026년 7월 Qualcomm에 인수되었고, 지금은 Qualcomm 산하에서 Mojo, MAX, Modular Cloud를 계속 개발하고 있습니다.
왜 시작되었나: CUDA 종속과 파편화된 AI 소프트웨어 스택
Modular가 공식적으로 밝힌 출발점은 2022년 초입니다. 2022년 4월 첫 공개 글 The future of AI depends on Modularity에서 Chris Lattner와 Tim Davis는 TensorFlow, PyTorch, CUDA가 각각 서로 의존하는 수많은 부품으로 이루어진 거대한 기술이 되었다고 지적했습니다. 그 결과 AI 배포 도구가 수십 개로 파편화되었다는 진단입니다. 두 사람은 1990년대에 난립하던 C/C++ 컴파일러를 GCC가 정리한 역사를 예로 들었습니다. 이후 2000년에 시작된 LLVM은 모듈식 설계로 자리 잡았습니다. 그리고 다음 세대 AI 시스템은 기존 코드를 다시 쓰지 않고도 여러 프레임워크, 여러 클라우드, 여러 하드웨어를 기본으로 지원해야 한다고 썼습니다.
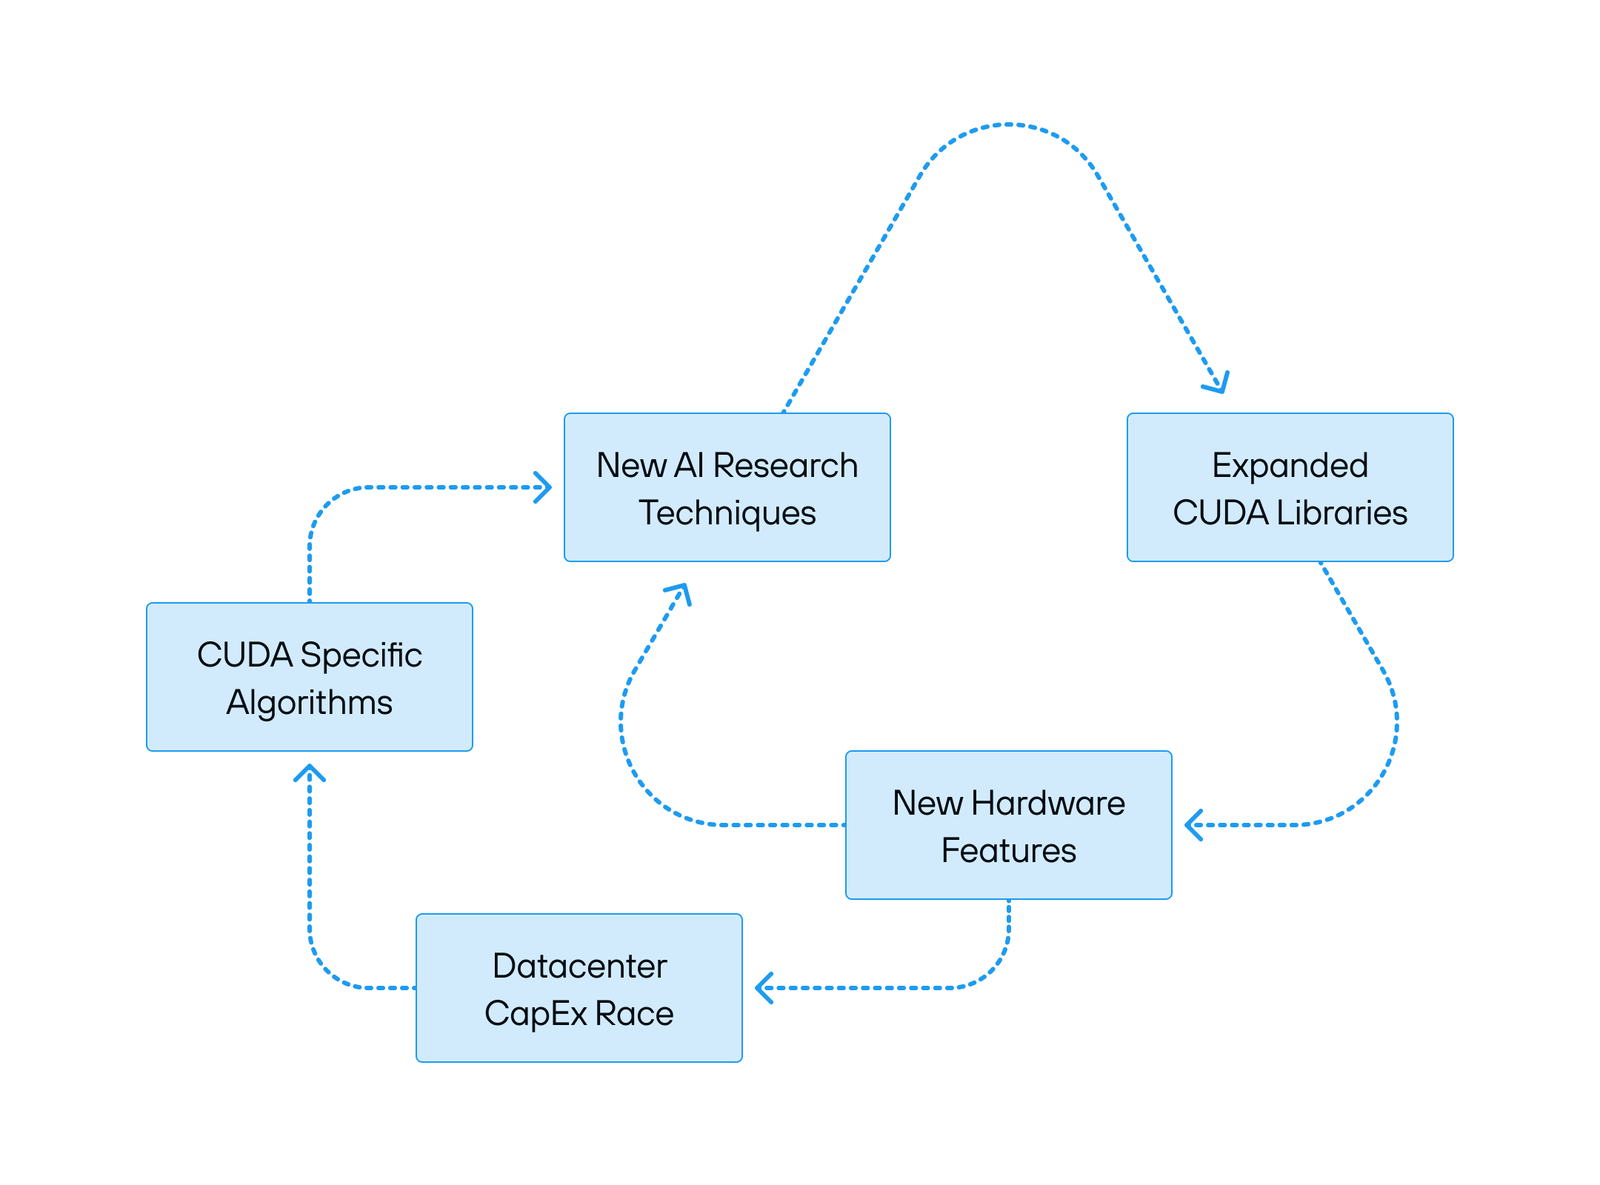
2025년에 Chris Lattner가 11부작으로 연재한 Democratizing AI Compute에서는 문제의 중심이 CUDA 종속(Lock-in)으로 옮겨집니다. 이 연재에 따르면 CUDA는 단일 라이브러리가 아니라 드라이버, 컴파일러, cuBLAS 같은 라이브러리, 개발 도구가 층층이 쌓인 CUDA 플랫폼(The CUDA Platform) 입니다. 또한 새 GPU 세대가 나올 때마다 성능을 위해 코드를 크게 다시 작성해야 하는 성능 이식성(Performance Portability) 문제가 있습니다. 아래 그림은 연재 3부에 실린 순환 구조입니다. 새로운 AI 연구 기법, CUDA 라이브러리 확장, 새 하드웨어 기능, 데이터센터 투자 경쟁, CUDA 전용 알고리즘이 서로를 키우면서 종속이 스스로 강화되는 과정을 보여줍니다.
연재는 이 종속을 풀려던 기존 시도들이 왜 성공하지 못했는지를 하나씩 다룹니다. 아래 표는 각 편에서 Chris Lattner가 내린 진단을 정리한 것으로, Modular 쪽의 시각이라는 점을 감안해서 읽어야 합니다.
| 기존 시도 | 연재의 진단 (Chris Lattner의 견해) |
|---|---|
| OpenCL, SYCL, oneAPI 등 C++ 기반 표준 (5부) | 위원회 합의 속도가 느리고, 표준만 있고 기준 구현(Reference Implementation)이 없었으며, 텐서 코어를 표준으로 지원하지 못해 AI에서 쓰일 수 없었다 |
| TVM, XLA 등 AI 컴파일러 (6부) | 최신 하드웨어에서 최고 성능을 내기 어려웠고, 하드웨어를 지나치게 추상화해 사용자 정의 알고리즘과 세밀한 제어를 잃었다 |
| Triton 등 Python 내장 DSL (7부) | Python처럼 보이지만 Python이 아니며, 생산성을 위해 성능을 내주는 구조라 H100에서 20% 정도 손해를 보는 경우가 흔하다고 보았다 |
| MLIR 단독 (8부) | 기술적으로는 성공해 거의 모든 AI 스택에 들어갔지만, 초기에 방언(Dialect)이 난립하고 핵심 개발자가 경쟁사로 흩어져 CUDA 종속을 깨지 못했다 |
| 하드웨어 제조사의 자체 소프트웨어 (9부) | 하드웨어 회사는 구조적으로 소프트웨어 생태계를 독립 제품으로 보기 어렵고, 큰 고객 한 곳에 맞춘 데모 중심으로 흐르기 쉽다 |
이러한 진단을 바탕으로 연재 10부는 Modular의 선택을 설명합니다. 핵심은 LLVM에서 영감을 받은 공용 계층, 곧 하드웨어 제조사가 자기 칩을 꽂아 넣고 그 칩의 장점을 표현하면서도 성능을 스스로 책임질 수 있는 시스템입니다. 이를 위해 Modular는 칩도, 클라우드도, 파운데이션 모델도 만들지 않는 독립 회사로 남겠다고 했고, 연구 단계에서는 "합의가 연구를 죽인다" 는 이유로 의도적으로 비공개 개발을 택했습니다. 또한 CPU에서 먼저 범용성을 증명한 뒤 GPU로 넓히는 순서를 밟았다고 설명합니다. 2026년 8월 ModCon에서 Modular는 이 출발점을 다음과 같이 다시 정리했습니다.
"4년 반 전, Modular는 AI가 영원히 한 종류의 실리콘에서만 실행되지는 않을 것이며, 이기종 하드웨어와 점점 복잡해지는 AI 워크로드의 세계에 맞게 소프트웨어 스택을 다시 설계해야 한다는 데 베팅했습니다."
"Four and a half years ago, Modular made a bet: AI would not run on one kind of silicon forever, and the software stack would need to be rearchitected for a world of heterogeneous hardware and increasingly complex AI workloads."
Mojo: Python 문법으로 CPU와 GPU를 함께 다루는 시스템 언어
새 언어를 만든 이유
Modular는 처음부터 새 프로그래밍 언어를 만들 계획이 아니었습니다. 지금은 삭제된 예전 Why Mojo 문서(2023년)에 따르면, 플랫폼을 만들면서 스택 전체를 오가는 프로그래밍이 너무 복잡했고 MLIR을 손으로 많이 작성해야 했습니다. 2023년 블로그 What's the difference between the AI Engine and Mojo?에 따르면 엔지니어들은 처음에 커널을 MLIR로 직접 작성했지만 생산성에 문제가 있었습니다. 이 블로그는 Mojo가 당시 AI 엔진의 내부 개발 수요를 채우려고 태어났다고 설명합니다.
현재 공식 문서의 Mojo Vision은 선택지를 세 가지로 비교합니다. 첫째, C++, Rust, Julia, Swift 같은 기존 언어를 확장하는 방법은 이 언어들이 CPU 시대에 설계되어 필요한 하드웨어 기능을 지원하지 못해 제외했습니다. 둘째, Python이나 C++ 위에 내장 DSL(Embedded DSL)을 만드는 방법은 호스트 언어의 문법을 바꿀 수 없어 제외했습니다. 남은 길이 완전히 새로운 언어였고, Modular는 언어를 확정하기 전에 거의 1년 동안 이 접근을 시제품으로 검증했다고 밝혔습니다. 같은 문서는 Python, C++, Rust, CUDA를 오가야 하는 복잡성을 N개 언어 문제(N Language Problem) 라고 부르고, Mojo가 이를 하나의 언어로 묶는 것을 목표로 한다고 설명합니다.
MLIR Core 위에 세운 KGEN 컴파일러
Mojo 컴파일러의 내부 이름은 KGEN(Kernel Generator)입니다. Vision 문서에 따르면 KGEN은 MLIR Core 위에서만 만들어졌고, MLIR 프로젝트에 있는 linalg, affine, scf 같은 AI 관련 방언은 쓰지 않습니다. 대신 매개변수가 있는 코드를 구체적인 값으로 확정하기 전의 상태 그대로 표현합니다. Vision 문서는 이 덕분에 컴파일이 빨라지고 오류 메시지가 명확해지며, 같은 소스 코드를 여러 대상 장치로 컴파일할 수 있다고 설명합니다. 또한 Mojo 코드는 컴파일러를 수정하지 않고도 MLIR 방언의 연산을 직접 표현할 수 있습니다(모든 MLIR 방언을 지원하지는 않습니다).
GitHub 저장소의 Mojo 컴파일러 안내 문서는 컴파일 과정을 6단계로 설명합니다. 전통적인 추상 구문 트리(AST, Abstract Syntax Tree) 없이 파서가 곧바로 MLIR 연산을 만든다는 점이 일반적인 컴파일러와 다릅니다.
- 구문 분석과 타입 검사: 소스 코드를 매개변수가 남아 있는
lit방언의 중간 표현(IR, Intermediate Representation)으로 만듭니다. - 의미 검사와 하향 변환: 소유권과 수명 검사(Borrow Check)를 거쳐 KGEN 방언으로 내립니다.
- 확정 전 최적화: 매개변수가 남아 있는 상태에서 먼저 최적화를 적용합니다.
- 확정(Elaboration): 함수와 구조체를 실제 매개변수 값으로 단일화(Monomorphization)하고, 컴파일 타임 코드는 인터프리터로 실행합니다. 이 단계는 병렬로 동작합니다.
- 확정 후 하향 변환과 최적화: 구체화된 코드를 다시 최적화합니다.
- LLVM으로 변환: LLVM 방언을 거쳐 LLVM IR과 기계어를 만듭니다.
공식 FAQ는 Mojo가 대상 하드웨어마다 LLVM 수준의 방언과 다른 MLIR 기반 코드 생성 백엔드를 활용하므로 새로운 하드웨어 백엔드로 확장하기 쉽다고 설명합니다. 실제로 Qualcomm의 NPU(Neural Processing Unit) 지원은 업스트림 LLVM에 있는 Hexagon 백엔드를 활용해 구현했다고 Modular 블로그가 밝히고 있습니다.
Mojo의 주요 특징
Mojo는 Python과 비슷해 보이지만 미리 컴파일(AOT, Ahead-of-Time)되는 정적 타입 언어입니다. 공식 문서의 Mojo 기본 문법은 Mojo가 정적 타입 검사와 메모리 안전성을 갖추고 있어 C++, Rust와도 공통점이 많다고 설명합니다. 같은 문서는 Mojo가 아직 프로그래밍 입문자를 위한 언어는 아니라고 밝히고 있습니다. 주요 특징은 다음과 같습니다.
-
소유권(Ownership) 기반 메모리 관리: 가비지 컬렉터(Garbage Collector) 없이, 각 값의 소유자를 한 번에 하나로 제한하고 소유자의 수명이 끝나면 값을 해제합니다. 공식 문서는 이 방식이 해제 후 사용(Use-after-free), 이중 해제, 메모리 누수를 결정론적으로 막는다고 설명합니다.
-
컴파일 타임 매개변수(Parameter)와 메타프로그래밍: 대괄호 안의 매개변수는 항상 컴파일 타임 값이고, 소괄호 안의 인자는 런타임 값입니다. C++ 템플릿이나 Rust 제네릭과 비슷한 역할을 하지만, 컴파일 타임 코드를 런타임 코드와 같은 문법으로 작성한다는 점이 다릅니다.
-
SIMD(Single Instruction, Multiple Data)를 기본으로 한 숫자 타입: Mojo의 숫자 타입은
SIMD타입을 바탕으로 하며, 1.0부터는Int도Scalar[DType.int]의 별칭입니다. 프로세서의 벡터 레지스터를 언어 차원에서 그대로 다룰 수 있습니다. -
같은 언어로 작성하는 GPU 커널: 별도의 DSL이나 CUDA C++ 없이 CPU 코드와 같은 언어로 GPU 커널을 작성하고, 필요하면 PTX(Parallel Thread Execution) 같은 저수준 어셈블리까지 내려갈 수 있습니다. NVIDIA, AMD, Apple 실리콘 GPU를 지원합니다.
-
Python 상호 운용(Interoperability): Mojo에서 수정하지 않은 CPython 런타임을 불러 기존 Python 라이브러리를 그대로 쓸 수 있고, 반대로 Mojo 함수를 Python 모듈로 내보낼 수도 있습니다. 이 중 Python에서 Mojo를 부르는 기능은 공식 문서에서 아직 베타 기능으로 표시되어 있습니다.
아래는 공식 매뉴얼에 실린 컴파일 타임 매개변수 예시입니다. count 는 컴파일 타임 값이고, comptime 키워드가 붙은 for 반복문은 컴파일 시점에 완전히 펼쳐집니다.
def repeat[count: Int](msg: String):
    comptime for i in range(count):
        print(msg)
GPU 커널도 같은 언어로 작성합니다. 아래는 MAX 문서의 GPU 입문 튜토리얼에 실린 벡터 덧셈 커널로, 스레드마다 원소 하나를 처리하는 CUDA와 비슷한 SIMT(Single Instruction, Multiple Threads) 모델을 따릅니다. 1.0부터 GPU 관련 API 대부분이 표준 라이브러리에서 max 패키지로 옮겨졌기 때문에 max.gpu 에서 block_idx, thread_idx 등을 가져와 씁니다.
def vector_addition(
    lhs_tensor: TileTensor[float_dtype, type_of(layout), ImmutAnyOrigin],
    rhs_tensor: TileTensor[float_dtype, type_of(layout), ImmutAnyOrigin],
    out_tensor: TileTensor[float_dtype, type_of(layout), MutAnyOrigin],
):
    """Calculate the element-wise sum of two vectors on the GPU."""

    # Calculate the index of the vector element for the thread to process
    var tid = block_idx.x * block_dim.x + thread_idx.x

    # Don't process out of bounds elements
    if tid < vector_size:
        out_tensor[tid] = lhs_tensor[tid] + rhs_tensor[tid]
Python 라이브러리를 부르는 방법은 아래와 같습니다. Mojo는 자체 CPython 인터프리터를 포함하지 않고, 실행 환경의 기본 Python을 동적 라이브러리로 불러 씁니다.
from std.python import Python

def main() raises:
    # This is equivalent to Python's `import numpy as np`
    var np = Python.import_module("numpy")

    # Now use numpy as if writing in Python
    var array = np.array(Python.list(1, 2, 3))
    print(array)  # [1 2 3]
2023년의 Modular는 Mojo가 점차 Python의 상위 집합(Superset)이 될 것이라고 소개했습니다. 그러나 현재 로드맵은 "Mojo가 Python의 완전한 상위 집합으로 발전할 수도, 그렇지 않을 수도 있으며, 그렇지 않아도 괜찮다" 고 적고 있습니다. Vision 문서도 표면적인 Python 호환보다 이식 가능한 고성능 연산에 필요한 기능을 먼저 만든다고 밝히고 있습니다.
Mojo 1.0부터 1.2까지, 그리고 컴파일러 공개
Mojo는 2023년 5월 첫 공개 이후 빠르게 바뀌어 왔고, 그 때문에 커뮤니티가 장기 프로젝트를 유지하기 어려웠습니다. 2026년 8월 11일 공개된 Modular 26.5는 Mojo 1.0을 발표하면서 1.x 기간 동안의 변경은 주로 기능 추가가 되도록 하고, 하위 호환을 깨는 변경은 C++처럼 성숙한 언어의 관례에 따라 신중하게 다루겠다고 약속했습니다. 공식 FAQ에 따르면 1.0부터 핵심 언어와 표준 라이브러리의 안정 부분에 의미적 버전(Semantic Versioning)을 적용하고, 6주마다 안정 버전을 내는 것을 목표로 합니다. 다만 안정성 문서에 따르면 이 보장은 소스 코드에만 적용되고, ABI(Application Binary Interface)는 아직 안정적이지 않습니다. 표준 라이브러리에서 @stable 로 표시된 안정 API의 범위도 아직 작습니다.
일주일 뒤인 8월 18일, Modular는 개발자 행사 ModCon에서 Mojo 컴파일러와 도구 전체를 공개했습니다. 공개 범위는 컴파일러와 표준 라이브러리, 언어 서버(LSP), LLDB 디버거 연동, 코드 포매터, REPL까지이며, 라이선스는 Apache License v2.0 with LLVM Exceptions입니다. 2024년 3월 표준 라이브러리, 2025년 5월 MAX 커널에 이어 컴파일러까지 공개한 것입니다. Modular는 소수의 설계 팀이 언어의 정체성을 먼저 정하고, 그 뒤에 커뮤니티 피드백으로 보완하는 방식을 의도적으로 택했다고 설명합니다. 26.5 블로그에 따르면 표준 라이브러리 공개 이후 200명 가까운 기여자가 1,100개 이상의 PR로 20만 줄 넘는 코드를 바꾸었습니다.
9월 17일의 Modular 26.6과 Mojo 1.1부터는 컴파일러도 외부 기여를 받습니다. 기여 범위 문서에 따르면 현재 컴파일러 팀은 버그 수정과 리팩터링만 받으며, 언어 의미나 MLIR 방언의 의미, 컴파일 파이프라인을 바꾸는 변경은 받지 않습니다. 기여 안내에 따르면 기여자는 CLA에 서명해야 하고, 새 기여자는 동시에 열 수 있는 PR이 2개로 제한됩니다. 저장소의 AI 도구 정책은 AI 도구 사용을 허용하되 Assisted-by: 표기를 요구하고, 사람의 검토 없는 완전 자동화 기여는 받지 않는다고 밝히고 있습니다. 1.1에서는 예전 문법인 fn, alias, @parameter if/for 와 .mojopkg 형식이 제거되었으므로, 이 문법을 쓰는 예전 예제 코드는 그대로 컴파일되지 않습니다.
10월 22일의 Modular 26.7과 함께 나온 Mojo 1.2는 로드맵 2단계인 시스템 프로그래밍 언어로 본격적으로 나아가는 릴리스입니다. 가장 큰 변화는 패턴 매칭(Pattern Matching)으로, match 문이 값을 여러 패턴과 차례로 비교하고 일치한 패턴의 코드를 실행합니다. 같은 패턴을 if, while 문과 구조 분해 할당에도 쓸 수 있고, comptime match 로 컴파일 시점에도 쓸 수 있습니다. 또한 20개가 넘는 std.math 함수가 시스템 libm 대신 CPU와 GPU가 공유하는 Mojo 구현으로 바뀌어 GPU에서도 실행되고, nn 패키지의 컴파일 시간이 약 98초에서 약 61초로 줄었습니다. 아래는 26.7 블로그에 실린 패턴 매칭 예시입니다.
def classify_point(p: Tuple[Int, Int]) -> String:
    match p:
        case 0, 0:
            return "origin"
        case x, 0 if x < 0:
            return String("negative x-axis:", x)
        case x, 0:
            return String("x-axis:", x)
        case 0, y:
            return String("y-axis:", y)
        case x, y:
            return String("point:", x, ",", y)
더 알아보기: Mojo
Mojo 공식 문서: 설치, 언어 매뉴얼, 표준 라이브러리, 로드맵
Mojo GPU Puzzles: 퍼즐을 풀면서 Mojo로 GPU 프로그래밍을 배우는 공식 학습 자료
Mojo 1.0 발표 블로그: 1.0의 안정성 약속과 26.5의 변경 사항
MAX: Mojo 커널과 그래프 컴파일러로 만든 추론 프레임워크
MAX의 구성
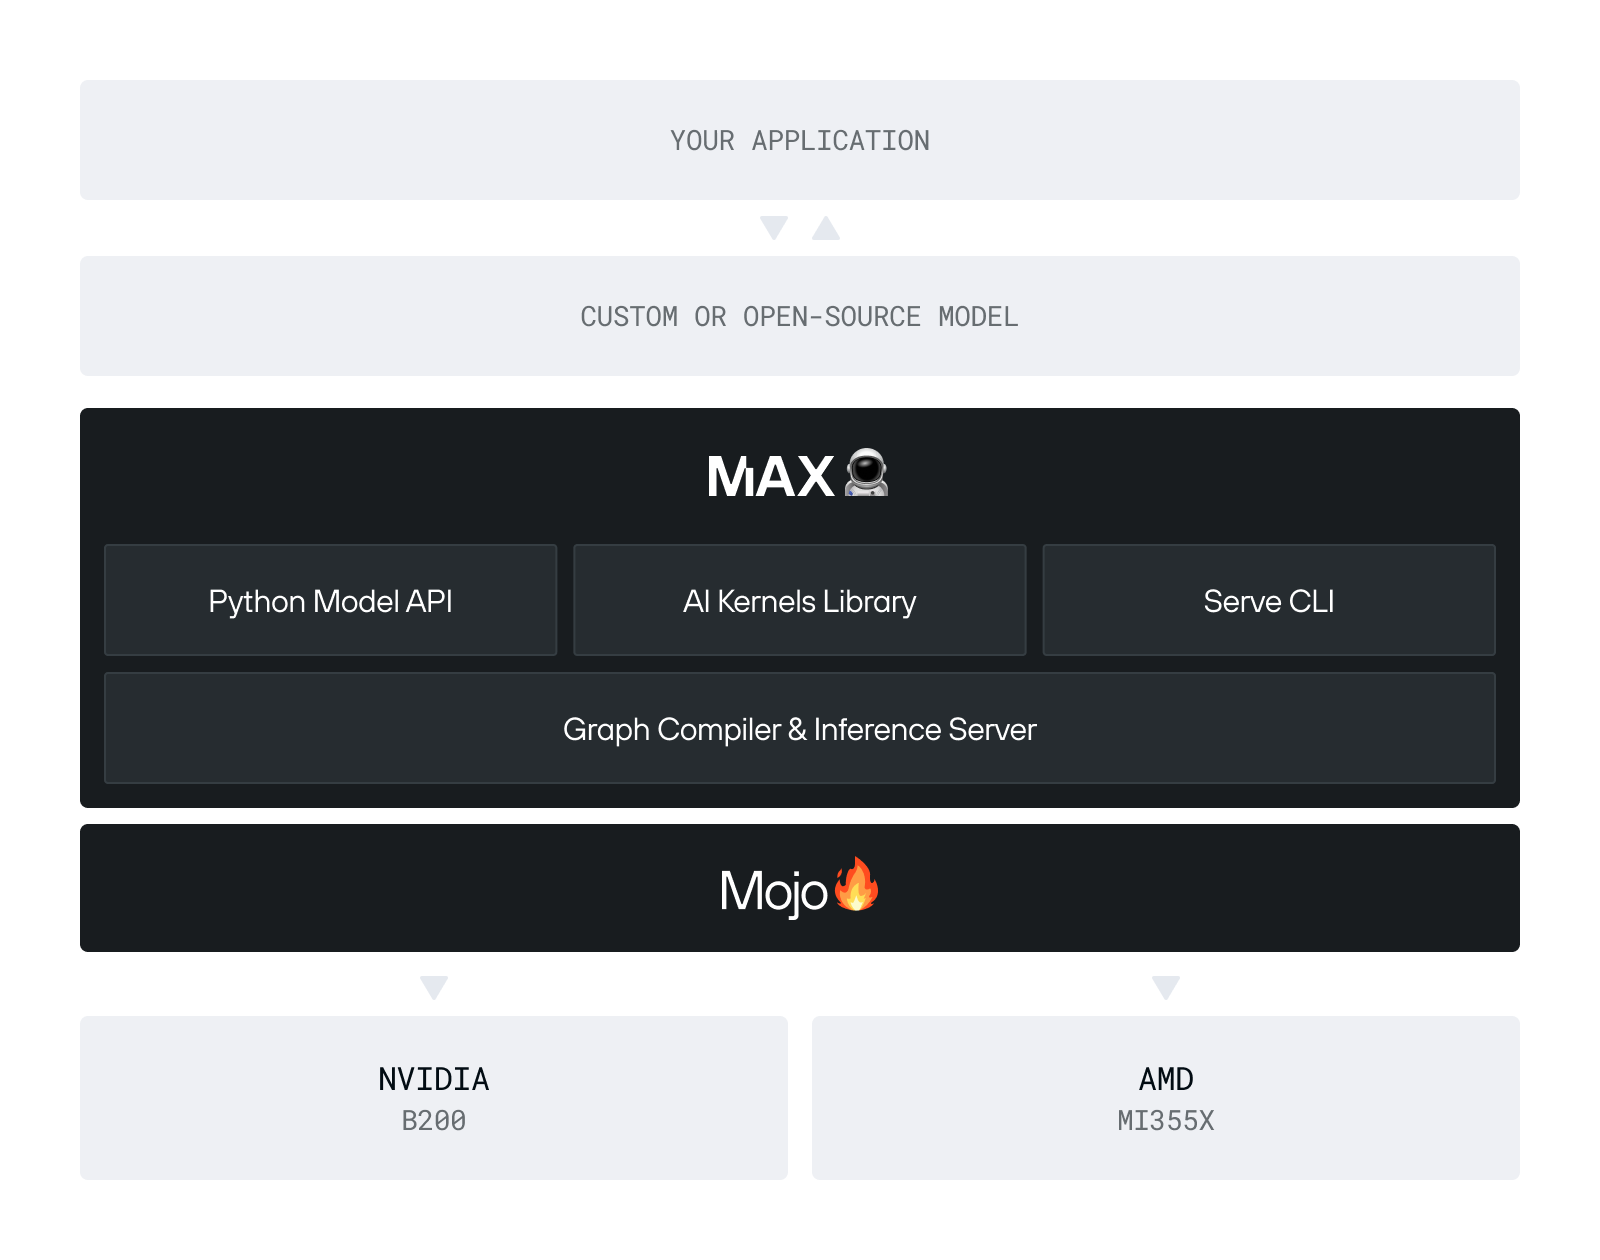
MAX 공식 문서는 MAX를 고성능 AI 서빙 및 모델링 프레임워크로 소개하며, 서빙, 모델링, GPU 프로그래밍의 세 가지 기능을 묶은 것이라고 설명합니다. 사용자는 Hugging Face에 공개된 모델을 그대로 서빙할 수도 있고, PyTorch와 비슷한 Python API로 모델을 직접 구현하거나 Mojo로 커스텀 커널을 작성해 넣을 수도 있습니다. 아래 그림은 Modular 26.1 블로그에 실린 MAX의 구조입니다.
-
Python 모델 API: 계산 그래프를 명시적으로 만드는
max.graph와max.nn방식, 그리고 바로 실행해 볼 수 있는 즉시 실행(Eager) 방식의max.experimental이 있습니다. 즉시 실행 방식으로 작성한 연산도Module로 묶어compile()을 호출하면 하나의 최적화된 그래프로 바뀝니다. 26.7부터는 커스텀 연산까지 즉시 실행 모드를 완전히 지원하며, 즉시 실행과 컴파일이 같은 코드 경로를 공유합니다. 26.7 블로그에 따르면 Gemma 4 31B의 일부 구간에서 첫 토큰까지 걸리는 시간이 컴파일 방식은 약 110초, 즉시 실행 모드는 약 30초였습니다. 공식 문서는 새 모델 구조를 이식할 때 ModuleV3 방식을 권장하지만,max.experimental의 이름과 모듈 구조는 릴리스마다 바뀔 수 있다고 안내합니다. -
그래프 컴파일러: 그래프 문서에 따르면 MAX에서 실행되는 모든 모델은 그래프로 기록된 뒤 컴파일됩니다. 컴파일러는 연산 융합(Fusion)으로 메모리 이동을 줄이고, 메모리 할당과 재사용을 계획하고, 하드웨어에 맞게 튜닝된 커널을 고릅니다. 그래프 컴파일러의 소스는 26.7부터 저장소의
/GraphCompiler에 공개되어 있습니다. -
MAX 가속기 라이브러리(MAX Accelerator Library): Mojo로 작성한 저수준 커널 모음입니다. 26.5부터 이전 이름인 MAX AI Kernels 대신 이 이름을 쓰며, GPU 프로그래밍 API도 이
max패키지 아래로 모였습니다. -
커스텀 연산(Custom Ops): Mojo로 작성한 커널을 MAX 그래프에 연산으로 등록할 수 있습니다. 커스텀 연산 문서에 따르면
max.experimental.torch의CustomOpLibrary로 등록하면 MAX로 옮기지 않은 기존 PyTorch 모델에서도 Mojo 커널을 쓸 수 있습니다. 저장소의 PyTorch 커스텀 연산 예제에는 Whisper 모델의 어텐션 층을 Mojo로 작성한 융합 어텐션 연산으로 바꾸는 예제도 있습니다. -
max serve: OpenAI 호환 엔드포인트를 제공하는 추론 서버입니다. 요청 스케줄링, 연속 배치(Continuous Batching), KV(Key-Value) 캐시 관리, 병렬화, safetensors와 GGUF 형식의 가중치 로딩을 MAX가 맡고, 모델 작성자는 모델 그래프와 가중치 변환기, 설정 등만 구현하면 됩니다.
공식 문서는 MAX가 PyTorch, CUDA, ROCm에 의존하지 않아 컨테이너가 작고 시작이 빠르다고 설명합니다. 다만 같은 문서의 컨테이너 안내를 보면 전체 기능이 들어간 max-full 이미지에는 PyTorch와 ROCm, cuDNN이 포함되어 있고, 최소 구성은 -base 이미지입니다. MAX로 NVIDIA GPU를 쓰려면 NVIDIA 드라이버도 여전히 필요합니다.
서빙 기능과 성숙도
MAX의 서빙 기능은 vLLM이나 SGLang과 비슷한 영역을 다룹니다. 그런데 기능마다 성숙도가 달라서, 공식 문서에 적힌 상태를 함께 확인해야 합니다.
| 기능 | 공식 문서의 상태 (MAX 26.7 기준) |
|---|---|
| 연속 배치, OpenAI 호환 API | 기본 제공 (/v1/chat/completions, /v1/completions, /v1/embeddings, /v1/responses 등). 26.7에서 분류, 점수, 예/아니오 판정용 /v1/decisions 와 System One 호환 /v1/systemone 추가 |
| PagedAttention 기반 KV 캐시와 접두사 캐싱(Prefix Caching) | 기본 활성화. 멀티모달 모델과 LoRA 어댑터에는 접두사 캐싱 미지원 |
| Jenga KV 캐시 | 26.6에서 Gemma와 Llama의 기본값이 되었고, 26.7부터 전체 기본값 |
| 투기적 디코딩(Speculative Decoding): EAGLE, MTP(Multi-Token Prediction), DFlash, DSpark | 프리뷰(Preview), API와 동작이 바뀔 수 있음 |
| 텐서, 데이터, 전문가(Expert) 병렬화 | 단일 노드에서 지원. 파이프라인 병렬화는 미지원 |
| 프리필과 디코딩 분리(Prefill-Decode Disaggregation) | 실험적(Experimental) 기능 |
| 이미지, 동영상, 오디오 생성 | FLUX.2(26.2), Wan 2.1/2.2(26.3), MiniMax-Music3(26.6) 지원 |
여러 노드에 걸친 대규모 분산 서빙은 2025년에 Kubernetes 기반 플랫폼 Mammoth로 소개되었지만, 2026년 10월 현재 Mammoth 제품 페이지와 문서는 더 이상 열리지 않습니다. 2026년의 라우터 연재는 접두사 인식 라우팅을 상용 서비스인 Modular Cloud 내부의 분산 추론 계층으로 설명합니다. 따라서 이 부분은 공개된 max serve 와 구분해서 보아야 합니다.
지원 하드웨어와 모델
MAX의 패키지 문서에 따르면 MAX는 CPU와 GPU를 모두 지원하지만, GPU 서빙을 정식으로 테스트하는 하드웨어는 NVIDIA B200과 AMD MI355X입니다. 그 밖의 호환 GPU에서도 모델이 동작할 수 있지만 서빙 테스트 대상은 아닙니다. Apple 실리콘(M1~M5)은 일부 모델만 지원하며, Llama, Gemma, Nemotron, FLUX.2 계열을 직접 실행해 확인했지만 아직 다른 GPU와 같은 야간 CI에는 포함되지 않았습니다. 운영체제는 Linux와 macOS이고 Windows는 공식 지원하지 않습니다.
Mojo로 커널을 작성할 수 있는 GPU의 범위는 더 넓습니다. 하드웨어 호환성 문서는 NVIDIA Turing(sm_75)부터 Blackwell까지, AMD CDNA2 이후의 Instinct와 RDNA2 이후의 Radeon, Apple M1~M5를 나열합니다. Turing에서는 MAX의 기본 행렬 곱 커널이 Ampere(sm_80) 이상을 요구하므로 이를 쓰는 모델은 실패합니다. 2026년 8월 ModCon에서는 AWS Trainium, Google TPU, Qualcomm Cloud AI 100 Ultra와 Dragonfly 지원도 발표되었습니다. 그러나 Modular는 이들을 앞으로 몇 달에 걸쳐 Modular Cloud를 통해 프로덕션에 투입하겠다고 밝혔고, 10월 현재 MAX 하드웨어 문서에는 아직 올라와 있지 않습니다.
지원 모델은 모델 문서에 Hugging Face Transformers의 모델 구조 단위로 정리되어 있습니다. 여기에는 Llama, Gemma 4, gpt-oss, DeepSeek V3/V4, Qwen3, Kimi K2.5, GLM, MiniMax, Mistral 계열과 FLUX.2, Wan 같은 이미지, 동영상 생성 모델이 포함되어 있습니다. 새 모델 구조를 이식할 때는 Hugging Face 모델을 MAX 모델로 바꾸는 import-model 과 원본 모델과의 출력 차이를 찾는 debug-model 같은 에이전트 스킬도 공식 저장소에서 제공합니다.
설치와 실행
MAX는 Python 패키지로 설치합니다. 26.6부터 예전의 modular 패키지는 폐기되었으므로, 아직 일부 페이지에 남아 있는 pip install modular 대신 아래 명령을 써야 합니다. Mojo만 필요하면 mojo 패키지를 설치합니다.
uv pip install --upgrade mojo
uv pip install "max[all]"
GPU가 있는 Linux 환경에서, 위 패키지를 설치한 뒤 아래 명령으로 OpenAI 호환 서버를 실행합니다. 빠른 시작 문서의 예시 모델인 Gemma 4 31B는 96GiB 이상의 GPU 메모리를 요구하며, 공식 문서는 NVIDIA B200이나 AMD MI355X를 권장합니다.
max serve --model google/gemma-4-31B-it
서버가 실행되면 OpenAI Python SDK로 바로 요청을 보낼 수 있습니다.
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

completion = client.chat.completions.create(
    model="google/gemma-4-31B-it",
    messages=[
        {
          "role": "user",
          "content": "Who won the world series in 2020?"
        },
    ],
)

print(completion.choices[0].message.content)
Docker를 쓰는 경우에는 modular/max-nvidia-full 이나 modular/max-amd 같은 공식 컨테이너를 실행해도 됩니다. 컨테이너는 아직 macOS와 호환되지 않습니다. MAX는 기본적으로 익명 사용 지표를 수집하며, MAX_SERVE_DISABLE_TELEMETRY 환경 변수로 끌 수 있습니다.
더 알아보기: MAX
MAX 공식 문서: 빠른 시작, 서빙 가이드, 모델 개발, GPU 프로그래밍
Build an LLM from scratch with MAX: MAX로 LLM을 처음부터 구현해 보는 공식 학습서
Modular 26.7 릴리스 블로그: MAX 소스 전체 공개, 커스텀 연산을 포함한 즉시 실행 모드, Mojo 1.2
이식성과 성능은 어떻게 얻는가: 구조화된 Mojo 커널
여러 하드웨어에서 같은 코드를 쓴다는 Modular의 목표는 커널 단계에서 어떻게 구현될까요? AMD MI355 지원 경험을 다룬 글에 따르면 Mojo와 MAX는 GPU에 대한 지식과 최적화를 컴파일러에 고정하지 않고 모두 라이브러리에 맡깁니다. 또한 SIMD 폭이나 타일 크기 같은 상수를 코드에 고정하지 않고 컴파일 타임 매개변수로 만들었습니다. 새 하드웨어에서는 이 값을 다시 튜닝하면 됩니다. Modular는 이 방식 덕분에 MI355 지원을 엔지니어 두 명이 2주 만에 마쳤다고 밝혔습니다.
2026년 3월부터 연재된 Structured Mojo Kernels는 이 설계를 커널 구조로 구체화합니다. 이 연재는 하나의 커널을 데이터 이동을 맡는 TileIO, 생산자와 소비자 사이의 동기화를 맡는 TilePipeline, 행렬 곱 연산을 맡는 TileOp 의 세 구성 요소로 나눕니다. 세 요소는 공통 설정 계층과 공통 텐서 타입인 TileTensor로 연결됩니다. 각 구성 요소는 서로의 내부를 모르도록 분리되어 있어서, 예를 들어 합성곱(Convolution)은 행렬 곱 커널에서 TileIO만 im2col 방식으로 바꾸어 구현할 수 있습니다.
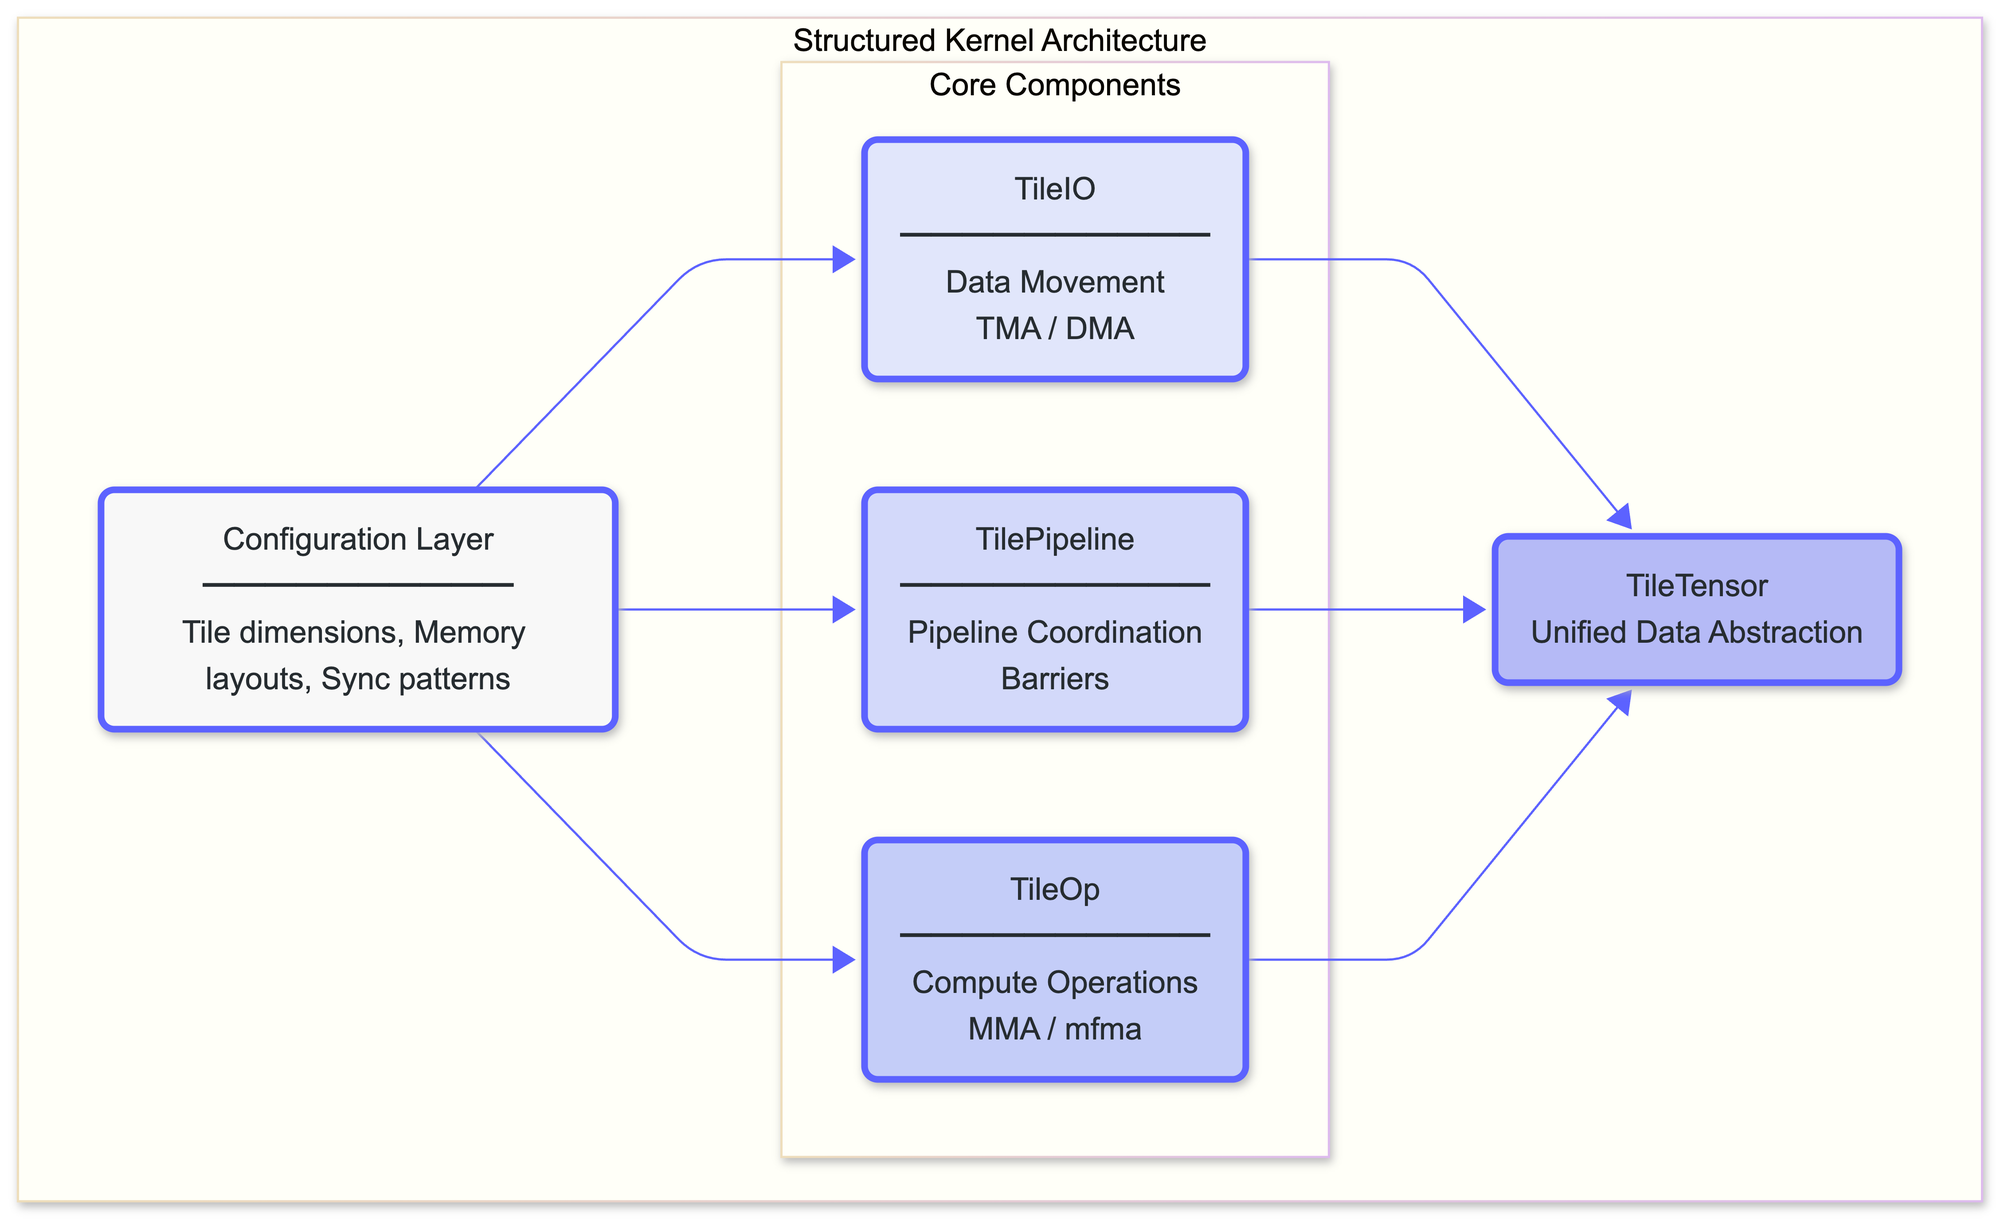
하드웨어별 차이는 이 구성 요소의 내부에만 들어갑니다. 연재 2부에 따르면 데이터 이동은 NVIDIA에서는 TMA(Tensor Memory Accelerator) 비동기 복사로, AMD에서는 load_to_lds 로 구현하지만 둘 다 같은 load() 인터페이스 뒤에 있습니다. 동기화도 NVIDIA는 하드웨어 mbarrier, AMD는 원자적 카운터를 쓰지만 같은 획득과 해제 인터페이스를 제공합니다. 또한 Python의 with 블록과 같은 컨텍스트 관리자로 획득과 해제를 짝지어, 동기화의 짝이 어긋나는 실수를 컴파일 단계에서 막도록 했습니다. 연재 1부에 따르면 Blackwell(SM100) 행렬 곱 커널을 이 구조로 다시 작성해 코드를 14,683줄에서 7,634줄로 48% 줄였습니다. 3부에서는 생성된 GPU 어셈블리(SASS)가 기존 커널과 명령어 단위로 같았다고 밝혔습니다.
다만 이 연재가 말하는 이식성은 한 번 작성한 코드가 모든 하드웨어에서 그대로 최고 성능을 낸다는 뜻이 아닙니다. 4부에 따르면 NVIDIA에서 쓰는 워프 특화(Warp Specialization) 방식은 AMD에서 효율적이지 않습니다. AMD에서는 모든 웨이브가 레지스터를 똑같이 나눠 쓰기 때문입니다. 그래서 AMD에서는 웨이브 그룹이 로드와 연산을 번갈아 맡는 다른 조정 방식을 씁니다. 두 회사의 GPU에서 함께 실행되는 하나의 워프 특화 커널은 아직 계획 단계이고, 저자들은 이 커널이 처음에는 최적 성능을 내지 못할 것이라고 밝혔습니다.
4부에는 AMD 쪽 성능 수치도 없습니다. 저자들은 이를 다음과 같이 요약합니다.
"이식성이란 소스 호환성이 아니라 점진적 특화를 뜻합니다."
"Portability means progressive specialization, not source compatibility."
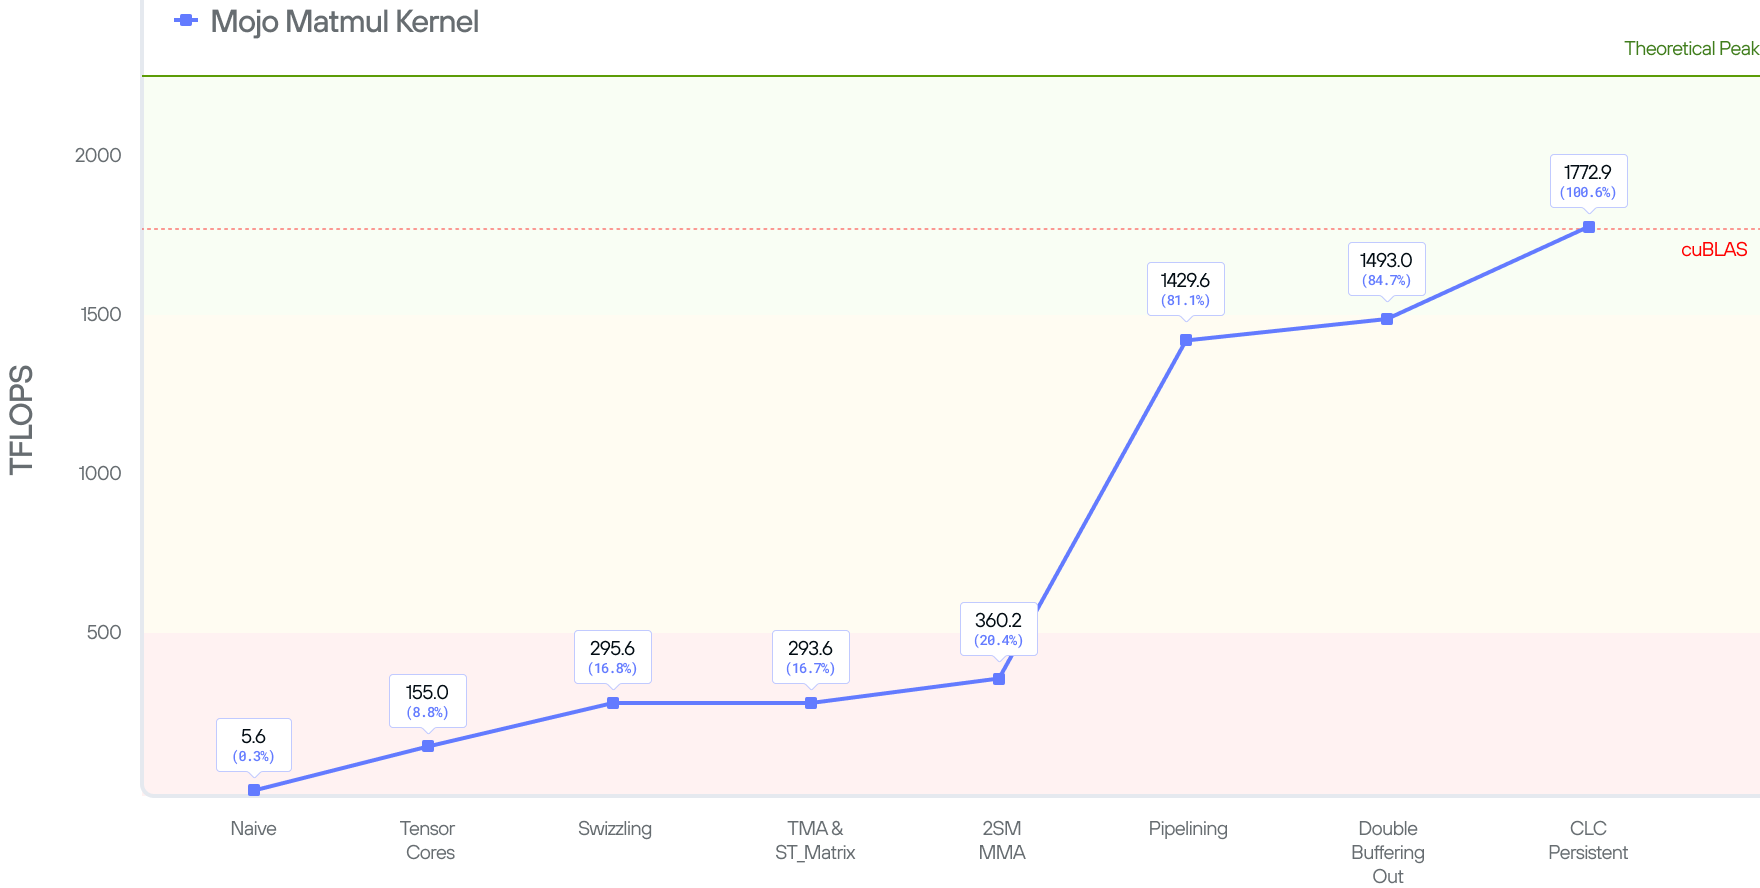
성능 수치는 모두 Modular가 직접 측정한 것입니다. 2025년 Matrix Multiplication on Blackwell 연재는 B200에서 BF16 행렬 곱 커널을 4줄짜리 단순 구현부터 시작해 Blackwell 하드웨어 기능을 하나씩 적용하면서 개선한 기록입니다. 아래 그래프와 같이 마지막 단계에서 1772.9 TFLOPS로 cuBLAS의 100.6%에 도달했습니다. 다만 이 수치는 4096x4096x4096 크기의 결과이고, 저자들은 8192x8192x8192 크기에서는 cuBLAS의 90% 수준이라고 함께 밝혔습니다. 실제 Gemma 3 27B 모델의 행렬 크기에서는 cuBLAS와 비슷하거나 최대 6% 빠른 결과를 보고했습니다.
GPU가 아닌 하드웨어로의 확장은 2026년 8월의 Qualcomm 지원 글이 첫 사례입니다. Qualcomm Cloud AI 100은 Modular 스택에 처음 통합된 ASIC(Application-Specific Integrated Circuit), 곧 NPU입니다. Mojo는 LLVM의 Hexagon 백엔드로 컴파일되고, MAX는 GPU와 같은 DeviceContext 인터페이스로 이 장치를 다룹니다. 그러나 행렬 곱이나 어텐션 같은 무거운 커널은 NPU용으로 새로 작성했습니다.
GPT-2 124M 모델은 처음에는 기준선인 Qualcomm Cloud AI 100용 PyTorch 구현보다 약 1.6배 느렸지만, 3주가량의 최적화 끝에 기준선의 6.7배 성능에 도달했다고 보고했습니다. 10월 22일 공개된 MAX 소스에는 NVIDIA, AMD, Apple 실리콘, CPU용 하드웨어 백엔드가 들어 있습니다. Qualcomm Dragonfly와 Google TPU용 MAX 플러그인 소스는 앞으로 몇 달 안에 공개할 계획이라고 26.7 블로그가 밝혔습니다.
타일 단위 추상화로 커널 작성의 부담을 줄이려는 시도는 다른 곳에서도 이어지고 있습니다. PyTorch의 Helion은 Python에 내장된 DSL을 Triton 코드로 컴파일하고, NVIDIA의 CUDA Tile은 NVIDIA GPU를 위한 타일 기반 프로그래밍 모델입니다. Mojo는 여러 회사의 하드웨어를 대상으로 하는 독립된 언어이며, 언어 자체의 컴파일 타임 기능으로 같은 문제를 다룬다는 점이 다릅니다.
무엇이 공개되어 있나: Mojo와 MAX의 라이선스
Mojo와 MAX는 같은 저장소에 있지만 적용되는 라이선스가 다릅니다. Modular는 Mojo 표준 라이브러리(2024년), MAX의 커널과 모델, 서빙 코드, Python API(2025년), Mojo 컴파일러(2026년 8월)를 차례로 공개해 왔습니다. 그리고 10월 22일 MAX 소스 공개 발표에서 마지막으로 남은 그래프 컴파일러, 런타임, 하드웨어 백엔드의 소스를 공개했습니다. 이 블로그에 따르면 이미 Apache 2.0으로 공개된 구성 요소는 계속 Apache 2.0으로 남고, 이번에 공개한 MAX 핵심부와 Modular가 배포하는 MAX 바이너리에는 새 MAX License가 적용됩니다. 각 소스 파일의 헤더에 어떤 라이선스가 적용되는지 적혀 있습니다.
| 구성 요소 | 저장소 경로 (공개 시점) | 라이선스 |
|---|---|---|
| Mojo 컴파일러와 도구 | /Mojo (2026년 8월) |
Apache 2.0 with LLVM Exceptions |
| Mojo 표준 라이브러리 | /Mojo/stdlib (2024년 3월) |
Apache 2.0 with LLVM Exceptions |
| MAX 가속기 라이브러리 (커널), GPU 프로그래밍 API | /max/kernels, /max/mojo/max/gpu (2025년 5월) |
Apache 2.0 with LLVM Exceptions |
| MAX Python 프레임워크, 모델 파이프라인, 추론 서버 | /max/python/max 등 (2025년) |
Apache 2.0 with LLVM Exceptions |
| MAX 그래프 컴파일러, 런타임, 드라이버와 하드웨어 백엔드 | /GraphCompiler, /MLRT, /max/driver 등 (2026년 10월) |
MAX License |
| Modular가 배포하는 MAX 바이너리 | 패키지와 컨테이너 | MAX License |
| Modular Cloud | 상용 서비스 | 서비스 이용 약관 |
MAX 소스 공개 발표 블로그와 MAX License FAQ에 따른 주요 조건은 다음과 같습니다. MAX는 무료이며, 하드웨어 종류의 제한 없이 상업적 제품에도 로열티 없이 쓸 수 있습니다. MAX 위에 만든 애플리케이션과 라이브러리는 원하는 라이선스로 배포할 수 있지만, 포함된 MAX 부분은 오브젝트 코드 형태로 MAX License 사본과 함께 배포해야 합니다. MAX를 애플리케이션에 포함해 배포하려면 그 애플리케이션이 MAX 단독보다 의미 있는 기능을 더 갖춰야 합니다.
반면 MAX License가 적용된 소스를 수정해 공개하는 것은 Modular 공식 저장소의 포크에서 기여를 목적으로 할 때만 허용됩니다. MAX를 다시 구현하거나 대체하는 소프트웨어를 만들기 위해 MAX를 AI 시스템의 학습 데이터나 입력으로 쓰는 것도 금지합니다. 또한 법인이 다른 기업에 MAX 기반 학습이나 추론 서비스를 상업적으로 제공한다면 Modular Accelerated 상표를 표시해야 하며, 상표를 쓴 자료는 사용 전에 Modular의 서면 승인을 받아야 합니다. MAX는 사용 지표를 수집할 수 있으며, FAQ는 MODULAR_TELEMETRY_ENABLED=0 과 MAX_SERVE_DISABLE_TELEMETRY=1 환경 변수로 끌 수 있다고 안내합니다. 각 릴리스에는 그 릴리스와 함께 배포된 라이선스가 적용되므로, 이전 버전은 원래 조건으로 계속 쓸 수 있습니다.
Modular는 26.7 블로그에서 Apache 2.0을 택하지 않은 이유를 파편화(Fragmentation) 방지로 설명합니다. MAX의 목표는 하드웨어 전반의 프로그래밍 모델을 통합하는 것인데, 플랫폼마다 호환되지 않는 MAX가 생기면 그 목표가 무너진다는 것입니다. 자체 하드웨어 지원처럼 업스트림에 올리지 않는 큰 수정이 필요한 회사를 위해서는 공통 호환성 요구 사항과 테스트를 갖춘 얼라이언스 프로그램이 더 넓은 유연성을 제공할 것이라고 FAQ는 밝히고 있습니다.
모든 코드가 공개된 것은 아닙니다. Qualcomm Dragonfly와 Google TPU용 MAX 플러그인은 앞으로 몇 달 안에 공개될 예정이고, rust_kv 디렉터리의 README는 공개 대상에서 빠진 비공개 MAX Serve 이미지용 패키징을 언급합니다. 기여도 단계적으로 열리고 있습니다. MAX 기여 안내에 따르면 MAX는 현재 모든 영역에서 버그 수정부터 받으며, 기여 범위 문서에 따르면 GPU 프로그래밍 영역은 이미 지원하는 하드웨어에 빠진 기본 연산 기여도 받고, 개발 문서와 예제, 벤치마크 스크립트는 기여를 환영합니다. 같은 문서는 C API 바인딩(max/include/max/c)을 비공개 바인딩으로 표시하고 있습니다. 코드는 Modular의 내부 저장소와 Copybara로 매일 동기화됩니다.
정리하면, Mojo는 Apache 2.0(LLVM 예외 포함)으로 공개된 오픈소스 언어입니다. MAX는 이제 핵심부를 포함한 소스 대부분을 읽고 수정하고 빌드할 수 있지만, 핵심부의 수정본 배포와 상업적 호스팅에 조건이 붙는 소스 공개 프레임워크입니다. Modular는 라이선스 방식이 앞으로도 바뀔 수 있다고 밝혔으므로, 도입을 검토한다면 사용하는 릴리스에 포함된 라이선스 조문을 직접 확인해야 합니다. Chris Lattner와 Tim Davis는 11월 10일 새 라이선스에 대한 온라인 Q&A를 진행할 예정입니다.
Qualcomm 인수 이후의 약속과 남은 과제
Modular는 2022년과 2025년 글에서 칩을 팔지 않는 독립 회사이기 때문에 중립적인 공용 계층을 만들 수 있다고 강조해 왔습니다. 그런데 2026년 6월 Qualcomm이 인수 계약을 발표했고, 7월 29일 인수를 마쳤습니다. Qualcomm은 Modular 블로그에도 실린 인수 완료 발표에서 Mojo, MAX, Modular Cloud를 제품과 브랜드로 유지한다고 밝혔습니다. 이어 ModCon 발표에서는 Qualcomm과 직접 경쟁하는 하드웨어도 계속 지원하고 최적화하겠다고 밝혔습니다.
ModCon에서 Modular는 이를 뒷받침할 두 가지 계획도 발표했습니다. 하나는 MAX 라이선스를 바꾸고 소스 접근을 넓혀, 하드웨어 제조사와 파트너가 MAX를 직접 확장하게 하는 것으로, 앞에서 정리한 대로 10월 22일 MAX 소스 전체 공개로 이어졌습니다. 다른 하나는 하드웨어 제조사, 모델 제공자, 클라우드 회사가 참여하는 얼라이언스(Alliance) 프로그램입니다. 실제로 HTEC라는 외부 회사가 몇 달 만에 소수의 엔지니어로 Google TPU 지원을 직접 구현했다고 소개했습니다.
얼라이언스 프로그램은 아직 출범 전입니다. MAX License FAQ에 따르면 지금은 관심 등록을 받고 있으며, 정식 출범은 2027년 초가 목표입니다. MAX 소스 공개 발표 블로그에 따르면 엔지니어링 인력이나 컴퓨팅 자원, 초기 모델 체크포인트를 기여하는 파트너에게는 거버넌스와 호환성 표준에 대한 발언권, 로드맵 의견 반영, 전용 하드웨어 백엔드 소유, 더 관대한 라이선스 등을 제공할 계획입니다. Trainium, TPU, Qualcomm 가속기의 프로덕션 투입과, Microsoft Windows 팀과 협력하는 Mojo의 Windows 기본 지원도 아직 예고 단계입니다. 현재 Windows에서는 WSL로만 Mojo를 쓸 수 있습니다.
그 밖에 Modular가 공개한 프로젝트
Mojo와 MAX 외에도 Modular는 다음과 같은 프로젝트를 공개하고 있습니다.
-
BentoML: 모델 추론 API와 AI 애플리케이션을 서빙하는 오픈소스 프레임워크입니다. 2026년 2월 BentoML이 Modular에 합류했으며, Modular는 BentoML이 같은 문서와 커뮤니티, 기여 절차를 유지한 채 Apache 2.0 오픈소스로 계속 개발된다고 밝혔습니다. Modular의 BYOC(Bring Your Own Cloud) 배포도 BentoCloud 인프라를 바탕으로 합니다.
-
modular/skills: Mojo 프로젝트 생성, GPU 프로그래밍, 다른 언어에서의 이식, MAX 모델 이식과 디버깅을 돕는 코딩 에이전트용 스킬 모음입니다.
-
Mojo GPU Puzzles: 퍼즐을 풀면서 Mojo로 GPU 프로그래밍을 배우는 학습 자료입니다.
-
LLM Inference Handbook 과 Build an LLM from scratch with MAX: 각각 LLM 추론 전반을 정리한 안내서와, MAX Python API로 GPT-2를 처음부터 구현해 보는 학습서입니다.
-
stack-pr: GitHub에서 여러 개의 쌓인(Stacked) PR을 다루는 도구입니다.
누구에게 유용한가
Mojo는 Python 문법에 익숙하면서 CPU SIMD 코드나 GPU 커널을 직접 작성해야 하는 개발자, 특히 NVIDIA와 AMD, Apple GPU를 한 언어로 다루고 싶은 커널 개발자에게 살펴볼 만한 선택지입니다. 1.0의 안정성 약속과 Apache 2.0 컴파일러 공개로 장기 프로젝트에 쓸 기반은 마련되었습니다. 다만 로드맵 기준으로 대수적 자료형(Algebraic Data Type)은 1.2의 패턴 매칭 이후에도 개발 중입니다. 비동기 기능은 1.2에서 async/await 가 __async/__await 로 바뀌면서 불안정 기능임이 명시되었고, 패키지 관리 기능은 시작 전 단계라는 점도 함께 고려해야 합니다.
MAX는 vLLM이나 SGLang 같은 기존 추론 엔진의 대안을 찾거나, AMD GPU에서 같은 서빙 코드를 쓰고 싶은 팀이 비교해 볼 수 있는 프레임워크입니다. PyTorch 사용자라면 모델 전체를 옮기지 않고 병목 연산 하나를 Mojo 커스텀 연산으로 바꿔 보는 것부터 시작할 수도 있습니다. 공식 문서와 블로그의 성능 수치는 모두 Modular가 직접 측정한 결과입니다. 서빙 테스트 하드웨어도 B200과 MI355X로 한정되어 있으므로, 도입 전에 자신의 모델과 하드웨어로 직접 측정해야 합니다. 상업적으로 배포하거나 호스팅 서비스를 운영할 계획이라면 위에서 정리한 MAX License 조건을 먼저 확인해야 합니다.
 Democratizing AI Compute 연재 (Chris Lattner)
ModCon 2026 발표 블로그: Open source, open cloud, open silicon
MAX 소스 공개와 새 라이선스 발표 블로그
Mojo 컴파일러 오픈소스 공개 블로그
Structured Mojo Kernels 연재
 Modular 플랫폼(MAX, Mojo) GitHub 저장소
 Mojo 공식 문서 (mojolang.org)
MAX 공식 문서
 Modular 회사 소개 페이지 (Modular Cloud 등 상용 서비스 포함)
라이선스
Mojo 컴파일러와 표준 라이브러리, MAX의 커널과 Python API 등 modular/modular 저장소의 상당 부분은 Apache License v2.0 with LLVM Exceptions로 공개되어 있습니다. 따라서 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 단, 2026년 10월 공개된 MAX 핵심부(그래프 컴파일러, 런타임, 하드웨어 백엔드)와 Modular가 배포하는 MAX 바이너리에는 MAX License가 적용됩니다. 무료로 상업적 사용이 가능하지만, 수정한 소스는 기여 목적의 포크에서만 공개할 수 있는 등 별도 조건이 있습니다.
커뮤니티 참여
Modular는 공식 포럼과 Discord 서버에서 Mojo와 MAX에 대한 질문을 받고 있습니다. 2026년 10월에는 Mojo와 MAX 기반 라이브러리를 지원하는 커뮤니티 그랜트 프로그램에서 지원하는 프로젝트 6개를 발표했습니다. 저장소의 공개 이슈에서 표준 라이브러리와 컴파일러 팀이 진행 중인 작업도 확인할 수 있습니다.
더 읽어보기
-
CUDA Tile: NVIDIA가 제시하는 차세대 타일(Tile) 기반 GPU 프로그래밍 (feat. cuTile Python, Tile IR, TileGym)
-
vLLM과 SGLang 중 무엇을 골라야 할까? Red Hat이 공개한 PagedAttention과 RadixAttention의 차이와 벤치마크 해석법
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
