핵심 요약
- Red Hat Developer 블로그의 vLLM vs. SGLang 비교 글은 두 엔진이 같은 KV 캐시 문제에서 출발했다고 정리합니다. vLLM은 메모리를 블록으로 나누는 PagedAttention, SGLang은 공유 접두사를 트리로 재사용하는 RadixAttention이 출발점입니다.
- 지금은 연속 배칭, 접두사 캐싱, 투기적 디코딩, 양자화 등 주요 기능이 상당 부분 겹칩니다. 원문은 워크로드, 하드웨어, 생태계를 보고 고르라고 결론 내립니다.
- 원문이 인용한 Modal LLM Engineer's Almanac의 2025년 H100 1장 측정에서 두 엔진의 처리량은 대부분 비슷했고, 출력이 긴 코드 생성 형태에서만 SGLang이 약 22% 높았습니다. 이 수치는 데이터가 바뀐 현재 Advisor 페이지에는 없습니다.
- 이 벤치마크는 접두사가 거의 겹치지 않는 프롬프트와 기본 설정으로 측정했고, Modal 요약 보고서가 밝힌 측정 버전은 2025년 중반의 vLLM 0.8~0.9, SGLang 0.4.6입니다. 채팅과 에이전트 트래픽은 직접 측정해야 합니다.

vLLM과 SGLang 비교 글 소개
이 글은 오픈 모델을 직접 서빙하려는 팀이 vLLM과 SGLang 중 무엇을 고를지 판단하도록 돕는 해설입니다. Red Hat Developer 블로그에 2026년 10월 14일 Cedric Clyburn이 쓴 글을 바탕으로, 원문이 인용한 1차 자료를 함께 읽고 확인한 조건과 한계를 덧붙였습니다.
원문은 오픈 가중치 모델의 사용량이 늘었다는 데서 시작합니다. 첫 근거는 Vercel CEO Guillermo Rauch가 공유한 Vercel AI Gateway 차트입니다. 원문은 OpenRouter 순위도 비슷한 흐름을 보인다고 덧붙입니다. 다만 원문의 "9월에 프로덕션 토큰의 약 80%" 라는 표현은 링크된 게시물보다 넓습니다. 해당 게시물(2026년 9월 19일, UTC)은 하루치 비중을 두고 "기록적인 날일 수 있다" 고 했고, 차트의 마지막 막대(9월 18일)가 오픈 가중치 78.4%입니다. 차트는 6월 21일부터의 일별 비중만 보여 주므로, 원문이 말한 2025년 12월의 10% 미만이라는 수치는 이 게시물에서 확인할 수 없었습니다.
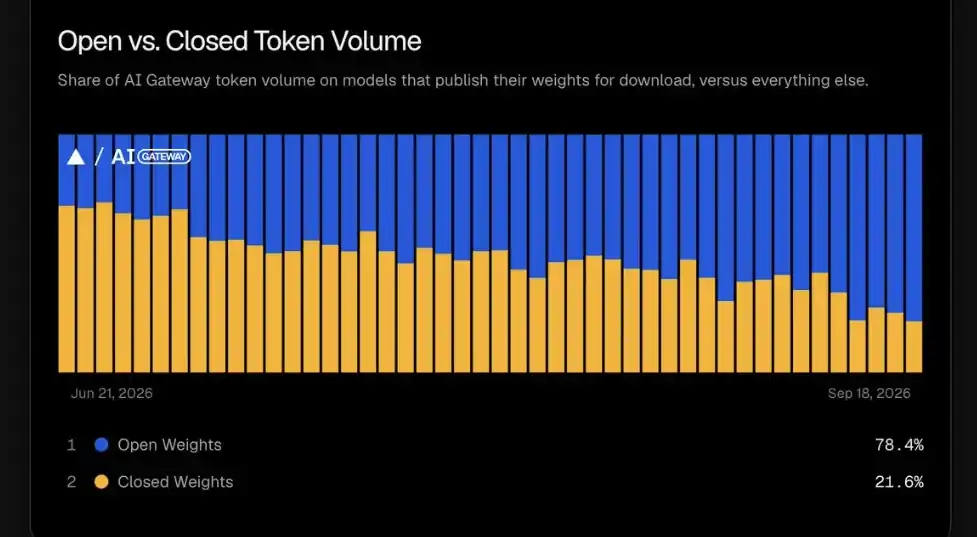
그래서 원문은 이 모델들을 직접 실행하면 어떨지 묻습니다. 에이전트나 RAG 파이프라인은 대개 OpenAI 호환 API를 쓰므로, 백엔드를 바꾸는 일은 기본 URL 하나를 바꾸는 일입니다. 그러나 그 URL 뒤에서 요청을 어떻게 스케줄하고 GPU 메모리를 어떻게 쓰는지가 응답 속도와 비용을 정합니다. 원문은 대규모 프로덕션 서빙에서 가장 자주 거론되는 두 오픈소스 엔진으로 vLLM과 SGLang을 꼽습니다.
읽기 전에 알아 둘 점이 하나 있습니다. Red Hat은 원문 스스로 밝히듯 vLLM의 가장 큰 기업 기여자이고, 원문은 관련 제품으로 Red Hat AI를 표시합니다. 원문이 성능 근거로 쓴 자료는 제3자인 Modal의 측정이며, 그 결과도 vLLM이 앞선다고 말하지 않습니다.
두 엔진이 함께 푸는 문제: KV 캐시를 어떻게 관리할 것인가
LLM 요청 하나는 두 단계로 처리됩니다. 프리필(Prefill) 은 프롬프트 전체를 한 번에 처리하면서 모든 입력 토큰의 어텐션 키(key)와 값(value)을 계산하는 단계입니다. 디코드(Decode) 는 그 키와 값을 재사용하면서 출력 토큰을 하나씩 생성하는 단계입니다.
이렇게 저장해 둔 키와 값이 KV 캐시(KV Cache) 입니다. KV 캐시가 있으면 새 토큰마다 같은 계산을 반복하지 않아도 되지만, 대화가 길어질수록 커져서 GPU 메모리를 많이 차지합니다. 워크로드마다 부담이 가는 단계도 다릅니다. 원문은 긴 문서를 읽는 작업은 프리필 쪽, 출력이 긴 코드 생성은 디코드 쪽에 부담이 크다고 설명합니다.
원문은 추론 엔진(Inference Engine)을 KV 캐시를 다루는 스케줄러이자 메모리 관리자로 정의합니다. 어떤 요청을 함께 실행할지, 캐시된 상태를 어디에 둘지, 요청이 들어오고 나갈 때 GPU를 어떻게 계속 바쁘게 할지를 정하는 소프트웨어라는 뜻입니다. vLLM과 SGLang은 이 문제에 서로 다른 답으로 출발했습니다.
추론 엔진 내부를 코드 수준으로 따라가 보고 싶다면 Nano-vLLM 내부를 살펴보는 글이나 C++와 CUDA로 vLLM을 다시 구현한 tiny-vllm을 함께 보면 좋습니다. 노트북이나 소비자용 GPU에서 모델을 실행하는 경우라면 Red Hat의 llama.cpp와 vLLM 비교 글이 더 맞습니다.
vLLM의 출발점: PagedAttention으로 낭비되는 GPU 메모리 줄이기
vLLM은 2023년 UC Berkeley에서 공개되었습니다. 당시 서빙 시스템은 대화의 KV 캐시가 얼마나 커질지 모르기 때문에 GPU 메모리를 큰 연속 구간으로 미리 잡아 두었습니다. vLLM 논문의 측정에서 기존 시스템은 KV 캐시 메모리의 20.4~38.2%만 실제 토큰 상태를 저장하는 데 썼습니다. vLLM 팀은 공개 블로그에서 이를 단편화와 과잉 예약으로 인한 60~80% 낭비로 요약했습니다. 그 때문에 GPU 한 장에 동시에 올릴 수 있는 요청 수가 제한되었습니다.
vLLM의 답이 PagedAttention 입니다. KV 캐시를 크기가 고정된 작은 블록으로 나누고, 각 블록을 GPU 메모리의 아무 곳에나 둘 수 있게 합니다. 운영체제가 가상 메모리를 페이지 단위로 관리하는 방식과 같은 발상입니다. 메모리를 미리 잡아 두지 않고 시퀀스가 길어질 때마다 블록을 할당하므로, 같은 GPU에서 더 많은 요청을 동시에 처리할 수 있습니다.
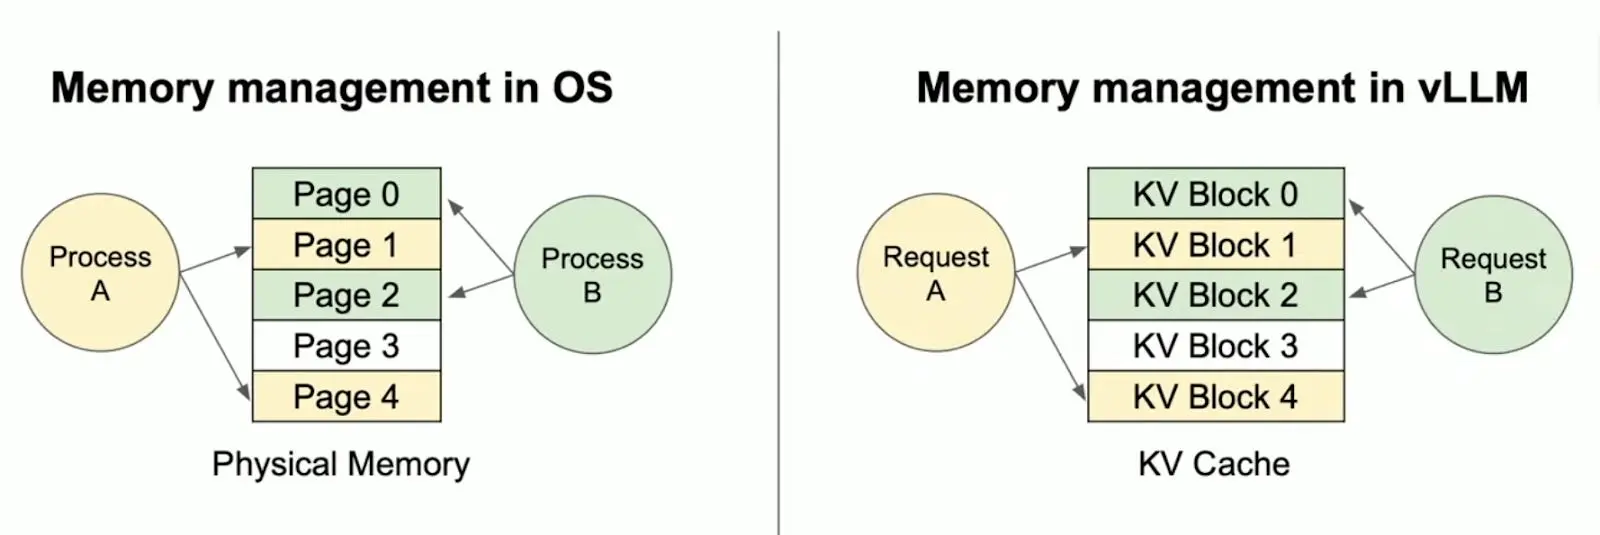
원문에 따르면 이 방식은 이제 SGLang을 포함한 현대 서빙 엔진의 표준이 되었습니다. vLLM은 이후 어떤 모델이든 어떤 가속기와 클라우드에서든 실행하는 것을 목표로 하는 서빙 생태계로 커졌습니다. 원문은 Red Hat이 가장 큰 기업 기여자이고, 수백 개의 기업과 학계 조직이 함께 기여한다고 밝힙니다.
SGLang의 출발점: RadixAttention으로 관련 요청 사이의 계산 재사용하기
SGLang은 2024년 1월 LMSYS 블로그 글 Fast and Expressive LLM Inference with RadixAttention and SGLang로 소개되었습니다. 이름은 Structured Generation Language의 약자입니다. 원문은 이 이름이 SGLang의 목표를 말해 준다고 설명합니다. 여러 차례 대화를 주고받는 채팅, 추출 워크플로, 분기와 반복을 하는 에이전트처럼 서로 관련된 모델 호출을 많이 하는 애플리케이션입니다.
이런 애플리케이션은 같은 내용을 반복해서 보냅니다. 에이전트는 호출마다 같은 시스템 프롬프트와 같은 도구 정의를 보내고, 대화 기록은 계속 길어집니다. SGLang의 RadixAttention 은 계산한 KV 캐시를 토큰 접두사를 키로 하는 래딕스 트리(Radix Tree) 에 저장합니다. 래딕스 트리는 공통 접두사를 한 경로로 합쳐 저장하는 트리 자료구조입니다. 새 요청이 오면 엔진은 트리를 따라 내려가 일치하는 부분을 모두 재사용하고, 새로운 부분만 계산합니다. 오래 쓰이지 않은 가지부터 메모리에서 내보냅니다(evict).
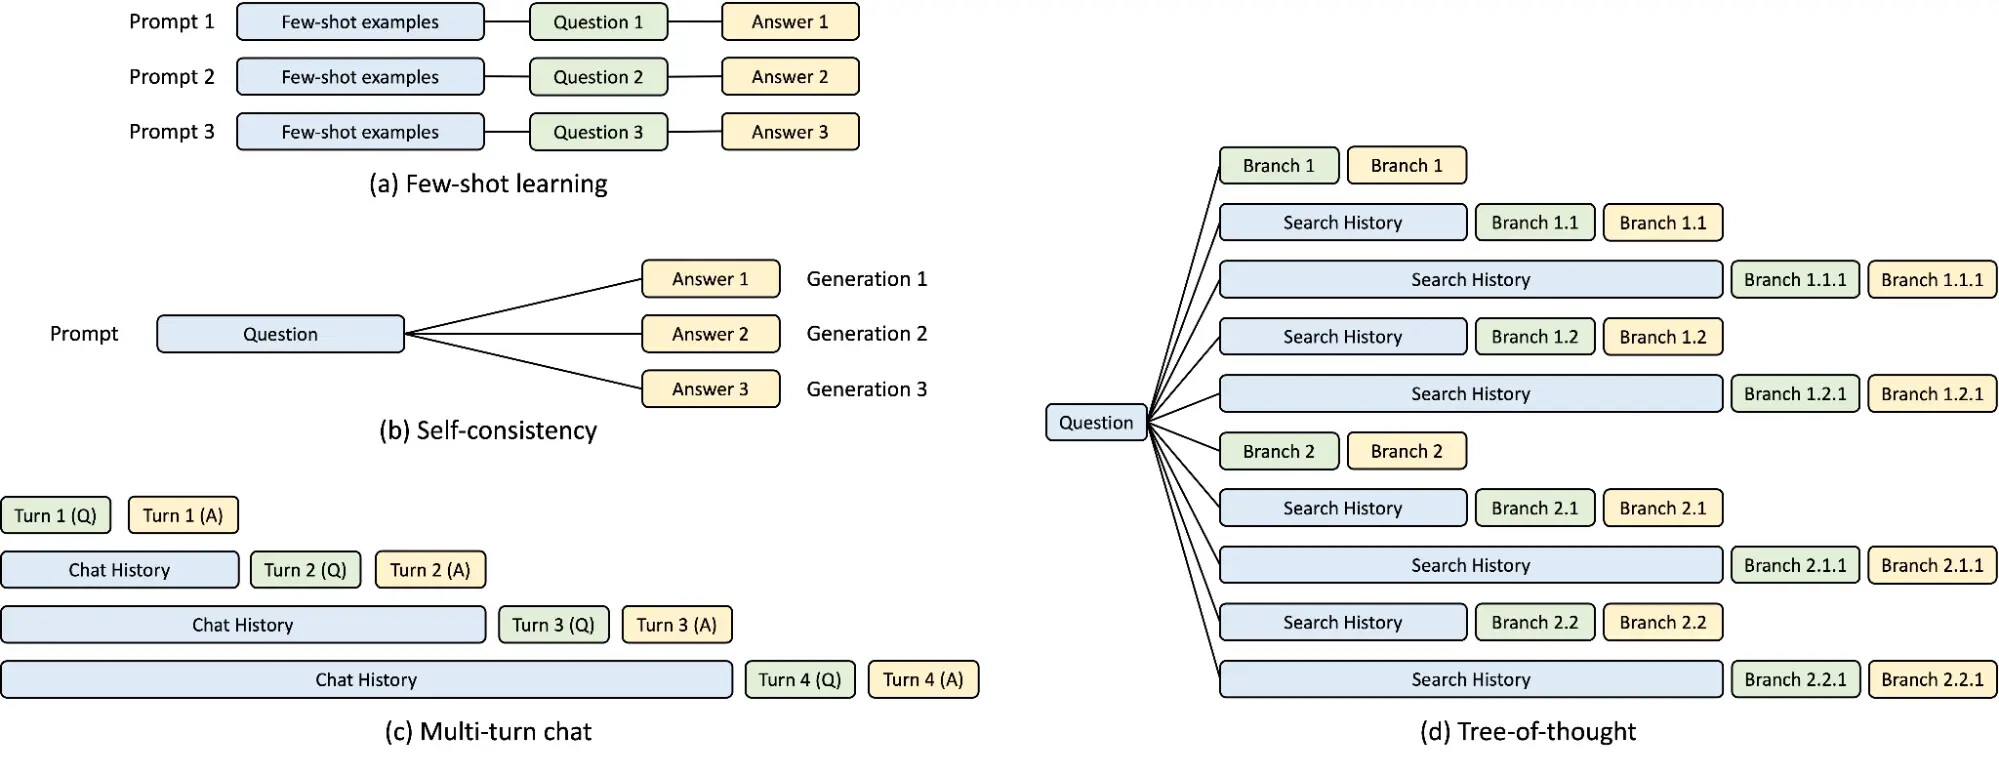
원문에 따르면 SGLang은 여기에 캐시 인식 스케줄링(Cache-aware Scheduling) 을 더합니다. 접두사를 공유하는 요청들을 가까운 시점에 실행해서, 그 요청들이 필요로 할 때 캐시된 가지가 아직 메모리에 남아 있게 하는 방식입니다. RadixAttention 발표 당시의 설명은 RadixAttention과 SGLang을 소개한 PyTorchKR 글에 정리되어 있습니다.
원문은 vLLM에도 접두사 캐싱이 있다고만 적습니다. 둘의 구현 차이는 vLLM의 Automatic Prefix Caching 설계 문서에서 확인할 수 있습니다. vLLM은 트리 대신 해시를 씁니다. 각 KV 블록을 그 블록의 토큰과 앞선 접두사의 해시로 식별하고, 같은 해시의 블록이 있으면 재사용합니다. 이 문서에 따르면 vLLM은 가득 찬 블록만 캐시합니다. 두 엔진 모두 공유 접두사를 재사용하지만, 찾는 자료구조가 SGLang은 래딕스 트리, vLLM은 블록 해시로 다릅니다.
지금은 많이 겹친다: 공통 기능, 모델 지원, 하드웨어, 커뮤니티
원문은 두 프로젝트가 처음의 최적화를 넘어 크게 확장되었고, 지금은 같은 기능을 상당 부분 공유한다고 정리합니다. 원문이 꼽은 공통 기능은 다음과 같습니다.
- 연속 배칭(Continuous Batching): 요청이 도착하고 끝나는 대로 배치를 갱신해 GPU를 계속 바쁘게 둡니다.
- 접두사 캐싱(Prefix Caching): 공유된 프롬프트 지시문을 다시 계산하지 않습니다.
- 청크 단위 프리필(Chunked Prefill): 긴 프롬프트 처리를 작은 조각으로 나눠 다른 작업과 함께 스케줄합니다.
- 구조화된 출력(Structured Outputs): 생성 결과를 JSON이나 문법에 맞게 제한합니다.
- 투기적 디코딩(Speculative Decoding): 후보 토큰을 먼저 제안하고 검증해서 생성을 빠르게 합니다.
- 양자화(Quantization): 낮은 정밀도 표현으로 메모리 요구량을 줄이고 성능을 높일 수 있습니다.
- 분산 실행(Distributed Execution): 큰 모델과 워크로드를 여러 가속기에 나눠 실행합니다.
모델 지원. 두 엔진은 대개 새 모델이 나온 당일에 지원합니다(Day-0 지원). 원문은 두 프로젝트가 프런티어 연구소, 모델 제공사와 미리 협력해서 채팅 템플릿과 추론 파라미터를 맞춘다고 설명합니다. 특정 모델을 내 하드웨어에서 실행하는 명령은 vLLM의 Recipes 페이지와 SGLang Cookbook에서 찾을 수 있습니다. 원문 그림에 따르면 vLLM Recipes 페이지는 NVIDIA와 AMD GPU용 옵션과 함께 바로 실행할 수 있는 docker 명령을 보여 줍니다. 커뮤니티가 RTX 3090 같은 소비자용 GPU 기준으로 모은 실행 설정은 Club-3090 레시피 모음에 있습니다.
하드웨어 지원. 두 엔진 모두 NVIDIA GPU, AMD GPU, Intel GPU, Google TPU 등을 지원합니다. 원문에 따르면 두 엔진 모두 NVIDIA와 AMD를 1순위로 다룹니다. TPU, Intel GPU, CPU, Apple 지원은 vLLM 쪽이 더 오래되었고, 모델 서빙 문서도 갖추고 있습니다. 다만 현재 SGLang README도 TPU, Intel GPU와 CPU, Apple Silicon, Huawei Ascend별 문서를 두고 있습니다. vLLM README는 TPU와 Apple Silicon 등을 별도 하드웨어 플러그인으로 지원한다고 적습니다. NVIDIA 이외의 가속기를 쓴다면 두 프로젝트의 플랫폼별 문서에서 내 가속기의 지원 범위를 먼저 확인해야 합니다.
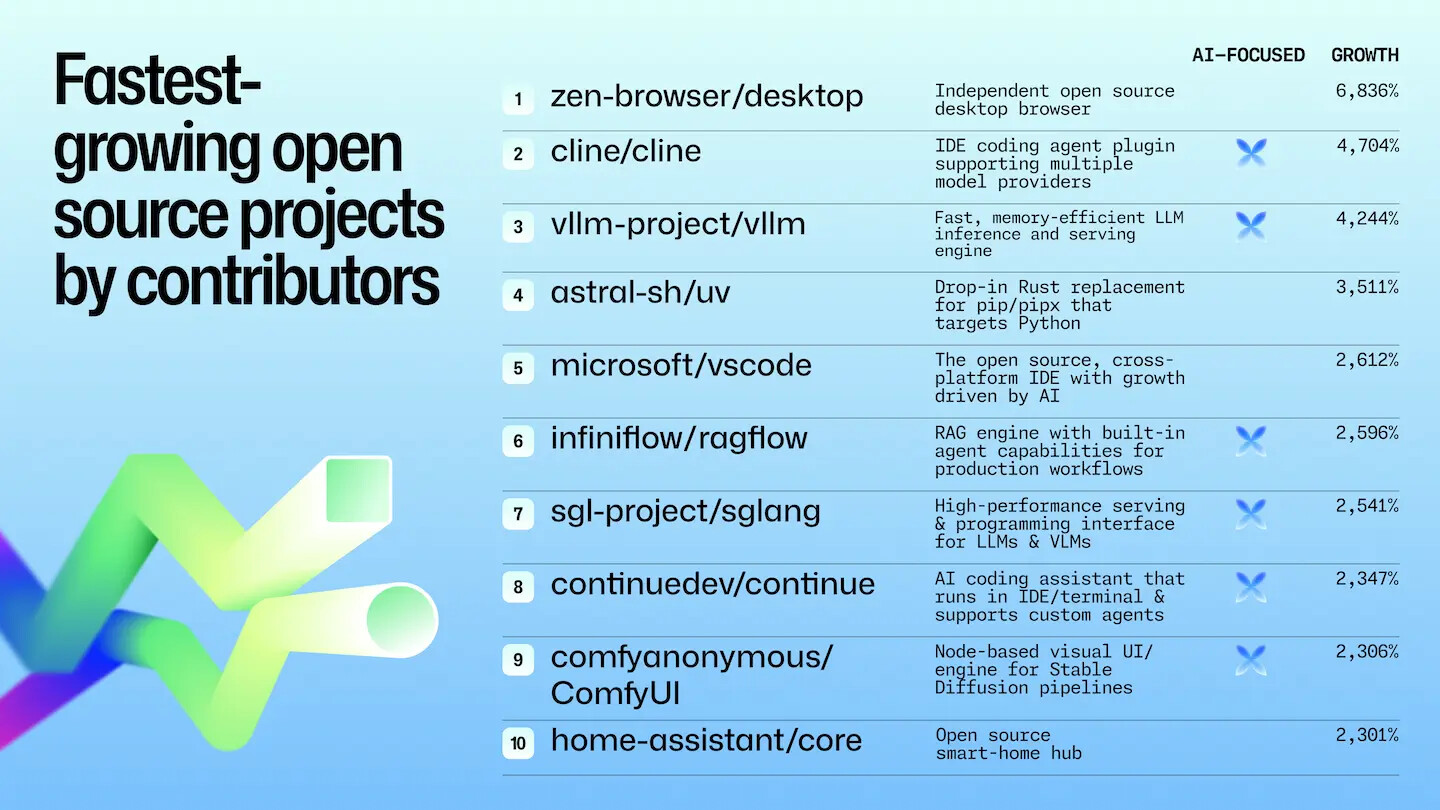
커뮤니티. GitHub Octoverse 2025 보고서에서 기여자 증가율 기준으로 가장 빠르게 성장한 오픈소스 프로젝트 목록에 vLLM이 3위, SGLang이 7위로 올랐습니다. 같은 보고서의 전체 기여자 수 순위에서는 vLLM이 1위였습니다.
두 프로젝트는 2025년에 PyTorch Foundation 생태계에도 들어갔습니다. 다만 지위가 다릅니다. SGLang은 2025년 3월 PyTorch 생태계 프로젝트(Ecosystem Project)로 합류했고, vLLM은 2025년 5월 재단이 직접 호스팅하는 프로젝트(Foundation-Hosted Project)가 되었습니다. 원문은 이 차이를 다른 재단의 졸업(Graduated) 단계와 샌드박스(Sandbox) 단계에 빗대고, SGLang은 독립적인 프로젝트 거버넌스를 유지하기 때문에 생태계 프로젝트라고 설명합니다. 이 비유는 원문 필자의 설명이며, PyTorch Foundation이 쓰는 공식 용어는 아닙니다. 재단 프로젝트의 최근 소식은 PyTorch Foundation 프로젝트 최신 소식 글에서 볼 수 있습니다.
독립 벤치마크가 보여 주는 것과 보여 주지 않는 것
원문이 성능 근거로 든 자료는 Modal의 LLM Engineer's Almanac입니다. 원문에 따르면 Modal은 vLLM, SGLang, TensorRT-LLM을 십여 개 모델과 10가지 입력/출력 길이 조합에서 측정했습니다. 모든 측정은 NVIDIA GPU에서 기본 설정으로 실행했습니다. Modal의 요약 보고서(Executive Summary)는 "vLLM과 SGLang은 기본 설정에서 비슷한 성능을 낸다. 다른 요인으로 결정해야 한다" 고 결론 내립니다.
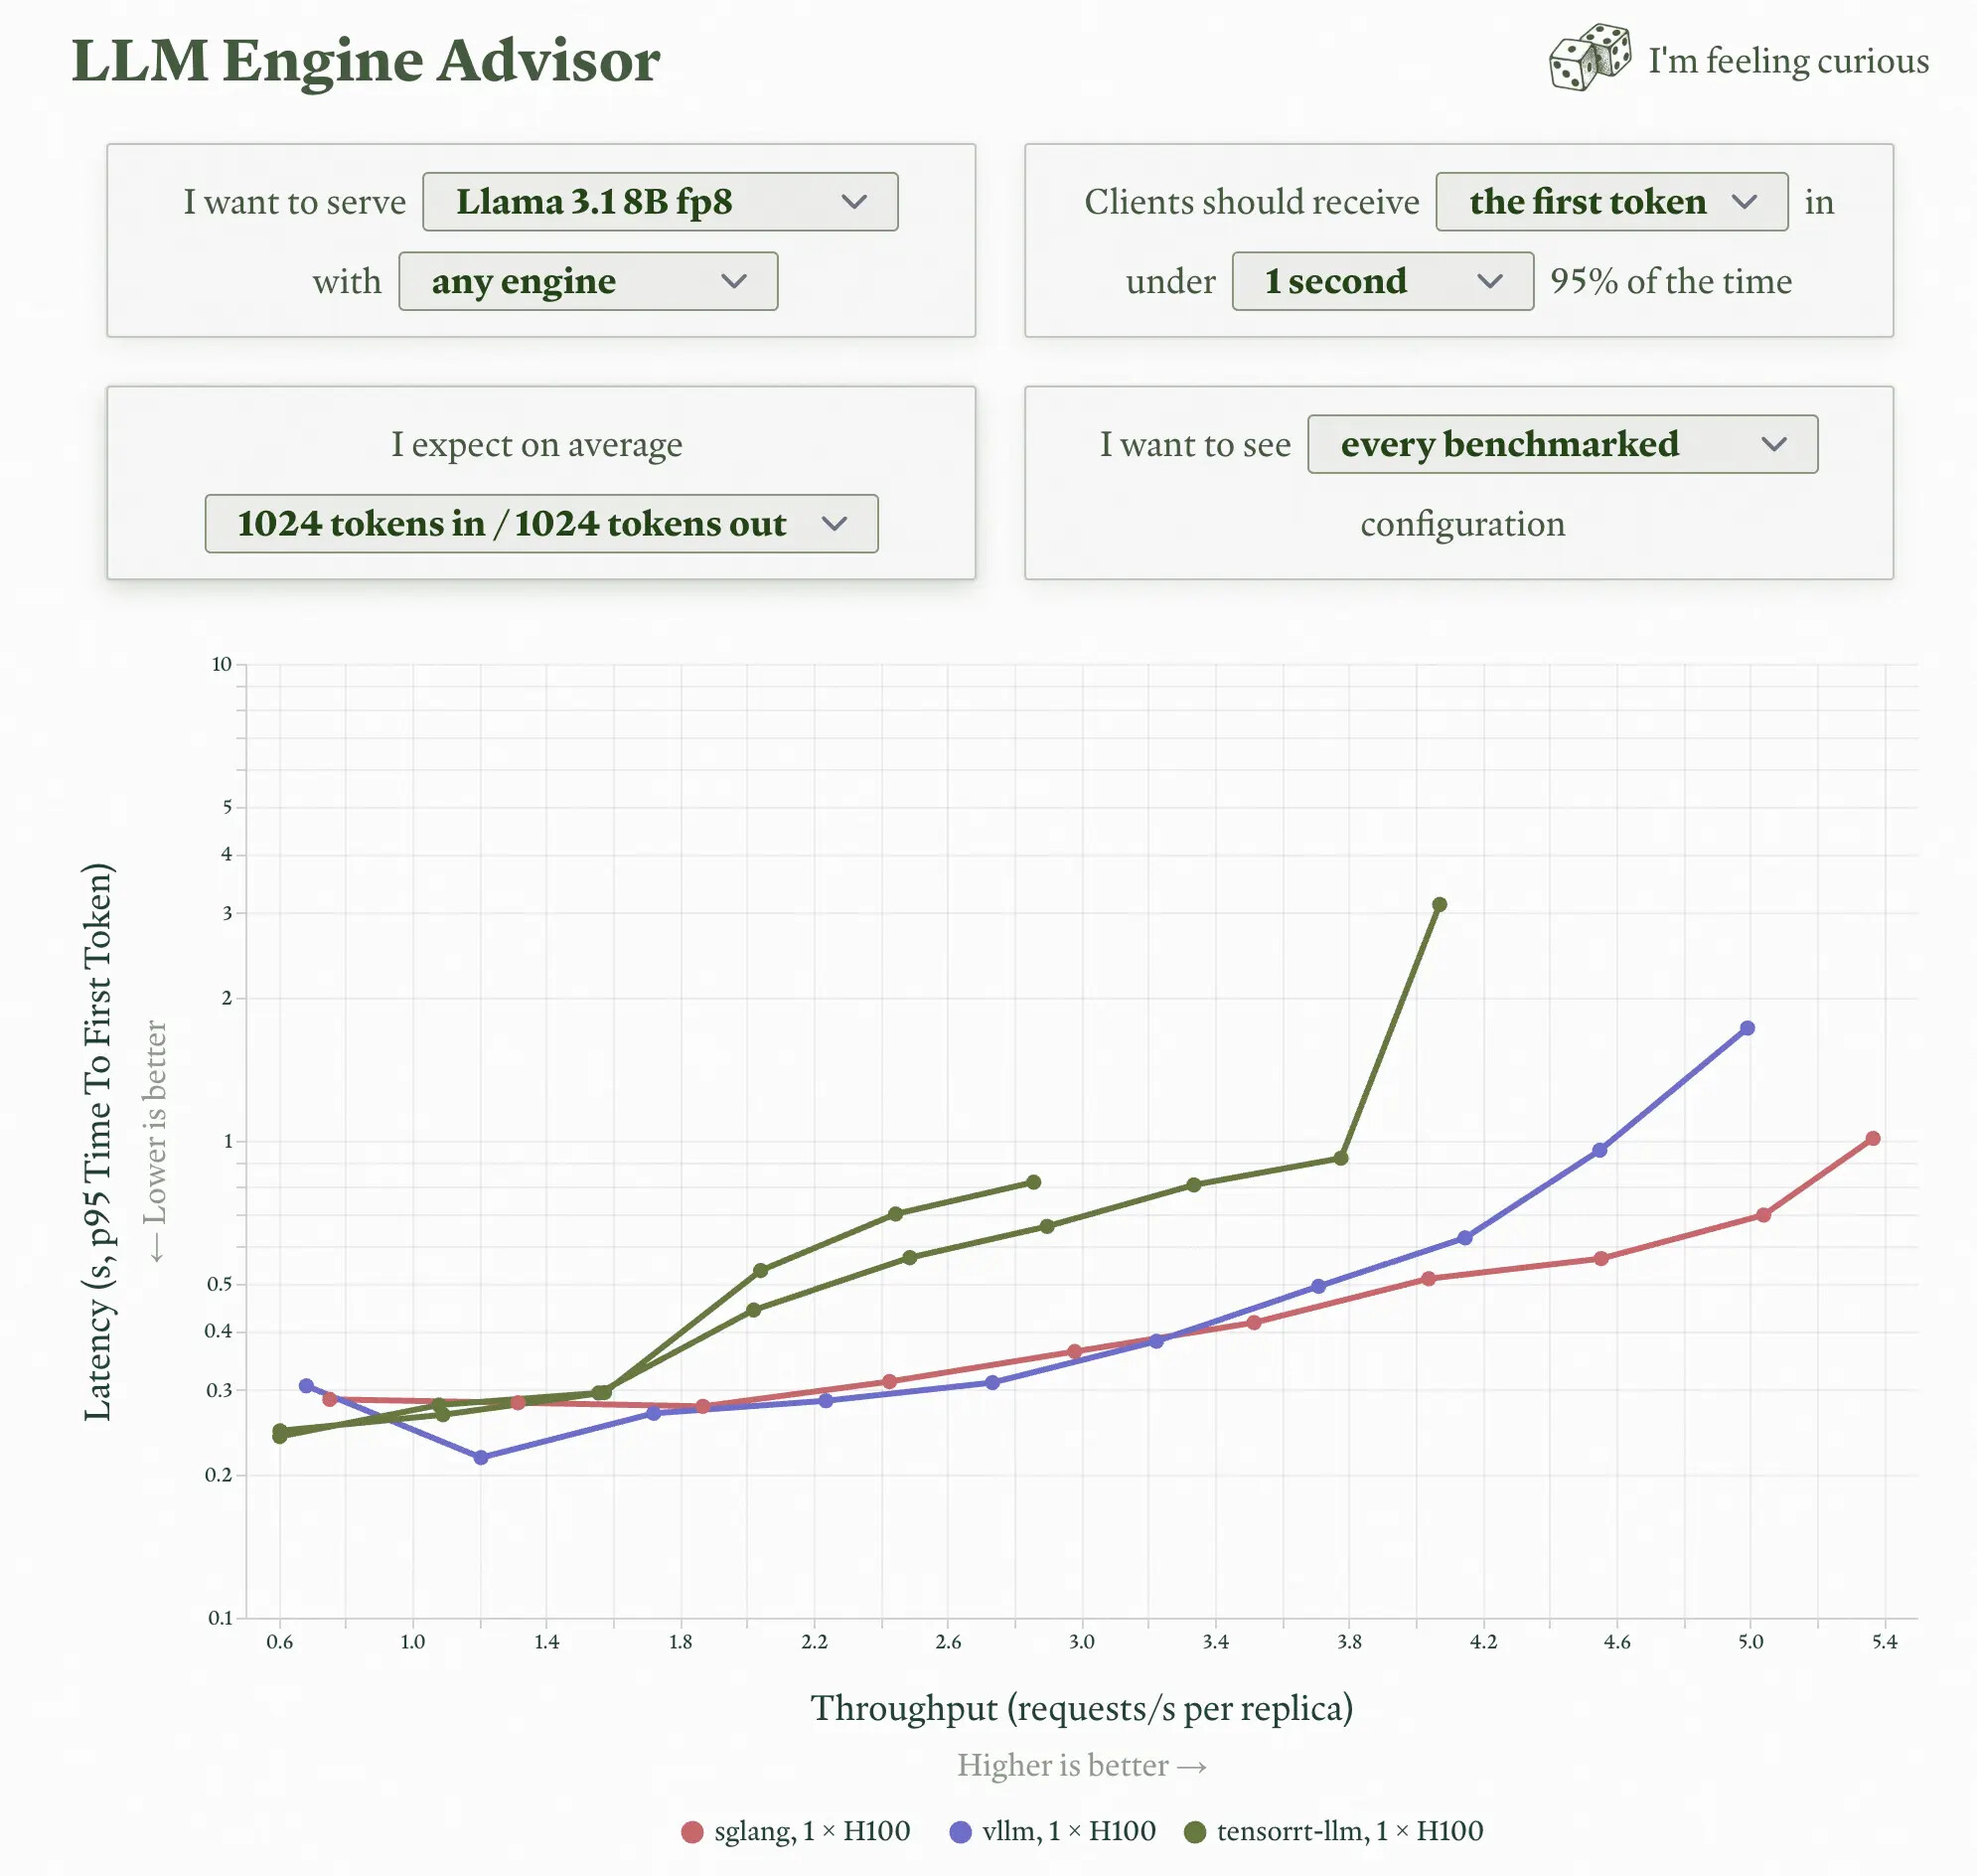
원문은 Llama 3.1 8B를 H100 1장에서 실행한 결과 중 세 가지 워크로드 형태를 골라 표로 보여 줍니다. 각 엔진이 p95 첫 토큰 지연(TTFT, Time To First Token) 1초 미만을 지키는 가장 높은 요청률을 골랐습니다. p95는 요청 95%가 그 시간 안에 첫 토큰을 받았다는 뜻입니다. 처리량은 복제본(replica) 하나당 초당 요청 수입니다. 위 Advisor 화면의 모델 설정은 Llama 3.1 8B fp8이지만, 원문은 표의 수치가 같은 fp8 설정인지 밝히지 않습니다.
| 워크로드 (입력 / 출력 토큰) | 가까운 사용 사례 | vLLM 처리량 | SGLang 처리량 | vLLM p95 TTFT | SGLang p95 TTFT |
|---|---|---|---|---|---|
| 1024 / 128 | RAG, 요약 | 17.08 req/s | 16.88 req/s | 0.52초 | 0.83초 |
| 128 / 1024 | 코드 생성 | 5.34 req/s | 6.50 req/s | 0.82초 | 0.87초 |
| 2048 / 2048 | 긴 채팅 | 1.23 req/s | 1.25 req/s | 0.65초 | 0.74초 |
위 표에서 3가지를 알 수 있습니다. 첫째, 입력이 긴 RAG 형태와 긴 채팅 형태에서 처리량 차이는 2% 안쪽입니다. 둘째, 출력이 긴 코드 생성 형태에서는 SGLang의 처리량이 vLLM보다 약 22% 높습니다(6.50 대 5.34). 셋째, 표에 적힌 p95 TTFT는 세 형태 모두 vLLM이 더 짧습니다. RAG 형태에서는 0.52초 대 0.83초로 차이가 큽니다. 다만 각 엔진의 지연 값은 서로 다른 요청률에서 잰 것이므로, 같은 부하에서 비교한 값이 아닙니다.
원문이 직접 짚은 한계도 있습니다. 원문에 따르면 Modal의 테스트 프롬프트는 제인 오스틴의 소설 『오만과 편견』에서 무작위로 잘라 낸 조각이라, 요청끼리 접두사를 거의 공유하지 않습니다. Modal의 벤치마크 방법 문서도 이 소설을 측정 데이터로 썼다고 밝힙니다. 원문은 이것이 서로 독립적인 요청에 대한 공정한 테스트이지만, 채팅과 에이전트에서 중요한 접두사 재사용, 즉 RadixAttention과 vLLM 접두사 캐싱이 차이를 만드는 지점은 보여 주지 않는다고 설명합니다. 또 결과는 기본 설정의 단일 복제본에서 나왔으므로 튜닝하면 달라질 수 있습니다.
원문이 적지 않은 조건도 둘 있습니다. 첫째, 측정 시점입니다. Modal 요약 보고서에 따르면 첫 실험 라운드는 2025년 5월 말에 끝났고, 사용한 버전은 vLLM 0.8.x와 0.9.x, SGLang 0.4.6-post5였습니다. 같은 보고서는 당시 SGLang 안정 버전에 Blackwell GPU용 가속 커널이 없었다고도 적습니다. 2026년 10월에 이 수치를 읽을 때는 1년 넘게 지난 버전의 결과라는 점을 감안해야 합니다.
원문이 링크한 Advisor 페이지도 그 뒤 데이터가 바뀌었습니다. 2026년 10월 16일에 확인한 현재 데이터 파일은 10월 8일에 생성되었고, 실시간 생성 워크로드 기준으로 2026년 7~9월에 측정한 모델별 레시피 42개(SGLang 40개, vLLM 2개)로 이루어져 있습니다. 모델마다 엔진 하나만 측정했고, Llama 3.1 8B는 없습니다. 같은 모델을 두 엔진으로 비교한 결과가 없으므로, 현재 페이지로는 원문의 표를 확인하거나 엔진을 비교할 수 없습니다. 대신 현재 데이터에는 요청당 캐시된 입력 45,000 토큰을 가정한 에이전트형 워크로드(Online agentic)가 들어 있어, 원문이 지적한 접두사 재사용 조건을 일부 다룹니다.
둘째, Modal은 같은 Almanac의 워크로드 문서에서 워크로드별로 다른 엔진을 권합니다. 처리량이 중요한 오프라인 배치 워크로드에는 vLLM을 권합니다. 지연이 중요한 온라인 워크로드에는 텐서 병렬화와 EAGLE-3 투기적 디코딩을 켠 SGLang을 권합니다. 부하가 들쭉날쭉한 준온라인 워크로드에는 둘 중 어느 것이든 쓸 수 있다고 봅니다. 원문이 인용한 Modal의 결론은 기본 설정 성능에 대한 것이고, Modal의 권고는 그 위에 운영 설정을 더한 판단입니다.
내 트래픽으로 직접 측정하기: GuideLLM
원문의 결론은 자기 트래픽으로 측정한 결과가 가장 좋은 벤치마크라는 것입니다. 원문은 GuideLLM을 예로 듭니다. GuideLLM은 vLLM 프로젝트가 관리하는 벤치마크 도구입니다. README에 따르면 OpenAI 호환 서버에 실제 데이터나 합성 데이터로 요청을 보내, 내 하드웨어에서 처리량과 지연을 측정합니다. 최근 버전에서 추가된 지연 SLO(서비스 수준 목표, Service Level Objective) 탐색과 에이전트 트레이스 재생 기능은 GuideLLM v0.8.0 소개 글에 정리되어 있습니다.
앞의 한계를 고려하면, 자체 측정에서는 다음 세 가지를 확인해야 합니다.
- 실제 트래픽에서 요청끼리 공유하는 접두사의 비율을 확인합니다. 시스템 프롬프트, 도구 정의, 대화 기록이 반복되는 에이전트라면 Modal의 무작위 텍스트 조건과 결과가 다를 수 있습니다.
- 실제 입력과 출력 길이 분포로 측정합니다. 원문의 표에서도 출력이 긴 형태에서만 처리량 차이가 컸습니다.
- 지금 쓰려는 엔진 버전과 GPU로 측정합니다. Modal 수치는 2025년 중반 버전과 H100 기준입니다.
정리: 원문과 Modal이 제시한 판단 기준
원문은 두 엔진이 같은 KV 캐시 문제에 다른 답을 냈고, 지금은 서로의 좋은 아이디어를 가져와 둘 다 빠르다고 정리합니다. 아래 표는 원문과 Modal 문서가 실제로 근거로 든 기준만 모은 것입니다.
| 상황 | 원문과 Modal 문서가 근거로 든 내용 |
|---|---|
| NVIDIA GPU에서 서로 독립적인 요청을 처리 | 기본 설정 처리량은 비슷하다 (Modal, 2025년 중반 버전) |
| 시스템 프롬프트와 대화 기록을 반복하는 채팅, 에이전트 | 접두사 재사용이 성능 차이를 만드는 조건이며, 공개 벤치마크는 이 조건을 측정하지 않았다 (원문) |
| TPU, Intel GPU, CPU, Apple 하드웨어 | vLLM의 지원이 더 오래되었다 (원문). 현재는 SGLang도 플랫폼별 문서를 둔다 (README) |
| 오프라인 배치 처리 | Modal은 vLLM을 권한다 |
| 지연이 중요한 온라인 서빙 | Modal은 텐서 병렬화와 EAGLE-3를 켠 SGLang을 권한다 |
여러분의 서비스에서는 요청의 몇 퍼센트가 같은 접두사를 공유하나요? 그 비율이 엔진 선택에 영향을 주었는지 댓글로 나눠 주시면 다른 분들의 판단에 도움이 됩니다.
 vLLM vs. SGLang: Choosing the right inference engine for your workload 원문 블로그
 vLLM GitHub 저장소
SGLang GitHub 저장소
 Modal LLM Engineer's Almanac 홈페이지
더 읽어보기
-
[2309.06180] Efficient Memory Management for Large Language Model Serving with PagedAttention
-
Fast and Expressive LLM Inference with RadixAttention and SGLang - LMSYS Org
-
GuideLLM v0.8.0 공개, 지연 SLO를 지키는 최대 동시성 탐색과 에이전트 트레이스 재생 (feat. vLLM)
-
Club-3090: RTX 3090 GPU에서 vLLM, llama.cpp, SGLang으로 LLM을 서빙하는 커뮤니티 레시피 모음
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
