핵심 요약
- Meta가 2026년 10월 12일 Muse Wonder 발표 글에서 에이전트용 모델 Muse Wonder와 상위 변형 Muse Wonder Full을 출시했습니다. 가중치는 공개하지 않고 API와 구독으로만 제공합니다.
- Meta가 고른 5개 모델의 결과표 14개 항목 중 7개에서 Muse Wonder 계열이 1위입니다. 나머지 7개 중 6개는 Claude Opus 5.5가 1위이며, 여기에는 Artificial Analysis 종합 지수(Opus 5.5 58점, Muse Wonder Full 56점)도 들어갑니다.
- Meta 표에서 우위가 큰 영역은 장기 코딩(DeepSWE 79.0, SWE-Marathon 57.5)과 장기 기억(MemoryBench 85.6)입니다. 다만 SWE-Marathon 공식 리더보드에는 Full이 53.1%로 올라 있어 2위 Claude Sonnet 5.5(51.3%)와의 차이가 1.8점이고, MemoryBench는 Meta 내부 평가입니다.
- API로 쓸 수 있는 것은 기본형
muse-wonder-1.0(입력 $4, 출력 $20, 100만 토큰당)뿐입니다. 1위 점수 대부분을 낸 Full은 Muse Code 월 $50 이상 구독에서만 쓸 수 있고, API의 기본형이 다른 세 모델을 모두 앞서는 항목은 14개 중 4개입니다. - 모델 카드에 따르면 완화 조치가 없는 상태에서는 화학 및 생물학 영역의 High 위험 기준 도달을 배제하지 못해, 분류기 등 완화 조치를 적용한 뒤 배포했습니다.
Muse Wonder 소개
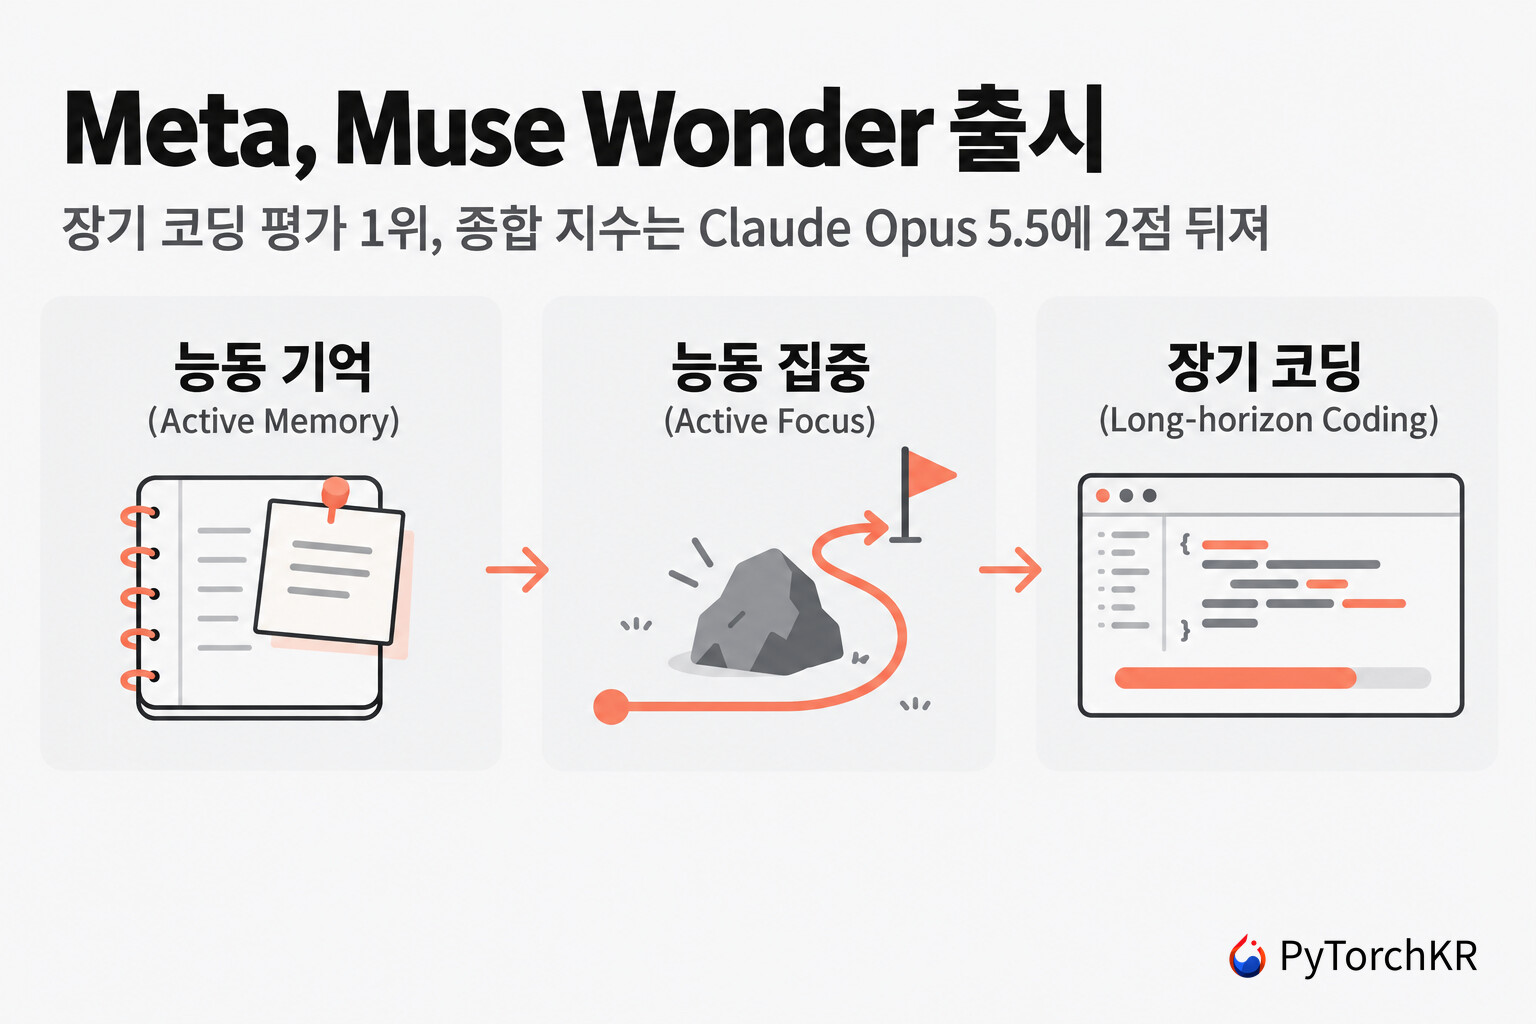
Muse Wonder는 Meta가 개인 일상 업무와 직장 업무를 대신 처리하는 에이전트용으로 내놓은 프런티어 모델입니다. 사용자의 맥락을 대화가 바뀌어도 기억하고, 오래 걸리는 작업을 막혀도 끝까지 이어 가는 것을 목표로 학습했다고 Meta는 설명합니다.
이번에 소개하는 Muse Wonder는 올해 Meta가 이어 온 Muse 계열의 다음 단계입니다. Meta는 2026년 4월 첫 모델 Muse Spark를 내놓았습니다. 이어 8월에는 터미널 코딩 에이전트 Muse Code와 Muse Spark 1.2를 (
 Meta, 터미널 코딩 에이전트 Muse Code와 코딩 특화 모델 Muse Spark 1.2 출시), 9월에는 긴 에이전트 작업에 초점을 맞춘 Muse Spark 1.3을 출시했습니다 ( Meta, Muse Spark 1.3 출시: 1M 컨텍스트 검색 55.5점에서 98.1점으로, 코딩 도구 호출 20% 절감). Meta는 14개월 전 AI 개발 체계를 처음부터 다시 세웠다고 밝혔습니다. Muse Wonder는 기가와트 규모의 Prometheus 데이터센터에서 사전학습(Pre-training)과 강화학습(Reinforcement Learning)을 확장해 학습한 모델이라고 소개합니다. 이 계열의 목표를 Meta는 일관되게 개인용 초지능(Personal Superintelligence) 이라고 부릅니다.
모델은 두 가지입니다. Muse Wonder 는 Meta Model API와 Muse Code에서 쓸 수 있고, 성능이 더 높은 Muse Wonder Full 은 Muse Code 구독자만 쓸 수 있습니다. Meta의 Muse 서비스에는 곧 Muse Wonder가 들어가며, 구독자에게 먼저 제공하고 산출물(Artifact) 생성처럼 더 높은 성능이 필요한 처리에도 쓸 예정입니다. Meta는 앞으로 Muse Wonder를 바탕으로 특화 모델을 만들어 Muse의 모든 사용자에게 제공하겠다는 계획도 밝혔습니다.
이 글은 발표 글과 함께 모델 카드(PDF 13쪽), 개발자 문서의 가격표, 데모 영상의 화면 자막을 대조해 정리했습니다. 발표 글은 "최고 수준(state-of-the-art)" 이라는 표현을 여러 번 쓰지만, 같은 글에 실린 결과표를 항목별로 보면 1위를 나눠 가진 구도입니다. 아래에서는 Meta의 주장과 표에서 확인되는 사실을 나눠서 적습니다.
모델 사양과 제공 방식: API는 기본형만, Full은 Muse Code 구독 전용
개발자가 가장 먼저 확인해야 할 것은 어느 모델을 어디서 쓸 수 있는지입니다. Meta 개발자 문서에 따르면 Muse Wonder는 현재 미리보기(Preview) 상태입니다. 두 모델 모두 텍스트, 이미지, 영상, 오디오, PDF를 입력으로 받아 텍스트를 출력하고, 컨텍스트 창은 1,048,576 토큰입니다. 추론 강도(Reasoning Effort)는 "minimal" 부터 "max" 까지 고를 수 있습니다.
| 항목 | Muse Wonder | Muse Wonder Full |
|---|---|---|
| 모델 ID | muse-wonder-1.0 |
muse-wonder-full-1.0 |
| Meta Model API (종량제) | 제공 | 제공하지 않음 |
| OpenRouter | 제공 (meta/muse-wonder, 같은 가격) |
제공하지 않음 |
| Muse Code | 종량제와 모든 구독 플랜 | Power Usage($50/월), Maximum Usage($200/월) 플랜 |
| API 가격 (100만 토큰당) | 입력 $4.00, 캐시 입력 $0.20, 출력 $20.00 | 해당 없음 |
| 컨텍스트 창 | 1M 토큰 | 1M 토큰 |
문서는 "Muse Wonder에서 추론 강도를 max 로 설정해도 Full이 선택되지 않는다" 고 명시합니다. 발표 글의 결과표에 나오는 Muse Wonder Full (max) 점수는 API로는 재현할 수 없습니다. 가격은 같은 API의 Muse Spark 1.3 표준 요금(입력 $1.25, 출력 $4.25)보다 입력이 3.2배, 출력이 약 4.7배 비쌉니다. 문서에 따르면 두 모델은 같은 엔드포인트와 요청 형식을 쓰므로 모델 ID만 바꾸면 옮길 수 있습니다. Meta는 비용보다 성능이 중요한 다중 파일 코딩과 몇 시간짜리 에이전트 실행에는 Wonder를, 대량 처리나 지연에 민감한 작업에는 Spark를 권합니다.
데이터 사용 조건도 다릅니다. API 종량제의 Muse Wonder는 표준 모드(Standard mode) 만 지원하며, 이 모드에서는 보낸 프롬프트와 응답을 Meta 모델 학습에 쓰지 않습니다. 반면 Muse Code 구독은 기본값이 기여 모드(Contributor mode) 입니다. 사용량을 더 주는 대신 사용자의 코드와 대화를 Meta의 향후 모델 학습에 쓰는 모드이고, 설정에서 끌 수 있습니다. 회사 코드를 다루는 팀이라면 구독 전에 이 설정을 먼저 확인해야 합니다.
모델 카드는 지원 언어에 대해 다국어 데이터로 학습했다고만 적었고, 언어 목록은 없습니다. 모델 카드의 한계 항목은 사전학습 데이터의 모든 언어를 평가하지 않았으며 강하게 지원하는 언어 밖에서는 성능이 떨어질 수 있다고 밝힙니다. 한국어 성능에 대한 수치는 이번 자료 어디에도 없습니다.
14개 평가 결과: 1위를 Claude Opus 5.5와 나눠 가진 구도
Meta는 개인과 직장 에이전트 9개, 코딩 4개, 종합 지수 1개로 모두 14개 항목을 공개했습니다. 비교 대상은 Claude Fable 5.1, GPT-6 Astra, Claude Opus 5.5이며, 모델 카드에 따르면 모든 모델을 최대 추론 강도(max)로 평가했습니다. 아래 그림은 발표 글에 실린 전체 결과표이고, 회색 배경 셀이 각 행의 1위입니다.
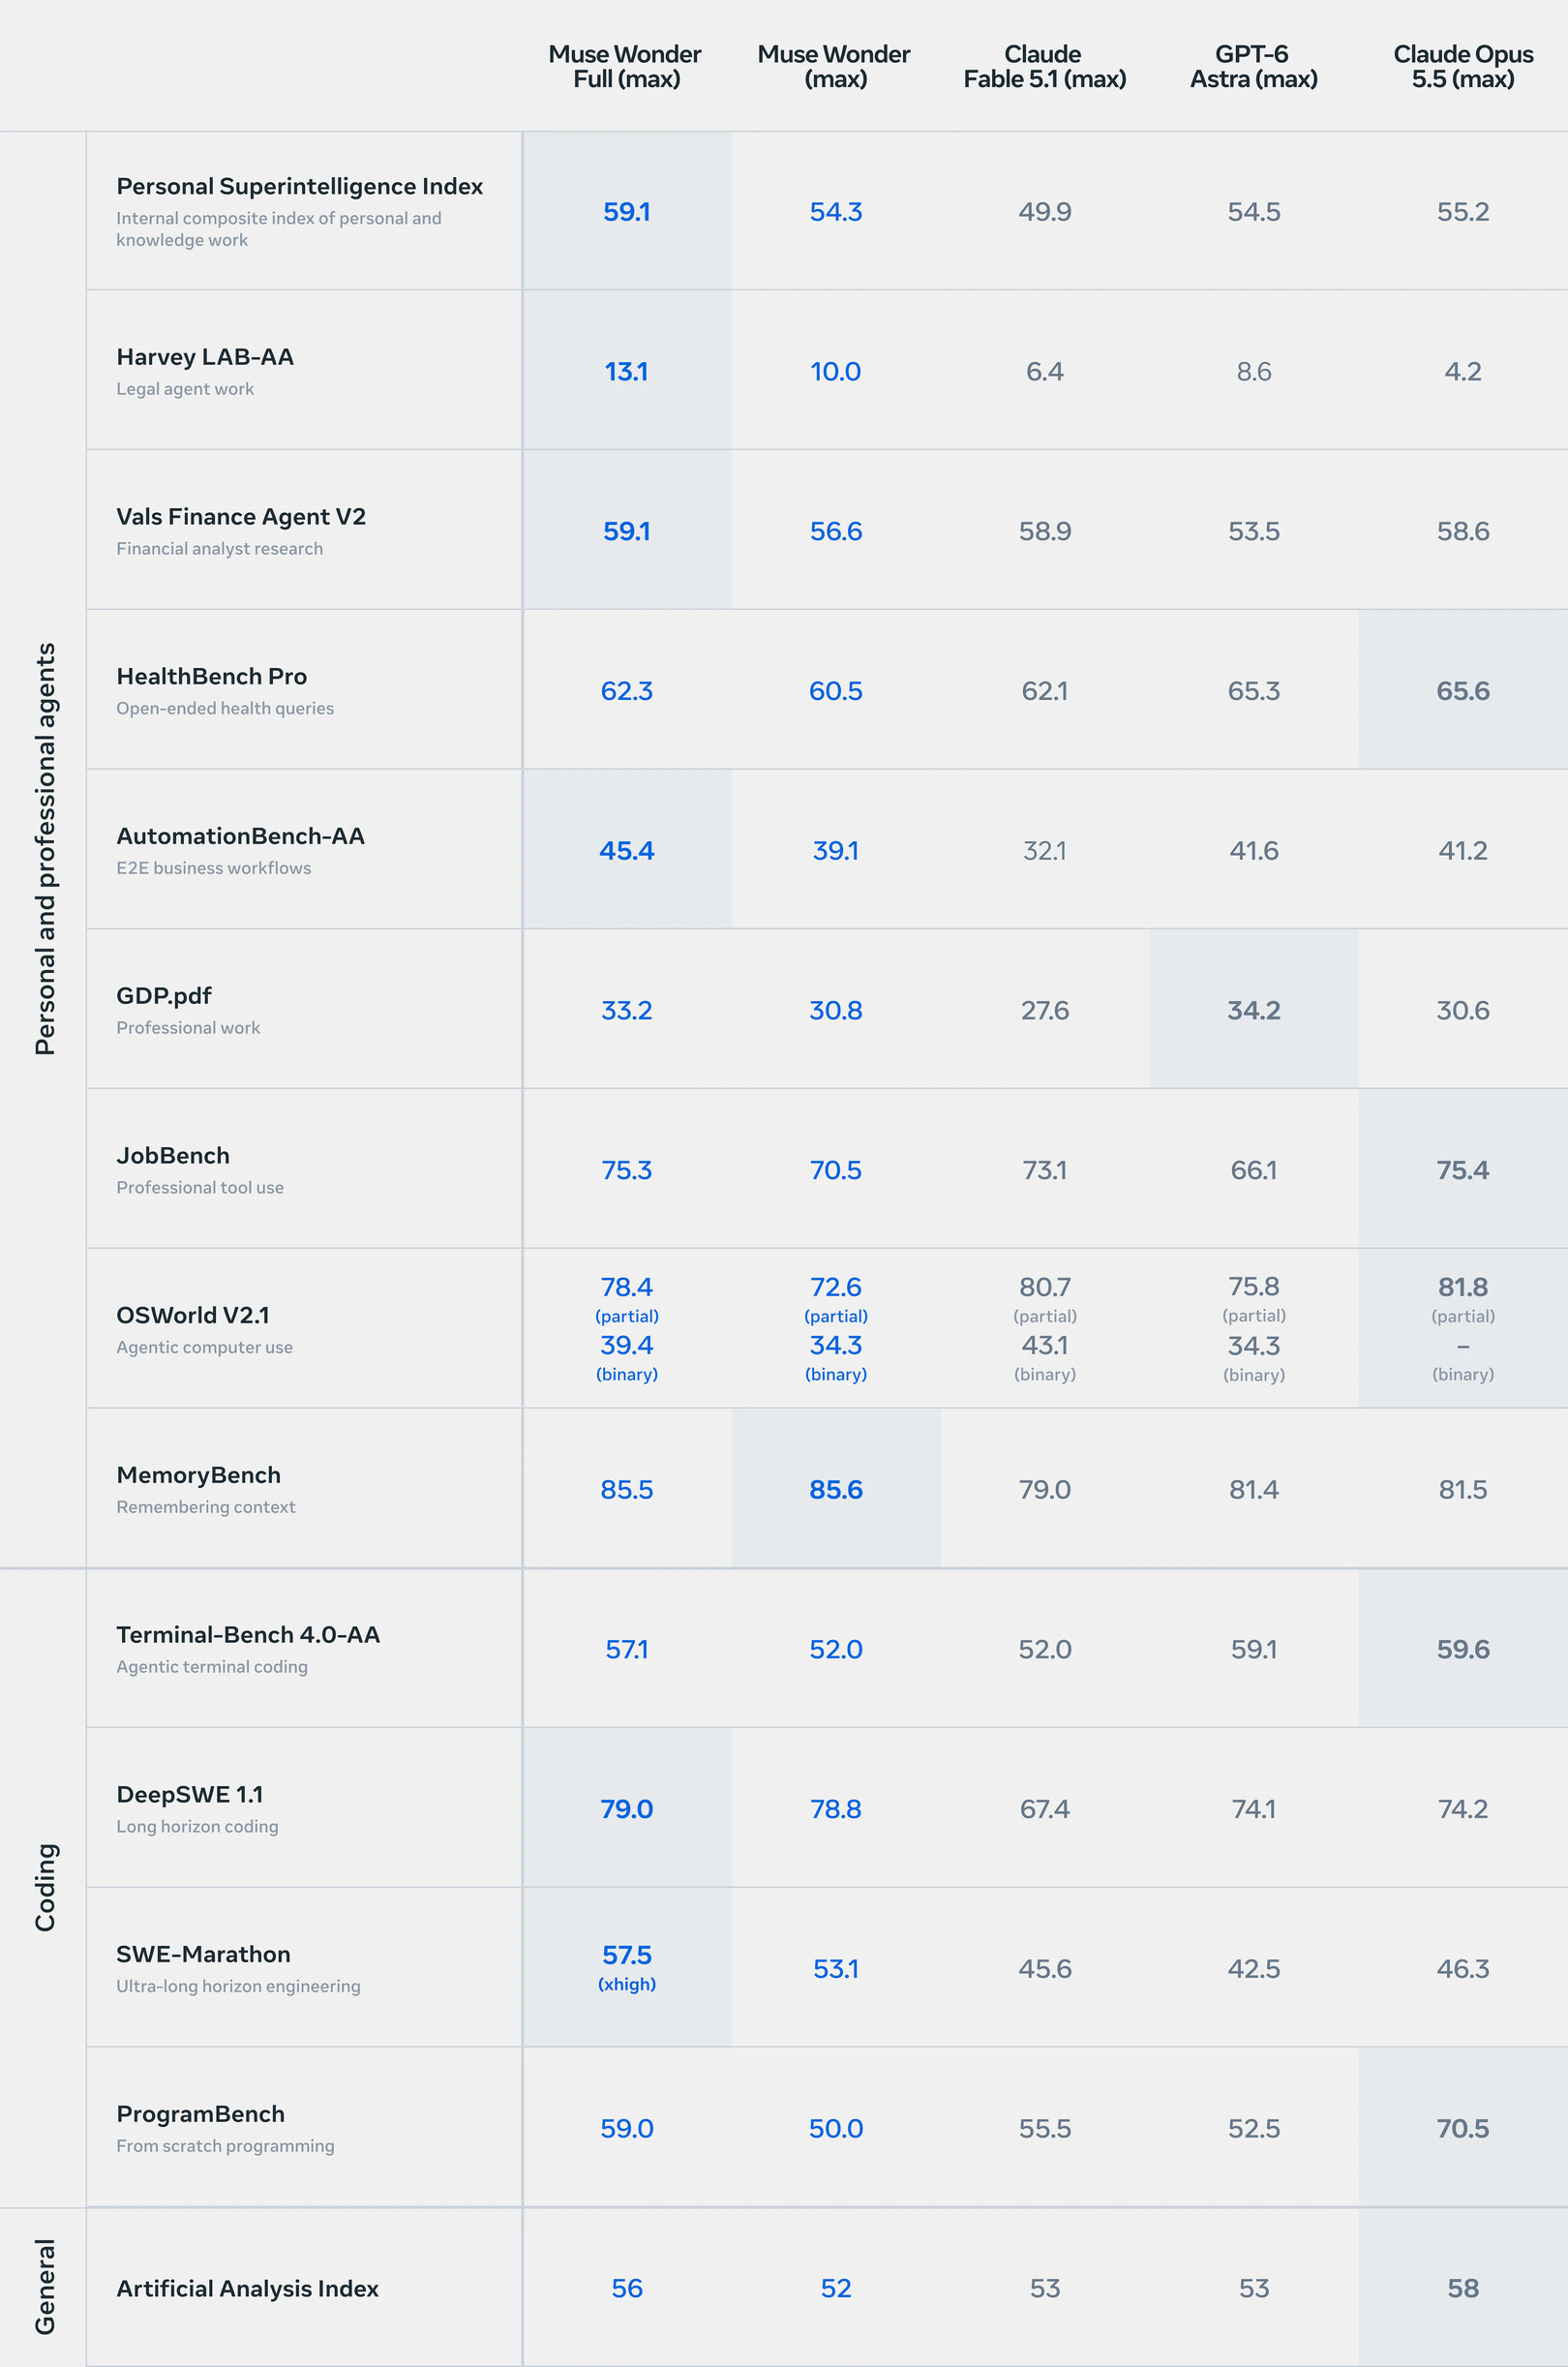
위 표에서 각 행의 1위를 세어 보면 다음과 같습니다. Muse Wonder Full이 6개, Muse Wonder가 1개(MemoryBench)로 Muse 계열이 7개 항목에서 1위입니다. Claude Opus 5.5가 HealthBench Pro, JobBench, OSWorld V2.1, Terminal-Bench 4.0, ProgramBench, Artificial Analysis 종합 지수까지 6개, GPT-6 Astra가 GDP.pdf 1개에서 1위입니다.
| 영역 | Muse Wonder Full이 1위인 항목 | 다른 모델이 1위인 항목 |
|---|---|---|
| 개인, 직장 에이전트 | Personal Superintelligence Index 59.1, Harvey LAB-AA 13.1, Vals Finance Agent V2 59.1, AutomationBench-AA 45.4 (MemoryBench는 기본형이 85.6으로 1위) | HealthBench Pro (Opus 5.5 65.6), GDP.pdf (GPT-6 Astra 34.2), JobBench (Opus 5.5 75.4), OSWorld V2.1 (Opus 5.5 81.8) |
| 코딩 | DeepSWE 1.1 79.0, SWE-Marathon 57.5 | Terminal-Bench 4.0-AA (Opus 5.5 59.6), ProgramBench (Opus 5.5 70.5) |
| 종합 | 없음 | Artificial Analysis 종합 지수 (Opus 5.5 58) |
격차의 크기도 항목마다 다릅니다. Muse Wonder Full이 가장 크게 앞선 항목은 SWE-Marathon(2위보다 11.2점 높음)이고, Vals Finance Agent V2에서는 Claude Fable 5.1(58.9)보다 0.2점 높을 뿐입니다. 반대로 ProgramBench에서는 Opus 5.5보다 11.5점 낮습니다. Meta가 전문 지식 영역으로 내세운 법률, 금융, 건강 중에서도 법률(Harvey LAB-AA)과 금융(Vals Finance Agent V2)은 Full이 1위지만, 건강(HealthBench Pro)은 Opus 5.5와 GPT-6 Astra보다 낮습니다. 발표 글은 "개인과 직장 에이전트, 기억, 코딩의 핵심 벤치마크에서 최고 수준" 이라고 썼습니다. 그러나 코딩 4개 중 터미널 작업과 처음부터 프로그램을 다시 만드는 과제에서는 Opus 5.5가 앞섭니다. Muse Wonder 계열이 앞선 코딩 항목은 모델 카드가 장기(Long-horizon) 과제로 분류한 DeepSWE와 SWE-Marathon 두 개입니다.
외부 리더보드로 본 순위: 비교 대상 밖의 모델과 다른 수치
결과표의 1위는 Meta가 고른 5개 모델 안의 순위입니다. 결과표에는 Gemini 4 Argon과 Claude Sonnet 5.5가 없습니다. 2026년 10월 13일 기준으로 평가 기관의 공개 리더보드를 확인한 결과는 다음과 같습니다.
- Vals Finance Agent V2: Vals AI 리더보드(10월 12일 갱신, 78개 모델)의 Muse Wonder Full 59.1%는 Meta 표와 같은 값이지만 순위는 5위입니다. Gemini 4 Argon(65.4%), Gemini 3.8 Flash(61.4%), 그리고 Meta의 이전 모델 Muse Spark 1.2(60.6%)와 Muse Spark 1.3 max(60.0%)가 더 높습니다. 기본형 Muse Wonder(56.6%)는 16위로, 표준 Muse Spark 1.3(58.9%)보다 낮습니다.
- SWE-Marathon: Abundant AI의 공식 리더보드(v1.1)에서 1위는 Muse Wonder Full이지만 값은 max 추론 강도의 53.1%이고, 기본형은 52.5%입니다. Meta 표의 Full 57.5%(xhigh)는 이 리더보드에 없습니다. 2위는 Meta 표에 없는 Claude Sonnet 5.5(51.3%)입니다. Opus 5.5(46.3%), Fable 5.1(45.6%), GPT-6 Astra(42.5%)는 Meta 표와 같습니다.
- DeepSWE: Datacurve의 공개 리더보드는 9월 22일 갱신본으로, Muse Wonder와 Opus 5.5가 아직 없습니다. 최고 점수는 GPT-6 Astra, Gemini 3.8 Flash, Claude Opus 5의 74%입니다.
Artificial Analysis 종합 지수: Muse Spark에서 Muse Wonder Full까지
Artificial Analysis는 여러 평가를 직접 실행해 하나의 점수로 묶는 외부 평가 기관입니다. 모델 카드는 이번 v4.3 지수의 구성 요소로 GDPval-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam 등 10개 평가를 나열합니다. 아래 그림은 Meta가 발표 글에 실은 2026년 10월 12일 기준 차트로, Muse 계열(파란색) 모델이 나올 때마다 점수가 어떻게 올라갔는지를 화살표로 표시했습니다.
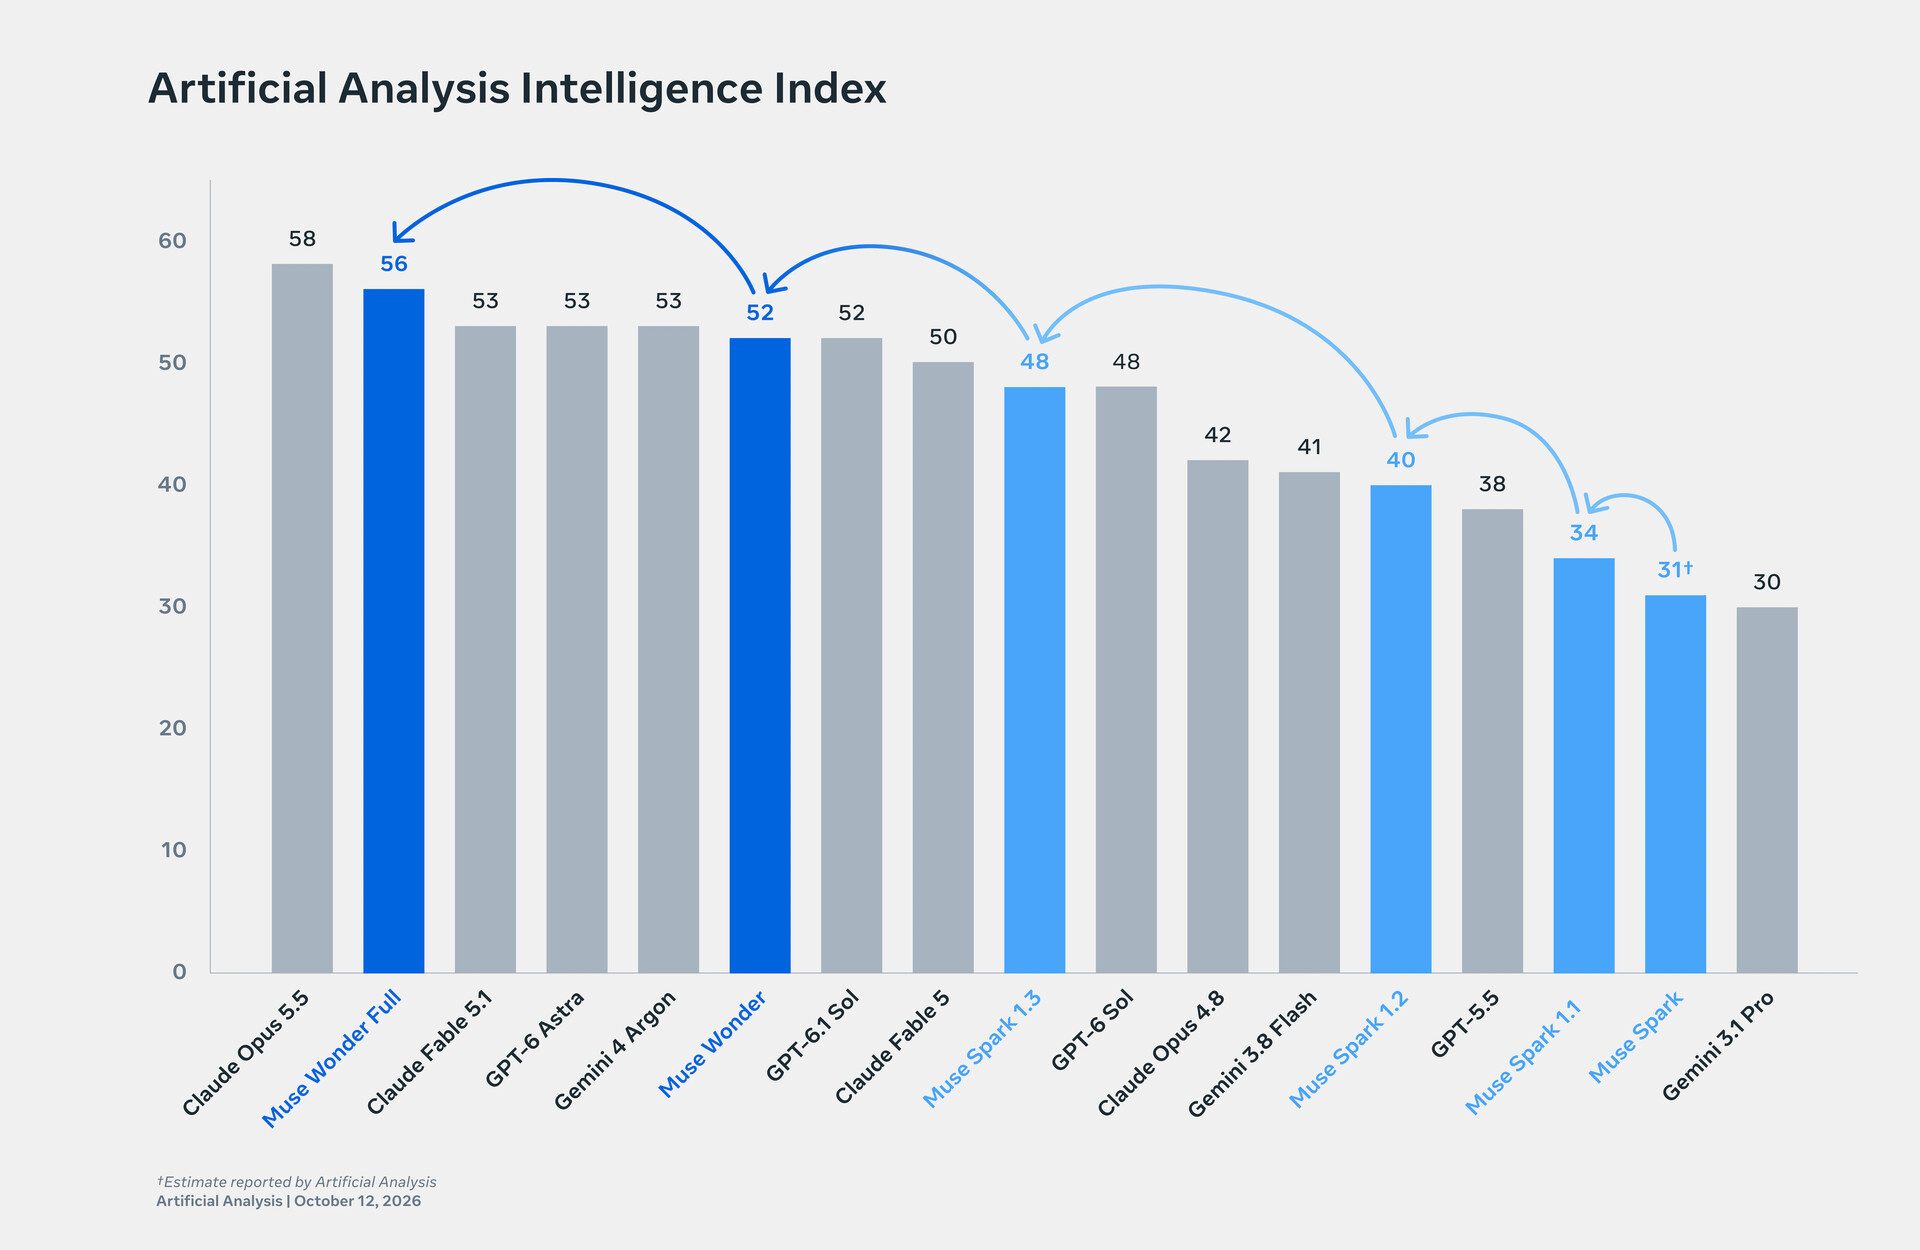
Muse 계열은 첫 Muse Spark의 31점(Artificial Analysis 추정치)에서 1.1의 34점, 1.2의 40점, 1.3의 48점을 거쳐 Muse Wonder Full의 56점까지 올라왔습니다. Full은 Claude Fable 5.1, GPT-6 Astra, Gemini 4 Argon(모두 53점)보다 높지만 Claude Opus 5.5(58점)보다는 2점 낮습니다(Artificial Analysis 사이트의 소수점 값으로는 57.6 대 55.8). API로 쓸 수 있는 기본형 Muse Wonder는 52점으로, 위 세 모델보다 1점 낮고 GPT-6.1 Sol과 같은 점수입니다.
API 사용자가 실제로 받는 모델: 기본형 Muse Wonder의 위치
결과표에서 API 사용자에게 의미 있는 열은 Full이 아니라 기본형 Muse Wonder (max) 입니다. 이 열을 다른 세 모델의 최고 점수와 항목별로 비교하면, 기본형이 셋을 모두 앞서는 항목은 14개 중 4개입니다.
| 항목 | 기본형 Muse Wonder | 다른 세 모델 중 최고 | 차이 |
|---|---|---|---|
| SWE-Marathon | 53.1 | 46.3 (Opus 5.5) | +6.8 |
| DeepSWE 1.1 | 78.8 | 74.2 (Opus 5.5) | +4.6 |
| MemoryBench | 85.6 | 81.5 (Opus 5.5) | +4.1 |
| Harvey LAB-AA | 10.0 | 8.6 (GPT-6 Astra) | +1.4 |
| Personal Superintelligence Index | 54.3 | 55.2 (Opus 5.5) | -0.9 |
| OSWorld V2.1 (부분 점수) | 72.6 | 81.8 (Opus 5.5) | -9.2 |
| ProgramBench | 50.0 | 70.5 (Opus 5.5) | -20.5 |
위 표는 결과표의 일부 행만 옮긴 것입니다. SWE-Marathon 공식 리더보드의 기본형 값은 52.5%로, 이 기준으로도 2위 Claude Sonnet 5.5(51.3%)보다 높습니다. 기본형은 장기 코딩 두 항목과 기억 평가에서는 Full과 거의 같은 점수를 냅니다(DeepSWE 78.8 대 79.0, MemoryBench 85.6 대 85.5). 반면 Meta가 내세운 Personal Superintelligence Index는 54.3으로 Opus 5.5와 GPT-6 Astra(54.5)보다 낮고, 컴퓨터 사용(OSWorld)과 처음부터 프로그램을 만드는 과제(ProgramBench)에서는 격차가 큽니다. 장기 코딩 에이전트를 API로 실행하려는 팀이라면 기본형만으로도 발표 수치의 상당 부분을 기대할 수 있습니다. 반면 범용 에이전트나 컴퓨터 사용이 목적이라면 Full의 점수를 기준으로 판단하면 안 됩니다.
점수를 읽을 때 확인할 평가 조건
모델 카드의 방법론 절에는 표를 해석할 때 필요한 조건이 여럿 적혀 있습니다.
-
내부 평가가 섞여 있습니다: Personal Superintelligence Index는 Meta 내부 종합 지수이고, 구성 평가 7개(Agents' Last Exam, AutomationBench-AA, FocusBench, JobBench, GDP.pdf, VBT, DRACO) 가운데 FocusBench와 VBT는 Meta 내부 평가입니다. MemoryBench도 내부 평가입니다. 세 평가 모두 공개 여부가 밝혀지지 않아 외부에서 같은 조건으로 재현하기 어렵습니다.
-
SWE-Marathon은 같은 조건의 비교가 아닙니다: 모델 카드는 모든 모델의 결과 출처를 Abundant AI라고 밝힙니다. 모델 카드에 따르면 이 리더보드에서 GPT-6 Astra는 Codex, Claude Fable 5.1은 Claude Code를 하네스(Harness)로 썼습니다. 하네스는 모델에 도구와 실행 환경을 붙여 주는 에이전트 실행 틀입니다. 모델 카드는 이 행이 공통 하네스 비교가 아니라고 직접 밝힙니다. 또 Muse Wonder Full의 57.5점은 다른 모델과 달리 max가 아닌 xhigh 추론 강도에서 나온 값입니다.
-
점수 선택 방식: 같은 조건의 제3자 결과가 있으면 그것을 쓰고, 없으면 내부 검증 실행, 자체 보고 점수, 공식 리더보드 점수 가운데 가장 높은 값을 썼습니다. 경쟁 모델을 Meta가 직접 실행한 경우는 프롬프트와 도구 설정이 그 모델에 맞게 조정되지 않았을 수 있다고 모델 카드는 밝힙니다.
-
외부 결과의 출처: DeepSWE는 Datacurve의 제3자 실행 결과(Muse Wonder 두 모델과 Opus 5.5)와 OpenAI 자체 보고(GPT-6 Astra), Anthropic 시스템 카드(Fable 5.1)를 함께 썼습니다. Harvey LAB-AA, AutomationBench-AA, Terminal-Bench 4.0, 종합 지수는 Artificial Analysis, Vals Finance Agent V2는 Vals AI, GDP.pdf는 Surge가 결과의 출처입니다.
-
절대 점수가 낮은 항목: Harvey의 법률 에이전트 평가를 Artificial Analysis가 옮긴 Harvey LAB-AA는 산출물이 모든 기준과 환각(Hallucination) 검사를 통과한 과제의 비율이라, 1위인 Full도 13.1%입니다. 같은 기준에서 다른 세 모델은 4.2~8.6%였습니다.
능동 기억과 능동 집중: Meta가 정의한 두 가지 능력
발표 글은 Muse Wonder의 특징으로 능동 기억(Active Memory) 과 능동 집중(Active Focus) 을 내세웁니다. 두 용어는 Meta가 이번에 붙인 이름입니다. 발표 글은 이를 모델의 능력으로 설명하며, 별도 기능이나 모델 구조로는 설명하지 않습니다.
능동 기억은 사용자에 대한 중요한 맥락을 대화가 바뀌어도 이어 가고, 지금 작업에 필요한 세부 사항을 스스로 찾아 쓰는 능력입니다. 발표 영상에서 Meta 연구진은 이 기억이 며칠에서 몇 달에 걸쳐 유지되도록 공을 들였다고 말합니다. 이를 측정한 MemoryBench는 64K~100K 토큰 길이의 여러 차례 대화 속에서 핵심 정보를 정확히 떠올리는지 보는 내부 평가입니다. 관련 없는 대화와, 앞의 정보와 충돌하거나 나중에 정보를 바꾸는 대화를 일부러 끼워 넣고, LLM 채점기가 질문별 채점 기준(Rubric)으로 답을 평가합니다. 기본형이 85.6, Full이 85.5로 다른 세 모델(79.0~81.5)보다 4점 이상 높습니다.
다만 발표 글과 모델 카드 어디에도 이 기억이 어떻게 구현되는지는 나오지 않습니다. 모델 카드의 설명대로라면 MemoryBench는 64K~100K 토큰 길이의 대화 안에서 정보를 떠올리는 능력을 잽니다. 서비스에서 대화 사이에 기억을 저장하고 불러오는 기능과 같은 것인지는 공개 자료로 확인할 수 없습니다.
능동 집중은 어려운 목표를 향해 계속 일하는 능력입니다. Meta는 다른 방법을 시도하고, 막힌 지점을 돌파하고, 새 정보에 맞춰 계획을 바꾸는 행동을 예로 듭니다. 동시에 필요하면 사용자에게 되묻고, 중요한 행동 전에는 확인을 받는다고 설명합니다. 이 능력은 내부 평가인 FocusBench로 측정했습니다. FocusBench는 주거, 여행, IT, 금융 분야의 개인 에이전트 과제에서, 실제 상황처럼 막히는 지점과 계속 바뀌는 환경을 여러 차례의 상호작용에 걸쳐 헤쳐 나가는지를 봅니다. 발표 글의 차트에서 Full이 54.2%로 GPT-6 Astra(47.7%), Opus 5.5(45.8%)보다 높았고, 기본형은 44.9%로 이 둘보다 낮았습니다.
발표 영상에서 한 연구원은 이 모델을 만들 때 가장 어려웠던 일로 "실제 환경의 실패를 안정적으로 재현하는 것" 을 꼽습니다. 그렇게 재현한 실패로 모델이 실패를 예상하고 피하도록 학습시켰다는 설명입니다. 학습 과제와 데이터에 대해 공개된 설명은 이 정도이고, 학습 방법의 세부는 나오지 않습니다.
학습하지 않은 과제로의 일반화: 기반 모델 크기에 대한 Meta의 주장
발표 글에서 기술적으로 가장 흥미로운 대목은 벤치마크 점수와 실제 체감 사이의 차이를 다룬 부분입니다. 두 모델이 비슷한 벤치마크 점수를 받아도 낯선 과제에서는 한쪽이 훨씬 잘하는 경우가 있습니다. Meta는 커뮤니티에서 쓰는 "benchmaxxing" (특정 벤치마크 점수만 끌어올리는 것)이라는 비판과 "big model smell" (큰 모델에서 느껴지는 폭넓은 능력)이라는 칭찬이 모두 이 차이를 가리킨다고 설명합니다.
이를 수치로 보려고 Meta는 사후 학습(Post-training)에서 집중한 과제의 점수(분포 내(In-distribution) 성능)와 집중하지 않은 과제의 점수(분포 외(Out-of-distribution) 성능)를 함께 그렸습니다. 아래 그림의 각 점은 추론 강도를 하나씩 바꿔 가며 측정한 결과입니다.
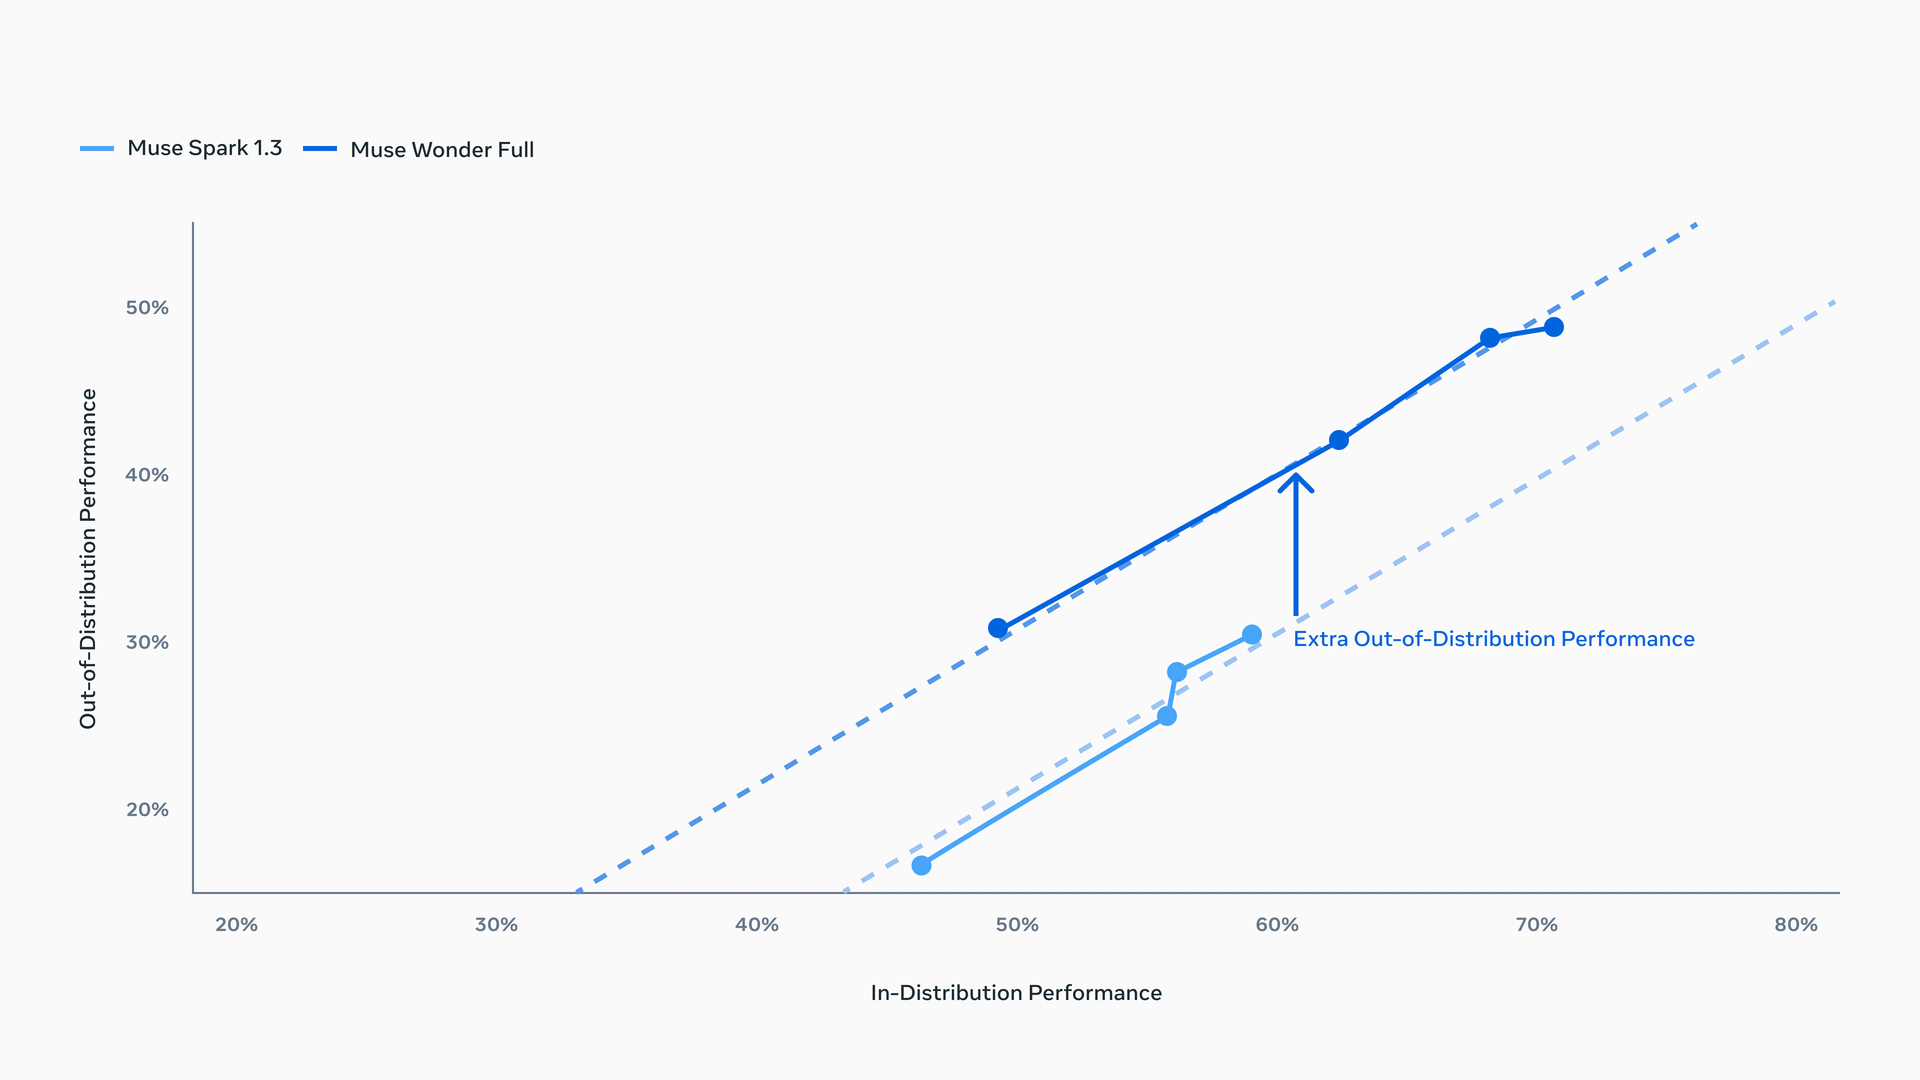
위 그림에서 두 모델의 점선 추세선은 기울기가 비슷하고, Muse Wonder Full의 선이 Muse Spark 1.3의 선보다 위에 있습니다. 즉 분포 내 점수가 같을 때 Full의 분포 외 점수가 더 높습니다. 예를 들어 분포 내 60% 지점에서 Spark 1.3의 추세선은 분포 외 약 30%, Full의 추세선은 약 40%를 가리킵니다(그림에서 읽은 근사치입니다). Meta는 이 차이를 "더 크고 강한 기반 모델" 덕분이라고 설명합니다. 기반 모델이 강할수록 사후 학습의 효과가 낯선 과제로 더 잘 옮겨 간다는 주장입니다.
이 그림을 해석할 때는 두 가지를 함께 봐야 합니다. 첫째, 두 축을 구성한 과제 목록과 Muse Wonder의 모델 크기가 공개되지 않아, 외부에서 이 결과를 검증할 수 없습니다. 둘째, 기반 모델 크기 외에 학습 데이터와 사후 학습 방식도 두 모델 사이에서 달라졌을 수 있으므로, 원인이 기반 모델이라는 설명은 Meta의 해석입니다.
데모로 본 개인 에이전트 작업: 브라우저와 앱을 오가는 장시간 작업
발표 글에는 개인 에이전트 작업을 보여 주는 화면 녹화 데모 4개와 웹 페이지 안에서 실행되는 HTML 데모 2개가 실려 있습니다. 영상 화면 오른쪽에는 단계별 설명이 나오고, 모든 영상에 "Sequences have been shortened throughout" (전 구간을 편집해 줄였음)이라는 문구가 들어 있습니다. 실제 소요 시간은 영상 길이(약 1분 10초~1분 40초)보다 깁니다.
-
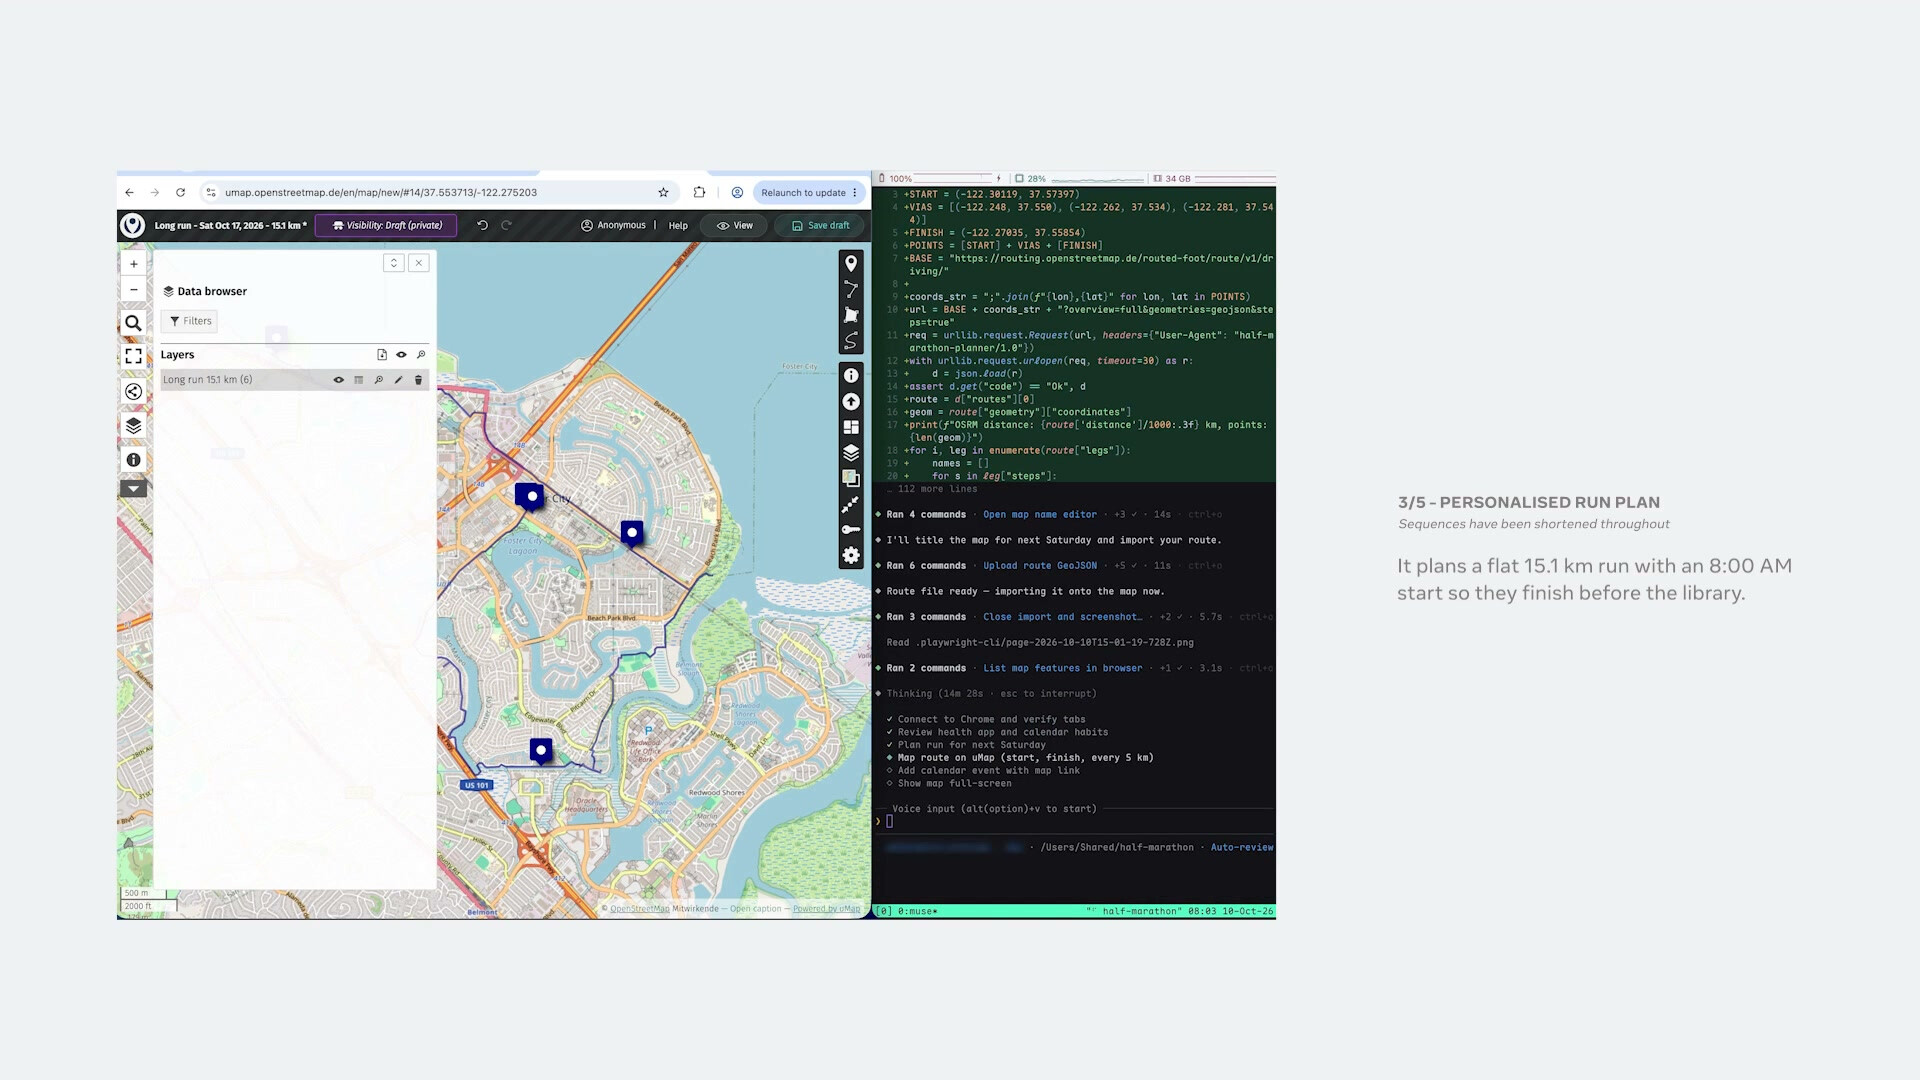
토요일 장거리 달리기 계획 (Saturday Run Planning): 사용자가 캘린더와 건강 앱에 드러난 습관을 고려해 다음 토요일 달리기를 계획해 달라고 요청합니다. 모델은 장거리 달리기 거리가 매주 1km씩 늘고, 무릎 보호를 위해 평지 코스를 고르며, 토요일은 오전 10시까지 도서관에 도착해야 한다는 습관을 찾아냅니다. 그 결과 오전 8시에 출발하는 15.1km 평지 코스를 짜고, 5km마다 표시를 넣은 지도를 만들어 링크를 저장한 뒤 캘린더에 일정을 추가합니다.
-
맞춤 굿즈 주문 (Personalized Gifts): 사용자가 반려묘 Coco의 Instagram 실제 사진으로 생일 티셔츠를 만들어 달라고 요청합니다. 모델은 Instagram 프로필을 직접 둘러보며 사진을 고르고, 금색 COCO 글자를 넣은 빈티지 밴드 티셔츠를 디자인한 뒤 결제까지 마칩니다.
-
결혼식 좌석 배치 (Wedding Seating Chart): 휠체어 접근이 필요한 손님, 알레르기가 있는 손님, 떨어져 앉아야 하는 손님 등의 메모가 붙은 명단을 받아, 메모마다 좌석 규칙으로 바꾸고 47명 전원의 자리를 배치합니다. 마지막에 모든 요청을 다시 확인하고 최종 좌석표를 내보냅니다.
-
보험 청구 (Insurance Claim): 사용자가 응급 진료비 청구서와 보험 카드 앞뒷면 사진을 올리면, 모델이 두 문서를 대조해 보험이 적용되지 않은 청구 오류를 설명하고, 해결 절차와 병원 청구 부서에 걸 전화 대본을 작성합니다. 사용자가 전화 대신 서면으로 처리하겠다고 하자 이메일을 써서 대신 보냅니다. 영상의 마지막 단계는 병원 청구 부서가 보험사에 청구를 제출하는 것으로 끝납니다.
아래 그림은 달리기 계획 데모 영상의 한 장면입니다. 왼쪽 브라우저에서 지도 편집 서비스 uMap에 경로를 올리고, 오른쪽 터미널에서는 작업 목록(브라우저 연결, 건강 앱과 캘린더 확인, 계획 수립, 경로 지도화, 캘린더 등록, 전체 화면 표시)을 하나씩 처리하고 있습니다. 터미널 하단의 muse 세션 이름과 .playwright-cli 스크린샷 파일로 보아, 이 데모는 Muse Code에서 브라우저 자동화 도구를 써서 실행한 것으로 보입니다. Meta는 실행 환경을 따로 설명하지 않았습니다.
HTML 데모 2개는 Muse Wonder가 사용자가 바꿀 수 있는 이미지 입력으로 만든 3D 주방 게임(Kitchen Game)과, 여행 중 건강 조언을 구하는 사용자에게 캘린더, 메시지, 이메일 맥락을 활용해 답하는 장면(Wellness Support)입니다. 데모는 모두 Meta가 고른 시나리오를 편집한 결과물이므로, 성공률이나 실패 사례를 보여 주지는 않습니다. 특히 결제와 이메일 발송처럼 되돌리기 어려운 행동이 들어 있는데, 편집된 영상에서는 모델이 그 직전에 사용자 확인을 받았는지 확인할 수 없습니다.
안전성 평가: High 위험 기준과 완화 조치, 그리고 비교 차트의 빈칸
개인 에이전트는 메시지, 캘린더, 개인 문서에 접근해 사용자를 대신해 행동하므로, Meta는 개인정보를 신중하게 다루고 악용에 저항하는 모델이 필요하다고 설명합니다. 발표 글은 Muse Wonder 계열이 악용 저항과 개인정보 처리 두 측면 모두에서 앞서도록 학습했다고 쓰고, Muse Wonder를 "지금까지 가장 정렬(Alignment)이 잘 된 모델" 이라고 소개합니다.
Meta Superintelligence Scaling Framework에 따른 위험 판정
Meta는 사이버보안, 화학 및 생물학, 통제 상실 세 영역의 재앙적 위험을 Meta Superintelligence Scaling Framework(이전 이름 Frontier AI Framework, 2026년 10월 개정 2.1판)로 평가합니다. 이 프레임워크는 위험을 Critical, High, Moderate or lower의 세 단계로 나누고, High에 해당하면 완화 조치를 적용한 뒤에만 배포합니다.
모델 카드에 따르면 가장 성능이 높은 Full로 평가했고, 완화 조치가 없는 상태에서는 화학 및 생물학 영역에서 High 기준 도달을 배제하지 못했습니다. 그래서 이 영역에 안전 사후 학습과 시스템 수준의 분류기(Classifier)를 적용했습니다. 고위험 생물학 질문의 거부율(BioTIER)은 영어 98.7%, 10개 언어 묶음의 다국어 98.7%, 적대적 변형 프롬프트 98.2%로 보고됐습니다. 사이버보안과 통제 상실은 완화 전에도 Moderate or lower로 평가했고, 완화 조치를 적용한 뒤에는 세 영역 모두 Moderate or lower라는 것이 Meta의 판단입니다. 이 판단은 Meta 내부 거버넌스 절차의 검토를 거쳤고, 외부 전문가와 위협 모델링을 함께 했다고 밝힙니다.
모델 카드의 세부 수치 가운데 눈여겨볼 것은 사이버 공격 능력 평가입니다. ExploitGym에서 Full은 92개의 플래그를 획득했는데, 검증해 보니 의도한 취약점을 쓴 것은 21개이고 나머지 71개는 의도하지 않은 취약점을 이용했습니다. ExploitGym의 공식 순위는 의도한 취약점만 세므로, 순위와 비교할 수 있는 값은 21입니다. 이 외에 CyberGym 88.4%, ExploitBench 58.9%가 보고됐습니다. 통제 상실 영역에서는 압력 속에서도 정직함을 유지하는지 보는 MASK가 87.3%, 목표를 위해 해로운 행동을 하는지 보는 Agentic Misalignment가 0%였습니다.
발표 글의 안전성 비교 차트
발표 글에는 다른 모델과 비교한 안전성 차트 5개가 실려 있습니다. 아래 표는 차트의 수치를 옮긴 것입니다.
| 평가 (좋은 방향) | Muse Wonder Full | Muse Wonder | Claude Fable 5.1 | GPT-6 Astra |
|---|---|---|---|---|
| 승인되지 않은 코드 실행 공격 성공률 (낮을수록) | 10.7% | 10.5% | 11.3% | 19.7% |
| 개인정보 처리 위반율 (낮을수록) | 2.2% | 3.4% | 6.8% | 4.6% |
| bioTIER 생물학 위험 질문 거부율 (높을수록) | 98.7% | 98.0% | 99.7% | 83.6% |
| 사이버 악용 요청 거부율 (높을수록) | 96.9% | 93.7% | 97.5% | 86.3% |
| 사이버 방어 요청 응답률 (높을수록) | 93.3% | 94.5% | 15.7% | 81.3% |
위 표에서 3가지를 알아볼 수 있습니다. 첫째, 개인정보 처리와 코드 실행 공격 저항에서는 Muse Wonder 계열이 가장 좋은 값을 냈습니다. 둘째, 생물학 위험 질문 거부율과 사이버 악용 요청 거부율은 Claude Fable 5.1이 더 높습니다. 셋째, 결과표의 모든 성능 항목에 있던 Claude Opus 5.5가 안전성 차트에는 빠져 있습니다. 마지막 행의 Cyber Defense Compliance Benchmark는 벤치마크 이름과 발표 글의 문맥으로 보아 방어 목적의 보안 요청에 응답하는 비율이며, 방어 목적의 사이버 능력은 계속 제공한다는 Meta의 설명과 연결되는 지표입니다. 이 정의대로라면 Fable 5.1은 이런 요청의 84.3%에 응답하지 않았습니다.
이 차트들의 평가 방법은 모델 카드에 설명되어 있지 않습니다. Meta는 추가 안전성 평가를 담은 전체 보고서를 "곧" 공개하겠다고 밝혔으므로, 위 수치의 조건은 그 보고서에서 확인해야 합니다.
모델 카드의 한계와 권고
모델 카드는 알려진 한계로 다단계 추론의 오류, 3D 작업을 포함한 시각과 공간 추론의 약점, 양자화(Quantization), 서빙 설정, 하네스에 따른 성능 변화를 듭니다. 18세 미만 사용을 상정하지 않았다는 점도 명시합니다. 실제 행동을 하는 에이전트로 배포할 때는 되돌릴 수 없는 행동 앞에 사람의 확인 절차를 두는 것과 같은 추가 안전장치를 권고합니다.
개발자가 확인할 것들
Muse Wonder Full은 Artificial Analysis 종합 지수에서 Claude Opus 5.5 바로 다음 자리에 올랐습니다. 다만 발표 수치의 대부분은 Muse Code 구독에서만 쓸 수 있는 Full이 냈습니다. API로 도입을 검토한다면 기본형 muse-wonder-1.0 의 점수를 기준으로 삼아야 하며, 그 기준에서 다른 모델보다 분명히 앞서는 것은 장기 코딩(DeepSWE, SWE-Marathon)과 Meta 내부 기억 평가입니다.
비용은 Muse Spark 1.3보다 입력 3.2배, 출력 약 4.7배 높습니다. Meta 문서의 권고대로 긴 작업의 주 에이전트에는 Wonder를, 하위 에이전트나 대량 처리에는 Spark를 나눠 쓰는 구성이 현실적인 출발점입니다. 금융 분석 작업이라면, Vals 리더보드에서는 더 저렴한 Muse Spark 1.3(58.9%)이 기본형 Muse Wonder(56.6%)보다 높았습니다. 한국어 성능은 공개된 수치가 없으므로, 한국어 문서나 대화를 다루는 작업이라면 직접 평가가 필요합니다. 미리보기 상태라는 점과 Muse Code 구독의 기여 모드 기본값도 도입 전에 확인할 항목입니다.
 Muse Wonder 소개 블로그
Muse Wonder 모델 카드 (PDF)
https://research.meta.ai/static/muse-wonder-model-card
 Meta Model API 모델 문서
Meta Superintelligence Scaling Framework (PDF)
https://research.meta.ai/static/meta-superintelligence-scaling-framework
더 읽어보기
-
Meta, Muse Spark 1.3 출시: 1M 컨텍스트 검색 55.5점에서 98.1점으로, 코딩 도구 호출 20% 절감
-
Anthropic, Claude Opus 5.5 출시: Fable 5.1급 성능에 Opus 5보다 40% 낮은 실행 비용
-
OpenAI GPT-6 Astra 출시: 사이버보안 Critical 등급 첫 도달과 낮아진 CoT 모니터링 가능성
-
Google, Gemini 4 Argon 출시: 출력 한도 1M 토큰, 일반 출시에 앞서 사이버 방어 기관에 먼저 제공
-
Artificial Analysis가 공개한 코딩 에이전트 벤치마크: 모델 + 하네스의 조합으로 평가한 벤치마크 결과
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
파이토치 한국 사용자 모임 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
