핵심 요약
- NVIDIA와 프린스턴 대학교 Dao AI Lab이 ReplaySSM 소개 블로그와 논문으로, SSM 레이어의 상태를 매 스텝 저장하지 않고 체크포인트와 최근 입력 버퍼로 표현하는 디코딩 방법을 공개했습니다.
- 배치 256에서 SSM 커널은 1.46~1.80배, 디코드 스텝 전체는 1.20~1.47배 빨라졌고, 120B급 두 모델의 투기적 디코딩 처리량은 배치 512에서 vLLM 투기적 디코딩 대비 1.85배와 2.10배였습니다. 배치 1에서는 오히려 커널이 느렸습니다.
- 같은 구조로 읽기용 저정밀도 상태와 재귀용 고정밀도 상태를 나누면, NVFP4 상태의 GPQA-Diamond 정확도 손실이 4개 모델 평균 13.05점에서 1.77~2.36점으로 줄었습니다. 이 정확도 실험은 에뮬레이션한 양자화로 측정했습니다.
- 공개 vLLM 릴리스(v0.31.0)의 ReplaySSM 경로는 Mamba-2 표준 디코딩(실험 기능
--use-replayssm)뿐이고, 같은 플래그가 Kimi-K3에서는 별도 구현인 RecoverSSM을 켭니다. vLLM용 GDN 경로와 저정밀도 커널은 ReplaySSM GitHub 저장소의 vLLM 포크에만 있습니다.
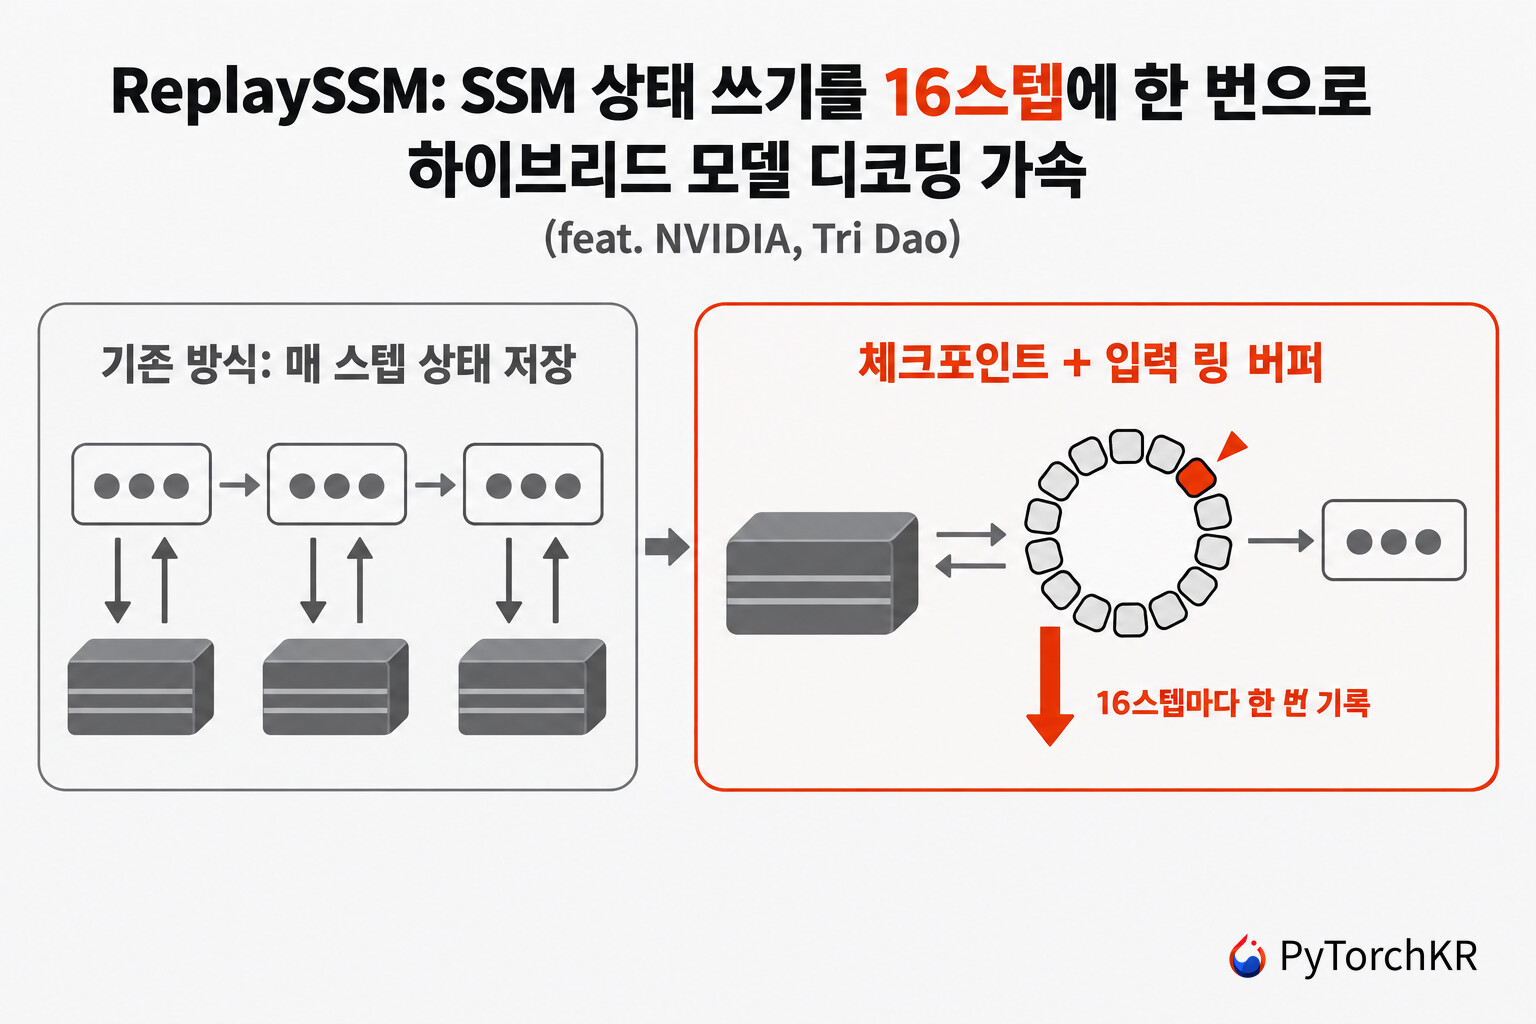
ReplaySSM 소개
ReplaySSM은 하이브리드 언어 모델의 상태 공간 모델(State-Space Model, SSM) 레이어를 위한 디코딩 방법입니다. 핵심은 상태를 매 토큰마다 GPU 메모리에 다시 쓰는 대신 마지막 체크포인트와 그 뒤의 최근 입력 몇 개로 표현하는 것입니다. 저자들은 서빙 배치가 클 때 SSM 레이어가 디코딩 지연의 가장 큰 부분을 차지한다는 관찰에서 출발했습니다. 이 표현 하나로 메모리 트래픽, 투기적 디코딩의 되돌리기, 상태 양자화(Quantization) 오차라는 세 문제를 함께 다룹니다.
배경부터 보겠습니다. Transformer의 어텐션은 지나간 토큰의 키와 값을 KV 캐시(KV cache) 에 모두 보관하므로, 컨텍스트가 길어질수록 저장 공간과 매 스텝 읽는 양이 늘어납니다. SSM은 지나간 정보를 고정 크기의 행렬 하나, 즉 상태(state) 로 요약해 이 증가를 없앤 구조입니다. 대신 정확한 회상(recall)에 약하기 때문에, 최근 모델들은 SSM 레이어 여러 개 사이에 어텐션 레이어를 조금 섞는 하이브리드 모델(hybrid model) 을 씁니다. 원문은 NVIDIA Nemotron 3, Qwen3.5부터 Qwen3.8까지, Kimi-K3, GLM-5.3-Flash를 예로 들고, SSM 레이어로는 Mamba-2, Gated DeltaNet(GDN), Kimi Delta Attention(KDA)을 꼽습니다.
연구는 NVIDIA와 Tri Dao 교수가 이끄는 프린스턴 대학교 Dao AI Lab의 공동 작업입니다. 저자는 Ze-Wei Liou, Harris Nover, Amey Naik, Andrii Skliar, Igor Shovkun, Ido Shahaf, Tri Dao 7명입니다. 논문은 2026년 10월 9일 arXiv에, NVIDIA 블로그 글은 10월 12일에 올라왔습니다. Dao AI Lab은 이보다 앞선 6월에 같은 제목의 블로그 글을 냈는데, 이 글과 10월 논문은 실험 설정과 수치가 다릅니다. 이 차이는 글 뒷부분의 별도 절에서 정리합니다.
이 글은 NVIDIA 블로그를 중심으로, 블로그가 생략한 논문 부록의 측정 조건과 실제 프레임워크 코드의 지원 범위를 함께 정리합니다. 하이브리드 모델을 큰 배치로 서빙하거나, 투기적 디코딩과 상태 양자화를 검토하는 분들이 판단에 쓸 수 있도록 각 수치의 조건을 빠뜨리지 않으려 했습니다. 직접 실행해 재현한 수치는 없습니다.
하이브리드 모델에서 SSM 레이어가 디코딩 병목이 되는 이유
매 스텝 상태를 읽고 다시 쓰는 재귀
원문은 Nemotron 3 Ultra의 Mamba-2 레이어를 예로 듭니다. 이 레이어는 토큰 하나를 다음 재귀식으로 디코딩합니다.
여기서 S_t 는 상태, \alpha_t 는 입력에 따라 달라지는 감쇠(decay) 값, v_t, k_t, q_t 는 그 토큰의 입력 벡터입니다. 각 스텝은 S_{t-1} 을 HBM(High-Bandwidth Memory) 에서 읽고, 감쇠와 랭크 1 갱신을 적용한 뒤, q_t 로 출력을 계산하고, S_t 를 다시 HBM에 씁니다. GDN과 KDA는 델타 규칙(delta rule)이라는 보정 항이 더 붙지만, 갱신을 같은 외적(outer product) 형태로 다시 쓸 수 있어 아래 내용이 그대로 적용됩니다.
저자들은 이 과정에서 상태가 두 가지 일을 한다는 점에 주목합니다. 하나는 이번 토큰의 출력을 만들기 위해 읽히는 일이고, 다른 하나는 다음 토큰의 상태가 되기 위해 갱신되는 일입니다. 기존 디코딩은 이 둘을 한 번에 처리하며, 아래의 세 가지 문제가 모두 여기서 나옵니다.

문제 1: 연산은 적고 메모리 이동만 큰 상태 갱신
SSM 디코딩 스텝은 상태 전체를 읽고 쓰지만, 그 위에서 하는 연산은 감쇠와 랭크 1 갱신 정도입니다. 논문 부록의 계산에 따르면 연산량을 이동 바이트 수로 나눈 산술 강도(arithmetic intensity) 가 FP32 상태에서 약 0.63 FLOP/byte입니다. H100의 FP32 CUDA 코어를 채우려면 약 20, BF16 텐서 코어를 채우려면 약 300이 필요하므로, 이 커널은 계산이 아니라 HBM 대역폭에 묶여 있습니다.
Nemotron-3-Super-120B-A12B-NVFP4를 B300 GPU 한 장에서 배치 256으로 돌린 측정(위 그림 왼쪽)에서는 컨텍스트 100K 토큰까지 SSM 레이어가 디코드 스텝의 가장 큰 구성 요소였습니다. 원문은 이유를 두 가지로 설명합니다.
- 레이어 수: 이 모델은 SSM 레이어가 어텐션 레이어의 5배입니다(40개 대 8개).
- 상태 크기: SSM 레이어 하나의 FP32 상태는 시퀀스당 4MiB이고, FP8 KV 캐시 항목은 토큰당 0.5KiB입니다. 즉 SSM 상태 하나가 어텐션 레이어 하나의 8K 토큰 분량 KV 캐시와 같은 크기입니다.
논문 부록은 여기에 한 가지를 더 지적합니다. 디코딩 스텝은 SSM 상태를 읽고 쓰지만 KV 캐시는 읽기만 하므로, 바이트 수로 계산한 교차점은 약 80K 토큰(81,920)입니다. 실측 교차점이 100K 근처로 더 뒤에 있는 것은 어텐션 커널이 그동안 더 많이 최적화된 결과와 맞아떨어진다고 저자들은 해석합니다.
문제 2: 되돌릴 수 없는 상태와 투기적 디코딩
투기적 디코딩(Speculative decoding) 은 작은 드래프터가 토큰 T 개를 먼저 제안하고, 대상 모델이 한 번의 순전파로 이를 검증한 뒤, 마지막으로 수용된 토큰까지만 남기는 가속 기법입니다. 어텐션은 KV 캐시의 위치 포인터를 뒤로 옮기기만 하면 거절된 토큰을 버릴 수 있습니다. 반면 SSM은 드래프트 토큰을 이미 상태에 요약해 넣은 뒤에는 그 갱신을 쉽게 되돌릴 방법이 없습니다.
그래서 vLLM 같은 서빙 엔진은 드래프트 토큰마다 상태 스냅샷을 따로 저장하고, 수용된 접두어에 맞는 스냅샷을 고릅니다. 메모리에 묶인 경로에서 스텝마다 읽기 1번과 쓰기 T 번을 하는 셈이고, 스냅샷이 GPU 메모리를 차지해 동시에 처리할 수 있는 요청 수도 줄어듭니다. 원문은 그 결과 Transformer에서는 믿을 만한 가속 기법인 투기적 디코딩이 서빙 배치의 SSM에서는 거의 도움이 되지 않는다고 설명합니다.
문제 3: 재귀로 다시 들어가는 양자화 오차
상태를 낮은 정밀도로 저장하면 메모리 이동량이 줄어듭니다. 그런데 양자화한 상태는 출력을 만드는 데 쓰이는 동시에 다음 갱신의 입력이 되므로, 반올림 오차가 매 스텝 재귀 안으로 다시 들어갑니다. KV 캐시에는 이런 순환이 없습니다. 양자화한 항목을 여러 번 읽지만 자기 자신에게 다시 쓰지 않기 때문입니다.
원문은 이 차이 때문에 KV 캐시가 SSM 상태보다 낮은 정밀도를 견딘다고 설명합니다. 예로는 Qwen3.5-122B-A10B-NVFP4가 가중치는 4비트 NVFP4, KV 캐시는 FP8을 쓰면서도 SSM 상태는 FP32로 둔다는 점을 듭니다. NVFP4는 NVIDIA의 4비트 부동소수점 형식입니다.
상태를 체크포인트와 최근 입력 버퍼로 나누어 표현하기
ReplaySSM의 출발점은 재귀식을 h 개 토큰의 구간에 걸쳐 펼치면 같은 상태를 다르게 쓸 수 있다는 점입니다.
S_{\mathrm{ckpt}} 는 구간이 시작되기 전의 상태(체크포인트)이고 \gamma 는 누적 감쇠입니다. 기존 디코딩은 왼쪽 식을 한 스텝씩 따라갑니다. ReplaySSM은 오른쪽 식을 써서, 상태를 체크포인트 하나와 최근 입력 기록 (\alpha_j, v_j, k_j) 을 담은 작은 버퍼로 표현합니다. 입력 기록은 벡터 몇 개라서 상태 행렬보다 훨씬 작습니다.
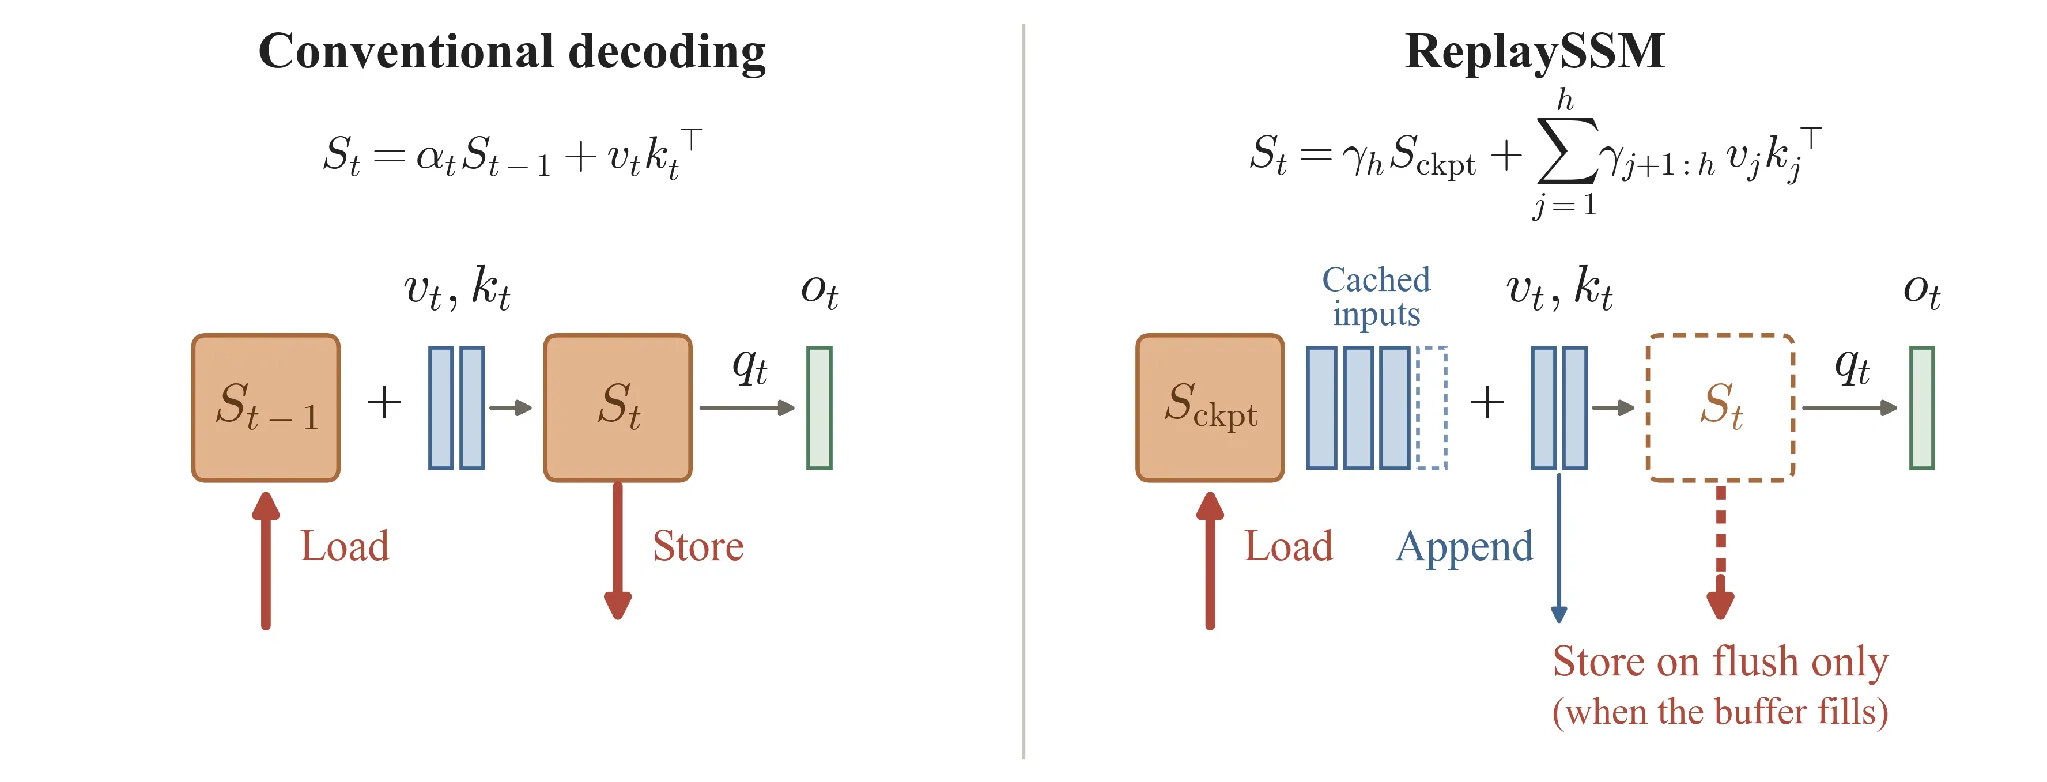
대부분의 스텝(논문의 용어로 non-flush 스텝)에서는 현재 입력을 버퍼에 덧붙이고, 체크포인트와 버퍼로 출력을 계산할 뿐 상태를 저장하지 않습니다. 버퍼에 기록이 L 개 차면 flush 스텝이 버퍼의 입력을 체크포인트에 접어 넣고, 새 체크포인트를 HBM에 한 번 쓴 뒤 버퍼를 비웁니다. 출력은 부동소수점 오차 범위 안에서 기존 디코딩과 같습니다.
원문은 이 방식을 세 질문으로 요약합니다.
- ReplaySSM은 무엇을 하나요? 최근 SSM 입력을 캐시하고, 상태를 체크포인트와 그 입력들로 표현합니다.
- 무엇이 바뀌나요? 출력 계산과 상태 갱신이 분리됩니다. 출력은 매 스텝 계산하고, 체크포인트는 구간마다 한 번 갱신합니다.
- 무엇을 얻나요? 상태 메모리 트래픽이 줄고, 투기적 디코딩의 롤백이 단순해지며, 저정밀도 상태를 읽어도 그 반올림 오차가 재귀 갱신으로 퍼지지 않습니다.
GDN에는 조정이 하나 필요합니다. GDN의 갱신은 이전 상태에 의존하는 보정값 u_t = \beta_t(v_t - \alpha_t S_{t-1} k_t) 를 포함하므로, 원시 입력 v_t 대신 이 u_t 를 버퍼에 저장합니다. 그러면 GDN도 Mamba-2와 같은 외적 형태로 펼칠 수 있습니다.
평가 설정: 두 계열 4개 모델과 튜닝한 vLLM 기준선
저자들은 Mamba-2 레이어를 쓰는 Nemotron 3 계열과 GDN 레이어를 쓰는 Qwen3.5 계열에서 모델을 2개씩 골랐습니다. ReplaySSM을 vLLM에 구현하고, vLLM 자체 커널을 가장 빠른 실행 설정(launch configuration)으로 맞춘 것을 기준선으로 삼았습니다. 성능 실험은 이 모델들의 기본값인 FP32 SSM 상태와 버퍼 크기 L = 16 을 쓰며, 투기적 디코딩은 각 모델의 MTP(Multi-Token Prediction) 헤드를 드래프터로 씁니다.
| 모델 | SSM 레이어 | 가중치 | GPU | SSM / 어텐션 레이어 |
|---|---|---|---|---|
| Nemotron-3-Nano-4B | Mamba-2 | BF16 | H100 1장 | 21 / 4 |
| Nemotron-3-Super-120B-A12B | Mamba-2 | NVFP4 | B300 1장 | 40 / 8 |
| Qwen3.5-4B | GDN | BF16 | H100 1장 | 24 / 8 |
| Qwen3.5-122B-A10B | GDN | NVFP4 | B300 1장 | 36 / 12 |
논문 부록에는 블로그에 없는 조건이 몇 가지 더 있습니다. B300은 1100W 전력 상한(power cap)에서 돌렸고, 모든 실험은 텐서 병렬 없이 GPU 한 장에서 했습니다. 기준선을 튜닝한 것은 비교를 보수적으로 만듭니다. 저자들에 따르면 vLLM이 기본으로 고르는 Mamba-2 설정과 비교했다면 배치 256의 Nemotron-3-Super 수치는 1.42배와 1.53배가 아니라 1.48배와 1.75배가 됩니다.
이점 1: 상태 쓰기를 구간당 한 번으로 줄여 메모리 트래픽 절감
L 개 토큰 구간에서 기존 디코딩은 상태를 L 번 읽고 L 번 씁니다. ReplaySSM도 출력 계산에 체크포인트가 필요하므로 L 번 읽지만, 쓰기는 flush 때 한 번뿐입니다. non-flush 스텝이 쓰는 것은 새 입력 기록, 즉 행렬이 아닌 벡터 몇 개입니다. 그래서 지배적인 상태 트래픽이 대략 절반으로 줄어듭니다. 논문 부록의 식으로 버퍼 트래픽까지 넣어 계산하면 Nemotron-3-Super의 Mamba-2 레이어에서 트래픽 비율은 0.58, 즉 약 1.7배 감소입니다.
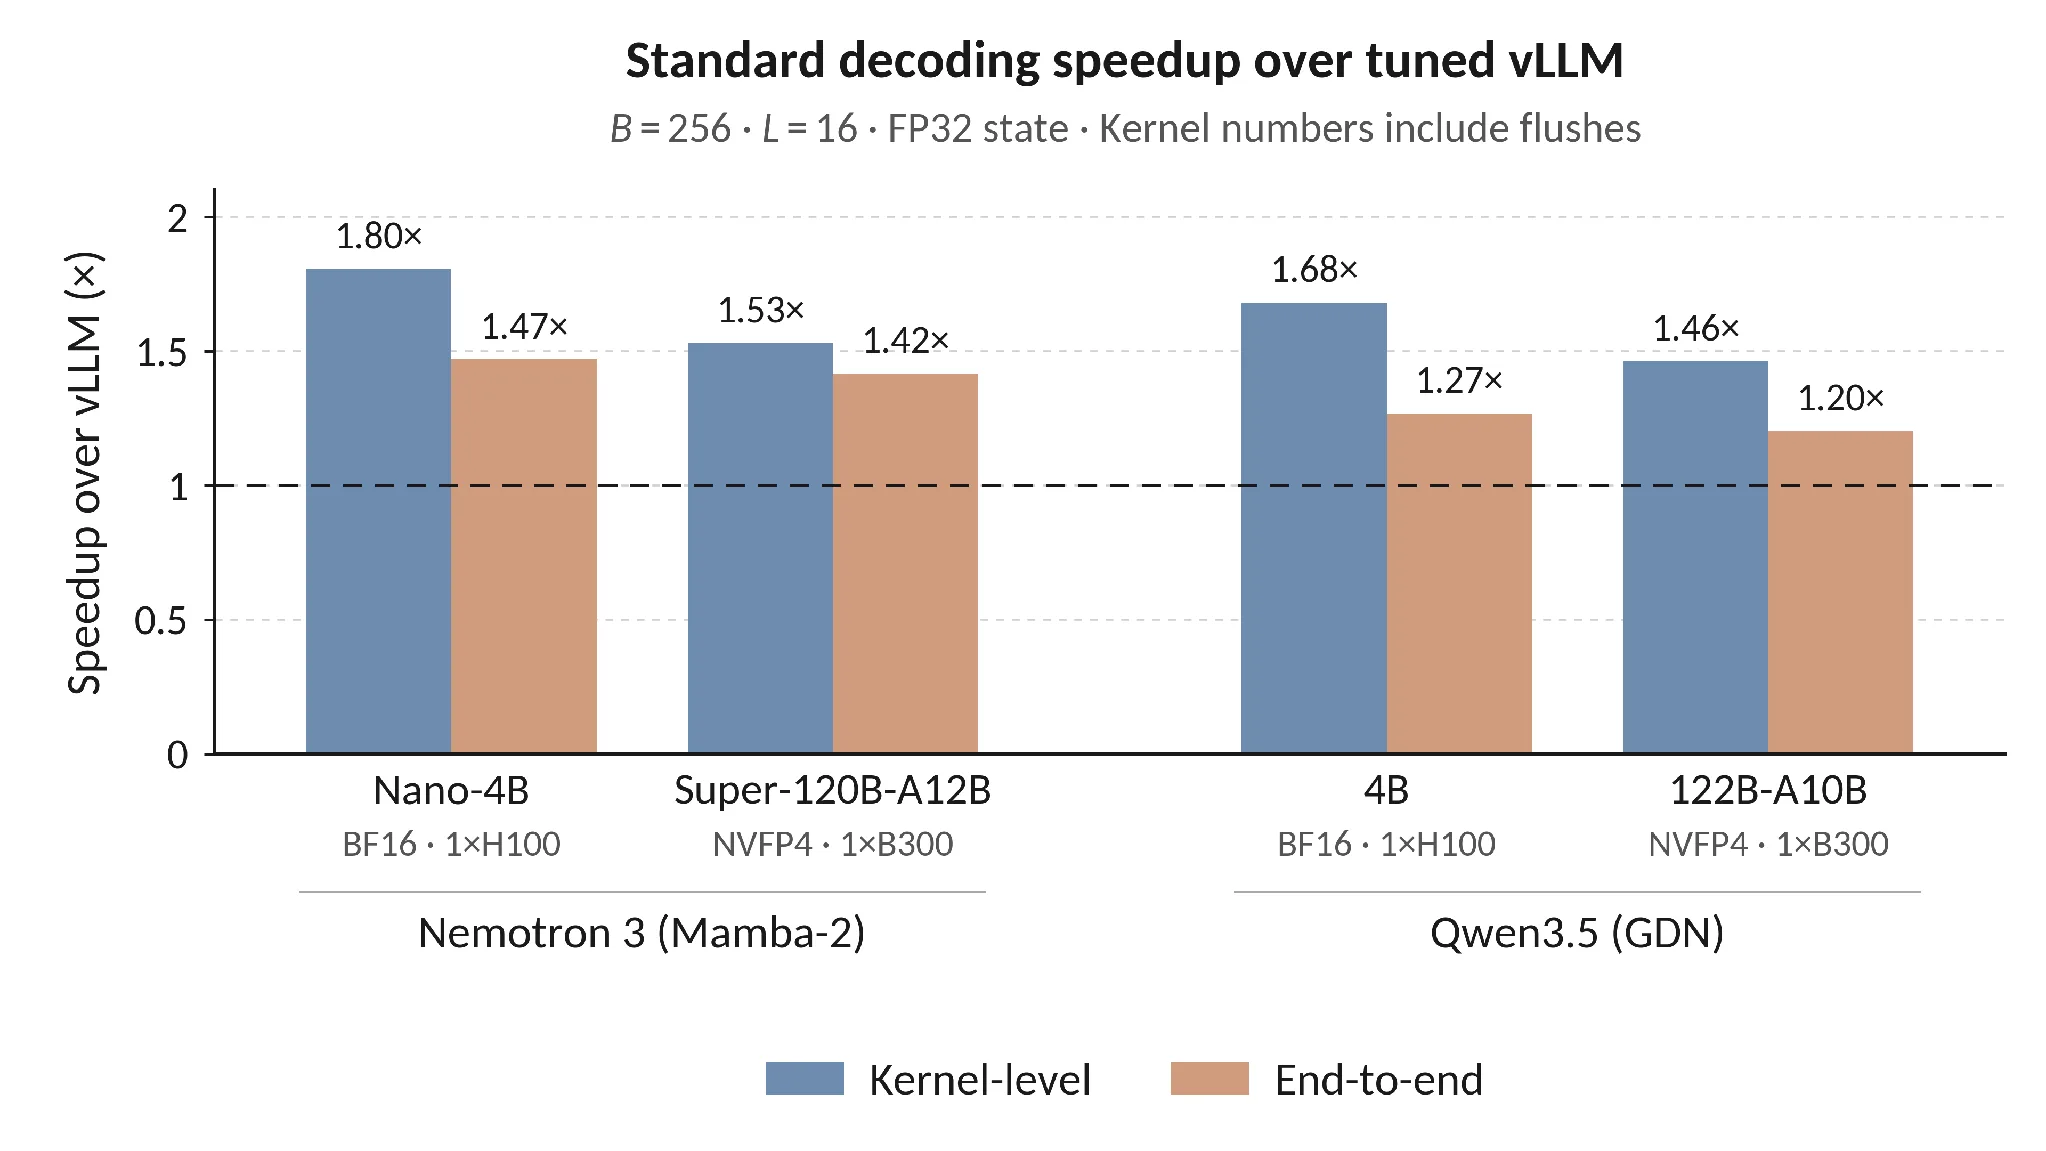
위 그래프처럼 배치 256에서 SSM 커널은 1.46~1.80배, 디코드 스텝 전체는 1.20~1.47배 빨라졌습니다. 커널 수치에는 flush 비용이 포함되어 있습니다. 종단 간 이득이 커널 이득보다 작은 이유는 ReplaySSM이 SSM 커널만 바꾸고 어텐션과 행렬곱(GEMM) 등 나머지는 그대로 두기 때문입니다.
이 이득은 배치 크기에 강하게 의존합니다. 블로그는 "배치 크기 1에서는 다른 지연 요인이 지배해 이번 실험에서 ReplaySSM이 속도 향상을 주지 못했다" 고만 적었지만, 논문 부록의 표를 보면 소형 배치에서는 커널이 오히려 느려집니다.
| 모델 (종단 간 / 커널) | B=1 | B=8 | B=32 | B=128 | B=256 | B=512 |
|---|---|---|---|---|---|---|
| Nemotron-3-Nano-4B | 0.98 / 0.73 | 1.03 / 1.36 | 1.16 / 1.69 | 1.38 / 1.78 | 1.47 / 1.80 | 1.51 / 1.80 |
| Nemotron-3-Super-120B-A12B | 0.96 / 0.41 | 1.01 / 1.02 | 1.06 / 1.20 | 1.24 / 1.46 | 1.42 / 1.53 | 1.72† / 1.56 |
| Qwen3.5-4B | 0.99 / 0.88 | 1.03 / 1.34 | 1.08 / 1.54 | 1.21 / 1.66 | 1.27 / 1.68 | 1.30 / 1.67 |
| Qwen3.5-122B-A10B | 0.96 / 0.51 | 1.03 / 1.16 | 1.09 / 1.37 | 1.16 / 1.44 | 1.20 / 1.46 | 1.22† / 1.49 |
위 표를 통해 두 가지를 알 수 있습니다. 첫째, 배치 1에서는 커널이 기준선의 0.41~0.88배 속도이고 종단 간으로도 1~4% 느립니다. 저자들은 배치 1에서 기존 커널이 최대 DRAM 대역폭의 21.6%(H100), 9.3%(B300)밖에 쓰지 못해 메모리 트래픽을 줄여도 아낄 것이 없다고 설명합니다. 둘째, 배치 128 무렵 기존 커널이 최대 대역폭의 84~86%에 도달하면 커널 이득은 1.4~1.8배에서 멈춥니다. 종단 간 이득은 SSM이 스텝에서 차지하는 비중이 커지면서 계속 늘어납니다. † 표시한 배치 512의 두 B300 수치는 전력 상한이 기존 커널만 조절(throttle)해서 부풀려진 값이라고 저자들이 논문에 직접 밝혀 두었습니다.
버퍼 크기 L 은 flush 횟수와 스텝마다 읽는 버퍼 양 사이의 균형입니다. 저자들의 트래픽 모델은 표준 디코딩의 최적값을 약 13으로 예측했고, L \in \{8, 16, 32\} 를 실측한 결과 네 모델 모두 16이 가장 빨랐습니다.
이점 2: 투기적 디코딩의 롤백을 버퍼 포인터 이동으로
포인터만 옮기는 롤백
투기적 디코딩에서 ReplaySSM은 검증 전에 드래프트 토큰 T 개의 입력을 모두 버퍼에 덧붙이고, 검증이 끝나면 수용된 개수만큼 버퍼 포인터를 앞으로 옮깁니다. KV 캐시처럼 포인터 뒤의 기록은 무시되고 다음에 덧붙일 때 덮어써집니다. 드래프트마다 저장할 상태 스냅샷도, 복원할 상태도 없습니다. flush는 이미 확정된 기록만 체크포인트에 접어 넣으므로 수용 길이를 기다리지 않고 실행할 수 있습니다. 구현은 링 버퍼(용량 L+T)를 써서 확정된 앞부분을 버릴 때 데이터를 복사하지 않고 시작 위치만 옮깁니다.
상태를 만들지 않고 출력만 계산하기
기존 디코딩은 다음 토큰이 상태를 쓰기 때문에 토큰마다 출력과 갱신된 상태 두 가지를 만들어야 합니다. ReplaySSM의 non-flush 스텝은 출력만 만들면 되는데, 이것이 다른 계산 방법을 열어 줍니다. 0에서 시작하는 갱신 한 번을 예로 들면 다음과 같습니다.
왼쪽은 d_v \times d_k 크기의 상태를 만든 뒤 읽고, 오른쪽은 스칼라 k^\top q 를 구해 벡터 v 에 곱할 뿐 상태를 만들지 않습니다. 확정된 기록 h 개와 드래프트 T 개에 같은 아이디어를 적용하면 다음 식이 됩니다.
D 는 드래프트 위치들의 누적 감쇠, W 는 인과 마스크를 씌운 감쇠 행렬입니다. 저자들은 이를 출력 전용 평가(output-only evaluation) 라고 부릅니다. 체크포인트는 T 개 쿼리 전체에 한 번만 쓰이고, 나머지는 캐시된 키와 값, 드래프트 쿼리에 대한 작은 행렬곱 두 번이라 텐서 코어로 가속할 수 있습니다. K^\top Q 는 그룹 안의 모든 값 헤드가 공유합니다. 원문은 이것이 프리필 커널이 이미 쓰는 청크 단위 계산과 같은 형태이며, 버퍼와 드래프트가 하나의 청크가 된다고 설명합니다.
논문 부록의 계산으로는 T = 4, h = 12 일 때 상태를 만드는 방식보다 FLOPs가 4배 넘게 적습니다. GDN은 드래프트끼리 보정값이 서로 의존하므로 T \times T 삼각 행렬 풀이 한 번으로 보정값 전체를 구한 뒤 같은 식을 씁니다.
GSM8K 처리량: 120B급 두 모델
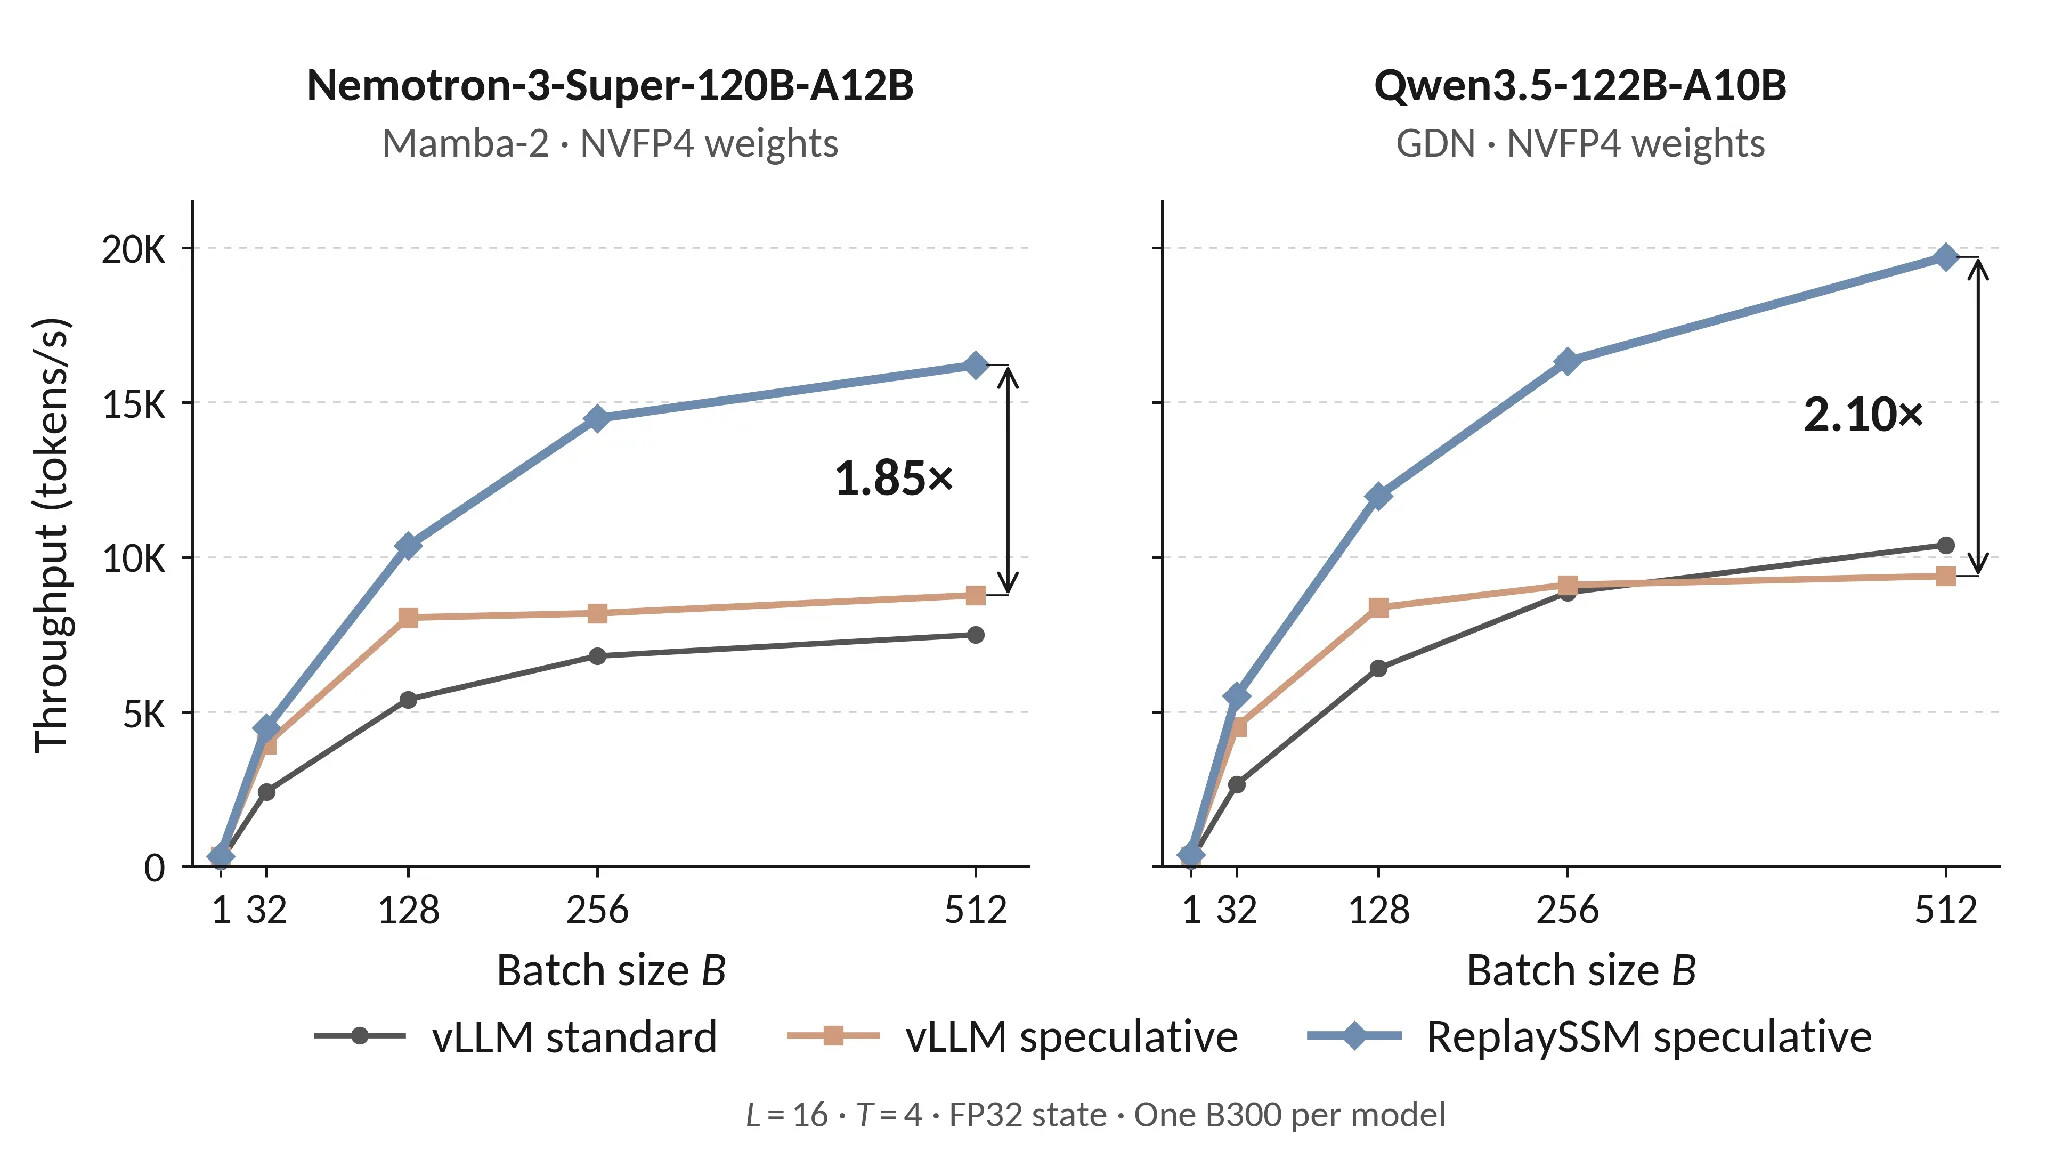
위 그래프는 GSM8K 프롬프트, T = 4, L = 16, FP32 상태, 모델당 B300 한 장 조건에서 요청당 256토큰을 생성한 처리량입니다. 배치 512에서 ReplaySSM은 vLLM 투기적 디코딩 대비 1.85배(Nemotron-3-Super)와 2.10배(Qwen3.5-122B)를 냈습니다. 수용 길이는 두 방식이 같았습니다(배치 256 기준 모든 조건에서 차이 0.05토큰 이내). 표준 디코딩 대비로는 2.16배와 1.90배입니다. 논문 초록의 "약 1.8배" 는 배치 256에서의 값(1.77배, 1.79배)입니다.
그래프에서 vLLM 투기적 디코딩은 배치 128 이후 거의 늘지 않고, Qwen3.5-122B에서는 배치 512에서 표준 디코딩보다도 낮아집니다. 원문은 이득의 출처를 두 가지로 나눕니다.
- 빠른 검증: vLLM 커널은 토큰마다 스냅샷을 저장하므로 지연이 T 에 따라 늘고, T = 8 에서는 표준 디코딩 스텝의 4.66배입니다. ReplaySSM은 대부분의 스텝에서 상태를 쓰지 않아, flush를 포함해도 8개 토큰을 표준 스텝의 0.89~1.21배 시간에 검증합니다(아래 그래프).
- 더 높은 동시성: 드래프트 스냅샷이 GPU 메모리를 차지해 동시에 처리할 수 있는 요청 수를 묶습니다. ReplaySSM은 작은 입력 벡터만 저장하므로 배치를 키워도 처리량이 계속 늘어납니다.
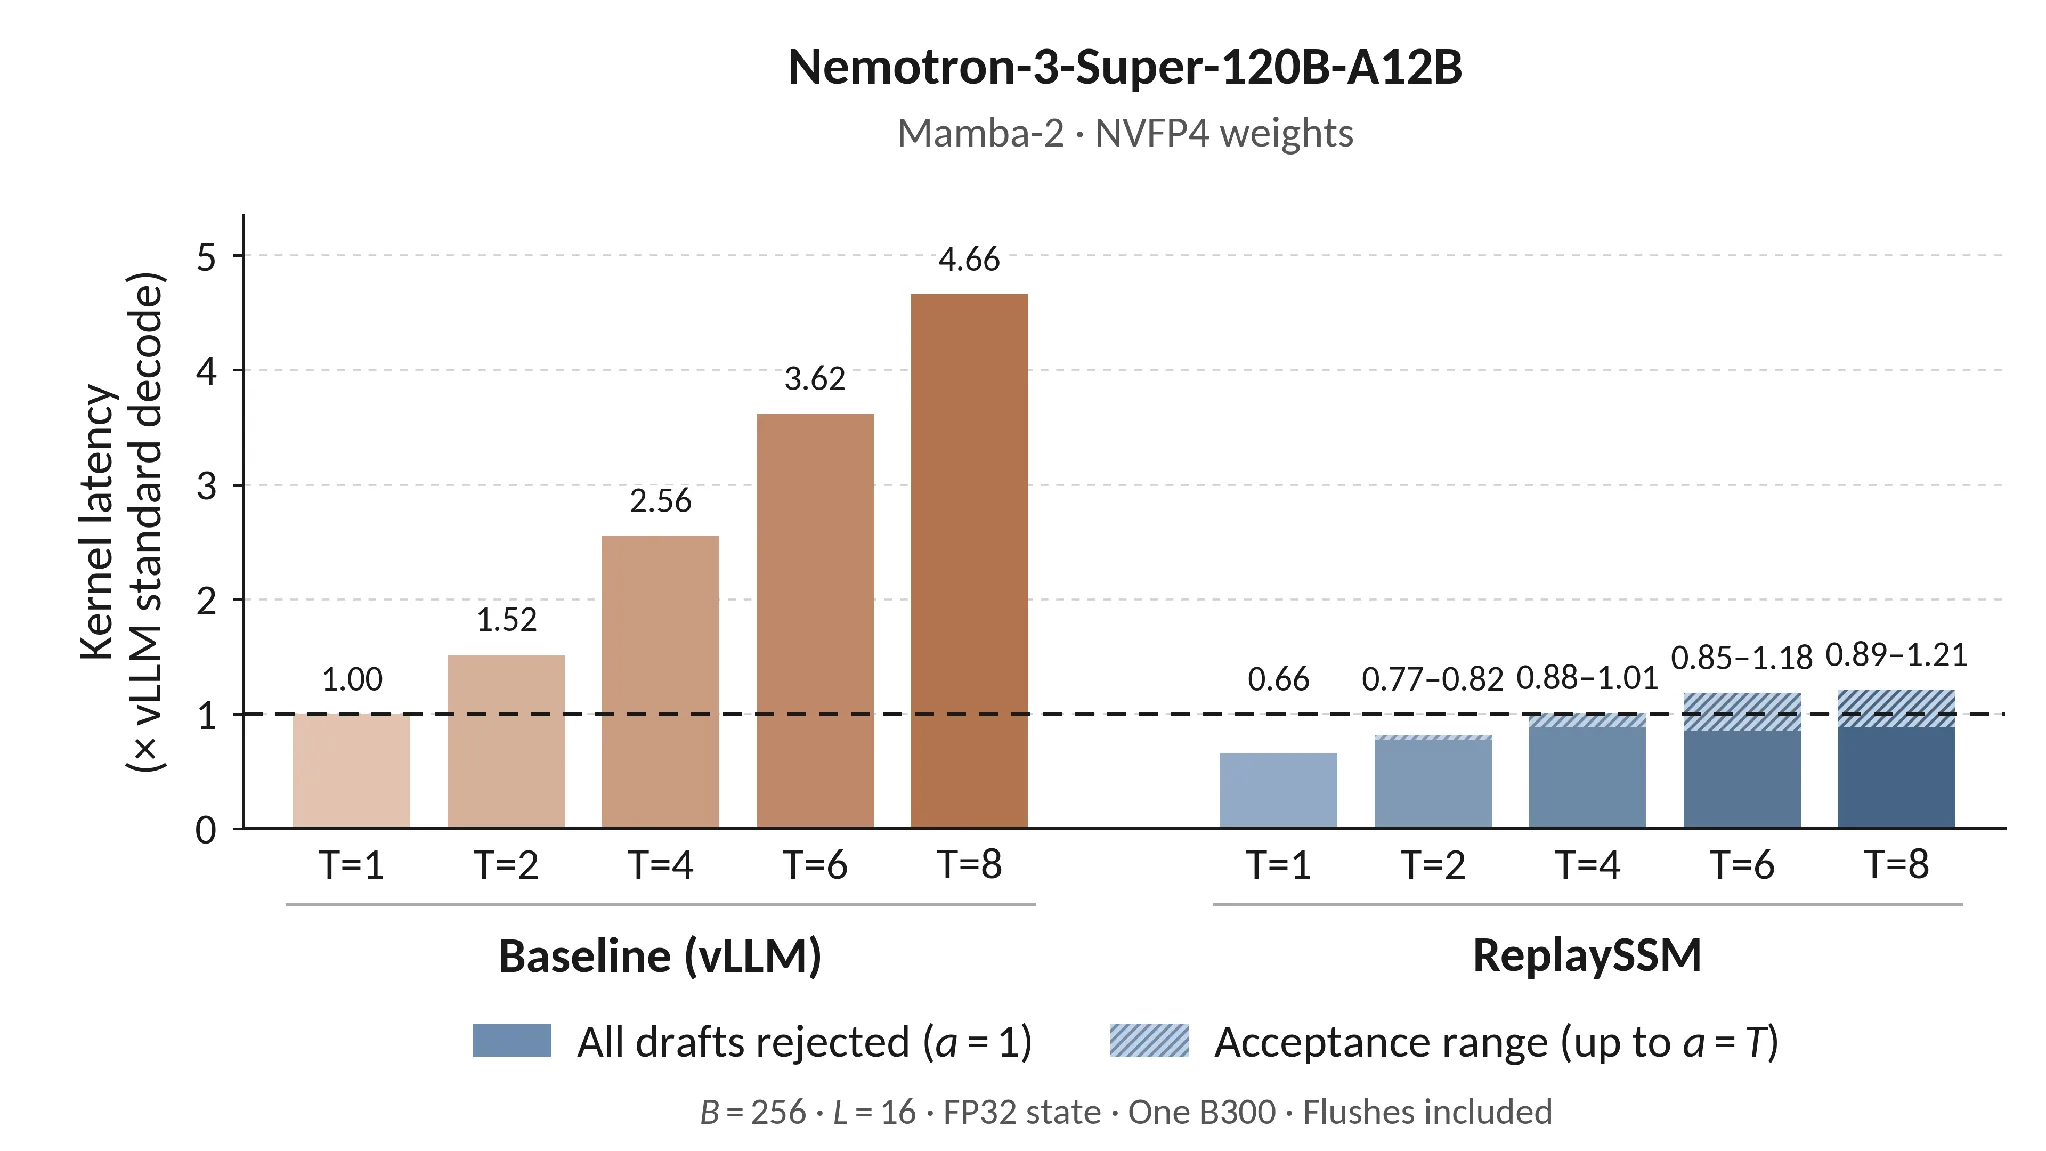
ReplaySSM 막대의 범위는 드래프트가 모두 거절된 경우부터 모두 수용된 경우까지입니다. 수용이 많을수록 버퍼가 빨리 차서 flush가 잦아지기 때문입니다. 논문 부록에 따르면 GDN(Qwen3.5-122B)에서도 같은 경향으로, 기존 커널은 T = 8 에서 6.40배, ReplaySSM은 1.11~1.33배였습니다.
블로그에 없는 조건도 있습니다. 배치 1에서는 두 방식이 거의 같습니다(Nemotron-3-Super 0.88~1.17배, Qwen3.5-122B 0.87~1.12배). 이득은 배치와 T 가 함께 커질 때 나옵니다.
기존 SSM 투기적 디코딩 연구와의 비교
드래프트마다 스냅샷을 저장하지 않는 시도는 이전에도 있었습니다. 논문 부록은 The Mamba in the Llama, Snakes and Ladders의 두 변형, STree를 같은 레이어 형태(Nemotron-3-Super, 배치 256, B300)에서 다시 측정했습니다. 저자들에 따르면 이 방법들은 상태를 복원하려고 재귀를 다시 실행하는 비용을 치르기 때문에, 서빙 배치에서는 어느 것도 vLLM의 스냅샷 방식보다 몇 퍼센트 이상 빠르지 않았습니다. STree와 The Mamba in the Llama는 vLLM보다 상태 바이트를 (T 4 이상에서) 1.6~2.9배 적게 옮기지만, 직렬 재귀가 상태 타일을 레지스터에 오래 붙잡아 점유율이 낮아지면서 대역폭을 다 쓰지 못했다고 합니다.
저자들은 이전 논문들이 배치 1에서 속도 향상을 보고한 점도 지적합니다. 소형 배치의 이득은 모델 가중치를 한 번 읽어 여러 토큰을 검증하는 데서 오는 투기적 디코딩 자체의 이득이고, 상태를 어떻게 다루는지와는 무관하다는 설명입니다. 다만 이 비교는 저자들이 공개 저장소의 커널을 현재 Triton에 맞게 고치고 실행 설정을 다시 튜닝해 측정한 결과입니다.
이점 3: 읽기용 저정밀도 복사본과 재귀용 고정밀도 체크포인트 분리
두 가지 정밀도로 나누는 방법
낮은 정밀도로 상태를 저장하면 바이트 수가 줄어 메모리에 묶인 커널이 빨라집니다. 원문에 따르면 Mamba-2의 non-flush 커널은 FP32 상태 대신 NVFP4 상태를 읽을 때 3.8배 빠릅니다. 이 값은 배치 256의 non-flush 스텝 기준이고, 배치 512에서 논문은 non-flush 4.11배, flush를 포함한 구간 전체 3.33배를 보고했습니다. ReplaySSM은 양자화를 두 방식으로 바꿉니다.
첫째, 체크포인트를 구간마다 한 번 쓰므로, 저정밀도 체크포인트 하나만 쓰더라도 반올림이 L 스텝에 한 번만 일어납니다. 원문에 따르면 Nemotron 3 Ultra 기술 보고서가 이 주기적 체크포인트 방식을 이미 탐색했습니다(논문은 저자 일부가 이 보고서에 참여했다고 밝힙니다). 이 방식은 반올림 빈도는 줄이지만, 오차가 여전히 이후 갱신으로 들어갑니다.
둘째, non-flush 스텝은 출력 계산용으로만 상태를 읽고, flush 스텝만 이후 갱신에 쓰일 체크포인트를 고칩니다. 그래서 두 역할에 서로 다른 정밀도를 줄 수 있습니다. 재귀용으로는 고정밀도 체크포인트를, non-flush 읽기용으로는 저정밀도 복사본을 둡니다. flush는 고정밀도 체크포인트에서 시작해 버퍼의 입력을 반영한 뒤, 결과를 두 형식으로 각각 변환해 저장합니다. 저정밀도 복사본은 재귀로 다시 읽히지 않으므로 그 반올림 오차는 현재 구간의 출력에만 영향을 줍니다. 수용, 롤백, 버퍼 관리는 그대로입니다.
GDN에는 여기서도 조정이 필요합니다. non-flush 스텝에서 계산한 보정값 u 는 저정밀도 복사본에서 나온 것이라 오차를 품고 있습니다. 그래서 두 정밀도 변형에서는 원시 입력 v 도 함께 캐시하고, flush 때 고정밀도 상태로 보정값을 다시 계산합니다.
KL 발산: 생성 길이에 따라 쌓이는 오차
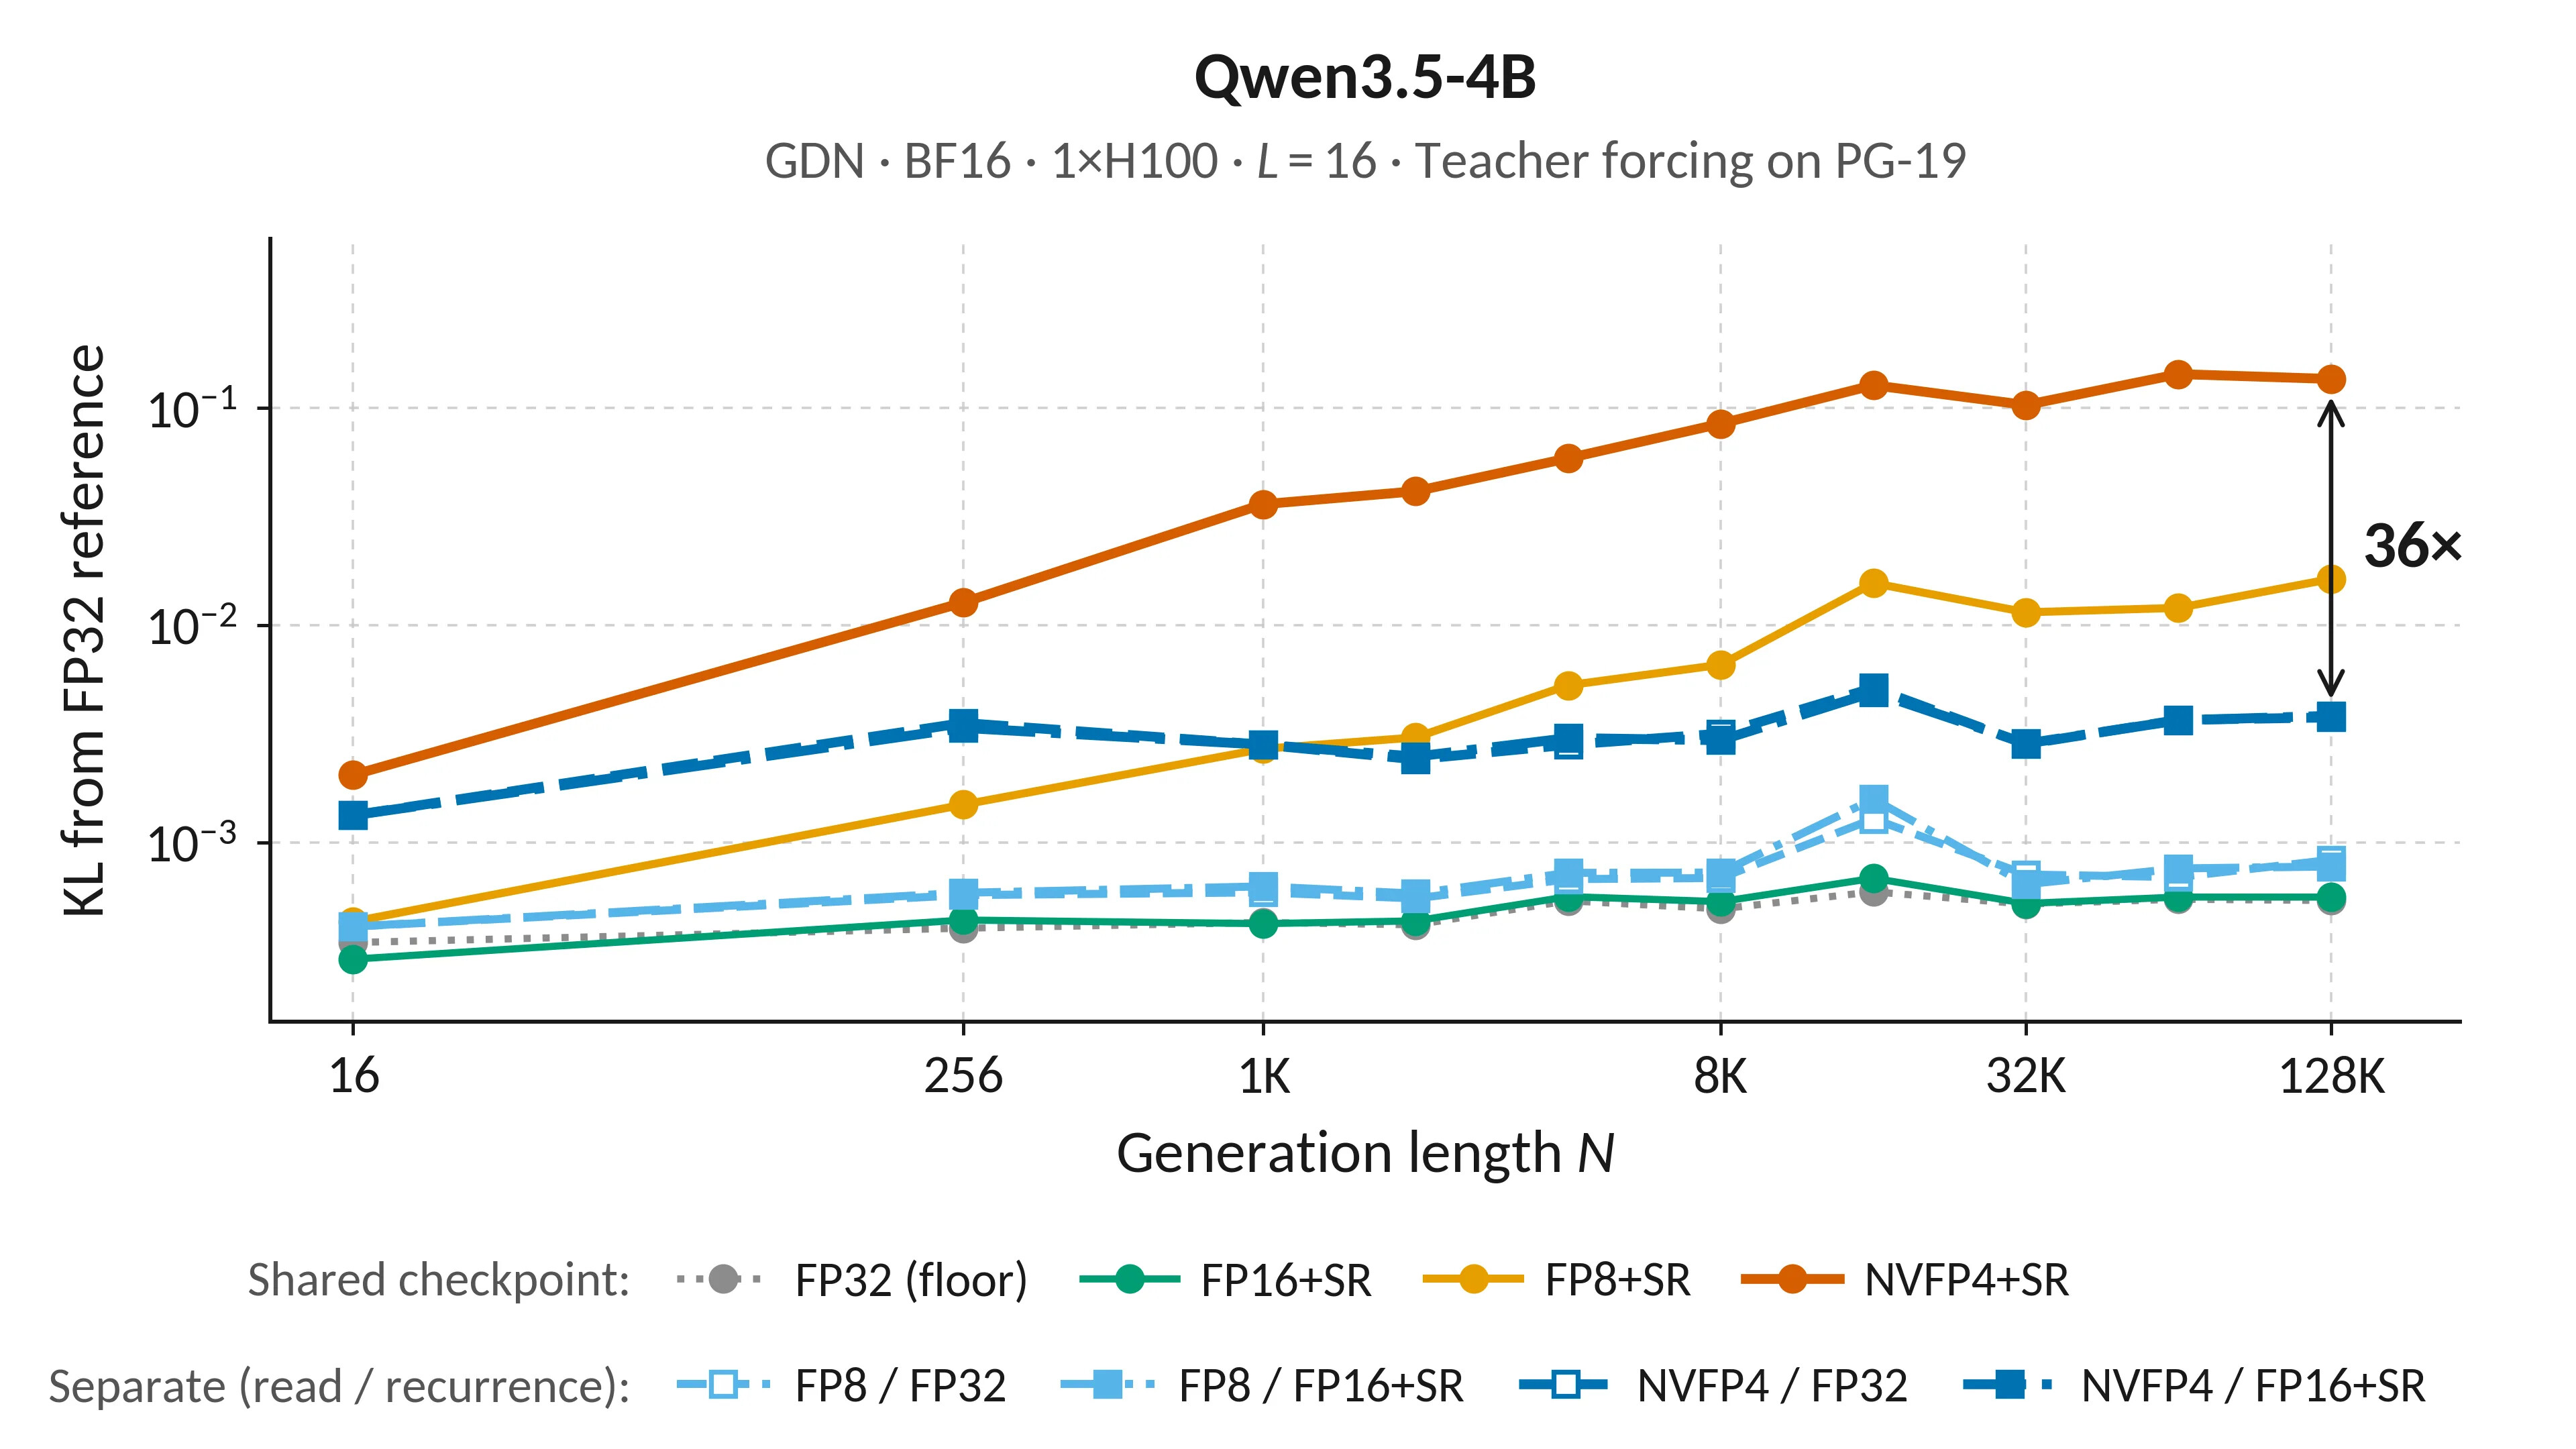
위 그래프는 FP32 상태 디코딩과의 출력 분포 차이를 KL 발산(Kullback-Leibler divergence) 으로 잰 것입니다. 측정은 PG-19 테스트 세트의 책 4권에서 교사 강요(teacher forcing), 즉 정답 토큰을 입력으로 넣어 가며 최대 128K 토큰까지 진행했습니다. 공유 FP8, NVFP4 체크포인트는 길이가 늘수록 오차가 쌓입니다. 재귀를 FP32로 유지하면 증가분 대부분이 사라집니다. Qwen3.5-4B의 128K 토큰 지점에서 NVFP4 읽기의 KL이 0.136에서 0.0038로 약 36배 줄었습니다(나머지 세 모델은 각자 마지막 측정 지점에서 13~29배). 남은 것은 읽기 자체의 오차로, Qwen3.5-4B에서는 길이에 따라 커지지 않지만 FP32 하한보다는 몇 배 높습니다. 두 Nemotron 모델에서는 분리 구성의 곡선도 측정 범위에서 몇 배 올라가, 오차 증가가 사라지기보다 줄어든 쪽입니다. 그래프를 보면 생성이 짧은 구간(약 1K 토큰까지)에서는 분리한 NVFP4 구성의 KL이 공유 FP8 체크포인트보다 높습니다.
확률적 반올림(Stochastic Rounding, SR) 을 쓴 FP16 재귀는 FP32 재귀와 거의 겹치므로, 저자들은 재귀용 체크포인트는 반정밀도면 충분하다고 결론짓습니다. 확률적 반올림은 값이 두 표현 가능한 값 사이에서 차지하는 위치에 비례하는 확률로 올리거나 내리는 방식으로, 기댓값이 원래 값과 같습니다. 원문은 읽기용 복사본을 상태 차원과 채널 차원에 따로 스케일을 두는 식으로 더 잘 양자화하면 남은 오차를 더 줄일 수 있다고 덧붙입니다.
다운스트림 정확도: 긴 생성에서 갈린다
블로그는 GPQA-Diamond 표만 실었습니다. 논문의 표 2에서 네 모델 평균을 함께 보면 다음과 같습니다(FP32 대비 변화, 퍼센트포인트).
| 체크포인트 구성 | MMLU-Pro | GPQA-Diamond | Math-L5 |
|---|---|---|---|
| FP32 기준 정확도 | 77.6% | 73.7% | 92.3% |
| 공유 NVFP4+SR | −5.88 | −13.05 | −10.92 |
| 분리: NVFP4 읽기 / FP16+SR 재귀 | −0.15 | −2.36 | −0.10 |
| 분리: NVFP4 읽기 / FP8+SR 재귀 | −0.40 | −1.77 | −0.38 |
GPQA-Diamond를 모델별로 보면 차이가 더 분명합니다.
| GPQA-Diamond (FP32 대비, 점) | FP32 정확도 | 공유 NVFP4 | NVFP4 읽기, FP16+SR 재귀 | NVFP4 읽기, FP8+SR 재귀 |
|---|---|---|---|---|
| Nemotron-3-Nano-4B | 56.7 | −31.3 | −6.7 | −5.6 |
| Nemotron-3-Super-NVFP4 | 79.3 | −12.5 | −1.4 | −1.4 |
| Qwen3.5-4B | 76.3 | −3.2 | +0.7 | +1.5 |
| Qwen3.5-122B-A10B-NVFP4 | 82.7 | −5.2 | −2.0 | −1.7 |
블로그는 분리 구성이 네 모델 중 세 모델을 FP32 대비 약 2점 이내로 유지한다고 요약했습니다. 나머지 하나인 가장 작은 Nemotron-3-Nano-4B는 분리 구성에서도 GPQA-Diamond에서 5.6~6.7점, 다른 벤치마크에서 1.5~2.8점을 잃었습니다. MMLU-Pro와 Math-L5에서 세 모델은 공유 NVFP4로도 최대 3점만 잃는다는 블로그 문장의 예외도 이 모델입니다. 공유 NVFP4에서 MMLU-Pro 21.0점, Math-L5 41.7점을 잃었습니다. 공유 FP16+SR, FP8+SR 체크포인트는 네 모델 모두에서 벤치마크 잡음 범위 안이었습니다.
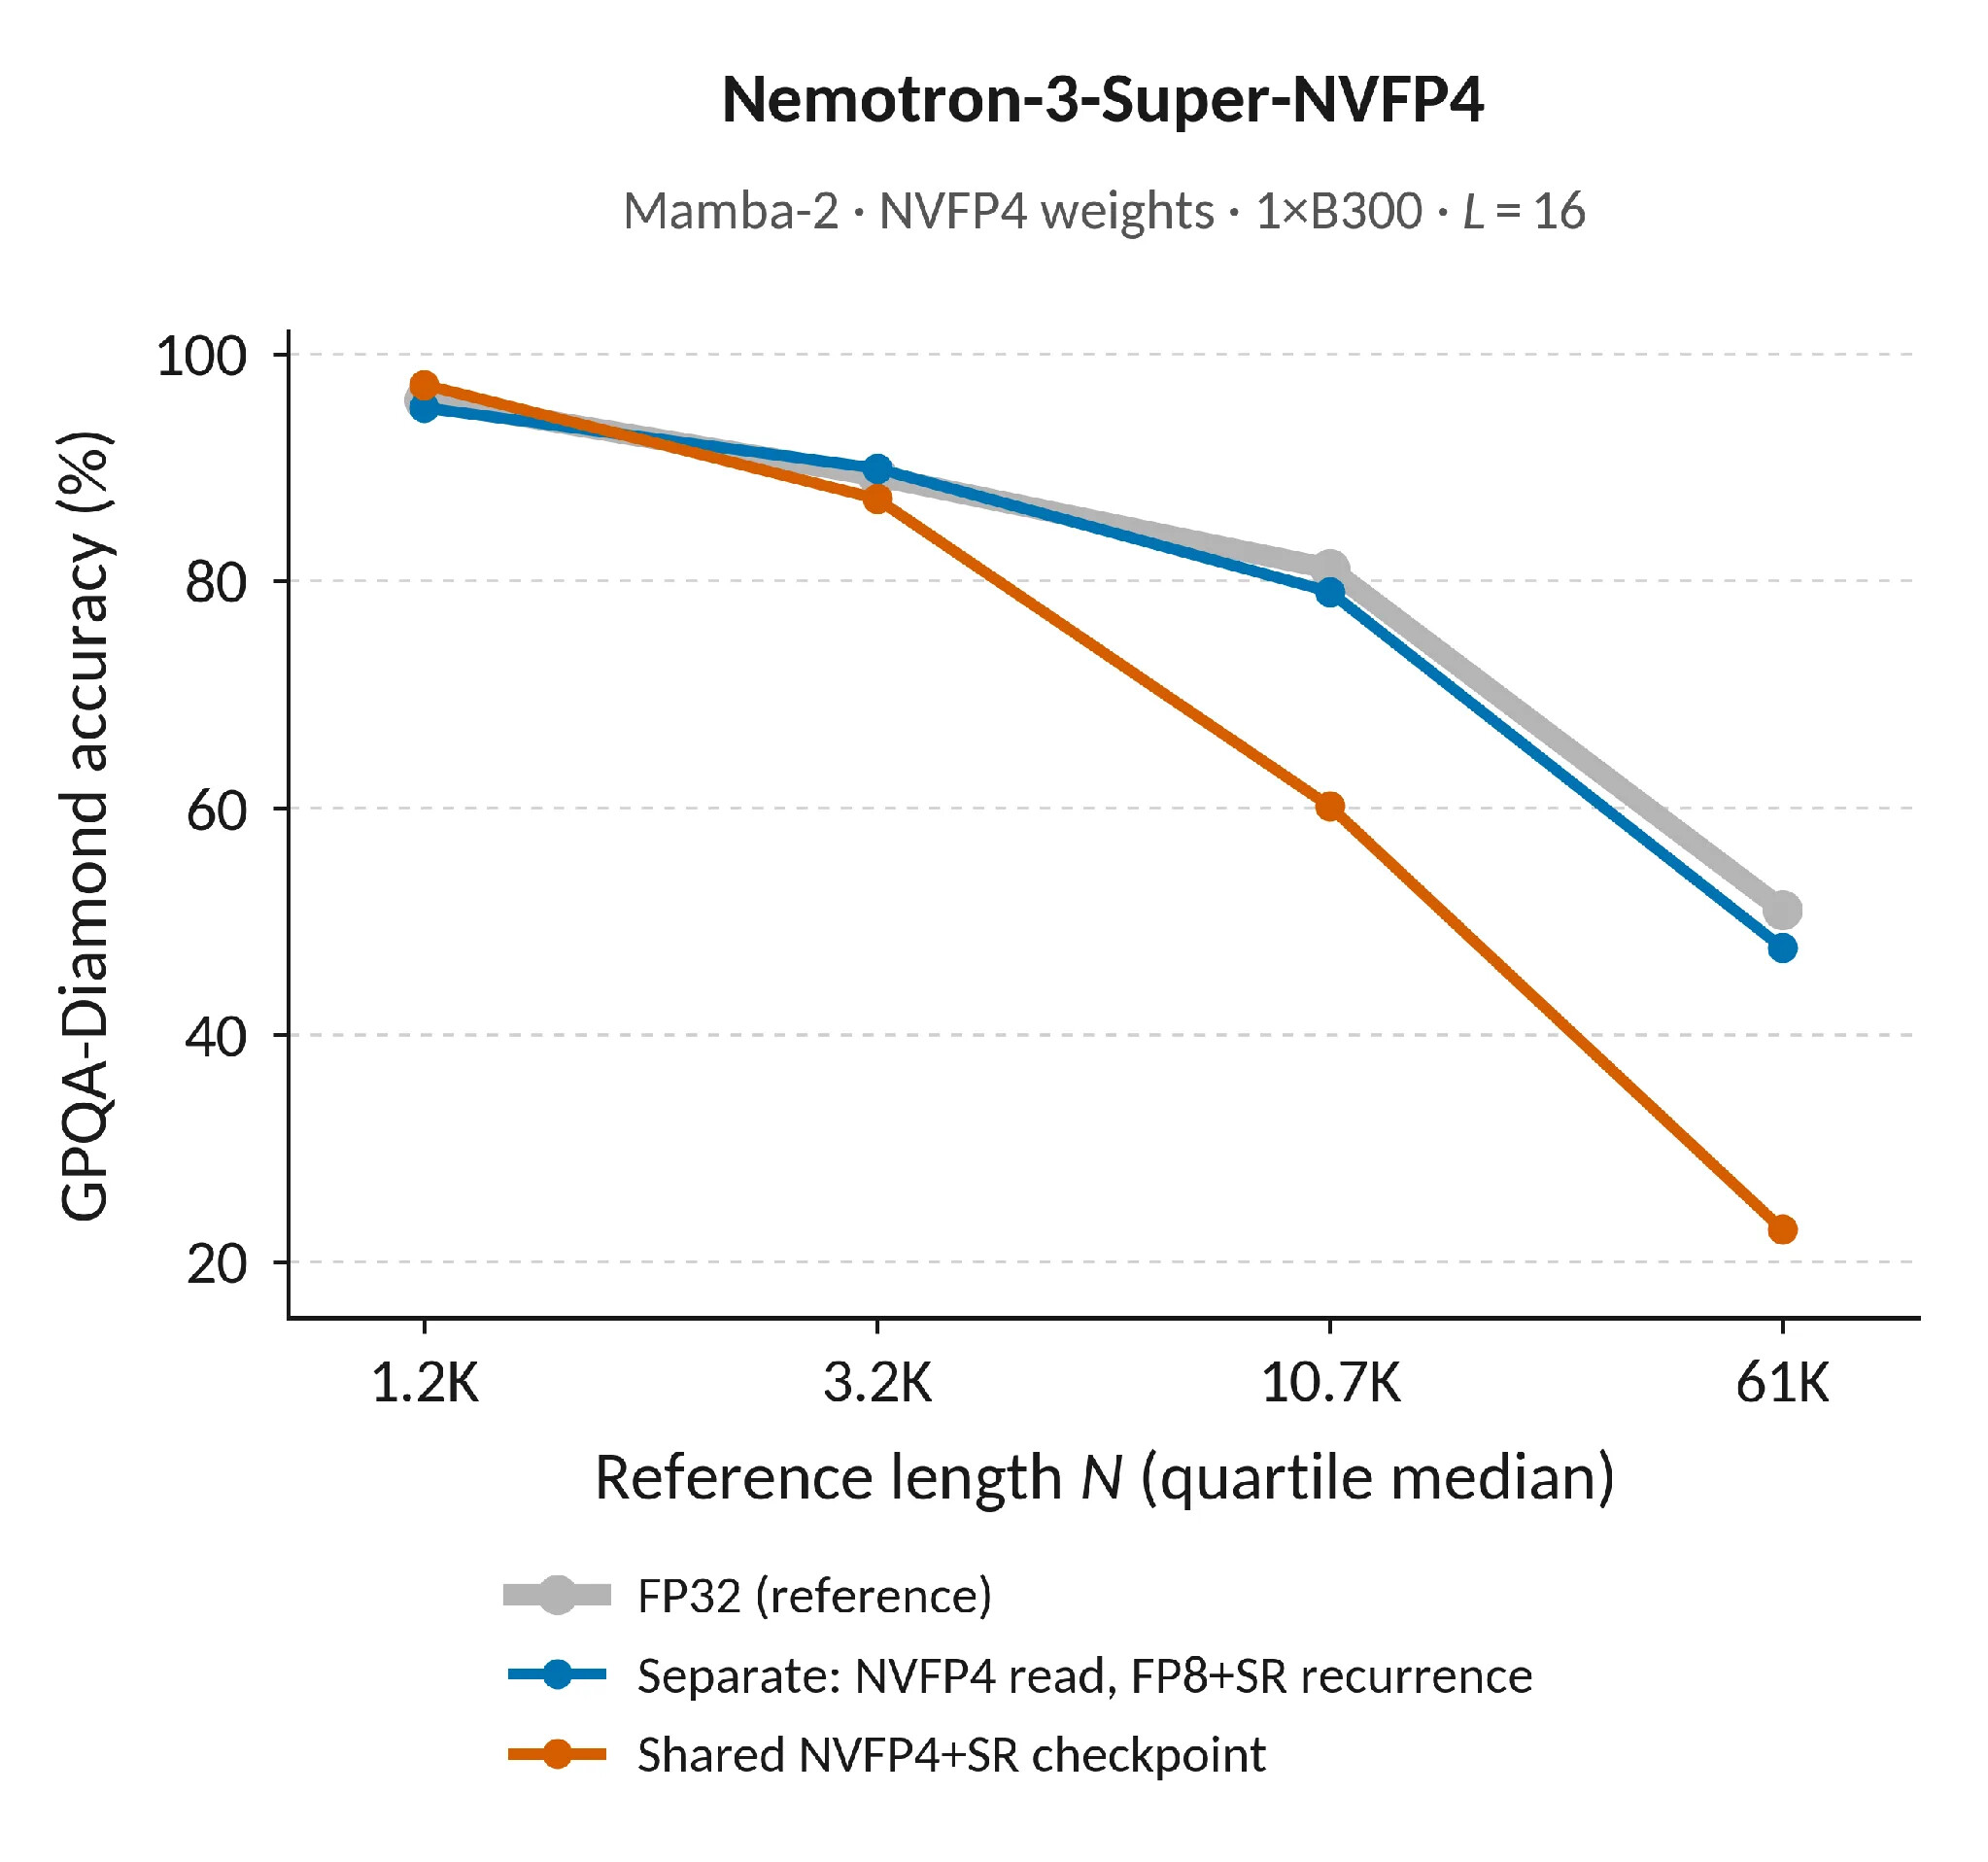
위 그래프는 Nemotron-3-Super-NVFP4의 GPQA-Diamond 문항을 FP32 출력 길이 기준 사분위로 나눈 것입니다. 공유 NVFP4 체크포인트는 짧은 두 구간에서는 FP32와 0~2점 차이지만, 긴 두 구간(중앙값 10.7K, 61K 토큰)에서는 20.9점과 28.2점 뒤처집니다. NVFP4 읽기와 FP8+SR 재귀 구성은 같은 구간에서 2.0점과 3.4점 차이였습니다.
논문 부록에는 이 결과를 읽을 때 필요한 조건이 더 있습니다.
- 에뮬레이션한 양자화: KL과 정확도 측정은 실제 저정밀도 저장이 아니라 에뮬레이션한 양자화를 구현한 Triton 커널로 했고, 지연 측정(3.8배 등)은 별도의 CuTe DSL 커널로 했습니다. 두 측정은 같은 커널에서 나온 것이 아닙니다.
- 정확도 손실의 일부는 미완료: Nemotron-3-Super에서 공유 NVFP4 생성의 20.7%가 출력 토큰 한도에 걸려 오답 처리되었습니다(FP32는 5.7%). 둘 다 끝까지 생성한 문항끼리만 보면 손실은 2.8점입니다.
- 잡음 범위: GPQA-Diamond는 칸마다 594개 생성에서 문항 단위 표준 오차가 2.5~3점이라, 큰 차이만 구분됩니다.
- 긴 입력은 무관: 약 130K 토큰 입력의 RULER-128K에서는 공유 NVFP4를 포함한 모든 구성이 FP32 대비 0.3점 이내였습니다. 양자화는 디코딩에만 적용되므로, 손실은 긴 입력이 아니라 긴 출력에서 나타납니다.
- 반올림 방식: 재귀로 다시 읽히는 체크포인트에는 확률적 반올림이 필요했습니다. 가장 가까운 값으로 반올림(RTN)하면 GDN 모델 두 개에서 FP8, NVFP4 상태가 64K~128K 토큰 전에 발산(non-finite)했습니다. 한 번만 반올림하고 다시 읽지 않는 읽기용 복사본에는 RTN이 더 나았습니다.
프레임워크별 통합 현황: 지금 무엇을 쓸 수 있나
NVIDIA 블로그는 ReplaySSM이 TensorRT-LLM, vLLM, SGLang, FlashInfer에 통합되었다고 씁니다. 원문이 링크한 7개 PR은 모두 병합되었지만, 프레임워크마다 들어간 범위가 다릅니다. 아래 표는 2026년 10월 13일 기준으로 각 저장소의 PR 상태와 소스 코드를 확인한 결과입니다.
| 프레임워크 | 들어간 범위 | 확인한 근거 |
|---|---|---|
| vLLM v0.27.0 이상 | Mamba-2 표준 디코딩, --use-replayssm, 기본값 꺼짐 |
PR 48018 (7월 24일 병합) |
| vLLM v0.30.0 이상 | Mamba-2용 FlashInfer 백엔드 | PR 52506 (9월 1일 병합) |
| vLLM v0.30.0 이상 | Kimi-K3 KDA 투기적 디코딩 전용 변형(RecoverSSM), --use-replayssm과 투기적 디코딩 설정을 함께 줄 때만 켜짐 |
PR 51855 (8월 17일 병합, NVIDIA 블로그 목록에는 없음) |
| vLLM main (릴리스 전) | Mamba-2 MTP 투기적 디코딩, FlashInfer 백엔드 필요 | PR 52928 (9월 30일 병합, v0.31.0 미포함) |
| vLLM (미병합) | GDN 표준 디코딩, Triton 기반 Mamba-2와 GDN 투기적 디코딩 | PR 48792, PR 49847, PR 49887 모두 병합 없이 닫힘 (저장소 README는 open으로 표기). Qwen3.5 GDN용 RecoverSSM PR 61309와 FlashInfer 경로의 FP8, INT8 상태 캐시 PR 52962는 초안으로 열려 있음 |
| TensorRT-LLM | Mamba-2 MTP 체크포인트 replay, GDN MTP replay | PR 14203, PR 16464 병합 |
| FlashInfer | Mamba-2 체크포인트 커널, GDN 투기적 디코딩 커널 | PR 3975, PR 4081 병합 |
| SGLang | GDN, KDA용 ReplaySSM 커널과 서버 인자 | 소스에 --enable-linear-replayssm 등이 있으나 문서화되지 않은 인자 목록에만 있음. GLM-5.3-Flash용은 PR 40517 (9월 21일 병합) |
| 연구용 vLLM 포크 | Mamba-2와 GDN의 표준, 투기적 디코딩 전체, 에뮬레이션 양자화, 저정밀도 CuTe 커널 | ReplaySSM 저장소 (vLLM 0.23.1 기반) |
정리하면, 논문의 Qwen3.5(GDN) 결과와 저정밀도 상태 결과는 공개 vLLM 릴리스로는 재현할 수 없습니다. 저장소 README도 상위 vLLM에는 Mamba-2 표준 디코딩 커널만 병합되었고, 나머지 디코딩 경로와 에뮬레이션 양자화, 저정밀도 CuTe 커널은 이 저장소에만 있다고 밝힙니다. vLLM 코드 안에서도 이 기능은 실험적(experimental) 으로 표시되어 있습니다.
vLLM v0.31.0에서 Nemotron 3 같은 Mamba-2 하이브리드 모델에 표준 디코딩용 ReplaySSM을 켜려면 다음처럼 실행합니다. 이 릴리스의 설정 설명에 따르면 Triton 또는 FlashInfer Mamba 백엔드가 필요하고(기본값은 Triton), 투기적 디코딩이 아닌 표준 디코딩에만 적용됩니다. 이 명령은 설정 코드로 확인한 것이며 직접 실행해 보지는 않았습니다.
vllm serve nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4 \
  --use-replayssm \
  --replayssm-buffer-len 16
main 브랜치에서 Mamba-2 MTP 투기적 디코딩과 함께 쓰려면 --mamba-backend flashinfer가 필요하고, 이 경우 접두어 캐싱(prefix caching)을 끄고(--no-enable-prefix-caching) 버퍼 길이를 1 + num_speculative_tokens 이상 16 이하로 맞춰야 합니다. 이 조건들은 main의 vllm/config/vllm.py 검증 코드에서 확인했습니다.
운영 환경 사례로는 GLM-5.3-Flash와 Kimi-K3가 언급됩니다. 원문과 논문에 따르면 GLM-5.3-Flash는 서빙 스택에서 ReplaySSM을 씁니다. 다만 Z.ai의 추론 인프라 보고서를 보면 조건이 다릅니다. 이 서빙은 메모리 용량과 대역폭이 제한된 10만 대 이상의 중국산 AI 가속기에서 돌고, Z.ai는 ReplaySSM을 연산을 더 쓰는 대신 메모리 부담을 줄이는 용도로 넣었습니다. 보고서의 대표 KDA 디코드 커널에서는 ReplaySSM을 넣은 직후 실행 시간이 오히려 늘었고, 이후 별도 최적화로 줄였습니다. PyTorchKR의 GLM-5.3-Flash 소개 글에서도 서빙 최적화 목록에 ReplaySSM이 있습니다.
Kimi-K3는 KDA 레이어에서 드래프트 토큰의 SSM 입력을 캐시해 검증하며, ReplaySSM을 동시기 접근(concurrent approach) 으로 인용합니다. 즉 Kimi-K3는 ReplaySSM을 가져다 쓴 것이 아니라 같은 착상을 독립적으로 구현한 사례이며, Kimi K3 기술 문서 분석 글에도 같은 내용이 정리되어 있습니다.
vLLM에는 이 방식이 v0.30.0부터 RecoverSSM이라는 Kimi-K3 전용 경로(PR 51855)로 들어 있고, 같은 --use-replayssm 플래그를 투기적 디코딩 설정과 함께 줄 때 켜집니다. RecoverSSM도 체크포인트 하나와 토큰별 입력 기록을 둡니다. 다만 검증이 끝날 때마다 수용된 위치의 상태를 다시 계산해 저장하므로, ReplaySSM처럼 버퍼가 찰 때까지 상태 쓰기를 미루지는 않습니다. PR이 보고한 이득은 GB300 두 노드의 TP8 Kimi-K3 구성에서 같은 메모리 예산의 유효 캐시 용량 10.97% 증가입니다.
6월 Dao AI Lab 글과 10월 논문의 차이
Dao AI Lab의 6월 글을 먼저 읽은 분은 숫자가 달라 혼란스러울 수 있습니다. 두 자료를 대조한 결과는 다음과 같습니다.
| 항목 | 6월 Dao AI Lab 글 | 10월 논문과 NVIDIA 블로그 |
|---|---|---|
| 버퍼 크기 | Nemotron-3은 8, Qwen3.5는 16이 최적 | 네 모델 모두 16 |
| 평가 모델 | Nemotron-3-Ultra-550B(B300 2장, TP2) 포함 5개 | Ultra 제외, GPU 1장 모델 4개 |
| 표준 디코딩 종단 간 | 최대 1.48배 | 1.20~1.47배 |
| 투기적 디코딩 | vLLM 표준 디코딩 대비 1.87~1.96배, vLLM 투기적 대비 최대 2.14배 | vLLM 투기적 대비 1.85배, 2.10배 (배치 512) |
| 동시 처리 요청 수 | 고정 메모리 예산에서 vLLM 투기적 대비 3.0~3.3배 | 별도 수치 없음 |
| 저정밀도 상태 분리 | 다루지 않음 | 세 번째 이점으로 추가 |
6월 글에는 투기적 디코딩의 flush 조건을 h + 2T > L 로 한 창 일찍 당기는 설명도 있는데, 논문은 링 버퍼 용량을 L + T 로 두고 h + T > L 일 때 flush하는 규칙으로 정리했습니다. 두 자료는 실험 설정이 다르므로 수치를 섞어 인용하지 않는 것이 안전합니다.
어떤 상황에서 검토할 만한가
ReplaySSM의 이득은 SSM 커널이 메모리 대역폭에 묶이는 큰 배치 서빙에서 나옵니다. 논문 수치로는 종단 간 이득이 배치 32에서 6~16%, 배치 128에서 16~38%, 배치 256에서 20~47%로 커집니다. 반대로 배치 1의 로컬 추론(inference)에서는 이득이 없거나 약간 손해이고, 컨텍스트가 100K 토큰을 넘어 어텐션이 스텝을 지배하는 구간에서도 종단 간 효과는 줄어듭니다.
투기적 디코딩 쪽은 하이브리드 모델에서 MTP 헤드를 켜고도 처리량이 늘지 않던 문제를 직접 겨냥하므로, 가장 큰 차이를 낼 수 있는 부분입니다. 다만 vLLM에서는 아직 릴리스되지 않은 main 브랜치에만 Mamba-2 경로가 있고(Kimi-K3는 v0.30.0부터 전용 RecoverSSM 경로), GDN 계열(Qwen3.5 이후)은 TensorRT-LLM, SGLang 또는 연구용 포크를 봐야 합니다. 저정밀도 상태 분리는 정확도 손실을 크게 줄였지만, 에뮬레이션으로 측정한 결과입니다. 공개 서빙 엔진에도 아직 들어가지 않았으므로 현재로서는 연구 결과로 보는 편이 정확합니다.
저자들은 다음 단계로 체크포인트 읽기까지 줄이는 방향을 제시합니다. 체크포인트는 헤드별 누적 감쇠가 곱해진 채로 출력에 들어가므로, 감쇠가 무시할 만큼 작아진 헤드는 non-flush 스텝에서 체크포인트를 읽지 않아도 된다는 아이디어입니다. 6월 글은 Mamba-3와 GDN2로의 확장도 계획으로 언급했습니다.
 ReplaySSM: Rethinking State Storage for Faster Hybrid-Model Decoding 소개 블로그 (NVIDIA)
ReplaySSM: Cache SSM Inputs, Not State 논문
ReplaySSM: Cache SSM Inputs, Not State 블로그 (Dao AI Lab, 2026년 6월)
 ReplaySSM GitHub 저장소
더 읽어보기
-
Qwen3.5: 초기부터 멀티모달 데이터로 학습한, 에이전트 중심의 워크플로우에 최적화된 Native Multimodal Agent Model
-
FlashKDA: MoonshotAI가 공개한, Kimi Delta Attention을 위한 고성능 CUDA 커널 라이브러리
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
