핵심 요약
- OpenAI가 2026년 11월 2일 LifeVal 발표 글에서 육아, 건강, 행정 서류, 장보기 같은 일상 과제 169개로 만든 평가 LifeVal을 소개했습니다.
- 과제당 여러 번 시도한 평균 보상을 다시 169개 과제에 같은 비중으로 평균하면, xhigh 설정에서 GPT-5.2가 49.3%, GPT-6 Astra가 80.6%입니다.
- 최근 상승 폭은 작습니다. GPT-5.6(80.0%)과 GPT-6 Astra(80.6%)의 차이는 0.6%p이고, OpenAI도 차트에서 GPT-5.6이 약 절반의 추정 API 비용으로 비슷한 성능을 낸다고 적었습니다.
- 전체 과제 목록, 채점 방식, 실행 환경은 발표 글에 없고, 별도 공개본도 찾지 못했습니다. 그래서 외부에서 같은 점수를 재현하거나 다른 회사 모델과 비교할 수 없습니다.
LifeVal 소개
LifeVal 은 모델이 사람의 일상 과제를 대신 처리하는 능력을 재기 위해 OpenAI가 만든 평가입니다. 발표 글은 조언이나 대화 응답을 넘어 실제로 일을 끝내는 행동이 필요하다고 설명하고, 같은 글에서 브라우저 사용, 컴퓨터 사용, 커넥터 과제에 맞춰 모델을 학습해 왔다고 밝힙니다. OpenAI는 이 평가로 지난 1년 동안 모델 성능을 추적했고, 개선 방향을 정하는 데도 썼다고 밝혔습니다.
OpenAI는 앞서 2025년 9월 44개 직업의 실무 산출물을 평가하는 GDPval을 공개했습니다. GDPval이 직장 업무를 다룬다면, LifeVal은 유치원 찾기, 장보기, 복지 신청서 작성처럼 업무 밖의 생활 과제를 다룹니다. 발표 글은 LifeVal의 목표를 "지식을 묻는 학술 평가를 넘어, AI가 사람들의 결정과 일상 책임을 얼마나 도울 수 있는지 측정하는 것"이라고 설명합니다.
이 글은 개인용 에이전트를 만들거나 모델을 고르는 개발자가 LifeVal 수치를 어디까지 믿고 쓸 수 있는지 판단하도록 정리했습니다. 원문 본문에는 수치 설명이 거의 없고, 핵심 데이터는 인터랙티브 차트와 펼쳐 보기 표 안에 있습니다. 그래서 페이지에 들어 있는 차트 데이터를 직접 추출해 아래 표와 그림을 만들었습니다.
과제를 고른 방법: 시간 사용 조사와 3,995명 설문
OpenAI는 과제 목록을 사람들이 하루를 어떻게 쓰는지 기록한 두 조사에서 시작했습니다. 하나는 미국 노동통계국의 American Time Use Survey(ATUS)입니다. 다른 하나는 여러 나라의 시간 사용 자료를 모은 Multinational Time Use Study(MTUS)입니다. 두 자료에는 인구 집단, 시간대, 계절별로 사람들이 하는 일상 활동이 정리되어 있습니다.
이 목록에 OpenAI가 인구 구성을 대표하도록 뽑은 응답자 3,995명의 새 설문을 더했습니다. 과제마다 개인 비서의 도움을 얼마나 원하는지 여러 질문으로 물었고, 그렇게 고른 과제는 돌봄, 건강, 교육, 가사 행정, 개인 재무, 쇼핑, 정부 서비스 이용 등의 영역에 걸칩니다. 최종 과제 수는 차트 설명에 적힌 169개입니다.
다만 설문 대상 국가와 과제별 응답 분포는 원문에 없습니다. 공개된 과제 예시도 미국 생활에 맞춰져 있습니다. 예를 들어 텍사스주 SNAP(Supplemental Nutrition Assistance Program, 미국 저소득층 식비 지원) 신청서, Luzerne 카운티(펜실베이니아주)의 집 찾기가 있습니다. Ann Arbor(미시간주) 공연 예매, LSAT(Law School Admission Test, 미국 로스쿨 입학시험) 답안 검토도 있습니다. 따라서 한국어 사용 환경이나 국내 행정 서비스에서 같은 점수가 나온다는 근거는 원문에 없습니다.
1년간의 점수 변화: GPT-5.2의 49.3%에서 GPT-6 Astra의 80.6%까지
첫 번째 차트는 모델 출시일 순서로 LifeVal 점수를 보여 줍니다. 차트 설명에 따르면 각 점은 과제 안의 여러 시도를 평균한 뒤 169개 과제 평균을 같은 비중으로 다시 평균한 값입니다. GPT-6 Astra는 출시 블로그와 같은 xhigh 추론 강도(Reasoning Effort)로 측정했고, 데이터상 다른 모델의 점도 모두 xhigh 값입니다.
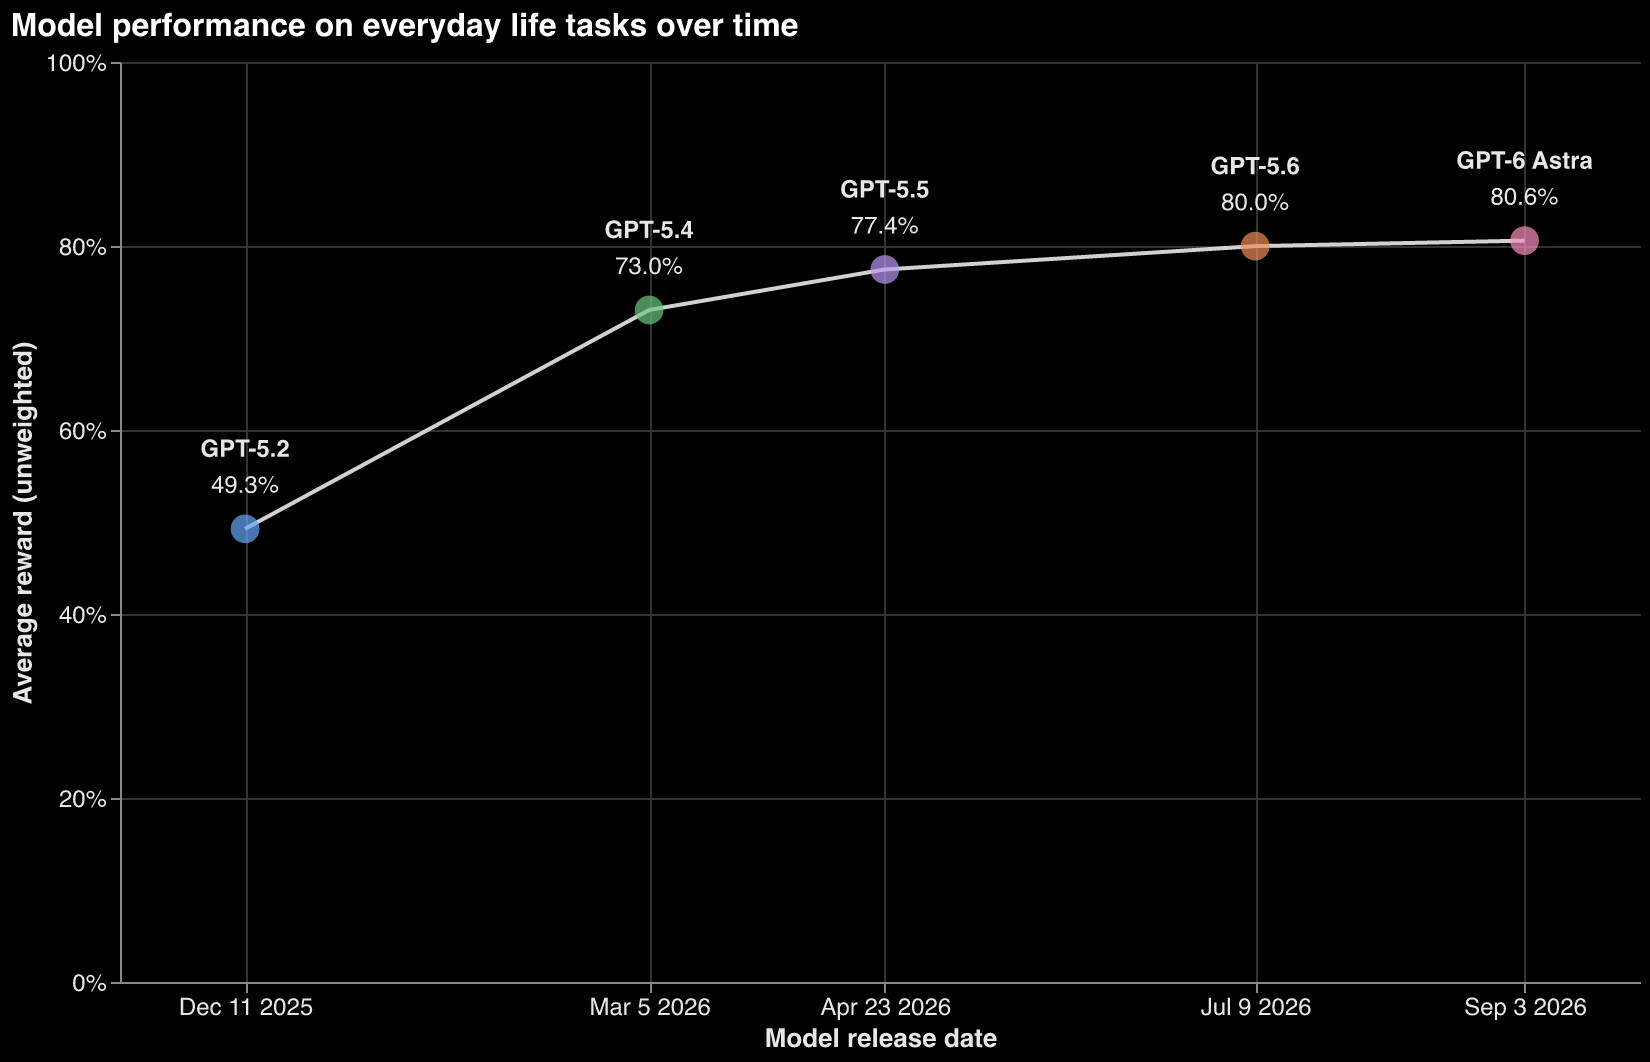
| 모델 | 차트의 출시일 | 평균 보상 (xhigh) | 직전 모델 대비 |
|---|---|---|---|
| GPT-5.2 | 2025년 12월 11일 | 49.3% | - |
| GPT-5.4 | 2026년 3월 5일 | 73.0% | +23.8%p |
| GPT-5.5 | 2026년 4월 23일 | 77.4% | +4.4%p |
| GPT-5.6 | 2026년 7월 9일 | 80.0% | +2.5%p |
| GPT-6 Astra | 2026년 9월 3일 | 80.6% | +0.6%p |
(차이는 반올림 전 값으로 계산했습니다)
위 표에서 확인할 수 있는 것은 두 가지입니다. 첫째, 가장 큰 상승은 GPT-5.2에서 GPT-5.4로 넘어갈 때 나왔습니다. LifeVal 글은 상승의 원인을 모델별로 설명하지 않습니다. 둘째, 그 뒤 상승 폭은 4.4%p, 2.5%p, 0.6%p로 계속 줄었습니다.
평균 보상(Average Reward)의 정확한 정의는 원문에 없습니다. 차트 설명은 보상에 100을 곱해 퍼센트로 표시한다고만 적었고, 세로축 범위가 0~1입니다. 과제 점수는 여러 시도의 평균이고, 부분 점수가 섞였을 수도 있습니다. 그래서 80.6%를 과제 169개 중 80.6%를 성공했다는 뜻으로 읽으면 안 됩니다.
차트에는 GPT-5.6의 티어(Sol, Terra, Luna)가 표시되어 있지 않습니다. 또 발표 시점에 이미 나와 있던 GPT-6 Sol과 GPT-6 Luna(9월 22일), GPT-6.1 Sol(9월 29일 DevDay 발표) 등도 포함되지 않았습니다.
추론 강도별 비용과 대기 시간: GPT-5.6이 절반 비용으로 비슷한 점수
두 번째 차트는 같은 모델을 low, medium, high, xhigh 추론 강도로 실행했을 때의 평균 보상을 세 가지 축과 함께 보여 줍니다. max 강도는 GPT-5.6과 GPT-6 Astra에만 있습니다. 세 축은 시도당 생성 토큰 수, 시도당 추정 지연 시간(분), 시도당 추정 API 비용(달러)입니다. 지연 시간과 비용은 모두 추정치(estimated)로 표시되어 있고, 비용 차트 캡션은 OpenAI API에서 생활 과제를 실행한 기준이라고 밝힙니다.
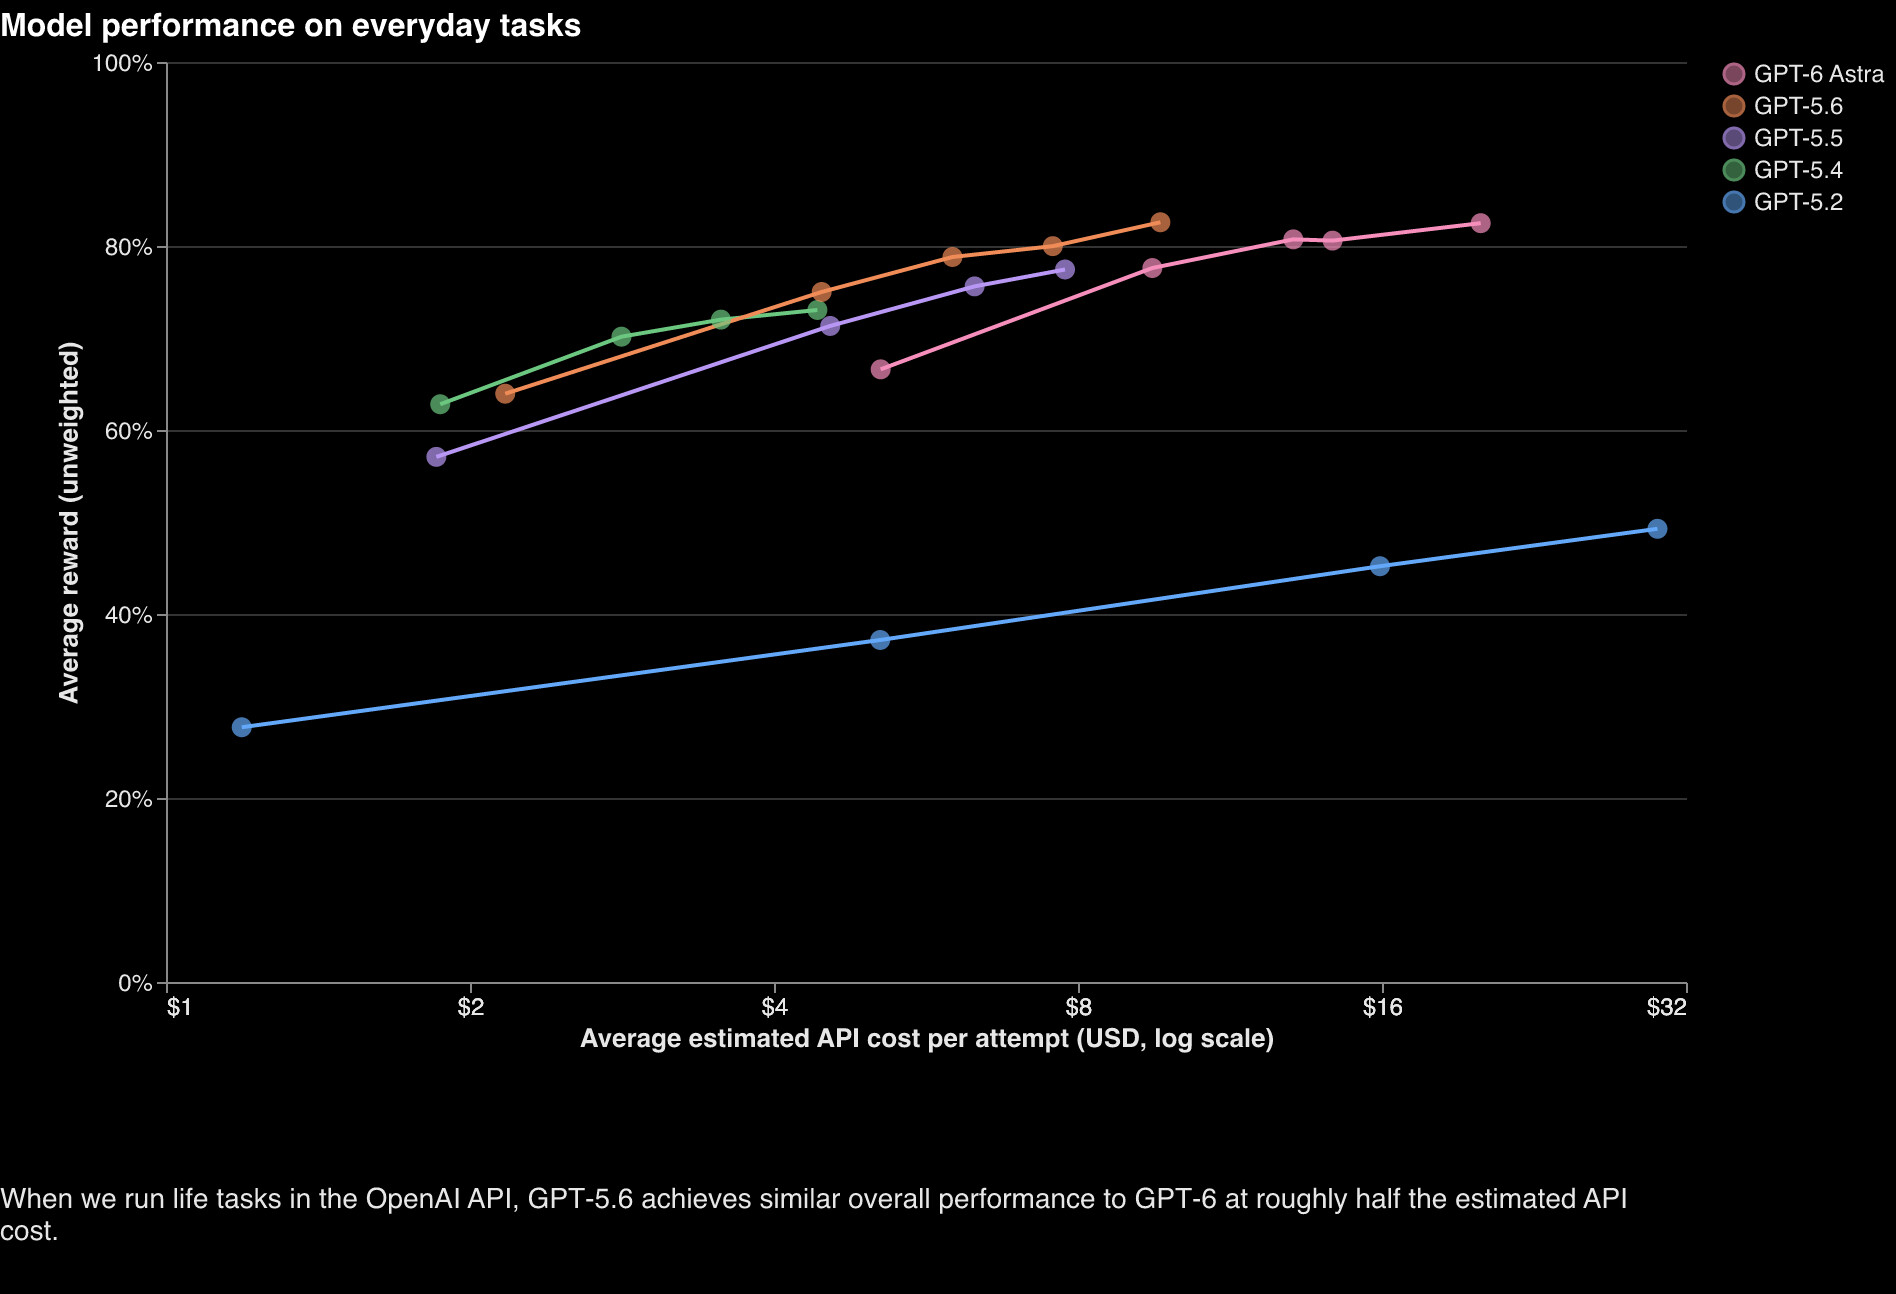
비용 축 차트에 OpenAI가 직접 적은 캡션은 "GPT-5.6이 GPT-6와 비슷한 전체 성능을 약 절반의 추정 API 비용으로 달성한다"입니다. 데이터로 확인하면 같은 추론 강도에서 GPT-6 Astra의 시도당 비용은 GPT-5.6의 1.9~2.4배입니다. 최고 점수도 GPT-5.6 max가 82.6%로, GPT-6 Astra max의 82.5%와 같은 수준입니다. 이때 비용은 $9.65와 $20.04입니다.
| 모델 | 추론 강도 | 평균 보상 | 시도당 추정 API 비용 | 시도당 추정 지연 | 시도당 생성 토큰 |
|---|---|---|---|---|---|
| GPT-5.6 | high | 78.8% | $6.01 | 14.1분 | 14,313 |
| GPT-5.6 | xhigh | 80.0% | $7.55 | 17.5분 | 20,686 |
| GPT-5.6 | max | 82.6% | $9.65 | 22.2분 | 29,739 |
| GPT-6 Astra | high | 80.7% | $13.07 | 13.6분 | 12,400 |
| GPT-6 Astra | xhigh | 80.6% | $14.30 | 15.0분 | 14,500 |
| GPT-6 Astra | max | 82.5% | $20.04 | 20.6분 | 26,278 |
GPT-6 Astra가 앞서는 축은 대기 시간과 토큰 수입니다. 지연 시간 차트의 캡션은 "GPT-6가 이 과제들에서 GPT-5.6보다 약 23% 빠르다"입니다. 그러나 어떤 설정끼리 비교했는지는 적혀 있지 않습니다. 데이터에서 22.5%가 나오는 조합은 GPT-6 Astra high(80.7%, 13.6분)와 GPT-5.6 xhigh(80.0%, 17.5분)입니다. 같은 xhigh끼리 비교하면 차이는 14.7%이고, 나머지 추론 강도에서는 3.5~7.5%입니다.
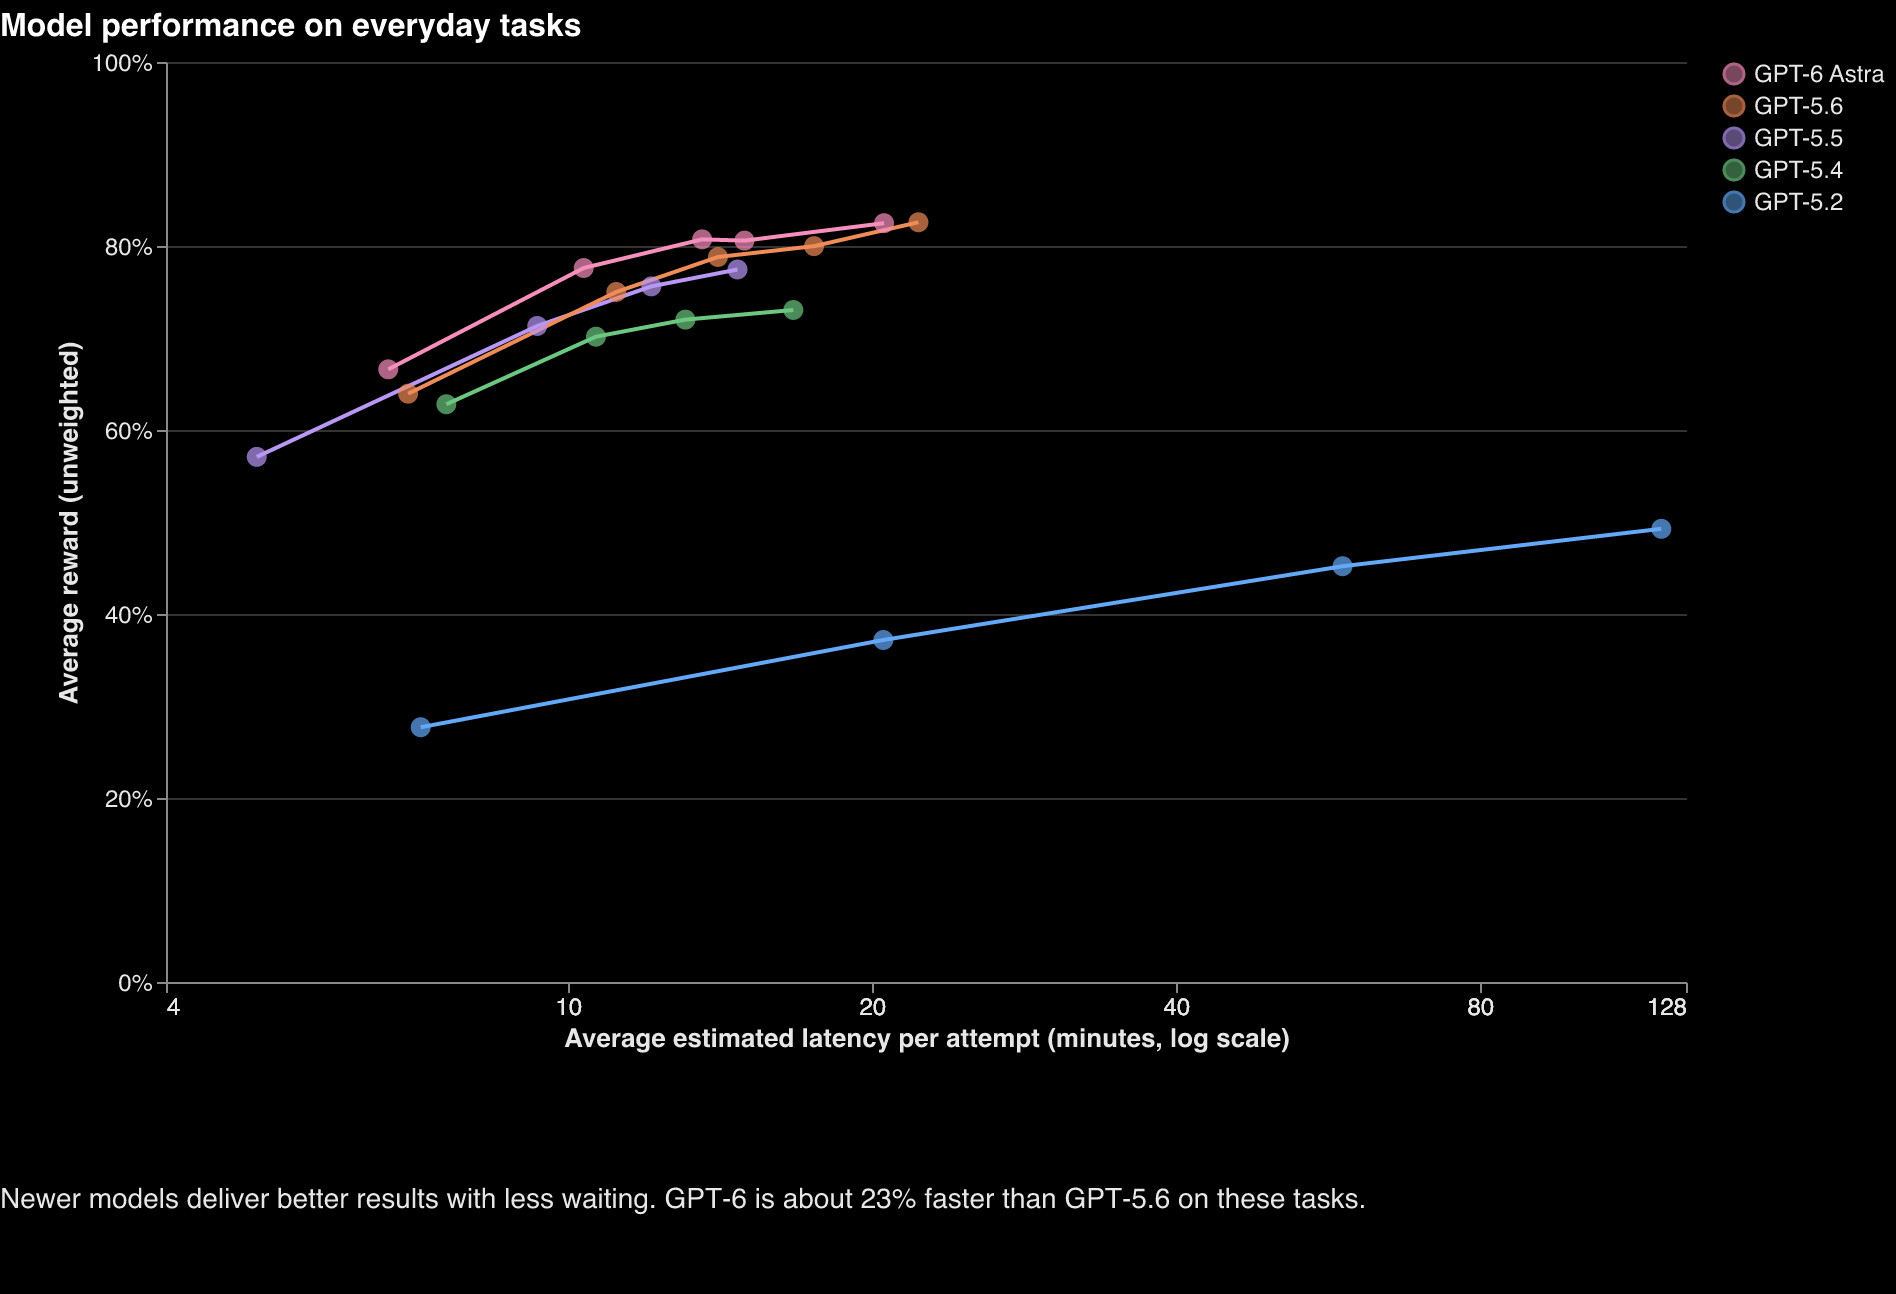
즉 GPT-6 Astra는 비슷한 점수를 조금 더 빨리, 더 적은 생성 토큰으로 내지만 시도당 추정 비용은 약 2배입니다. 응답을 기다리는 사용자가 있는 제품이라면 대기 시간을, 백그라운드에서 많은 과제를 실행한다면 비용을 기준으로 고를 수 있습니다. 비용 차이의 원인(입력 토큰, 토큰 단가 등)과 브라우저나 실행 환경 비용의 포함 여부는 원문에 나와 있지 않습니다.
1년 전 모델과의 차이는 더 큽니다. GPT-5.2 xhigh는 시도당 평균 202,044 토큰을 생성하고 121.0분, 약 $29.99를 쓰면서 49.3%에 그쳤습니다. GPT-5.4 xhigh는 16.7분, $4.42로 73.0%를 기록했습니다. 추론 강도를 높일수록 점수가 꼭 오르지도 않습니다. GPT-6 Astra는 high(80.7%)가 xhigh(80.6%)보다 근소하게 높았습니다. 낮은 강도에서는 새 모델이 이전 모델보다 낮기도 해서, GPT-5.5 low(57.1%)가 GPT-5.4 low(62.8%)에 못 미쳤습니다.
과제별 예시: 표의 점수는 최고 기록값
원문은 과제 다섯 개를 대화 예시와 함께 보여 주고, 펼쳐 보기 표에 16개 과제(대화 예시 4개 포함)를 실었습니다. 중복을 빼면 공개된 과제는 17개입니다. 표의 점수 열 이름은 "Best recorded GPT-6 Astra score", 즉 GPT-6 Astra가 기록한 최고 점수 입니다. 169개 과제의 xhigh 평균이 80.6%인 것과 달리, 원문이 고른 과제들은 88.7%에서 100% 사이입니다. 대화 예시의 점수에는 모델 표시가 없지만, 표와 겹치는 4개는 표와 같은 값입니다.
| 과제 (원문을 번역) | GPT-6 Astra 최고 기록 |
|---|---|
| 유아에게 맞고 가족 일정에도 맞는 감각 수업을 찾아 예약 | 100% |
| 차량 정비 시기를 확인하고 장거리 여행 전에 점검 예약 | 100% |
| 좋아하는 요리 세 가지에 필요한 할랄 식재료를 예산 안에서 주문하고 스프레드시트로 정리 | 100% |
| 사진과 다이아몬드 감정서로 아내의 잃어버린 약혼반지를 대신할 반지 찾기 | 100% |
| 휴대폰, 전자책 단말기, 휴대용 게임기를 대신할 주머니 크기 기기 하나를 찾아 주문 | 100% |
| 이메일 구독 해지 | 100% |
| 어머니께 드릴 카메라 골라 구매 | 100% |
| 아이가 다닐 수 있는 연극 워크숍을 찾아 수업 일정을 캘린더에 추가 | 100% |
| Ann Arbor의 4월 피아노 공연을 찾아 예산 안이면 나란히 붙은 두 좌석 예매 | 100% |
| 예산에 맞고 별도 생활 공간이 있으며 통근이 짧은 집 찾기 | 100% |
| 텍사스주 SNAP 신청서를 작성하고 증빙 서류를 첨부해 검토할 수 있게 준비 | 98.7% |
| 신용카드 포인트로 제네바 여행 예약 | 96.7% |
| 멀리 사는 할머니와 함께 경기 시청하기 | 96.3% |
| 이사 후 알맞은 유치원 찾기 | 93.1% |
| 당뇨 진단에 적응하도록 부모 돕기 | 90.4% |
| LSAT 논리 추론 답안 검토 | 88.7% |
대화 예시에는 표에 없는 과제도 하나 있습니다. 홍수에 대비해 침수 방지 도움이 필요한 이웃 네 집에 지역 자원봉사자를 배치하는 과제이고, 점수는 98.0%입니다. 대부분의 예시 응답은 마지막 검토나 결정을 사용자에게 넘깁니다. 유치원 예시에서는 후보를 세 곳으로 좁힌 뒤 남은 선호 사항 두 가지를 묻습니다.
이 표는 모델이 할 수 있는 일의 상한을 보여 주지만, 평균적인 성공률을 보여 주지는 않습니다. 같은 과제를 다시 시도했을 때 어느 정도로 성공하는지, 그리고 점수가 낮은 과제는 무엇인지는 공개되지 않았습니다.
원문이 밝히지 않은 것
발표 글에는 재현에 필요한 정보가 거의 없습니다. 빠진 정보는 아래와 같습니다.
- 과제와 데이터: 169개 전체 과제 목록, 프롬프트, 데이터셋이 공개되지 않았습니다. OpenAI GitHub와 Hugging Face에서도 LifeVal 저장소나 데이터셋을 찾지 못했습니다. GDPval이 전체 1,320개 과제 중 220개 골드 부분집합을 Hugging Face 데이터셋으로 공개했던 것과 다릅니다.
- 채점 방식: 보상을 누가 어떤 기준으로 매기는지(사람, 모델 채점기, 규칙 기반 검사), 부분 점수를 주는지 설명이 없습니다.
- 시도 횟수와 실행 환경: 과제당 몇 번 시도했는지, 실제 웹사이트에서 결제나 예약까지 진행했는지, 모의 환경을 썼는지 나와 있지 않습니다.
- 가중치: 차트 설명에 "No WTP weighting"이라는 문구가 있지만 WTP가 무엇인지는 본문에 없습니다. 설문에서 얻은 지불 의사(Willingness To Pay)로 과제에 가중치를 준 집계가 따로 있다는 뜻으로 읽힙니다. 그러나 이는 필자의 해석이고, 공개된 수치는 비가중 평균뿐입니다.
- 비교 대상: 차트에는 OpenAI 모델만 있습니다. 다른 회사 모델이나 사람 기준선과의 비교가 없습니다.
에이전트 평가에서 도구 호출 정확도보다 과업 완수를 채점해야 하는 이유는 NVIDIA가 정리한 AI 에이전트 평가 글에서 다룹니다. LifeVal 점수만으로 다른 회사 모델과 비교하거나 자기 제품의 모델을 고를 수는 없습니다. 원문 수치는 OpenAI 모델 사이의 상대적인 흐름을 보여 주는 자료입니다.
 LifeVal 소개 블로그
https://openai.com/index/lifeval/
더 읽어보기
-
OpenAI GPT-6 Astra 출시: 사이버보안 Critical 등급 첫 도달과 낮아진 CoT 모니터링 가능성
-
OpenAI DevDay 2026 발표 25가지 총정리: 상시 에이전트 dots부터 GPT-6.1 Sol, 플러그인 확장까지
-
NVIDIA가 정리한 AI 에이전트 평가: 도구 호출 정확도 대신 과업 완수를 채점하는 지표들과 트레이스 읽는 법
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
