핵심 요약
- Yale 대학교 연구진의 Pie 논문(SOSP 2025)은 LLM 서빙 엔진의 고정된 생성 루프를 42개의 API로 쪼갭니다. 사용자가 쓴 WebAssembly 프로그램(인퍼렛, Inferlet)이 이 API로 KV(Key-Value) 캐시, 순전파, 샘플링, 도구 호출을 직접 제어합니다.
- 논문 평가(NVIDIA L4, Llama 3 1B, vLLM v0.6.0과 SGLang v0.4.4 비교)에서 웹 API를 8번 부르는 ReACT 에이전트는 지연 시간이 최대 15% 줄고 처리량이 최대 30% 늘었습니다. 대신 일반 텍스트 생성은 출력 토큰당 약 1.5~1.9ms(모델 크기에 따라 2.4~11.4%) 느렸습니다.
- pie-project/pie 저장소는 Apache 2.0으로 공개됐고 최신 릴리스는 0.5.2(2026년 9월 22일)입니다. 지금은 Python, JavaScript, Rust로 인퍼렛을 쓰고 CUDA, Metal, Vulkan, WebGPU 빌드를 내려받을 수 있습니다.
- 프로젝트 FAQ(2026년 10월 기준)는 Pie를 프로덕션 준비가 되지 않은 연구 프로토타입 으로 규정합니다. 상태 없는 프롬프트를 많이 처리하는 서비스라면 vLLM이나 SGLang이 더 맞고, 다중 노드 추론은 릴리스로 발표되지 않았습니다.
Pie 소개
Pie 는 프롬프트가 아니라 프로그램을 서빙하는 LLM 서빙 시스템입니다. 클라이언트가 프롬프트를 보내면 엔진이 토큰을 돌려주는 대신, 클라이언트가 작은 프로그램을 보내면 엔진이 그 프로그램을 모델 바로 옆에서 실행합니다. 이 프로그램을 Pie에서는 인퍼렛(Inferlet) 이라고 부릅니다.
vLLM이나 SGLang 같은 서빙 시스템은 모든 요청을 같은 프리필(prefill)과 디코드 루프로 처리합니다. 이 구조는 짧은 질의응답을 대량으로 처리할 때 가장 효율적입니다. 그러나 요즘 LLM 애플리케이션은 생성 도중에 도구를 부르고 외부 결과를 기다립니다. 여러 갈래로 추론(Reasoning)을 펼쳤다가 합치기도 합니다. 엔진이 이 흐름을 모르기 때문에, 도구를 한 번 부를 때마다 클라이언트까지 왕복하고 KV 캐시를 버린 뒤 다시 프리필하는 일이 생깁니다.
Pie는 운영체제와 네트워크 분야의 프로그래밍 가능한 시스템이 써 온 방법을 LLM 서빙에 가져옵니다. 엔진은 자원과 기본 연산만 관리하고, 무엇을 언제 계산할지는 애플리케이션 프로그램이 정합니다. 논문은 이 관점에서 기존 서빙 시스템은 사실상 하나의 고정된 인퍼렛, 즉 자기회귀 루프만 실행하는 시스템 이라고 설명합니다.
Pie는 Yale 대학교의 In Gim, Zhiyao Ma, Seung-seob Lee, Lin Zhong이 SOSP 2025(2025년 10월, 서울)에서 발표했습니다. 첫 공개 릴리스 v0.1.0은 학회 첫날인 2025년 10월 13일에 나왔습니다. 그 뒤 1년 동안 추론 백엔드를 다시 만들고 Python과 JavaScript 인퍼렛, 멀티모달, 여러 GPU 백엔드를 더했습니다. 그래서 이 글은 논문의 설계와 평가를 먼저 정리하고, 이어서 지금의 0.5.x 버전이 논문과 어떻게 다른지 비교합니다.
기존 서빙 시스템의 고정된 생성 루프와 세 가지 한계
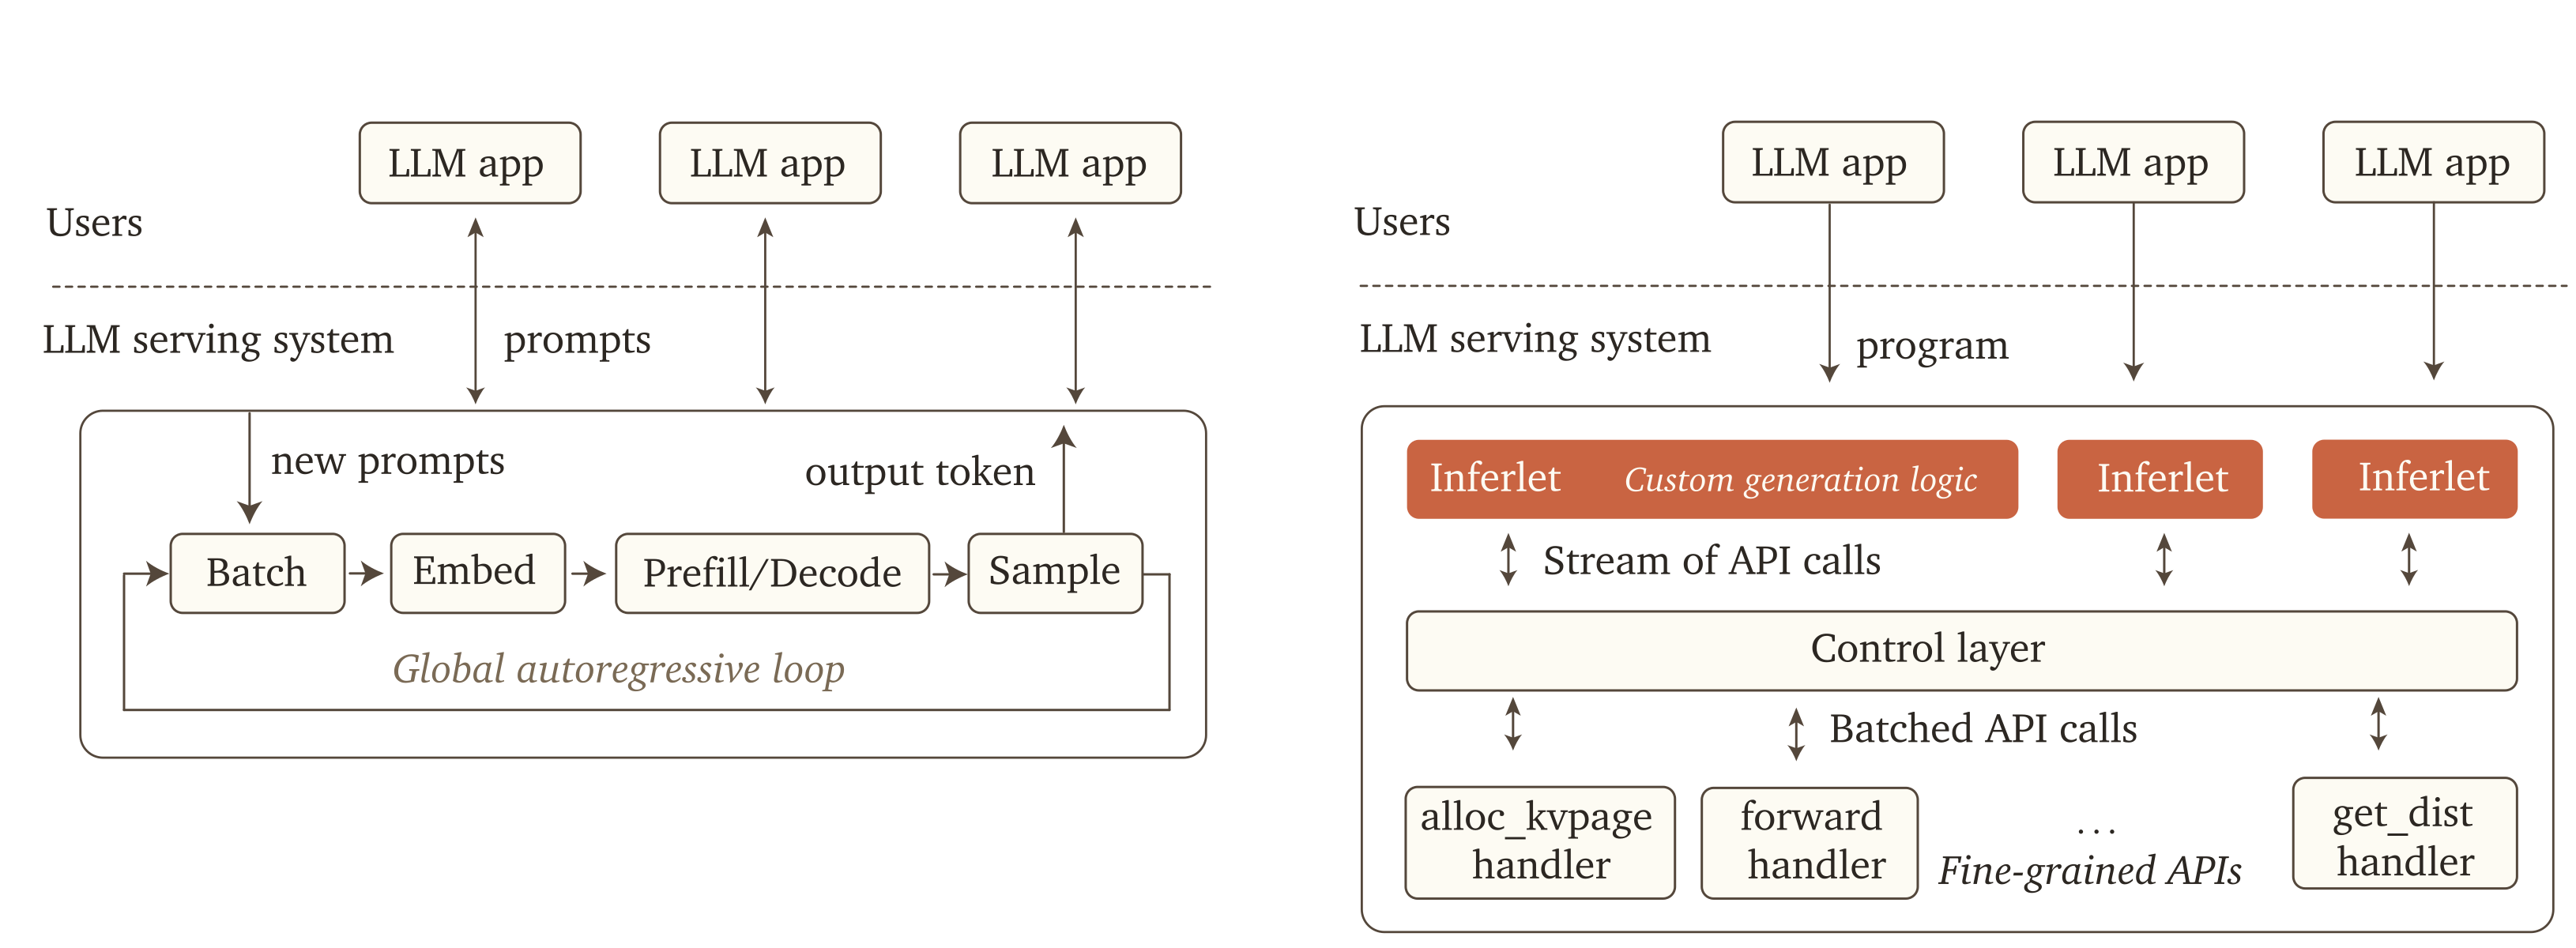
논문은 지금의 서빙 구조가 새로운 LLM 애플리케이션을 받쳐 주지 못하는 지점을 세 가지 요구 사항(R1~R3)으로 정리합니다. 위 그림의 왼쪽이 기존 구조이고, 오른쪽이 Pie의 구조입니다.
애플리케이션별 KV 캐시 제어 (R1): 기존 시스템은 LRU(Least Recently Used) 축출이나 프리픽스 캐싱(Prefix Caching) 같은 시스템 전체 정책으로 KV 캐시를 관리합니다. 프리픽스 캐싱은 요청들이 같은 앞부분을 공유할 때 그 부분의 캐시를 재사용하는 기법입니다. 그러나 Tree-of-Thought나 Graph-of-Thought처럼 추론 구조가 실행 중에 바뀌는 기법은 어떤 캐시 블록을 남기고 버리고 복제할지 애플리케이션이 결정해야 합니다. 논문은 그 예로 vLLM이 복잡도 때문에 v0.6.3에서 빔 서치(Beam Search) 지원 제거를 검토한 일을 듭니다.
사용자 정의 생성 과정 (R2): 추측 디코딩(Speculative Decoding)이나 병렬 디코딩은 한 단계에 여러 토큰을 예측하고 검증합니다. 이런 기법은 요청마다 한 단계에 토큰 하나 라는 배치 가정과 맞지 않아서, 기존 시스템에서는 시스템 전체 옵션으로만 켜고 끕니다. 문법 제약 디코딩이나 MCTS처럼 단계 사이에 상태를 들고 가야 하는 기법, 워터마킹처럼 샘플링 직전에 분포를 바꾸는 기법도 넣을 자리가 마땅치 않습니다.
계산과 I/O의 통합 (R3): 에이전트가 도구를 부르면 생성이 멈추고 제어권이 클라이언트로 돌아갑니다. 클라이언트는 도구를 실행한 뒤 늘어난 대화 전체를 새 요청으로 보냅니다. 서빙 시스템은 요청 사이에 상태를 남기지 않으므로 앞에서 만든 KV 캐시를 버리고 다시 프리필해야 합니다.
SGLang의 fork/join 프리미티브나 Parrot의 시맨틱 변수(Semantic Variable)도 프로그래밍 추상화를 제공합니다. 다만 논문은 이 시스템들도 결국 같은 단일 생성 루프 위에 있어서, 개별 KV 페이지나 임베딩, 샘플링 순서를 직접 다루지 못한다고 봅니다.
Pie의 설계: 생성 루프를 API로 쪼개고 인퍼렛에 넘기기
세분화된 API와 두 가지 자원
Pie는 순전파 한 번을 세 단계로 나눕니다. 입력을 임베딩으로 바꾸는 embed, 임베딩과 KV 캐시로 출력 임베딩을 계산하는 forward, 출력 임베딩에서 다음 토큰 분포를 꺼내는 sample 입니다. 각 단계를 API로 노출하고, 인퍼렛이 이 API를 원하는 순서로 부릅니다.
인퍼렛이 다루는 자원은 두 가지입니다. Embed 는 토큰 임베딩 버퍼이고, KvPage 는 PagedAttention 방식의 KV 캐시 조각으로 8~32개 토큰을 담습니다. 인퍼렛은 alloc_kvpage, dealloc_kvpage 로 이 자원을 명시적으로 할당하고 해제합니다. 각 인퍼렛은 자기만의 가상 자원 주소 공간을 가지며, export_kvpage 와 import_kvpage 로 다른 인퍼렛과 KV 캐시를 공유할 수 있습니다.
API는 모두 42개이고, 그중 18개가 순전파와 자원 관리에 쓰입니다. 나머지 24개는 인자 읽기, 클라이언트와 메시지 주고받기(send, receive), HTTP 요청(http_get), 인퍼렛 사이의 메시지 전달처럼 GPU가 필요 없는 일을 맡습니다. 샘플링 API get_next_dist 는 전체 어휘 대신 상위 K개 토큰 분포를 돌려주며, K의 기본값은 256입니다.
모델마다 할 수 있는 일이 다르므로, Pie는 관련 API를 Rust의 트레이트(Trait)처럼 묶습니다. InputText, InputImage, Forward, Tokenize 같은 트레이트를 모델이 구현하고, 인퍼렛은 available_traits 로 모델이 지원하는 기능을 실행 중에 확인합니다. 논문은 이 API가 Transformer 기반 LLM을 대상으로 하며, 커널 퓨전이나 양자화(Quantization), 텐서 병렬화는 추론 레이어가 따로 맡는다고 범위를 밝힙니다.
논문은 이 저수준 API로 자기회귀 루프를 직접 쓰는 예를 보여 줍니다. 프리필 한 번 뒤에 분포를 받아 가장 큰 토큰을 고르고, 그 토큰을 다시 임베딩해 다음 KvPage에 기록하는 과정을 인퍼렛 코드가 모두 적습니다:
prom = tokenize("Hello,")
tok_limit = len(inp) + 10

# Resource allocation
prom_emb = alloc_emb(len(prom))
gen_emb = alloc_emb(1)
kv = alloc_kvpage(tok_limit)

# Prefill
pos = list(range(len(prom)))
embed_txt(prom, pos, prom_emb)
forward([], prom_emb, kv[:len(prom)], gen_emb)

# Decode
for i in range(len(prom), tok_limit):
    dist = await get_next_dist(gen_emb)
    gen = dist.max_index()
    print(detokenize(gen))
    embed_txt(gen, [i], gen_emb)
    forward(kv[:i], gen_emb, kv[i:i+1], gen_emb)

# Resource cleanup
dealloc_emb(prom_emb)
dealloc_emb(gen_emb)
dealloc_kvpage(kv)
논문은 이 모델을 GPU 그래픽스의 OpenGL에 비유합니다. 저수준 제어가 필요한 개발자는 위처럼 직접 쓰고, 대부분은 지원 라이브러리의 고수준 추상화를 씁니다. 같은 루프를 지원 라이브러리로는 Context(model), ctx.fill("Hello,"), ctx.generate_until(max_tokens=10) 세 줄로 쓸 수 있습니다.
세 개의 레이어와 API 호출 배치
인퍼렛 수백 개가 동시에 API를 부르면 GPU 연산을 어떻게 묶을지가 성능을 좌우합니다. Pie는 이를 위해 시스템을 세 레이어로 나눕니다.
- 애플리케이션 레이어: Wasmtime 기반 WebAssembly(Wasm) 런타임에서 인퍼렛을 실행하고 서로 격리합니다. 인퍼렛의 생성, 종료, 통신을 관리합니다.
- 컨트롤 레이어: GPU가 필요 없는 API는 직접 처리합니다. Embed와 KvPage의 가상 주소 매핑을 관리하고, GPU로 갈 API 호출을 배치로 묶습니다.
- 추론 레이어(Inference Layer): 묶인 API 호출을 받아 GPU에서 실행합니다. 논문 시점의 구현은 PyTorch와 FlashInfer 커널로 만들었고, 컨트롤 레이어와 ZeroMQ로 통신했습니다. 오픈소스 릴리스에는 PyTorch 없이 C++/CUDA로 만든 추론 레이어도 들어 있었습니다. 저자들은 이 구현의 종단 간 지연 시간이 10~30% 낮다고 밝혔지만, 일부 트레이트(
Forward,InputText등)만 지원해서 논문 평가에서는 뺐습니다.
배치를 묶는 단위는 커맨드 큐(Command Queue) 입니다. 인퍼렛은 GPU로 가는 API 호출을 큐에 넣고, 큐는 호출 사이의 의존 관계와 우선순위를 스케줄러에 알려 줍니다. 스케줄러는 두 가지 방식으로 호출을 묶습니다. 수평 배치(Horizontal Batching) 는 서로 다른 큐에 있는 같은 종류의 호출을 묶습니다. 수직 배치(Vertical Batching) 는 한 큐 안에서 연속된 같은 종류의 호출을 묶습니다. 수직 배치는 같은 KvPage에 쓰는 것처럼 서로 충돌하지 않을 때만 묶습니다.
언제 배치를 GPU로 보낼지는 작업 보존(Work-Conserving) 정책으로 정합니다. GPU가 바쁘면 호출을 쌓아 두고, GPU가 비는 순간 추론 레이어가 알리면 쌓인 호출로 배치를 만듭니다. 인퍼렛 128개로 스케줄러를 포화시킨 실험에서, 이 적응형 정책은 배치 없이 바로 보내는 방식보다 처리량이 최대 17배 높았습니다. 큐 길이나 대기 시간을 고정 기준으로 쓰는 방식보다는 8~40% 높았습니다.
인퍼렛 런타임으로 WebAssembly를 고른 이유도 논문에 있습니다. 저자들의 설명에 따르면 운영체제 프로세스는 격리가 약하고, Docker 같은 컨테이너는 자주 실행하기에 시작 비용이 큽니다. Lua 같은 임베디드 인터프리터는 외부 함수 인터페이스(FFI, Foreign Function Interface) 비용과 격리 문제가 있었습니다. 다중 사용자가 인퍼렛을 자주 시작하는 환경에서 격리, 시작 지연, 이식성의 균형이 가장 좋았다는 판단입니다.
더 알아보기: Pie의 설계와 기반 기술
Pie: A Programmable Serving System for Emerging LLM Applications: SOSP 2025 논문 PDF
What is Pie?: 프로젝트 문서의 개요 페이지
LLM 추론 엔진 이해하기: Nano-vLLM 내부 살펴보기: 기존 서빙 엔진의 동작을 설명하는 PyTorchKR 글
논문 평가: 무엇을 어떤 조건에서 측정했나
평가 환경은 GCP g2-standard-32 인스턴스의 NVIDIA L4 GPU(24GB) 한 장입니다. 모델은 Llama 3 1B, 3B, 8B(BF16)를 썼습니다. 비교 대상은 vLLM v0.6.0과 SGLang v0.4.4입니다. 구조화 생성은 LMQL v0.7.3과, 어텐션 싱크는 StreamingLLM과 비교했습니다. 커널 차이가 아니라 구조 차이를 보려고 Pie, vLLM, SGLang 모두 FlashInfer 백엔드를 썼습니다. 지연 시간은 캠퍼스 네트워크의 원격 Python 클라이언트에서 쟀습니다.
이 조건을 먼저 밝히는 이유가 있습니다. 비교한 vLLM과 SGLang 버전은 2026년 10월 기준으로 1년 넘게 지난 버전이고, GPU는 L4 한 장, 모델은 작은 Llama 3입니다. 아래 수치는 설계 방향의 근거 로 읽어야 하며, 지금의 vLLM이나 SGLang과 비교한 결과로 옮기면 안 됩니다.
에이전트 워크로드: 왕복을 없애고 KV 캐시를 유지하기
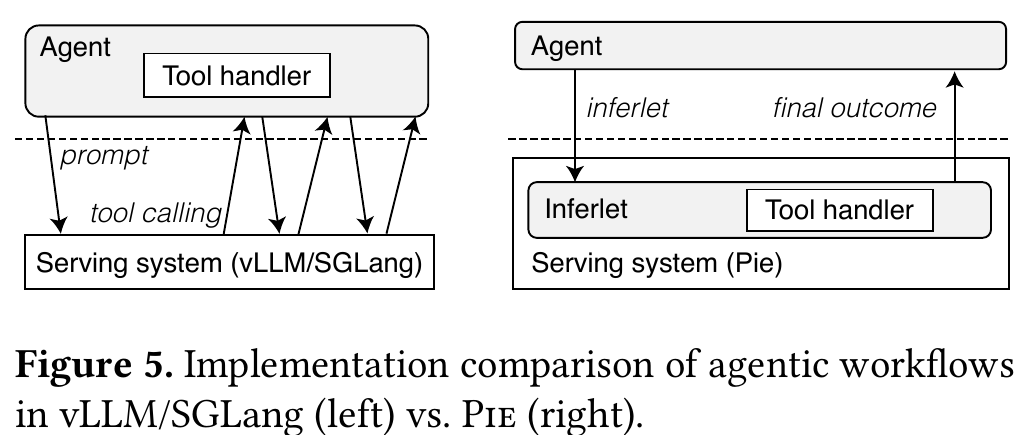
저자들은 세 가지 에이전트를 인퍼렛으로 구현했습니다. 웹 API를 부르는 ReACT, 코드를 실행하는 CodeACT, 에이전트끼리 메시지를 주고받는 Swarm 입니다. vLLM과 SGLang 쪽은 같은 로직을 Python 클라이언트 스크립트로 구현하고, 처리량에 도움이 되는 곳에서는 요청을 병렬로 보냈습니다.
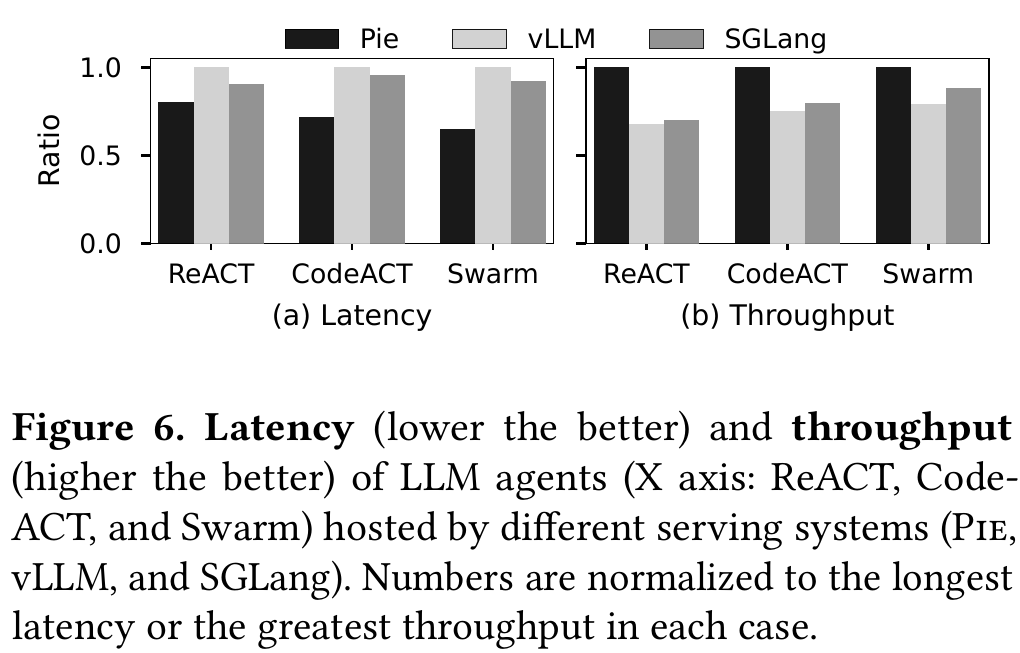
실험은 1B 모델로 에이전트당 외부 I/O를 ReACT 8회, CodeACT 8회, Swarm 32회 수행했습니다. 이때 Pie의 지연 시간은 각각 4.27초, 3.18초, 6.14초였고, 처리량은 초당 29.94, 40.18, 5.21개 에이전트였습니다. 논문은 ReACT에서 지연 시간이 최대 15% 줄고 처리량이 최대 30% 늘었다고 보고합니다. CodeACT와 Swarm은 감소율을 숫자로 밝히지 않았지만, 정규화된 그래프에서는 두 워크로드의 지연 시간 막대 차이가 ReACT보다 큽니다. 이득의 크기는 외부 I/O 횟수에 비례합니다. 외부 호출이 2회 미만이면 시스템 사이에 차이가 없었고, 호출이 늘수록 격차가 선형으로 벌어졌습니다.
저자들은 이득의 원인을 모델 크기에 따라 다르게 설명합니다. 1B와 3B처럼 작은 모델에서는 토큰 생성 시간(수 ms)과 클라이언트 왕복 시간(수십 ms)이 비슷해서, 왕복을 없앤 효과가 가장 큽니다. 8B 이상에서는 외부 호출 사이에 KV 캐시를 유지해 다시 프리필하지 않는 효과가 더 큽니다.
애플리케이션 지식을 쓰는 최적화: 3.5배라는 수치의 조건
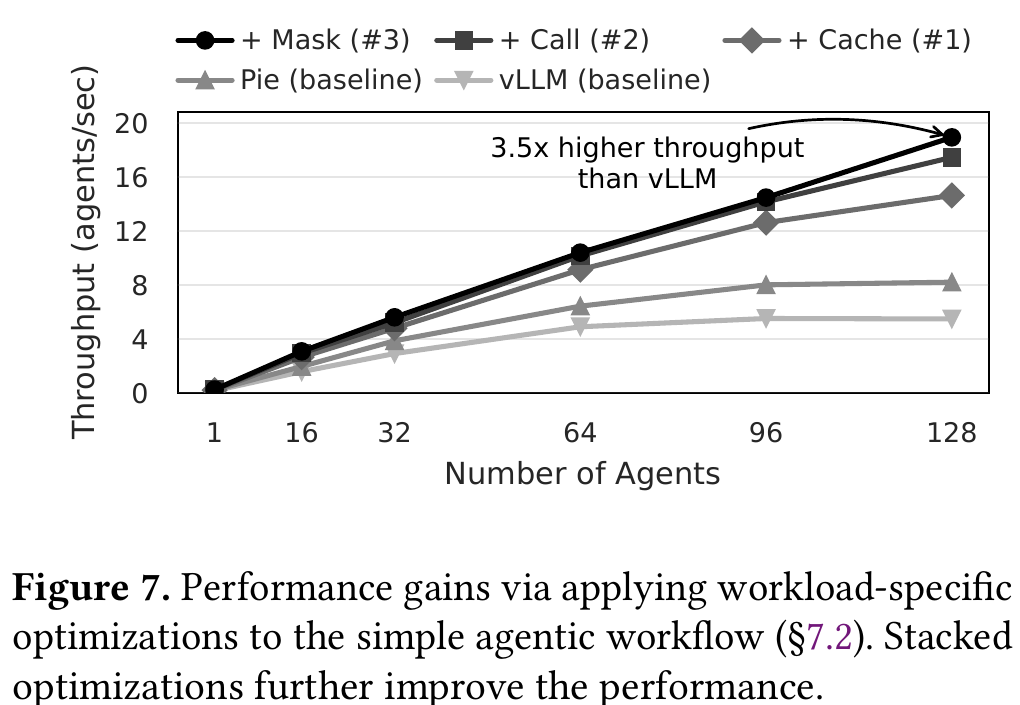
이 논문에서 가장 큰 수치인 vLLM 대비 3.5배 처리량 은 특정 가정을 둔 실험에서 나왔습니다. 저자들은 함수 호출 에이전트가 세 가지 성질을 가진다고 가정합니다. 일부 API가 다른 API보다 자주 쓰이고, 대부분의 API는 결과를 기다릴 필요가 없고, 한 세트의 API는 대개 한 번만 불립니다.
이 가정 위에서 인퍼렛은 세 가지 최적화를 차례로 더합니다:
- 자주 쓰는 API 문서의 KV 캐시를
export_kvpage로 남겨 둡니다. - 생성된 토큰에서 호출 형식이 보이는 즉시, 결과를 기다리지 않고 API를 동시에 부릅니다.
- 한 번만 쓰는 API 명세의 KV 캐시를
mask_kvpage로 문맥에서 뺍니다.
세 가지를 모두 적용한 결과가 Python으로 구현한 vLLM 워크플로 대비 3.5배 처리량입니다.
3.5배는 애플리케이션 지식을 코드로 옮긴 결과이고, Pie를 쓰기만 하면 나오는 수치가 아닙니다. 3.5배는 에이전트 128개에서 잰 값입니다. 같은 지점의 그래프를 픽셀로 재면, 최적화를 하나도 적용하지 않은 Pie 기준선은 vLLM의 약 1.5배입니다. 가장 큰 증가는 1번 최적화(KV 캐시 보존)에서 나와 약 2.7배가 되고, 2번과 3번을 더해 약 3.2배, 3.5배가 됩니다. 에이전트 수가 적을수록 격차는 작습니다. 초록의 처리량 1.3~3.4배 향상 과 서론의 지연 시간 1.1~2.4배 감소 도 이런 고급 워크로드를 묶은 범위입니다. 논문 본문에는 이 범위를 어느 실험에서 뽑았는지 정리한 표가 없습니다. 실험별 수치는 위와 아래에 적은 본문 값을 보는 편이 정확합니다.
기존 서빙 기능을 인퍼렛으로 다시 구현하기
Pie의 또 다른 주장은 vLLM과 SGLang이 시스템 기능으로 넣어 둔 최적화를 인퍼렛 수준에서 다시 만들 수 있다는 것입니다. 저자들이 구현한 기법과 결과는 다음과 같습니다:
| 기법 | 인퍼렛 구현 방식 | 논문이 보고한 결과 |
|---|---|---|
| 프리픽스 캐싱, 프리픽스 트리 | export_kvpage, import_kvpage 로 KV 공유, RadixAttention과 같은 분기 생성 |
vLLM, SGLang과 비슷한 성능 |
| 추측 디코딩 | vLLM의 n-gram 프롬프트 조회 방식 | vLLM과 비슷한 성능 (SGLang은 이 방식 미지원) |
| 빔 서치 (빔 3개) | 인퍼렛이 빔별 KV를 관리 | 지연 시간은 조금 높고 처리량은 더 높음 |
| EBNF(Extended Backus-Naur Form) 제약 디코딩 (JSON 문법) | Rust 라이브러리 llguidance를 Wasm으로 통합 | SGLang과 비슷하고, vLLM과 LMQL보다 빠름 |
| ToT, RoT, GoT, SkoT 추론 전략 | 기법당 약 80~100줄, KV 재사용을 프로그램이 직접 제어 | 지연 시간 최대 28% 감소, 처리량 최대 34% 증가 |
| 어텐션 싱크 | mask_kvpage 와 forward 의 마스크 인자 |
StreamingLLM 대비 지연 시간 1.5배 감소, 처리량 30배 이상 (커널 라이브러리 차이 포함) |
추론 전략 실험은 원 논문의 과제를 단순화한 버전(ToT와 RoT는 산술 문제, GoT는 문서 요약)으로 수행했습니다. 저자들은 RoT처럼 그래프 구조가 실행 중에 바뀌는 경우 SGLang의 RadixAttention이 효과적으로 적용되지 않는다고 설명합니다. 어텐션 싱크 결과는 저자들도 GPU 커널 라이브러리 차이의 영향을 받았다고 밝혔으므로, 구조의 이득만으로 읽으면 안 됩니다.
프로그래밍 가능성의 비용
유연성에는 비용이 있습니다. 논문은 일반 텍스트 생성처럼 Pie의 이점이 없는 작업에서 출력 토큰당 생성 시간(TPOT, Time Per Output Token)을 vLLM과 비교했습니다:
| 모델 | vLLM TPOT | Pie TPOT | 추가 시간 (비율) |
|---|---|---|---|
| Llama 3 8B | 64.06ms | 65.59ms | 1.53ms (2.39%) |
| Llama 3 3B | 30.30ms | 32.01ms | 1.71ms (5.64%) |
| Llama 3 1B | 16.83ms | 18.75ms | 1.92ms (11.41%) |
추가 시간은 1.5~1.9ms로 거의 일정하므로, 모델이 클수록 비율이 작아집니다. 저자들이 원인을 나눠 본 결과, 가장 큰 몫은 GPU에서 샘플링을 순전파와 겹쳐 실행하지 못하는 비용(토큰당 1.320ms)이었습니다. Wasm 처리 자체는 0.001ms, 레이어 경계 통과는 0.001~0.006ms 수준이었습니다.
인퍼렛을 시작하는 비용도 측정했습니다. 인퍼렛 896개가 동시에 시작을 요청할 때, 캐시된 바이너리를 쓰면 10~50ms, 바이너리를 올리고 JIT(Just-In-Time) 컴파일하는 콜드 스타트는 35~81ms가 걸렸습니다. Wasmtime의 풀링 할당으로 최대 1,000개 인스턴스의 가상 메모리를 미리 잡아 둔 결과입니다. API 호출 한 번의 지연은 배치 스케줄링을 끄고 잰 상한값입니다. 컨트롤 레이어 처리가 30µs 미만, 추론 레이어 처리가 동시 인퍼렛 수에 따라 10~300µs였고, 후자는 Python 쪽 역직렬화가 단일 스레드인 탓이 컸습니다.
논문이 밝힌 한계
저자들은 한계도 직접 적었습니다. 사용자 코드에 제어권과 네트워크 I/O를 넘기면 공격 표면이 넓어집니다. 부채널 정보 유출, 자원 고갈(DoS), 토큰 분포를 이용한 탈옥이나 모델 추출이 그 예이고, 논문은 보안을 본격적으로 다루지 않았다고 밝힙니다. 컨트롤 레이어는 추론 백엔드 하나를 맡는 중앙 스케줄러이므로 여러 GPU 노드로 확장하려면 분산 조정이 필요합니다. KV 페이지가 부족하면 가장 최근에 시작한 인퍼렛을 종료하는 선착순(FCFS) 정책을 썼습니다.
논문 발표 1년 뒤: 0.5.x는 무엇이 달라졌나
논문 시점의 Pie와 지금의 Pie는 구현이 많이 다릅니다. 아래 표는 논문, 0.4.0 릴리스 블로그, 0.5.x 릴리스 노트와 README, 프로젝트 문서를 대조해 정리한 것입니다:
| 항목 | 논문 시점 (v0.1.0, 2025년 10월) | 현재 (0.5.2, 2026년 9월) |
|---|---|---|
| 인퍼렛 언어 | Rust 지원 라이브러리 중심 (Wasm으로 컴파일되는 언어) | Python, JavaScript, Rust |
| 추론 레이어 | Python, PyTorch, FlashInfer (평가 구현). 일부 트레이트만 지원하는 C++/CUDA 구현 동봉 | Rust 단일 바이너리에 엔진 내장, cuda, metal, vulkan, wgpu 빌드 |
| 지원 모델 | Llama 계열 | Qwen, Llama, Gemma, GPT-OSS, Mistral, Phi, OLMo 등 (CUDA 드라이버 기준, 일부는 preview) |
| 멀티모달 | 이미지 입력 API 정의 | 이미지, 오디오, 영상 입력과 음성 출력 (0.4.0). README 예제에 확산(Diffusion) 생성 포함 |
| 샘플링 위치 | 상위 K개 분포를 인퍼렛으로 돌려받아 호스트에서 샘플링 | README 예제 기준, epilogue 를 한 번 추적해 GPU에서 실행하고 호스트는 결과 토큰만 받음 |
| 제약 디코딩 엔진 | llguidance를 Wasm으로 통합 (평가 구현) | crates/grammar: XGrammar 일부를 Rust로 다시 쓴 엔진 (NOTICE) |
| GPU 병렬화 | 단일 추론 백엔드 | 한 호스트 안의 텐서 병렬, 데이터 병렬 (FAQ). 다중 노드는 릴리스로 발표되지 않음 |
| 자원 경합 | 가장 최근 인퍼렛 종료 (FCFS) | v0.3.0에서 시장 기반 경합 관리 도입 (로드맵) |
| 기존 API 호환 | 논문에 언급 없음 | OpenAI, Anthropic, Google GenAI 형식의 엔드포인트 |
샘플링 위치의 변화는 논문이 가장 큰 추가 비용으로 꼽은 부분(GPU에서 샘플링을 겹쳐 실행하지 못하는 비용, 토큰당 1.320ms)과 맞닿아 있습니다. 다만 이 변화가 TPOT 비용을 얼마나 줄였는지 공개한 측정은 아직 없습니다.
프로그래밍 가능성 비용을 숨기는 추측 실행
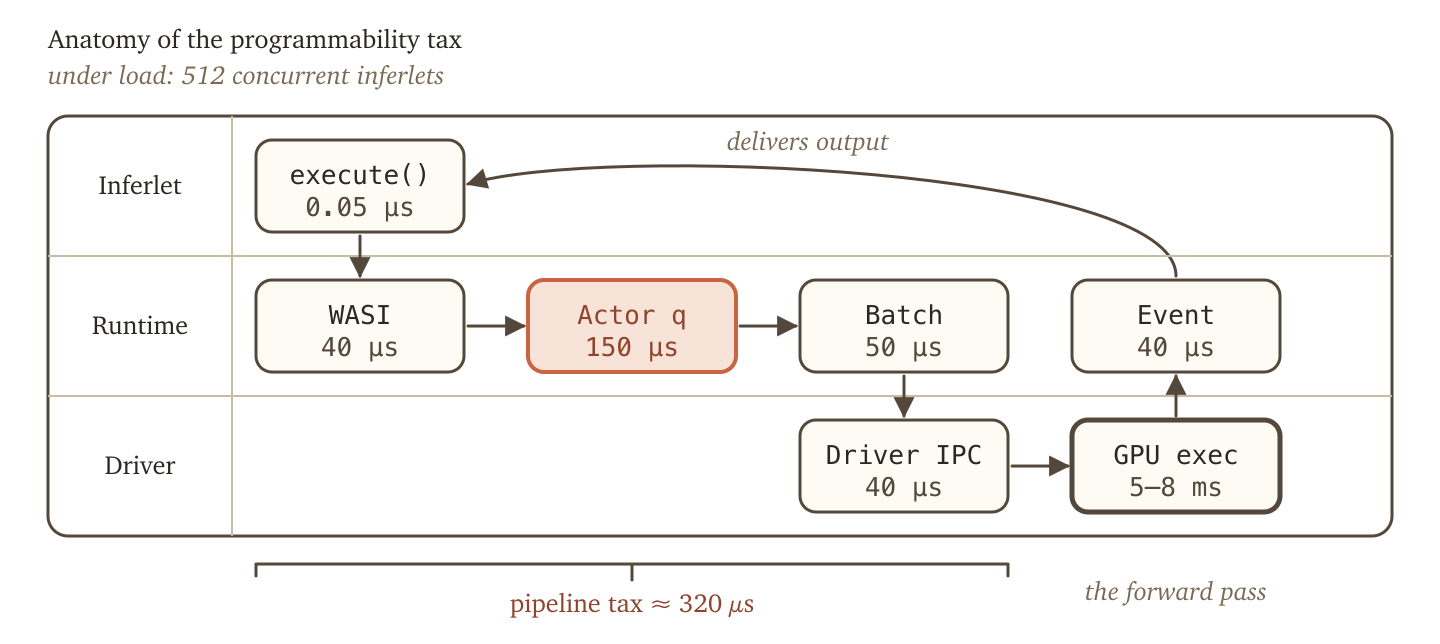
0.4.0의 가장 큰 변화는 추측 실행(Speculative Execution) 입니다. 0.4.0 블로그에 따르면, 인퍼렛 512개가 도는 부하에서 디코드 한 단계는 5~8ms의 순전파와 약 320µs의 런타임 작업으로 이뤄집니다. vLLM과 SGLang은 비슷한 파이프라인에 약 150µs를 쓰고, Pie는 인퍼렛이 호출을 하나씩 보내면서 WebAssembly 경계와 액터 큐를 매번 지나기 때문에 약 170µs를 더 씁니다. 프로젝트는 이 추가 비용을 프로그래밍 가능성 세금(Programmability Tax) 이라고 부릅니다.
다음 순전파는 대개 KV 페이지 오프셋과 위치 ID만 하나씩 늘어난 형태입니다. 추측 실행은 이 점을 이용해, GPU가 현재 순전파를 실행하는 동안 런타임이 다음 순전파를 미리 준비합니다. 인퍼렛이 실제로 execute() 를 부를 때 예측이 맞으면 준비된 결과를 약 10µs 만에 돌려주고, 틀리면 원래 경로로 처리합니다. 블로그는 두 경로가 같은 토큰을 만든다고 설명하고, 이 방식으로 프로그래밍 가능한 서빙의 오버헤드 90%를 없앴다 고 주장합니다. 기본 깊이는 1이며 speculation_depth 로 늘릴 수 있습니다. 이 기능은 여러 토큰을 한 번에 예측하는 추측 디코딩과는 다른 기법이고, 둘을 함께 쓸 수 있습니다.
다만 이 개선을 반영한 TPOT 표는 아직 없습니다. 프로젝트의 벤치마크 페이지는 여전히 SOSP 논문의 수치를 싣고 있습니다. 0.4.0 블로그의 CUDA 드라이버가 Qwen3에서 vLLM 처리량과 같거나 더 높다 는 문장에도 측정 조건이 없습니다. 같은 문서 안에서도 비용 설명이 조금씩 다릅니다. FAQ는 모델 크기와 상관없이 vLLM 대비 토큰당 약 1ms라고 적고, 비교 페이지는 모델 크기에 따라 1~15%라고 적습니다.
0.5.x의 빌드 변화와 남은 계획
0.5.0(2026년 9월 10일)은 Linux x86_64와 macOS Apple Silicon용 wgpu 빌드를 더했습니다. CUDA 장치 코드를 실행 시점에 NVRTC로 컴파일해 디스크에 캐시하므로, 연산 능력(Compute Capability)마다 나뉘던 빌드가 아키텍처당 cuda13.0 하나로 줄었습니다. 대신 CUDA 12 빌드는 더 이상 나오지 않고, NVIDIA 드라이버 r580 이상이 필요합니다. 0.5.1부터는 Python과 JavaScript 인퍼렛용 언어 구성 요소가 릴리스 파일로 함께 올라옵니다.
로드맵은 0.5.0의 목표로 프리필, 디코드, 이미지 임베딩, 영상, 음성 출력을 서로 다른 노드에서 실행하는 분리형 백엔드와 그 위의 컨트롤러를 적었습니다. 인퍼렛을 완전한 에이전트 가 아니라 추론의 단위 로 좁히고, 런타임 사이를 옮겨 다니는 지속형 인퍼렛(Durable Inferlet)으로 가겠다는 방향도 밝혔습니다. 저장소 main에는 분산 컨트롤 플레인(crates/controller), 워커 사이 RDMA KV 전송(crates/transport), 클라이언트 게이트웨이(crates/gateway)가 들어와 있습니다. 그러나 0.5.0 릴리스 노트는 위의 빌드 변경만 적었으므로, 분리형 백엔드를 지금 릴리스에서 쓸 수 있는지는 공개 자료로 확인되지 않습니다.
설치하고 첫 인퍼렛 실행하기
아래 절차는 README 기준입니다. 설치 스크립트는 ~/.local/bin 에 pie 바이너리를, ~/.pie 에 Python과 JavaScript 지원 파일을 넣습니다. 스크립트를 열어 보면 GitHub 릴리스 아카이브를 내려받아 tar 형식만 확인하고 설치하며, 별도 체크섬 검증은 하지 않습니다.
-
Linux와 NVIDIA GPU 환경이라면, 드라이버 r580 이상인지 먼저 확인합니다. NVIDIA GPU가 없는 Linux x86_64는 Vulkan 1.2 장치용
vulkan이나 이식용wgpu빌드를, Linux arm64는vulkan빌드를 씁니다. Apple Silicon Mac은metal빌드를 씁니다. CPU 전용 빌드와 Intel Mac용 빌드는 없습니다. -
설치 스크립트를 실행합니다. 스크립트는 Linux에서 NVIDIA 드라이버 r580 이상을 찾았을 때만
cuda13.0을 자동으로 고릅니다. NVIDIA GPU가 없거나 드라이버가 r580보다 낮으면 자동 선택이 되지 않으므로,PIE_FLAVOR환경 변수로 빌드 종류를 직접 지정합니다.curl -fsSL https://pie-project.org/install.sh | bash # Linux, macOS, WSL curl -fsSL https://pie-project.org/install.sh | PIE_FLAVOR=vulkan bash # Linux without an NVIDIA GPU irm https://pie-project.org/install.ps1 | iex # Windows PowerShell -
설정 파일을 만들고 Hugging Face에서 모델을 가져옵니다.
pie config init pie model import Qwen/Qwen3.5-0.8B -
인퍼렛 파일을 만듭니다. 파일 확장자가 언어를 정합니다. 아래는 README의 Python 예제로, 토큰마다 순전파를 한 번씩 실행하는 그리디 텍스트 생성입니다.
from inferlet import chat, model from inferlet.eta import ForwardPass, Pipeline, WorkingSet, intrinsics, reduce_argmax async def main(input: dict) -> dict: tokens = chat.prefix() + model.encode(input.get("prompt", "The capital of France is")) max_tokens = int(input.get("max_tokens", 8)) ws = WorkingSet(tokens=len(tokens) + max_tokens) # KV pages (and recurrent state on a hybrid model) pipe = Pipeline() done = 0 # tokens already in the KV cache for _ in range(max_tokens): fwd = ForwardPass() fwd.embed(tokens[done:]) # the new tokens fwd.bind_state(ws, ws.geometry(done, len(tokens))) out = fwd.epilogue(lambda: reduce_argmax(intrinsics.logits())) # runs on the device pipe.submit(fwd) done = len(tokens) tokens.append(await out) pipe.close() return {"text": model.decode(tokens[-max_tokens:])} -
인퍼렛 파일이 있는 디렉터리에서 실행합니다.
pie run은 이 프로그램 하나를 위한 엔진을 시작했다가 끝냅니다.pie run main.py -- --prompt "The capital of France is"
논문의 예제와 비교하면 API 모양이 꽤 달라졌습니다. WorkingSet 이 KV 페이지(하이브리드 모델이면 순환 상태까지)를 묶어 관리하고, epilogue 에 넘긴 함수는 한 번 추적된 뒤 매 순전파 직후 GPU에서 실행됩니다. 호스트 쪽 인퍼렛은 GPU가 고른 토큰만 받습니다.
엔진을 계속 실행해 두려면 pie serve 를 쓰고, 다른 셸에서 pie-client(pip install pie-client)로 같은 파일을 제출합니다. pie serve 는 같은 포트에서 OpenAI(/v1/chat/completions, /v1/responses 등), Anthropic(/v1/messages), Google GenAI(:generateContent) 형식의 엔드포인트도 API 키 없이 제공합니다. README에 따르면 이 호환 API들도 각각 내장 인퍼렛으로 구현돼 있고, 도구 호출, JSON 스키마 출력, 스트리밍, 추론 출력을 지원합니다. 같은 서버를 프로세스 안에 넣어 쓰는 pie-server(PyPI)와 @pie-project/server(npm) 패키지도 있으며, npm 패키지는 번들러에서 쓰면 브라우저의 WebGPU 위에서 동작합니다.
문서와 저장소의 버전 차이
저장소가 빠르게 바뀌는 탓에, 2026년 10월 15일 기준으로 문서 사이트와 README가 서로 다른 버전을 설명합니다:
- 버전 표시: 문서 사이트 상단은 Pie 0.4.0 is out 을 표시하고, 최신 릴리스는 0.5.2입니다.
- 예제 경로: 문서의 예제 링크는
inferlets/디렉터리를 가리키지만 이 경로는 지금 404이고, 예제는examples/로 옮겨졌습니다. - 언어 지원 범위: 문서의 I/O 페이지는 Python과 JavaScript SDK에서 HTTP 요청을 pending 으로 적고, FAQ는 저수준
forward()API와 사용자 정의 추측기, 어댑터를 Rust 전용으로 적습니다. 반면 README의 Python 예제는 이미ForwardPass를 직접 씁니다. - 크레딧 경매: 문서의 스케줄링 페이지는
scheduling모듈의 크레딧 경매 API(Experimental)를 설명하지만, 현재 Python SDK README의 모듈 목록에는 이 모듈이 없습니다.
따라서 문서의 코드를 그대로 붙여 넣기 전에 examples/의 같은 이름 예제(예: quickstart-py, prefix-tree-kv-cache-py)와 대조하는 편이 안전합니다.
Pie를 써 볼 만한 경우와 아닌 경우
프로젝트 FAQ는 Pie를 연구, 프로토타이핑, 프로젝트를 따라 업데이트할 수 있는 내부 배포 용으로 쓰라고 안내합니다. 릴리스 사이에 API가 지원 중단 기간 없이 바뀐다고도 밝힙니다. 비교 페이지는 상태 없는 프롬프트를 연속으로 처리하는 워크로드에는 토큰당 오버헤드가 사용자 정의 최적화의 이득보다 커서 Pie가 맞지 않는다고 적습니다.
반대로 Pie가 맞는 경우는 논문 평가가 보여 준 조건과 겹칩니다. 에이전트가 한 작업에서 외부 도구를 여러 번 부르고, 도구 사이에 같은 문맥을 계속 쓰는 경우가 그렇습니다. 여러 갈래로 추론을 펼치면서 공통 앞부분의 KV 캐시를 프로그램이 직접 관리하고 싶은 경우도 해당합니다. 새 샘플러, 워터마킹, 제약 디코딩, 추측 디코딩을 엔진을 고치지 않고 요청 단위로 실험하려는 연구자도 대상입니다. 저장소의 examples/ 에는 빔 서치, 대조 디코딩(Contrastive Decoding), 미로스탯(Mirostat), SnapKV 축출, 어텐션 싱크, JSON 스키마 제약 디코딩, MTP(Multi-Token Prediction) 추측 디코딩 같은 예제가 인퍼렛으로 들어 있습니다.
도입을 검토한다면 다음을 확인해야 합니다. 논문의 보안 논의처럼, 인퍼렛은 엔진 안에서 KV 캐시와 토큰 분포에 접근합니다. 프로젝트 문서는 WASI(WebAssembly System Interface) 샌드박스가 다른 인퍼렛의 메모리 접근과 호스트 탈출을 막는다고 설명합니다. 그러나 다중 사용자 환경의 자원 고갈과 분포 노출 문제는 논문이 향후 과제로 남긴 부분입니다. 기존 서빙 엔진과 성능을 비교하려면 논문의 vLLM v0.6.0, SGLang v0.4.4 결과에 의존하지 말고, 지금 쓰는 버전과 같은 하드웨어에서 직접 재야 합니다.
Pie의 라이선스
Pie는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. NOTICE 파일에는 코드 일부를 가져오거나 파생한 XGrammar, FlashInfer, NIXL(Apache 2.0)과 MLX(MIT) 같은 구성 요소의 고지가 있습니다. 논문은 Creative Commons Attribution 4.0(CC BY 4.0)으로 공개됐습니다.
 Pie: A Programmable Serving System for Emerging LLM Applications 논문
 Pie 프로젝트 홈페이지
 Pie GitHub 저장소
더 읽어보기
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
