핵심 요약
- Strata는 1,250억(125B) 파라미터 MoE 모델 Qwen3.8-Flash-Next 하나만을 위해 작성한 추론(Inference) 엔진입니다. 12GB 이상 그래픽카드와 32GB 이상 RAM을 갖춘 Windows/Linux PC에서 이 모델을 실행합니다.
- 개발자가 RTX 5070(12GB)과 64GB RAM PC에서 측정한 짧은 대화의 생성 속도는 2비트 Q2_0 기준 초당 94토큰, 기본 크기 중 가장 큰 IQ3_S 기준 초당 53토큰입니다.
- 그래픽카드에는 자주 쓰이는 전문가(expert)만 두고, 전문가 2만 4,576개 전체는 RAM에 둔 채 CPU가 나머지를 동시에 계산합니다. 모델에 들어 있는 다중 토큰 예측(MTP) 층으로 여러 토큰을 한 번에 검증해 생성 속도를 1.6~1.8배 높입니다.
- 같은 RTX 3060 PC에서 개발자가 비교한 llama.cpp v0.6.0 대비 생성 속도는 약 4.6배였지만, llama.cpp 쪽 튜닝 범위가 좁았다고 개발자 스스로 밝힌 자체 측정입니다.
- OpenAI와 Anthropic 호환 API를
127.0.0.1:8080에 열어 코딩 에이전트를 연결할 수 있고, 기본 설정은 한 번에 한 요청만 처리합니다.
Strata 소개
Qwen3.8-Flash-Next (
 Qwen3.8-Flash-Next, 1/9의 학습 비용으로 Qwen3.7-Plus(397B-A17B) 수준에 도달한 125B-A6B 모델)는 전체 125B 파라미터 중 토큰마다 6B만 활성화하는 전문가 혼합(Mixture of Experts, MoE) 모델입니다. 활성 파라미터가 작아도 가중치 전체는 어딘가에 올려 두어야 하고, Strata 개발자에 따르면 쓸 만한 품질을 내는 가장 작은 양자화(quantization) 파일도 66GB로 12GB 그래픽카드 메모리의 5.5배입니다. 보통은 llama.cpp 같은 범용 엔진으로 일부 가중치를 시스템 RAM에 두고 CPU에서 계산합니다. 개발자는 이 방식이 동작은 하지만 PC의 대부분을 대부분의 시간 동안 놀게 둔다고 지적합니다. 이번에 소개하는 Strata는 이 모델 하나만을 위해 추론 엔진을 새로 작성해, 게이밍 PC의 그래픽카드와 CPU, RAM, SSD가 각자 잘하는 일을 동시에 맡도록 만든 프로젝트입니다.
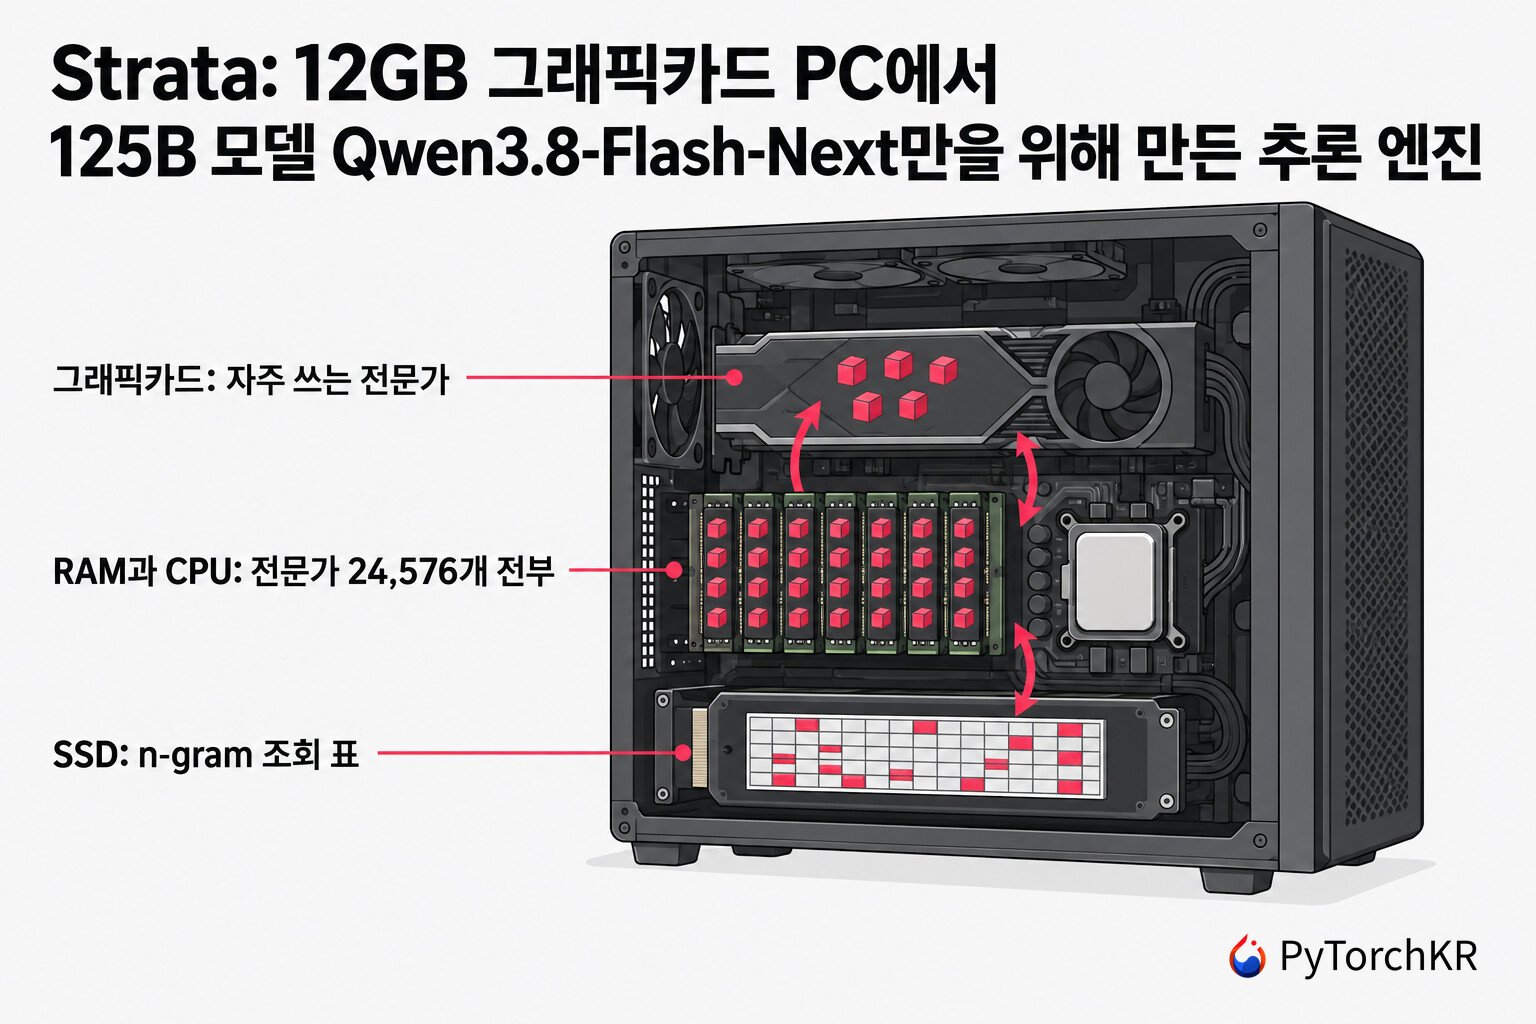
Strata는 범용성을 포기하는 대신 모델의 구조에 맞춰 메모리 배치를 정합니다. Qwen3.8-Flash-Next는 층마다 전문가 512개 중 10개만 고르기 때문에, 토큰 하나가 읽는 전문가 가중치는 전체의 2% 정도입니다. Strata는 매 토큰에 필요한 공통 부분(약 3.5GB)과 자주 쓰이는 전문가 수천 개를 그래픽카드에 두고, 나머지 전문가는 RAM에 둔 채 CPU가 그래픽카드와 같은 순간에 계산하게 합니다. 개발자는 이렇게 모델 하나에 맞춘 엔진을 만드는 발상을 Splash ( Splash: 범용 엔진 대신 모델마다 커널과 초안 모델을 새로 만드는 Apple Silicon 추론 엔진), ninfer, HyperQwen에서 가져왔다고 밝히고 있습니다.
아래 영상은 RTX 5070 PC에서 Strata로 실행한 IQ3_S 모델이 프롬프트 한 번으로 작성한 복셀(voxel) 탑 정원 웹 페이지입니다(128K 컨텍스트, 49초):
https://github.com/Niko1221/Strata/releases/download/v0.1.10/Pagoda.mp4
Strata의 엔진은 C++과 CUDA(NVIDIA), HIP(AMD)로 작성되어 있고, Python 서버가 OpenAI와 Anthropic 호환 API, 채팅 화면과 모니터 화면이 있는 웹 앱을 제공합니다. 설치 프로그램은 PC의 그래픽카드와 RAM을 확인해 모델 크기를 추천하고, 모델 파일(약 70GB)을 내려받아 바로 실행합니다. 모델 파일은 ISTA-DASLab이 GSQ-RCO 방식으로 압축한 GGUF를 기본으로 쓰며, 양자화 형식과 CPU 계산 일부는 llama.cpp의 ggml 코드를 가져다 씁니다. 저장소는 2026년 9월 24일에 만들어졌고 10월 14일 v0.1.44.1까지 거의 매일 릴리스가 나와서, 문서의 측정값마다 어느 엔진 버전에서 쟀는지가 함께 적혀 있습니다.
Strata vs. llama.cpp
같은 모델을 일반 PC에서 실행하는 기존 방법은 llama.cpp에서 전문가 층 일부를 CPU로 보내는 --n-cpu-moe 옵션을 쓰는 것입니다. Strata 개발자는 RTX 3060(12GB), RAM 46GB, Core Ultra 7 265를 갖춘 Linux PC에서 같은 IQ3_XXS GGUF 파일로 두 엔진을 번갈아 실행해 비교했습니다. 아래는 그 비교 기록의 온도 0, 256토큰 생성 조건 중앙값입니다:
| 항목 | Strata (엔진 v0.1.40) | llama.cpp v0.6.0 (튜닝, MTP 끔) |
|---|---|---|
| 4K 프롬프트 읽기 | 915.7 tok/s | 328 tok/s |
| 4K 생성 | 41.6 tok/s | 9.1 tok/s |
| 32K 프롬프트 읽기 | 1,050 tok/s | 294 tok/s |
| 32K 생성 | 41.8 tok/s | 8.8 tok/s |
| 32K 첫 토큰까지 걸린 시간 | 30.5초 | 109.0초 |
개발자는 생성 속도 차이의 주된 원인으로 CPU에 남는 전문가 계산을 듭니다. llama.cpp에 Unsloth가 배포한 별도의 MTP 헤드를 붙이자 4K 생성이 초당 9.1토큰에서 7.0토큰으로 오히려 느려졌습니다. 개발자는 이 헤드가 VRAM 3.4GB를 차지해 전문가 층이 더 많이 CPU로 밀려났기 때문이라고 설명합니다. Tesla P100(16GB) PC에서도 같은 방식으로 비교했고, 여기서는 생성 속도가 3.0~3.6배 차이 났습니다.
이 수치는 Strata 개발자가 직접 측정해 공개한 값이고, 개발자가 붙인 단서도 함께 봐야 합니다. 엔진마다 3라운드(32K는 요청 3건)만 돌렸고, llama.cpp 튜닝은 -ncmoe와 -ub 두 값만 좁게 훑었으며 텐서별 -ot 패턴과 스레드 수는 조정하지 않았습니다. 모델 크기도 IQ3_XXS 하나뿐이고 perplexity와 KL 같은 품질 비교는 이 기록에 없습니다. 품질 쪽으로는 Strata 논문이 llama.cpp 대비 다음 토큰 분포의 평균 KL 발산(Kullback-Leibler Divergence)이 0.022로, llama.cpp 자체의 CPU 빌드와 GPU 빌드 사이 차이(0.058)보다 작다고 보고합니다.
소비자 PC의 GPU와 CPU, 메모리를 함께 써서 큰 모델을 서빙하는 문제는 PowerInfer나 FreeToken 같은 연구에서도 다뤄졌습니다. Strata 논문은 Fiddler, KTransformers, MoE-Infinity를 관련 연구로 듭니다. Strata는 이 문제를 모델 하나로 좁히고, 설치 프로그램과 API 서버까지 함께 묶어 일반 사용자가 바로 실행할 수 있게 했다는 점이 다릅니다.
Strata를 사용하면 좋을 사용자
Strata는 64GB 안팎의 RAM과 12~24GB 그래픽카드를 가진 PC에서 큰 MoE 모델을 로컬로 돌려 보고 싶은 개발자에게 맞습니다. 대화 내용과 코드가 외부 API로 나가면 안 되는 상황에서 코딩 에이전트의 백엔드로 쓰기 좋습니다. 개발자가 공개한 측정값과 설치 과정이 모두 일반 게이밍 PC 기준이라, 자기 PC에서 어느 정도 속도가 나올지 가늠하기도 쉽습니다. 한국어 사용자라면 0.1.27부터 MTP 초안 층이 한중일(CJK) 토큰 10만 6,299개를 모두 제안할 수 있게 바뀌어, 개발자 측정(Q2_0, RTX 5070)으로 이 언어들의 답변이 15~38% 빨라졌다는 점도 참고할 만합니다. 다만 RAM 32GB PC에 맞춘 Coder 버전은 전문가 절반을 코드 데이터 기준으로 걸러 낸 모델이라 영어가 아닌 언어에 약합니다. 중국어 답변이 반복되거나 틀린 사례(#438)도 보고되었는데, 전문가를 모두 남긴 원본 크기에서는 재현되지 않았습니다.
다른 모델을 함께 쓰거나 여러 사람이 동시에 접속하는 팀 서버가 목적이라면 Strata는 아직 적절한 선택지가 아닙니다. Strata가 실행하는 모델은 Qwen3.8-Flash-Next와 그 파생 버전뿐입니다. 기본 설정은 한 번에 한 요청만 처리하고, "parallel": 2로 늘리면 12GB 그래픽카드에서는 답변마다 느려집니다. 서버는 아직 외부 보안 감사를 받지 않았고, 엔진이 거의 매일 바뀌어서 오래 고정해 둘 운영 환경보다는 개인 실험 환경에 더 맞습니다.
Strata의 동작 원리
그래픽카드, RAM, SSD에 나눠 담은 전문가
아래 그림은 Strata가 모델을 PC의 각 부분에 나눠 두는 방식입니다. 위 칸의 "24,576 small specialists"가 전문가이고, 아래 세 칸은 각각 Graphics card, RAM + processor, SSD입니다:
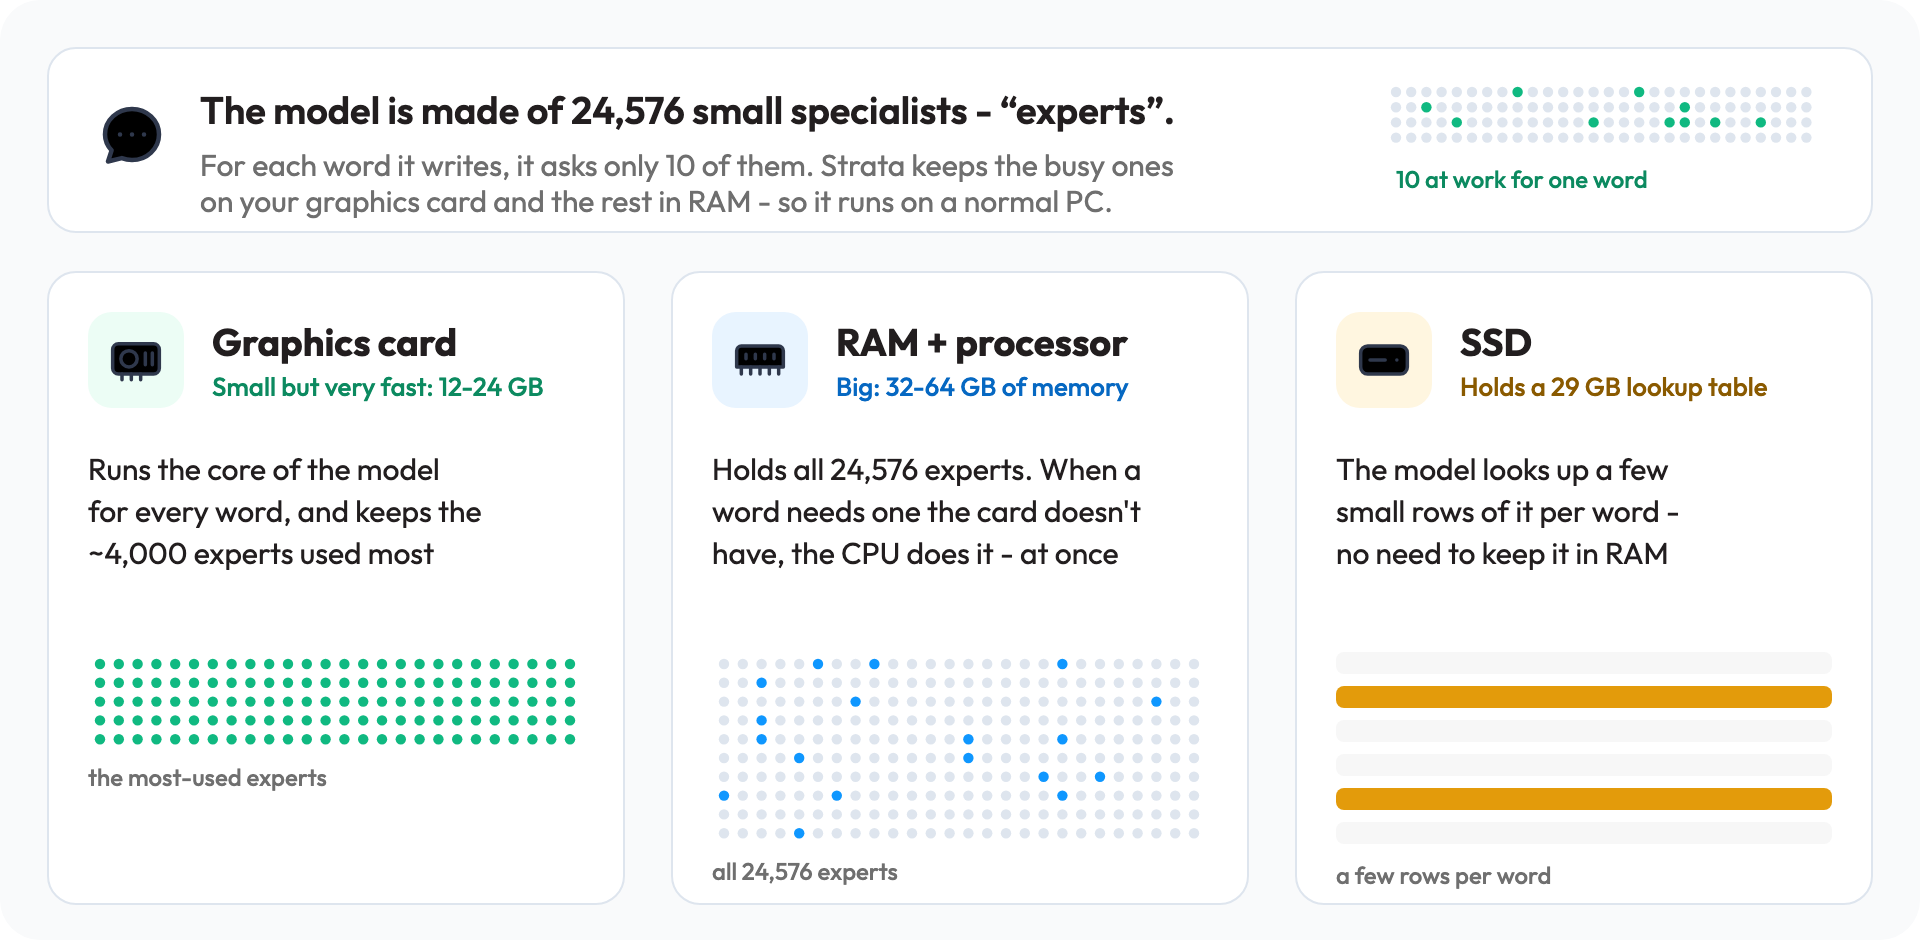
그래픽카드(VRAM)에는 모든 토큰이 거치는 부분이 올라갑니다: Gated DeltaNet과 Qwen 희소 어텐션(Qwen Sparse Attention) 믹서, 라우터, 공유 전문가, 출력 헤드, MTP 초안 층, KV(Key-Value) 캐시입니다. 남는 VRAM은 자주 쓰이는 전문가를 담는 전문가 캐시가 채웁니다. 논문 측정(Q2_0, 4K 컨텍스트)으로 12GB 그래픽카드에는 약 4,500개가 들어가고, 개발자는 VRAM이 1GB 늘 때마다 전문가가 약 700개 더 들어간다며 그래픽카드의 계산 속도보다 VRAM 용량이 더 중요하다고 설명합니다. RAM에는 전문가 2만 4,576개 전체가 페이지 잠금(pinned) 상태로 올라갑니다. VRAM에 없는 전문가는 CPU가 RAM 안에서 바로 계산합니다(AVX-512 또는 AVX2 커널). SSD에는 28.8GB 크기의 N-gram 임베딩 표가 남고, 엔진은 토큰마다 필요한 16개 행을 한 단계 앞서 읽어 둡니다.
층 하나를 처리하는 과정은 이렇습니다. 그래픽카드가 라우터를 실행해 선택된 전문가 10개의 번호를 CPU 쪽 고정(pinned) 메모리에 적으면, 이를 기다리던 CPU가 곧바로 전문가를 나눕니다. VRAM 캐시에 있는 전문가는 그래픽카드가, 일부는 PCIe로 복사해 그래픽카드가, 나머지는 CPU가 맡고, 각 결과를 그래픽카드가 합친 뒤 다음 층으로 넘어갑니다. 0.1.42부터 CUDA 빌드의 기본값은 VRAM에 없는 전문가 중, 함께 처리하는 토큰들이 모두 상위 10개 중 7위 이하로만 고른 전문가를 계산하지 않고 건너뜁니다. 개발자 측정으로 생성 속도는 약 13~16% 빨라지지만, 건너뛰지 않을 때와 다음 토큰 1순위가 일치하는 비율은 97.5~98.2%로 답이 조금 달라집니다(STRATA_ROUTE_TAIL_SKIP=0으로 끌 수 있음). 전문가 캐시는 대화가 이어지는 동안 그 대화가 자주 부르는 전문가로 바뀝니다. 논문에 따르면 다른 프롬프트로 만든 고정 프로필은 전문가의 50%를 VRAM에서 처리했지만, 대화에 맞춰 교체하면 이 비율이 약 72%로 올라갑니다.
추측 후 검증: MTP 층을 이용한 투기적 디코딩
Strata는 Qwen3.8-Flash-Next에 들어 있는 다중 토큰 예측(Multi-Token Prediction, MTP) 층을 초안 모델로 써서 투기적 디코딩(Speculative Decoding)을 합니다. 아래 그림의 Helper guesses 줄이 MTP 층이 추측한 토큰이고, Big model checks 줄이 본 모델이 한 번에 검증한 결과입니다:
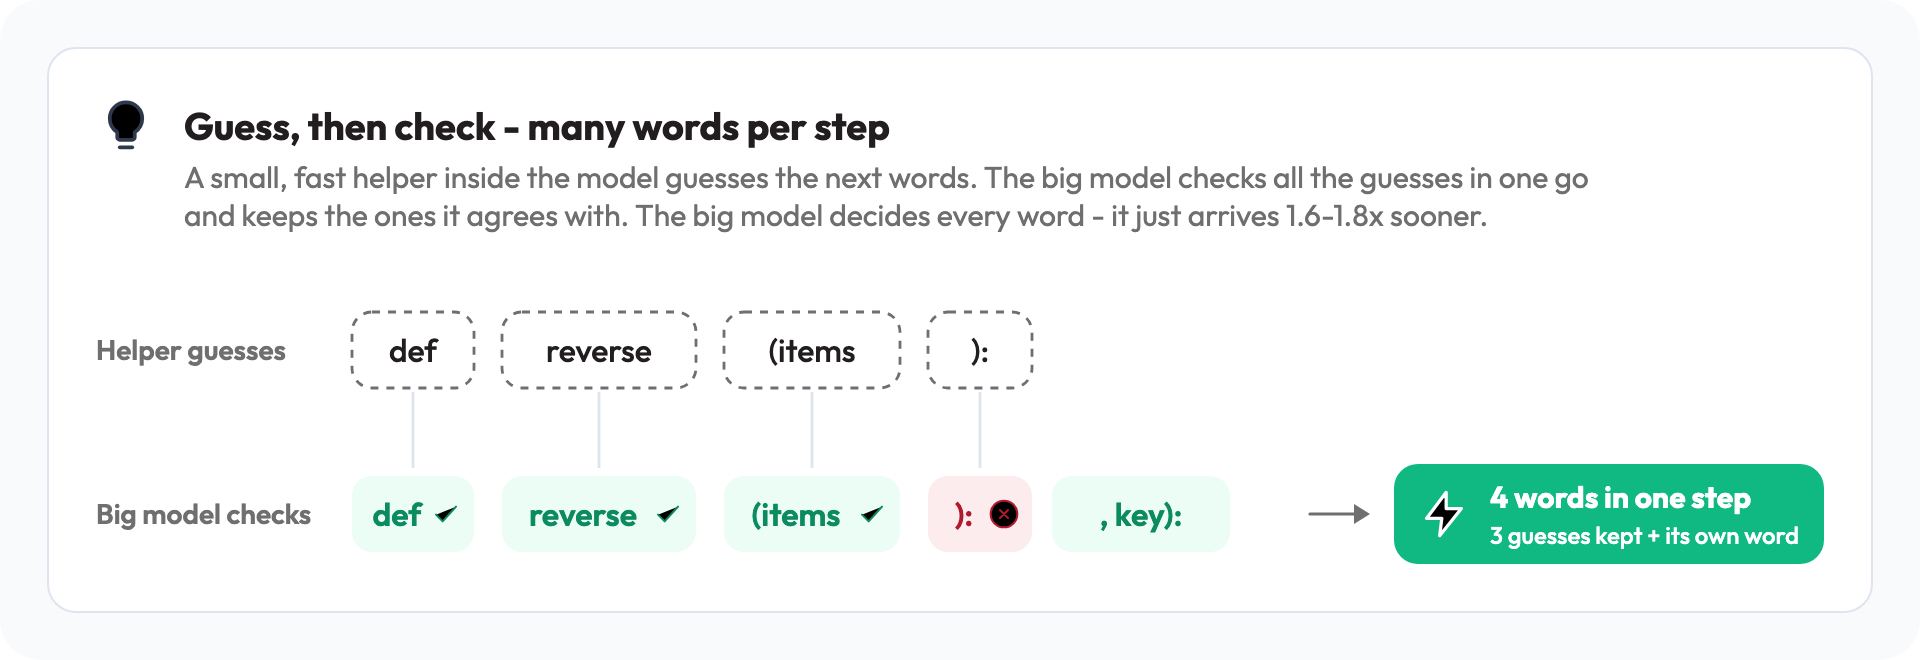
MTP 층은 다음 토큰을 최대 3개까지 추측합니다. 본 모델은 48개 층을 한 번 통과하면서 추측을 모두 확인해 맞는 것만 남기고, 한 토큰을 직접 더 씁니다. 추측은 MTP 층의 확신이 50% 이상일 때만 넣고, 한 번 통과할 때 평균 2.4~3.2토큰이 나옵니다. 그 결과 생성 속도는 1.6~1.8배 빨라집니다. 모델 전체가 VRAM에 있는 엔진들이 보고하는 2.5~3배보다 작은 이유를 개발자는 추측한 토큰마다 서로 다른 전문가를 불러 CPU 계산이 늘어나기 때문이라고 설명합니다. 본 모델이 모든 토큰을 결정하므로, 논문(2026년 9월 엔진)은 결과가 일반 탐욕(greedy) 디코딩과 토큰 단위로 같다고 보고합니다. 다만 현재 기본 설정에서는 앞의 하위 전문가 생략이 함께 검증하는 토큰 구성에 따라 달라지고, IQ 계열 크기에서는 CPU가 전문가를 한 토큰씩 계산할 때와 여러 토큰을 묶어 계산할 때 반올림도 조금 다릅니다. 그래서 온도 0에서도 초안 구성에 따라 답이 달라질 수 있습니다.
긴 프롬프트와 긴 컨텍스트 처리
Strata는 프롬프트를 최대 8,192토큰 단위로 나눠 읽습니다(Q2_0은 2,048토큰 고정). 프롬프트 처리 중에는 그래픽카드가 지금 층의 어텐션을 계산하는 동안 다음 층의 전문가를 PCIe로 미리 옮기고, 첫 메시지 이후에는 대화 상태를 재사용해 새로 들어온 부분만 읽습니다. 그래서 첫 메시지는 3만 토큰당 약 1분이 걸리지만 이어지는 메시지는 몇 초 안에 시작됩니다. 컨텍스트가 길어질 때의 비용은 주로 VRAM에서 나옵니다. 이를 줄이려고 64K 이상에서는 KV 캐시 대부분을 RAM에 두고 어텐션이 읽는 부분만 VRAM에 남겨 전문가 캐시 자리를 확보합니다(Q2_0, 262K에서 VRAM 전문가 1,589개 → 3,872개).
Strata의 모델 크기 선택과 측정 속도
Strata는 같은 모델을 압축 정도가 다른 여러 크기로 제공하고, 설치 프로그램이 RAM 용량에 맞춰 하나를 추천합니다. 저장소의 모델 선택 문서 기준 권장 조합은 다음과 같습니다:
| RAM | 권장 크기 | 이유 |
|---|---|---|
| 32GB | Coder | 32GB RAM에 들어가며 코드 작업용 (24GB 그래픽카드라면 Q2_0과 IQ2_XS도 실행 가능) |
| 48GB | IQ2_XS (또는 가장 빠른 Q2_0) | 더 큰 크기는 들어가지 않음 |
| 64GB | IQ2_XS (권장), 또는 IQ3_XXS / IQ3_S | 모든 크기가 들어감, IQ3_S가 품질은 가장 좋고 속도는 가장 느림 |
| 96GB 이상 | IQ3_S, 또는 Unsloth의 UD-IQ4_XS(약 4비트) | 다른 프로그램을 열어 둔 채로 큰 크기 실행 |
크기 외에 버전도 고를 수 있습니다. Coder는 ISTA-DASLab이 층마다 전문가 512개 중 256개만 남긴 코딩 버전으로, 저자 측정 기준 원본 SWE-bench Verified 점수의 91%를 냅니다. Swift 1.5는 UkisAI가 생각하는 시간을 줄이도록 미세 조정한 버전이고, Unsloth의 4~8비트 파일은 RAM이 충분한 PC에서 원본에 더 가까운 품질을 냅니다.
개발자가 RTX 5070(12GB), Ryzen 5 7600, 64GB RAM PC에서 측정한 크기별 속도는 다음과 같습니다(Q2_0은 엔진 0.1.36, 나머지는 0.1.26, 프롬프트 읽기는 32K 토큰 기준). 마지막 열은 ISTA-DASLab이 측정한 AIME25, GPQA-Diamond, LiveCodeBench v6 세 과제의 평균 점수로, BF16 원본 모델은 93.12입니다:
| 크기 | 생성 (짧은 대화) | 생성 (128K 컨텍스트) | 프롬프트 읽기 | 품질 (과제 평균) |
|---|---|---|---|---|
| Q2_0 | 94 tok/s | 76 tok/s | 2,650 tok/s | 89.07 |
| IQ2_XS | 79 tok/s | 63 tok/s | 2,090 tok/s | 89.16 |
| IQ3_XXS | 62 tok/s | 49 tok/s | 1,750 tok/s | 92.57 |
| IQ3_S | 53 tok/s | 46 tok/s | 1,620 tok/s | 93.26 |
| Coder (IQ1_M) | 55 tok/s | 43 tok/s | 2,180 tok/s | - |
AMD RX 9070 XT(16GB) PC에서는 짧은 대화 생성이 Q2_0 초당 60토큰, IQ2_XS 초당 52토큰으로 측정되었습니다. 저장소의 논문 PDF는 2026년 9월 엔진으로 측정해 프롬프트 읽기 속도가 초당 285~571토큰으로 적혀 있으므로, 최신 수치는 README와 상세 문서를 기준으로 보시기 바랍니다. 다른 그래픽카드의 실측값은 커뮤니티 측정 결과에 모여 있고, PyTorchKR에도 Strata를 포크해 RTX 4090에서 A/B 비교를 재현한 Juud_engine 글이 올라와 있습니다.
Strata 설치와 사용
Strata를 설치하려면 VRAM 12GB 이상인 NVIDIA RTX 20~50 시리즈 또는 지원 목록의 AMD Radeon 그래픽카드가 필요합니다. 그 밖에 RAM 32GB 이상, 약 80GB의 여유 디스크 공간(AVX-512 CPU에서 Q2_0을 쓰면 약 40GB 추가), Windows 10/11 또는 Linux를 갖춰야 합니다. 그래픽카드 드라이버(NVIDIA는 580 이상)만 직접 설치하면 나머지(Python, 엔진, 모델)는 설치 프로그램이 준비합니다. Windows에서는 저장소를 내려받아 START-HERE.bat을 더블클릭하고, Linux에서는 다음과 같이 실행합니다:
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
설치 프로그램이 모델 크기, 컨텍스트 길이, 이미지 입력 사용 여부를 묻고, Enter만 누르면 권장값으로 진행합니다. Claude Code나 Codex CLI 같은 AI 코딩 도구를 쓰고 있다면 아래 문장을 붙여 넣어 설치를 맡길 수도 있습니다. 이때 도구는 저장소의 AI 에이전트용 설치 안내를 따라 PC를 점검하고 모델을 고릅니다:
Set up Strata on this PC for me: https://github.com/Niko1221/Strata - follow docs/AI_SETUP.md in that repository.
모델을 처음 올리는 1~3분 동안 PC가 느려지거나 멈춘 것처럼 보일 수 있습니다. Strata가 35~55GB를 RAM에 올리고 그중 일부를 그래픽카드용으로 잠그기 때문입니다. 이때 창을 닫지 말고 기다리면 됩니다. 다음부터는 같은 START-HERE.bat이나 ./setup.sh로 바로 시작하고, 내 PC에서의 속도는 BENCH.bat(./bench.sh)으로 5~10분 안에 측정할 수 있습니다. 설치 중 묻는 experimental speed projection 옵션(기본값 꺼짐)은 이름과 달리 모델의 거절 방향을 제거하는 벡터로, 개발자는 이 옵션을 켜면 모델의 안전 동작이 사라진다고 밝히고 있습니다. Apple Silicon Mac(M1~M5), Intel Arc, AMD Ryzen AI Max(Strix Halo)는 커뮤니티가 작성하고 시험한 실험적 경로로, 직접 소스를 빌드해 실행합니다.
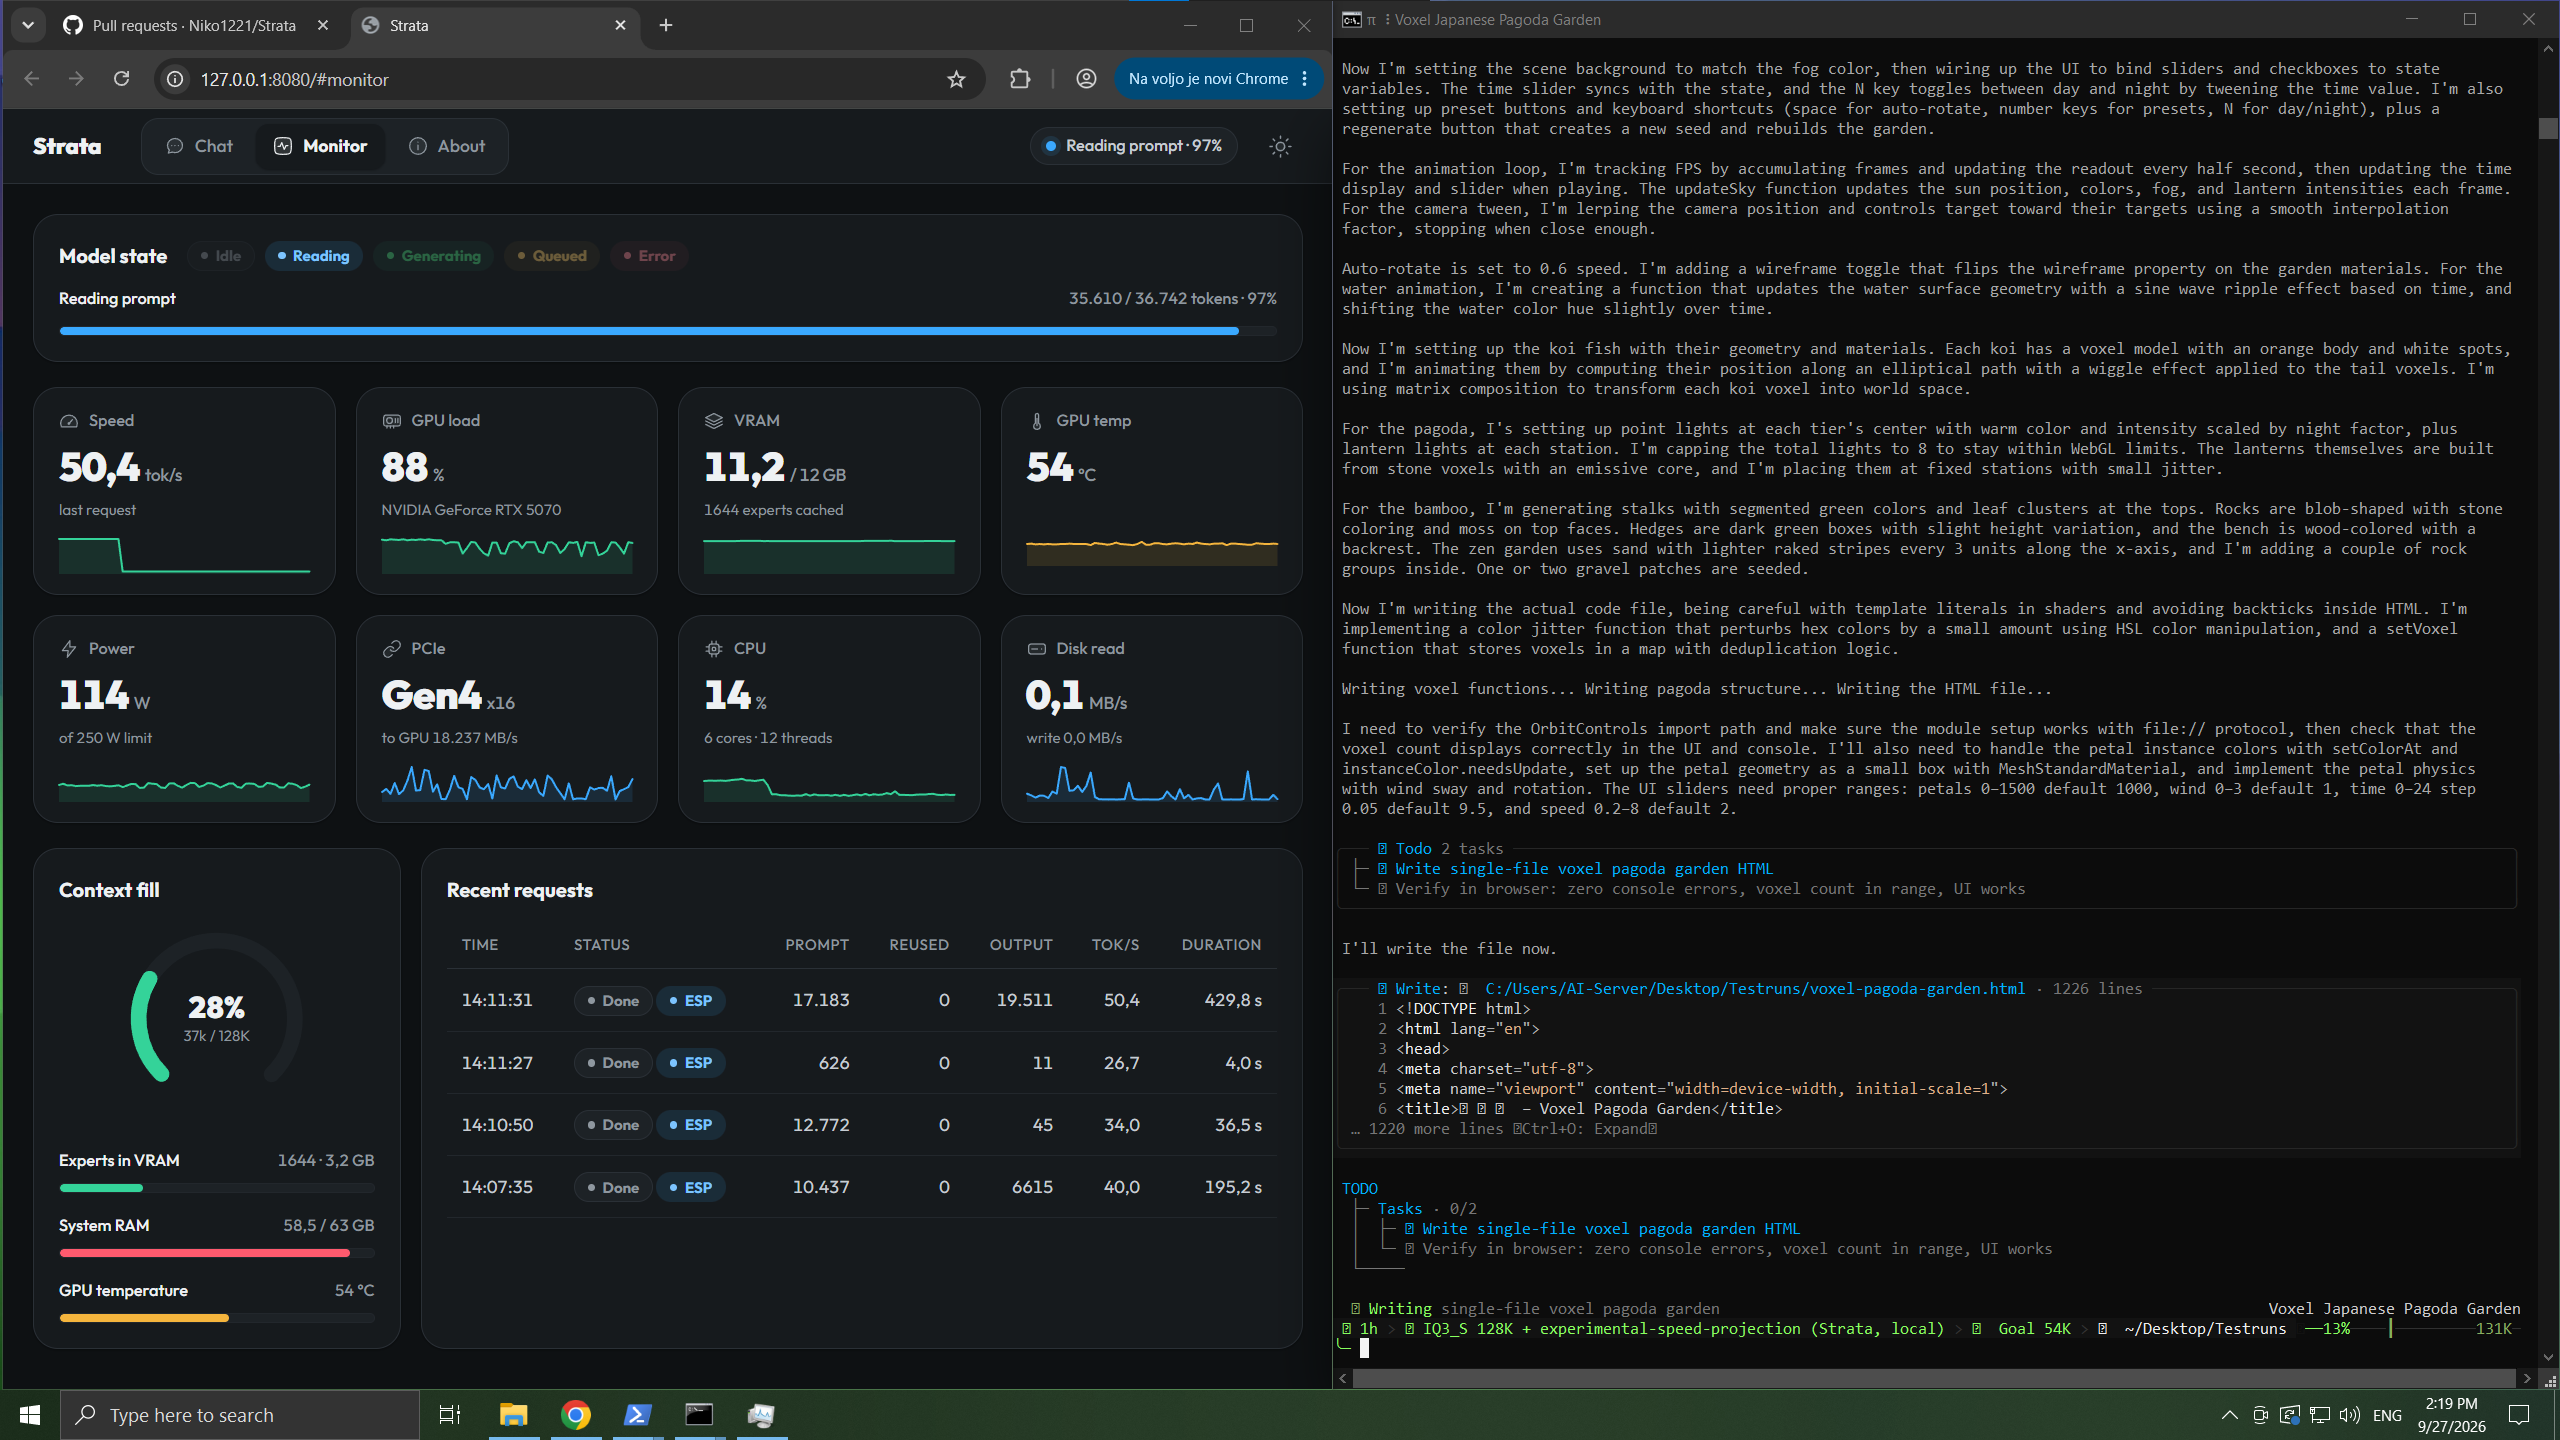
실행이 끝나면 브라우저에서 http://127.0.0.1:8080을 열어 채팅과 Monitor 탭을 쓸 수 있습니다. 아래는 Strata 앱의 Monitor 탭(왼쪽)과 영상 속 탑 정원을 작성하는 코딩 에이전트(오른쪽)를 나란히 띄운 화면입니다:
다른 앱과 코딩 에이전트에서는 OpenAI 호환 공급자의 기본 URL을 http://127.0.0.1:8080/v1로 지정하면 되고, API 키와 모델 이름은 아무 값이나 받습니다. Anthropic API를 쓰는 Claude Code는 ANTHROPIC_BASE_URL=http://127.0.0.1:8080으로, Codex CLI는 OpenAI Responses API 경로(/v1/responses)로 연결합니다. Python에서는 OpenAI SDK로 다음과 같이 호출합니다:
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8080/v1", api_key="none")
r = client.chat.completions.create(model="strata", messages=[{"role": "user", "content": "Hello!"}])
print(r.choices[0].message.content)
설치할 때 이미지 입력을 켜면 채팅이나 API로 그림을 함께 보낼 수 있는데, AMD 그래픽카드는 Linux에서만 CPU로 그림을 처리합니다. 그래픽카드 2~3장에 모델을 나눠 올리는 다중 GPU 구성도 지원합니다. 모델이 답하기 전에 생각하는 정도는 요청마다 reasoning_effort로 none, low, medium, high 중에서 고를 수 있고, 지정하지 않으면 모델 기본값인 high를 씁니다. 서버는 기본적으로 127.0.0.1에서만 접속을 받으며, 개발자는 휴대폰이나 다른 PC에서 접속하려면 --host 0.0.0.0과 함께 반드시 --api-key를 지정하라고 보안 정책에서 안내합니다. 서버 코드의 telemetry 모듈은 Monitor 탭에 보여 줄 GPU, CPU, RAM 사용량을 로컬에서 수집하는 용도입니다.
Strata의 라이선스
Strata는 MIT 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다.
단, 모델 파일은 저장소에 포함되지 않고 각자의 라이선스를 따르므로 상업적 사용 전에는 따로 확인해야 합니다. 원본 Qwen3.8-Flash-Next는 Qwen Community License 1.0을 따릅니다. 이 라이선스에 따르면 모델을 API로 제공하는 서비스(Model as a Service)나 AI 코딩 및 업무 보조 서비스를 사업으로 하는 경우, 상업적으로 쓰기 전에 Qwen에서 별도 라이선스를 받아야 합니다. 외부에 제공하지 않는 사내 사용은 이 조건에서 제외되고, 월간 활성 사용자 1억 명 또는 월 매출 2,000만 달러를 넘는 서비스는 모델 이름을 화면에 표시해야 합니다. 저장소 안의 data/experimental-speed-projection 벡터도 모델 활성값에서 만든 파일이라 같은 Qwen Community License 1.0을 따릅니다.
 Strata 논문 (Running a 125-Billion-Parameter Model on a Normal PC)
 Strata 프로젝트 GitHub 저장소
 Strata가 기본으로 쓰는 Qwen3.8-Flash-Next GSQ-RCO 양자화 모델
더 읽어보기
-
Qwen3.8-Flash-Next, 1/9의 학습 비용으로 Qwen3.7-Plus(397B-A17B) 수준에 도달한 125B-A6B 모델
-
FreeToken: 프론티어급 MoE 모델을 게이밍 데스크톱 수준에서 서빙하기 위한 Edge-Serving에 대한 연구
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
