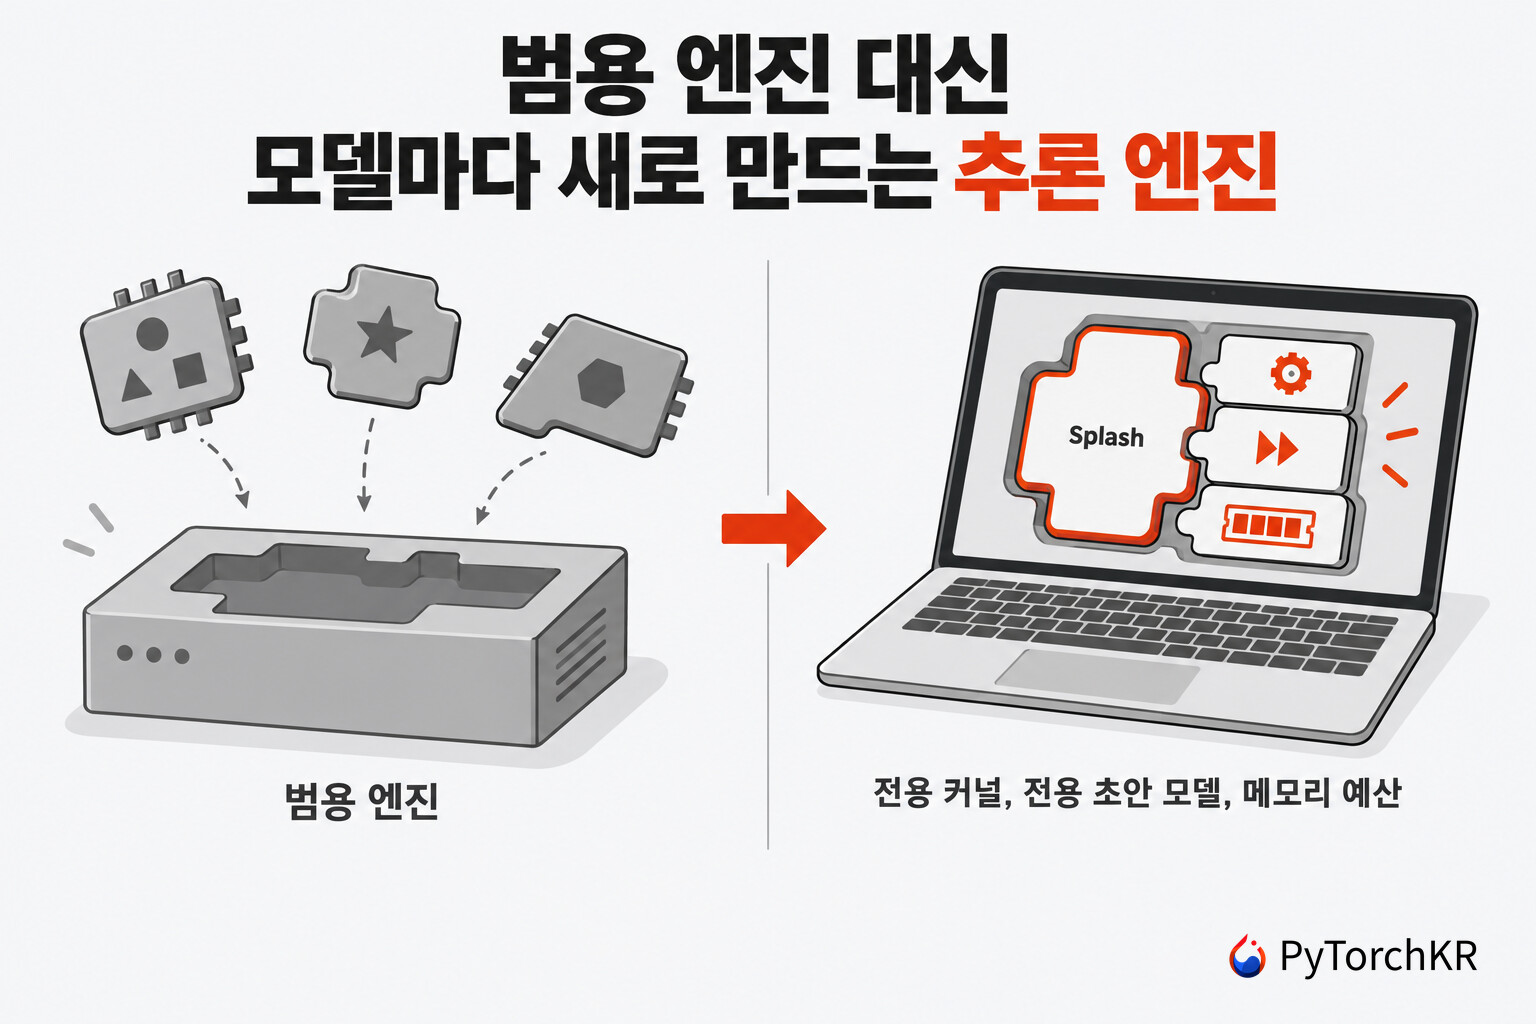
Splash 소개
Splash는 Inco AI가 2026년 9월 17일 Apache-2.0 라이선스로 공개한 Apple Silicon 전용 로컬 추론 엔진입니다. 아무 모델이나 받아 주는 범용 런타임(Runtime)을 포기하는 대신, 지원하는 모델 하나하나에 맞춰 커널과 초안 모델(Draft Model)과 메모리 계획(Memory Plan)을 새로 만들어 넣었습니다. 48GB 메모리의 M5 Pro 맥에서 Qwen3.8-27B를 짧은 프롬프트 기준 초당 74토큰으로 디코딩하고(32K 프롬프트에서는 초당 54토큰), 32K 컨텍스트가 캐시에 남아 있으면 첫 토큰을 282ms 만에 돌려줍니다.
맥에서 모델을 직접 실행하는 선택지는 이미 여러 가지가 나와 있습니다. Ollama와 llama.cpp는 GGUF 파일 하나만 있으면 어떤 모델이든 실행해 주고, Apple의 MLX를 감싼 oMLX나 여러 런타임을 함께 묶은 LM Studio는 거기에 서버와 관리 화면을 더했습니다. 이들의 설계 목표는 범용성입니다. 모델이 바뀌어도 같은 런타임이 받아 주려면 커널은 여러 형상(shape)을 다 처리할 수 있어야 하고, 메모리 정책은 어떤 크기의 가중치가 올라와도 터지지 않도록 여유를 남겨 둬야 합니다. 그 여유가 곧 성능의 상한이 됩니다.
문제는 로컬 모델의 주된 용처가 채팅에서 코딩 에이전트로 옮겨 가면서 이 상한이 실제로 걸리기 시작했다는 것입니다. 에이전트는 저장소를 읽고 파일을 고치고 테스트를 실행한 결과를 다시 대화에 넣기 때문에 컨텍스트가 계속 늘어나고, 서브 에이전트로 나뉘면 같은 대화 기록을 공유하는 요청이 동시에 여러 개 들어옵니다. 한 번에 한 요청만 처리하거나 매 턴마다 저장소를 다시 읽는 엔진은 이 흐름에서 버티지 못합니다. 커뮤니티에서도 에이전트 코딩에 로컬 LLM을 쓰는 방법이나 소형 로컬 모델에 맞춘 터미널 코딩 에이전트가 꾸준히 다뤄졌는데, 걸림돌은 대체로 모델 품질이 아니라 이런 서빙 쪽에 있었습니다.
Inco AI가 택한 방향은 가정을 뒤집는 것입니다. 엔진이 모델을 받아 주는 것이 아니라 엔진을 모델에 맞춰 만들고, 그렇게 만든 패키지만 지원합니다. 같은 기술로 데이터센터 GPU에서 Inco 추론 플랫폼을 운영하면서 Kimi K3, MiniMax M3, GLM 5.3, GLM 5.3 Flash, DeepSeek V4.1 Flash 5종에 대해 Artificial Analysis 출력 속도 1위를 기록했고, 이번에 같은 접근을 Apple Silicon으로 옮겨 온 것이 Splash입니다. 저자들은 글의 마지막을 "엔진은 모델을 중심으로 만들어진다(The engine is built around the model)" 라는 한 문장으로 마무리합니다.
brew 한 줄로 끝나는 설치와 실행
Splash를 실행하려면 M3 이상의 맥, macOS 26.4 이상, 통합 메모리 36GB 이상(48GB 이상 권장), 그리고 Homebrew가 필요합니다. 설치와 서빙은 두 줄입니다.
brew install incoai/tap/splash
splash serve --model incoai/Qwen3.8-27B-Splash
첫 실행에서 모델 패키지를 내려받아 검증하고, 사용 가능한 메모리를 확인한 뒤 시스템 구성에 맞춰 엔진을 자동으로 튜닝합니다. Ready 가 찍히면 127.0.0.1:8000 에서 서빙이 시작되므로 다른 터미널에서 호출하거나 에이전트를 연결하면 됩니다.
curl http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "incoai/Qwen3.8-27B-Splash",
    "messages": [{"role": "user", "content": "Explain speculative decoding in one sentence."}]
  }'
코딩 에이전트는 서브커맨드 하나로 연결됩니다. OpenCode, Claude Code, Codex, Hermes가 대상입니다.
splash opencode
splash claude
splash codex
splash hermes
서버는 OpenAI Chat Completions(/v1/chat/completions), OpenAI Responses(/v1/responses), Anthropic Messages(/v1/messages)를 모두 받고, 스트리밍과 도구 호출, JSON Schema 출력, 이미지와 인라인 PDF 입력을 지원합니다. 모델을 실행하지 않고 토큰 ID와 렌더링된 프롬프트만 돌려주는 /tokenize 와 /apply-template 도 있습니다. 설정 파일은 없고, 동시에 실행 중인 다른 앱을 위해 상한만 지정하는 --max-memory 와 --max-context 정도가 조절 가능한 전부입니다.
Inco AI는 LM Studio 팀과 함께 출시 당일부터 LM Studio Bionic에 Splash를 1급 추론 엔진으로 넣었습니다. Settings → Runtime 에서 Splash를 내려받고 Qwen3.8-27B를 받으면 LM Studio로 로컬 코딩 에이전트를 구성하는 흐름에 그대로 얹을 수 있습니다.
아래는 Splash 위에서 Qwen3.8-27B를 OpenCode로 구동하는 Inco AI의 데모 영상입니다.
엔진을 모델에 맞춰 다시 만드는 설계
Splash가 지원하는 모델은 현재 2종뿐이고, 각각에 대해 엔진이 따로 만들어집니다. 런타임과 스케줄러, 캐시, API는 공유하지만 그 밖의 요소는 모델마다 다시 제작합니다. 모델의 형상에 정확히 맞춰 융합한 Metal 커널, 그 모델을 위해 학습한 초안 모델, 최적화한 메모리 계획, 그리고 고정된 성능 기준선이 여기에 해당합니다. 사용자가 받는 것은 MLX나 Transformers 체크포인트가 아니라 이 모든 것이 들어 있는 하나의 Splash 패키지입니다.
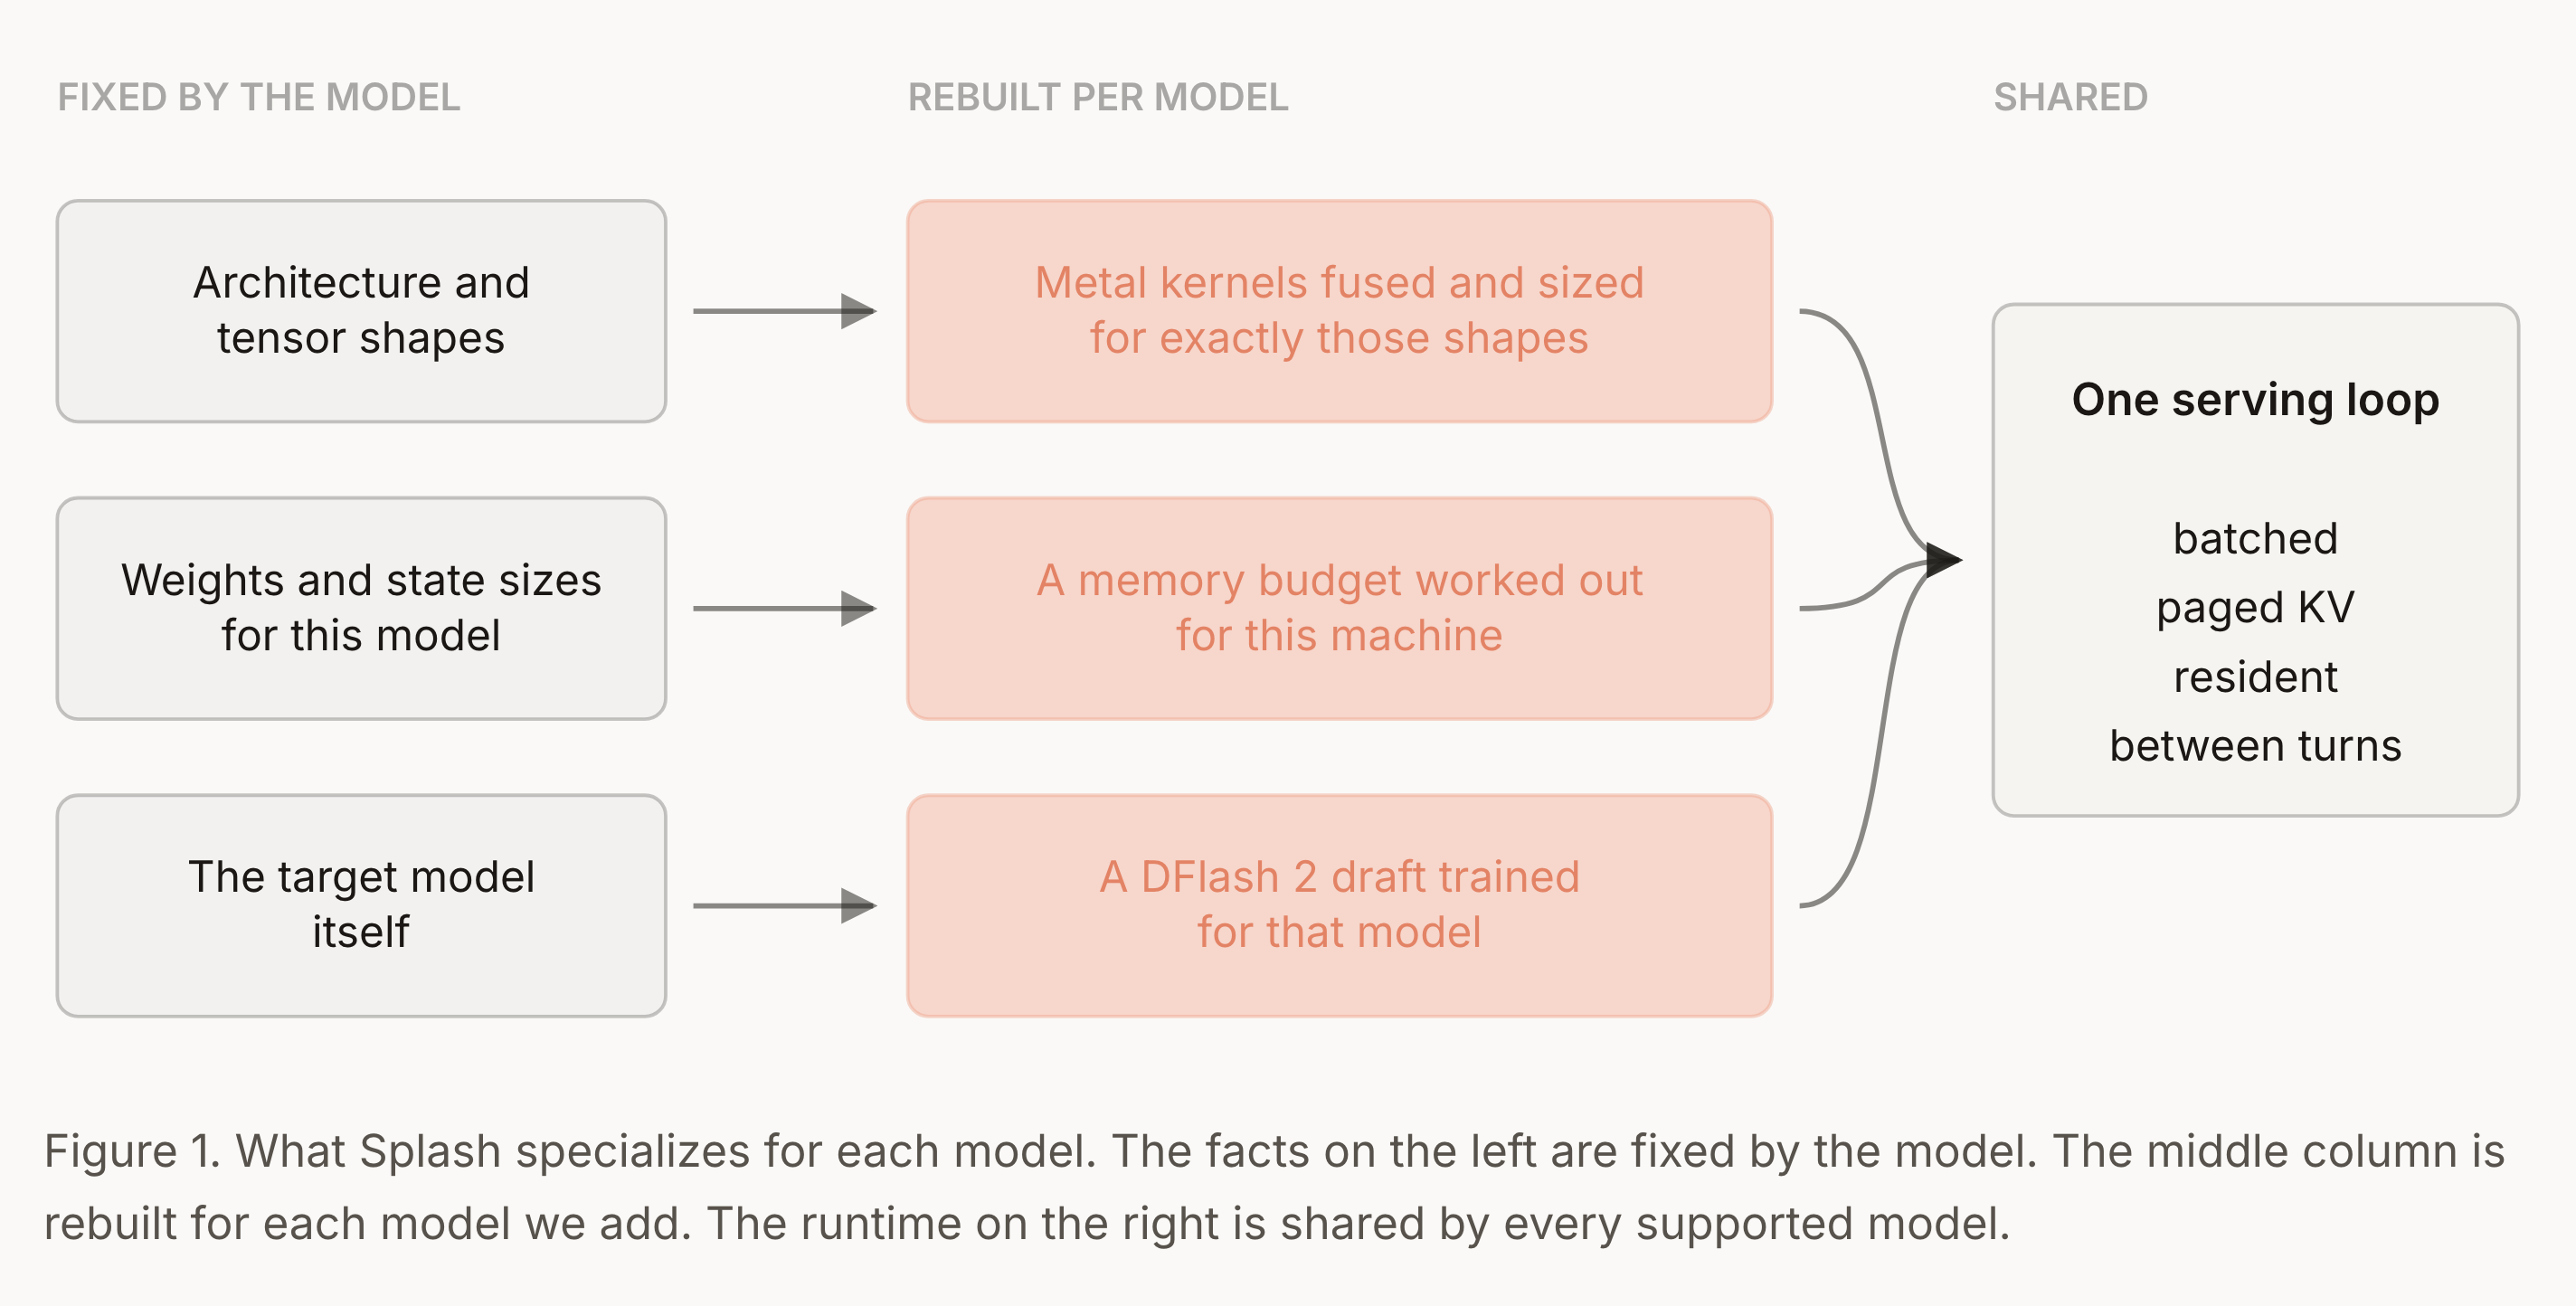
위 그림은 무엇이 고정이고 무엇이 다시 만들어지는지를 세 열로 나눠 보여줍니다. 왼쪽의 세 가지, 즉 아키텍처와 텐서 형상, 이 모델의 가중치와 상태 크기, 대상 모델 자체는 모델이 정해지는 순간 함께 정해지는 사실입니다. 가운데 열은 새 모델을 추가할 때마다 다시 만드는 부분이고, 오른쪽의 서빙 루프 하나만 모든 지원 모델이 공유하는데, 이 루프는 배치 처리와 paged KV 캐시를 안고 턴 사이에도 메모리에 상주합니다. 설계상 범용 멀티 모델 런타임도, 폴백 경로도, 손으로 조정할 항목도 없습니다.
배치 스케줄링과 시작 시점에 확정되는 메모리 예산
Splash는 요청이 들어오는 대로 배치로 묶고 프리필과 디코딩의 비중을 조절합니다. 새 요청이 빨리 시작되면서 이미 처리 중인 요청의 스트리밍도 끊기지 않도록 하기 위함입니다. 어텐션 상태는 접두사(Prefix)로 색인되는 paged KV(Key-Value) 캐시에 들어가므로, 앞선 요청과 접두사를 공유하는 요청은 그 페이지를 다시 계산하지 않고 재사용합니다. 하이브리드 모델의 경우 Gated DeltaNet(GDN) 상태까지 접두사 경계에서 스냅샷으로 남겨, 순환 계층도 재생하지 않고 캐시 재사용 범위에 넣습니다.
메모리 쪽은 모델이 고정되어 있다는 점을 그대로 활용합니다. 가중치와 초안 모델의 크기가 정해져 있고 요청 하나가 토큰당 쓰는 상태 비용도 알려져 있으므로, Splash는 시작 시점에 Metal이 권장하는 워킹셋 상한에서 이 비용들을 빼 메모리 예산을 확정합니다. Qwen3.8-27B라면 KV 캐시를 잡기 전에 가중치 15GiB 와 초안 모델 1.2GiB 가 먼저 나갑니다. 48GB를 권장하는 이유가 여기에 있습니다. 작업이 실행되는 동안에도 편집기와 브라우저를 함께 실행할 여지를 남기기 위해서입니다. 컨텍스트가 길어지면 캐시 상태를 회수하고 메모리 압박에 맞춰 스케줄링을 조정합니다.
옵션이 아니라 기본 경로인 DFlash 2 추측 디코딩
Splash에서 추측 디코딩(Speculative Decoding) 은 켜고 끄는 옵션이 아니라 디코딩 경로 그 자체입니다. 지원 모델마다 그 모델을 위해 학습한 DFlash 2 초안 모델이 함께 들어 있습니다. 초안 모델은 한 번의 순전파로 토큰 블록을 제안하고, 대상 모델이 그 블록을 한 번의 순전파로 검증합니다.
DFlash는 블록 확산(Block Diffusion)을 초안 생성에 쓰는 기법으로, ICML 2026 논문으로 발표되었고 SGLang, vLLM, TensorRT-LLM, llama.cpp에서 동작합니다. NVIDIA는 Blackwell GPU에서 최대 15배 처리량을, Google은 TPU에서 초당 토큰 3배를 보고했고, DFlash 계열 초안 모델의 누적 다운로드는 600만 회를 넘겼습니다. 기존 추측 디코딩의 초안 모델이 토큰을 한 개씩 순차적으로 뽑는 것과 달리, DFlash는 블록 전체를 한 번의 순전파로 병렬 예측합니다.
DFlash 2는 여기에 두 가지를 더했습니다. 하나는 각 위치의 후보 토큰들 사이에서 앞뒤가 맞는 경로를 고르는 경량 경로 선택기이고, 다른 하나는 블록 뒤쪽으로 갈수록 정확도가 떨어지는 현상(suffix decay)을 줄이는 2탭 동적 합성곱입니다. 둘을 합쳐도 초안 생성과 검증 한 사이클에 더해지는 지연은 1.3%인 반면 검증 패스당 통과하는 토큰은 20% 이상 늘어나고, 최종 출력은 자기회귀 디코딩과 동일하다는 것이 증명됩니다. Splash가 싣는 Qwen3.8-27B에서는 모델이 자체 제공하는 다중 토큰 예측(Multi-Token Prediction, MTP)보다 수용 길이가 길었고, SGLang 배치 크기 1 기준으로 자기회귀 디코딩 대비 2.7배에서 3.4배의 처리량으로 이어졌습니다. 추측 디코딩 자체가 궁금하시다면 커뮤니티의 추측 디코딩 초안 모델 학습 프레임워크와 배치 크기에 맞춰 초안 토큰 수를 조절하는 DSD 정리를 함께 보셔도 좋습니다.
엔진에서 이 초안 모델에 맞춰 다시 만든 부분은 세 군데입니다.
-
디코딩 스텝이 하나의 단위로 실행됩니다: 출력이 스키마로 제약되지 않은 경우, Splash는 초안 생성과 검증, 수용, 상태 갱신을 단계별로 나누지 않고 한 번에 제출합니다. 초안 모델이 만든 속도 이득이 스텝별 오버헤드로 사라지지 않고 API까지 도달하게 하려는 것입니다.
-
추측이 배치 안에서 동작합니다: 요청마다 자기 초안 상태를 들고 다니면서 수용된 토큰에 맞춰 그 상태를 진행시킵니다. 그래서 추측이 동시 처리나 캐시 재사용과 충돌하지 않습니다.
-
긴 컨텍스트에서도 초안 모델이 작게 유지됩니다: 초안 모델은 슬라이딩 윈도우 어텐션(Sliding Window Attention)을 쓰고, 긴 프리필에서는 생성과 접두사 스냅샷에 필요한 초안 상태만 계산합니다. 컨텍스트가 아무리 길어져도 초안 모델이 쓰는 메모리에 상한이 걸립니다.
형상에 맞춰 자동으로 생성하는 Metal 커널
프리필과 디코딩은 성격이 다른 작업입니다. 프리필은 큰 배치를 처리하고, 초안 검증은 작은 블록을 처리합니다. Splash는 이 둘에 각각 별도의 4비트 행렬 곱셈 커널과 어텐션 커널을 두고, 그것도 모델의 정확한 차원에 맞춰 작성합니다. 사람이 손으로 짜고 튜닝하기에는 양이 너무 많기 때문에 Inco AI는 자체 커널 에이전트에게 이 작업을 맡겼습니다. 커널 생성 자동화는 DeepSeek의 TileLang 기반 GPU 커널 라이브러리나 이식 가능한 멀티 실리콘 커널 API처럼 여러 팀이 동시에 파고 있는 주제이기도 합니다.
에이전트가 만들어 내는 커널 중에는 다음과 같은 것들이 있습니다.
- 8비트 KV 캐시를 직접 읽고 이를 쿼리 헤드와 검증 토큰에 걸쳐 재사용하는 디코딩 커널
- 순환 상태를 온칩에 유지하는 GDN 프리필 커널
- 전문가 혼합(Mixture-of-Experts, MoE) 모델에서 라우팅된 전문가를 위한 전용 커널
모든 커널은 GPU 패밀리와 코어 수, 작업 유형별 프리셋과 함께 미리 컴파일되어 배포됩니다. Xcode도, 컴파일러 툴체인도, 사용자 기기에서 수행하는 튜닝 단계도 없습니다.
에이전트 루프를 네 구간으로 나눈 벤치마크
Inco AI는 에이전트가 저장소를 읽고 파일을 고치고 테스트를 실행하는 루프를 네 구간으로 나눠 측정했습니다.
- 디코딩(Decode): 대화가 길어질 때 토큰이 얼마나 빨리 돌아오는지
- 프리필(Prefill): 저장소를 처음 읽는 데 걸리는 시간
- 캐시 재사용(Cache Reuse): 컨텍스트가 이미 올라간 뒤 다음 턴이 치르는 비용
- 동시성(Concurrency): 요청이 함께 돌 때의 속도와 한 번에 몇 개가 들어가는지
모든 엔진은 같은 48GB M5 Pro에서 Qwen3.6-35B-A3B와 Qwen3.8-27B를 각자의 권장 설정으로 HTTP를 통해 서빙했습니다. 프롬프트는 NVIDIA의 SPEED-Bench에서 고른 고정된 코딩 작업 집합으로 최대 32K 토큰이며, 출력은 1,024토큰으로 제한했습니다. 두 모델 모두 추론(reasoning)을 켠 상태였고 27B는 medium 수준이었으며, 디코딩 수치에는 추론 토큰이 포함됩니다. 단일 요청 수치는 중앙값입니다.
비교 대상 중 oMLX가 가장 가까운 상대입니다. 여러 모델에 걸쳐 배치와 캐시 재사용을 지원하는 범용 서버이기 때문입니다. Lily와 uzu는 한 번에 한 요청만 처리하고, uzu의 Qwen3.8-27B 패키지에는 초안 모델이 없습니다. 각 엔진이 자기 권장 설정으로 실행되었으므로 이 수치들은 종단 간(end-to-end) 비교이며, 엔진을 모델에 특화시킨 결과가 합쳐져 나타난 것이지 개별 요소의 기여를 분리한 값이 아닙니다.
컨텍스트가 길어져도 유지되는 디코딩 속도
Splash의 디코딩 속도는 Qwen3.6-35B-A3B에서 차순위 엔진의 1.7배, Qwen3.8-27B에서 2.0배 이고, 이 격차는 측정한 모든 프롬프트 길이에서 유지됩니다. 짧은 프롬프트에서 초당 210토큰과 74토큰, 32K에서 초당 143토큰과 54토큰입니다.
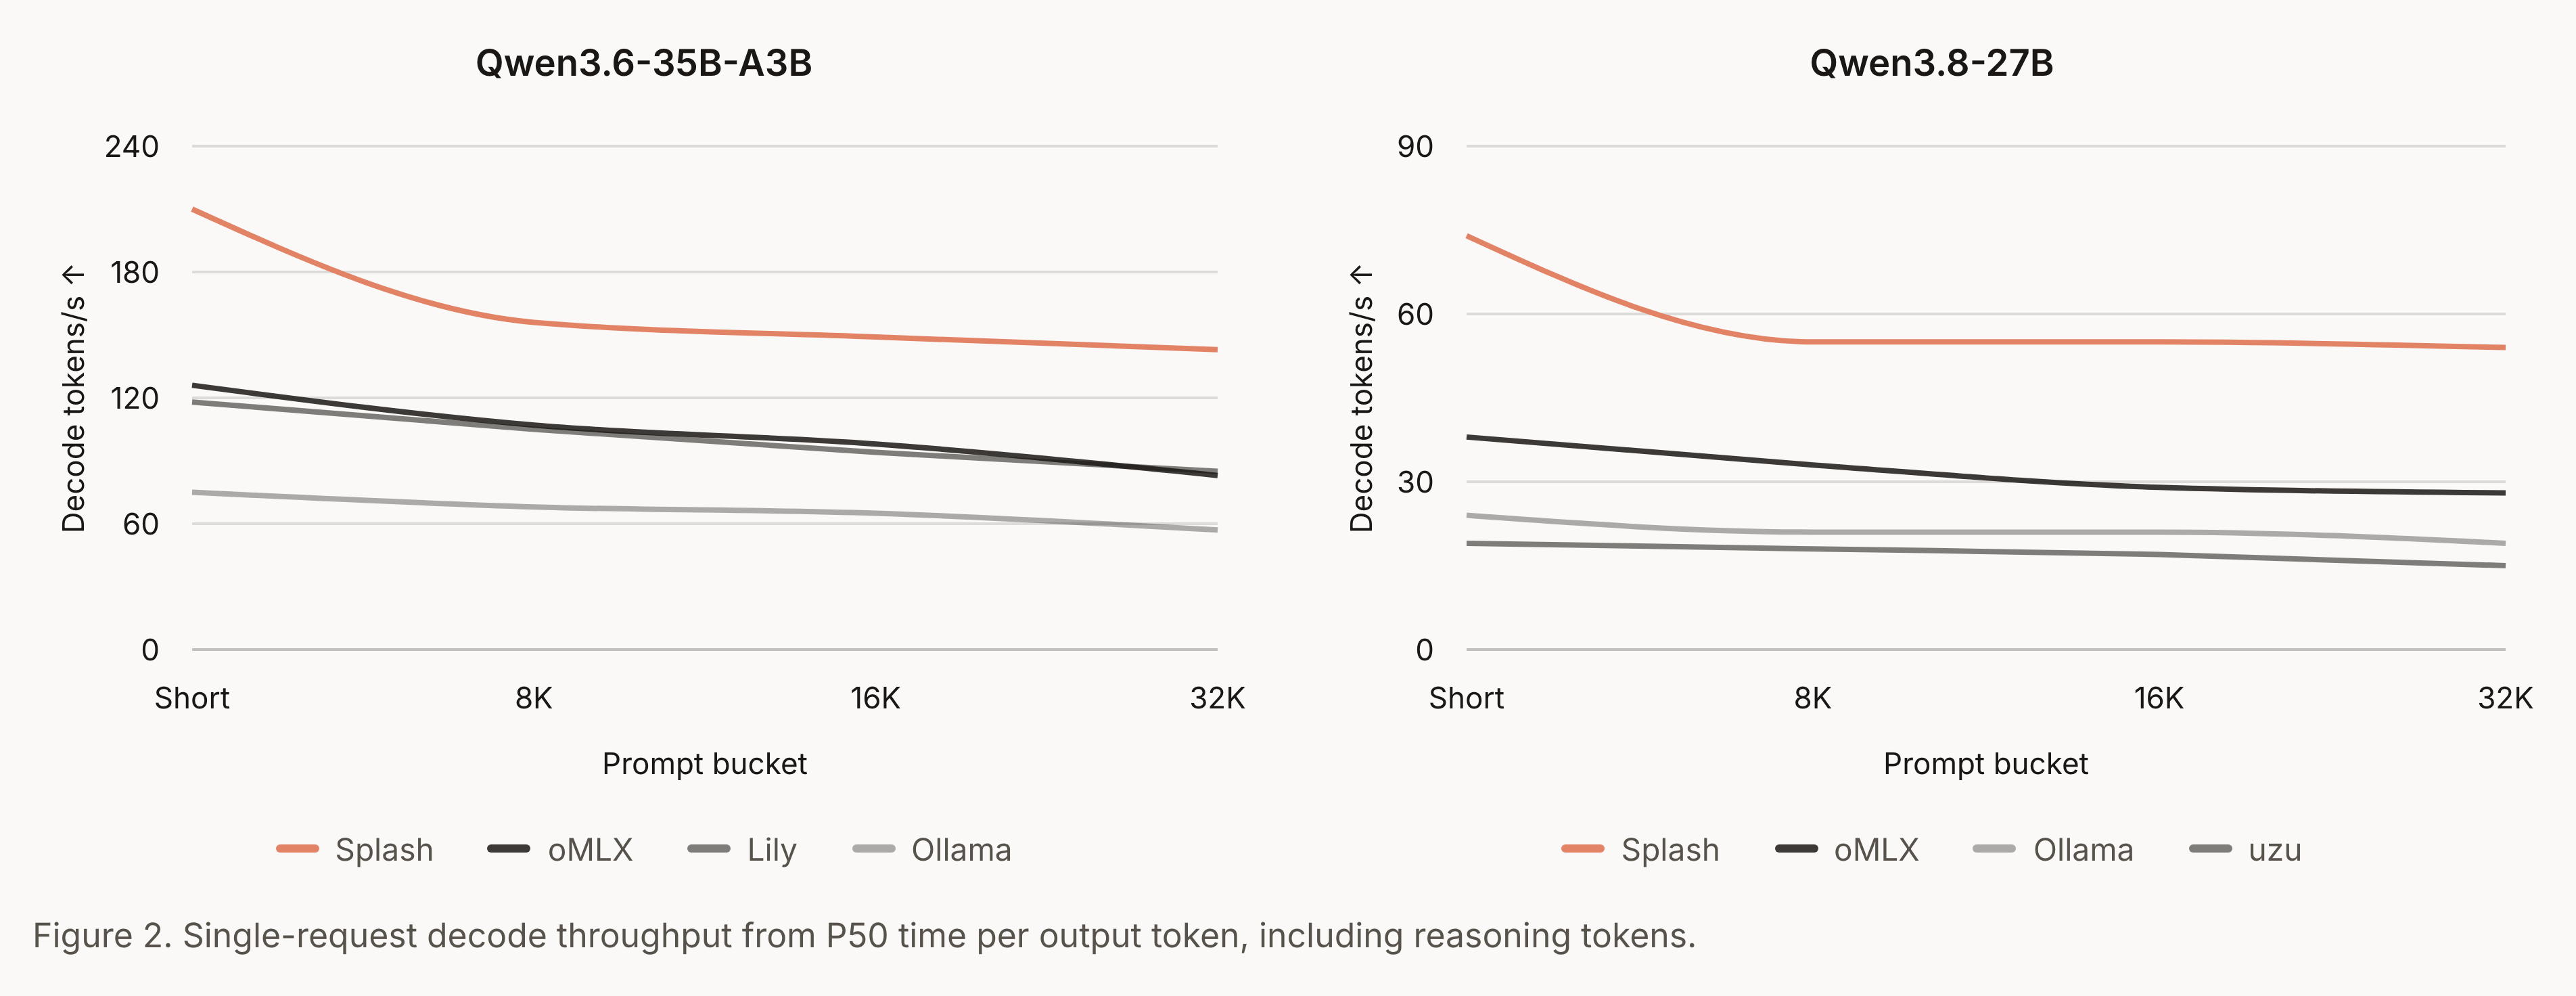
| Qwen3.6-35B-A3B | Short | 8K | 16K | 32K |
|---|---|---|---|---|
| Splash | 210 | 156 | 149 | 143 |
| oMLX | 126 | 107 | 98 | 83 |
| Lily | 118 | 105 | 94 | 85 |
| Ollama | 75 | 68 | 65 | 57 |
| Qwen3.8-27B | Short | 8K | 16K | 32K |
|---|---|---|---|---|
| Splash | 74 | 55 | 55 | 54 |
| oMLX | 38 | 33 | 29 | 28 |
| Ollama | 24 | 21 | 21 | 19 |
| uzu | 19 | 18 | 17 | 15 |
위 표를 통해 눈에 띄는 것은 Splash의 32K 수치가 다른 엔진의 짧은 프롬프트 수치보다 높다는 점입니다. 35B에서 Splash의 32K는 초당 143토큰인데 oMLX의 짧은 프롬프트는 초당 126토큰이고, 27B에서도 54토큰 대 38토큰으로 같은 관계가 나타납니다. 에이전트 관점에서 보면 대화 기록이 길게 쌓인 세션이 Splash에서는 다른 엔진의 새 세션보다 빠르게 동작합니다.
저장소를 처음 읽는 시간, 프리필
프리필은 에이전트가 저장소에 손대기 전에 기다려야 하는 시간입니다. 32K 프롬프트에서 Splash는 35B에서 초당 약 2,000 입력 토큰, 27B에서 초당 약 360 입력 토큰을 처리합니다. oMLX와 비교하면 첫 토큰까지의 대기가 35B에서 29초에서 17초로, 27B에서 317초에서 96초로 줄어듭니다.
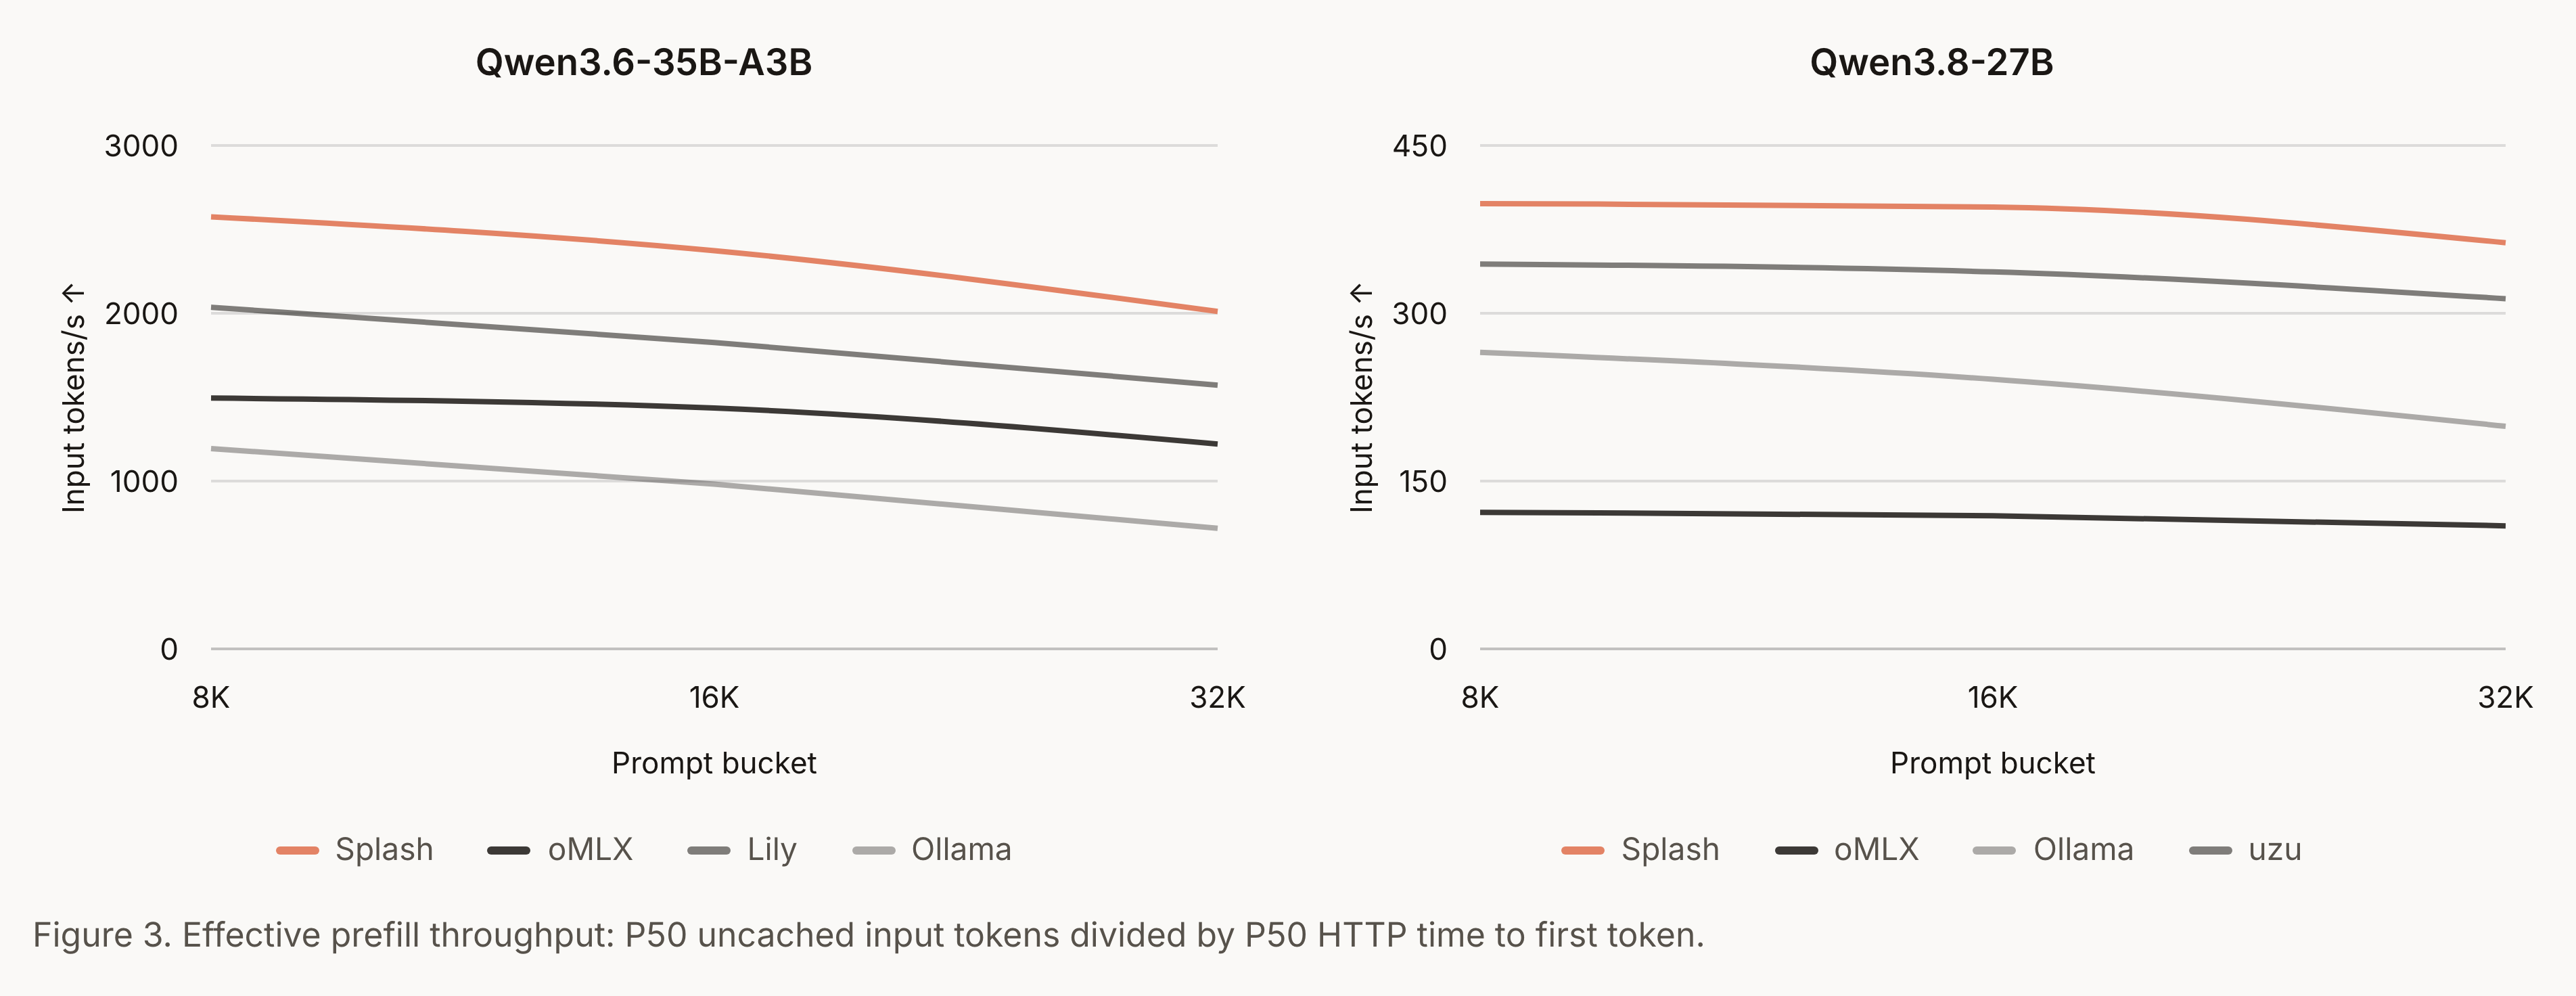
| Qwen3.6-35B-A3B | 8K | 16K | 32K |
|---|---|---|---|
| Splash | 2,575 | 2,373 | 2,011 |
| oMLX | 1,495 | 1,435 | 1,221 |
| Lily | 2,036 | 1,826 | 1,572 |
| Ollama | 1,194 | 982 | 719 |
| Qwen3.8-27B | 8K | 16K | 32K |
|---|---|---|---|
| Splash | 398 | 395 | 363 |
| oMLX | 122 | 119 | 110 |
| Ollama | 265 | 241 | 199 |
| uzu | 344 | 337 | 313 |
다만 원문은 이 구간에 단서를 함께 적어 두었습니다. 줄어든 폭이 크기는 하지만 큰 저장소를 처음 읽는 일은 Splash를 포함한 모든 엔진에서 여전히 비쌉니다. 에이전트가 이 비용을 치르는 시점이 저장소를 처음 읽을 때이고 매 턴마다는 아니라는 것이 차이입니다.
가장 격차가 큰 구간인 캐시 재사용
에이전트에게 흔한 경우는 다음 턴입니다. 같은 컨텍스트에 조금을 덧붙여 다시 보내고, 바뀌지 않은 부분은 이미 올라와 있습니다. Splash의 우위가 가장 크게 나타나는 구간이 여기입니다. 32K 컨텍스트가 캐시된 상태에서 Splash는 첫 토큰을 35B에서 123ms, 27B에서 282ms 에 돌려줍니다. 같은 컨텍스트를 처음 읽을 때의 17초와 96초와 비교되는 수치입니다. oMLX도 모든 프롬프트에서 캐시에 적중했지만 Splash가 각각 6.6배와 7.3배 빠르게 첫 토큰에 도달했습니다.
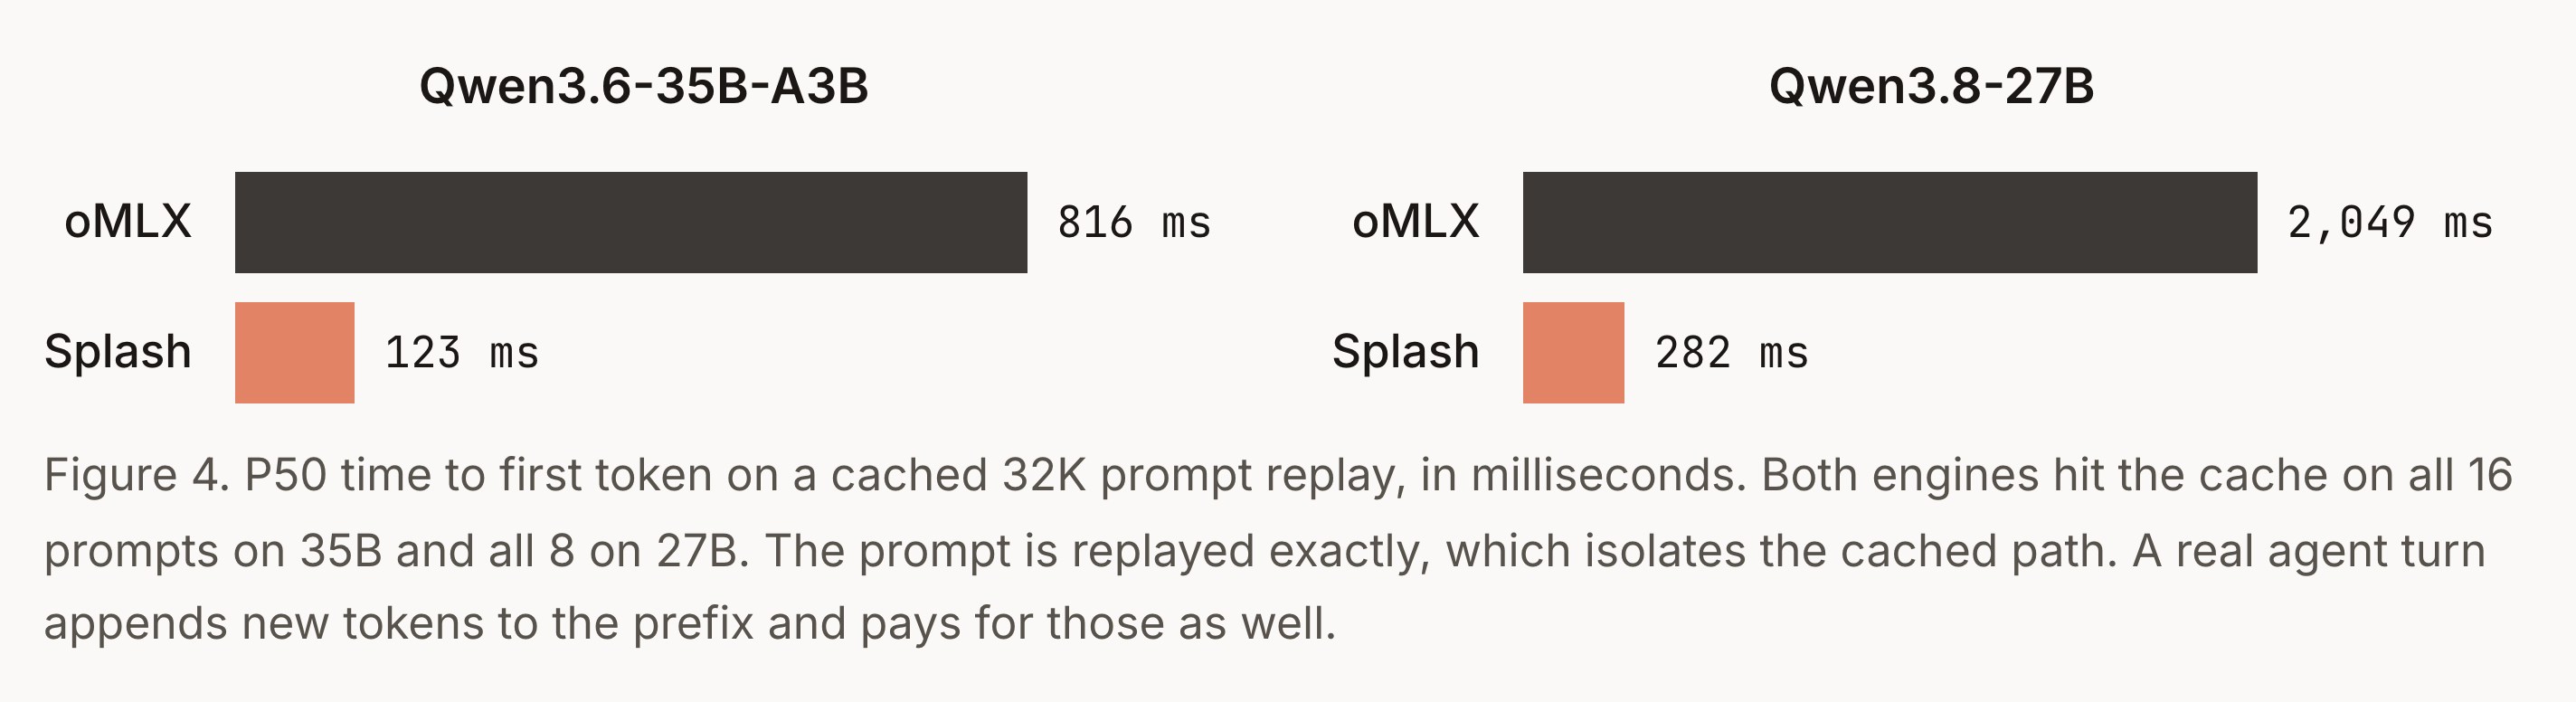
이 측정은 프롬프트를 정확히 그대로 재생하여 캐시 경로만 분리한 것이고, 실제 에이전트 턴은 접두사에 새 토큰을 덧붙이므로 그만큼의 비용을 더 치릅니다. 한편 같은 재생 조건에서 Lily는 35B에서 캐시 적중 없이 22초가 걸렸고, uzu는 27B에서 첫 패스와 같은 112초가 걸렸습니다. Ollama의 캐시는 이 정도 길이의 프롬프트에서 적중하지 않았습니다. 캐시 재사용이 없으면 모든 턴이 저장소를 다시 읽는 비용을 치릅니다.
동시 요청에서 더 벌어지는 격차
에이전트가 네 개의 요청으로 나뉠 때 격차는 더 커집니다. Splash의 합산 디코딩 처리량은 차순위 엔진의 2.0배와 3.9배 로, 단일 요청에서의 1.7배와 2.0배보다 올라갑니다. 짧은 프롬프트에서 35B는 초당 357토큰, 27B는 초당 170토큰입니다. 32K 프롬프트에서는 격차가 더 벌어져 35B에서 Splash가 초당 236토큰, oMLX가 초당 62토큰으로 3.8배 차이가 납니다.
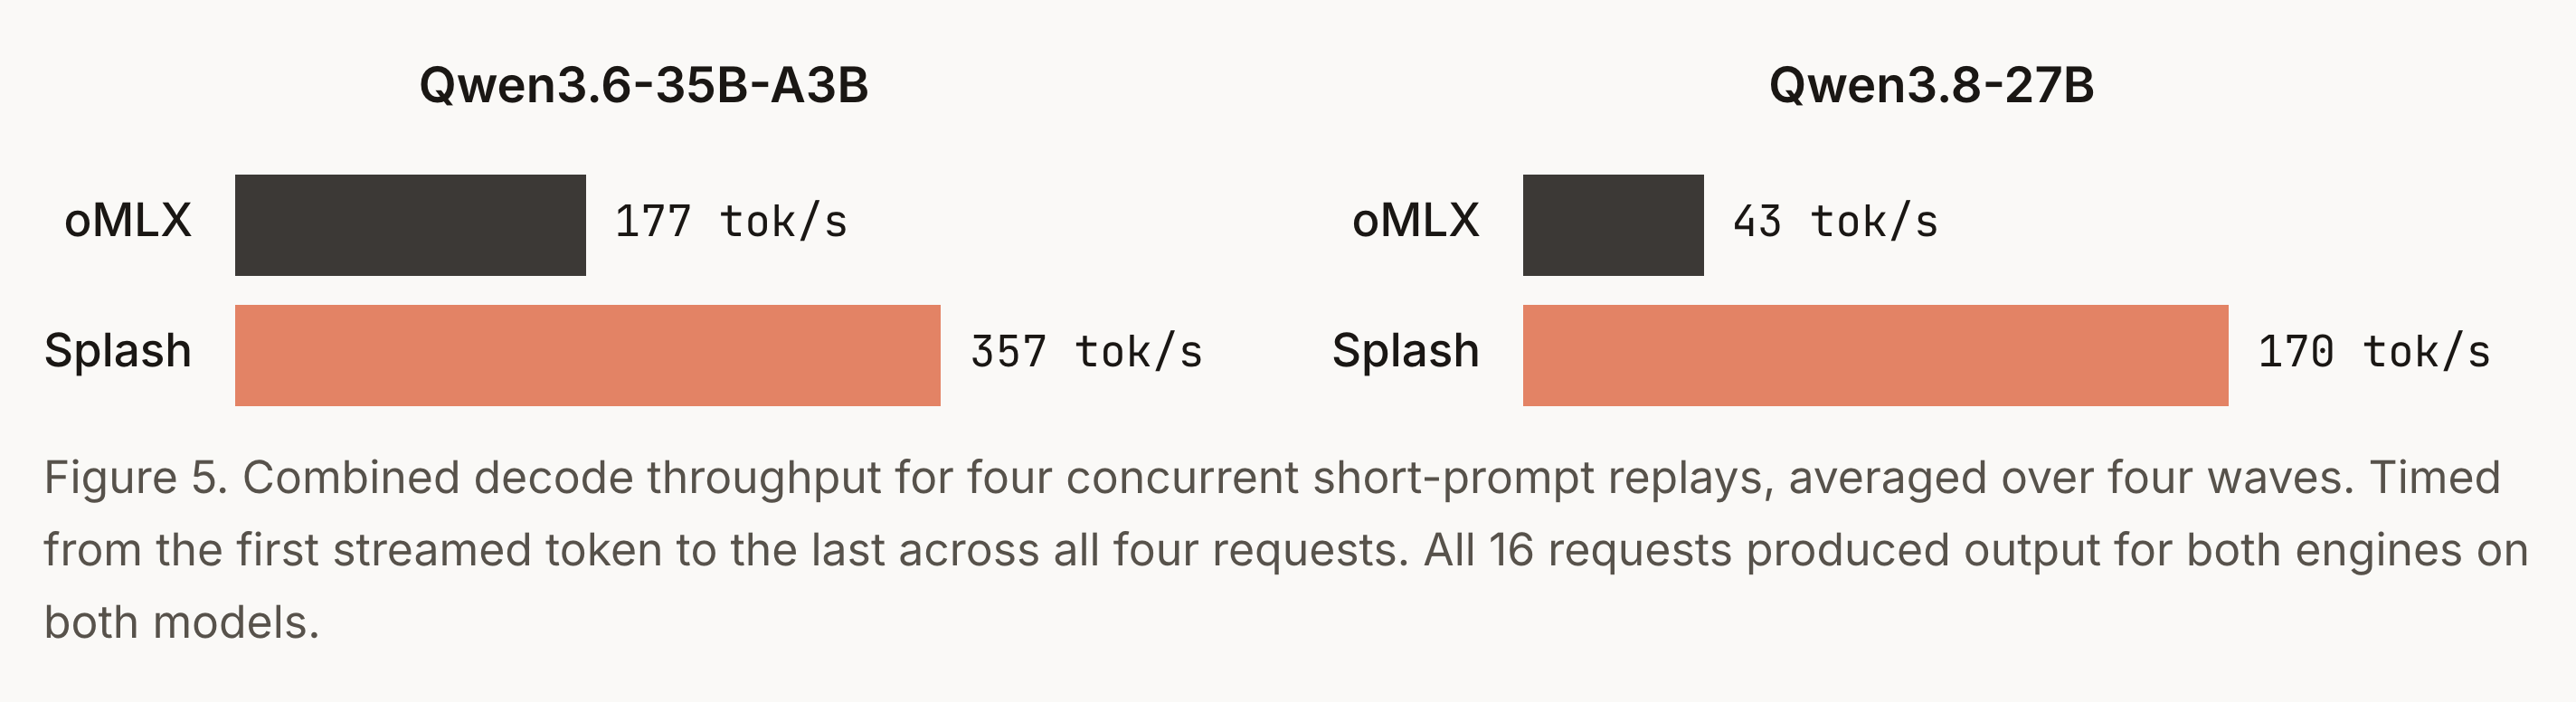
수용량 쪽에서도 차이가 나타납니다. 48GB 기기의 27B에 32K 요청 16개 를 동시에 보냈을 때, 범용 메모리 정책은 첫 패스에서 9개를 받았고 Splash는 16개를 모두 받아 완료했습니다. 모델의 크기가 미리 알려져 있으므로 기기 메모리의 거의 전부를 안전하게 예산에 넣을 수 있다는 것이 Inco AI의 설명입니다. 다만 원문은 다른 엔진을 같은 결과가 나오도록 설정할 수 있는지는 시험하지 않았다고 밝히고 있습니다.
Splash가 지원하는 모델 패키지
현재 공개된 패키지는 2종이며, 각 패키지에는 4비트로 양자화(Quantization)된 대상 모델과 그 모델을 위한 DFlash 2 초안 모델, 비전 인코더, 토크나이저가 함께 들어 있습니다. Qwen3.8-27B는 밀집(Dense) 모델이고 Qwen3.6-35B-A3B는 전체 35B에 토큰당 활성 파라미터가 약 3B인 MoE 모델인데, 모델 카드는 둘 중 후자가 더 빠르다고 적고 있습니다.
패키지(--model) |
구성 | 다운로드 크기 |
|---|---|---|
incoai/Qwen3.8-27B-Splash |
Qwen3.8-27B 4비트(밀집) + DFlash 2 초안 모델 | 17.4GB |
incoai/Qwen3.6-35B-A3B-Splash |
Qwen3.6-35B-A3B 4비트(MoE, 활성 약 3B) + DFlash 2 초안 모델 | 20.9GB |
--model 에는 Splash 패키지 형식을 담고 있는 owner/repo 를 지정할 수 있고, 일반 MLX나 Transformers 체크포인트는 동작하지 않습니다. 컨텍스트는 모델의 기본 윈도우인 256K까지 지원하되 실제 사용 가능한 용량은 남은 메모리에 따라 달라집니다. 모델이 들어가지 않으면 서버가 시작하지 않고 메모리 예산 내역을 출력한 뒤 멈춥니다. 인증은 기본적으로 꺼져 있으며 SPLASH_API_KEY 를 설정하면 요청에 베어러 토큰이나 x-api-key 가 필요해집니다. 추론은 기본으로 켜져 있고 모델 카드 기준 기본값이 xhigh 이며, reasoning_effort 로 low, medium, xhigh, none 을 지정하고 추론 내용은 reasoning_content 로 돌려받습니다. 앞의 벤치마크에서 27B는 medium 으로 측정했으므로 기본값 그대로 쓰면 추론 토큰이 늘어나는 만큼 체감 속도가 달라집니다. RAM이 부족한 환경을 위해 KV 캐시와 GDN 상태를 SSD로 내보내는 기능은 아직 병합되지 않은 PR #3에 실험적으로 올라와 있습니다. 접근 방식으로 보면 SSD로 전문가를 스트리밍하는 edge0와 같은 계열인데, 비교 대상인 oMLX는 같은 성격의 hot/cold 2계층 KV 캐시를 이미 정식 기능으로 싣고 서버를 재시작한 뒤에도 디스크에서 복원합니다.
Splash와 다른 로컬 엔진들의 설계 차이
| 엔진 | 지원 모델 범위 | 동시 요청 | 캐시 재사용 | 초안 모델 |
|---|---|---|---|---|
| Splash | 전용 패키지 2종 | 배치 처리 | 접두사 기반 paged KV | DFlash 2 기본 탑재 |
| oMLX | MLX 모델 전반 | 배치 처리 | 지원 | 선택 사항 |
| Lily | Qwen3.6-35B-A3B 4비트 체크포인트 1종 | 한 번에 하나 | 측정 조건에서 미적중 | 없음 |
| uzu | 여러 모델 | 한 번에 하나 | 측정 조건에서 미적중 | 27B 패키지에 없음 |
| Ollama | GGUF 모델 전반 | 지원 | 측정한 긴 프롬프트에서 미적중 | 선택 사항 |
위 표에서 Lily의 위치가 눈에 띕니다. Lily는 Perplexity가 2026년 9월 초에 공개한 Rust와 Metal 기반 서버로, 저장소가 밝히는 지원 범위가 MLX 4비트로 변환한 Qwen3.6-35B-A3B 체크포인트 하나입니다. 밀집(Dense) Qwen이나 더 작은 Qwen, BF16, GGUF, AWQ, GPTQ, int8, fp8은 로드 시점에 거부합니다. 모델 하나에 맞춰 엔진을 만드는 접근을 택한 곳이 Inco AI만은 아니라는 뜻이고, 실제로 프리필 수치에서 Lily는 범용 서버인 oMLX보다 35B에서 앞서 있습니다.
다른 점은 세 가지입니다. Splash에는 배치 처리와 접두사 기반 캐시 재사용, 초안 모델이 있지만 Lily에는 셋 다 없고 항상 그리디 디코딩만 합니다. 커널을 다루는 방식도 반대여서, Splash가 미리 컴파일한 커널을 배포하는 반면 Lily는 실행 시점에 Metal 커널을 소스에서 컴파일합니다. 요구 사항도 Lily 쪽이 높아 Apple GPU 패밀리 10(M5 이상)과 macOS 26 이상이 필요합니다. 앞의 세 가지는 단일 요청 벤치마크에서는 드러나지 않고 에이전트 루프에서 드러납니다.
맥이 아닌 환경에서 비슷한 문제를 다루는 사례로는 추측 디코딩과 전용 커널로 소비자용 GPU의 추론을 끌어올리는 Lucebox, RTX 3090에서 vLLM과 llama.cpp, SGLang으로 서빙하는 레시피를 모은 Club-3090이 있고, Apple Silicon 쪽으로는 Rapid-MLX, mlxcel, cider가 커뮤니티에 정리되어 있습니다.
Splash를 도입할 때 확인할 점
Splash의 장점과 제약은 같은 설계 결정에서 나옵니다. 모델이 고정되어 있어야 커널을 형상에 맞춰 컴파일하고 메모리 예산을 시작 시점에 확정할 수 있는데, 그 대가로 사용자가 쓸 수 있는 모델은 Inco AI가 패키지를 만들어 준 2종으로 제한됩니다. 직접 파인튜닝한 모델이나 다른 계열 모델을 올리려면 현재로서는 Inco AI에 contact@inco.ai 로 문의해야 합니다.
하드웨어 문턱도 낮지 않습니다. M3 이상, macOS 26.4 이상, 통합 메모리 36GB 이상이 요구 사항이고 권장은 48GB입니다. 27B 패키지만 해도 가중치 15GiB에 초안 모델 1.2GiB가 KV 캐시 이전에 상주하므로, 16GB나 24GB 맥에서는 선택지가 되지 않습니다.
벤치마크를 읽을 때도 조건을 함께 봐야 합니다. 이 수치들은 엔진을 만든 쪽이 자사 제품을 포함해 측정한 결과이고, 각 엔진을 자기 권장 설정으로 실행한 종단 간 비교입니다. 원문 스스로도 개별 요소의 기여를 분리한 값이 아니며 다른 엔진을 같은 조건으로 튜닝했을 때의 결과는 시험하지 않았다고 적고 있습니다. 재현이 필요하다면 SPEED-Bench 프롬프트가 공개되어 있으므로 자신의 기기에서 직접 실행해 보는 편이 확실합니다.
수치를 비교할 때는 어느 구간인지를 함께 보는 편이 낫습니다. 단일 요청 디코딩의 2배보다, 캐시 재사용의 6.6배와 7.3배, 동시 요청 네 개에서의 3.9배가 훨씬 큰 값인데 코딩 에이전트가 시간을 쓰는 곳은 대부분 후자입니다. 에이전트를 연결해 쓸 계획이라면 이 두 구간을 자신의 작업 부하에서 직접 측정해야 도입 여부를 판단할 수 있습니다.
Splash의 라이선스
Splash는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 다만 모델 가중치는 각자의 라이선스를 따릅니다.
 Splash 소개 블로그
 Splash GitHub 저장소
 Qwen3.8-27B-Splash 모델 패키지 (Hugging Face)
DFlash 2 소개 블로그
더 읽어보기
-
DFlash 논문: Block Diffusion for Flash Speculative Decoding (영문)
-
DFlash: 블록 확산(Block Diffusion) 기반으로 LLM 추론 속도를 높이는 오픈소스 라이브러리 (feat. Z.ai)
-
Rapid-MLX: Apple Silicon 맥에서 로컬 LLM을 OpenAI 호환 서버로 띄우는 추론 엔진
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
