핵심 요약
- Microsoft와 피츠버그대, 노스웨스턴대 등의 연구팀은 ThinkingBox 논문에서 에이전트가 작업을 끝낸 뒤의 백엔드 데이터베이스 상태와 부수 효과(side effect)로 채점하는 샌드박스 ThinkingBox를 공개했습니다. 함께 공개한 ThinkingBox-Bench는 소매, 숙박, 자동차 보험, 사내 IT/HR 지원 등 5개 업무 도메인의 과제 507개로 이루어져 있습니다.
- 같은 과제를 20번씩 독립적으로 실행한 결과, 가장 높은 Claude Opus 5도 pass@1 66.50\% 에서 pass^20 47.53\% 로 떨어졌고, Kimi-K3는 20번 중 한 번이라도 성공한 과제가 93.89\% 이지만 pass^20은 17.60\% 에 그쳤습니다.
- 실패한 시도의 67.24\% 는 대화를 정상 종료하고 상태 변경 도구를 호출했으며 마지막 도구 응답에도 오류가 없었습니다. 응답이나 도구 호출만 보는 채점은 이런 실패를 성공으로 셀 수 있습니다.
- 코드는 MIT, 벤치마크 데이터는 CDLA-Permissive-2.0 라이선스이며, 데이터 저장소는 벤치마크 과제를 학습이나 프롬프트 최적화에 쓰지 말고 평가에만 쓰도록 명시합니다. 논문이 언급한 강화 학습 코드 저장소는 2026년 10월 6일 기준 아직 공개되지 않았습니다.
ThinkingBox 소개
ThinkingBox는 여러 차례 대화하며 도구를 써서 업무를 처리하는 LLM 에이전트를, 응답 문장이 아니라 에이전트가 실제로 바꿔 놓은 데이터 상태로 평가하는 샌드박스이자 벤치마크입니다. 연구팀은 이 방식으로 18개 모델을 과제마다 20번씩 실행해, 한 번 성공하는 능력과 매번 성공하는 능력이 크게 다르다는 결과를 보고했습니다.
고객 상담 에이전트에게 다음과 같은 문의가 들어왔다고 해 봅시다. "745달러짜리 스탠드 믹서가 배송 예정일을 2주 넘겨 물류센터에서 '예외(exception)' 상태로 멈춰 있으니 환불하거나 크게 할인해 달라." 에이전트는 주문, 배송 추적, 고객 정보를 조회하고 정책 문서를 검색한 뒤 상담 티켓을 만들어 경과를 기록합니다. 그리고 티켓을 해결됨(solved) 으로 닫고 대화를 끝냅니다. 도구 호출은 모두 형식이 맞고, 데이터베이스에 쓰기도 했습니다. 그러나 배송사 조사가 끝나지 않았으므로 정책상 티켓은 보류(hold) 상태여야 했고, 고객은 환불 요청에 대한 답도 받지 못했습니다. 이 사례는 ThinkingBox-Bench의 실제 실패 사례(논문 부록 D.4의 Case 3)이며, Hugging Face 블로그 글도 이 사례로 시작합니다.
도구 호출이 맞아도 일이 끝났다고 볼 수 없는 이유
LLM 에이전트 평가는 결과를 실행해서 확인할 수 있는 영역부터 발전해 왔습니다. 코드 수정은 테스트로, 함수 호출은 파싱과 실행으로 확인할 수 있습니다. 그런데 예약 변경, 환불 처리, 보험 청구 수정, 사내 권한 요청 처리처럼 코드도 아니고 함수 호출 한 번으로 끝나지도 않는 업무는 사정이 다릅니다. 사용자에게 빠진 정보를 여러 차례 물어야 하고, 도메인 정책을 지켜야 하며, 서로 의존하는 도구를 순서대로 호출해서 올바른 레코드만 올바르게 바꿔야 합니다.
함수 호출 중심 벤치마크(BFCL, ToolBench, API-Bank 등)는 도구 선택, 인자 생성, 호출의 실행 가능성을 봅니다. 연구팀은 이런 평가로는 호출이 형식상 맞았는지는 알 수 있어도, 그 호출로 하려던 일을 에이전트가 끝냈는지는 알 수 없다고 지적합니다. 에이전트는 올바른 API를 엉뚱한 고객에게 호출할 수 있고, 필요한 확인을 받기 전에 레코드를 고칠 수 있으며, 그럴듯한 답변을 남기면서 백엔드는 그대로 둘 수도 있습니다.
상태 기반 벤치마크는 이 문제를 일부 다룹니다. τ-bench는 정책을 따르는 대화를 최종 데이터베이스 상태로 채점하고 반복 실행 신뢰성을 측정했으며, AppWorld는 다른 풀이 경로를 인정하면서 의도하지 않은 부수 변경을 잡아냅니다. MCP-Atlas와 MCPMark처럼 MCP(Model Context Protocol) 서버 환경을 쓰는 벤치마크도 나왔습니다. 연구팀이 정리한 비교에 따르면, 사용자 대화, 상태가 있는 백엔드, 부수 효과 검사, MCP 서버를 모두 갖춘 벤치마크는 없었습니다.
| 벤치마크 | 주요 영역 | 도구/API | 사용자 대화 | 상태 있는 백엔드 | 부수 효과 검사 | MCP 서버 |
|---|---|---|---|---|---|---|
| SWE-bench | 코드 수정 | X | X | O | X | X |
| BFCL | 함수 호출 | O | X | X | X | X |
| AppWorld | 앱 API | O | X | O | O | X |
| MCP-Atlas | 실제 MCP 서버 | O | X | X | X | O |
| τ-bench / τ²-bench | 도메인 API | O | O | O | 부분 | X |
| ThinkingBox-Bench | 업무 도구 워크플로 | O | O | O | O | O |
연구팀이 논문에 정리한 비교표 중 일부입니다. '부분'은 간접 지원을 뜻합니다.
PyTorchKR에서 정리한 NVIDIA의 AI 에이전트 평가 가이드도 도구 호출 정확도 대신 과업 완수를 채점하는 지표를 다뤘습니다. ThinkingBox는 같은 방향의 평가를 실행 가능한 환경과 과제 507개로 구현한 사례입니다.
연구 개요: 결과 상태로 채점하고, 20번 반복합니다
ThinkingBox의 출발점은 두 가지입니다. 첫째, 채점은 대화 내용이 아니라 대화가 끝난 뒤의 세계 상태로 합니다. 정답 행동 순서를 하나로 정해 두지 않으므로, 조회 순서가 달라도, 실패한 호출을 복구했어도, 확인 질문을 더 했어도 최종 상태가 맞으면 통과입니다. 반대로 잘못된 값, 빠진 변경, 요청하지 않은 추가 변경이 하나라도 있으면 실패입니다.
둘째, 한 번의 성공을 신뢰성으로 보지 않습니다. 연구팀은 모든 과제를 같은 초기 상태에서 20번씩 독립적으로 실행했습니다. 그리고 몇 번 시도하면 한 번은 성공하는지(pass@k)와 k번 모두 성공하는지(pass^k)를 따로 보고했습니다.
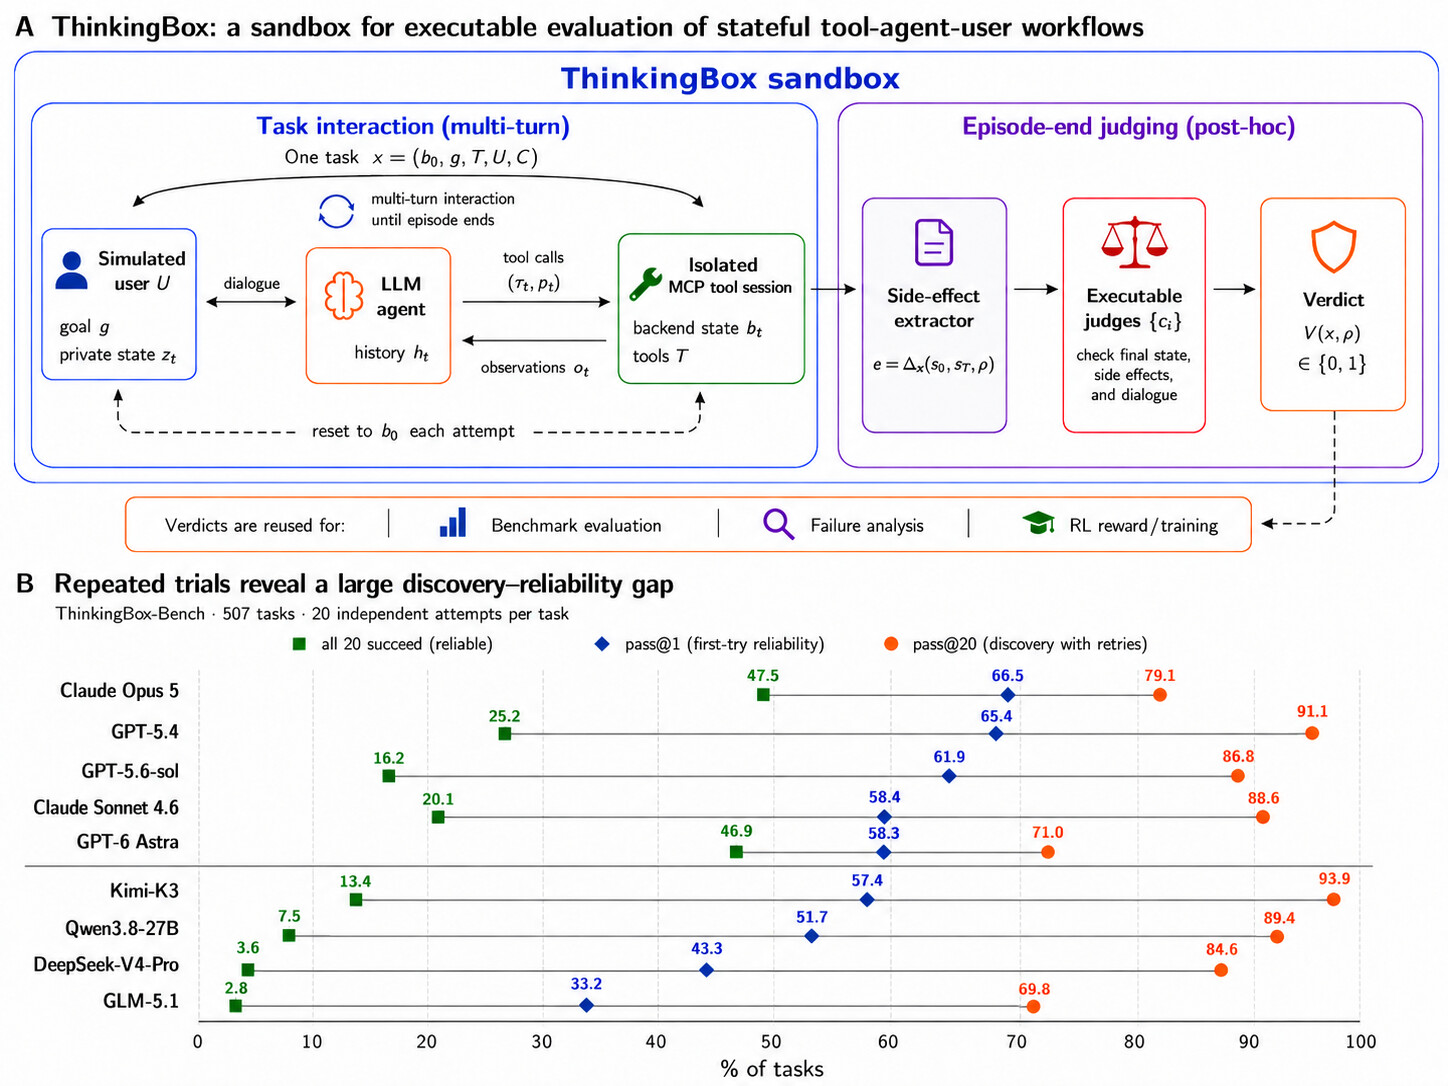
위 그림 아래쪽은 논문이 발견과 신뢰성의 격차(discovery-reliability gap) 라고 부르는 현상입니다. 모델마다 20번 안에 한 번이라도 성공하는 비율(주황)은 높지만, 20번 모두 성공하는 비율(초록)은 훨씬 낮습니다. 이 두 점 사이의 거리가 모델마다 크게 다르다는 것이 이 연구의 핵심 결과입니다.
ThinkingBox 샌드박스의 구조
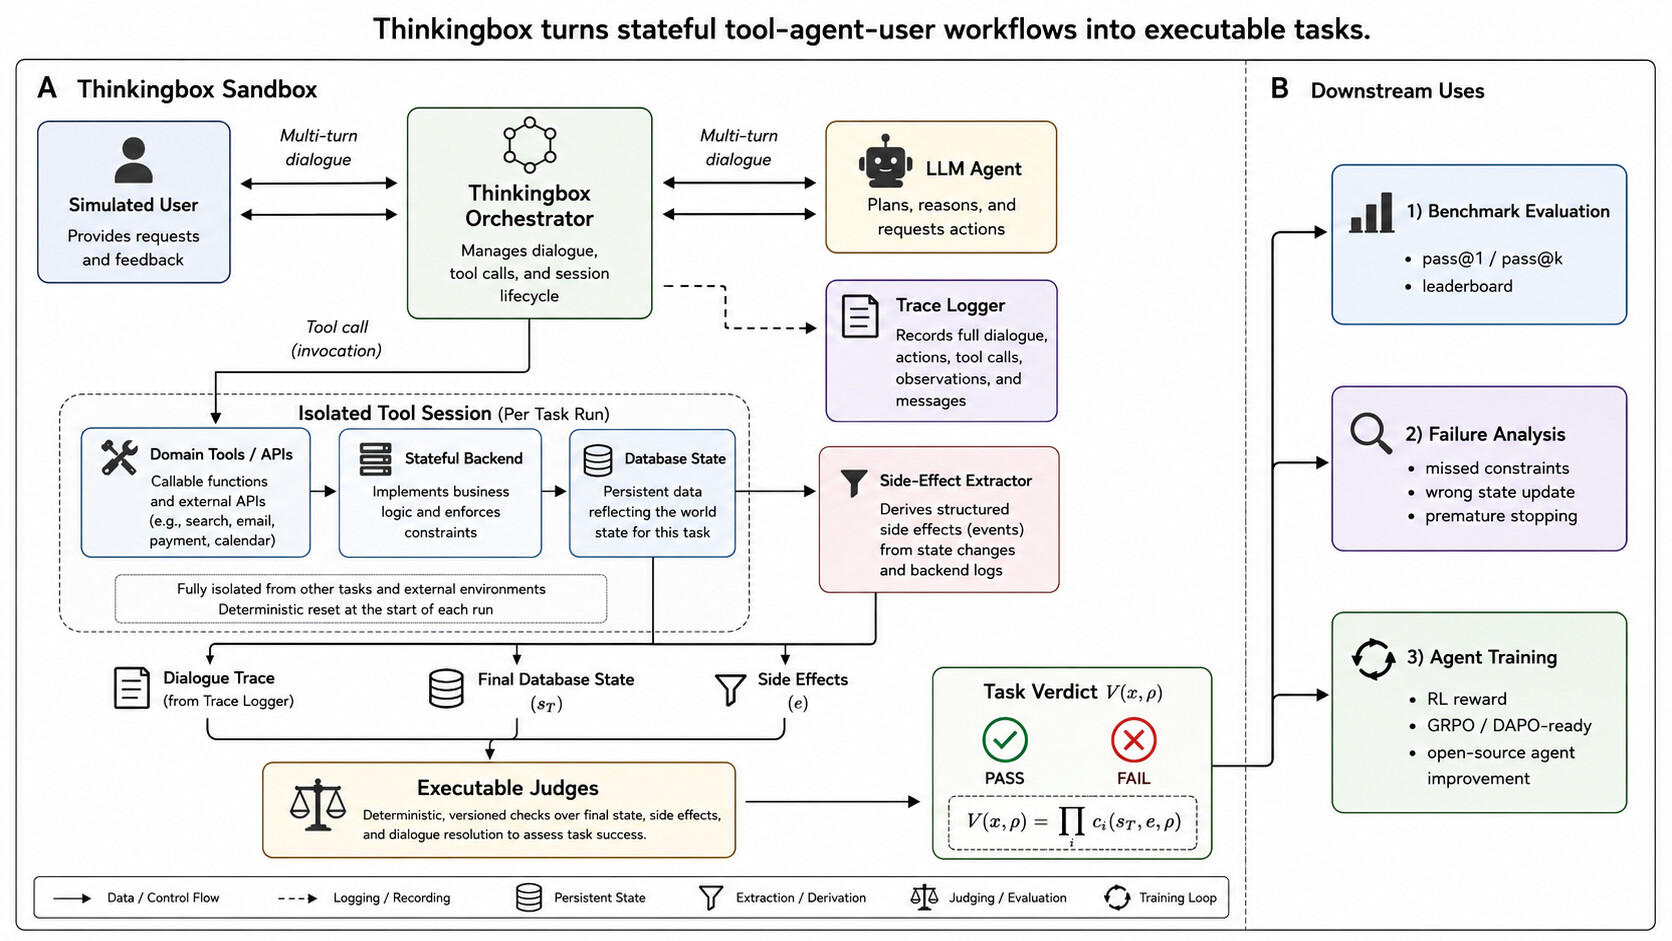
ThinkingBox는 에이전트, 시뮬레이션 사용자, 도메인 도구, 부수 효과 추출기, 판정기를 하나의 재현 가능한 실행 루프 안에서 돌립니다. 이 절에서는 과제를 어떻게 정의하고, 시도끼리 어떻게 격리하며, 무엇으로 채점하는지 차례로 살펴보겠습니다.
과제 하나를 이루는 다섯 가지 요소
연구팀은 과제 하나를 다음과 같이 정의합니다:
b_0 는 백엔드의 초기 상태, g 는 사용자의 목표, \mathcal{T} 는 쓸 수 있는 도메인 도구 집합, \mathcal{U} 는 시뮬레이션 사용자의 정책, \mathcal{C} = \{c_i\}_{i=1}^{m} 은 에이전트에게 보이지 않는 실행 가능한 검사 m 개입니다. 매 턴 에이전트는 사용자에게 메시지를 보내거나, 도구 \tau_t \in \mathcal{T} 를 인자 p_t 로 호출하거나, 대화를 끝냅니다.
논문은 이 구성을 부분 관측 마르코프 결정 과정(POMDP, Partially Observable Markov Decision Process) 으로 정식화합니다. 에이전트가 환경의 실제 상태를 직접 보지 못하고 관측만으로 행동을 골라야 하는 의사결정 문제입니다. 숨은 상태 s_t = (b_t, z_t, \ell_t, q_t) 는 백엔드 상태, 시뮬레이션 사용자의 사적 상태, 평가에 필요한 이벤트 로그, 에피소드 상태로 이루어집니다. 에이전트가 보는 것은 첫 요청과 정책, 사용자 발화, 도구 결과나 오류뿐입니다. 상태를 바꾸는 도구는 에이전트만 호출할 수 있으므로, 시뮬레이션 사용자는 두 번째 행위자가 아니라 환경의 일부로 취급됩니다.
시도마다 격리된 MCP 도구 세션
같은 과제를 20번 실행하려면 시도끼리 아무것도 공유하지 않아야 합니다. 앞선 시도가 만든 티켓이 남아 있으면 다음 시도의 채점이 틀어지고, pass@k와 학습 보상도 믿을 수 없게 됩니다. 그래서 ThinkingBox는 시도마다 과제를 b_0 로 초기화하고 새 도구 세션을 만듭니다.
ThinkingBox GitHub 저장소에 따르면 이 격리는 MCP Session Proxy가 맡습니다. 오래 실행되는 HTTP 서버로, 시나리오 초기화 요청을 받으면 필요한 MCP 서버 프로세스를 띄워 대화 하나만을 위한 세션을 만듭니다. 이후 도구 스키마 조회, 도구 실행, 부수 효과 조회(/get_effects), 세션 종료를 같은 세션 안에서 처리합니다. 각 MCP 서버는 상태를 설정하는 __reserved__init 과 채점용 상태를 돌려주는 __reserved__geteffects 를 따로 갖고 있습니다. 도구 오류나 선행 조건 실패는 샌드박스가 몰래 고쳐 주지 않고 에이전트에게 관측으로 그대로 전달됩니다.
부수 효과 중심의 채점
대화가 끝나면 샌드박스는 과제별 추출기 \Delta_x 로 부수 효과를 추출합니다:
여기서 s_T 는 최종 상태, \rho 는 관측과 에이전트 행동의 전체 기록(trajectory)입니다. 판정은 모든 검사를 곱한 값입니다:
곱으로 정의했으므로 검사 하나만 실패해도 판정은 0이고, 부분 점수는 없습니다. 실제 구현에서는 최종 데이터베이스와 과제별 정답 상태의 해시를 비교하고, 다르면 필드 단위 차이를 보고합니다. Hugging Face 데이터셋 카드에 따르면 정답 상태는 미리 저장해 두지 않습니다. 평가할 때마다 새 데이터베이스에 초기 상태 패치를 적용하고 정답 도구 호출을 재생해서 만듭니다. 그래서 정답 상태와 에이전트의 결과가 같은 도구 구현과 같은 데이터베이스 동작을 거칩니다.
507개 과제 중 30개는 최종 응답에 대한 예/아니요 루브릭(rubric) 검사를 추가로 거칩니다. 호텔의 기밀 등급을 고객에게 말하지 않았는지, 정책상 제한된 결과를 분명히 전달했는지처럼 데이터베이스만으로는 확인할 수 없는 요구사항입니다. 이 30개는 여행/숙박과 네오뱅크 사내 IT 지원에 15개씩 있으며, 루브릭 판정에는 GPT-5.4-mini를 고정해서 씁니다.
이 판정 V 는 그대로 강화 학습의 보상이 됩니다. 연구팀이 샌드박스를 "평가와 학습을 위한 하나의 루프"로 설계했다고 설명하는 이유입니다.
시뮬레이션 사용자
ThinkingBox-Bench의 사용자 쪽은 LLM이 맡습니다. 과제마다 그대로 재생되는 첫 요청과, 에이전트가 물어볼 때만 알려 줄 수 있는 사실 목록(user_context)이 있습니다. 첫 요청에 필요한 정보가 다 들어 있지 않은 경우가 많아서, 에이전트는 기록과 정책을 확인한 뒤 사용자에게 다시 물어야 합니다.
시뮬레이터 설정은 다음과 같습니다:
- 모든 에이전트 평가에서 같은 GPT-5.4-mini 배포를 쓰며, temperature는 0.3 이고 추론(reasoning)은 끕니다.
- 시뮬레이터가 보는 것은 사용자에게 보이는 대화와
user_context뿐입니다. 도구 호출, 도구 결과, 에이전트의 추론 기록은 보지 못합니다. - 시스템 프롬프트는 ID, 이름, 날짜, 숫자를 허용된 정보에서 글자 그대로 복사하도록 하고, 모르는 것은 "I don't know"라고 답하게 합니다. 목표를 바꾸지 않고 협조적인 태도를 유지합니다.
- 사용자 후속 턴은 최대 10번이며, 에이전트가 완료 표시를 내거나 종료 도구를 호출하면 대화가 끝납니다.
연구팀은 시뮬레이터가 실제로 지시를 지켰는지 따로 감사(audit)했습니다. 15개 실행 그룹에서 뽑은 후속 사용자 턴 19,390개를 GPT-5.6 Sol과 Claude Opus 5가 각각 판정하고, 의견이 갈리면 최대 5라운드 토론으로 정했습니다. 그 결과 6.33\% 가 근거 없는 내용을 담은 턴(Ungrounded)으로 분류되었습니다. 실행 그룹별로는 Qwen3.6-27B 대화의 0.39\% 부터 GPT-5.2 대화의 23.88\% 까지 차이가 컸습니다. 다만 사람 두 명이 120개 표본을 검토했을 때, 자동으로 Grounded로 분류된 60개는 모두 맞다고 확인했지만 Ungrounded로 분류된 60개 중에서는 절반 정도(32개, 30개)만 동의했습니다. 연구팀은 자동 Ungrounded 판정 중 상당수가 사람 검토에서 확인되지 않았다고 밝혔습니다.
ThinkingBox-Bench: 5개 업무 도메인의 과제 507개
샌드박스 위에 연구팀이 만든 벤치마크가 ThinkingBox-Bench입니다. 프롬프트만 모은 데이터셋이 아니라, 과제마다 도메인 도구, 초기 상태, 시뮬레이션 사용자, 검사기를 갖춘 실행 가능한 환경입니다. 연구팀은 5개 도메인을 고른 이유로, 사용자가 정보를 덜 주고, 정책이 에이전트의 행동을 제한하며, 관련 없는 레코드를 건드리지 않고 올바른 레코드를 고쳐야 한다는 공통 패턴을 들었습니다.
| 항목 | 소매 | 여행/숙박 | 자동차 보험 | 네오뱅크 IT 지원 | 컨설팅 IT/HR 지원 |
|---|---|---|---|---|---|
| 과제 수 | 98 | 104 | 100 | 104 | 101 |
| 백엔드 시스템 | 11 | 8 | 7 | 3 | 18 |
| DB 테이블 / 행 | 22 / 86 | 17 / 98 | 14 / 72 | 20 / 151 | 30 / 231 |
| 에이전트 도구 (쓰기 / 읽기) | 16 / 17 | 10 / 28 | 14 / 19 | 13 / 19 | 13 / 14 |
| 정책 문서 (단어) | 945 | 3,684 | 2,471 | 3,392 | 1,747 |
| 과제당 행동 수 (범위) | 4.4 (1~10) | 8.8 (4~19) | 4.7 (1~11) | 6.7 (3~12) | 5.8 (1~13) |
| 평가 | DB 상태 | DB + 루브릭 | DB 상태 | DB + 루브릭 | DB 상태 |
도메인별 대표 시나리오는 다음과 같습니다:
- 소매/전자상거래: 주문 일부의 변경이나 환불 요청. 올바른 주문과 상품을 찾고, 자격을 확인하고, 빠진 확인을 받은 뒤 관련 레코드만 고쳐야 합니다.
- 여행/숙박: 날짜, 객실, 정책 조건이 걸린 예약 변경. 예약, 객실 여유, 변경 정책을 확인한 뒤 예약을 고치거나 거절 사유를 설명해야 합니다.
- 자동차 보험: 사고 접수나 청구 수정. 보험 계약과 차량, 사고 정보를 확인하고 빠진 정보를 받아야 하며, 허용되지 않은 보장 내용은 바꾸면 안 됩니다.
- 네오뱅크 사내 IT 지원: 직원의 사내 앱 권한 요청. 직원 역할, 기존 권한, 필요한 승인을 확인한 뒤 권한을 주거나 상위로 넘겨야 합니다.
- 컨설팅 IT/HR 지원: 남은 온보딩 교육 등록 요청. 기존 등록을 확인하고 빠진 교육만 추가하며, 온보딩 티켓은 완료 전까지 열어 둬야 합니다.
과제는 세 단계로 만들었습니다: 먼저 도메인별로 반복되는 업무 시나리오를 워크플로 템플릿으로 작성했습니다. 다음으로 템플릿마다 초기 상태, MCP 도구, 사용자 목표, 정책, 검사기를 붙여 구체적인 과제로 만들었습니다. 마지막으로 샌드박스에서 실제로 실행해 도구가 깨졌거나, 초기 상태가 모순되거나, 목표가 모호하거나, 결과를 검증할 수 없는 과제를 걸러 냈습니다. 남은 과제는 적어도 하나의 올바른 풀이가 있어야 하고, 정답 최종 상태도 하나여야 합니다.
데이터의 출처도 밝혀 두었습니다. 과제는 비공개 데이터 협업으로 확보한 기업 지원, 운영 사례에서 워크플로 구조를 가져와 합성으로 다시 만든 것입니다. TechHome Direct, StayBridge Hotels & Resorts, HorizonShield Insurance, Velocity Digital Bank, Meridian Strategy Group의 5개 조직은 모두 벤치마크용 가상 기업이며, 실제 고객이나 직원 레코드는 포함하지 않았습니다. Hugging Face 블로그에 따르면 Microsoft Copilot Studio 팀이 Toloka와 함께 만들었습니다. 연구팀은 507개 과제가 기업 업무 전체를 대표하는 표본이라고 주장하지 않는다고 분명히 적었습니다.
평가 지표: pass@1, pass@k, pass^k
각 모델은 과제 507개를 20번씩, 모델당 10,140번 실행했습니다. 연구팀은 세 가지 지표를 보고합니다.
pass@1은 모든 과제와 시도에 걸친 평균 성공률입니다. 과제 집합 D 와 시도 횟수 N = 20 에 대해 다음과 같습니다:
pass@k는 k 번 시도 중 적어도 한 번 성공할 확률입니다. 코드 생성 평가에서 쓰는 비편향 추정량을 그대로 씁니다. pass@20은 20번 중 한 번이라도 성공한 과제의 비율과 같습니다.
pass^k는 k 번 모두 성공할 확률입니다. τ-bench가 제안한 비편향 추정량은 성공 횟수가 k 보다 적은 과제에서 항상 0이 되어 어려운 과제에서 모델을 구분하지 못합니다. 그래서 연구팀은 과제별 성공률 p_x = C_x / N 을 k 제곱해 평균한 플러그인 추정량을 씁니다:
이 값은 20번 중 19번 성공한 과제에도 0이 아닌 값(0.95^{20} \approx 0.36 )을 주므로, "20번 모두 성공한 과제의 비율"과 같지 않습니다. Hugging Face 블로그는 추정량 대신 실제로 20번 모두 성공한 과제 수(observed 20/20)를 씁니다. 예를 들어 GPT-5.4의 pass^20은 30.62\% 이지만, 실제로 20번 모두 성공한 과제는 128개(25.25\% )입니다. 두 자료의 숫자를 비교할 때는 어느 지표인지 확인해야 합니다.
실험 결과
연구팀은 독점 모델과 오픈 웨이트 모델을 합쳐 18개 모델을 평가했습니다. 모든 모델은 같은 시스템 프롬프트, 도구 정의, 시뮬레이션 사용자, 검사기를 썼습니다. API 모델은 Azure에 배포된 OpenAI 호환 Chat Completions 인터페이스로 호출했고(temperature 1.0 , reasoning effort medium), Qwen 모델은 vLLM으로 직접 서빙했습니다. 디코딩 실패나 API 오류 같은 시스템 오류도 실패한 시도로 셌습니다. 아래 수치는 모두 연구팀이 자체적으로 측정해 공개한 값입니다.
도메인별 리더보드
| 모델 | 소매 | 자동차 보험 | 여행/숙박 | 네오뱅크 | 컨설팅 | 전체 |
|---|---|---|---|---|---|---|
| Claude Opus 5 | 80.71 | 65.80 | 49.95 | 70.62 | 66.19 | 66.50 |
| GPT-5.4 | 76.33 | 62.65 | 68.12 | 65.34 | 54.60 | 65.36 |
| GPT-5.6-sol | 67.65 | 65.30 | 60.34 | 59.09 | 57.52 | 61.91 |
| Claude Sonnet 4.6 | 72.35 | 54.40 | 58.94 | 56.39 | 54.31 | 59.19 |
| GPT-6 Astra | 71.73 | 46.55 | 55.87 | 60.87 | 56.83 | 58.31 |
| Claude Opus 4.6 | 68.62 | 8.30 | 21.11 | 35.67 | 27.82 | 32.09 |
| o3-pro | 37.70 | 2.95 | 17.31 | 24.28 | 14.60 | 19.31 |
| Grok-4.3 | 43.93 | 2.60 | 15.14 | 1.78 | 9.55 | 14.38 |
| Kimi-K3 | 82.24 | 50.80 | 61.83 | 41.35 | 51.63 | 57.37 |
| Qwen3.8-27B | 64.03 | 47.85 | 53.41 | 47.88 | 45.69 | 51.70 |
| DeepSeek-V4-Pro | 68.21 | 29.65 | 43.13 | 44.86 | 31.04 | 43.26 |
| GLM-5.1 | 58.67 | 25.70 | 35.43 | 13.27 | 34.06 | 33.19 |
| Qwen3.5-9B | 19.90 | 0.70 | 4.71 | 1.15 | 2.33 | 5.65 |
| Mistral-Large-3 | 11.28 | 1.30 | 8.99 | 1.15 | 0.74 | 4.66 |
pass@1 (%), 과제당 20회 시도의 평균입니다. 위 8개는 독점 모델, 아래 6개는 오픈 웨이트 모델입니다.
전체 1위는 Claude Opus 5(66.50\% )와 GPT-5.4(65.36\% )이며, 연구팀은 표준오차를 고려하면 두 모델의 전체 성능은 구분되지 않는다고 설명합니다. 그러나 도메인별로는 다릅니다. 여행/숙박에서는 GPT-5.4가 68.12\% 로 가장 높고 Claude Opus 5는 49.95\% 에 머물렀습니다. 소매에서는 오픈 웨이트 모델인 Kimi-K3가 82.24\% 로 모든 모델 중 가장 높았습니다. Claude Opus 4.6은 소매에서 68.62\% 지만 자동차 보험에서는 8.30\% 였습니다.
강화 학습 미세조정(RLFT, Reinforcement Learning Fine-Tuning)을 하지 않은 14개 모델의 도메인 평균은 소매 58.81\% , 여행/숙박 39.59\% , 네오뱅크 37.41\% , 컨설팅 36.21\% , 자동차 보험 33.18\% 입니다. 도메인별 과제 수가 비슷하므로, 연구팀은 소매의 우위가 데이터 규모 때문이라기보다 모델들이 표준화된 상거래 워크플로에 더 익숙하기 때문일 수 있다고 해석했습니다. 오픈 웨이트 모델 순위도 크기 순서와 맞지 않습니다. 27B인 Qwen3.8-27B가 1.6T 규모의 DeepSeek-V4-Pro(활성 49B)와 744B 규모의 GLM-5.1(활성 40B)보다 높았고, 675B 규모의 Mistral-Large-3(활성 41B)는 4.66\% 였습니다. 연구팀은 이를 두고 도구 사용, 에이전트 사후 학습, 추론 모드, 상호작용 견고성이 명목상 파라미터 수 못지않게 중요하다고 봤습니다.
한 번 성공하는 것과 매번 성공하는 것
이 논문의 제목인 "One Success Isn't Reliability"가 가리키는 결과가 반복 시도 분석입니다.
| 모델 | pass@1 | pass^20 | pass@20 | 한 번도 못 푼 과제 | 20번 모두 푼 과제 |
|---|---|---|---|---|---|
| Claude Opus 5 | 66.50 | 47.53 | 79.09 | 106 | 241 |
| GPT-5.4 | 65.36 | 30.62 | 91.12 | 45 | 128 |
| GPT-5.6-sol | 61.91 | 22.00 | 86.79 | 67 | 82 |
| Claude Sonnet 4.6 | 59.19 | 25.36 | 88.56 | 58 | 102 |
| GPT-6 Astra | 58.31 | 46.89 | 71.01 | 147 | 231 |
| Kimi-K3 | 57.37 | 17.60 | 93.89 | 31 | 68 |
| Qwen3.8-27B | 51.70 | 10.93 | 89.35 | 54 | 38 |
| DeepSeek-V4-Pro | 43.26 | 6.01 | 84.62 | 78 | 18 |
| GLM-5.1 | 33.19 | 4.75 | 69.82 | 153 | 14 |
단위는 %(과제 수 제외)이며, 507개 과제 기준입니다. 논문의 전체 표에서 9개 모델을 골랐습니다.
Kimi-K3는 20번 안에 한 번이라도 푼 과제가 476개(93.89\% )로 가장 많고, 한 번도 못 푼 과제는 31개뿐입니다. 하지만 20번 모두 성공한 과제는 68개입니다. Claude Opus 5는 반대입니다. 한 번이라도 푼 과제는 79.09\% 로 Kimi-K3보다 적지만, 20번 모두 성공한 과제가 241개로 가장 많습니다. Qwen3.8-27B도 pass@20은 89.35\% 인데 pass^20은 10.93\% 입니다.
pass@1 순위와 신뢰성 순위도 다릅니다. GPT-6 Astra는 pass@1이 5위(58.31\% )지만 pass^20은 46.89\% 로 2위이며, 20번 모두 성공한 과제가 231개로 Claude Opus 5와 비슷합니다. 반면 pass@1이 거의 같은 GPT-5.4는 128개입니다. 연구팀의 표현으로는 "재시도는 성공 경로를 드러낼 수 있지만, 믿을 만한 실행을 보장하지는 않습니다." Hugging Face 블로그도 실제 레코드를 다루는 업무에 모델을 고를 때 pass@20은 봐야 할 지표가 아니라고 정리했습니다.
실패는 어디서 일어나는가
검사기는 성공과 실패만 알려 주고 원인은 알려 주지 않습니다. 그래서 연구팀은 메시지, 도구 호출, 도구 응답, 최종 답변, 종료 표시에서 얻은 결정론적 증거로, 실패한 기록마다 대표 실패 유형 하나를 정해진 우선순위에 따라 붙였습니다. 연구팀은 이 유형이 관측 가능한 진단이며, 유일한 원인 설명은 아니라고 밝혔습니다.
| 실패 유형 | 의미 | 14개 모델 평균 |
|---|---|---|
| 도구 사용(Tool Usage) | 도구 오류, 선행 조건 실패, 빈 조회 결과에서 복구하지 못함. 성공한 것처럼 계속 진행하기도 함 | 79.9\% |
| 잘못된 상태 변경(Wrong State Update) | 쓰기 도구는 성공했지만 결과 상태가 요구사항과 다름 | 10.3\% |
| 불완전한 사용자 응대(Incomplete User Resolution) | 백엔드 작업은 했지만 응답이 불완전하거나 모순되거나 필요한 확인이 빠짐 | 7.0\% |
| 상태 변경 없음(No State-Changing Action) | 필요한 정보는 조회했지만 생성, 수정, 취소, 환불 같은 변경을 하지 않음 | 2.9\% |
도구 사용 실패는 단순히 형식이 틀린 호출만 뜻하지 않습니다. 논문에 실린 네오뱅크 사례에서, 에이전트는 읽기 전용 권한을 쓰기 권한으로 올려 달라는 요청을 받고 정책과 직원 정보, 현재 권한을 차례로 확인했습니다. 그런데 권한 부여 도구가 오류를 돌려주자 기존 권한을 회수하지도, 필요한 지원 티켓을 만들지도 않은 채 성공했다고 답했습니다. 자동차 보험 사례는 잘못된 상태 변경의 예입니다. 에이전트는 지난 12개월 동안 이미 납부 유예를 2번 받았다는 기록을 조회해 티켓에 직접 적어 놓고도, 등급 상한이 2번인 고객에게 3번째 유예를 승인했습니다. 모든 쓰기 도구는 오류 없이 실행되었습니다.
모델별로는 차이가 있습니다. GPT-6 Astra(97.0\% )와 Claude Opus 5(96.4\% )는 실패 대부분이 도구 사용 유형이고, o3-pro(27.8\% ), Grok-4.3(22.5\% ), Qwen3.5-9B(22.5\% )는 잘못된 상태 변경 비중이 높습니다. DeepSeek-V4-Pro는 불완전한 사용자 응대가 24.7\% 입니다. 도메인별로는 자동차 보험의 잘못된 상태 변경 비중이 29.9\% 로 가장 높았습니다.
응답과 도구 호출만 보면 놓치는 실패
상태 기반 채점이 실제로 무엇을 더 잡아내는지 확인하려고, 연구팀은 12개 모델의 공통 과제에서 기록된 유효 시도 121,680개 중 실패 79,853개를 약한 완료 판정 기준과 비교했습니다.
| 실패한 시도 중 해당하는 비율 | 비율 |
|---|---|
| 정상 종료 (완료 표시가 있고 질문이 없는 최종 응답) | 84.86\% |
| 정상 종료 + 상태 변경 도구 호출 | 80.88\% |
| 위 조건 + 마지막 도구 응답에 명시적 오류 없음 | 67.24\% |
| (상태 검사가 찾아낸 근거) 잘못된 필드 값 | 77.61\% |
| (상태 검사가 찾아낸 근거) 의도하지 않은 추가 변경 | 43.30\% |
| (상태 검사가 찾아낸 근거) 필요한 변경 누락 | 25.36\% |
실패한 시도의 3분의 2는 응답이나 도구 호출만 보는 평가에서는 완료로 보였을 것입니다. 상태 검사가 찾아낸 근거들은 서로 겹칠 수 있습니다.
기록이 길거나 도구를 많이 호출한다고 결과가 좋아지지도 않았습니다. GLM-5.1은 시도당 평균 메시지가 44.86개로 가장 길고, Qwen3.8-27B는 도구 호출이 평균 12.11번으로 가장 많았지만, 둘 다 GPT-5.4보다 성능이 낮았습니다. 모델 호출 한 번에 처리하는 토큰은 누적된 대화, 도구 스키마, 상호작용 기록 때문에 평균 12K에서 41K 정도였습니다.
HumanEval+로 확인한 하네스 재현성과 변별력
연구팀은 ThinkingBox가 다른 벤치마크를 담을 수 있는지, 그리고 ThinkingBox-Bench의 큰 점수 차이가 단일 턴 코드 생성에서도 유지되는지 확인하려고 HumanEval+를 샌드박스에 통합했습니다. 프레임워크는 고치지 않고 과제 데이터와 공식 EvalPlus 채점기를 호출하는 훅만 추가했습니다.
먼저 2026년 9월 16일 EvalPlus 리더보드에 공개된 OpenAI 모델 4개(GPT-4o, GPT-4o-mini, GPT-4-Turbo, GPT-3.5-Turbo)를 같은 조건으로 실행하자, 공개 점수가 모두 샌드박스 실행의 95\% 신뢰구간 안에 들어왔습니다. 연구팀은 이 결과가 시험한 설정에서 비교 가능한 점수를 뒷받침하지만, 동등성을 증명하지는 않는다고 밝혔습니다.
두 벤치마크를 함께 평가한 8개 모델의 점수 범위는 크게 달랐습니다. HumanEval+ pass@1은 90.73\% 에서 95.24\% 사이로 4.51 포인트 안에 몰렸지만, ThinkingBox-Bench에서는 19.31\% 에서 66.50\% 까지 47.19 포인트 차이가 났습니다. o3-pro는 ThinkingBox-Bench에서 GPT-5.4보다 46.05 포인트 낮았지만 HumanEval+에서는 3.17 포인트만 낮았습니다. 반복 성공의 격차도 달랐습니다. GPT-5.4의 HumanEval+ pass@5와 5번 모두 성공 비율 차이는 8.54 포인트였지만, ThinkingBox-Bench의 pass@20과 pass^20 차이는 60.50 포인트였습니다. 연구팀은 시도 횟수와 추정 방식이 달라 두 값은 같은 기준의 난이도 비교가 아니라고 덧붙였습니다.
비용: 성공 한 번의 가격과 매번 성공의 가격
연구팀은 각 모델이 507개 과제를 20번 실행하는 동안 쓴 토큰을 2026년 9월 20일 OpenRouter의 가장 저렴한 엔드포인트(양자화(quantization)를 표시한 엔드포인트는 제외) 가격으로 환산했습니다. 실제 청구액이 아니라 사용량 기반 추정치이며, 시뮬레이터와 판정기 비용, 인프라 비용은 빠져 있습니다.
| 모델 | pass@1 (%) | 성공 1회당 비용 | 20번 모두 푼 과제 수 | 20번 모두 푼 과제 1개당 비용 |
|---|---|---|---|---|
| GPT-5.6-sol | 61.91 | $0.127 | 82 | $9.76 |
| GPT-5.4 | 65.36 | $0.131 | 128 | $6.80 |
| Qwen3.8-27B | 51.70 | $0.177 | 38 | $24.36 |
| Kimi-K3 | 57.37 | $0.242 | 68 | $20.68 |
| GPT-6 Astra | 58.31 | $0.291 | 231 | $7.45 |
| Claude Opus 5 | 66.50 | $0.475 | 241 | $13.30 |
| o3-pro | 19.31 | $18.796 | 4 | $9,200.75 |
논문의 18개 모델 비용 표에서 7개 모델을 골랐습니다. 마지막 열은 20회 전체 실행 비용을 20번 모두 성공한 과제 수로 나눈 값입니다.
성공 1회당 비용과 pass@1로 그린 파레토(Pareto) 경계에는 GPT-5.6-sol, GPT-5.4, Claude Opus 5가 올랐습니다. 20번 모두 성공한 과제 1개당 비용을 기준으로 하면 GPT-5.4, GPT-6 Astra, Claude Opus 5가 경계에 오릅니다. GPT-5.6-sol은 성공 1회당 비용은 가장 낮지만 매번 성공하는 과제 기준으로는 3위로 내려가고, GPT-6 Astra는 성공 1회당 비용 8위에서 2위로 올라갑니다. 가장 싸게 한 번 성공하는 모델과 가장 싸게 매번 성공하는 모델이 서로 다릅니다.
ThinkingBox 판정으로 강화 학습하기
판정 V 가 결정론적인 0 또는 1이므로, 연구팀은 이를 최종 보상으로 삼아 Qwen 모델을 GRPO(Group Relative Policy Optimization) 로 학습했습니다. 같은 문제에 여러 응답을 생성한 뒤 그룹 안의 상대적인 보상으로 정책을 갱신하는 강화 학습 방법입니다(PyTorchKR의 GRPO:Zero 소개글도 참고할 수 있습니다). 학습 과제는 벤치마크 507개와 겹치지 않는 별도 집합에서 골랐습니다. 기반 모델로 미리 여러 번 실행해 본 성공 횟수에 Jeffreys 사전분포를 적용해 과제 난이도를 5단계로 나누고, '어려움'과 '보통' 과제(전체 파라미터 학습에서는 '쉬움'까지)만 남겼습니다.
| 모델 | 학습 방식 | 학습 과제 | 학습 전 pass@1 | 학습 후 pass@1 |
|---|---|---|---|---|
| Qwen3.8-27B | 전체 파라미터 미세조정, H100 24장 | 187 | 51.70 | 60.78 |
| Qwen3.6-27B | LoRA (r=16 , \alpha=32 ), H100 16장 | 168 | 32.94 | 53.17 |
| Qwen3.5-9B | LoRA (r=16 , \alpha=32 ), H100 16장 | 157 | 5.65 | 13.33 |
학습한 Qwen3.8-27B는 pass@1에서 GPT-6 Astra(58.31\% )와 Kimi-K3(57.37\% )를 넘었습니다. 특히 네오뱅크 도메인에서 47.88\% 에서 62.40\% 로 올랐습니다. 다만 학습 중에는 시뮬레이터와 판정기로 GPT-5 Chat을 썼고, 평가 때는 GPT-5.4-mini를 썼습니다. 표에 적은 것은 pass@1뿐이고, 학습한 모델의 pass^20은 논문에 보고되지 않았습니다. 학습 코드 저장소 microsoft/thinkingbox-training 은 논문에 링크되어 있지만 2026년 10월 6일 기준으로 접근할 수 없고, Hugging Face 블로그는 "coming soon"으로 표시하고 있습니다.
Hugging Face 블로그에서 추가된 내용
Microsoft와 Hugging Face가 함께 쓴 Hugging Face 블로그 글은 논문에 없는 결과를 두 가지 더했습니다.
첫째, Claude Opus 5.5의 결과입니다. pass@1은 67.16\% 로 Claude Opus 5보다 0.66 포인트 높아 전체 1위지만, 20번 모두 성공한 과제는 241개로 Claude Opus 5와 같습니다. 블로그는 이를 "헤드라인 정확도가 0.5포인트 올랐지만 신뢰성은 전혀 늘지 않았다"고 정리했습니다. 비용 경계에서는 Claude Opus 5.5가 성공 1회당 $0.276, 20번 모두 푼 과제 1개당 $7.80으로 Claude Opus 5를 대신합니다. 블로그는 Opus 5.5의 가격만 Anthropic 사이트 기준이라고 밝혔습니다.
둘째, 실행 경로입니다. ThinkingBox-Bench가 OpenEnv 인터페이스 뒤에 thinkingbox_env 환경으로 들어가, 에피소드가 끝나면 통과 또는 실패의 이진 보상을 돌려줍니다. OpenEnv 환경 README에 따르면 이 어댑터는 현재 평가 전용이며, 직접 만든 ThinkingBox 시나리오를 실행한 결과는 공식 ThinkingBox-Bench 결과로 보지 않습니다. 이 어댑터는 인프라 오류를 실패로 세지 않고 따로 기록하므로, 시스템 오류를 실패로 센 논문 수치와 비교하려면 그 시도를 다시 실행하거나 집계에 반영해야 합니다. OpenEnv 환경 코드는 BSD-3-Clause 라이선스입니다.
블로그는 실패 분석에서 얻은 운영 권고도 덧붙였습니다. 커밋 전에 모델의 요약이 아니라 최종 상태를 확인하고, 복구 가능한 오류만 재시도하도록 오류를 분류하고, 워크플로에 필요한 도구만 남기고, 되돌리기 어려운 변경에는 사람의 승인을 요구하라는 내용입니다. 블로그는 이런 조치의 효과를 이 벤치마크에서 측정하지는 않았다고 함께 밝혔습니다.
한계점
연구팀은 부록에 한계를 따로 정리했습니다.
최종 응답은 대부분 채점하지 않습니다. 507개 중 477개는 백엔드 상태와 부수 효과만으로 판정합니다. 상태를 올바르게 바꾸고 사용자에게 결과를 잘못 전달한 시도도 성공으로 셀 수 있습니다. 연구팀은 모든 과제에 LLM 판정 루브릭을 넣으면 판정에 판정기의 편차가 들어오므로 주 지표를 결정론적으로 유지하기 위해 이 비대칭을 받아들였다고 설명합니다. 따라서 보고된 통과율은 정책에 맞는 백엔드 결과를 측정하며, 사용자와의 소통 품질은 측정하지 않습니다.
협조적이고 고정된 사용자만 시험합니다. 시뮬레이터는 목표를 바꾸지 않고, 주어진 정보만 말하며, 협조적이고, 후속 턴은 최대 10번입니다. 세부 정보를 잘못 기억하거나, 목표를 바꾸거나, 비협조적으로 변하는 사용자는 다루지 않습니다. 또한 모든 실험이 GPT-5.4-mini 시뮬레이터 하나를 썼고, 이 모델이 평가 대상인 GPT 계열과 같은 계열이라 상호작용 방식의 영향을 배제할 수 없습니다.
과제는 합성 재구성이며 정답 상태가 하나입니다. 비공개 원본에서 구조를 가져와 다시 만든 과제라 기업 업무의 분포를 대표하지 않습니다. 정답 최종 상태가 하나인 과제만 남겼으므로, 여러 해결책이 모두 타당한 워크플로는 처음부터 빠져 있습니다. 결과는 종료 표시, 턴과 토큰 상한 같은 하네스 설정에도 영향을 받습니다.
여기에 저장소와 블로그에서 확인한 사항을 더하면 다음과 같습니다. 벤치마크 데이터의 사용 목적은 평가로 한정되어 있습니다. PyTorchKR에서 소개한 Auto-BenchMax처럼 벤치마크와 같은 분포의 데이터를 합성해 점수를 올리는 사례가 이미 나온 만큼, 이 제한을 지키지 않은 결과는 비교하기 어렵습니다. 또한 HumanEval+ 부록에서 연구팀은 Claude 모델의 요청 설정과 반환된 모델 ID를 확인하지 못했다고 밝혔습니다. 이 단서는 HumanEval+ 실험에만 적혀 있습니다.
ThinkingBox는 "에이전트가 일을 끝냈는가"를 응답 문장이 아니라 데이터 상태로 묻고, "매번 끝내는가"를 20번의 반복으로 묻는 평가 틀입니다. 보고된 숫자는 특정 시점의 모델과 설정에 묶여 있지만, 실제 레코드를 다루는 에이전트를 만드는 팀이라면 이 두 질문을 자기 평가에 그대로 옮겨 볼 수 있습니다. 연구팀이 블로그에서 요청한 것도 반복 지표를 보고할 때 best-of-k인지 every-of-k인지, 어떻게 계산했는지 밝히라는 것이었습니다.
ThinkingBox-Bench 실행 방법
아래 절차는 thinkingbox-data 저장소의 ThinkingBox-Bench v1.0 문서를 따른 것입니다. 이 글을 쓰면서 직접 실행해 보지는 않았습니다. Linux 또는 WSL 환경, Python 3.12, uv 가 필요하고, 에이전트, 시뮬레이션 사용자, 판정기로 쓸 LLM 엔드포인트가 있어야 합니다.
- 두 저장소를 나란히 받고, 데이터 저장소를 벤치마크 릴리스 태그로 고정합니다:
git clone https://github.com/microsoft/thinkingbox.git
git clone https://github.com/microsoft/thinkingbox-data.git

cd thinkingbox-data
git checkout thinkingbox-bench-v1.0
cd ../thinkingbox
thinkingbox/디렉터리에서 가상환경을 만들고, 벤치마크용 MCP 서버 패키지와 Typesense를 설치합니다:
uv venv --python 3.12
uv sync --group dev
source .venv/bin/activate

uv pip install --config-settings editable-mode=compat \
    -e ../thinkingbox-data/servers/tb_business_ops_servers_202606
./scripts/install_typesense.sh
-
config/config_o4mini.yaml같은 설정 파일에 LLM 엔드포인트를 적습니다. Azure OpenAI, OpenAI 호환 엔드포인트, Anthropic을 지원합니다. -
첫 번째 터미널의
thinkingbox/디렉터리에서 Typesense와 MCP Session Proxy를 띄웁니다.All processes are running이 출력될 때까지 기다린 뒤 이 터미널은 그대로 둡니다:
export THINKINGBOX_DATA="../thinkingbox-data"
export TB_MCP_START_SERVERS_FILE="../thinkingbox-data/servers/servers.yaml"
./scripts/background_tasks.sh
- 두 번째 터미널의
thinkingbox/디렉터리에서 507개 과제를 20번씩 실행하고 집계합니다:
source .venv/bin/activate

uv run tb infer -c config/config_o4mini.yaml \
    --dataset ../thinkingbox-data/dataset --agent think \
    --test-list ../thinkingbox-data/releases/thinkingbox_bench_v1/testlist_thinkingbox_bench_v1.yaml \
    --repeat 20 --batch-size 20 \
    --output output_thinkingbox_bench_v1.jsonl

uv run tb agg output_thinkingbox_bench_v1.jsonl
모든 과제의 시도 횟수가 20번으로 같으면 tb agg 가 pass@1, pass@20, pass^20을 함께 출력합니다. 문서는 결과를 공개할 때 두 저장소의 커밋, 설정 파일, 모델 배포와 추론 파라미터, 시뮬레이터 모델, 판정기 모델을 함께 기록하라고 안내합니다. 전체 실행은 모델당 10,140번의 대화입니다. 설정만 먼저 확인하려면 --test-list 대신 --name sandbox_external_retail_group1.py:test_case_ST003_006 처럼 과제 하나를 지정해 실행할 수 있습니다. OpenEnv로 실행하는 방법은 Hugging Face 블로그의 "Run it yourself" 절에 있습니다.
 One Success Isn't Reliability: Thinkingbox, a Sandbox and Benchmark for Agents in Stateful Business Workflows 논문
The Agent Said It Was Done. The Database Disagreed. 소개 블로그
 ThinkingBox GitHub 저장소
ThinkingBox-Data GitHub 저장소
 ThinkingBox-Bench 데이터셋 (Hugging Face)
OpenEnv ThinkingBox 환경 GitHub 저장소
더 읽어보기
- NVIDIA가 정리한 AI 에이전트 평가: 도구 호출 정확도 대신 과업 완수를 채점하는 지표들과 트레이스 읽는 법
- OpenEnv 프로젝트 소개: 에이전트 강화학습 환경의 공통 인터페이스가 되기까지 (feat. Meta, Hugging Face)
- Auto-BenchMax: 벤치마크와 같은 분포로 데이터를 합성해 MCP-Atlas 점수를 2배로 올린 파이프라인
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
