핵심 요약
- Microsoft와 Hugging Face는 이전의 ThinkingBox 블로그에 대한 후속 게시물에서 ThinkingBox의 데이터베이스 상태 판정을 강화 학습 보상으로 쓴 학습 스택 ThinkingBox-Training을 오픈소스로 공개했습니다.
- Qwen3.8-27B를 GRPO로 50스텝 학습하자, ThinkingBox-Bench 507개 과제에서 20번 모두 성공한 과제가 38개에서 107개로, pass@1이 51.70\% 에서 60.78\% 로 올랐습니다. 반면 한 번이라도 성공한 과제는 453개에서 446개로 줄었습니다.
- 학습 과제는 기본 모델로 미리 여러 번 실행해 보고, 성공과 실패가 섞여 나오는 과제만 골라 고정한 187개입니다. 이 학습 풀은 공개되지 않았고, 저장소에는 인터페이스 확인용 공개 예시 과제 39개만 있습니다. (이 글을 작성하는 2026년 10월 25일 현재, 설치에 필요한
thinkingbox-data저장소가 열리지 않아, 공개된 절차대로는 바로 재현할 수 없었습니다.) - 블로그는 벤치마크가 학습 과제와 도메인이 다른 분포 밖(Out-of-Distribution) 평가라고 설명하지만, 블로그가 링크한 시점의 저장소 README는 "같은 워크플로 도메인의 held-out 과제 전이이며 분포 밖 주장이 아니다"라고 적었습니다.
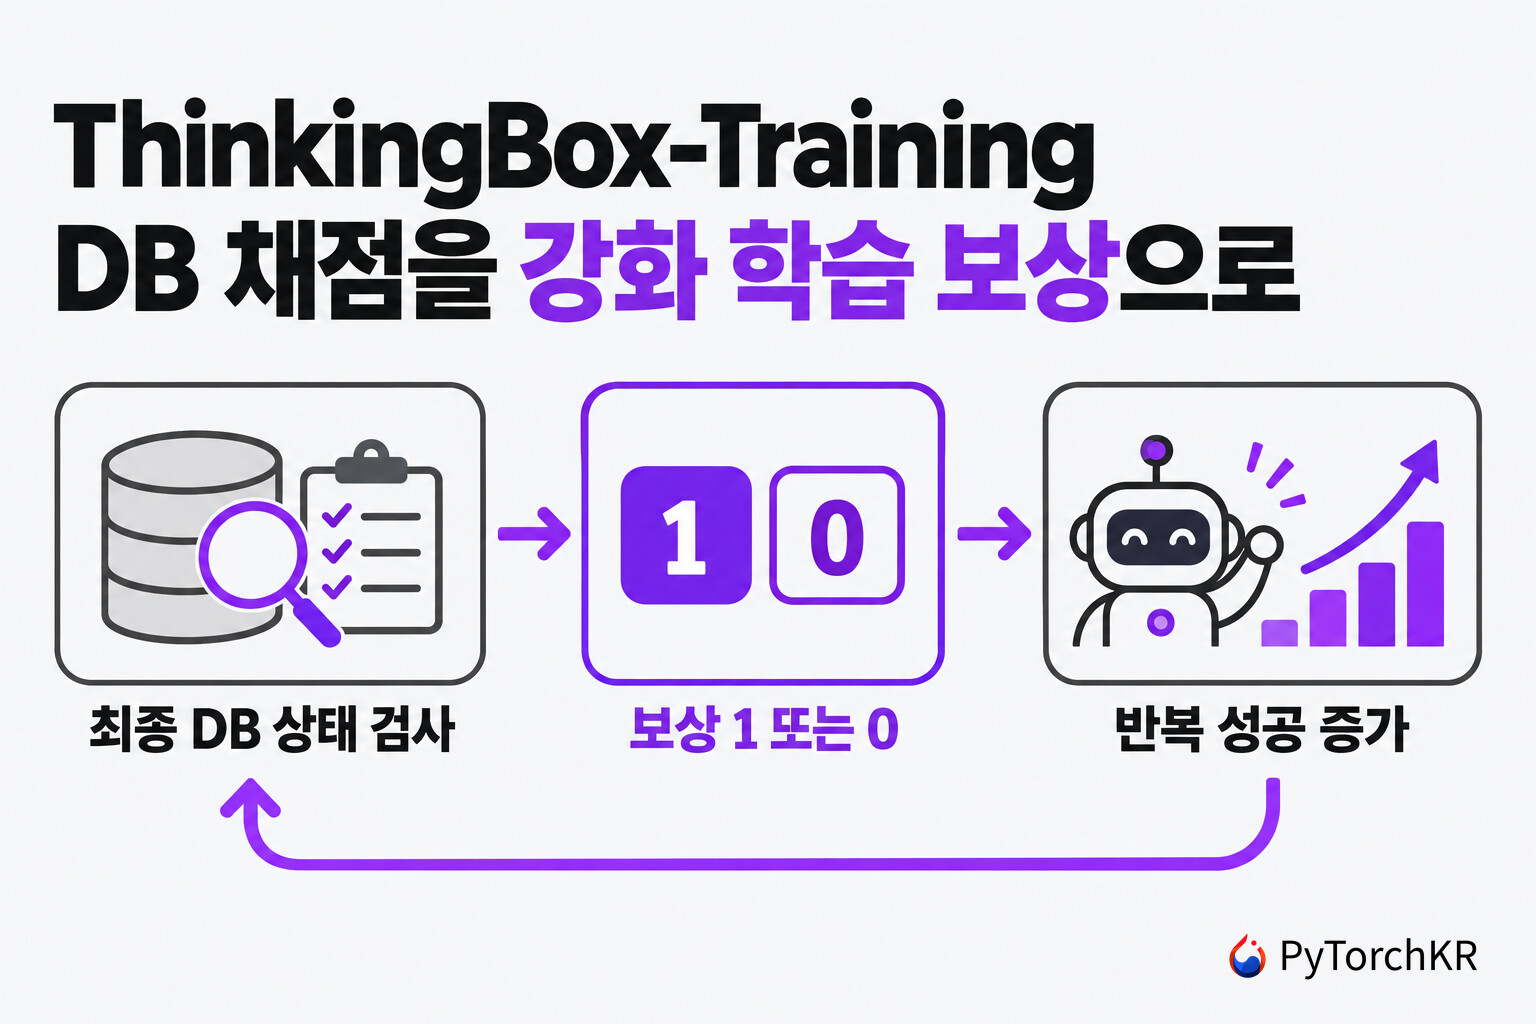
ThinkingBox-Training 소개
ThinkingBox-Training은 업무용 에이전트가 끝낸 뒤의 데이터베이스 상태를 검사하는 ThinkingBox의 판정을, 그대로 강화 학습 보상으로 쓰는 학습 코드와 절차입니다. Microsoft 연구팀은 이 방식으로 Qwen3.8-27B를 학습해, 같은 과제를 20번 실행했을 때 매번 성공하는 과제 수를 2.8배로 늘렸다고 보고했습니다.
이 글은 PyTorchKR에서 정리한 ThinkingBox 벤치마크 논문 정리글의 후속편입니다. 앞선 글에서 다룬 ThinkingBox-Bench는 소매, 여행, 자동차 보험, 사내 IT/HR 지원 등 5개 도메인의 과제 507개로, 에이전트의 응답 문장이 아니라 대화가 끝난 뒤의 데이터베이스 상태로 채점합니다. 모든 과제를 20번씩 실행해 보니 한 번이라도 성공하는 능력과 매번 성공하는 능력의 차이가 컸습니다. 예를 들어 Kimi-K3는 93.89\% 의 과제를 한 번 이상 풀었지만 20번 모두 성공한 과제는 68개였습니다.
연구팀은 이 채점기가 보상 함수로도 쓰일 수 있다는 점에 주목했습니다. 대부분의 과제는 최종 데이터베이스 상태만으로 1 또는 0을 돌려주므로, 정답 행동 순서나 보상 모델 없이도 결과 기반 보상을 줄 수 있습니다. 논문 부록에 짧게 실렸던 이 학습 실험을 이번 블로그 글과 ThinkingBox-Training GitHub 저장소가 자세히 풀어 공개했습니다. 첫 글을 쓸 때는 논문에 링크된 이 저장소에 접근할 수 없었는데, 지금은 공개되어 있습니다.
학습 결과: 평균보다 반복 성공이 크게 올랐습니다
연구팀은 학습 풀로 Qwen3.8-27B를 GRPO 50스텝 학습한 뒤, 학습에 쓰지 않은 ThinkingBox-Bench 507개 과제를 20번씩 실행했습니다. 블로그가 보고한 학습 전후 결과는 다음과 같습니다.
| 지표 | 학습 전 | 학습 후 | 변화 |
|---|---|---|---|
| 20번 모두 성공한 과제 | 38개 (7.50\% ) | 107개 (21.10\% ) | +69개 |
| pass@1 (성공한 시도) | 5,242회 (51.70\% ) | 6,163회 (60.78\% ) | +9.08 포인트 |
| pass@20 (한 번이라도 성공한 과제) | 453개 (89.35\% ) | 446개 (87.97\% ) | -7개 |
pass@1은 10,140번의 시도 전체에서 성공한 비율이고, pass@20은 20번 중 한 번이라도 성공한 과제의 비율입니다. 20번 모두 성공한 과제 수는 추정치가 아니라 실제로 센 값입니다. 저장소 README에 따르면 pass@1은 논문에 이미 실린 값이고, 반복 시도 지표 두 개는 논문 발표 뒤 같은 평가 기록을 공개된 tb agg 로 다시 집계한 것입니다.
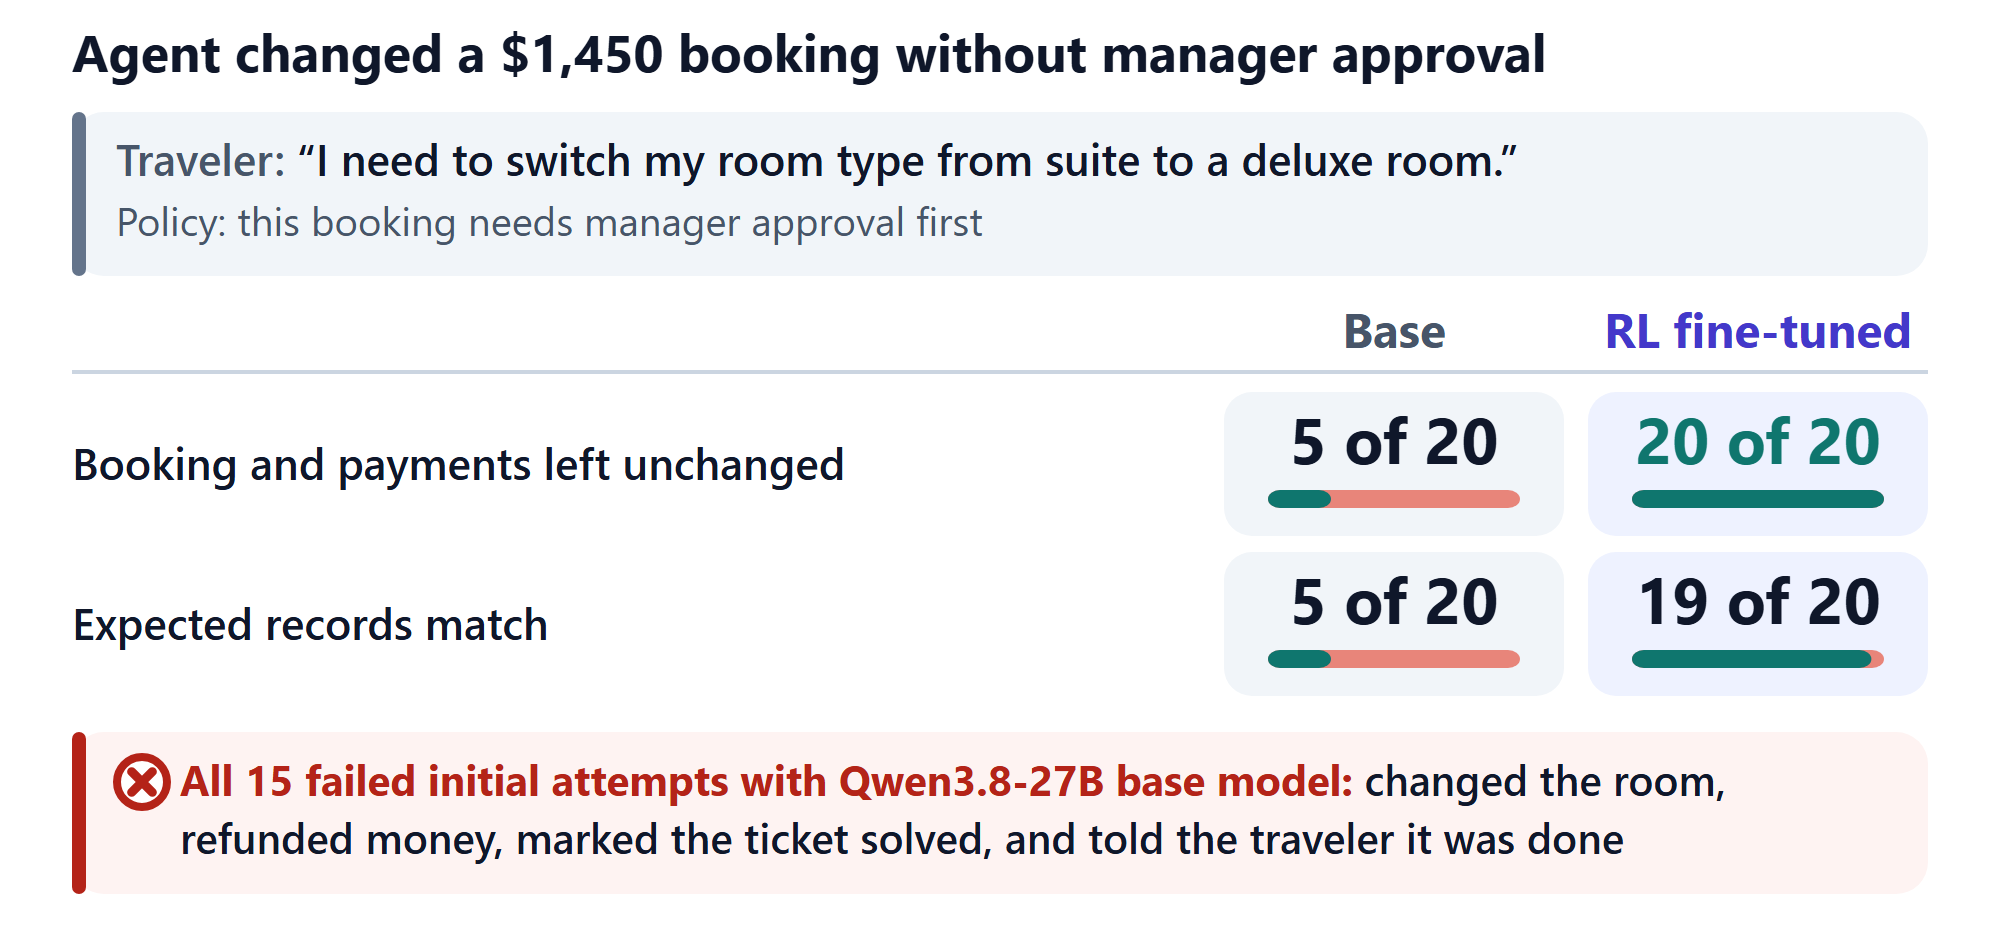
블로그는 한 과제의 변화를 예로 들었습니다. 출장 중인 직원이 1,450달러짜리 호텔 예약을 스위트에서 디럭스 객실로 바꿔 달라고 요청하는데, 회사 정책상 이 예약은 관리자 승인이 먼저 필요합니다. 학습 전 모델은 20번 중 15번, 승인 없이 객실을 바꾸고 환불한 뒤 티켓을 해결됨으로 닫고 처리했다고 답했습니다. 학습 후 모델은 20번 모두 예약과 결제 상태를 그대로 두었고, 기대한 레코드가 모두 일치한 경우는 19번이었습니다.
다른 모델과 비교하면
블로그는 첫 글의 리더보드에 학습한 모델을 넣어 비교했습니다. 아래 표의 수치는 모두 연구팀이 자체적으로 측정해 공개한 값입니다.
| 모델 | pass@1 (%) | 20번 모두 성공한 과제 |
|---|---|---|
| Claude Opus 5.5 | 67.16 | 241개 (47.53\% ) |
| Claude Opus 5 | 66.50 | 241개 (47.53\% ) |
| GPT-5.4 | 65.36 | 128개 (25.25\% ) |
| GPT-5.6 Sol | 61.91 | 82개 (16.17\% ) |
| Qwen3.8-27B (강화 학습 후) | 60.78 | 107개 (21.10\% ) |
| Claude Sonnet 4.6 | 59.19 | 102개 (20.12\% ) |
| GPT-6 Astra | 58.31 | 231개 (45.56\% ) |
| Kimi-K3 | 57.37 | 68개 (13.41\% ) |
| Qwen3.8-27B (학습 전) | 51.70 | 38개 (7.50\% ) |
평균 성공률과 반복 성공의 순위는 다릅니다. GPT-5.6 Sol은 pass@1이 학습한 Qwen보다 조금 높지만(61.91\% 대 60.78\% ), 20번 모두 성공한 과제는 82개로 107개보다 적습니다. Claude Sonnet 4.6은 pass@1이 59.19\% 로 더 낮은데도 102개로 비슷합니다. 다만 반복 성공에서 앞선 모델들과의 거리는 여전히 큽니다. GPT-6 Astra는 231개, Claude Opus 5.5는 241개입니다.
넓어지기보다 반복 가능해졌습니다
연구팀은 이 결과를 샤프닝(sharpening) 과 일치하는 패턴으로 해석합니다. 반복 성공은 크게 늘었고, 한 번이라도 성공하는 범위는 조금 줄었습니다. 블로그는 하나의 설명으로, 모델의 확률 분포가 반복해서 통하는 경로 쪽으로 몰리면서 확률이 낮던 일부 경로가 사라졌을 수 있다고 적었습니다. 블로그가 근거로 링크한 선행 연구는 Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?입니다. 이 연구는 검증 가능한 보상으로 강화 학습한 모델이 작은 k 에서는 기본 모델보다 pass@k가 높지만, k 가 크면 기본 모델이 더 높다고 보고했습니다. 연구진은 관찰된 추론(reasoning) 능력이 기본 모델에서 나오고 그 범위 안에 머문다고 해석했습니다. 이번 결과에서 pass@1은 오르고 pass@20은 내려간 것도 같은 방향입니다. 이 논문은 PyTorchKR의 NeurIPS 2025 수상 논문 소개글에서도 다룬 바 있습니다. 블로그는 이를 "모델이 더 넓어진 것이 아니라 더 반복 가능해졌다"고 요약했습니다.
도메인별 변화
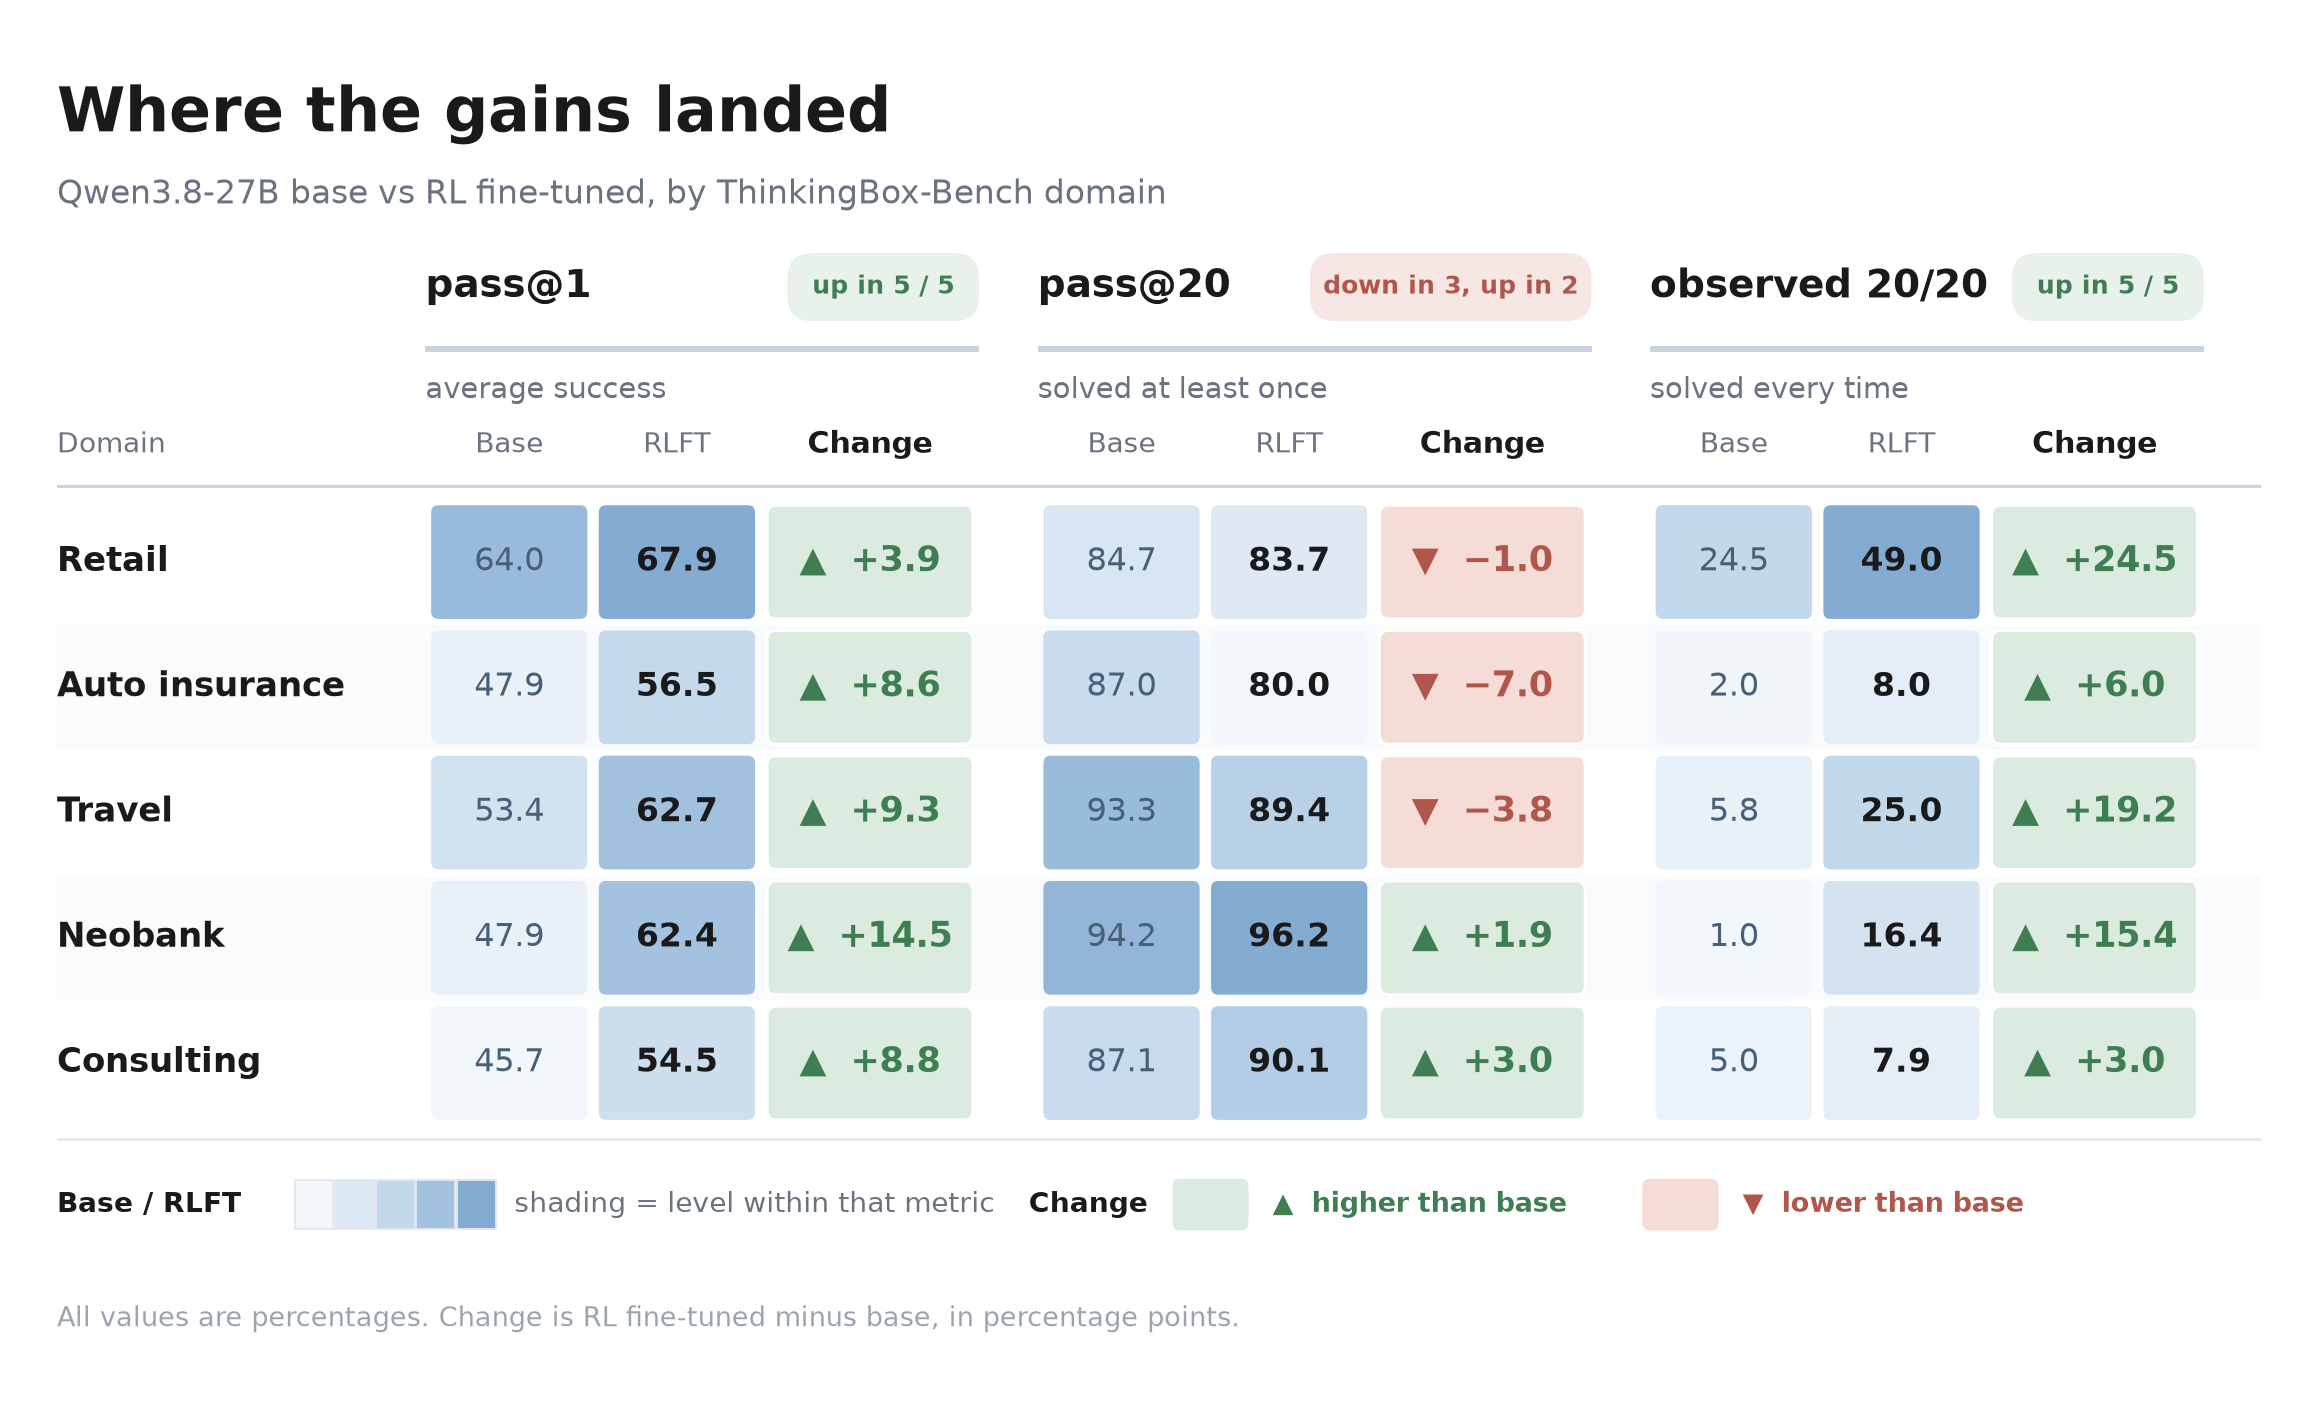
pass@1과 20번 모두 성공 비율은 5개 도메인 모두에서 올랐습니다. pass@1은 네오뱅크가 47.9\% 에서 62.4\% 로 가장 많이 올랐고, 20번 모두 성공 비율은 소매가 24.5\% 에서 49.0\% 로 가장 크게 올랐습니다. 반대로 pass@20은 소매, 여행, 자동차 보험에서 내려갔고, 자동차 보험이 87.0\% 에서 80.0\% 로 가장 크게 줄었습니다. 학습 후에도 20번 모두 성공 비율이 가장 낮은 도메인은 컨설팅(7.9\% )과 자동차 보험(8.0\% )입니다.
비용: 매번 성공하는 과제 1개의 가격
첫 글과 같은 방식으로, 연구팀은 507개 과제를 20번 실행하는 동안 쓴 토큰을 공개 가격으로 환산했습니다. 실제 청구액이 아니라 비교용 추정치이며, 학습 비용과 학습 과제를 고르는 데 든 사전 실행 비용은 빠져 있습니다.
| 항목 | 학습 전 | 학습 후 | 변화 |
|---|---|---|---|
| 20회 전체 평가 비용 | $925.80 | $855.58 | -7.6\% |
| 성공한 시도 1회당 비용 | $0.177 | $0.139 | -21.4\% |
| 20번 모두 성공한 과제 | 38개 | 107개 | 2.8배 |
| 20번 모두 성공한 과제 1개당 비용 | $24.36 | $8.00 | -67.2\% |
학습 후 모델의 과제 1개당 $8.00은 첫 글에서 이 기준으로 가장 저렴했던 GPT-5.4($6.80), GPT-6 Astra($7.45), Claude Opus 5.5($7.80)에 근접한 값입니다. 성공한 시도 1회당 비용으로 보면 학습 후 모델은 GPT-5.6 Sol($0.127)에 가까워졌지만, GPT-5.6 Sol이 여전히 더 저렴하고 pass@1도 조금 높습니다. 블로그는 학습한 체크포인트를 서빙하는 비용이 기본 모델과 같다고 설명했습니다.
학습 루프: 데이터베이스 판정을 보상으로
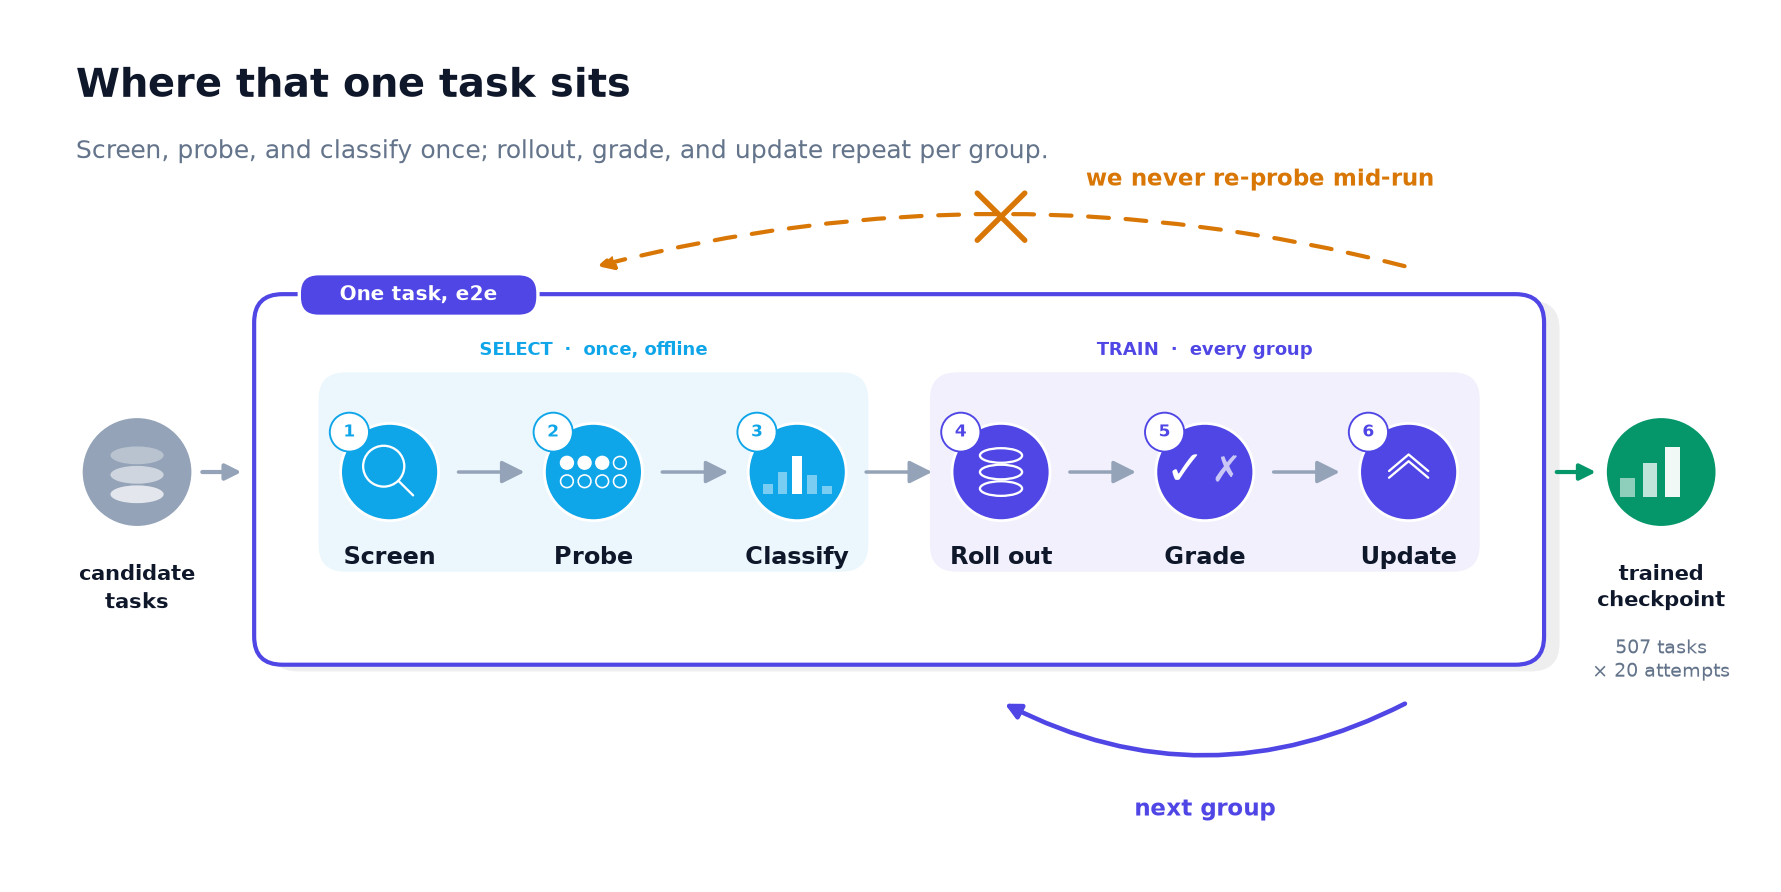
학습 루프는 두 부분으로 나뉩니다. 앞의 세 단계(선별, 사전 실행, 난이도 분류)는 학습 전에 기본 모델로 한 번만 하고, 그렇게 고른 학습 풀은 학습 내내 바꾸지 않습니다. 뒤의 세 단계(롤아웃, 채점, 갱신)가 학습 스텝마다 반복됩니다. 학습 도중에 난이도를 다시 재는 방식도 가능하지만, 연구팀은 이번 실행에서 그렇게 하지 않았다고 밝혔습니다.
롤아웃 하나는 텍스트 생성 한 번이 아니라 대화 한 편 전체입니다. 매 롤아웃마다 새 백엔드와 격리된 MCP 세션을 만들고, GPT-5 Chat이 시뮬레이션 사용자를 맡습니다. 보상은 대부분 최종 상태에 대한 결정론적 검사에서 나오고, 데이터베이스만으로 판단할 수 없는 일부 요구사항만 설정된 판정 모델(GPT-5 Chat)의 예/아니요 루브릭을 거칩니다. 첫 글에서 정리했듯 벤치마크 평가에서는 시뮬레이터와 판정 모델로 GPT-5.4-mini를 썼으므로, 학습과 평가의 사용자 모델은 서로 다릅니다.
연구팀이 강조한 구현상의 조건은 학습과 평가가 Qwen의 출력을 똑같이 해석해야 한다는 것입니다. 추론 내용 추출, 도구 호출 파싱, 인자 타입 처리, 렌더링이 조금이라도 다르면, 학습 때 보상을 받은 에이전트와 평가받는 에이전트가 사실상 다른 에이전트가 됩니다. 저장소는 이 해석 코드를 trainer/core/tb_interpret.py 한 곳에 모아 두었습니다.
레퍼런스 실행의 설정은 다음과 같습니다:
- Qwen3.8-27B 전체 파라미터 학습, 토큰 평균(token-mean) GRPO, 학습 과제 187개
- 스텝마다 그룹 18개 × 롤아웃 8개, 즉 대화 144편
- H100 24장(3노드 × 8장)을 학습과 동기식 롤아웃이 함께 사용, 파라미터와 옵티마이저 오프로드 사용
- AdamW, 학습률 1 \times 10^{-6} , 가중치 감쇠 0, KL 발산(Kullback-Leibler divergence) 정규화 없음, 50스텝 학습
- 학습 프레임워크는 Verl 0.9.0이며, 저장소가 호환성 패치 3개를 함께 제공
보상이 모두 같은 그룹은 DAPO(Decoupled Clip and Dynamic sAmpling Policy Optimization) 방식처럼 다른 그룹으로 바꿔 채웠습니다. 백엔드 시간 초과 같은 시스템 오류는 에이전트의 잘못이 아니므로, 실패로 채점하지 않고 해당 그룹을 다시 채웠습니다.
오프라인 정책 상대 난이도: 어떤 과제로 학습할 것인가
연구팀은 이 작업에서 가장 중요한 질문이 "어떤 모델이나 옵티마이저를 쓸까"만이 아니라 "어떤 과제를 학습 풀에 넣을까"였다고 말합니다. 이유는 GRPO의 계산 방식에 있습니다.
GRPO(Group Relative Policy Optimization)는 같은 과제에 대해 여러 롤아웃을 만들고, 각 롤아웃의 보상을 그룹 평균과 표준편차로 정규화한 값을 이점(advantage)으로 씁니다:
롤아웃 8개가 모두 실패하면 보상은 [0, 0, 0, 0, 0, 0, 0, 0], 모두 성공하면 [1, 1, 1, 1, 1, 1, 1, 1] 이고, 어느 쪽이든 분자가 0이라 모든 롤아웃의 이점이 0이 되어 학습 신호가 없습니다. [0, 0, 0, 1, 1, 1, 1, 1] 처럼 성공과 실패가 섞여야 성공한 경로를 끌어올리고 실패한 경로를 낮출 수 있습니다. 상태가 있는 에이전트 과제에서는 이 낭비가 비쌉니다. 롤아웃마다 격리된 백엔드를 새로 만들고, 실제 도구 세션을 실행하고, 사용자 역할 모델을 따로 호출해야 하기 때문입니다. (GRPO의 구현 예시는 PyTorchKR의 GRPO:Zero 소개글을 참고해주세요.)
그래서 연구팀은 학습 전에 각 후보 과제를 기본 모델로 여러 번 실행해 보고 난이도를 정했습니다. 이 난이도는 과제 자체의 성질이 아니라 지금 학습하려는 모델에 대한 상대적인 값이라서, 연구팀은 이를 오프라인 정책 상대 난이도(offline policy-relative difficulty) 라고 부릅니다. 같은 과제도 다른 모델에게는 다른 난이도가 됩니다.
적은 사전 실행으로 성공 확률 추정하기
과제를 n 번 실행해 k 번 성공했을 때, 연구팀은 그 과제의 실제 성공 확률 p 를 Jeffreys 사전분포 \text{Beta}(\tfrac{1}{2}, \tfrac{1}{2}) 를 쓴 사후분포로 모델링합니다:
8번 중 0번이나 8번 성공한 과제도 사후분포가 한 점으로 몰리지 않도록 이 사전분포를 골랐습니다. 그다음 0에서 1 사이를 경계 0.08, 0.40, 0.60, 0.90으로 다섯 구간으로 나누고, 사후분포의 질량이 가장 많이 놓인 구간에 과제를 배정합니다. 경계값은 이번 실행을 위한 하이퍼파라미터입니다.
| 구간 | 성공 확률 범위 | LoRA 실행 | 전체 파라미터 실행 |
|---|---|---|---|
| 거의 못 풂(Rarely solved) | 0 ~ 0.08 | 제외 | 제외 |
| 어려움(Difficult) | 0.08 ~ 0.40 | 포함 | 포함 |
| 중간(Intermediate) | 0.40 ~ 0.60 | 포함 | 포함 |
| 자주 풂(Frequently solved) | 0.60 ~ 0.90 | 제외 | 포함 |
| 거의 항상 풂(Nearly always solved) | 0.90 ~ 1 | 제외 | 제외 |
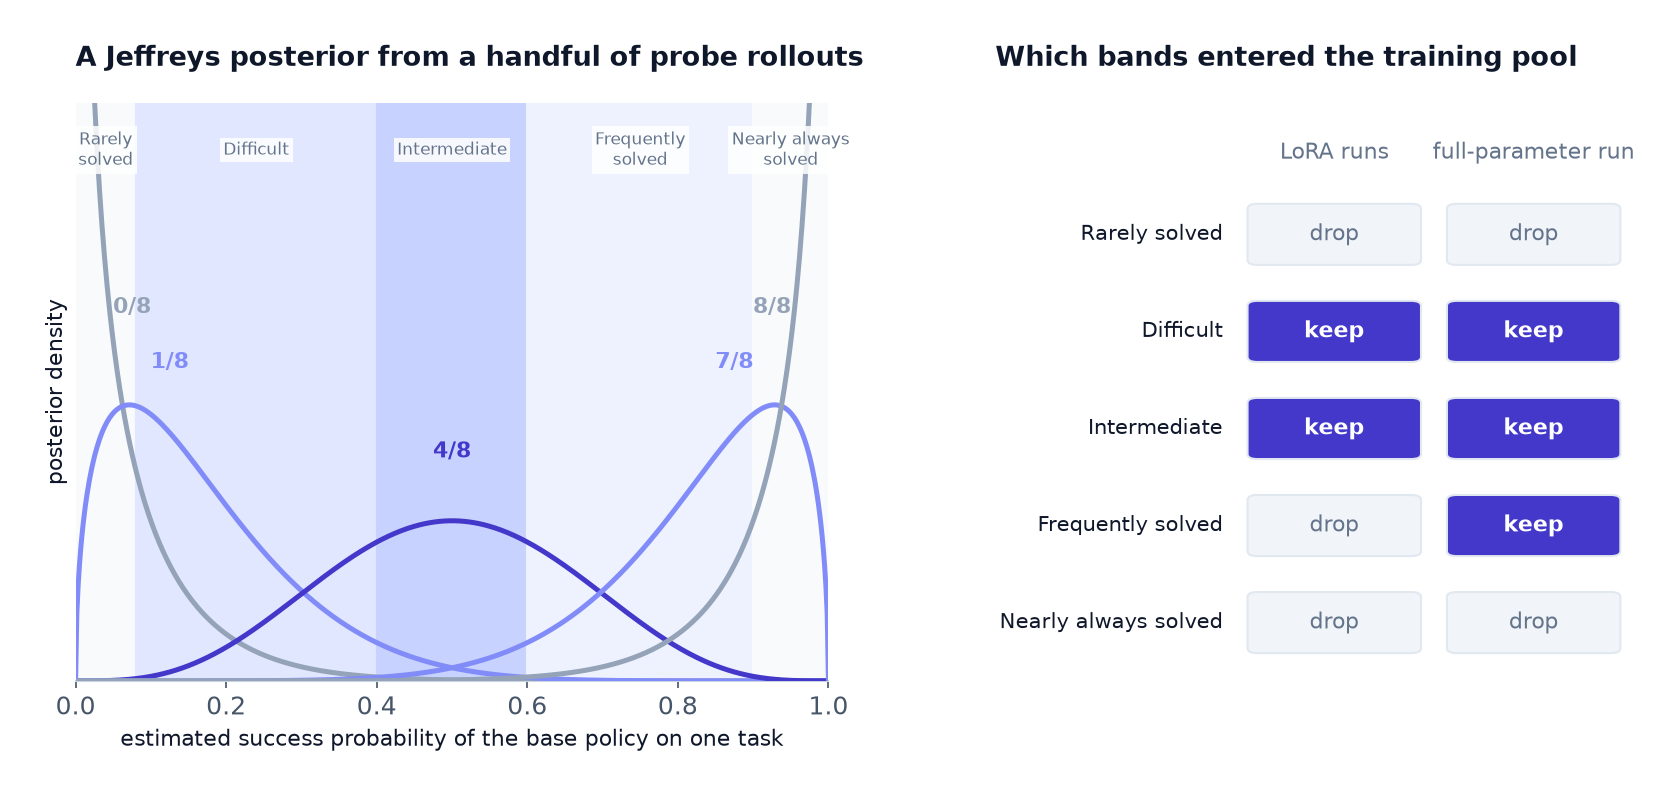
블로그가 든 예시에서는 GPT-5.4가 먼저 과제가 풀 수 있는지 확인하고(전체 파라미터 실행에서만 쓴 단계), 기본 모델이 8번 중 3번 성공했습니다. 사후분포는 \text{Beta}(3.5, 5.5) 이고 질량의 54.0\% 가 어려움 구간에 놓여 학습 풀에 들어갔습니다. 학습 중 이 과제의 롤아웃 그룹은 [0, 0, 0, 0, 1, 1, 1, 1] 처럼 섞인 보상을 내서 GRPO에 학습 신호를 주었습니다. 이렇게 고른 Qwen3.8-27B의 최종 학습 풀은 187개 과제입니다.
블로그와 저장소가 함께 강조하는 점은 ThinkingBox-Bench의 과제는 하나도 학습 풀에 넣지 않았다는 것입니다. 저장소의 data/prepare_data.py 는 제외할 과제 ID 목록을 --exclude-uids 옵션으로 받아 학습 풀에서 빼 줍니다.
무엇이 보상이 되는가
보상은 행동 경로에 대해 아무것도 묻지 않고, 과제의 실행 가능한 판정 결과만 씁니다. 대화가 끝나면 샌드박스가 백엔드에서 실제로 바뀐 내용을 추출하고 과제별 결정론적 검사를 돌립니다. 어떤 경로로든 올바른 최종 상태를 만들면 1이고, 잘못되거나 빠지거나 요청하지 않은 변경이 있으면 0입니다. 벤치마크에서 "시험관" 역할을 하던 데이터베이스 채점기가 학습에서는 서로 겹치지 않는 다른 과제 집합 위의 "교사" 역할을 맡는 셈입니다.
| 보상 경로 | 적용되는 경우 | 보상의 출처 |
|---|---|---|
| 실행 가능한 검사 (대부분) | 요구되는 결과가 최종 상태나 부수 효과에 드러나는 경우 | 결정론적 테스트가 LLM 판정 없이 통과 또는 실패를 반환 |
| 판정 모델 보조 검사 (일부) | 좁은 요구사항을 데이터베이스만으로 판단할 수 없는 경우 | 설정된 판정 모델이 예/아니요 루브릭에 답하고, 그 답을 실행 가능한 테스트가 사용 |
저장소 README는 시뮬레이션 사용자가 정책을 채점하지 않는 별도의 환경 역할이라고 명시합니다.
결과를 읽을 때 확인할 점
블로그, 저장소, 논문을 함께 보면 결과를 해석할 때 고려할 조건이 몇 가지 있습니다.
분포 밖 평가인지는 자료마다 다르게 적혀 있습니다. 블로그는 507개 벤치마크 과제가 "분포 밖 테스트 집합"이며, 그 도메인, 데이터베이스, 정책, 대부분의 MCP 도구가 학습 중에 나오지 않았다고 썼습니다. 같은 블로그는 두 집합이 프레임워크, 시뮬레이션 사용자, 상태 기반 채점, 일부 공통 도구, 비슷한 과제 형식을 공유하므로 전이 주장의 범위가 제한된다고도 덧붙였습니다. 그런데 블로그가 링크한 커밋(8c04db1, 10월 8일)의 저장소 README는 "학습 과제와 평가 과제는 ID가 겹치지 않지만 같은 샌드박스와 워크플로 도메인을 쓰며, 이는 held-out 과제 전이이지 분포 밖 주장이 아니다"라고 적었습니다. 10월 20일 커밋(64dc2e68)에서 이 문장은 "ThinkingBox-Bench 과제는 학습 풀에 포함되지 않았다"로 바뀌었습니다. 학습 풀 187개가 공개되지 않아 외부에서는 어느 쪽인지 확인할 수 없습니다.
학습 전후 평가 설정이 모두 같았는지는 공개 자료로 다 확인되지 않습니다. 논문 표에는 로컬 Qwen 모델을 vLLM 최대 길이 65,536, 도구 호출 파서 qwen3_coder 로 서빙했다고 적혀 있습니다. 반면 학습 코드 tb_interpret.py의 설명에는 기준 모델을 측정한 평가 캠페인이 qwen3 추론 파서와 qwen3_xml 도구 호출 파서를 썼다고 적혀 있어, 논문 표의 표기와 다릅니다. 블로그는 학습한 체크포인트를 A100 8장에서 최대 길이 262,144, qwen3_xml 파서로 서빙하고, Qwen 채팅 템플릿용 호환 프록시를 거쳐 응답 최대 8,192 토큰으로 평가했다고 적었습니다. 저장소의 평가 문서도 같은 vLLM 설정을 안내합니다. 파서 외에 최대 길이, 응답 토큰 상한, 호환 프록시가 기본 모델 평가에도 똑같이 적용됐는지는 나오지 않습니다.
시스템 오류 처리도 다릅니다. 논문은 API 오류 같은 시스템 오류를 실패한 시도로 셌지만, 저장소의 평가 스크립트는 시스템 오류가 난 시도를 다시 실행하고 오류 행이 0개일 때만 점수를 보고하도록 되어 있습니다. 학습 전후 평가에 같은 오류 처리 방식을 적용했는지는 어느 자료에도 나오지 않습니다.
결과는 한 번의 학습 실행입니다. 보고된 결과는 Qwen3.8-27B 전체 파라미터 실행 하나의 50스텝 체크포인트이며, 시드를 바꾼 반복 실행은 보고되지 않았습니다. 논문 부록에는 LoRA로 학습한 Qwen3.6-27B와 Qwen3.5-9B의 pass@1도 실려 있지만, 이번 블로그와 저장소의 반복 시도 지표는 Qwen3.8-27B만 다룹니다.
학습 데이터는 직접 마련해야 합니다. 저장소의 공개 예시 39개는 thinkingbox-data 의 개발용 파일 5개(airline_tau_bench.py, banking.py 등)에서 가져온 것으로, 인터페이스 확인용입니다. 같은 결과를 재현하려면 ThinkingBox 형식의 학습 과제를 직접 준비해야 하고, 그 과제가 벤치마크와 겹치지 않아야 합니다. ThinkingBox-Bench 데이터는 학습이나 프롬프트 최적화에 쓰지 말고 평가에만 쓰도록 데이터셋 카드의 사용 목적 안내에 명시되어 있습니다.
학습 스택 실행 방법
아래 절차는 블로그와 저장소 문서를 따른 것이며, 이 글을 쓰면서 직접 실행해 보지는 않았습니다. 2026년 10월 25일에 확인했을 때 1단계에서 받는 microsoft/thinkingbox-data 저장소는 404 응답을 돌려주었습니다. 벤치마크 과제와 MCP 서버 패키지가 이 저장소에 있으므로, 저장소가 다시 열리기 전에는 2단계 이후를 진행할 수 없습니다. Hugging Face의 ThinkingBox-Bench 데이터셋은 열리지만, 열람용 데이터라 실행 환경을 대신하지는 못합니다. Linux 또는 WSL, Python 3.12, uv 가 필요합니다. CUDA/NCCL 환경을 갖춘 NVIDIA GPU, 로컬 Qwen3.8-27B 체크포인트, 시뮬레이션 사용자와 판정 모델용 OpenAI 호환 엔드포인트도 있어야 합니다. 검증된 레퍼런스 구성은 3노드 × H100 8장입니다.
- 세 저장소를 나란히 받고, 블로그가 지정한 커밋과 벤치마크 릴리스로 고정합니다:
mkdir -p ~/thinkingbox-workspace
cd ~/thinkingbox-workspace

git clone https://github.com/microsoft/thinkingbox.git
git clone https://github.com/microsoft/thinkingbox-data.git
git clone --branch main https://github.com/microsoft/thinkingbox-training

git -C thinkingbox checkout 892964e7226044e5463ad188da119df838f4bec1
git -C thinkingbox-data checkout thinkingbox-bench-v1.0
thinkingbox-training/디렉터리에서 환경을 만들고, 패치를 적용한 Verl을 설치한 뒤 검증합니다:
cd ~/thinkingbox-workspace/thinkingbox-training

uv venv --python 3.12
source .venv/bin/activate

uv sync --frozen --extra fast --extra tracking --extra eval-proxy
uv pip install -e ../thinkingbox
uv pip install --config-settings editable-mode=compat \
  -e ../thinkingbox-data/servers/thinkingbox_tools
uv pip install --config-settings editable-mode=compat \
  -e ../thinkingbox-data/servers/tb_business_ops_servers_202606

python scripts/prepare_verl.py --dest .deps/verl --install
python scripts/verify_verl_install.py
uv pip check
마지막 두 명령은 패치된 Verl 설치와 깨진 의존성이 없음을 확인합니다. 블로그는 이 뒤에 자동 패키지 동기화를 다시 실행하지 말라고 경고합니다. 패치된 소스 설치가 일반 Verl 휠로 바뀔 수 있기 때문입니다.
-
학습 과제를 준비합니다.
data/prepare_data.py가 기본 모델 사전 실행 결과를 모으고, 난이도 구간 필터와 벤치마크 제외를 적용해train.yaml과test.yaml을 만듭니다. 입력 형식과 전체 명령은docs/data-preparation.md에 있습니다. -
docs/reference-q38-run.md를 따라 Typesense와 MCP 서버, 시뮬레이션 사용자와 판정 모델, Ray 클러스터를 설정합니다. 그다음 GPU를 잡기 전에 설정만 확인하는 dry-run을 실행합니다. 이 명령은 Ray를 시작하거나 GPU를 할당하지 않고 0으로 끝나야 합니다:
DRY_RUN=true ./scripts/run_train.sh \
  trainer.total_training_steps=50 \
  trainer.save_freq=5
- 각 노드에서 Ray를 시작하고,
ray status에 GPU 24장이 모두 보이면 헤드 노드에서 학습을 한 번 시작합니다:
export RAY_ADDRESS=auto
export GPUS=0,1,2,3,4,5,6,7

./scripts/run_train.sh \
  trainer.project_name=thinkingbox-training \
  trainer.experiment_name=q38-full-rlft \
  trainer.total_training_steps=50 \
  trainer.save_freq=5
- 학습한 체크포인트는
docs/evaluation.md를 따라 Hugging Face 형식으로 병합하고 vLLM으로 서빙한 뒤, 507개 과제를 20번씩 평가합니다. 블로그는 이 평가를 OpenEnv의thinkingbox-eval로 실행하는 방법도 함께 안내합니다.--coverage-profile full은 집계 전에 10,140개 과제와 반복 조합이 모두 있는지 확인합니다.
라이선스
ThinkingBox-Training은 MIT License로 공개되어 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 다만 저장소에 포함된 Verl 호환성 패치 파일은 Verl을 따라 Apache License 2.0으로 배포됩니다(저장소 NOTICE 파일). ThinkingBox-Bench 데이터는 CDLA-Permissive-2.0 라이선스입니다.
 Turning Database Grading into RL Rewards: Post-Training Agents with ThinkingBox 소개 블로그
 ThinkingBox-Training GitHub 저장소
ThinkingBox GitHub 저장소
One Success Isn't Reliability: Thinkingbox, a Sandbox and Benchmark for Agents in Stateful Business Workflows 논문
더 읽어보기
-
ThinkingBox: 에이전트가 남긴 DB 상태로 채점하고 20번 반복해 신뢰성을 재는 업무 에이전트 벤치마크
-
OpenEnv 프로젝트 소개: 에이전트 강화학습 환경의 공통 인터페이스가 되기까지 (feat. Meta, Hugging Face)
-
OpenEnv, AAIF 프로젝트로 합류: 에이전트 학습 환경을 과제 정의부터 TRL 학습까지 만드는 방법 (feat. Hugging Face)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
