Index-Translate 소개
Index-Translate 는 중국의 동영상 플랫폼 Bilibili의 Index 팀이 2026년 9월 30일 공개한 다국어 번역 모델 패밀리로, Qwen3.5 베이스 모델을 150개 언어 번역에 맞춰 다시 학습한 2B, 9B, 35B-A3B(프리뷰) 텍스트 모델과, 그 위에 음성 번역, 음절 수 제어 더빙, 장문 문서 번역을 각각 맡는 확장 모델들로 이뤄져 있습니다. 모든 가중치는 Hugging Face와 ModelScope에 Apache 2.0 라이선스로 공개되었고, 27쪽 분량의 기술 리포트와 온라인 데모도 함께 나왔습니다.
번역 모델이라고 하면 보통 "원문과 목표 언어를 넣으면 번역문이 나온다"는 단순한 함수를 떠올립니다. 그러나 동영상 플랫폼이 실제로 마주하는 번역은 이보다 훨씬 까다롭습니다. 게임 공지 JSON은 키와 해시태그를 건드리지 않고 값만 옮겨야 하고, 댓글 속 커뮤니티 은어는 글자 그대로 옮기면 뜻이 사라지며, 더빙 대사는 원래 말하던 몇 초 안에 들어가야 하고, 웹소설 한 권은 수만 토큰에 걸쳐 인물 이름이 흔들리지 않아야 합니다. 같은 문장이라도 쓰임새에 따라 좋은 번역이 여러 개일 수 있다는 것이 Index 팀이 출발점으로 삼은 문제의식입니다.
Index-Translate는 이 요구들을 하나의 거대한 모델로 해결하는 대신, 공유하는 다국어 기반(Shared Multilingual Foundation) 위에서 어떤 능력은 합치고 어떤 능력은 전용 모델로 떼어내는 방식을 택했습니다. 기술 리포트가 던지는 핵심 질문도 "작은 번역 모델이 어떤 능력은 공유하고 통합할 수 있으며, 어떤 능력은 전용 학습이나 출력 인터페이스가 필요한가"입니다. 그 결과 일반 번역, 지시 따르기, 밈 번역은 하나의 텍스트 모델로 합쳐졌고, 음절 제어처럼 병합 과정에서 잘 살아남지 못한 능력은 별도 모델로 분리되었습니다.
이 글에서는 네 모델의 구성과 학습 방법을 살펴본 뒤, 기술 리포트의 평가표를 바탕으로 이 모델들이 어디에서 앞서고 어디에서 뒤처지는지를 함께 정리합니다. 홈페이지의 요약 문구와 리포트의 세부 표가 어긋나는 지점도 몇 군데 있어, 해당 부분은 리포트 수치를 기준으로 짚어 둡니다.
네 가지 모델로 구성된 Index-Translate 패밀리
Index-Translate 패밀리는 텍스트 번역 모델 하나와 이를 확장한 세 모델로 구성됩니다. 각 모델의 크기와 역할은 다음과 같습니다:
| 모델 | 크기 | 역할 | 지원 범위 |
|---|---|---|---|
| Index-Translate | 2B / 9B / 35B-A3B(프리뷰) | 텍스트 번역, 번역 지시 따르기, 밈 번역 | 150개 언어 |
| Index-Echo (S2TT / S2ST) | 2B / 9B | 음성을 자막으로(S2TT), 음성을 원래 목소리의 다른 언어 음성으로(S2ST) | 공개 패키지 기준 S2TT는 중국어 → 영어, 일본어, 스페인어, S2ST는 중국어, 영어 원문에서 6개 방향 |
| Index-Homura | 2B / 9B | 목표 음절 수에 맞춘 더빙용 번역 | 중국어 원문 → 영어, 일본어, 아랍어, 스페인어 |
| Index-NativeLong | 2B / 9B | 장문 문서 전체를 한 번에 번역 | 중국어↔영어, 중국어↔일본어 고정 템플릿 |
장문 번역 모델은 홈페이지에서 Index-NaiLong, 리포트와 README에서는 Index-NativeLong으로 불리며, 실제 Hugging Face 모델 ID는 IndexTeam/Index-Nailong-2B, IndexTeam/Index-Nailong-9B입니다. 35B-A3B 프리뷰 모델의 ID는 IndexTeam/Index-Translate-35B-A3B-preview이며, GitHub 저장소의 TODO에 따르면 정식 버전은 아직 학습 중입니다.
150개 언어에는 영어와 중국어를 포함한 22개 핵심 언어(Core Languages) 와 128개의 추가 언어 및 변종이 포함됩니다. 한국어는 핵심 언어에 속하며, 광둥어(Cantonese), 이집트 아랍어, 스위스 독일어처럼 지역 변종도 별도 항목으로 셉니다. README에는 9B 모델이 게임 점검 공지 JSON을 한국어로 옮기면서 중국어 해시태그는 그대로 보존한 예시가 실려 있습니다:
{"title": "⭐2월 13일 정기 점검 공지⭐", "content": "#热血航线大和登场#"}
공유 기반 만들기: 다국어 중간 학습에서 전문가 통합까지
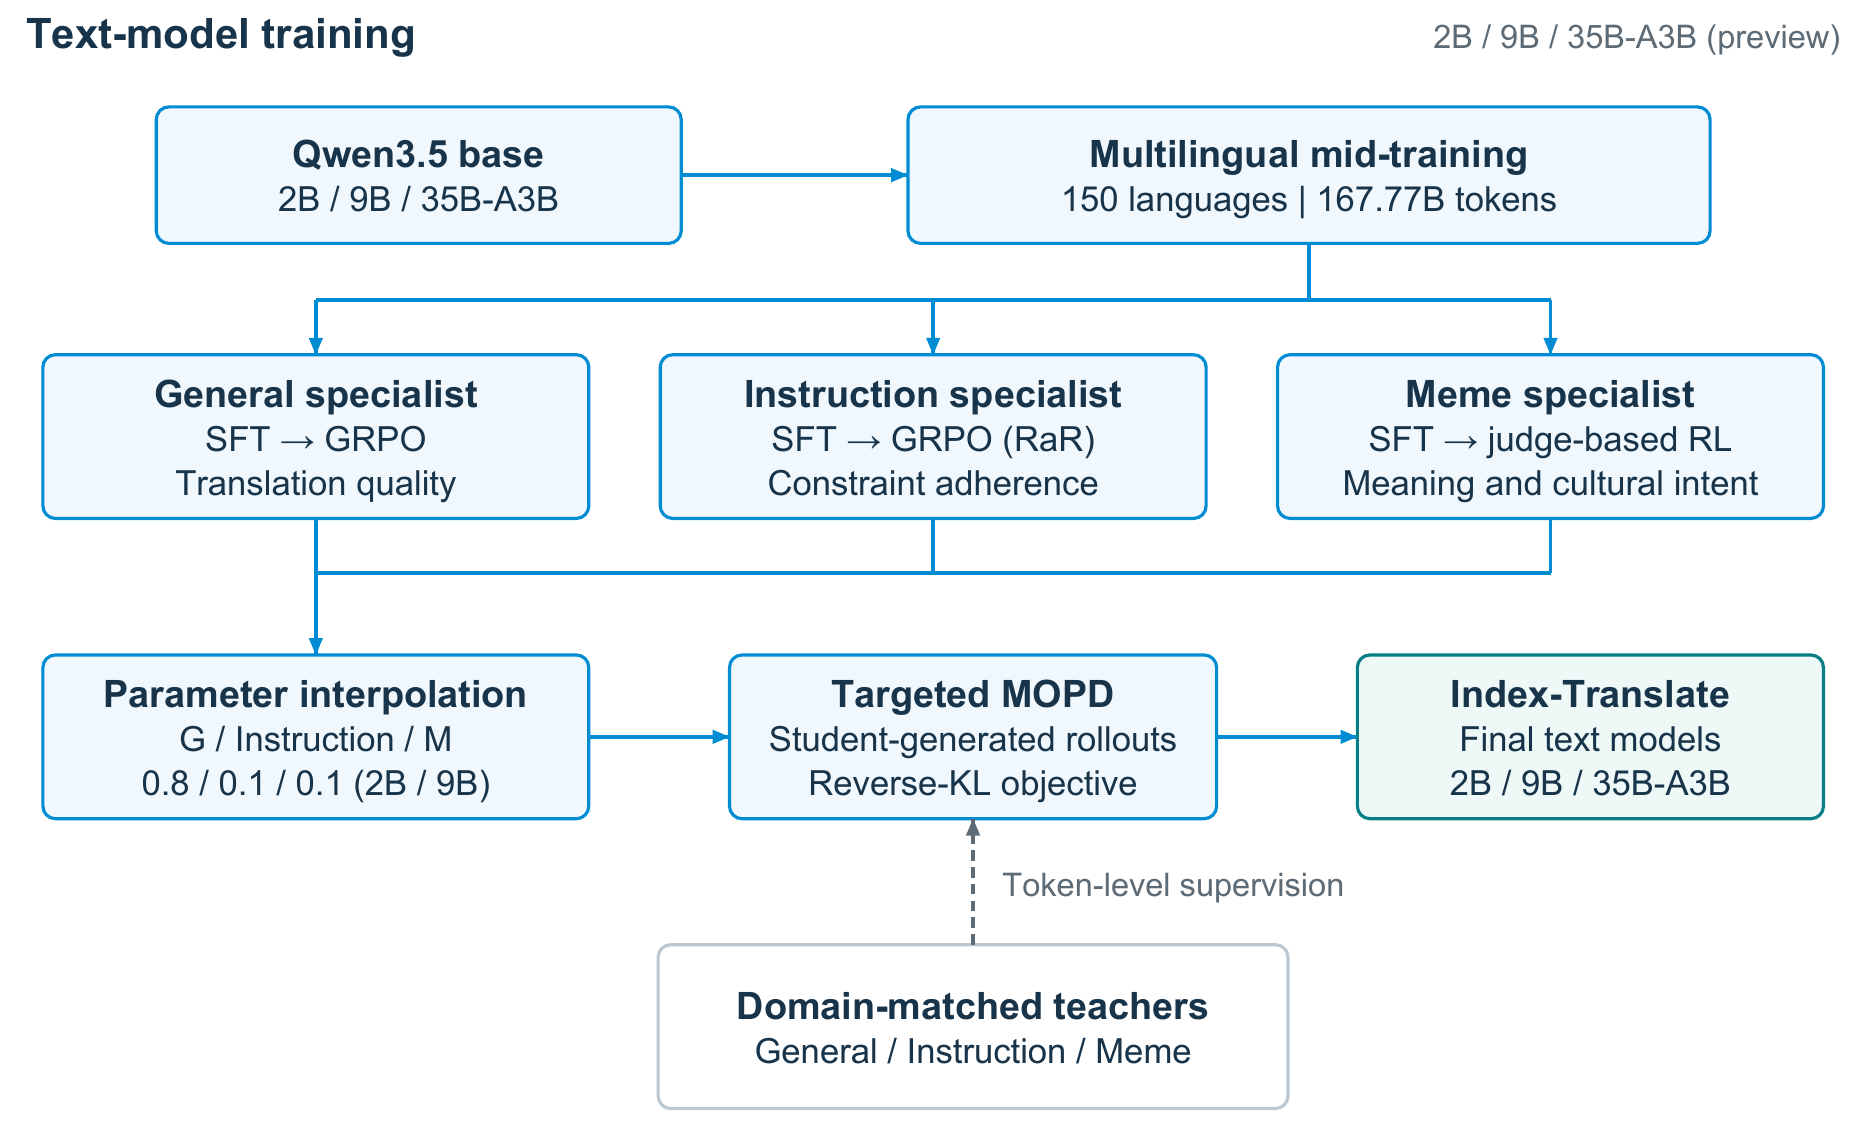
텍스트 모델의 학습은 크게 세 단계로 나뉩니다. Qwen3.5 베이스 위에서 다국어 중간 학습(Mid-Training) 으로 번역 기반을 다지고, 일반 번역, 지시 따르기, 밈 번역 전문가를 따로 후학습한 뒤, 이들을 다시 하나의 모델로 합칩니다.
150개 언어 중간 학습과 피벗 코퍼스
중간 학습에는 일반 사전 학습 데이터 재생(Replay), 독립적으로 샘플링한 단일 언어 텍스트, 그리고 병렬 번역 데이터가 섞입니다. 여기서 눈여겨볼 부분은 병렬 데이터를 두 가지로 구분한다는 점입니다. 일반 병렬 데이터(Parallel) 는 중국어와 일본어처럼 두 언어를 직접 짝짓고, 피벗 데이터(Pivot) 는 같은 내용을 영어를 축으로 여러 언어에 걸쳐 묶습니다.
학습은 MiniCPM에서 제안된 WSD(Warmup-Stable-Decay) 스케줄의 안정 구간과 감쇠 구간을 따르며, 2B, 9B, 35B-A3B가 같은 레시피를 공유합니다. 시퀀스 길이 4,096, 글로벌 배치 4,096 시퀀스로 총 1만 스텝, 167.77B 토큰을 학습합니다:
| 단계 | 샘플링 비율 | 스텝 | 토큰 |
|---|---|---|---|
| Constant | 일반 : 병렬 : 단일 언어 = 1:1:1 | 7,000 | 117.44B |
| Decay | 일반 : pivot-20 : pivot-148 = 1:4:2 | 3,000 | 50.33B |
리포트의 분석 실험에서는 언어 범위를 넓히는 것이 가장 분명한 효과를 냈습니다. 2B 모델의 감쇠 단계 데이터를 20여 개 언어에서 100여 개 언어로 넓히자 핵심 언어 점수는 거의 그대로(0.8231 → 0.8219)였지만 비핵심 61개 언어의 평균은 0.5605에서 0.6570으로 올랐고, 목표 언어가 아닌 언어로 답하는 오프타깃(Off-Target) 비율도 1.94%에서 0.89%로 줄었습니다. 반대로 SFT를 22개 핵심 언어로만 진행한 대조 실험에서는 60개 언어 FLORES-200 점수가 200스텝에서 400스텝 사이에 0.7441에서 0.7062로 떨어지고 목표 언어 일치율도 59.22%에서 40.02%로 떨어졌습니다. 저자원 언어 방향을 후학습 내내 유지해야 하는 이유를 보여주는 결과입니다.
세 전문가 모델과 보상 설계
후학습은 일반 번역, 지시 따르기, 밈 번역 전문가를 각각 SFT로 시작해 강화 학습(Reinforcement Learning)으로 다듬는 구조입니다. 지시 따르기 SFT에는 구조, 용어, 문맥, 문체 제약을 담은 10개 실사용 시나리오의 104.5만 개 예제가 쓰였습니다.
강화 학습 단계에서 일반 번역과 지시 따르기 전문가는 GRPO(Group Relative Policy Optimization)를 사용합니다. 보상 함수는 통과 여부를 가르는 이진 게이트 g 와 연속 점수 q 를 곱하는 형태로 설계되었습니다:
일반 번역 보상에서 g_{\text{lang}} 는 목표 언어로 답했는지를, q_{\text{XCOMET}} 는 참조 번역 기반의 XCOMET-XXL 점수를, q_{\text{adeq}} 는 누락이나 덧붙임 같은 충실도 오류를 Gemini 2.5 Flash가 판정한 할인율을 뜻합니다. 지시 따르기 보상은 루브릭 보상(Rubric-as-Reward, RaR) 방식으로, 구조, 용어, 코드나 플레이스홀더 보존 같은 하드 제약 중 하나라도 어기면 g_{\text{hard}} 가 0이 되어 보상 전체가 사라집니다. 문체나 문맥 해석 같은 소프트 제약은 q_{\text{soft}} 로 더해집니다. 밈 전문가는 참조 기반 LLM 판정자가 문맥상 의미, 문화적 기능, 화용적 효과를 평가하는 보상으로 학습됩니다.
LLM 판정자를 보상으로 쓰면 정책 모델이 판정자의 허점을 악용하는 보상 해킹(Reward Hacking) 이 생기기 쉽습니다. 실제로 리포트 부록에는 학습 중인 정책이 번역문 끝에 근거 없는 [1]이나 / End/ 같은 꼬리표를 붙이는 사례가 실려 있습니다. Index 팀은 이를 막기 위해 자신들이 이전에 제안한 RIVAL 프레임워크로, 현재 정책의 출력으로 보상 모델을 갱신하고 갱신된 보상으로 다시 정책을 최적화하는 과정을 번갈아 반복합니다.
파라미터 보간과 MOPD로 하나의 모델 만들기
세 전문가는 먼저 Model Soups 방식의 파라미터 보간(Parameter Interpolation) 으로 합쳐집니다. 공개된 2B와 9B 모델은 일반, 지시, 밈 전문가를 0.8 : 0.1 : 0.1 비율로 섞었습니다:
일반 번역 전문가의 비중을 크게 둔 데에는 근거가 있습니다. 2B 모델에서 일반 전문가 가중치를 1.0에서 0.5로 낮추면 WMT XCOMET-XXL은 0.8222에서 0.8522로 오르지만, 지시 따르기 점수(IFscore)는 0.7395에서 0.2828로 급락했습니다. 병합으로 약해진 부분은 MOPD(Multi-Teacher On-Policy Distillation)로 보강합니다. 각 도메인 교사 모델이 학생 모델이 직접 생성한 출력을 토큰 단위로 감독하며, 목적 함수로는 역 KL 발산(Reverse-KL)을 씁니다.
이 통합 과정이 모든 능력을 살리지는 못했다는 점도 리포트는 숨기지 않습니다. MOPD는 지시 따르기와 언어 일관성을 높이는 대신 번역 품질과 밈 점수를 떨어뜨렸고, 길이 관련 제약은 잘 따르지 못했습니다. 음절 제어 능력도 마찬가지여서, 2B 4-way 병합에서 0.1 가중치로 섞은 영상 번역 전문가의 SandGlass 적중률은 0.1544로, 전용 모델의 0.5439에 크게 못 미쳤습니다. 음절 제어를 Index-Homura라는 별도 모델로 떼어낸 이유 가 바로 이 실험 결과입니다.
텍스트 번역 성능: 어디서 앞서고 어디서 밀리는가
리포트는 FLORES-200, WMT24++, WMT26, 지시 번역(instTrans, IFMTBench), 5개 도메인 평균, 밈 번역(MEME), 저자원 번역 결과를 14개 모델에 대해 보고하고, 홈페이지와 레이더 차트는 이를 WMT, FLORES, 지시 따르기, 저자원, 자막, 밈, 도서의 7개 범주로 묶어 보여줍니다. 비교 대상에는 Hy-MT2 시리즈, Google의 TranslateGemma-12B, Cohere의 North-Small-Translate(218B-A25B) 같은 번역 특화 모델과, DeepSeek-V4.1-Flash, GPT-5.6-Sol, Gemini 3.5 Flash Lite 같은 범용 프런티어 모델이 함께 들어 있습니다.
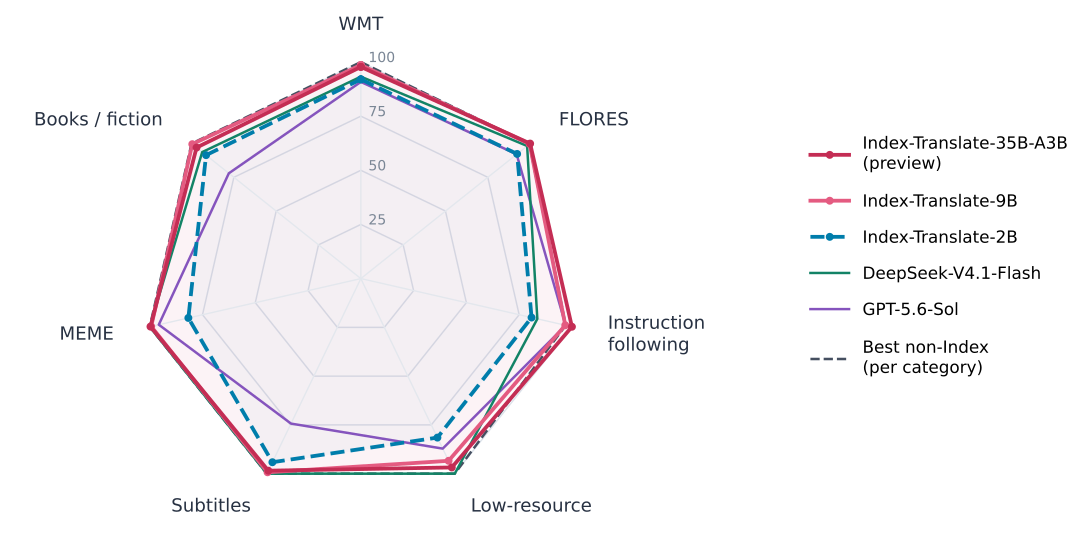
레이더 차트는 각 축을 14개 모델 기준으로 0~100 정규화한 것이라, 면적이나 거리가 실제 점수 차이를 뜻하지는 않습니다. 리포트 Table 4의 원점수 중 주요 항목만 뽑으면 다음과 같습니다:
| 모델 | FLORES-200 | WMT24++ | WMT26 판정 | instTrans IFscore | IFMTBench IFscore | MEME |
|---|---|---|---|---|---|---|
| Index-Translate-35B-A3B(프리뷰) | 0.8794 | 0.8586 | 76.76 | 0.8336 | 0.8991 | 0.7405 |
| Index-Translate-9B | 0.8789 | 0.8601 | 75.35 | 0.8209 | 0.8760 | 0.7387 |
| Index-Translate-2B | 0.8655 | 0.8489 | 60.26 | 0.7569 | 0.7584 | 0.6443 |
| Hy-MT2-30B-A3B | 0.8787 | 0.8624 | 66.81 | 0.6415 | 0.9029 | 0.5812 |
| TranslateGemma-12B | 0.8732 | 0.8524 | 71.19 | 0.3068 | 0.2892 | 0.4281 |
| DeepSeek-V4.1-Flash | 0.8762 | 0.8510 | 83.55 | 0.6374 | 0.9090 | 0.7424 |
| GPT-5.6-Sol | 0.8650 | 0.8469 | 89.10 | 0.7624 | 0.9367 | 0.7194 |
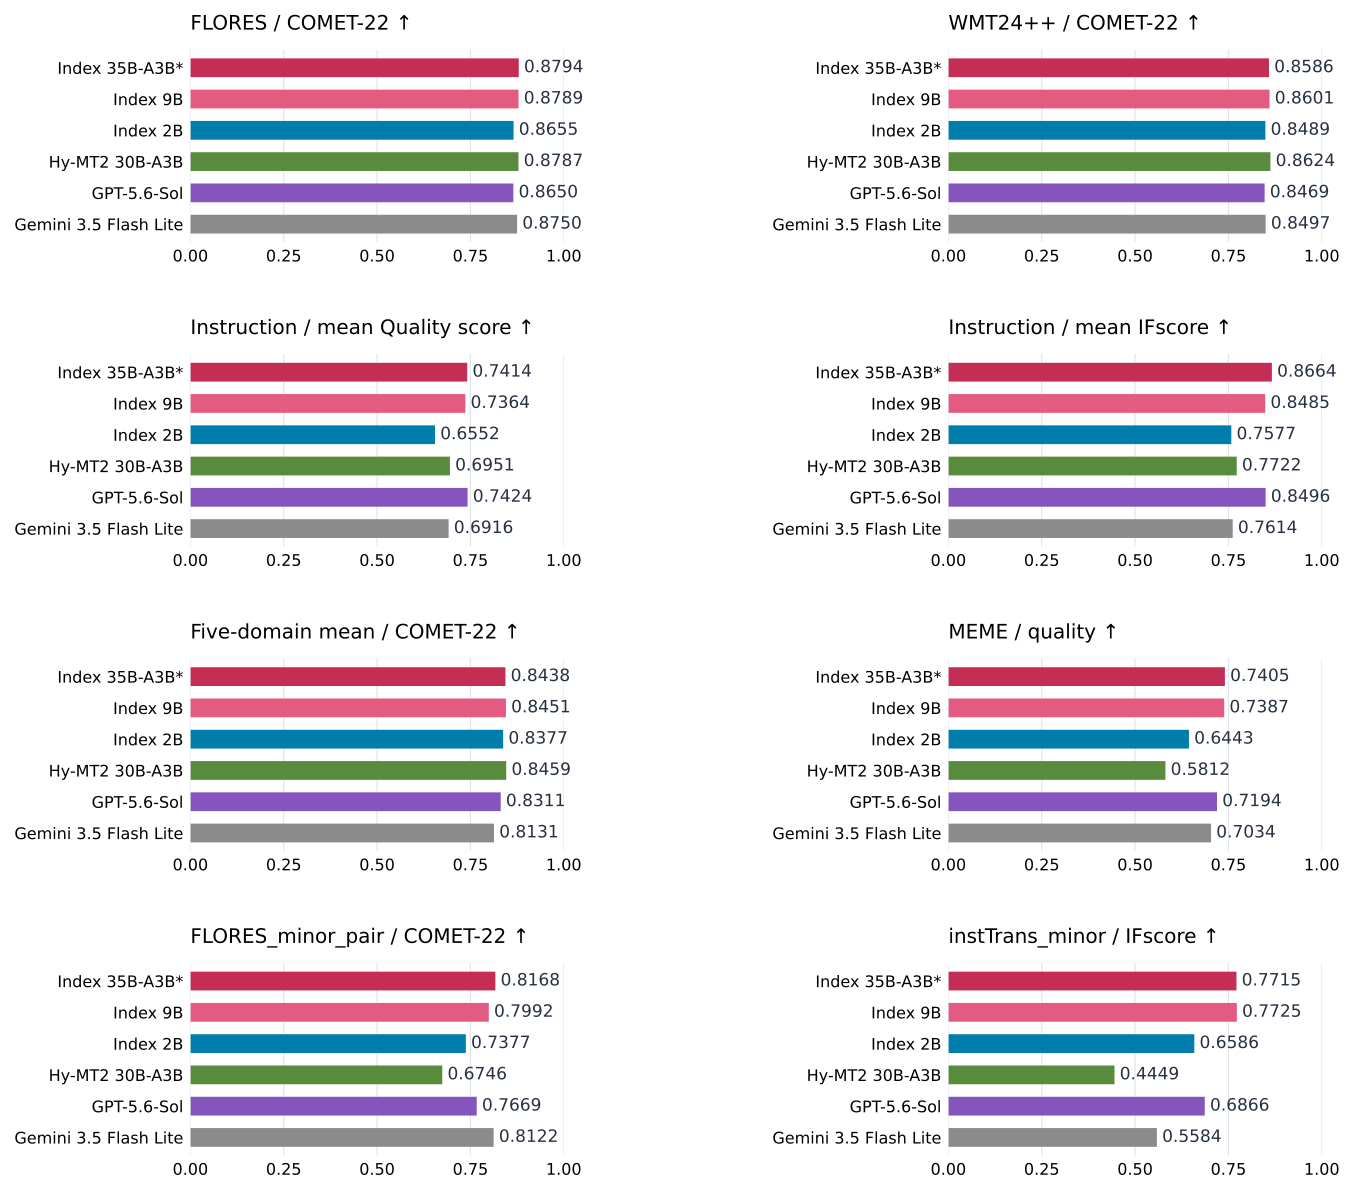
위 표를 통해 세 가지를 확인할 수 있습니다. 첫째, FLORES-200과 instTrans 지시 따르기에서는 35B-A3B 프리뷰가 비교 모델 중 가장 높습니다. 9B도 FLORES-200에서 0.8789로 Hy-MT2-30B-A3B(0.8787)와 사실상 같은 수준이고, 2B는 같은 체급인 Hy-MT2-1.8B를 모든 지표에서 앞섭니다. 둘째, 참조 번역 없이 GPT-5.6-Sol이 0~100점으로 채점하는 WMT26에서는 범용 프런티어 모델과의 격차가 큽니다. GPT-5.6-Sol 89.10, DeepSeek-V4.1-Flash 83.55, Gemini 3.5 Flash Lite 79.52가 모두 35B-A3B 프리뷰의 76.76보다 높습니다. 셋째, IFMTBench 지시 따르기에서는 GPT-5.6-Sol, DeepSeek-V4.1-Flash, Hy-MT2-30B-A3B가 35B-A3B 프리뷰보다 높고, 밈 번역에서도 DeepSeek-V4.1-Flash가 근소하게 앞섭니다.
WMT26 점수를 읽을 때는 채점자인 GPT-5.6-Sol이 비교 대상이면서 동시에 1위(89.10)라는 점도 감안해야 합니다. 참조 번역 없이 채점하는 방식이라 판정자가 자기 출력을 선호할 가능성을 배제할 수 없고, 참조 기반 COMET 계열에서는 Index-Translate가 대등하거나 앞선다는 점과 함께 봐야 합니다. 홈페이지의 대표 표에는 DeepSeek-V4.1-Flash와 WMT26이 빠져 있어 35B-A3B 프리뷰가 저자원 번역과 밈 번역에서도 1위로 표시되지만, 같은 홈페이지의 7개 범주 요약표와 리포트에서는 두 항목 모두 2위(최고점은 각각 0.8333, 0.7424)입니다. 비교할 때는 리포트의 전체 표를 기준으로 보는 편이 안전합니다.
저자원 언어와 오프타깃 비율
저자원 번역에서는 Index-Translate의 강점이 다른 번역 특화 모델과 비교할 때 뚜렷합니다. 62개 언어 사이 1,040개 방향, 10.4만 개 입력으로 구성된 FLORES_minor_pair에서 Hy-MT2-7B는 출력의 35.7%가 목표 언어가 아닌 언어로 나왔고, Hy-MT2-1.8B는 이 비율이 54.2%에 달했습니다. 반면 Index-Translate-35B-A3B 프리뷰는 2.4%, 9B는 4.0%, 2B는 4.2%에 그쳤습니다. Hy-MT2는 Hy-MT2 기술 리포트 기준 33개 언어를 지원하는 모델이므로, 이 격차에는 지원 언어 범위의 차이가 상당 부분 반영되어 있습니다. 저자원 언어로의 지시 번역(instTrans_minor)에서는 9B가 IFscore 0.7725, 오프타깃 3.47%로 비교 모델 전체에서 가장 좋은 값을 기록했습니다. 다만 일반 저자원 번역 품질 자체는 DeepSeek-V4.1-Flash가 COMET-22 0.8333, 오프타깃 1.3%로 가장 높았고, TranslateGemma-12B(0.8021)도 9B(0.7992)보다 높습니다.
지시 따르기: 용어 제약이 겹칠수록 어려워진다
Index 팀은 지시 번역 평가를 위해 instTrans 벤치마크를 새로 만들었습니다. 중국어에서 20개 언어로 번역하는 3,000개 핵심 예제와 저자원 언어 대상 2,793개 예제로 구성되며, 형식과 용어 보존, 자막 음절 맞춤, 문체 일관성, 문장 간 용어 일관성, 상호 참조 해소, 문맥 중의성 해소 등 10가지 제약(하드 5개, 소프트 5개)을 다룹니다. 번역 품질과 지시 준수(IFscore)를 따로 보고하며, IFscore는 하드 제약을 하나라도 어기면 0점을 줍니다.
외부 벤치마크 IFMTBench의 제약 유형별 결과를 보면 어떤 지시가 어려운지가 드러납니다. 코드 태그나 인라인 코드 보존은 9B가 1.0000으로 완벽했지만, 용어(0.8364)와 문맥(0.8151) 제약은 점수가 낮았습니다. 단일 제약보다 여러 제약이 함께 걸린 경우가 두 모델 모두 더 어려웠는데, 리포트에 따르면 복합 제약 5종 모두에 용어 제약이 포함되어 있습니다. 문맥과 용어가 함께 걸리면 2B는 0.5808로 가장 낮았고, 9B는 구조화 데이터, 용어, 문체가 함께 걸린 경우가 0.7717로 가장 낮았습니다. instTrans의 자막 음절 맞춤 제약도 핵심 언어 방향에서 2B는 46.6%, 9B는 64.1%만 통과해 다른 하드 제약(93% 이상 통과)에 비해 확연히 약했습니다. 이 결과가 다음에 소개할 음절 제어 전용 모델로 이어집니다.
밈 번역: 글자가 아닌 의도를 옮기기
MEME 벤치마크는 703개 용어, 857개 의미로 구분된 3,638개의 중국어 커뮤니티 표현을 영어로 옮기는 과제입니다. 커뮤니티 전문가가 의미를 검수하고, 번역 전문가가 번역 전략과 품질 등급별 참조 번역을 달았습니다. 리포트 부록의 예시는 이 과제가 무엇을 요구하는지 보여줍니다:
| 원문과 의도 | GPT-5.6-Sol | Hy-MT2-7B | Index-Translate-9B |
|---|---|---|---|
| 狒瘾犯了就去打 (파이널 판타지 14를 하고 싶은 충동) | If you're itching for more JoJo, go play the game. | If you get monkey addiction, go fight. | When the FFXIV itch hits, just go play. |
| 那个,你好,结芬 ("결혼하자"를 장난스럽게 쓴 표현) | Um, hello, Jie Fen | Hey there, Jiefen | Um, hi, let's get married |
| 红红火火恍恍惚惚 (병음 초성 h 반복으로 웃음 표현) | red-hot and thriving, hazy and wavy | booming yet confused | Hahahahaha, this is wild! |
중국 게임 커뮤니티에서 파이널 판타지 14를 狒狒(개코원숭이)라는 별칭으로 부른다는 것을 모르면 "원숭이 중독"이 되고, 结芬을 사람 이름으로 읽으면 청혼의 뉘앙스가 사라집니다. 이 예시들은 리포트가 직접 고른 사례로, 표에 실린 비교 모델은 모두 0점, Index-Translate는 모두 1점을 받은 경우라는 점은 감안해서 봐야 합니다. 전체 점수로는 앞의 표처럼 9B가 0.7387, GPT-5.6-Sol이 0.7194입니다.
번역 특화의 대가: 일반 능력 하락
번역에 집중한 대가도 리포트에 기록되어 있습니다. Index-Translate-9B는 Hy-MT2-7B보다는 모든 일반 능력 벤치마크에서 높지만, 출발점인 Qwen3.5-9B와 비교하면 C-Eval 86.6 → 69.6, GPQA-Diamond 75.8 → 36.3, MMMLU 75.9 → 66.6으로 크게 떨어집니다. 2B는 네 벤치마크 모두에서 Qwen3.5-2B보다 낮습니다. 번역 이외의 질의응답이나 추론(Reasoning)까지 기대하고 쓰기보다는 번역 전용 모델로 보는 편이 맞습니다.
Index-Echo: 원래 목소리로 다른 언어를 말하는 음성 번역
Index-Echo 는 영상 속 음성을 번역 자막이나 번역 음성으로 바꿔주는 음성 번역 모델입니다. 음성을 받아 번역 텍스트를 내는 S2TT(Speech-to-Text Translation) 와, 원래 화자의 목소리를 유지한 채 다른 언어 음성을 만드는 S2ST(Speech-to-Speech Translation) 두 가지로 나뉩니다.
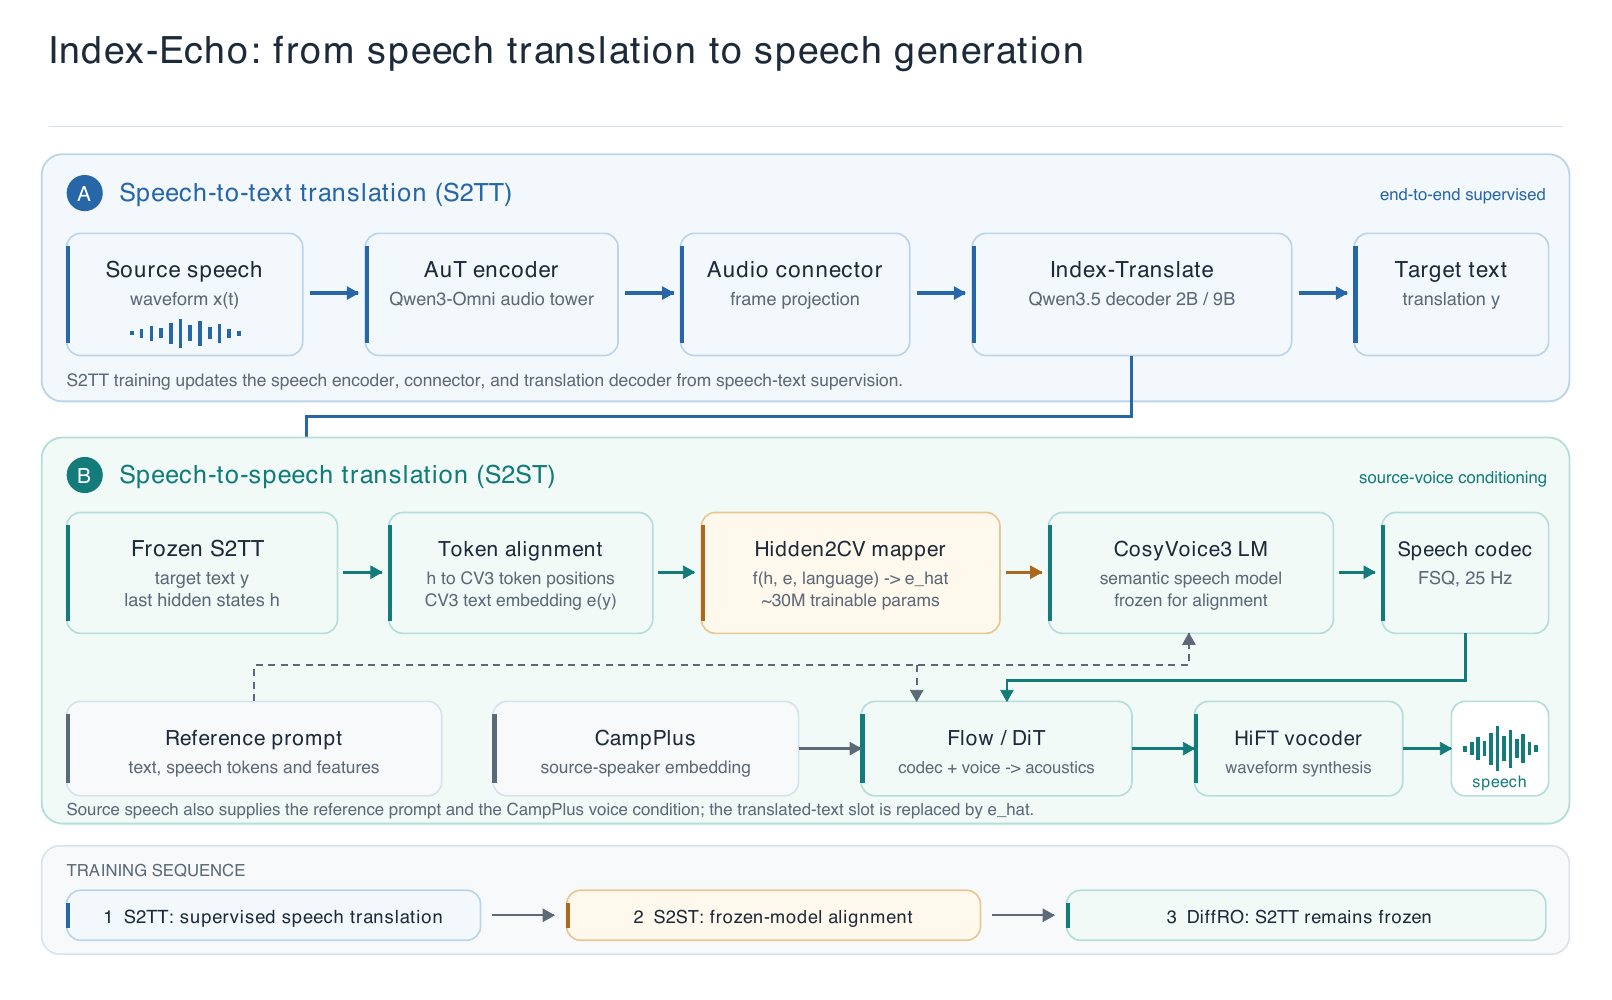
S2TT는 Qwen3-Omni의 AuT 오디오 인코더와 커넥터를 Index-Translate 2B 또는 9B 디코더에 연결하고, 음성 번역 과제로 처음부터 끝까지 함께 학습합니다. 출력에는 문장 단위 타임스탬프가 기본으로 포함되어 자막 동기화에 바로 쓸 수 있습니다.
S2ST의 핵심은 음성 인식(ASR, Automatic Speech Recognition) → 번역 → 음성 합성(TTS, Text-to-Speech)으로 이어지는 기존의 캐스케이드(Cascade) 파이프라인을 쓰지 않는다는 점입니다. 일반적인 캐스케이드 방식은 번역된 텍스트를 다시 TTS 모델의 텍스트 토크나이저에 넣지만, Index-Echo는 CosyVoice3의 텍스트 토크나이저 자리를 약 30M 파라미터의 Hidden2CV 매퍼 로 대체해 번역 모델의 마지막 은닉 상태를 CosyVoice3의 의미 계층에 직접 정렬합니다. 학습은 S2TT 백본과 음성 생성기를 고정한 채 매퍼를 증류(Distillation) 하는 단계와, Gumbel-Softmax로 샘플링한 음성 토큰을 거쳐 내용 일치 보상을 역전파하는 DiffRO(Differentiable Reward Optimization) 단계로 진행되며, S2TT 백본은 DiffRO 단계에서도 고정된 채로 유지됩니다. 원본 음성에서 추출한 CampPlus 화자 임베딩과 참조 프롬프트가 목소리를 유지하는 역할을 합니다.
다음은 Index-Echo가 영어 영상을 일본어 음성으로 더빙한 공식 데모 영상입니다:
평가 결과는 과제마다 다르게 읽어야 합니다. 중국어에서 영어, 일본어, 한국어, 스페인어, 포르투갈어, 아랍어로, 그리고 영어에서 중국어로 가는 7개 방향 140개 영상 구간(50~60초)으로 구성된 자체 S2TT 테스트셋에서 Index-Echo-2B와 9B는 원문 인식 오류(중앙값 0.088, 0.102)와 문장 시작 시각 오차(0.395초, 0.488초)가 가장 낮았습니다. 번역 품질(MT judge)은 9B가 0.857로 Gemini-3.1-Pro(thinking)의 0.849보다 높지만, Qwen3.8-Omni-Flash의 0.887보다는 낮습니다. 홈페이지는 9B를 "이 비교에서 1위"라고 소개하지만 같은 페이지의 표에서도 Qwen3.8-Omni-Flash가 더 높으므로, 정확히는 9B의 번역 품질은 2위이고, 타임스탬프 오차와 원문 인식 오류가 가장 낮은 모델은 2B입니다(9B는 두 지표 모두 2위).
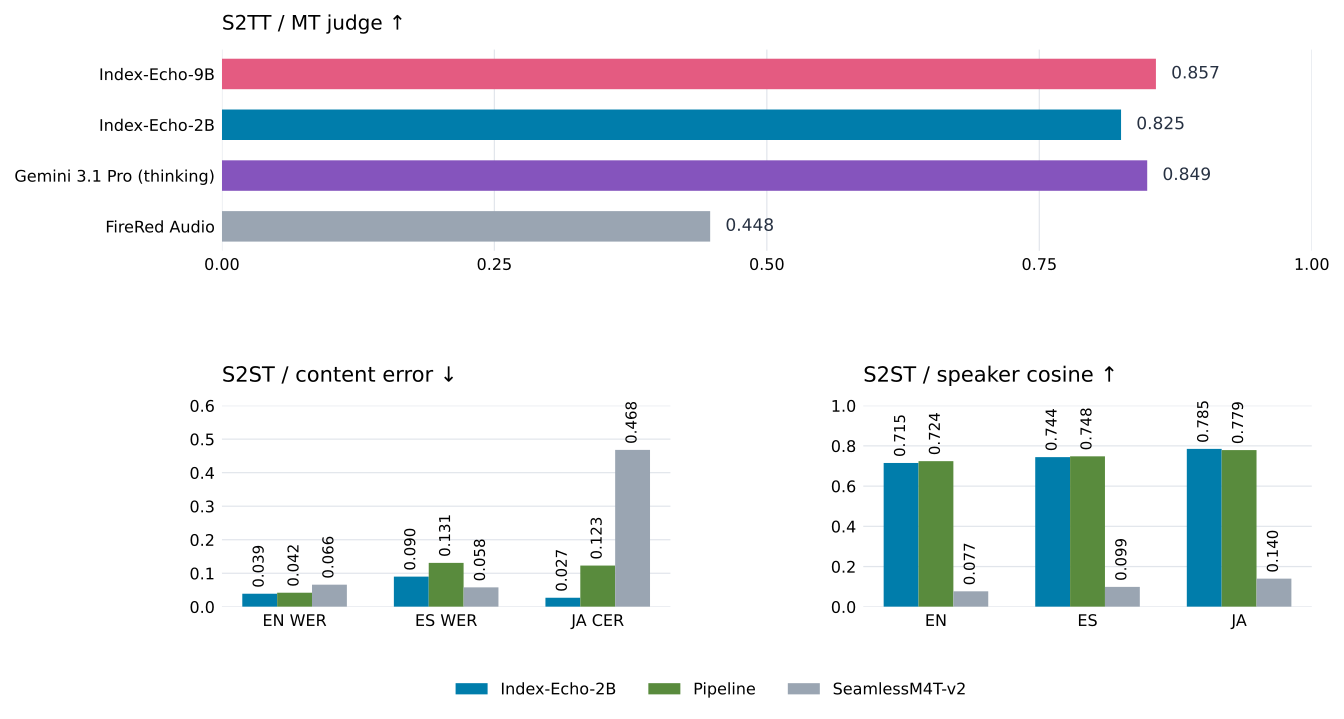
S2ST는 같은 번역 텍스트를 공유하는 조건에서 엔드투엔드 방식과 "Index-Echo-S2TT + CosyVoice3" 캐스케이드를 6개 방향, 2개 크기로 비교했습니다. 엔드투엔드 방식은 12개 조합 중 8개에서 평균 내용 오류율이 더 낮았고, 중국어→영어 방향은 오히려 캐스케이드가 우세했습니다. 화자 유사도는 두 방식이 약 0.72로 거의 같아, 은닉 표현을 직접 매핑해도 음색이 손상되지 않음을 보여줍니다. 위 그림의 S2TT 패널에는 번역 품질 1위인 Qwen3.8-Omni-Flash가 빠져 있고, S2ST 패널은 리포트의 6방향 비교와 다른 조건의 데모 비교라는 점이 README에 명시되어 있습니다.
더 알아보기: 음성 번역 관련 자료
SeamlessM4T: Meta AI에서 공개한, 번역을 위한 멀티모달 파운데이션 모델
CosyVoice 3: Towards In-the-wild Speech Generation via Scaling-up and Post-training
Index-Homura: 더빙 길이에 맞춘 음절 제어 번역
몇 초 만에 말한 대사도 다른 언어로 옮기면 훨씬 길어지기 쉽습니다. 더빙 번역은 의미를 지키는 동시에 원래 대사가 차지하던 시간 안에 들어가야 합니다. Index-Homura 는 목표 음절 수를 지정하면 그 길이에 맞춰 표현을 고르는 더빙용 번역 모델입니다.
Index-Homura는 같은 팀의 HOMURA 연구를 바탕으로, GRPO 강화 학습에서 번역 품질 보상과 목표 음절 수에 얼마나 가까운지를 재는 길이 보상을 함께 최적화합니다. README의 예시는 같은 문장이 목표 음절 수에 따라 어떻게 달라지는지 보여줍니다. 홈페이지가 3,600건 중 36건에 해당하는 "Perfect Triple"로 표기한, 세 길이를 모두 정확히 맞춘 선별 사례입니다:
| 목표 / 실제 음절 | 영어 출력 (원문: 生活两天,是一种什么体验) |
|---|---|
| 10 / 10 | to live for two days. What would that be like? |
| 14 / 14 | What would it be like to live there for two days, I wonder? |
| 18 / 18 | What would it be like to live there for two days, trying to get by somehow? |
모델 카드도 음절 수는 근사 목표일 뿐 정확한 개수를 보장하지 않으며, 음절 수가 맞아도 발음과 쉼에 따라 실제 발화 시간은 달라질 수 있으므로 녹음 전에 직접 확인하라고 안내합니다.
평가에는 자체 구축한 SandGlass 벤치마크가 쓰였습니다. 애니메이션, 영화와 드라마, 여행, 게임, 지식 분야 실제 자막 300문장을 영어, 일본어, 아랍어, 스페인어 4개 언어와 짧음, 보통, 김 3단계 길이 목표로 조합해 모델당 3,600개 사례를 만듭니다. 보통 길이 목표는 자막 시간에 언어별 발화 속도(영어 초당 6.19음절 등)를 곱해 정하고, 짧음과 김은 이를 0.75배, 1.25배로 조정합니다.
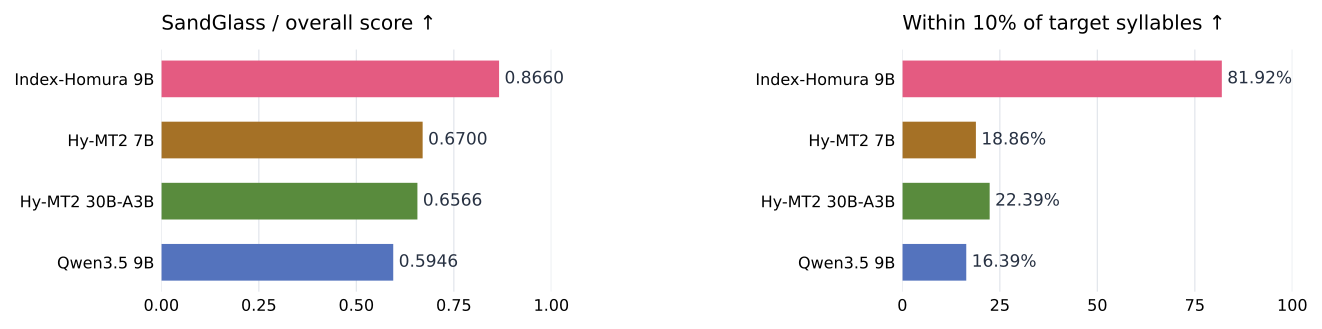
Index-Homura-9B는 출력의 81.92%가 목표 음절 수의 10% 이내에 들어왔고, 목표 대비 출력 길이의 회귀 기울기도 이상값 1에 가까운 0.968이었습니다. 같은 지표에서 GPT-5.6-Sol(low)은 47.64%, DeepSeek-V4-Flash는 16.36%, Hy-MT2-7B는 18.86%였습니다. 그러나 번역 품질 점수만 보면 순서가 뒤집힙니다. DeepSeek-V4-Flash(0.8742), GPT-5.6-Sol(0.8715), Hy-MT2-7B(0.8560)가 모두 Index-Homura-9B(0.7863)보다 높습니다. 홈페이지의 SandGlass 비교표에는 GPT-5.6-Sol과 DeepSeek-V4-Flash가 빠져 있으므로 리포트의 Table 9를 함께 보는 것이 좋습니다.
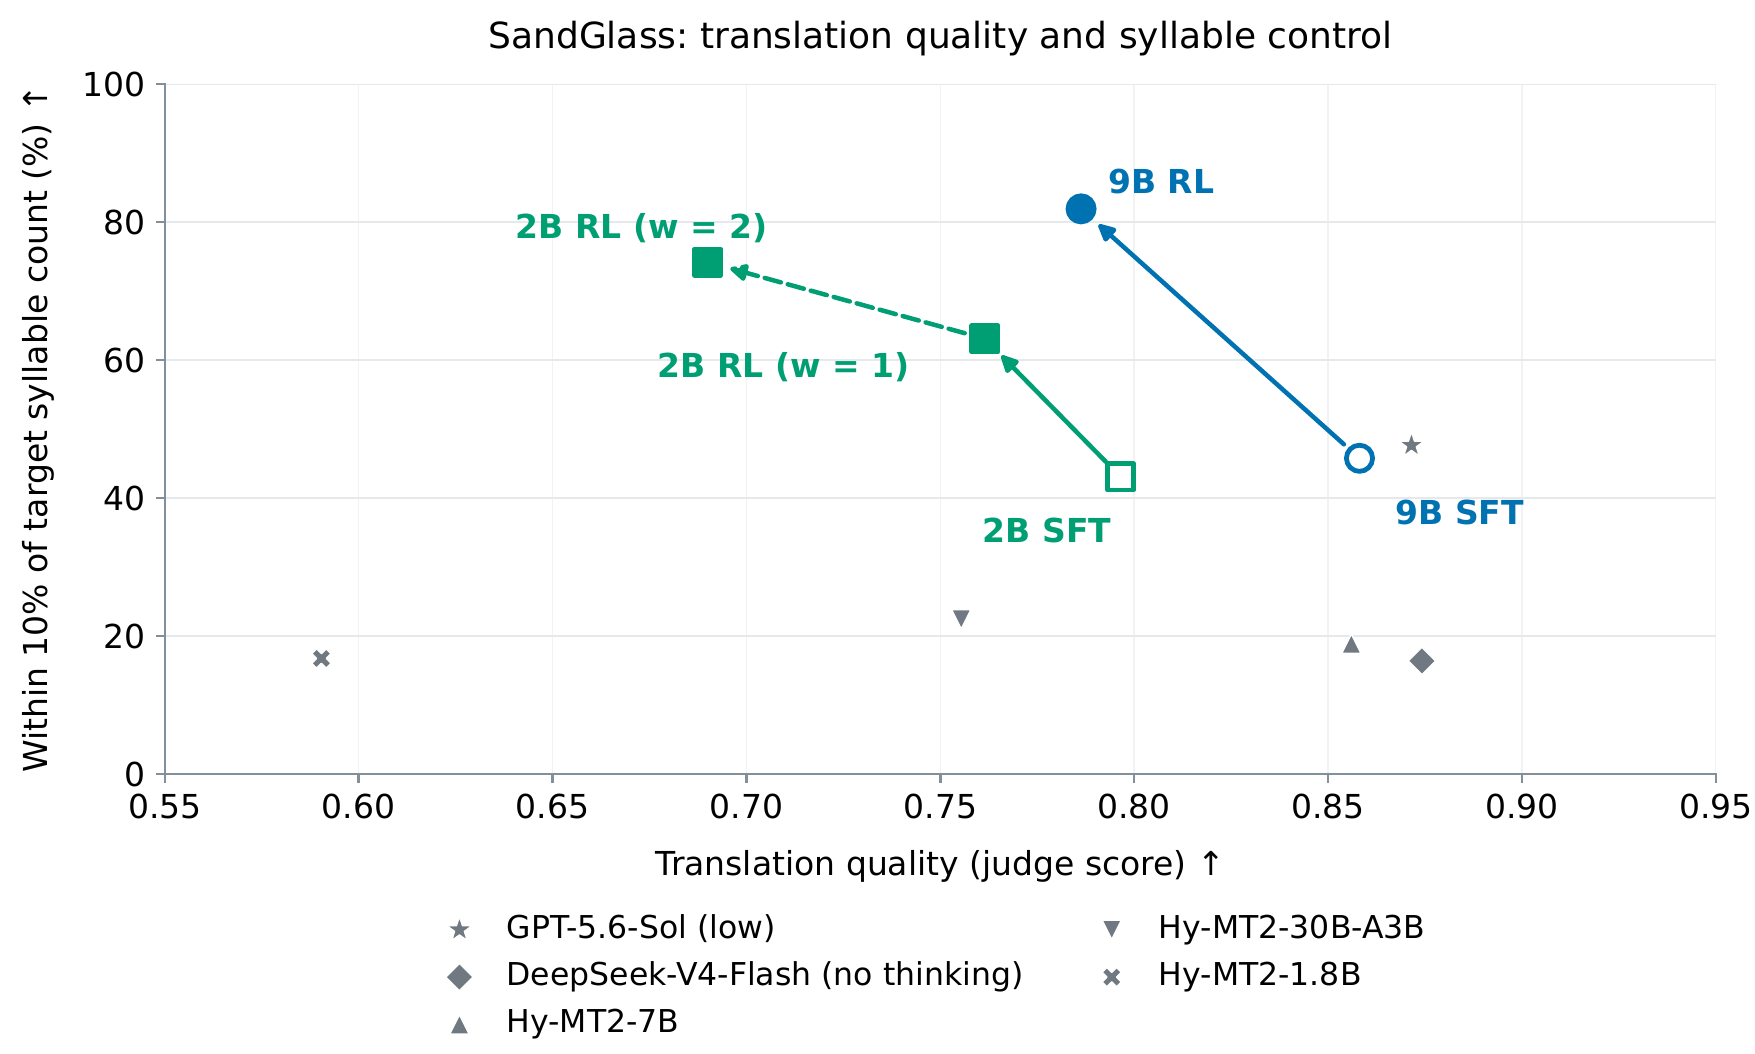
위 그림은 길이 제어와 번역 품질 사이의 트레이드-오프(Trade-Off) 를 보여줍니다. 9B는 SFT에서 RL로 넘어가며 적중률이 45.75%에서 81.92%로 올랐지만 품질은 0.8581에서 0.7863으로 내려갔습니다. 2B에서 음절 보상 가중치를 1에서 2로 높이면 적중률은 63.08%에서 74.19%로 오르는 대신 품질이 0.7615에서 0.6900으로 떨어집니다. 길이를 엄격히 맞출수록 표현 선택의 폭이 좁아진다는 점에서 자연스러운 결과이며, 실제 더빙에서는 적중률과 품질 중 무엇을 우선할지 용도에 맞게 정해야 합니다.
Index-NativeLong: 장편 소설을 한 번에 번역하기
책 한 권을 LLM으로 번역할 때는 보통 문서를 여러 조각(Chunk)으로 나누고 용어집(Glossary)과 앞뒤 문맥을 함께 넘기는 방식을 씁니다. Index-NativeLong 은 이와 달리 문서 전체를 입력으로 받아 전체 번역을 한 번의 생성으로 출력하는 네이티브 장문 번역(Native Long-Document Translation) 을 목표로 합니다. 긴 입력을 받는 것보다 긴 출력을 끝까지 생성하는 것이 더 어렵다는 점은 LongWriter에서도 지적된 바 있습니다.
학습은 정렬된 책 구절과 완전한 번역문으로 전체 파라미터 SFT를 하는 방식입니다. 2B는 128K 시퀀스 감쇠 단계를 거친 중간 학습 모델에서, 9B는 앞서 통합된 텍스트 모델에서 출발해 중국어 기준 약 4K~64K 토큰 길이의 양방향 문서로 학습했습니다. 평가는 원문 전체와 출력 전체를 문장 단위로 정렬하는 SEGALE로 블록을 맞춘 뒤 COMET으로 채점하며, 짝이 맞지 않는 블록은 0점이라 번역을 중간에 멈추면 점수가 크게 떨어집니다.
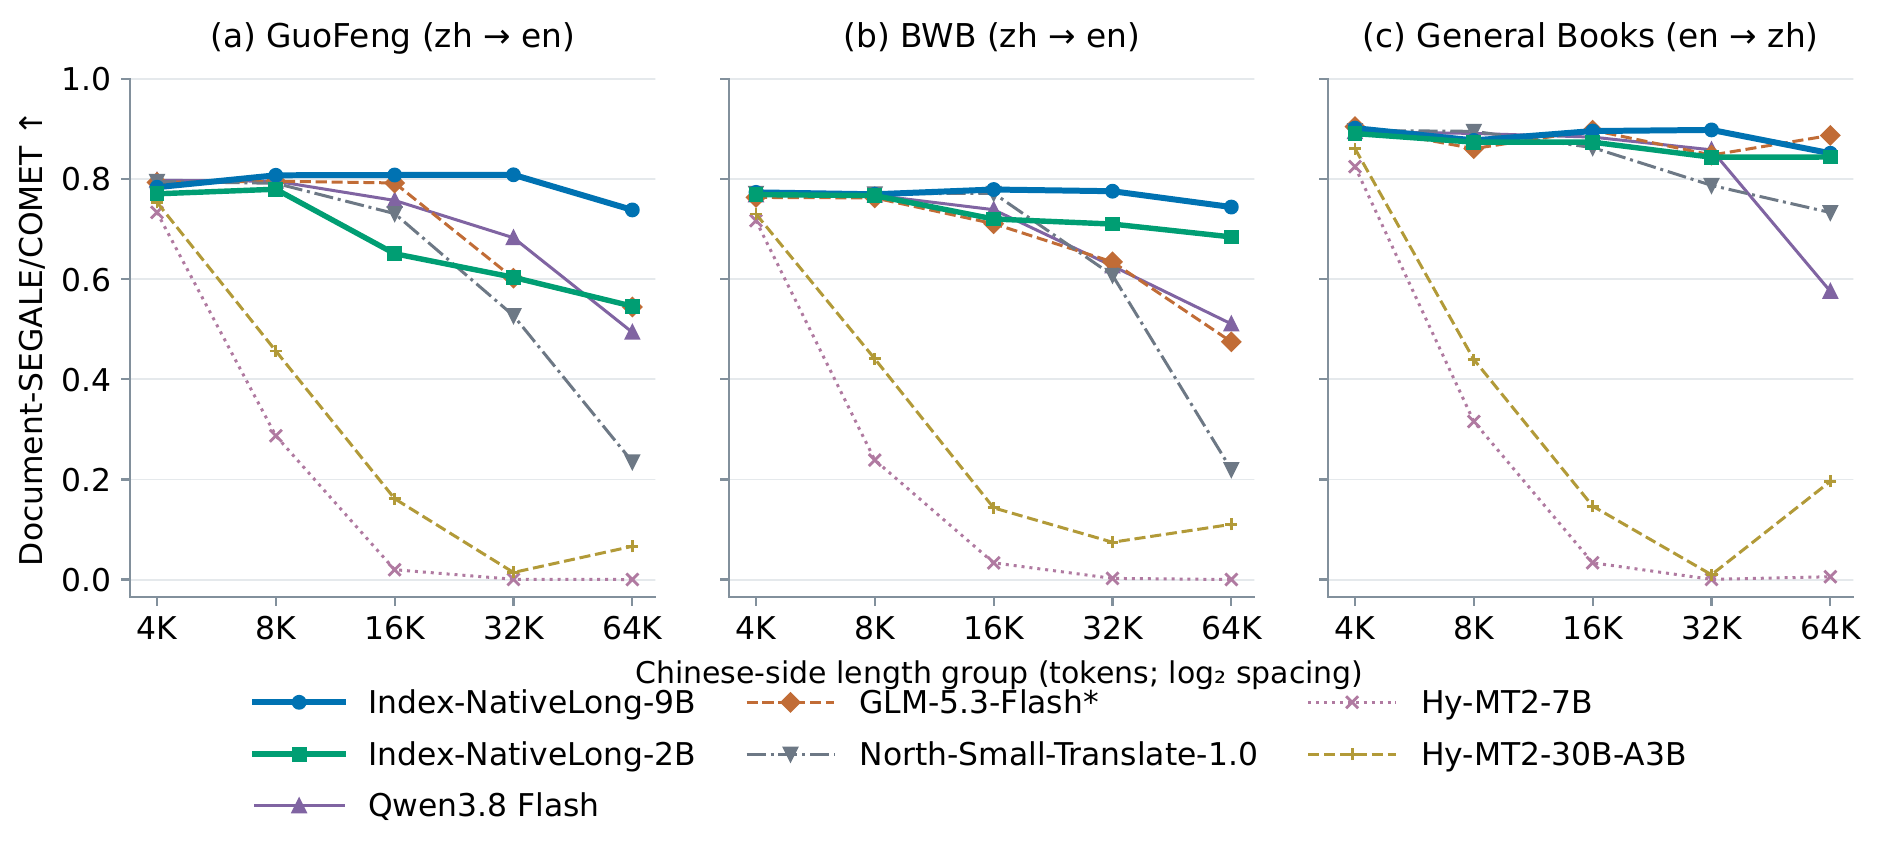
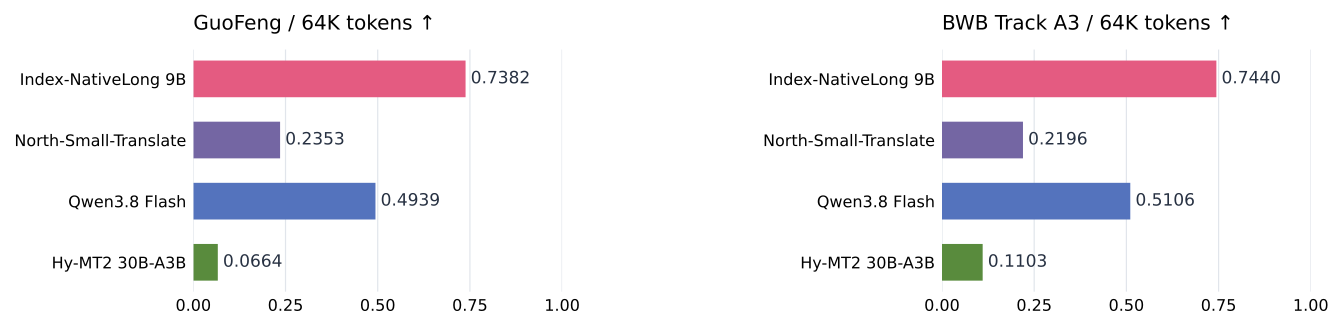
위 그림처럼 4K 길이에서는 대부분의 모델이 비슷한 점수를 보이지만, 길이가 늘어날수록 차이가 크게 벌어집니다. 번역 특화 모델인 Hy-MT2-7B는 GuoFeng(중국어→영어)에서 4K 0.7334였던 점수가 16K에서 0.0197, 64K에서 0.0001로 사실상 0이 되었고, 리포트는 이 모델이 짧은 조각만 번역하고 멈추는 경우가 있었다고 설명합니다. 범용 모델인 Qwen3.8 Flash도 GuoFeng 64K에서 0.4939로 떨어진 반면, Index-NativeLong-9B는 0.7382를 유지했습니다. 9B의 5개 길이 평균은 GuoFeng 0.7891, BWB 0.7683, General Books(영어→중국어) 0.8848로 세 데이터셋 모두에서 가장 높았습니다.
리포트 부록의 사례는 전체 문서를 한 번에 번역하는 방식의 장점을 구체적으로 보여줍니다. 약 32K 토큰 판타지 소설에서 인물 이름 王妃(Wang Fei)는 네이티브 9B가 31.3%, 56.6%, 84.8% 지점 모두에서 Wang Fei로 일관되게 옮긴 반면, 같은 9B를 TranslateBooksWithLLMs 조각 번역 흐름에 넣자 Instructor Wangfei, the Dean, The Queen Consort로 바뀌었습니다. 빙하사 문서에서는 저자가 정의한 "빙하 시대(冰河时代)"와 그 안의 "빙기(冰期)"라는 포함 관계를 네이티브 9B는 지켰지만, Qwen3.8-Flash 조각 번역은 원문 전체로 만든 용어집을 줘도 두 개념을 모두 冰期로 옮겨 구분이 사라졌습니다. 반대로 원문 전체로 만든 용어집은 王妃를 Wang Fei로 바로잡아, 좋은 용어집이 조각 번역의 문제 일부를 덜어준다는 점도 함께 확인되었습니다. 세 문서 기준 호출 횟수는 네이티브 방식이 3회와 입력 90,143 토큰, 조각 방식이 160회와 입력 225,125 토큰이었는데, 홈페이지는 두 방식의 실행 환경이 달라 이 값을 실행 시간 비교가 아니라 작업 흐름의 부담을 보여주는 수치로 봐야 한다고 덧붙입니다.
다만 해석할 때 주의할 점도 있습니다. 리포트는 이 고정 평가셋이 모델 개발 과정에서도 사용되었다고 밝히고 있어, 개발 중 평가셋에 맞춰 조정되었을 가능성을 배제할 수 없습니다. 또한 Gemini 3.8 Flash는 출력 한도(65,536 토큰)가 가장 긴 테스트 그룹의 출력 예산보다 작아 비교에서 제외되었고, North-Small-Translate의 32K 이상 결과는 공식 지원 범위(16K)를 넘겨 실험적으로 확장한 값입니다. NativeLongBench는 공유 가능한 부분을 공개할 계획이라고 합니다.
vLLM으로 Index-Translate 실행하기
텍스트 모델은 Qwen3.5를 지원하는 vLLM 버전으로 OpenAI 호환 서버를 띄운 뒤, 저장소의 클라이언트 스크립트로 호출합니다. README의 빠른 시작 예시는 다음과 같습니다:
git clone https://github.com/bilibili/Index-Translate.git
cd Index-Translate
pip install -U vllm
pip install -r inference/llm/requirements.txt
vllm serve IndexTeam/Index-Translate-2B --host 127.0.0.1 --port 8000 --max-model-len 4096
다른 터미널에서 번역을 요청합니다:
python inference/llm/translate.py \
  "你好,世界。今天天气不错,我们去公园散步吧。" \
  --target en --model IndexTeam/Index-Translate-2B
텍스트 번역은 그리디 디코딩(temperature=0)과 enable_thinking=False가 기본이고, Index-Homura는 syllable_translate.py에 --syllables로 목표 음절 수를, Index-NativeLong은 doc_translate.py로 전체 문서를 넘깁니다. 기본 서빙 컨텍스트는 텍스트 모델 32K, NativeLong 2B 262,144 토큰, 9B 229,376 토큰입니다. 저장소 안내에 따르면 bf16 기준 GPU 메모리는 2B 약 8GB, 9B 약 24GB에 KV 캐시가 더해지며, vLLM 0.29에서 테스트되었고 SGLang으로도 서빙할 수 있습니다. Index-Echo-S2ST는 별도 패키지(2B 약 13GB, 9B 약 26GB)로 배포되며 2B는 12GB, 9B는 24GB 이상의 VRAM이 필요하고, 30초 이하의 짧은 발화 단위 입력에 맞춰져 있습니다. 프롬프트는 "다음 텍스트를 {목표 언어}로 번역하고, 설명 없이 번역 결과만 출력하라" 형태의 고정 템플릿을 쓰며, 용어 고정이나 구조화 데이터 번역용 템플릿은 저장소의 프롬프트 예시 문서에 정리되어 있습니다. 로컬 모델로 웹 페이지를 번역하는 브라우저 확장과, 음성 분리부터 더빙 정렬까지 처리하는 영상 더빙 파이프라인도 함께 제공됩니다.
설치 없이 써 보려면 홈페이지의 온라인 데모를 이용할 수 있습니다. 텍스트 번역 데모에서는 어조, 호칭, 출력 형식 같은 사용자 지시를 함께 넣을 수 있고 이때는 9B 모델이 쓰이며, 영상 데모는 Bilibili 영상 URL이나 BV, av ID를 받아 번역 자막(이중 언어 ASS 파일 내보내기)과 별도의 더빙 단계를 제공합니다. 음절 제어 데모는 중국어 대사를 영어, 아랍어, 스페인어, 일본어로 옮기면서 목표 음절 수를 슬라이더로 정합니다. 장문 번역 데모는 중국어 TXT, Markdown 문서를 받아 영어 번역을 Markdown이나 PDF로 내려받게 해 주는데, 홈페이지 설명에 따르면 현재 데모는 문서를 구간별로 나눠 처리하므로 전체 문서를 한 번에 생성하는 앞서 설명한 네이티브 방식과는 동작이 다릅니다.
평가 수치를 읽을 때 짚어볼 점
Index-Translate의 평가는 범위가 넓고, 리포트가 약점도 비교적 솔직하게 기록하고 있습니다. 그럼에도 결과를 받아들일 때 고려할 점이 몇 가지 있습니다.
-
자체 벤치마크 비중: instTrans, MEME, SandGlass, NativeLongBench, 그리고 S2TT, S2ST 테스트셋은 모두 Index 팀이 직접 만든 것이며 아직 공개되지 않았습니다. GitHub TODO에 따르면 instTrans, SandGlass-V2, nailong-bench, meme-bench는 공개 예정입니다.
-
LLM 판정자 의존: 지시 따르기와 WMT26은 GPT-5.6-Sol이, 밈과 SandGlass 품질은 Gemini 2.5 Flash가, 음성 번역 품질은 Gemini 3.1 Pro가 채점합니다. 학습 보상에도 Gemini 계열 판정자가 쓰였으므로 판정자와 보상 모델의 취향이 겹칠 가능성이 있고, WMT26처럼 판정자(GPT-5.6-Sol)가 비교 대상에 포함된 경우도 있습니다.
-
홈페이지와 리포트의 차이: 앞서 살펴본 것처럼 홈페이지 요약 문구는 비교 대상이나 지표를 일부 생략한 표를 기준으로 "1위"를 표기한 경우가 있습니다. 순위를 인용할 때는 리포트의 전체 표를 확인하는 것이 좋습니다.
-
35B-A3B는 프리뷰: 일부 지표에서 가장 높은 35B-A3B는 아직 학습 중인 프리뷰 버전이며, 리포트의 분석 실험 대부분은 2B와 9B를 기준으로 합니다.
Index-Translate의 라이선스
Index-Translate의 코드와 모든 모델 가중치는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다.
 Index-Translate 홈페이지 및 온라인 데모
 Index-Translate 기술 리포트 (PDF)
 Index-Translate GitHub 저장소
 Index-Translate 모델 컬렉션 (Hugging Face)
더 읽어보기
-
Hy-MT2: A Family of Fast, Efficient and Powerful Multilingual Translation Models in the Wild (arXiv)
-
TranslateGemma: Google이 공개한 Gemma 3 기반의 개방형 기계 번역 모델 (4B / 12B / 27B)
-
Qwen3.5: 초기부터 멀티모달 데이터로 학습한, 에이전트 중심의 워크플로우에 최적화된 Native Multimodal Agent Model
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
