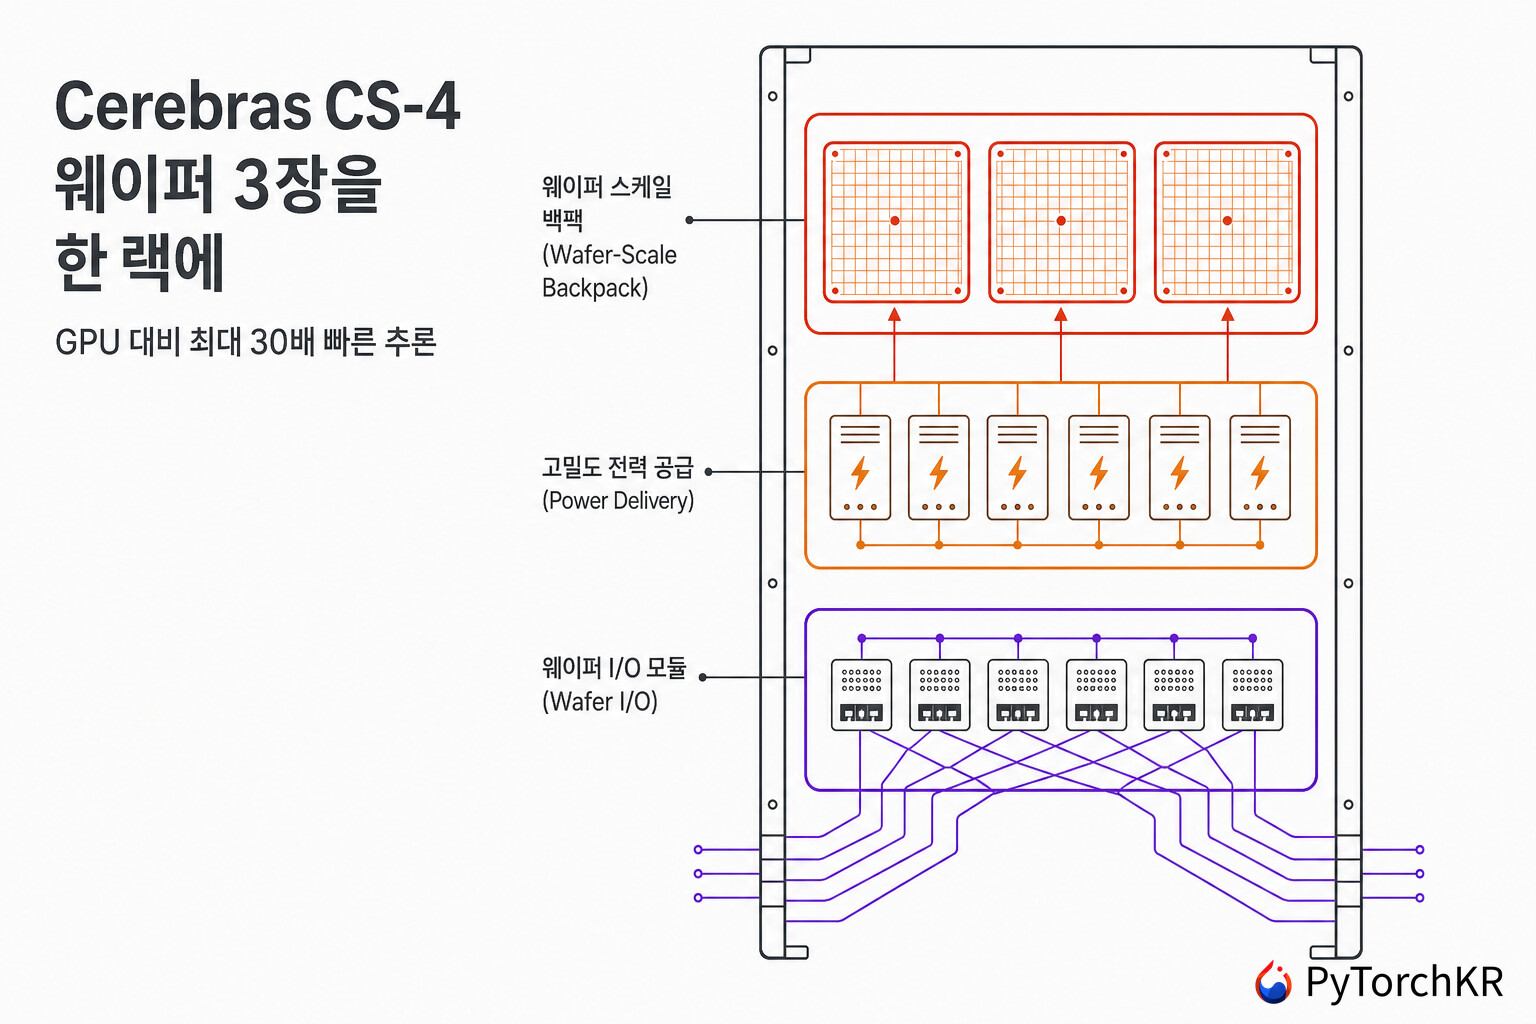
Cerebras CS-4 소개
Cerebras Systems(NASDAQ: CBRS)가 2026년 8월 18일 4세대 웨이퍼 스케일 시스템인 Cerebras CS-4를 공개했습니다. CS-4는 웨이퍼 한 장을 그대로 프로세서로 쓰는 Wafer Scale Engine의 신형 판본인 WSE-3 Turbo(WSE-3T) 3장을 하나의 랙에 담은 시스템으로, Cerebras는 사용자당 초당 토큰 수(tokens per second per user) 기준으로 GPU 기반 시스템 대비 최대 30배, 전 세대인 CS-3 대비 최대 2배 빠른 추론(Inference) 속도를 제시했습니다. 같은 전력 예산에서 만들어 내는 총 토큰 수도 CS-3 대비 최대 10배로 늘었다고 밝혔습니다.
Cerebras는 2019년부터 GPU를 여러 장 연결하는 대신 웨이퍼 한 장(46,225mm²)을 자르지 않고 통째로 프로세서로 쓰는 노선을 택해 왔습니다. 이 노선의 이점이 가장 크게 드러나는 곳이 디코드(Decode), 즉 토큰을 한 개씩 만들어 내는 단계입니다. 디코드는 토큰 하나를 만들 때마다 활성 가중치 전체를 메모리에서 읽어야 하므로, 연산량보다 메모리 대역폭(Memory Bandwidth)이 성능을 결정합니다. GPU는 이 가중치를 칩 밖의 HBM에서 읽어 오지만, 웨이퍼 스케일 프로세서는 44GB를 웨이퍼 안 SRAM에 두고 읽습니다. CS-4의 시스템 메모리 대역폭이 초당 129.6페타바이트로 표기되는 것은 이 구조 덕분이며, 2019년 이후 Cerebras의 세대 갱신이 대체로 "웨이퍼 안에서 얼마나 빨리 읽을 수 있는가" 를 밀어 온 이유이기도 합니다 (
 Cerebras, 62개의 H100 GPU와 유사한 성능의 WSE-3 공개).
이번 발표에서 눈여겨볼 부분은 프로세서 자체가 아니라 랙입니다. WSE-3 Turbo는 트랜지스터 수, 코어 수, SRAM 용량, 공정이 모두 WSE-3와 동일한데 연산 성능과 대역폭만 두 배가 됐습니다. 새 실리콘을 찍은 것이 아니라, 랙 설계를 바꿔 웨이퍼에 두 배의 전력을 밀어 넣을 수 있게 되면서 동작 주파수를 올린 결과입니다. Cerebras가 이번에 함께 발표한 Nexus 랙 스케일 플랫폼(Nexus Rack-Scale Platform) 은 컴퓨트, 전력, I/O를 각각 독립적으로 교체 가능한 모듈로 분리한 랙 구조이고, CS-4는 그 첫 번째 구현체입니다.
아래에서는 Cerebras가 제시한 성능 수치와 그 수치가 어떤 조건에서 측정된 것인지, Nexus 플랫폼이 컴퓨트와 전력과 I/O를 어떻게 나눴는지, 그리고 사양표에 적히지 않은 항목이 무엇인지를 순서대로 살펴보겠습니다.
한 랙에 웨이퍼 3장, CS-3에서 CS-4로 바뀐 것
CS-3은 16RU 섀시에 WSE-3 한 장을 담은 시스템이었습니다. CS-4는 웨이퍼 3장을 하나의 랙에 담고, 그 3장을 랙 안에서 직접 연결합니다. 공식 보도자료가 제시한 세대 간 사양 비교는 다음과 같습니다.
| 항목 | CS-3 (웨이퍼 1장) | CS-4 (웨이퍼 3장) |
|---|---|---|
| AI 연산 성능 | 125 PFLOPS | 750 PFLOPS |
| 메모리 대역폭 | 21.6 PByte/s | 129.6 PByte/s |
| 온칩 패브릭 대역폭 | 26.7 PByte/s | 160.5 PByte/s |
| 시스템 I/O 대역폭 | 1.2 Tbit/s | 7.2 Tbit/s |
| I/O 지연 | 5마이크로초 | 2마이크로초 |
위 표를 통해 2가지를 알아볼 수 있습니다. 첫 번째로, 대역폭 항목은 모두 약 6배입니다. 웨이퍼가 3장으로 늘어난 3배와 웨이퍼당 대역폭이 2배가 된 것이 곱해진 값입니다. 두 번째로, I/O 지연은 웨이퍼 수와 무관하게 5마이크로초에서 2마이크로초로 줄었습니다. 이 항목만 배수가 아닌 절대값으로 개선됐고, 뒤에서 볼 대형 모델 서빙에서 가장 직접적으로 작용하는 수치입니다.
같은 실리콘, 두 배의 전력, WSE-3 Turbo
WSE-3 Turbo의 사양을 전 세대와 나란히 놓으면 무엇이 바뀌고 무엇이 그대로인지가 분명해집니다.
| 항목 | WSE-3 | WSE-3 Turbo |
|---|---|---|
| 트랜지스터 / 면적 / 공정 | 4조 개 / 46,225mm² / TSMC 5nm | 동일 |
| AI 코어 / 온칩 SRAM | 900,000개 / 44GB | 동일 |
| AI 연산 성능 | 125 PFLOPS | 250 PFLOPS |
| 메모리 대역폭 | 21.6 PByte/s | 43.2 PByte/s |
| 온칩 패브릭 대역폭 | 26.7 PByte/s | 53.5 PByte/s |
| 오프칩 I/O 대역폭 | 1.2 Tbit/s | 2.4 Tbit/s |
물리적 규모는 하나도 바뀌지 않았고 속도만 두 배가 됐습니다. Cerebras의 공식 블로그가 이 결과를 "다음 단계의 AI 인프라 도약은 한 부품만 개선해서는 나올 수 없다" 는 전제로 설명하는 이유가 여기 있습니다. 연산, 전력, 냉각, I/O를 함께 옮겼기 때문에 같은 다이에서 더 높은 주파수를 낼 수 있었다는 서술입니다. 실제로 전력 공급 거리를 약 100분의 1로 줄여 웨이퍼에 두 배의 전력을 전달한다는 설명이 랙 구조 절에 이어집니다.
다만 연산 성능 표기는 한 가지 유의할 점이 있습니다. 데이터시트는 750 PFLOPS와 250 PFLOPS 모두에 각주를 달아 희소(Sparse) FP16 기준 임을 명시하고 있습니다. 희소성(Sparsity)을 가정한 최대치이므로, 다른 가속기가 흔히 표기하는 밀집(Dense) 연산 성능과 같은 축에 두고 비교할 수 없는 숫자입니다.
최대 30배라는 숫자가 가리키는 것, 사용자당 초당 토큰
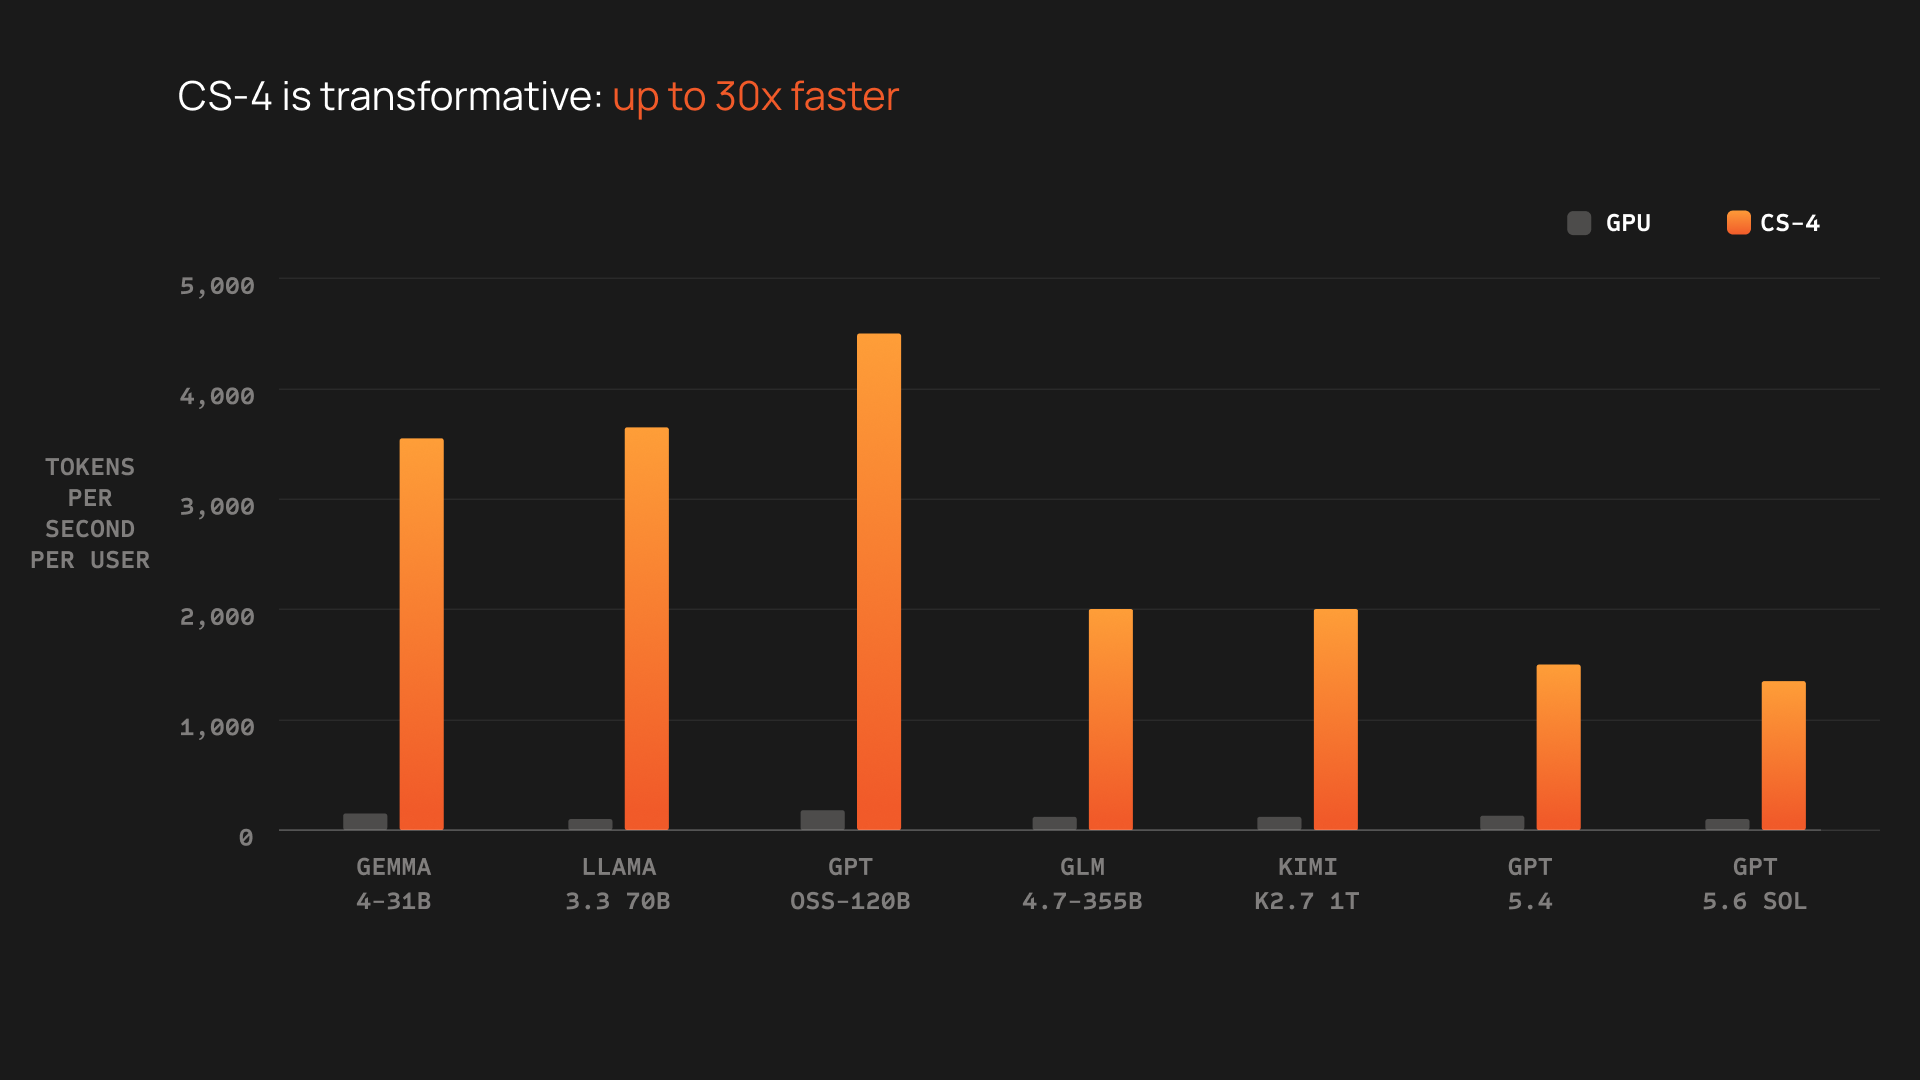
Cerebras가 공개한 비교 그래프는 7개 모델에서 CS-4와 GPU의 사용자당 초당 토큰 수(TPS/user) 를 나란히 놓습니다. 대상 모델은 Gemma 4-31B, Llama 3.3 70B, GPT-OSS-120B, GLM 4.7-355B, Kimi K2.7 1T, GPT-5.4, GPT-5.6 Sol로, 31B 규모의 소형 모델부터 1조 파라미터급 모델까지 걸쳐 있습니다. 보도자료가 명시한 단일 수치는 GPT-OSS-120B 한 건으로, 동일한 프롬프트를 준 직접 비교에서 CS-4가 사용자당 초당 4,400 토큰 이상을 냈고 이것이 GPU 대비 최대 30배에 해당한다고 적혀 있습니다.
그래프에서 읽히는 경향은 모델이 커질수록 CS-4의 절대 속도도 함께 내려간다는 점입니다. 다만 가장 큰 1조 파라미터급 모델에서도 막대는 2,000 토큰/초 부근에 머물러, GPU 계열의 막대가 모든 모델에서 200 토큰/초 아래에 머무는 것과 대비됩니다. Cerebras CTO이자 공동창업자인 Sean Lie는 이 차이가 체감 속도의 문제가 아니라고 설명합니다.
"30배 빠르다는 것은 응답이 빠르게 느껴지는 데서 끝나지 않습니다. 같은 실제 경과 시간 안에서 에이전트 시스템에 한 자릿수 이상 더 많은 추론, 검증, 도구 사용을 할 여유를 줍니다."
"Being 30 times faster doesn't just make a response feel fast. It gives an agentic system room for more than an order of magnitude as much reasoning, verification, or tool use in the same wall-clock time."
CEO이자 공동창업자인 Andrew Feldman은 여기에 "AI에서 속도는 곧 생산성"이라는 문장과 함께, 지금까지 빠른 추론은 더 작고 성능이 낮은 모델을 쓴다는 뜻이었지만 CS-4는 가장 큰 프런티어 모델에서 그 속도를 낸다는 점이 다르다고 덧붙였습니다.
10조 파라미터 모델에서 대화성을 지키는 방법, 2마이크로초
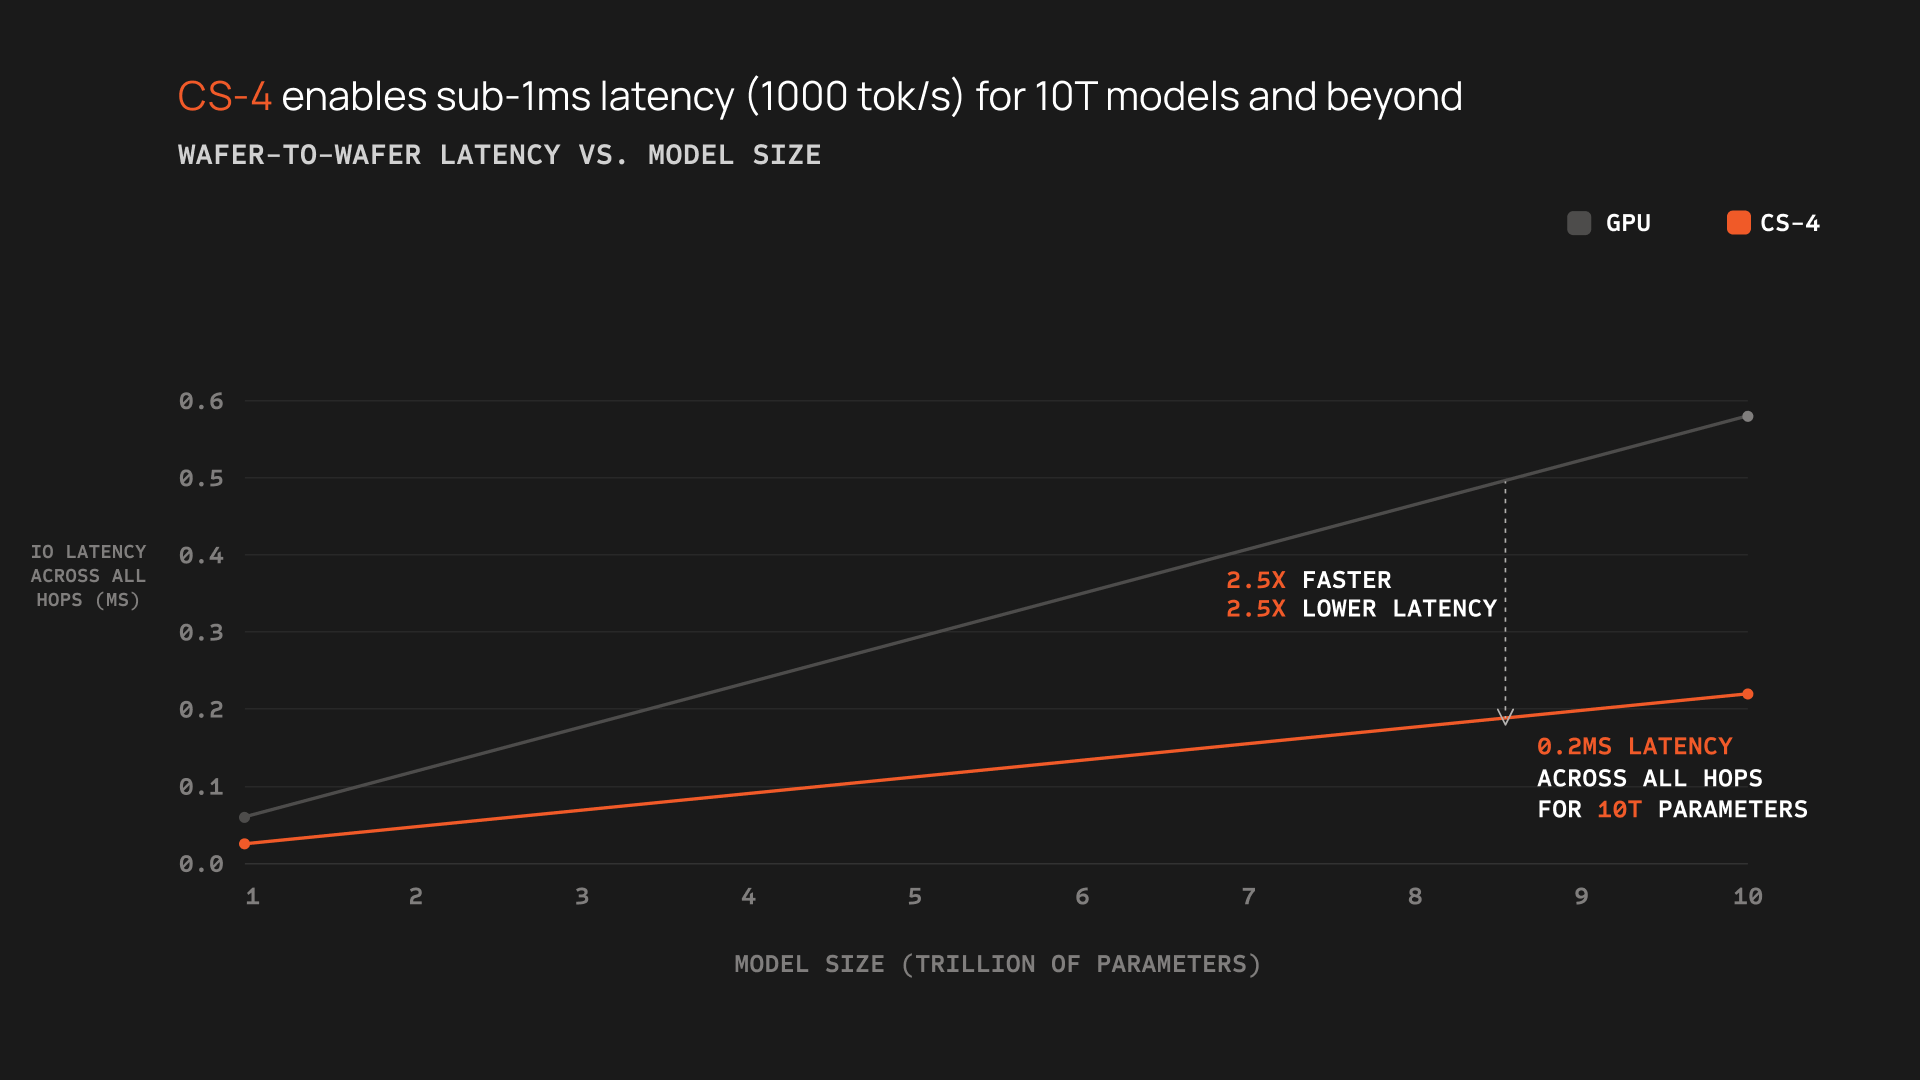
한편 모델이 가속기 한 장에 들어가지 않으면 여러 장에 쪼개 얹어야 하고, 그때부터는 가속기 사이로 중간 결과를 옮기는 시간이 토큰 생성 속도를 결정합니다. 토큰 하나를 만들 때마다 모든 홉(hop)을 한 바퀴 돌아야 하므로, 홉 하나의 지연이 파라미터 수에 비례해 누적됩니다.
위 그래프의 가로축은 조 단위 파라미터 수, 세로축은 모든 홉을 합친 I/O 지연(밀리초)입니다. Cerebras는 웨이퍼 간 지연을 최소 2마이크로초까지 낮춰, 10조 파라미터 모델에서도 전체 홉 지연을 0.2밀리초 수준으로 유지한다고 제시합니다. 10조 파라미터 지점에서 GPU 곡선은 0.5밀리초를 넘고, 그래프는 이 차이를 2.5배 낮은 지연으로 표기합니다. 이 지연 예산 안에서 10조 파라미터를 넘는 모델에서도 초당 1,000 토큰 이상을 낼 수 있다는 것이 CS-4의 대형 모델 관련 핵심 주장이며, 보도자료는 클러스터를 키우면 50조 파라미터를 넘는 모델까지 지원 범위에 든다고 밝혔습니다. 다만 그래프의 캡션은 이 곡선이 내부 벤치마크에서 외삽(extrapolation)한 값(2026년 8월)이라고 표기하고 있습니다.
처리량과 대화성의 트레이드 오프를 옮기려는 시도
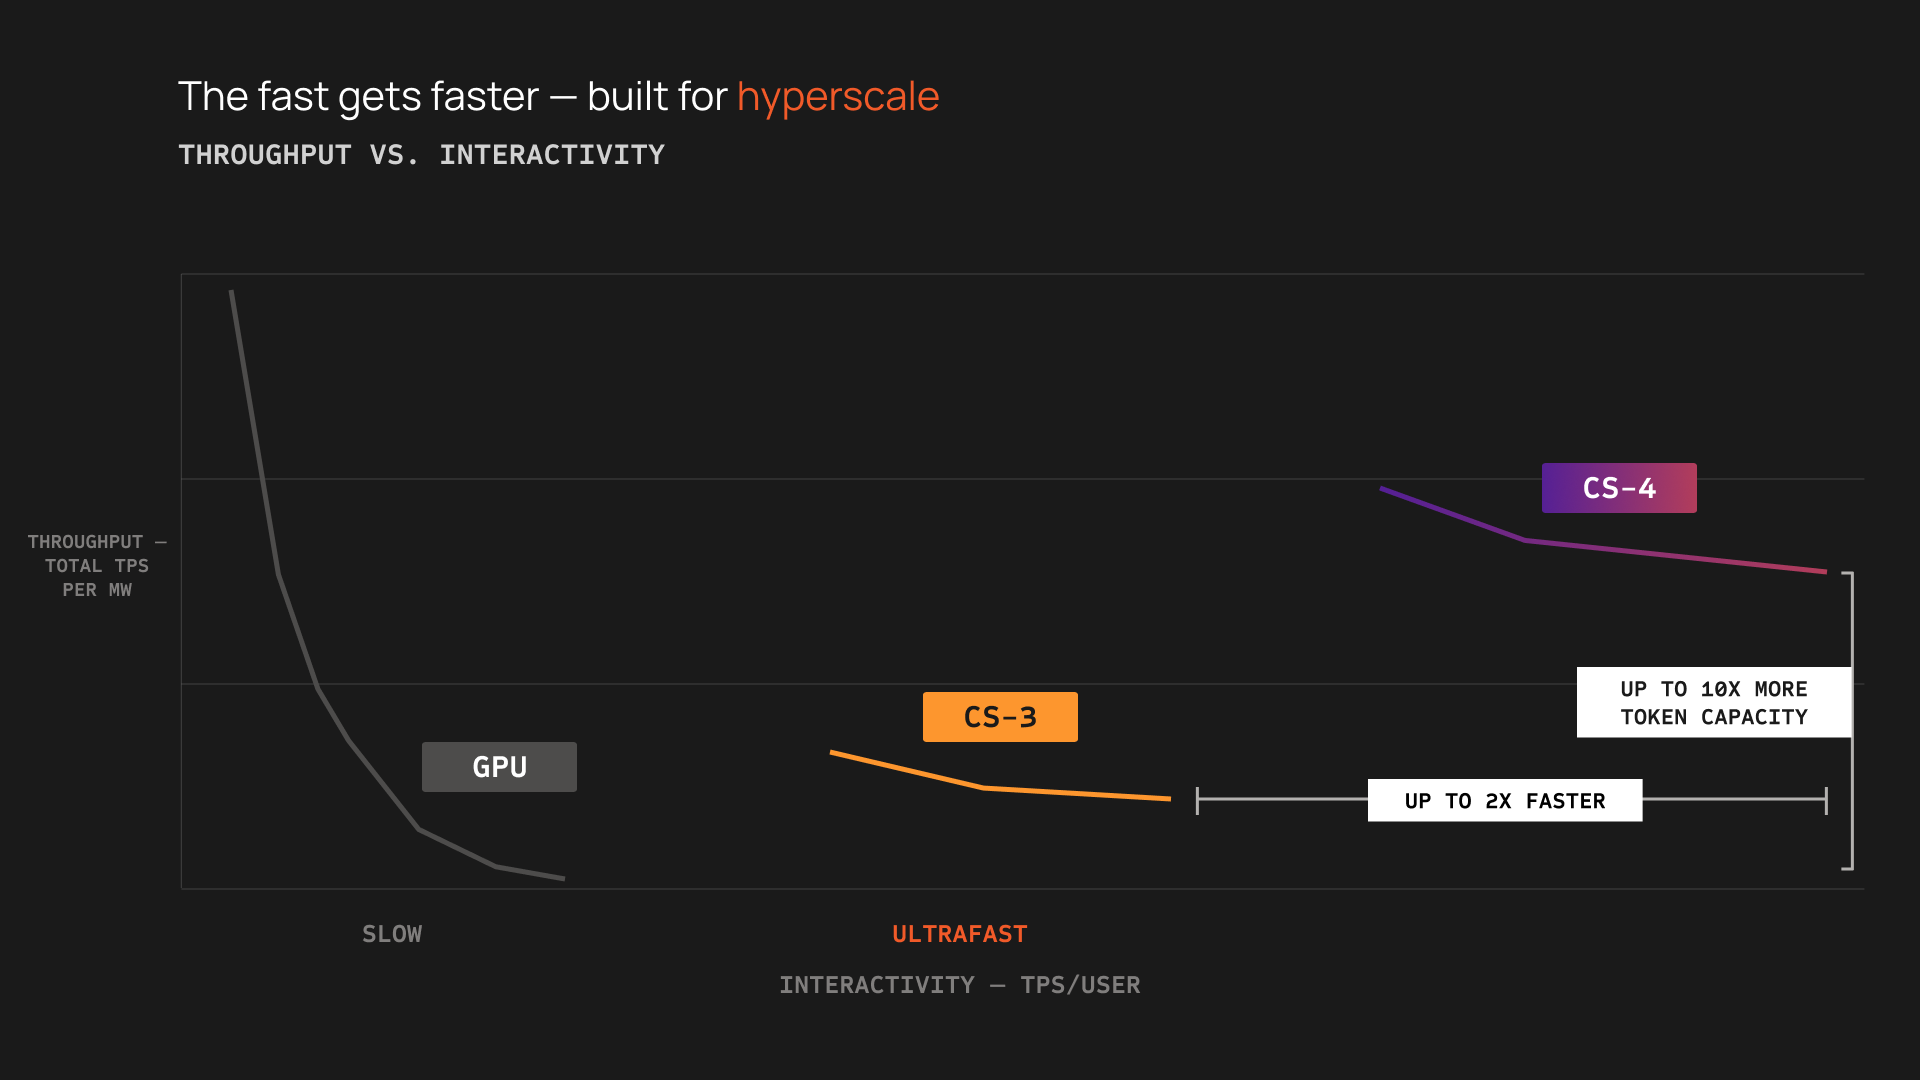
추론 서비스를 운영하는 쪽에서는 사용자 한 명이 느끼는 속도와 시스템 전체가 뽑아내는 총 토큰 수가 서로 상충합니다. 배치를 키우면 총량이 올라가지만 개별 응답은 느려지고, 반대로 대화성을 지키려면 총량을 포기해야 합니다. 위 그래프의 세로축은 메가와트당 총 토큰 처리량(Throughput), 가로축은 사용자당 초당 토큰으로 표현한 대화성이며, 세 곡선은 각각 GPU, CS-3, CS-4의 선택 가능한 조합을 나타냅니다.
Cerebras가 주장하는 것은 이 곡선 자체가 위로, 그리고 오른쪽으로 옮겨간다는 것입니다. CS-4는 CS-3 대비 와트당 처리량이 최대 10배, 토큰 생성 속도가 최대 2배라고 표기돼 있습니다. 데이터센터 운영 관점에서는 이쪽이 30배라는 숫자보다 직접적입니다. 전력이 병목인 환경에서 같은 메가와트로 더 많은 토큰을 팔 수 있는지가 실제 비용 구조를 결정하기 때문입니다. 이 곡선 역시 내부 벤치마크와 추정치(2026년 8월) 기준이라고 캡션에 적혀 있습니다.
프리필은 GPU에, 디코드는 웨이퍼에, 분리형 추론
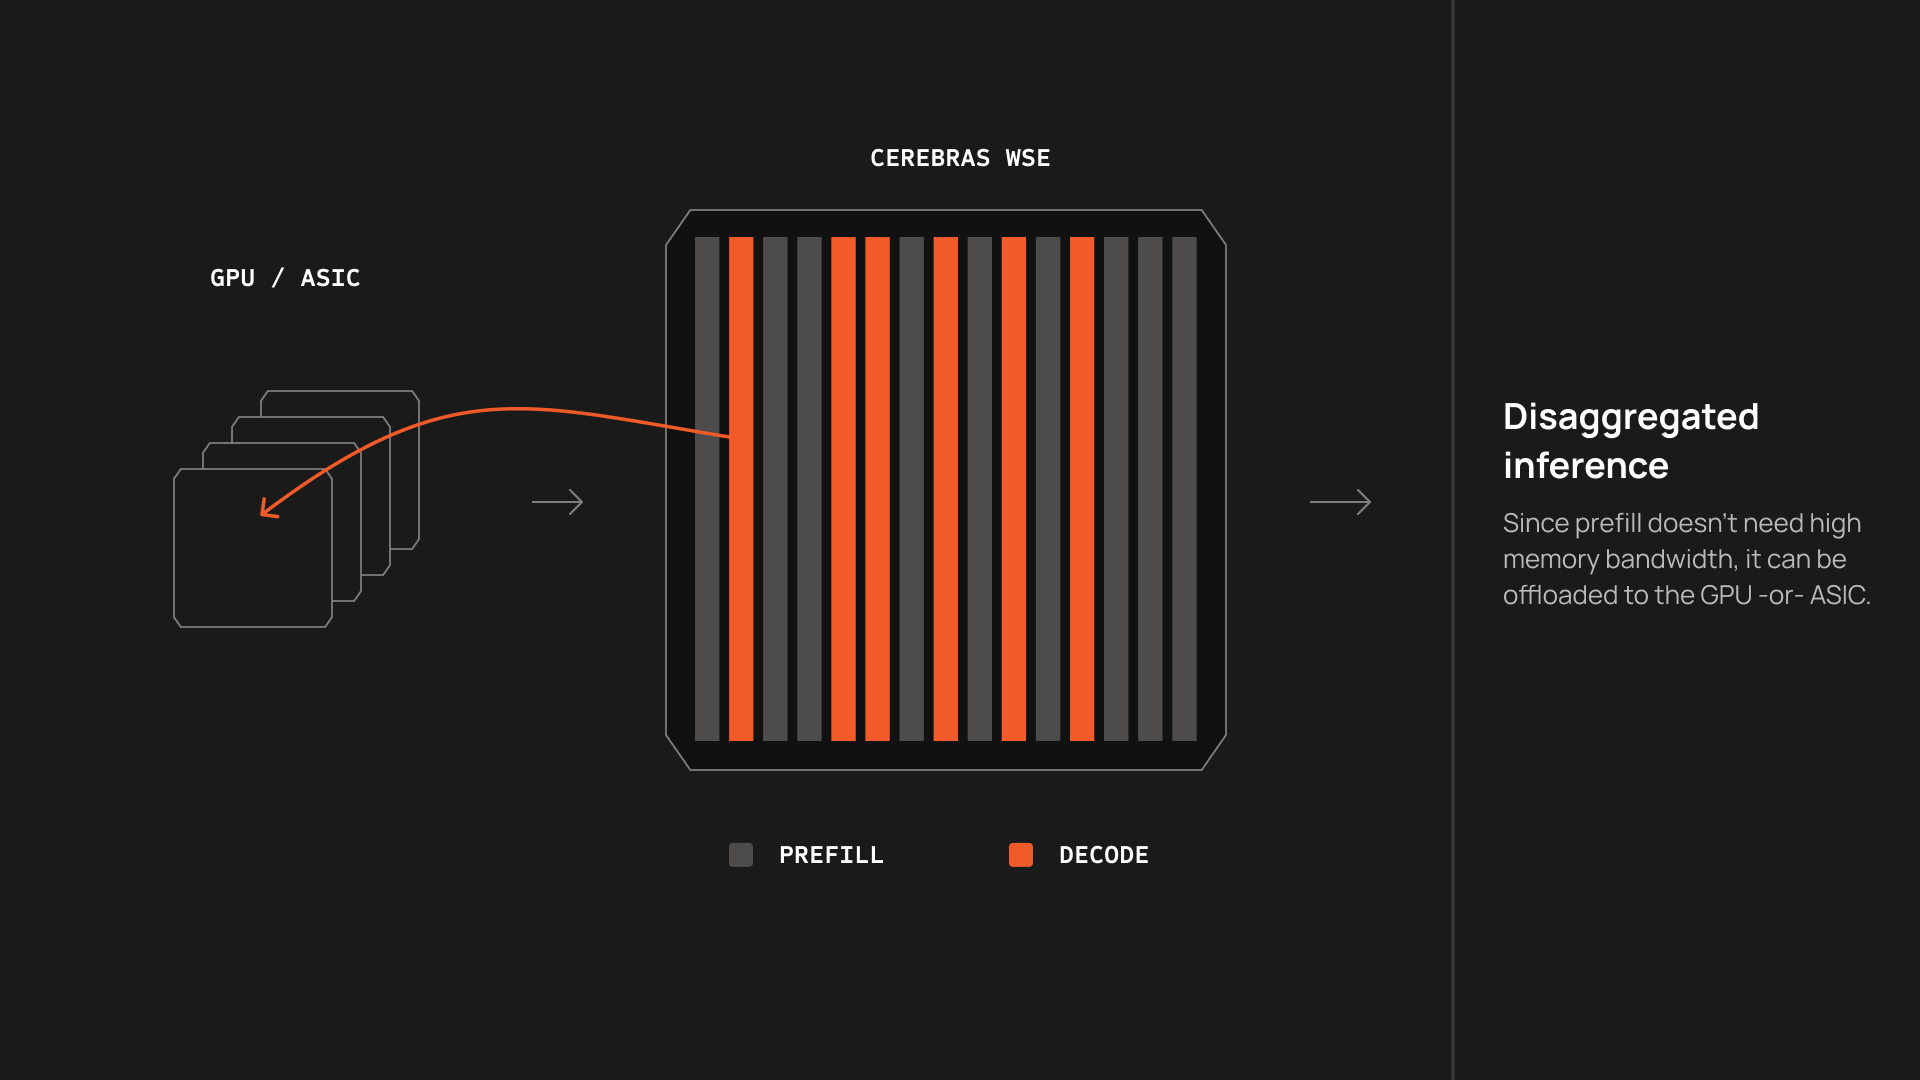
CS-4가 이전 세대와 성격이 달라진 지점은 다른 회사의 가속기와 한 파이프라인에 들어가는 것을 전제로 설계됐다는 점입니다. LLM 추론은 입력 프롬프트를 한 번에 처리하는 프리필(Prefill) 과 토큰을 하나씩 만들어 내는 디코드로 나뉘고, 두 단계의 병목이 서로 다릅니다. 프리필은 연산량이 많은 대신 메모리 대역폭을 크게 요구하지 않고, 디코드는 그 반대입니다. 그래서 두 단계를 서로 다른 하드웨어에 나눠 맡기는 분리형 추론(Disaggregated Inference) 이 대규모 서빙에서 널리 쓰이는 구조로 자리 잡아 왔습니다 ( DeepSeek-V3/R1 추론 시스템 개요 공개 (feat. DeepSeek OpenInfra)).
그중에서 CS-4가 맡으려는 쪽은 디코드입니다. 전용 프리필 엔진이 프롬프트를 처리해 모델 상태를 만들면 그 상태를 CS-4로 넘기고, CS-4가 초저지연 디코드를 담당해 응답을 생성하는 흐름입니다. Cerebras는 프리필 파트너로 AMD Instinct 계열의 Helios 랙과 AWS Trainium을 직접 거명했습니다. 두 단계를 쪼개 배치하는 발상 자체는 LLM 서빙에서 이미 여러 층위로 진행돼 온 것이기도 합니다 ( LLM 서빙에서 CPU를 GPU로부터 분리해야 하는 이유 | 파이토치 한국 사용자 모임).
Nexus 랙 아키텍처, 컴퓨트와 전력과 I/O를 따로 떼어내다
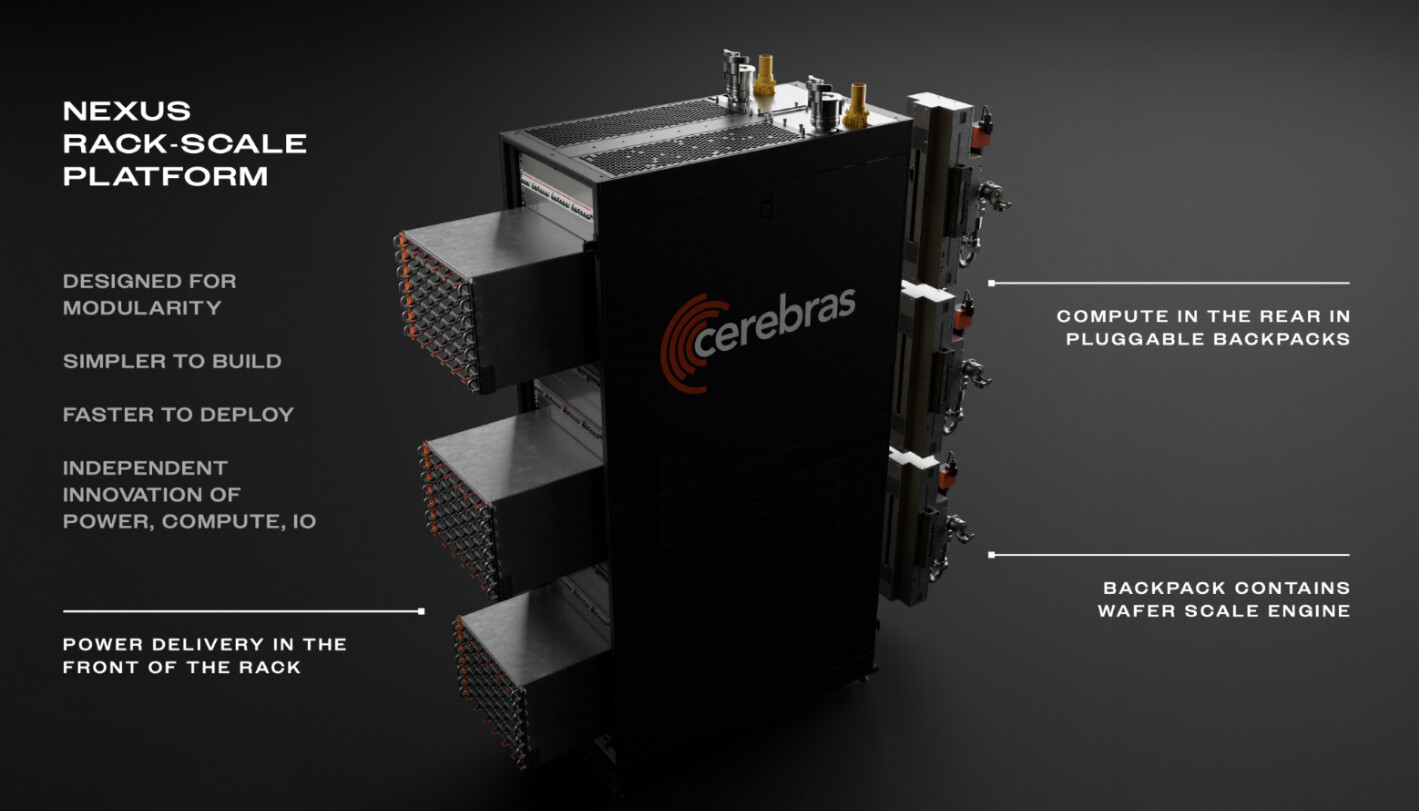
Nexus 플랫폼은 랙을 컴퓨트, 전력, I/O 세 요소로 나누고 각각을 독립적으로 설계하고 교체할 수 있게 만든 구조입니다. 랙 전면에는 전력 공급 장치가 들어가고, 후면에는 웨이퍼가 담긴 착탈식 백팩이 수직으로 꽂힙니다. Cerebras가 이 분리로 노리는 효과는 성능 수치보다 제조와 배치, 그리고 다음 세대로 넘어가는 속도 쪽에 있습니다. 세 요소 중 하나만 개선해도 나머지를 재설계할 때까지 기다리지 않고 제품에 반영할 수 있기 때문입니다.
SemiAnalysis의 창업자이자 CEO인 Dylan Patel은 이 변화를 시스템 배치 가능성과 신뢰성, 네트워킹의 개선으로 평가하면서, 대규모 토큰 생산 환경에서 더 큰 모델로 성능을 확장하는 데 이 부분이 작용한다고 논평했습니다.
웨이퍼 스케일 백팩, 부품 수를 절반으로 줄인 컴퓨트 모듈
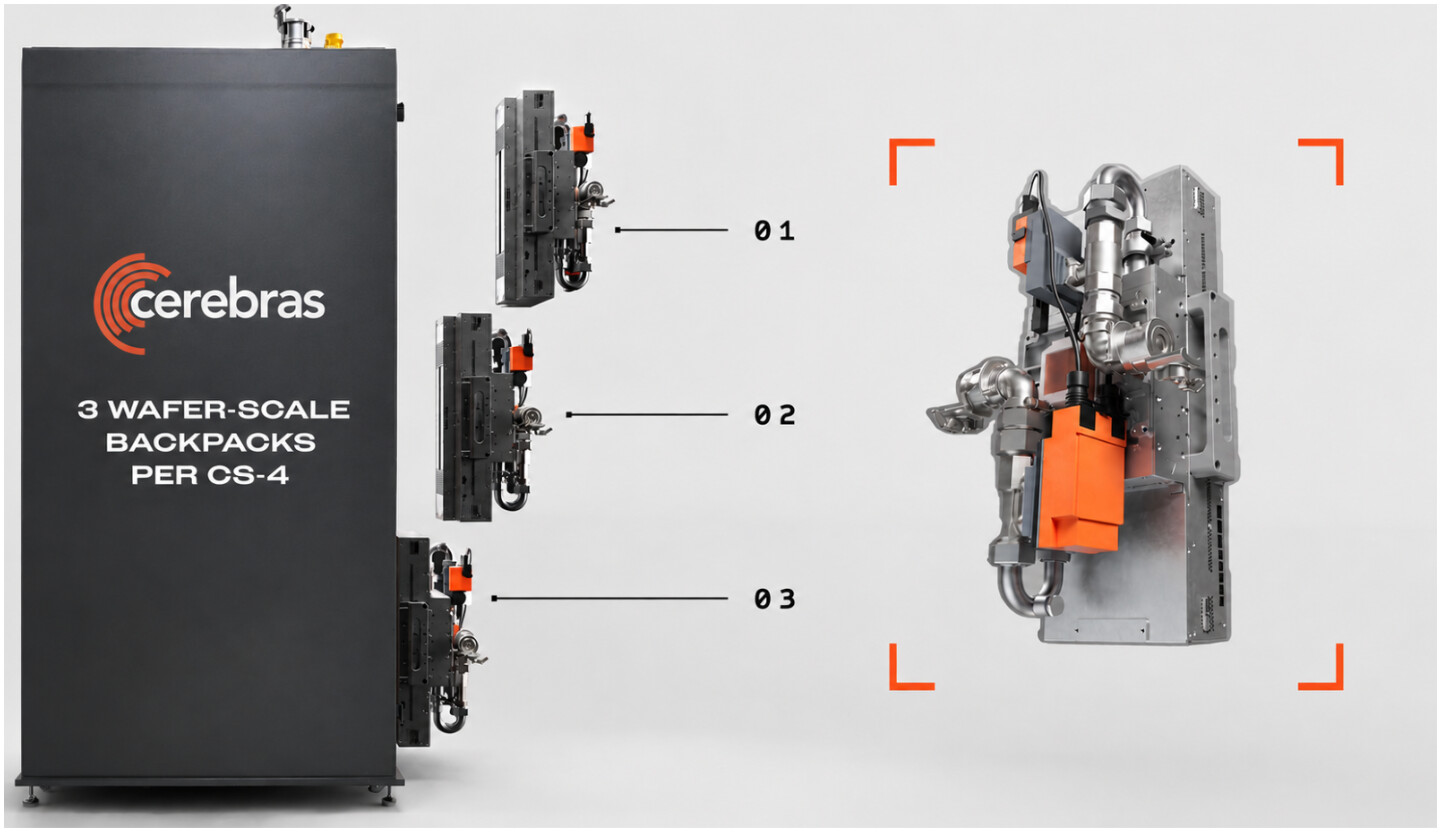
웨이퍼 스케일 백팩(Wafer-Scale Backpack) 은 웨이퍼 한 장을 중심에 두고 전력 변환, 직접 액체 냉각(Direct Liquid Cooling), 고속 I/O, 제어 전자 장치를 3차원으로 접어 넣은 자기완결적 조립체입니다. CS-4 한 대에 이 백팩이 3개 들어갑니다. 컴퓨트를 전원 공급부와 분리한 결과로 전 세대 시스템 대비 부품 수가 50% 줄었고, 자동화 제조 비중은 60% 늘었으며, 배치에 걸리는 시간이 며칠 단위에서 몇 시간 단위로 짧아졌다고 Cerebras는 밝혔습니다.
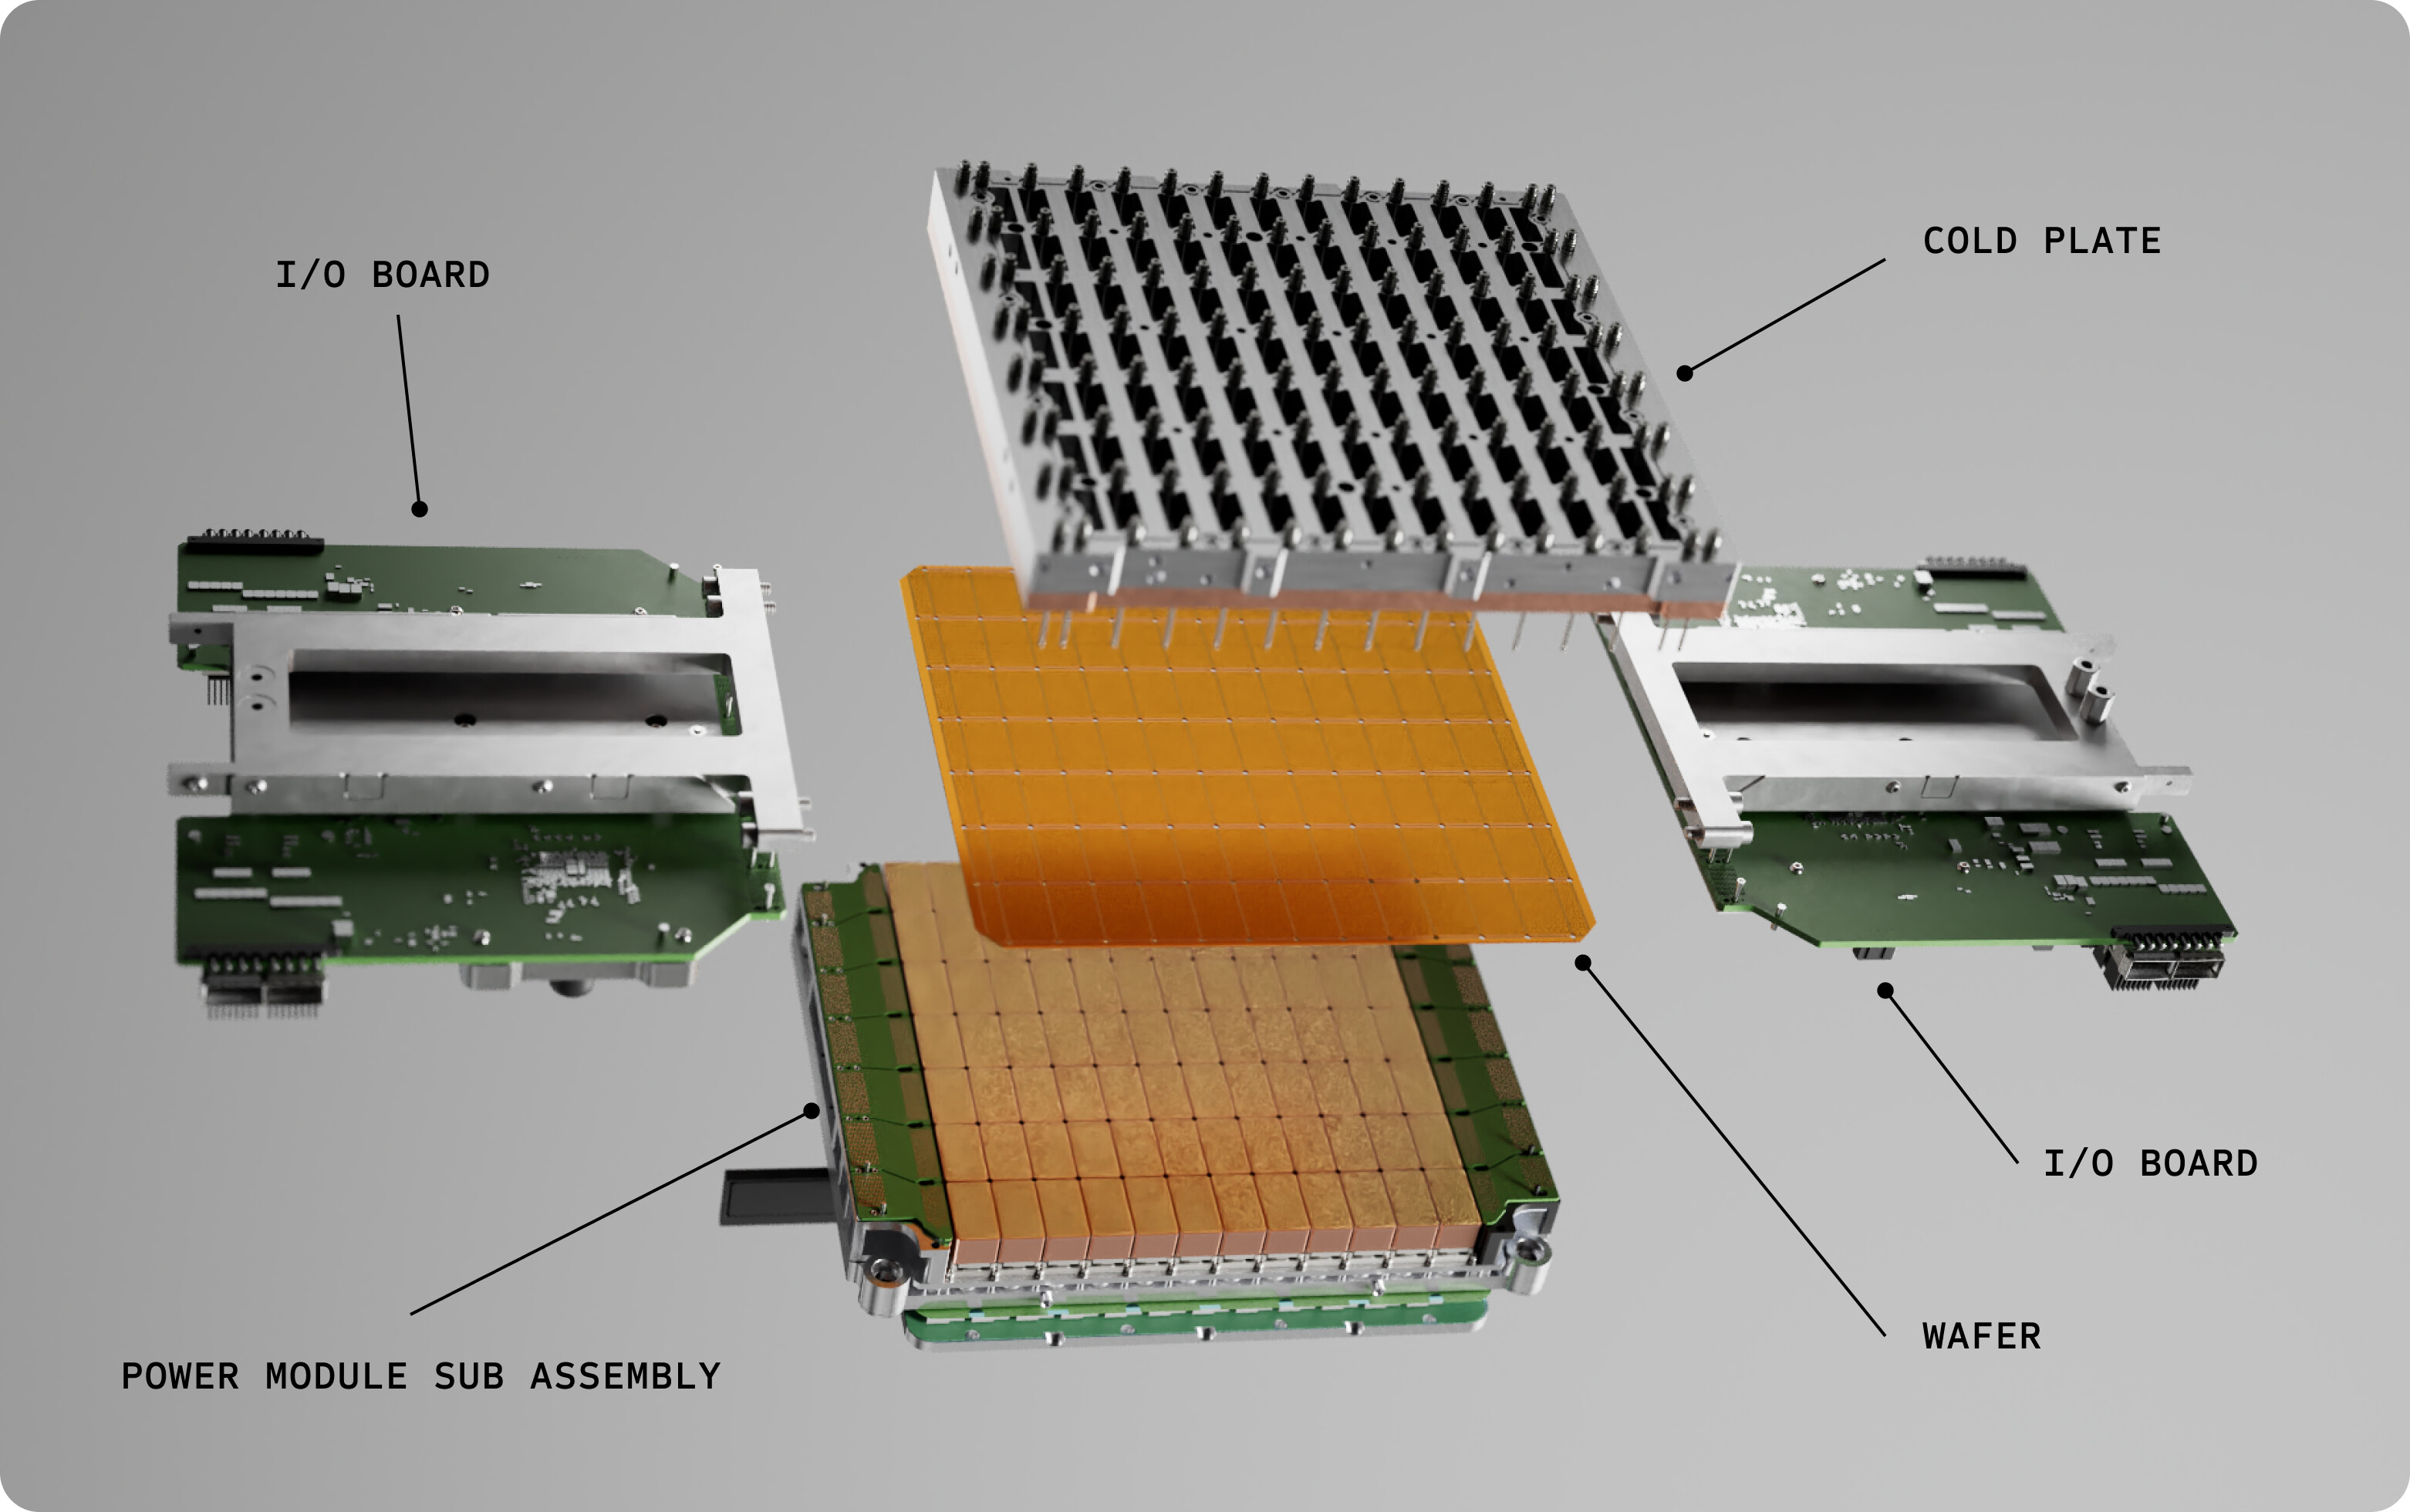
위 분해도는 백팩 하나에 무엇이 들어가는지를 보여줍니다. 가운데 웨이퍼를 기준으로 아래쪽에 전력 모듈 하위 조립체(Power Module Sub Assembly)가 밀착해 있고, 위쪽에 액체 냉각용 콜드 플레이트(Cold Plate)가 얹히며, 좌우 양쪽에 I/O 보드가 결합됩니다. 웨이퍼 한 장을 쓰는 프로세서는 발열과 전력을 면 전체로 처리해야 하므로, 전력과 냉각이 웨이퍼 면에 직접 맞물리는 이런 구조가 필요합니다.
0.5mm까지 끌어온 전력 공급
Nexus에서 성능 수치로 직접 이어지는 부분은 전력 공급 거리입니다. 통상적인 GPU 보드는 전력 변환 회로가 프로세서로부터 약 50mm 떨어져 있는데, CS-4는 이 거리를 약 0.5mm로 줄였습니다. 약 100배 가까워진 셈이고, 그만큼 보드 수준에서 발생하는 전력 손실이 거의 사라집니다. Cerebras는 이렇게 확보한 여유로 WSE-3T에 두 배의 전력을 공급하고, 그 결과 더 높은 동작 주파수와 더 빠른 토큰 생성이 가능해졌다고 설명합니다.
앞서 본 WSE-3 Turbo의 사양표가 이 문장으로 설명됩니다. 트랜지스터도 코어도 공정도 그대로인 프로세서의 연산 성능과 대역폭이 두 배가 된 근거는 새 실리콘이 아니라 전력 전달 경로의 단축입니다. 웨이퍼 한 장이 이미 실리콘 면적의 상한이어서 규모를 더 키울 여지가 없으므로, 성능을 올릴 방향이 전력 밀도와 동작 주파수 쪽에 남아 있다는 사정도 함께 작용합니다.
새 웨이퍼 I/O 모듈과 스위치 없는 Direct Wafer Links
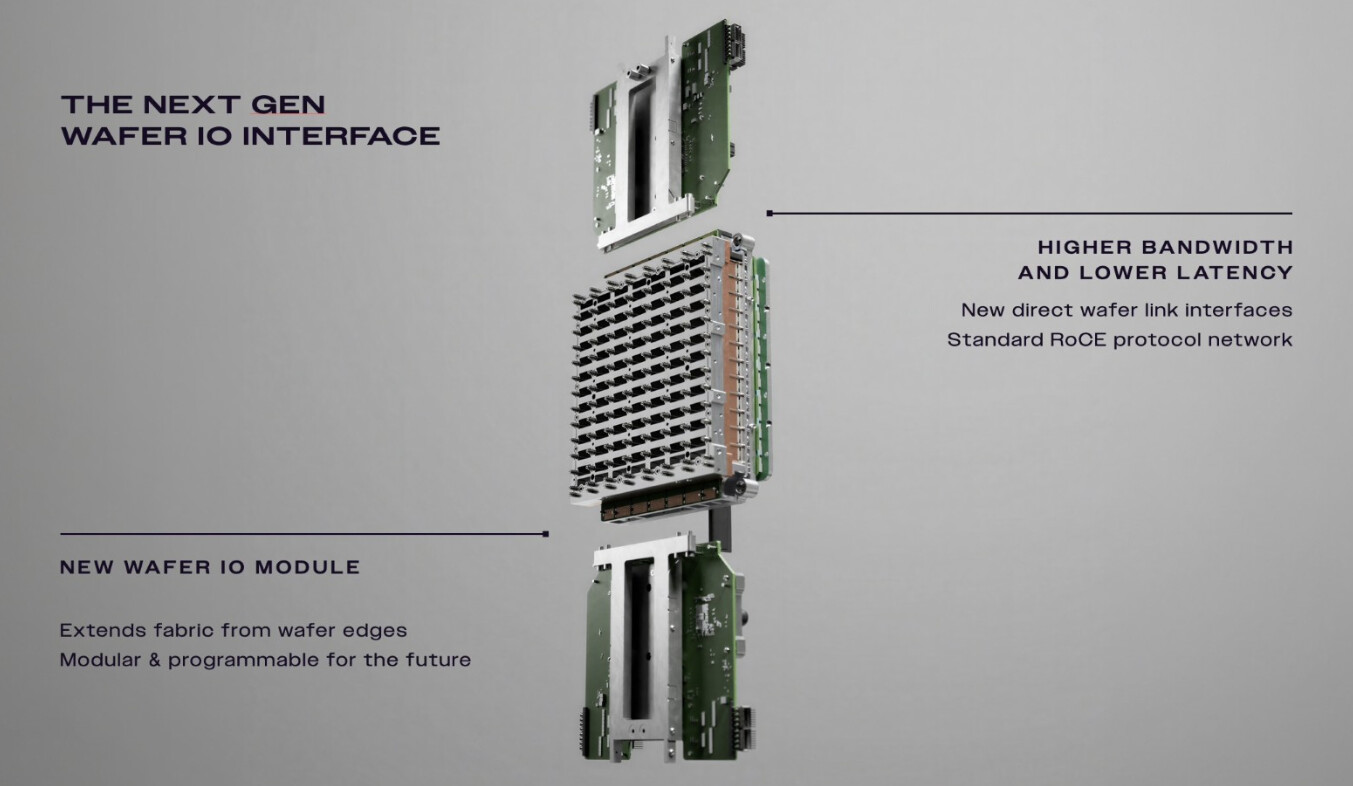
CS-4는 프로그래밍 가능한 I/O 하위 시스템을 새로 도입해 대역폭을 두 배로 늘리고 지연을 줄였습니다. 웨이퍼 I/O 모듈(Wafer I/O Module) 은 웨이퍼 가장자리에서 패브릭을 밖으로 연장하는 부품이고, 두 가지 연결 방식을 지원합니다.
-
RoCE v2 RDMA over Ethernet: 표준 이더넷 위에서 동작하는 RDMA over Converged Ethernet 방식입니다. 기존 데이터센터 네트워크와 이종 시스템 생태계에 그대로 끼워 넣을 수 있는 경로이고, 앞 절의 분리형 추론에서 프리필 엔진과 주고받는 통로가 여기입니다. 웨이퍼당 오프칩 대역폭은 2.4Tbit/s, CS-4 랙 전체로는 7.2Tbit/s입니다.
-
Direct Wafer Links: 랙 안과 랙 사이의 웨이퍼를 스위치를 거치지 않고 직접 잇는 새 통신 방식입니다. 스위치 홉이 빠지면서 웨이퍼 간 지연이 최소 2마이크로초까지 내려가고, 이 값이 앞서 본 10조 파라미터 이상 모델에서 초당 1,000 토큰을 유지한다는 주장의 근거가 됩니다.
따라서 CS-4는 표준 네트워크로 다른 회사 하드웨어와 연결하는 경로와, 전용 링크로 Cerebras 시스템끼리 잇는 경로를 모두 갖게 됩니다.
CS-4와 WSE-3 Turbo 상세 명세
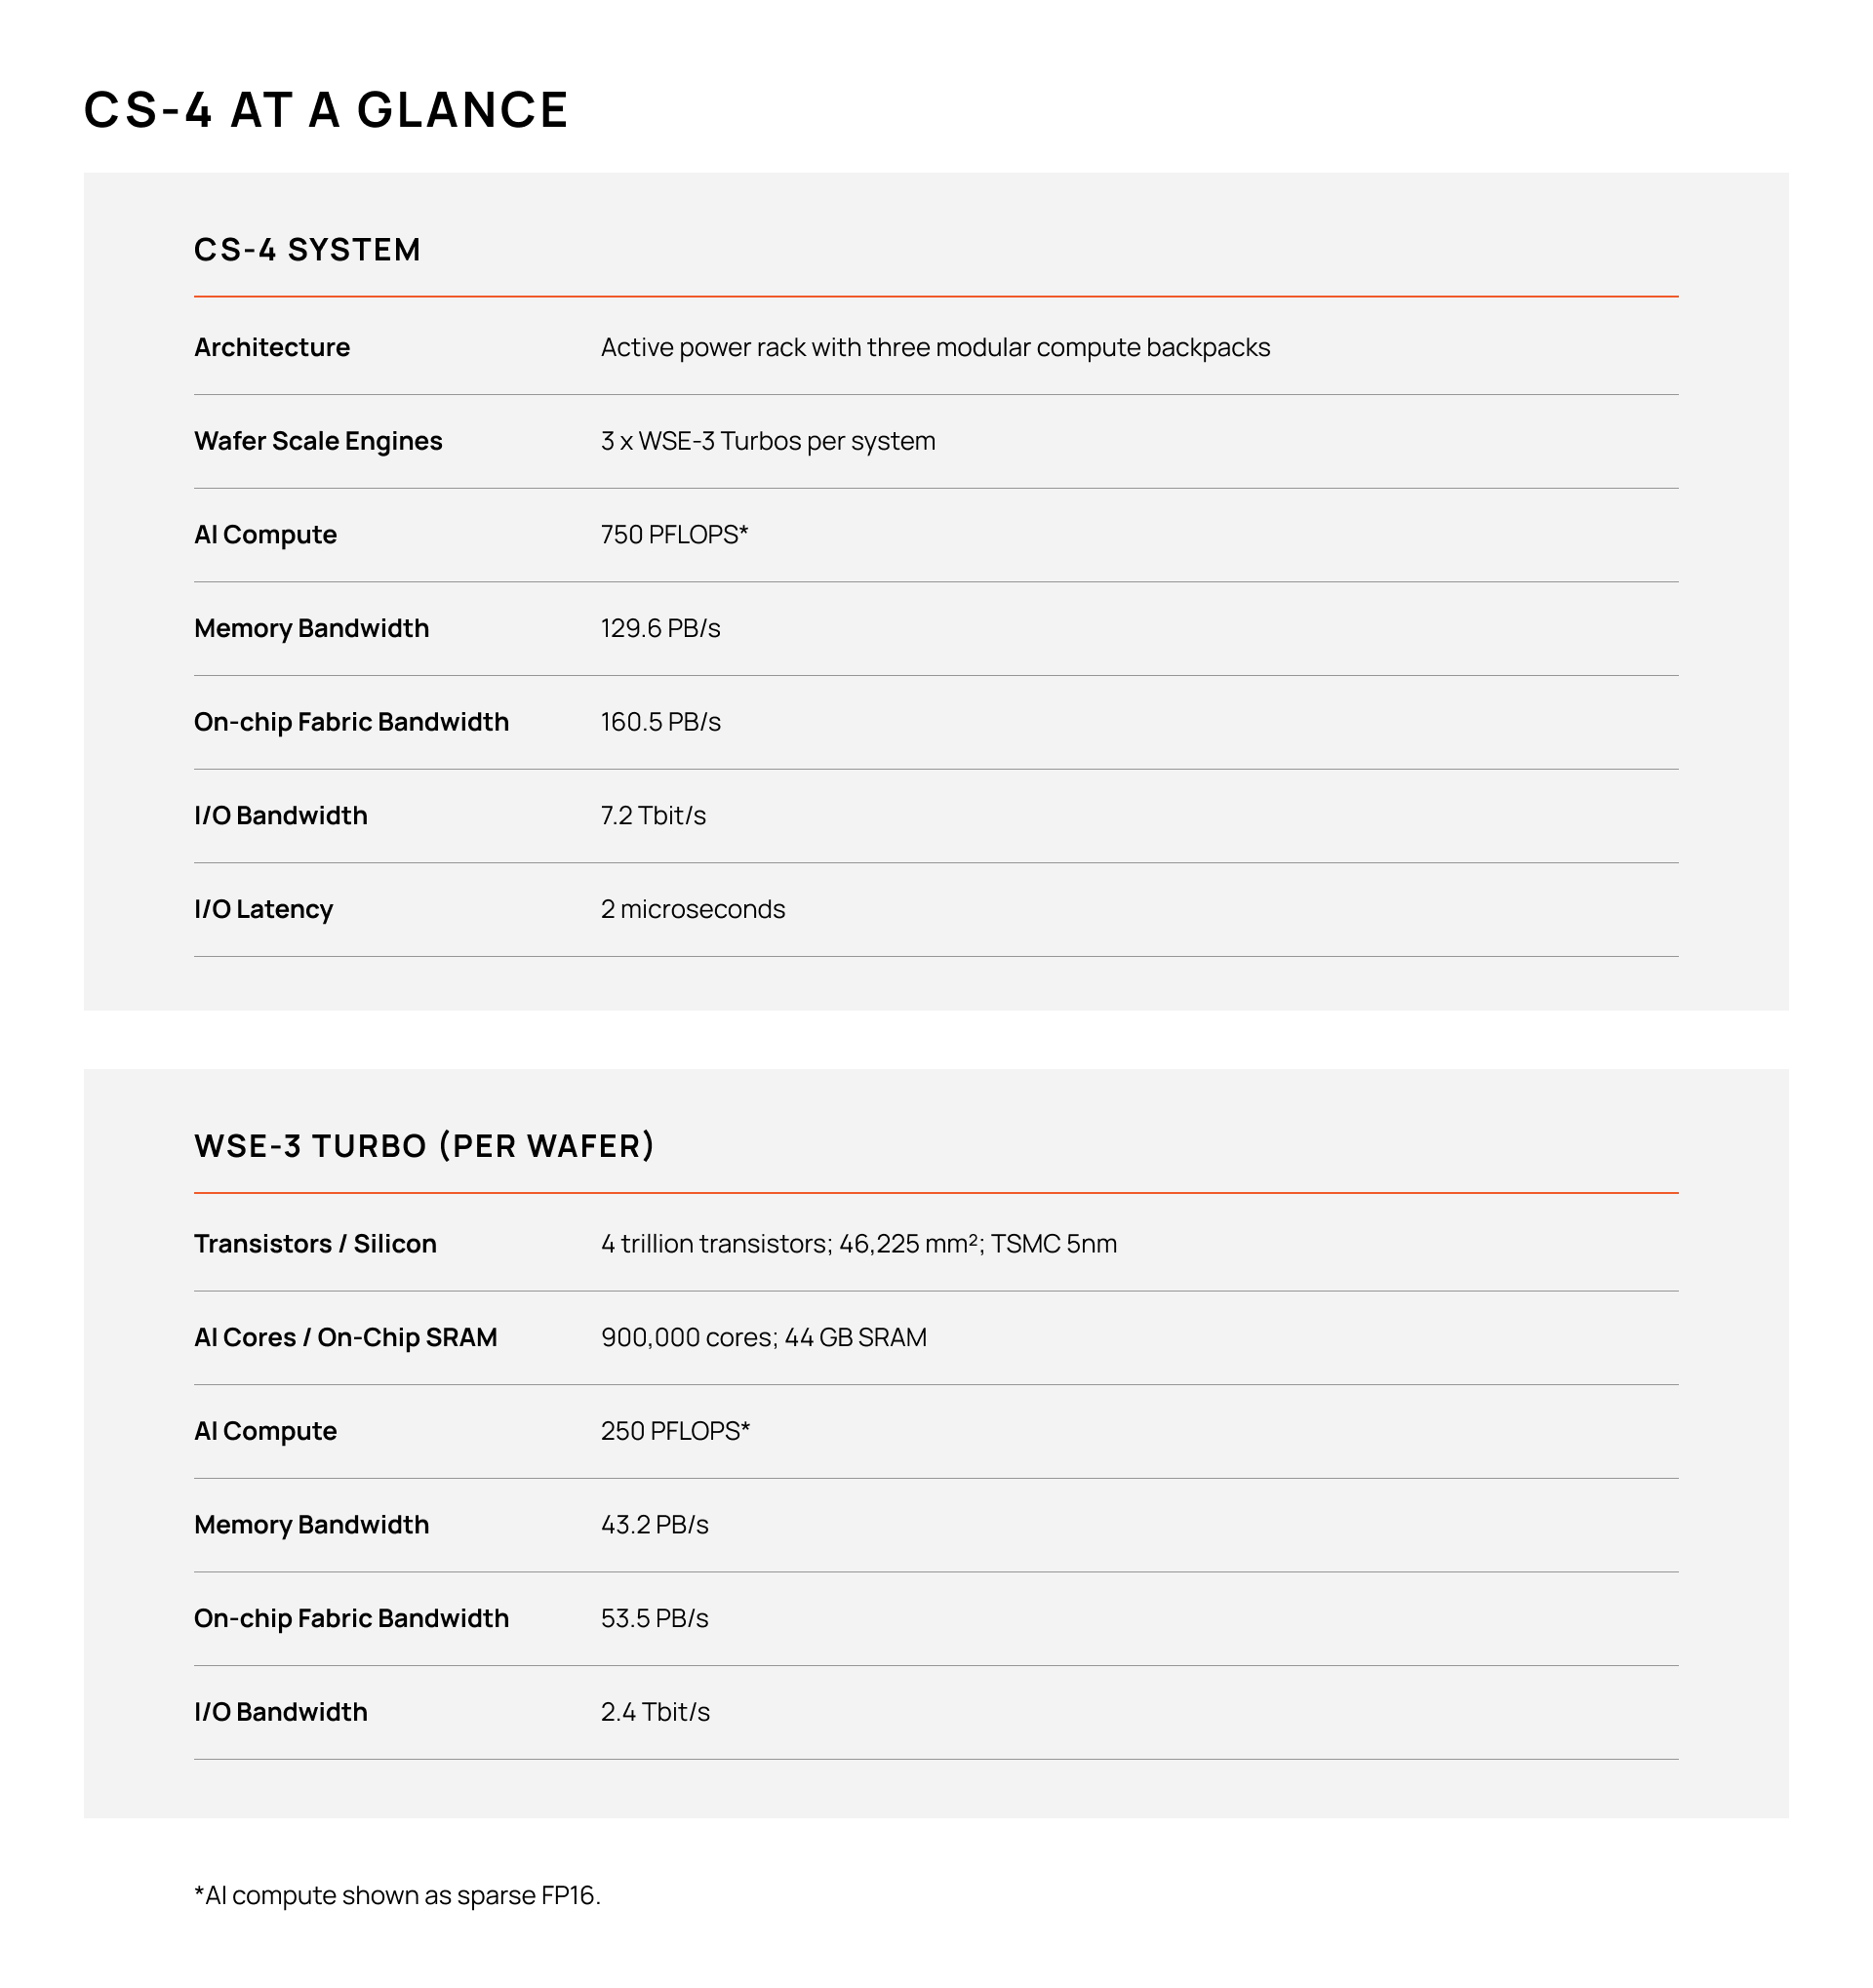
데이터시트가 정리한 전체 사양은 위와 같습니다. 시스템 아키텍처는 "3개의 모듈형 컴퓨트 백팩을 갖춘 액티브 파워 랙"으로 기술되며, 웨이퍼 1장 기준 항목과 시스템 3장 기준 항목이 구분돼 있습니다. 연산 성능 두 항목에는 앞서 언급한 희소 FP16 각주가 달려 있습니다.
사양표에 적히지 않은 것들
발표 자료를 액면대로 읽기 전에 함께 봐야 할 항목이 몇 가지 있습니다.
메모리 용량 항목이 없습니다. 데이터시트는 메모리 대역폭과 온칩 SRAM 용량만 표기합니다. 웨이퍼당 44GB이므로 랙 전체로는 132GB이고, 10조 파라미터 모델의 가중치를 여기에 담을 수는 없습니다. Cerebras가 공개한 웨이퍼 스케일 클러스터 구조는 모델을 한 계층씩 웨이퍼에 올리면서 가중치를 외부 MemoryX 서버에서 흘려 보내는 가중치 스트리밍(Weight Streaming) 방식인데, CS-4 발표 자료와 데이터시트는 추론 시 가중치를 어디에 두고 어떤 대역폭으로 가져오는지를 다루지 않습니다. 대형 모델 서빙에서 실제 성능을 가르는 항목이므로, 이 부분은 추가 공개를 기다려야 합니다.
30배와 10배는 비교 기준이 서로 다릅니다. 30배는 사용자당 초당 토큰, 즉 한 사용자가 체감하는 속도이고 비교 대상은 GPU 시스템입니다. 10배는 와트당 총 처리량이며 비교 대상은 CS-3입니다. 두 숫자를 곱하거나 같은 축에 놓을 수 없습니다.
GPU 기준선이 특정되지 않았습니다. 그래프의 GPU 계열은 모델명이나 구성이 표기되지 않고 범례에 GPU 하나로만 묶여 있습니다. 출처는 Artificial Analysis와 내부 벤치마크(2026년 8월)로 적혀 있는데, Artificial Analysis는 상용 API 제공자의 실측 속도를 집계하는 곳이므로 특정 GPU 하드웨어의 이론 성능이 아니라 서비스 중인 엔드포인트의 속도에 가깝습니다 ( Artificial Analysis가 공개한 코딩 에이전트 벤치마크: 모델 + 하네스의 조합으로 평가한 벤치마크 결과). 자체 벤치마크로 측정한 값이 섞여 있다는 점도 캡션에 표기돼 있습니다.
가격 정보가 없습니다. 보도자료와 제품 페이지 모두 시스템 가격이나 Cerebras Inference 클라우드의 CS-4 기반 요금을 언급하지 않았습니다. 와트당 처리량이 10배라는 주장이 실제 비용 절감으로 이어지는지는 시스템 단가와 랙 소비 전력이 공개된 뒤에 판단할 수 있습니다.
공급 일정과 한국에서의 접점
첫 CS-4 출하는 이번 분기 중에 시작됩니다. Bloomberg의 보도에 따르면 현재는 소수 고객을 대상으로 샘플을 제공하는 단계이고, 더 넓은 공급은 3분기 후반으로 예정돼 있습니다. 발표는 Cerebras가 샌프란시스코에서 개최한 Cerebras Supernova 2026 행사에서 함께 이뤄졌습니다.
Cerebras는 이미 OpenAI 모델의 고속 서빙 파트너로 참여하고 있습니다. 앞선 비교 그래프에 GPT-5.4와 GPT-5.6 Sol이 들어간 것도 실제로 서비스 중인 워크로드이기 때문입니다. OpenAI와의 고속 추론 협력과 GPT-5.6 Sol의 Ultrafast 모드 지원이 그 사례입니다.
한국 개발자 입장에서 직접적인 접점은 Cerebras와 Upstage의 협력입니다. 두 회사는 한국 기업용 실시간 AI 애플리케이션을 대상으로 초당 최대 2,000 토큰 수준의 추론을 제공한다고 밝혔습니다. CS-4가 이 서비스 기반에 반영되는 시점과 조건은 아직 공개되지 않았지만, 국내에서 웨이퍼 스케일 추론을 접할 경로는 이쪽입니다.
 Cerebras CS-4 공식 보도자료
Cerebras CS-4 발표 블로그
 Cerebras CS-4 제품 페이지
 Cerebras CS-4 데이터시트 (영문/PDF/5p)
 Cerebras Supernova 2026 발표 영상
더 읽어보기
-
하루 15,000개 질문에 답하는 Cerebras의 사내 지식 베이스 설계 노하우 (feat. pgvector, RRF, MCP)
-
TokenSpeed: 에이전트형 워크로드를 위한 빠른 LLM 추론 엔진 (feat. Kimi K2.5, NVIDIA Blackwell)
-
뉴로모픽(neuromorphic) 컴퓨팅 선언문: 메모리 물리학이 지배하는 Post-von Neumann 시대현실 문제 제기
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글이 유용하셨다면 아래 쪽 좋아요
 를 눌러주세요 — 파이토치 한국 사용자 모임
 이 새로운 소식을 정리하고 공유하는 데 힘이 됩니다!
