핵심 요약
- 고려대학교 DMIS 연구실이 UltraBERT 논문과 소개 블로그에서 영어 양방향 인코더 UltraBERT-150M, UltraBERT-380M과 임베딩 모델 UltraBERT-Embed-150M을 Apache 2.0으로 공개했습니다. 세 모델 모두 32K 토큰 컨텍스트를 지원합니다.
- 저자들은 인코더 성능이 학습 토큰 수 조(마스킹 비율에 따라 1~3T) 부근에서 포화되고, 분류는 낮은 마스킹 비율에서, 검색은 높은 마스킹 비율에서 좋아진다는 것을 확인했습니다. 그래서 한 배치에 5%와 50% 마스킹 문장을 섞고 비율마다 LM 헤드를 따로 두었습니다.
- 저자들이 같은 조건으로 미세조정해 비교한 10개 벤치마크 중 9개에서 두 크기 모두 1위였고, 380M 모델은 GLUE 91.0, BEIR 47.7을 기록했습니다. 진 항목은 150M의 MultiCoNER v2와 380M의 MLDR입니다.
- 영어 전용 모델이고, 확인 시점(2026년 10월 15일)에 공개된 학습 코드는 임베딩 학습 저장소뿐입니다. 백본 사전학습 코드와 1.3B 교사 모델은 공개 저장소에서 찾지 못했습니다.
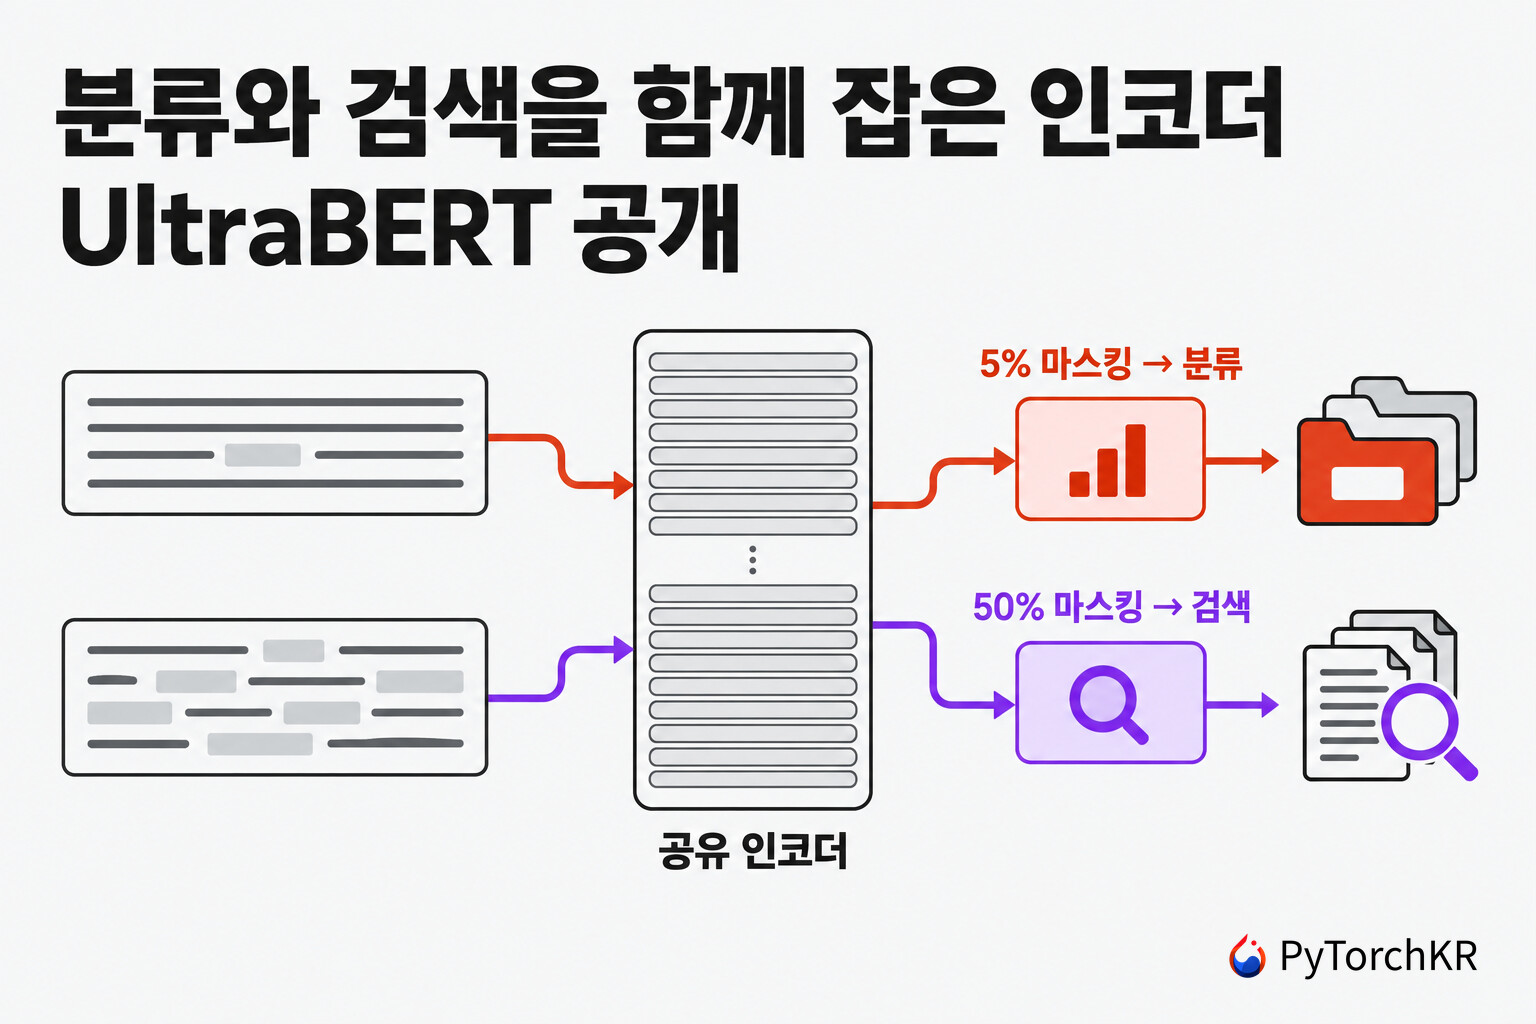
UltraBERT 소개: 분류와 검색 중 하나를 고르지 않아도 되는 인코더
UltraBERT 는 문장을 한 번에 양방향으로 읽어 벡터나 점수를 내는 BERT 계열 인코더입니다. 이 모델의 요점은 같은 크기대 인코더 중에서 분류(classification)와 검색(retrieval) 모두 최상위 점수를 낸다는 것입니다. 지금까지는 두 작업에서 1위 모델이 서로 달랐습니다. GLUE에서는 Ettin Encoder가, BEIR에서는 ModernBERT나 LFM2.5-Encoder가 앞섰습니다.
인코더는 생성 모델이 주목받는 지금도 대량의 텍스트를 싸게 처리하는 기본 도구입니다. RAG 파이프라인은 문서를 인코더로 임베딩하고, FineWeb-Edu 같은 사전학습 데이터셋도 인코더로 품질 점수를 매겨 걸러냈습니다. 인코더는 입력을 한 번 읽고 끝나므로 토큰을 하나씩 생성하는 디코더보다 훨씬 저렴합니다. 원문 블로그는 텍스트 생성 없이 정해진 선택지 중 하나를 고르는 Jev 같은 결정 모델도 이런 인코더의 쓰임새로 듭니다. 실제로 Laya는 ModernBERT-large를 인코더로 써서 Jev 호환 결정을 내립니다.
한편 지난 2년 동안 인코더 구조는 디코더 LLM의 기법(RoPE, SwiGLU, 국소/전역 어텐션 교차)을 받아들이며 빠르게 현대화되었습니다. 그러나 저자들은 학습 방법, 특히 마스크 언어 모델링(Masked Language Modeling, MLM) 의 설정이 여전히 10B~100B 토큰 규모 실험에서 나온 BERT 시대 관행을 따른다고 지적합니다. MLM은 입력 토큰 일부를 가리고 원래 토큰을 맞히게 하는 사전학습 목표입니다. UltraBERT 논문은 이 관행을 수 조(T) 토큰 규모에서 다시 실험하고, 그 결과로 새 학습 방법을 제안합니다.
UltraBERT를 만든 곳은 BioBERT로 알려진 고려대학교 DMIS 연구실입니다. 저자는 Jungwoo Park, Taewhoo Lee, Jaewoo Kang(교신 저자)이며 소속은 고려대학교, AIGEN Sciences, Amazon입니다. Taewhoo Lee의 작업은 Amazon 합류 전에 수행했습니다. 사전학습에는 Google TPU Research Cloud(TRC)의 Cloud TPU를 주로 썼습니다.
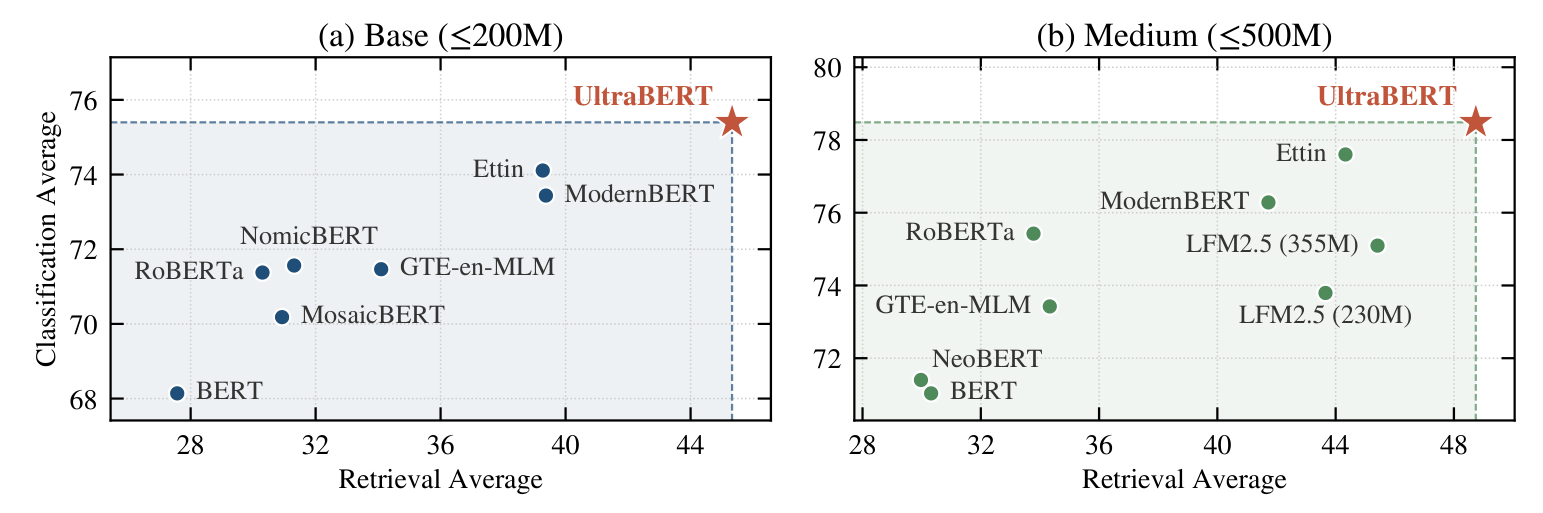
위 그림의 분류 평균은 GLUE, SQuAD 2.0, MultiCoNER v2, Few-NERD, RewardBench 다섯 개의 평균입니다. 검색 평균은 BEIR, RAR-b(Code와 Math 평균), MLDR 세 개의 평균입니다. 즉, 두 축 모두 저자들이 고른 벤치마크 묶음에 대한 평균입니다.
인코더 학습 방법을 다시 실험해 얻은 세 가지 발견
저자들은 150M, 380M, 1.3B 세 크기의 인코더를 같은 데이터 혼합, 같은 토크나이저, 같은 구조(RoPE, SwiGLU, 국소/전역 어텐션 교차)로 학습했습니다. 모든 체크포인트는 같은 방식으로 미세조정(Fine-tuning) 해 평가했습니다. 원문 블로그에 따르면 이 실험에 쓴 학습 토큰은 모두 합쳐 70T가 넘고, 가장 긴 단일 실행은 8.8T 토큰입니다.
발견 1. 디코더는 계속 좋아지지만, 인코더는 수 조 토큰에서 포화된다
디코더 LLM은 학습 토큰을 늘릴수록 계속 좋아진다고 알려져 있습니다. 저자들은 마스킹 비율 30%로 150M과 1.3B 인코더를 8.8T 토큰까지 학습하며 중간 체크포인트를 평가했습니다. 그 결과 GLUE와 SQuAD 2.0은 1~2T 토큰 부근에서 멈췄고, BEIR는 첫 평가 지점인 275B 토큰 이후로 의미 있게 오르지 않았습니다. 반면 학습 손실과 검증 손실은 8.8T까지 계속 내려갔습니다.
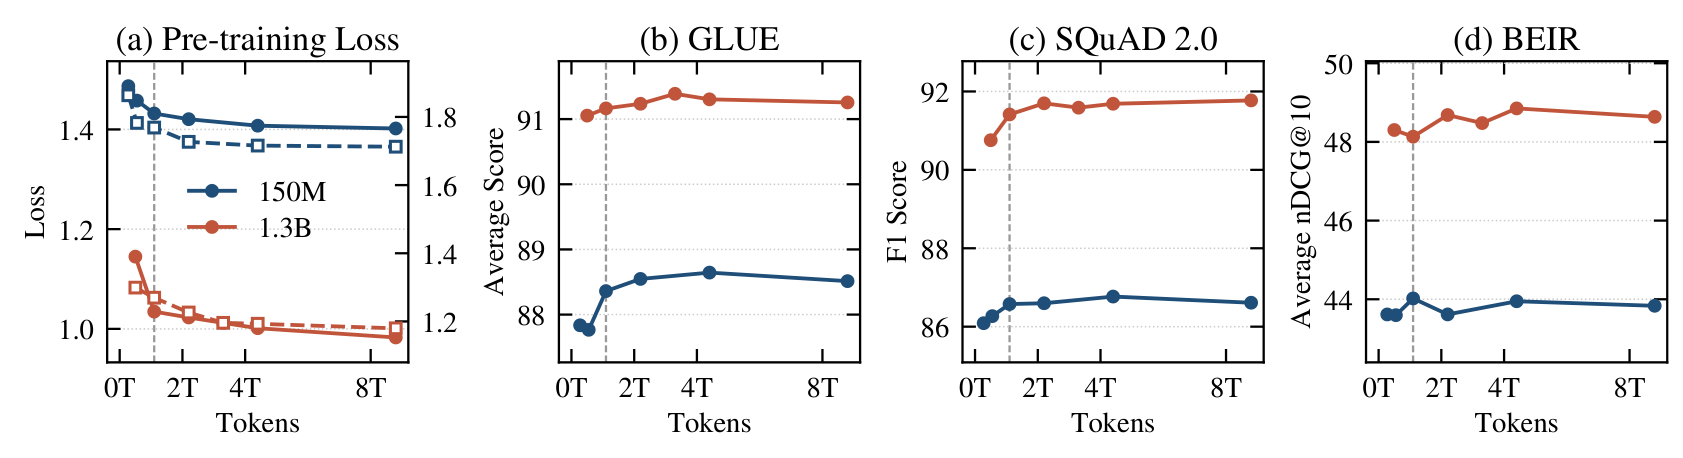
저자들은 이것이 인코더의 고유한 성질인지 확인하려고 비슷한 크기의 디코더 SmolLM2-1.7B와 비교했습니다. ARC, MMLU 등 6개 객관식 질의응답(MCQA) 벤치마크에서 명령어 튜닝을 한 뒤 비교하자, 1.3B 인코더는 다른 작업처럼 평평해졌고 디코더는 계속 올라갔습니다. 저자들은 이를 근거로 "포화 지점을 넘으면 같은 방법으로 토큰을 더 넣어도 얻는 것이 거의 없고, 더 나아지려면 학습 방법 자체를 바꿔야 한다"고 결론 내립니다. 독자 입장에서 이 발견은 인코더 사전학습 예산을 정할 때 쓸 수 있는 기준입니다. 다만 포화 시점은 마스킹 비율에 따라 다릅니다. 저자들은 15%에서 1~2T, 6%와 3%에서 2~3T 토큰 부근에서 포화를 관찰했습니다.
발견 2. 분류는 낮은 마스킹 비율을, 검색은 높은 마스킹 비율을 원한다
마스킹 비율(masking ratio) 은 MLM에서 가리는 토큰의 비율입니다. BERT는 15%를 썼고, 이후 Should You Mask 15% in Masked Language Modeling? 같은 연구들은 큰 모델일수록 더 높은 비율이 낫다고 보고했습니다. 저자들은 이 연구들이 10B~100B 토큰 예산에서 진행되었다고 지적합니다. 그 규모에서는 높은 비율의 이점이 주로 빠른 수렴이었고, 최종 성능과 수렴 속도가 섞여 있었다는 것입니다.
그래서 저자들은 마스킹 비율마다 포화될 만큼 토큰을 배정했습니다(50%와 30%는 1T, 15%는 2T, 6%와 3%는 5T). 그러자 분류 성능은 모든 모델 크기에서 마스킹 비율이 높을수록 일관되게 떨어졌습니다. 즉, 큰 모델에 높은 비율이 맞다는 기존 결론과 반대입니다.
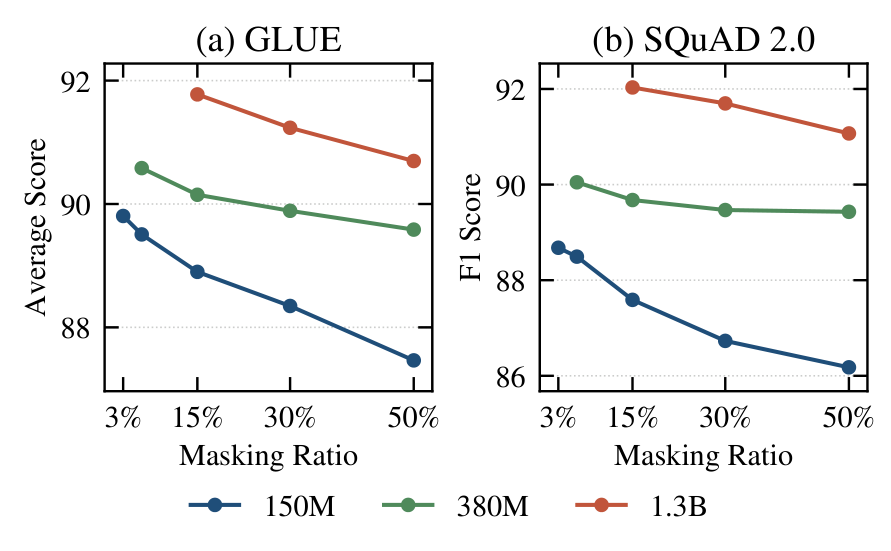
검색은 반대였습니다. 모든 크기에서 50% 마스킹이 가장 높은 BEIR 점수를 냈습니다. 저자들은 표현 공간도 살펴봤습니다. 유효 랭크(effective rank) 는 표현 벡터가 실제로 몇 개 차원을 쓰는지 나타내는 값입니다. 150M 모델에서 이 값은 마스킹 비율이 높을수록 커지는 경향을 보였습니다(상관계수 0.91). 다만 저자들은 유효 랭크 증가가 검색 성능 향상의 원인인지는 알 수 없다고 밝힙니다.
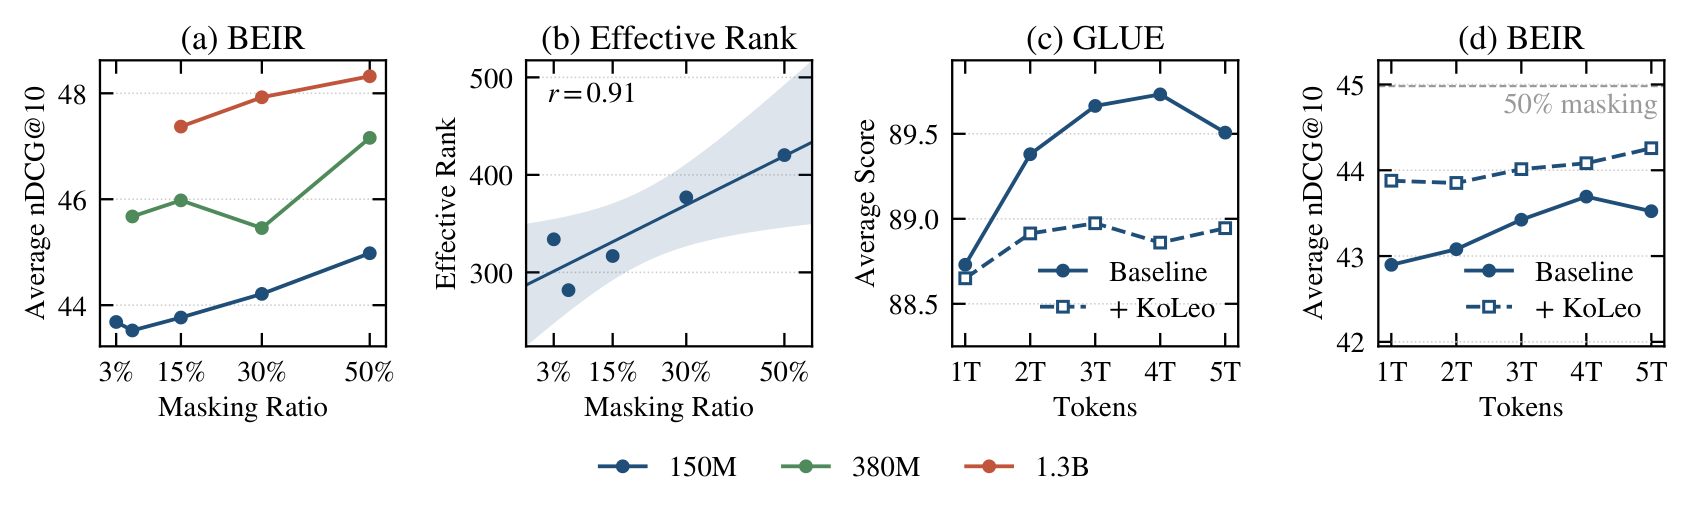
저자들은 낮은 마스킹을 유지하면서 유효 랭크만 올리면 두 마리 토끼를 잡을 수 있는지도 시험했습니다. 6% 마스킹에 벡터를 고르게 퍼뜨리는 KoLeo 정규화를 더하자 BEIR는 조금 올랐지만 50% 마스킹에는 못 미쳤고, GLUE는 떨어졌습니다. 결국 하나의 마스킹 비율로는 두 작업을 모두 만족시킬 수 없다는 것이 이 절의 결론입니다.
원문은 여기에 ELECTRA 계열의 교체 토큰 탐지(Replaced Token Detection, RTD) 분석을 덧붙입니다. RTD는 작은 생성기가 바꿔 넣은 토큰이 원래 토큰인지 판별하는 사전학습 목표로, 분류에 강하고 검색에 약하다고 알려져 있습니다. 같은 오염 비율에서 비교하자 RTD의 이득은 15% 부근에서 가장 컸고 3%와 50% 쪽으로 갈수록 줄었습니다. 저자들은 이를 근거로, 분류에 낮은 비율을 쓴다면 MLM을 유지해도 분류 품질을 잃지 않고 RTD의 검색 손해도 피할 수 있다고 설명합니다.
발견 3. 증류는 낮은 마스킹 비율에서만 도움이 된다
큰 모델을 가지치기(pruning) 해서 작은 모델의 초기값으로 쓰고, 큰 모델의 출력을 따라 배우게 하는 지식 증류(Knowledge Distillation) 는 인코더와 디코더 모두에서 흔히 쓰는 방법입니다. 저자들은 1.3B 인코더를 380M으로 가지치기한 뒤 증류한 모델과, 380M을 처음부터 학습한 모델을 비교했습니다.
| 설정 | 모델 | GLUE | BEIR |
|---|---|---|---|
| 15% 마스킹 | 1.3B (교사) | 91.8 | 47.4 |
| 15% 마스킹 | 380M (처음부터 학습) | 90.2 | 46.0 |
| 15% 마스킹 | 380M (증류) | 90.8 | 46.0 |
| 50% 마스킹 | 1.3B (교사) | 90.7 | 48.3 |
| 50% 마스킹 | 380M (처음부터 학습) | 89.6 | 47.2 |
| 50% 마스킹 | 380M (증류) | 89.6 | 46.5 |
15% 마스킹에서는 증류가 GLUE를 90.2에서 90.8로 올렸습니다. 50% 마스킹에서는 오히려 BEIR가 47.2에서 46.5로 떨어졌습니다. 저자들은 입력의 절반이 가려지면 교사의 예측이 일반 MLM 이상의 정보를 주지 못하기 때문일 수 있다고 추정하지만, 원인은 확인하지 않았다고 밝힙니다. 이 결과로 정한 규칙은 간단합니다. 낮은 비율에서만 증류하고, 높은 비율은 일반 MLM으로 학습합니다.
UltraBERT 학습 방법: 두 마스킹 비율을 한 배치에 섞고 LM 헤드를 나누기
분류는 5%를, 검색은 50%를 원한다면 둘 다 학습하면 됩니다. 저자들은 먼저 단순한 방법들을 시도했습니다. 첫 번째는 비율을 50%에서 6%로 서서히 낮추는 방법입니다. 이 방법은 6% 단일 비율의 분류 품질을 되찾지 못했습니다(GLUE 88.8 대 89.5). 배치마다 5%~50% 사이에서 비율을 무작위로 뽑는 방법은 평균에 가까운 30% 단일 비율과 거의 같게 동작했습니다.
5%와 50% 문장을 한 배치에 섞는 방법이 가장 가까웠습니다. 저자들은 두 비율로 학습한 모델 내부를 들여다봤고, 입력 임베딩은 거의 같은데 출력층인 LM 헤드 는 모양이 크게 다르다는 것을 발견했습니다. 인코더가 받는 모든 그래디언트는 이 헤드를 거쳐 돌아오므로, 헤드를 공유하면 두 비율이 서로를 방해한다는 것이 저자들의 추정입니다. 그래서 비율마다 헤드를 따로 두었고, 이를 LM 헤드 분리(LM head decoupling) 라고 부릅니다.
| 마스킹 전략 (150M) | GLUE | BEIR |
|---|---|---|
| 단일 비율 6% | 89.5 | 43.5 |
| 단일 비율 50% | 87.5 | 45.0 |
| 무작위 5%~50% | 88.0 | 44.2 |
| 5% + 50% 혼합, 공유 헤드 | 88.9 | 44.7 |
| 5% + 50% 혼합, 분리 헤드 | 89.4 | 45.1 |
위 표에서 2가지를 알 수 있습니다. 첫째, 분리 헤드의 GLUE는 최고 단일 비율(6%)보다 0.1점 낮습니다. 반면 BEIR는 최고 단일 비율(50%)보다 0.1점 높습니다. 둘째, 헤드를 공유하면 BEIR는 44.7까지 오르지만 GLUE가 88.9에 머뭅니다. 이 차이들은 모두 0.5점 이하이고, 원문은 사전학습을 몇 번 반복했는지 밝히지 않았습니다.
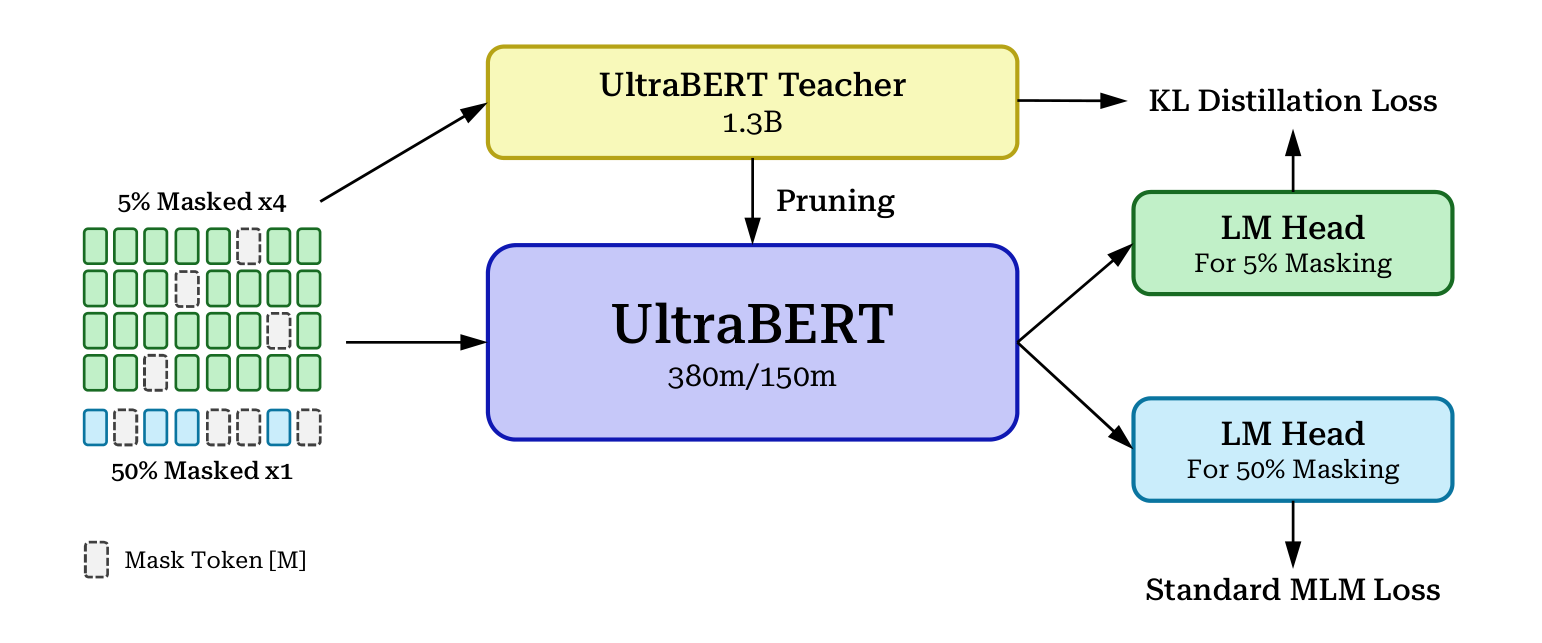
최종 학습 절차는 위 그림과 같습니다.
- 배치 구성: 5% 마스킹 문장과 50% 마스킹 문장을 4:1로 섞습니다. 5%는 그래디언트 신호가 드물고 수렴이 느려서 더 많이 넣습니다.
- 손실: 5% 헤드는 1.3B 교사의 로짓과의 KL 발산(Kullback-Leibler divergence)으로 학습하고, 50% 헤드는 일반 MLM 손실로 학습합니다.
- 가지치기와 증류: 가장 좋은 1.3B 인코더를 380M으로 가지치기해 증류하고, 증류된 380M을 다시 150M으로 가지치기해 증류합니다. 두 학생 모두 중간 단계인 380M이 아니라 1.3B 교사에게서 직접 배웁니다. 이 방식은 NVIDIA의 Minitron 연구와 Ministral 3의 Cascade Distillation을 따른 것입니다. 층 수는 24층으로 고정하고 폭만 줄였습니다.
- 학습 규모: 총 2T 토큰을 학습했고, 마지막 100B 토큰에서 컨텍스트를 32K로 늘렸습니다. 배치는 400만 토큰, 최대 학습률은 1e-4입니다. 각 모델은 TPU v4-512, v5e-256, v6e-256 중 한 슬라이스(모두 256칩)에서 학습했습니다.
- 데이터: 웹(DCLM, FineWeb-Edu) 66.9%, 코드(Stack-Edu) 14.0%, 학술 논문(peS2o) 7.1%, 수학 5.8%, 참고 자료(Cosmopedia v2, Wikipedia) 3.7%, 명령어 데이터(FLAN 등) 2.5%를 한 번 정한 비율로 끝까지 썼습니다. 저자들에 따르면 2.5%의 명령어 데이터 덕분에 기본 모델도 마스크 토큰 하나로 객관식 질문에 영샷(zero-shot)으로 답합니다. 저자들은 단계마다 데이터 비율을 바꾸는 방식도 예비 실험했지만, 미세조정 성능은 거의 달라지지 않았다고 보고합니다.
공개된 모델의 구조도 모델 카드에 정리되어 있습니다. 두 모델 모두 24층, 헤드 차원 128, 어휘 49,152개(SmolLM2 토크나이저)입니다. 세 층 중 한 층만 전체 시퀀스를 보고, 나머지 두 층은 좌우 128토큰만 보는 국소 어텐션을 씁니다. 은닉 크기는 150M이 768, 380M이 1,024입니다.
성능: 같은 미세조정 조건에서 다른 인코더와 비교한 결과
저자들은 각 인코더를 과제마다 같은 격자 탐색(grid search)으로 미세조정해 비교했습니다. 검색 점수도 각 백본을 MS MARCO(긴 문서는 MLDR)로 같은 방식으로 미세조정해 측정했습니다. 따라서 이 값은 완성된 임베딩 모델의 점수가 아니라, 백본을 검색 모델로 학습했을 때 도달할 수 있는 수준을 나타냅니다. 아래 표는 원문 표 3에서 주요 행과 열을 골라 옮긴 것입니다.
| 크기 | 모델 | GLUE | SQuAD 2.0 | MultiCoNER v2 | RewardBench | BEIR | RAR-b Code | RAR-b Math | MLDR | LongEmbed |
|---|---|---|---|---|---|---|---|---|---|---|
| 200M 이하 | ModernBERT (149M) | 88.4 | 86.7 | 57.4 | 68.0 | 42.6 | 29.6 | 46.1 | 37.7 | 63.2 |
| 200M 이하 | Ettin Encoder (149M) | 88.9 | 87.4 | 57.4 | 70.3 | 42.4 | 31.8 | 47.1 | 35.9 | 60.1 |
| 200M 이하 | NomicBERT (137M) | 84.0 | 82.7 | 60.1 | 64.1 | 42.0 | 13.8 | 30.2 | 29.9 | 45.0 |
| 200M 이하 | UltraBERT (152M) | 89.5 | 89.2 | 57.9 | 73.0 | 45.2 | 39.1 | 55.4 | 43.5 | 72.0 |
| 500M 이하 | ModernBERT (395M) | 90.4 | 89.8 | 60.9 | 72.8 | 45.2 | 34.0 | 46.1 | 39.9 | 63.5 |
| 500M 이하 | Ettin Encoder (395M) | 90.8 | 90.4 | 62.3 | 76.7 | 45.9 | 38.5 | 54.0 | 40.9 | 64.3 |
| 500M 이하 | LFM2.5-Encoder (355M) | 89.2 | 87.2 | 62.7 | 68.5 | 47.3 | 38.6 | 50.2 | 44.5 | 71.7 |
| 500M 이하 | UltraBERT (380M) | 91.0 | 90.9 | 63.5 | 78.8 | 47.7 | 47.0 | 61.7 | 44.1 | 74.9 |
차이가 가장 큰 곳은 코드와 수학 문제를 검색 문제로 바꾼 RAR-b입니다. 2위와 비교해 150M에서 Code 7.3점, Math 8.3점, 380M에서 Code 8.4점, Math 7.7점 앞섰습니다. 저자들은 UltraBERT-150M이 분류에서 2.3배 큰 RoBERTa-large와 비슷하고, 검색에서 2.6배 큰 Ettin-400M을 앞선다고 정리합니다.
반면 GLUE와 BEIR의 1위 차이는 작습니다. 380M의 GLUE는 Ettin Encoder보다 0.2점, BEIR는 LFM2.5-Encoder-355M보다 0.4점 높습니다. 세부 표를 보면 진 칸도 있습니다.
- GLUE 세부 과제: 150M은 QQP와 CoLA에서, 380M은 QQP, SST-2, MRPC, CoLA에서 1위가 아닙니다. 저자들은 CoLA를 뺀 나머지는 1위와 1점 이내라고 밝힙니다.
- BEIR 세부 데이터셋: 380M에서는 LFM2.5-Encoder-355M이 NFCorpus, SciFact, TREC-COVID, CQADupstack 4개 데이터셋에서 앞섭니다.
- LongEmbed 세부 과제: 380M에서는 LFM2.5-Encoder-230M이 Needle(78.2 대 68.2)과 2WikiMultihopQA에서 앞섭니다.
비교 수치의 출처도 확인할 필요가 있습니다. GLUE 점수는 대부분 각 모델의 원 논문에서 가져왔습니다. SQuAD 2.0(일부 제외), 개체명 인식(Named Entity Recognition, NER) 벤치마크, RewardBench, 모든 검색 벤치마크는 저자들이 직접 미세조정해 측정했습니다. 저자들은 자신들의 GLUE 절차로 Ettin Encoder를 다시 평가해 보고된 점수와 0.2점 이내로 맞는다는 것을 보였습니다. 그러나 나머지 직접 측정 수치는 제3자가 재현한 결과가 아닙니다. 또한 원문 표 2의 1.3B 교사는 GLUE 91.8(15% 마스킹), BEIR 48.3(50% 마스킹)으로 공개된 380M보다 높지만, 이 교사 모델은 공개 컬렉션에 없습니다.
분류에 많이 쓰이는 RTD 계열의 DeBERTaV3는 검색 성능이 크게 낮다는 이유로 위 표에서 빠졌습니다. 부록에서 저자들은 그림 1과 같은 평균으로 DeBERTaV3-large를 분류 78.1, 검색 25.8로 보고합니다. UltraBERT-380M(78.5, 48.7)과 분류는 비슷하지만 검색은 22.9점 낮습니다.
32K 컨텍스트 전 구간에서 유지되는 passkey 검색
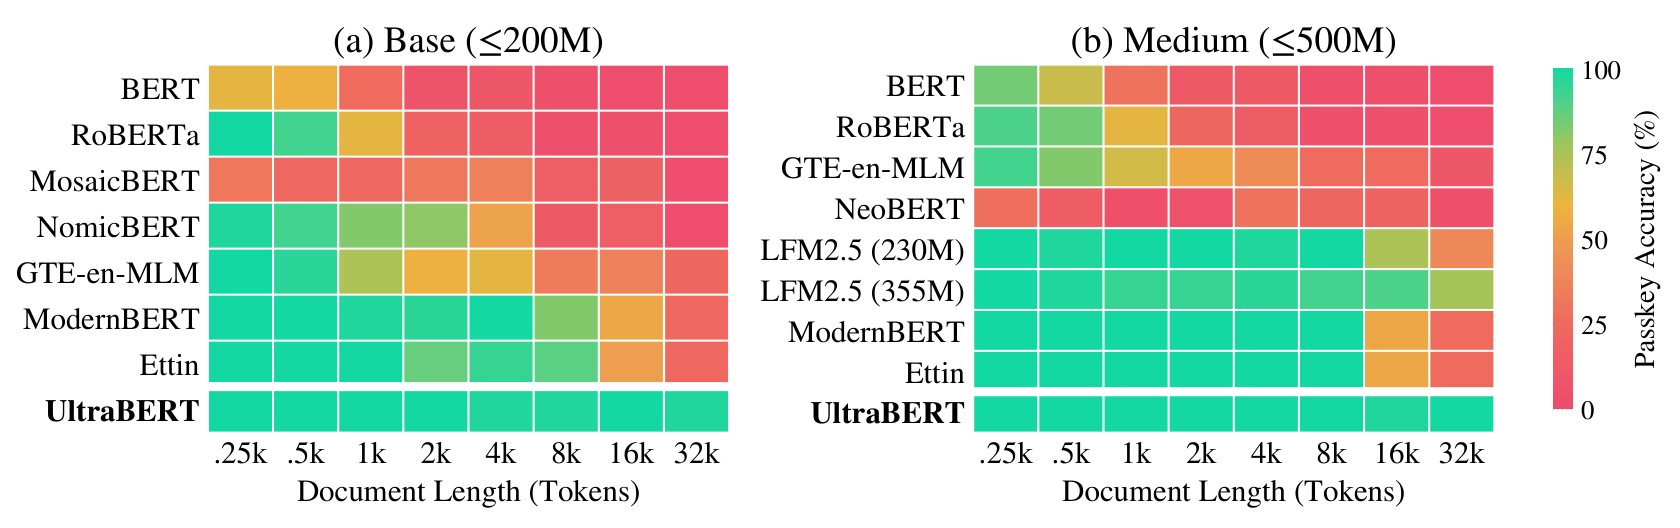
LongEmbed의 passkey 과제는 긴 문서 속 숨은 암호를 찾게 해서 컨텍스트 창 중 실제로 쓸 수 있는 길이를 잽니다. 512토큰 모델은 1K를 넘으면 실패하고, 8K 모델(ModernBERT, Ettin Encoder)은 16K와 32K에서 크게 떨어집니다. LFM2.5-Encoder는 완만하게 떨어지지만 32K에서 90% 아래로 내려갑니다. UltraBERT는 두 크기 모두 32K까지 모든 길이에서 99% 정확도를 유지했습니다. 원문 블로그는 분류나 결정 작업도 문서나 대화 전체를 한 번에 판단해야 할 때가 많다는 점에서 긴 입력이 검색 밖에서도 쓸모 있다고 설명합니다.
저자 외 사용자의 첫 비교: Tom Aarsen의 소규모 미세조정 실험
블로그 댓글에는 Sentence Transformers를 관리하는 Tom Aarsen의 비교 결과가 있습니다. 그는 MS MARCO 삼중항 32,768개로 ModernBERT, Ettin, UltraBERT를 같은 조건(학습률 3개, 최대 1에폭)으로 미세조정했습니다. 그 결과 밀집(dense) 임베딩, 멀티 벡터, 재순위화(reranker) 세 방식, 두 크기 모두에서 UltraBERT의 평균 nDCG@10이 가장 높았습니다. 예를 들어 150M 밀집 임베딩에서는 UltraBERT가 0.587, Ettin이 0.507, ModernBERT가 0.502였습니다.
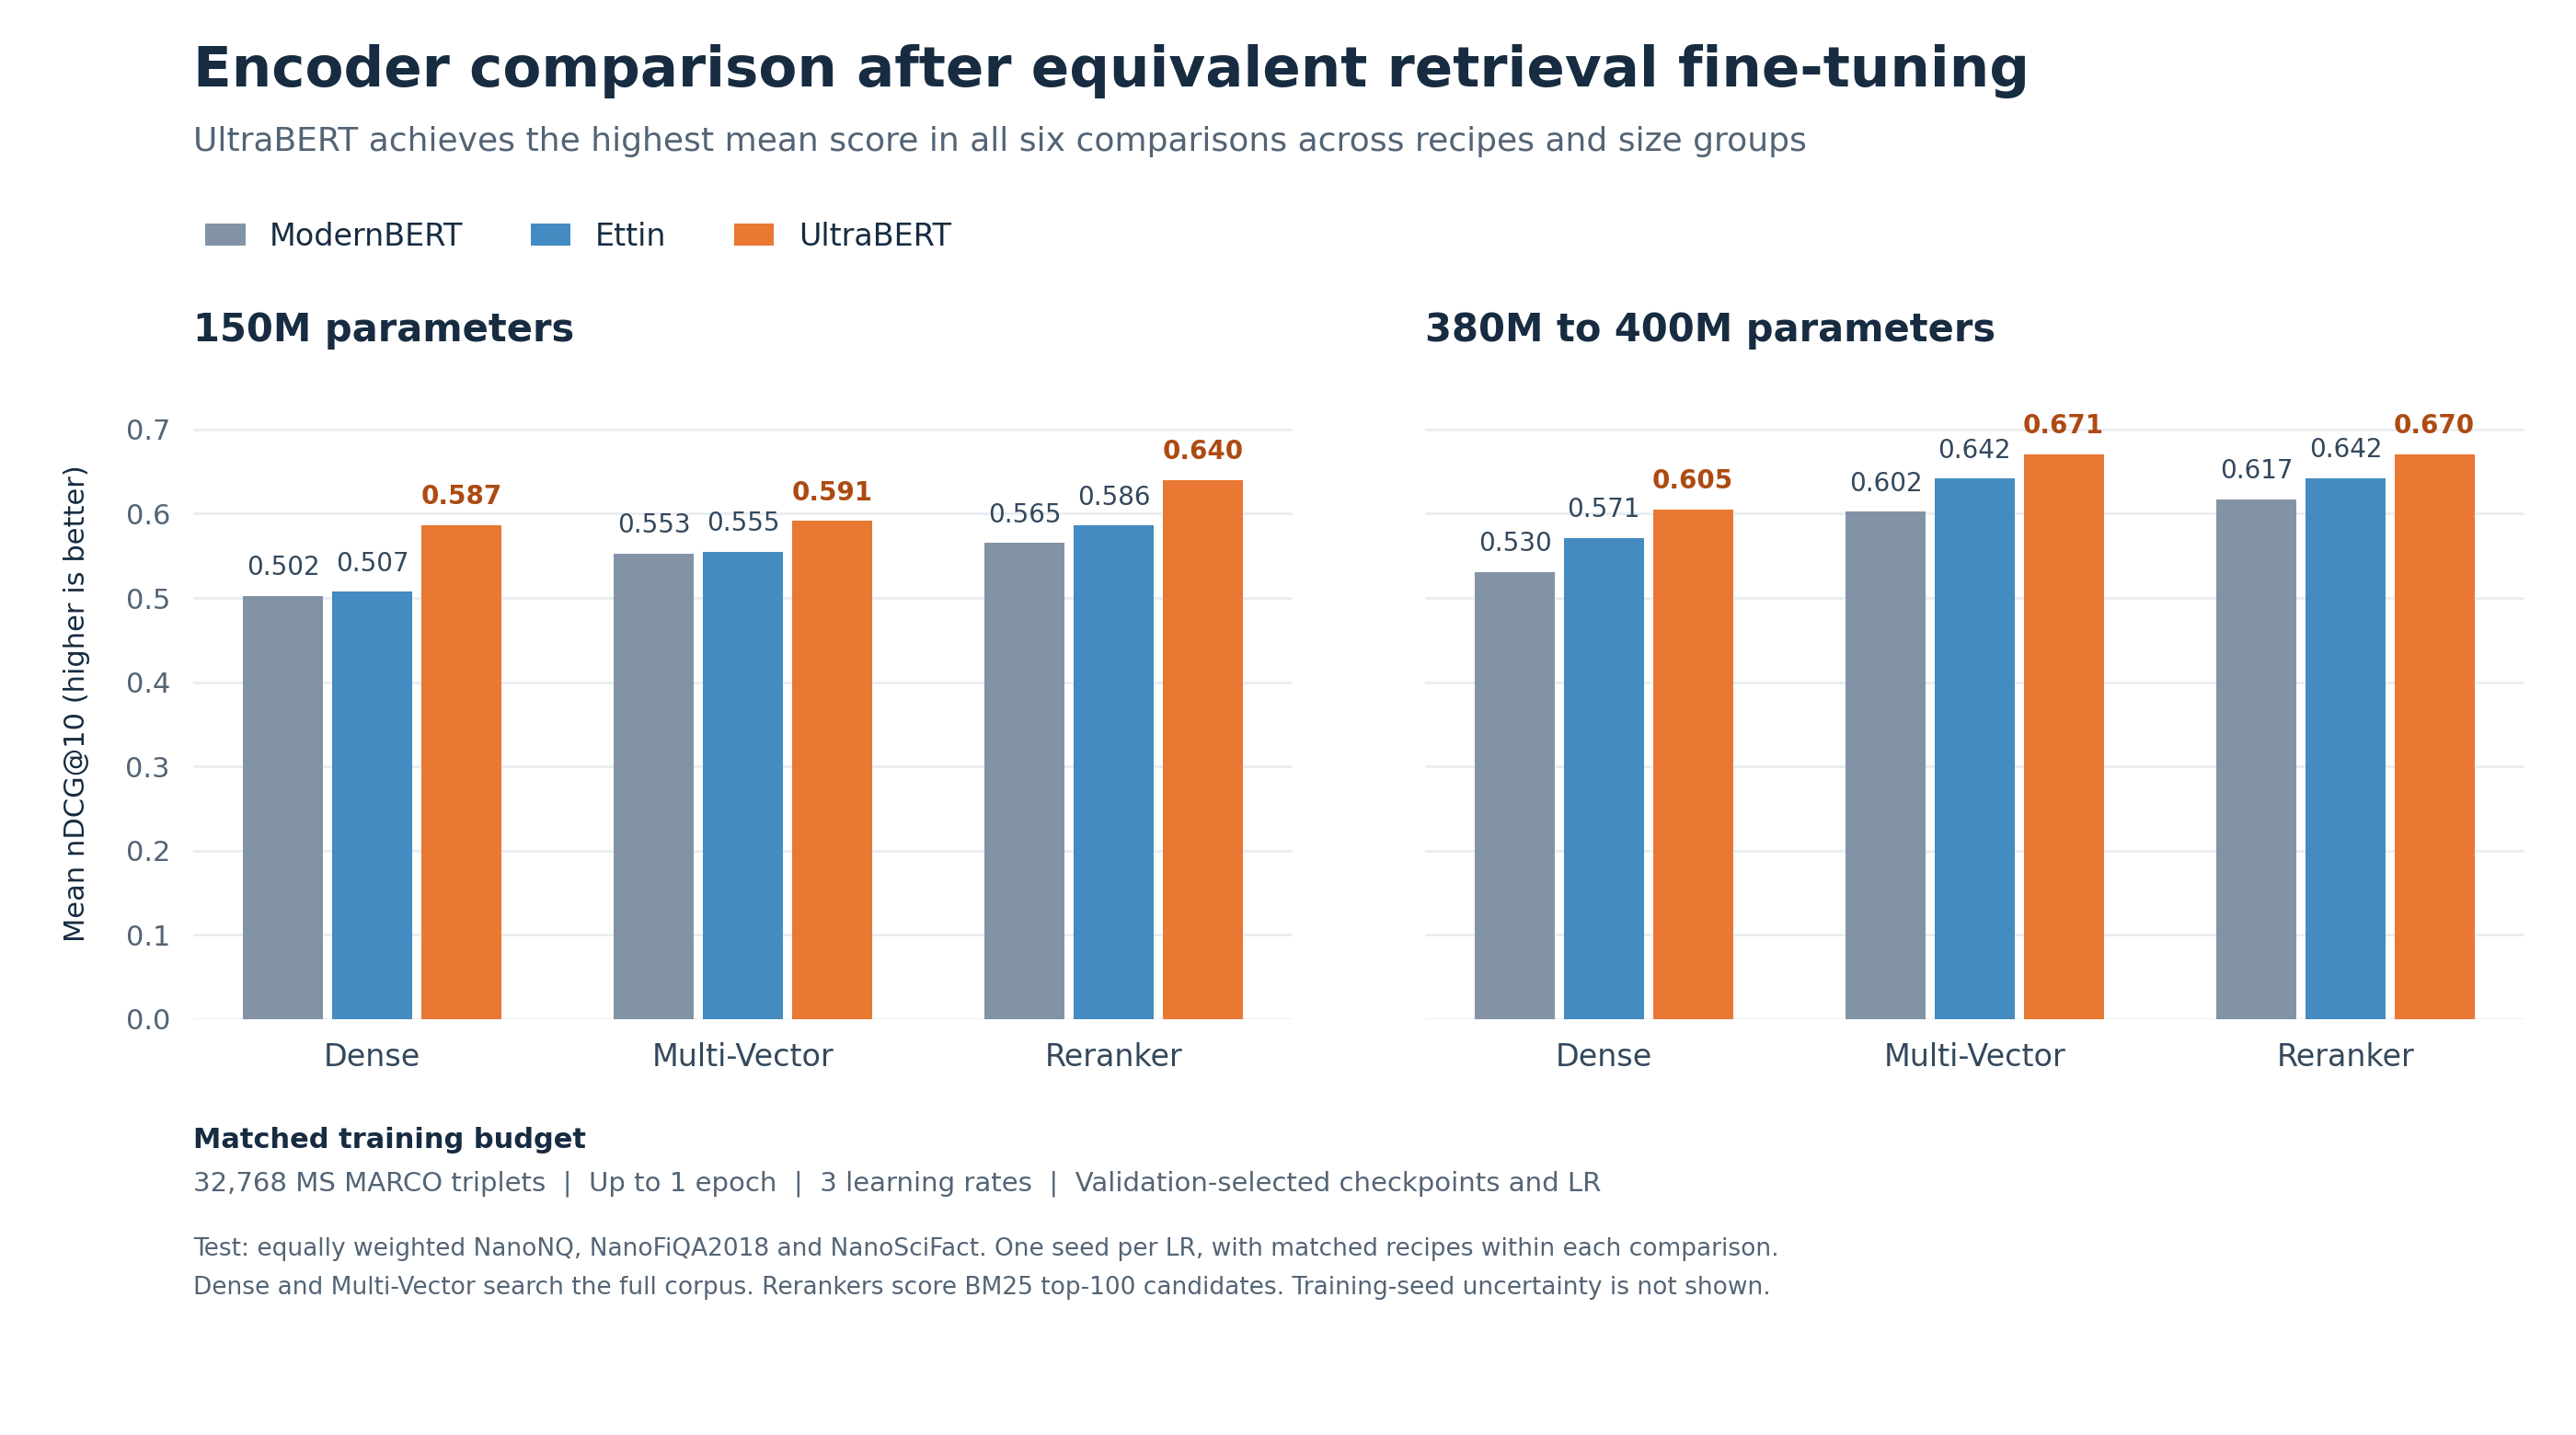
이 실험은 규모가 작습니다. 평가 데이터는 NanoNQ, NanoFiQA2018, NanoSciFact 세 개이고, 학습률마다 시드 하나로 돌렸으며 시드 간 편차는 표시하지 않았습니다. Tom Aarsen도 "더 많은 데이터로 학습하면 격차가 크게 줄어들 것"이라고 덧붙였습니다. 즉, 이 결과는 적은 데이터로 미세조정할 때 UltraBERT가 학습 신호에 더 민감하게 반응한다는 관찰로 읽는 것이 맞습니다.
UltraBERT-Embed-150M: 바로 쓸 수 있는 영어 임베딩 모델
위 백본 점수는 가벼운 미세조정 결과입니다. 저자들은 완전한 임베딩 학습을 거친 UltraBERT-Embed-150M도 함께 공개했습니다. 이 모델은 UltraBERT-150M에서 출발해 두 단계의 대조 학습(contrastive learning) 을 거쳤습니다. 대조 학습은 관련된 텍스트 쌍의 벡터는 가깝게, 관련 없는 쌍은 멀게 만드는 학습 방법입니다.
- 약 5억 개의 약한 지도 텍스트, 코드 쌍(질문과 답, 제목과 본문, 독스트링과 코드)으로 학습합니다.
- 하드 네거티브(정답과 헷갈리는 오답)를 붙인 약 570만 개의 예제로 미세조정합니다. 입력은 최대 32K 토큰이라 긴 문서를 자르지 않고 학습합니다.
학습 데이터는 모두 공개 데이터셋이고, 더 큰 임베딩 모델로부터 증류하지 않았습니다. 출력은 768차원 벡터이며 CLS 토큰 풀링과 코사인 유사도를 씁니다.
| 모델 | 파라미터 | MTEB(eng, v2) | MTEB(Code, v1) | LongEmbed | RAR-b |
|---|---|---|---|---|---|
| UltraBERT-Embed-150M | 151M | 67.24 | 73.30 | 79.30 | 28.75 |
| Tarka-Embedding-150M-V1 (증류) | 156M | 66.39 | 57.71 | 55.12 | 21.76 |
| gte-modernbert-base | 149M | 66.26 | 71.66 | 57.0 | 23.54 |
| F2LLM-v2-160M (증류) | 159M | 65.93 | 70.38 | 57.64 | 19.62 |
| bge-base-en-v1.5 | 109M | 65.14 | 50.35 | 33.9 | 14.59 |
모델 카드는 2026년 10월 11일 기준으로 200M 이하 밀집 임베딩 모델 중 MTEB(eng, v2)와 MTEB(Code, v1) 1위라고 밝힙니다. 그러나 MTEB(eng, v2) 평균 67.24는 과제 유형별 1위의 합이 아닙니다. 모델 카드의 유형별 표에서 분류(81.74)는 증류 모델 F2LLM-v2-160M(87.13)과 Tarka(86.28)보다 낮습니다. 클러스터링(49.70)은 F2LLM-v2-160M(52.55)보다, 검색(57.20)은 DenseOn(59.09)보다 낮습니다. 따라서 문장 분류나 클러스터링이 주 용도라면 유형별 점수를 직접 비교해야 합니다.
임베딩 학습 코드는 ultrabert-embed-training 저장소에 공개되어 있습니다. 데이터 내려받기, 형식 변환, 두 단계 학습(GPU 8장, torchrun), MTEB 평가 스크립트가 들어 있습니다. 저장소 README는 처리된 학습 데이터를 재배포하지 않는 이유로 원본 데이터의 라이선스를 들며, 여러 검색 데이터셋에 포함된 MS MARCO가 비상업 연구용이라고 명시합니다. 또한 확인 시점에 이 저장소에는 LICENSE 파일이 없었습니다. 한편 MTEB 라이브러리에는 이미 UltraBERT-Embed 모델 정의가 들어가 있습니다.
UltraBERT 사용 방법
모든 모델은 transformers>=5 와 trust_remote_code=True 가 필요합니다. trust_remote_code=True 는 모델 저장소의 modeling_ultrabert.py 를 내려받아 실행한다는 뜻이므로, 운영 환경에서는 revision 으로 커밋을 고정하는 것을 검토할 수 있습니다. 긴 입력에는 FlashAttention 2를 권장하며 SDPA도 동작합니다. 먼저 패키지를 설치합니다.
pip install -U "transformers>=5" "sentence-transformers>=6.0"
마스크 언어 모델링
아래 코드는 UltraBERT-380M으로 가려진 단어를 예측합니다. FlashAttention 2가 설치되어 있지 않다면 attn_implementation 을 "sdpa" 로 바꿉니다. CUDA GPU가 없다면 device_map="cuda" 도 바꿔야 합니다.
import torch
from transformers import AutoModelForMaskedLM, AutoTokenizer

model_id = "dmis-lab/UltraBERT-380M"
tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForMaskedLM.from_pretrained(
    model_id,
    trust_remote_code=True,
    dtype=torch.bfloat16,
    attn_implementation="flash_attention_2",  # or "sdpa"
    device_map="cuda",
)

text = f"The capital of France is {tokenizer.mask_token}."
inputs = tokenizer(text, return_tensors="pt").to(model.device)
with torch.no_grad():
    logits = model(**inputs).logits

mask_index = (inputs.input_ids == tokenizer.mask_token_id).nonzero()[0, 1]
print(tokenizer.decode(logits[0, mask_index].argmax()))
공개된 체크포인트에는 인코더와 5% 마스킹(증류) LM 헤드만 들어 있고, 50% 헤드는 빠져 있습니다. 가중치는 사전학습 마스터 가중치인 float32로 저장되어 있습니다.
미세조정
체크포인트는 일반 과제 클래스로 불러올 수 있습니다. 문장 분류, 토큰 분류, 질의응답 클래스를 지원합니다.
from transformers import AutoModelForSequenceClassification

model = AutoModelForSequenceClassification.from_pretrained(
    "dmis-lab/UltraBERT-150M", num_labels=2, trust_remote_code=True
)
학습률 설정은 다른 인코더와 다릅니다. 저자들에 따르면 UltraBERT는 다른 인코더보다 최대 10배 낮은 학습률을 선호합니다. 검색 미세조정에서 가장 좋았던 값은 150M이 5e-5, 380M이 3e-5였고, 다른 인코더는 보통 3e-4~5e-4가 좋았습니다. 모델 카드는 분류 학습률로 {5e-6, 8e-6, 1e-5, 3e-5, 5e-5, 8e-5} 범위의 탐색을 제시합니다.
Sentence Transformers로 임베딩 만들기
UltraBERT-Embed-150M은 Sentence Transformers v6.0 이상에서 씁니다. 질의에는 Instruct: {task}\nQuery: 접두어를 붙이고, 문서는 그대로 임베딩합니다. 레이블 문구에는 Label: 접두어를 붙입니다.
from sentence_transformers import SentenceTransformer

model = SentenceTransformer(
    "dmis-lab/UltraBERT-Embed-150M",
    trust_remote_code=True,
    model_kwargs={"attn_implementation": "flash_attention_2", "dtype": "bfloat16"},
)

queries = ["Win big, click now!"]
labels = ["spam", "promotional", "announcement"]
query_embeddings = model.encode(queries, prompt="Instruct: Labeling spam emails\nQuery: ")
label_embeddings = model.encode(labels, prompt="Label: ")
print(model.similarity(query_embeddings, label_embeddings))
prompt_name="query" 를 쓰면 기본 검색 지시문이 붙습니다. 문장 유사도처럼 양쪽이 대칭인 과제에서는 두 입력에 같은 지시문을 붙입니다.
도입 전에 확인할 한계
- 영어 전용입니다. 모델 카드는 백본 두 개와 임베딩 모델 모두 영어(와 코드) 전용이라고 밝힙니다. 한국어 문서를 다룬다면 다국어 모델과 비교해야 하며, 한국어 임베딩 모델 비교에는 ko-embedding-leaderboard를 참고할 수 있습니다.
- 백본은 그대로 쓰는 모델이 아닙니다. UltraBERT-150M과 380M은 과제에 맞게 미세조정해야 합니다. 바로 쓸 임베딩이 필요하면 UltraBERT-Embed-150M을 씁니다.
- 재현 범위가 제한적입니다. 논문의 재현성 문단은 평가 코드, 모델 가중치, 사전학습 데이터 혼합을 공개한다고 적습니다. 확인 시점에 dmis-lab GitHub 조직에서 찾은 공개 학습 코드는 임베딩 학습과 MTEB 평가를 담은 저장소 하나뿐이었습니다. 추론용 모델 코드는 Hugging Face 모델 저장소에 있습니다. 백본 사전학습 코드, GLUE 등 백본 평가 코드, 1.3B 교사 모델은 찾지 못했습니다. 따라서 LM 헤드 분리 방법을 다른 데이터로 다시 학습해 보려면 논문 부록의 설정을 보고 직접 구현해야 합니다.
- 추론 속도는 보고되지 않았습니다. 논문과 블로그에는 지연 시간이나 처리량 측정이 없습니다. 비교 대상인 LFM2.5-Encoder는 Liquid AI 블로그에서 CPU의 긴 입력 처리 속도를 강점으로 내세웁니다(8,192토큰에서 ModernBERT-base보다 약 3.7배 빠름). 지연 시간이 중요한 배포라면 UltraBERT의 속도를 직접 측정해야 합니다.
- 동료 평가 전 논문입니다. arXiv 원고는 심사 중(Under review)이라고 표기되어 있습니다. 비교 모델 점수의 상당수는 저자들이 직접 측정한 값입니다.
UltraBERT의 라이선스
UltraBERT-150M, UltraBERT-380M, UltraBERT-Embed-150M 모델 가중치는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 다만 임베딩 학습 데이터에는 저장소 README가 비상업 연구용이라고 밝힌 MS MARCO가 포함되어 있고, ultrabert-embed-training 저장소에는 확인 시점에 LICENSE 파일이 없습니다. 상업 서비스에 쓴다면 이 두 가지를 법무 검토 대상에 넣어야 합니다.
 UltraBERT: One Encoder for Classification and Retrieval 소개 블로그
UltraBERT: Beyond the Limit of BERT Pre-Training 논문
 UltraBERT 모델 컬렉션 (Hugging Face)
 UltraBERT-Embed 학습 코드 GitHub 저장소
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
Laya: 텍스트 생성 없이 한 번의 순전파로 결정을 내리는 Jev 호환 오픈 가중치 모델과 로컬 실행 도구들
-
BidirLM, 기존의 LLM을 오픈소스 옴니모달 양방향 인코더(Omni-modal Bidirectional Encoder)로 변환하는 레시피와 모델 공개
-
Liquid AI, 엣지용 350M 모델 LFM2.5와 다국어 검색 리트리버 LFM2.5 Retrievers 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
