핵심 요약
- Google DeepMind가 EmbeddingGemma 2 발표 글에서 텍스트, 코드, 이미지, 영상, 음성을 하나의 768차원 공간에 담는 740M 임베딩 모델을 Apache 2.0 라이선스로 공개했습니다.
- 텍스트 전용 270M 모델에 비전(170M)과 오디오(300M) 인코더를 골라 붙이는 구조라, 텍스트만 다루는 서비스는 270M만 불러 쓸 수 있습니다.
- Hugging Face 모델 카드 기준으로 코드 검색 벤치마크(MTEB Code)는 전작보다 9.92점 올랐고(68.76에서 78.68), 다국어 텍스트 점수는 61.15에서 61.36으로 거의 같습니다.
- 벡터를 128차원으로 줄여도 텍스트와 코드는 약 90% 이상의 품질을 지킵니다. 반면 멀티모달 검색 점수는 크게 떨어져서, Google도 128차원은 텍스트 위주로 쓰도록 안내합니다.
- 모든 벤치마크는 Google이 직접 측정한 값이고, 음성 벤치마크(MAEB)에서는 Google 차트 안에서도 약 1B 크기의 jina-embeddings-v5-omni-nano가 더 높게 그려져 있습니다.

EmbeddingGemma 2 소개
EmbeddingGemma 2는 Google DeepMind가 2026년 10월 6일 공개한 멀티모달 임베딩 모델입니다. 휴대폰과 노트북 위에서 텍스트, 코드, 이미지, 영상, 음성을 같은 벡터 공간에 넣어 서로 검색할 수 있게 해 줍니다. 임베딩 모델은 입력을 고정 길이 벡터로 바꾸고, 뜻이 가까운 입력끼리 벡터도 가깝게 놓습니다. 검색 증강 생성(RAG, Retrieval-Augmented Generation)과 의미 검색(Semantic Search)이 모두 이 벡터 사이의 거리로 동작합니다.
지금까지 기기 안에서 사진이나 녹음을 검색하려면 보통 여러 모델을 이어 붙였습니다. 이미지는 캡션 모델로 문장을 만들고, 음성은 음성 인식 모델로 받아쓴 다음, 그 텍스트를 다시 텍스트 임베딩 모델에 넣는 식입니다. Google AI Edge 블로그는 EmbeddingGemma 2가 이렇게 모델을 여럿 거치며 생기는 지연과 메모리 부담을 줄인다고 설명합니다. 사진과 소리를 텍스트로 바꾸지 않고 바로 벡터로 옮기기 때문입니다.
이번에 소개하는 EmbeddingGemma 2는 작년에 나온 EmbeddingGemma (
 EmbeddingGemma: Google이 공개한, On-Device Embedding을 위한 308M 규모의 소형 모델)의 후속작입니다. 전작은 308M 규모의 텍스트 전용 모델이었고, Google에 따르면 다운로드 횟수가 2,000만 회를 넘었습니다. 2편의 텍스트 모델은 270M으로 전작보다 작습니다. Google은 2편이 Gemini Embedding 모델과 같은 기술로 만들어졌다고 설명합니다. 2편은 Gemma 4 ( Google DeepMind, 모바일 기기부터 클라우드까지 사용 가능한, 통합 멀티모달 모델 Gemma 4 공개) 구조를 바탕으로 만들었고, 컨텍스트 창도 2K에서 8K 토큰으로 4배 늘렸습니다.
텍스트와 이미지, 영상, 음성을 한 공간에 담는 오픈 임베딩 모델은 이미 있습니다. 올해 4월 Jina AI가 공개한 jina-embeddings-v5-omni ( Jina AI, 텍스트와 이미지, 오디오, 비디오를 하나의 임베딩 공간에 담는 jina-embeddings-v5-omni 공개)가 대표적입니다. EmbeddingGemma 2가 다른 점은 크기와 배포 경로입니다. 전체 모델이 740M이고 상업적 이용이 가능한 Apache 2.0 라이선스이며, Google이 LiteRT와 MediaPipe 같은 자체 온디바이스 도구에 바로 연결해 두었습니다.
모듈형 구조: 270M 텍스트 모델에 필요한 인코더만 붙이기
개발자 가이드에 실린 아래 그림은 EmbeddingGemma 2의 입력 경로를 보여줍니다. 텍스트와 코드는 270M 텍스트 모델로 바로 들어가고, 이미지와 영상 프레임은 비전 인코더를, 음성은 오디오 인코더를 거친 뒤 같은 텍스트 모델을 통과합니다. 그래서 어떤 입력이든 결과는 같은 768차원 공간의 벡터가 됩니다.
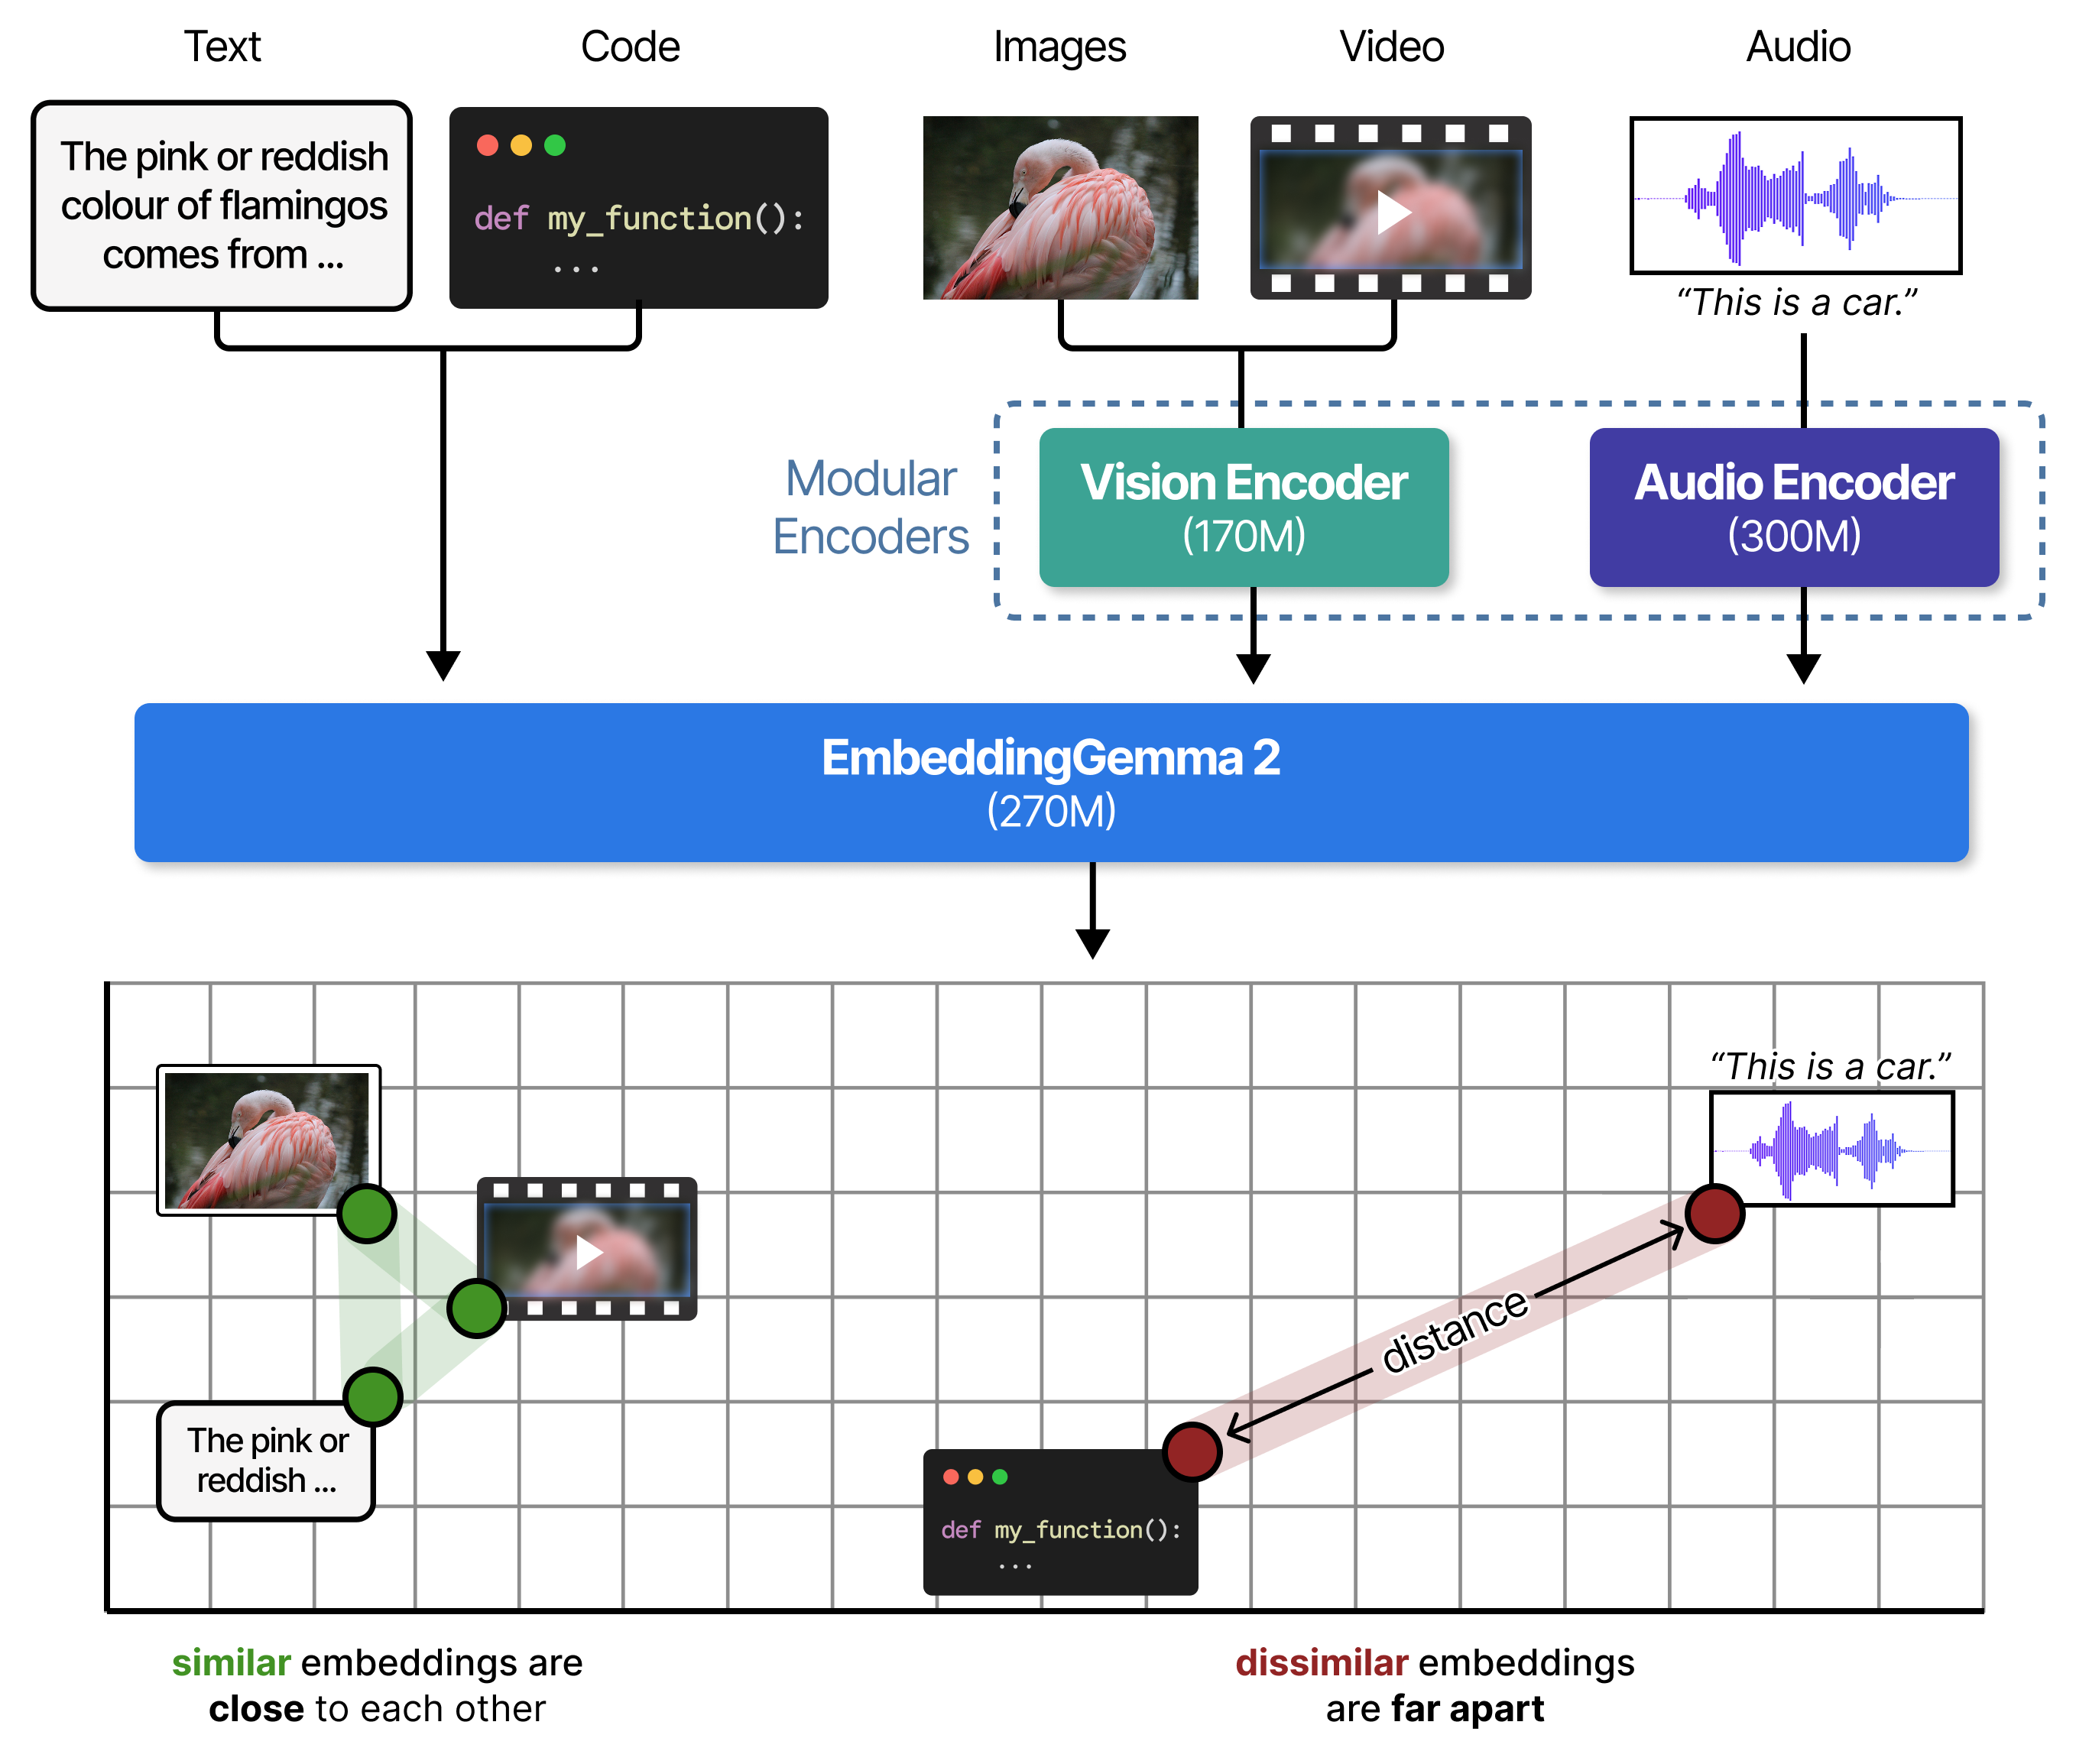
두 인코더는 독립된 부품이라 필요한 것만 메모리에 올릴 수 있습니다. 개발자 가이드에 따르면 꺼 둔 인코더는 아예 메모리에 올라가지 않으므로 가중치 크기와 최대 메모리 사용량이 함께 줄어듭니다. sentence-transformers에서 config_kwargs 로 고르는 조합은 아래와 같습니다.
| 다루는 데이터 | config_kwargs |
파라미터 수 |
|---|---|---|
| 텍스트, 코드 | {"vision_config": None, "audio_config": None} |
270M |
| 텍스트 + 이미지, 영상 | {"audio_config": None} |
440M |
| 텍스트 + 음성 | {"vision_config": None} |
570M |
| 전체 모달리티 | {} (기본값) |
740M |
네 조합은 같은 체크포인트에서 불러오므로 벡터 공간도 같습니다. 270M 텍스트 전용 구성으로 만든 질의 벡터를 전체 모델로 만든 문서 벡터와 바로 비교할 수 있습니다. 개발자 가이드는 텍스트 색인으로 시작해 나중에 이미지나 음성을 추가해도 이미 계산한 임베딩을 다시 계산할 필요가 없다고 밝히고 있습니다.
모델 카드의 제원을 보면 270M 텍스트 모델은 130M 트랜스포머 본체(Backbone)와 140M 임베딩 층(Embedder)으로 나뉩니다. 어휘 크기는 262,144개이며, 여기에 모델 차원 512를 곱하면 약 1억 3,400만 개라 임베딩 층 140M의 대부분에 해당합니다. 본체는 24개 층, 모델 차원 512이며, 지역(Local) 어텐션과 전역(Global) 어텐션을 5:1로 섞고 지역 어텐션의 슬라이딩 윈도우(Sliding Window)는 1,024 토큰입니다. 출력은 평균 풀링(Mean Pooling)으로 하나의 벡터를 만든 뒤 512차원에서 768차원으로 투영합니다.
Gemma 4와 함께 쓸 때의 이점도 있습니다. EmbeddingGemma 2는 Gemma 4와 텍스트 토크나이저(Tokenizer)와 오디오 인코더 구조를 공유합니다. Google은 기기 안 RAG 파이프라인에서 두 모델을 함께 실행하면 전체 메모리 사용량이 줄어든다고 설명합니다.
벤치마크: 코드 검색은 크게 오르고, 다국어 텍스트는 그대로
아래 표는 Hugging Face 모델 카드에 실린 768차원 전체 정밀도(full-precision) 체크포인트의 결과입니다. 전작은 텍스트 전용이라 이미지, 영상, 음성 항목에는 비교 대상이 없습니다. 벤치마크 이름은 각각 MTEB(Massive Text Embedding Benchmark), MIEB(Massive Image Embedding Benchmark), MMEB(Massive Multimodal Embedding Benchmark), MSEB(Massive Sound Embedding Benchmark), MAEB(Massive Audio Embedding Benchmark)의 약자입니다.
| 모달리티 | 벤치마크 | 지표 | EmbeddingGemma 2 | EmbeddingGemma 1 |
|---|---|---|---|---|
| 텍스트 | MTEB (multilingual, v2) | Mean(Task) | 61.36 | 61.15 |
| 텍스트 | MTEB (code, v1) | NDCG@10 | 78.68 | 68.76 |
| 이미지 | MIEB (lite) | Mean(TaskType) | 64.64 | - |
| 이미지 | MMEB v2 Image | Hit@1 | 57.28 | - |
| 시각 문서 | MMEB v2 VisDoc | NDCG@5 | 67.84 | - |
| 영상 | MMEB v2 Video | Hit@1 | 50.67 | - |
| 음성 | MSEB (Retrieval) | MRR@10 | 69.54 | - |
| 음성 | MAEB | Mean(Task) | 49.39 | - |
위 표를 통해 가장 크게 바뀐 곳이 코드라는 것을 알 수 있습니다. MTEB Code 점수가 9.92점 올랐고, 상대 비율로는 약 14%입니다. Google은 이 결과를 근거로 로컬 코드베이스 색인, 의미 기반 코드 검색, 코딩 에이전트의 검색 단계를 주요 용도로 꼽습니다. 반면 다국어 텍스트 점수는 0.21점 차이로, Google의 설명대로 전작과 같은 수준입니다.
다른 모델과 비교한 Google의 차트
Google 블로그는 모델 크기(가로축, 로그 눈금)와 점수(세로축)를 함께 놓은 차트 3장을 실었습니다. 비교 대상과 측정값은 모두 Google이 정한 것입니다.
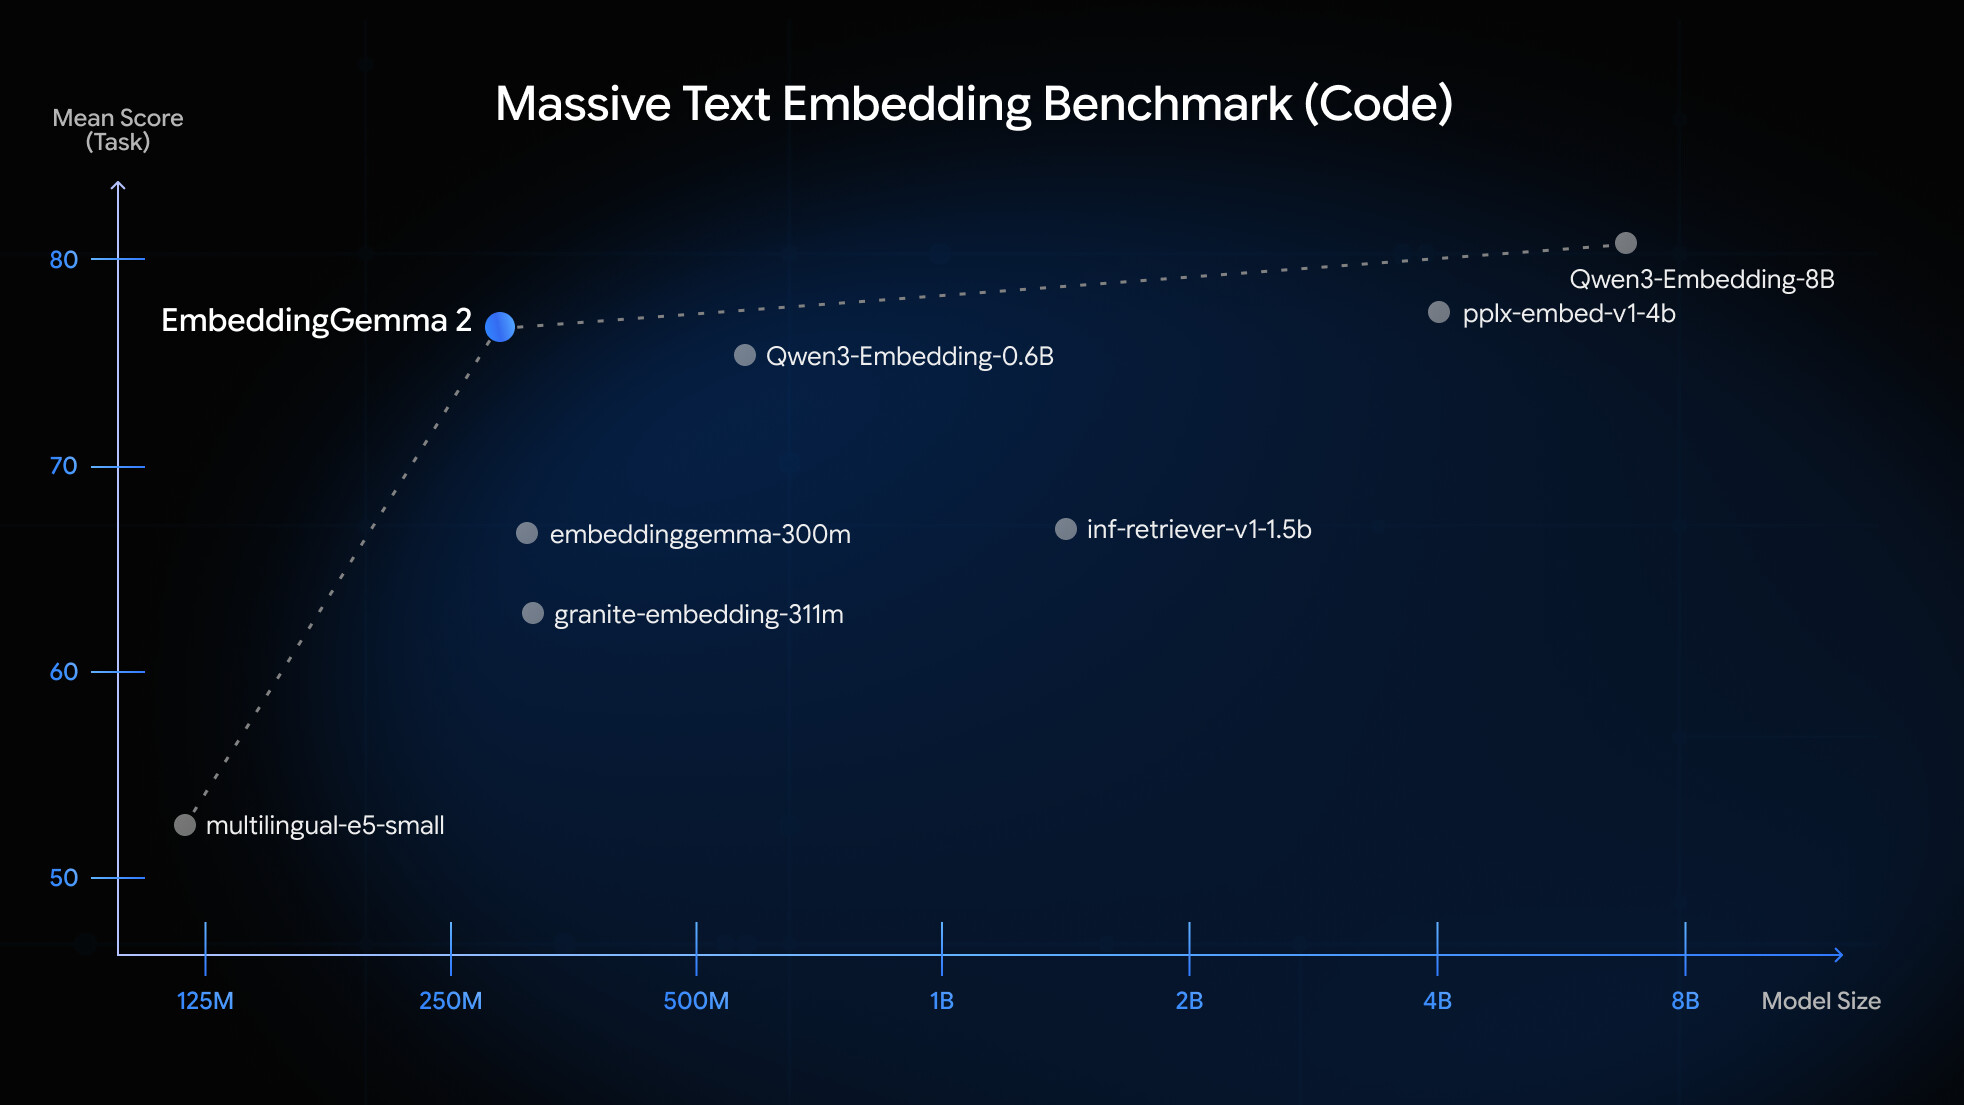
코드 차트에서 EmbeddingGemma 2는 Qwen3-Embedding-0.6B보다 약간 위에 있고, 4B 규모의 pplx-embed-v1-4b와 Qwen3-Embedding-8B보다는 아래에 있습니다. 차트를 직접 읽을 때 주의할 점이 하나 있습니다. 축 눈금으로 점의 높이를 재면 EmbeddingGemma 2는 약 76.7, 전작(embeddinggemma-300m)은 약 66.8로, 모델 카드 표의 78.68과 68.76보다 두 점 모두 약 2점 낮게 그려져 있습니다. 두 모델의 순서는 같지만, 절대값은 표를 기준으로 읽어야 합니다.
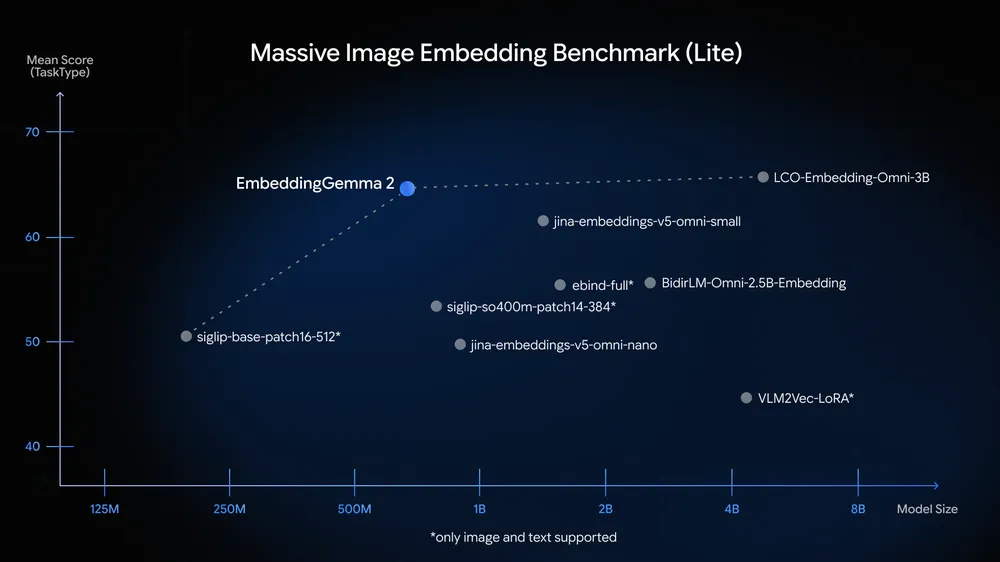
이미지 차트(MIEB Lite)에서는 3B 규모의 LCO-Embedding-Omni-3B가 EmbeddingGemma 2보다 약 1점 위에 있고, 나머지 비교 모델은 모두 아래에 있습니다.
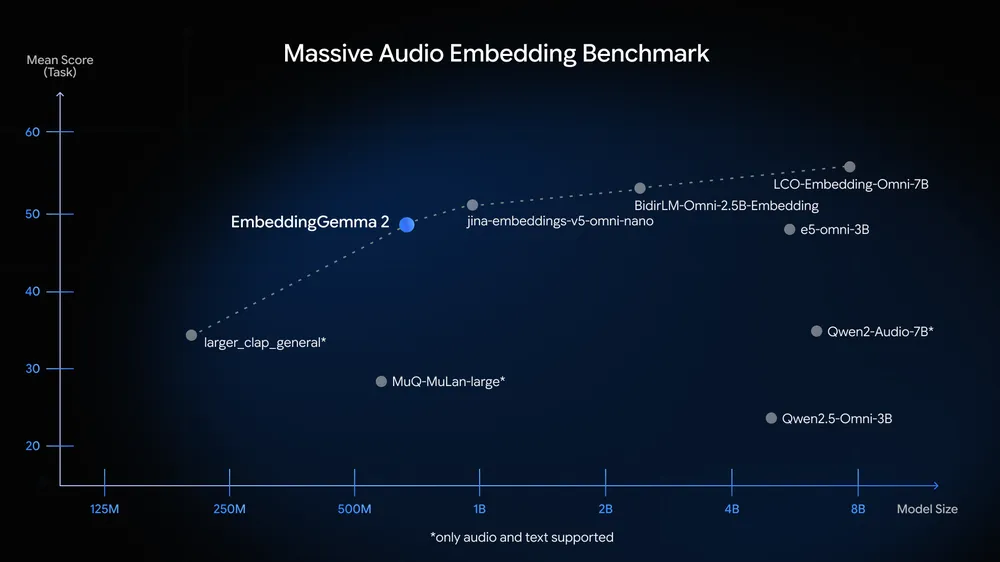
음성 차트(MAEB)는 발표 글의 문구와 함께 읽어야 합니다. Google은 EmbeddingGemma 2가 MAEB에서 1B 미만 멀티모달 임베딩 모델 가운데 최상위 점수(leading scores)를 낸다고 썼습니다. 그런데 같은 차트에서 jina-embeddings-v5-omni-nano가 EmbeddingGemma 2보다 약 2점 높게, 1B 눈금 바로 왼쪽에 그려져 있습니다. Hugging Face에 올라온 이 모델의 safetensors 파라미터 수는 약 986M이고, 모델 카드에는 약 1.04B로 적혀 있습니다. 따라서 Google의 주장이 성립하는지는 1B 경계를 어디에 긋느냐에 달려 있습니다. 다만 jina 모델은 CC BY-NC 4.0이라 상업적으로 쓸 수 없으므로, 상업 서비스에 넣을 모델을 고르는 독자에게는 이 차이가 점수 차이보다 클 수 있습니다.
벡터 길이 줄이기: 마트료시카 표현 학습(MRL)의 효과와 한계
EmbeddingGemma 2는 마트료시카 표현 학습(Matryoshka Representation Learning, MRL) 으로 학습했습니다. 벡터의 앞쪽 차원에 중요한 정보가 먼저 모이도록 학습하는 방법이라, 768차원 벡터에서 앞의 512, 256, 128차원만 잘라 써도 검색이 동작합니다. 차원을 줄이면 벡터 데이터베이스(Vector Database)의 저장 공간과 검색 시간이 함께 줄어듭니다.
마트료시카 표현 학습과 관련해서는 다음 논문(Matryoshka Representation Learning)을 참고해주세요:
| 출력 차원 | 압축비 | MTEB multilingual | MTEB code | MIEB lite | MMEB v2 | MSEB | MAEB |
|---|---|---|---|---|---|---|---|
| 768 | 1:1 | 61.36 | 78.68 | 64.64 | 59.01 | 69.54 | 49.39 |
| 512 | 1:1.5 | 61.17 | 77.24 | 64.32 | 58.38 | 69.18 | 49.21 |
| 256 | 1:3 | 60.41 | 76.18 | 63.13 | 56.24 | 66.76 | 48.91 |
| 128 | 1:6 | 57.89 | 71.41 | 59.06 | 45.65 | 56.71 | 46.92 |
위 표에서 256차원까지는 손실이 작다는 것을 알 수 있습니다. 768차원 대비 MTEB code는 약 97%, MMEB v2와 MSEB는 약 95~96%를 유지합니다. 128차원에서는 모달리티마다 결과가 다릅니다. 다국어 텍스트(약 94%)와 코드(약 91%)는 버티지만, 멀티모달 종합 점수인 MMEB v2는 59.01에서 45.65로 약 77%, 음성 검색 MSEB는 약 82%까지 떨어집니다. 모델 카드도 128차원은 텍스트 위주 작업에 맞고, 멀티모달에 쓰려면 자기 데이터로 먼저 검증하라고 적고 있습니다.
저장 공간은 차원 수에 비례합니다. 개발자 가이드의 예로는 768차원 벡터 100만 개가 bfloat16으로 약 1.5GB이고, 128차원이면 약 250MB라 6배 차이가 납니다. 참고로 AI Edge 블로그는 MRL로 저장 공간을 "최대 8배" 줄인다고 적었는데, 발표 글과 모델 카드, 개발자 가이드는 모두 최대 6배(768 대 128)로 적고 있습니다.
차원을 자를 때는 두 가지를 지켜야 합니다. 첫째, 잘라 낸 벡터는 길이가 1이 아니므로 벡터 길이를 다시 1로 맞추는 L2 정규화(L2 Normalization)를 해야 합니다. 모델 카드는 이 단계를 빼먹으면 오류 없이 순위 품질만 조용히 나빠진다고 경고합니다. 둘째, 질의와 문서는 같은 차원을 써야 합니다. 768차원 질의를 128차원 색인과 비교할 수는 없습니다.
입력 한도: 8,192 토큰을 모든 모달리티가 나눠 씀
컨텍스트 창 8,192 토큰은 모든 모달리티가 함께 씁니다. 모달리티마다 토큰을 쓰는 비율이 정해져 있고, 아래 최대치는 텍스트 없이 한 가지 모달리티만 넣었을 때의 값입니다.
| 모달리티 | 토큰 비용 | 한 입력의 최대치 |
|---|---|---|
| 텍스트 | 서브워드 1개당 1토큰 | 8,192 토큰 |
| 이미지 | 이미지 1장당 280토큰 (기본값) | 약 29장 |
| 영상 | 프레임 1장당 140토큰 (기본값) | 약 58프레임 |
| 음성 | 1초당 25토큰 | 약 327초 (약 5분 27초) |
이미지와 영상 프레임에 쓰는 토큰 수는 70에서 1,120 사이로 바꿀 수 있습니다. 토큰을 많이 주면 세밀한 시각 정보를 더 담고, 적게 주면 지연이 줄어듭니다. 낮은 예산을 쓰면 한 입력에 이미지나 프레임을 약 114장까지 넣을 수 있습니다. 영상은 기본값으로 초당 1프레임을 뽑고, 음성은 16kHz 모노로 넣어야 합니다. 미디어는 파일 경로(영상은 MP4), URL(이미지와 음성), 메모리 안의 PIL 이미지, 배열, 텐서로 넘길 수 있습니다.
한 입력 안에 텍스트와 미디어를 섞을 수도 있습니다. 텍스트 안에 <|image|>, <|video|>, <|audio|> 자리 표시 토큰을 두면, 그 자리에 해당 미디어가 순서대로 들어가 전체가 하나의 벡터가 됩니다. 상품 설명, 상품 사진, 시연 영상을 묶어 하나의 상품 벡터로 만드는 식입니다.
sentence-transformers로 사용하기
Google은 sentence-transformers ( Sentence Transformers v6.0, ColBERT 스타일 멀티 벡터 검색을 표준 API로) 6.1.0 이상을 기준으로 사용법을 안내합니다. 아래 코드는 개발자 가이드와 모델 카드의 예제를 그대로 옮긴 것입니다.
- 이미지, 음성, 영상 처리에 필요한 추가 패키지와 함께 설치합니다.
pip install -U sentence-transformers[image,audio,video] transformers
- 모델을 불러옵니다. 메모리를 아끼려면, 쓰지 않는 인코더를
config_kwargs로 끕니다.
from sentence_transformers import SentenceTransformer

# Full model: all modalities (740M parameters)
MODEL_ID = "google/embeddinggemma-2"
model = SentenceTransformer(MODEL_ID)

# Text only (270M parameters)
text_only_model = SentenceTransformer(
    MODEL_ID,
    config_kwargs={"vision_config": None, "audio_config": None},
)
- 텍스트를 넣을 때는 작업 접두어(Task Prefix)를 붙입니다. EmbeddingGemma 2는 짧은 작업 지시문을 앞에 붙인 텍스트로 학습했으므로, 접두어를 빼도 동작하지만 품질이 떨어집니다.
prompt_name을 지정하면 아래 접두어가 자동으로 붙습니다.
| 용도 | prompt_name |
붙는 접두어 |
|---|---|---|
| 검색 질의 | SearchQuery |
task: search result | query: |
| 질의응답 | QuestionAnswering |
task: question answering | query: |
| 사실 검증 | FactChecking |
task: fact checking | query: |
| 코드 검색 질의 | CodeRetrieval |
task: code retrieval | query: |
| 문서 | Document |
title: none | text: |
| 분류 | Classification |
task: classification | query: |
| 군집화 | Clustering |
task: clustering | query: |
| 유사도 | SentenceSimilarity |
task: sentence similarity | query: |
검색처럼 질의와 문서가 다른 작업에서는 질의와 문서에 서로 다른 접두어를 씁니다. 문서에 제목이 있다면, prompt_name="Document" 대신 title: {제목} | text: {본문} 형식으로 직접 만들어 넣어야 합니다. 이미지, 영상, 음성에는 접두어를 붙이지 않습니다.
query = "What causes the northern lights?"
document = "The northern lights are caused by charged particles from the sun.." # truncated

# Embed using `prompt_name`
query_emb = model.encode(query, prompt_name="SearchQuery")
doc_emb = model.encode(document, prompt_name="Document")

print(model.similarity(query_emb, doc_emb))
- 미디어는 모달리티 이름을 키로 한 딕셔너리로 넣습니다. 텍스트 질의 하나로 사진과 녹음을 함께 검색할 수 있습니다.
# Cross-modal search: one text query against a photo and a sound recording
image_emb = model.encode({"image": "sunset_beach.jpg"})
audio_emb = model.encode({"audio": "ocean_waves.wav"})
query_emb = model.encode("ocean waves at sunset", prompt_name="SearchQuery")

print(model.similarity(query_emb, image_emb))
print(model.similarity(query_emb, audio_emb))

# Interleaved: one embedding for a product listing with text, photo, and video
listing_emb = model.encode({
    "text": "Waterproof trail shoe. <|image|> Grip test on wet rock: <|video|>",
    "image": "trail_shoe.jpg",
    "video": "grip_test.mp4",
})
query_emb = model.encode("waterproof trail shoes", prompt_name="SearchQuery")

print(model.similarity(query_emb, listing_emb))
- 차원을 줄이려면,
truncate_dim과normalize_embeddings=True를 함께 넘깁니다. 정규화까지 한 번에 처리됩니다.
# Truncate the query
query_emb = model.encode(
    query,
    prompt_name="SearchQuery",
    truncate_dim=256,
    normalize_embeddings=True,
)
정밀도 설정에는 주의가 필요합니다. 모델 카드에 따르면 EmbeddingGemma 2의 활성값 범위가 float16의 표현 범위를 넘기 때문에, float16으로 실행하면 오류 대신 NaN이나 품질이 떨어진 벡터가 조용히 나옵니다. 따라서 float16은 쓰지 않아야 합니다. 모델 카드는 bfloat16을 지원하는 하드웨어에서는 bfloat16을, 그 밖의 환경(대부분의 CPU 포함)에서는 float32를 권장합니다.
dtype = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float32

model = SentenceTransformer("google/embeddinggemma-2", model_kwargs={"torch_dtype": dtype})
아래 영상은 개발자 가이드의 시연입니다. 270M 텍스트 전용 구성으로 Hugging Face transformers 코드베이스를 임베딩한 뒤, Gemma 4 26B A4B 모델을 쓰는 에이전트가 이 색인으로 코드를 찾습니다.
sentence-transformers 외의 실행 환경도 출시일부터 지원됩니다. 서버에서는 Hugging Face transformers, vLLM, SGLang을 쓸 수 있습니다. 로컬에서는 llama.cpp용 GGUF, Ollama, MLX, LM Studio를 쓸 수 있습니다. 다만 Unsloth 안내에 따르면 llama.cpp 예제는 텍스트 임베딩용이고, 이미지와 음성에는 해당 인코더를 지원하는 런타임이 필요합니다. 브라우저용으로는 transformers.js와 WebGPU 데모가 있습니다.
벡터 저장은 Qdrant가, 미세조정(Fine-tuning)은 Unsloth가 출시에 맞춰 안내 문서를 냈습니다. 가중치는 Hugging Face와 Kaggle에 있고, Google Cloud의 Gemini Enterprise Agent Platform Model Garden에도 곧 추가될 예정입니다.
기기 안에서 실행하기: LiteRT, MediaPipe, 데모 앱
Google은 양자화(Quantization)한 EmbeddingGemma 2가 Pixel 11 Pro에서 텍스트 전용 가중치 기준 약 191MB, 전체 멀티모달 모델 기준 약 567MB의 활성 메모리로 동작한다고 밝혔습니다. AI Edge 블로그에 따르면 양자화 인식 학습(QAT, Quantization-Aware Training)으로 가중치를 INT4와 INT8로 줄였습니다. 실행 엔진은 LiteRT이며, 하나의 .litertlm 파일이 지원 플랫폼의 CPU와 GPU에서 그대로 실행됩니다. 미리 양자화한 파일은 LiteRT Community의 Hugging Face 저장소에 있으며, 텍스트 270M(165MB), 텍스트와 비전 440M(388MB), 전체 740M(485MB) 세 가지로 나뉩니다. 이 변환본이 지원하는 이미지 토큰 수는 70과 140뿐이라, 앞 절의 기본값(280)보다 적습니다.
아래 표는 AI Edge 블로그가 공개한 이미지 1장당 비전 인코딩 지연입니다. 이미지당 비전 토큰을 최소값인 70개로 둔 조건이므로, 토큰을 늘리면 지연도 늘어납니다.
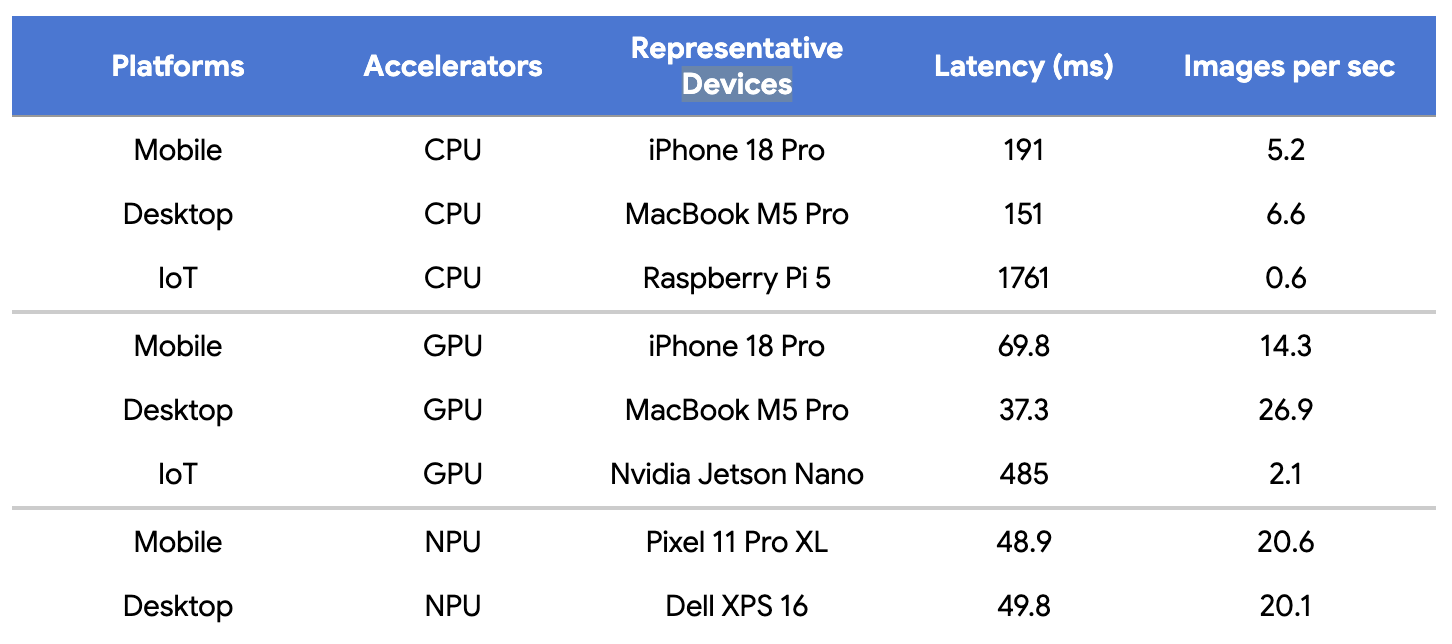
MacBook M5 Pro GPU에서 이미지 1장에 37.3ms(초당 26.9장), Pixel 11 Pro XL의 NPU에서 48.9ms가 걸립니다. 반면 Raspberry Pi 5의 CPU에서는 이미지 1장에 1,761ms가 걸려, 초당 0.6장을 처리합니다. 텍스트만 넣으면 더 빠릅니다. LiteRT Community 모델 카드에 따르면 128토큰 텍스트의 임베딩 지연은 Pixel 11 Pro TPU에서 8.3ms입니다.
앱에 붙이는 방법은 두 가지입니다. 첫째는 MediaPipe Tasks입니다. Universal Embedder Task는 이미지 크기 조정, 정규화, 토큰화를 대신 처리합니다. Semantic Retriever Task는 기기 안에서 벡터를 색인하고 근사 최근접 이웃(ANN, Approximate Nearest Neighbor) 검색을 합니다. 둘째로, 세밀한 제어가 필요하다면 LiteRT를 직접 씁니다. AI Edge 블로그에 따르면 Android용 ML Kit 지원은 몇 주 안에 추가될 예정입니다.
MediaPipe Decision Task는 임베딩을 분류에 쓰는 사례입니다. 사용자 입력을 미리 정한 라벨과 설명의 벡터와 비교해, 학습 데이터 없이 의도를 분류하거나 다음 동작을 고릅니다. AI Edge 블로그의 체스 시연에서는 매 수마다 후보 500개를 평가하는 데 100ms 미만이 걸렸습니다.
직접 써 볼 수 있는 앱도 함께 나왔습니다. Google AI Edge Gallery ( Google AI Edge Gallery: Android 기기에서 다양한 생성형 AI App을 체험해볼 수 있는 실험적인 앱) 앱에는 EmbeddingGemma 2를 쓰는 데모 두 가지가 추가됐습니다. Instant Media Search는 휴대폰 속 사진과 영상을 자연어나 예시 이미지로 찾고, Video Moments Finder는 영상에서 특정 장면의 시간 위치를 찾습니다. 아래 영상은 Instant Media Search에서 입력할 때마다 결과가 바뀌는 모습입니다. 앱의 구현 코드는 GitHub 저장소에 있습니다.
Mac용 실험 앱 Google AI Edge Foresight는 EmbeddingGemma 2와 Gemma 4를 써서 회의 중 메모를 보강하고, 회의 기록과 개인 파일을 검색하는 회의 보조 도구입니다. 설치 없이 브라우저에서 확인하려면 LiteRT-LM의 웹 데모를 열면 됩니다.
도입 전에 확인할 점
Hugging Face 모델 카드의 제한 사항과 위 수치에서 확인할 것을 정리하면 다음과 같습니다.
-
언어별 성능 편차: 모델 카드는 100개 이상의 언어를 이해하지만 언어마다 성능이 같지는 않다고 적고 있습니다. 모델 카드에는 한국어 결과가 따로 없으므로, 한국어 검색에 쓰려면 ko-embedding-leaderboard와 같은 한국어 평가로 먼저 확인해야 합니다.
-
학습 데이터 기준일: 사전 학습 데이터의 기준일은 2025년 1월입니다.
-
안전성 조정 없음: 생성 모델과 달리 사후 정렬이나 안전성 조정을 거치지 않았습니다. 검색 결과 필터링 같은 안전장치는 서비스를 만드는 쪽이 직접 넣어야 합니다.
-
벤치마크의 측정 주체: 모든 점수는 Google이 측정했고, 비교 대상도 Google이 골랐습니다. 음성 벤치마크에서는 위에서 본 것처럼 Google 차트 안에서도 더 높은 모델이 있습니다.
라이선스
EmbeddingGemma 2는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 다만 배포할 때는 Gemma 금지 사용 정책(Prohibited Use Policy)을 지켜야 한다고 모델 카드에 적혀 있습니다. MediaPipe 작업 문서에는 아직 Gemma 라이선스로 적혀 있지만, Hugging Face의 원본과 LiteRT 변환본, 공식 문서는 모두 Apache 2.0으로 표시합니다.
 EmbeddingGemma 2 발표 블로그
EmbeddingGemma 2 개발자 가이드
Google AI Edge의 EmbeddingGemma 2 온디바이스 활용 블로그
 EmbeddingGemma 2 모델 (Hugging Face)
 EmbeddingGemma 공식 문서
더 읽어보기
-
EmbeddingGemma: Google이 공개한, On-Device Embedding을 위한 308M 규모의 소형 모델
-
Jina AI, 텍스트와 이미지, 오디오, 비디오를 하나의 임베딩 공간에 담는 jina-embeddings-v5-omni 공개
-
Google DeepMind, 모바일 기기부터 클라우드까지 사용 가능한, 통합 멀티모달 모델 Gemma 4 공개
-
Google AI Edge Gallery: Android 기기에서 다양한 생성형 AI App을 체험해볼 수 있는 실험적인 앱
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
