핵심 요약
- Decision-Oriented Recommendation Reranking 논문은 TypeSafe AI의 결정 지향 모델 Jev로 추천 후보를 재순위화한 실증 연구입니다. 비교 대상은 Qwen2.5 7B Instruct 기반 재순위화 2종과 SASRec, DCNv2입니다.
- Amazon 리뷰 데이터 세 영역과 후보 수 네 가지, 모두 12개 조건 중 11개에서 Jev의 Hit Rate@10과 MRR이 가장 높았습니다. 후보 200개에서 Jev의 지연 시간 중앙값은 포인트와이즈 Qwen의 약 10 분의 1에서 17 분의 1이었습니다.
- 나머지 1개인 Movies and TV 후보 200개 조건에서는 재순위화를 하지 않은 SASRec의 원래 순서가 모든 재순위화 방법보다 나았습니다. 후보 200개에서 이 원래 순서를 넘어선 방법은 Video Games와 Books의 Jev뿐입니다.
- Jev는 호스팅 API로, 나머지는 A800 GPU 1장에서 로컬로 측정해 지연 시간은 하드웨어를 맞춘 비교가 아니며, 비용과 통계적 유의성은 보고되지 않았습니다.
Jev 추천 재순위화 연구 소개
이 논문은 추천 재순위화(reranking)에 결정 지향 모델(decision-oriented model) 을 썼을 때의 품질과 지연 시간을 측정한 연구입니다. 결정 지향 모델은 텍스트를 생성하지 않고, 정해진 선택지마다 확률을 돌려주는 모델을 가리킵니다. 대상 모델은 TypeSafe AI가 2026년 9월에 공개한 Jev 이고, 저자는 Singapore Management University의 Hanjia Lyu와 Meta AI의 Yinglong Xia입니다. 논문에는 TypeSafe AI와의 관계나 API 지원 여부에 대한 언급이 없습니다.
온라인 쇼핑몰의 추천 화면을 떠올려 보면, 화면에 보이는 열 개 남짓한 상품 뒤에는 보통 두 단계가 있습니다. 먼저 가벼운 모델이 수십만 개 상품 중 수백 개 후보를 빠르게 추리고, 그다음 더 무거운 모델이 이 후보들을 다시 줄 세웁니다. 이번 연구는 이 두 번째 단계, 즉 재순위화 단계만 떼어 내어 살펴봅니다.
추천 재순위화에서 LLM이 부딪히는 품질과 지연의 상충
최근에는 이 재순위화 단계에 대규모 언어 모델(Large Language Model, LLM)을 쓰려는 시도가 많습니다. 사용자의 과거 상호작용 이력과 후보 상품을 텍스트로 읽고 판단할 수 있어서, ID만 보는 기존 추천 모델이 활용하지 못하는 의미 정보를 활용할 수 있기 때문입니다. Large Language Models are Zero-Shot Rankers for Recommender Systems 연구가 이 방향을 보여 준 대표 사례입니다.
LLM으로 재순위화하는 방식은 크게 두 가지로 나뉩니다: 첫째는 후보 하나하나를 따로 채점하는 포인트와이즈(pointwise) 방식이고, 둘째는 후보 전체를 한 번에 보여 주고 고르게 하는 리스트와이즈(listwise) 방식입니다. 포인트와이즈 방식은 후보마다 세밀하게 판단하지만, 후보가 K 개면 모델을 K 번 실행해야 하므로 계산량이 후보 수에 비례해 늘어납니다. 리스트와이즈 방식은 모델을 한 번만 실행하지만, 후보가 많아질수록 입력이 길어지고 모델이 긴 목록 안에서 순서 관계를 정확히 따지기 어려워집니다.
실제 추천 시스템에서는 재순위화 단계가 수십에서 수백 개 후보를 정해진 지연 시간 안에 처리해야 하므로, 이 상충이 특히 중요합니다.
결정 지향 모델이라는 다른 선택지
Jev는 TypeSafe AI가 첫 번째 System One 모델 이라고 부르는 모델입니다. 자유 형식의 텍스트를 생성하는 대신, 상태(state)와 질문을 받아 타입이 정해진 확률적 결정을 돌려줍니다. Jev의 학습 방식과 API 구성은 Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 글에서 자세히 정리한 바 있습니다.
연구팀이 주목한 점은 이 인터페이스가 추천 재순위화와 그대로 맞물린다는 것입니다. 사용자의 상호작용 이력은 결정의 상태가 되고, 후보 상품은 선택지가 되며, Jev가 돌려주는 선택지별 확률은 그대로 순위 점수가 됩니다. Jev의 Choice 질문은 TypeSafe 문서 기준으로 선택지를 최대 255개까지 받으므로, 후보 200개도 한 번의 요청으로 처리할 수 있습니다.
연구팀은 결정 지향 모델이 추천 특화 모델이나 LLM 기반 재순위화와 다른 품질과 지연 시간의 상충점을 제공하는지 확인하려 했습니다. 이 연구는 새 추천 모델을 제안하지 않고, 같은 조건에서 여러 방법을 측정해 비교하는 데 목적을 둡니다.
실험 설계: 같은 후보 집합, 다섯 가지 재순위화 방법
이런 비교에서 결과를 좌우하는 것은 후보 집합을 어떻게 만드느냐입니다. 연구팀은 재순위화 능력만 따로 측정할 수 있도록 후보 집합을 통제했습니다.
어려운 후보 집합 만들기
후보 집합을 무작위로 뽑으면 사용자의 관심과 무관한 상품이 많이 섞여 문제가 지나치게 쉬워집니다. 그래서 연구팀은 1단계 검색 모델로 SASRec 을 학습한 뒤, SASRec이 높게 순위를 매긴 상품을 오답 후보로 썼습니다. 사용자가 실제로 다음에 상호작용한 상품 하나에, SASRec 상위 순위의 다른 상품 K-1 개를 더해 후보 집합을 만드는 방식입니다. 오답 후보가 사용자의 행동 패턴상 그럴듯한 상품이라 구분하기 어렵습니다.
평가 대상은 정답 상품이 SASRec 상위 200위 안에 들어 있는 사용자로 한정했습니다. 검색 단계에서 이미 정답을 놓친 경우를 빼서 재순위화 성능만 보기 위해서입니다. 그 결과 Movies and TV 954명, Video Games 1,000명(대상자가 더 많아 1,000명으로 제한), Books 626명을 평가했습니다. 후보 수 K 는 20, 50, 100, 200 네 가지로 바꿨고, 모든 방법이 같은 사용자의 같은 후보 집합을 같은 순서로 받습니다. 후보 순서는 SASRec 순위가 드러나지 않도록 결정적으로 섞었습니다.
데이터는 Amazon Reviews 2023의 세 영역(Movies and TV, Video Games, Books)에서 상호작용이 5건 이상인 사용자와 상품만 남긴 설정을 그대로 썼습니다. 텍스트를 읽는 방법에는 상품 제목, 카테고리, 설명 앞 250자를 넣었고, 사용자 이력은 최근 상호작용 10개를 넣었습니다.
비교한 방법
| 방법 | 종류 | 점수를 얻는 방식 |
|---|---|---|
| Jev | 결정 지향 모델 (호스팅 API, jev-latest) |
이력을 상태로, 후보 K 개를 선택지로 넣은 Choice 질문 1회. 반환된 확률을 그대로 점수로 사용 |
| Pointwise Qwen2.5 7B Instruct | LLM 재순위화 | 후보마다 "다음에 상호작용할까"를 묻고 1 과 0 토큰의 로짓으로 확률 계산 (K 회 실행, 배치 16) |
| Listwise Qwen2.5 7B Instruct | LLM 재순위화 | 후보 전체에 라벨을 붙여 한 번에 넣고, 라벨 토큰의 로짓을 정규화 (1회 실행) |
| SASRec | 추천 특화 순차 모델 | 1단계 검색 점수를 그대로 사용 (재순위화 없음과 같음) |
| DCNv2 | 추천 특화 순위 모델 | 이력 임베딩과 후보 임베딩을 교차 네트워크로 채점 |
Qwen 두 방식 모두 자유 형식 텍스트를 생성하지 않고 로짓에서 바로 점수를 얻습니다. 연구팀은 Qwen2.5 7B Instruct를 bfloat16으로 로컬에서 실행했다고 밝혔고, 추천 데이터로 미세조정(fine-tuning)했다는 설명은 없습니다. 반면 SASRec과 DCNv2는 영역마다 따로 학습했습니다.
SASRec 행은 조금 다르게 읽어야 합니다. 후보 집합 자체가 SASRec 상위 순위에서 만들어졌으므로, SASRec 점수로 정렬하면 원래 검색 순서가 그대로 나옵니다. 따라서 어떤 재순위화 방법이 SASRec보다 낮다면, 그 방법은 1단계 순서를 오히려 나쁘게 만든 것입니다.
평가 지표와 지연 측정 방식
정답이 하나뿐이므로 지표는 모두 정답 상품의 순위로 계산합니다. 주 지표인 NDCG@10(Normalized Discounted Cumulative Gain)은 정답이 순위 r 에 있을 때 r \le 10 이면 \frac{1}{\log_2(r+1)}, 아니면 0 입니다. 여기에 정답이 상위 10위 안에 있는지 보는 Hit Rate@10, 정답 순위의 역수 평균인 MRR(Mean Reciprocal Rank)을 함께 보고했습니다.
지연 시간은 측정 조건이 방법마다 다릅니다. SASRec, DCNv2, Qwen은 NVIDIA A800-SXM4-80GB GPU 1장에서 입력을 GPU로 옮기는 단계(Qwen은 토큰화 포함)부터 최종 정렬까지를 쟀습니다. Jev는 TypeSafe의 호스팅 API를 호출해 성공한 요청의 경과 시간을 쟀기 때문에 네트워크 왕복과 게이트웨이 처리 시간이 포함됩니다. 연구팀도 이 값을 모델 자체의 추론(inference) 시간이 아니라 "관측된 서빙 지연(observed serving latency)"이라고 부릅니다.
실험 결과
결과는 연구팀이 세운 질문 순서대로 추천 품질, 후보 수에 따른 변화, 지연 시간, 둘 사이의 상충 관계로 나눠 볼 수 있습니다.
추천 품질: 후보가 늘수록 격차가 벌어진다
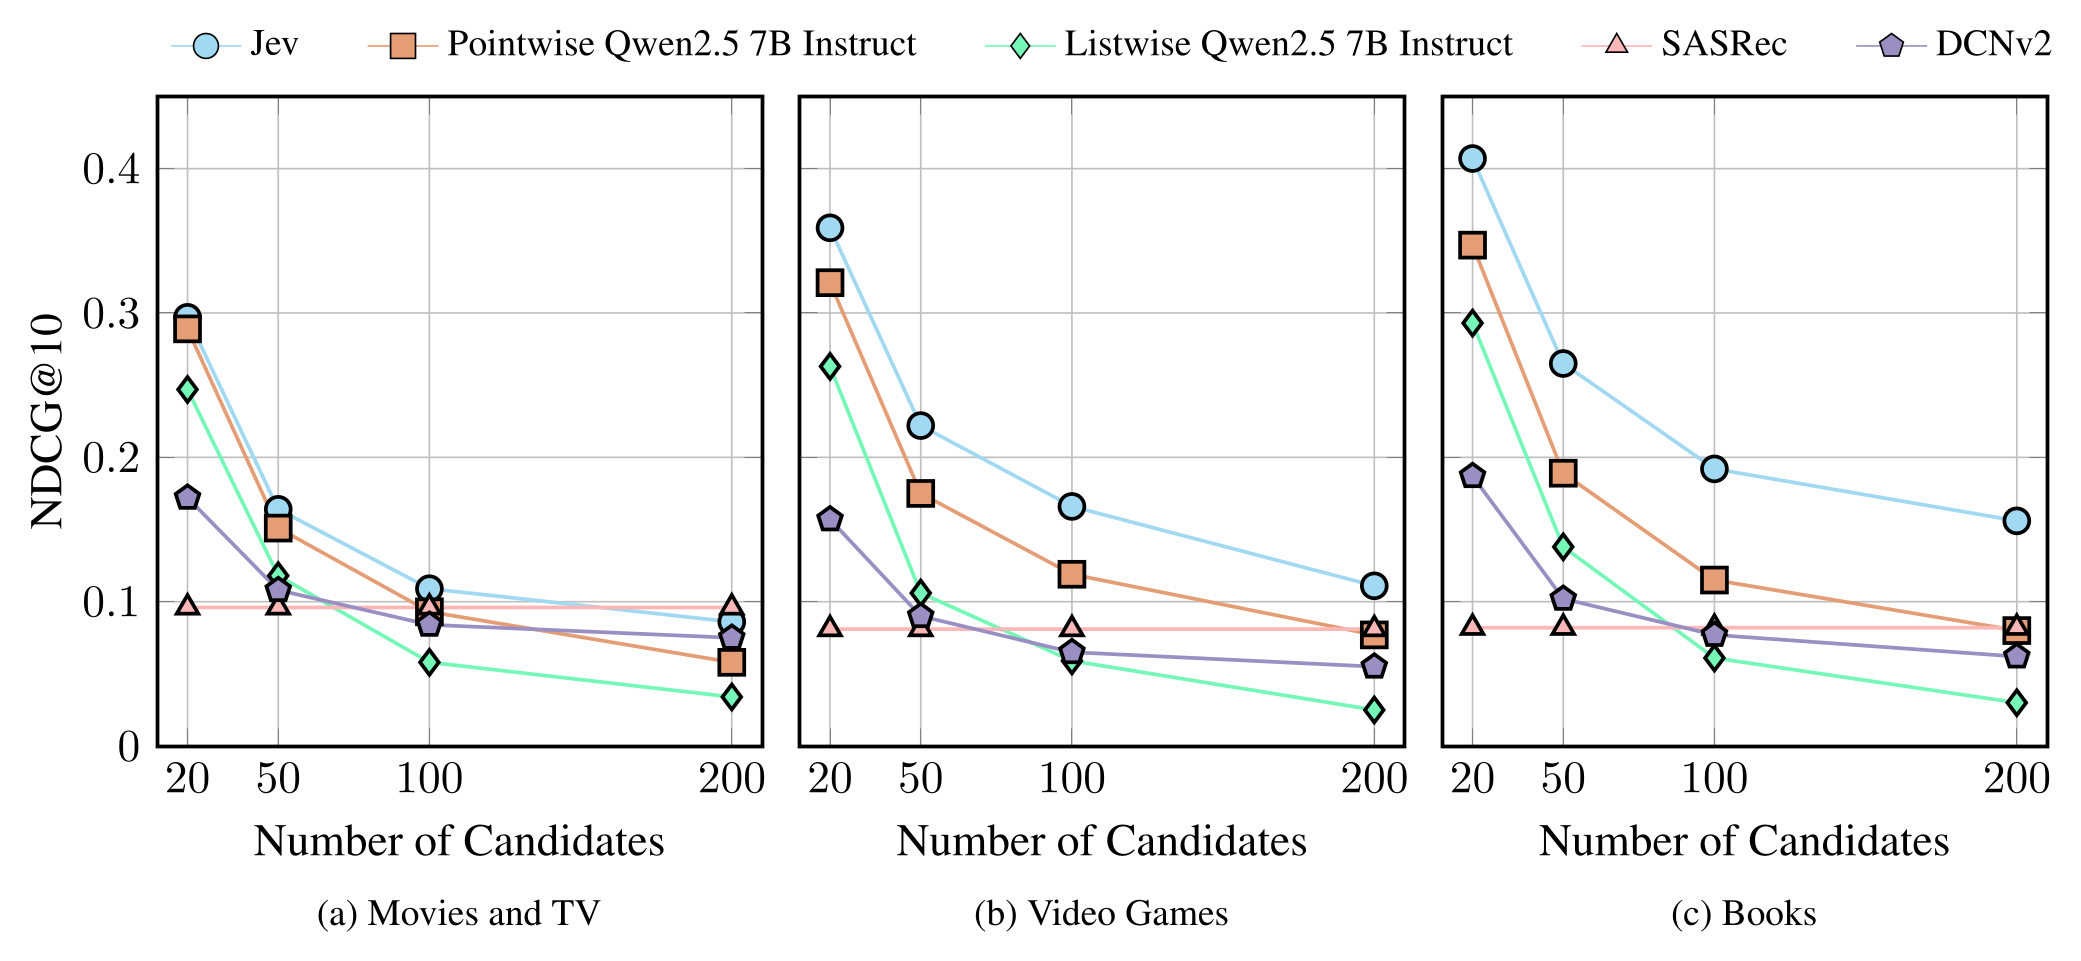
위 그림은 논문 그림 1로, 후보 수에 따른 NDCG@10을 영역별로 보여 줍니다. 후보가 늘면 정답 하나를 그럴듯한 오답 사이에서 찾아야 하므로, SASRec을 제외한 모든 방법의 품질이 떨어집니다. 차이는 떨어지는 속도에 있습니다.
NDCG@10은 그림으로만 공개되어, 아래 표는 부록에 수치로 실린 Hit Rate@10을 후보 20개와 200개 조건만 옮긴 것입니다. 각 열의 최고값은 볼드로 표시했습니다.
| 방법 | Movies K=20 | Movies K=200 | Games K=20 | Games K=200 | Books K=20 | Books K=200 |
|---|---|---|---|---|---|---|
| Jev | 0.587 | 0.150 | 0.648 | 0.216 | 0.684 | 0.251 |
| Qwen Pointwise | 0.575 | 0.109 | 0.612 | 0.161 | 0.644 | 0.161 |
| Qwen Listwise | 0.519 | 0.065 | 0.535 | 0.050 | 0.551 | 0.062 |
| SASRec | 0.170 | 0.170 | 0.161 | 0.161 | 0.166 | 0.166 |
| DCNv2 | 0.373 | 0.143 | 0.346 | 0.126 | 0.411 | 0.126 |
Video Games와 Books에서는 Jev가 네 가지 후보 수 모두에서 가장 높았고, 후보가 많아질수록 포인트와이즈 Qwen 대비 Hit Rate@10 비율이 커졌습니다. Books 후보 200개에서 Jev의 Hit Rate@10은 0.251 로 포인트와이즈 Qwen(0.161)의 약 1.6\times, MRR은 0.140 으로 포인트와이즈 Qwen(0.074)의 약 1.9\times 입니다. 반면 Movies and TV에서는 후보 20개일 때 Jev(0.587)와 포인트와이즈 Qwen(0.575)의 차이가 작습니다.
두 Qwen 방식은 서로 다른 모습을 보였습니다. 연구팀은 후보 수가 작을 때는 두 방식의 차이가 비교적 작다고 설명합니다. 하지만 후보 200개에서는 리스트와이즈 Qwen의 Hit Rate@10이 영역에 따라 0.050 에서 0.065 사이로 떨어졌습니다. 이는 세 영역 모두에서 SASRec의 원래 순서보다 낮은 값입니다. 연구팀은 이를 근거로 "작은 후보 집합에서 얻은 결론이 큰 재순위화 문제로 일반화되지 않을 수 있다"고 지적합니다.
SASRec의 원래 순서가 더 나은 구간: Movies and TV의 후보 200개
논문 본문과 그림 설명은 Jev가 "후보 수가 클수록 특히 강한 상대 성능"을 보였다고 요약하지만, 부록 표를 열 단위로 보면 예외가 하나 있습니다. Movies and TV의 후보 200개 조건에서는 SASRec이 Hit Rate@10 0.170, MRR 0.093 으로, Jev(0.150, 0.080)를 포함한 모든 재순위화 방법보다 높았습니다. 그림 1에서도 이 조건의 NDCG@10은 SASRec이 Jev보다 위에 있습니다.
앞에서 설명했듯 SASRec 행은 1단계 검색 순서 그대로입니다. 이 조건에서는 어떤 방법으로 재순위화해도 1단계 순서보다 결과가 나빠졌습니다. Movies and TV 영역 후보 100개 조건에서도 Jev의 Hit Rate@10(0.190)은 SASRec(0.170)보다 약간 높은 정도였습니다. 연구팀은 이 영역에서 차이가 작은 이유를 따로 분석하지 않았습니다.
후보 200개로 범위를 넓혀 보면 이 현상은 Movies and TV만의 일이 아닙니다. 같은 조건에서 포인트와이즈 Qwen의 Hit Rate@10은 세 영역에서 각각 0.109, 0.161, 0.161 로, SASRec(0.170, 0.161, 0.166)보다 낮거나 같았습니다. DCNv2와 리스트와이즈 Qwen도 마찬가지였습니다. 후보 200개에서 SASRec의 원래 순서를 Hit Rate@10과 MRR 모두에서 넘어선 방법은 Video Games와 Books의 Jev뿐입니다.
지연 시간: 포인트와이즈 Qwen은 후보 수에 비례해 늘어난다
부록에 실린 사용자당 지연 시간 중앙값(밀리초)을 후보 20개와 200개 조건만 옮기면 다음과 같습니다.
| 방법 | Movies K=20 | Movies K=200 | Games K=20 | Games K=200 | Books K=20 | Books K=200 |
|---|---|---|---|---|---|---|
| Jev (호스팅 API) | 459 | 627 | 570 | 967 | 542 | 866 |
| Qwen Pointwise | 607 | 6,070 | 1,480 | 14,554 | 1,525 | 14,868 |
| Qwen Listwise | 64 | 398 | 181 | 1,448 | 193 | 1,530 |
| SASRec | 1.2 | 1.2 | 1.2 | 1.2 | 1.2 | 1.2 |
| DCNv2 | 0.6 | 0.6 | 0.6 | 0.6 | 0.6 | 0.6 |
포인트와이즈 Qwen은 후보 수에 거의 비례해 지연이 늘어, 후보 200개에서 중앙값이 6 초에서 15 초에 이르렀습니다. 같은 조건에서 Jev의 중앙값은 0.6 초에서 1.0 초로, 포인트와이즈 Qwen보다 약 9.7\times(Movies)에서 17\times(Books) 짧았습니다.
리스트와이즈 Qwen과 비교하면 결과가 엇갈립니다. 후보 20개에서는 세 영역 모두 리스트와이즈 Qwen이 Jev보다 빨랐습니다. 후보 200개에서는 Video Games와 Books에서 Jev가 더 빨랐지만, Movies and TV에서는 여전히 리스트와이즈 Qwen(398 ms)이 Jev(627 ms)보다 빨랐습니다. 추천 특화 모델인 SASRec과 DCNv2는 후보 수와 관계없이 1 ms 안팎으로, Jev보다 수백 배 이상 빠릅니다.
Jev의 지연은 측정값의 흩어짐도 큽니다. Movies and TV 후보 20개 조건에서 Jev의 25번째와 75번째 백분위수는 각각 294 ms와 708 ms였고, 중앙값은 후보 50개(350 ms)가 후보 20개(459 ms)보다 오히려 짧았습니다. 연구팀은 실패한 요청과 재시도를 포함한 종단 간 지연도 따로 기록했다고 밝혔지만, 그 수치나 실패 비율은 공개하지 않았습니다.
참고로 TypeSafe는 Jev 소개 블로그에서 응답 시간을 70 ms에서 500 ms로 제시했고, 서비스가 미국 서부에 있다고 밝혔습니다. 이번 논문의 Jev 중앙값은 350 ms에서 967 ms 사이였으며, 연구팀은 API 요청을 어디에서 보냈는지 밝히지 않았습니다.
품질과 지연의 상충: 비지배 경계 위의 Jev
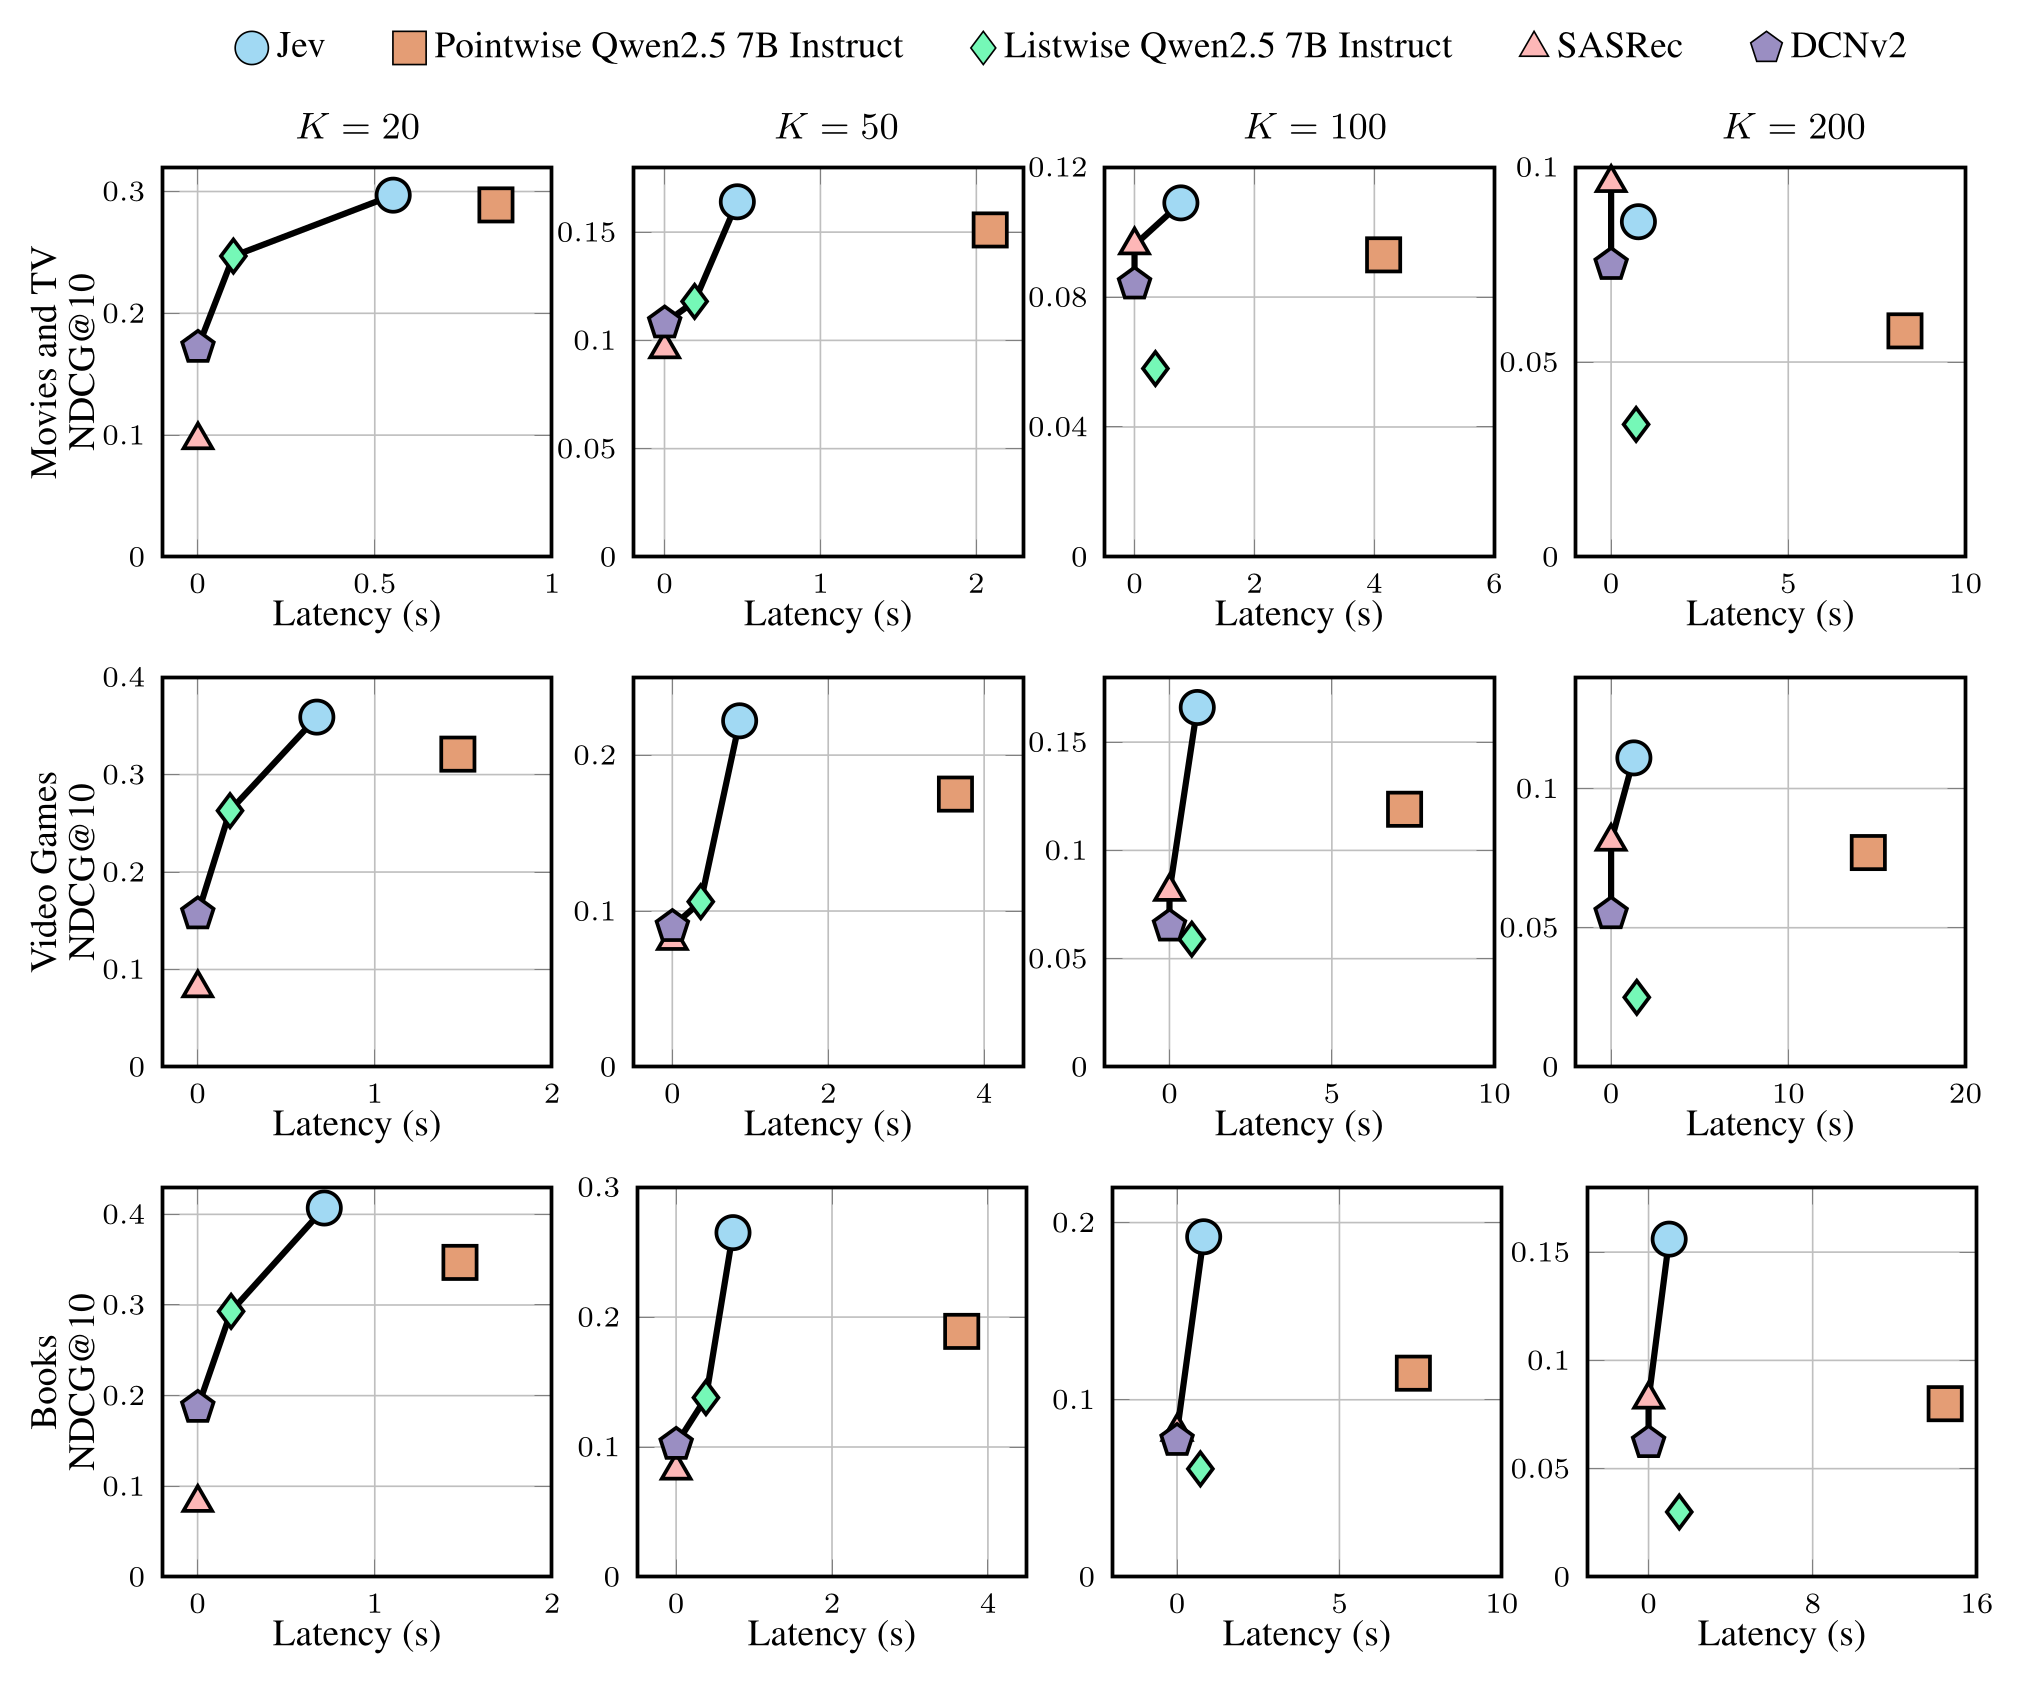
위 그림은 논문 그림 3으로, 가로축이 지연 시간, 세로축이 NDCG@10입니다. 검은 선은 비지배(non-dominated) 방법을 잇습니다. 비지배 방법은 평가한 방법 중 자기보다 지연이 짧으면서 품질도 높은 방법이 없는 방법입니다.
SASRec과 DCNv2는 지연이 가장 짧은 왼쪽 아래에, 포인트와이즈 Qwen은 품질은 비교적 높지만 지연이 긴 오른쪽에 모입니다. 리스트와이즈 Qwen은 후보가 많을수록 품질이 낮은 영역으로 내려갑니다. Jev는 12개 조건 중 Movies and TV 후보 200개를 제외한 11개에서 이 경계 위에 있습니다. 연구팀은 이를 "평가한 환경 안에서 구별되는 품질과 지연의 작동 지점"이라고 표현합니다. 연구팀은 이것이 추천 시스템 전반의 파레토 경계를 정의한다는 근거는 아니라고 덧붙였습니다.
결과를 해석할 때 주의할 점
연구팀이 직접 밝힌 한계는 세 가지입니다.
첫째, 결정 지향 모델은 Jev 하나만 평가했습니다. 연구팀은 Jev의 아키텍처, 학습 절차, 서빙 구현에 접근할 수 없어 이런 차이가 왜 생기는지 설명할 수 없다고 밝혔습니다. 지연 특성이 모델에서 오는지, 서빙 시스템에서 오는지, 둘 다인지 알 수 없으므로 결과를 결정 지향 모델 전체의 장점으로 일반화하지 말라고 당부합니다.
둘째, LLM 비교 대상은 Qwen2.5 7B Instruct 한 종류뿐입니다. 더 큰 모델이나 상용 LLM은 다른 품질과 서빙 비용을 보일 수 있습니다. 연구팀도 결론이 평가한 Qwen 구성에만 해당하고, LLM 재순위화 전체에 대한 것은 아니라고 적었습니다.
셋째, 지연 시간은 하드웨어를 맞춘 비교가 아닙니다. 로컬 모델은 GPU 1장에서, Jev는 하드웨어와 배치 전략이 공개되지 않은 원격 서비스에서 측정했습니다.
논문을 읽으며 함께 짚어 둘 점도 있습니다. 먼저 Qwen을 추천 데이터로 미세조정했다는 설명이 없고, RecRanker처럼 추천에 맞춰 지시 조정한 LLM 재순위화는 비교에 들어가지 않았습니다. 포인트와이즈 Qwen은 후보마다 같은 사용자 이력을 반복해 넣는 구조인데, 공통 접두부 캐싱 같은 서빙 최적화를 적용했는지는 논문에 적혀 있지 않습니다. 또한 반복 실행 결과나 신뢰 구간, 유의성 검정이 보고되지 않아서, Movies and TV 후보 20개처럼 차이가 0.01 안팎인 비교는 순위를 단정하기 어렵습니다. TypeSafe가 내세우는 장점 중 하나가 비용인데, 이번 연구는 호출 비용을 측정하지 않았습니다.
마치며
연구팀은 이 연구를 추천 재순위화에서 Jev의 특성을 측정한 초기 실증 연구라고 소개합니다. 후보 200개에서 Jev는 포인트와이즈 7B LLM보다 지연 시간 중앙값이 9.7\times 이상 짧았고, 세 영역 모두에서 더 정확했습니다. 연구팀은 이를 근거로 "출력이 정해진 선택지에 대한 순위인 추천 과제에서는 구조화된 결정 방식을 더 검토할 가치가 있다"고 결론짓습니다.
동시에 이 실험에는 어떤 재순위화 방법도 1단계 검색 순서를 개선하지 못한 조건이 있었습니다. 재순위화 방법을 고를 때는 후보 수와 영역을 바꿔 가며 검색 모델의 원래 순서와 직접 비교해 볼 필요가 있습니다.
연구팀은 후속 과제로 더 크고 다양한 LLM, 다른 결정 지향 모델, 다른 검색 파이프라인, 실제 서비스 환경으로의 확장을 꼽았습니다. 논문 공개 무렵에는 Jev와 같은 요청 형식을 쓰는 결정 모델도 나왔습니다. 다만 오픈 가중치인 Laya는 저장소 문서에서 choice 질문의 선택지를 약 20개 안쪽으로 두라고 권하고, HTTP 서버는 질문당 선택지를 100개로 제한해 이번 실험의 후보 200개 조건에 그대로 쓰기는 어렵습니다. Liquid AI의 d1은 현재 API로만 제공되어, Jev와 마찬가지로 모델과 서빙 환경의 영향을 나눠 보기 어렵습니다.
 Decision-Oriented Recommendation Reranking: An Empirical Study of Jev 논문
Introducing System One Models & Jev 소개 블로그
 TypeSafe AI Choice 질문 문서
 Amazon Reviews 2023 데이터셋
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
Laya: 텍스트 생성 없이 한 번의 순전파로 결정을 내리는 Jev 호환 오픈 가중치 모델과 로컬 실행 도구들
-
Liquid AI, 문장 생성 대신 Jev 호환 API로 분류 / 라우팅 / 점수를 처리하는 결정 모델 d1 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
