kev 소개
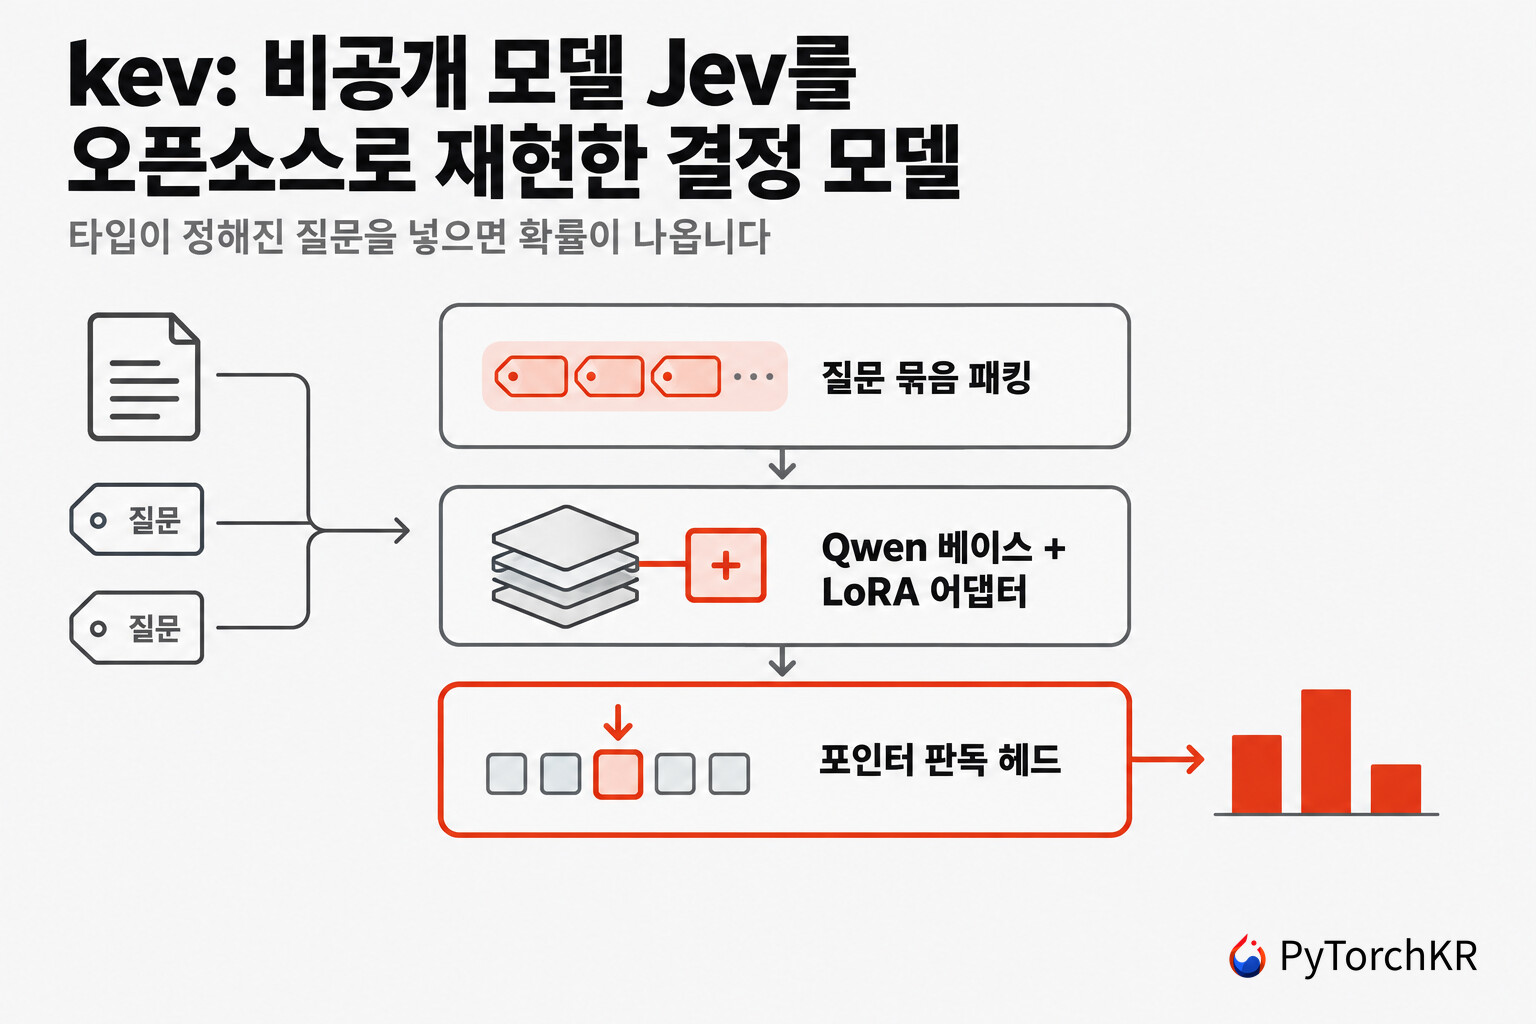
소프트웨어가 사람 손을 거치지 않고 내리는 판단, 예를 들어 들어온 문의를 어느 팀으로 보낼지나 이 요청을 사람에게 넘길지 같은 결정을 대형 언어 모델(Large Language Model, LLM)에 맡기면 한 가지 문제가 남습니다. 모델은 "confidence": 0.9 라는 글자를 만들어 낼 뿐이고, 그 글자가 나올 확률과 답이 실제로 맞을 확률은 서로 다른 값입니다. 구조화된 출력(Structured Output)이나 함수 호출로 응답 형식을 강제해도 이 간극은 그대로 남고, 판단 하나를 위해 토큰을 한 개씩 생성하는 비용도 함께 남습니다. 이번에 소개하는 kev는 그 자리에 텍스트 생성 대신 확률 판독을 놓은 결정 모델(Decision Model) 을 Qwen 베이스 모델 위에 오픈소스로 재현한 프로젝트입니다.
kev는 Qwen (
 Qwen3: 더 깊게 사고하고, 더 빠르게 반응하는 대규모 언어 모델) 베이스 모델에 LoRA(Low-Rank Adaptation) 어댑터와 작은 포인터 판독 헤드(Pointer Readout Head)를 붙인 구조입니다. 문서 하나를 상태(state)로 한 번 읽은 뒤, 그 문서에 대한 여러 개의 타입이 정해진 질문을 한 번의 프리필(prefill) 패스에서 동시에 답합니다. 문서와 모든 질문은 하나의 토큰 시퀀스로 묶이고, 블록 인과 마스크(block-causal mask)가 각 질문이 문서는 볼 수 있지만 다른 질문은 볼 수 없도록 막습니다. 마지막에 포인터 헤드가 질문마다 선택지를 결정 토큰과 견주어 점수를 매기고 소프트맥스를 적용하며, 그렇게 나온 확률 분포가 곧 응답입니다. 디코딩 단계가 아예 없으므로 kev는 글자를 한 자도 생성하지 않습니다.
kev가 재현 대상으로 삼은 Jev ( Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI))는 TypeSafe AI가 얼리 액세스로 제공하는 유료 호스팅 모델이라 가중치가 공개되어 있지 않습니다. kev는 Archer Hume이 Jev's Architecture Unmasked에서 공개 API를 탐침해 복원한 아키텍처를 따라 구현했고, TypeSafe의 System One API 계약까지 맞춰 두어 공식 파이썬 SDK인 typesafe-sdk의 base_url 만 바꾸면 로컬 kev 서버를 그대로 호출할 수 있습니다. 저장소를 공개한 Jared Palmer는 Cognition의 VP Engineering이며, 모델 카드에는 같은 회사의 코딩 에이전트 Devin과 함께 작업했다고 적혀 있습니다. 구현에는 Python 3.12 이상과 PyTorch, PEFT, FastAPI를 사용합니다.
kev vs. Jev
kev와 Jev의 관계는 복제가 아니라 공개된 근거까지만 따라간 재구성에 가깝습니다. Archer Hume의 복원 글은 Jev의 백본으로 희소 전문가 혼합(Sparse Mixture-of-Experts) 구조를 추정하면서도, 그 부분이 가장 불확실하며 조밀한(dense) 트랜스포머로 바꿔도 인터페이스와 공유 상태, 격리된 분기, 판독 방식은 그대로 유지된다고 밝히고 있습니다. kev는 그 여지를 이용해 조밀한 Qwen 베이스 모델을 그대로 쓰고, 나머지 세 가지를 구현했습니다.
두 모델의 성격 차이를 정리하면 다음과 같습니다:
| 항목 | kev | Jev |
|---|---|---|
| 공개 범위 | LoRA 어댑터와 판독 헤드 가중치, 학습과 평가 코드 전부 공개 | 가중치 비공개, 호스팅 API로만 제공 |
| 백본 | Qwen2.5-0.5B 또는 Qwen3 0.6B/4B/8B Base, 조밀한 구조 | 비공개, 복원 글은 희소 전문가 혼합으로 추정 |
| 학습 방식 | LoRA r=16 어댑터와 처음부터 학습한 포인터 헤드, 교차 엔트로피 | 비공개, TypeSafe는 보정된 결정을 위한 강화학습(Reinforcement Learning for Calibrated Decisions, RLCD)이라고 설명 |
| 실행 위치 | 로컬, 32GB 맥에서 bf16으로 서빙 | TypeSafe 클라우드 |
| 컨텍스트 | 서빙 시 분기당 8,192 토큰 | 분기당 약 32k 토큰 |
| 학습에 없던 출처에서의 정확도 | kev-4b 0.759, kev-8b 0.774 | 0.857 |
마지막 행이 이 프로젝트의 솔직한 부분입니다. kev는 동결한 평가 항목 위에서 진짜 Jev를 같은 조건으로 함께 채점했고, 그 결과 자신이 8에서 10포인트 뒤진다는 수치를 README와 모델 카드에 그대로 실었습니다. Jev 호출은 Vercel AI Gateway를 거쳐 스위트당 2센트 정도의 비용으로 수행했으며, Jev가 이 공개 데이터셋들을 학습에 썼는지는 알 수 없으므로 통제된 비교가 아니라 같은 항목을 함께 푼 비교라는 점도 저장소가 함께 밝히고 있습니다. 반대 방향으로는 4B와 8B 모델 카드가 학습에 Jev의 출력을 전혀 쓰지 않았다고 명시하고 있어, kev는 Jev를 증류(Distillation)한 것이 아니라 공개된 설명만 보고 다시 만든 쪽에 해당합니다.
kev를 사용하면 좋을 사용자
결정 모델이라는 구조가 실제로 어떻게 동작하는지 코드 수준에서 확인하려는 연구자와 엔지니어에게 kev가 가장 잘 맞습니다. 블록 인과 마스크와 질문 격리, 포인터 판독, 보정(Calibration) 측정이 모두 짧은 파이썬 파일 몇 개에 담겨 있고(kev/model.py 175줄, kev/api.py 111줄, kev/serve.py 174줄), 32GB 맥북에서 4B 체크포인트를 띄워 직접 호출해 볼 수 있으며, 학습 재현 명령과 동결된 평가 스위트까지 공개되어 있습니다. TypeSafe API 계약을 그대로 구현했으므로 Jev를 도입하기 전에 자기 데이터로 이 방식이 맞는지 미리 시험해 보려는 팀에게도 쓸모가 있습니다.
반대로 사람에게 영향을 주는 판단을 자동화하려는 팀에게는 kev가 아직 적절한 선택지가 아닙니다. 모델 카드는 콘텐츠 중재(Moderation), 사기 탐지, 신용, 채용, 의료와 법률 라우팅에 쓰지 말라고 명시하고, 0.6B/4B/8B 체크포인트 세 개는 모두 저자가 미리 선언한 출시 기준인 학습에 없던 규칙 조합에서 짝 문항 양쪽이 모두 정답인 비율 70% 이상을 통과하지 못해 버전 태그 없는 연구 프리뷰로 공개되어 있습니다. 한국어 사용자에게는 언어 문제도 있습니다. 네 체크포인트의 Hugging Face 카드는 모두 language: en 으로 표기되어 있고 학습에 쓴 공개 데이터셋도 전부 영어이므로, 한국어 입력에서의 동작은 측정된 적이 없습니다.
kev의 동작 원리: 상태는 한 번, 질문은 서로 격리
kev는 요청 하나를 단일 토큰 시퀀스로 펼칩니다. 상태가 앞에 놓이고 질문마다 지시문, 선택지들, 결정 토큰이 뒤따르는 형태입니다:
<state> …state…
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>    ← question 1
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>    ← question 2
이 다섯 개의 구분자는 새로 추가한 토큰이 아니라 Qwen이 이미 가지고 있던 잘 쓰이지 않는 특수 토큰(<|fim_prefix|>, <|fim_middle|>, <|box_start|>, <|box_end|>, <|fim_suffix|>)을 재사용한 것이라고 kev/model.py에 적혀 있습니다. 임베딩 행을 새로 만들어 학습시킬 필요가 없고, 의미는 LoRA가 적응시킵니다. 사용자가 보낸 텍스트는 토큰화 직전에 <|name|> 꼴을 <¦name¦> 으로 바꿔 넣기 때문에 본문에 구분자처럼 생긴 문자열을 적어도 선택지 경계를 위조할 수 없습니다.
격리는 어텐션 마스크가 담당합니다. 같은 파일의 조건은 attend(i,j) iff j<=i and (seg[j]==0 or seg[j]==seg[i]) 한 줄이며, seg 값 0이 상태이고 1 이상이 각 질문 분기입니다. 상태 토큰은 한 번만 계산되고 모든 질문이 그 계산 결과를 함께 읽으며, 질문 분기끼리는 서로를 전혀 보지 못합니다:

위 그림은 상태 접두 문맥 하나를 두 질문 분기가 함께 읽고 두 분기 사이에는 어텐션이 없다는 것을 보여줍니다. 여기에 더해 각 분기는 상태가 끝난 지점에서 위치 인덱스를 다시 시작합니다. 모든 질문이 언제나 상태와 자기 질문 하나만 보게 되므로 요청에 질문을 넣는 순서가 답에 영향을 주지 않습니다.
마지막 판독은 포인터 헤드가 맡습니다. <decide> 토큰의 은닉 상태를 질의로, 각 선택지를 닫는 </opt> 토큰의 은닉 상태를 키로 두고 내적을 계산한 뒤 소프트맥스를 적용하는 단순한 구조입니다:
class PointerHead(nn.Module):
    def __init__(self, d, dp=256):
        """dp = pointer dimension (head capacity knob)."""
        super().__init__()
        self.q, self.k = nn.Linear(d, dp), nn.Linear(d, dp)
        self.scale = 1 / math.sqrt(dp)

    def forward(self, h_decide, h_opts):  # [d], [K,d] -> logits [K]
        return (self.k(h_opts) @ self.q(h_decide)) * self.scale
선택지 개수 K 는 헤드에 고정되어 있지 않고 요청이 보낸 만큼 그때그때 정해집니다. 그리고 <decide> 가 모든 선택지 뒤에 놓이기 때문에 모델은 점수를 매기기 전에 목록 전체를 읽으며, 저장소는 이 순서 덕분에 None of the above 와 같은 선택지가 제대로 동작한다고 설명합니다. kev-0.5b 기준으로 학습 가능한 파라미터는 LoRA 8.8M과 헤드 0.46M을 합쳐 9.3M이고, 이는 백본의 1.9%에 해당합니다.
kev의 세 가지 질문 유형과 System One API 호환성
kev가 노출하는 질문 유형은 TypeSafe가 정의한 세 가지와 같고, 세 유형 모두 위의 포인터 하나로 환원됩니다:
| 질문 유형 | 선택지 구성 | 응답 필드 | 확률 분포에서 유도하는 방법 |
|---|---|---|---|
noul |
[false, true] 두 개로 고정 |
noul |
p[yes] |
choice |
이름과 설명이 붙은 선택지 목록, 최대 255개 | choice, probabilities, confidence |
argmax, 선택지 키별 p, (p_max - 1/K) / (1 - 1/K) |
score |
순서가 있는 등급 설명 목록 | score, legend, probabilities, confidence |
Σ k·p[k], 등급 인덱스에서 텍스트로, 등급별 p |
서버를 띄운 뒤 문의 하나에 세 가지 유형을 섞어 던지는 요청은 다음과 같습니다:
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department":  {"type": "choice", "instructions": "Which team should handle this?",
                    "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                 "shipping": "Delivery status, delays, lost packages",
                                 "billing": "Charges, invoices, payment problems"}},
    "escalate":    {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration": {"type": "score", "instructions": "How frustrated is the customer?",
                    "criteria": ["Calm", "Frustrated", "Very angry"]}
  }}'
응답에는 선택된 값과 함께 선택지별 확률 분포가 그대로 들어옵니다. 아래는 M5 맥에서 bf16으로 kev-4b 를 실행했을 때의 결과입니다:
{
  "model": "kev-latest",
  "answers": {
    "department":  { "type": "choice", "choice": "returns", "confidence": 0.83,
                     "probabilities": { "returns": 0.89, "shipping": 0.04, "billing": 0.07 } },
    "escalate":    { "type": "noul", "noul": 0.54 },
    "frustration": { "type": "score", "score": 1.25, "confidence": 0.88,
                     "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
                     "probabilities": { "0": 0.00, "1": 0.75, "2": 0.25 } }
  },
  "usage": { "input_tokens": 101, "output_tokens": 161 },
  "latency_ms": 277
}
같은 요청을 공식 SDK로 보내면 base_url 한 줄만 로컬 주소로 바꾸면 됩니다:
from typesafe_sdk import TypeSafeClient, Choice, Noul, Score

client = TypeSafeClient(api_key="local", base_url="http://127.0.0.1:8009", model="kev-latest")
r = client.system_one(
    state="I was charged twice. Please fix this ASAP.",
    questions={
        "billing": Noul(instructions="Is this ticket about billing?"),
        "tone": Choice(instructions="What is the customer's tone?", criteria={"calm": None, "frustrated": None, "angry": None}),
        "urgency": Score(instructions="How urgent is this ticket?", criteria=["can wait", "this week", "today"]),
    },
)
r.nouls["billing"].noul, r.choices["tone"].choice, r.scores["urgency"].score
기본 엔드포인트 외에 실험용 엔드포인트 두 개가 더 있는데, 둘 다 이 구조가 주장하는 성질을 직접 확인하기 위한 것입니다:
| 메서드 | 경로 | 용도 |
|---|---|---|
GET |
/v1/models |
모델, 베이스, 실행 중인 체크포인트 정보 |
POST |
/v1/systemone/permute |
Choice 질문 하나를 N가지 선택지 순서로 다시 질의 |
POST |
/v1/systemone/separate |
질문을 각각 별도 패스로 처리해 묶음 처리와 비교 |
다만 서버에는 인증이 없으며, 저장소는 로컬 사용을 전제로 한다고 밝히고 있습니다. 호환성 주장은 테스트로도 받쳐 두었는데, tests/test_api.py가 TypeSafe 공식 문서의 예제 요청과 공식 SDK를 로컬 서버에 그대로 실행합니다.
kev의 학습 레시피에서 확인된 것
학습 데이터는 공개 데이터셋을 TypeSafe 요청 형태로 변환한 것과, 프로그램으로 생성한 정책 규칙 쌍입니다. 처음 공개된 kev-0.5b 는 Banking77, AG News, MNLI, BoolQ, SST-5, Yelp 여섯 개 소스에서 9,000건을 추출해 학습했고, 현재 레시피는 공개 소스 10~13개를 각 1,000건씩과 448건짜리 프로그램 생성 정책 데이터 두 갈래를 더해 2 에폭을 학습합니다. 변환과 실제 요청이 같은 렌더링 코드를 지나므로 모델은 학습에서 보지 못한 형식을 추론(Inference) 시점에 만나지 않습니다.
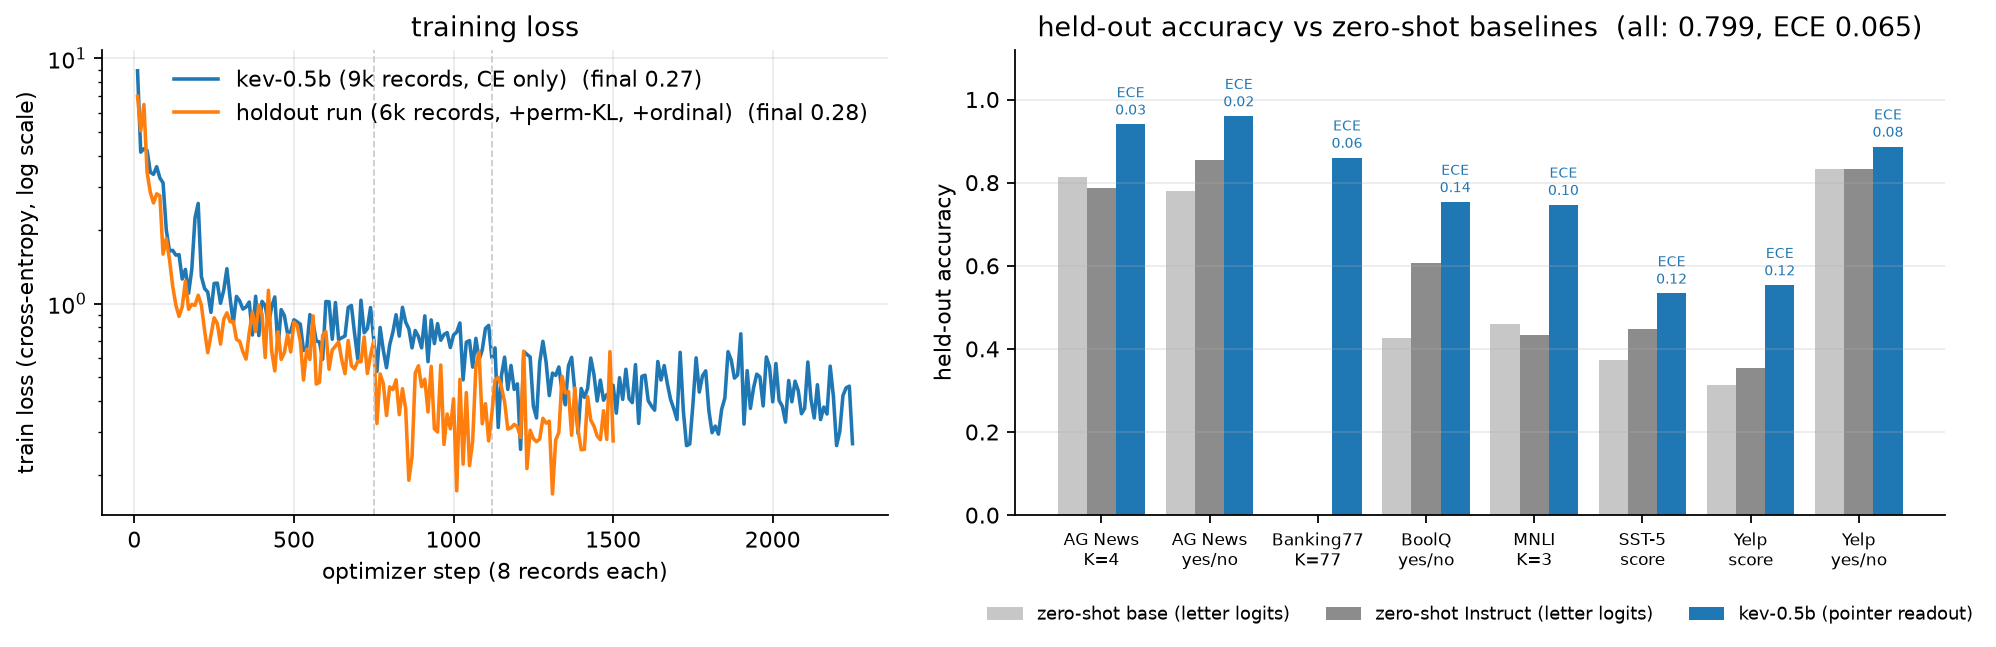
위 오른쪽 그래프는 같은 렌더링 텍스트를 놓고 선택지 알파벳의 다음 토큰 확률을 읽는 제로샷(Zero-shot) 베이스라인과 포인터 판독을 비교한 것입니다. AG News 4지선다에서 0.813에서 0.940으로, MNLI 3지선다에서 0.460에서 0.747로, BoolQ에서 0.427에서 0.753으로 올랐고, 같은 백본으로 77지선다인 Banking77에서 0.860을 냅니다. 학습에 쓰지 않고 남겨 둔 1,350개 질문 전체 기준으로 정확도는 0.799, 기대 보정 오차(Expected Calibration Error, ECE)는 0.065입니다.
저장소의 연구 기록인 PLAN.md는 어떤 조정이 실제로 효과가 있었는지를 효과 크기 순으로 정리해 두었습니다. 가장 큰 것은 백본 용량으로, 데이터를 맞춘 상태에서 0.6B에서 4B로 올릴 때 학습에 없던 출처 정확도가 14~19포인트 오릅니다. 반면 4B에서 8B로 올리는 폭은 1.5~2포인트에 그치고, 8B 모델 카드는 이 차이를 두고 학습에 없던 출처 정확도가 kev-4b와 통계적으로 구별되지 않는다고 적습니다(+0.4포인트, 95% 신뢰구간 [-3.9, +4.5]). 두 번째는 학습률입니다. 기본값인 2e-4는 베이스 모델이 이미 알고 있던 지식을 깎아내는데, 4B 베이스가 제로샷으로 MMLU에서 0.688을 내는 반면 기본 레시피로 미세조정(Fine-tuning)하면 0.60에서 0.66으로 떨어집니다. 학습률만 5e-5로 낮추면 그 손실을 대부분 되돌려 학습에 없던 출처 정확도가 4.7포인트 [+0.4, +9.6] 오르며, 이 결과는 4B와 8B 각각 세 개 시드에서 재현되었습니다.
반대로 효과가 없었던 것도 같은 문서에 남아 있습니다. 공개 데이터를 늘리면 학습 분포 안의 정확도는 오르지만 학습에 없던 출처의 정확도는 그대로이거나 떨어지고, 선택지 격리는 선택지 순서를 바꿔도 결과가 변하지 않는 성질을 정확히 보장하는 대신 4B에서 정확도를 5.8포인트 깎습니다. 저자는 저학습률 레시피 주변에서 한 번에 하나씩 바꾼 열네 가지 변형이 모두 ±1포인트 안에 들어왔다는 점을 근거로, 남은 격차는 하이퍼파라미터가 아니라 MMLU가 재는 지식, PAWS가 재는 문장 바꿔 쓰기, 잡음이 섞인 감정 분류, 날짜 계산 쪽에 있다고 정리합니다. 학습은 맥북에서도 가능하지만(kev-0.5b 기준 M5에서 약 1시간 45분) 4B와 8B 레시피는 Modal의 H100 한 장에서 40~70분씩 학습했습니다.
kev 벤치마크와 저자가 밝힌 한계
모든 수치는 동결하고 체크섬을 붙인 평가 스위트 위에서 측정합니다. 학습, 보정, 개발, 잠금 테스트 분할이 분리되어 있고 데이터셋과 베이스 모델의 리비전이 고정되어 있으며, 모델 선택에는 개발 분할만 쓰고 잠금 테스트는 공개 후보마다 단 한 번만 읽습니다. 두 번째 읽기 시도는 코드가 거부합니다.
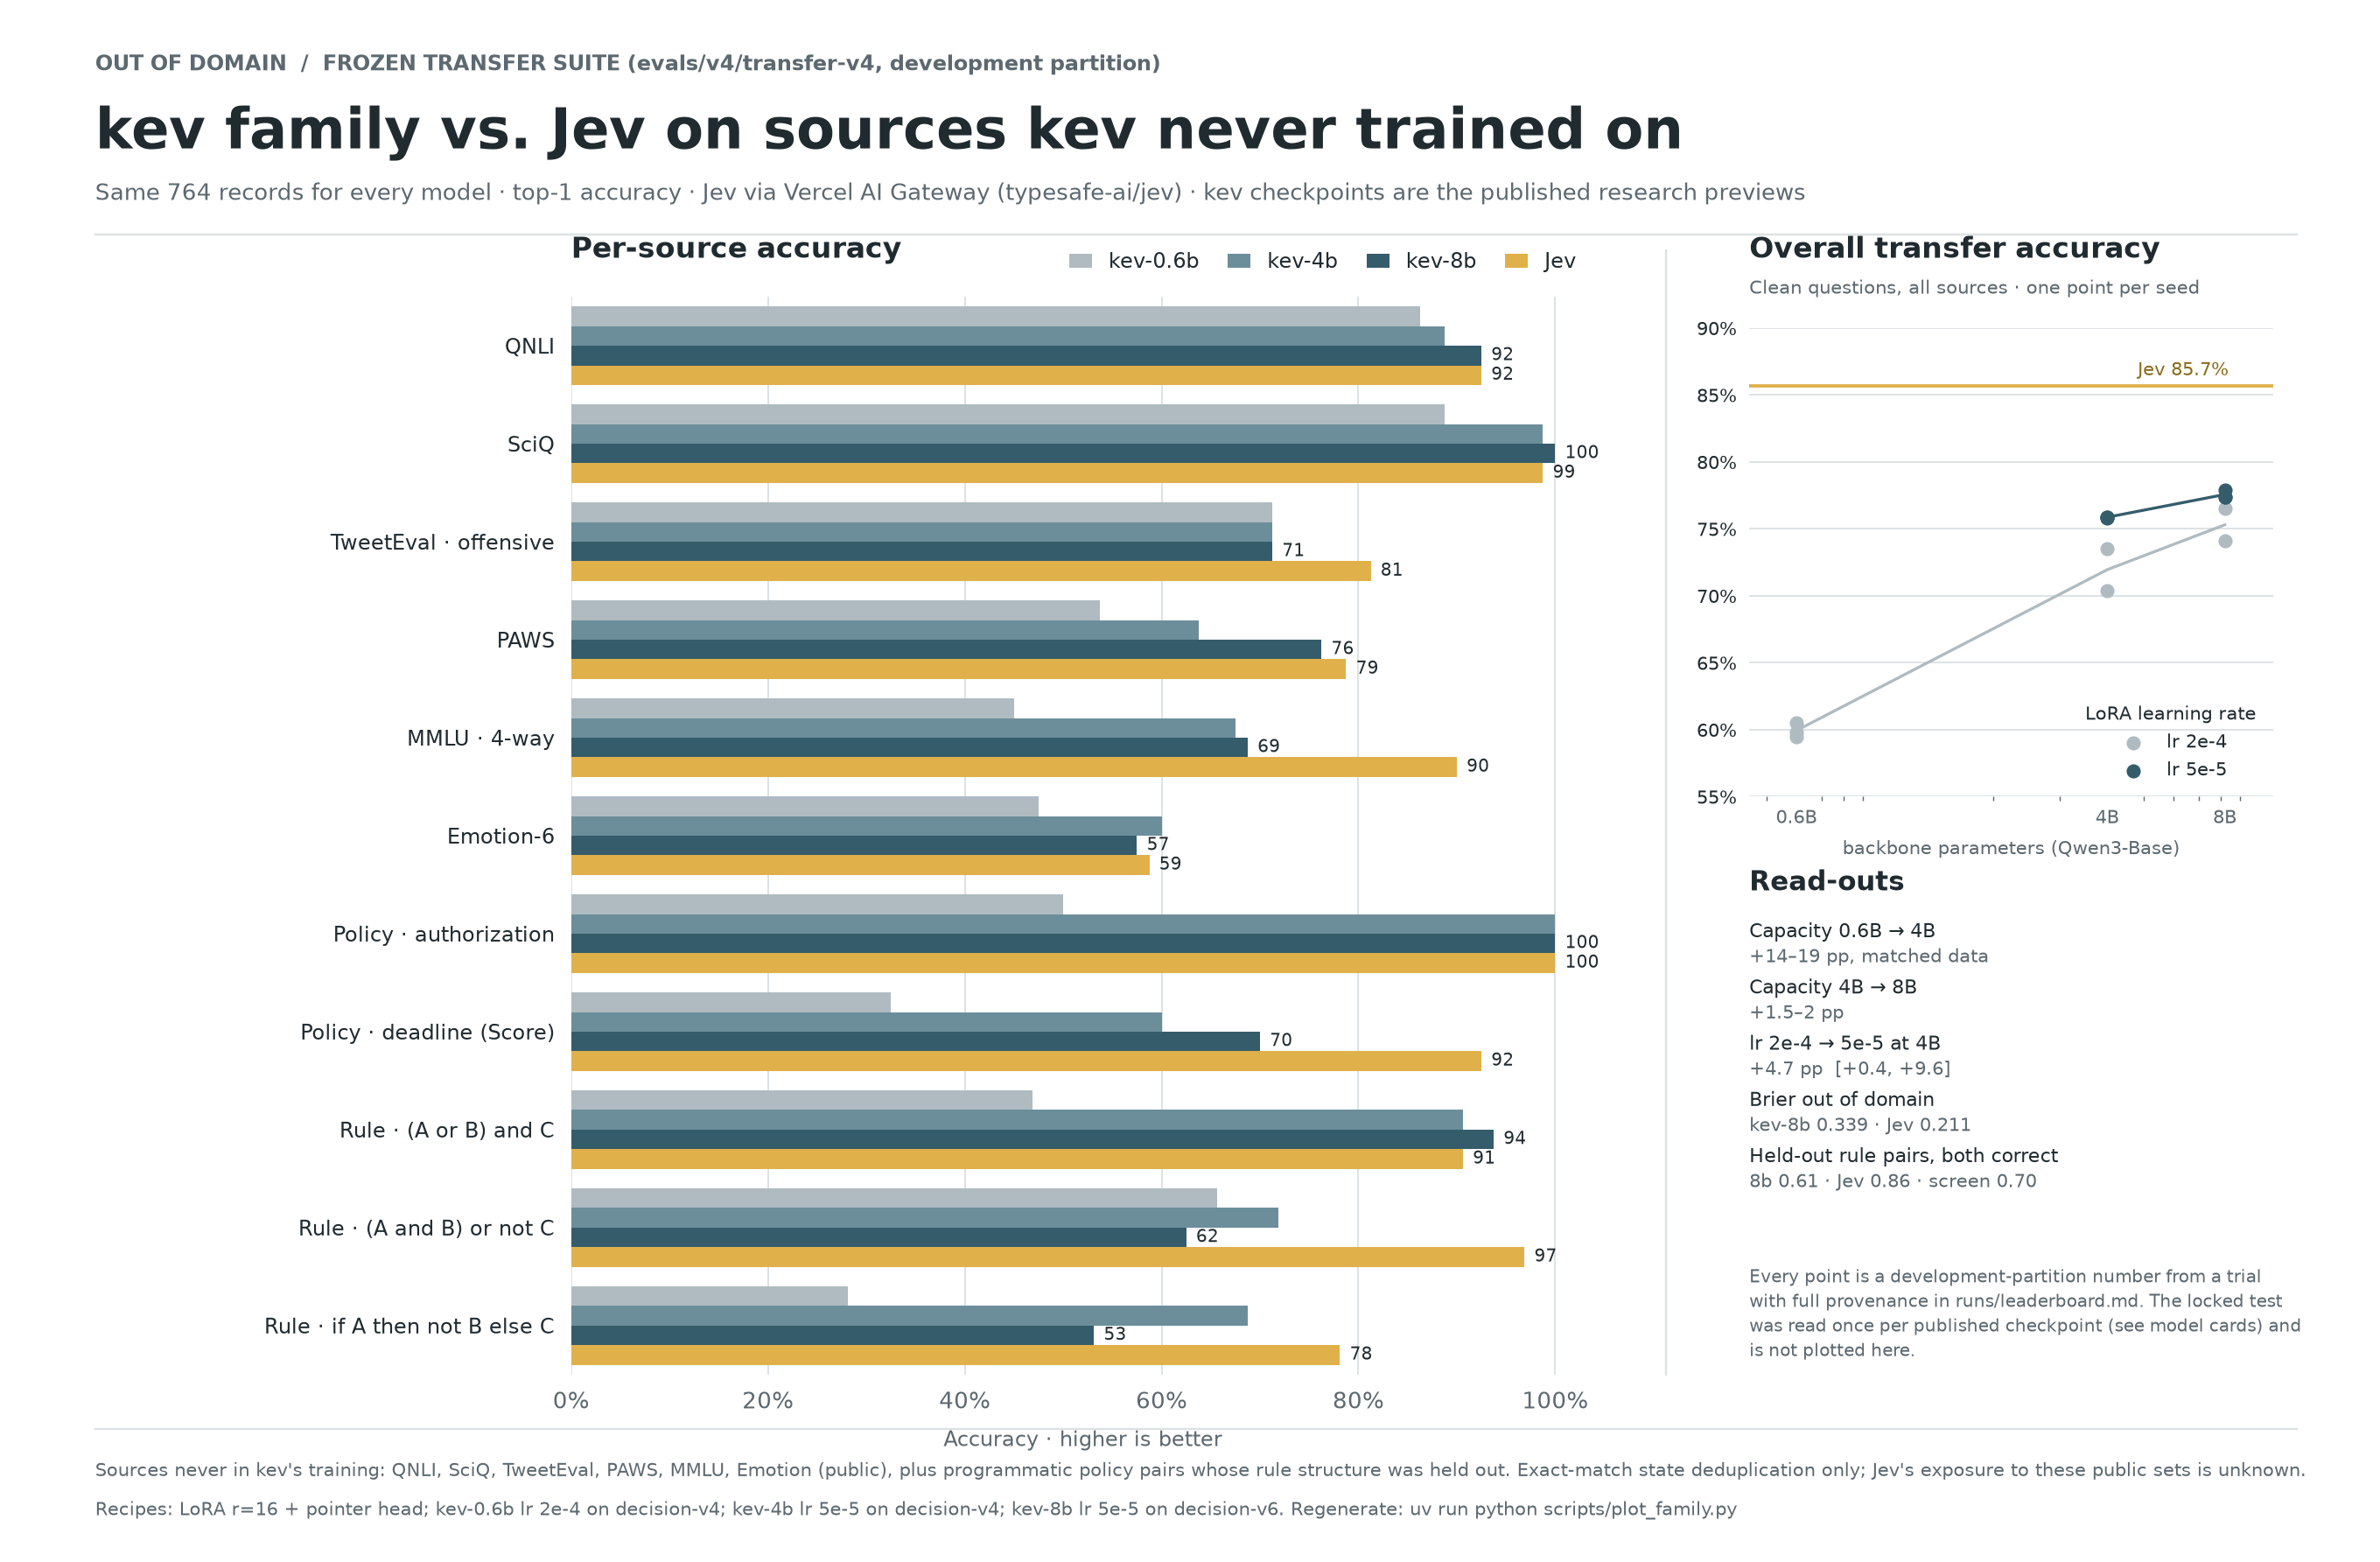
학습에 쓰지 않은 출처 764건(transfer-v4 개발 분할)에서 측정한 결과는 다음과 같습니다:
| 항목 | kev-0.6b | kev-4b | kev-8b | Jev |
|---|---|---|---|---|
| 정확도 | 0.598 | 0.759 | 0.774 | 0.857 |
| Brier 점수(낮을수록 좋음) | 0.521 | 0.346 | 0.339 | 0.211 |
| 확신에 찬 오답(p ≥ 0.9인데 틀림) | 5.2% | 5.5% | 8.2% | 3.7% |
| 학습에 없던 정책 규칙, 짝 문항 양쪽 정답 | 0.11 | 0.62 | 0.61 | 0.86 |
| 선택지 순서를 바꿨을 때 최댓값이 뒤집힌 비율 | 0.08 | 0.08 | 0.03 | 0.00 |
표의 마지막 행은 문서마다 값이 다릅니다. 같은 지표를 4B와 8B 모델 카드는 각각 0.00과 0.02로 적고 있어 README의 0.08과 0.03보다 낮습니다. 세 문서에서 일치하는 것은 Jev가 0.00이라는 값뿐입니다.
위 그래프의 출처별 막대를 보면 격차가 어디에 몰려 있는지가 드러납니다. QNLI와 정책 권한 판정에서는 kev-8b가 Jev와 같고 SciQ에서는 100 대 99로, (A 또는 B) 그리고 C 형태의 규칙에서는 94 대 91로 오히려 앞서지만, MMLU 4지선다에서 69 대 90, 마감 기한을 다루는 3등급 Score에서 70 대 92로 벌어집니다. 지식과 날짜 계산이 남은 격차의 대부분이라는 뜻이며, 8B 베이스 모델이 제로샷으로 MMLU에서 0.762를 낸다는 점을 함께 보면 판독 헤드가 베이스가 아는 것을 다 꺼내 쓰지 못하고 있다는 해석이 따라옵니다.
반면 구조가 주장하는 성질 쪽은 수치가 분명합니다. 저장소가 kev-0.5b 에서 측정하고 4B와 8B에서도 매 시행마다 재현했다고 밝힌 결과는 다음과 같습니다:
| 메커니즘 검사 | 결과 |
|---|---|
| 격리 검사, 비밀을 형제 질문에 둘 때 / 없을 때 / 상태에 둘 때 | p = 0.03 / 0.03 / 0.99 |
| 묶음 처리와 개별 처리의 최대 확률 차이 | 3.7e-6, 묶음 처리가 2.0배 빠름 |
| 선택지 순서 4가지에서 최댓값이 뒤집힌 비율 | 7.4% |
| 무관한 선택지 하나를 추가했을 때 로그 오즈 변화 | 평균 0.13, p90 0.34 |
| 경계 위조, 선택지 텍스트에 가짜 구분자를 넣었을 때 | 선택지 개수 불변, 위조된 선택지 p ≤ 0.09 |
저자가 README의 한계 절에 직접 적어 둔 항목도 함께 읽어야 합니다. 학습에 없던 출처에서 4B/8B가 Jev에 8~10포인트, 0.6B가 26포인트 뒤지고, 보정은 학습 분포 안에서만 확인되었으며 그 분포에서 맞춘 온도(temperature)는 다른 분포로 옮겨 가지 않습니다. 학습은 상태 384 토큰과 분기 1,024 토큰에서 이뤄졌고 서빙 상한은 8,192 토큰입니다. 서버는 한 번에 요청 하나만 처리하고 요청 사이 KV(Key-Value) 캐시를 공유하지 않습니다. 학습에 대응되는 예시가 없는 제품 고유의 질문에서는 동작이 보장되지 않으므로 자기 데이터로 직접 측정하라고 권하고 있습니다. Score의 확신도 계산식은 TypeSafe가 공개하지 않아 대용 공식을 쓰고 있습니다. 모델 카드는 이 프로젝트의 위치를 "It shows that the mechanism works. It is not a production model and it is not Jev." 라고 밝히고 있습니다.
이 한계들이 어디서 오는지는 저자가 진단해 두었습니다. 규칙 쪽 실패는 학습에 쓴 규칙 구조가 여덟 가지로 고정되어 있고 부정이 항상 최상위에만 있었기 때문이며, 8B 베이스 모델이 같은 항목에서 제로샷으로 0.58을 내는 것을 보면 규칙 조합 능력은 합성 데이터에서만 학습된다는 것이 근거입니다. 그래서 다음 단계로 부정이 어디에나 들어가는 무작위 규칙 트리 60개로 만든 decision-v7 스위트와, 한 시드가 아니라 모든 시드가 기준을 통과해야 출시로 인정하는 규칙이 v0.2 계획에 올라가 있습니다.
kev 설치와 사용
Python 3.12 이상과 uv가 필요하고, 플레이그라운드를 함께 쓰려면 Node 20 이상이 필요합니다. 서빙은 Apple Silicon의 MPS에서, 학습과 평가는 CUDA와 MPS에서 시험되었습니다:
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
cd playground && npm install && cd ..
가중치는 Hugging Face Hub의 kev 컬렉션에 있고 --run 인자에 Hub 아이디를 그대로 넘기면 됩니다. 베이스 모델은 첫 로드 시 함께 내려받습니다:
KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
공개된 체크포인트는 네 개이고, 모두 어댑터와 헤드만 배포하므로 내려받는 용량 자체는 크지 않습니다. 아래 표의 모든 행은 같은 동결 스위트(evals/v4)에서 측정한 것이라 앞 절의 0.799와는 다른 평가이며, 괄호 안은 개발 분할과 잠금 테스트 분할 순서입니다:
| 체크포인트 | 베이스 모델 | 학습 분포 안(개발 / 잠금 테스트) | 학습에 없던 출처(개발 / 잠금 테스트) | 어댑터와 헤드 용량 | 맥에서의 서빙 |
|---|---|---|---|---|---|
kev-0.5b |
Qwen2.5-0.5B | 0.712 / 없음 | 0.575 / 없음 | 35MB | fp32, 약 160ms |
kev-0.6b |
Qwen3-0.6B-Base | 0.805 / 0.819 | 0.598 / 0.631 | 41MB | fp32 |
kev-4b |
Qwen3-4B-Base | 0.843 / 0.852 | 0.759 / 0.794 | 131MB | bf16, 약 1초 |
kev-8b |
Qwen3-8B-Base | 0.869 / 0.869 | 0.774 / 0.799 | 175MB | bf16, 약 2초 |
| Jev(호스팅 기준점) | 비공개 | 0.845 / 없음 | 0.857 / 없음 | 해당 없음 | 해당 없음 |
저장소는 이 중 kev-4b 를 먼저 써 보라고 권합니다. 용량 대비 정확도가 가장 좋고 32GB 맥에서 bf16으로 서빙되기 때문입니다. fp32로는 4B가 약 16GB, 8B가 약 33GB를 차지해 8B는 32GB 맥에 올라가지 않으므로, 8B를 쓰려면 약 17GB로 줄어드는 KEV_DTYPE=bf16 이 사실상 필수입니다. kev-0.5b 에만 v0.1 버전 태그가 지정되어 있고 나머지 세 개는 앞서 적은 출시 기준을 통과하지 못해 연구 프리뷰로 남아 있습니다.
다만 큰 체크포인트가 언제나 나은 것은 아니라는 반대 사례를 kev-4b 모델 카드가 직접 적어 두었습니다. 카드에 두 번 청구되었다는 TypeSafe 문서의 예제 문의를 놓고 결제 문제인지 묻는 질문에서 kev-4b는 0.22를 내놓는 반면 kev-0.6b는 0.97을 내놓고 반품 사유까지 맞힙니다. 베이스 모델에서 덜 멀어지도록 학습한 만큼 과제별 사전 지식도 덜 가져가기 때문이며, 학습에 대응되는 예시가 없는 질문이라면 체크포인트를 크기순으로 고르지 말고 자기 입력으로 직접 재어 보라는 것이 카드의 권고입니다.
플레이그라운드는 별도 포트로 띄웁니다. 브라우저에서 http://localhost:3001 을 열면 프리셋을 고르고 상태와 질문을 고쳐 가며 ⌘↵ 로 실행할 수 있습니다:
cd playground && npm run dev -- -p 3001
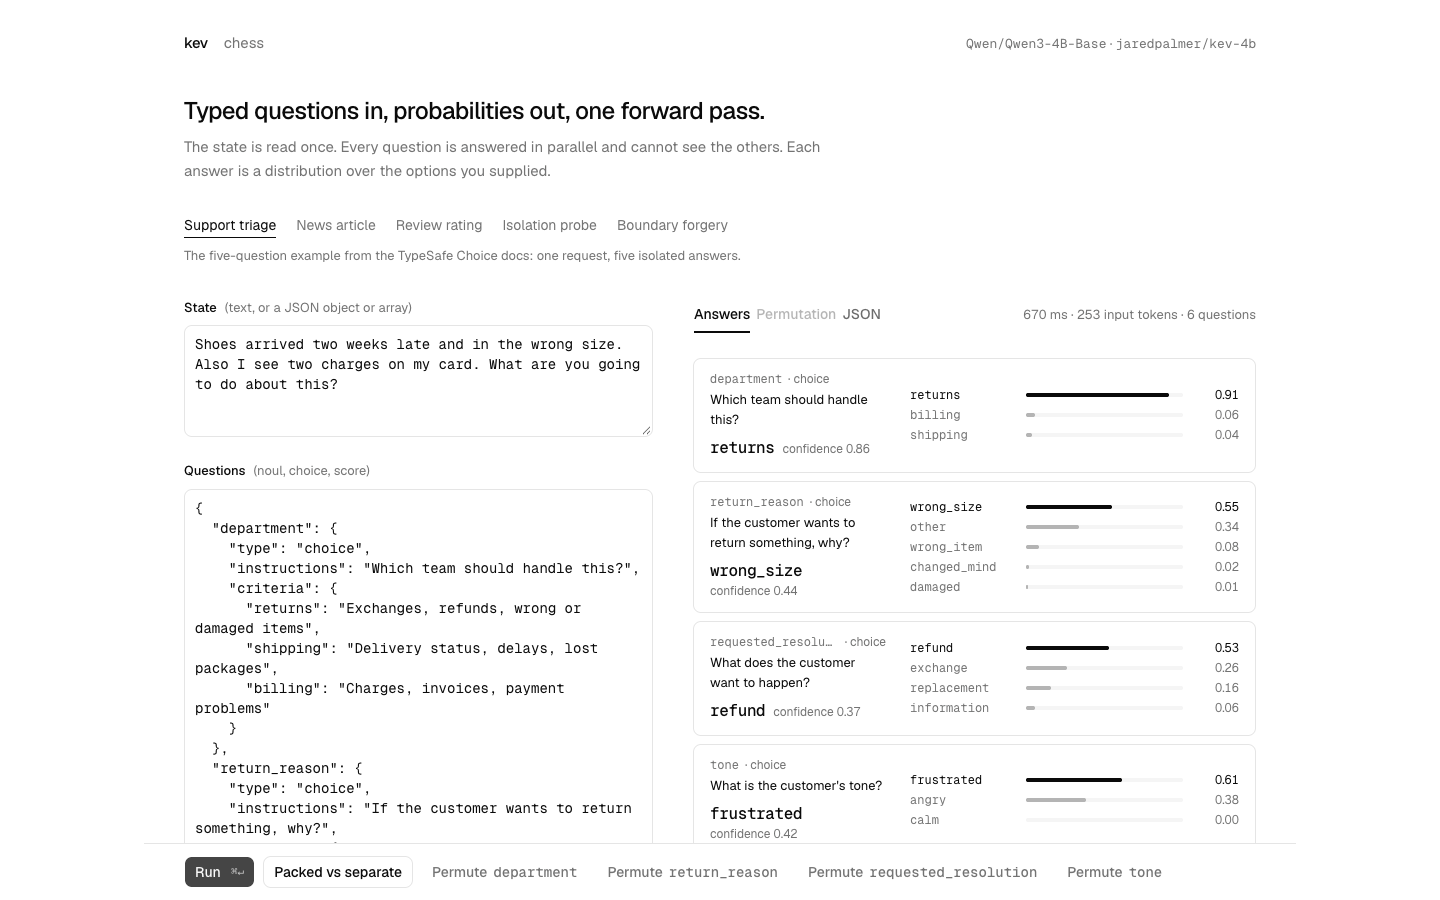
Packed vs separate 버튼은 질문 N개를 담은 요청 하나와 질문 하나짜리 요청 N개를 비교하고, Permute 버튼은 Choice 질문을 여섯 가지 선택지 순서로 다시 질의합니다.
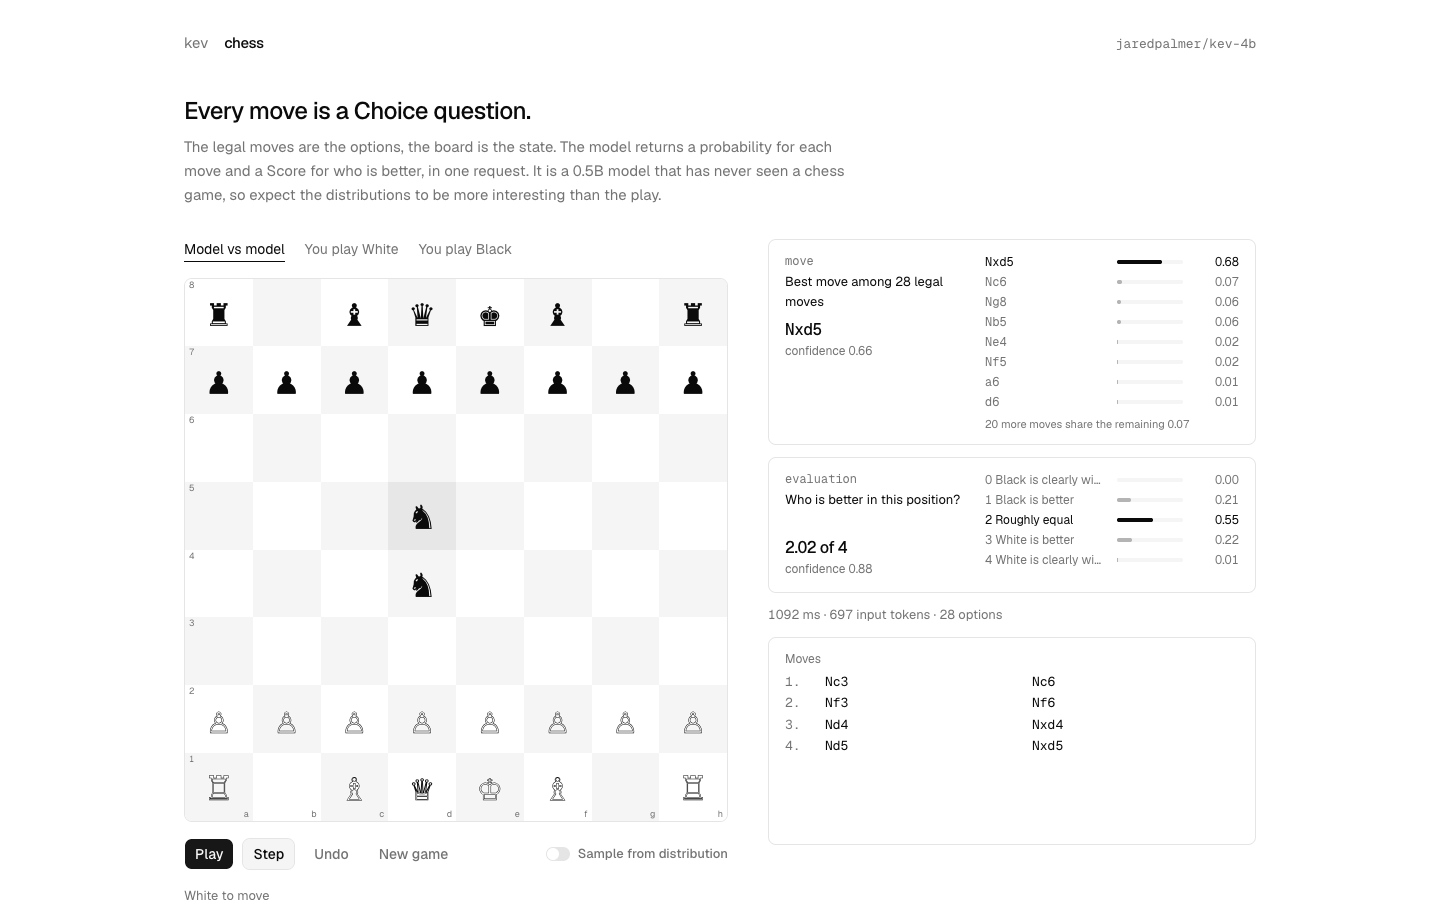
Isolation probe 와 Boundary forgery 프리셋은 앞서 본 메커니즘 검사 두 가지를 그대로 재현합니다. 같은 서버 위에 체스 화면도 올라가 있는데, 합법 수 목록이 Choice 질문의 선택지가 되고 보드가 상태가 되며 같은 요청 안에서 Score 질문 하나가 형세를 평가하는 구성입니다:
직접 학습시켜 보려면 1분 정도 걸리는 점검용 실행부터 시작할 수 있습니다. 두 번째 명령이 kev-0.5b 를 그대로 재현하는 레시피이고, 세 번째가 현재 4B 레시피입니다:
# 1분 정도 걸리는 점검용 실행
uv run python -m kev.train --n_per_source 40 --accum 4 --out runs/smoke

# kev-0.5b, M5에서 약 1시간 45분
uv run python -m kev.train --n_per_source 1500 --epochs 2 --perm_kl 0 --ord_w 0 --out runs/kev

# kev-4b 레시피, H100 한 장에서 약 40분
uv run python -m kev.train --suite evals/v4/decision-v4 --base Qwen/Qwen3-4B-Base --epochs 2 --lr 5e-5 \
    --batch 4 --accum 2 --dtype bf16 --checkpointing 1 --p_none_pair 0.25 --device cuda --out runs/kev-4b
맥에서 학습할 때는 한 번에 한 작업만 실행하라고 저장소가 안내합니다. 같은 Apple GPU에서 두 작업을 동시에 실행하면 서로를 약 10배 느리게 만들기 때문입니다. 평가 스위트의 매니페스트와 개발/테스트 분할은 저장소에 함께 들어 있고, 10MB가 넘는 학습 분할만 jaredpalmer/kev-suites 미러에서 내려받아 매니페스트 해시로 검증한 뒤 사용합니다.
kev의 라이선스
kev는 Apache-2.0으로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다. 어댑터와 판독 헤드 가중치에도 같은 라이선스가 적용됩니다.
다만 kev는 가중치 전체가 아니라 베이스 모델 위에 얹는 어댑터만 배포하므로, 실제로 모델을 실행하려면 베이스 모델을 함께 내려받아야 하고 그 부분은 베이스 모델의 라이선스를 따릅니다. kev가 쓰는 Qwen2.5-0.5B와 Qwen3 0.6B/4B/8B Base는 모두 Apache-2.0으로 배포되고 있다고 모델 카드가 밝히고 있습니다.
상업적으로 쓸 때 추가로 확인할 것은 학습 데이터 쪽입니다. 학습에 사용한 공개 데이터셋은 각자의 라이선스를 가지므로 모델 카드의 학습 데이터 절에 정리된 출처별 조건을 확인해야 합니다.
 kev가 따른 Jev 아키텍처 복원 글 (Archer Hume)
 kev 프로젝트 GitHub 저장소
 kev 모델 체크포인트 컬렉션
 kev 평가 스위트 데이터셋
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
정확도 너머에: 시계열 파운데이션 모델(TSFM)이 잘 보정(Calibration)되어 있는지에 대한 연구 (feat. ICLR 2026)
-
Anthropic, API를 사용한 Claude Sonnet 4.5, Opus 4.1 호출 시 구조화된 출력(Structured Output) 기능의 공개 베타 시작
-
Mistral, 추론 시점에 정책을 바꾸는 3B 규모의 멀티모달 안전성 분류 모델 Shieldstral 공개
-
Gemma Multimodal Fine-Tuner: Apple Silicon Mac에서 PyTorch와 MPS로 Gemma 4 멀티모달 모델을 파인튜닝하는 오픈소스 도구
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글은 파이토치 한국 사용자 모임 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
