핵심 요약
- Liquid AI가 LFM3 발표 글에서 텍스트, 비전, 오디오, 옴니, 결정 모델 6종을 공개했습니다. 6종 모두 22T 토큰으로 사전 학습한 같은 백본 LFM3-1.7B-Base에서 갈라져 나왔고, 크기는 1.7B~2.2B입니다.
- 텍스트 모델 LFM3-1.7B는 Liquid AI가 고른 29개 벤치마크 평균에서 Qwen3.5-9B보다 약간 높았습니다. 다만 에이전트 코딩, 지식 문제, 128K 긴 문맥에서는 더 큰 모델에 뒤졌습니다.
- 2026년 10월 28일 기준으로 llama.cpp 릴리스(b11946)에는 6종 모두의 지원이 들어갔고, 동영상 입력 지원도 이날 병합되어 다음 릴리스부터 들어갑니다. 반면 Transformers는
trust_remote_code=True가 필요하고, SGLang 지원은 리뷰 중이며, vLLM은 공개 PR이 없고 모델 카드끼리 지원 표기가 엇갈립니다. - 라이선스는 LFM Open License v1.0입니다. 연 매출 1,000만 달러 이상인 기업의 상업적 사용은 허가 범위 밖입니다.
LFM3 소개
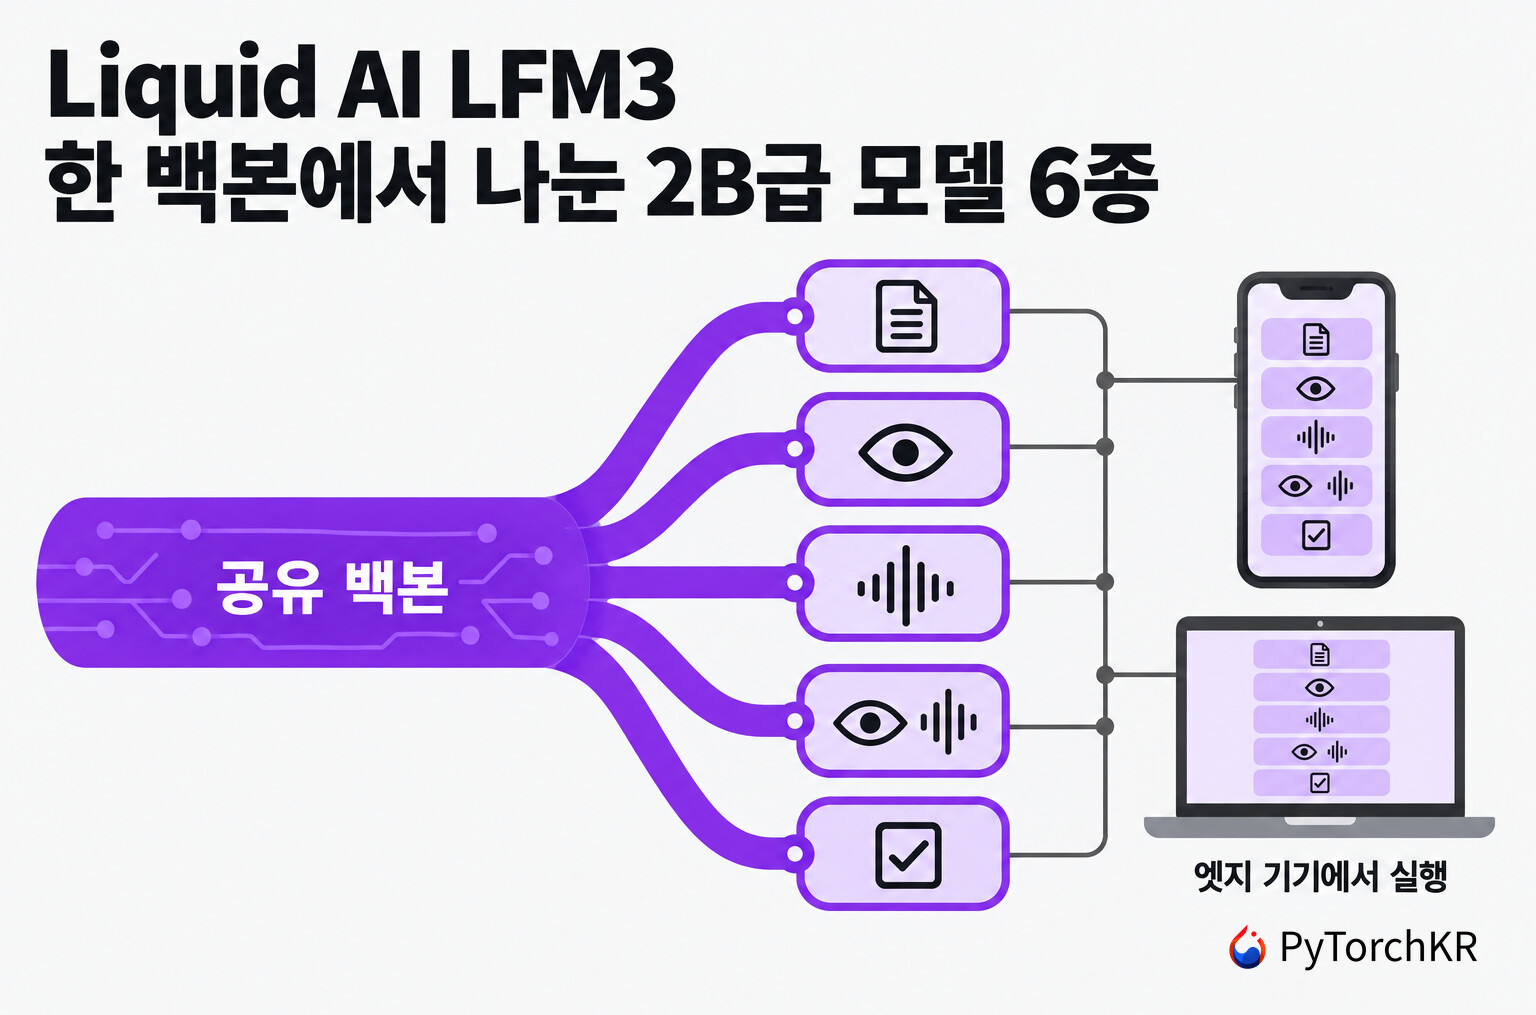
LFM3는 휴대폰, 노트북, 차량 같은 엣지 기기에서 실행하고, 사용자가 자기 데이터로 미세조정(fine-tuning)해 특정 작업 전문 모델로 만드는 것을 목표로 한 2B급 모델군입니다. Liquid AI의 이전 세대 LFM2와 LFM2.5에서는 텍스트, 비전 언어, 오디오 모델의 크기와 출시 시점이 제각각이었습니다. 이번 첫 릴리스는 6개 모델이 모두 같은 백본 하나에서 갈라져 나왔으므로, 같은 어휘, 같은 레이어 구성, 같은 사전 학습 데이터를 공유합니다.
Liquid AI가 내세우는 근거는 "작고 빠른 모델에 더 많은 표현력"입니다. 큰 범용 모델 하나를 클라우드에서 부르는 대신, 작업에 맞는 2B급 모델을 골라 단일 GPU로 미세조정하고 기기에서 실행하라는 제안입니다. 텍스트 모델의 가중치는 4비트 양자화(quantization) 기준으로 약 1GB이며, 실제로 Hugging Face의 LFM3-1.7B-QAD-Q4_0.gguf 파일은 1.05GB입니다.
이 글은 Liquid AI 발표 글, Hugging Face 모델 카드 7개, 쿡북의 풍력 터빈 예제, 라이선스 파일을 함께 읽고 정리했습니다. 모델별 사용법과 미세조정 노트북 목록은 Liquid AI의 Hugging Face 블로그 글에서 가져왔습니다. llama.cpp, SGLang, Transformers, vLLM, MLX 저장소의 PR 상태도 확인했습니다. 성능과 속도 수치는 모두 Liquid AI와 파트너가 발표한 값이며, PyTorchKR이 모델을 직접 실행해 측정하지는 않았습니다. 직접 계산하거나 대조한 것은 KV 캐시 크기, 토크나이저 동일성, GGUF 파일 크기, 각 프레임워크의 지원 상태입니다.
하나의 백본에서 갈라진 6개 모델
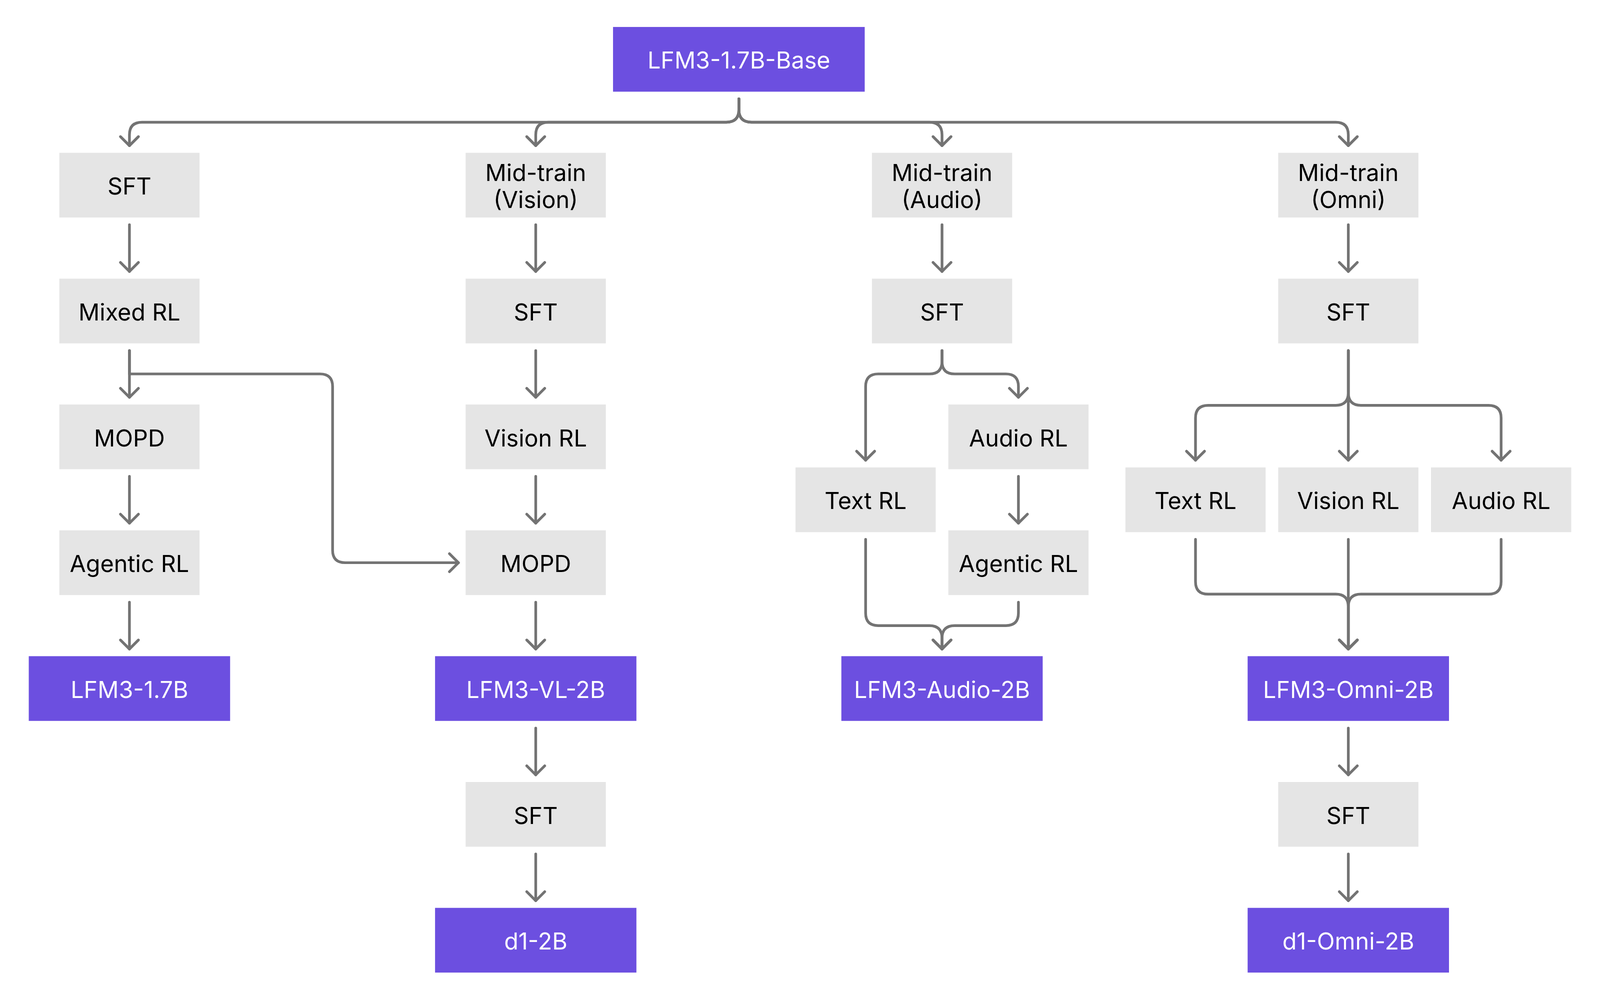
첫 릴리스의 6개 모델은 모두 LFM3-1.7B-Base에서 출발합니다. 텍스트 모델은 백본에 바로 후속 학습을 했고, 비전, 오디오, 옴니 모델은 각자의 인코더를 붙여 중간 학습(mid-training)을 거친 뒤 후속 학습을 했습니다. 결정 모델 두 개는 비전 모델과 옴니 모델에 지도 미세조정(SFT)을 한 번 더 한 것입니다.
| 모델 | 파라미터 | 입력 → 출력 | 컨텍스트 | 모델 카드가 밝힌 용도 |
|---|---|---|---|---|
| LFM3-1.7B-Base | 1.73B | 텍스트 → 텍스트 | 256K | 언어나 도메인 특화를 위한 대규모 미세조정의 출발점 |
| LFM3-1.7B | 1.73B | 텍스트 → 텍스트 | 256K | 로컬 에이전트, 도구 호출, 구조화 출력 |
| LFM3-VL-2B | 1.92B | 텍스트, 이미지, 동영상 → 텍스트 | 128K | 문서, 차트, 앱 화면 읽기, 물체 위치 찾기, 로봇용 공간 추론 |
| LFM3-Audio-2B | 2.00B | 텍스트, 음성 → 텍스트, 음성 | 32K | 음성 대화, 음성 인식, 음성 합성, 음성으로 도구 호출 |
| LFM3-Omni-2B | 2.17B | 텍스트, 이미지, 동영상, 음성 → 텍스트, 음성 | 32K | 보고 듣고 말로 답하는 기기 내 비서 |
| d1-2B, d1-Omni-2B | 1.92B, 2.17B | 상태와 질문 목록 → 확률이 붙은 답 | 128K | 라우팅, 분류, 문서 추출, 검사 같은 판단 단계 |
모델 카드의 지원 언어 목록에는 6종 모두 한국어가 들어 있습니다. 텍스트 쪽은 16개 언어이고, LFM3-Audio-2B와 LFM3-Omni-2B의 음성은 18개 언어(영국 영어와 미국 영어를 따로 세면 19개 로캘)입니다. d1-Omni-2B의 음성 입력은 텍스트 16개 언어에서 힌디어, 태국어, 베트남어, 인도네시아어를 뺀 12개 언어입니다. 각 모델 카드는 용도와 함께 맞지 않는 작업도 적어 두었습니다. LFM3-1.7B와 LFM3-Audio-2B는 에이전트 코딩과 복잡한 다단계 추론에 권하지 않고, LFM3-VL-2B는 코딩, 다중 턴 대화, 복잡한 추론에 권하지 않습니다. LFM3-Omni-2B는 추론(reasoning) 모드를 지원하지 않는 모델입니다.
백본 구조: 합성곱, 슬라이딩 윈도 어텐션, 전역 어텐션의 3중 하이브리드
LFM2는 짧은 합성곱(short convolution)과 어텐션을 섞은 하이브리드 구조였고, 이 구조는 Liquid AI의 하드웨어 인 더 루프 아키텍처 탐색에서 나왔습니다. LFM3도 같은 탐색으로 구조를 다시 골랐습니다. 이번에는 에이전트 작업을 목표로 긴 문맥에서도 빠른 구조를 찾았고, 탐색에 쓴 기기도 휴대폰 1대와 노트북 1대의 CPU에서 14개의 기기와 백엔드 조합으로 늘렸습니다. 여기에는 Samsung Galaxy S26 Ultra, OnePlus 15, Raspberry Pi 5, Apple M4 Max, AMD Ryzen AI, Arm과 x86 클라우드 CPU, GPU, Qualcomm Hexagon NPU가 들어갑니다.
24개 레이어는 세 종류의 연산으로 나뉩니다. 두 어텐션 레이어는 모두 그룹 쿼리 어텐션(Grouped Query Attention, GQA)입니다.
| 레이어 종류 | 개수 | 특징 |
|---|---|---|
| 게이트 짧은 합성곱(gated short convolution) | 13 | 커널 크기 7 (LFM2는 3). 입력 길이와 무관하게 상태 크기가 일정 |
| 슬라이딩 윈도 어텐션(Sliding-Window Attention, SWA) | 5 | 최근 256개 토큰만 봄. RoPE를 모든 차원에 적용 |
| 전역 어텐션(global attention) | 6 | 전체 문맥을 봄. 헤드 차원의 절반에만 RoPE 적용(partial RoPE) |
Hugging Face 블로그 글에 실린 구조도는 블록 내부와 레이어 배치를 함께 보여 줍니다. 각 레이어는 시퀀스 블록(합성곱 또는 어텐션)과 SwiGLU FFN으로 이뤄지며, 어텐션 블록은 Q와 K를 정규화한 뒤 계산합니다. 배치는 합성곱 2개로 시작한 뒤 합성곱과 어텐션이 번갈아 나오며, 어텐션은 전역과 SWA가 교대로 놓입니다. 이 순서는 config.json의 layer_types 값과 같습니다.
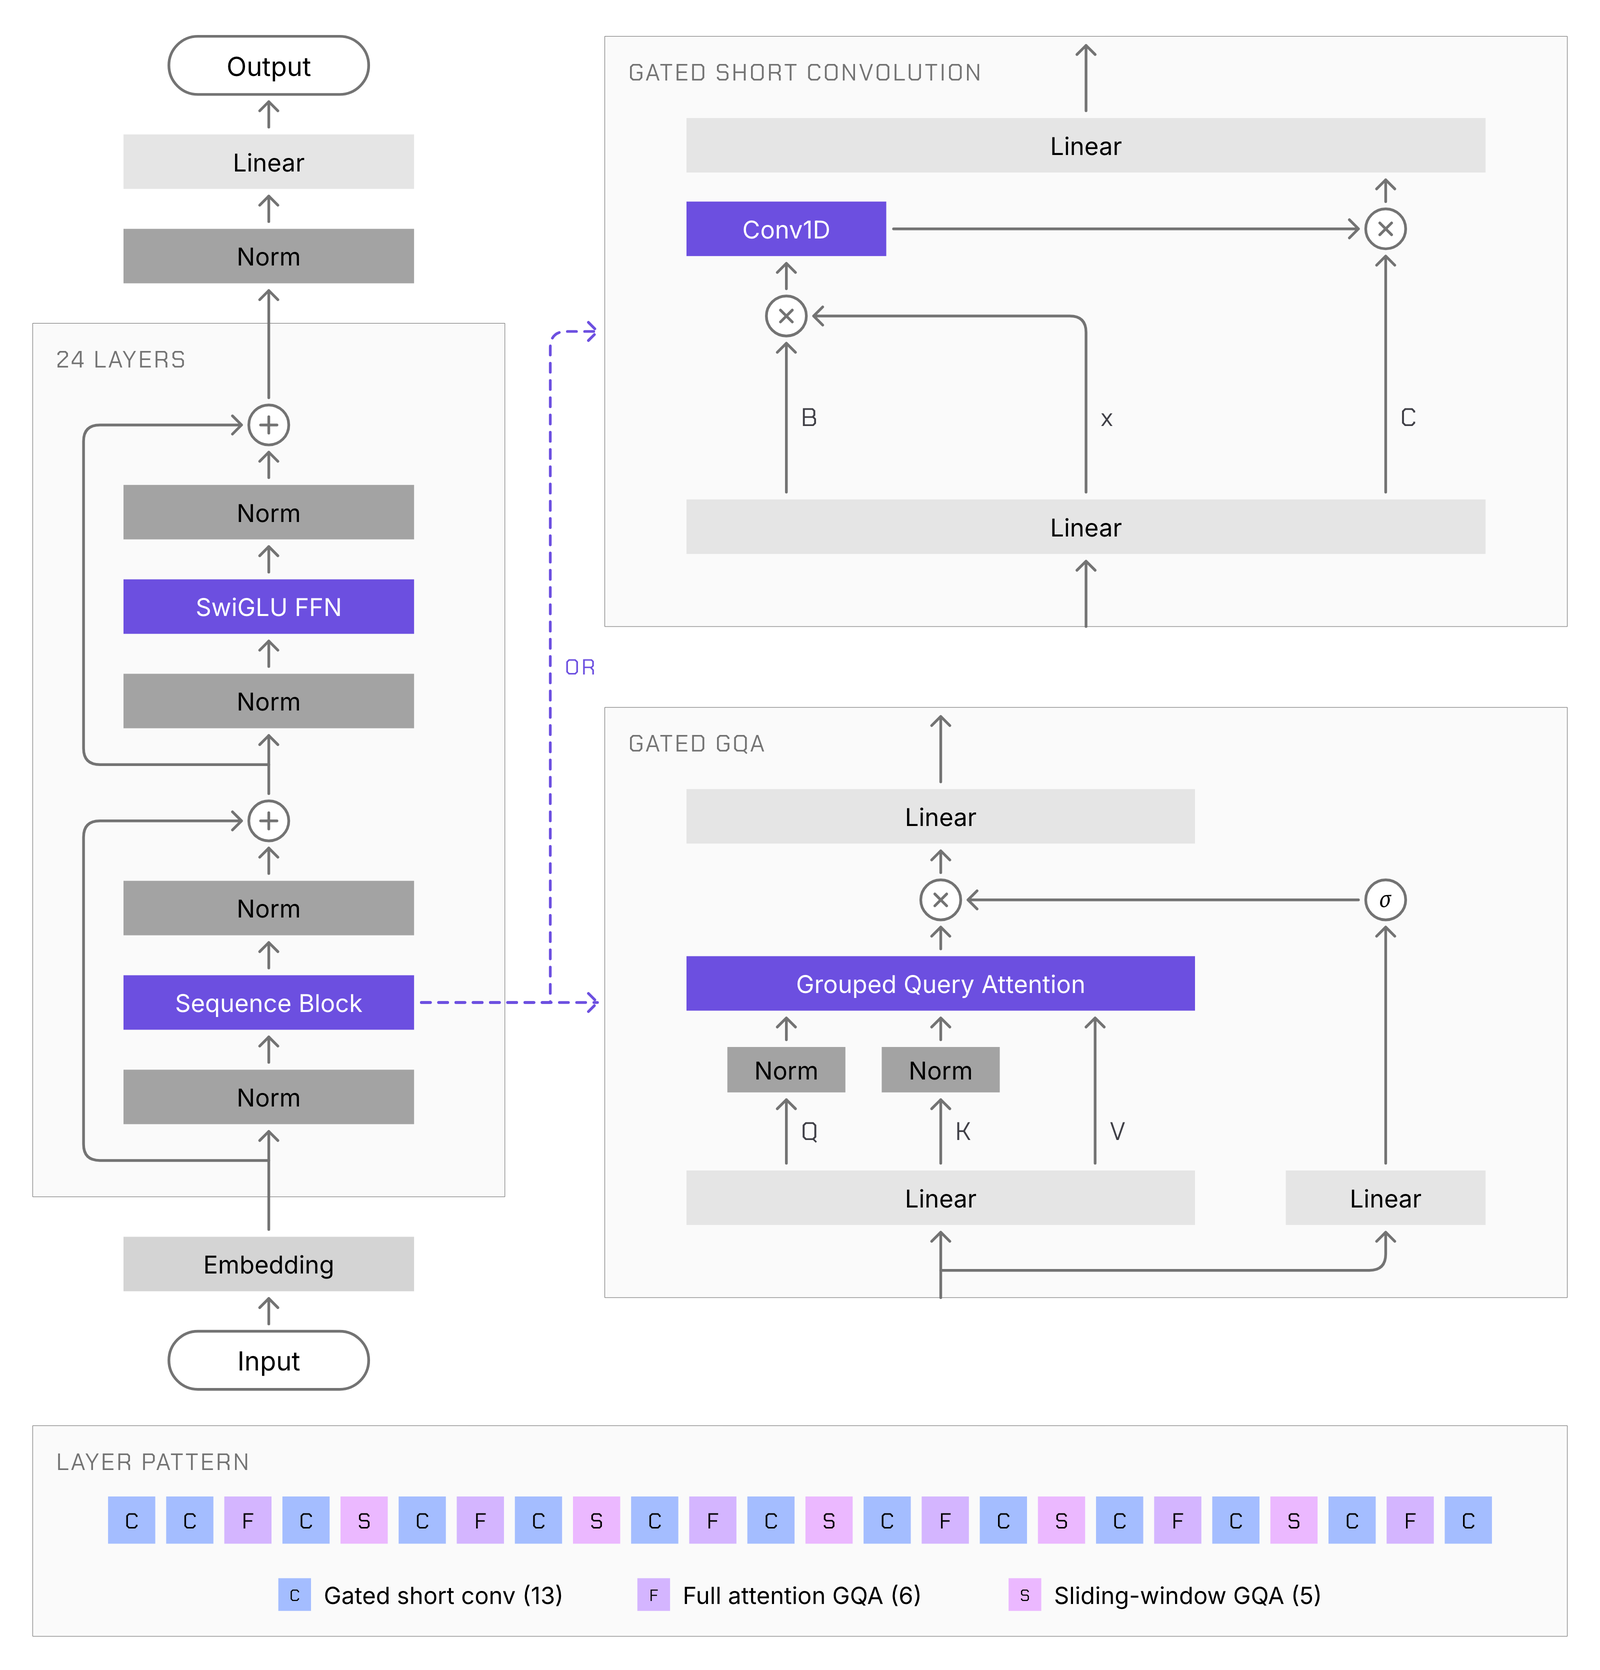
Liquid AI는 합성곱 일부를 다른 시퀀스 블록으로 바꿔 보는 실험을 했고, 그중 SWA가 품질과 속도의 균형이 가장 좋았다고 밝혔습니다. 그 밖에 바꾼 점은 세 가지입니다. 헤드별 게이트 어텐션(head-wise gated attention) 은 시그모이드 게이트로 헤드마다 출력 크기를 조절해, 기여할 것이 없는 헤드를 끌 수 있게 합니다. 이 게이트는 양자화를 어렵게 하는 활성값 이상치를 줄이는 데 도움이 될 수 있다고 합니다. 부분 RoPE(partial RoPE) 는 전역 어텐션에서 저주파 절반을 회전하지 않고 남겨, 그 차원이 위치와 무관하게 내용으로 일치를 찾도록 합니다. 샌드위치 정규화(sandwich norm) 는 블록의 입력과 출력을 모두 정규화합니다.
이 구조의 효과는 긴 문맥에서 커집니다. KV 캐시는 전역 어텐션 6개 레이어에서만 문맥 길이에 비례해 커지기 때문입니다. config.json의 값(KV 헤드 4개, 헤드 차원 128)으로 128K 토큰의 KV 캐시를 16비트로 계산하면 다음과 같습니다.
여기서 앞의 2는 K와 V, 뒤의 2는 16비트 값의 바이트 수입니다. SWA 5개 레이어는 256개 토큰만 보관하므로 약 2.6MB에 그칩니다. 이 값은 Liquid AI가 밝힌 1.6GB와 일치하며, 같은 조건에서 Qwen3.5-4B는 4.3GB, MiniCPM5-2B는 5.6GB가 필요하다고 합니다. Liquid AI는 또 파라미터당 속도로 보면 짧은 프롬프트에서는 LFM2-1.2B와 같고, 문맥에 8K 토큰이 있을 때는 약 25% 빠르다고 밝혔습니다.
어휘는 LFM2.5-8B-A1B와 같은 128K입니다. PyTorchKR이 tokenizer.json을 비교해 보니 LFM2.5-24B-A2B와 어휘, 병합 규칙이 완전히 같았습니다. 따라서 LFM2.5-24B-A2B 글에서 측정한 한국어 토큰 효율(위키백과 본문 기준 1.85자/토큰, 65K 어휘보다 토큰 16.7% 감소)이 LFM3에도 그대로 적용됩니다.
22T 토큰의 사전 학습과 4단계 후속 학습
LFM3-1.7B-Base의 사전 학습은 웹과 합성 데이터 약 15T 토큰으로 시작해, 코드, 수학, 과학 데이터 3T 토큰(4K 문맥)으로 이어졌습니다. 마지막 3.5T 토큰은 중간 학습입니다. 선별한 데이터와 에이전트 실행 기록, 도구 호출 데이터를 3T 토큰(32K 문맥)만큼 학습하고, 이어서 500B 토큰으로 128K까지, 50B 토큰으로 256K까지 문맥을 늘렸습니다.
텍스트 모델 LFM3-1.7B의 후속 학습은 네 단계입니다.
- 지도 미세조정(Supervised Fine-Tuning, SFT): 대화, 추론, 도구 호출, 에이전트 실행 기록을 담은 1.75T 토큰
- 혼합 강화 학습(mixed RL): 수학, 코드, SQL, 구조화 출력 등 여러 도메인을 한 번에 학습하며, 보상에 길이 페널티를 넣어 답을 짧게 유지
- 다중 도메인 온폴리시 증류(Multi-domain On-Policy Distillation, MOPD): 코드, 수학, 도구 사용, 긴 문맥, 에이전트 작업, 기업 업무 흐름의 6개 전문 RL 교사 모델을 하나의 모델로 증류
- 에이전트 RL(agentic RL): 웹 탐색부터 사무 작업까지의 과제를 실제 에이전트 하네스 안에서 실행
LFM3-1.7B: 에이전트 점수는 9B급, 코딩과 지식은 아직 뒤처진다
LFM3-1.7B는 Hermes Agent, Pi, OpenClaw 같은 에이전트 하네스에서 돌리도록 후속 학습한 256K 문맥의 텍스트 모델입니다. Liquid AI는 메일 분류, 일정 관리, 웹 조사, WhatsApp 아침 브리핑, 수천 개 도구 중에서 맞는 도구를 찾는 도구 검색을 예로 들었습니다. 도구 검색은 채팅 템플릿에서 defer_loading=True로 도구 정의를 프롬프트 밖에 두었다가, 하네스의 검색 도구가 이름을 돌려줄 때 정의를 넣는 방식입니다.
LFM3-1.7B는 이전 모델 LFM2.5-2.6B보다 파라미터가 35% 적지만 점수가 높고, 차이는 에이전트 과제에서 가장 큽니다. 아래 표는 Liquid AI가 발표한 29개 벤치마크 중 주요 항목입니다. Gemma 4 E4B 열은 표 폭 때문에 뺐고, 전체 표는 모델 카드에 있습니다.
| 벤치마크 | LFM3-1.7B | LFM2.5-2.6B | MiniCPM5-2B | Qwen3.5-4B | Qwen3.5-9B |
|---|---|---|---|---|---|
| LiveClaw | 45.60 | 14.70 | 30.37 | 19.94 | 35.77 |
| WebArena-Verified | 38.42 | 3.02 | 9.11 | 21.92 | 28.94 |
| AutomationBench (public) | 41.29 | 0.94 | 4.71 | 8.67 | 15.10 |
| BFCL V4 | 71.39 | 55.89 | 62.65 | 55.12 | 62.83 |
| MCP-Atlas | 32.57 | 16.45 | 26.38 | 41.37 | 42.67 |
| τ³-bench | 68.01 | 56.77 | 69.44 | 65.98 | 67.11 |
| SWE-bench Verified (OpenCode) | 43.40 | 18.00 | 34.80 | 41.20 | 51.20 |
| Terminal-Bench 2.1 (OpenCode) | 12.92 | 0.00 | 5.62 | 13.48 | 17.98 |
| IFBench | 73.03 | 60.48 | 62.08 | 38.16 | 48.84 |
| GPQA Diamond | 63.37 | 57.78 | 65.15 | 75.76 | 80.40 |
| Humanity's Last Exam (도구 없음) | 7.17 | 5.88 | 8.20 | 12.84 | 16.41 |
| Humanity's Last Exam (도구 사용) | 13.90 | 9.60 | 11.50 | 11.60 | 17.50 |
| RULER 128K | 65.56 | 1.15 | 37.96 | 84.63 | 87.11 |
| 29개 평균 | 49.37 | 31.55 | 39.19 | 39.27 | 47.24 |
브라우저와 업무 앱에서 긴 작업을 하는 WebArena-Verified와 AutomationBench, 그리고 함수 호출을 보는 BFCL V4에서는 5배 이상 큰 Qwen3.5-9B보다 점수가 높습니다. 반면 MCP-Atlas에서는 Qwen3.5-4B와 9B 모두에 뒤집니다. 에이전트 코딩과 지식 문제에서는 Qwen3.5-9B에 뒤지고, Qwen3.5-4B와는 항목마다 엇갈립니다(SWE-bench Verified는 앞서고 Terminal-Bench와 GPQA는 뒤짐). 128K 문맥의 RULER에서는 Qwen3.5-4B보다 19점 낮습니다. 문맥 창이 256K라는 것과 그 길이에서 정보를 정확히 찾는 능력은 별개라는 점을 보여 줍니다. Humanity's Last Exam은 검색 도구를 붙이자 점수가 7.17에서 13.90으로 거의 두 배가 되었습니다.
표에 없는 AA-Omniscience 결과도 함께 볼 만합니다. LFM3-1.7B의 정답률은 7.07%로 비교 모델 중 가장 낮지만, 틀린 답을 지어내지 않은 비율(non-hallucination)은 92.93%로 가장 높습니다. 모르는 지식 질문에 답을 지어내기보다 답하지 않는 경우가 많다는 뜻이며, Liquid AI도 지식 위주 작업에는 검색이나 RAG를 붙이라고 권합니다.
평가 조건도 확인해야 합니다. 모든 모델을 vLLM, BF16으로 실행했고, 별도 언급이 없는 평가는 temperature 0.6, top_p 0.95를 썼습니다. 반면 모델 카드가 일반 사용에 권하는 값은 temperature=0.1, top_k=50, repetition_penalty=1.1입니다. 또 이 모델은 기본으로 추론 과정을 출력하며, enable_thinking=False로 끌 수 있지만 모델 카드는 그 동작이 일정하지 않을 수 있다고 적었습니다.
실행 속도: 측정 조건부터 확인할 것
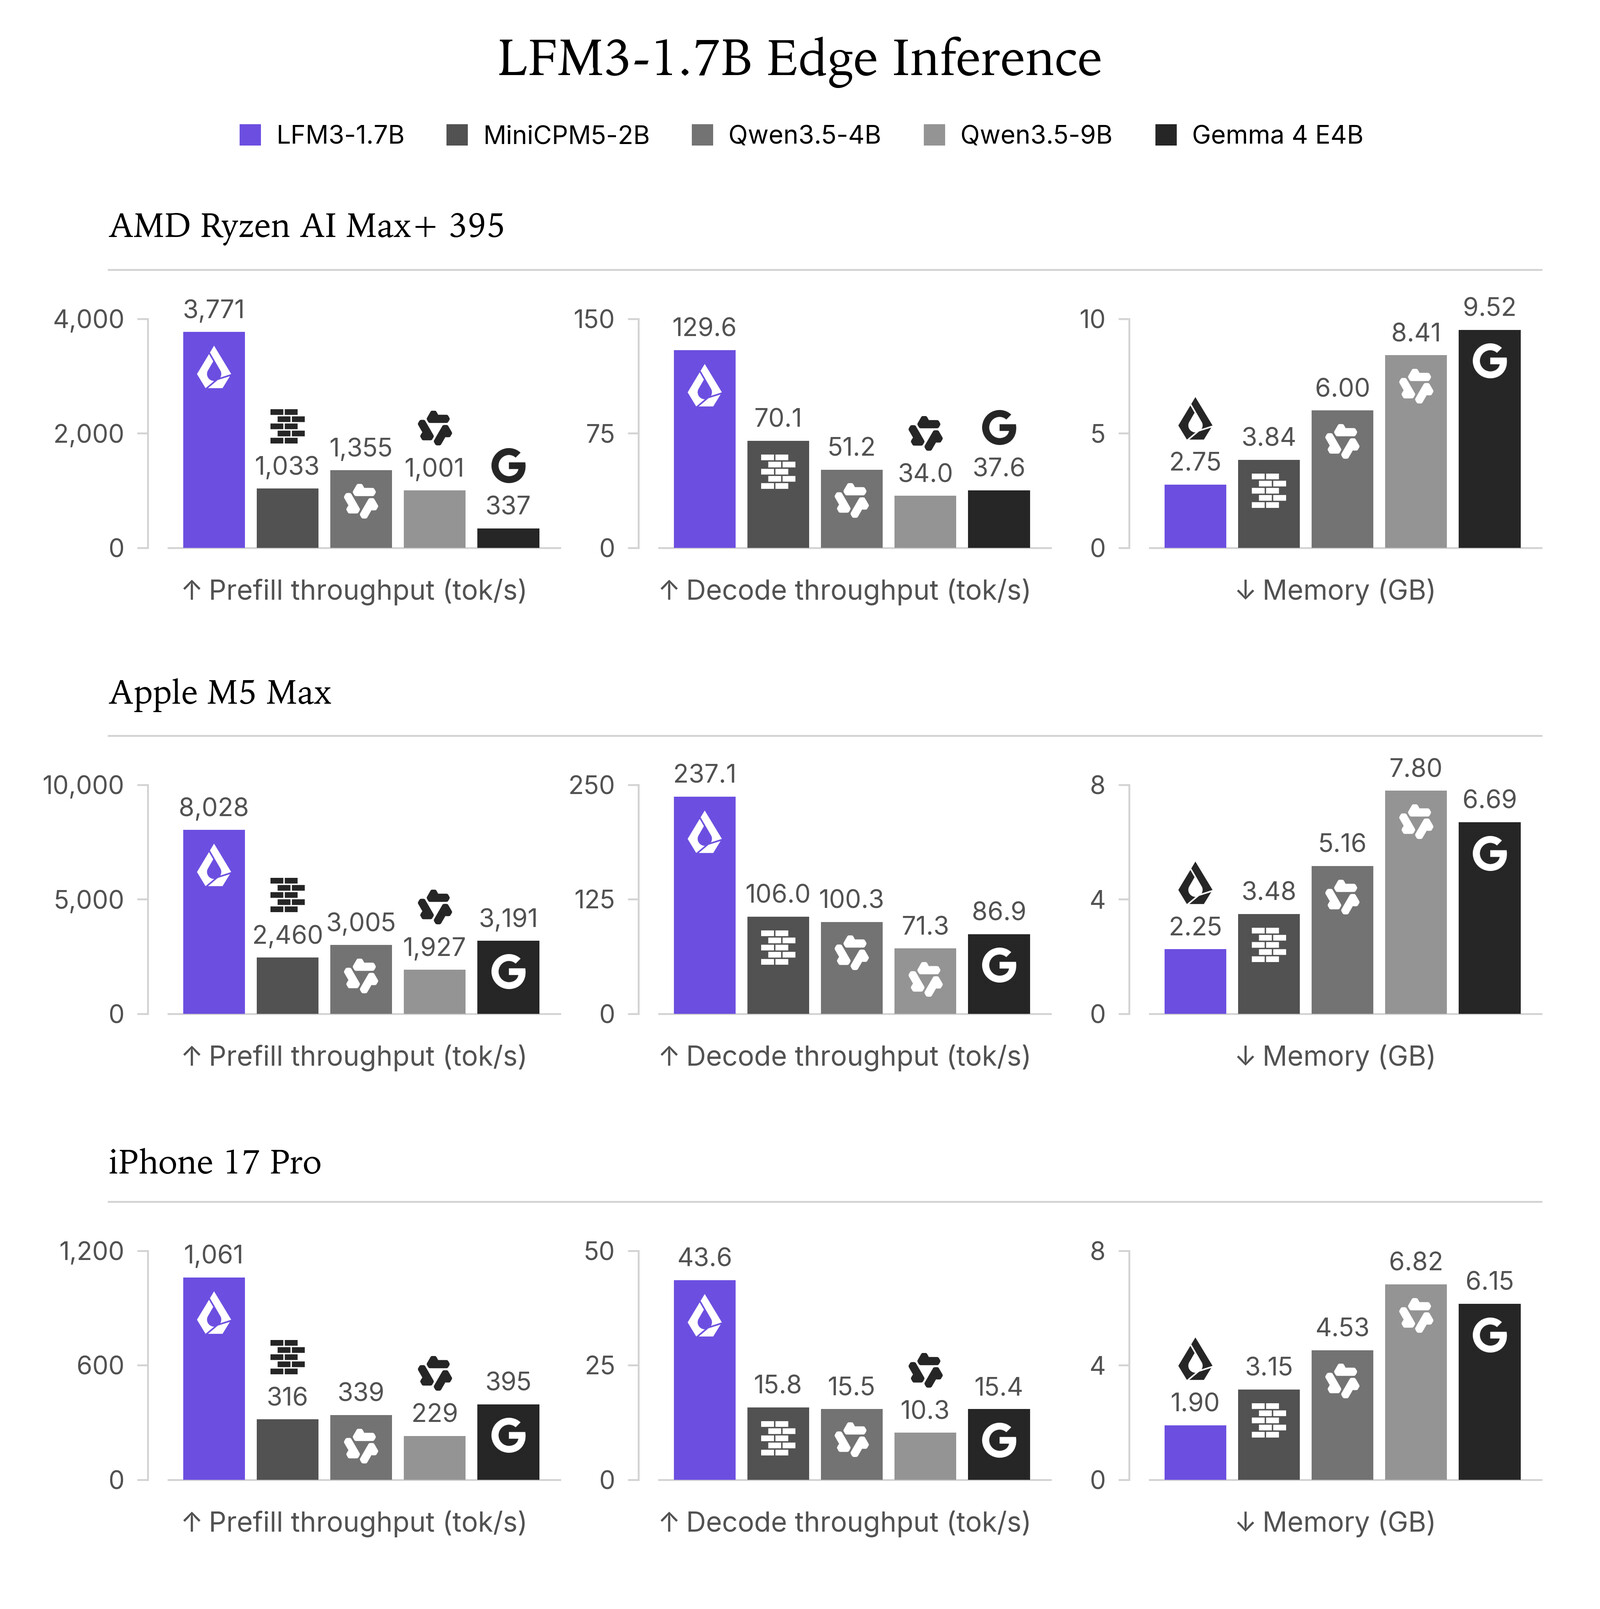
엣지 기기: llama.cpp, Q4_0, 32K 문맥
기기 측정은 llama.cpp에서 Q4_0 GGUF, 32,768 토큰 문맥, 배치 크기 1, 출력 100 토큰으로 했습니다. 기기는 AMD Ryzen AI Max+ 395(Vulkan), Apple M5 Max(Metal), iPhone 17 Pro(llama.cpp 기반 iOS 앱)입니다. 디코딩 속도는 다음으로 빠른 모델보다 1.85배(AMD), 2.24배(M5 Max), 2.76배(iPhone) 빨랐고, 메모리도 가장 적게 썼습니다. 한 가지 차이는 LFM3는 LFM3 지원을 넣은 llama.cpp 빌드로, 비교 모델은 릴리스 b11744로 측정했다는 점입니다.
GPU 처리량: B300 한 장에서 하루 36억 토큰
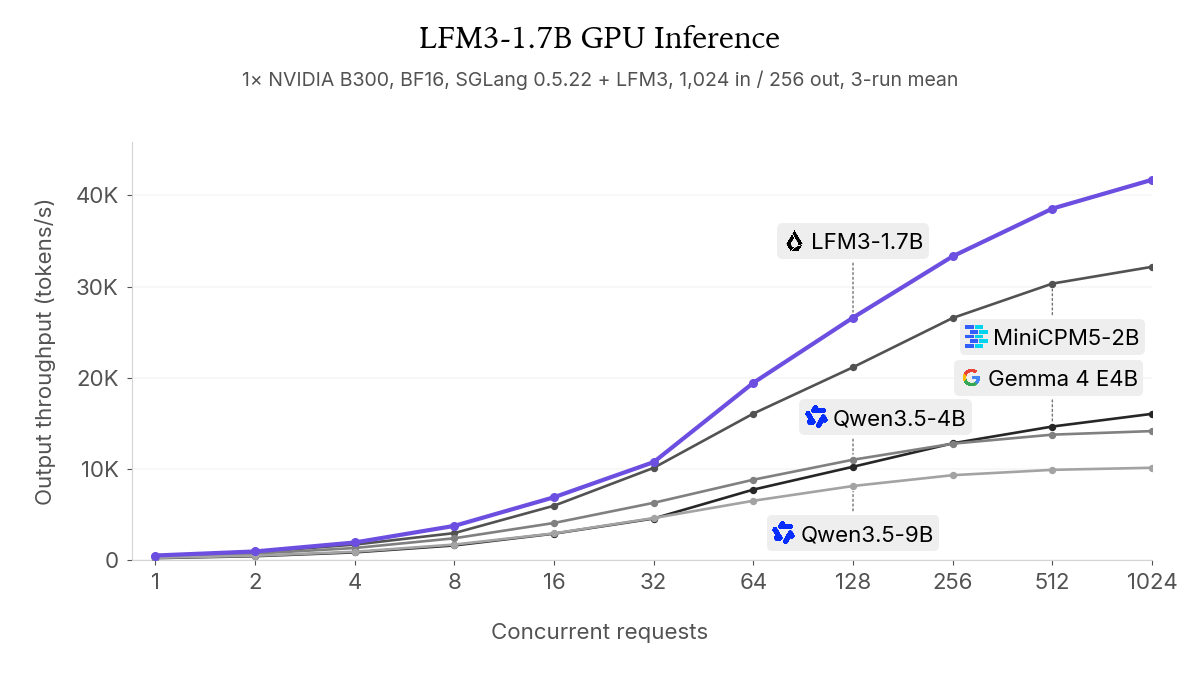
NVIDIA B300 한 장에서 SGLang, BF16으로 동시 요청 1,024개를 처리했을 때 출력 처리량은 초당 약 41,700 토큰이며, 하루로 환산하면 36억 토큰입니다. 그래프 부제에 적혀 있듯이 측정에 쓴 SGLang은 0.5.22 릴리스에 LFM3 지원을 더한 버전입니다. 이 지원은 아직 SGLang 본 저장소에 병합되지 않았습니다(아래 "지금 실행할 수 있는 환경" 참고).
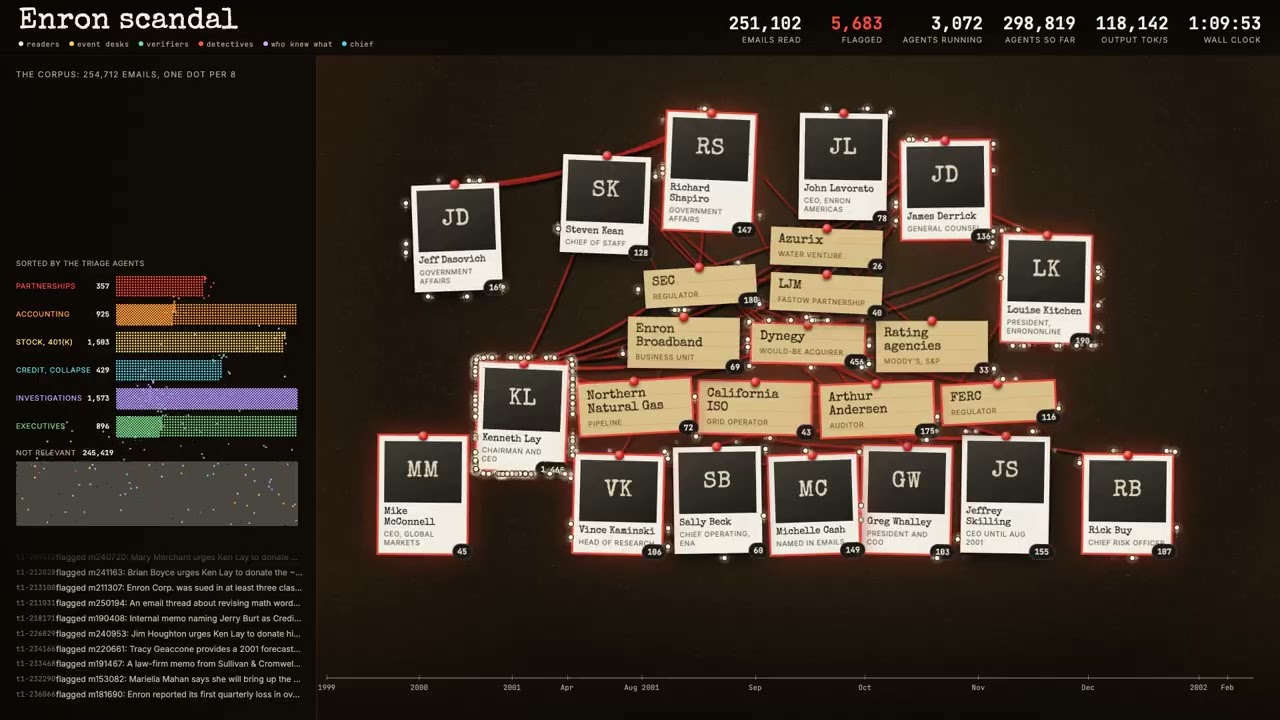
Liquid AI는 이 처리량을 보여 주려고 LFM3-1.7B 에이전트 30만 개 이상을 병렬로 띄워 Enron 이메일 아카이브를 조사하는 데모를 공개했습니다.
무작위 트래픽 지연 시간: 서빙 엔진이 다르다
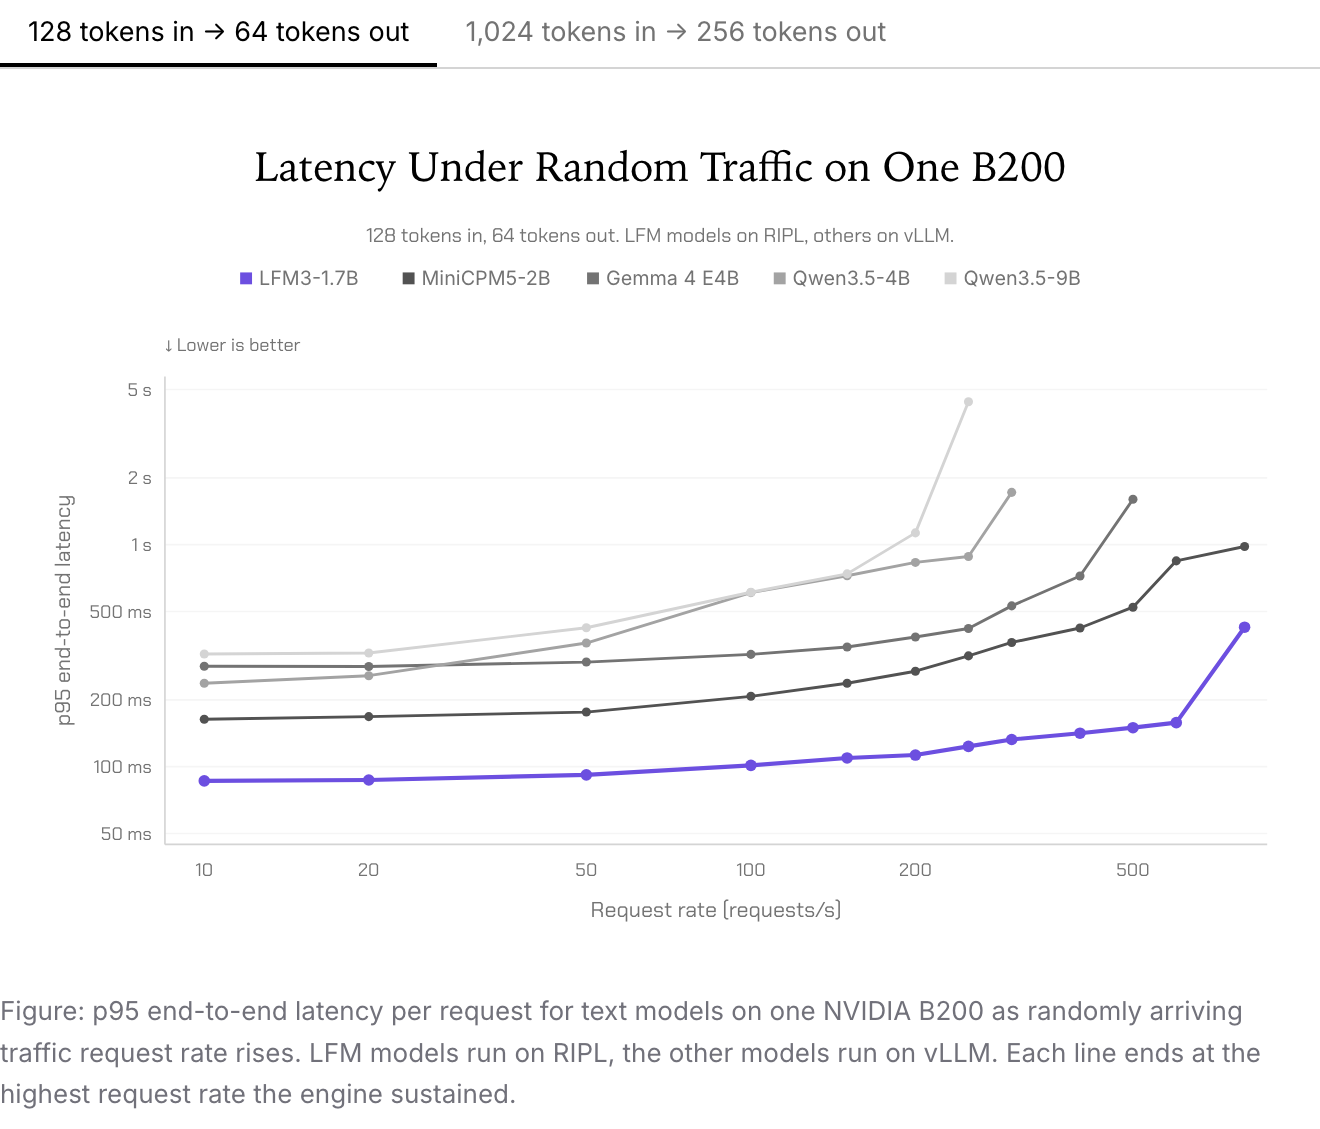
발표 글은 무작위로 들어오는 요청에서 LFM3-1.7B의 p95 지연 시간이 낮게 유지된다고 밝혔습니다. 다만 이 그래프의 측정 GPU는 B300이 아닌 B200이고, LFM3는 Liquid AI의 저지연 추론 엔진 Liquid RIPL에서, 비교 모델은 vLLM에서 실행했습니다. 모델 차이와 엔진 차이가 함께 섞인 비교입니다. 128 토큰 입력, 64 토큰 출력 기준으로 LFM3-1.7B는 초당 600개 요청까지 p95 158ms를 유지했고, 초당 800개에서 425ms로 올라갔습니다.
파트너 측정도 하나 소개되었습니다. MacPaw의 Ivan Petrukha는 실제 macOS 환경의 일상 에이전트 과제 65개에서 LFM3-1.7B와 Qwen3.5-2B를 비교했다고 밝혔습니다.
더 작은 모델이 이겼습니다. 과제 성공률은 64% 대 48%, 과제당 토큰은 58% 적었고, 진행이 멈춘 비율은 1% 미만 대 15%였습니다.
"The smaller model won: 64% task success versus 48%, 58% fewer tokens per task, and it got stuck in under 1% of attempts versus 15%."
LFM3-VL-2B: 62개 벤치마크 평균은 Gemma 4 12B와 같은 수준
LFM3-VL-2B는 LFM 비전 모델 중 처음으로 동영상을 입력으로 받습니다(2fps 샘플링). 답하기 전에 단계별로 추론하는 사고 모드와, 물체의 위치와 공간 관계를 다루는 능력도 더해졌습니다. 1.92B 파라미터는 언어 모델 1.73B, 비전 인코더 164M, 프로젝터 25M으로 이뤄집니다. 아래 표는 발표 글의 10개 분류 중 7개와 8개 모델 중 6개만 옮긴 것이고, 전체 표는 발표 글에 있습니다:
| 분류 | LFM3-VL-2B | LFM2.5-VL-3B | Qwen3.5-2B | Gemma 4 12B | GPT-5.6 Luna | Gemini 3.5 Flash Lite |
|---|---|---|---|---|---|---|
| 문서, OCR, 차트 | 83.9 | 71.2 | 79.1 | 85.7 | 84.4 | 82.3 |
| 수학과 논리 추론 | 68.8 | 40.6 | 61.0 | 79.3 | 77.3 | 66.7 |
| 시각 그라운딩 | 77.3 | 68.3 | 61.2 | 74.1 | 72.7 | 63.5 |
| 체화 추론 | 64.4 | 48.0 | 51.2 | 59.1 | 61.5 | 50.3 |
| GUI 이해 | 83.1 | 66.0 | 67.2 | 76.1 | 82.5 | 71.0 |
| 동영상 | 61.2 | 41.3 | 57.0 | 58.9 | 72.8 | 70.0 |
| 에이전트 | 42.5 | 21.1 | 15.2 | 43.6 | 56.1 | 62.4 |
| 62개 평균 | 71.4 | 57.6 | 64.0 | 71.7 | 73.4 | 70.0 |
평균만 보면 Liquid AI의 설명대로 비슷한 크기의 모델보다 7.4점 이상 높고, 6배 큰 Gemma 4 12B(71.7)와 비슷하며 GPT-5.6 Luna에 2점 뒤집니다. 분류별로 보면 강점과 약점이 나뉩니다. 그라운딩, 체화 추론, GUI 이해는 표의 모든 모델보다 높지만, 동영상과 에이전트 분류에서는 GPT-5.6 Luna와 Gemini 3.5 Flash Lite에 9~20점 뒤집니다. 동영상은 이번에 처음 추가된 기능입니다. 표에서 뺀 일반(General) 분류에서도 66.0으로 Gemma 4 12B(74.0), GPT-5.6 Luna(72.2), Gemini 3.5 Flash Lite(74.1)에 6~8점 뒤집니다.
새 비전 인코더와 기기 속도
비전 인코더는 이전 LFM VL 모델의 SigLIP2 대신 Liquid AI가 직접 만든 164M 인코더입니다. 14개 레이어 중 8개는 게이트 깊이별 2D 합성곱, 6개는 양방향 어텐션입니다. 동영상에서는 샘플링한 프레임 두 장을 하나의 시간 조각으로 묶어 임베딩하므로, 인코더에 들어가는 시간 방향 길이가 절반이 됩니다.
인코더끼리 비교한 실험은 언어 모델을 LFM2.5-230M으로 고정하고 13개 VLM 벤치마크의 평균 정확도를 쟀습니다. 연산량은 1024×768 이미지 한 장에 대한 인코더와 커넥터의 이론 FLOPs이며, 실제 지연 시간을 잰 값은 아닙니다.
| 비전 인코더 | 인코더 + 커넥터 연산량 | 평균 정확도 |
|---|---|---|
| Liquid 인코더 (164M) | 1.3 TFLOPs | 55.9% |
| Qwen3.5-2B 인코더 | 2.8 TFLOPs | 55.9% |
| Qwen3.5-0.8B 인코더 | 0.9 TFLOPs | 54.8% |
| SigLIP2 | 3.7 TFLOPs | 54.5% |
| C-RADIOv4 | 3.8 TFLOPs | 55.2% |
| Kimi-K3 | 6.2 TFLOPs | 55.5% |
Qwen3.5-2B 인코더와 같은 정확도를 2.2배 적은 연산으로 냈고, SigLIP2보다는 약 3배 적은 연산을 씁니다. 연산이 더 적은 인코더는 Qwen3.5-0.8B 것 하나이며, 정확도는 1.1점 낮습니다.
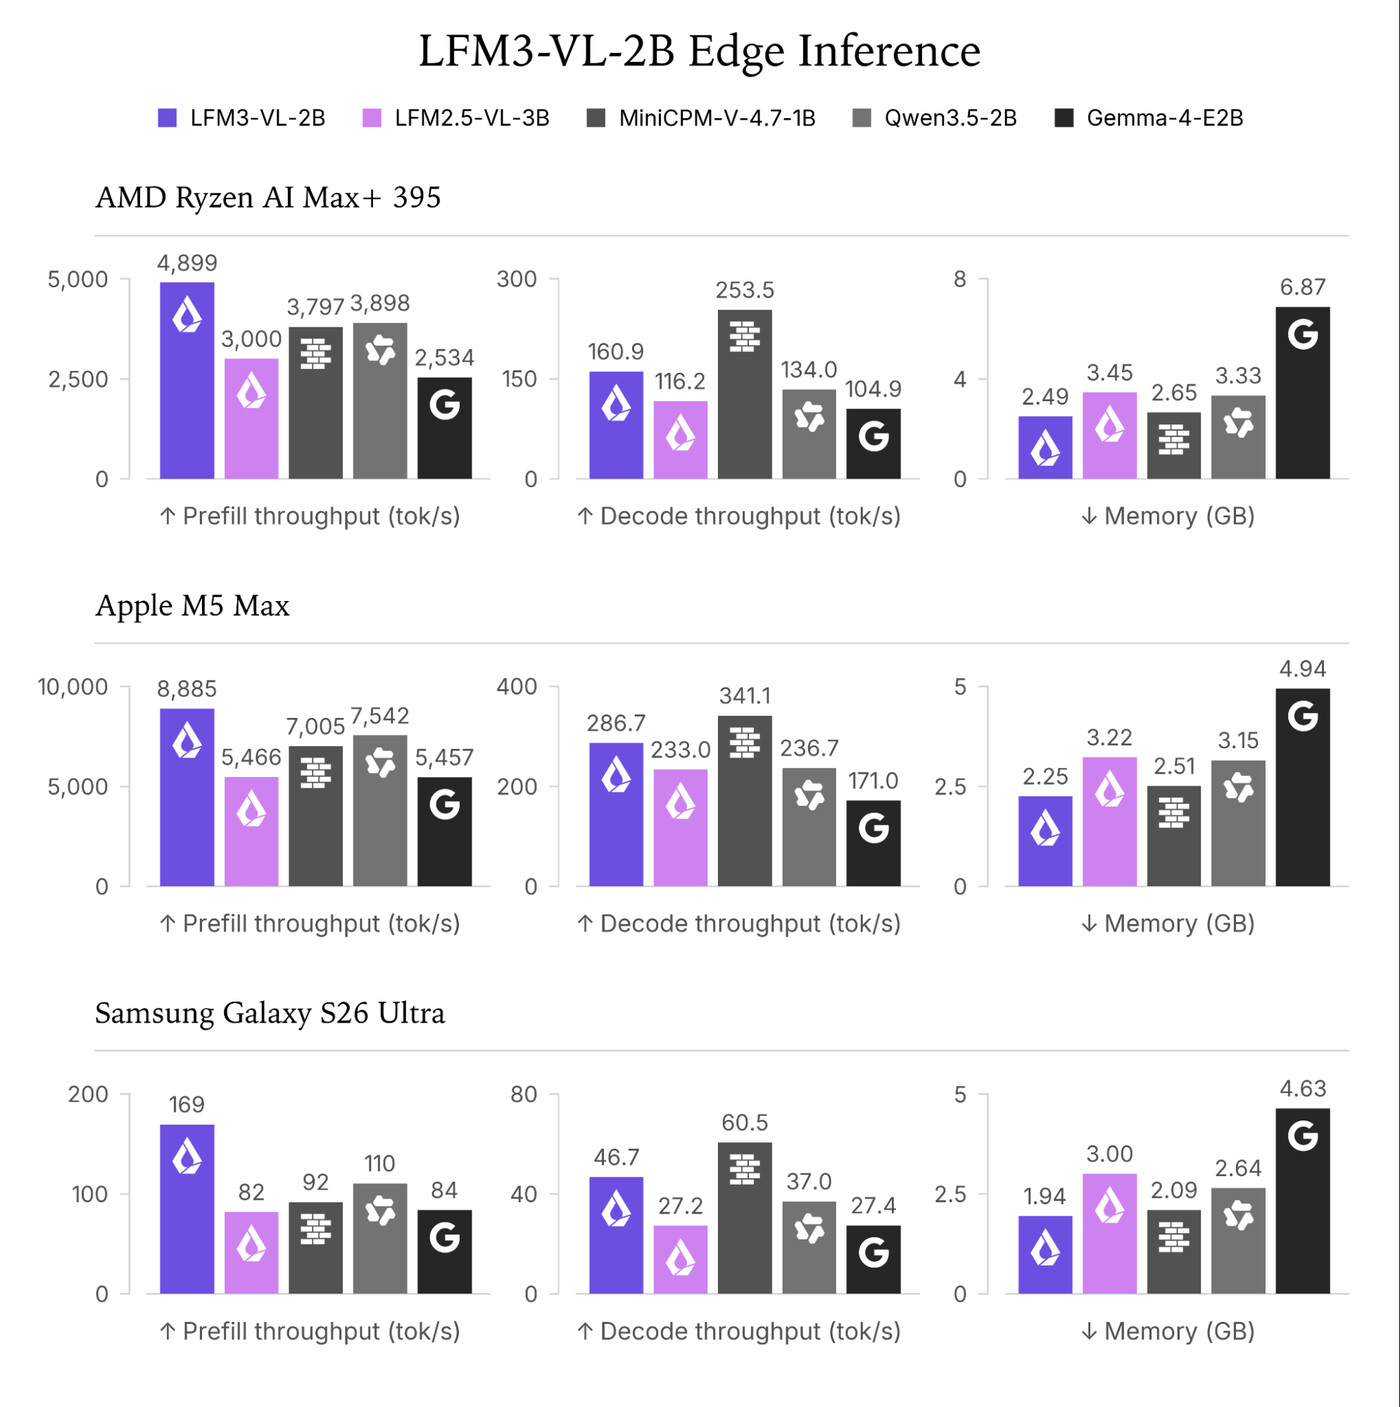
기기 측정에서 LFM3-VL-2B는 세 기기(AMD Ryzen AI Max+ 395, Apple M5 Max, Samsung Galaxy S26 Ultra) 모두에서 프리필 속도가 가장 빠르고 메모리를 가장 적게 썼습니다. 발표 글은 이 두 항목만 내세웁니다. 같은 그래프의 디코딩 속도는 세 기기 모두에서 MiniCPM-V-4.7-1B가 더 빠릅니다(예: Galaxy S26 Ultra에서 60.5 대 46.7 토큰/초). 이미지 한 장을 읽고 짧게 답하는 작업이면 프리필이, 긴 답을 생성하는 작업이면 디코딩이 체감 속도를 좌우합니다.
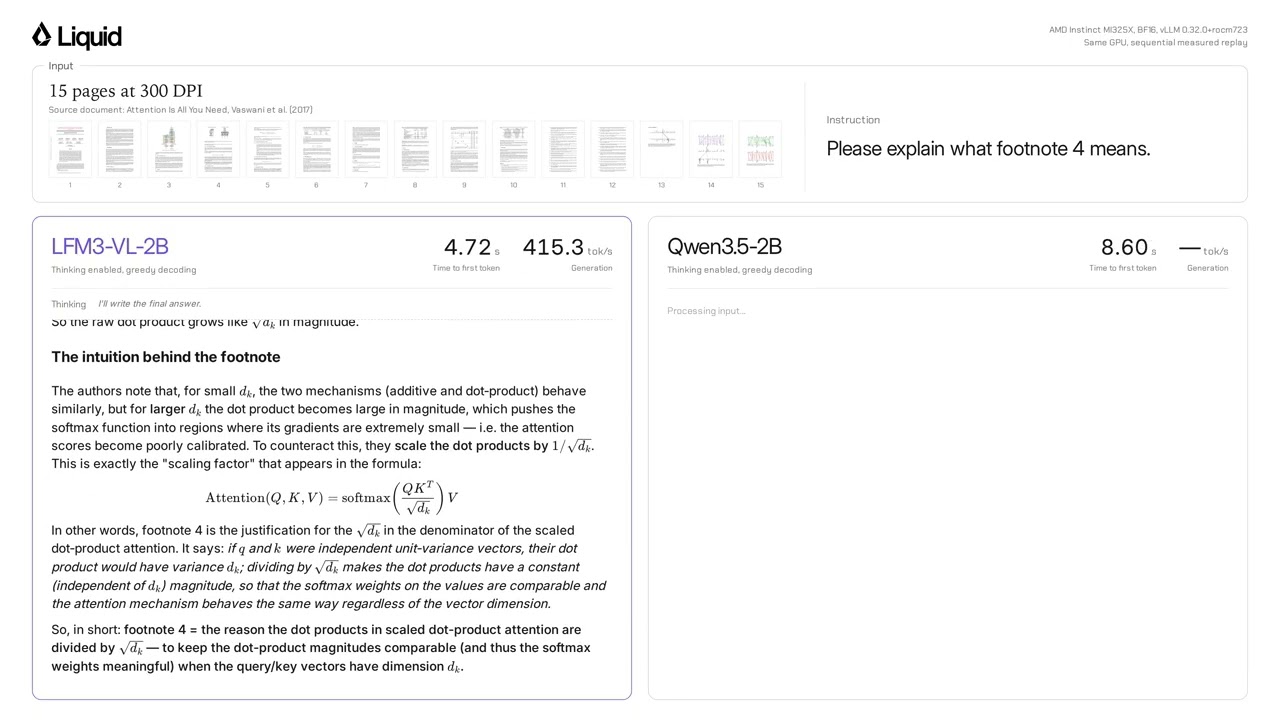
B300 한 장(SGLang 0.5.22에 LFM3 지원을 더한 버전)에서는 동시 요청 1,024개일 때 초당 12,000 토큰 이상을 출력했습니다. 아래 영상은 Qwen3.5-2B와 추론 속도를 나란히 비교한 데모입니다.
LFM3-Audio-2B와 LFM3-Omni-2B: 말하는 동안 프리필하는 음성 모델
LFM3-Audio-2B는 텍스트나 음성을 받아 텍스트, 음성, 또는 둘 다로 답합니다. 18개 언어에서 음성 인식과 음성 합성에 더해 음성 번역도 하며, 모델 카드는 영어가 들어간 언어 쌍에서 번역이 가장 잘된다고 적었습니다. 이전 모델 LFM2.5-Audio-1.5B와 비교하면 오디오 이해, 오디오 추론, 도구 호출이 더해졌습니다. 오디오 인코더와 코덱을 모두 새로 만들었습니다. 오디오 인코더는 SWA와 짧은 합성곱 레이어로만 이뤄진 완전 인과적(causal) 구조라, 사용자가 말하는 동안 마이크 입력을 받아 프리필을 진행합니다. 그래서 말을 마친 뒤 첫 토큰까지의 시간이 최소 50ms라고 합니다. 새 오디오 토크나이저 LiquidCodec 은 80ms 음성을 12개의 이산 토큰으로 표현하고, 이전 LFM 오디오 모델과 달리 여러 오디오 토큰을 병렬로 예측합니다. Apple M4 Max의 CPU 스레드 하나에서 실시간보다 약 87배 빠르게 음성을 만든다고 합니다.
기기 측정(AMD Ryzen AI Max+ 395, Apple M5 Max, Samsung Galaxy S26 Ultra)에서는 세 기기 모두에서 프리필과 디코딩이 비교 모델보다 빠르고 메모리도 가장 적었습니다(Galaxy S26 Ultra 디코딩 43.8 대 Qwen2.5-Omni-3B 19.7 토큰/초).
| 항목 | LFM3-Audio-2B | LFM2.5-Audio-1.5B | Gemma 4 E4B | Qwen2.5-Omni-3B | 표 안의 최고값 |
|---|---|---|---|---|---|
| 영어 음성 인식 단어 오류율(Word Error Rate, WER), 낮을수록 좋음 | 6.2 | 6.1 | 7.8 | 6.3 | 5.3 (Kimi-Audio-7B) |
| 다국어 음성 인식 WER, 한중일은 문자 오류율(CER) (9개 언어, 한국어 포함) | 6.0 | - | 6.5 | 7.4 | 6.0 |
| 영어 음성 합성 UTMOSv2, 높을수록 좋음 | 3.8 | 3.2 | - | 3.4 | 3.8 |
| VoiceBench | 73.1 | 55.2 | 72.9 | 66.4 | 77.3 (MiMo-Audio-7B) |
| 음성 입력 도구 호출 (자체 평가) | 58.5 | - | 72.4 | 44.3 | 72.4 (Gemma 4 E4B) |
| 오디오 이해 MMAR | 50.6 | 25.9 | 49.1 | 54.4 | 62.3 (MiMo-Audio-7B) |
음성 합성 품질과 다국어 음성 인식은 표에서 가장 좋지만, 영어 음성 인식은 이전 모델 LFM2.5-Audio와 비슷하고, 음성 입력 도구 호출은 Gemma 4 E4B에, 오디오 이해는 Qwen2.5-Omni-3B, MiMo-Audio-7B, Kimi-Audio-7B에 뒤집니다. 다국어 음성 인식의 9개 언어 평균에는 한국어가 들어 있으나, 한국어만 따로 뗀 수치는 공개되지 않았습니다.
LFM3-Omni-2B는 Liquid AI의 첫 옴니 모델입니다. 아래 구조도처럼 LFM3 비전 인코더와 오디오 인코더를 한 백본에 연결하고, 음성 출력은 Depthformer와 LiquidCodec이 만듭니다. 출력은 텍스트 6개, 오디오 12개 토큰이 번갈아 나오는 하나의 스트림입니다.
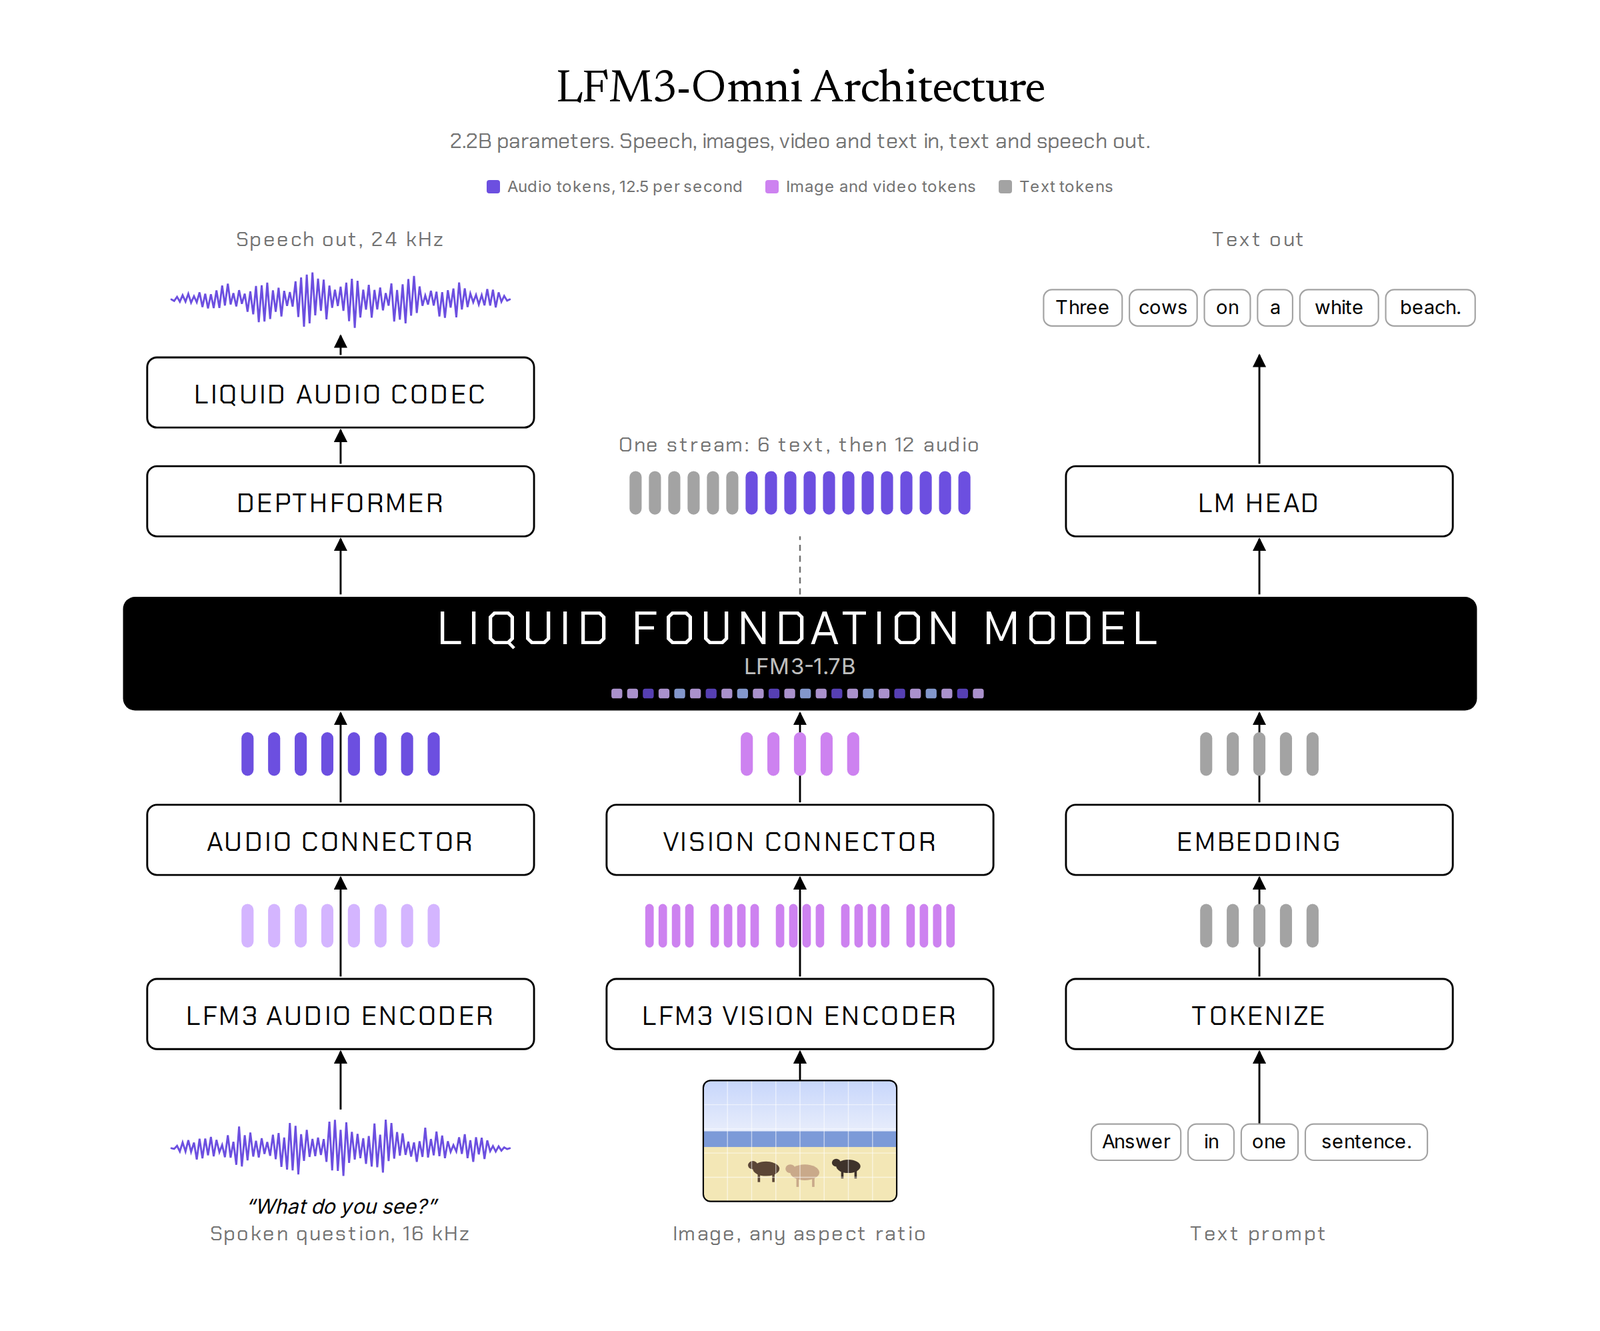
Liquid AI는 LFM3-Omni-2B를 음성 인식, 비전 언어, 언어, 음성 합성 모델 네 개를 따로 연결하는 구성의 대안으로 내세웁니다. 모델 카드의 옴니 벤치마크는 다음과 같습니다. 괄호 안은 모델 카드가 적은 전체 파라미터 수입니다:
| 벤치마크 | LFM3-Omni-2B (2.2B) | Qwen2.5-Omni-3B (6B) | Qwen2.5-Omni-7B (10.7B) | Gemma 4 E4B (8B) |
|---|---|---|---|---|
| Daily-Omni (동영상 + 소리) | 70.09 | 58.81 | 61.32 | 54.14 |
| WorldSense (동영상 + 소리) | 47.10 | 44.99 | 45.37 | 43.51 |
| AV-SpeakerBench (동영상 + 소리) | 46.79 | 40.44 | 43.24 | 36.36 |
| OmniBench 전체 (이미지 + 오디오) | 46.32 | 47.11 | 49.65 | 20.67 |
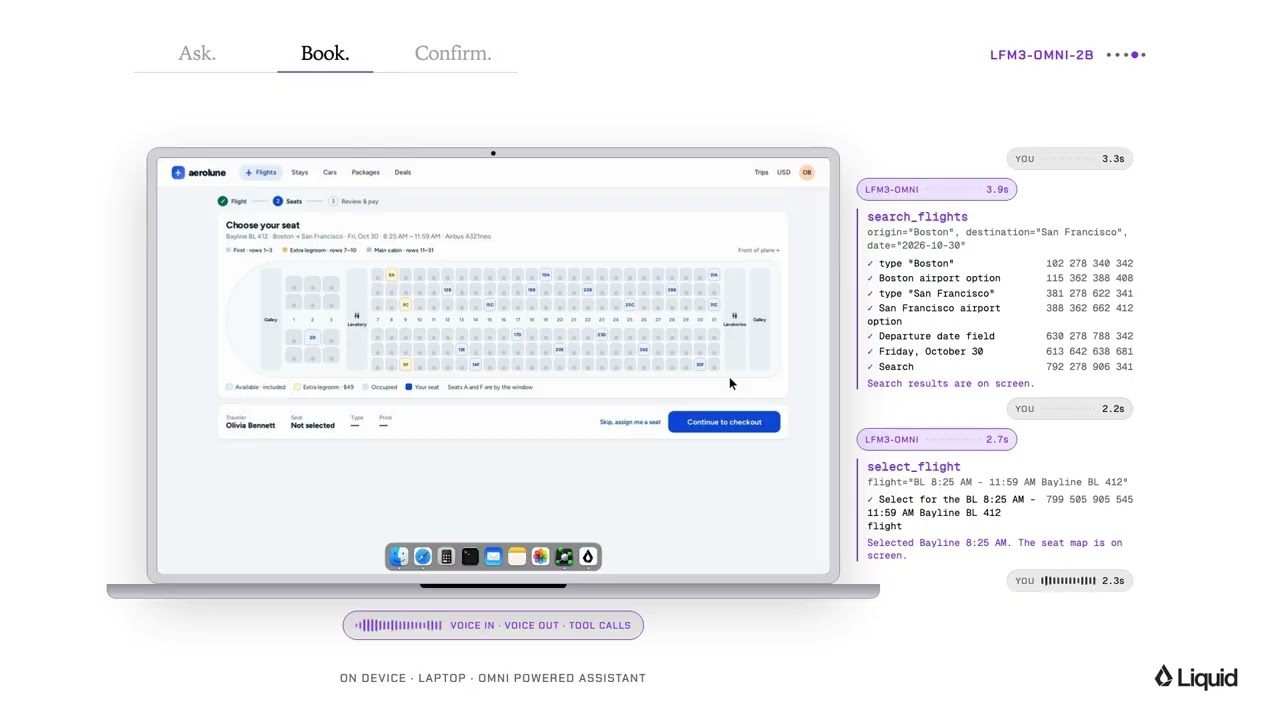
동영상의 화면과 소리를 함께 이해하는 세 벤치마크에서는 약 5배 큰 Qwen2.5-Omni-7B보다 높았습니다. 반면 이미지와 오디오를 함께 다루는 OmniBench에서는 Qwen2.5-Omni-3B와 7B 모두에 뒤졌습니다. 아래 데모는 노트북에서 음성으로 항공권을 예약하는 장면으로, 들은 요청을 화면 요소의 위치와 함께 도구 호출로 바꿉니다.
d1-2B와 d1-Omni-2B: 문장 대신 확률로 답하는 결정 모델
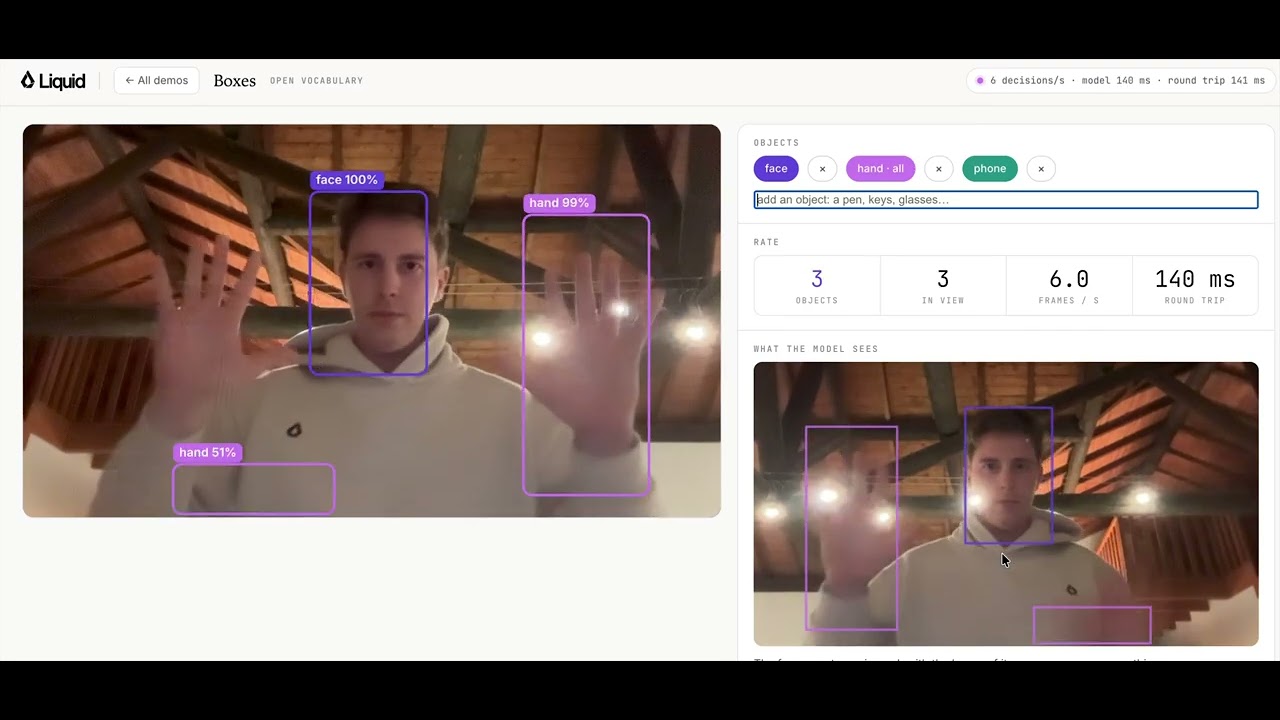
결정 모델은 10월 초에 나온 d1-3B의 후속입니다. 상황(지원 티켓, 송장, 앱 화면, 사진, 음성 메모)과 질문 목록을 주면, 문장을 생성하지 않고 한 번의 순전파로 모든 질문에 보정된 확률이 붙은 답을 냅니다. d1-2B는 LFM3-VL-2B에서, d1-Omni-2B는 LFM3-Omni-2B에서 만들었습니다.
이번에 가장 크게 바뀐 점은 타입이 있는 답(typed answers) 입니다. 예/아니오, 선택지, 점수에 더해 네 가지 답 형식이 생겼습니다.
- Point: 설명한 대상에 상자를 그리거나, 해당하는 모든 대상을 찾아 개수와 함께 반환
- Read: 문서에서 텍스트, 숫자, 날짜를 원문 위치와 함께 추출하고, 없으면 "not found"로 답함
- Estimate: 수치를 가능한 범위와 함께 추정
- Pick: 해당하는 선택지를 모두 고르고 각각에 확률을 붙임
d1-2B는 파라미터가 3분의 1 적지만 d1-3B보다 모든 지표가 높았습니다. Decision Index는 결정 모델 비교 글에서 다룬 벤치마크입니다.
| 벤치마크 | d1-3B | d1-2B |
|---|---|---|
| Decision Bench (실제 기업 기록) | 83.6 | 85.2 |
| Decision Index (공개 세트) | 49.0 | 51.1 |
| ImajevBench (사진과 규칙으로 판단) | 64.0 | 75.5 |
| Liquid AI 메타 지수 (비공개, 공개 117개 벤치마크) | 58.8 | 63.2 |
d1-Omni-2B는 같은 질문을 음성으로 받아도 정확도를 대부분 유지했습니다. DecisionBench는 글로 물을 때 83.4, 말로 물을 때 78.2였습니다. 환경음 분류 ESC-50은 84.5%, FLEURS의 43개 언어 식별은 92.5%입니다. 모델 카드는 상태 길이가 약 64K 토큰을 넘으면 답의 신뢰도가 떨어지고, d1-Omni-2B는 긴 음성 구간, 특히 라틴 문자가 아닌 언어에서 정확도가 크게 떨어진다고 적었습니다. 오디오가 없는 입력이면 d1-2B가 텍스트와 단일 상자 찾기에서 더 강하고 보정도 낫다고 합니다.
미세조정: 모델별 노트북, 풍력 터빈 검사, 로봇 제어
단일 GPU용 미세조정 노트북 10종
Liquid AI는 모든 LFM3 모델을 GPU 한 장으로 미세조정할 수 있다고 밝혔고, Hugging Face 블로그 글에서 텍스트, 비전, 오디오, 옴니 모델의 노트북 10개를 소개했습니다. 각 노트북은 데이터 준비부터 평가까지 한 작업을 끝까지 다루며, 쿡북 저장소에 있습니다:
| 모델 | 방법 | 작업 | 노트북 |
|---|---|---|---|
| LFM3-1.7B | SFT | 정리되지 않은 문서에서 구조화된 JSON 추출 | lfm3_sft_with_trl |
| LFM3-1.7B | DPO | 검색한 문서로 답하거나 답변 거절 | lfm3_dpo_with_trl |
| LFM3-1.7B | GRPO | 도구 108개가 있는 휴대폰 앱에서 맞는 도구 호출 | lfm3_grpo_with_trl |
| LFM3-1.7B | 지속 사전 학습(CPT) | 원시 텍스트로 새 언어(튀르키예어) 학습 | lfm3_cpt_with_trl |
| LFM3-VL-2B | SFT | 영수증 사진을 JSON으로 변환 | lfm3_vl_sft_with_trl |
| LFM3-VL-2B | GRPO | 수식 이미지를 LaTeX로 옮기기 | lfm3_vl_grpo_with_trl |
| LFM3-Audio-2B | SFT | 음성 스마트홈 명령을 함수 호출로 변환 | lfm3_audio_sft_with_transformers |
| LFM3-Audio-2B | SFT | 새 목소리 학습(음성 합성) | lfm3_audio_tts_sft_with_transformers |
| LFM3-Omni-2B | SFT | 음성 스마트홈 명령을 함수 호출로 변환 | lfm3_omni_sft_with_transformers |
| LFM3-Omni-2B | SFT | 의료 영상에 대한 음성 질문에 답하기 | lfm3_omni_vqa_sft_with_transformers |
텍스트와 비전 모델 노트북은 TRL을, 오디오와 옴니 모델 노트북은 Transformers를 씁니다. 결정 모델용으로는 같은 폴더에 SFT 노트북 두 개(TRL판, Unsloth판)가 있지만, 둘 다 이전 세대 d1-3B를 미세조정하는 예제이고 d1-2B용으로 바뀌지는 않았습니다.
풍력 터빈 블레이드 결함 찾기: 유형 정확도는 올랐지만 검출은 아직 어렵다
Liquid AI는 드론으로 찍은 풍력 터빈 블레이드 사진에서 9가지 결함을 찾고 유형을 붙이는 작업으로 LFM3-VL-2B를 미세조정했습니다. 학습 데이터는 공개 데이터셋 WTBs2025(CC BY 4.0)의 사진 약 3,000장입니다. A100 한 장에서 LoRA 기반 SFT와 GRPO를 몇 시간 돌렸고, 전체 과정은 쿡북의 노트북 4개로 공개되어 있습니다. 쿡북 README의 테스트 사진 1,372장 결과는 다음과 같습니다:
| 모델 | 결함 유형 정확도 | 검출 F1 | 사진당 출력 토큰 |
|---|---|---|---|
| LFM3-VL-2B 미세조정 (SFT + GRPO) | 66.5% | 0.106 | 약 31 |
| LFM3-VL-2B 기본 모델 | 9.2% | 0.003 | 약 85 |
| GPT-6 Luna | 8.5% | 0.010 | 약 762 |
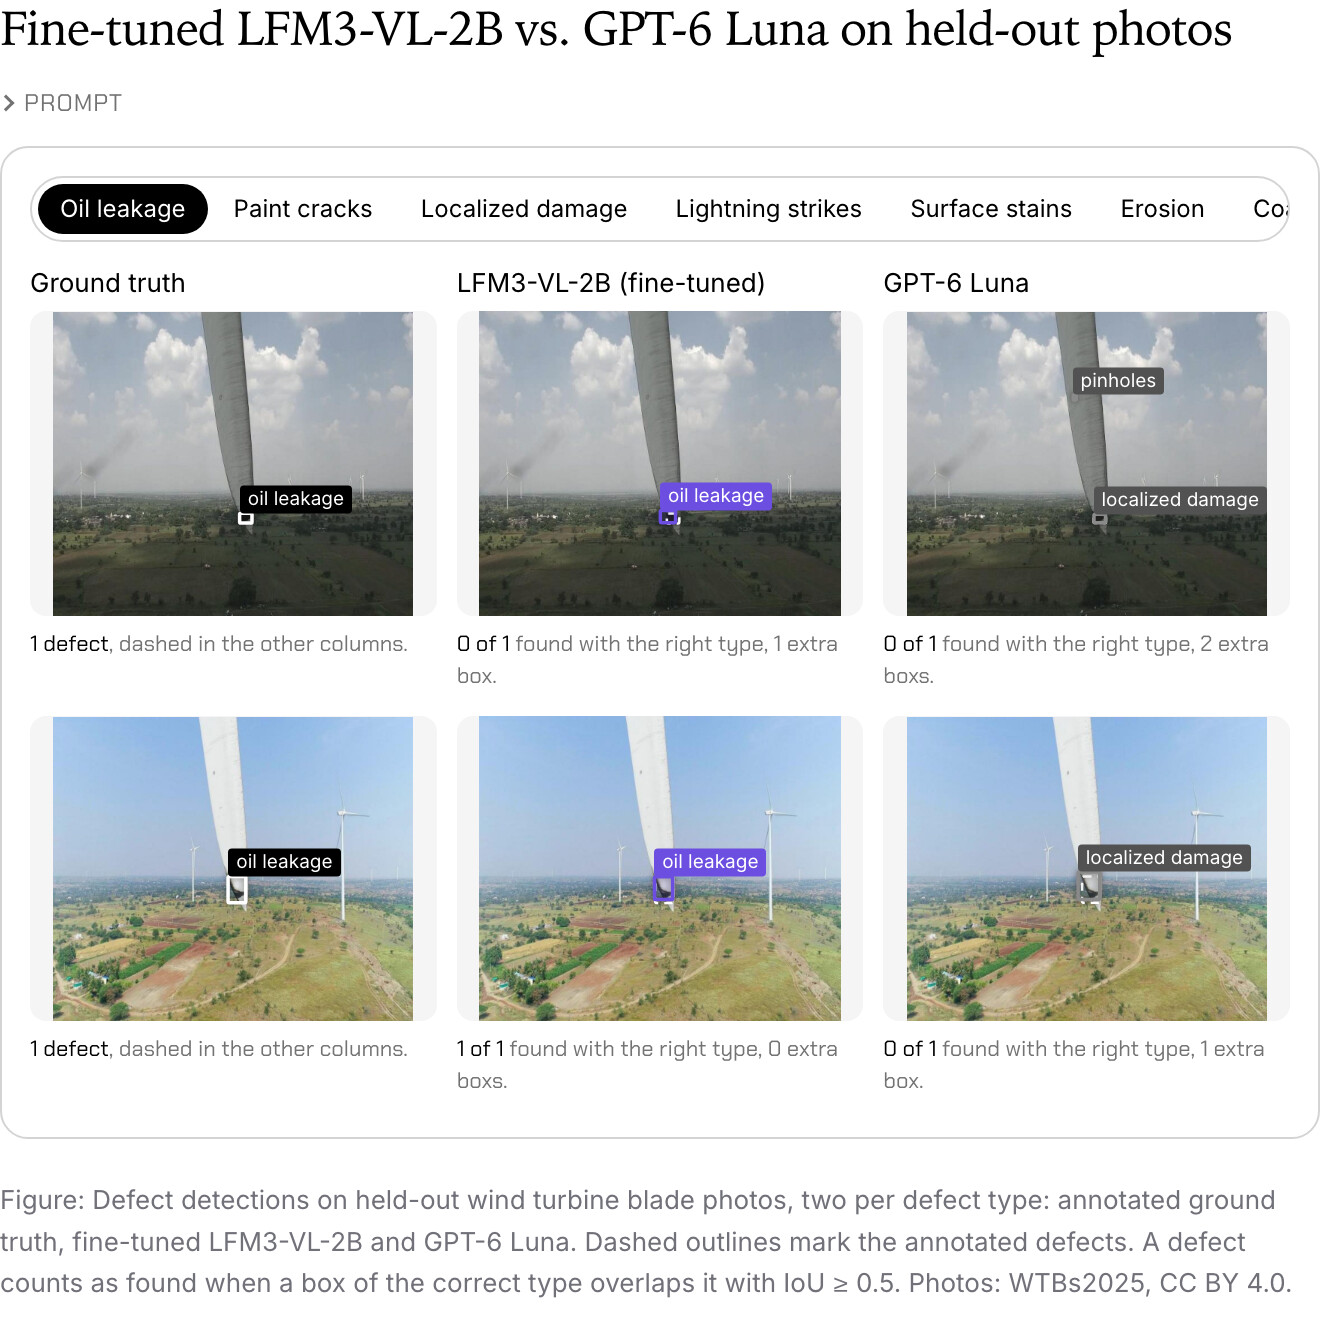
발표 글은 유형 정확도 67%를 앞세웠지만, 검출 F1은 0.106에 그칩니다. 쿡북 README에 따르면 미세조정한 모델이 정확한 유형과 상자로 찾아낸 결함은 2,030개 중 190개이며, 작은 결함일수록 재현율이 낮습니다. 유형을 맞히는 데는 짧은 미세조정이 큰 효과를 냈지만, 결함 위치를 찾는 문제는 여전히 어렵다는 결과입니다. Liquid AI는 README에서 일부 라벨이 모호하니 전문가 검토가 필요하다고도 적었습니다.
로봇: 공개 체크포인트가 없는 연구 결과
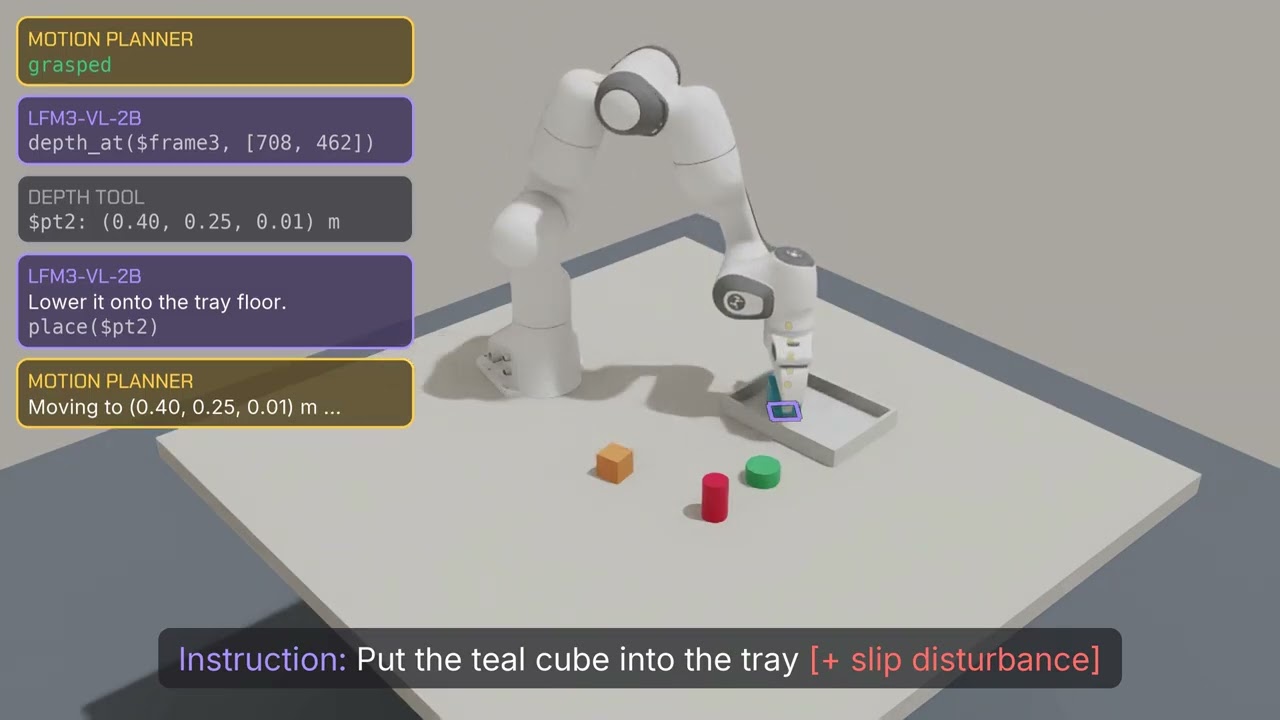
Liquid AI는 LFM3-VL-2B를 로봇에 쓰는 세 방향의 실험도 발표했습니다. 이 결과에 쓰인 체크포인트는 LFM3 Hugging Face 컬렉션에 없으므로, 연구 결과 발표로 읽어야 합니다.
- 도구 오케스트레이션: 요청과 카메라 이미지를 받아 물체를 가리키고, 깊이 도구로 재고, 모션 플래너로 로봇 팔을 움직인 뒤, 다음 카메라 이미지로 결과를 확인합니다. rank 32 LoRA를 샘플 약 4만 개로 AMD Instinct MI325X 한 장에서 약 6 GPU시간 학습했고, Isaac Sim에서 시험했습니다.
- 시각 언어 내비게이션(Vision-and-Language Navigation, VLN): 경로 설명과 최근 RGB 프레임으로 10개 경유점 경로를 토큰 5개로 예측합니다. R2R에서 성공률 53%, RxR에서 43%이며, Jetson AGX Orin에서 2.5Hz 이상으로 경로를 갱신합니다.
- 조작(시각 언어 행동 모델, VLA): 이미지, 언어 지시, 로봇 상태를 받아 작은 MLP가 8단계 연속 행동을 한 번의 순전파로 출력합니다. 15종 로봇 데이터로 170 GPU시간 학습해 LIBERO 4개 세트 평균 96.2%, RoboCasa-GR1 탁상 과제 45.7%를 기록했습니다. 행동 묶음 생성 시간은 Jetson AGX Orin에서 TensorRT FP16으로 실행할 때 50ms 미만입니다.
지금 실행할 수 있는 환경 (2026년 10월 28일 기준)
발표 글은 "출시 당일부터 llama.cpp, MLX, vLLM을 기본 지원"한다고 밝혔습니다. 각 저장소를 확인해 보니 지원 상태는 프레임워크마다 달랐습니다.
| 프레임워크 | 상태 |
|---|---|
| llama.cpp | 텍스트, VL, Audio, Omni, d1 지원 PR이 10월 27일 병합되었고, 릴리스 b11946에 포함됨. LFM3 동영상 입력 PR #31283은 10월 28일 병합되어 b11954 다음 릴리스부터 포함됨 |
| Transformers | 본 저장소 지원 PR #50036이 열려 있음. 지금은 모델 저장소의 코드를 trust_remote_code=True로 불러와야 함 |
| SGLang | 지원 PR #46858이 리뷰 중. 발표의 B300 처리량도 이 지원을 더한 버전으로 측정 |
| vLLM | LFM3 관련 PR이 검색되지 않음. 텍스트, 오디오 모델 카드는 BF16 실행 환경에 vLLM을 적었지만 실행 명령은 없고, LFM3-VL-2B 모델 카드는 "지원 작업 중"으로 표기 |
| MLX | mlx-vlm은 VL, Audio, Omni, d1 지원이 병합됨. 텍스트 모델용 mlx-lm PR #2016은 열려 있음 |
텍스트 모델을 가장 빨리 시험하는 방법은 b11946 이후의 llama.cpp에 GGUF를 받는 것입니다. 모델 카드가 권하는 샘플링 값을 그대로 넣었습니다.
llama-cli -hf LiquidAI/LFM3-1.7B-GGUF:Q4_K_M \
  --temp 0.1 --top-k 50 --repeat-penalty 1.1
LFM3-1.7B-QAD-Q4_0.gguf는 Q4_0 양자화로 떨어진 정확도를 되찾도록 양자화 인지 증류(Quantization-Aware Distillation, QAD) 로 학습한 파일입니다. 발표의 기기 측정도 Q4_0으로 했습니다. Python에서는 다음처럼 불러옵니다:
from transformers import pipeline

generator = pipeline(
    "text-generation",
    model="LiquidAI/LFM3-1.7B",
    trust_remote_code=True,
)

messages = [{"role": "user", "content": "What is C. elegans?"}]
output = generator(
    messages,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.1,
    max_new_tokens=2048,
)
print(output[0]["generated_text"][-1]["content"])
수학과 과학 문제에는 temperature=1.0, top_p=0.95, top_k=20을 권합니다. 비전 모델은 transformers>=5.21.0, 오디오와 옴니 모델은 transformers>=5.20.2, 결정 모델은 transformers>=5.19가 필요하다고 각 모델 카드에 적혀 있습니다. LFM3-VL-2B 예제는 답하기 전 추론이 길어질 수 있다며 max_new_tokens=16384를 지정합니다.
결정 모델은 생성 API 대신 system_one(상태, 질문) 메서드를 씁니다. 질문마다 이름과 형식(noul은 예/아니오 확률, choice는 선택지, score는 점수)을 정하면, 한 번의 순전파로 모든 질문의 답이 나옵니다. 아래는 Hugging Face 블로그 글과 d1-2B 모델 카드의 예제로, 지원 티켓 하나에 질문 네 개를 묻습니다:
import torch
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
dtype = torch.float32 if device == "cpu" else torch.bfloat16
model = AutoModel.from_pretrained("LiquidAI/d1-2B", trust_remote_code=True, dtype=dtype).to(device)

# Several named questions over one state, answered in one pass
questions = {
    "refund": {"type": "noul", "instructions": "Is the customer asking for a refund?"},  # yes/no: P(yes)
    "team": {"type": "choice", "instructions": "Which team should handle this?",
             "criteria": {"billing": "Charges, refunds, invoices", "shipping": "Delivery and parcels",
                          "technical": "App or site faults"}},
    "topics": {"type": "choice", "multiple": True, "instructions": "Which topics does the message raise?",
               "criteria": {"billing": "Payments and charges", "delivery": "Shipping and parcels",
                            "login": "Signing in to the account"}},
    "urgency": {"type": "score", "instructions": "How urgent is this ticket?", "criteria": ["low", "medium", "high"]},
}
out = model.system_one("I was charged twice and my parcel never arrived. Please refund one charge.", questions)
a = out["answers"]
urgency = a["urgency"]["legend"][str(int(a["urgency"]["score"]))]
print(round(a["refund"]["noul"], 2), a["team"]["choice"], a["topics"]["choices"], urgency)
# 1.0 billing ['billing', 'delivery'] medium
여러 상태를 한 번에 처리하는 system_one_batch도 있으며, 이미지와 음성 입력 예제는 각 모델 카드에 있습니다.
Liquid AI 문서의 Agent Harnesses 가이드는 에이전트 하네스 연결 방법을 설명하지만, 아직 LFM2.5-2.6B를 예로 듭니다. 출시 파트너로는 AMD, Arm, Ambarella, Intel(OpenVINO), NVIDIA, Qualcomm, OpenRouter, Vercel이 소개되었고, Mercedes-Benz와 Shopify는 출시 전 시험과 평가에 참여했습니다.
라이선스
LFM3의 7개 체크포인트는 모두 LFM Open License v1.0으로 배포됩니다. PyTorchKR이 비교해 보니 LFM2.5-24B-A2B의 라이선스 파일과 내용이 같습니다. 복제, 수정, 재배포 조항은 Apache License 2.0과 비슷하지만, 5조에 상업적 사용 제한이 있습니다. 연 매출 1,000만 달러 이상인 법인의 상업적 사용은 이 라이선스가 허가하지 않습니다. 연구와 비상업적 사용, 그리고 매출이 그보다 적은 기업의 상업적 사용은 가능합니다. 비영리 단체의 비상업, 연구 목적 사용에는 매출 기준이 적용되지 않습니다.
Liquid AI의 라이선스 안내 문서에 따르면 미세조정한 파생 모델에도 같은 기준이 적용되고, 모델을 고객사에 배포하면 고객사의 상업적 사용은 고객사의 매출로 따로 판단합니다.
정리: 누가 먼저 써 볼 만한가
LFM3-1.7B는 가중치 약 1GB(4비트), 32K 문맥에서 최대 메모리 1.9~2.75GB로 도구 호출과 웹, 업무 앱 조작을 하는 로컬 에이전트를 만들려는 개발자에게 가장 먼저 맞는 모델입니다. Liquid AI의 측정에서 이 영역의 점수는 9B 모델과 비슷하거나 높았고, 기기에서는 비교 모델보다 빠르고 KV 캐시는 작았습니다. 반면 코딩 에이전트, 지식 질문, 128K 문맥의 정보 찾기에는 더 큰 모델이 낫고, 지식 작업에는 검색을 붙여야 합니다.
비전, 음성, 결정 모델은 같은 백본을 공유하므로 한 기기에서 여러 모델을 함께 쓰거나 같은 미세조정 절차를 재사용하기 쉽습니다. 다만 동영상과 에이전트 시각 과제는 아직 약점입니다. GPU 서빙은 SGLang과 vLLM 지원이 병합될 때까지 기다리는 편이 안전합니다. 상업적 사용을 생각한다면 회사 매출이 라이선스 기준을 넘는지부터 확인해야 합니다.
 Introducing LFM3: Every Modality for Specialized Intelligence 블로그
 Build specialized multimodal models with LFM3 Hugging Face 블로그
LFM3 모델 컬렉션 Hugging Face
LFM3-1.7B 모델 카드
 풍력 터빈 블레이드 검사 미세조정 예제 GitHub 저장소
 Introducing LFM3 YouTube 영상
더 읽어보기
-
RIPL: Real-time Intelligence When Every Millisecond Counts (Liquid AI 블로그)
-
Liquid AI, 활성 2B로 로컬 에이전트를 돌리는 MoE 추론 모델 LFM2.5-24B-A2B 공개 (feat. Hermes Agent)
-
Liquid AI, 엣지 기기에서 한 번의 순전파로 판단하는 결정 모델 d1-3B와 d1-omni-600M 공개
-
Liquid AI, 문장 생성 대신 Jev 호환 API로 분류 / 라우팅 / 점수를 처리하는 결정 모델 d1 공개
-
Liquid AI, VLM 디코딩 속도를 2.66~3.13배 가량 높인 LFM2.5-VL-3B-DSpark 모델 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
