핵심 요약
- Liquid AI가 Open d1 소개 글에서 결정 모델 두 종의 가중치를 공개했습니다. 디코더 기반 d1-3B는 텍스트와 이미지를, 인코더 기반 실험판 d1-omni-600M은 텍스트와 이미지 또는 텍스트와 음성을 받습니다.
- 두 모델 모두 문장을 생성하지 않고, 예/아니오(Noul), 선택(Choice), 점수(Score) 질문에 대한 확률을 순전파 한 번으로 돌려줍니다. Transformers와 llama.cpp로 로컬에서 실행할 수 있습니다.
- Liquid AI가 직접 잰 Decision Index 0.2.1에서 d1-3B는 48.57점으로 10B 미만 모델 중 가장 높았습니다. d1-omni-600M은 15.95점이며, Hugging Face 블로그 본문에는 이 점수가 빠져 있습니다.
- d1-3B는 Jetson AGX Thor에서 질문 하나에 16ms, Jetson Orin Nano에서 50ms가 걸렸습니다. d1-omni-600M의 속도는 공개하지 않았습니다.
- 라이선스는 LFM Open License v1.0입니다. 연 매출 1천만 달러 이상인 기업의 상업적 사용은 허가 범위 밖이어서, Liquid AI 블로그의 "제한 없이"라는 표현과 다릅니다.
이전 d1 글과 무엇이 다른가요?
이전 d1 글은 9월 말 출시된 호스팅 API d1을 다뤘고, 이 글은 가중치를 공개한 별도의 작은 모델 두 종을 다룹니다.
- 대상 모델: 이전 글은 가중치를 공개하지 않은 API d1, 이 글은 공개 가중치 d1-3B와 d1-omni-600M입니다. 이름은 같은 계열이지만 서로 다른 모델이고, Decision Index 자체 측정 점수도 약 60점 대 48.57점으로 다릅니다.
- 실행 방식: 이전 글은 Liquid API를 typesafe-sdk로 호출하는 방법을, 이 글은 Transformers, llama.cpp, Jetson에서 로컬로 실행하는 방법을 설명합니다.
- 다루는 내용: 이전 글은 질문 설계,
confidence해석, 기존 LLM 호출을 옮기는 패턴, Road Decider 예제를 다뤘습니다. 이 글은 두 모델의 구조와 학습, 벤치마크 세부 칸, 기기별 지연, 라이선스를 다룹니다. 질문 형식은 같으므로 질문 설계는 이전 글을 참고하시면 됩니다.- 이전 글 이후 바뀐 점: API d1은 10월 5일 이미지 입력과 요금(입력 100만 토큰당 0.04달러)을 추가했습니다. 두 모델 중 무엇을 쓸지는 아래 "API d1과 공개 d1-3B 비교" 절에 정리했습니다.
Liquid AI의 공개 결정 모델 d1-3B와 d1-omni-600M 소개
d1-3B 와 d1-omni-600M 은 Liquid AI가 2026년 10월 7일 공개한 결정 모델(Decision Model) 입니다. 결정 모델은 문장을 생성하지 않고, 앱이 정한 선택지마다 확률을 돌려주는 모델입니다. 고객 문의의 담당 팀, 카메라에 보이는 손 모양, 메시지의 유해성처럼 답의 후보가 미리 정해진 판단이 대상입니다. 이 글은 이런 판단을 노트북이나 엣지 기기에서 직접 처리하려는 개발자를 위해 썼습니다.
이 범주는 TypeSafe AI가 2026년 9월 공개한 Jev에서 시작됐습니다. Jev는 가중치를 공개하지 않은 API 전용 모델이었고, 그 뒤 수십 개의 공개 재현 모델이 나왔습니다. 이 모델들의 점수는 커뮤니티 리더보드인 Decision Index로 비교합니다. Liquid AI도 9월 말 텍스트 전용 실험판으로 결정 모델 d1을 Jev와 호환되는 API로 먼저 출시했습니다. 10월 5일에는 이미지 입력을 더한 d1을 출시 블로그에서 정식으로 소개했습니다. Liquid AI는 그 글에서 다음 모델들의 가중치를 Hugging Face에 곧 공개하겠다고 예고했고, 이틀 뒤 이번 두 모델을 공개했습니다.
이번 공개는 그 d1 계열의 가중치 공개판 입니다. 다만 API로 제공하는 d1과 이번에 공개한 d1-3B는 같은 모델이 아닙니다. Liquid AI가 직접 잰 Decision Index 점수로 보면 호스팅 API d1은 아래 산점도 기준 약 60점(9월 발표 때는 58.9점)이고 d1-3B는 48.57점입니다. 따라서 이번 공개는 API d1을 내려받을 수 있게 된 것이 아니라, 작은 크기로 따로 만든 모델을 공개한 것입니다.
이 글은 Hugging Face 블로그의 공개 발표를 중심으로 정리했습니다. 학습 과정을 더 자세히 적은 Liquid AI 블로그, 두 모델 카드, 라이선스 파일, llama.cpp 저장소도 함께 확인했습니다. 이 글에서 직접 모델을 실행해 보지는 않았으며, 모든 수치는 Liquid AI가 발표한 값입니다.
두 모델의 구조: 디코더 기반 d1-3B와 인코더 기반 d1-omni-600M
두 모델은 이름은 비슷하지만 바탕이 되는 모델이 완전히 다릅니다. d1-3B는 Liquid AI의 LFM(Liquid Foundation Models) 계열 비전-언어 모델(Vision-Language Model, VLM) 인 LFM2.5-VL-3B에서 출발한 디코더 모델입니다. d1-omni-600M은 양방향 인코더인 LFM2.5-Encoder-350M에 비전 인코더와 오디오 인코더를 붙였습니다. 모델 카드의 제원은 다음과 같습니다.
| 항목 | d1-3B | d1-omni-600M |
|---|---|---|
| 바탕 모델 | LFM2.5-VL-3B (디코더) | LFM2.5-Encoder-350M (양방향 인코더) |
| 전체 파라미터 | 3.12B | 587M (본체와 결정 헤드 381M, 비전 94M, 오디오 112M) |
| 입력 | 텍스트, JSON, 이미지 | 텍스트와 이미지, 또는 텍스트와 음성 (동시에 둘 다는 불가) |
| 비전 인코더 | SigLIP2 NaFlex 400M | LFM2.5-VL-450M의 SigLIP2 |
| 오디오 인코더 | 없음 | 17층 FastConformer, 최대 30초, 16kHz 모노 |
| 컨텍스트 길이 | 32,768 토큰 | 16,384 토큰 (이미지가 있으면 텍스트는 896 토큰까지) |
| 출시 상태 | 정식 공개 | 초기 연구용 공개 (실험판) |
d1-3B: 두 모델의 가중치를 평균한 디코더
Liquid AI 블로그에 따르면 d1-3B는 먼저 텍스트 모델 LFM2.5-2.6B와 LFM2.5-VL-3B의 텍스트 백본 가중치를 평균해 바탕 모델을 만들었습니다. 그다음 무작위 시드와 데이터 구성을 바꿔 여러 체크포인트를 미세조정(Fine-tuning) 한 뒤 다시 병합했습니다. Liquid AI는 고급 기법보다 긴 입력으로 학습하기, 선택지 순서 섞기, 데이터 속 지름길(shortcut) 고치기 가 더 큰 차이를 냈다고 적었습니다. 선택지 순서를 섞는 이유는 모델이 내용 대신 첫 번째 선택지 같은 위치를 외우지 못하게 하려는 것입니다.
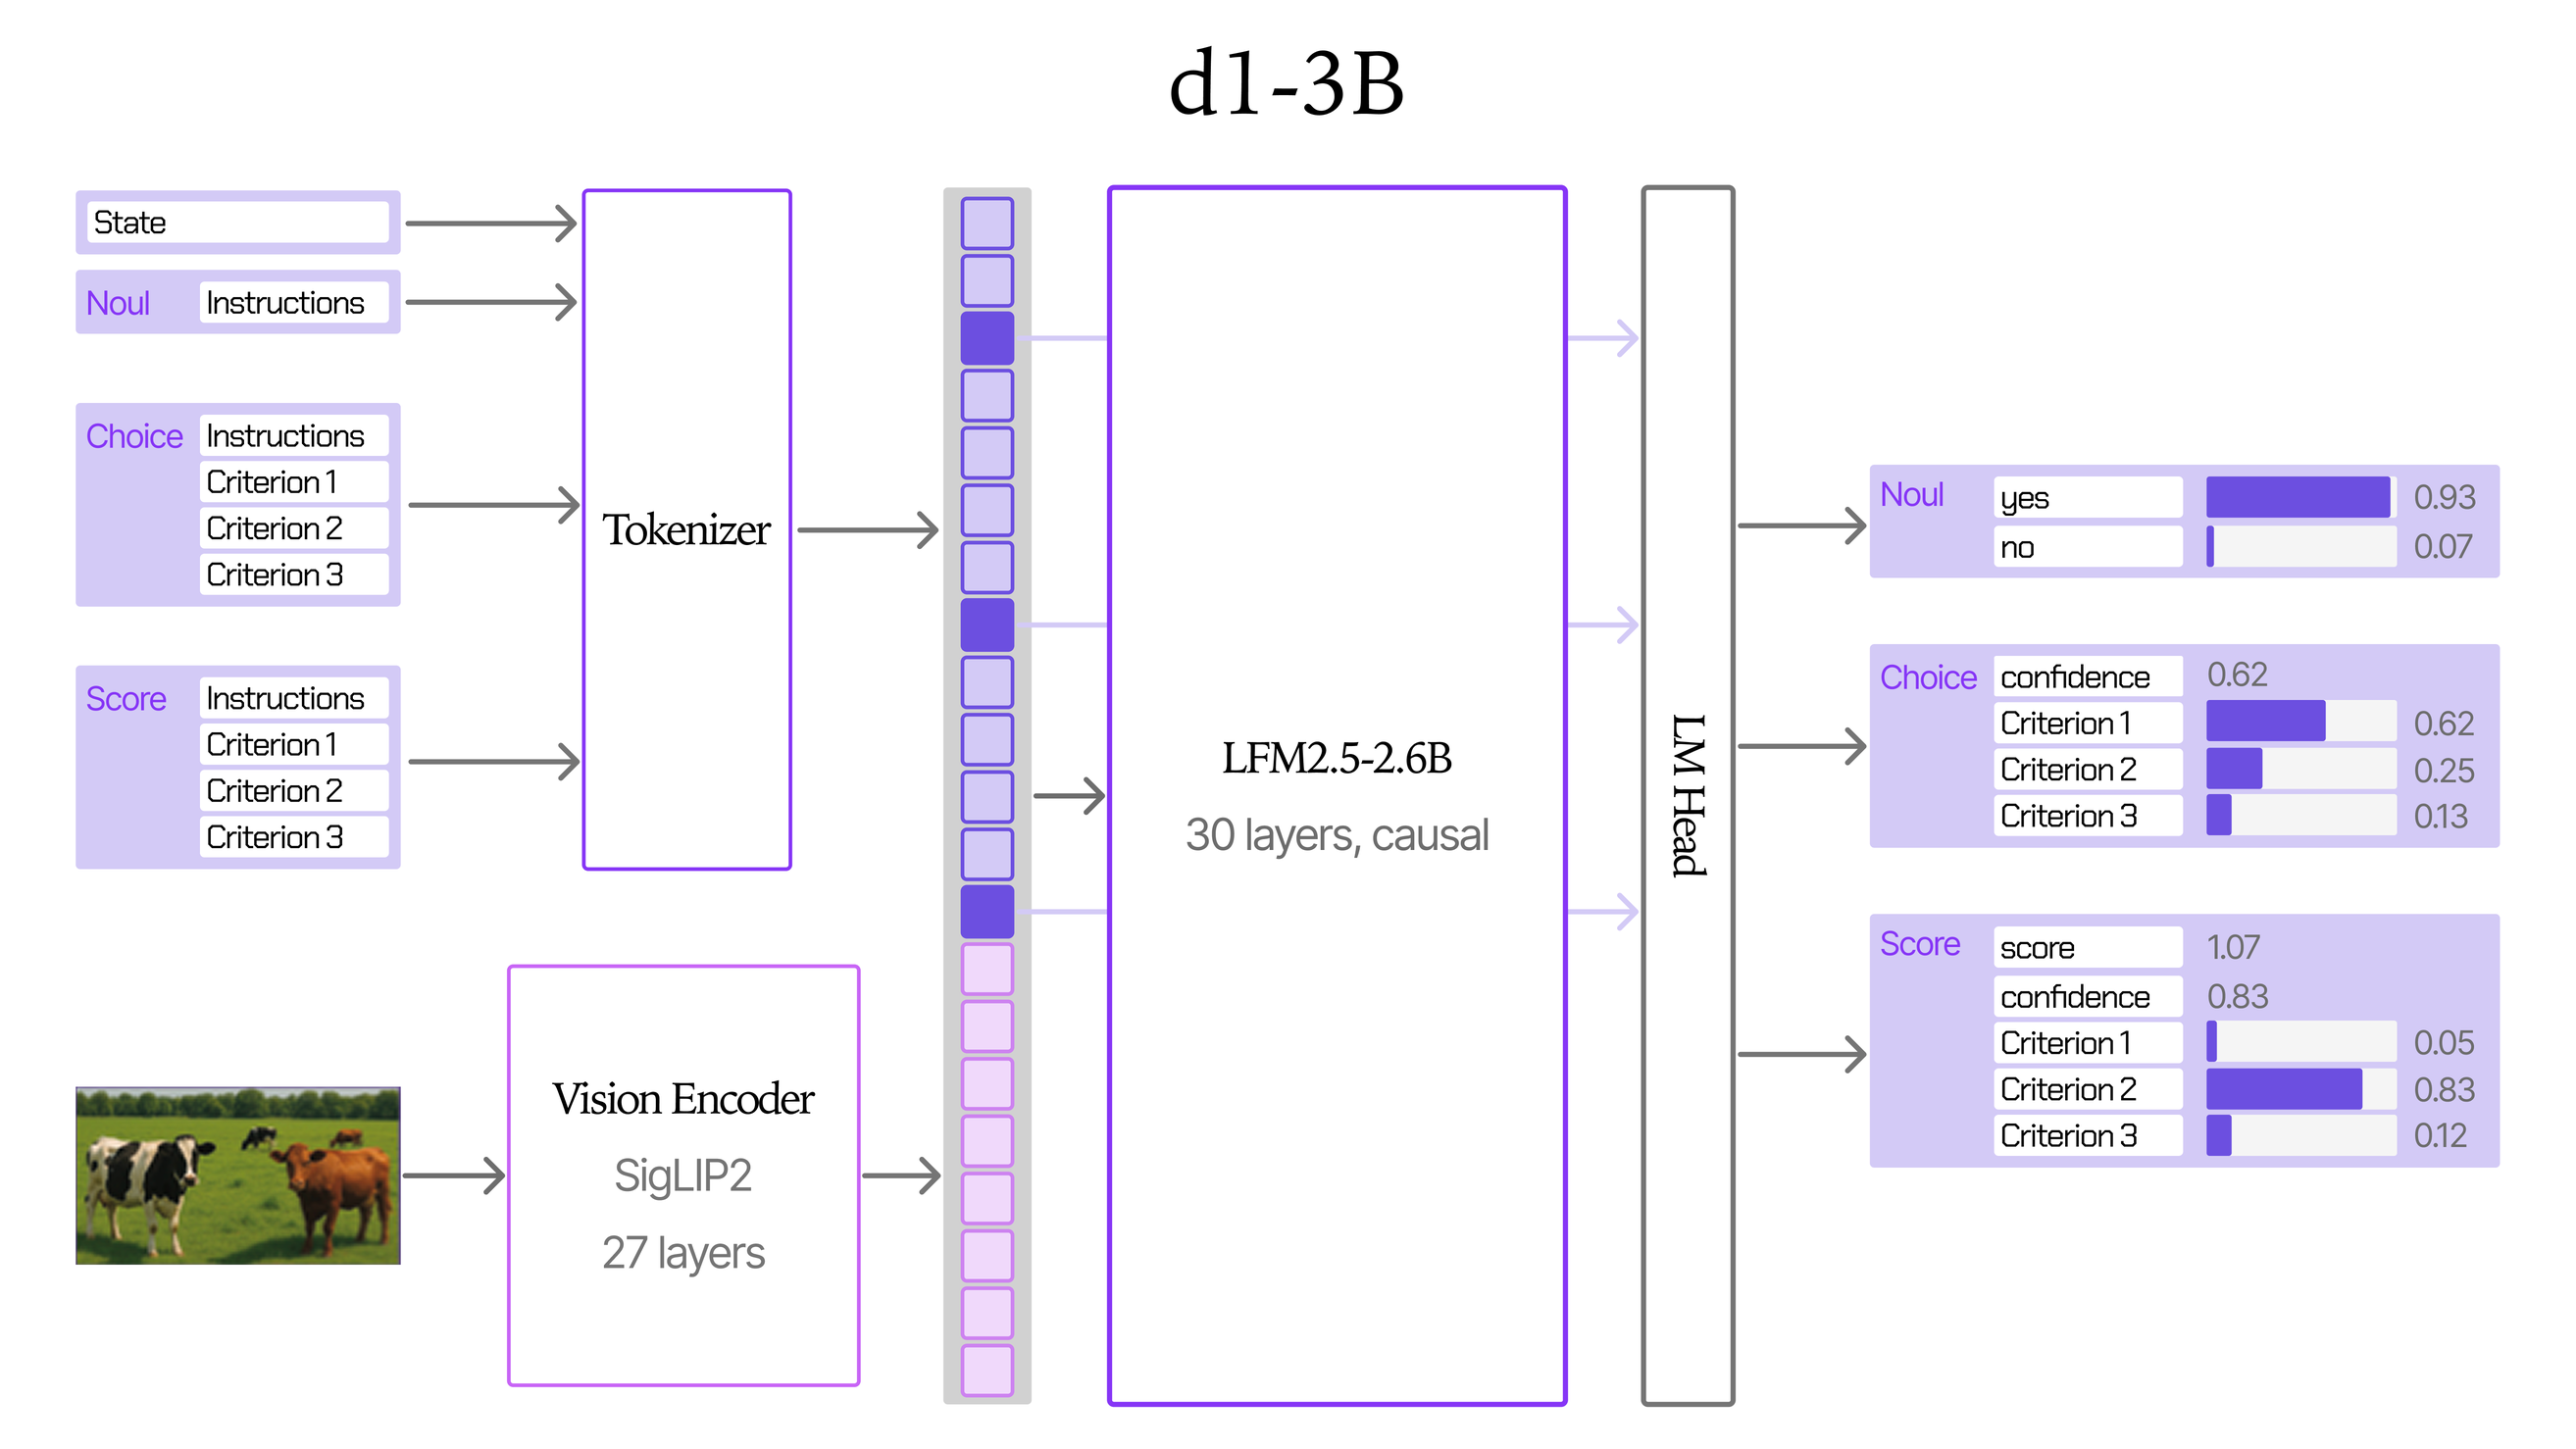
구조도를 보면 상태(State)와 세 질문이 한 시퀀스로 들어가고, 30층 인과(causal) 모델을 한 번 통과한 뒤 LM 헤드(LM Head) 가 질문마다 지정된 위치에서 선택지 확률을 읽습니다. 그래서 질문을 몇 개 넣든 상태와 이미지는 한 번만 읽습니다. 그림 오른쪽에서 Choice 답의 confidence 와 1순위 확률이 0.62로 같은데, 이 값은 그림 속 예시입니다. 이전 d1 글에서 확인한 API의 confidence 는 선택지 수로 보정한 값이라 1순위 확률과 달랐지만, 공개 모델 카드는 confidence 의 계산식을 밝히지 않습니다.
d1-omni-600M: 인코더에 음성과 이미지를 단계별로 추가
d1-omni-600M은 먼저 LFM2.5-Encoder-350M을 결정 작업에 미세조정하고, 음성과 이미지를 차례로 붙였습니다. 음성은 FastConformer 인코더와 어댑터를 학습한 뒤, 텍스트 백본을 고정한 채 오디오 인코더를 미세조정했습니다. 이미지는 LFM2.5-VL-450M의 인코더를 고정해 가져오고, 어댑터와 이미지 입력이 있을 때만 켜지는 LoRA(Low-Rank Adaptation) 가중치를 학습했습니다. 마지막으로 전체를 미세조정하고 LoRA를 병합한 뒤, 이전 체크포인트와 가중치를 평균해 마무리했습니다.
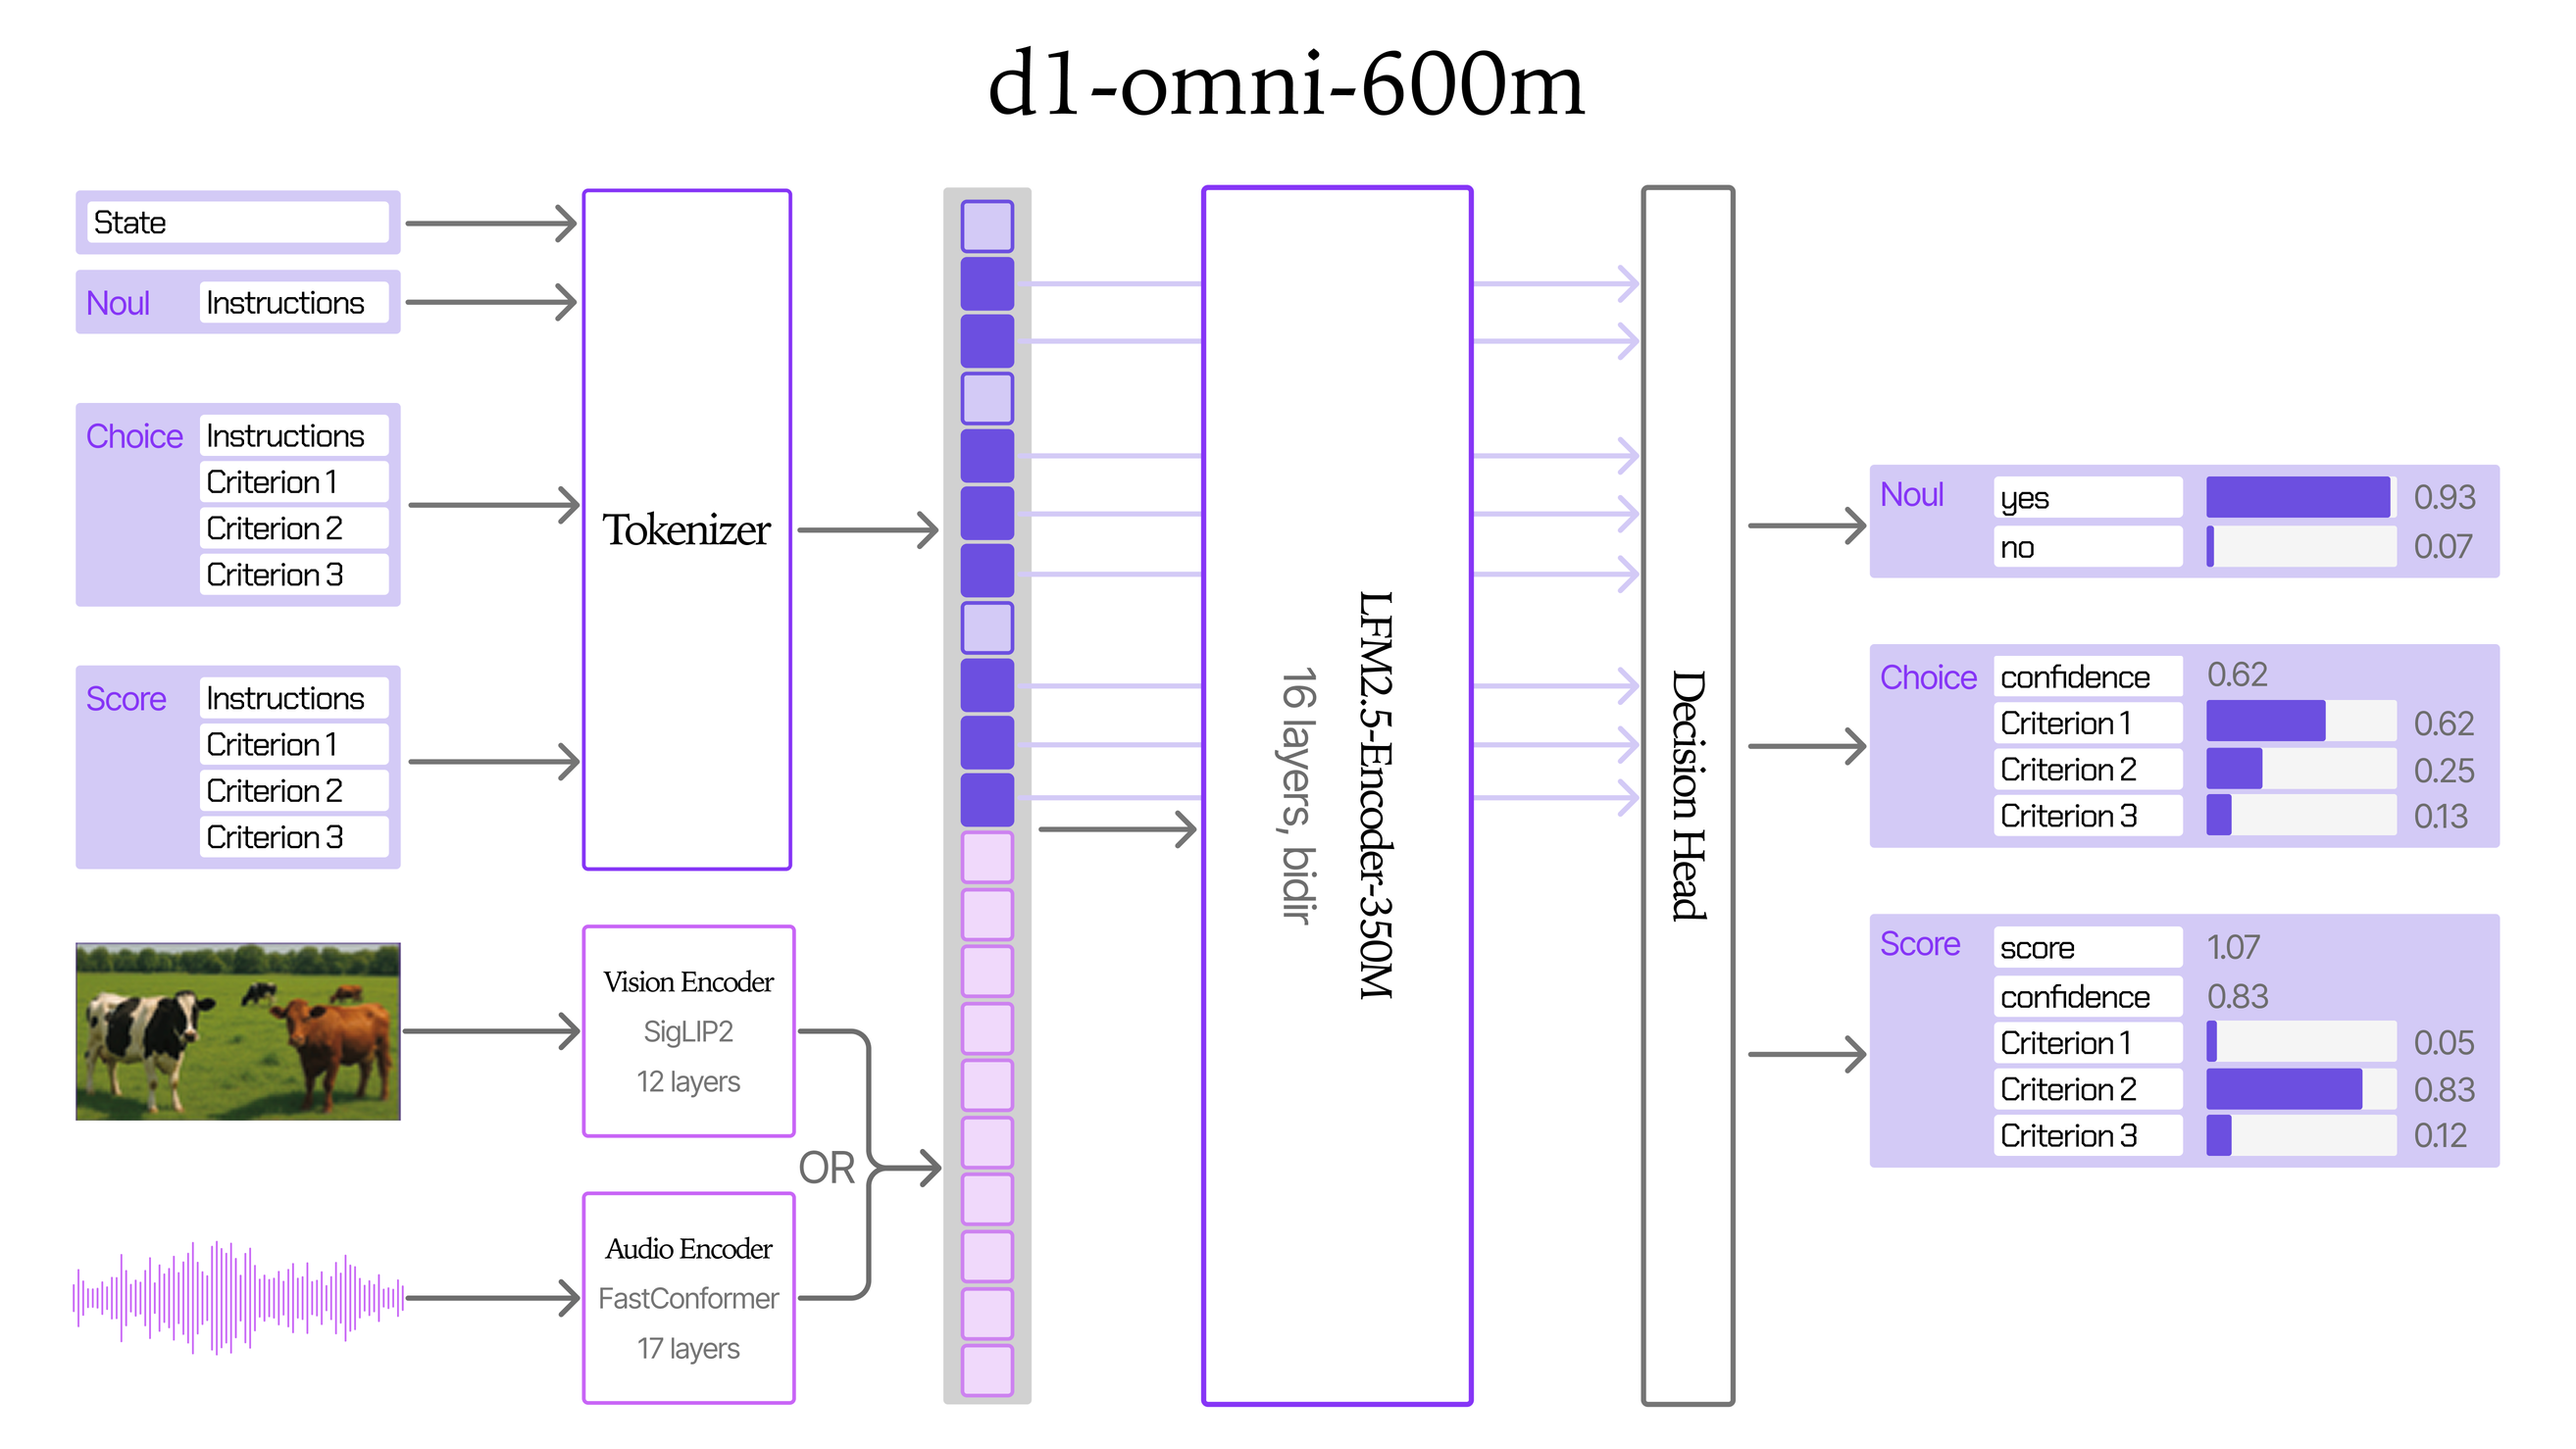
d1-3B와 달리 출력은 LM 헤드가 아니라 별도의 결정 헤드(Decision Head) 가 만들고, 본체는 16층 양방향(bidirectional) 인코더입니다. 그림에서 이미지 인코더와 오디오 인코더 사이에 "OR"이 적혀 있듯이, 한 요청에는 이미지와 음성 중 하나만 넣을 수 있습니다. 모델 카드는 두 입력을 함께 넘기면 ValueError 가 난다고 밝힙니다.
로컬에서 실행하기: Transformers와 llama.cpp
질문 형식은 Jev와 같은 세 가지
두 모델의 질문은 Decision Index의 스키마(type, instructions, criteria)를 따릅니다. Jev와 이전 d1 API를 써 본 개발자라면 같은 질문 정의를 그대로 옮길 수 있습니다.
type |
criteria |
돌려받는 값 |
|---|---|---|
noul: 예 또는 아니오 |
선택. {"true": "...", "false": "..."} 로 양쪽 뜻을 정의 |
noul: 예일 확률 |
choice: 이름 붙은 선택지 중 하나 |
{이름: 설명} |
choice, confidence, probabilities |
score: 2~10단계의 순서형 척도 |
낮은 단계부터 적은 설명 목록 | score(기대 단계), confidence, probabilities, legend |
응답은 {"answers": {...}, "usage": {"input_tokens": n, "output_tokens": 0}} 형태이고, 출력 토큰은 항상 0입니다.
Transformers로 d1-3B 실행하기
d1-3B는 transformers>=5.14 가 필요합니다. 아래 명령으로 의존성을 설치합니다.
pip install "transformers>=5.14" torch torchvision pillow
모델은 저장소에 포함된 자체 코드로 동작하므로 trust_remote_code=True 로 불러옵니다. 이 옵션은 Hugging Face 저장소의 Python 코드를 로컬에서 실행하므로, 운영 환경에 넣기 전에 저장소의 모델링 코드를 한 번 읽어 보거나 커밋을 고정해야 합니다. 아래는 블로그의 예제입니다. 텍스트 상태 하나에 질문 세 개를 묻고, 이미지만으로 고양이 수를 묻고, 여러 요청을 패딩 없이 묶어 처리합니다.
import io
import urllib.request

import torch
from PIL import Image
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
model = AutoModel.from_pretrained("LiquidAI/d1-3B", trust_remote_code=True,
                                  dtype=torch.float32 if device == "cpu" else torch.bfloat16).to(device)

# Several named questions over one text state, answered in one pass
questions = {
    "refund": {"type": "noul", "instructions": "Is the customer asking for a refund?"},
    "team": {"type": "choice", "instructions": "Which team should handle this?",
             "criteria": {"billing": "Charges, refunds, invoices", "technical": "App or site faults",
                          "fraud": "Suspected unauthorised use"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["Can wait", "Today", "Blocking the customer now"]},
}
print(model.system_one("I was charged twice this month, please refund one of them.", questions))

# An image as the whole state
url = "http://images.cocodataset.org/val2017/000000039769.jpg"  # two cats on a sofa
photo = Image.open(io.BytesIO(urllib.request.urlopen(url).read()))
print(model.system_one(None, {"cats": {"type": "choice", "instructions": "How many cats are there?",
                                       "criteria": {"one": "One", "two": "Two", "more": "Three or more"}}},
                       images=[photo]))

# Many requests, packed together with no padding
tickets = ["Where is my parcel? It was due Monday.", "The app crashes when I open settings."]
print(model.system_one_batch([(t, {"team": questions["team"]}) for t in tickets]))
system_one() 은 상태 하나에 대한 여러 질문을 한 번에 처리하고, system_one_batch() 는 서로 다른 상태의 요청 여러 개를 묶어 처리합니다. 상태가 None 이면 이미지 자체가 상태가 됩니다.
d1-omni-600M을 쓸 때 다른 점
d1-omni-600M의 사용법은 모델 카드에 따로 있습니다. 같은 system_one() 에 audio= 인자가 추가되고, 몇 가지 조건이 d1-3B와 다릅니다.
- 버전과 정밀도:
transformers>=5.15와soundfile이 필요합니다. 모델은 float32로 학습했고, GPU에서는 float16을 쓰라고 모델 카드가 안내합니다. bfloat16은 텍스트의 0.8%, 음성의 1.7%에서 1순위 답을 바꿨으므로 피해야 합니다. - 음성 입력: 16kHz 모노 클립 하나만 받고, 30초에서 자릅니다. 음성 질문은 학습 때 형식대로 선택지를 설명으로 적고(
option_000: ...), 예/아니오는 평이한 yes/no로 적어야 합니다. 답은 원래 선택지 이름으로 돌아옵니다. 음성은 영어 화자와 어시스턴트 사이의 요청으로만 학습했으므로, 한국어 음성 명령에는 별도 검증이 필요합니다. - 보정 범위: 텍스트 답만 질문 유형별 온도(temperature)로 보정하고, 이미지와 음성 답은 학습된 그대로의 소프트맥스(softmax) 값입니다. 따라서 이미지와 음성 답의 확률을 임계값으로 쓰려면 직접 보정해야 합니다.
llama.cpp 서버로 실행하기
두 모델은 GGUF 판(d1-3B-GGUF, d1-omni-600M-GGUF)도 함께 공개되었습니다. llama.cpp는 10월 2일 결정 모델용 /v1/systemone 엔드포인트를 추가했고, d1-3B 지원은 10월 7일(#30110), d1-omni-600M 지원은 10월 8일(#30114)에 병합되었습니다(UTC 기준). 따라서 이 기능이 들어간 최신 빌드가 있어야 합니다. d1-omni-600M은 질문을 배치 하나로 읽으므로, 서버를 -b 4096 -ub 4096 옵션으로 실행하고 긴 상태에서는 16384까지 올려야 한다고 GGUF 모델 카드가 안내합니다. GGUF 모델 카드의 예시는 다음과 같습니다.
llama-server -hf LiquidAI/d1-3B-GGUF:Q8_0
curl http://127.0.0.1:8080/v1/systemone -H "Content-Type: application/json" -d '{
  "state": "I was charged twice this month, please refund one of them.",
  "questions": {
    "refund":  {"type": "noul", "instructions": "Is the customer asking for a refund?"},
    "team":    {"type": "choice", "instructions": "Which team should handle this?",
                "criteria": {"billing": "Charges, refunds, invoices", "technical": "App or site faults",
                             "fraud": "Suspected unauthorised use"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["Can wait", "Today", "Blocking the customer now"]}
  }
}'
이미지는 images 필드에 base64 data URL 목록으로 넣습니다. 요청 본문 형식이 Transformers 예제의 질문 정의와 같아서, 프로토타입과 서빙 사이에 질문 정의를 다시 작성할 필요가 없습니다.
성능: 발표 수치와 모델 카드의 세부 점수
Decision Index 0.2.1: 10B 미만 1위, 지식 영역은 약점
Decision Index 는 Hugging Face의 apolinário가 운영하는 비공식 커뮤니티 리더보드로, 38개 벤치마크를 다섯 영역으로 나눠 채점합니다. Liquid AI 블로그는 d1-3B의 점수가 공개 분할(public split) 기준이라고 밝힙니다. 두 모델 카드는 d1-3B와 d1-omni-600M을 공식 채점기로 직접 쟀으며, 리더보드에 제출한 결과가 아니라고 밝힙니다. 다른 모델의 점수는 공개 리더보드 0.2.1판에서 가져왔습니다. 아래 표는 모델 카드의 표에서 일부 행을 옮긴 것입니다.
| 모델 | 크기 | Decision Index | Knowledge | Language | Retrieval | Tools | Arts |
|---|---|---|---|---|---|---|---|
| Winnow-12B | 12B | 50.02 | 33.8 | 56.0 | 54.0 | 71.0 | 30.0 |
| d1-3B (자체 측정) | 3B | 48.57 | 23.8 | 56.4 | 52.8 | 74.5 | 36.3 |
| Decider 35B-A3B | 36B | 47.11 | 31.8 | 55.5 | 54.7 | 56.5 | 32.6 |
| JPT-9B | 9.7B | 46.89 | 31.7 | 56.7 | 44.6 | 67.0 | 28.6 |
| Decision 1.0 Lux | 9.7B | 43.49 | 30.9 | 48.0 | 50.0 | 57.2 | 26.4 |
| Decider 4B | 4.7B | 40.70 | 25.7 | 46.0 | 44.7 | 58.6 | 25.0 |
| Decider 2B | 2.3B | 28.97 | 14.9 | 32.6 | 37.3 | 42.4 | 14.6 |
| d1-omni-600M (자체 측정) | 587M | 15.95 | 8.3 | 12.9 | 35.0 | 15.1 | 6.8 |
위 표를 통해 세 가지를 알 수 있습니다. 첫째, d1-3B의 점수는 주로 도구 호출(Tools)과 예술, 예측(Arts) 영역에서 나왔습니다. 지식과 추론(Knowledge)은 23.8점으로 4B 이상 모델 대부분보다 낮습니다. 점수로만 보면 상식이나 전문 지식이 필요한 판단보다, 정해진 규칙과 도구 선택에 가까운 판단에 더 맞습니다.
둘째, Liquid AI 블로그가 "12배 큰 결정 모델과 대등하다"고 비교한 Decider 35B-A3B는 Qwen3.5-35B-A3B를 미세조정한 전문가 혼합(Mixture of Experts, MoE) 모델입니다. Qwen 모델 카드에 따르면 이 바탕 모델은 전체 35B 중 토큰마다 3B 파라미터만 활성화합니다. 12배는 전체 파라미터 기준이고, 토큰당 활성 파라미터로 보면 d1-3B(3.12B)와 비슷한 규모입니다. 다만 Decider 저장소에 따르면 표의 47.11점은 NVFP4로 양자화(Quantization) 한 버전의 점수이고, 이 모델은 GPU 메모리가 65GB(NVFP4는 19.6GB) 필요합니다. 따라서 작은 엣지 기기에서는 d1-3B가 여전히 훨씬 가볍습니다.
셋째, d1-omni-600M의 15.95점은 Hugging Face 블로그 본문에 없고, d1-omni-600M 모델 카드와 Liquid AI 블로그에만 있습니다. 2B인 Decider 2B(28.97)의 절반 수준이고, 언어 이해(Language) 12.9점과 도구 호출 15.1점이 특히 낮습니다. 아래 그림처럼 1B 미만 모델들 사이에서는 높은 편이지만, 범용 결정 모델로 쓰기에는 부족한 점수입니다.
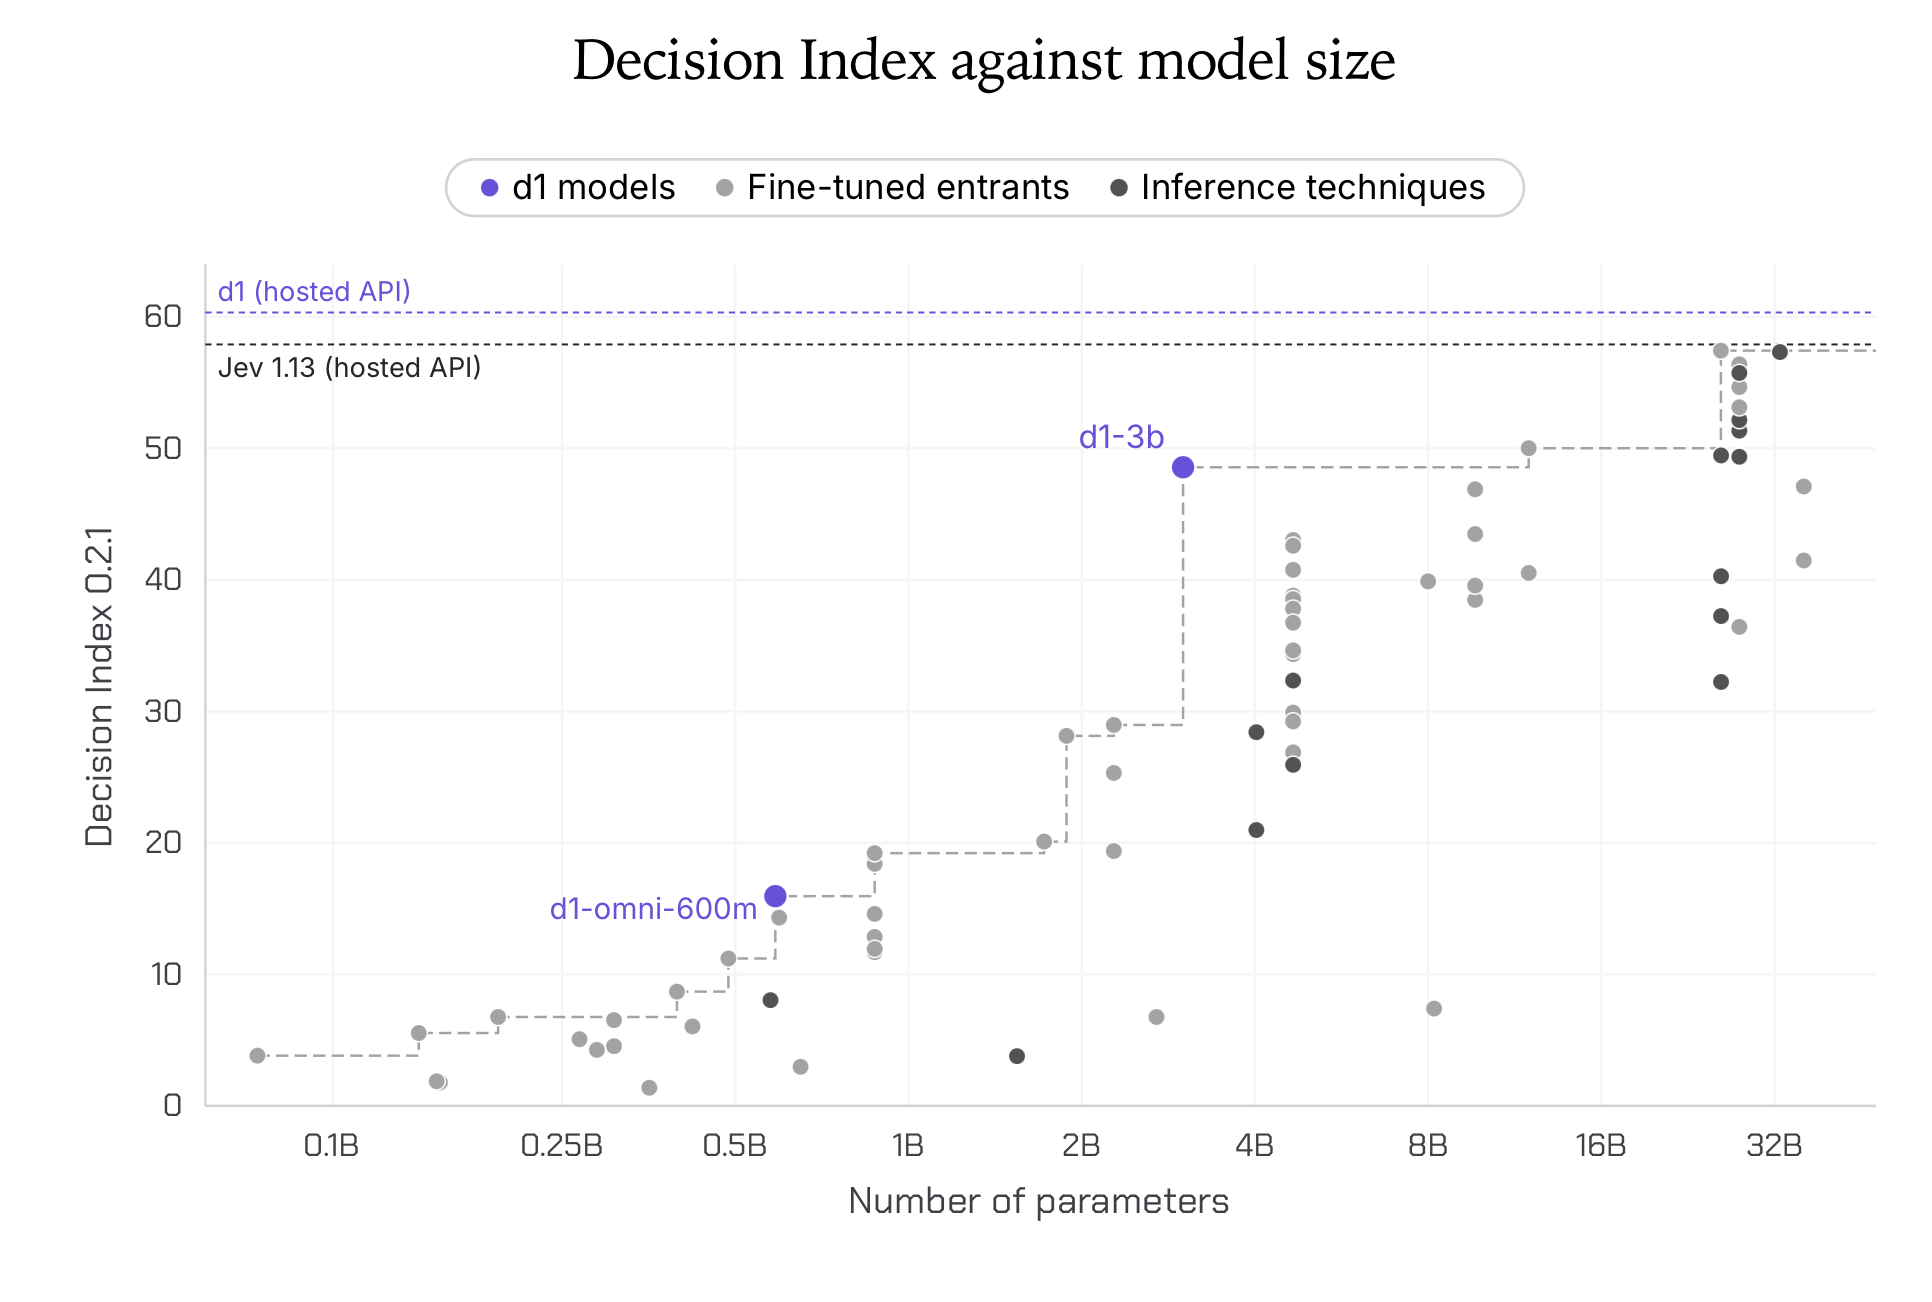
그림 상단의 점선 두 개는 Liquid AI가 측정한 호스팅 API d1과 Jev 1.13의 점수입니다. 공개 모델 중 30B급 몇 개만 Jev 선에 가깝고, d1-3B는 Jev 선보다 약 9점 아래에 있습니다.
공개 벤치마크 7종: 평균 우위는 PAWS-X에서 나온다
블로그는 Decision Index와 별도로, 공개 데이터셋 7개를 결정 문제로 바꿔 내부 평가했습니다. 독해(SQuAD 2.0, BoolQ), 유해성 탐지(Civil Comments), 의도 분류(MASSIVE), 의료 질의응답(PubMedQA), 다국어 이해(XNLI, PAWS-X)입니다. 아래 표는 블로그의 수치이며, 굵은 글씨는 각 행의 최고점입니다.
| 벤치마크 | d1-omni-600M | d1-3B | Decider 2B | Decider 4B |
|---|---|---|---|---|
| SQuAD 2.0 | 74.0 | 83.3 | 67.7 | 76.0 |
| Civil Comments | 95.8 | 93.3 | 93.6 | 92.8 |
| MASSIVE intent | 86.1 | 86.9 | 81.1 | 88.3 |
| PubMedQA | 61.3 | 68.3 | 65.7 | 63.3 |
| BoolQ | 77.7 | 86.3 | 87.3 | 89.0 |
| XNLI | 74.7 | 85.6 | 85.0 | 88.6 |
| PAWS-X | 79.5 | 76.4 | 59.5 | 69.8 |
| 평균 | 78.4 | 82.9 | 77.1 | 81.1 |
블로그는 "d1-omni-600M이 4분의 1 크기로 Decider 2B를 앞선다"고 요약했습니다. 평균은 그렇지만 세부 칸은 다릅니다. d1-omni-600M은 7개 중 4개에서 Decider 2B를 앞서고, BoolQ(-9.6)와 XNLI(-10.3)에서는 크게 뒤처집니다. PAWS-X의 20점 차이 하나가 평균을 2.9점 올리므로, 평균 차이 1.3점보다 큽니다. PAWS-X를 빼고 6개로 평균을 내면 d1-omni-600M은 78.3, Decider 2B는 80.1로 순위가 바뀝니다. d1-3B도 Decider 4B에 비해 7개 중 3개(MASSIVE, BoolQ, XNLI)에서 뒤지고, SQuAD 2.0과 PAWS-X의 큰 차이가 평균 우위를 만듭니다.
이 표를 읽을 때 확인할 점이 세 가지 더 있습니다.
- 블로그와 모델 카드의 d1-3B 수치가 다릅니다: d1-omni-600M 모델 카드의 같은 7종 표에서 d1-3B는 SQuAD 2.0 85.3, PubMedQA 66.0, PAWS-X 76.9처럼 칸마다 최대 2.3점 다르고, 평균만 82.9로 같습니다. Liquid AI는 어느 쪽이 최종 체크포인트의 값인지 밝히지 않았습니다.
- HelpSteer2를 뺀 표입니다: d1-3B 모델 카드는 HelpSteer2를 포함한 8개 벤치마크 표도 싣습니다. 그 표에서 d1-3B는 HelpSteer2 36.7점으로 Decider 4B(42.0)보다 낮고, 평균 차이는 77.1 대 76.2로 0.9점까지 줄어듭니다. d1-omni-600M 모델 카드는 HelpSteer2가 학습 데이터와 겹칠 수 있어 뺐다고 설명합니다.
- 다른 결정 벤치마크에는 비교 대상이 없습니다: d1-3B 모델 카드는 DecisionBench(영어 v1, 23,900행) 71.8점과 Fast Decisions(dev 분할) 69.3점을 적었습니다. d1-omni-600M은 Fast Decisions에서 76.9점으로 d1-3B보다 높습니다. 하지만 두 카드 모두 다른 모델의 점수를 함께 싣지 않았습니다.
한국어 사용자에게는 다국어 항목이 중요합니다. PAWS-X는 영어 원본에 한국어를 포함한 6개 언어 번역을 더한 문장 쌍 데이터셋이지만, 모델 카드는 어느 언어 부분집합으로 평가했는지 밝히지 않습니다. d1-3B 모델 카드 메타데이터의 언어 목록에 한국어(ko)가 있으나, 한국어만 따로 잰 결과는 없습니다.
비전: 바탕 모델 수준 유지, 항목별 편차는 큼
블로그는 비전과 음성 점수를 싣지 않았습니다. Decision Index v0.3의 비전 부분은 비공개 데이터이고, 음성 결정 벤치마크는 아직 없다는 이유입니다. 대신 d1-3B 모델 카드에는 공개 이미지 벤치마크 11개를 선택지 문제로 바꿔 각각 최대 1,000행으로 잰 결과가 있습니다.
평균은 d1-3B 74.1, 바탕 모델 LFM2.5-VL-3B 73.9로 비슷합니다. 하지만 VL-RewardBench에서 d1-3B가 14.1점 높은 것이 평균을 끌어올렸고, CV-Bench(-5.5)와 VisualWebBench(-6.9)에서는 바탕 모델보다 낮습니다. VL-RewardBench를 빼면 d1-3B가 약 1.2점 낮습니다. 이미지를 기반으로 판단하는 ImajevBench에서도 64.0점으로 바탕 모델(66.8)보다 낮습니다. 모델 카드는 같은 질문에서 이미지를 빼면 45.1점이 나온다고 밝혀, 답이 실제로 이미지에서 나온다는 점을 확인했습니다.
속도: Jetson부터 RTX 4090까지 질문 하나에 50ms 이내
결정 모델은 출력 토큰이 없으므로 Liquid AI는 입력부터 답까지의 지연을 쟀습니다. Jetson 3종은 NVIDIA와 함께 측정했고, 모든 기기는 워밍업한 뒤 한 번에 요청 하나씩 보낸 값입니다. 마지막 열은 상태 64개를 한 번에 묶었을 때의 초당 처리량입니다. d1-omni-600M은 연구용 공개라는 이유로 속도를 공개하지 않았습니다.
| 기기 | 질문 1개 | 질문 3개 | 3.4K 토큰 상태 | 384px 이미지 | 상태 64개 묶음 |
|---|---|---|---|---|---|
| Apple M5 Pro | 30 ms | 41 ms | 640 ms | 62 ms | 78 / s |
| NVIDIA Jetson AGX Thor | 16 ms | 20 ms | 220 ms | 35 ms | 262 / s |
| NVIDIA Jetson AGX Orin 64 GB | 26 ms | 35 ms | 560 ms | 83 ms | 110 / s |
| NVIDIA Jetson Orin Nano | 50 ms | 73 ms | 1,640 ms | 202 ms | 38 / s |
| NVIDIA RTX 4090 | 8 ms | 21 ms | 102 ms | 17 ms | 475 / s |
| AMD MI325X | 9 ms | 14 ms | 44 ms | 18 ms | 1,106 / s |
블로그는 엣지 기기에서 질문 3개를 처리하는 시간이 질문 1개의 1.3배라고 적었습니다. 실제 비율은 AGX Thor 1.25배, AGX Orin 1.35배, M5 Pro 1.37배, Orin Nano 1.46배로 기기마다 다릅니다. RTX 4090은 2.6배로 차이가 더 큰데, 질문 1개 값 8ms가 model.compile(mode="reduce-overhead") 로 단일 질문을 CUDA 그래프로 실행한 결과이기 때문입니다. 모델 카드는 이 설정 없이 질문 1개에 16ms가 걸린다고 밝힙니다. 또한 새 입력 형태로 처음 호출하면 커널 선택과 컴파일 시간이 들기 때문에, 서비스에서 쓸 입력 형태는 미리 워밍업해야 합니다.
GPU 측정은 bf16에서 20회 실행의 중앙값입니다. 엣지 측정에는 정밀도와 반복 횟수가 적혀 있지 않습니다. 긴 상태의 비용도 확인해야 합니다. 3.4K 토큰 상태는 Orin Nano에서 1.6초가 걸리므로, 실시간 루프에서는 상태를 짧게 요약해 넣는 편이 유리합니다.
Jetson에서 실행하기: bf16 가이드와 INT8 판
NVIDIA Jetson AI Lab은 JetPack 7.2와 NGC PyTorch 컨테이너(nvcr.io/nvidia/pytorch:26.09-py3)에서 d1-3B를 bf16으로 실행하는 가이드를 제공합니다. d1-omni-600M 가이드는 같은 환경에서 FP16을 씁니다.
Jetson이나 Ampere 이후 NVIDIA GPU에서는 INT8 판인 d1-3B-w8a8도 쓸 수 있습니다. 이 체크포인트는 torchao로 언어 모델의 선형 계층 166개를 미리 INT8로 양자화했고, 비전 인코더와 출력 헤드는 bf16으로 남겼습니다. 크기는 bf16의 6.2GB에서 3.8GB로 줄어듭니다. INT8 커널은 컴파일해야 빠르므로 model.compile() 을 호출해야 합니다. 모델 카드가 Jetson AGX Orin 64GB에서 5회 실행 중 가장 빠른 값을 잰 결과는 다음과 같습니다.
| 체크포인트 | 질문 1개 | 질문 3개 | 3.4K 토큰 상태 | 384px 이미지 | 상태 64개 묶음 | 최대 메모리 |
|---|---|---|---|---|---|---|
| d1-3B (bf16) | 37 ms | 65 ms | 831 ms | 137 ms | 68 / s | 12.4 GB |
| d1-3B-w8a8 | 31 ms | 45 ms | 562 ms | 99 ms | 107 / s | 7.9 GB |
이 표의 bf16 질문 1개 값 37ms는 위 속도 표의 같은 기기 값 26ms보다 40% 넘게 느립니다. w8a8 카드는 JetPack 6.2, PyTorch 2.11, torchao 0.18 환경에서 쟀다고 밝혔지만, d1-3B 카드는 엣지 측정의 소프트웨어 환경과 체크포인트를 밝히지 않았습니다. 같은 기기에서도 환경에 따라 이만큼 차이가 나므로, 발표 수치를 그대로 기대하지 말고 실제 배포 환경에서 직접 재야 합니다. Jetson은 CPU와 GPU가 메모리를 함께 쓰므로, 메모리가 작은 기기일수록 w8a8의 메모리 절감이 중요합니다.
System One Arcade: 카메라, 그림, 문장으로 판단하는 데모 10종
Liquid AI는 d1-3B를 반복 호출하는 데모 10개를 System One Arcade Space로 공개했습니다. 손바닥을 펴면 새가 날아오르는 게임, 스쿼트 횟수 세기, 손가락 욕설 모자이크, 그림 맞히기 등이 있습니다. Live Triage 데모는 지원 문의를 입력하는 동안 담당 팀, 긴급도, 환불 여부를 계속 갱신합니다. 각 데모는 카메라 프레임, 그림, 문장 중 하나에 대해 타입이 정해진 질문 몇 개를 던지고, 순전파 한 번의 답을 읽습니다. 10개 중 8개가 카메라 입력을 씁니다.
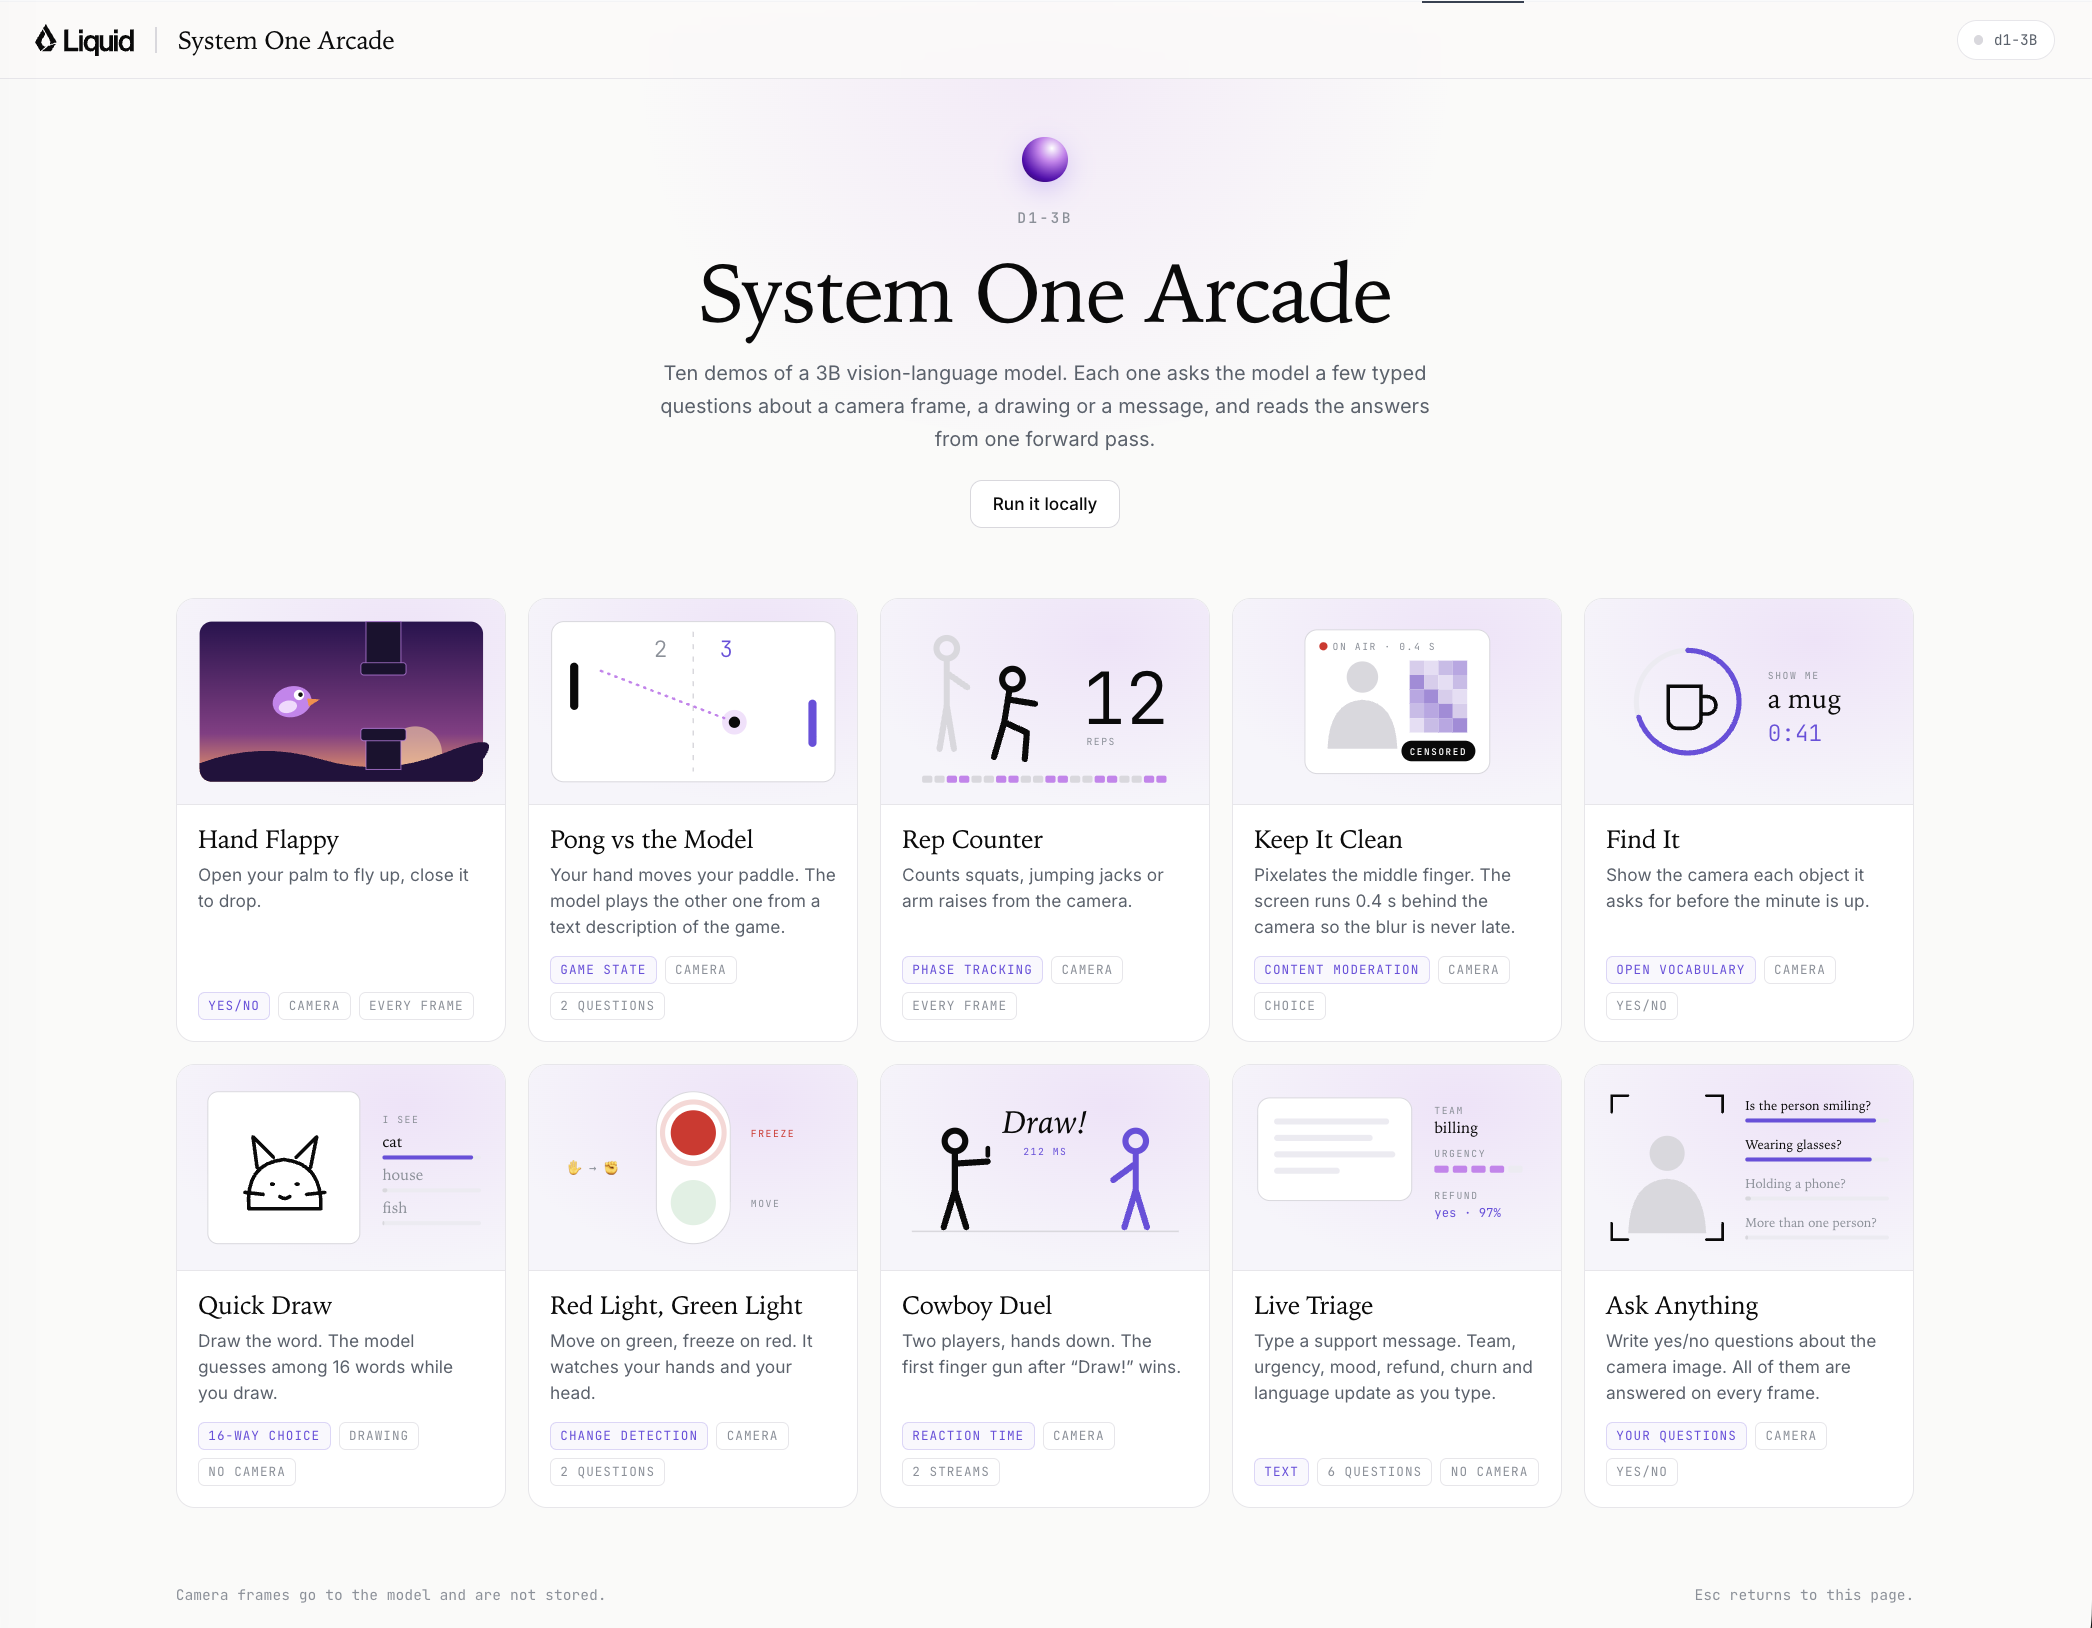
데모 카드의 태그를 보면 대부분 예/아니오나 선택 질문입니다. 예를 들어 Keep It Clean은 화면을 카메라보다 0.4초 늦게 보여 줘서 모자이크가 늦지 않게 하는데, 이는 모델 지연을 화면 지연으로 감추는 설계입니다. Space는 L4 GPU에서 실행되며, 카메라 프레임은 이 GPU의 모델로만 보내고 저장하지 않는다고 README가 밝힙니다. README에 따르면 Space에서는 프레임마다 서버 왕복이 약 0.2초 걸립니다. 따라서 Flappy, Pong처럼 프레임마다 반응하는 게임은 Apple silicon Mac이나 8GB 이상 NVIDIA GPU가 있는 Linux에서 로컬로 실행해야 반응이 빠릅니다.
Liquid AI는 이 밖에 NVIDIA와 함께 Isaac Sim 환경에서 d1-3B가 길을 찾는 데모도 공개했습니다. 모델은 Jetson에서 실행하고 시뮬레이터와 실제 하드웨어를 연결한 HIL(Hardware-in-the-Loop) 구성입니다. 아래는 Liquid AI 블로그에 실린 영상이며, 데모 코드는 공개하지 않았습니다.
API d1과 공개 d1-3B 비교: 서버 호출과 로컬 실행
Liquid AI의 d1 출시 블로그에 따르면 API d1은 텍스트와 이미지를 받고, 텍스트 결정 하나에 200~300ms가 걸립니다. 공개 d1-3B와 나란히 놓으면 다음과 같습니다. 수치는 모두 Liquid AI가 발표한 값입니다.
| 항목 | API d1 | 공개 d1-3B |
|---|---|---|
| 입력 | 텍스트, 이미지 | 텍스트, 이미지 |
| Decision Index (자체 측정) | 약 60 | 48.57 |
| 지연 | 텍스트 결정 1건 200~300ms | 질문 1개 8~50ms (기기별, 네트워크 왕복 없음) |
| 비용 | 입력 100만 토큰당 0.04달러, 출력 과금 없음 | 하드웨어와 운영 비용 |
| 제공 경로 | Liquid API, Vercel AI Gateway, OpenRouter (두 곳은 현재 텍스트만) | Hugging Face 가중치, GGUF, INT8 판 |
| 데이터 처리 위치 | Liquid AI 서버 | 로컬 기기 |
API는 이미지를 32×32 픽셀 패치당 1.5토큰으로 세므로, 1024×1024 이미지 한 장은 1,536토큰입니다. 출시 블로그는 같은 상태에 질문 여러 개를 묻으면 입력 토큰을 아낄 수 있다고 적었습니다. 하지만 같은 글의 과금 설명은 질문마다 질문 텍스트와 모든 이미지를 포함한 별도 프롬프트로 과금한다고 밝힙니다. 따라서 이미지 한 장에 질문 다섯 개를 묻으면 이미지 토큰도 다섯 번 셉니다. 반면 로컬 d1-3B는 상태와 이미지를 한 번만 읽습니다.
출시 블로그는 API d1을 GPT-6.1 Sol, Claude Opus 5.5와 6개 응용에서 비교했습니다. API d1은 그중 4개에서 GPT-6.1 Sol과 같거나 나았고, 비용은 두 모델보다 19~200배 적었다고 합니다. 다만 방법론 각주에 따르면 각 응용을 모델마다 한 번씩만 실행했습니다. 또한 코드 검색 질문 15개 중 6개와 컨텍스트 압축 세션 4개 중 2개는 d1 파이프라인을 정한 뒤에 작성했습니다. 이 비교는 API d1의 결과이며, 공개 d1-3B에는 이런 비교가 없습니다.
d1-3B와 d1-omni-600M의 라이선스
두 모델은 LFM Open License v1.0으로 배포됩니다. 조문 구조는 Apache 2.0과 비슷하지만, 5조에서 상업적 사용에 조건을 둡니다. 연 매출 1천만 달러 이상인 법인의 상업적 사용은 이 라이선스로 허가되지 않습니다. 법인(Legal Entity)의 정의에는 지배 관계로 묶인 계열사가 포함되므로, 매출 기준을 그룹 단위로 볼 여지도 있습니다. 개인, 연구 목적, 그 기준 아래의 회사는 수정과 재배포를 포함해 쓸 수 있습니다. 기준 이상의 기업이 상업적으로 쓰려면 Liquid AI에 별도 조건을 확인해야 합니다.
Liquid AI 블로그는 두 모델을 "제한 없이 내려받고, 미세조정하고, 배포할 수 있다"고 소개합니다. 실제 라이선스 조문과 다르므로, 회사에서 도입하려면 블로그 문구가 아니라 라이선스 파일을 기준으로 판단해야 합니다.
도입 전에 확인할 점
d1-3B는 결정 모델을 로컬과 엣지 기기에서 실행하려는 팀에게 지금 가장 작은 실용 선택지 중 하나입니다. 다만 발표 수치는 모두 Liquid AI의 자체 측정이므로, 아래 항목을 함께 확인해야 합니다.
- API d1과는 다른 모델입니다: 이전에 d1 API로 판단 로직을 만들었다면, d1-3B로 바꿀 때 Decision Index 기준 10점 이상 낮은 모델로 바꾸는 것입니다. 같은 질문으로 두 모델의 결과를 비교한 뒤 옮겨야 합니다.
- 보정을 측정한 수치가 없습니다: 모델 카드는 답이 보정(calibrated)되었다고 적지만, 예측 확률과 실제 정답률의 차이를 재는 ECE(Expected Calibration Error) 같은 값은 없습니다. d1-omni-600M은 이미지와 음성 답을 보정하지 않았다고 밝힙니다. 확률을 임계값으로 쓰려면 레이블이 있는 자체 데이터로 확인해야 합니다.
- 한국어 성능은 확인되지 않았습니다: 공개된 평가는 대부분 영어 데이터이고, 다국어 항목도 언어별 결과를 밝히지 않습니다. d1-omni-600M의 음성은 영어 요청으로만 학습했습니다.
- d1-omni-600M은 실험판입니다: Decision Index 15.95점, 속도 미공개, 개발 중이라는 단서를 Liquid AI가 직접 붙였습니다. 음성 명령 라우팅처럼 질문 형식이 좁고 정해진 작업에서 시험해 볼 수 있지만, 범용 판단기로 쓰기에는 아직 근거가 부족합니다.
결정 모델의 질문 설계와 확률 사용법은 Jev 소개 글과 이전 d1 API 글에서 다뤘습니다. 학습 없이 범용 LLM을 결정 모델처럼 쓰는 방법은 LLM-as-Jev 글을 참고하시기 바랍니다.
 Open d1 소개 Hugging Face 블로그
 Open d1 소개 Liquid AI 블로그
d1 결정 모델 출시 Liquid AI 블로그
d1-3B 모델 카드
d1-omni-600M 모델 카드
System One Arcade 데모 Space
더 읽어보기
-
Liquid AI, 문장 생성 대신 Jev 호환 API로 분류 / 라우팅 / 점수를 처리하는 결정 모델 d1 공개
-
Jev와 유사한 오픈소스 결정 모델에 대한 정리: Decision Index와 JevBench로 비교한 결정 모델 성능 비교
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
Liquid AI, VLM 디코딩 속도를 2.66~3.13배 가량 높인 LFM2.5-VL-3B-DSpark 모델 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
