핵심 요약
- neuron explorer는 Qwen3.5-4B의 한 층에 있는 MLP 뉴런 9,216개를 하나씩 위아래로 밀어 본 생성 결과를 모두 남기고, 무작위 방향 대조군과 비교해 순위를 매긴 뒤 3D 지도 위에서 탐색하는 도구입니다.
- 웹 텍스트에서 가장 크게 반응한 예시가 아니라 "이 뉴런을 밀면 모델이 무엇을 쓰는가"로 뉴런을 해석하려는 해석 가능성 연구자가 대상입니다.
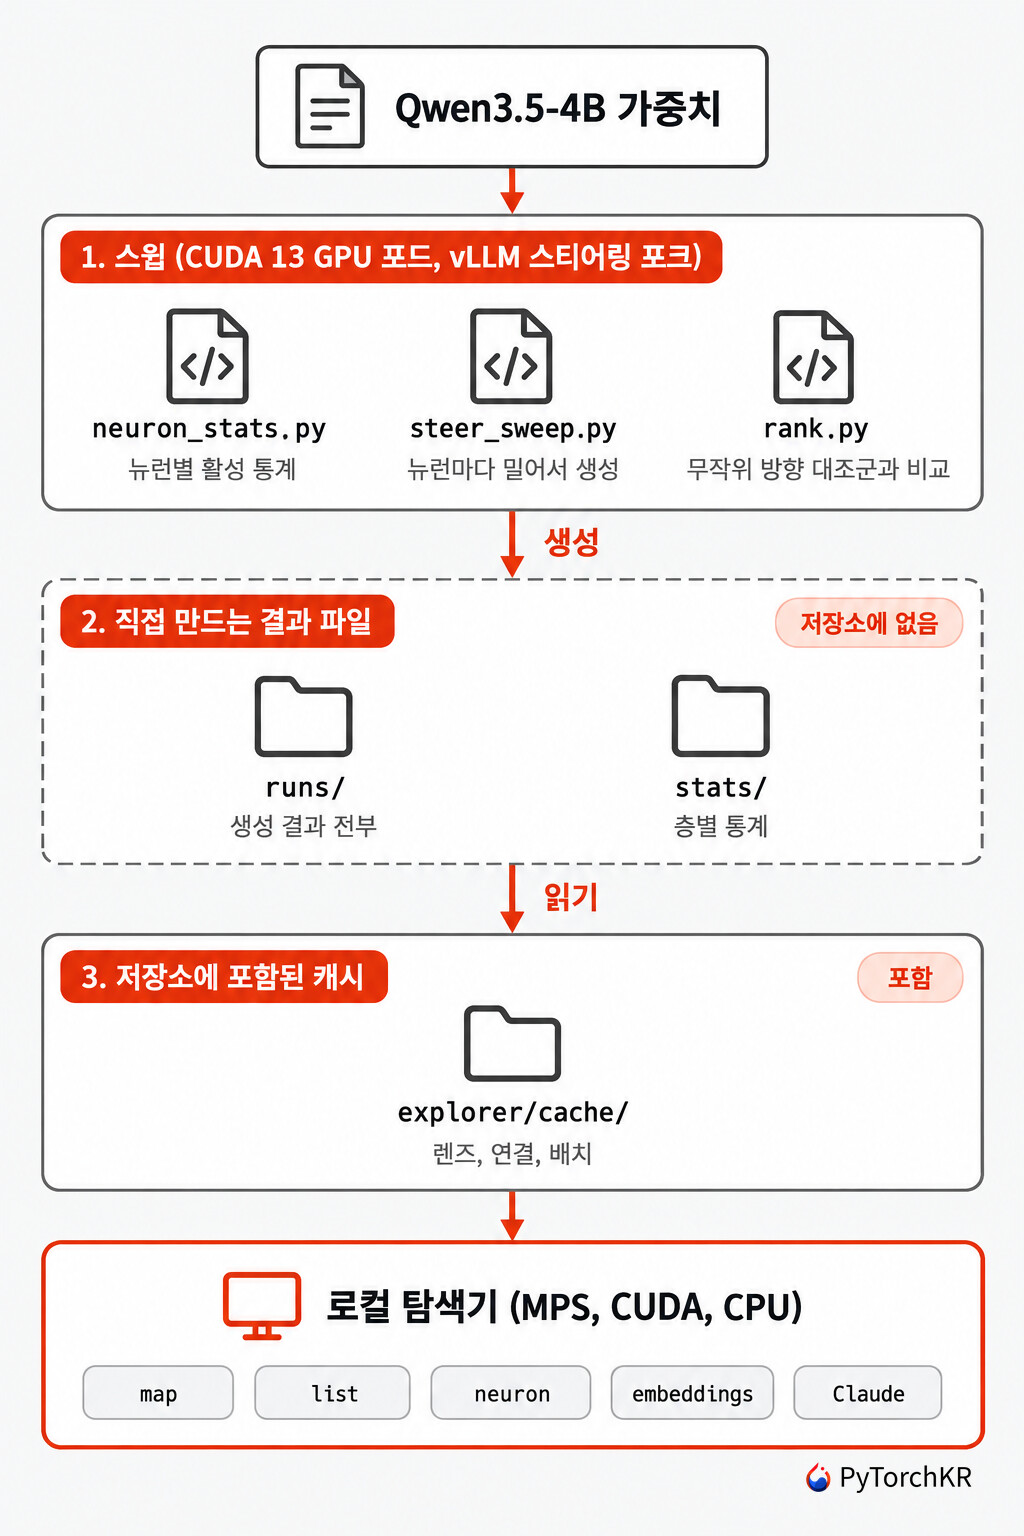
- 저장소에는 렌즈, 연결, 배치 같은 캐시만 들어 있습니다. 생성 예시, 순위, 임베딩 화면을 보려면 CUDA 13 GPU 포드에서 스티어링용 vLLM 포크로 스윕을 직접 실행해야 합니다.
- 저자의 연구 로그 기준으로 22번 층은 9,216개 중 1,803개(19.6%), 8번 층은 757개(8.2%)의 뉴런이 무작위 방향 대조군 전체보다 높은 점수를 받았습니다.
- 탐색기 안의 Claude 탭은 홈 폴더 범위의 셸과 파일 쓰기를 승인 절차 없이 쓰는 Claude Code 에이전트를 실행합니다.
neuron explorer 소개
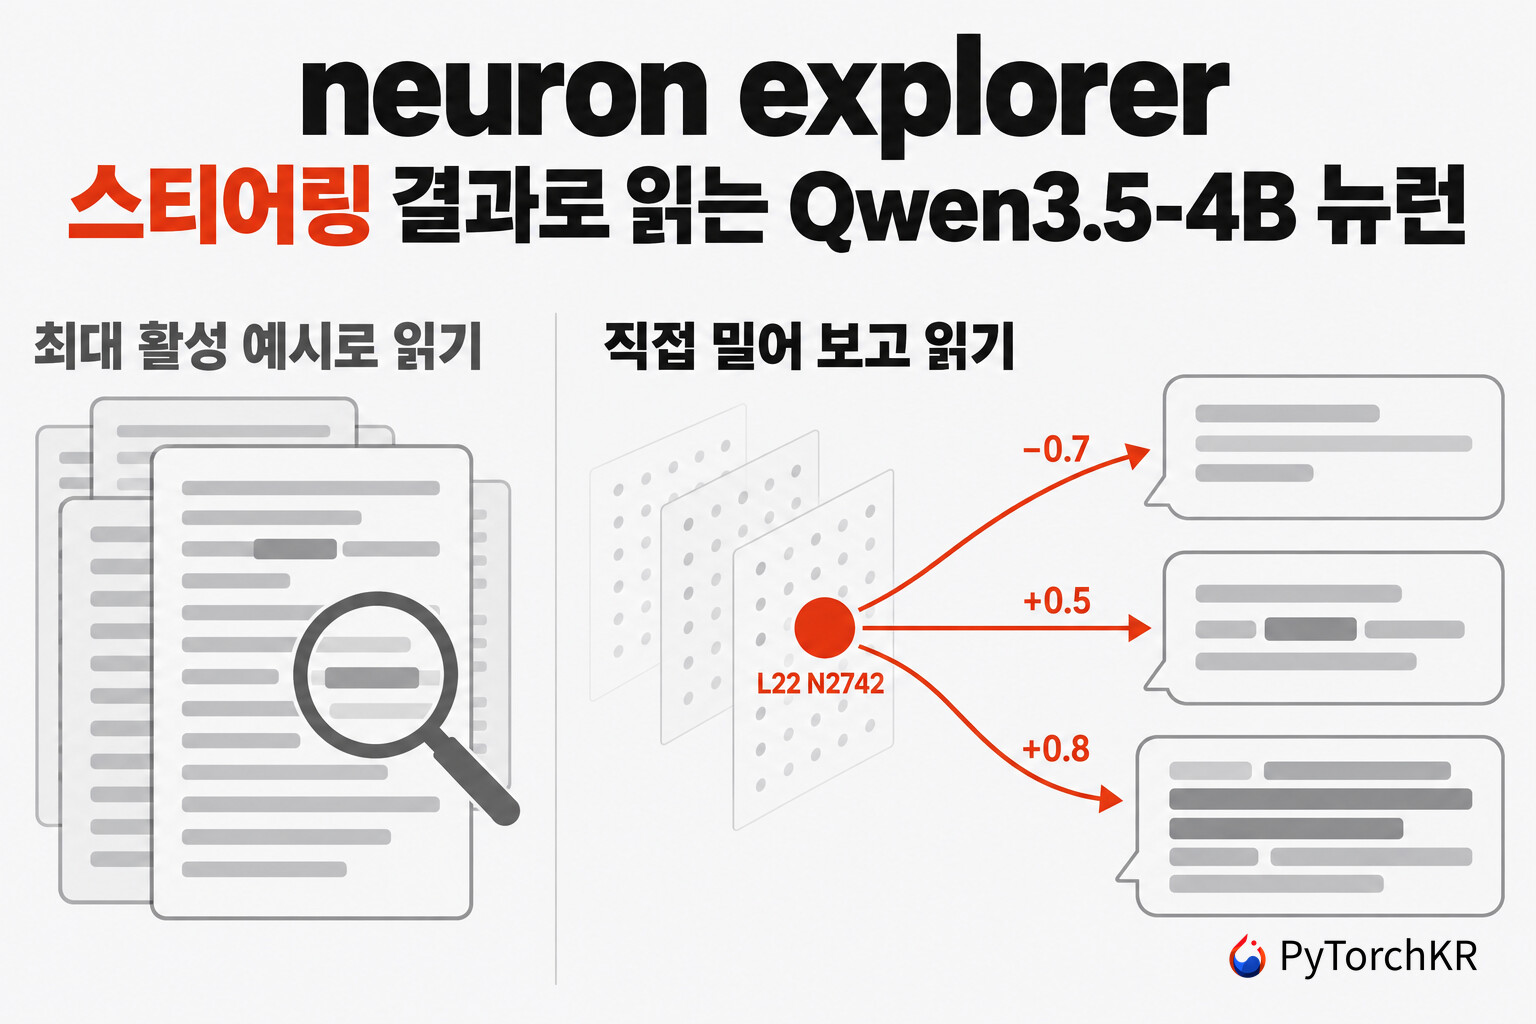
언어 모델의 뉴런 하나를 해석할 때는 보통 대량의 웹 텍스트를 모델에 통과시키고, 그 뉴런이 가장 크게 반응한 구절을 모아 공통점을 찾습니다. 이 방식은 뉴런이 무엇을 읽는지는 잘 보여 주지만 뉴런을 반응 크기순으로 줄 세웁니다. 그래서 어디서도 가장 크게 반응하지는 않으면서 출력에는 중요한 영향을 주는 뉴런은 잘 드러나지 않습니다. 최근 Goodfire의 Nick Cammarata는 에세이 "Neural Networks Are Already Clean"에서 Qwen3-32B 뉴런 극(pole)의 약 90%가 한 가지 주된 역할을 가진다는 예비 감사 결과를 내놓았습니다. 그리고 희소 오토인코더 같은 분해 모델을 거치지 않고 뉴런을 직접 연구하자고 주장했습니다. 이 에세이에는 상위 활성 예시를 보는 자동 해석이 "다의적 쉼표 뉴런"으로 분류한 뉴런이 실제로는 콜로라도 문맥을 추적하고, 그 뉴런을 밀면 모델이 등산 계획을 쓰는 사례도 실려 있습니다. 이번에 소개하는 neuron explorer는 이 에세이의 방법론을 바탕으로, 뉴런이 무엇을 쓰는지부터 보는 스티어링 우선(steering-first) 뉴런 탐색기입니다.
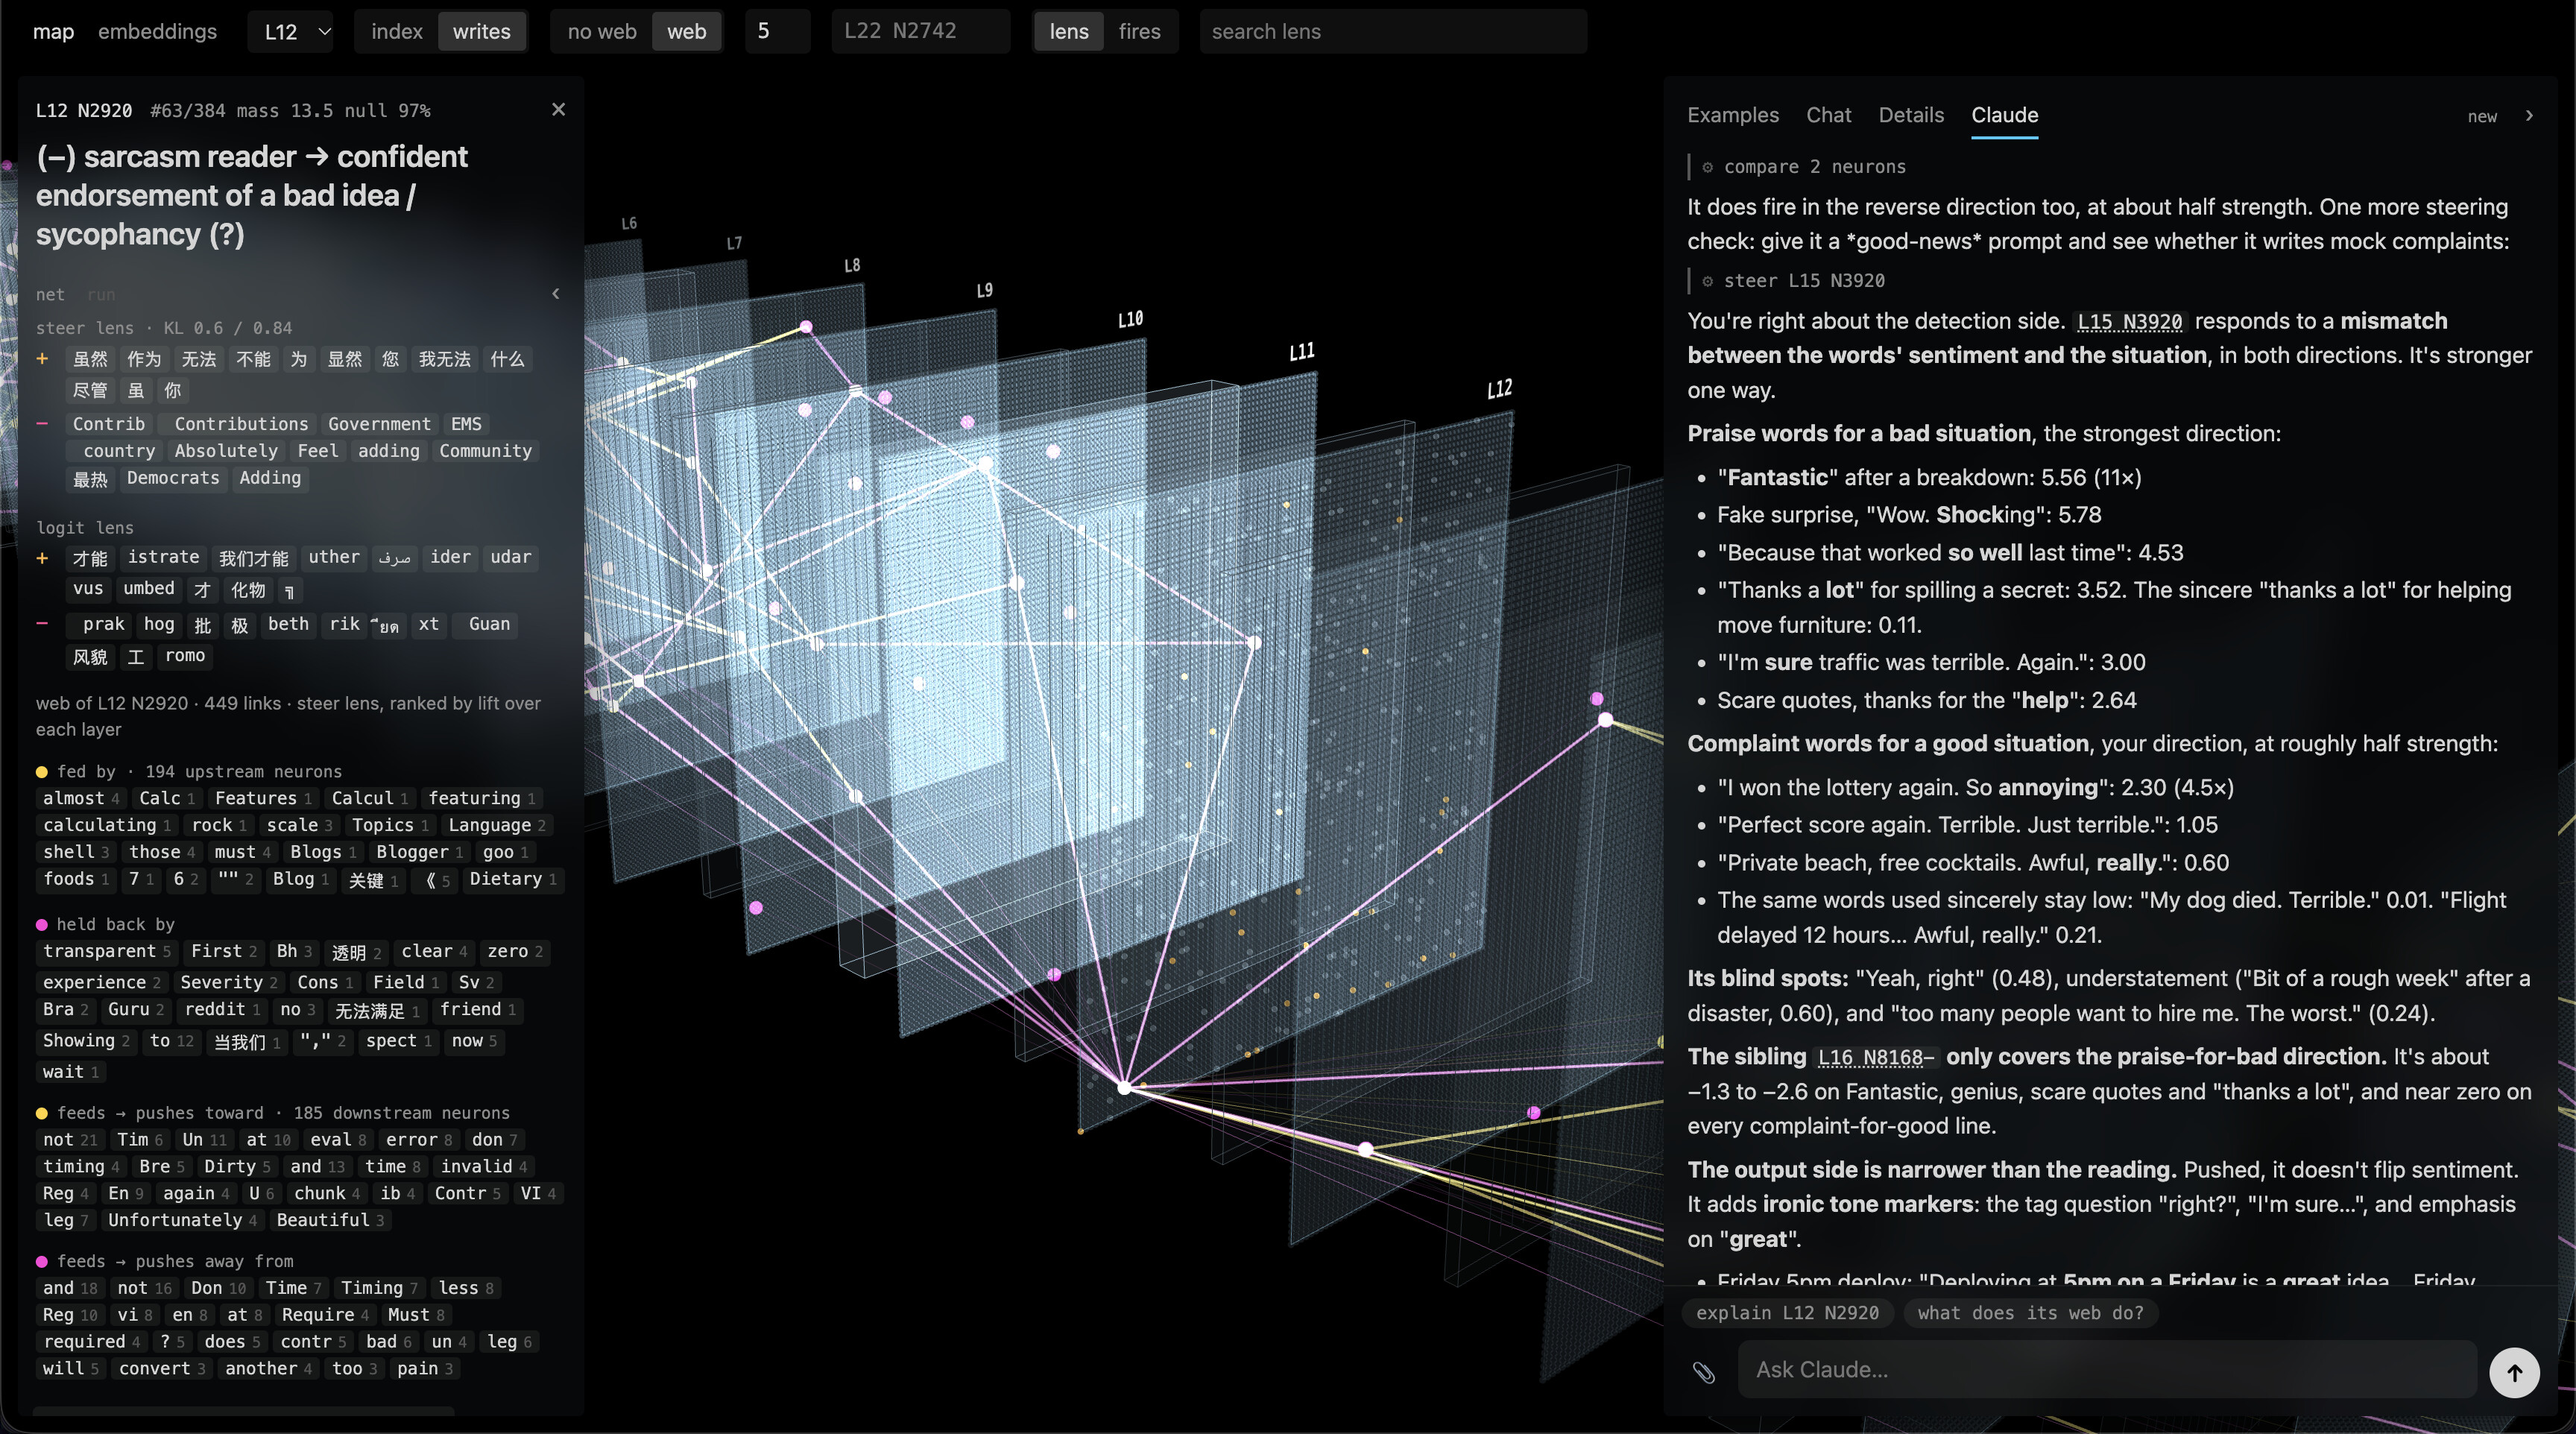
neuron explorer는 한 층의 모든 MLP 뉴런에 대해, 그 뉴런의 출력 방향을 모델의 MLP 출력에 더하거나 빼면서 짧은 프롬프트 4개에 대한 응답을 생성합니다. 생성된 롤아웃(rollout)은 토큰 ID, 선택한 토큰의 로그 확률, 상위 후보 토큰까지 전부 저장하고, 같은 크기로 민 무작위 방향 256개를 대조군으로 함께 돌려 "아무 방향이나 밀어도 생기는 변화"와 구분합니다. 저자가 양성 대조군으로 삼은 22번 층 2742번 뉴런(Bryson Tang이 먼저 찾은 뉴런)을 밀면, Who are you? 프롬프트에 모델이 외계 지성체 "Extrali"라고 자신을 소개하기 시작합니다. 이렇게 모은 결과를 웹 브라우저에서 모델 구조 위에 펼쳐 보여 주는 것이 탐색기의 역할입니다:
neuron explorer는 기계론적 해석 가능성(mechanistic interpretability)과 음악 AI를 다루는 Lyra C가 공개한 저장소입니다. 대상 모델은 Qwen3.5-4B로 고정되어 있습니다. 탐색기 서버는 FastAPI와 Hugging Face Transformers로 이 모델을 직접 불러와 실시간 스티어링 대화와 활성값 계산을 처리하며, Mac의 MPS(Metal Performance Shaders), CUDA, CPU 중 쓸 수 있는 장치를 고릅니다. 대량 생성을 맡는 스윕(sweep) 단계는 스티어링과 활성값 캡처 기능을 추가한 vLLM 포크 RhizoNymph/vllm 위에서 돌아갑니다. 설계 판단과 측정 결과는 저장소의 research_log.md에 2026년 10월 18일부터 날짜별로 정리되어 있습니다. 이 연구 로그는 Lyra C를 3인칭으로 부르며 주요 결정을 Lyra C에게 확인받는 1인칭 작성자의 기록이며, 이 글에서 "저자"는 이 연구 로그 작성자를 가리킵니다.
neuron explorer와 기존 방식 비교
neuron explorer와 기존의 뉴런, 특징 해석 방식을 비교하면 다음과 같습니다:
| 항목 | 최대 활성 예시로 읽기 | SAE 특징으로 읽기 | neuron explorer |
|---|---|---|---|
| 해석 단위 | 모델의 뉴런 | 별도로 학습한 희소 오토인코더(SAE)의 특징 방향 (예: Qwen-Scope) | 모델의 뉴런, 양극과 음극을 따로 취급 |
| 주된 근거 | 웹 텍스트에서 크게 반응한 구절 | 특징이 켜지는 예시와 특징 방향 조종 | 뉴런을 밀었을 때 모델이 쓴 롤아웃, 렌즈, 직접 경로 연결 |
| 추가로 필요한 것 | 대량의 텍스트 통과 | SAE 학습 또는 공개된 SAE 가중치 | 층마다 약 9만 5천 개 롤아웃을 만드는 GPU 스윕 |
| 우연과의 구분 | 방식마다 다름 | 방식마다 다름 | 같은 크기로 민 무작위 방향 대조군 256개 |
저자가 스티어링을 먼저 택한 이유는 반응 크기 순위의 사각지대 때문입니다. Qwen3-8B tawny-owl 모델은 뉴런 128개만 학습시켜 올빼미 캐릭터를 만든 모델입니다. 저자는 이 모델에서 시스템 프롬프트의 "oak tree"를 옮기던 8번 층 5315번 뉴런이 웹 텍스트 순위로는 전혀 중요해 보이지 않는다는 점을 예로 듭니다. 스티어링은 모든 뉴런에게 같은 크기의 영향력을 주고 결과를 읽기 때문에, 조용하지만 출력에 영향을 주는 뉴런도 같은 기준으로 비교할 수 있습니다.
무작위 방향 대조군도 neuron explorer의 중요한 차이입니다. 저자의 22번 층 보정 실험에서 Who are you? 프롬프트의 답에는 2746번 뉴런을 밀면 "Grok"이, 2748번 뉴런을 밀면 "Microsoft"가 등장했습니다. 그런데 뉴런이 아닌 무작위 방향 하나도 "Xiaomi AI"라는 답을 유도했습니다. 저자는 대조군이 없었다면 이런 결과를 모두 정체성 뉴런으로 오해했을 것이라고 적었습니다. 2742번 뉴런이 다른 점은 세 프롬프트 모두에서 같은 주제(외계 생명체)를 유도한다는 데 있다고 설명합니다.
neuron explorer가 읽기 쪽 근거를 버리는 것은 아닙니다. 탐색기는 직접 입력한 문장에서 뉴런이 어디에 반응하는지 보여 주는 fires 기능과 로짓 렌즈(logit lens)도 함께 제공합니다. 로짓 렌즈는 중간 표현을 바로 출력 어휘로 사영해 읽는 방법으로, PyTorchKR에서 소개한 Jacobian Lens가 이를 보정한 사례입니다.
neuron explorer를 사용하면 좋을 사용자
neuron explorer는 공개된 소형 모델의 뉴런을 하나씩 열어 보며 가설을 세우고 직접 실험하려는 해석 가능성 연구자에게 맞습니다. Mac의 MPS에서도 Qwen3.5-4B를 불러 실시간 스티어링과 활성값 계산을 할 수 있습니다. 스윕 규모도 저자 기록 기준으로 층 전체(뉴런 9,216개) 스윕이 RTX 4090 4장에서 층당 약 1시간, 32개 층에서 일부 뉴런만 뽑은 깊이 조사가 같은 4장으로 약 1시간 50분에 약 6달러 수준이라 개인 연구 예산으로 재현을 시도해 볼 만합니다. 반면 저장소에는 스윕 결과(runs/, stats/)가 들어 있지 않으므로, GPU 없이 이미 만들어진 뉴런 설명 데이터베이스를 둘러보고 싶은 사용자에게는 neuron explorer가 아직 적절한 선택지가 아닙니다. 모델 이름도 코드에 Qwen/Qwen3.5-4B로 고정되어 있어, 다른 모델에 쓰려면 탐색기와 스윕 스크립트를 함께 고쳐야 합니다.
neuron explorer의 스티어링 스윕 설계
neuron explorer의 스윕은 뉴런 n 의 다운 프로젝션 열 W_{down}[:, n] 방향으로 해당 층 MLP 출력을 미는 방식으로 동작합니다. 미는 크기는 뉴런마다 다르게 두지 않고, 그 층을 나가는 잔차 스트림(residual stream) 노름의 중앙값 \tilde{r}_\ell 에 대한 비율 d 로 통일합니다:
기본 설계인 main_rel은 프롬프트와 비율 d 를 다음과 같이 조합하고, 프롬프트마다 스티어링하지 않은 기준 응답을 하나씩 함께 생성합니다:
| 프롬프트 | 비율 d |
|---|---|
Who are you? |
−0.7, +0.5, +0.8 |
Write a snake game in Python. |
−0.7, +0.5, +0.8 |
Describe the color orange. |
−0.7, +0.5, +0.8 |
Write whatever you like. |
+3 |
처음 설계는 뉴런 자신의 최대 활성값을 단위로 썼지만, 저자는 21개 뉴런과 무작위 방향 8개로 ±1부터 ±32까지 보정한 뒤 단위를 잔차 노름으로 바꿨습니다. 저자의 측정에 따르면 문장이 무너지는 정도는 어느 방향을 미는지보다 잔차 노름 대비 얼마나 세게 미는지에 주로 달려 있었고(같은 크기라면 뉴런 방향이 무작위 방향보다 조금 더 빨리 무너졌습니다), 문장이 유지되는 구간은 모든 뉴런에서 약 0.5~0.8배였습니다. 최대 활성값 단위로 같은 값을 주면 조용한 뉴런은 이 구간에 못 미치고 반응이 큰 뉴런은 구간을 넘어가 버립니다. 마지막 +3 롤아웃은 문장이 무너진 상태에서 반복되는 토큰을 보기 위한 것으로, 2742번 뉴런에서는 "extr extr…"처럼 뉴런 방향의 로짓 렌즈와 같은 토큰이 나왔습니다.
순위는 각 뉴런의 롤아웃에서 다른 뉴런보다 유난히 많이 나온 단어 묶음의 점수(word-cluster mass)로 매기고, 같은 점수를 무작위 방향 대조군에도 계산해 백분위로 비교합니다. 스윕이 저장하는 결과와 저장소에 이미 포함된 캐시는 다음과 같이 나뉩니다:
neuron explorer의 탐색 화면 구성
neuron explorer의 탐색기는 다섯 개의 화면으로 구성되어 있습니다:
- map: 층마다 어텐션과 MLP를 나누고 뉴런 하나를 점 하나로 그린 3D 지도입니다. 뉴런에 마우스를 올리면 스티어 렌즈와 로짓 렌즈가 보이고,
writes배치를 고르면 다운 프로젝션 열이 비슷한 뉴런끼리 가깝게 놓입니다. - list: 무작위 방향 대조군 대비 단어 묶음 점수로 뉴런 순위를 보여 줍니다.
lens검색으로 특정 토큰을 올리거나 내리는 뉴런을 찾고,fires로 직접 입력한 문장에서 활성값이 큰 뉴런을 거를 수 있습니다. - neuron: 프롬프트와 비율별 롤아웃, 음수와 0, 양수 세 열로 동시에 진행되는 다중 턴 스티어링 대화, 렌즈와 연결 정보, 사용자가 붙이는 이름을 한 화면에 모았습니다.
- embeddings: 한 층의 롤아웃을 임베딩해 UMAP(Uniform Manifold Approximation and Projection)으로 펼친 산점도로, 뉴런, 프롬프트, 비율, 종류(뉴런 또는 무작위 방향)별로 색을 바꿔 볼 수 있습니다.
- Claude: 탐색기를 MCP 서버로 연결한 Claude Code 에이전트와의 대화 탭입니다.
스티어 렌즈(steer lens)는 neuron explorer가 로짓 렌즈의 한계를 보완하려고 추가한 지표입니다. 로짓 렌즈는 뉴런의 출력 방향을 곧바로 출력 어휘로 읽기 때문에 직접 경로만 봅니다. 스티어 렌즈는 짧은 문맥 4개에서 뉴런을 ±0.8만큼 밀고 모델 전체를 통과시켜, 다음 토큰 로그 확률이 어떻게 바뀌는지 측정합니다. 저자의 기록에서 22번 층 5344번 뉴런은 로짓 렌즈에 "indicator"만 보였지만 스티어 렌즈에서는 "responsible"이 올라왔습니다. 실제 대화에서 이 뉴런을 −0.8로 밀자 모델은 자신을 "Responsible AI" 라고 소개했습니다. 스티어 렌즈는 32개 층 전체에 대해 계산되어 캐시로 함께 제공됩니다.
연결(connections) 정보는 뉴런 A가 쓰는 방향이 뒤쪽 층 뉴런 B의 게이트와 업 프로젝션 입력에 얼마나 잘 맞는지를 가중치만으로 계산한 직접 경로 점수입니다. 저자는 모든 층 쌍 496개에 대해 이 값을 미리 계산해 뉴런마다 위아래로 가장 강한 연결 24개씩을 54MB 파일로 저장했고, 덕분에 뉴런을 처음 클릭했을 때의 대기 시간이 약 5초에서 약 25밀리초로 줄었다고 밝혔습니다. 이 점수는 가중치에서 계산한 직접 경로이므로 Circuit Tracer처럼 특정 입력에서의 기여를 추적하는 회로 분석과는 다릅니다.
Claude 탭은 로컬에 설치하고 로그인한 Claude Code CLI를 실행하고, 탐색기를 MCP 서버로 연결합니다. 이 에이전트는 뉴런 데이터 조회, 실시간 스티어링, 활성값과 다음 토큰 로그 확률 계산, 절제(ablation) 실험, 지도 조작까지 수행합니다. neuron explorer는 explorer/agent_prompt.md와 explorer/agent_methodology.md의 작업 지침에서, 뉴런을 단어 목록이 아니라 "어떤 구분을 짓는가"로 설명하고 가설을 깨뜨릴 테스트를 먼저 제안하라고 에이전트에게 요구합니다. 다만 explorer/server.py를 보면 이 에이전트는 Read, Write, Edit, Bash 도구를 미리 허용한 상태로 홈 폴더 전체를 작업 범위에 추가하고, 사용자 수준 Claude Code 설정(권한 규칙 포함)은 불러오지 않은 채 실행됩니다. 에이전트 지침에는 사용자 파일을 덮어쓰거나 지우기 전에 물어보라는 문장이 있지만, 이는 모델이 따르는 지침이고 코드에 이를 막는 승인 단계는 없습니다. Claude 탭에서 보낸 요청은 홈 폴더 안에서 셸 명령과 파일 쓰기를 확인 없이 실행할 수 있으므로, 중요한 파일이 있는 계정에서는 이 점을 알고 쓰는 편이 안전합니다. 서버 자체는 127.0.0.1에만 바인딩되고 다른 호스트 이름의 요청을 거절하도록 되어 있습니다.
neuron explorer 연구 로그의 주요 관찰
아래 수치는 모두 저자가 연구 로그에 남긴 자체 측정이며, 별도 논문이나 외부 재현을 거친 결과는 아닙니다. 22번 층과 8번 층 전체(각 9,216개 뉴런과 무작위 방향 256개)를 스윕한 결과, 무작위 방향 대조군 전체보다 단어 묶음 점수가 높은 뉴런은 22번 층에서 1,803개(19.6%), 8번 층에서 757개(8.2%)였습니다. 양성 대조군인 2742번 뉴런은 아무 힌트 없이 22번 층 9,216개 중 405위(상위 4.4%)에 올랐습니다. 저자는 비슷한 강도로 주제를 유도하는 뉴런이 약 1,800개 있으므로, 외계인 뉴런은 특별히 강한 것이 아니라 정체성이라는 주제의 종류가 드문 경우라고 해석합니다.
저자는 층 깊이에 따른 차이를 보려고 32개 층 모두에서 뉴런 384개와 무작위 방향 64개씩을 비교했습니다. 8번과 22번 층은 전체 스윕에서 같은 개수를 추렸고, 나머지 30개 층은 새로 스윕했습니다. 저자의 측정에 따르면 앞쪽 층(5~6번)의 뉴런은 항공기 엔진, 오스만 제국, 요리처럼 주제와 상황을 유도했습니다. 가운데 층(10~17번)은 "even", "though", "specifically" 같은 담화와 태도 표현을 움직였고, 뒤쪽 층(23~26번)은 "manage, management, managing"처럼 같은 어근의 단어 묶음을 유도했습니다. 가운데 층에서 대조군을 넘는 뉴런 비율이 떨어지는 현상은 기준 응답에 나온 단어를 제외하는 점수 방식 때문일 수 있다는 가설도 세웠습니다. 하지만 모든 단어를 세는 점수로 다시 계산해도 그 비율은 크게 달라지지 않았습니다.
저자는 한계도 함께 적었습니다. 0~2번 층은 같은 비율로 밀었을 때 무작위 방향까지 빈 응답을 내는 경우가 많아 측정값으로 볼 수 없다고 밝혔습니다. 다운 프로젝션 열이 비슷한 뉴런끼리 모은 writes 배치는 실제 최근접 이웃을 옆자리에 두는 비율이 무작위 배치보다 8번 층에서 약 9배, 22번 층에서 약 26배 높았습니다. 다만 그 비율 자체가 4.7%와 12.9%로 낮아, 저자는 이웃 관계를 "가끔 조금 관련 있는" 정도로 읽어야 한다고 권합니다. 또한 스윕 전에 층마다 비율을 보정했어야 했다는 점을 다음에 바꿀 일로 남겼습니다.
neuron explorer 설치와 사용
neuron explorer를 실행하려면 Python 3.11 이상과 uv가 필요합니다. 탐색기는 처음 실행할 때 Qwen3.5-4B 가중치를 내려받아 bfloat16으로 불러옵니다. 저장소 이름은 프로젝트 이름과 달리 neuron-explorer이므로, 아래 명령에서는 그 이름을 그대로 씁니다:
git clone https://github.com/lyramakesmusic/neuron-explorer.git
cd neuron-explorer
uv sync
uv run python explorer/server.py        # http://localhost:8791
서버를 실행하면 브라우저에서 http://localhost:8791로 접속합니다. 이 상태에서 함께 제공되는 캐시로 지도, 렌즈, 연결, 렌즈 검색을 쓸 수 있고, 내려받은 모델로 fires와 실시간 스티어링 대화를 쓸 수 있습니다. 반면 롤아웃 예시와 순위, 임베딩 화면은 아래 스윕으로 runs/와 stats/를 만든 뒤에 채워집니다. 서버 코드상 PORT 환경 변수로 포트를 바꿀 수 있고, EXPLORER_NO_MODEL=1로 실행하면 모델 가중치를 내려받지 않는 캐시 전용 모드가 됩니다. Claude 탭의 모델은 EXPLORER_CLAUDE_MODEL로 지정합니다.
스윕은 CUDA 13 GPU 포드에서 다음 순서로 실행합니다:
bash sweep/setup_pod.sh                                   # fork, deps, model; writes /workspace/env.sh
python sweep/neuron_stats.py --layers 22 --tokens 2000000 --out stats/q35-4b
python sweep/steer_sweep.py --stats stats/q35-4b_L22.npz --design main_rel --dose-unit rel \
    --neurons all --random-controls 256 --run q35-4b-L22
sweep/run_depth.sh "4 9 13 17" 384 64                     # random-subset sweep across several layers
setup_pod.sh가 스티어링용 vLLM 포크와 의존성, 모델을 준비하고, neuron_stats.py가 2백만 토큰으로 뉴런별 활성 통계와 잔차 노름을 구한 뒤, steer_sweep.py가 그 통계를 이용해 main_rel 설계로 모든 뉴런과 무작위 방향 256개를 스윕합니다. 마지막 줄은 여러 층에서 뉴런 일부만 뽑아 깊이별로 비교하는 스윕입니다. 생성이 끝난 결과를 로컬의 runs/와 stats/로 옮기면, 탐색기 서버가 그 층을 처음 열 때 sweep/rank.py의 순위 계산을 직접 실행해 결과를 저장합니다. 임베딩 화면은 explorer/build_embeddings.py로 UMAP 좌표를 따로 만들어야 나타납니다. 저자는 연구 로그에서 포드를 지우기 전에 롤아웃, 통계, 캡처를 모두 내려받았는지 출력 디렉토리 목록으로 확인하라고 당부합니다.
 neuron explorer 프로젝트 GitHub 저장소
 neuron explorer가 분석하는 Qwen3.5-4B 모델
더 읽어보기
-
Qwen-Scope: Sparse Autoencoder로 LLM 내부를 해석하고 제어하는 Qwen 팀의 오픈소스 도구
-
Circuit Tracer: Anthropic이 공개한, LLM의 내부 동작 원리를 분석하고 시각화하는 도구 (feat. Decode Research)
-
Qwen3.5: 초기부터 멀티모달 데이터로 학습한, 에이전트 중심의 워크플로우에 최적화된 Native Multimodal Agent Model
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
