핵심 요약
- Qwenputer는 Qwen3.5-4B 앞에 32비트 RISC-V CPU(RV32IM)를 11개 층으로 붙인 실험 모델입니다. 이 층의 가중치는 학습이 아니라 컴파일러가 계산했고, CPU의 메모리로는 이 층들이 가진 Gated DeltaNet 상태를 씁니다. Qwen3.5와 같은 종류의 층이라 새 층 유형은 필요 없습니다.
- Qwen은 학습 때 익힌 도구 호출 형식으로 계산을 요청하고, 응답(
<tool_response>)은 모델의 컴퓨터 층이 직접 씁니다. 다만 펌웨어를 상태에 넣고 트레이스 토큰을 Qwen 층에서 가리는 드라이버(RvChat)가 있어야 실행됩니다. - 세트당 40문항인 DeepMind 산술 세트에서 Qwenputer는 97.5~100%로, 호스트에서 Python 도구를 쓴 기본 Qwen(95~100%)과 비슷합니다. 블로그 차트의 NUPA 100%는 이번 RISC-V 판이 아니라 이전 CHIP-8 판의 결과입니다.
- 체크포인트는 bf16 기준 18.8GB이고 24GB GPU 한 장에서 돌아갑니다. 코드는 MIT, 가중치는 Apache-2.0이며, 저자 Divyansh Agrawal의 블로그 글이 설계를 설명합니다.

Qwenputer 소개
Qwenputer는 언어 모델의 가중치 안에 실제로 동작하는 컴퓨터를 컴파일해 넣은 실험 모델입니다. 정확한 계산을 외부 Python 도구에 맡기지 않고 모델의 순전파(forward pass) 안에서 끝낸다는 점이 목표입니다.
LLM이 긴 자릿수 곱셈이나 나눗셈에서 틀리는 문제는 오래된 문제입니다. 지금까지의 표준 해법은 모델이 도구 호출을 내보내면 바깥의 인터프리터나 샌드박스가 계산하고 결과를 다시 넣어 주는 방식이었습니다. 이 방식은 정확하지만, 실행 환경과 도구 서버를 따로 준비해야 합니다. Qwenputer는 계산기를 모델 밖에 두지 않고 모델의 층으로 만들어 넣습니다.
이 실험이 가능한 이유는 기반 모델의 구조에 있습니다. Qwen3.5는 Qwen3-Next처럼 전체 어텐션(Gated Attention) 층과 Gated DeltaNet(GDN) 층을 섞은 하이브리드 모델이며, 4개 층 중 3개가 GDN입니다. GDN은 선형 RNN의 일종으로, 각 헤드가 고정 크기의 상태 행렬을 들고 토큰마다 갱신합니다. 저자는 이 상태 행렬을 조건만 맞추면 정확하게 읽고 쓰는 메모리로 쓸 수 있다는 점에 주목했습니다.
저자는 Divyansh Agrawal입니다. 2026년 10월 22일 블로그 글을 올렸고, 10월 28일 X 스레드로 공개를 알렸습니다. 저장소는 10월 19일에 만들어졌으며, 2026년 11월 1일 기준 GitHub 스타 401개, 포크 49개입니다. 저자는 이 모델을 아주 실험적인 모델이라고 부르며, 플러그인이나 도구, 샌드박스가 아니라고 거듭 강조합니다. 이 글은 블로그와 README에 더해 저장소의 설계 문서 rv32.md와 커밋 기록을 함께 읽고 정리했습니다. 모델을 직접 실행해 보지는 않았습니다.
Gated DeltaNet 상태를 정확한 RAM으로 쓰는 원리
GDN 헤드는 토큰이 들어올 때마다 상태 행렬 S 를 다음 식으로 갱신하고, 쿼리 q 로 값을 읽습니다. 그림의 표기를 그대로 옮기면 다음과 같습니다.
여기서 \alpha_t 는 게이트(gate) 입니다. 새 값을 쓰기 전에 상태 전체에 곱하는 0과 1 사이의 수이고, RNN이 오래된 정보를 잊는 장치입니다. \beta_t 는 쓰기 강도(write strength) 로, 키가 가리키는 방향의 기존 값을 새 값 쪽으로 얼마나 옮길지 정합니다. 저자에 따르면 원래의 Qwen3.5는 GDN에 정확한 값을 보관하지 않습니다.
저자는 세 가지 조건을 걸었습니다. 게이트 \alpha = 1 로 두어 아무것도 잊지 않게 하고, 쓰기 강도 \beta = 1 로 두어 기존 값을 섞지 않고 완전히 바꿉니다. 그리고 키를 원-핫(one-hot) 벡터로 만듭니다. 원-핫 키는 1이 하나뿐인 벡터라서 상태의 한 행만 가리킵니다. 메모리 주소가 칸 하나를 가리키는 것과 같습니다. 이 조건에서 쓰기 한 번은 정확히 한 행을 덮어쓰고, 원-핫 쿼리는 그 행의 값을 정확히 돌려줍니다.
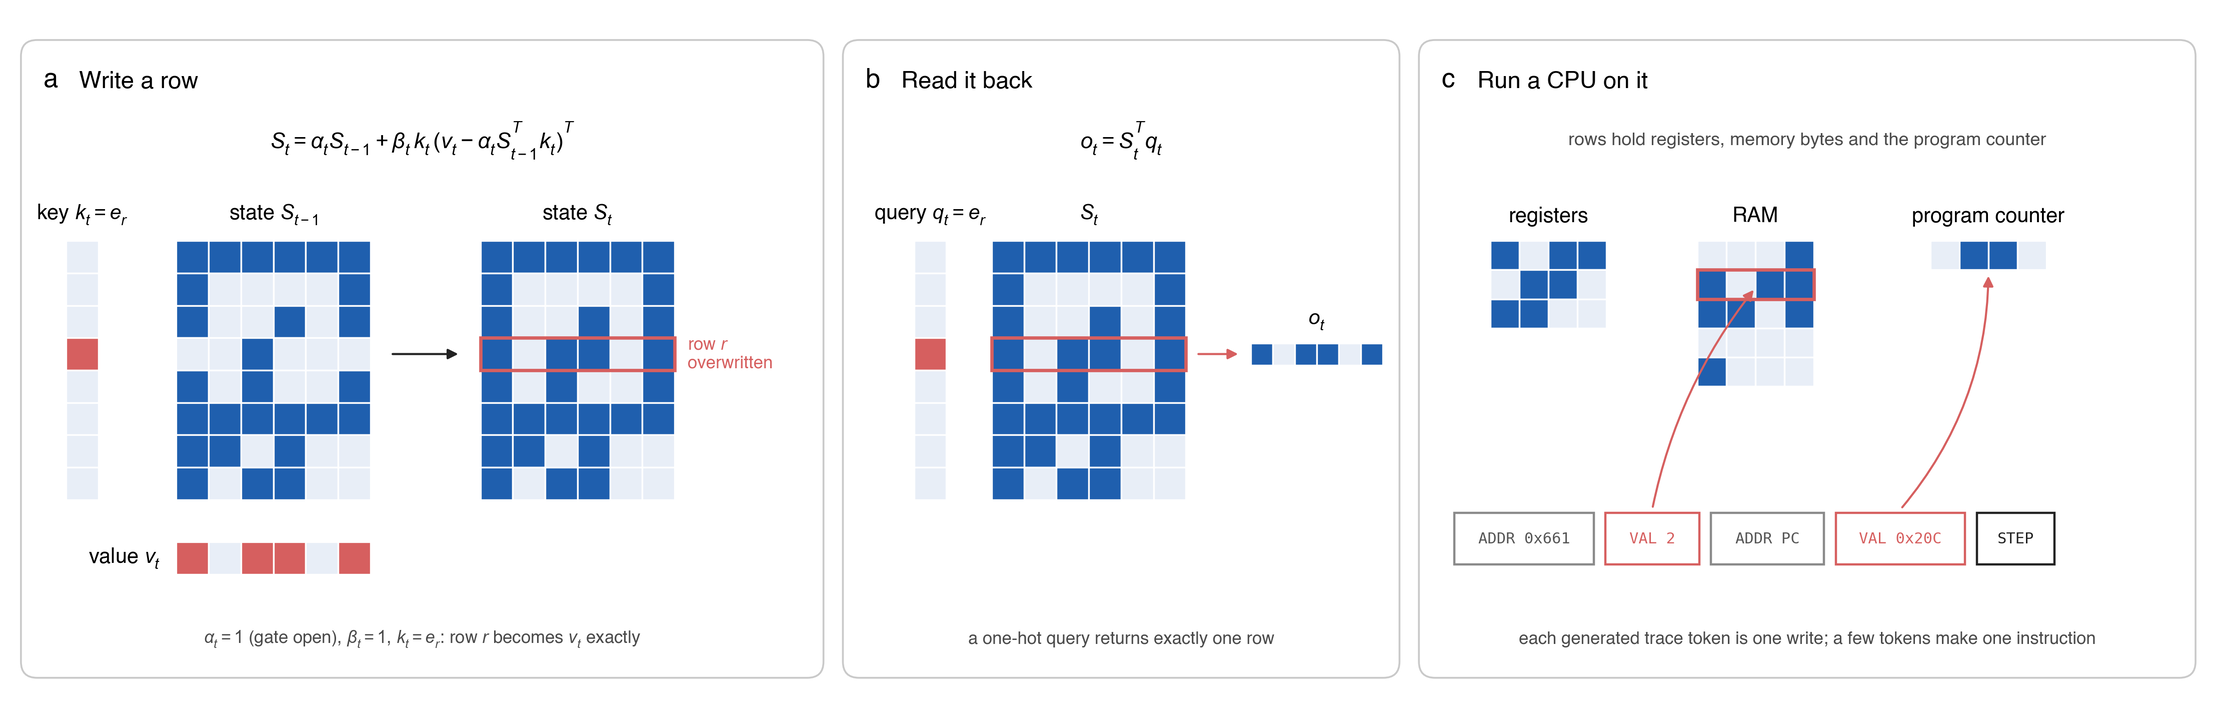
메모리 배치는 주소의 하위 비트로 헤드를, 나머지 비트로 행을 고르는 방식입니다. 각 행에는 1바이트를 비트 단위로 저장합니다. CPU의 메모리는 수십 개 헤드에 퍼져 있고, 레지스터와 프로그램 카운터, 호출 스택은 각자 전용 헤드를 씁니다. 게이트도 버리지 않고 활용합니다. \alpha = 0 을 한 토큰 동안 주면 헤드 전체가 지워지고, \alpha = 1/2 로 두면 매 단계 값이 절반이 되어 카운터 역할을 합니다.
이 방식은 어텐션을 메모리로 쓰는 방식보다 가볍습니다. 어텐션의 KV 캐시(Key-Value cache)는 대화가 길어질수록 커지지만, GDN 헤드의 상태는 대화 길이와 상관없이 크기가 같습니다. 저자는 델타 규칙을 연상 메모리로 보는 관점 자체는 새롭지 않다고 밝힙니다. Schlag, Irie, Schmidhuber의 ICML 2021 논문이 델타 규칙을 쓴 선형 어텐션을 "fast weights" 연상 메모리로 해석했습니다. 저자가 새로 보인 것은 이 메모리를 실제 배포된 모델 안에서 주소 지정이 가능하고 정확하게 만들어, CPU 전체를 돌릴 만큼 안정적으로 쓴 점이라고 설명합니다.
 델타 규칙과 fast weights에 관련해서는 다음 논문(Linear Transformers Are Secretly Fast Weight Programmers)을 참고해주세요:
학습 없이 가중치를 계산하는 컴파일러와 11개의 CPU 층
CPU 층의 가중치는 학습으로 얻지 않습니다. 저자는 CPU를 레지스터 읽기, 두 수 더하기, 0이면 점프하기 같은 작은 단계의 목록, 즉 회로로 기술합니다. 컴파일러는 각 단계를 트랜스포머 층의 부품으로 바꿉니다. 값을 찾아오는 일은 어텐션 헤드가, 산술은 피드포워드(MLP) 유닛이 정확한 룩업 테이블로, RAM은 DeltaNet 헤드가 맡습니다.
CPU는 모델이 토큰을 디코딩하는 동안 실행됩니다. 명령어 하나는 몇 개의 생성 토큰이 됩니다. 블로그의 설명으로는 ADDR 토큰이 쓸 메모리 행을 고르고, 다음 VAL 토큰이 값을 싣고, STEP 토큰이 명령어를 끝냅니다. 이 트레이스 토큰(trace token) 의 흐름이 곧 CPU의 실행 기록입니다. 설계 문서의 측정으로는 C 프로그램 기준 명령어 하나에 1.0~1.55개 토큰이 듭니다.
모델의 사양은 Hugging Face 모델 카드와 설계 문서에 다음과 같이 정리되어 있습니다.
| 항목 | 값 |
|---|---|
| 기반 모델 | Qwen/Qwen3.5-4B, Qwen의 원래 가중치는 변경 없음 |
| 아키텍처 | 표준 Qwen3_5ForCausalLM(텍스트 전용), 설정 파일만 변경 |
| 컴퓨터 층 | Qwen의 32개 층 앞에 컴파일된 11개 층 |
| 명령어 집합(ISA, Instruction Set Architecture) | RV32IM, Zba 확장, 큰 수 연산용 보조 프로세서(bignum coprocessor) |
| 히든 크기 | 3968 (Qwen의 2560에 컴퓨터용 차원 추가) |
| 어휘 | Qwen 어휘에 트레이스 토큰 230,324개 추가 |
| 0이 아닌 가중치 | 약 104만 개 (설계 문서 기준 1,040,595개) |
| 크기 | bf16 18.8GB, 대부분 0으로 채운 부분 |
CPU 메모리는 RAM 32KB, 읽기 전용 데이터 영역 128KB, 코드 ROM 256KB로 나뉘며, 모두 새로 붙인 11개 층의 DeltaNet 상태에 있습니다. Qwen 원래 층의 상태는 건드리지 않습니다. 검증 결과로는 공식 riscv-tests의 rv32ui(38개), rv32um(8개), rv32uzba(3개)를 통과했습니다. 61개 ELF 프로그램에서는 참조 모델이 QEMU와 같은 종료 코드와 출력을 냈고, 회로는 그 참조 모델의 트레이스를 그대로 재현했습니다. 저자는 블로그에서 CPU가 1,800만 개 명령어를 자유 실행(free-running) 하며 오류가 없었다고 밝힙니다. 자유 실행은 참조 기계가 중간에 바로잡아 주지 않고 CPU가 자기 출력만으로 계속 실행하는 방식입니다.
설계 문서는 병합 전 단독 코어를 실행기로 자유 실행한 프로그램도 적습니다. 재귀 fib(25)는 211만 개 명령어, 정수 1,000개 퀵소트는 20만 개, MicroPython의 print(2**100)은 4만 개 명령어로 끝까지 정확하게 실행했습니다. 계산기 펌웨어 calc는 무작위 수식 10,000개를 Python 결과와 똑같이 계산했고, 회로에서 자유 실행할 때도 1만 개 모두 정확했습니다.
Qwen이 CPU를 부르는 방식: 도구 호출 형식만 빌린 calc
Qwen3.5-4B는 추가 학습 없이 이 CPU를 씁니다. 저자는 모델이 이미 잘 익힌 도구 호출 형식에 올라타는 방법을 택했습니다. 프롬프트에는 calc라는 도구가 다른 도구처럼 등록되어 있고, Qwen은 <tool_call> 블록을 평소대로 씁니다. 차이는 그다음입니다. 바깥의 어떤 런타임(runtime)도 이 블록을 해석하지 않습니다. 컴퓨터 층이 호출 내용을 읽어 RISC-V CPU에서 실행하고, <tool_response>를 모델이 직접 한 자리씩 씁니다.
설계 문서가 이 연결부(bridge)를 자세히 설명합니다. <tool_call> 뒤의 토큰은 CPU가 메모리처럼 읽는 텍스트 버퍼로 들어가고, 토큰당 16바이트로 한 번에 최대 80개 토큰까지 담습니다. </tool_call>이 실행을 시작하며, 프로그램이 출력하는 바이트는 대응하는 Qwen 토큰으로 바뀌어 Qwen이 일반 텍스트로 읽습니다. 펌웨어는 최대 62자리 값을 다루고, 정수의 + - * // % **, gcd(), 괄호와 소수의 덧셈, 뺄셈, 곱셈을 지원합니다. 10월 19일의 calc v2부터는 /가 기약분수를 쓰는 정확한 유리수 연산입니다.
아래 애니메이션은 저자가 만든 시각화입니다. Qwen이 -2241842 × 8077을 받아 적으면 CPU가 DeltaNet 상태의 레지스터와 메모리를 고쳐 쓰며 계산합니다. 계산이 끝나면 모델이 -18107357834를 출력합니다.
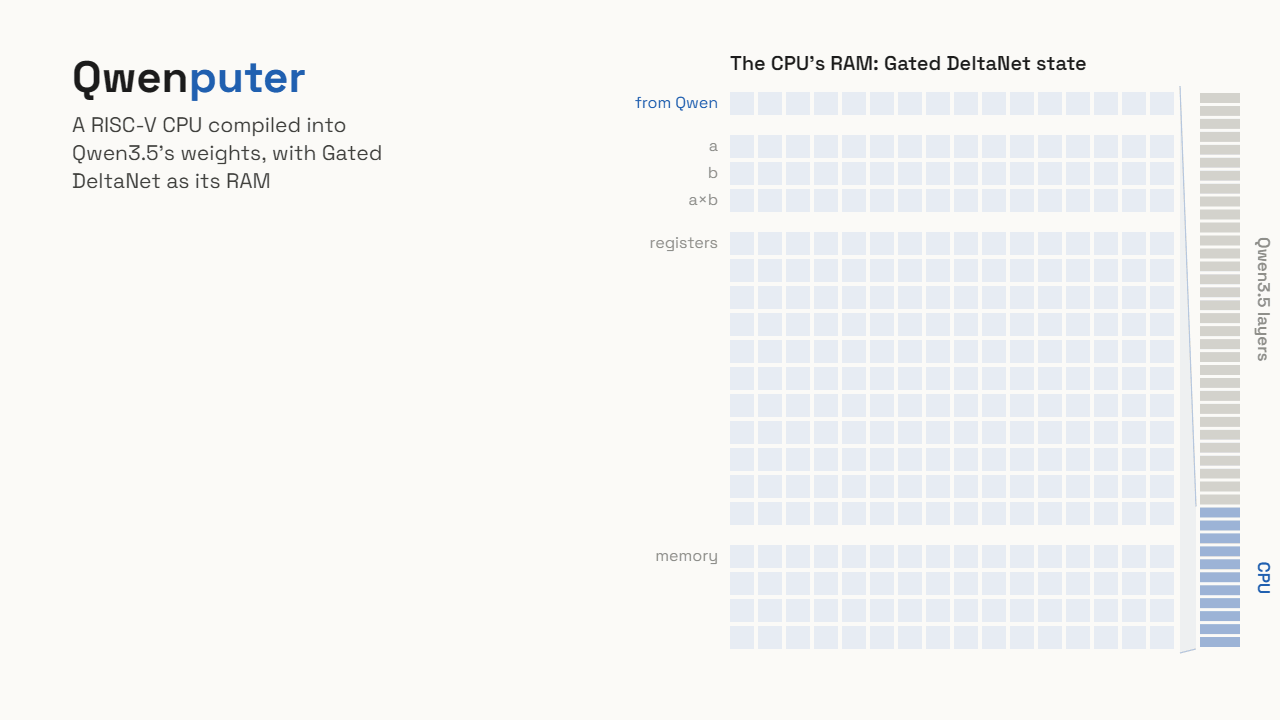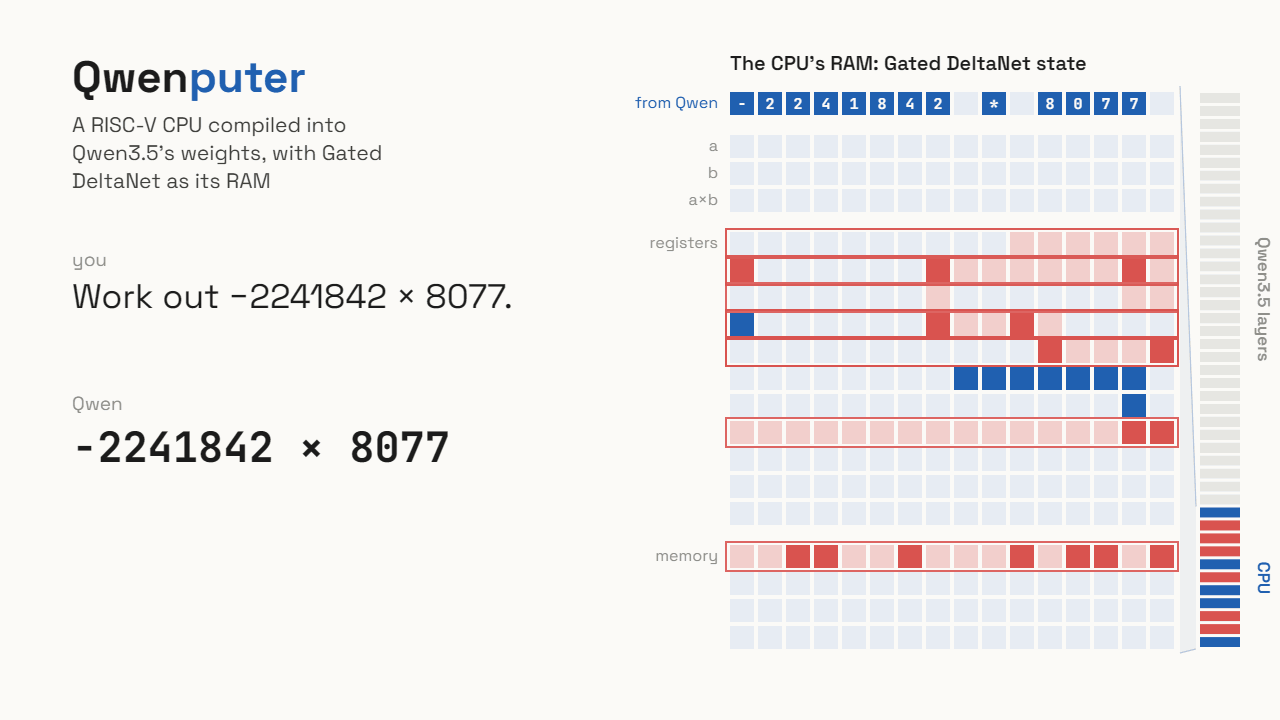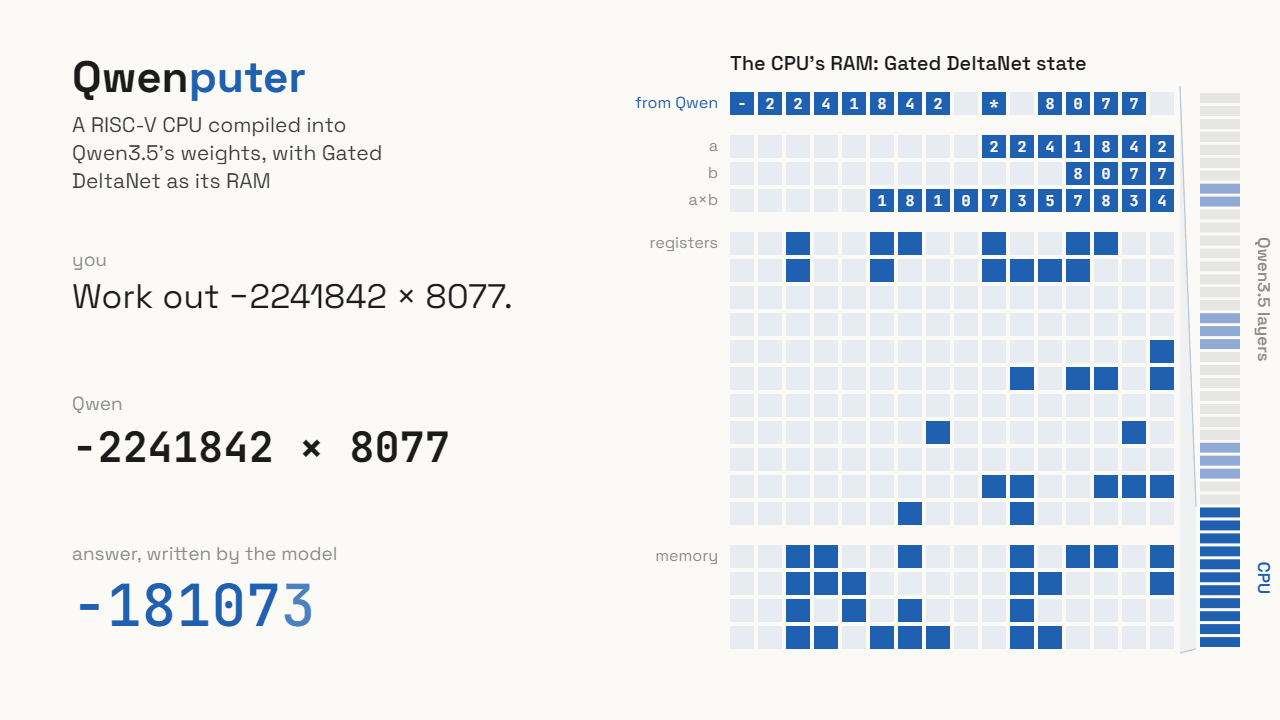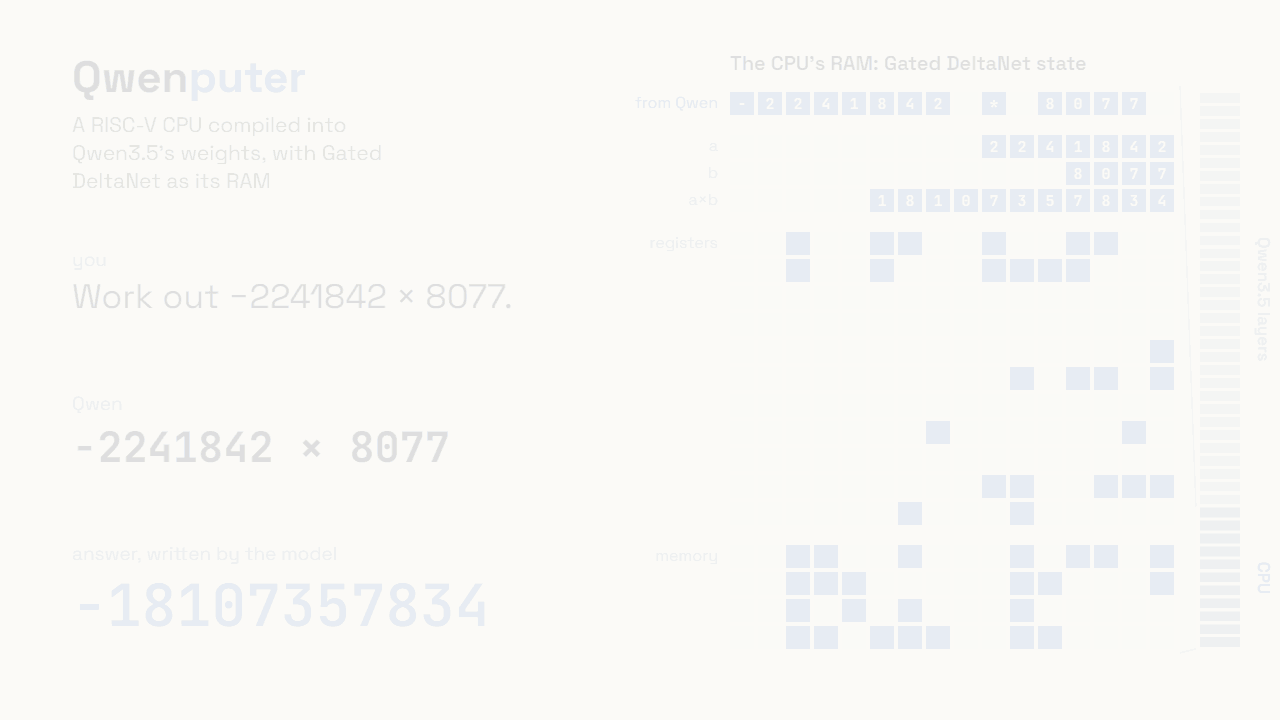
여기서 "도구 호출이 전혀 없다"는 주장의 범위를 정확히 살펴볼 필요가 있습니다. 계산 결과를 바깥 프로그램이 만들어 넣지 않는다는 뜻으로는 맞습니다. 하지만 RISC-V 판은 기본 generate() 호출만으로는 돌지 않습니다. RvChat이라는 작은 드라이버가 프롬프트 뒤에 펌웨어, RAM, 레지스터 스냅숏을 DeltaNet 상태에 넣어 CPU를 부팅합니다. 디코딩 중에는 트레이스 토큰이 CPU 층만 지나고 Qwen의 층에는 보이지 않게 합니다. 이전 CHIP-8 판은 기본 model.generate()로 돌았지만, 이번 판은 이 드라이버가 필요하다고 저자도 한계로 밝힙니다.
실행 경로도 하나 더 있습니다. README가 밝힌 L4 기준 초당 약 3,200 트레이스 토큰은 Hugging Face 모듈이 아니라 Triton 실행기(executor) 의 속도입니다. 이 실행기는 같은 회로의 연산을 fp32로 다시 구현해 토큰마다 CUDA 그래프 하나로 돌립니다. 설계 문서는 6개 기록에서 실행기와 Hugging Face 경로의 잔차가 모든 위치에서 비트 단위로 같았다고 적습니다. 순수 Hugging Face 경로의 속도는 초당 약 250 토큰으로 13배 느립니다. 또한 RvChat은 회로가 낸 토큰을 참조 기계와 한 토큰씩 대조(lockstep)하는 검사를 함께 돌립니다.
벤치마크를 읽을 때 확인할 조건
README와 Hugging Face 모델 카드의 표는 그리디 디코딩, 세트당 40문항, Qwen 토큰 예산 4,096개 조건입니다. 기본 Qwen에는 도구 없이 "모든 산술 단계를 정확히 하라"는 시스템 문장을 주었습니다. README는 Python 도구 열을 호스트의 실제 Python 인터프리터가 답한 결과라고 설명합니다. 설계 문서의 문항 수로 함께 적으면 다음과 같습니다.
| 벤치마크 (각 40문항) | 기본 Qwen3.5-4B | Qwenputer | Python 도구(호스트) |
|---|---|---|---|
| 합성 정수 산술 | 75.0 (30/40) | 97.5 (39/40) | 97.5 (39/40) |
DeepMind mul_big |
55.0 (22/40) | 97.5 (39/40) | 100 (40/40) |
DeepMind div_big |
72.5 (29/40) | 97.5 (39/40) | 95.0 (38/40) |
DeepMind mul_div_multiple_longer |
90.0 (36/40) | 100 (40/40) | 97.5 (39/40) |
DeepMind add_or_sub_big |
87.5 (35/40) | 97.5 (39/40) | 97.5 (39/40) |
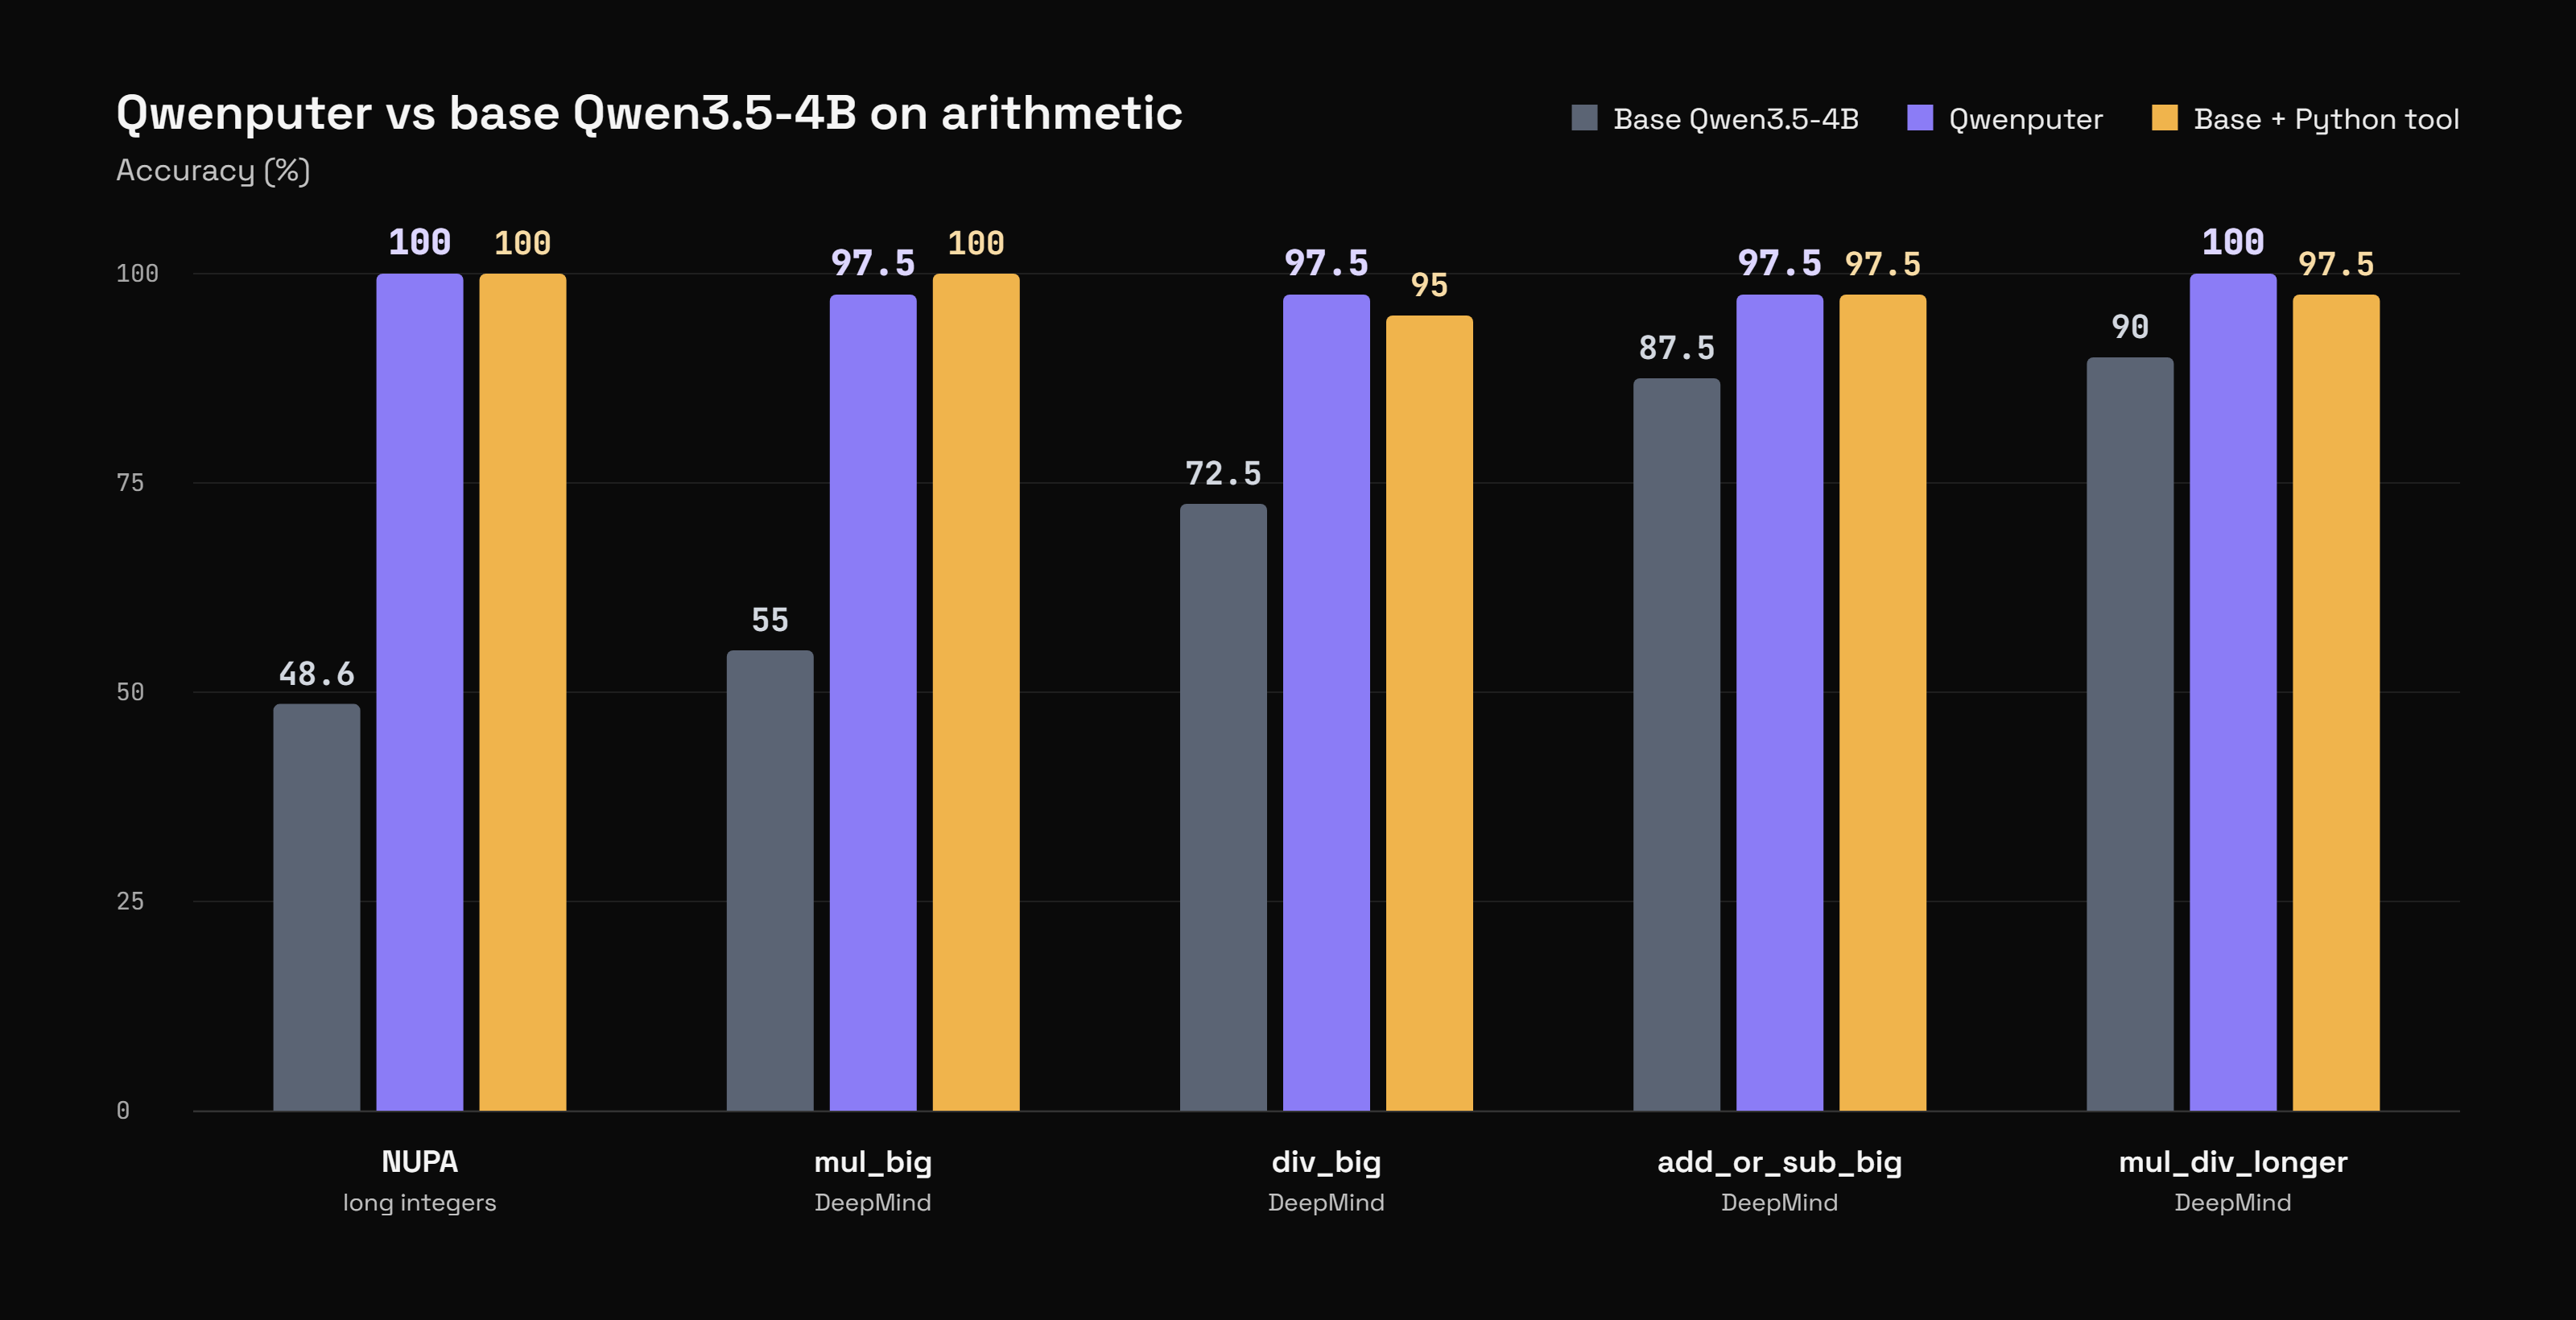
이 숫자들을 읽을 때 다섯 가지를 함께 봐야 합니다.
NUPA 막대는 다른 모델의 결과입니다: 블로그와 X 스레드는 "NUPA 장정수 산술에서 48.6%가 100%로 올랐다"고 씁니다. 하지만 이 수치는 이번 RISC-V 판이 아니라 첫 버전인 CHIP-8 판의 576문항 결과입니다. 10월 22일 커밋 메시지가 "NUPA는 CHIP-8 판, DeepMind와 합성 세트는 RISC-V 판"이라고 밝혔고, 직후 커밋이 차트에서 그 버전 표기를 지웠습니다. RISC-V 판 표에는 NUPA 행이 없고, CHIP-8 판의 표도 개발 체크포인트들 중 벤치마크별로 가장 좋은 모드를 고른 수치입니다.
세트당 40문항은 작은 표본입니다: 97.5%는 40문항 중 1문항을 틀린 결과라서, Qwenputer와 Python 도구의 1~2문항 차이는 우열로 읽기 어렵습니다. 10월 19일 README에는 McNemar 검정 열이 있었고, add_or_sub_big의 p값은 1.0이었습니다. 이 열은 같은 날 삭제됐습니다. 그 뒤 기본 Qwen 열은 같은 문항, 같은 예산의 재실행으로 네 행이 모두 바뀌었습니다(mul_big 65.0→55.0, add_or_sub_big 95.0→87.5, div_big 80.0→72.5, 합성 산술 70.0→75.0).
도구 설계가 결과를 뒤집은 적이 있습니다: calc v1에서는 분수를 최종 값으로만 허용했습니다. 그래서 mul_div_multiple_longer에서 Qwenputer는 20/40으로 기본 Qwen(36/40)보다 크게 낮았습니다. 1,040번의 호출 중 610번이 오류를 돌려받았고, Qwen은 재시도를 반복하다가 예산을 다 썼습니다. 같은 규칙을 쓴 Python 도구도 19/40이었습니다. 표의 40/40은 분수를 전 과정에서 다루는 calc v2로 A10G에서 다시 돌린 결과입니다. 이 재실행(mul_div, div_big)의 Python 도구 열은 실제 Python이 아니라 참조 기계 위의 같은 펌웨어가 답했습니다. 설계 문서는 남은 오답이 기계가 아니라 Qwen에서 나왔다고 분석합니다. 맞는 결과를 받고 다시 빼거나, 부호를 빠뜨리거나, 44번 호출을 반복한 경우입니다.
"정확하다"의 범위는 회로와 참조 기계의 일치입니다: 저자는 출력 위치 약 23만 개를 참조 기계로 재생해 불일치가 0건이었다고 밝힙니다. 이는 회로가 펌웨어를 그대로 실행한다는 보장이지, 펌웨어가 항상 옳은 답을 낸다는 보장은 아닙니다. 실제로 10월 20일 커밋은 한 세션의 다음 호출이 앞 호출의 자릿수를 출력할 수 있던 펌웨어 버그를 고쳤습니다. 같은 날 README는 RISC-V 절에서 "틀린 답을 낸 적이 없다"는 문장을 지웠습니다.
일반 텍스트 품질은 기본 모델 수준입니다: 16개 프롬프트에서 병합 모델과 기본 모델의 평균 KL 발산(Kullback-Leibler divergence)은 6.1e-4였습니다. 기본 모델 자신의 sdpa와 eager 커널 차이에서 오는 잡음 수준은 5.1e-4입니다. 그리디로 생성한 텍스트는 16개 중 10개에서 완전히 같았습니다.
실험적 파일 시스템: DeltaNet 상태에 저장하는 대화 간 기억
저자는 같은 RAM 위에 파일 시스템도 얹었습니다. Qwenputer-Filesystem 모델은 calc 옆에 put, append, get, list, delete 다섯 도구를 추가로 등록합니다. 이 역시 바깥에서 실행되지 않습니다. Qwen이 파일을 저장하면 컴파일된 층이 파일 이름을 해시해 DeltaNet 상태 안의 1,024칸짜리 디렉터리 중 한 칸에 넣습니다. 본문은 다른 헤드에 한 행당 8개 토큰씩 연결해 저장합니다. 해시가 겹치면 다음 칸을 봅니다. 파일을 찾는 데 트레이스 토큰 2~3개가 들고, 최대 512개 파일, 텍스트 약 53,000토큰을 담습니다.
이 기억은 대화를 넘어 유지됩니다. 대화가 끝날 때 해당 헤드의 상태를 저장하고 다음 대화에서 불러오면 파일이 그대로 있습니다. 모델 카드의 결과는 다음과 같습니다.
| 벤치마크 | 기본 Qwen3.5-4B | Qwenputer Filesystem | Python 도구(호스트) |
|---|---|---|---|
| 여러 세션에 걸친 회상 (90문항) | 7.8 | 83.3 | 78.9 |
| 나중 세션에서 바뀐 사실 (30문항) | 3.3 | 90.0 | 83.3 |
| 새 세션에서 저장한 문자열 50개 회상 | 해당 없음 | 100 | 100 |
| 새 세션에서 저장한 문자열 200개 회상 | 해당 없음 | 100 | 100 |
회상 테스트는 LongMemEval 형식을 본뜬 합성 테스트입니다. 지난 네 세션에서 사용자에 관한 사실 8개를 말하고 그중 2개를 바꾼 뒤, 질문마다 새 세션에서 묻습니다. 블로그가 비교한 90%와 30% 중 30%는 지난 대화를 프롬프트에 붙여 넣은 기본 Qwen의 바뀐 사실 정답률입니다. 같은 조건의 전체 회상 정답률은 76.7%입니다.
모델 카드는 한계도 적습니다. 한 대화 안에서는 Qwen이 컨텍스트에서 답하고 파일 시스템을 찾아보지 않습니다. 체크포인트는 22.3GB이고 GPU 메모리 약 18GB를 씁니다. 코드는 아직 main이 아니라 rv-store 브랜치에 있습니다.
CHIP-8 첫 버전과 NPU, QwenPU로 이어진 실험들
RISC-V 판 이전에 첫 Qwenputer인 CHIP-8 판이 있었습니다. 이 모델은 CHIP-8 기계와 큰 수 산술 라이브러리를 층으로 컴파일했고, 프롬프트 앞에 BIOS 토큰을 붙이면 기본 model.generate()로 실행됩니다. NUPA 3~20자리 정수 덧셈, 뺄셈, 곱셈 576문항에서 48.6%를 100.0%로 올렸고, MMLU는 71.9로 기본 모델의 71.7과 비슷했습니다. 저자는 이 판이 모든 곳에서 도움이 되지는 않는다고도 적었습니다. GSM8K와 GSM-Hard는 산술보다 추론(reasoning)이 병목이라 동점이었습니다. 긴 DeepMind 수식 체인에서는 Qwen이 이미 받은 정확한 결과를 토큰 예산이 바닥날 때까지 다시 검증하는 바람에 기본 Qwen이 앞섰습니다.
10월 30일 이후 README에는 두 갈래가 더 생겼습니다. Qwenputer-npu는 RISC-V CPU에 int4 가중치 내적 명령어 VDOT과 부호 있는 바이트 곱셈 누산 명령어 SMAQA를 더한 모델입니다. 이 CPU에서 Karpathy의 26만 파라미터 Llama인 stories260K를 C 프로그램으로 돌리며, 이야기 토큰 하나에 실행기 기준 약 41초(L4)가 걸립니다. QwenPU는 CPU에 별도 벡터 유닛을 붙여 이를 토큰당 약 16초로 줄였지만, 체크포인트가 26.7GB라 통째로 올리려면 40GB 이상의 GPU가 필요하고, 저자도 진행 중인 작업이라고 밝힙니다.
한계: 크기, 속도, 아직 병합 모델 밖에 있는 MicroPython
체크포인트 크기: 모든 층이 같은 폭이어야 하는 표준 체크포인트 형식이라 Qwen의 층까지 히든 크기 3968로 넓어져, 18.8GB로 기본 Qwen의 약 두 배가 됐습니다. 늘어난 부분은 대부분 0이며, 모델을 직접 병합해 만들려면 RAM이 약 31GB 필요합니다.
속도: CPU 명령어 하나가 디코딩 토큰 몇 개를 쓰므로, 큰 계산은 밀리초가 아니라 초 단위가 걸립니다. 설계 문서에 따르면 calc 호출 한 번은 칩 토큰 1,300~3,000개, 실행기로 0.5~1초입니다. 전체 시간은 오히려 텍스트 토큰이 지배합니다. L4, 배치 1에서 텍스트 토큰 하나에 약 68ms가 들고, mul_div 문제 하나의 중앙값은 실행기 경로로 242초였습니다. 이 측정은 flash-linear-attention이 없어 PyTorch의 선형 어텐션과 causal_conv1d 참조 구현을 대신 쓴 환경입니다.
MicroPython 실행 범위: 블로그와 README는 CPU가 "모델의 순전파 안에서 C와 MicroPython을 실행한다"고 씁니다. 그러나 설계 문서에서 Qwen과 연결하는 3단계(P3)의 미완료 항목은 MicroPython이 단독 코어와 실행기에서만 돌았고, 병합된 모델 안에서는 아직 실행하지 않았다고 적습니다. 그러려면 연결부를 새로 빌드해야 합니다(P4). 블로그의 다음 목표인 "Qwen이 Python을 써서 자기 가중치 안의 MicroPython으로 실행하는 python() 도구"가 바로 이 부분입니다.
그 밖의 제약: calc 호출은 80토큰을 넘으면 error (too long: split it)를 돌려줍니다. 이 창을 넓히면 bf16에서 가중치가 넘치므로 2단 카운터가 필요합니다. 계산이 큰 수 레지스터 7개를 넘으면 error (too complex: split it)가 납니다. Qwen3.5-0.8B는 키 헤드당 값 헤드가 하나뿐이라 지원하지 않습니다.
직접 실행해 보기
저자에 따르면 24GB GPU 한 장, uv와 Hugging Face CLI(hf)가 있으면 됩니다. 계산용 도구 서버나 Python 샌드박스는 필요 없습니다. 저장소를 받아 experimental/riscv에서 의존성을 설치하고, 모델을 내려받은 뒤 RvChat 드라이버로 질문합니다.
git clone https://github.com/divagr18/qwenputer && cd qwenputer/experimental/riscv && uv sync --extra hf
hf download divagr1925/Qwen3.5-4B-Qwenputer --local-dir qwenputer-rv
uv run python -m chipformer.rv.chat qwenputer-rv --firmware tests/data/rv/calc-bridge.elf \
    --ask "Use calc: what is 123456789 * 987654321?"
GPU가 없다면, 저자가 X 스레드에서 공유한 ModelScope 데모 스튜디오에서 먼저 동작을 볼 수 있습니다.
후속 연구: AI 안전성 실험대로서의 Qwenputer
저자는 RNN 층을 정확히 제어할 수 있다는 점이 산술 밖에서도 쓸모 있고 AI 안전성 연구의 실험대가 된다고 보고, 같은 컴파일러로 후속 글 두 편을 썼습니다.
첫 글 Hybrid models can hide reasoning in their RNN state는 하이브리드 모델이 추론을 CoT(Chain-of-Thought)로 적지 않고 RNN 상태에 숨길 수 있는지 실험합니다. 답만 학습시키는 미세조정(fine-tuning)에서, 쓰기 강도 \beta 를 2까지 허용하는 OLMo-Hybrid-7B는 학습 길이의 두 배인 스위치 128번 뒤집기에서도 정답률 0.89(6개 시드 평균)를 냈습니다. \beta 가 1 이하인 Qwen3.5-4B는 0.55, 같은 OLMo-Hybrid의 \beta 를 1로 묶으면 0.52로 우연 수준이었습니다. 저자는 과제가 패리티 하나뿐이라는 한계를 함께 밝힙니다. 둘째 글 Building oversight tools into a model's weights는 선형 프로브가 거짓말을 감지하면 플래그 토큰을 내고 그 기록을 DeltaNet 상태에 남기는 감시 장치를 가중치에 컴파일합니다. 저자의 측정으로 거짓말의 91%를 잡았고, 일반 대화와 GSM8K 28,000토큰에서 오탐은 0건이었습니다.
라이선스
코드는 MIT License로 배포되어 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 모델 가중치는 Qwen/Qwen3.5-4B를 수정한 버전으로 Apache-2.0을 따릅니다. 설정을 넓히고 컴퓨터 층을 더했지만 Qwen의 원래 가중치는 바꾸지 않았다고 저자는 밝힙니다.
 Qwenputer 소개 블로그
 Qwenputer GitHub 저장소
 Qwen3.5-4B-Qwenputer 모델 (Hugging Face)
 Qwen3.5-4B-Qwenputer 모델 (ModelScope)
 저자의 Qwenputer 공개 X 스레드
https://x.com/divagr1925/status/2115394340357116169
더 읽어보기
-
Qwen3.5: 초기부터 멀티모달 데이터로 학습한, 에이전트 중심의 워크플로우에 최적화된 Native Multimodal Agent Model
-
ReplaySSM: 상태-공간 모델(SSM)의 상태 쓰기를 줄여 하이브리드 모델 디코딩을 가속하는 NVIDIA 블로그 글 정리
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
