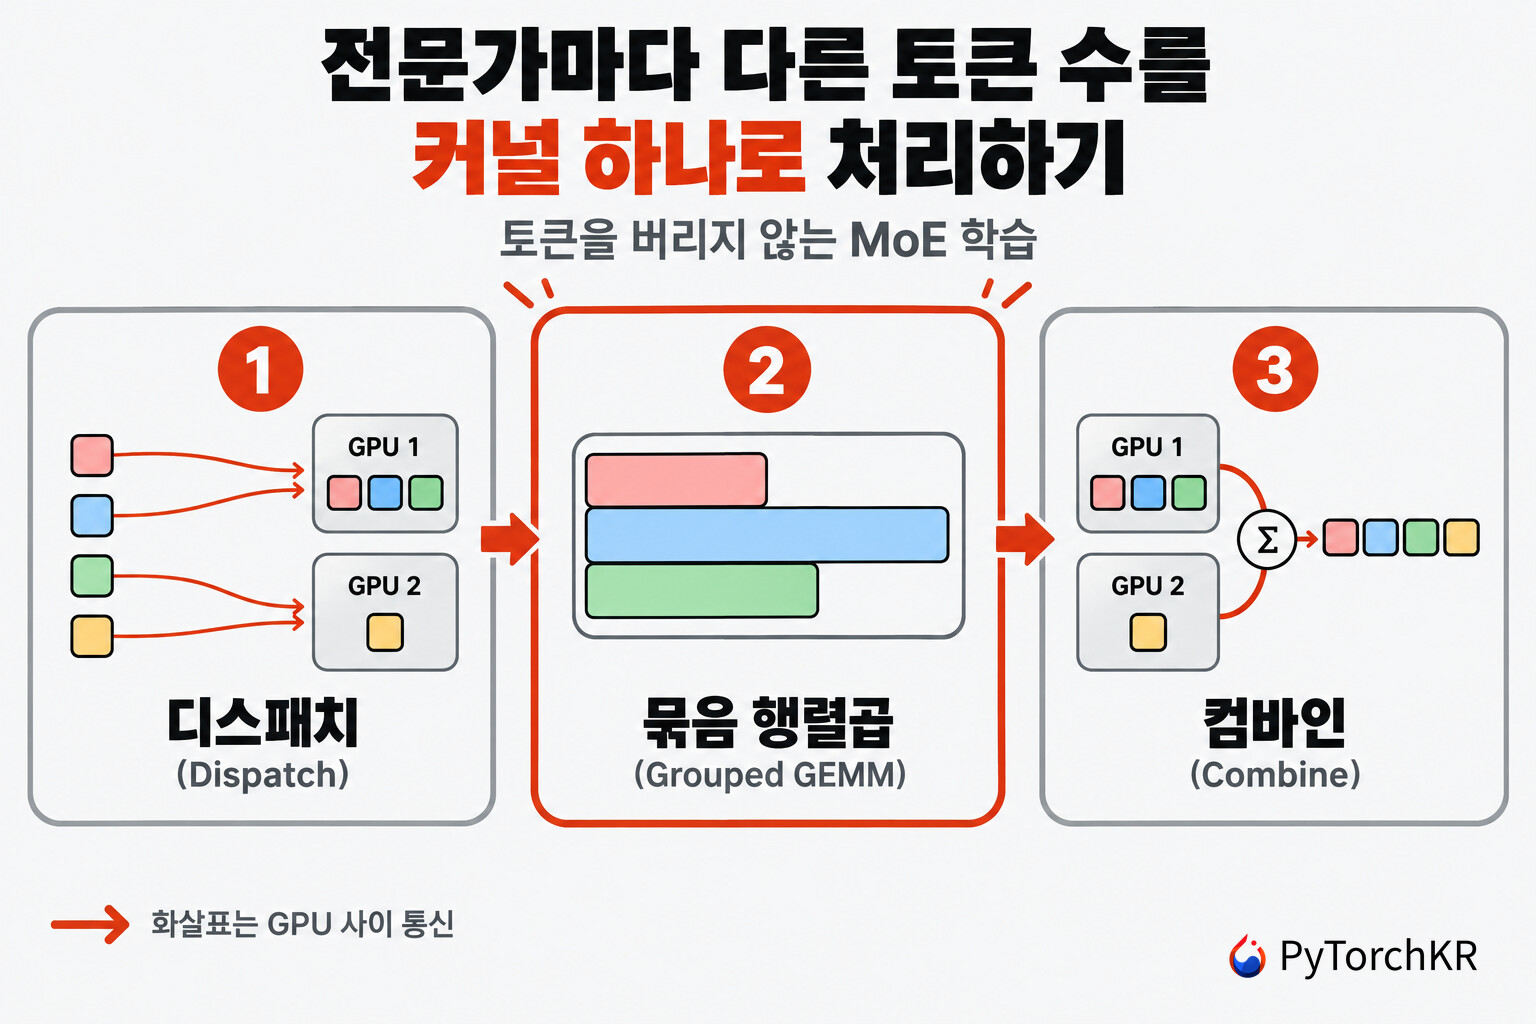
Dropless MoE 학습과 NVIDIA Transformer Engine 소개
전문가 혼합(Mixture of Experts, MoE) 은 지난 2년간 대규모 모델 학습의 사실상 표준 아키텍처가 되었습니다. 토큰마다 모든 파라미터를 통과시키는 밀집(Dense) 모델과 달리, MoE는 하나의 큰 순방향 신경망(Feed-Forward Network, FFN) 을 여러 개의 작은 전문가(Expert) 네트워크로 쪼개고, 학습된 라우터(Router)가 토큰별로 상위 K개 전문가만 활성화합니다. DeepSeek, Qwen, Mixtral이 같은 학습 연산량의 일부만 써서 밀집 모델에 필적하거나 앞서는 성능을 낸 것이 이 조건부 연산(Conditional Computation)의 결과입니다.
문제는 이 구조가 학습 시스템에는 정반대로 작동한다는 것입니다. 라우터는 학습되는 대상이라 학습이 진행되면서 특정 전문가를 선호하게 되고, 배치마다 전문가별 토큰 수가 예측 불가능하게 달라집니다. 대부분의 라이브러리가 균일한 직사각형 텐서를 가정하고 최적화되어 있는데, MoE는 매 스텝 모양이 바뀌는 텐서를 내놓습니다. NVIDIA 기술 블로그가 밝힌 수치가 그 대가를 잘 보여줍니다. NVIDIA GB200에서 DeepSeek-V3를 최적화 없이 학습했을 때 GPU당 103 TFLOPS에 그쳤고, 누적 커널 시간의 84% 가 GPU 사이 통신에 쓰였습니다.
2026년 9월 14일 NVIDIA의 Seonghee Lee, Jeremy Berchtold, Phuong Nguyen, Teddy Do, Tejash Shah가 공개한 이 글은 JAX 학습 스택에서 그 통신 병목을 제거한 과정을 다룹니다. 핵심 도구는 NVIDIA Transformer Engine(이하 TE)이고, 목표는 드롭리스(Dropless) MoE, 즉 라우팅이 아무리 치우쳐도 토큰을 버리지 않는 학습입니다. 결과적으로 같은 GB200 환경에서 GPU당 1,068 TFLOPS, 10.4배 향상에 도달했다고 밝히고 있습니다.
이번 글에서는 원문의 최적화 항목을 따라가면서, MoE 학습이 왜 어려운지, grouped GEMM과 전문가 병렬화(Expert Parallelism, EP) 커널이 각각 무엇을 해결하는지, 그리고 MaxText (
 MaxText, Jax와 Python으로 구현한 오픈소스 LLM 학습 프레임워크 (feat. Google))에서 직접 재현하려면 무엇이 필요한지를 정리합니다. 원문이 다루지 않은 부분, 특히 드롭리스라는 표현이 실제 설정에서 어디까지 보장되는지는 TE와 MaxText 저장소의 소스를 확인해 따로 정리했습니다.
MoE 학습이 밀집 모델보다 어려운 이유: 래그드 텐서
밀집 FFN에서는 모든 토큰이 같은 가중치 행렬을 통과하므로 행렬곱의 모양이 고정됩니다. MoE에서는 라우터가 토큰을 전문가별로 나눠 보내고, 그 배분이 매 스텝 달라집니다. 한 배치 안에서도 어떤 전문가는 다른 전문가보다 훨씬 많은 토큰을 받습니다. 그래서 전문가별 입력을 하나로 묶어 일괄 처리할 깔끔한 직사각형 행렬곱이 존재하지 않고, 대신 행 길이가 제각각인 래그드 텐서(Ragged Tensor) 가 남습니다.
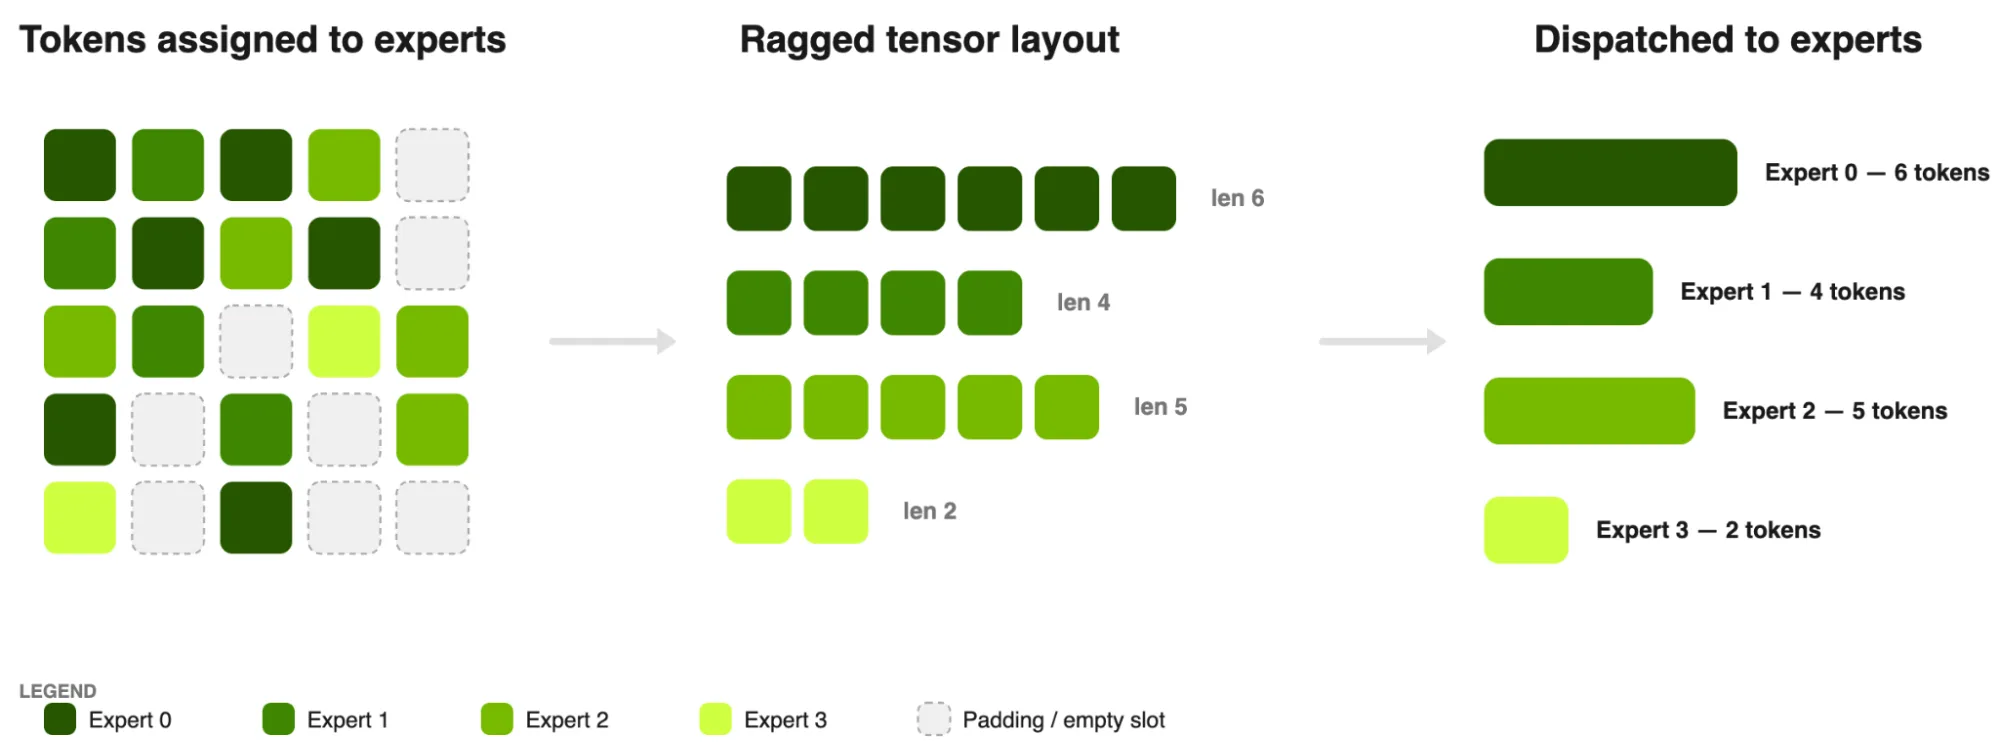
위 그림은 5x5 토큰 격자가 전문가 4개로 라우팅되는 과정을 보여줍니다. 왼쪽 격자에는 라우팅되지 않은 빈 슬롯(점선)이 섞여 있고, 가운데 래그드 레이아웃에서 전문가 0은 길이 6, 전문가 1은 4, 전문가 2는 5, 전문가 3은 2를 받습니다. 오른쪽 디스패치 결과의 막대 길이가 그 차이를 그대로 보여줍니다. 커널 입장에서는 같은 연산을 네 가지 다른 크기로 해야 하는 상황입니다.
EP를 쓰면 여기에 통신이 더해집니다. 토큰을 자기 전문가가 사는 GPU로 보내야 하고(디스패치), 계산이 끝나면 결과를 원래 GPU로 돌려보내 원래 토큰 순서로 복원해야 합니다(컴바인). 이 경로가 최적화되어 있지 않으면 통신이 전체 시간을 지배하고, GPU는 데이터가 도착할 때까지 아무 일도 하지 않습니다. 앞서 본 84%라는 숫자가 정확히 그 상태입니다. 해결책은 래그드 레이아웃을 그대로 다룰 수 있는 전용 커널이며, TE의 MoE 최적화가 해결하려는 문제가 이것입니다.
용량 기반 MoE와 드롭리스 MoE: 토큰 드롭과 연산 낭비의 교환
토큰 라우팅의 불균형을 다루는 방법은 크게 두 가지입니다.
용량 기반(Capacity-Based) MoE 는 동적 라우팅의 복잡도를 제약으로 우회합니다. 전문가마다 고정된 토큰 예산(용량)을 할당하고, 그 예산을 넘긴 토큰은 버리거나(Drop) 남는 자리를 패딩으로 채웁니다. 연산이 규칙적이라 하드웨어에 친화적이지만, 모델 품질과 효율 사이에서 직접적인 교환이 발생합니다. 넘친 토큰을 버리면 모델이 불완전한 데이터로 학습하고, 버리지 않으려고 패딩하면 연산과 메모리를 낭비합니다.
드롭리스 MoE 는 부하가 아무리 치우쳐도 모든 토큰을 자기 전문가가 처리하도록 합니다. 모델 품질에는 유리하지만 시스템에는 부담입니다. 2022년 논문 MegaBlocks: Efficient Sparse Training with Mixture-of-Experts가 전문가 연산을 블록 희소 행렬곱(Block-Sparse Matrix Multiplication)으로 재정식화해 이 방향을 열었습니다. 전문가마다 다른 토큰 수를 버리거나 패딩하지 않고 처리하는 대신, 블록 희소 GPU 커널과 최적화된 grouped GEMM, 가변 토큰 수를 전제로 설계된 디스패치 및 컴바인 원시 연산(Primitive)이 새로 필요해집니다.
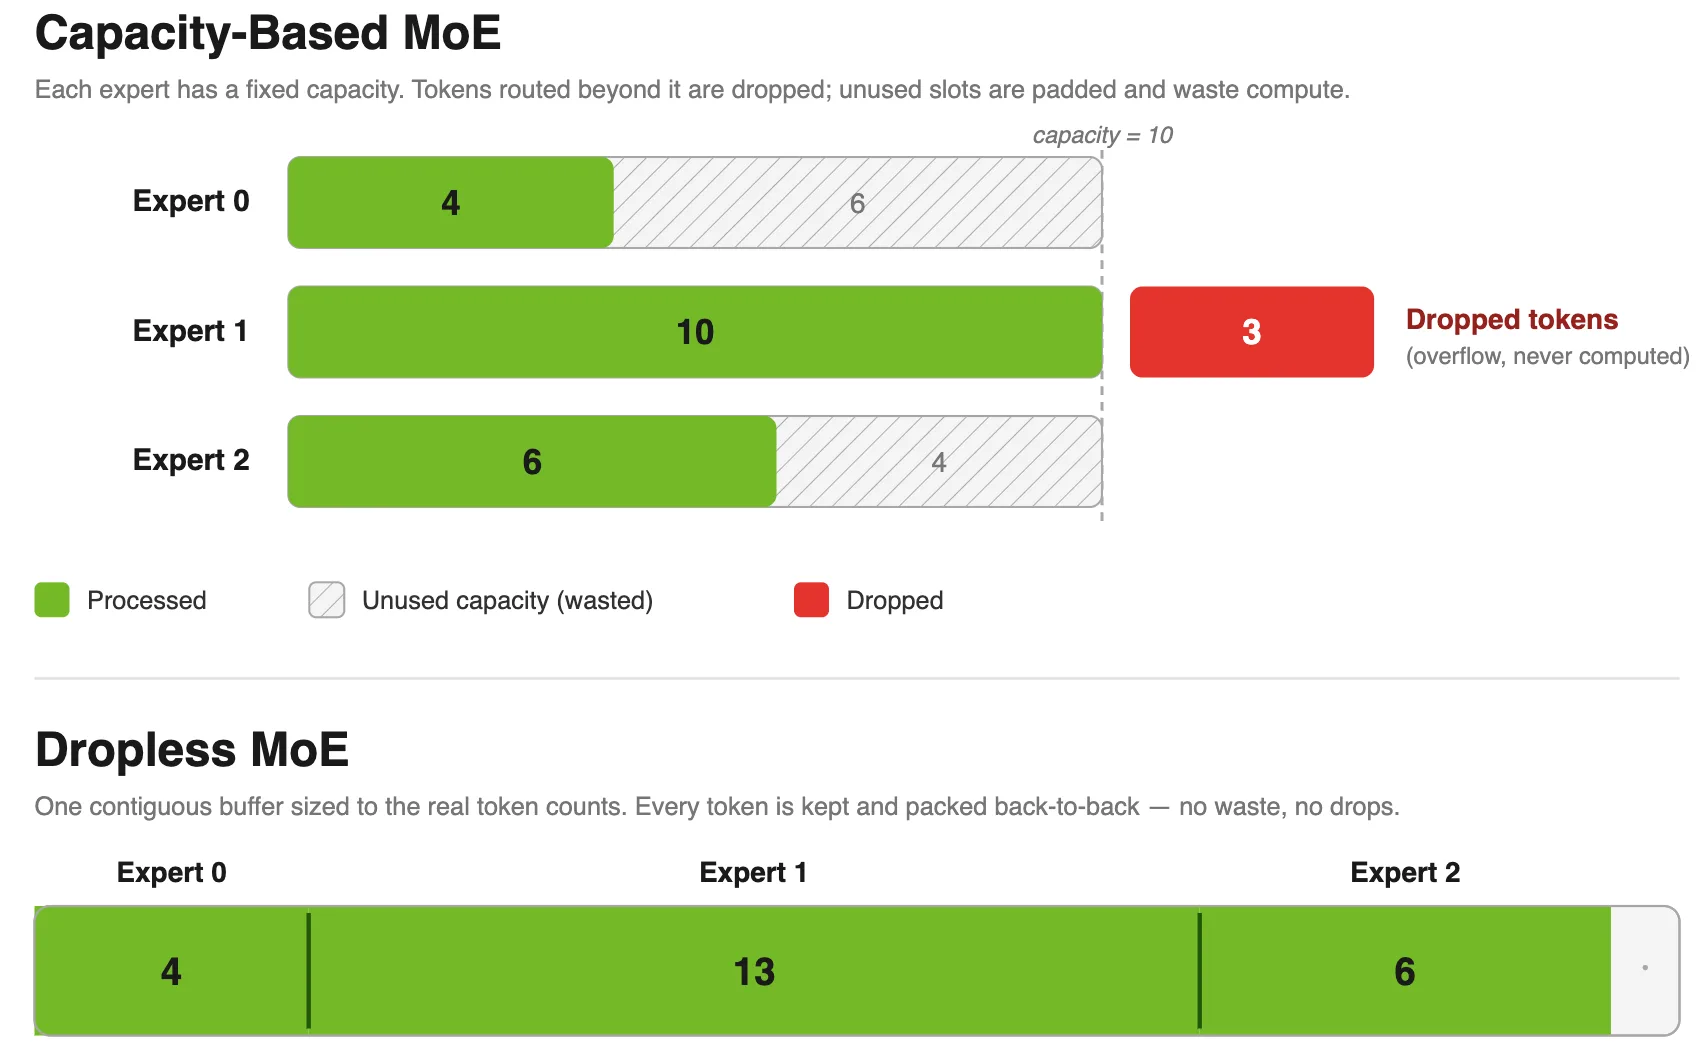
위 그림의 숫자를 따라가 보면 차이가 분명해집니다. 용량을 10으로 잡았을 때 전문가 0은 토큰 4개만 받아 6칸이 낭비되고, 전문가 2는 6개를 받아 4칸이 낭비됩니다. 반면 전문가 1에는 13개가 몰려 10개만 처리되고 나머지 3개는 계산되지 않은 채 버려집니다. 드롭리스 방식에서는 4개, 13개, 6개가 연속된 버퍼 하나에 빈틈 없이 담겨 낭비도 드롭도 없습니다.
PyTorch 쪽에서 같은 문제를 어떻게 다뤄 왔는지는 커뮤니티에 정리된 PyTorch로 전문가 혼합(MoE) 모델 학습 확장하기가 참고가 됩니다. Databricks가 PyTorch 팀과 함께 바로 이 MegaBlocks 구현으로 학습을 3,000장 이상의 GPU까지 확장한 기록이라, 이번 글과 같은 논문에서 출발한 다른 구현입니다. 이번 글의 주제는 그 접근을 JAX와 XLA(Accelerated Linear Algebra) 스택에서 성립시키는 커널들입니다.
드롭리스 MoE 더 알아보기
MegaBlocks: Efficient Sparse Training with Mixture-of-Experts - 블록 희소 행렬곱으로 드롭리스 MoE를 처음 실용화한 논문
Mixture of Experts - NVIDIA 용어집의 MoE 개요
MaxText MoE Configuration - MaxText가 지원하는 드롭리스 및 드롭 전략의 결정 트리와 전체 설정 항목
Transformer Engine이 제공하는 세 가지 구성 요소
드롭리스로 가기로 결정한 순간, 학습 스택은 전문가의 고정된 모양에 의존할 수 없게 됩니다. 전문가 연산을 건드리는 모든 커널이 가변 토큰 수를 효율적으로 다뤄야 하고, 그 토큰 수는 데이터에 따라 달라집니다. 더 까다로운 조건이 하나 더 있습니다. 커널은 동적 모양을 받아들이는 것으로 끝이 아니라, 그 모양을 CPU에서 읽을 수 없는 상태에서도 동작해야 합니다. 그래야 CUDA 그래프를 쓸 수 있고 재컴파일을 피할 수 있습니다.
TE는 JAX에서 이를 가능하게 하는 구성 요소 세 가지를 제공합니다.
- 그룹 인식 MXFP8 양자화(Group-Aware MXFP8 Quantization): 전문가 그룹 경계를 인식하면서 활성값을 MXFP8로 양자화합니다.
- MXFP8 grouped GEMM: 전문가별 행렬곱을 낮은 정밀도로 한 번에 처리합니다.
- 최적화된 EP 연산: 디스패치와 컴바인을 융합된 커널 경로로 실행합니다.
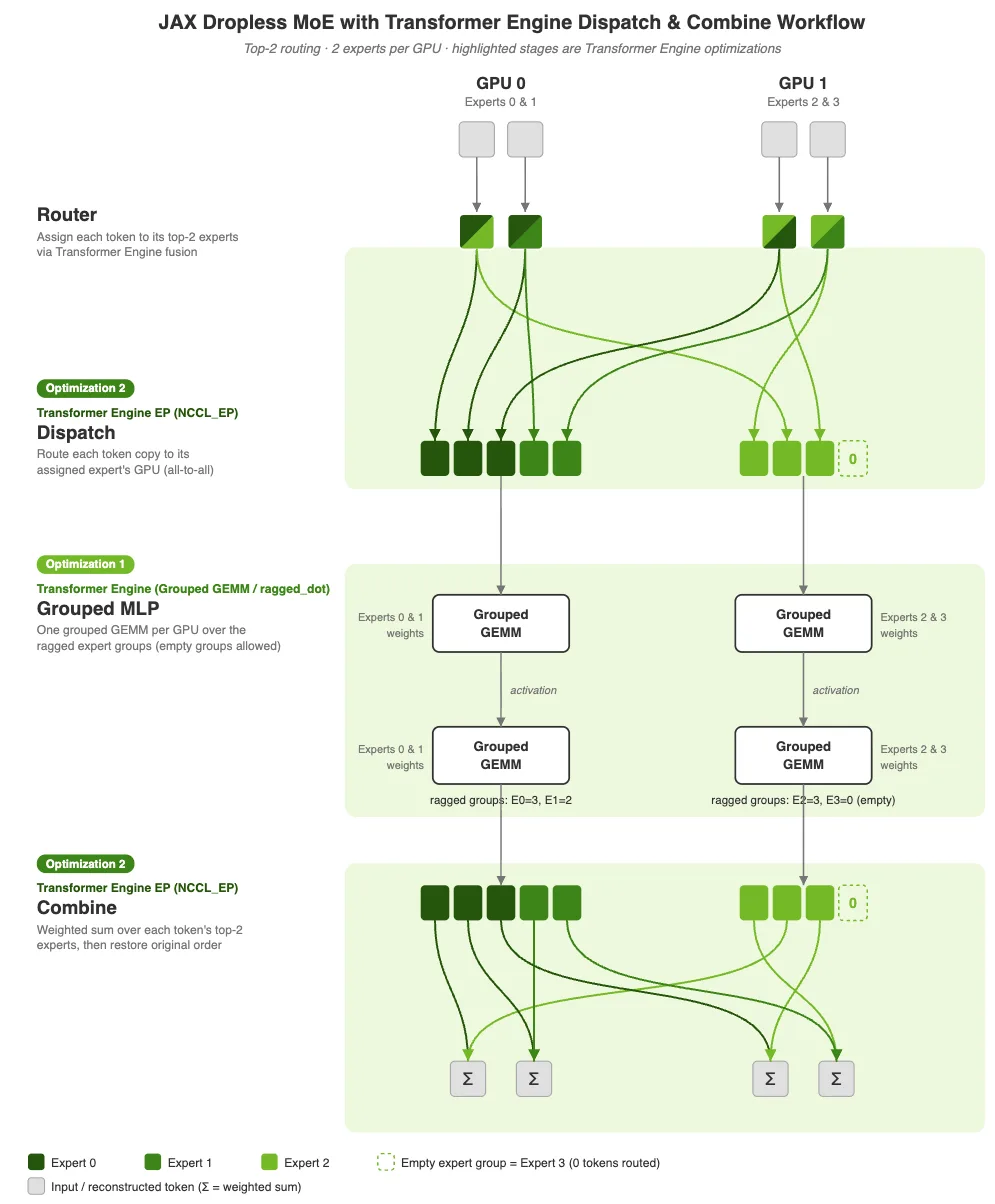
위 그림은 GPU 2개에 전문가 4개를 배치한 상위 2개(Top-2) 라우팅 사례입니다. 라우터가 각 토큰에 전문가 2개를 배정하고, 디스패치가 토큰 사본을 해당 전문가의 GPU로 옮깁니다. grouped MLP는 그 가변 길이 그룹들에 grouped GEMM 2개를 실행하고, 컴바인이 교환을 역방향으로 수행해 원래 토큰 순서를 복원합니다. 눈여겨볼 부분은 오른쪽 GPU 1의 ragged groups: E2=3, E3=0 (empty) 라벨입니다. 토큰이 하나도 배정되지 않은 빈 전문가 그룹이 그대로 커널에 들어갑니다. 고정 모양을 가정하는 커널이라면 이 경우에도 최악 용량만큼 연산하게 됩니다.
실제 구현을 확인해 보면 이 흐름이 TE JAX 소스의 transformer_engine/jax/moe.py 모듈 설명과 그대로 일치합니다. 게이트, 상위 K개 선택, ep_dispatch, 전문가별 FFN(grouped GEMM), ep_combine, 출력이 하나의 jax.custom_vjp 아래 묶여 있어, 라우팅과 디스패치와 FFN과 컴바인이 XLA 위에서 중간 잔여값(Residual)을 사용자 autograd 그래프로 흘리지 않고 융합됩니다.
최적화 1: grouped GEMM, 전문가마다 다른 토큰 수를 커널 하나로
전문가별 행렬곱을 처리하는 이전 방식은 두 가지였고, 각각 다른 대가를 치렀습니다.
첫째는 GEMM 커널을 루프로 도는 것입니다. 전문가별 토큰 수를 알아야 커널을 실행할 수 있으니 장치에서 호스트로(Device-to-Host) 토큰 수를 복사해야 하는데, 이 복사가 크리티컬 패스에 놓입니다. 전송 지연이 그대로 노출되고 CUDA 그래프도 깨집니다.
둘째는 배치 GEMM(Batched GEMM) 입니다. 고정된 전문가 연산을 강제하기 위해 패딩하므로, 실제로 쓰이는 토큰이 적어도 최악의 토큰 용량만큼 계산합니다. 남는 연산을 그대로 버리는 셈입니다.
grouped GEMM은 전문가별 행렬곱 전체를 커널 호출 한 번으로 처리하면서, 각 전문가에 실제 토큰 수를 그대로 씁니다. 유효한 토큰이 있는 영역만 계산하므로 두 방식의 낭비가 모두 사라집니다. TE의 grouped_gemm과 ragged_dot은 cuBLAS와 cuBLASLt를 백엔드로 삼아 NVIDIA의 GEMM 라이브러리에 직접 대응되며, 전문가 모양이 불규칙해도 텐서 코어(Tensor Core) 활용률을 최대한 높입니다. NVIDIA Blackwell GPU에서는 TE의 grouped 양자화 커널과 함께 전문가 행렬곱에 MXFP8 블록 스케일링(Block Scaling) 경로까지 열립니다.
소스에서 확인되는 세부 사항 하나가 성능 감각을 잡는 데 도움이 됩니다. TE는 전문가별 수신 블록을 128토큰 단위로 정렬합니다. NCCL EP의 고처리량 모드가 최소 128토큰 정렬을 요구하고, 현재 TE의 grouped GEMM 레시피(bf16, fp16, fp8, mxfp8)가 모두 같은 128토큰 타일로 충족되기 때문에 상수 하나로 모든 경로를 덮습니다. 또한 MaxText의 prefuse_moe_weights 옵션을 켜면 FFN1의 두 grouped GEMM(wi_0, wi_1)이 하나로 융합되어, 전문가 가중치가 (num_experts, embed_dim, 2 * mlp_dim) 모양으로 연결 저장되고 입력 활성값을 HBM에서 순전파당 두 번이 아니라 한 번만 읽습니다.
grouped GEMM 더 알아보기
DeepGEMM: NVIDIA Hopper GPU에서 효율적인 FP8 연산을 위한 GEMM 커널 라이브러리 - DeepSeek이 공개한 grouped GEMM 구현
Tokamax: JAX와 Pallas 기반의 커스텀 가속 커널 라이브러리 - MaxText가 TE 외에 쓰는 또 하나의 드롭리스 ragged dot 백엔드
jax.lax.ragged_dot - JAX 표준 라이브러리의 래그드 행렬곱 API
최적화 2: NCCL EP, 디스패치와 컴바인을 융합된 커널 경로로
융합된 라우터 커널이 토큰별 전문가를 배정한 다음, 모델은 그 토큰을 물리적으로 올바른 장치로 옮기고, 처리하고, 결과를 되돌려야 합니다. 이 과정은 두 단계로 나뉩니다.
- 디스패치(Dispatch): 토큰이 실제로 이동하는 단계입니다. 토큰을 재배열(Permute)하고 배정된 전문가가 있는 GPU로 보냅니다. 로컬 재정렬과 다중 GPU 통신이 동시에 걸립니다.
- 컴바인(Combine): 처리된 토큰이 원래 GPU로 되돌아가고, 전문가별 결과가 토큰마다 누적됩니다.
단순하게 구현하면 이 단계들이 분리된 연산의 직렬 사슬로 실행됩니다. 단계 사이에 GPU가 멈추고, 데이터가 메모리를 여러 번 오가고, 연산이 실행되는 동안에는 통신이 멈추고 통신이 실행되는 동안에는 연산이 멈춥니다.
TE의 EP 구현은 디스패치와 컴바인을 촘촘히 융합된 커널 경로 하나로 묶습니다. 이 통합을 뒷받침하는 것이 NCCL EP로, 전문가 병렬 라우팅이 만드는 불규칙하고 불균형한 트래픽 패턴에 맞춰 튜닝된 통신 백엔드입니다. 저장소를 확인해 보면 NCCL EP는 NCCL(NVIDIA Collective Communications Library) 장치 API의 LSA(Load-Store Accessible)와 GIN(GPU-Initiated Networking) 연산 위에 구현되어 있고, 두 가지 알고리즘을 ncclEpDispatch와 ncclEpCombine이라는 통합 API로 노출합니다.
- 저지연(Low-Latency, LL) 모드: 작은 배치와 지연에 민감한 워크로드, 즉 LLM 추론(Inference)을 대상으로 합니다. 지연을 최소화하기 위해 전문가와 직접 점대점(Point-to-Point) all-to-all 통신을 씁니다.
- 고처리량(High-Throughput, HT) 모드: 큰 배치를 쓰는 학습과 추론 프리필을 대상으로 합니다. 노드 안에서는 NVIDIA NVLink로 모으고 노드 사이는 RDMA로 보내는 계층적 통신 패턴을 구현하며, 워프 특화 파이프라인과 TMA(Tensor Memory Accelerator) 연산 같은 Hopper 아키텍처 기능을 활용합니다.
이번 글의 학습 워크로드가 쓰는 쪽은 HT 모드입니다. NCCL EP는 GIN의 put 및 signal 연산으로 RDMA를, LSA의 로드 및 스토어 연산으로 NVLink 통신을 처리해 CPU를 크리티컬 패스에서 완전히 빼내면서도 NCCL의 토폴로지 탐지와 플러그인 구조를 그대로 물려받습니다.
여기에 토큰 중복 제거(Token Deduplication) 가 더해집니다. 상위 K개 라우팅에서는 한 토큰이 여러 전문가로 가는데, 그 전문가들이 같은 랭크에 있거나 원격 InfiniBand 노드의 여러 랭크에 있으면 같은 토큰이 네트워크를 여러 번 건너게 됩니다. NCCL EP는 이런 경우 토큰이 네트워크를 한 번만 건너고 수신 노드에서 복제되도록 해 대역폭을 절약합니다. 앞서 본 그림에서 상위 2개 라우팅이 GPU 사이로 토큰 사본을 보내는 부분에서 이 중복이 발생합니다.
원문이 요약한 두 최적화의 역할 분담이 명확합니다. grouped GEMM은 각 전문가 내부에서 일어나는 일을, EP는 그 주변의 모든 것을 담당합니다.
같은 문제를 DeepSeek이 PyTorch 생태계에서 어떻게 풀었는지는 DeepEP: 효율적인 Mixture-of-Experts 병렬 통신 라이브러리와 비교해 보면 흥미롭습니다. 두 라이브러리의 API 설계는 오히려 반대 방향입니다. NCCL EP는 위와 같이 LL과 HT 두 알고리즘을 남겨 두고 골라 쓰게 하는데, DeepEP V2는 고처리량 API와 저지연 API를 ElasticBuffer 인터페이스 하나로 통합했습니다. 대신 하부에서는 수렴했습니다. DeepEP V2가 백엔드를 NVSHMEM에서 NCCL Gin으로 바꿨으므로, 두 라이브러리가 모두 NCCL의 GIN 장치 API 위에 올라가 있습니다.
NCCL EP 더 알아보기
NCCL Extensions - NCCL EP와 메시 리샤딩(nccl_m2n)을 함께 담은 저장소
nccl-extensions (PyPI) - pip install "nccl-extensions[cu12]" 또는 [cu13]로 설치, CUDA 메이저 버전별 extra가 정확히 NCCL 2.30.7을 함께 설치
torchcomms: 현대적인 PyTorch 통신 API - PyTorch 쪽에서 같은 계층을 다시 설계하는 작업
호스트 오프로딩과 XLA 멀티스트림 집합 통신
커널 두 개만으로 10배가 나오지는 않았습니다. 원문은 메모리와 스케줄링 층에서도 병목 두 가지를 더 제거했다고 밝히고 있습니다.
JAX 호스트 오프로딩
중간 활성값(Activation)을 순전파 내내 장치 메모리에 들고 있을 필요는 없습니다. JAX의 재계산(Rematerialization) API는 선택한 활성값을 호스트 메모리로 내보내는 경로를 제공합니다. 역전파에서 그 값을 다시 계산하는 대신 호스트 메모리에서 되읽어 오는 방식입니다.
여기서 원문의 서술과 원문이 제시한 재현 설정이 어긋납니다. 원문 산문은 DeepSeek-V3 학습에서 쿼리(Query)와 값(Value) 프로젝션 결과를 호스트로 내보낸다고 적었지만, 아래 재현 설정의 custom_remat_config에는 query_proj: remat, key_proj: remat, value_proj: remat으로 적혀 있고 offload는 주석으로만 남아 있습니다. 실제로 offload가 걸린 항목은 MoE FFN1의 두 중간 활성값인 moe_mlpwi_0과 moe_mlpwi_1입니다. MaxText의 base.yml을 보면 이 세 값은 각각 호스트로 내보내기, 재계산, 장치에 보관을 뜻하므로(['remat','device','offload']) 둘은 서로 다른 동작입니다. 재현 설정을 그대로 쓴다면 산문이 아니라 설정 쪽이 기준입니다.
이 기법이 NVIDIA Grace Blackwell 시스템에서 특히 유리한 이유가 관련 블로그에 정리되어 있습니다. Grace CPU와 Blackwell GPU가 NVLink-C2C로 양방향 900 GB/s로 연결되어 고정(Pinned) 호스트 메모리를 활성값 임시 저장소로 쓸 만하고, 후속 Vera CPU와 Rubin GPU는 이를 1.8 TB/s로 두 배 늘립니다. 다만 대역폭만으로는 부족하고 활성값 전송이 유용한 GPU 연산과 겹쳐야 합니다. 그 블로그는 GB200 NVL72 128 GPU에서 DeepSeek-V3 671B에 오프로딩과 LHS와 파이프라인 전송을 모두 켰을 때 장치당 908.2 TFLOPs/s에 도달했고, 같은 배치 구성에서 재계산보다 57% 빨랐다고 보고합니다.
처리량보다 눈에 띄는 것은 용량 쪽입니다. 같은 블로그의 표를 보면 마이크로 배치 8에 글로벌 배치 1,024 구성은 오프로딩도 재계산도 없이는 OOM(Out-of-Memory)으로 아예 돌지 않고, 활성값을 장치에 보관하는 설정으로는 마이크로 배치 2에 글로벌 배치 256까지만 들어갑니다. 오프로딩이 처리량을 올리는 선택이기 전에 그 배치 구성을 가능하게 만드는 선택입니다.
반대로 오프로딩이 항상 이득인 것도 아닙니다. 같은 블로그는 텐서가 작을 때, 전송을 겹칠 독립적인 작업이 부족할 때, 병목이 메모리가 아닌 다른 곳에 있을 때는 도움이 되기 어렵다고 적고 있습니다. 실제로 밀집 모델인 Llama 3.1 405B에서는 LHS만 켠 구성이 장치당 2,746 TFLOPs/s로, LHS와 파이프라인 전송을 함께 켠 2,718 TFLOPs/s보다 오히려 빨랐습니다. LHS가 이미 전송 지연을 거의 다 숨겨서 파이프라인이 숨길 지연이 남지 않은 경우입니다.
XLA 멀티스트림 집합 통신
EP는 TE의 NCCL EP가 담당하지만, 최적화된 FSDP는 XLA가 직접 처리합니다. XLA는 기본적으로 통신을 단일 스트림에서 실행하므로, 병렬로 실행될 수 있는 집합 통신(Collective) 연산이 직렬화되고 그중 일부가 크리티컬 패스에 노출됩니다. 멀티스트림 집합 통신은 컴파일러가 독립적인 집합 통신을 별개의 CUDA 스트림에 동시에 스케줄링하도록 해, 노드 간 InfiniBand 전송과 노드 내 NVLink 통신을 겹쳐 두 패브릭을 동시에 씁니다. 직렬화된 하나의 스트림을 기다리는 대신 양쪽을 함께 쓰는 셈입니다.
어떤 집합 통신을 겹쳐도 안전한지는 지연 은닉 스케줄러(Latency Hiding Scheduler, LHS) 가 복제 그룹(Replica Group)을 분석하고 교착(Deadlock) 위험을 확인해 판단합니다. 수동 주석(Annotation)이 필요 없다는 점이 실용적인 부분이고, 원문은 이 최적화로 DeepSeek-V3 학습에서 노출된 집합 통신의 비율이 크게 줄었다고 밝히고 있습니다.
성능: GPU당 105에서 1,025 TFLOPs까지
원문이 보고하는 종단 간(End-to-End) 결과는 DeepSeek-V3 671B에서 처리량 약 10배 향상입니다. 다만 수치를 인용할 때 주의할 점이 있습니다. 도입부의 103에서 1,068 TFLOPS, 10.4배는 GB200 기준이고, 아래 성능 차트는 GB300 NVL72 랙 하드웨어 기준으로 별도 측정된 값입니다.
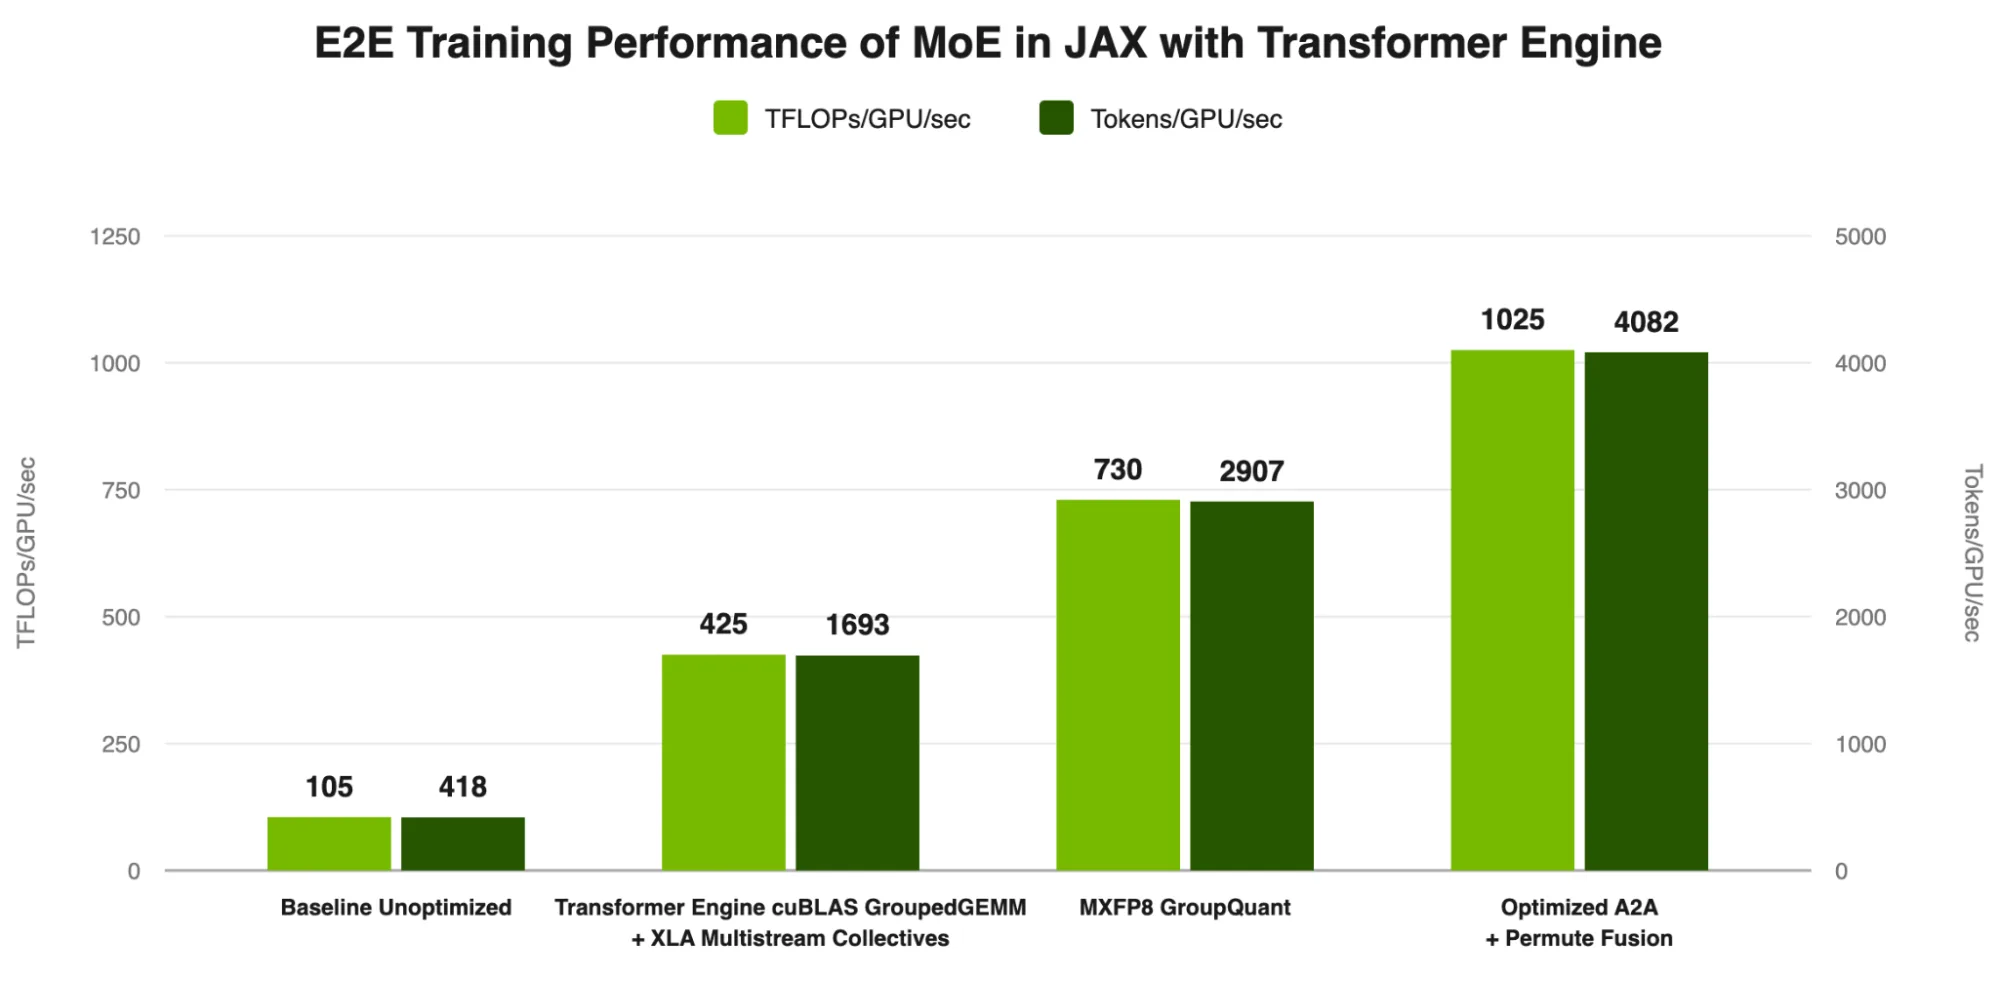
위 차트의 값을 표로 옮기면 각 최적화가 얼마씩 기여했는지 보입니다.
| 최적화 단계 | TFLOPs/GPU/sec | Tokens/GPU/sec |
|---|---|---|
| Baseline Unoptimized | 105 | 418 |
| + TE cuBLAS GroupedGEMM, XLA Multistream Collectives | 425 | 1,693 |
| + MXFP8 GroupQuant | 730 | 2,907 |
| + Optimized A2A, Permute Fusion | 1,025 | 4,082 |
가장 큰 개선은 첫 단계에서 나왔습니다. grouped GEMM과 멀티스트림 집합 통신만으로 105에서 425로 4배가 됩니다. 차트가 이 두 최적화를 한 단계로 묶어 놓았으므로 각각의 기여도는 분리되지 않습니다. 여기에 MXFP8 grouped 양자화가 1.7배를, 최적화된 all-to-all과 재배열 융합이 다시 1.4배를 더해 1,025에 도달합니다. 원문은 이 스택을 서술할 때 호스트 활성값 오프로딩도 함께 언급하지만, 차트의 네 단계 라벨에는 별도 단계로 잡혀 있지 않습니다.
1,024 GPU까지 97% 스케일링 효율
생산 규모 학습은 수조 개 토큰과 거대한 배치를 다룹니다. 단일 노드에서는 무시할 만한 비효율이 수천 개 GPU에서는 빠르게 누적되고, 멀티랙 구간에서는 통신 오버헤드가 연산보다 빠르게 증가하는 것이 일반적입니다. 대부분의 시스템이 여기서 어려움을 겪습니다.
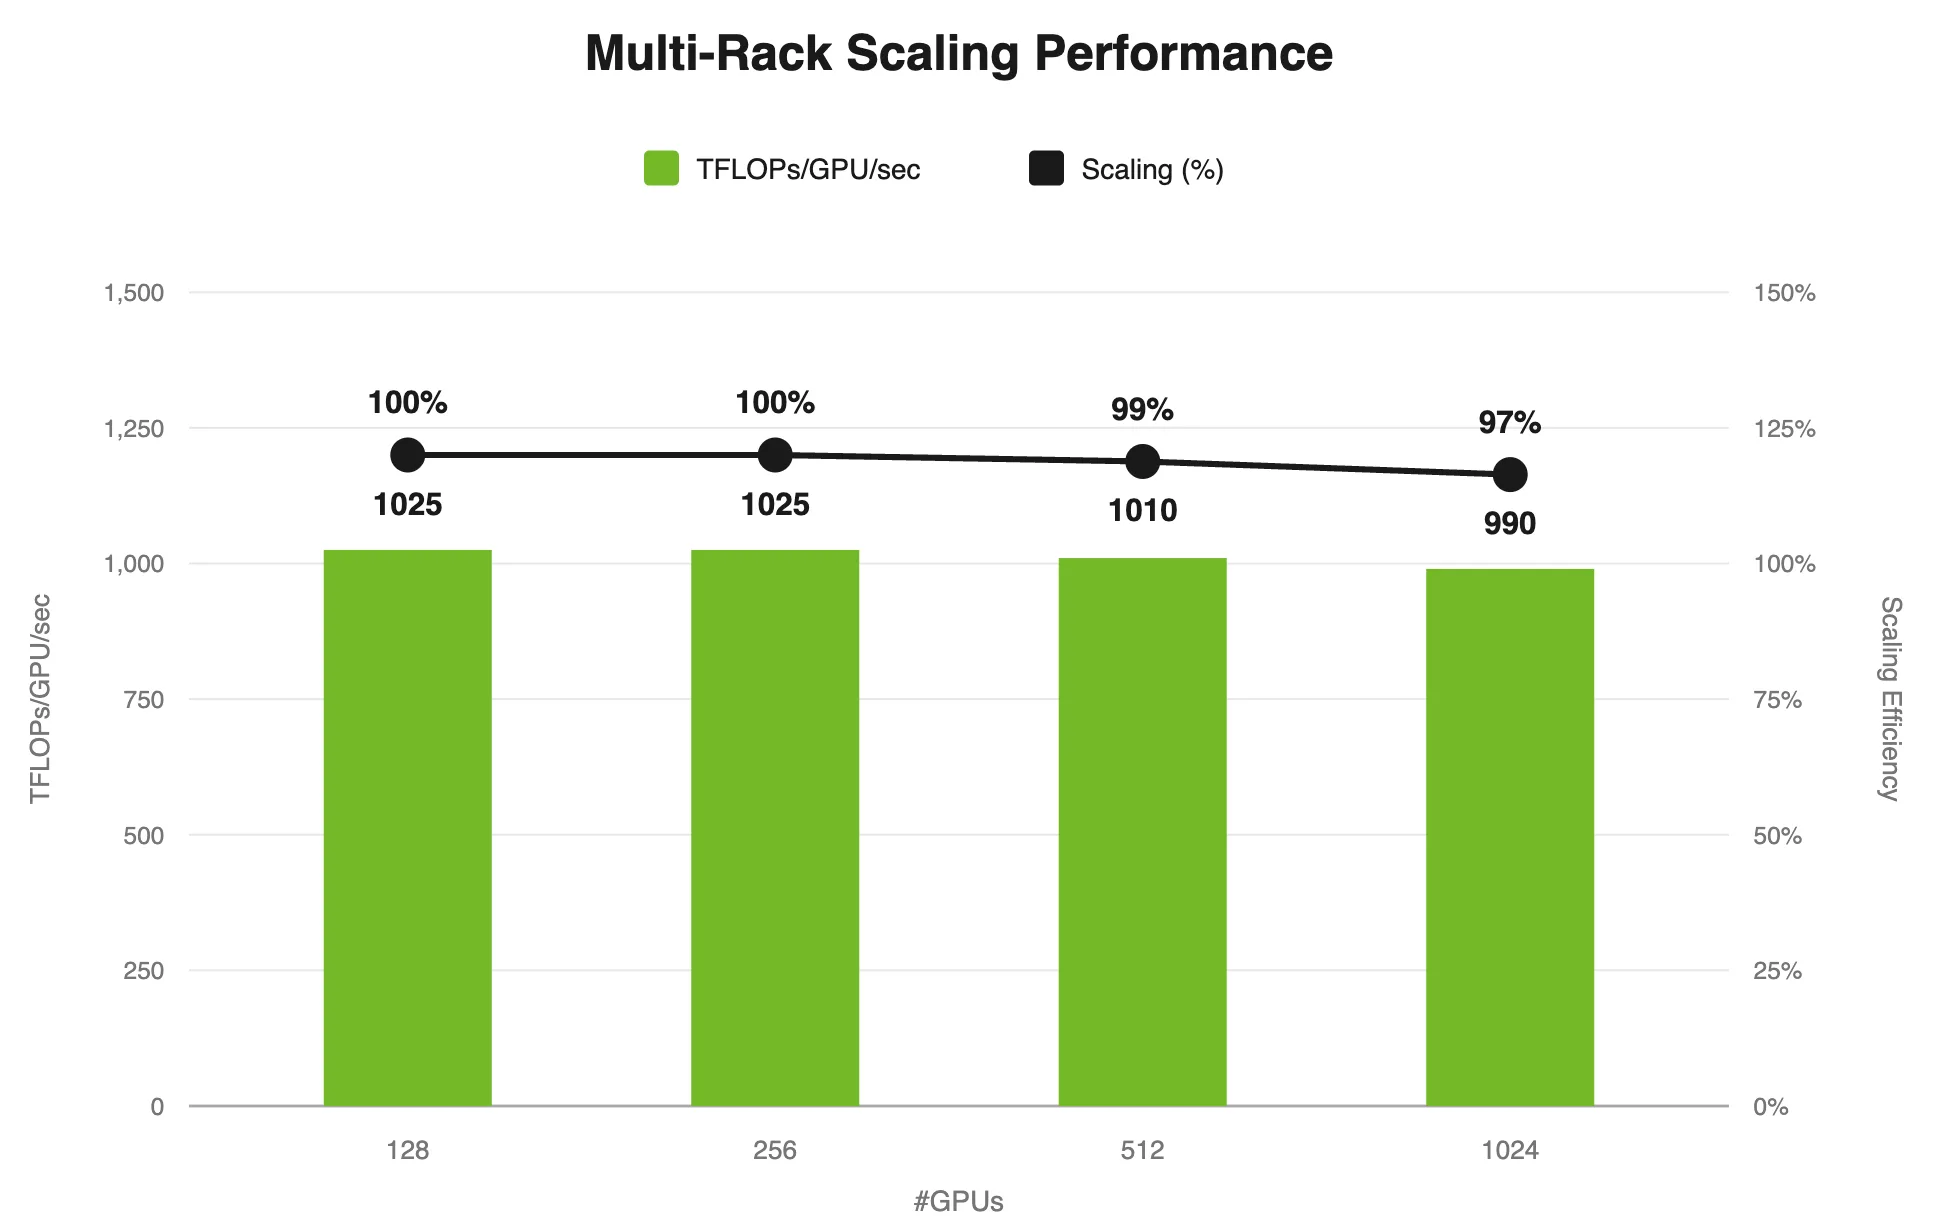
| GPU 수 | TFLOPs/GPU/sec | 128 GPU 기준 스케일링 효율 |
|---|---|---|
| 128 | 1,025 | 100% |
| 256 | 1,025 | 100% |
| 512 | 1,010 | 99% |
| 1,024 | 990 | 97% |
GPU를 8배로 늘리는 동안 GPU당 처리량이 1,025에서 990으로, 3% 남짓만 떨어집니다. 원문이 강조하는 97% 효율이 이 마지막 행이고, 앞서 본 통신 최적화 덕분에 클러스터가 커져도 처리량이 유지된다는 근거입니다.
인용할 때 한 가지 확인할 점이 있습니다. 원문의 그림 설명과 대체 텍스트(alt)는 "128부터 2,048까지 다섯 개 GPU 수" 라고 적고 있지만, 실제 차트에는 128, 256, 512, 1,024의 네 개 막대만 있고 2,048 측정값은 없습니다. 본문 서술도 1,024 GPU에서의 97%까지만 주장하므로, 위 표는 차트에 실제로 그려진 값만 옮겼습니다.
직접 재현하기: MaxText 컨테이너와 설정
이 최적화들은 TE가 내장된 NVIDIA NGC(NVIDIA GPU Cloud) MaxText 컨테이너로 배포됩니다. 2026년 9월 9일자 이미지인 ghcr.io/nvidia/jax:maxtext-2026-09-09 또는 그 이후 버전을 쓰면 되고, 이미지 목록은 NVIDIA/JAX-Toolbox 저장소에 정리되어 있습니다.
원문의 권고 순서는 이렇습니다. 참조 설정으로 시작해서 작은 MoE 모델로 정확성을 검증한 다음, 스텝 시간, GPU당 TFLOPS, MFU(Model FLOPs Utilization), grouped GEMM 지연, MoE 디스패치 및 컴바인 지연을 추적하면서 규모를 올립니다.
MaxText에서 TE MoEBlock을 켜는 최소 설정은 다음과 같습니다. YAML 설정 파일에 넣거나 학습 스크립트의 커맨드라인 인자로 넘기면 됩니다.
te_moe_block: true
te_gmm_quantization: "te_mxfp8"
ragged_buffer_factor: 2.0
te_ep_overflow_check_every_n_steps: 20
sparse_matmul: true
prefuse_moe_weights: true
MaxText 문서를 확인해 보면 te_moe_block은 TE의 융합된 전문가 병렬 MoEBlock으로 라우팅, 디스패치, grouped GEMM, 전문가 출력 컴바인을 처리하며, sparse_matmul=True와 prefuse_moe_weights=True, 그리고 전문가 병렬 MoE를 지원하는 TE JAX 2.19 이상을 요구합니다. TE v2.19는 2026년 9월 11일에 릴리즈되었으니, 이 글이 나온 시점 기준으로 사흘 전에 나온 버전입니다. te_gmm_quantization은 te_no_quant(모델 기본 정밀도, 예를 들어 BF16)와 te_mxfp8 두 값을 받습니다.
DeepSeek-V3 671B 결과를 그대로 재현하려면 위 설정에 다음을 더합니다. 원문이 명시하듯 이 설정은 DeepSeek-V3에 특화된 것이고, 다른 모델은 다른 튜닝이 필요하며 TE MoEBlock 자체를 쓰기 위한 필수 조건도 아닙니다.
# Model parameters
model_name: "deepseek3-671b"
max_target_length: 4096
hardware: "gpu_multiprocess"

# Training settings
per_device_batch_size: 6
gradient_accumulation_steps: 1
steps: 15
attention: "cudnn_flash_te"
remat_policy: "custom"

# Transformer Engine MoEBlock with MXFP8 grouped GEMMs
quantization: "te_fp8_currentscaling"
te_moe_block: true
te_gmm_quantization: "te_mxfp8"
ragged_buffer_factor: 2.0
te_ep_overflow_check_every_n_steps: 20
prefuse_moe_weights: true

weight_dtype: "bfloat16"
mu_dtype: "bfloat16"

# Features
pgle: true
profiler: "xplane"
scan_layers: true
zero_one: false
shardy: true
use_segment: false

skip_first_n_steps_for_profiler: 4

custom_remat_enabled: true
logits_dot_in_fp32: false
use_iota_embed: false

custom_remat_config:
  mlpwi: device
  mlpwi_0: device
  mlpwi_1: device
  mlpwo: device
  moe_mlpwi_0: offload #remat
  moe_mlpwi_1: offload #remat
  moe_mlpwo: device
  query_proj: remat #offload
  key_proj: remat
  value_proj: remat #offload
  query_wa_proj: device
  kv_wa_proj: device
  out_proj: device
  context: device

# MoE routing parameters
n_routing_groups: -1
topk_routing_group: -1
capacity_factor: 1.0
megablox: false

# 128 GPUs: total FSDP=16 (ICI 8 × DCN 2) × EP=8.
nodes: 32
ici_data_parallelism: 1
ici_fsdp_parallelism: 8
ici_tensor_parallelism: 1
ici_expert_parallelism: 8
dcn_data_parallelism: 1
dcn_fsdp_parallelism: 2
dcn_tensor_parallelism: 1
dcn_expert_parallelism: 1
shard_optimizer_over_data: false

shard_exp_on_fsdp: false
XLA 플래그와 환경 변수도 함께 조정합니다. 플래그 튜닝 지침은 OpenXLA의 XLA GPU 플래그 가이드와 JAX Toolbox GPU 성능 가이드에 있습니다.
xla_gpu_all_reduce_combine_threshold_bytes: 33554432
xla_gpu_all_gather_combine_threshold_bytes: 6442450944
xla_gpu_reduce_scatter_combine_threshold_bytes: 201326592
xla_gpu_experimental_enable_nccl_symmetric_buffers: false
xla_gpu_enable_command_buffer: "'FUSION,CUBLAS,CUDNN,DYNAMIC_SLICE_FUSION'"
xla_gpu_experimental_max_unroll_factor: 8
xla_gpu_memory_limit_slop_factor: 99
XLA_PYTHON_CLIENT_MEM_FRACTION: 0.88
CUDA_DEVICE_MAX_CONNECTIONS: 16
XLA_PJRT_GPU_HOST_MEMORY_PREALLOCATE: false
XLA_PJRT_GPU_HOST_MEMORY_LIMIT_GB: 180
"드롭리스"의 실제 경계: 래그드 버퍼 계수와 오버플로 검사
위 설정에서 눈에 잘 띄지 않는 항목이 ragged_buffer_factor: 2.0입니다. 원문은 드롭리스 MoE를 부하가 아무리 불균등해도 모든 토큰이 자기 전문가에서 처리되는 방식으로 설명하는데, 이 설정값이 실제로 어디까지 보장하는지는 MaxText 문서와 TE 소스를 확인해야 드러납니다.
MaxText의 MoE 설정 문서는 ragged_buffer_factor를 래그드 버퍼 크기, 실질적으로는 전문가 용량의 배수로 정의하고 두 경우를 나눕니다. 값이 0보다 크면 명시적인 버퍼 크기를 쓰고 그 크기를 넘기면 토큰을 버릴 수 있으며, 값이 -1이면 최악의 경우를 계산한 버퍼 크기를 써서 토큰을 버리지 않음이 보장됩니다.
TE JAX 소스의 get_moe_recv_capacity_per_rank 함수가 이 계산을 더 명확하게 알려 줍니다. 수신 용량 계수가 None이면 드롭리스 최악의 경우를 예약하고, 1 이상의 유한한 계수는 완벽하게 균형 잡힌 라우팅에 필요한 용량을 배수만큼 늘린 값이며 최악의 경우를 상한으로 잘립니다. 즉 ragged_buffer_factor: 2.0은 균형 라우팅 기준 용량의 2배를 잡는 설정이고, 실제 치우침이 그 2배를 넘는 순간이 오버플로입니다.
그 순간에 무슨 일이 일어나는지도 문서에 적혀 있습니다. te_ep_overflow_check_every_n_steps(기본값 20)는 버퍼링된 수신 용량 오버플로 결과를 호스트 쪽에서 몇 스텝마다 확인할지 정합니다. 오버플로가 난 스텝은 즉시 장치에서 옵티마이저 업데이트를 건너뛰고, 다음 확인 시점에 학습이 관측된 수요와 설정된 용량을 함께 보고하면서 에러를 발생시킵니다. 넘친 토큰 자체는 버려지지만 그 스텝의 가중치 갱신을 무효로 만들어, 모델이 일부만 들어온 배치로 학습하지 않게 막는 방식입니다.
한 층 아래 NCCL EP에는 이 상황의 정책이 두 가지 있습니다. 기본값인 NCCL_EP_OVERFLOW_TRAP은 장치에서 __trap()을 실행해 실제 수신량과 설정값을 출력한 뒤 프로세스를 중단시키고, NCCL_EP_OVERFLOW_DROP은 넘친 토큰을 버리고 파이프라인을 정상 진행합니다. 후자에서는 recv_total_counter가 잘리기 전의 실제 총량을 보고하므로, 두 값을 비교해 드롭이 났는지와 몇 개가 사라졌는지를 호출자가 알 수 있습니다. MaxText가 스텝을 무효로 만들고 다음 확인 시점에 수요와 용량을 보고하는 동작이 이 후자의 경로입니다.
앞서 본 128토큰 정렬이 여기서 다시 등장합니다. 같은 문서는 수신량을 서로 다른 두 버퍼에서 각각 같은 예산과 비교한다고 설명합니다. 라이브러리의 스테이징 버퍼는 중복 제거된 토큰을 세지만, TE가 쓰는 전문가 우선(Expert-Major) 레이아웃의 출력 버퍼는 (토큰, 로컬 전문가) 쌍마다 슬롯 하나를 쓰고 전문가별 구역을 정렬 단위까지 패딩합니다. 한 토큰이 그 랭크의 로컬 전문가 k 개로 가면 스테이징에서는 한 줄이지만 출력에서는 k 개 슬롯이므로, 스테이징에는 다 들어갔는데 출력 버퍼에서 넘치는 경우가 생깁니다. 용량을 잡을 때 세어야 하는 단위는 토큰이 아니라 (토큰, 전문가) 쌍에 정렬 패딩을 더한 값입니다.
MaxText에는 retry_when_tokens_dropped라는 옵션도 있어서, 오버플로로 토큰이 버려질 상황이면 최악의 경우 버퍼 크기로 스텝 전체를 재시도합니다. 속도와 메모리를 위해 작게 튜닝한 버퍼를 쓰면서도 드롭이 없음을 보장하는 절충안인데, 원문이 제시한 재현 설정에는 이 옵션이 들어 있지 않습니다.
정리하면 이 설정은 드롭리스 알고리즘에 균형 기준 2배 버퍼와 오버플로 시 조기 실패를 더한 조합입니다. 용량 기반 MoE처럼 품질을 깎으며 조용히 토큰을 버리는 것과는 분명히 다르지만, 무조건적인 최악 대비 버퍼를 예약하는 것도 아닙니다. 라우팅 치우침이 큰 모델을 학습한다면 ragged_buffer_factor를 -1로 두거나 retry_when_tokens_dropped를 함께 켜는 쪽을 검토해 볼 만합니다.
TE JAX MoEBlock의 현재 상태: 아직 실험적 API
TE 저장소를 확인하면 한 가지 더 알아 둘 점이 있습니다. v2.19의 transformer_engine/jax/flax/moe.py에 정의된 Flax Linen 레이어는 밑줄로 시작하는 _MoEBlock 이고, 모듈 설명이 스스로 실험적(Experimental)이라고 밝히고 있습니다. 공개 MoEBlock 별칭은 TE의 NCCL 기반 EP 구성 요소와 레시피 기반 정렬 후속 작업이 안정화된 뒤에 도입할 계획이라고 적혀 있습니다. MaxText 설정에서 te_moe_block: true 한 줄로 켜지는 기능이지만, 그 아래 API는 아직 이름부터 고정되지 않았습니다.
또 하나, MaxText에서 드롭리스 경로가 TE로 새로 열린 것은 아닙니다. 설정 문서는 드롭리스 전략으로 네 가지를 열거합니다.
| 드롭리스 백엔드 | 켜는 설정 |
|---|---|
| Tokamax Ragged Dot (GMM v2) | sparse_matmul=True, use_tokamax_gmm=True, use_gmm_v2=True |
| Tokamax Ragged Dot (GMM v1) () |
sparse_matmul=True, use_tokamax_gmm=True |
| Megablox | sparse_matmul=True, use_tokamax_gmm=False, megablox=True |
| JAX Ragged Dot | sparse_matmul=True, use_tokamax_gmm=False, megablox=False |
TE MoEBlock 은 여기에 더해진 NVIDIA GPU 특화 백엔드이고, 원문의 재현 설정이 megablox: false로 기존 경로를 끄는 것도 그래서입니다. 원문 차트의 Baseline Unoptimized 가 이 중 어느 백엔드였는지는 밝혀져 있지 않으니, 105에서 1,025로 올라간 비교를 드롭리스와 드롭의 차이로 읽지는 말아야 합니다. 같은 드롭리스 안에서 커널과 통신 경로를 바꾼 결과입니다.
다음 단계: NVFP4, GEMM 융합 양자화, A2A 오버랩
원문은 앞으로 추가할 것으로 NVFP4, GEMM에 융합된 양자화, all-to-all 오버랩을 꼽습니다. TE JAX 소스의 모듈 설명도 같은 방향을 가리키는데, 모든 로직을 단일 jax.custom_vjp 아래 둔 이유로, 통신 경로에서 FP8을 쓰는 EP, 융합된 ragged_all_to_all과 grouped_gemm, 게이트와 라우팅과 디스패치 융합 같은 향후 융합을 래퍼(Wrapper)를 건드리지 않고 추가하기 위해서라고 적어 두었습니다.
TE JAX 바인딩에 들어올 융합 커널의 모습은 Boosting MoE Training Throughput with Advanced Fusion Kernels에서 미리 볼 수 있습니다. NVIDIA CuTe DSL로 작성한 융합 MLP 커널 3종(GroupGemm + Quantize, GroupGemm + Activation + Quantize/Transpose, GroupGemm + dActivation + Quantize/Transpose)이 그것입니다. 그 블로그의 마이크로 벤치마크는 순전파를 최대 1.3배, 역전파를 최대 2.1배 빠르게 했다고 보고하는데, 비교 기준선이 TE 자체의 최적화 커널(GB200 측정)이라는 점을 함께 봐야 합니다. 종단 간 수치는 내부 테스트 기준 DeepSeek-V3 사전 학습에서 최대 8%, GPT-OSS 사전 학습에서 최대 93%로, 도입부의 단정형 표현보다 뒤쪽 절의 최대(up to)가 정확한 표기입니다.
쓸 수 있는 경로는 cuDNN Frontend v1.23.0 이상, TE v2.15 이상, Megatron Core 26.04-alpha.rc2 이상입니다. 다만 TE가 이 연산을 노출하는 창구가 transformer_engine.pytorch.ops, 즉 PyTorch 네임스페이스입니다. 그래서 이 글의 JAX 경로에서는 아직 쓸 수 없고, 그 블로그의 향후 계획 절도 JAX를 비롯한 프레임워크 지원을 작업 중이라고만 적고 있습니다.
TE MoEBlock 최적화를 적용하면 좋을 환경
이 글의 결과를 그대로 쓸 수 있는 조건은 꽤 구체적입니다. NVIDIA GPU 위의 JAX와 MaxText로 EP를 걸어 MoE를 학습하고, TE 2.19 이상과 NGC 컨테이너를 쓸 수 있고, 최소 수십 노드 규모를 다루는 팀입니다. 재현 설정 자체가 노드 32개, GPU 128개 구성으로 적혀 있고, 스케일링 결과도 128 GPU를 기준선으로 삼고 있습니다.
PyTorch 스택에서 같은 문제를 다룬다면 이 글의 커널 자체보다 설계 선택이 참고가 됩니다. grouped GEMM으로 전문가별 행렬곱을 커널 하나로 모으는 것, 디스패치와 컴바인을 장치 주도 통신으로 융합해 CPU를 크리티컬 패스에서 빼는 것, 오버플로를 조용한 드롭이 아니라 명시적 실패로 처리하는 것은 프레임워크와 무관한 결정입니다. Mixture-of-Kittens: Cursor가 새로 공개한 NVL72용 MoE 학습 메가커널은 같은 NVL72를 목표로 MoE 계층의 통신과 연산을 CUDA 커널 하나에 전부 넣어 자사 프로덕션 스택의 종단 간 처리량을 1.41배로 올린 사례입니다. TE가 grouped GEMM과 EP를 여전히 별개 커널로 두는 것과 비교하면, 커널 경계를 어디까지 넓힐 수 있는지 가늠해 보기에 좋습니다.
Transformer Engine과 MaxText, NCCL Extensions의 라이선스
Transformer Engine과 MaxText는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. NCCL Extensions도 대부분이 Apache 2.0이지만, 다른 프로젝트에서 가져온 파일은 각자의 라이선스 문구를 포함하고 있으므로 third_party 디렉토리를 함께 확인해야 합니다.
 Accelerating Dropless MoE Training in JAX with NVIDIA Transformer Engine 소개 블로그
 NVIDIA Transformer Engine GitHub 저장소
NCCL Extensions GitHub 저장소
 Transformer Engine 공식 문서
MaxText MoE 설정 가이드
더 읽어보기
-
DeepEP: 효율적인 Mixture-of-Experts 병렬 통신 라이브러리 (feat. DeepSeek)
-
DeepGEMM: NVIDIA Hopper GPU에서 효율적인 FP8 연산을 위한 GEMM 커널 라이브러리 (feat. DeepSeek)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
파이토치 한국 사용자 모임 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
