핵심 요약
- Microsoft AI가 Frontier Pre-training at Microsoft AI 글에서 활성 80B, 전체 2.8T 파라미터의 MoE 기반 모델 MAI-Base-2의 사전학습 완료를 알렸습니다. GB200 GPU 1만 6천 장으로 2026년 8~9월 38일 동안 50T 토큰을 학습했고, 지금은 사후 학습 중입니다.
- Microsoft AI의 자체 보류(held-out) 평가 4종에서 MAI-Base-2는 비교한 오픈 웨이트 모델 모두보다 낮은 bits-per-byte(BPB)를 기록했습니다. DeepSeek-V4-Pro-Base와 같은 BPB에 도달하는 데 필요한 연산은 4.2~12.3배 적다고 추정했습니다.
- MAI는 이 효율의 근거로 스케일링 사다리와 하이퍼파라미터 스케일링 법칙을 듭니다. 모델 쪽에서는 모든 층의 다회차 Dropless MoE, Muon 옵티마이저, 활성값 그래디언트 클리핑을, 데이터 쪽에서는 증류 없는 데이터와 네이티브 비전 학습을 듭니다.
- 가중치는 공개하지 않습니다. Microsoft AI는 데이터 출처 관리 덕분에 앞으로 Foundry를 통해 신뢰할 수 있는 파트너에게 가중치를 라이선스할 수 있다고 밝혔고, 비교 평가 세트도 공개되지 않아 외부에서 수치를 재현할 수는 없습니다.
MAI-Base-2 소개
MAI-Base-2는 Microsoft AI(MAI)가 직접 사전학습한 두 번째 대형 기반 모델(Base Model) 입니다. 토큰마다 일부 전문가 네트워크만 활성화하는 전문가 혼합(Mixture of Experts, MoE) 구조입니다. 기반 모델은 지시 따르기나 추론 학습을 거치기 전, 다음 토큰 예측만으로 학습한 모델을 말합니다. 2026년 6월 MAI는 MAI-Thinking-1 기술 보고서에서 첫 기반 모델 MAI-Base-1(활성 35B, 전체 1T)과 그 위에 사후 학습한 추론 모델을 발표했습니다. 이번 글은 그 다음 세대의 기반 모델을 어떻게 사전학습했는지 정리한 실험실 노트(Lab Notes)이며, 웹 글과 같은 내용의 13쪽 PDF가 함께 나왔습니다.
MAI의 출발점은 규모입니다. 원문은 MAI-Base-1이 크기 대비 강한 모델이지만 프런티어의 오픈 웨이트와 비공개 모델보다는 작았다고 말하고, 그래서 다음 과제가 "규모 키우기(scale up)" 였다고 적습니다. 다만 이 글의 중심 주장은 "더 큰 모델" 자체보다 같은 성능을 더 적은 연산으로 내는 학습 레시피 에 있습니다. MAI는 DeepSeek-V4-Pro-Base 대비 4~12배의 연산 효율을 얻었고, 그 절약분을 더 큰 모델을 학습하는 데 썼다고 설명합니다. 또한 MAI-Base-1 때부터 모든 모델을 "지능은 제1원리에서 학습해야 한다", "단순한 방법이 가장 잘 확장된다", "지름길보다 과학적 엄밀성"이라는 세 원칙에 따라 만든다고 밝힙니다.
또 하나의 축은 데이터 출처입니다. MAI는 MAI 모델 7종 발표 때부터 다른 모델의 출력을 베끼는 증류(Distillation) 없이 사람이 만든 데이터로만 학습한다는 원칙을 내세웠고, MAI-Base-2도 같은 원칙을 따랐습니다. 원문은 이 데이터 출처 관리 덕분에 앞으로 Microsoft Foundry를 통해 신뢰할 수 있는 파트너에게 모델 가중치를 라이선스할 수 있다고 밝힙니다. 즉 MAI-Base-2는 오픈 웨이트 모델이 아니며, 이 글은 제품 출시가 아니라 학습 방법의 기록입니다. 대규모 MoE 모델을 학습하거나 학습 인프라를 운영하는 팀이라면 아래의 스케일링 사다리, Dropless MoE, Muon 분산 구현 부분을 참고할 수 있습니다.
MAI-Base-1에서 MAI-Base-2로: 더 크고, 더 희소하게
원문은 MAI-Base-2의 사전학습을 성공시킨 세 가지 작업을 꼽습니다:
- 스케일링 과학(Scaling Science): 반복 학습 데이터를 반영한 스케일링 사다리와 경험적인 하이퍼파라미터 스케일링 법칙
- 모델과 인프라의 공동 설계(Model-Infrastructure Co-design): 개선한 MoE 및 Muon 구현과 활성값 그래디언트 클리핑
- 데이터 확장(Scaling Data): 확장한 데이터 파이프라인과 비전 데이터의 통합
MAI-Base-2는 2026년 8월과 9월에 걸쳐 GB200 GPU 1만 6천(16k) 장에서 38일 동안 학습했습니다. 학습 기간 평균 MFU(Model FLOPs Utilization) 는 21%, 학습이 실제로 진행된 시간의 비율인 굿풋(Goodput) 은 89%였습니다. MFU는 GPU의 이론 최대 연산량 대비 모델 연산에 실제로 쓴 비율이며, MAI는 GB200의 BF16 이론 최대치 2.5 PFLOPS를 분모로 두고 재계산(rematerialization)과 옵티마이저 연산은 제외해 계산했습니다.
아래 표는 원문에 실린 두 모델의 아키텍처 비교입니다:
| 항목 | MAI-Base-1 | MAI-Base-2 |
|---|---|---|
| 활성 / 전체 파라미터 | 35B / 1T | 80B / 2.8T |
| 층 수 | 78 | 102 |
| 은닉 차원 | 6656 | 8704 |
| MoE 배치 | 밀집 FFN(Feed-Forward Network)과 MoE를 번갈아 배치 | 모든 층에 MoE |
| 밀집 FFN 차원 | 13312 | 없음 |
| MoE 다운 프로젝션 차원 | 3072 | 4096 |
| MoE 전문가 FFN 차원 | 10240 | 8704 |
| 라우팅 / 전문가 수 | 공유 0 + 라우팅 8 / 512 | 공유 1 + 라우팅 7 / 512 (공유 전문가는 다운/업 프로젝션 없음) |
| 어텐션 헤드 (KV / Q) | 전역 8 / 80 (6층마다), 지역 8 / 80 | 전역 2 / 96 (6층마다), 지역 16 / 96 |
| 임베딩 | 입출력 공유(Tied) | 분리(Untied) |
| 학습 토큰 | 30T | 50T |
| 옵티마이저 | AdamW | Muon (임베딩을 뺀 2D 파라미터), AdamW |
| FP8 방식 | 텐서 단위 지연 스케일링 E4M3 / E5M2 | MXFP8 E4M3 |
| 그래디언트 클리핑 | 전역 가중치 그래디언트 클리핑 | 전역 가중치 그래디언트 + 활성값 그래디언트 클리핑 |
| 비전 | 텍스트 전용 | 네이티브 VLM |
표에서 3가지 변화를 확인할 수 있습니다. 첫째, 밀집 FFN을 없애고 모든 층을 MoE로 바꿨습니다. 둘째, 전역 어텐션 층의 KV 헤드를 8개에서 2개로 줄인 대신 지역 어텐션 층의 KV 헤드는 16개로 늘렸습니다. 셋째, 옵티마이저와 FP8 형식, 그래디언트 클리핑, 비전 입력이 모두 바뀌었습니다. FP8 형식의 MXFP8은 작은 블록마다 공유 스케일을 두는 마이크로스케일링(Microscaling, MX) 형식의 8비트 변형입니다.
공개된 수치는 서로 맞아떨어집니다. 아래는 필자의 계산이며 원문에 있는 값이 아닙니다. 흔히 쓰는 근사식 6ND(활성 파라미터 수 N, 학습 토큰 수 D)로 계산하면 80B × 50T × 6 ≈ 2.4 \times 10^{25} FLOPs입니다. GPU 수, 이론 최대치, MFU, 학습 일수, 굿풋을 곱해도 약 2.5 \times 10^{25} FLOPs가 나옵니다. 아래 그림 3의 MAI-Base-2 점도 이 위치에 있습니다.
공개 모델과의 비교: 보류 데이터에서 잰 bits-per-byte
MAI는 사전학습 모델을 bits-per-byte(BPB) 로 비교합니다. BPB는 텍스트 1바이트를 예측하는 데 드는 평균 비트 수로, 토큰 단위 손실을 원문 바이트 수로 나눠 정규화하므로 토크나이저가 다른 모델끼리도 비교할 수 있습니다. 값이 낮을수록 모델이 그 텍스트를 잘 예측한다는 뜻입니다. 평가 세트는 4종입니다. 코드는 MAI 자체 코드베이스를 쓰고, STEM, 수학(Math), 질의응답(QA)은 학습 데이터 오염 위험을 줄이려고 외부 업체에 새로 의뢰해 만들었습니다. MAI는 모든 평가 세트를 자사 학습 데이터 기준으로 다시 오염 제거(decontamination)했다고 밝힙니다.
비교 대상은 2026년 10월 이전에 나온 전체 1T 파라미터 이상의 체크포인트입니다:
- DeepSeek-V4-Pro-Base (활성 49B / 전체 1.6T): 원문은 "오픈 웨이트 기반 모델 중 가장 강한 모델" 로 소개합니다. 커뮤니티의 DeepSeek-V4 소개 글도 참고할 수 있습니다.
- Kimi K3 (104B / 2.8T), Qwen3.8-2.4T-A95B (95B / 2.4T), MiMo-V2.6-Pro-RL (42B / 1.02T): 이 세 모델은 사후 학습한 체크포인트만 공개되어 있습니다. MAI는 사후 학습이 이 평가에 영향을 줄 수 있다는 단서를 달고 결과를 보고했습니다.
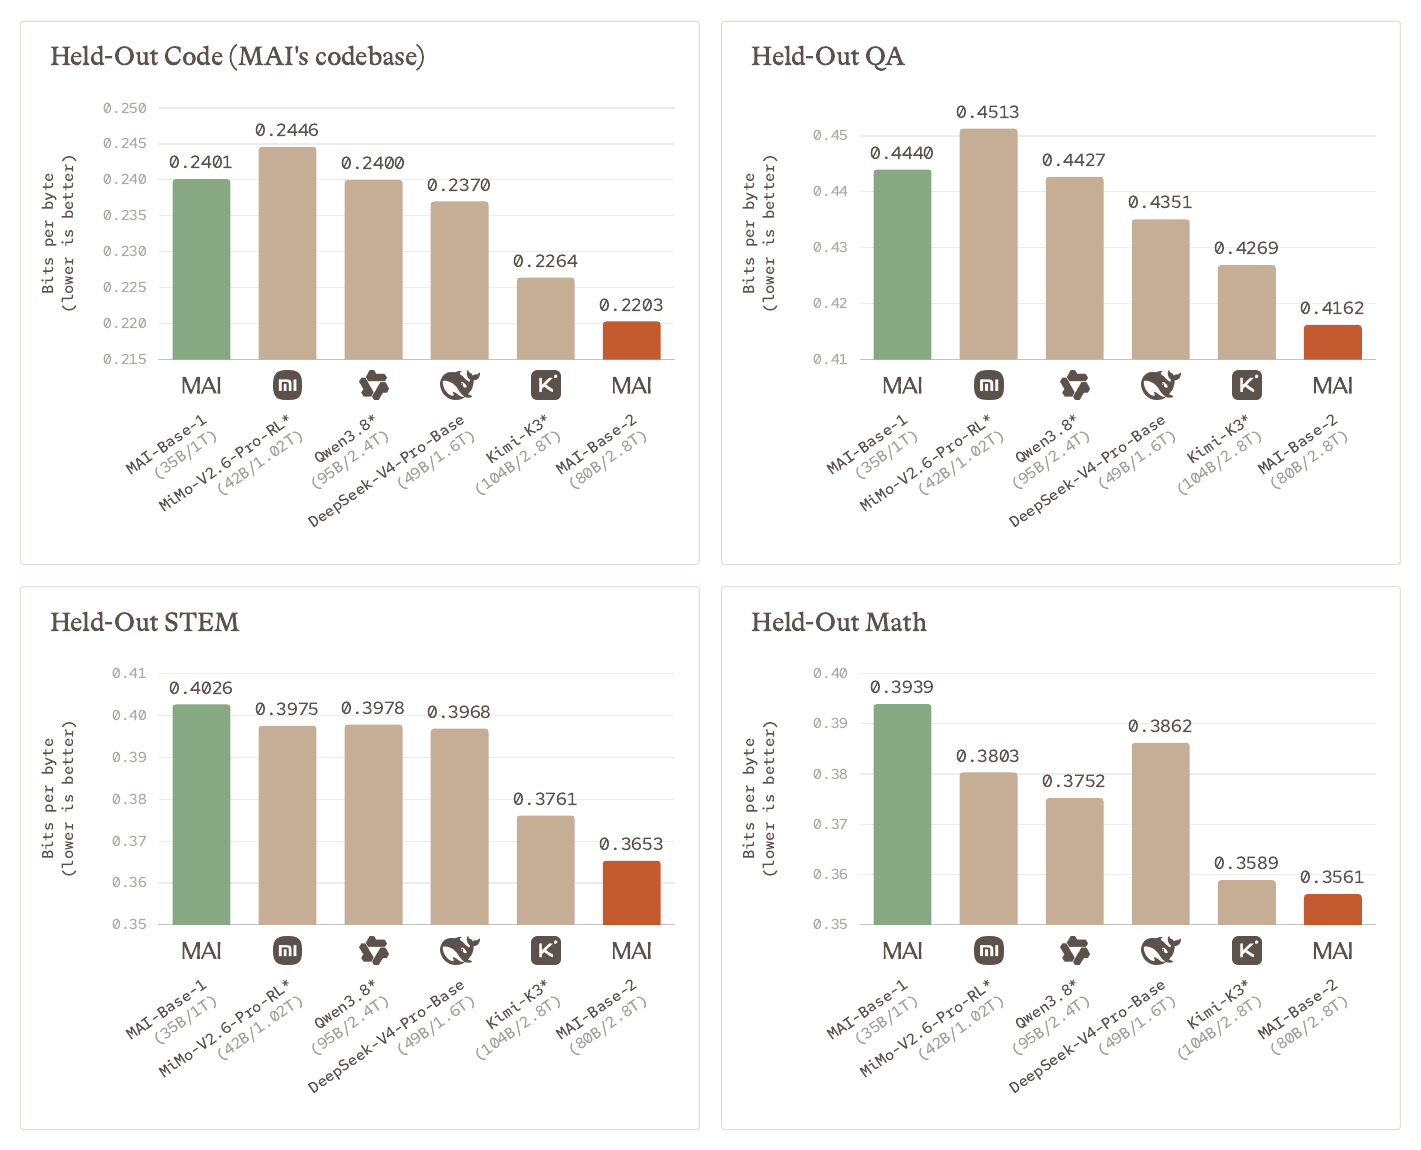
그림에 표시된 값을 표로 옮기면 다음과 같습니다(낮을수록 좋음, * 는 사후 학습 모델):
| 모델 | 코드 | QA | STEM | 수학 |
|---|---|---|---|---|
| MAI-Base-1 | 0.2401 | 0.4440 | 0.4026 | 0.3939 |
| MiMo-V2.6-Pro-RL* | 0.2446 | 0.4513 | 0.3975 | 0.3803 |
| Qwen3.8-2.4T-A95B* | 0.2400 | 0.4427 | 0.3978 | 0.3752 |
| DeepSeek-V4-Pro-Base | 0.2370 | 0.4351 | 0.3968 | 0.3862 |
| Kimi K3* | 0.2264 | 0.4269 | 0.3761 | 0.3589 |
| MAI-Base-2 | 0.2203 | 0.4162 | 0.3653 | 0.3561 |
MAI-Base-2는 4개 항목 모두에서 가장 낮은 BPB를 기록했습니다. 차이의 크기는 항목마다 다릅니다. 2위는 모든 항목에서 사후 학습 모델인 Kimi K3였고, 수학에서는 그 차이가 0.0028로 작습니다. 수학에서는 DeepSeek-V4-Pro-Base가 사후 학습 모델인 MiMo와 Qwen보다 BPB가 높았다는 점도 함께 보아야 합니다. 이 표는 평가 세트가 공개되지 않은 MAI 내부 측정이며, 다운스트림 벤치마크 점수는 이번 글에 없습니다.
같은 BPB에 필요한 연산으로 학습 레시피를 비교하기
모델끼리 직접 비교하면 학습 레시피의 품질과 모델 크기, 학습 연산량의 차이가 한데 섞입니다. MAI는 레시피만 떼어 보려고 "우리 레시피로 상대 모델과 같은 BPB를 내려면 연산이 얼마나 필요한가" 를 추정했습니다. 기준 모델은 DeepSeek-V4-Pro-Base입니다. 원문은 이 모델이 1T 파라미터를 넘는 유일한 공개 사전학습 기반 체크포인트이고, 학습 FLOPs는 MAI-Base-2보다 상당히 적다고 설명합니다.
방법은 다음과 같습니다. 그림 1의 평가 4종마다 MAI 스케일링 사다리 모델들의 학습 FLOPs 대비 BPB에 스케일링 법칙을 따로 맞추고, DeepSeek-V4-Pro-Base의 BPB에 도달하는 지점의 연산량을 읽습니다. 이미 결과를 아는 MAI-Base-2도 피팅에 넣었기 때문에, 도달 지점이 외삽이 아니라 피팅 범위 안에 놓입니다. 이 추정치를 DeepSeek-V4-Pro-Base의 실제 학습 연산량과 비교하면 MAI 레시피가 4.2~12.3배 FLOPs 효율적 이라는 결과가 나옵니다. 같은 방식으로 6월에 발표한 MAI-Base-1과 비교하면 그 사이 효율이 6.3~12.7배 좋아졌습니다.
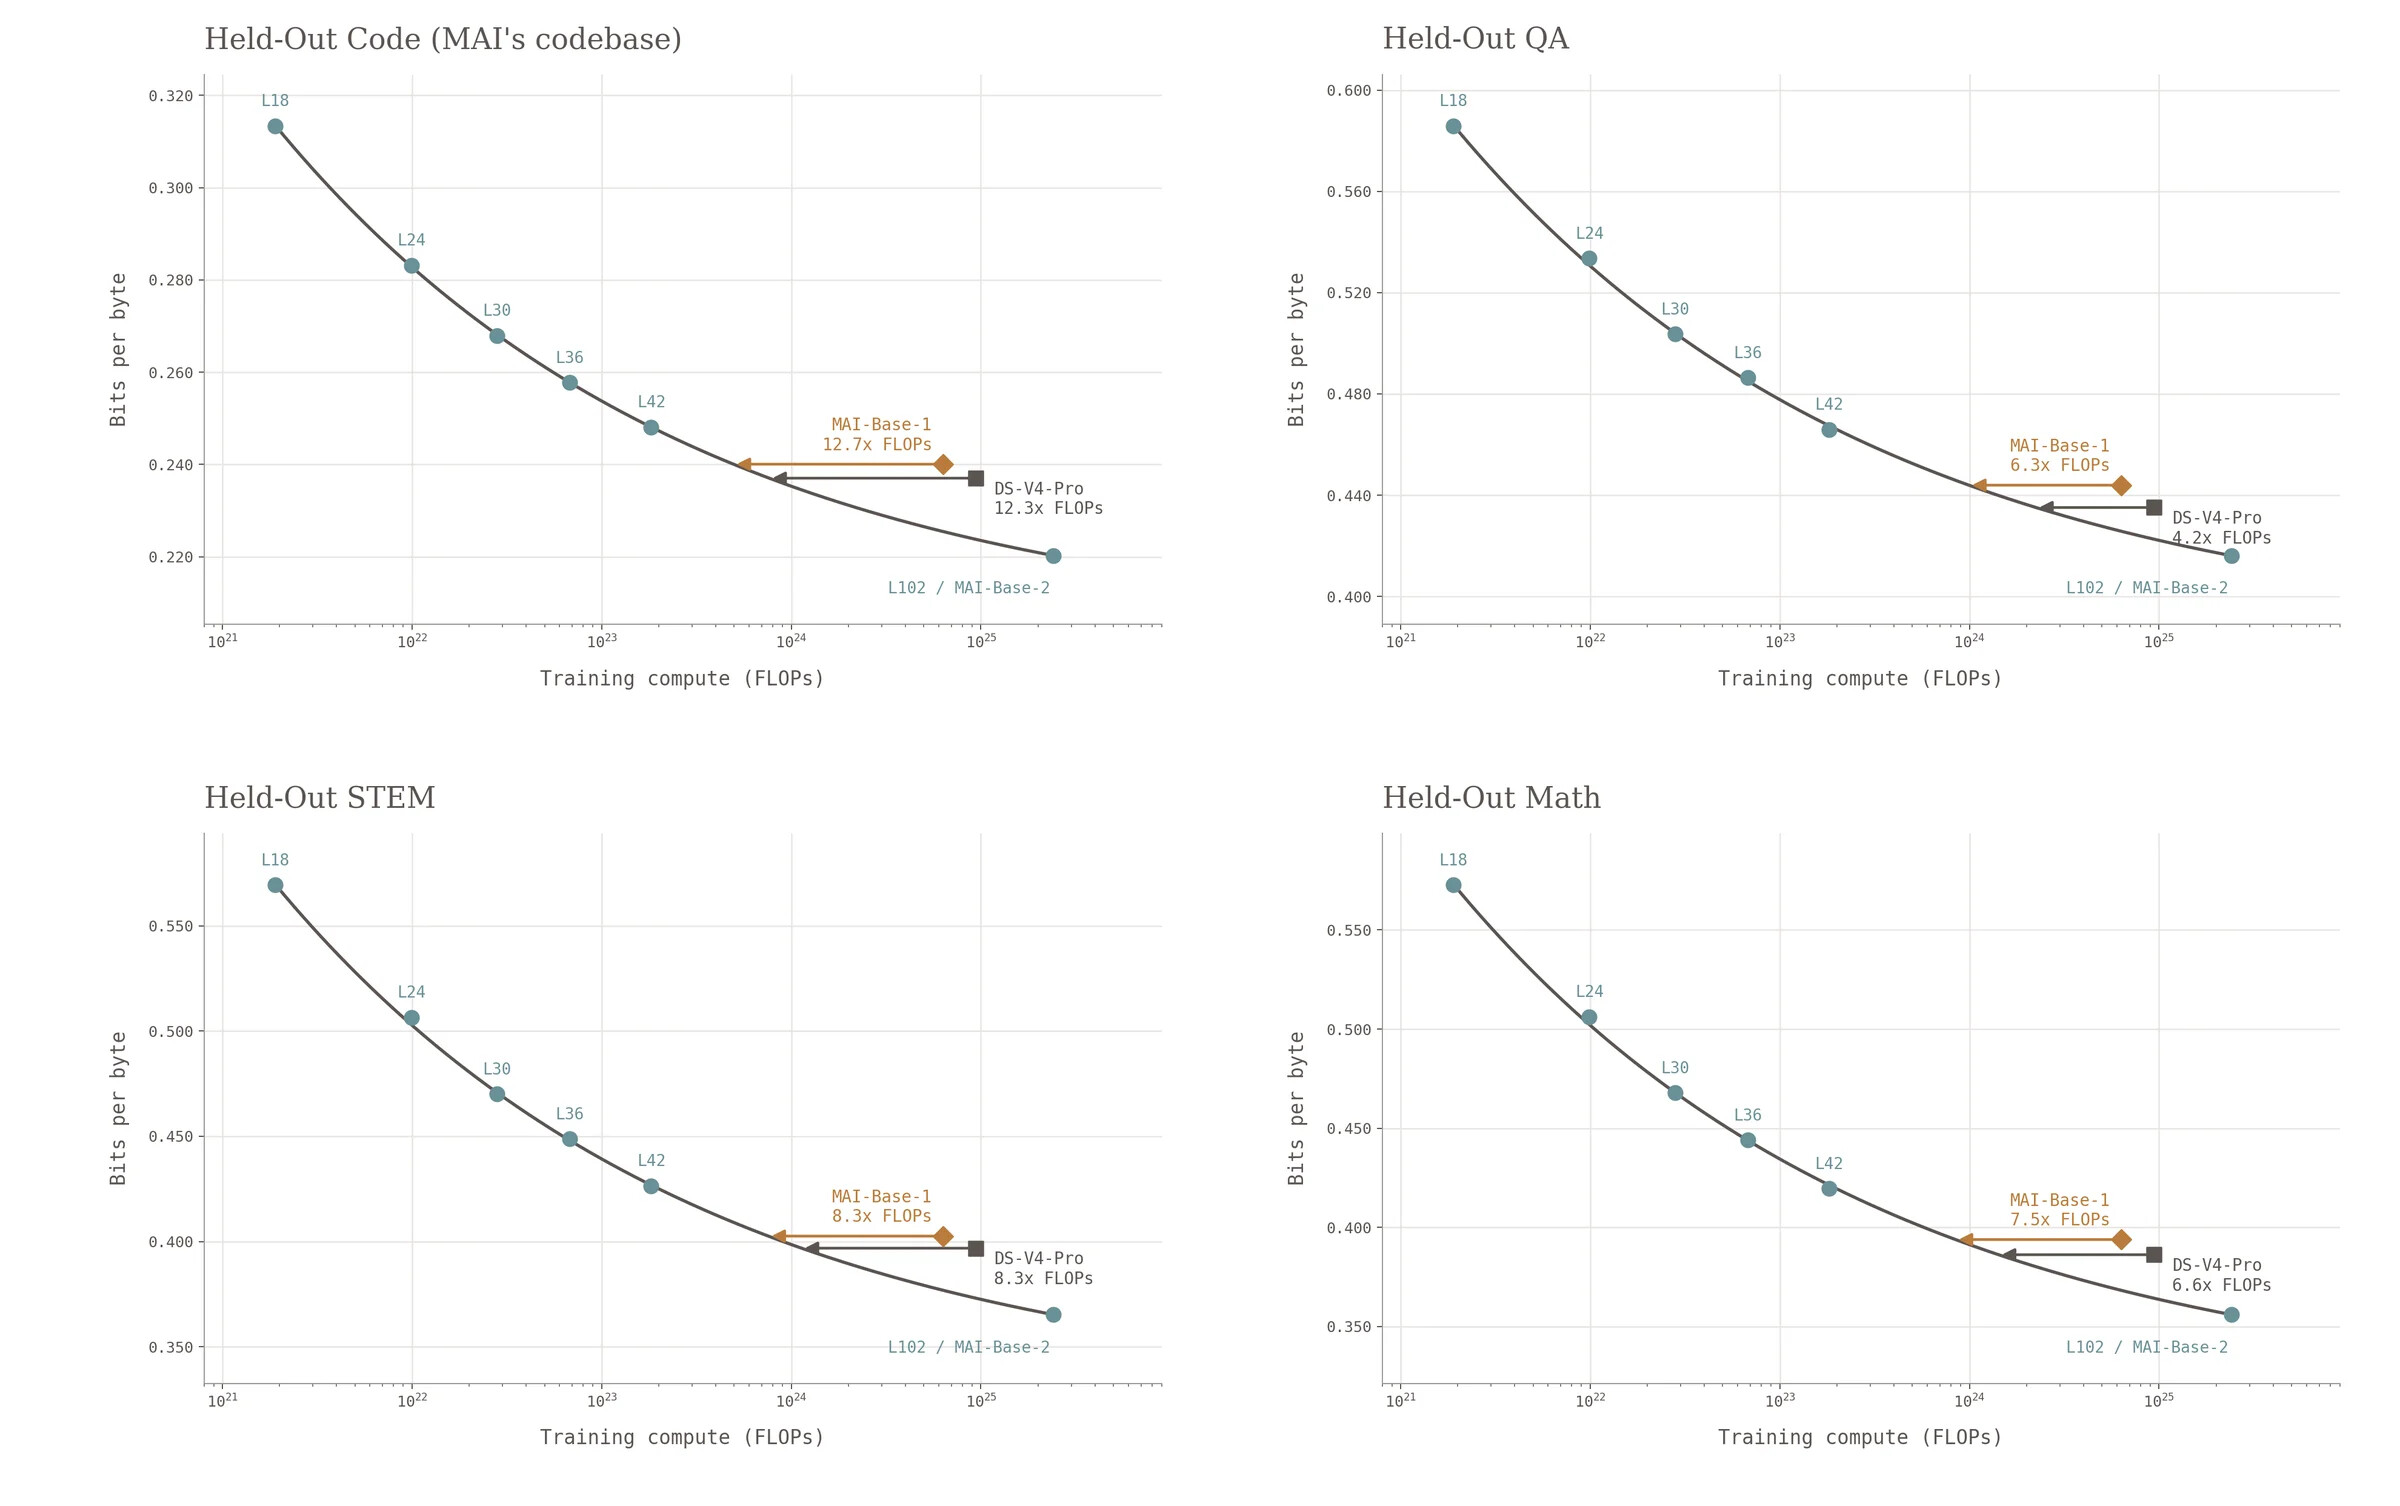
그림 3에 표시된 평가별 배수는 다음과 같습니다:
| 평가 | DeepSeek-V4-Pro-Base 대비 | MAI-Base-1 대비 |
|---|---|---|
| 코드 | 12.3배 | 12.7배 |
| QA | 4.2배 | 6.3배 |
| STEM | 8.3배 | 8.3배 |
| 수학 | 6.6배 | 7.5배 |
배수는 평가에 따라 3배 가까이 차이 납니다. 가장 큰 값은 MAI 자체 코드베이스로 만든 코드 평가에서 나왔고, 가장 작은 값은 QA에서 나왔습니다. 또한 이 배수는 DeepSeek-V4-Pro-Base의 학습 연산량을 분모로 쓰는데, 원문은 그 값을 숫자로 적지 않았습니다. MAI는 이 효율이 데이터의 품질과 적합성, 그리고 아래에서 설명하는 모델링 선택에서 왔다고 봅니다.
스케일링 사다리: 작은 모델로 2.8T 모델의 결과를 예측하기
MAI는 모델 변경을 스케일링 사다리(Scaling Ladder) 로 평가합니다. 스케일링 사다리는 학습 레시피를 고정하고 크기만 바꾼 모델 묶음입니다. 사다리의 각 단은 층 수 L 로 이름을 붙이고(L18, L24 등), 나머지 구조는 L 하나로 정해집니다. 예를 들어 은닉 차원은 (256/3) \cdot L 이고, 쿼리 헤드 수는 L 을 16의 배수로 반올림한 값입니다. 모델을 키울 때는 활성 파라미터당 학습 토큰 수(Tokens Per Parameter, TPP) 를 일정하게 유지합니다.
문제는 데이터 반복입니다. 50T 토큰 학습에서는 데이터셋 일부를 여러 번(멀티 에폭) 반복해 쓰는데, 작은 실험에서는 토큰을 적게 쓰니 같은 데이터가 거의 반복되지 않습니다. 그러면 작은 규모에서는 규제가 약한(Under-regularized) 아키텍처와 하이퍼파라미터가 좋아 보이다가, 큰 규모에서는 과적합으로 이어질 수 있습니다. MAI는 이를 소스 스케일링(Source Scaling) 으로 해결합니다. 사다리의 아래 단에서 학습하는 고유 샘플 집합을 일부러 줄여, 학습 길이와 상관없이 각 데이터셋의 반복 횟수를 같게 맞추는 방법입니다. 예를 들어 50T 토큰 전체 학습에서 8번 반복되는 데이터셋이라면, 5T 토큰 실험에서는 그 데이터의 1/10만 골라 8번 반복합니다.
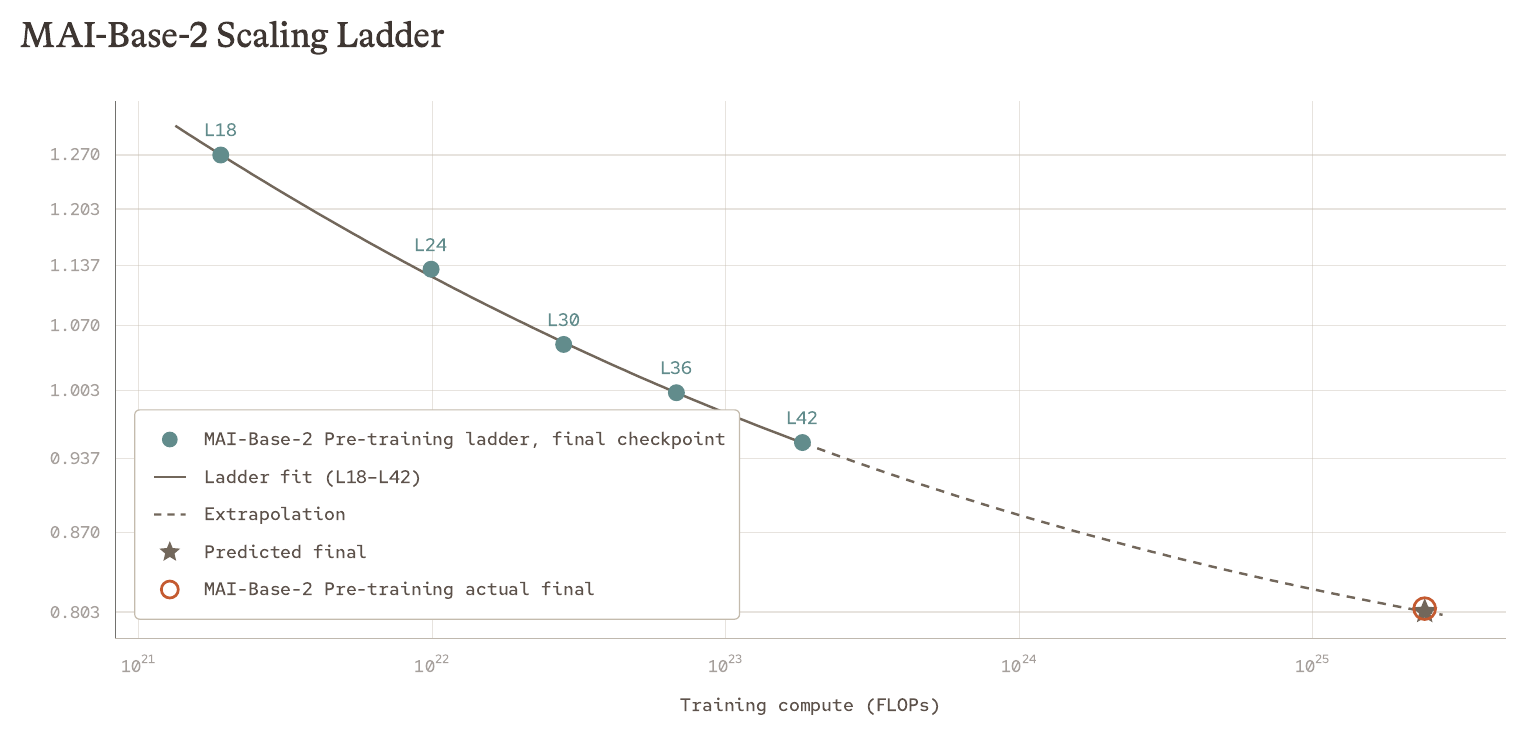
TPP를 고정한 상태에서 소스 스케일링을 쓰면 파라미터 대비 고유 데이터의 비율도 고정되므로, 작은 실험의 결론이 큰 규모로 옮겨질 가능성이 높아집니다. 원문은 소스 스케일링이 2.8T 모델까지 안정적으로 키우는 데 핵심이었다고 말합니다. 그림 2는 L18~L42 사다리로 맞춘 곡선을 외삽한 예측값(별)과 MAI-Base-2의 실제 최종값(빨간 원)이 겹치는 모습입니다. 웹판 그림에 담긴 데이터로는 예측값 0.8034, 실제값 0.8058로 차이가 0.3%이며, 가장 큰 사다리 모델 L42보다 약 130배 큰 연산까지 외삽한 결과입니다. 세로축은 코드 45%, 수학과 STEM 각 15.8% 등으로 가중 평균한 평가 손실(NLL)입니다.
하이퍼파라미터 스케일링 법칙: LR과 WD를 함께 찾기
하이퍼파라미터 하나를 바꾸면 다른 하이퍼파라미터의 최적값도 바뀌므로, 대규모 학습의 하이퍼파라미터는 조합 공간이 커서 찾기 어렵습니다. MAI는 학습률(Learning Rate, LR)과 가중치 감쇠(Weight Decay, WD)를 함께 탐색했습니다. 모델 성능은 두 값의 곱 LR \times WD 에 가장 민감해서, 좋은 설정은 (\log LR, \log WD) 평면의 좁은 대각선 띠에 모입니다. 직사각형 격자로는 이 띠를 비효율적으로 훑게 되므로, MAI는 대신 (\log LR, \log(LR \times WD)) 격자를 탐색했습니다.
여러 모델 크기와 TPP 조합마다 격자 위의 모델을 학습하고 평가 손실에 2차 함수 곡면을 맞춘 뒤, 해석적 최솟값 (LR^*, LR^* \times WD^*) 을 구했습니다. 그다음 이 최솟값을 모델 크기, TPP, 학습 스텝 수의 함수로 모델링했습니다. 모델 선택 결과 LR^* \times WD^* 는 주로 학습 스텝 수에만 의존했고, \log LR^* 는 여기에 \log \text{TPP} 가 더해졌습니다.
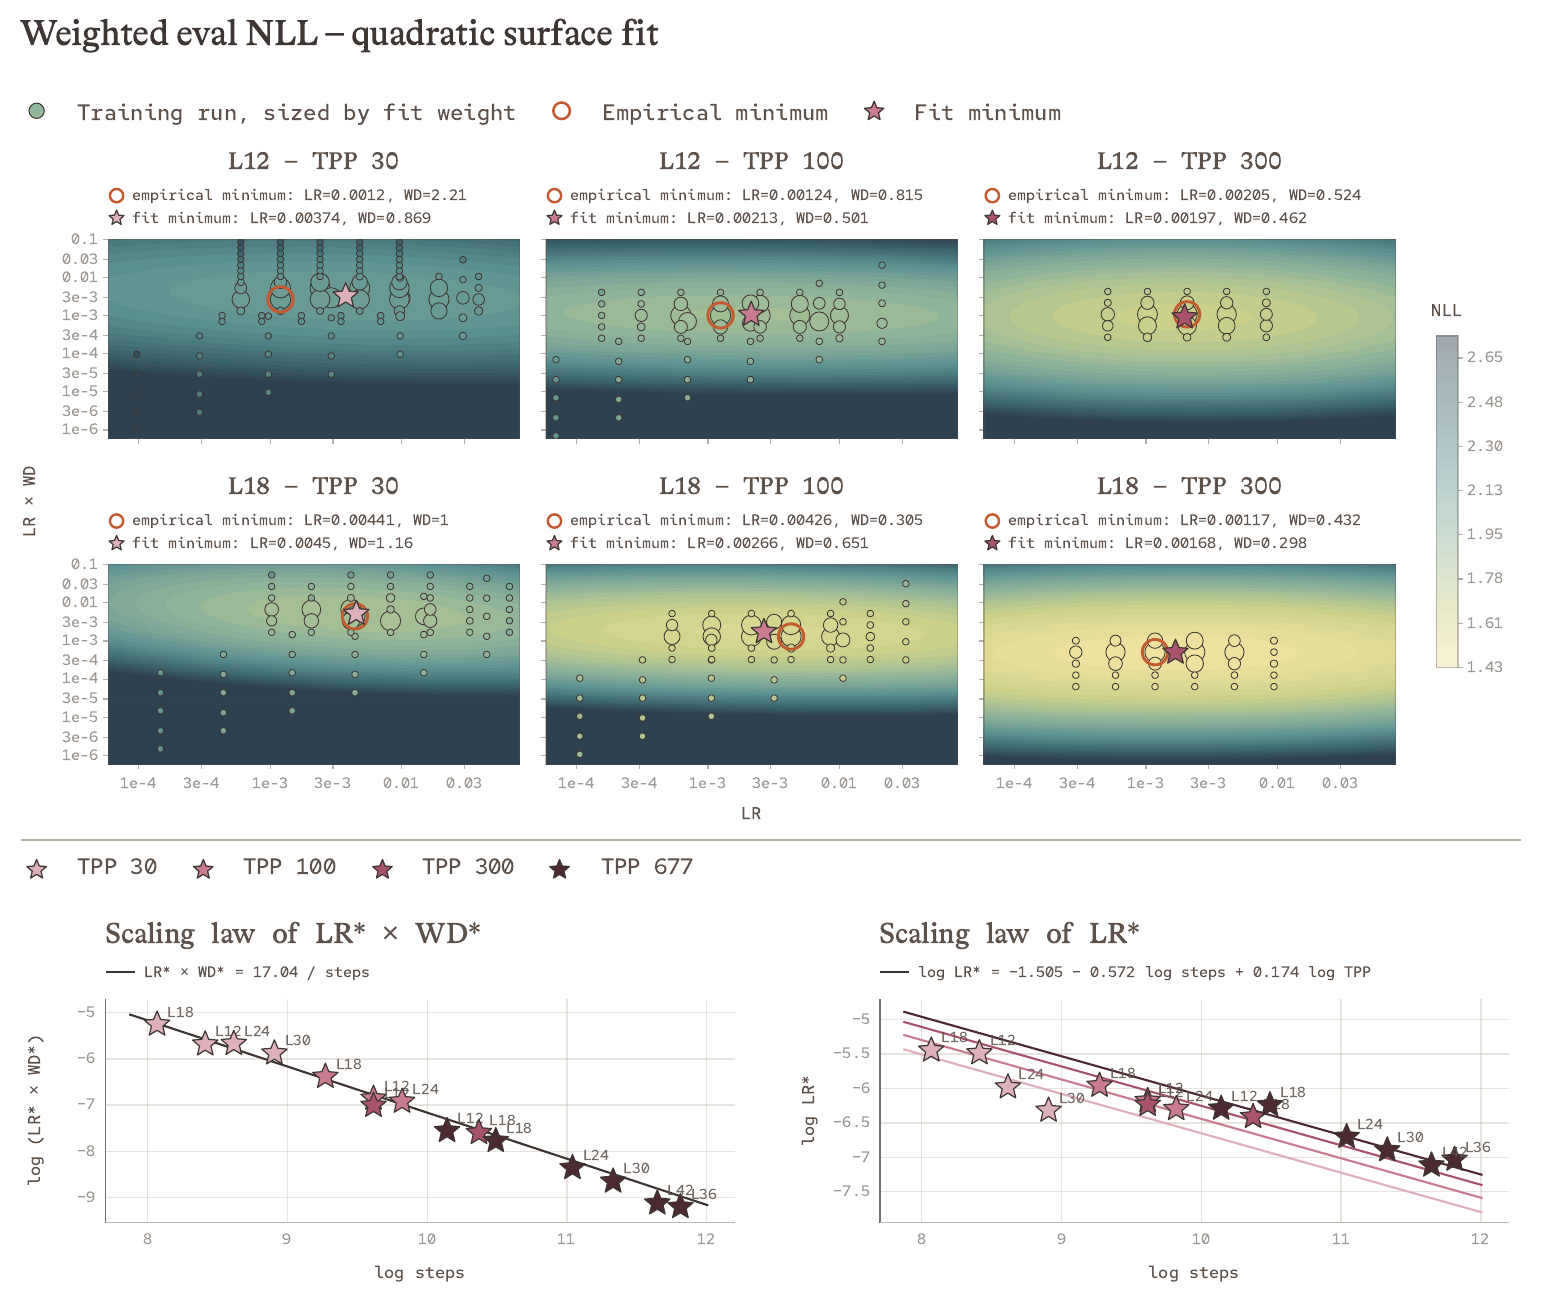
최종 스케일링 법칙은 다음과 같습니다:
스텝 수에 대한 LR^* \times WD^* 의 지수는 -1 에 매우 가깝습니다. 원문은 이것이 분리형 가중치 감쇠(Decoupled Weight Decay)의 시간 척도 \frac{1}{LR \times WD} 가 전체 학습의 일정 비율이어야 한다는 관점과 맞는다고 해석합니다. 스텝 수에 대한 LR 의 지수는 -0.5 에 가까운데, 이는 배치 크기를 2배로 늘리면 학습률에 \sqrt{2} 를 곱한다는 널리 쓰이는 경험칙과 맞습니다. 같은 방법으로 드롭아웃(Dropout)의 스케일링 법칙도 구했습니다:
MAI는 이 법칙들을 작은 실험에서 추정하고 중간 규모에서 기존 경험칙보다 일관되게 나은지 검증한 뒤 MAI-Base-2의 하이퍼파라미터를 정했습니다. 원문은 MAI-Base-2에 실제로 적용한 값을 밝히지 않았습니다. 웹판 그림 4의 데이터를 보면 LR 과 LR \times WD 식의 로그는 자연로그이고, 사다리 모델 15개의 실측 최적값은 식의 예측과 ±40% 안에서 맞습니다. 이 두 식에 MAI-Base-2의 최종 스텝 수 37만 2,530과 TPP 약 625(50T / 80B)를 넣으면 학습률은 약 4.4 \times 10^{-4}, 가중치 감쇠는 약 0.10입니다(필자 계산). 드롭아웃 식은 로그의 밑을 확인할 수 없어 계산하지 않았습니다.
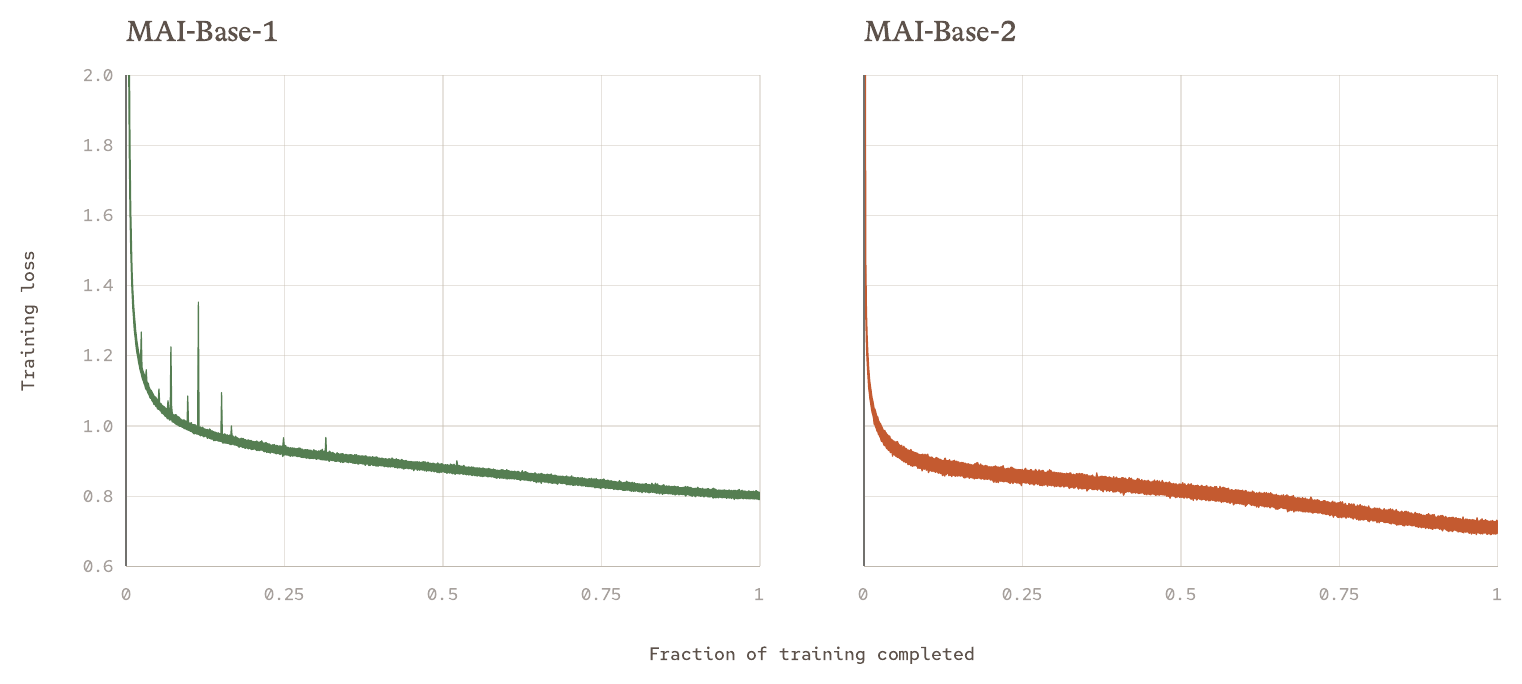
원문에는 두 모델의 학습 손실 곡선도 있습니다. MAI-Base-1 곡선에는 학습 전반부에 손실이 튀는 지점이 여러 번 보이지만, MAI-Base-2 곡선은 전체 학습 동안 매끄럽습니다. MAI는 이를 신중한 스케일링 사다리와 학습 레시피의 점진적인 개선 덕분으로 봅니다.
모델과 인프라를 함께 설계하기: 효율 이득(EG) 지표
정해진 연산 예산 안에서 프런티어 모델을 학습하려면 평가 품질과 연산 효율을 함께 보고 모델과 인프라를 같이 설계해야 합니다. MAI는 이 판단에 효율 이득(Efficiency Gain, EG) 지표를 씁니다. EG는 후보 설정이 기준 설정과 같은 평가 손실에 도달하는 데 필요한 연산의 비율입니다. 연산은 FLOPs로 잴 수도 있고(\text{EG}_{\text{FLOPs}}), 실제 경과 시간으로 잴 수도 있습니다(\text{EG}_{\text{time}}).
MAI는 주로 \text{EG}_{\text{time}} 을 씁니다. 현재 인프라의 상태를 그대로 반영하기 때문입니다. \text{EG}_{\text{FLOPs}} 는 프로토타입의 잠재력을 보여 주고 다음 인프라 개발 방향을 정하는 데 씁니다. FLOPs로는 이기는데 경과 시간으로는 지는 변경이 있다면, 그 지점이 인프라에 투자할 곳 이라는 것이 원문의 설명입니다. 아래 MoE와 Muon의 사례가 이 방식으로 결정되었습니다.
MoE를 모든 층에: 다회차 Dropless MoE
MAI의 이전 실험에서는 모든 층에 MoE를 두는 구성이 밀집 FFN과 MoE를 번갈아 두는 구성보다 \text{EG}_{\text{FLOPs}} 에서 꾸준히 앞섰습니다. 그러나 MAI-Base-1 당시에는 MoE 구현의 비효율 때문에 경과 시간 기준으로는 번갈아 두는 구성이 최적이었습니다. MAI-Thinking-1 보고서에서 MAI-Base-1이 인터리브 구조를 고른 이유와 같습니다. MAI-Base-2에서 MAI는 MoE의 MFU를 낮추는 원인 2가지를 찾았습니다:
- 동적 라우팅이 메모리 단편화를 늘렸고, 드물게 생기는 극단적인 전문가 부하 불균형에 대비해 메모리를 많이 잡아 두었습니다. 이 메모리를 쓸 수 있었다면 활성값 재계산을 줄일 수 있었습니다.
- 전문가를 더 많고 더 잘게 나누자 전문가마다 생기는 오버헤드가 커졌습니다.
이 2가지를 해결하자 MoE 층의 MFU가 24%에서 35%로 올랐고, MAI는 MAI-Base-2의 모든 층에 MoE를 쓸 수 있었습니다.
MoE 층에서는 전문가마다 받는 토큰 수가 다르므로, 토큰이 몰린 전문가는 GPU 메모리가 부족해질 수 있습니다. 전문가마다 상한을 두고 넘치는 토큰을 버리는 방법이 있지만, MAI의 실험에서는 토큰을 버리면 성능이 나빠졌습니다. 가장 큰 불균형에 맞춰 메모리를 넉넉히 잡는 방법은 평소 부하에서 메모리를 낭비합니다. MAI는 다회차 Dropless MoE(Multi-round Dropless MoE) 로 이 문제를 풀었습니다. Dropless MoE는 토큰을 버리지 않고 모든 토큰을 전문가가 처리하게 하는 방식이며, MegaBlocks 같은 앞선 연구에서 쓰인 용어입니다.
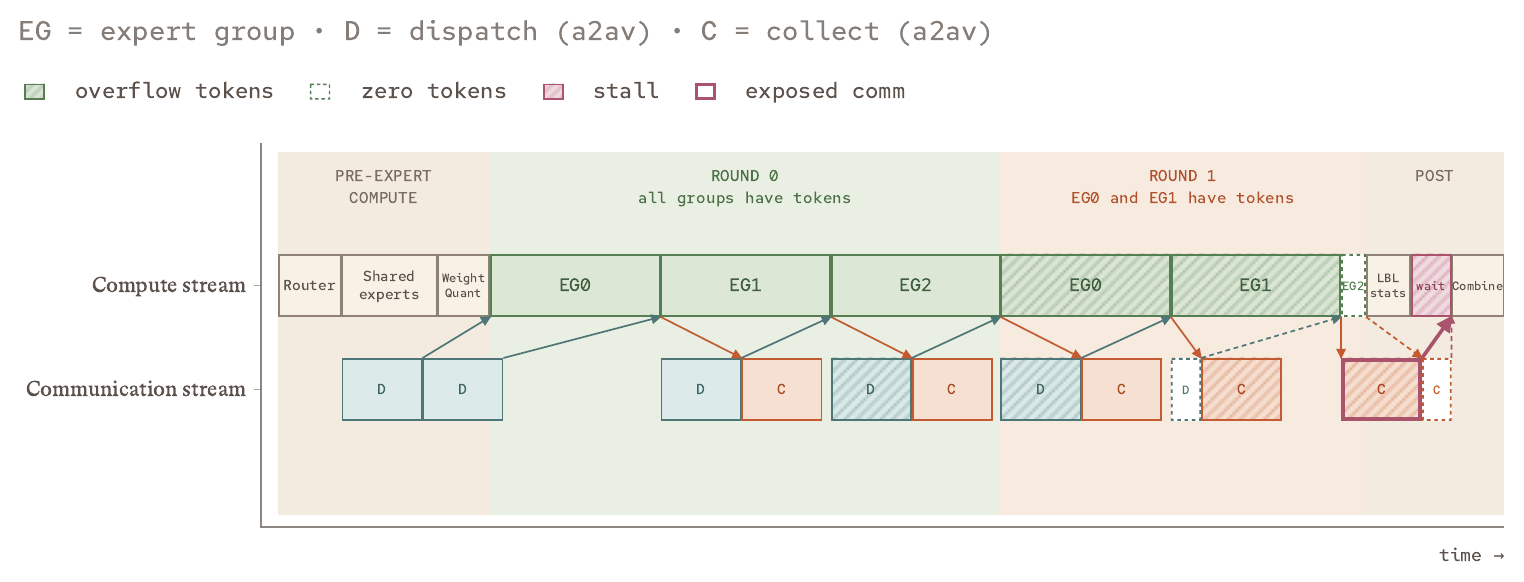
동작 방식은 다음과 같습니다. 전문가 병렬 랭크마다 전문가를 설정 가능한 크기의 그룹으로 묶고, 각 전문가 그룹이 전문가당 고정된 토큰 용량으로 디스패치(dispatch) → 연산(compute) → 수집(collect) 라운드를 실행합니다. 전문가가 용량보다 많은 토큰을 받으면, 넘친 토큰을 추가 라운드에서 처리합니다. 추가 라운드를 줄이려고 같은 그룹 안의 다른 전문가가 쓰지 않은 용량을 빌려 쓰게 합니다. 역전파에서도 비슷한 다회차 일정으로 전문가 그룹 단위의 세밀한 재계산을 합니다. 그래서 토큰이 얼마나 불균형하든 메모리 사용량이 고정되고, 메모리 단편화와 메모리 부족 오류가 사라집니다.
토큰 용량을 키우면 메모리를 더 쓰고, 줄이면 라운드가 늘어 연산이 더 듭니다. MAI는 평상시에는 라운드 1번으로 끝나도록 용량을 맞춰 둡니다. 라운드 수는 모든 전문가 그룹에 공통이므로, 그림 6에서 넘친 토큰이 없는 EG2도 두 번째 라운드에 참여하고 연산만 건너뜁니다. 라운드가 늘어나는 동안에는 MFU가 떨어지지만, 평상시에는 라운드가 1번이므로 이 비용을 감수한다는 것이 원문의 설명입니다. 또한 모든 라운드의 디스패치, 연산, 수집을 파이프라인으로 겹쳐서, 첫 디스패치와 마지막 수집을 뺀 통신은 전문가 연산과 동시에 진행됩니다. 순전파에서는 가중치 양자화와 공유 전문가 연산을 노출된 통신과 겹치고, 역전파에서는 같은 층의 재계산과 가중치 그래디언트 계산으로 전문가 통신을 모두 가립니다.
전문가마다 생기는 오버헤드 줄이기
MAI는 전문가당 오버헤드를 4가지 방법으로 줄였습니다:
- 전문가 그룹 단위로 연산과 통신을 묶어 GEMM과 NVLink 효율을 높였습니다. 커널 실행 오버헤드와 꼬리 효과(tail effect)가 줄어듭니다.
- 토큰 메타데이터를 GPU 메모리에 두고 all-to-all 통신을 GPU에서 직접 시작해 호스트와 디바이스 사이의 동기화를 줄였습니다.
- 대칭 메모리(Symmetric Memory)로 중간 복사 없이 NVLink를 통해 토큰을 직접 교환했습니다. 통신 처리량이 오르고, GEMM과 동시에 실행할 때의 HBM 경합이 줄어듭니다.
- 층마다 하던 부하 균형 손실의 all-reduce를 모든 층에 대한 한 번의 묶음 reduce로 바꿨습니다.
원문은 이 최적화 덕분에 MFU를 크게 떨어뜨리지 않고 더 희소한 모델을 학습할 수 있었다고 설명합니다. 커뮤니티의 Transformer Engine으로 JAX Dropless MoE 처리량을 높인 글도 같은 문제를 다른 구현으로 다룹니다.
1만 6천 GPU에서 Muon 쓰기
MAI-Base-2로 규모를 키우면서 MAI는 Muon 옵티마이저가 AdamW보다 학습이 안정적이고 효율 이득이 크다는 것을 확인했습니다. Muon은 가중치 행렬마다 모멘텀을 직교화(Orthogonalization) 한 뒤 업데이트에 쓰는 옵티마이저입니다. 직교화에는 행렬 곱셈 여러 번으로 이루어진 반복 알고리즘인 Newton-Schulz를 씁니다. 이 계산에는 행렬 전체가 필요한데, ZeRO는 모멘텀을 데이터 병렬 차원으로 쪼개서(sharding) 각 GPU에 나눠 둡니다. 그래서 Muon과 ZeRO를 그대로 함께 쓸 수 없습니다.
MAI는 앞선 연구를 따라 옵티마이저 단계에서 모멘텀을 다시 나눠(reshard) 해결했습니다. 순서는 다음과 같습니다:
- 각 GPU가 자기 FP32 모멘텀 조각을 업데이트하고 BF16으로 변환합니다.
- 모양이 같은 파라미터끼리 묶은 all-to-all 교환으로, 각 GPU가 전체 모멘텀 행렬 일부를 통째로 맡습니다.
- 각 GPU가 대칭성을 활용하는 Newton-Schulz 커널로 맡은 행렬을 직교화합니다.
- 두 번째 all-to-all로 업데이트를 원래 조각 위치로 돌려보내고, FP32로 변환해 가중치에 적용합니다.
1만 6천 GPU 규모의 효율을 위해 3가지를 더 최적화했습니다. 여러 배치를 미리 가져와 통신과 연산을 겹쳤고, 재분할 메타데이터를 캐시해 반복되는 인덱싱 로직을 없앴습니다. 원문은 모양이 같은 파라미터가 수천 개인 희소 MoE 모델에서 이 캐시가 특히 유용하다고 말합니다. 또한 MoE 라우터 가중치처럼 일부 가중치는 쪼개지 않고 모든 GPU에 복제해 두고, 첫 통신 단계를 건너뛴 뒤 Newton-Schulz 다음에 all-gather로 업데이트를 모읍니다.
최적화 후 Muon은 MAI-Base-2의 평균 학습 반복 시간 중 2.1%(165ms)를 차지했습니다. MAI가 추정한 이론 최고 성능은 55ms였고 병목은 통신이었습니다. MAI는 측정값과 이론값의 차이를 느린 GPU(straggler), 커널 실행 오버헤드, 부하 불균형, 재분할 중 메모리 복사와 할당 탓으로 봅니다. 참고로 165ms가 2.1%라면 학습 반복 한 번은 약 7.9초입니다. 여기에 웹판 그림 2 데이터의 최종 스텝 수 37만 2,530을 곱하면 약 34일이 나오며, 굿풋 89%를 감안하면 학습 기간 38일과 맞습니다(필자 계산). 커뮤니티의 DeepSpeed에서 Muon 옵티마이저 사용하기에서 Muon을 ZeRO와 함께 쓰는 다른 구현을 볼 수 있습니다.
활성값 그래디언트 클리핑: 학습 안정화와 데이터 버그 탐지
그래디언트 클리핑(Gradient Clipping) 은 이상치 그래디언트의 영향을 줄여 학습을 안정시키는 흔한 방법입니다. 일반적인 방식은 배치 전체의 가중치 그래디언트 전역 노름(norm)을 기준으로 자릅니다. 그런데 이상치 그래디언트는 보통 배치 안의 일부 데이터에서 나오므로, 이상치 하나 때문에 정상적인 예제의 그래디언트까지 함께 줄어듭니다. MAI는 대상을 좁혀 네트워크의 정해진 위치에서 활성값의 그래디언트(Activation Gradient) 를 자르는 방법을 썼습니다. Muon과 함께 이 방법을 쓰자 MAI-Base-2의 그래디언트 노름이 MAI-Base-1보다 훨씬 좁은 범위에 머물렀습니다.
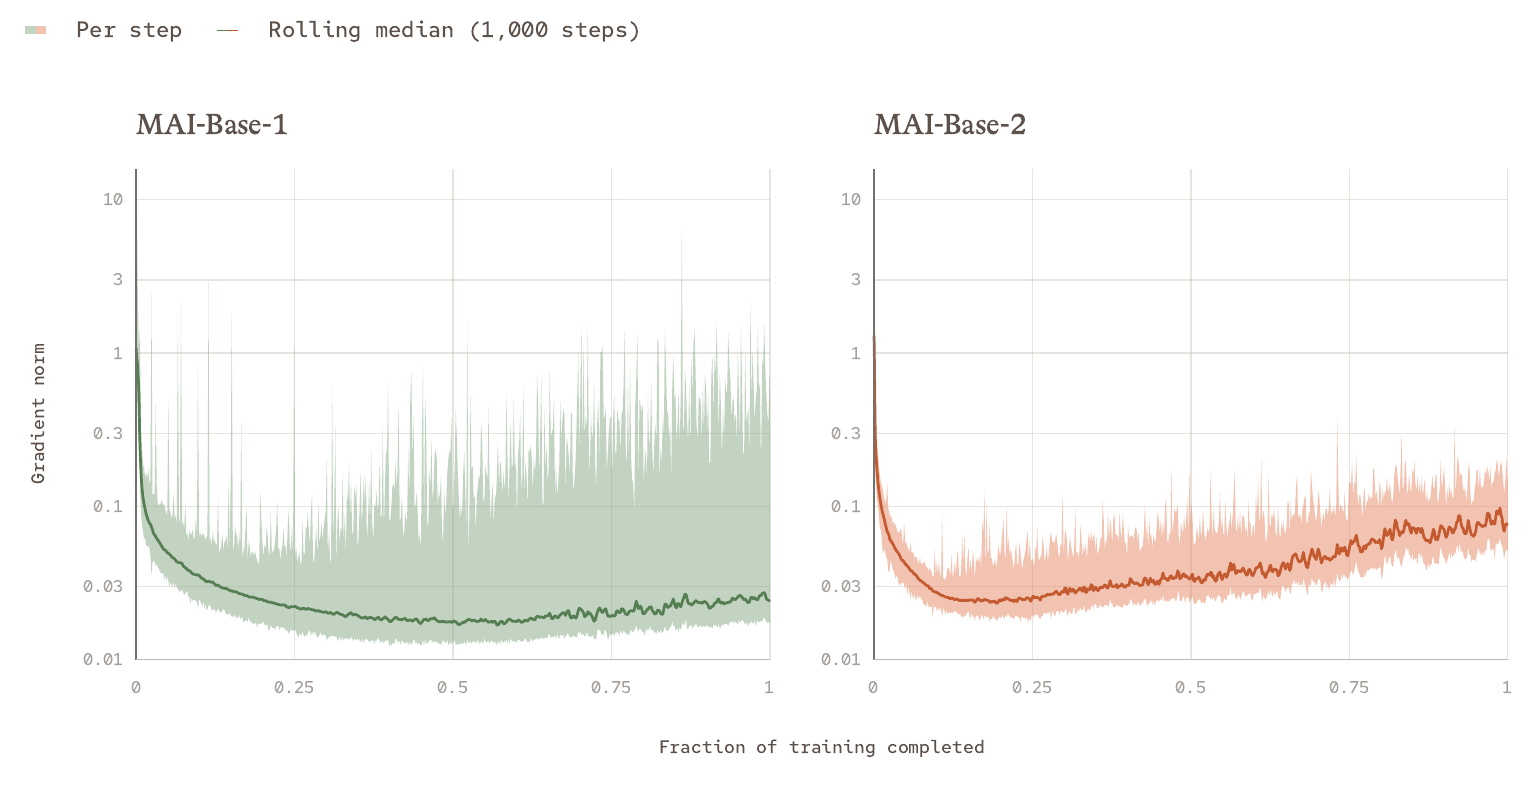
원문은 활성값 그래디언트 클리핑이 최적화를 더 안정시켰고, 그 이득이 규모가 커질수록 늘었다고 보고합니다. 그림 8에서 L18 사다리 모델의 이득은 2% 안팎이지만 L42에서는 28%입니다(웹판 그림 주석에 따르면 L42는 기준 모델을 실제로 학습하지 않고 L12~L36 피팅에서 기준값을 구했습니다). MAI가 실험한 변경 대부분은 규모와 관계없이 이득이 거의 일정했다는 점과 대비됩니다.
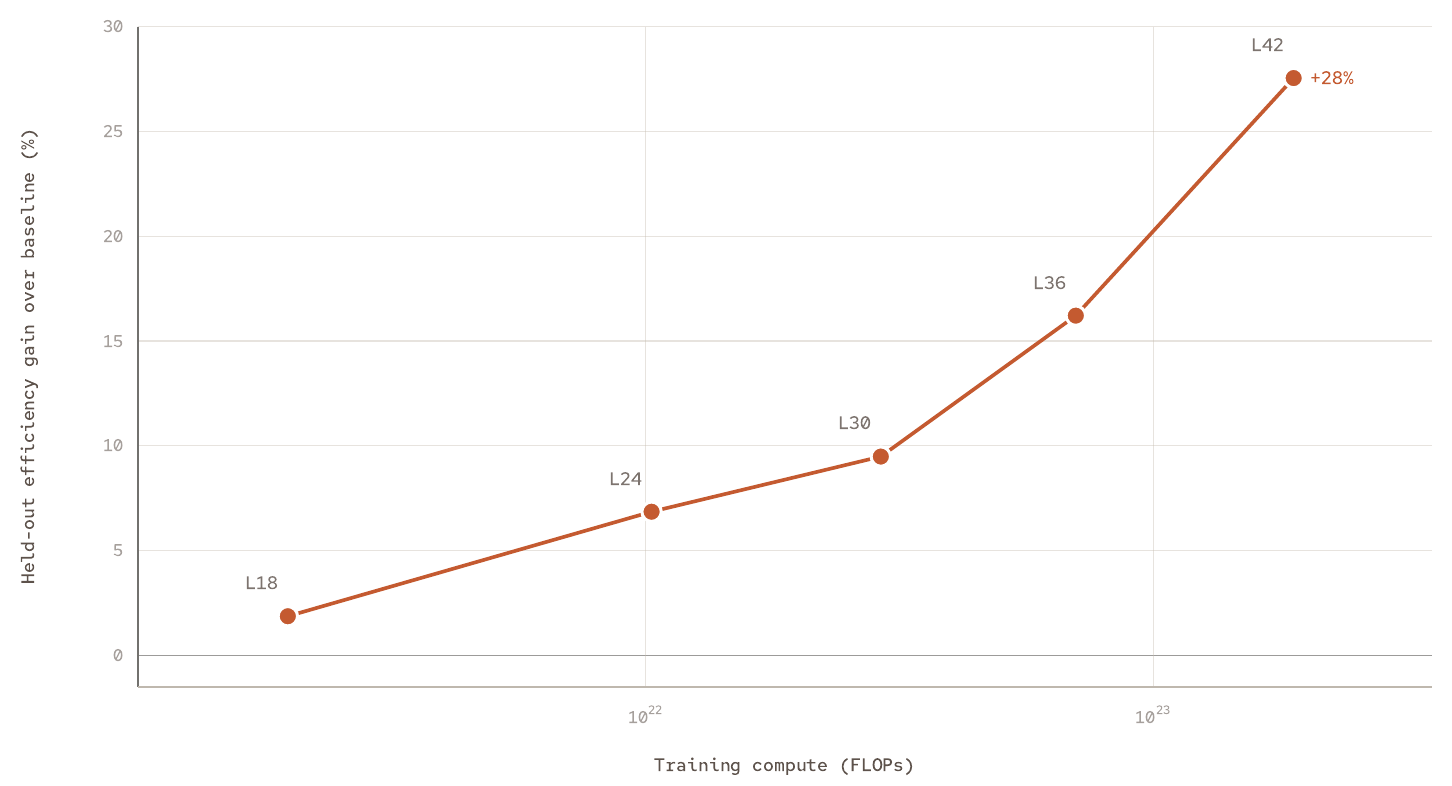
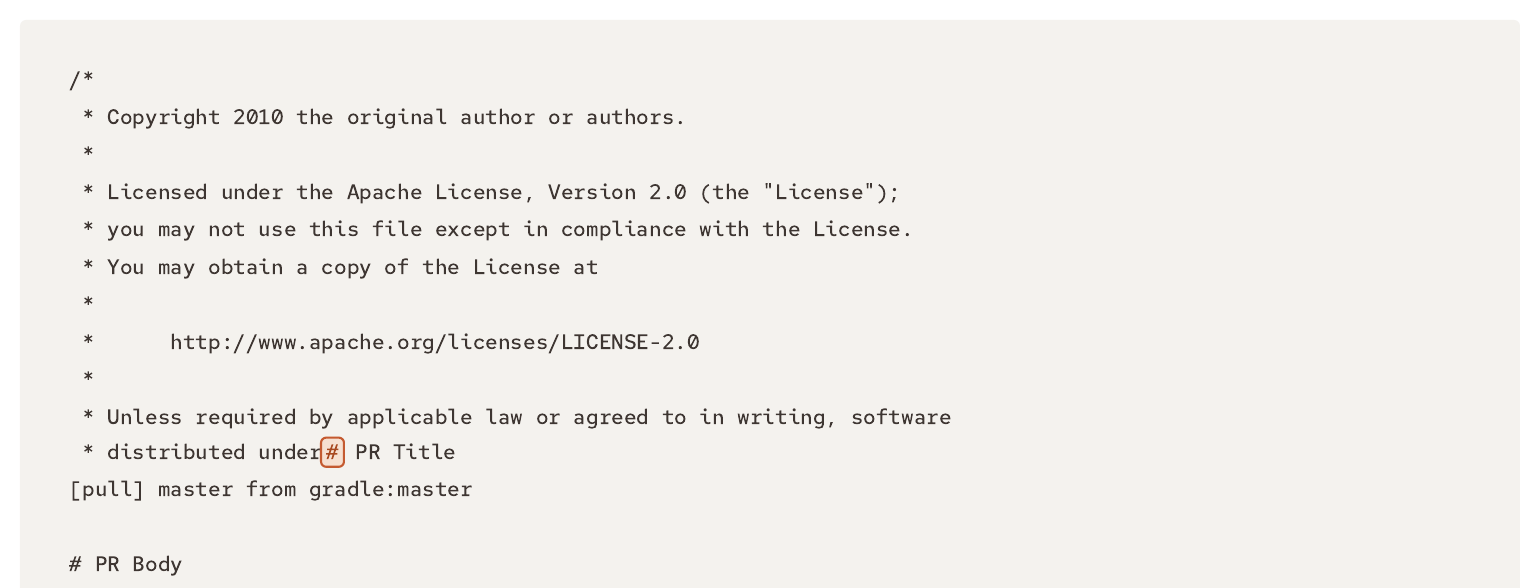
이 클리핑은 학습 데이터를 점검하는 진단 도구로도 쓰였습니다. 그림 9는 클리핑에 걸린 코드 데이터 예제입니다. 풀 리퀘스트(PR) 데이터에서 Apache License 헤더가 문장 중간에 끊기고 바로 # PR Title 이 이어집니다. 강조된 # 토큰에서 활성값 그래디언트가 잘렸고, MAI는 이 예제를 역추적해 전처리 파이프라인의 버그를 찾아 고쳤습니다.
데이터: 증류 없는 50T 토큰과 네이티브 비전
MAI-Base-2는 MAI-Base-1과 같은 데이터 원칙을 따릅니다. 다른 모델에서 증류한 데이터가 아니라 사람이 만든 데이터(Organic Data) 로 학습하고, 모든 학습 토큰을 사내 파이프라인으로 직접 처리했습니다. 원문은 고유 학습 토큰 기준으로 코퍼스가 MAI-Base-1보다 약 36% 늘었다고 밝힙니다(웹판 그림 10의 범주별 수치를 더하면 비전 전용을 뺀 고유 토큰은 11.7T에서 16.4T로 약 40%, 비전 전용을 포함하면 19.2T로 약 63% 늘었습니다, 필자 계산).
MAI-Thinking-1 이후 MAI는 품질 분류, 주제 분류(Topic Binning), 웹 파싱, 중복 제거, 평가 세트 오염 제거를 개선했습니다. MAI-Base-2에서는 훨씬 많은 웹 콘텐츠를 처리하도록 파이프라인을 넓혔고, 지식 기준 시점(Knowledge Cutoff)은 2026년 3월입니다. 임베딩 기반 다양성 샘플링으로 새로운 데이터를 우선하고 중복성 콘텐츠를 줄였습니다. 원문은 이 접근들이 모델 성능을 크게 높였다고 보고합니다.
웹 데이터 수집에 대해 원문 각주는 다음을 밝힙니다. MAI는 자체 크롤러를 쓰며, 이 크롤러는 로봇 배제 표준(robots.txt)과 관련 메타 태그, HTML 설정을 따릅니다. Microsoft 책임 있는 AI 정책을 어기는 출처와 미국 무역대표부(USTR)의 악명 높은 시장(Notorious Markets) 목록에 오른 출처는 제외합니다.
또 하나의 큰 변화는 비전입니다. MAI-Base-1과 달리 MAI-Base-2는 별도 이미지 인코더 없이 이미지를 입력받는 인코더 없는 VLM(Encoder-free VLM) 구조로 처음부터 비전을 함께 학습했습니다. VLM 코퍼스는 이미지-텍스트 쌍과 텍스트와 이미지가 섞인 문서로 이루어집니다. 다루는 작업은 웹 이미지 캡션, 차트 이해, 시각적 위치 찾기(Visual Grounding), 공간 추론, 의료 이해, 컴퓨터 사용, 악보 읽기 등입니다. VLM 코퍼스의 고유 토큰은 4.5T이고, 반복을 포함하면 50T 토큰 학습 혼합의 18%를 차지했습니다. 18%는 약 9T 토큰이므로, VLM 데이터를 평균 2번 정도 반복한 셈입니다(필자 계산).
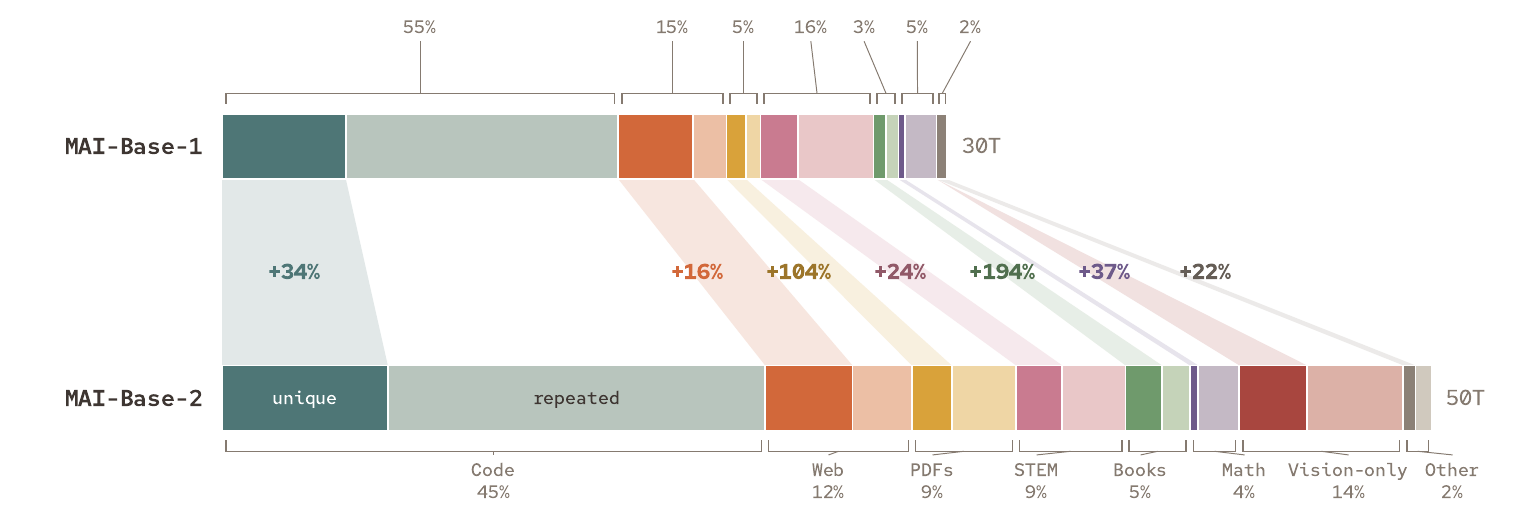
그림 10에서 학습 혼합의 비율 변화를 읽을 수 있습니다. 코드는 55%에서 45%로, STEM은 16%에서 9%로 줄었고, PDF는 5%에서 9%로 늘었습니다. 비전 전용 데이터는 새로 14%를 차지합니다. 고유 토큰 증가율은 코드 +34%, PDF +104%, 책 +194%로 범주마다 차이가 큽니다. 같은 데이터로 범주별 평균 반복 횟수를 계산하면 코드는 고유 6.8T를 약 3.3번, 수학은 고유 0.35T를 약 5.9번, 웹은 약 1.7번 학습했습니다(필자 계산).
이 글을 읽을 때 감안할 점
이 글은 사전학습 방법에 대한 자세한 기록이지만, 결과 수치는 외부에서 검증할 수 없습니다. 아래는 원문 내용을 바탕으로 한 필자의 정리입니다.
- 평가는 모두 비공개 보류 세트입니다. 코드 평가는 MAI 자체 코드베이스이고, 나머지 3종도 외부 업체에 의뢰해 만든 비공개 세트입니다. 오염을 줄이려는 설계이지만, 같은 세트로 다른 모델을 다시 재 볼 수는 없습니다.
- 비교 대상 3개는 사후 학습 모델입니다. MAI가 직접 단서를 달았듯, 사후 학습은 BPB를 바꿀 수 있습니다. 기반 모델끼리의 비교는 DeepSeek-V4-Pro-Base 하나입니다.
- 4~12배 효율은 피팅에 의존하는 추정치입니다. MAI 사다리의 스케일링 곡선과 DeepSeek-V4-Pro-Base의 학습 연산량에 따라 값이 정해지며, 원문은 후자의 값을 숫자로 적지 않았습니다.
- 다운스트림 벤치마크와 가중치가 없습니다. BPB는 다음 토큰 예측 품질의 지표이고, 사후 학습 뒤의 실제 작업 성능은 아직 발표되지 않았습니다. MAI는 MAI-Base-2 위에 만들 다음 세대 모델과 MAI-Base-3 준비를 예고했습니다.
그래서 이 글에서 가져갈 것은 수치보다 방법입니다. 다른 규모의 학습에 옮겨 볼 수 있는 방법은 다음과 같습니다:
- 소스 스케일링으로 반복 데이터를 사다리 실험에 반영하기
- (\log LR, \log(LR \times WD)) 격자로 학습률과 가중치 감쇠를 함께 탐색하기
- 메모리를 고정한 다회차 Dropless MoE
- ZeRO 환경에서 Muon 모멘텀을 재분할하기
- 활성값 그래디언트 클리핑을 학습 데이터 디버깅에 쓰기
 Frontier Pre-training at Microsoft AI 블로그
 Frontier Pre-training at Microsoft AI PDF
더 읽어보기
-
MAI-Thinking-1 기술 보고서: 데이터 파이프라인부터 RL 인프라까지, 프런티어 모델 학습의 전 과정을 해부한 '힐 클라이밍 머신' (feat. Microsoft AI)
-
DeepSeek, 100만 토큰 컨텍스트를 효율적으로 지원하는 MoE 모델 DeepSeek-V4-Pro 및 DeepSeek-V4-Flash 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
