핵심 요약
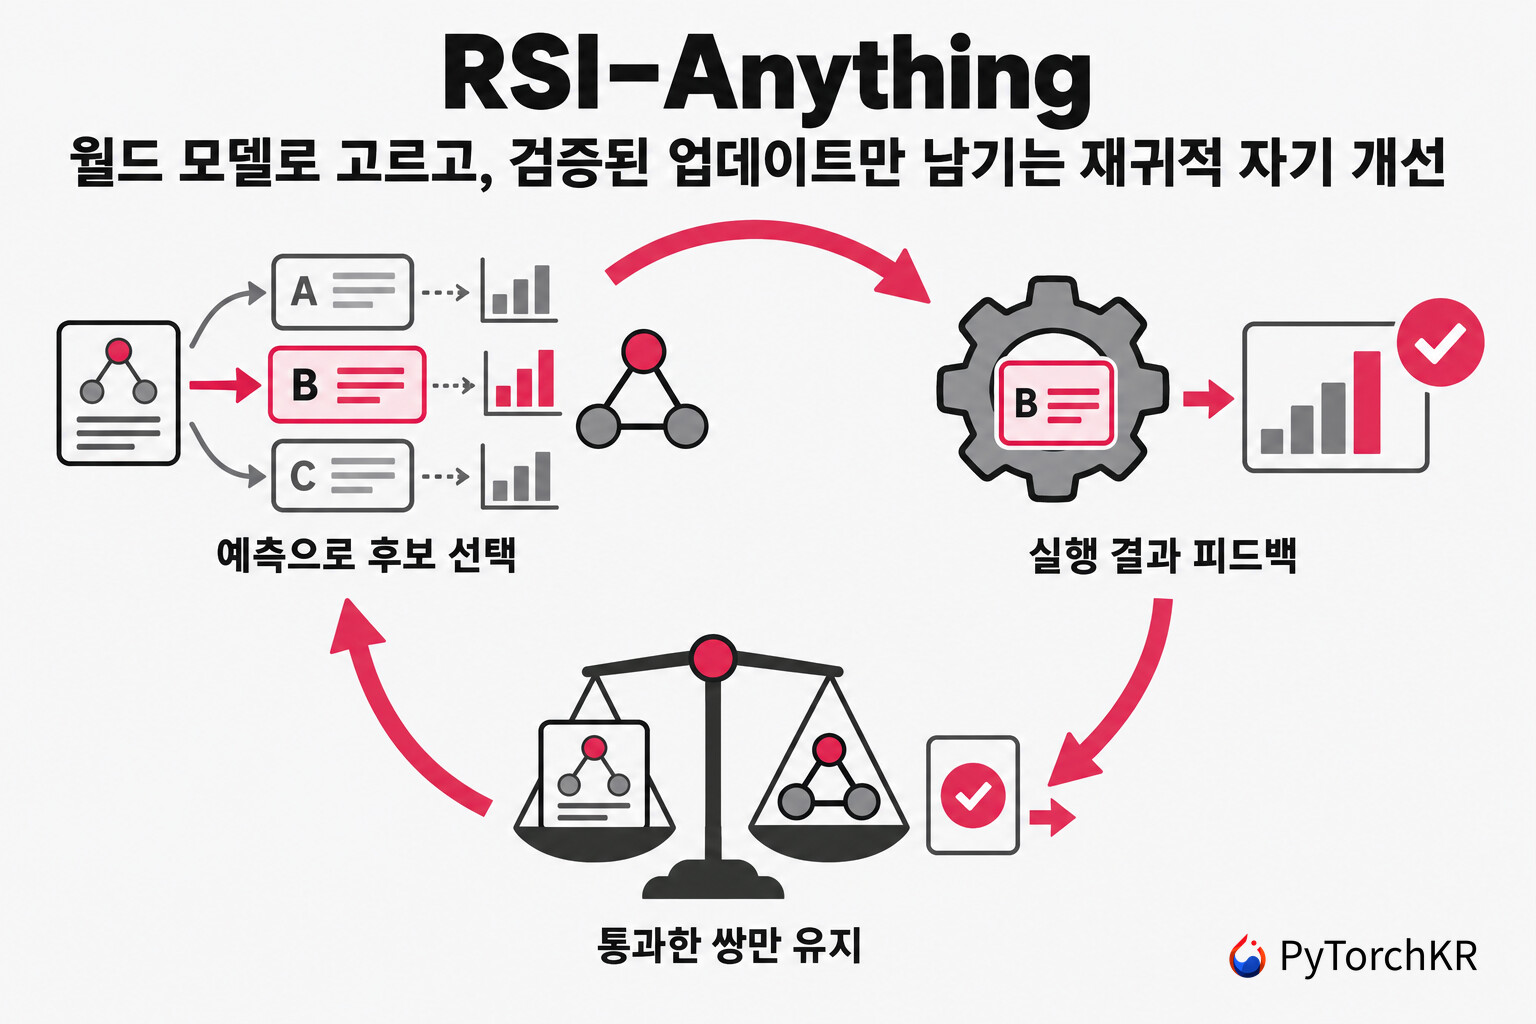
- RSI-Anything 논문은 정책이 낸 후보 중 실제로 실행할 것을 월드 모델의 예측으로 고르는 재귀적 자기 개선 프레임워크를 제안합니다. 실행 피드백으로 정책과 월드 모델을 갱신하고, 두 검사를 통과한 정책과 모델 쌍만 다음 라운드에 남깁니다.
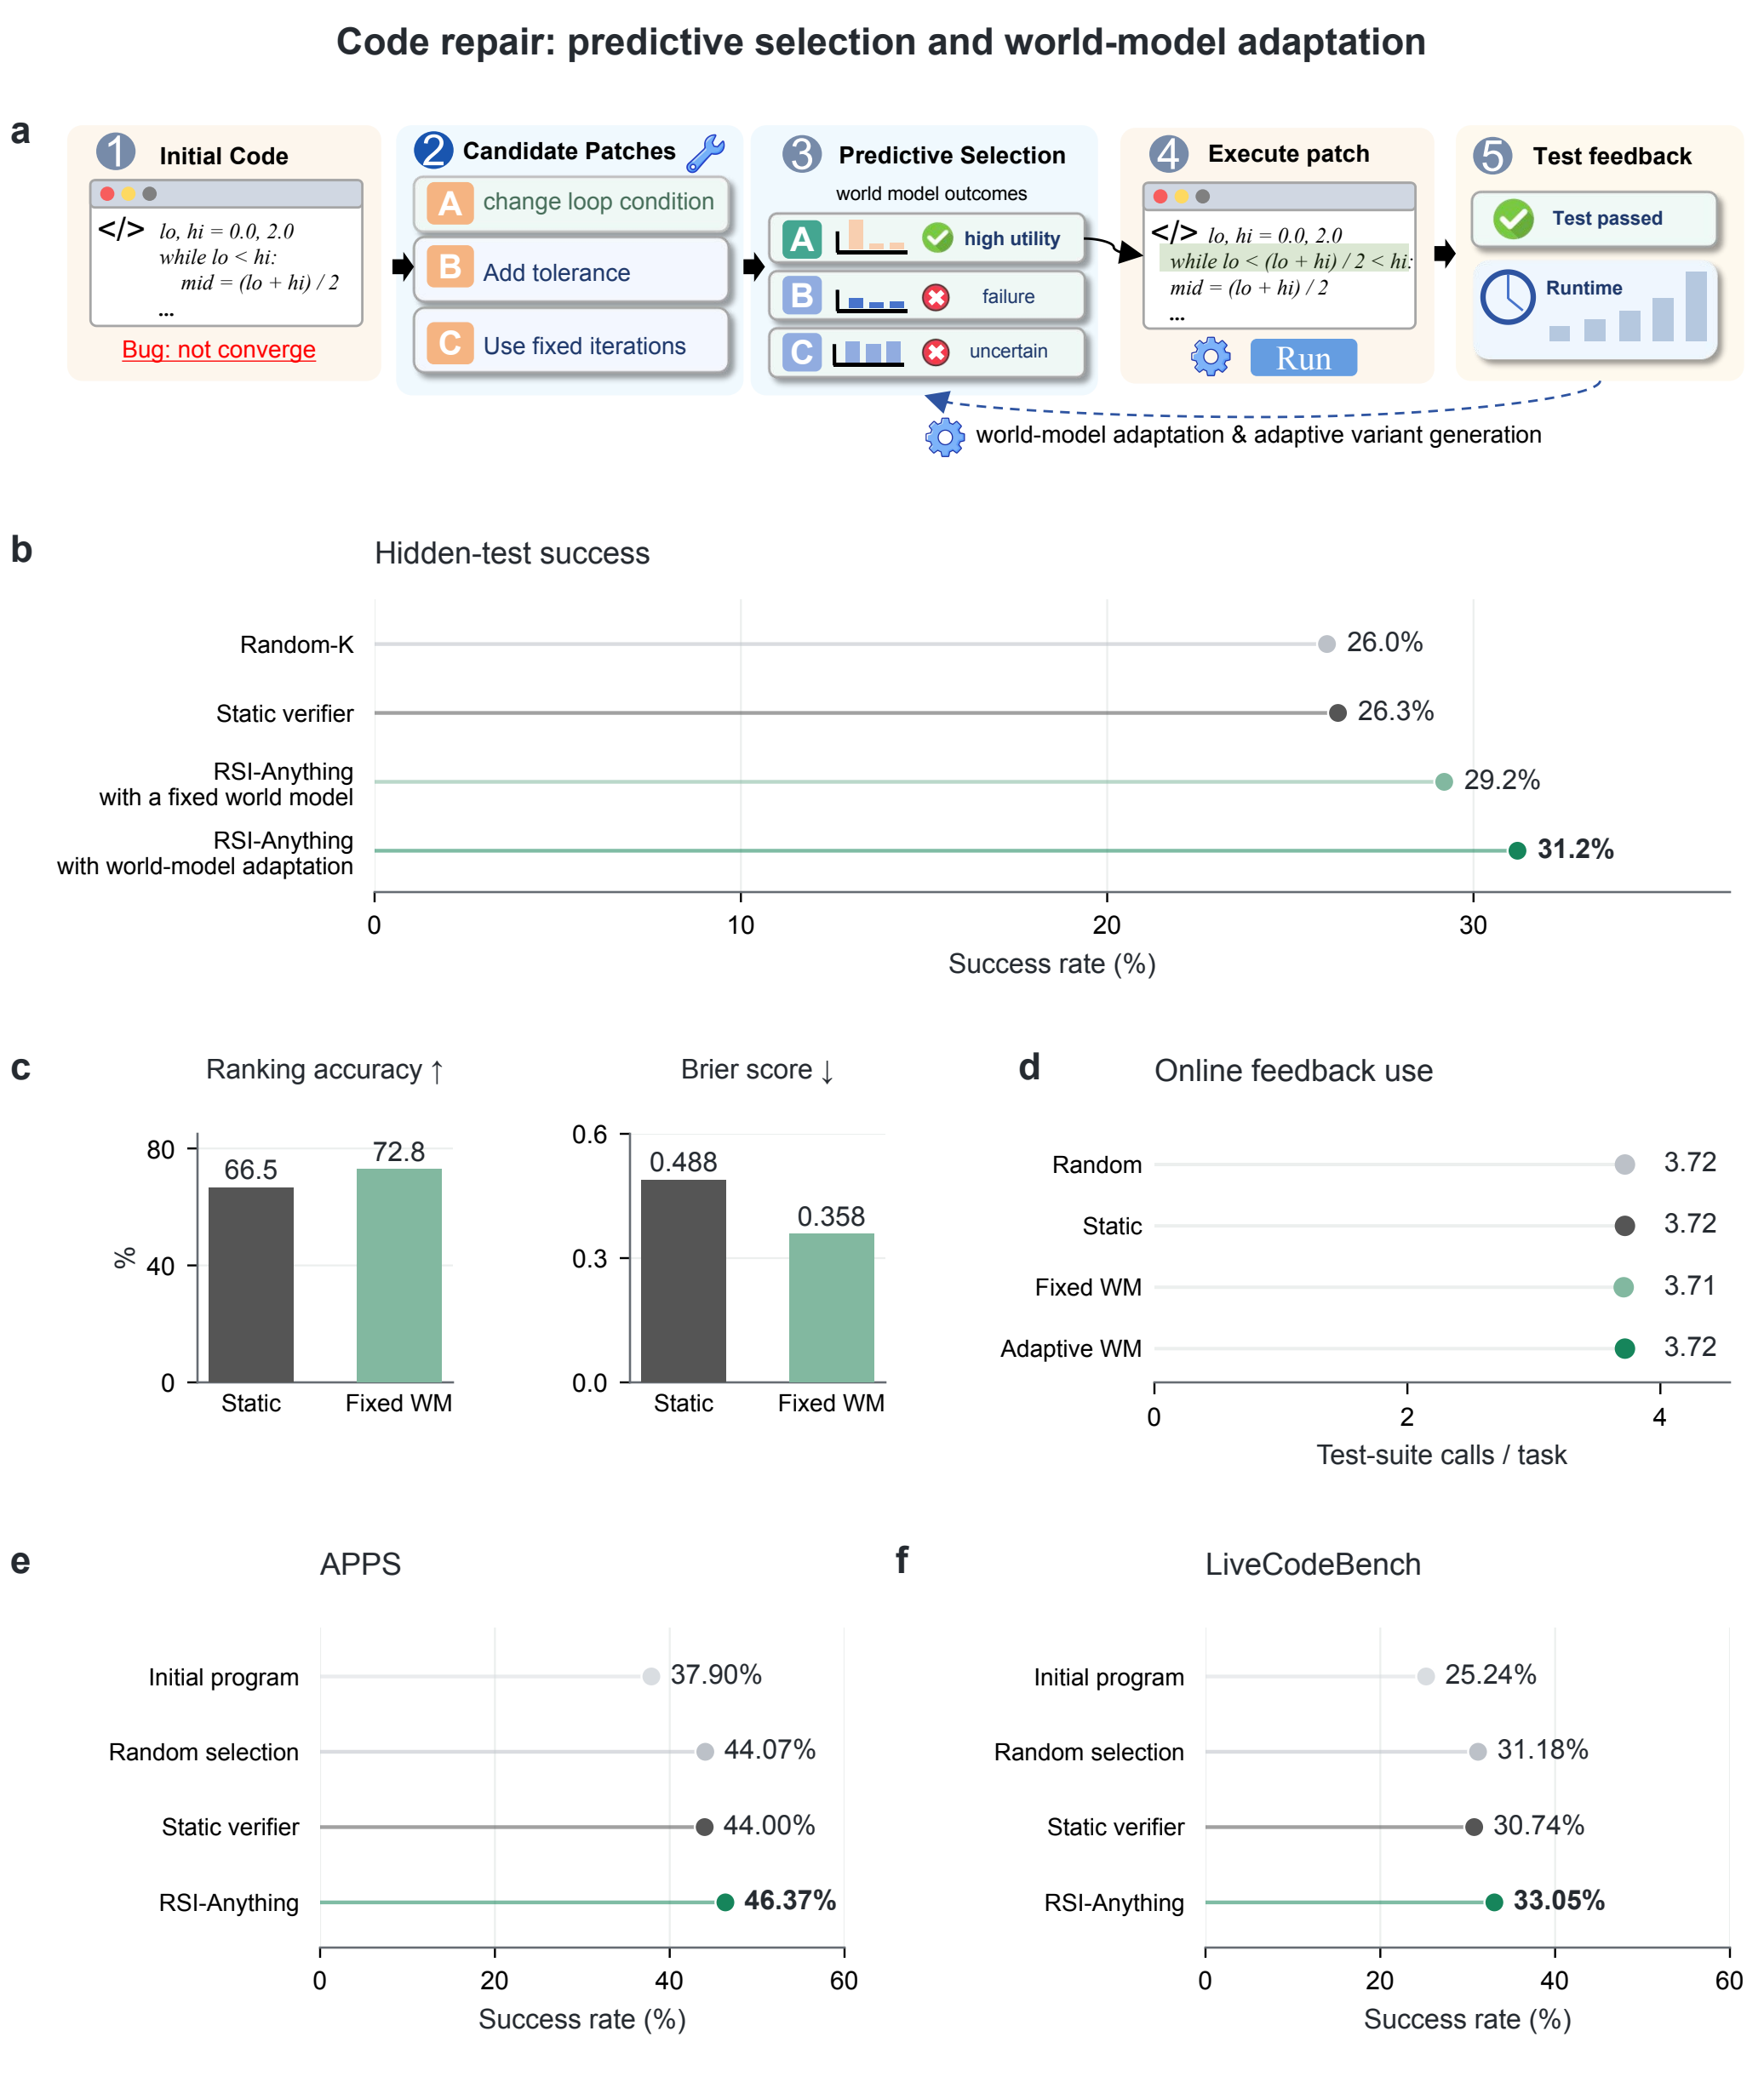
- 코드 복구 실험에서 코더 모델을 고정한 채 정적 검증기 26.3\% → 월드 모델 선택 29.2\% → 월드 모델 적응 31.2\% 로 성공률이 올랐고, 실행한 테스트 호출 수는 과제당 약 3.7 회로 같았습니다.
- RSI-Anything GitHub 저장소의 결과 기록을 보면 평가 조건이 도메인마다 다릅니다. 반응 최적화는 이미 측정된 수율 표를 다시 꺼내 보는 오프라인 평가이고, GUI의 99\% 는 월드 모델이 아니라 정책 순위를 따르는 실행 규칙에서 나온 값입니다.
- 정책과 월드 모델이 한 과제 안에서 여러 라운드에 걸쳐 서로를 계속 개선하는지 확인하려면 여러 라운드의 공동 평가가 더 필요하다고 저자들이 직접 밝혔으며, 면역학 응용의 추론 코드는 공개 예정(Coming soon) 상태입니다.
RSI-Anything 소개
RSI-Anything은 재귀적 자기 개선(RSI, Recursive Self-Improvement) 프레임워크로, PhAI Labs와 홍콩중문대학교(CUHK), 마카오대학교, 상하이교통대학교, 푸단대학교, 옥스퍼드대학교, 스탠퍼드대학교, 베이징대학교의 연구자들이 공개했습니다. 이 논문은 외부 피드백이 비싼 환경에서 월드 모델(world model) 의 예측으로 실제로 실행해 볼 후보를 고르는 방법을 다룹니다. 그 실행 결과로 정책과 월드 모델을 함께 고쳐 나갑니다. 여기서 월드 모델은 어떤 행동을 했을 때 결과가 어떻게 될지를 미리 예측하는 모델을 말합니다.
피드백은 비싸고, 정책이 바뀌면 월드 모델의 예측을 믿기 어려워질 수 있습니다
재귀적 자기 개선은 상호작용에서 얻은 경험을 다음 라운드의 행동과 학습에 남기는 과정입니다. PyTorchKR에서 앞서 정리한 재귀적 자기 개선 서베이 1편과 2편처럼, 이 분야는 추론과 코드 개선에서 시작해 에이전트 자체와 그 학습 환경을 고치는 쪽으로 넓어지고 있습니다.
기존 접근의 상당수는 외부 피드백에 의존해 개선합니다. CURE는 코더와 단위 테스트 생성기를 함께 강화학습하고, Darwin Gödel Machine은 에이전트 구현 자체를 고쳐 가며 검증된 개선만 남깁니다. RLAnything은 정책과 보상 모델과 환경을 함께 최적화하고, OpenClaw-RL은 사용자 대화와 도구 피드백으로 온라인 학습합니다. 하지만 이 방식은 후보를 실제로 실행하거나 평가해야 결과를 알 수 있습니다. 코드라면 테스트를 실행해야 하고, 화학이라면 실험을 해야 합니다. 상호작용 예산이 정해져 있으면 시도할 수 있는 후보 수가 그만큼 줄어듭니다.
다른 한쪽에는 World Models, MuZero, Dreamer처럼 행동의 결과를 미리 예측하는 월드 모델 연구가 있습니다. 예측이 정확하면 실행 전에 후보를 걸러 피드백 예산을 아낄 수 있습니다. 그런데 자기 개선 루프 안에 월드 모델을 넣으면 새로운 문제가 생깁니다. 저자들은 이를 결합 갱신(coupled-update) 문제라고 부릅니다. 정책이 바뀌면 월드 모델이 다루는 후보와 경험의 분포가 바뀌어 예측의 신뢰도가 떨어질 수 있고, 반대로 월드 모델이 바뀌면 후보의 순위와 학습 신호가 바뀝니다. 그래서 정책이나 월드 모델 하나만 따로 좋아져도 둘을 합친 시스템이 좋아진다는 보장이 없습니다.
정책과 월드 모델을 한 쌍으로 갱신하고 검사합니다
RSI-Anything의 출발점은 개선의 단위를 정책 하나가 아니라 정책과 월드 모델의 쌍으로 잡는 것입니다. 각 라운드는 다음 순서로 진행됩니다. 정책이 후보를 여러 개 내면, 월드 모델이 각 후보의 결과를 예측합니다. 예측 효용이 가장 높은 후보만 실제로 실행해 피드백을 받습니다. 그 피드백으로 정책을 갱신하고, 월드 모델의 예측이 믿기 어려워졌을 때만 월드 모델을 갱신합니다. 마지막으로 갱신된 정책과 모델이 각자의 검사와 둘 사이의 호환성 검사를 통과해야 다음 라운드에 남습니다.
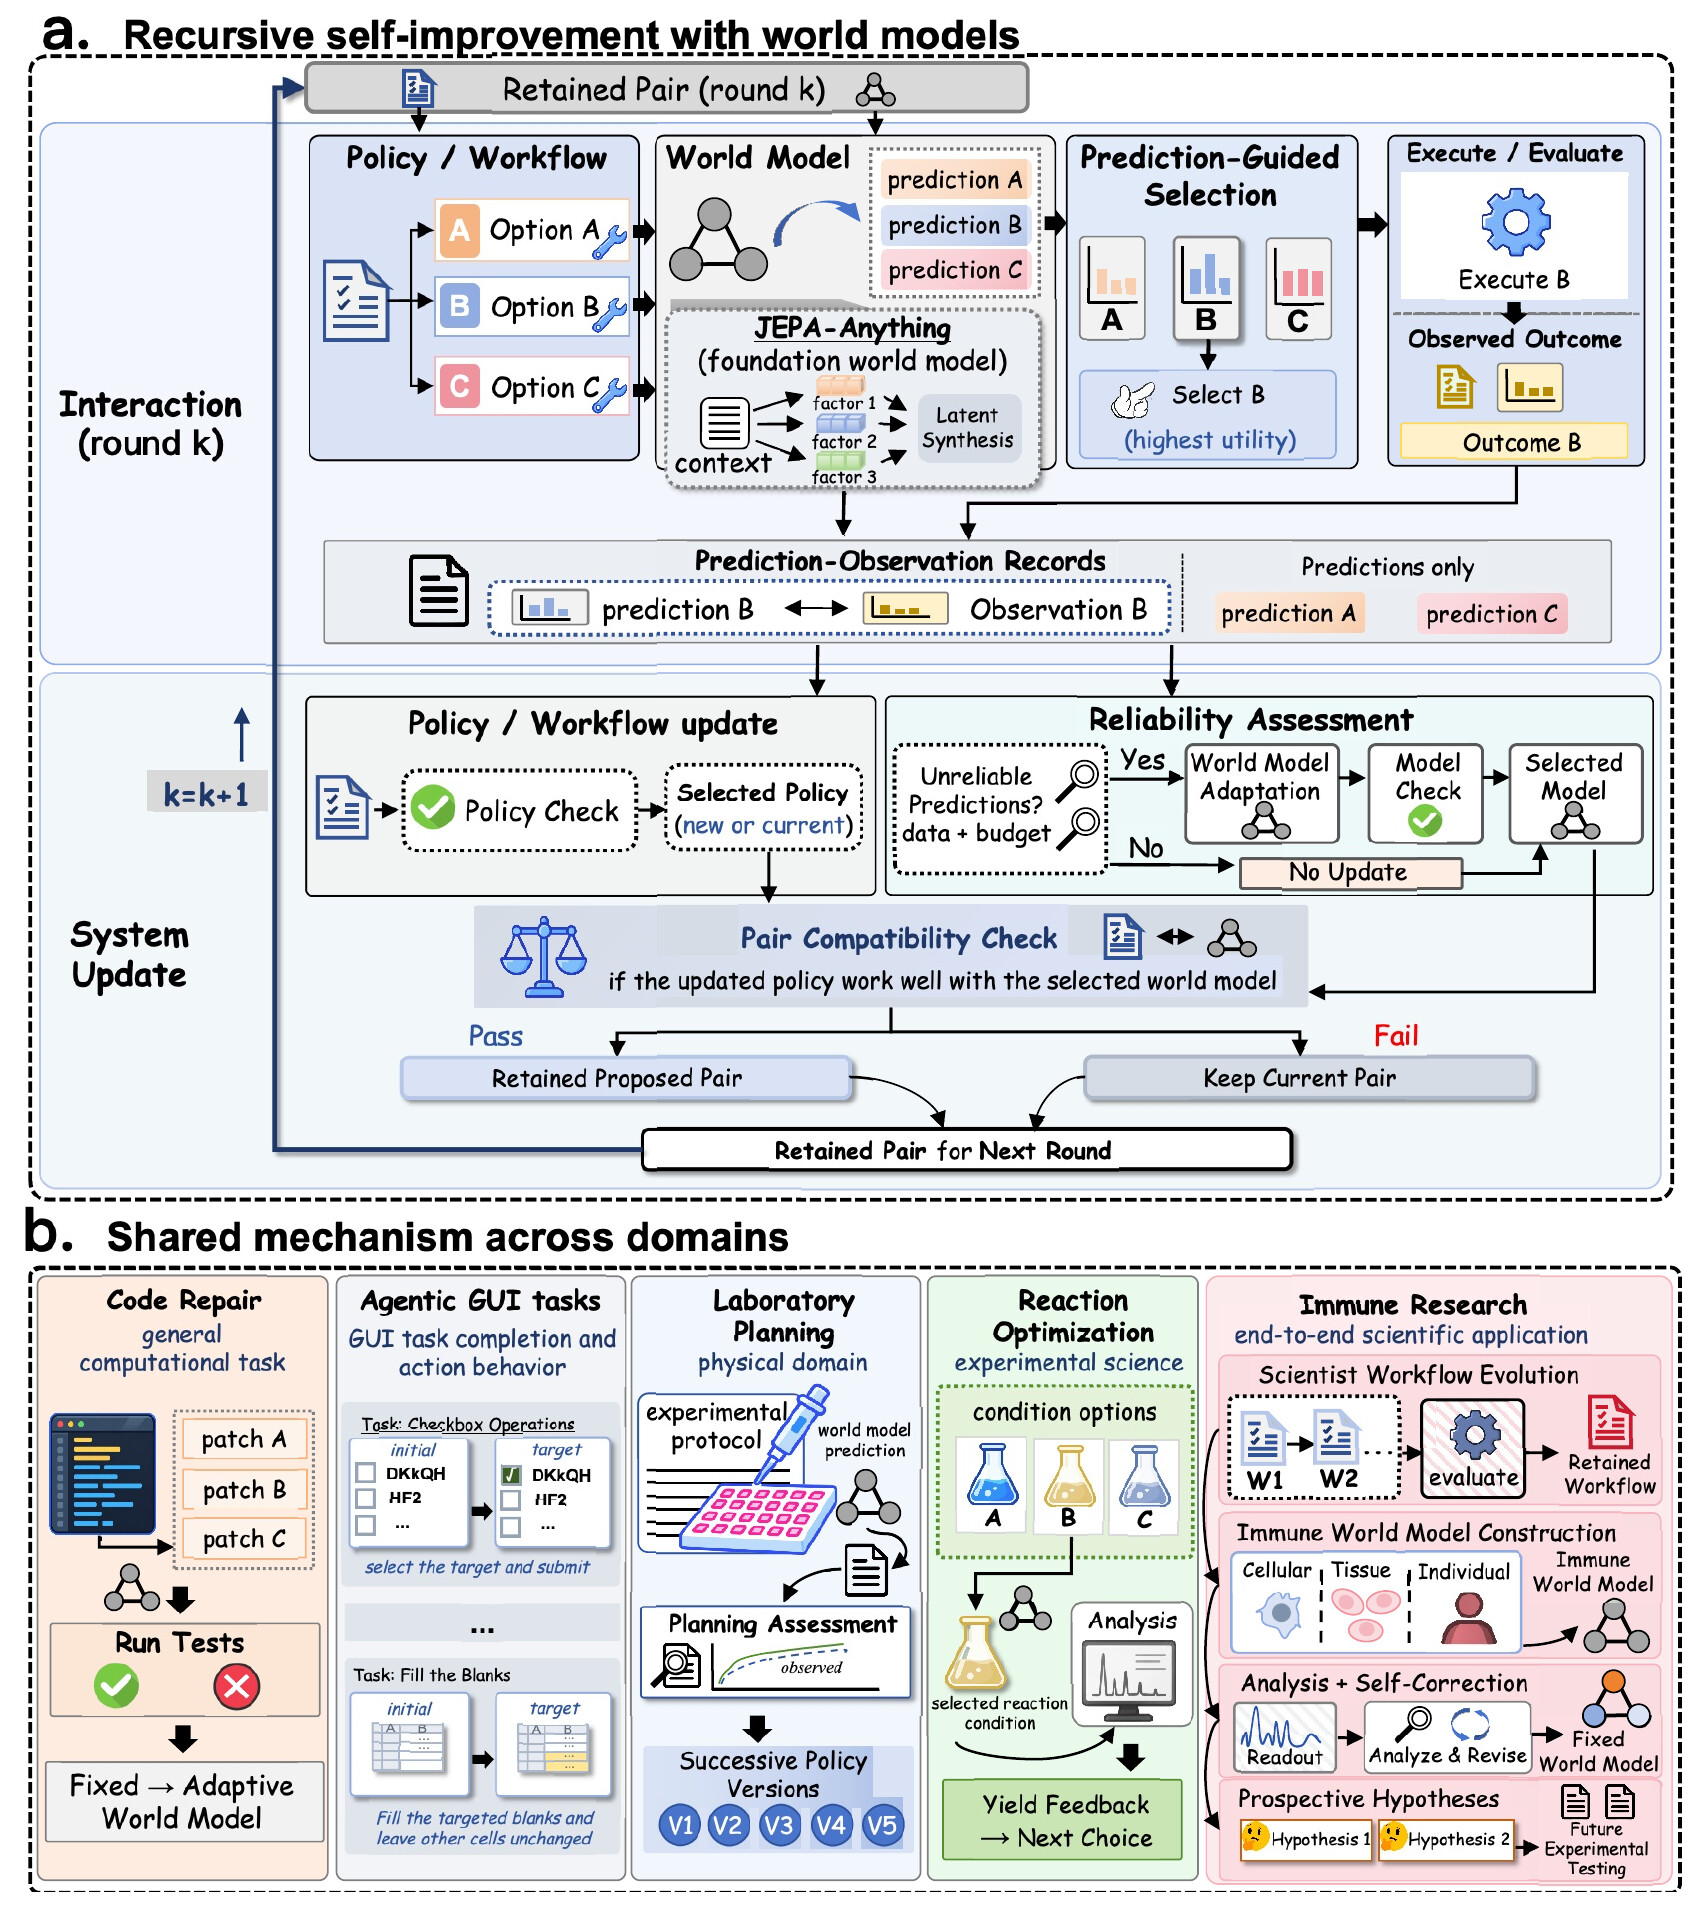
이 구조를 저자들은 코드 복구, GUI 조작, 실험실 계획, 화학 반응 조건 최적화, 면역학 연구의 다섯 도메인에 적용했습니다. 논문의 초록은 여러 계산 및 과학 도메인에서 "substantial gains"를 보였다고 정리합니다. 다만 아래에서 살펴보듯 도메인마다 실제로 갱신한 구성요소와 평가 방식이 꽤 다르므로, 숫자는 도메인별 조건과 함께 읽어야 합니다.
RSI-Anything의 동작 방식
예측의 기반: JEPA-Anything과 직교 예측 분해(OPF)
RSI-Anything의 월드 모델은 같은 연구진이 앞서 공개한 JEPA-Anything을 기반으로 합니다. JEPA-Anything은 V-JEPA와 같은 결합 임베딩 예측 아키텍처(JEPA, Joint-Embedding Predictive Architecture)를 확장한 것입니다. JEPA는 관측을 픽셀 단위로 복원하지 않고, 관측된 문맥에서 목표의 잠재 표현을 예측하도록 학습합니다.
JEPA-Anything의 핵심은 직교 예측 분해(OPF, Orthogonal Predictive Factorization) 입니다. OPF는 잠재 목표를 서로 보완하는 여러 인자(factor)로 나누고, 인자마다 전용 예측기를 학습한 뒤, 그 출력을 다시 합쳐 완전한 잠재 상태를 만듭니다. RSI-Anything에서 사이클 k 의 월드 모델 \phi_{d,k} 는 상태 s_t 와 도메인 문맥 c_d 를 인코딩하고, 후보 행동 a_t 가 주어졌을 때 다음 잠재 상태를 예측합니다.
예측한 잠재 상태 \hat{z}_{t+1} 은 판독기(readout) R 을 거쳐 실제로 비교할 수 있는 결과 예측으로 바뀝니다. 판독기는 도메인에 따라 점 예측(예: 수율 하나)을 내기도 하고 확률 분포(예: 코드 실행 결과 다섯 가지 클래스의 확률)를 내기도 합니다.
예측으로 실행할 후보 고르기
현재 정책 \theta_k 가 상태 s_t 와 목표 g 에서 후보 집합을 제안하면, 각 후보는 결과 예측을 받습니다. 검증기는 후보의 유효성, 효용 구성요소, 근거의 출처, 불확실성을 기록합니다. 유효하지 않은 후보는 순위를 매기기 전에 빠지고, 남은 후보는 다음 점수로 순위가 정해집니다.
여기서 \Delta_d 는 불확실성 벌점을 켰을 때만 \lambda_d U(\mathbf{u}_\tau) 가 되고, 끄면 0 입니다. 선택은 남은 피드백 예산 안에서 평가 비용을 감당할 수 있는 후보를 돌려줍니다. 예를 들어 코드 복구에서는 수정안 네 개의 실행 결과 클래스 확률을 모아 순위를 매긴 뒤, 그중 하나만 실제로 실행합니다. 상태 전이까지 예측하는 인터페이스가 있는 도메인에서는 정해진 길이의 여러 단계 롤아웃으로 후보를 평가할 수도 있습니다.
RSI-Anything은 근거의 출처도 등급으로 나눕니다: 결정적 규칙 검사(E0), 학습된 모델의 예측과 롤아웃(E1), 전문 시뮬레이터나 더 정밀한 계산(E2), 외부 측정과 실험(E3)입니다. 예측값과 관측값은 각자의 출처를 따로 보존합니다. 월드 모델이 상상한 궤적을 학습 데이터로 쓰는 경우에는, 유효성과 최소 효용과 불확실성 상한과 허용된 근거 출처라는 네 조건을 모두 만족하는 궤적만 학습에 들어갑니다.
피드백으로 정책과 월드 모델 갱신하기
외부 피드백은 예측과 관측의 쌍으로 기록되고, 그 예측을 낸 시스템 버전도 함께 남습니다. 이 기록에서 정책 개선용 데이터와 월드 모델 적응용 데이터를 따로 고릅니다. 정책 개선은 후보를 만들거나 고르는 방식을 바꾸고, 월드 모델 적응은 그 결과를 예측하는 방식을 바꿉니다.
정책 갱신의 형태는 도메인마다 다릅니다. 시연 기반 학습은 선택된 행동이나 궤적을 정답으로 쓰고, 선호 학습은 평가된 결과로 대안을 비교하며, 워크플로우 탐색은 평가 피드백으로 에이전트 워크플로우 구성의 순위를 매깁니다.
월드 모델 갱신에는 조건이 붙습니다. 먼저 현재 모델 버전이 낸 예측만으로 신뢰도를 평가합니다. 이전 버전의 예측은 과거 결정을 분석하는 데만 쓰고 현재 오차 추정에는 섞지 않습니다. 평가 결과는 신뢰함(reliable), 신뢰할 수 없음(unreliable), 판단 불충분(insufficient) 셋 중 하나입니다.
즉 월드 모델 적응은 ⓐ 예측이 신뢰할 수 없다고 판정되고 ⓑ 적응에 쓸 데이터가 충분하며 ⓒ 남은 예산이 적응 비용을 감당할 수 있을 때만 시도합니다. 피드백은 선택된 후보에서만 나오므로, 관측이 덮지 못한 후보 범위에 대해서는 판단 불충분으로 처리하고 적응을 시작하지 않습니다. 관측이 부족한 것을 예측이 믿을 만하다는 증거로 착각하지 않으려는 장치입니다.
구성요소 검사와 쌍 호환성 검사로 남길 버전 정하기
갱신 후보가 만들어지면 RSI-Anything은 두 단계로 검사합니다. 먼저 구성요소 검사에서 새 정책은 과제 효용과 제약을, 새 월드 모델은 관련 목표에 대한 예측 품질을 현재 버전과 비교합니다. 통과한 구성요소만 다음 검사로 갑니다.
다음은 쌍 호환성 검사입니다. 저자들은 이 검사가 필요한 이유를 이렇게 설명합니다: 개선된 정책이 개선된 월드 모델이 잘 예측하지 못하는 후보를 낼 수 있고, 개선된 월드 모델이 선택되는 후보 자체를 바꿀 수 있습니다. 그래서 조립한 새 쌍과 현재 쌍을 같은 평가 조건에서 비교하고, 새 쌍이 미리 정한 기준을 넘을 때만 교체합니다. 쌍 검사에 실패하면 현재 쌍 전체를 유지합니다.
| 대상 | 변경 규칙 | 다음 라운드로 넘어가는 것 |
|---|---|---|
| 과제와 평가 명세 | 실행 내내 고정 | 목표, 인터페이스, 평가 기준, 제약, 예산 한도, 수락과 중단 규칙 |
| 과제 상태와 경험 | 행동과 관측이 상태를 바꾸고 예측과 관측 기록을 늘림 | 현재 상태, 누적 기록 |
| 정책 구성 | 피드백으로 후보 버전을 만들고 구성요소 검사와 쌍 검사로 수락 | 수락된 정책, 아니면 현재 버전 |
| 월드 모델 | 신뢰도 하락, 충분한 데이터, 예산이 적응을 촉발하고 두 검사로 수락 | 수락된 예측기, 아니면 현재 버전 |
갱신용 데이터는 후보 버전을 만들고, 게이트용 데이터는 남길 버전을 고르며, 별도로 지정한 감사용 데이터는 최종 보고에만 씁니다. 남은 쌍이 다음 라운드의 후보와 학습 경험을 바꾸고, 그 경험이 다시 다음 갱신의 재료가 된다는 점이 저자들이 말하는 "재귀"의 의미입니다.
도메인별 실험 결과
저자들은 실험에서 세 가지를 물었습니다: 월드 모델 예측이 후보 선택을 개선하는가, 남긴 갱신이 추가 개선을 내는가, 이 개선이 제한된 피드백 안에서 가능한가. 아래에서는 논문의 수치와 함께, GitHub 저장소의 결과 문서에서 확인한 평가 조건을 도메인별로 정리했습니다.
코드 복구: 예측 선택과 월드 모델 적응이 각각 약 2~3%p를 보탰습니다
코드 복구에서는 ReasonFlux-Coder-7B를 정책(코더)으로 고정하고, 한 라운드에 수정안 네 개를 받아 하나만 실행하게 했습니다. 월드 모델 W1은 Qwen2.5-Coder-3B-Instruct에 LoRA를 붙여 JEPA-Anything 방식으로 만든 3B 실행 결과 예측 모델이며, 후보와 테스트 쌍마다 실행 결과 다섯 클래스의 확률을 냅니다. 평가는 CodeContests 200문제를 시드 3개로 돌린 600회이고, 최대 3라운드까지 공개 테스트로 피드백을 받은 뒤 숨김 테스트로 최종 성공을 판정합니다.
| 선택 방법 | 숨김 테스트 통과율 | 과제당 온라인 테스트 호출 |
|---|---|---|
| 무작위 선택(Random-K) | 26.0\% | 3.72 |
| 용량을 맞춘 정적 검증기 | 26.3\% | 3.72 |
| RSI-Anything, 고정 월드 모델(CURE-WM-Lite) | 29.2\% | 3.71 |
| RSI-Anything, 월드 모델 적응 | 31.2\% | 3.72 |
고정 월드 모델은 정적 검증기보다 숨김 테스트 성공률을 2.83\%p 높였고, 저자들이 보고한 95\% 구간은 [+0.17, +5.50] 입니다. 구간의 아래쪽 끝이 0에 가깝다는 점은 함께 봐야 합니다. 같은 비교에서 후보 순위 정확도는 66.5\% 에서 72.8\% 로, 다섯 클래스 Brier 점수(확률 예측의 오차, 낮을수록 좋음)는 0.488 에서 0.358 로 좋아졌습니다. 월드 모델 적응은 여기에 2.0\%p 를 더 보탰지만, 이 차이에 대한 구간은 논문에 없습니다.
APPS Introductory(1,000문제)와 LiveCodeBench v6(1,055문제)에서도 같은 코더와 예산으로 비교했습니다. 논문 본문은 RSI-Anything의 값(46.37\%, 33.05\%)만 적었고, 비교 대상의 값은 그림에만 있습니다.
| 벤치마크 | 초기 프로그램 | 무작위 선택 | 정적 검증기 | RSI-Anything |
|---|---|---|---|---|
| APPS Introductory | 37.90\% | 44.07\% | 44.00\% | 46.37\% |
| LiveCodeBench v6 | 25.24\% | 31.18\% | 30.74\% | 33.05\% |
무작위 선택 대비 차이는 각각 2.30\%p 와 1.87\%p 입니다. 초기 프로그램 대비 개선의 대부분은 수정 루프를 실행하는 것 자체에서 나오고, 월드 모델 선택은 그 위에 몇 %p를 더합니다.
저장소의 재현 문서에서 확인한 조건도 있습니다. 월드 모델 적응 설정의 체크포인트는 학습 분할의 실행 기록으로 네 단계(초기 JEPA, 실행 품질 적응, 확장 학습, 현재 프로그램 대비 쌍 학습)를 순서대로 학습해 만든 것이고, 평가 중에는 옵티마이저 갱신을 하지 않습니다. 즉 600회 평가 도중에 월드 모델이 실시간으로 바뀌는 것이 아니라, 평가 전에 실행 피드백으로 미리 적응시킨 모델을 고정해 씁니다. 기록된 실행 환경은 NVIDIA A800 80GB 8장, PyTorch 2.9.1입니다.
GUI 조작: 성공률 99%는 정책 순위를 따르는 실행 규칙의 값입니다
GUI 실험은 지정된 체크박스를 고르고 제출하는 MiniWoB++의 click-checkboxes 과제와, 데스크톱 과제 벤치마크 OSWorld에서 진행했습니다. 이 도메인에서는 상호작용 피드백으로 정책과 월드 모델을 모두 갱신했습니다. Hugging Face에 공개된 체크박스 과제의 정책은 ReasonFlux-Coder-7B에 붙인 어댑터입니다.
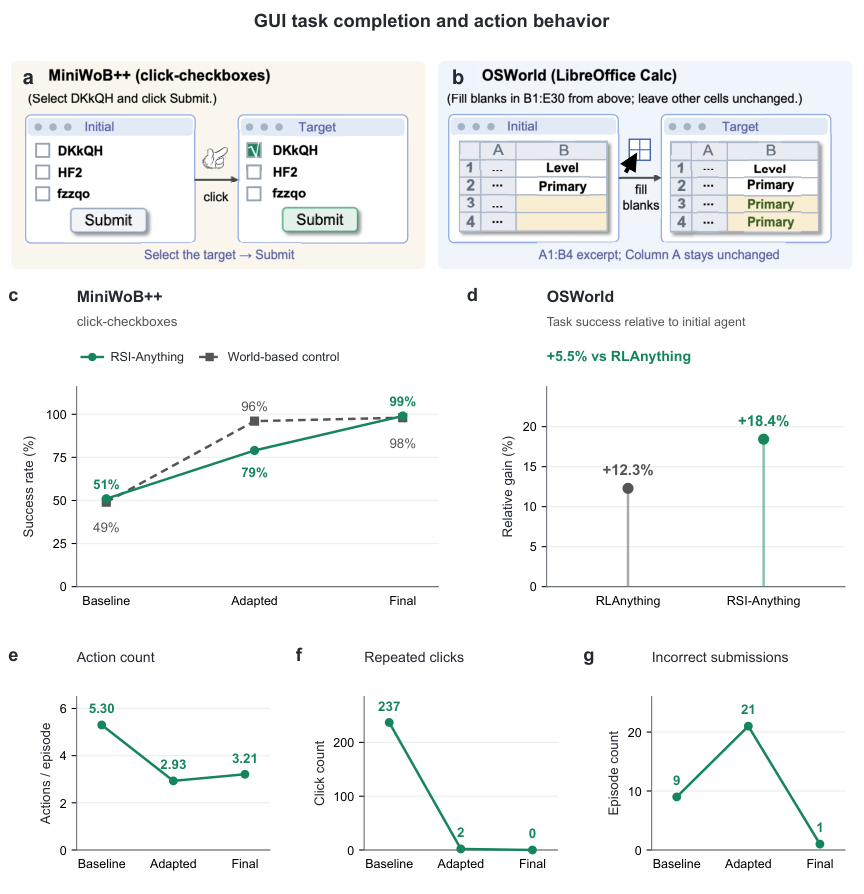
체크박스 과제는 120초 안에, 제출을 포함해 최대 8번의 행동으로 모든 체크박스를 지시대로 맞추고 제출해야 성공으로 칩니다. 성공률은 기준선 51\% 에서 1차 갱신 후 79\%, 최종 99\% 로 올랐습니다. 에피소드당 평균 행동 수는 5.30 에서 3.21 로 39.4\% 줄었고, 반복 클릭은 237회에서 0회로, 잘못된 제출은 9회에서 1회로 줄었습니다. 중간 버전은 행동 수가 2.93 으로 가장 적었지만 잘못된 제출이 21회로 가장 많았습니다. OSWorld에서는 초기 에이전트 대비 상대 성공률이 RSI-Anything 18.4\%, RLAnything 12.3\% 올랐고, RLAnything 대비로는 5.5\% 높았습니다. 다만 논문과 저장소 문서에는 OSWorld의 절대 성공률과 평가에 쓴 과제 수가 나와 있지 않습니다.
저장소의 GUI 결과 문서에는 이 숫자를 읽는 데 필요한 조건이 더 있습니다:
- 헤드라인 51\% \to 79\% \to 99\% 는 개발 세트에서 고른 선택 제어기(selected controller)의 값인데, 보고된 실행에서 이 규칙은
alpha=0으로 정책 자체의 순위를 따릅니다. 실제로 이 실행 규칙에서 월드 모델만 이전 버전과 새 버전으로 바꿔 끼운 결과는 성공률, 행동 수, 오류 수가 모두 같았습니다(1차 갱신에서 51\% 와 51\%, 79\% 와 79\%, 2차 갱신에서 99\% 와 99\% ). - 월드 모델의 효과가 드러나는 쪽은 월드 모델 값으로 후보를 고르는 월드 기반 제어(World-based control)입니다. 이 방식의 성공률은 49\% \to 96\% \to 98\% 였고, 별도의 확인 실험(630개 인스턴스, OPF 모델 3개)에서 월드 모델 갱신이 성공률을 평균 53.23\%p (부트스트랩 95\% 구간 [50.26, 56.30] )만큼 올렸습니다.
- 정책 갱신만의 효과는 1차 28\%p, 2차 20\%p 입니다. 갱신 단계의 정책 학습은 엄격한 기준으로 성공한 실제 에피소드의 행동만 남겨 재사용(replay)합니다. 전문가 시연과 전문가가 이어서 수행한 궤적(expert continuations)도 학습 단계에 쓰였는데, 특히 후자는 월드 모델의 학습 목표에 들어갑니다. 전문가의 도움은 학습에만 쓰이고 평가에는 들어가지 않습니다.
- 같은 과제의 다른 100개 인스턴스에서 규칙 기반 기준선(
baseline_rule)은 100\% 성공, 평균 2.87 행동, 반복 클릭 0회를 기록했습니다. 그러니 이 과제는 성능의 상한을 보는 벤치마크라기보다, 학습형 에이전트의 개선 과정을 관찰하는 진단용 과제로 보는 편이 맞습니다. - RSI 평가에 쓴 정책 학습 시드는 하나입니다.
실험실 계획: 4B 정책의 다섯 버전이 21.80%에서 46.01%로 올랐습니다
실험실 계획은 스탠퍼드 Cong Lab이 공개한 LabHorizon 벤치마크로 평가했습니다. Level-1은 실험실 물품을 여러 시점에서 렌더링한 이미지와 이전 행동을 보고 다음 행동을 고르는 과제이고, Level-2는 실험 맥락, 목표, 재료, 제약, 행동 라이브러리를 받아 프로토콜에 맞는 행동 순서와 매개변수를 계획하는 과제입니다. 저자들은 한 번의 자기 개선 과정에서 나온 4B 정책의 연속된 다섯 버전을 같은 200개 과제(F200 Level-2)로 평가했습니다.
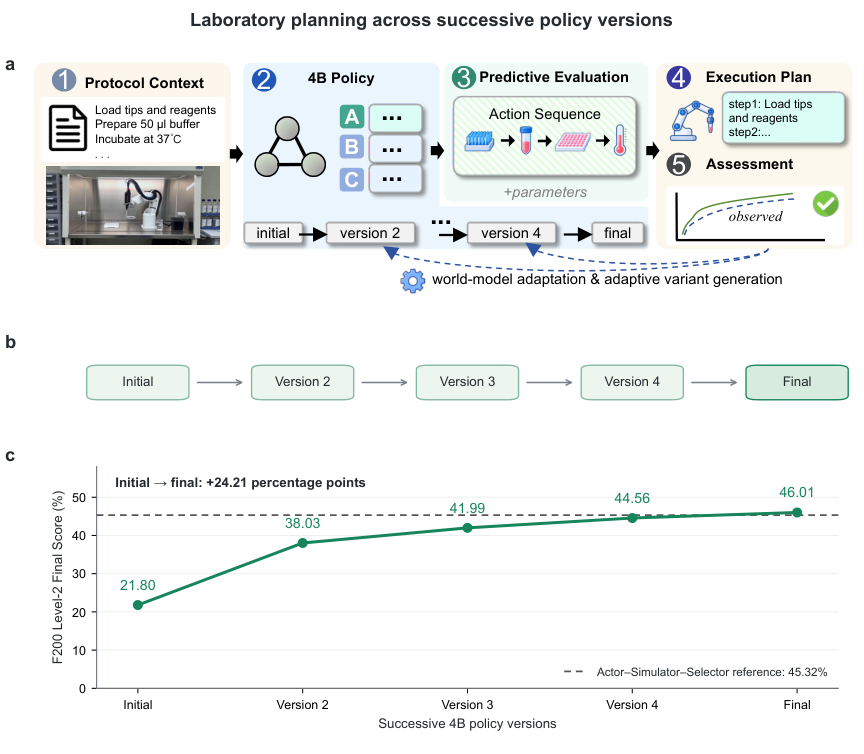
Final Score는 행동 순서의 유사도와 매개변수 정확도를 합친 점수입니다. 다섯 버전의 점수는 21.80\%, 38.03\%, 41.99\%, 44.56\%, 46.01\% 로 매 버전 올랐습니다. LabHorizon 저장소의 리더보드 값과 함께 보면 다음과 같습니다.
| 시스템 | Level-1 정확도 | Level-2 Final |
|---|---|---|
| Grok 4.3 | 0.555 | 0.3244 |
| Gemini 3.1 Pro | 0.465 | 0.3263 |
| GPT-5.5 | 0.535 | 0.2276 |
| Kimi K2.6 | 0.550 | 0.3150 |
| Qwen3.6-35B-A3B (직접 사용) | 0.475 | 0.2534 |
| Qwen3.6-35B-A3B (학습) | 0.635 | 0.4100 |
| Actor-Simulator-Selector 기준 | 0.665 | 0.4532 |
| RSI-Anything (4B) | 0.700 | 0.4601 |
Actor-Simulator-Selector 기준은 LabHorizon 학습 데이터로 학습한 Qwen3.6-35B-A3B를 Actor로, Gemini 3.1 Pro를 Simulator와 Selector로 쓴 구성입니다. 4B 정책은 이 구성보다 Level-2에서 0.69\%p 높았고, 논문에는 이 차이에 대한 신뢰구간이 없습니다. 위 표의 기준값 중 학습만 한 Qwen3.6-35B-A3B 행을 뺀 나머지는 LabHorizon 저장소 README의 리더보드와 일치하고, 그 행은 RSI-Anything 논문의 표에만 있습니다.
확인되지 않는 부분도 있습니다. 저자들은 다섯 버전이 각각 어떤 피드백으로 어떻게 만들어졌는지 설명하지 않았습니다. 저장소의 실험실 계획 문서는 Qwen3.5-4B-Base에 붙이는 로컬 P4 어댑터(Local P4 adapter)를 정책으로 쓰라고 안내합니다. 그런데 Hugging Face 저장소에 공개된 것은 시드 1401~1403의 JEPA 월드 모델 체크포인트뿐이고, 정책 어댑터는 없습니다. 그래서 지금 공개된 자산만으로는 46.01\% 를 다시 만들 수 없습니다.
반응 조건 최적화: 측정된 수율 표를 재생한 오프라인 평가입니다
화학 실험에서는 스즈키-미야우라(Suzuki-Miyaura) 교차 커플링 반응의 조건(촉매, 리간드, 염기, 용매)을 고르는 문제를 다뤘습니다. 월드 모델은 반응 예측 모델 ReactionT5와 JEPA-Anything을 결합한 ReactionT5-JEPA-Anything이며, 후보 조건마다 수율의 분포를 예측합니다. 비교 대상은 베이지안 최적화(Bayesian optimization)입니다.
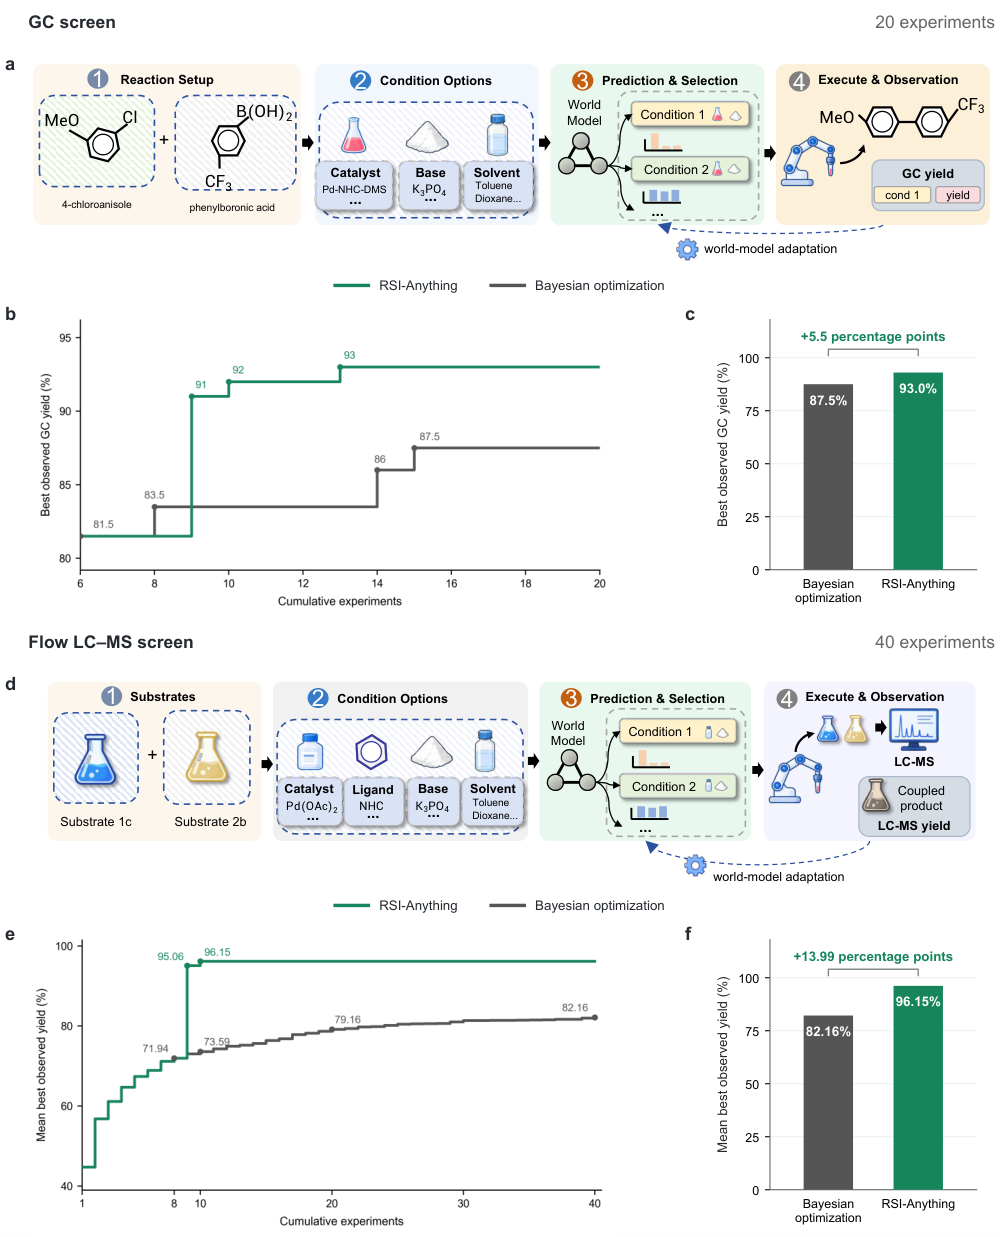
논문에 따르면 기체 크로마토그래피(GC, Gas Chromatography)로 분석한 스크린에서는 20회 실험 후 최고 관측 수율이 RSI-Anything 93.0\%, 베이지안 최적화 87.5\% 였습니다. 액체 크로마토그래피 질량분석(LC-MS, Liquid Chromatography-Mass Spectrometry)을 쓴 Flow 스크린에서는 40회 실험 후 평균 최고 관측 수율이 96.15\% 대 82.16\% 였습니다. GC 스크린의 그래프는 Flow 스크린과 달리 평균이 아닌 최고 관측 수율 곡선으로 표시되어 있고, 몇 번 반복했는지는 논문에 적혀 있지 않습니다.
저장소의 평가 기록을 보면 Flow LC-MS 결과의 성격이 더 분명해집니다:
- 평가 유형은 "offline sequential replay of measured screening yields"입니다. 새 실험을 한 것이 아니라, 이미 측정된 스크리닝 표의 321개 후보 조건 중에서 고른 조건의 측정값을 순서대로 꺼내 보는 방식입니다.
- 실행은 100회(시드 4001~4100)이고, 각 실행은 측정된 조건 8개에서 시작해 총 40개까지 관측합니다.
- 96.15\% 는 이 후보 풀의 최고 수율입니다. 100회 실행 모두가 10번째 관측 안에 이 최댓값을 찾았고(최초 발견 평균 9.94 번째), 그 뒤 곡선은 평평합니다. 초기 8개 관측 시점의 평균 최고 수율은 71.94\% 였습니다.
- 탐색 중 월드 모델의 예측은 고정되어 있습니다(
online_prediction_update: false). 측정값은 기대 개선(expected improvement)을 계산하는 기준과 이미 잰 조건을 제외하는 데만 쓰입니다. 수율 판독기는 JEPA 상태를 PCA로 줄인 특징 등을 입력으로 받는 ExtraTrees 회귀 모델입니다. 대상 반응의 321개 행은 이 판독기의 학습과 보정에 쓰지 않았고, 다른 14개 반응 그룹의 4,709개 행만 썼습니다.
정리하면 이 결과는 고정된 사전 예측이 후보를 좋은 순서로 정렬해, 베이지안 최적화보다 훨씬 빨리 최고 조건에 닿는다는 것을 보여 줍니다. 피드백으로 월드 모델이 갱신되는 재귀 루프의 증거라기보다, 예측 기반 선택의 효율을 보여 주는 실험입니다. 저자들도 논의 절에서 화학 결과가 보고된 예산 아래의 두 스크린에 한정된다고 밝혔습니다.
면역학 응용: 치료 가설 하나를 제안했고, 실험 검증은 남아 있습니다
마지막 응용은 면역학 연구 전체 흐름에 RSI-Anything을 적용한 사례입니다. 이 사례의 세부 내용은 같은 연구진의 별도 논문 An immune world model for multiscale forecasting and therapeutic hypothesis generation에 있습니다. 구축 단계에서는 Agent Genesis가 과학 에이전트 워크플로우와 모델 구성을 탐색해 모델 구축 워크플로우를 고르고, 그 워크플로우가 세포, 조직, 개인 수준의 면역 상태 변화를 예측하는 행동 조건부 면역 월드 모델을 만들었습니다. 분석 단계에서는 이 모델의 매개변수를 고정한 채 분석 에이전트가 시뮬레이션, 평가, 자기 교정을 거쳐 개입 후보의 순위를 매겼습니다.
그 결과 자기 교정 과정이 사이토카인 쌍 후보를 모두 걸러냈고, 측정된 섭동 근거와 모델 예측을 합쳐 SIRPα 억제와 IL-36γ 축 조절을 결합하는 치료 가설을 제안했습니다. 저자들은 이 가설이 "awaits experimental testing"이라고 명시했습니다. 저장소의 면역학 디렉터리에는 공개 예정(Coming soon)이라는 안내만 있어, 이 부분은 지금 코드로 확인할 수 없습니다.
도메인별로 실제로 바뀐 것
논문의 표 4와 저장소 문서를 합쳐 보면, 다섯 도메인이 프레임워크의 서로 다른 부분을 보여 준다는 점이 드러납니다. 저자들도 실험 방법 절에서 각 실험이 전체 프로토콜의 서로 다른 부분을 구현한다고 적었습니다. 정책과 월드 모델을 함께 두 번 갱신하고 개발 세트에서 남길 버전을 고른 도메인은 GUI뿐입니다. 그런데 그 헤드라인 수치는 앞서 본 것처럼 정책 순위를 따르는 실행 규칙에서 나왔고, 보고된 갱신 과정도 한 번(정책 학습 시드 하나)입니다.
| 도메인 | 정책 | 월드 모델 | 평가 방식 | 공개 자산 |
|---|---|---|---|---|
| 코드 복구 | ReasonFlux-Coder-7B 고정 | 고정 또는 사전 적응한 W1, 평가 중 고정 | CodeContests 600회, APPS, LiveCodeBench | 체크포인트, 학습 기록, 재현 스크립트 |
| GUI 조작 | 2회 갱신 | 2회 갱신 | MiniWoB++ 100개 인스턴스, OSWorld는 상대값만 | 최종 정책과 월드 모델 체크포인트 |
| 실험실 계획 | 4B 정책 다섯 버전 | JEPA 기반 프로토콜 모델 | LabHorizon F200 | 월드 모델만, 정책 어댑터 없음 |
| 반응 최적화 | 없음(조건 선택) | 고정 | 측정 수율 표의 오프라인 재생 | 고정된 예측 표, CPU 추론 코드 |
| 면역학 | 워크플로우 탐색 | 구축 후 고정 | 별도 논문 참조 | 공개 예정 |
한계와 시사점
저자들이 논의(Discussion) 절에서 직접 밝힌 한계는 세 가지입니다. 첫째, 정책과 월드 모델이 한 과제 안에서 서로를 계속 개선한다는 것을 보이려면 여러 라운드에 걸친 공동 평가가 더 필요합니다. 둘째, 실험실 계획 결과는 프로토콜에 맞는 계획을 평가한 것이고, 실제 장비에서의 실행은 별도의 검증이 필요합니다. 셋째, 화학 결과는 두 스크린과 보고된 예산에 한정되고, 면역학 가설은 실험 검증을 기다리고 있습니다.
저장소에서 확인한 내용은 몇 가지를 더 보탭니다. 코드 복구의 개선 폭은 2\%p 안팎이고 첫 비교의 신뢰구간 하한이 +0.17\%p 입니다. GUI와 화학의 헤드라인 수치는 각각 정책 순위와 고정된 사전 예측에서 나왔으므로, 월드 모델이 피드백으로 갱신되어 성능을 올렸다는 주장의 직접 증거는 GUI의 월드 기반 제어 실험과 코드 복구의 사전 적응 비교가 중심입니다. 또 코드 복구 재현 문서는 배포한 기준 체크포인트가 OPF의 엄격한 직교성 검사와 인자 독립성 검사를 통과하지 못했다고 기록하고 있습니다.
라이선스도 확인이 필요합니다. 저장소의 자체 코드는 Apache-2.0이지만, 코드 복구와 GUI의 월드 모델이 기반으로 삼은 Qwen2.5-Coder-3B-Instruct는 Qwen Research License를 따릅니다. 저장소의 제3자 고지에 따르면 이 모델과 파생물의 상업적 이용에는 라이선스 제공자의 별도 허가가 필요합니다.
그럼에도 이 연구가 던지는 설계 질문은 실용적입니다. 이 연구는 자기 개선 에이전트에 월드 모델을 붙일 때 언제 월드 모델을 다시 학습할지, 새 정책과 새 월드 모델을 함께 써도 나아지는지를 명시적인 검사로 만들었습니다. 예측과 관측을 모델 버전과 함께 기록해 현재 버전의 신뢰도만 따로 재는 규칙도, 다른 에이전트 학습 시스템에 그대로 가져다 쓸 수 있는 아이디어입니다.
RSI-Anything 설치 및 사용 방법
RSI-Anything 저장소는 Python 3.10 이상을 요구합니다. 공용 rsi 명령줄 도구는 현재 코드 복구(code_repair)와 GUI(gui) 두 과제만 다루고, 실험실 계획과 반응 최적화는 각 과제 디렉터리의 infer.py 로 실행합니다.
먼저 저장소를 복제하고 공용 워크플로우를 설치합니다.
git clone https://github.com/Gen-Verse/RSI-Anything.git
cd RSI-Anything
python3.10 -m venv .venv
source .venv/bin/activate
python -m pip install -e .
rsi tasks
GPU 없이 바로 돌려 볼 수 있는 것은 반응 최적화 예제입니다. 저장소 루트에서, 위 가상환경을 활성화한 상태로 실행합니다. 필요한 패키지는 NumPy와 SciPy뿐입니다.
python -m pip install -r tasks/reaction_optimization/requirements.txt
python tasks/reaction_optimization/infer.py \
  --observations tasks/reaction_optimization/examples/observations.json \
  --output runs/suzuki/next_condition.json
예제 입력의 수율은 입력 형식을 보여 주기 위한 합성 값입니다. 출력에는 다음에 측정할 조건(리간드, 염기, 용매), 예측 수율, 보정된 표준편차, 기대 개선 점수가 들어 있습니다. 측정한 수율을 observations.json 에 추가하고 다시 실행하면 다음 조건을 추천합니다. 이 예측 표는 한 가지 반응(1c, 2b, Pd(OAc)2)의 321개 조건에만 해당합니다.
코드 복구 평가를 재현하려면 Linux, runuser, unshare, nobody 계정이 필요합니다. 실행 격리에 이 기능들을 쓰기 때문입니다. 평가 자산은 약 64MB, 평가용 기반 모델은 약 6.2GB이며, 저자들이 기록한 실행 환경은 A800 80GB 8장입니다. 자세한 절차는 저장소의 코드 복구 재현 문서를 참고합니다.
python3.10 -m venv .venv-code-repair
source .venv-code-repair/bin/activate
python -m pip install -r tasks/code_repair/requirements.txt
python -m pip install -e .
rsi assets code_repair --profile evaluate --output assets
python tasks/code_repair/reproduce.py evaluate \
  --assets assets --gpus 0,1,2,3,4,5,6,7 \
  --inputs recorded --output runs/evaluation
 RSI-Anything: Unlocking Recursive Self-Improvement with World Models 논문
JEPA-Anything: Learning Predictive Models across Different Worlds 논문
An immune world model for multiscale forecasting and therapeutic hypothesis generation 논문
 RSI-Anything GitHub 저장소
JEPA-Anything GitHub 저장소
 RSI-Anything 체크포인트와 자산 (Hugging Face)
더 읽어보기
-
재귀적 자기 개선(RSI, Recursive Self-Improvement) 기법에 대한 서베이 연구 (1/2): 분류체계 및 배포 시점, 학습 시점의 자기 개선 루프 등
-
재귀적 자기 개선(RSI, Recursive Self-Improvement) 기법에 대한 서베이 연구 (2/2): 검증 계층과 자동 연구, 안전 문제 등
-
OpenClaw-RL: 대화를 통해 학습하는 개인화 자율 에이전트 강화학습 프레임워크 (feat. Gen-Verse)
-
Open-AgentRL: LLM 에이전트 강화를 위한 통합 오픈소스 프레임워크 (feat. RLAnything & DemyAgent)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
