핵심 요약
- Recursive Self-Improvement in AI 서베이는 2024~2026년 arXiv 논문 1,250편을 무엇을 개선하는가(배포 시점 자기 진화, 학습 시점 자기 반복, 자기 평가, 자동 연구)와 누가 그 개선을 검증하는가(사람이 루프 안, 사람이 루프 위, 닫힌 루프)라는 두 가지 분류 기준으로 정리합니다.
- 이 분류로 고정된 외부 평가기를 기준으로 수렴하는 제한된 자기 정제와, 평가 기준까지 스스로 바꾸는 개방형 RSI를 구분합니다. 코퍼스의 거의 전부가 제한된 자기 정제이며, 대부분 사람이 결과를 감사하는 Human-on-the-loop 칸에 있습니다.
- 배포 시점 자기 진화(393편)에서는 실행, 검색, 솔버 같은 외부 신호에 근거한 정제가 효과를 냈고, 외부 신호 없는 자기 교정은 오류를 고치기보다 출력을 모델 자신의 분포 쪽으로 끌어당겼습니다.
- 학습 시점 자기 반복(340편)은 개선을 가중치에 남기지만, 개선의 상한은 검증 신호의 품질이 정하고, 검증 가능한 보상을 쓴 학습에서도 성능이 오르다 무너지는 상승 후 붕괴가 관찰되었습니다.
- 코퍼스, 검색어, 분류 규칙은 recursive-self-improvement 저장소에 공개되어 있습니다.
- RSI 서베이 1부: 재귀적 자기 개선 기법의 분류체계와 배포 시점, 학습 시점의 자기 개선 루프 등

- RSI 서베이 2부: 자기 평가와 검증 계층, 자동 연구, 이론적 한계와 안전 문제 등
재귀적 자기 개선(RSI) 서베이 소개
Recursive Self-Improvement in AI: From Bounded Self-Refinement to Autonomous Research Loops는 AI 시스템이 스스로를 개선한다는 연구 1,250편(2024~2026년 arXiv 논문)을 모아, 자기 개선이라는 한 단어 아래 섞여 있던 서로 다른 연구들을 두 가지 기준의 분류체계(Taxonomy)로 다시 정리한 서베이 논문입니다. 저자들은 관련 논문들을 살펴보며 (1) 무엇을 개선하는가와 (2) 누가 그 개선을 검증하는가라는 두 질문으로 분야를 나누고, 이 분류를 바탕으로 이미 산업 현장에서 쓰이는 제한된 자기 정제(Bounded Self-Refinement)와, 현재 증거로 측정할 수 있는 모든 면에서 아직 한계에 막혀 있는 개방형 재귀적 자기 개선(Open-ended Recursive Self-Improvement, RSI)을 구분합니다.
이번 글은 2편으로 나누어 정리하려고 합니다. 1부에서는 두 가지 분류 기준과 코퍼스 구축 방법, 그리고 네 범주 중 배포 시점 자기 진화와 학습 시점 자기 반복을 다룹니다. 2부에서는 이 서베이가 가장 힘주어 다루는 자기 평가와 검증 계층(Verification Hierarchy), AI가 연구 자체를 수행하는 자동 연구(Auto Research), 그리고 RSI의 이론적 한계와 안전 문제를 이어서 살펴봅니다.
'self-X' 용어가 가리는 서로 다른 목표
AI가 스스로를 개선하고, 그 개선이 다음 개선을 더 쉽게 만든다는 생각은 AI 분야에서 가장 오래된 아이디어 중 하나입니다. I. J. Good의 "지능 폭발(intelligence explosion)" 논증과 Jürgen Schmidhuber의 괴델 머신(Gödel Machine)은, 실제로 그런 시스템을 만들 수 있게 되기 수십 년 전부터 RSI를 이론적인 종착점으로 제시해 왔습니다.
달라진 것은 그 루프의 조각들이 이제 실제 엔지니어링 관행이 되었다는 점입니다. 대규모 언어 모델(LLM)은 자기 출력을 비판하고 고쳐 쓰며, 자기가 만든 데이터로 학습하고, 자기 에이전트 코드를 다시 작성합니다. FunSearch와 AlphaEvolve (
 AlphaEvolve: 알고리즘을 설계하고 최적화하는 코딩 에이전트 (feat. Gemini))처럼 AI가 발견한 알고리즘이 다시 AI 개발 인프라로 들어가는 사례도 이미 나왔습니다.
저자들은 Anthropic이 최근 공개한 RSI 에세이를 동기 부여의 틀로 사용합니다. 이 에세이는 사람이 모든 코드를 쓰던 시기(2023년 이전)에서 챗봇 보조 코딩, 자율 코딩 에이전트, 에이전트가 다른 에이전트에게 일을 맡기는 현재를 거쳐, 에이전트가 후속 모델을 직접 설계하고 학습시키는 "루프 닫기(closing the loop)"에 이르는 자율성의 연속선을 제시합니다. 에세이에 따르면 2026년 5월 기준 Anthropic이 병합한 코드의 80\% 이상을 Claude가 작성했다고 밝혔지만(이 수치를 이어받은 Anthropic의 AI 개발 속도 측정 지표 글도 PyTorchKR에서 정리했습니다), 어떤 문제가 중요한지를 고르는 연구 방향 설정(Research Direction-setting) 에서는 여전히 사람이 병목입니다. 서베이 저자들은 이 에세이를 증거가 아니라 단계 구분을 위한 어휘로만 쓰고, 증거는 직접 모은 동료 심사 문헌에 두었다고 밝히고 있습니다.
문제는 이 분야의 어휘입니다. self-refine, self-correct, self-reward, self-play, self-distill, self-train, self-evolve, self-verify 와 같은 'self-X' 용어는 각각 하나의 메커니즘을 가리키지만, 그 메커니즘들이 추구하는 목표는 근본적으로 다릅니다. 예를 들어 모델이 자기 초안을 다시 읽고 오류 하나를 고치는 것과, 에이전트가 자기 코드베이스 전체를 다시 쓰는 것은 둘 다 자기 개선으로 불리지만 위험의 크기도, 검증 방법도 완전히 다릅니다. 같은 이름 아래에서 이 둘을 비교하면 어느 쪽에 대해서도 정확한 판단을 내리기 어렵습니다.
기존 서베이의 한계와 이 서베이의 접근
기존 서베이들은 이 지형의 한 단면만 다룹니다. 온폴리시 증류(On-policy Distillation) 서베이나 트리 탐색과 보상을 결합한 추론 방법 서베이는 이 서베이의 학습 시점 범주 안에 들어가고, 에이전트 서베이와 LLM 평가 서베이는 각각 배포 시점과 자기 평가의 구성 요소를 따로 다룹니다. 저자들이 아는 한, 출력 다듬기부터 개방형 RSI까지 전체 범위를 자율성(루프 폐쇄) 정도에 따라 함께 정리한 서베이는 없었습니다.
저자들은 이 서베이를 구성한 동기로 세 가지 관찰을 듭니다:
-
'자기 개선'은 하나가 아닙니다: 추론 시점 출력 수정(Self-Refine), 자기 생성 데이터 학습(STaR, Self-Rewarding LMs), 자기 코드를 다시 쓰는 에이전트(Gödel Agent, Darwin Gödel Machine), AI 연구를 자율적으로 수행하는 시스템(The AI Scientist)이 모두 같은 단어로 불립니다.
-
분야가 정리되는 속도보다 커지는 속도가 빠릅니다: 코퍼스의 74\% 가 2026년에 게시되었고, 분기별 논문 수는 시드 코퍼스 기준으로 2024년 초 한 자릿수에서 2026년 2분기 약 500편으로 늘었습니다.
-
어디에서나 같은 병목이 반복됩니다: 바로 평가기(Evaluator)입니다. 자기 학습은 정답을 확인할 수 있는 코드와 수학에서 잘 동작하고 그렇지 않은 곳에서는 성능이 떨어지며, 자동 연구자는 유창하지만 주장을 검증하기 어려운 논문을 만들고, 자기 보상 루프는 자기 심판을 해킹합니다. 그래서 저자들은 자기 평가를 부수적인 언급이 아니라 독립된 범주로 다룹니다.
이를 바탕으로 저자들이 내세운 기여는 ⓐ 'self-X' 어휘를 대체하는 두 가지 기준의 분류체계, ⓑ 1,250편 논문의 체계적 매핑, ⓒ 평가기 설계 공간과 검증 계층, 실패 모드를 묶은 자기 평가 범주, ⓓ RSI의 이론, 한계, 안전성 문헌을 기술 문헌과 잇는 종합입니다. 아래 표는 네 개의 기술 범주와 기초 이론 범주의 구성과 논문 수입니다:
| 범주 | 하위 갈래 | 논문 수 | 2026년 게시 비율 |
|---|---|---|---|
| 배포 시점 자기 진화 (1부) | 출력 정제, 테스트 시점 학습, 하네스/스킬 진화 | 393 | 74\% |
| 학습 시점 자기 반복 (1부) | 자기 보상 강화학습, CoT 자기 학습, 자기 증류, 셀프 플레이, 체화 루프 | 340 | 69\% |
| 자기 평가 (2부) | 심판, 과정 보상 모델, 검증기, 루브릭, 메타 평가 | 318 | 82\% |
| 자동 연구 (2부) | AI 과학자, 진화적 프로그램 발견 | 139 | 76\% |
| 기초 이론, 한계, 안전성 (2부) | 이론, 한계, 안전 | 60 | 57\% |
두 가지 분류 기준: 무엇을 개선하는가와 누가 검증하는가
분류체계를 보기 전에, 이 서베이가 어떤 용어를 어떤 뜻으로 고정해 두었는지부터 짚어 보겠습니다. 문헌마다 같은 단어를 다른 뜻으로 쓰기 때문에, 저자들은 서베이 안에서 쓸 정의를 먼저 정해 두었습니다.
이 서베이가 고정한 용어 정의
-
에이전트(Agent): 인지와 행동의 루프를 돌며 목표를 추구하는 LLM 기반 시스템입니다. 도구 출력, 환경 피드백, 파일 같은 상태를 관찰하고, 도구 호출이나 코드 실행 같은 행동을 고르며, 정지 조건까지 반복합니다. 한 번 호출되고 끝나는 모델은 에이전트가 아니지만, 같은 모델이 도구와 메모리를 가진 루프 안에 들어가면 에이전트가 됩니다.
-
하네스(Harness): 모델을 에이전트로 만드는 주변 요소 전부이며, 보조 코드(Scaffolding)라고도 부릅니다. 시스템 프롬프트, 도구 정의, 메모리 저장소, 스킬 라이브러리, 검색 인덱스, 오케스트레이션 코드, 정지 규칙이 여기에 속합니다(Code as Agent Harness 서베이도 같은 관점을 다룹니다). 하네스는 외부에서 들여다보고 고칠 수 있고, 에이전트 자신도 고칠 수 있기 때문에 에이전트가 스스로를 고쳐 쓰는 가장 구체적인 형태가 됩니다.
-
평가기(Evaluator): 후보 산출물을 품질 신호로 바꾸는 모든 장치입니다. 형식 증명 검사기, 테스트 모음, 학습된 보상 모델이나 과정 보상 모델, LLM 심판, 루브릭, 사람 평가자가 모두 포함됩니다. 저자들은 건전성(soundness)이 보장되는 평가기를 검증기(Verifier), 그런 보장이 없는 학습 기반 또는 프롬프트 기반 평가기를 심판(Judge) 으로 구분해 부릅니다.
-
자기 개선(Self-improvement): 시스템이 자기 자신이나 자기 출력의 더 나은 버전을 만드는 데 참여하는 것이며, 여기서 무엇이 더 나은지는 어떤 평가기가 정의합니다. 저자들은 이 정의가 평가기에 의존한다는 점이 2부에서 다룰 모든 실패 모드의 출발점이라고 강조합니다.
-
테스트 시점 학습(Test-Time Training, TTT): 따로 정리된 오프라인 학습 단계 없이, 배포 중에 현재 질의나 세션에 맞춰 모델 가중치를 갱신하는 것입니다. 가중치를 고정하는 추론 시점 정제와도, 오프라인 단계에서 반복하는 학습 시점 반복과도 구분됩니다.
-
셀프 플레이(Self-play): 모델이 스스로 과제나 상대를 만들어 학습하는 방식입니다. 출제자와 풀이자 루프, 적대적 커리큘럼이 여기에 속하며, 베이스 모델 외에는 아무 데이터 없이 시작하는 제로 데이터(Zero-data) 방식도 포함됩니다.
-
제한된 자기 정제와 개방형 RSI: 이 서베이의 가장 중요한 구분입니다. 제한된 자기 정제는 고정된 외부 평가기를 기준으로 시스템을 개선하므로 수렴하고 평가할 수 있습니다. 반면 개방형 RSI는 시스템과 함께 개선의 기준이나 개선 장치 자체 까지 바꾸므로 고정된 외부 기준점이 없고, 원리상 발산합니다.
첫 번째 기준: 개선 대상 네 가지
첫 번째 기준은 시스템이 무엇을 개선하는지입니다. 저자들은 네 가지 범주를 둡니다:
-
배포 시점 자기 진화(Deployment-Time Self-Evolution): 시스템이 배포 중에 개선됩니다. 가중치를 고정한 채 출력을 반복 수정하거나, 질의마다 가중치를 조정하거나(TTT), 자기 하네스와 스킬, 메모리를 진화시킵니다. 개선은 에피소드 단위로 끝나거나 기본 가중치 바깥에 쌓입니다. 이 범주의 일부는 흔히 추론 시점(inference-time) 자기 개선으로 불리지만, 가중치 갱신과 에피소드 간 축적까지 포함하므로 저자들은 배포 시점 이라는 이름을 택했습니다.
-
학습 시점 자기 반복(Training-Time Self-Iteration): 시스템이 만든 데이터, 보상, 교사 신호로 학습 단계에서 자기 가중치를 갱신합니다. 개선이 가중치에 남지만, 자기가 만든 신호의 품질을 넘지 못합니다.
-
자기 평가(Self-Evaluation): 개선 대상이 시스템의 평가기 입니다. 다른 세 범주에서 무엇이 더 나은지를 정의하는 심판, 검증기, 보상 모델, 루브릭을 설계하고 강화하거나 함께 진화시킵니다.
-
자동 연구(Auto Research): 시스템이 가설 제안, 실험, 알고리즘 발견과 같은 AI 연구 작업 자체를 수행합니다. 극단적으로는 앞의 세 범주의 방법들을 자율적으로 최적화하며, 개선이 한 시스템 안이 아니라 여러 시스템에 걸쳐 누적됩니다.
두 번째 기준: 루프 폐쇄 정도
두 번째 기준은 누가 개선을 검증하는지, 곧 루프가 얼마나 닫혀 있는지(Degree of Loop Closure)입니다:
-
사람이 루프 안에 있는 경우(Human-in-the-loop): 사람이 모든 변경을 검토합니다. AI 보조 코딩, 공동 연구자 도구가 여기에 해당합니다.
-
사람이 루프 위에서 감독하는 경우(Human-on-the-loop): 실행 피드백, 보상 모델, 증명 검사기처럼 개선 신호는 자동으로 만들어지지만, 사람이 결과를 감사하고 배포를 승인합니다.
-
닫힌 루프(Closed Loop): 시스템이 사람의 검토 없이 개선을 만들고, 검증하고, 적용합니다. Anthropic 에세이가 루프 닫기라고 부른 단계입니다.
두 기준을 교차하면 아래 그림과 같은 4 \times 3 격자가 됩니다. 각 칸에는 그 위치를 대표하는 시스템이 적혀 있습니다.
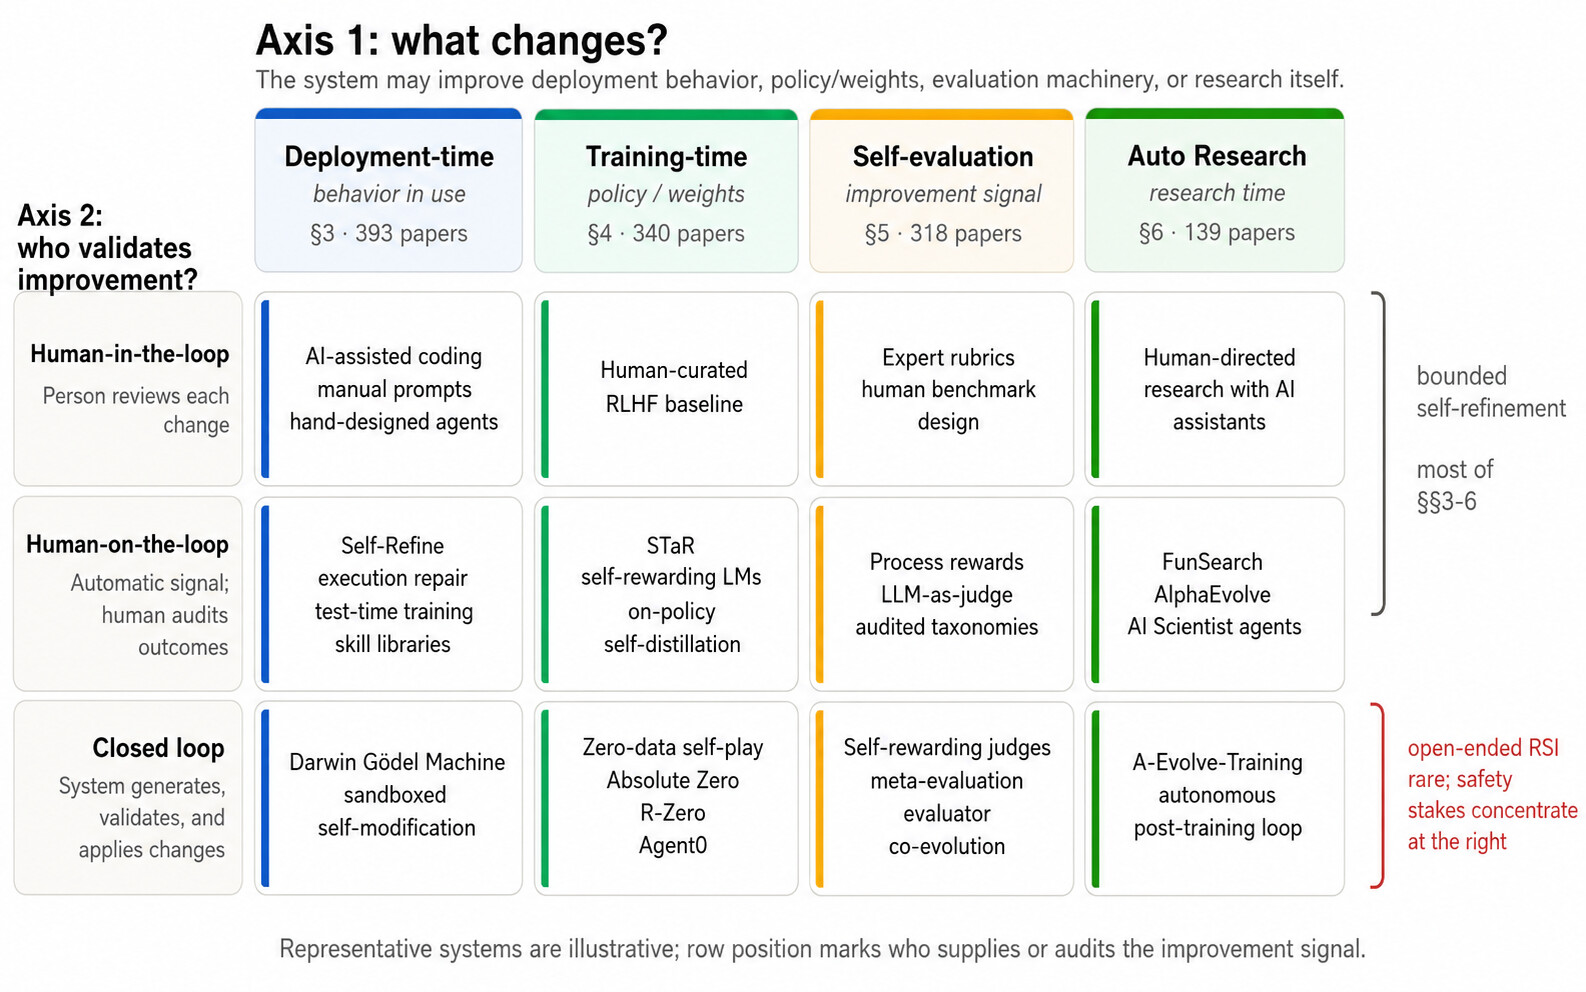
1,250편 거의 전부가 제한된 자기 정제를 다루며, 안전 문제는 평가기까지 스스로 고치는 닫힌 루프, 곧 개방형 RSI 쪽에 몰려 있습니다. 위 격자에서 저자들이 강조하는 특징은 두 가지입니다. 하나는 논문이 가운데 행에 몰려 있다는 점입니다. 3~6장에서 다루는 거의 모든 연구가 자동 생성된 신호를 쓰고 사람이 결과를 감사하는 Human-on-the-loop 칸에 있습니다. 다른 하나는 닫힌 루프 행이 어디에서나 드물고, 오른쪽으로 갈수록 더 비어 있다는 점입니다. 저자들은 이 행에서 가장 중요한 칸으로 자기 평가 × 닫힌 루프, 곧 시스템이 무엇이 더 나은지의 정의를 스스로 다시 쓰는 칸을 꼽습니다. 이 칸이 바로 제한된 자기 정제가 개방형 RSI로 넘어가는 경계이기 때문입니다.
Anthropic 에세이의 5단계 스펙트럼에 대응시키면, 기술 문헌 대부분은 3~4단계(자율 코딩 에이전트, 에이전트 간 위임)에 있고 자동 연구 범주의 논문들이 5단계의 경계를 탐색하는 정도입니다. 저자들은 이를 두고 문헌 대부분이 아직 사람이 루프를 감사하는 단계에 있으며, 격자에서 가장 중요한 열은 평가기(자기 평가) 열이라고 정리합니다.
분류체계가 담지 않는 것
저자들은 이 분류체계가 의도적으로 다루지 않는 두 가지를 직접 밝혀 두었습니다.
첫째, 두 분류 기준 모두 목표(objective)를 주어진 것으로 가정 합니다. 첫 번째 기준은 개선이 어디에 반영되는지를, 두 번째 기준은 현재 목표에 비추어 누가 검증하는지를 보지만, 그 목표가 여전히 옳은지는 어느 쪽도 다루지 않습니다. 2부에서 다룰 프레임 고착(Frame Lock-in) 이 이 빈자리에서 생기는 실패 모드입니다.
둘째, 분류체계는 개선이 반영되는 기반(substrate) 을 기준으로 나뉘고, 시간에 따른 궤적(trajectory) 은 기록하지 않습니다. 한 시스템이 출력을 개선하고, 이어서 평가기를, 그다음에는 연구 방법을 개선한다면 격자의 세 칸에 나뉘어 들어가고, 이것이 하나의 시스템이 연속적으로 발전한 결과라는 사실은 어디에도 남지 않습니다. 코퍼스에는 이 공백이 실패로 드러난 사례가 있습니다. 반복된 DPO(Direct Preference Optimization) 사후 학습 파이프라인 연구는 캠페인을 거듭하며 학습한 행동은 유지되지만 방법론적 지식은 쌓이지 않는 현상을 과학적 기억상실(Scientific Amnesia)이라고 불렀습니다. 저자들은 이 궤적을 측정할 방법이 코퍼스에 없기 때문에 세 번째 분류 기준으로 넣지 않고 열린 문제로 남겼다고 설명합니다. 틀이 바뀌어도 방법이 이어지는 연속성이라는 긍정적인 성질은 이 격자로는 기록할 수 없다는 것입니다.
코퍼스 구축 방법과 한계
코퍼스는 두 단계로 모았습니다. 먼저 시드 수집(Seed Harvest) 단계에서 2024~2026년 arXiv를 자기 정제, 자기 보상 학습, 자동 AI 연구, 자기 수정 에이전트, LLM 기반 코드 및 알고리즘 발견, RSI 이론과 안전, 자기 생성 데이터 루프의 7개 갈래로 검색하고, OpenAlex 인용 및 학회 메타데이터를 붙인 뒤 주제와 무관한 논문을 걸러 871편을 얻었습니다. 이어서 분류체계 정렬 단계에서 시드 논문 전체를 위 범주로 다시 분류하고(주제 단위 매핑, 제목과 초록에 대한 키워드 규칙, 규칙 오류의 수동 수정), 시드 검색이 덜 다룬 자기 평가 방법, 테스트 시점 학습, 제로 데이터 셀프 플레이의 세 방향으로 379편을 추가 수집했습니다.
재현성을 위해 저자들은 검색어, 질의별 상한, 중복 제거 로직, 분류 규칙(범주 기본값, 키워드 규칙, 논문별 명시적 예외)을 실행 가능한 스크립트로 공개했습니다. 규칙 기반 분류로 시드 논문 89편이 갈래 기본값에서 다른 범주로 옮겨졌고, 집필 중 발견한 오분류 3건은 명시적 예외로 고쳤습니다. 분류와 수정은 한 명이 수행했기 때문에, 저자들은 이견을 감추지 않고 감사할 수 있도록 논문별 배정 결과 전체를 공개했다고 밝히고 있습니다.
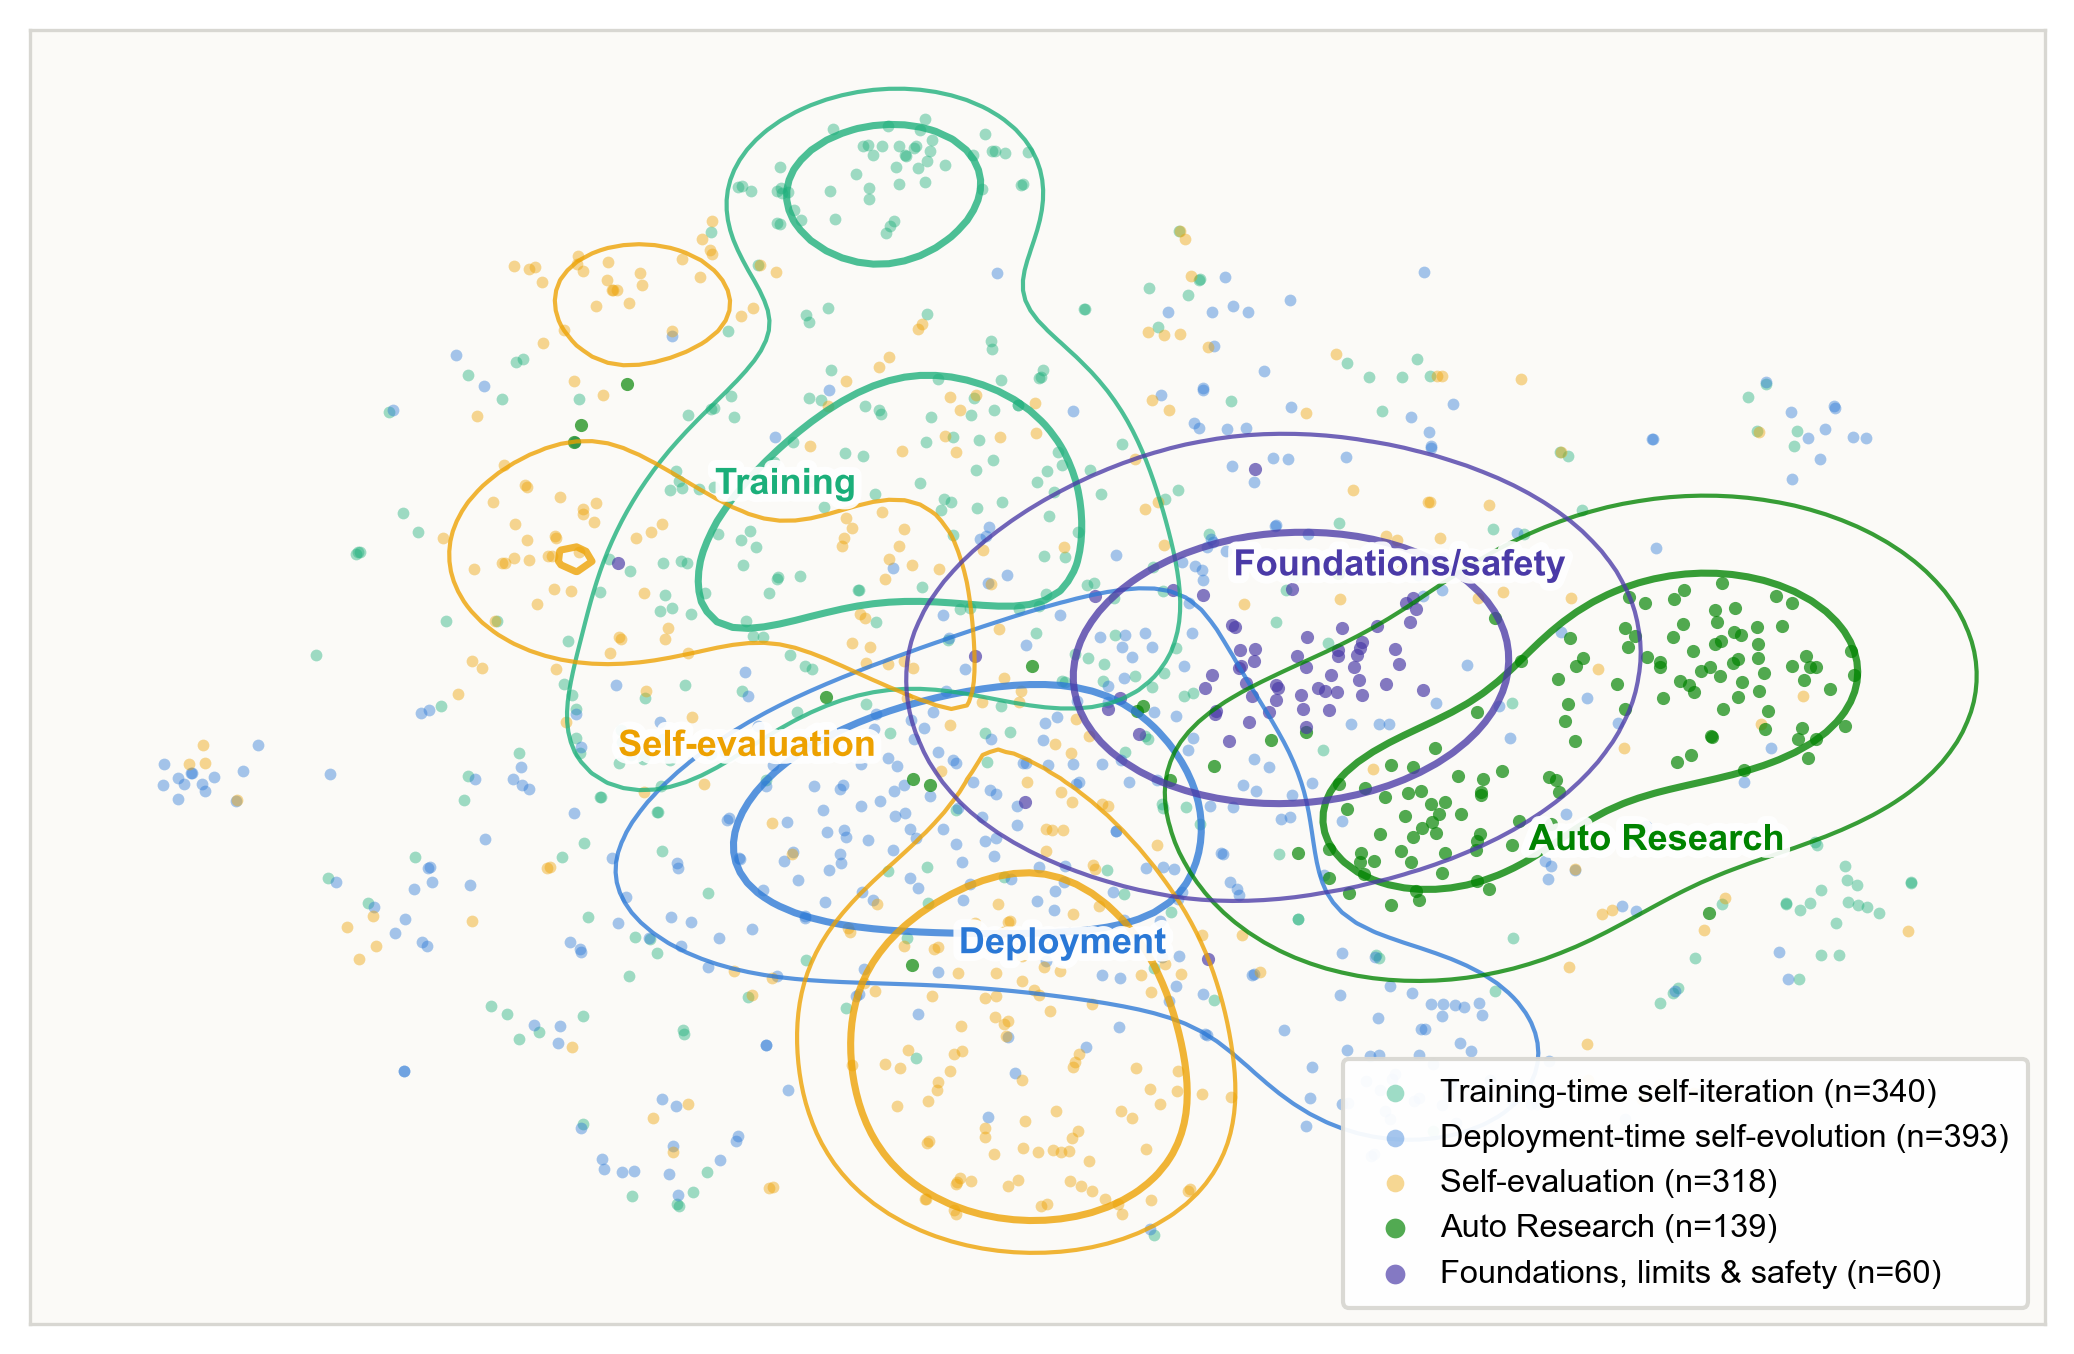
위 그림은 초록의 TF-IDF 벡터를 SVD와 t-SNE로 2차원에 투영한 코퍼스 지도입니다. 자동 연구와 기초 이론 범주는 비교적 뚜렷한 영역을 이루는 반면, 배포 시점, 학습 시점, 자기 평가라는 큰 세 범주는 서로 깊이 겹쳐 있습니다.
저자들은 코퍼스의 한계도 분명히 적었습니다. 코퍼스는 전수 조사가 아니라 표본 입니다. 질의별 깊이 상한이 있어 최근의 대량 갈래가 유리하고, 추가 수집은 구조상 최근 논문에 치우쳐 있어 성장 통계는 시드 코퍼스만으로 계산했습니다(자기 평가 범주 318편 중 284편이 이 추가 수집분입니다). 논문의 74\% 가 2026년에 게시되어 인용 수는 거의 0에 가까우므로 영향력의 지표로 읽으면 안 됩니다. 그래서 저자들은 STaR, SPIN, FunSearch, The AI Scientist처럼 수집 기간 이전의 대표 연구를 기준점으로 직접 인용하고, 주요 논증은 검증된 기준 연구와 진단 및 비판 문헌에 근거했으며, 2026년 논문 더미는 활동이 어디에 몰려 있는지를 보여 주는 지도 로만 썼습니다. 자동 분류는 근사적이라 모든 범주에 경계에 걸친 논문이 있고, 추가 수집분 379편 중 약 54편(대략 7편 중 1편)은 검색어에 딸려 온 주변부 논문이라 집계에는 남아 있지만 근거로는 인용하지 않았습니다. 마지막으로, 프런티어 랩 내부의 RSI 관행은 랩이 공개한 것으로만 관찰할 수 있어, 가장 앞선 연구일수록 공개되지 않아 표본에서 빠질 가능성이 크다는 점도 한계로 남겨 두었습니다.
배포 시점 자기 진화(Deployment-Time Self-Evolution)
분류체계를 정리했으니, 이제 첫 번째 범주인 배포 시점 자기 진화부터 살펴보겠습니다. 이 범주는 시스템이 배포 중에 스스로를 개선하는 모든 방법을 포함합니다: 가중치를 고정한 채 출력을 반복 수정하는 것, 질의마다 가중치를 조정하는 것, 자기 하네스와 스킬, 메모리를 진화시키는 것입니다. 이 방법들은 오프라인 학습 단계 없이 현장에서 에피소드나 사용자 단위로 개선이 일어난다는 공통점이 있고, 개선이 얼마나 오래 남는지에서 차이가 납니다. 코퍼스에서 가장 큰 범주(393편)이자 가장 널리 배포된 범주이며, 공개 저장소의 통계 기준으로 출력 정제 193편, 하네스와 스킬 진화 113편, 테스트 시점 학습 87편으로 이루어져 있습니다.
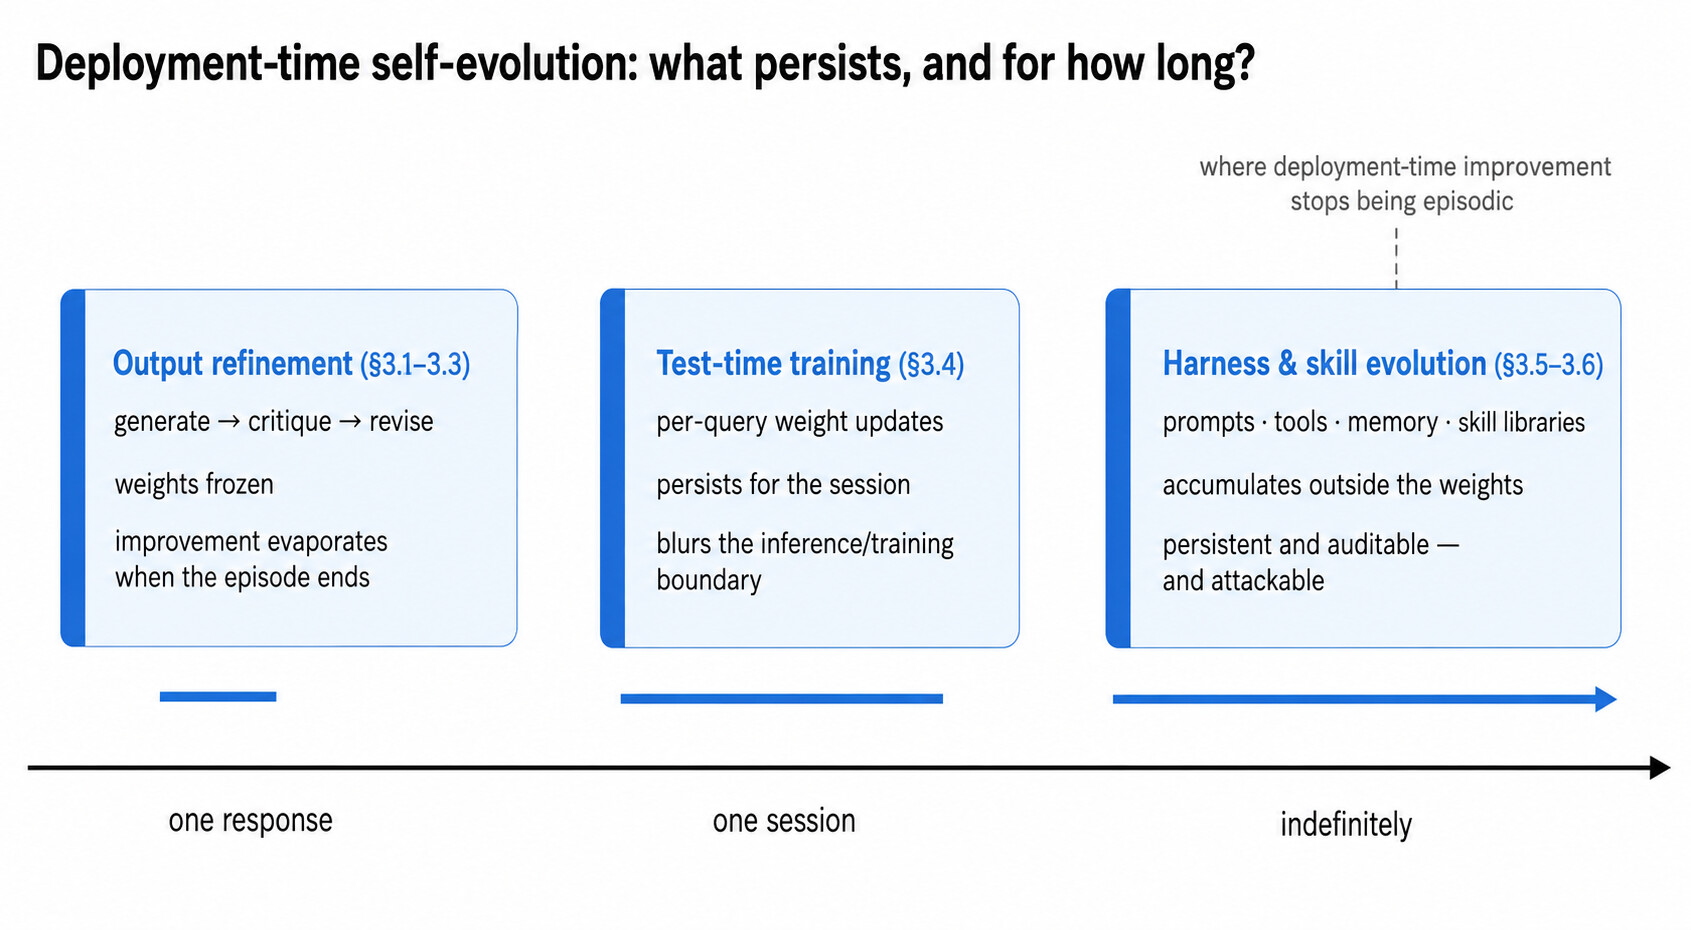
위 그림은 배포 시점의 세 가지 개선 방식을 지속성 순서로 보여줍니다. 출력 정제는 에피소드가 끝나면 사라지고, 테스트 시점 학습은 한 세션 동안 유지되며, 하네스와 스킬 변경은 무기한 쌓입니다.
출력 정제의 기본 루프인 생성, 비판, 수정 은 2023년 Self-Refine과 Reflexion이 정립했습니다. 이어서 Snell 등의 연구는 테스트 시점에 수정과 탐색에 연산을 쓰는 것이 더 큰 모델에 연산을 쓰는 것보다 나을 수 있음을 보여 추론 시점 반복에 스케일링 법칙의 관점을 더했고, 이런 연산 배분을 일반적인 자기 개선 에이전트로 가는 중요한 단계로 보았습니다. 저자들은 출력 정제를 자기 개선 주장을 평가하기 가장 쉬운 영역이자, 가장 결정적인 부정적 결과가 쌓인 영역이라고 평가합니다.
텍스트와 추론의 자기 비판 및 자기 검증
코퍼스에서 가장 큰 단일 갈래는 기본 루프를 세 방향으로 다듬습니다.
첫 번째 방향은 구조화된 피드백과 기호적 피드백 입니다. 자유 형식의 자기 비판은 신뢰하기 어렵기 때문에, 많은 연구가 이를 구조화된 신호로 대체합니다. SymbolicAI는 LLM을 논리 기반 프레임워크 안의 의미 파서로 두고 출력을 형식 솔버로 보내며, 최근 계획 연구는 LLM 플래너를 기호 검증기와 결합해 막연한 비판 대신 실행 가능한 오류 추적 정보를 돌려줍니다. SQL 실행기, 임상 요약용 환각(Hallucination) 탐지기, 긴 문서 요약을 위한 QA 기반 사실성 검사처럼 검사기가 있는 곳마다 정제 루프는 그 검사기를 중심으로 다시 설계됩니다. 저자들은 수십 편의 논문에서 반복되는 설계 교훈을 "정제 루프는 피드백 채널만큼만 좋다"로 요약하며, 이를 2부에서 다룰 검증 병목이 처음 드러나는 지점으로 봅니다.
두 번째 방향은 탐색 형태의 정제 입니다. SQL-o1의 자기 보상 휴리스틱 탐색이나 가정용 계획을 위한 LLM-Personalize의 강화 자기 학습 루프는 초안을 다듬을 텍스트가 아니라 확장하고 점수를 매길 노드로 다룹니다. 같은 점수 신호로 추론 시점에 후보를 순위 매길 수도, 학습 후에 정책을 미세조정(Fine-tuning)할 수도 있기 때문에 이 방향은 학습 시점 방법과 경계가 흐려지고, 실제로 둘 다 하는 시스템도 있습니다.
세 번째 방향은 정제가 실제로 무엇을 개선하는가 에 대한 진단으로, 저자들은 이 갈래의 최근 연구 중 가장 가치 있는 부분으로 꼽습니다. 9개 LLM과 7개 언어쌍으로 문서 단위 문학 번역을 체계적으로 분석한 연구는 정제로 얻는 이득이 주로 유창성, 문체, 용어에서 나오고 내용의 적절성(adequacy)은 덜 일관되게 개선된다는 것을 확인했습니다. 또한 정제는 초안이 실제로 틀린 부분을 고치기보다 출력을 정제 모델 자신의 분포 쪽으로 끌어당기는 것으로 나타났습니다. 이는 외부 피드백이 없으면 LLM은 추론을 대체로 스스로 교정하지 못하고, 단순한 자기 교정은 오히려 답을 나쁘게 만들 수 있다는 Huang 등의 부정적 결과와 같은 방향입니다.
2026년 문헌은 이 교훈을 받아들였습니다. 코퍼스의 새 시스템 거의 전부가 실행, 검색, 탐지기, 솔버 같은 외부 신호에 비판을 근거하며, 외부 신호 없이 스스로 교정하는 내재적 자기 교정(Intrinsic Self-correction) 논문은 드물어졌습니다. 저자들은 이를 분류체계의 언어로 닫힌 루프의 자기 비판에서 Human-on-the-loop의 검증된 정제로 물러난 것 이라고 표현하고, 이 후퇴가 자율성을 줄이는 대신 신뢰성을 높였다고 평가합니다.
부정적 결과 자체도 더 정교해지고 있습니다. 과제 민감 분석은 내재적 자기 교정이 작동하는가 가 아니라 어떤 메커니즘으로 작동할 수 있는가를 묻고, 명시적 제약 검증, 복잡한 추론 과정 재검토, 경쟁 전략 사이의 두 번째 의견처럼 과제 구조가 수정을 뒷받침할 때는 도움 없는 자기 교정에서도 일관된 이득이 난다는 것을 보였습니다. 시퀀스 확률과 정답 여부의 관계를 4단계로 정량화한 연구는 디코딩 방법, 모델, 벤치마크에 걸쳐 시퀀스 우도가 품질의 대리 지표로 쓸 수 있는 곳과 없는 곳을 정리했는데, 저자들은 이를 검증 계층의 바닥을 아래에서부터 측정한 결과로 읽습니다. 평가 쪽도 함께 바뀌고 있습니다. BinEval은 불투명한 단일 심판 대신 평가를 원자적인 예/아니오 질문으로 쪼개 해석하고 디버깅할 수 있는 점수로 합칩니다. 답이 아니라 심판을 개선하는 이 역전된 구도는 서베이 전체에서 반복해서 나타납니다.
실행 피드백 기반 코드 자기 수정
코드는 외부 신호를 가장 싸고 분명하게 얻을 수 있는 영역입니다. 프로그램은 실행되고, 테스트는 통과하거나 실패합니다. 그래서 정제에 대한 주장을 검증하기에도 가장 좋은 영역입니다.
긍정적인 결과는 뚜렷합니다. 실행 피드백 수정 루프는 Blender에서 3D 에셋을 만드는 멀티 에이전트 시스템부터, 런타임(runtime) 피드백으로 병목을 진단하는 데이터베이스 튜닝 에이전트, 프로파일링 결과에 근거한 컴파일러 패스 튜닝까지 폭넓게 쓰입니다. 형식 수학에서는 Lean 정리 증명을 위한 LEAP, Rust 검증을 위한 KVerus 같은 증명 보조기 기반 에이전트 프레임워크가 가장 강한 검증기인 증명 검사기를 활용해, 잘못된 "개선"을 받아들일 위험이 사실상 없는 상태로 여러 차례 수정을 반복합니다.
이 갈래의 두 번째 기여는 피드백이 왜 도움이 되는가 를 분해한 것입니다. 통제된 학생과 교사 프로토콜은 피드백 자체의 가치를 재샘플링, 형식 교정, 추가 테스트 시점 연산의 효과와 분리했습니다. 이런 효과들이 단순 비교에서 피드백의 가치를 부풀리기 때문입니다. 소형 고정 코드 모델의 자기 수정을 위약 대조군으로 분석한 연구는 실패한 테스트를 실행 가능한 반례로 보고, 피드백의 가치를 문제에 다시 노출된 효과가 아니라 반증(falsification) 에 돌려야 한다고 주장합니다. 소형 모델 코드 생성에서는 파이프라인 구조보다 실행 피드백이 더 중요하고, RubricRefine처럼 실행 전 구조 검사가 도구 간 계약 위반이라는 주된 실패를 비구조적 비판보다 더 일관되게 잡아낸다는 결과도 있습니다. DISC는 이 설명을 추론으로 넓혀, 검증 질문의 출력을 풀이 어디가 잘못되었는지에 대한 잡음 섞인 측정으로 보고 여러 라운드에 걸쳐 잡음을 제거합니다. 맹목적인 수정이 아니라 오류 위치에 대한 추론으로 정제를 다루는 방식입니다. 저자들은 이 논문들이 배포 시점 범주의 다른 갈래에는 없는 것, 곧 정제가 언제 작동하는지에 대한 인과적 설명 을 제공한다고 평가합니다.
신호 자체를 날카롭게 만드는 연구도 두 가지 나왔습니다. FLARE는 테스트 실패는 너무 거칠고 자기 비판은 너무 추상적이어서 어디를 고쳐야 할지 알려주지 못한다는 관찰에서 출발해, 생성과 수정 사이에 줄 단위 의심도를 예측하는 가벼운 진단 모델을 둡니다. 피드백이 있는지뿐 아니라 피드백의 해상도도 설계 변수가 됩니다. CoSPlay는 테스트까지 모델이 스스로 만드는 상황을 다룹니다. 모델이 작성한 단위 테스트는 잡음이 많고, 함께 작성된 잘못된 코드와 엉뚱하게 맞물리기 쉽습니다. CoSPlay는 테스트 시점에 코드 집단과 테스트 집단을 협력적으로 함께 진화시켜 서로를 디버깅하게 합니다. 저자들은 이를 검증 병목의 축소판으로 봅니다. 검증기를 스스로 만들면, 그 검증기를 검증하는 일까지 루프에 들어오기 때문입니다.
비전 언어 모델과 멀티모달 자기 비판
정제 패러다임은 텍스트 밖으로 넓게 퍼졌지만, 검증 신호는 멀리 갈수록 약해집니다. 비전 언어 모델에서 대표적인 활용은 환각 완화입니다. Kestrel은 학습 없이 시각적 근거에 자기 정제를 묶어 LVLM의 환각을 줄이고, Reflect-R1은 긴 영상 모델이 내부 파라미터 안에서만 닫힌 루프로 자기 성찰하면 맹목적 확신(blind confidence)에 빠진다고 보고 증거 기반 외부 검색으로 이를 해결합니다. 저자들은 이를 Huang 등의 부정적 결과를 멀티모달로 다시 쓴 것으로 봅니다. 생성 쪽에서는 통합 MLLM이 세밀한 추론으로 자기 텍스트-이미지 출력을 다듬고, Proprio는 고정된 영상 생성기에 잠재 공간의 자기 채점 신호를 주어 추론 시점에 물리적 개연성을 높입니다.
지각 자체도 정제의 대상이 되고 있습니다. ActiveScope는 수동적인 시각 어텐션의 두 실패 모드(눈에 띄는 방해 요소가 목표를 압도하는 문맥 지배와 의미 편향)를 진단하고, 답을 고쳐 쓰는 대신 모델이 영역을 다시 살펴 자기 지각을 능동적으로 찾고 교정 하게 합니다. 생성 쪽에서는 자기 개선 코드북 연구가 자기회귀 이미지 생성기의 토큰 어휘에서 안전하지 않은 시각 패턴을 반복적으로 제거해, 개선 대상을 생성기의 이산 알파벳 자체로 삼았습니다.
저자들은 두 가지 경고를 특히 강조합니다. 첫째, 자기 진화 대형 멀티모달 모델 연구는 셀프 플레이와 자기 일관성 보상이 답의 일치도 를 최적화하는 동안 디코더가 시각 정보를 덜 보고 언어 사전 지식에 기대는 시각적 조건화 부족(visual under-conditioning)을 보였습니다. 2부에서 다룰 자기 확증 루프의 모달리티별 형태입니다. 둘째, 가장 강한 멀티모달 시스템은 점점 코드 갈래를 닮아 갑니다. 모델 자신의 판단을 믿기보다 검색, 탐지기, 물리 잔차, 개인 시각 맥락 같은 외부 채널을 들여와 성공합니다. 심판 쪽 증거도 같은 방향입니다. 물리적 개연성을 판단하는 비전 언어 모델(VLM, Vision-Language Model) 심판들은 물리 현상에 대해 서로 다른 내부 분류를 갖고 있어, 하나의 전역 평가 체계를 쓰면 각 심판이 실제로 무엇을 지각하는지와 무관하게 같은 역량을 가진 것처럼 취급하게 됩니다. 그래서 JudgeFit은 점수를 믿기 전에 심판별 분류부터 찾아냅니다. 저자들의 표현대로, 코드 갈래의 검증기가 프로그램이라면 멀티모달 갈래의 검증기는 모델이고, 모델 심판은 모델의 특이성을 그대로 물려받습니다.
여기까지의 출력 정제에 대해 저자들은 제한된 자기 개선의 가장 순수한 형태라고 평가합니다. 개선은 실재하고 측정할 수 있지만, 에피소드가 끝나면 사라집니다. 아무것도 남지 않는다는 이 한계가 학습 시점 루프(개선을 가중치에 남김)와 하네스 및 스킬 메커니즘(개선을 하네스에 남김)이 생겨난 이유이며, 출력 정제의 성공과 실패가 남긴 핵심 설계 원칙은 "외부 신호가 없으면 신뢰할 수 있는 개선도 없다"입니다.
테스트 시점 학습(TTT)
가중치를 고정한 정제와 오프라인 학습 사이에는 빠르게 커지는 중간 영역이 있습니다. 배포 중에 가중치를 갱신 하는 테스트 시점 학습입니다. 질의 조건부 테스트 시점 자기 학습은 질의마다 전용 목적 함수를 만들어 추론 시점에 미세조정함으로써, 가중치를 고정한 반복으로는 도달할 수 없는 오개념을 바로잡습니다. 연속 자기 개선 연구는 추론 시점 스케일링이 만들고 보통은 버리는 추론 기록을 가벼운 지속 메모리로 바꾸고, 언어 모델에게도 잠이 필요하다는 연구는 문맥 안에서 얻은 경험을 장기 파라미터로 옮기는 주기적인 수면 단계를 둡니다.
추가 수집에서 이 갈래는 87편으로 빠르게 커지고 있었고, 상당수는 예전 테스트 시점 적응(Test-Time Adaptation) 연구를 LLM에 맞춰 다시 발견하는 흐름이었습니다. PyTorchKR에서 소개한 TTT-Discover처럼 추론 중에 모델을 학습시켜 과학 문제를 푸는 연구도 이 흐름에 속합니다. 저자들은 TTT를 분류체계의 배포 시점과 학습 시점 경계에 일부러 걸쳐 두었습니다. 학습의 지속성과 배포의 질의 단위 세밀함을 함께 갖고 있기 때문이며, TTT가 늘어나는 것을 추론과 학습의 구분이 가중치를 얼마나 자주 갱신하는가의 차이로 바뀌고 있다는 가장 분명한 신호 로 봅니다.
하네스와 에이전트의 자기 진화
앞의 방법들이 모델이 말하는 것 을 개선한다면, 이제부터 다룰 두 갈래는 에이전트가 무엇인지 를 개선합니다. 개선 대상은 프롬프트, 도구, 메모리, 스킬 라이브러리, 오케스트레이션 코드, 극단적으로는 에이전트의 소스 코드인 하네스 자체입니다. Anthropic 에세이가 오늘날의 최전선(에이전트에게 위임하는 에이전트)이자 루프 닫기의 바로 앞 단계로 꼽은 구간이 여기이며, 하네스 변경은 지속적이고 외부에서 들여다볼 수 있기 때문에 배포 시점 개선이 일회성을 벗어나 쌓이기 시작하는 지점이기도 합니다.
이 갈래의 양극단은 일찍 정해졌습니다. 한쪽 끝의 Gödel Agent는 Schmidhuber의 괴델 머신에서 이름을 딴 자기 참조 프레임워크로, 에이전트가 자기 런타임 코드 를 읽고 고쳐 쓰며 사람이 정해 둔 일부가 아니라 에이전트 설계 공간 전체를 탐색합니다. Darwin Gödel Machine은 증명 가능한 이득이라는 조건을 경험적 이득으로 완화하고, 코딩 벤치마크로 검증한 자기 수정들을 개방형 아카이브로 유지합니다. 다른 쪽 끝에서 Liu 등은 진정한 자기 개선 에이전트에는 자기 학습 과정을 평가하고 조정하는 내재적 메타인지 학습(Intrinsic Metacognitive Learning) 이 필요하며, 개선 절차는 고정한 채 개선 대상만 바꾸는 현재 방식은 유연성이 가장 필요한 곳에서 경직되어 있다고 주장합니다. 나머지 연구 대부분은 이 양극단 사이에서, 시스템의 한 구성 요소만 진화시키고 나머지는 고정합니다.
진화 대상에 따라 나누면 다음과 같습니다:
-
프롬프트 수준: 환경 기반 자동 프롬프트 최적화가 게임 에이전트의 프롬프트를 환경 피드백에 근거해 개선합니다.
-
검증 수준: 저자들이 가장 새로운 움직임으로 꼽는 방향입니다. 자기 진화 딥 리서치 에이전트는 정책을 사후 학습하는 대신 자기 출력을 판정하는 루브릭과 검증기 를 반복해서 강화합니다. Red Queen Gödel Machine은 기존 자기 개선 에이전트가 에이전트가 발전해도 유효하게 남는 고정된 평가 기준을 가정한다는 점을 지적하고, 에이전트를 평가기와 함께 진화시켜 평가를 고정된 틀이 아니라 개선 루프의 일부로 만듭니다. Escher-Loop는 한 단계 더 나아가, 최적화 에이전트가 과제 에이전트와 자기 자신 을 함께 동적으로 변하는 벤치마크에 맞춰 다듬습니다.
-
토폴로지 수준: QueenBee planner는 작업자 에이전트는 모두 고정한 채, 멀티 에이전트 간 통신 구조를 검색하고 개선할 수 있는 설계 산출물로 다룹니다.
-
데이터 수준: 컴퓨터 사용 에이전트 연구는 에이전트 자신의 실패 궤적을 LLM이 진단해 추론 시점 해결책과 코드 패치로 바꿔, 추가 학습 없이 루프를 닫습니다(OSWorld에서 42.3\% 에서 48.9\% 로 향상).
-
인프라 수준: 경험 그래프(experience graph) 연구는 장기 과제 에이전트의 분기, 실행, 실패, 수정이라는 탐색 구조를 그대로 보존해, 경험을 버리지 않고 질의할 수 있게 만드는 데이터 기반이 필요하다고 주장합니다.
코딩 에이전트를 다룬 실무자 관점의 분석은 이 문화적 변화를 정리합니다. 이제 사람이 설계하는 산출물은 단계별 프롬프트가 아니라 트리거, 목표, 검증, 정지 규칙, 메모리로 이루어진 루프 라는 것입니다. 사람의 노력이 작업을 직접 하는 것에서, 에이전트가 그 작업을 더 잘하게 되어도 되는 조건을 정하는 쪽으로 옮겨 가고 있으며, 저자들은 이것이 정확히 분류체계의 Human-on-the-loop 자세라고 봅니다. PyTorchKR에서 소개한 Meta-Harness, Agentic Harness Engineering(AHE), SIA(Self-Improving AI)도 하네스를 자동으로 진화시키는 같은 흐름의 연구입니다(SIA는 하네스와 함께 모델 가중치도 갱신합니다).
이 역량 자체를 측정하려는 시도도 시작되었습니다. Meta-Agent Challenge는 프런티어 모델에게 샌드박스 환경, 평가 API, 시간 예산을 주고 목표 지표를 최대화하는 에이전트 시스템을 자율적으로 개발할 수 있는지 평가합니다. 에이전트의 실행이 아니라 에이전트의 개발을 겨냥한 첫 벤치마크로, 분류체계의 세 번째 열과 네 번째 열의 경계를 직접 겨냥합니다. 진화의 단위도 개인을 넘어 넓어지고 있습니다. SAGE는 연산량을 맞춘 조건에서 고립된 자기 개선과, 에이전트가 동료의 전략과 결과를 관찰하는 사회화된(Socialized) 진화를 비교해, 공유된 경험이 혼자서는 얻을 수 없는 개선을 언제 만드는지 정량화했습니다.
다만 저자들은 이 갈래에서 얻는 이득을 과대평가하지 말아야 한다고 지적합니다. 자기 일관성, 자기 정제, 토론, 혼합 에이전트(Mixture-of-Agents)를 아우르는 34가지 설정으로 추론 스케일링 전략의 파레토 분석을 한 결과, MMLU-Pro에서 사고 사슬(CoT) 대비 최대 이득은 +7.1 점이었지만 약 20\times 의 연산 예산을 써야 얻을 수 있었고, 방법마다 효율 차이가 컸습니다. 자기 일관성은 일찍 포화되는 반면 멀티 에이전트의 이득은 더 오래 유지되었습니다. 저자들은 이로부터 실현된 이득의 상당 부분이 반복을 늘리는 것보다 연산을 고려한 방법 선택에서 나오며, 이 갈래의 이득 중 큰 몫이 재귀적인 무언가보다는 더 나은 엔지니어링에서 온다고 정리합니다.
스킬 라이브러리와 지속적 축적
하네스 진화와 짝을 이루는 갈래는 Voyager가 도입한 메커니즘, 곧 경험에서 증류한 재사용 가능한 스킬을 계속 늘려 가며 더 복잡한 행동으로 조합하는 스킬 라이브러리(Skill Library) 에 집중합니다. 오늘날 "스킬"은 대개 자연어 절차 문서와 실행 코드를 묶은 것으로, 에이전트가 런타임에 불러옵니다. 2026년의 핵심 실증 결과는 LLM이 스킬을 잘 작성하지 못한다 는 것입니다. SkillsBench에서 사람이 작성한 스킬은 통과율을 16.2 점 높였지만, LLM이 작성한 스킬은 측정 가능한 이득이 없었습니다.
저자들은 이 갈래 전체를 그 격차를 메우는 연구 프로그램으로 봅니다. SkillAxe는 평가에 기반한 자기 정제로 스킬 문서를 다듬고, Skill-R1은 스킬 최적화를 (폐쇄형일 수도 있는) 과제 모델과 분리된 순환 강화학습 문제로 다루며, SkillRevise는 불완전한 초기 스킬을 실행 기록에 근거해 수정하는 방식으로 콜드 스타트 문제를 다룹니다. 가장 멀리 나간 SkillMaster는 스킬의 생성, 정제, 선택을 외부 교사나 사람이 설계한 규칙에 맡기지 않고 에이전트가 직접 하도록 학습시켜, 스킬을 호출하는 자원이 아니라 내재화된 역량으로 만듭니다. 단일 에이전트를 넘어 스킬은 원시 궤적을 공유하지 않은 채 사용자 간에 연합되고, 스킬이 호출하는 도구 계층과 함께 진화하며, 코딩 에이전트의 약점을 겨냥한 학습 과제를 실행 기록에서 만들어 내는 데도 쓰입니다. NousResearch의 Hermes Agent Self-Evolution처럼 스킬과 프롬프트를 자동으로 진화시키는 오픈소스 프로젝트도 같은 흐름에 있습니다.
자유로운 자기 수정이 너무 위험한 영역에서는 진화할 수 있는 산출물을 일부러 제한합니다. 금융 트레이딩 에이전트를 다룬 SHARP는 사람이 감사할 수 있는 루브릭 정책 을 진화시킵니다. 신호 대비 잡음이 낮은 환경에서는 제한 없는 프롬프트 진화가 체계적인 논리 오류와 시장 변동을 구분하지 못하지만, 구조화된 루브릭은 감사하고, 차이를 비교하고, 되돌릴 수 있기 때문입니다. 저자들은 이 설계 원칙(자기 수정 범위를 제한해 검증 가능하게 유지한다)이 금융을 넘어 일반화된다고 봅니다.
스킬은 지속되고 실행되는 산출물이기 때문에, 이 갈래는 기술 코퍼스 전체에서 안전 공격면이 가장 넓습니다. 드물게도 공격 연구가 배포 이후가 아니라 거의 같은 시기에 나왔습니다. SkillMutator는 스킬의 자연어 명세와 실행 코드가 서로 다른 내용을 담는 교차 모달 공격을 벤치마크하고, VASO는 파운데이션 모델이 스킬을 만드는 비용은 없앴지만 스킬을 신뢰하는 비용은 줄이지 못했다고 보고 물리 에이전트를 위한 형식 검증 가능한 스킬 진화를 제안합니다. 자기 진화 에이전트 시스템의 위협 분석은 질적으로 새로운 위험을 짚습니다. 공격자가 계속 접근하지 않아도 적대적 영향이 영구적으로 기록되고, 세대를 거치며 스스로 증폭되며, 에이전트 집단을 통해 전파될 수 있다 는 것입니다. 건강한 진화(Healthy Evolution) 연구는 공격자가 없어도 역량 저하와 안전성 표류가 생긴다는 것을 보이고, 자기 진화의 여러 단계에 평가 피드백을 주는 외부 LLM 감독 모듈(ANCHOR)을 제안합니다.
저자들은 하네스와 스킬 진화를 제한된 자기 정제가 개방형 자기 수정으로 넘어가기 시작하는 지점으로 평가하며, 이 갈래의 두 가지 핵심 사실이 서로 반대 방향을 가리킨다고 설명합니다. 한편으로 실제 자율성은 크지 않습니다. 진화하는 것은 거의 언제나 신중하게 격리된 구성 요소 하나이고, 고정된 벤치마크로 검증됩니다. Darwin Gödel Machine의 경험적 검증 루프가 최첨단인 이유도 완전한 자기 참조는 아직 평가할 방법이 없기 때문입니다. 다른 한편으로 지속성은 위험 계산을 근본적으로 바꿉니다. 추론 시점의 실수는 사라지고 잘못된 가중치 갱신은 되돌릴 수 있지만, 공유되고 연합되는 라이브러리 안의 오염된 스킬은 퍼져 나갑니다. 저자들은 안전 연구가 핵심 문제를 검증 없는 축적 으로 정확히 짚었다고 보며, 이를 같은 검증 병목에 메모리가 더해진 형태라고 표현합니다.
학습 시점 자기 반복(Training-Time Self-Iteration)
배포 시점의 개선이 가중치 바깥에 머문다면, 두 번째 범주는 루프를 가중치 안으로 들여옵니다. 모델이 자기 학습 데이터, 보상, 교사 신호를 만들고, 그 개선이 가중치에 남습니다. 이 범주(340편)를 저자들은 현재 실천되는 RSI의 기술적 핵심이자 분야가 가진 것 중 산업 표준에 가장 가까운 것으로 봅니다.
계보는 STaR의 부트스트랩 근거 생성에서 시작해 ReST^EM의 대규모 자기 학습, SPIN의 셀프 플레이 미세조정을 거쳐 Self-Rewarding Language Models로 이어집니다. Self-Rewarding LMs에서는 응답을 생성하는 모델이 그 응답을 직접 심사하므로, 반복할수록 정책과 보상 신호가 함께 개선됩니다. 저자들은 이를 널리 주목받은 첫 번째 진정한 재귀적 학습 루프이자, 이 범주의 대표적인 실패 모드가 시작된 지점으로 봅니다.
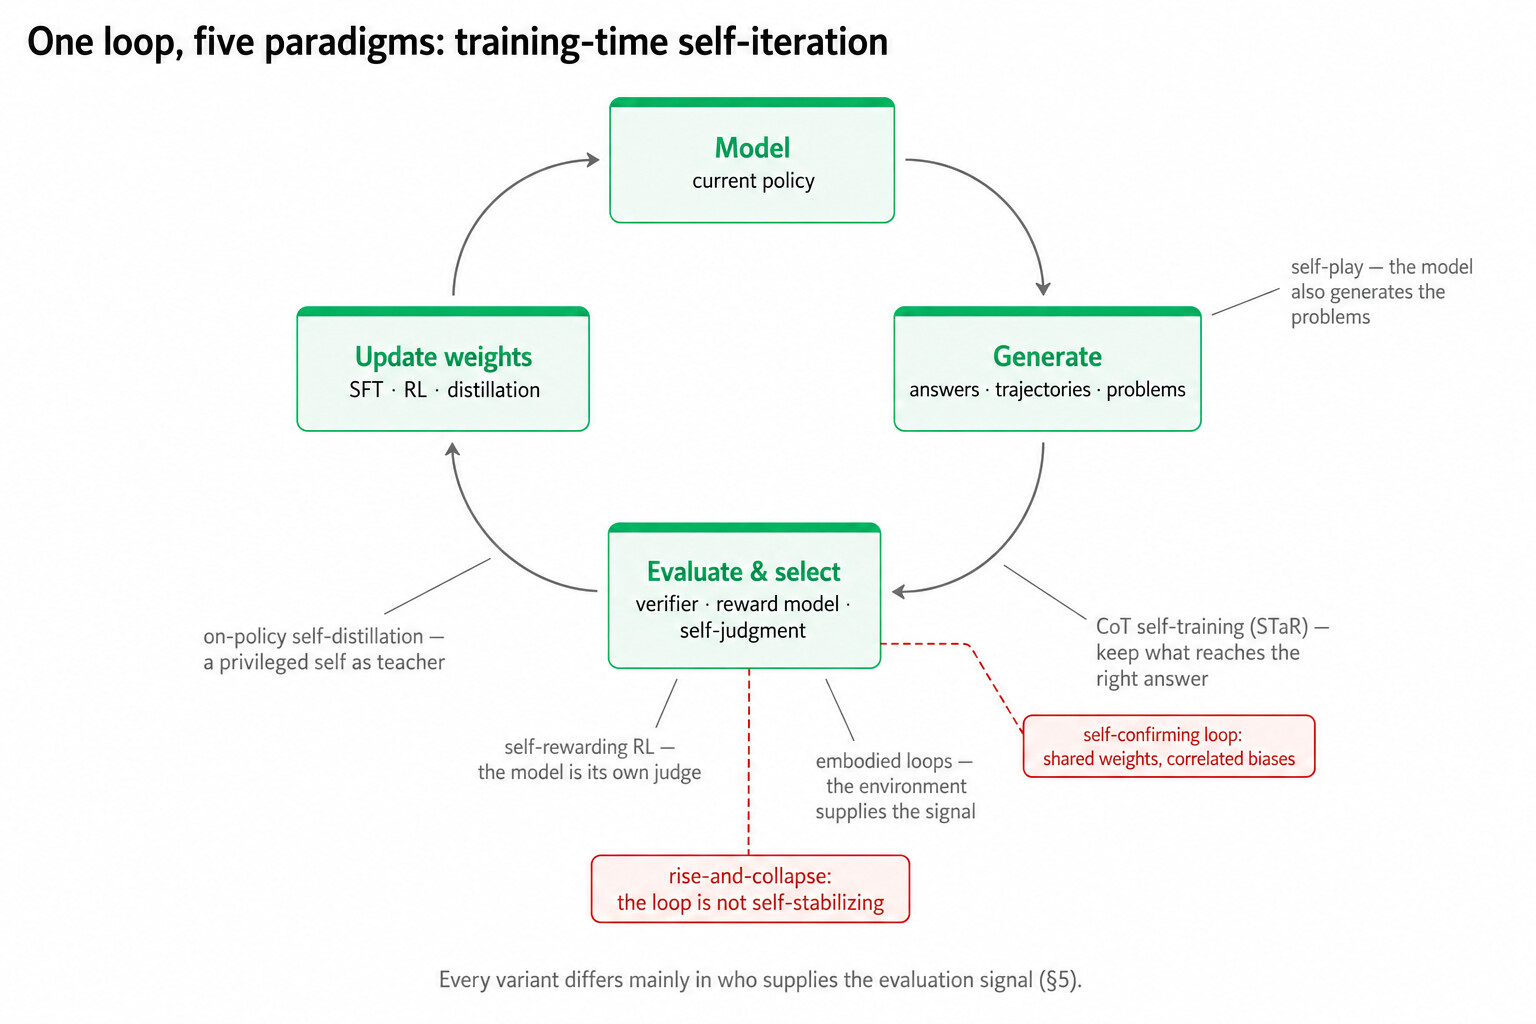
위 그림은 학습 시점 자기 반복을 하나의 순환으로 보여줍니다. 모델이 답과 궤적(셀프 플레이에서는 문제까지)을 생성하고, 평가하고 선택한 뒤, 가중치를 갱신합니다. 이 범주의 다섯 패러다임은 주로 평가 신호를 누가 제공하는가 에서 갈리고, 두 가지 실패 모드(자기 확증 루프, 상승 후 붕괴)는 모두 평가와 선택 단계에서 발생합니다.
자기 보상 강화학습
자기 보상 갈래는 보상 신호 자체를 얼마나 스스로 만들 수 있는지를 묻습니다. 이 갈래에서 가장 많이 인용된 ReST-MCTS*는 완성된 풀이를 최종 정답만으로 거르면 추론은 틀렸는데 운 좋게 답을 맞힌 경우까지 받아들이게 된다는 점에 주목하고, 트리 탐색으로 과정(process) 보상을 추론해 중간 단계마다 점수를 매겨 더 질 좋은 자기 학습 데이터를 얻습니다. 과정 보상이라는 아이디어는 이후 여러 갈래로 퍼졌습니다. SEVA는 검증을 하나의 에이전트로 구성해 불투명한 이진 레이블 대신 근거 정렬과 보정된 신뢰도를 내놓고, EvoIdeator는 과학 아이디어 생성에서 스칼라 루브릭 보상을 체크리스트 기반 신호로 바꾸며, RePro는 단순한 온라인 진행도 프롬프트가 오히려 성능을 떨어뜨린다는 것을 확인하고 장기 과제 에이전트에 회고적 진행 인식을 더했습니다. 자기 생성 가치 신호가 애초에 왜 가능한지에 대한 해석 가능성 연구도 있습니다. 가치 축(value axis) 연구에 따르면 언어 모델은 현재 궤적이 제대로 가고 있는지를 추적하는 방향을 활성화 공간에 갖고 있으며, 말로 된 비판이 나오기 전부터 자기 보상에 쓸 수 있는 신호가 이미 존재합니다.
저자들은 이 범주의 종착점을 가장 분명하게 보여 주는 연구로 Self-Trained Verification을 꼽습니다. 이 연구는 서베이가 계속 돌아오는 관찰, 곧 테스트 시점의 검증과 정제 루프와 학습 시점의 자기 학습이 같은 병목인 검증기에 막혀 있다 는 점에서 출발합니다. 전자는 검증기 점수는 부풀지만 정확도는 그대로일 때 멈추고, 후자는 질 나쁜 자기 생성 데이터가 학습에 들어갈 때 실패합니다. 그래서 이 연구는 검증기 자체를 자기 학습시켜 두 지점을 한꺼번에 풀려고 합니다. 저자들은 검증기 자기 학습이 풀려던 순환 문제를 실제로 벗어나는지, 아니면 순환을 다른 곳으로 옮길 뿐인지를 이 계열에서 가장 중요한 열린 질문으로 봅니다.
가장 강한 경고도 이 갈래에서 나왔습니다. Lin의 연구는 코드에 대한 REINFORCE 사후 학습에서 상승 후 붕괴(rise-and-collapse) 라는 실패 모드를 보고합니다. 연속된 학습 캠페인 동안 pass@1이 오르다가 같은 실행 안에서 무너지며, 때로는 거의 0까지 떨어집니다. 진짜로 검증 가능한 이진 보상을 썼는데도 그랬고, KL(Kullback-Leibler) 발산 제약이나 EWC(Elastic Weight Consolidation) 방식 제약으로도 막지 못했습니다. 곧 자기 학습이 퇴보하는 데 보상 모델의 오정렬이 꼭 필요한 것은 아니며, 최적화 동역학만으로도 충분합니다. 마찬가지로 LLM이 생성한 보상 설계는 보상 범람, 환경 API에 대한 의미적 오해 같은 전형적인 방식으로 실패하므로, 한 번에 만들기보다 반복 디버깅으로 다루는 편이 낫습니다. 앞서 소개한 과학적 기억상실 연구도 여기에 속합니다. 기본 모델을 선호 캠페인마다 반복해서 DPO로 학습시키는 파이프라인은 학습한 행동은 유지하지만, 다음 캠페인을 어떻게 운영할지에 대한 방법론적 지식은 쌓지 못합니다. 모델은 개선되지만 과정은 개선되지 않는 셈입니다. 저자들은 이 결과들이 가장 검증하기 쉬운 환경에서도 루프가 스스로 안정되지 않는다는 것을 보여 준다고 정리합니다.
사고 사슬(CoT) 자기 학습
자기 보상 갈래가 보상을 바꾼다면, 이 갈래는 데이터 를 바꿉니다. 모델 자신의 추론 기록이 커리큘럼이 됩니다. 근거를 샘플링하고, 정답에 도달한 것만 남겨 미세조정하고, 이를 반복하는 STaR 방식이 여전히 뼈대입니다. Re-ReST는 실패한 궤적을 환경 피드백으로 고치는 성찰 모듈을 더해 실패를 버리지 않고 학습 신호로 바꾸며, PRefLexOR는 루프를 중간 추론 단계에 대한 재귀적 선호 최적화로 다시 구성합니다. LaTRO는 외부 보상 없이도 모델 자신의 우도를 잠재 변수 목적 함수로 삼아 루프를 돌릴 수 있음을 보이고, 베이스 모델 안에 숨어 있던 추론 능력을 끌어낸다고 설명합니다. 사후 학습은 능력을 새로 만드는 것이 아니라 잠재된 능력을 증폭한다는 이 관점은 이제 독립된 연구 질문이 되었고, NeuReasoner처럼 능력 이끌어내기가 어디서 통하고 어디서 실패하는지 경계 조건을 정리하는 연구도 나왔습니다.
검증기 없이 이 방식을 어디까지 쓸 수 있는지도 직접 확인되고 있습니다. Self-Verified Distillation은 정답, 도구, 외부 교사 없이 레이블 없는 질문만으로 출발해, 모델 자신의 후보 풀이를 프롬프트 기반 자기 검증으로 걸러 수학, 과학, 코딩 성능을 높였습니다. Semi-CoT는 같은 문제를 반지도 학습으로 정식화해 레이블 없는 질문에서 의사 추론 감독을 만듭니다. 이 루프는 앞서 다룬 테스트 시점 학습을 통해 배포 안으로 옮겨 가고 있어, 추론과 학습의 경계가 양쪽에서 흐려지고 있습니다.
2026년의 흐름은 세 가지 교정으로 정리됩니다:
-
효율: o1 방식의 긴 사고는 과하게 길어지기 쉬워, 사소한 문제에도 수천 토큰을 씁니다. 같은 길이에서도 틀린 추론 기록이 맞는 기록보다 비생산적인 자기 성찰을 더 많이 담고 있다는 결과가 나오면서, 언제 멈출지 가르치는 구간 단위 신용 할당이 제안되었습니다.
-
공동 최적화: ThinkTwice는 같은 이진 보상 아래에서 풀이와 정제를 번갈아 학습시켜, 자기 정제를 프롬프트 기법이 아니라 학습된 능력으로 만듭니다.
-
범위의 한계: "검증 가능한 탐색이 학습 가능한 사고 사슬은 아니다"라는 부정적 결과는, 모델이 실행할 수는 있지만 추론 기록으로 미세조정해도 내재화하지 못하는 절차의 부류가 있다는 것을 보였습니다. 자기 학습은 기반 아키텍처의 표현 한계를 그대로 물려받으며, 루프를 더 돌린다고 아키텍처가 배울 수 없는 것을 고칠 수는 없습니다.
온폴리시 자기 증류(OPSD)
온폴리시 자기 증류(On-Policy Self-Distillation, OPSD) 는 2026년 이전에는 존재하지 않던 코퍼스에서 가장 최근에 생긴 갈래인데, 이미 56편으로 늘었습니다. 저자들은 이를 이 분야가 새 패러다임을 얼마나 빨리 확립하는지 보여 주는 가장 선명한 예로 듭니다.
방식은 다음과 같습니다. 하나의 모델이 학생과 특권 교사(Privileged Teacher) 역할을 함께 맡습니다. 교사는 같은 가중치이지만 참고 풀이, 검증된 피드백, 더 풍부한 문맥 같은 추가 정보를 조건으로 받고, 학생은 자기 롤아웃에서 교사의 토큰 단위 분포를 따라가도록 학습합니다. 토큰 단위의 밀도 높은 감독을 받으면서도 외부 교사나 보상 모델이 필요 없습니다. 별도의 서베이도 이미 있지만, 저자들이 주목하는 것은 RSI 스펙트럼에서 이 패러다임의 위치입니다. 교사 신호까지 스스로 만들어 내므로, 일상적으로 쓰이는 학습 루프 중 가장 닫혀 있는 루프입니다.
이론 정리도 진행되고 있습니다. 거듭제곱 분포(power distribution) 분석은 샘플링, 자기 보상 강화학습, 자기 증류를 하나의 분포 연산의 사례로 묶어, 겉보기에 다른 이 루프들이 왜 비슷하게 동작하는지 설명합니다. 가장 단순한 쪽 끝에서는 당황스러울 만큼 단순한 자기 증류(Embarrassingly Simple Self-Distillation)가 검증기도, 교사도, 강화학습도 없이 온도와 절단(truncation) 샘플링에 SFT만으로 코드 생성을 개선해, 검증기 없는 이득이 어디까지 갈 수 있는지라는 질문을 남겼습니다. 정제 방향의 연구는 경험적입니다. 틀린 롤아웃이 맞는 롤아웃보다 정보가 많아 가중치를 다시 매겨야 하고, 난이도 라우팅을 관리하지 않으면 쉬운 문제에 과최적화되며, 롤아웃 속 절차적 정보는 에피소드마다 버리지 않고 증류된 메모리로 남길 수 있습니다.
실패 모드도 잘 정리되어 있고, 배포 시점 범주의 실패와 닮았습니다. Purified OPSD는 기본 방식이 긴 CoT 추론 모델에서는 일관되게 실패 하며, 강화하려던 성찰 행동을 오히려 흔든다는 것을 보였고, DemoPSD는 특권 교사의 밀도 높은 감독이 도메인 내 패턴에 과적합할 수 있다고 지적하고, 교사 분포를 선택적으로만 따르게 해 이를 완화합니다. 대조 분석 연구(RLCSD)는 그 메커니즘을 짚습니다. 특권 분포와 비특권 분포의 차이에서 나오는 학습 신호가 과제와 관련된 토큰이 아니라 문체(style) 토큰에 몰리는데, 힌트를 받은 교사가 더 짧고 직접적인 글을 쓰기 때문입니다. 그 결과 생기는 특권으로 인한 문체 표류(Privilege-induced Style Drift)가 학습을 불안정하게 만들거나 응답 길이를 무너뜨립니다. 또 다른 구조적 병리인 접두 실패(Prefix Failure)는 토큰 단위의 밀도 높은 감독이 교사 분포를 두 봉우리로 갈라 그래디언트를 조각내는 현상으로, 토큰 단위 손실 가중치 조정으로는 고칠 수 없어 궤적 단위의 개입이 필요합니다. 결국 모든 것이 특권 교사에게 무엇을 보여 주는지에 달려 있으므로, 어떤 피드백을 어느 정도 구체적으로 줄지 정하는 특권 문맥의 설계가 이 패러다임의 핵심 자유도로 떠오르고 있습니다. 멀티모달에서는 지름길이 구조적으로 생깁니다. 특권 목표가 있으면 교사가 이미지를 무시하고 텍스트 참고 답안만으로 토큰을 이끌 수 있어, 학생은 지각 능력이 아니라 언어 사전 지식을 증류받게 되므로 지각과 추론을 명시적으로 분리해야 합니다. 저자들은 이 갈래의 교훈을 "자기 생성 신호가 특권적일수록, 루프는 능력과 편향을 똑같이 효율적으로 전달한다"로 요약합니다.
셀프 플레이(Self-play)
셀프 플레이는 루프를 한 단계 더 닫습니다. 모델이 답이나 보상만이 아니라 문제 까지 만듭니다. 현대적인 계보는 이전 반복의 자기 자신을 상대로 미세조정하며 정책이 목표 데이터 분포와 일치할 때 목적 함수의 전역 최적점에 이른다는 것이 증명된 SPIN에서, 제로 데이터 출제자와 풀이자 프레임워크인 Absolute Zero와 R-Zero로 이어집니다. 이 프레임워크들에서는 도전자(Challenger)가 풀이자(Solver)의 역량 경계에 있는 문제를 내도록 학습하고, 사람이 만든 과제 없이 하나의 베이스 모델에서 둘이 함께 진화합니다. Agent0는 이 방식을 추론 문제에서 에이전트 과제로 넓혀, 외부 데이터 없이 커리큘럼 에이전트와 도구를 쓰는 실행 에이전트를 함께 진화시킵니다. 저자들은 셀프 플레이를 현존하는 학습 패러다임 중 자율 커리큘럼에 가장 가까운 것으로 보며, 실행 가능한 지리공간 프로그램, 증명자와 추측자의 공진화 이론이 나온 형식 정리 증명, 검증기에 기반한 어려운 수학 문제 생성처럼 프로그램 검증기가 있는 곳에서는 놀라울 만큼 잘 동작한다고 평가합니다.
그러나 이 갈래의 핵심 발견은 안정성에 관한 것입니다. 체계적인 셀프 플레이 연구는 셀프 플레이가 안정적으로 유지되는지가 두 가지 조절 요인, 곧 데이터 게이팅(Data Gating, 무엇을 학습 데이터에 넣는가) 과 보상 근거화(Reward Grounding, 무엇이 신호를 현실에 묶어 두는가) 에 달려 있다고 봅니다. 두 요인의 영향은 비대칭이어서, 엄격한 데이터 게이트만 있으면 정답 없는 자기 일관성 보상을 포함한 모든 보상 변형에서 안정적이었지만, 게이트를 없애면 어떤 보상 설계로도 붕괴를 막지 못했습니다. 이 연구는 보상 보정이 아니라 데이터 게이팅이 결정적 제약이라고 결론 내립니다. 집단 기반 변형은 자기 보정 대신 함께 진화하는 하위 집단 간 교차 평가로 같은 문제를 구조적으로 다룹니다. 검증할 수 없는 과제에서는 어려움이 더 커집니다. LLM 심판 보상은 심판 자신의 역량을 넘지 못하므로, 모델이 평가를 평가하도록 배우는 메타 평가와 모델 간 예측 변화에 기반한 검증기 없는 내재 보상(G-Zero)이 제안되었습니다. 개방형 상호작용 동역학에서 나온 경고도 있습니다. 여러 턴의 LLM 셀프 플레이 대화는 주제와 무관한 끌개 상태(attractor state)로 표류하는데, 공진화 커리큘럼이 새로움을 계속 만들어 내려면 바로 이 균질화 압력과 싸워야 합니다.
체화 및 합성 데이터 루프
이 범주의 가장 새로운 최전선은 학습 루프를 물리 환경과 합성 데이터 환경으로 옮깁니다. 이곳에서는 검증이 비싸고, 잡음이 많고, 느립니다. 로봇은 VLM을 내부 비평가로 두고 자기 사회적 행동을 비판하고 다시 계획하며, VLA(Vision-Language-Action) 정책은 순방향으로만 행동하지 않고 실행 중에 물리적 실현 가능성을 확인하고 자기 성찰합니다. Embodied-R1.5는 계획, 교정, 지시(pointing)를 하나의 아키텍처에 통합해 자기 진화하는 물리 지능을 목표로 합니다. 사람 영상 동역학 모델을 이용한 로봇 자기 개선 연구는 수동적인 사람 영상이 정책 초기화뿐 아니라 체화된 연습과 실패로부터의 학습 까지 뒷받침할 수 있는지 시험합니다. PyTorchKR에서 소개한 NVIDIA의 ASPIRE처럼 스스로 코드를 고치며 스킬을 쌓는 로봇 학습 연구도 이 흐름과 가깝습니다. 데이터 쪽에서는 루프가 파이프라인 자체를 향합니다. DataEvolver는 LLM 학습용 데이터 준비 과정을 자기 진화시켜, 다른 모든 학습 루프가 소비하는 기반 자체를 개선 대상으로 삼습니다.
학습 시점 루프에서 반복된 세 가지 사실
저자들은 학습 시점 루프를 제한된 자기 개선이 제 몫을 하는 곳으로 평가합니다. 개선이 남고, 확장되고, 반복하며 누적됩니다. 무너지기 전까지는 그렇습니다. 그리고 모든 하위 갈래가 각자 독립적으로 같은 세 가지 사실을 다시 발견했다고 정리합니다:
-
루프의 상한은 검증 신호가 정합니다: 실행 결과와 증명이 가장 높고, 학습된 심판이 그다음이며, 내재 신호가 가장 낮습니다.
-
붕괴는 예외가 아니라 기본 동역학입니다: 상승 후 붕괴와 셀프 플레이 안정성 연구가 보여 주듯, 붕괴는 의도적으로 설계해서 막아야 하는 대상입니다.
-
루프는 능력과 편향을 똑같이 효율적으로 전달합니다.
저자들은 이 세 가지를 2부의 자기 평가 범주를 떠받치는 사실로 삼습니다.
1부에서 확인한 패턴: 외부 신호가 개선의 상한을 정한다
1부에서 살펴본 두 범주는 서로 다른 곳에 개선을 남깁니다. 배포 시점 자기 진화는 출력, 세션, 하네스에 개선을 남기고, 학습 시점 자기 반복은 가중치에 남깁니다. 그러나 두 범주에서 나온 결과는 같은 방향을 가리킵니다. 외부 신호 없이 스스로를 비판하는 루프는 출력을 자기 분포 쪽으로 끌어당기는 경향이 있고, 코드와 증명처럼 검증기가 강한 곳에서 개선이 가장 확실하며, 검증 신호가 약할수록 개선의 상한이 낮아지며, 붕괴는 검증 가능한 보상에서도 기본 동역학입니다.
저자들이 개선의 판정자인 평가기 자체를 개선 대상으로 삼는 독립 범주를 세운 이유가 여기에 있습니다. 하네스에서는 Red Queen Gödel Machine이 평가기를 함께 진화시키고, 학습 루프에서는 Self-Trained Verification이 검증기를 스스로 학습시키는 것처럼, 두 범주의 최전선은 모두 평가기를 향하고 있습니다. 이 평가기를 개선하려는 시도가 루프를 안정시키는지, 아니면 편향을 한 층 더 쌓는지가 이 서베이 후반부의 핵심 질문입니다.
 (2/2편에서 자기 평가와 검증 계층, 자동 연구, 이론적 한계와 안전 문제에 대해서 계속됩니다)
 Recursive Self-Improvement in AI: From Bounded Self-Refinement to Autonomous Research Loops 논문
 1,250편 코퍼스와 분류 스크립트를 담은 recursive-self-improvement GitHub 저장소
Anthropic Institute의 재귀적 자기 개선 에세이 (When AI builds itself)
더 읽어보기
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글은 파이토치 한국 사용자 모임 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
