핵심 요약
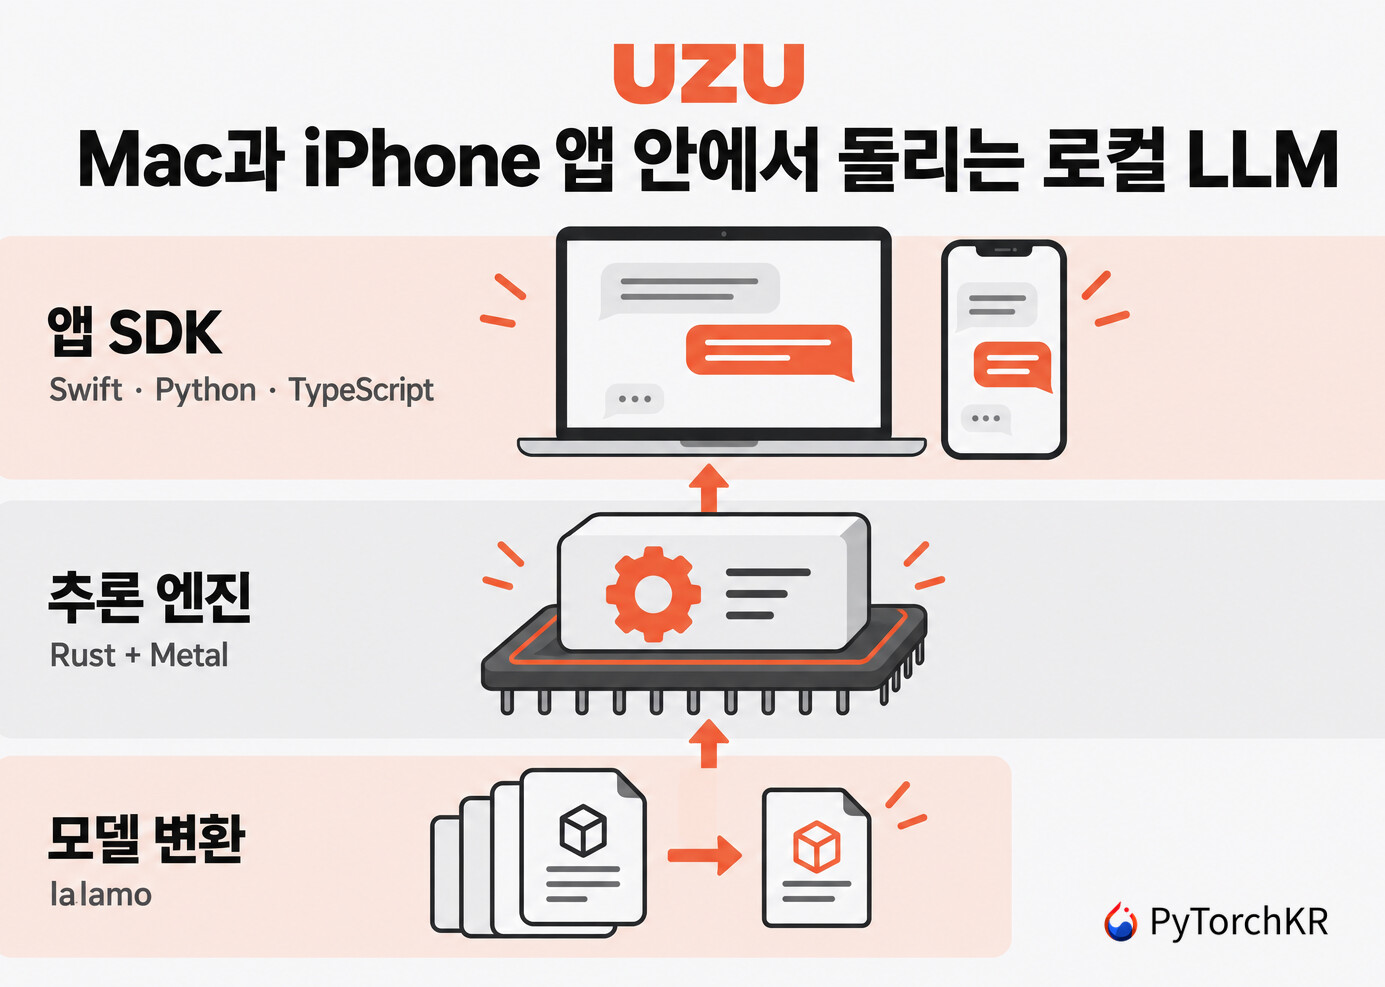
- uzu는 런던의 Mirai가 MIT 라이선스로 공개한 Rust 추론 엔진으로, Swift, Python, TypeScript, Rust 앱 안에서 Mac과 iPhone의 GPU(Metal)로 LLM을 실행합니다.
- 모델은 Mirai의 자체 형식으로 변환해서 써야 하며, Mirai가 Hugging Face에 올려 둔 4비트(Mirai-M)와 8비트(Mirai-L) 체크포인트는 모델 식별자 한 줄로 내려받아 바로 쓸 수 있습니다.
- Mirai의 벤치마크 페이지에서 같은 자기회귀 방식끼리 비교하면 uzu의 출력 속도는 MLX보다 중앙값 기준 약 8% 빠른 수준이고, 4배 안팎의 큰 격차는 일부 모델에서 M5 이후 칩 기준으로만 측정된 자체 추측 디코딩에서 나옵니다.
- 배포 패키지는 Apple 기기 전용이며(Swift 패키지는 macOS와 iOS 26.4 이상, 파이썬 휠은 macOS 26 이상), 고수준 API 크레이트 대부분이 저장소에서 재작성 대상(
legacy)으로 분류되어 있습니다.
uzu 소개
맥에서 로컬 LLM을 실행하는 방법은 이미 여럿입니다. llama.cpp는 GGUF 파일 하나로 거의 모든 플랫폼에서 동작하고, Apple의 MLX와 그 위의 mlx-lm은 Apple Silicon에 맞춘 파이썬 중심 도구입니다. 그런데 이 도구들은 대부분 개발자의 맥에서 서버나 스크립트로 모델을 실행하는 쪽에 맞춰져 있습니다. 출시하는 iPhone 앱이나 macOS 앱 안에 모델을 넣어 사용자 기기에서 실행하려면 바인딩, 모델 다운로드, 메모리 관리를 직접 엮어야 합니다. 이번에 소개하는 uzu는 이 문제를 겨냥해 Mirai가 만든 온디바이스(On-device) 추론(Inference) 엔진으로, Rust로 작성한 코어를 Swift, Python, TypeScript 바인딩으로 감싸 앱에 바로 넣을 수 있게 했습니다.
uzu는 범용 런타임(Runtime)보다 모델 변환, 양자화, 커널을 한 회사가 함께 설계하는 방식을 택했습니다. 원본 체크포인트는 Mirai의 변환 도구 lalamo로 uzu 전용 형식으로 바꾸고, 엔진은 그 형식을 이루는 블록마다 Metal 커널을 둡니다. 앱 코드에서는 alibaba:qwen3.5:0.8b:mirai:mirai-m:4 같은 모델 식별자를 넘기면 다운로드부터 추론 설정까지 엔진이 처리합니다. Mirai는 여기에 자체 양자화 형식(Mirai-M, Mirai-L)과 초안 모델 기반의 추측 디코딩(Speculative Decoding)을 얹어 Apple 기기에서 MLX와 llama.cpp보다 빠르다고 주장합니다.
uzu를 만든 Mirai는 2024년 런던에서 설립된 약 20명 규모의 회사로, 2026년 2월 Uncork Capital이 이끈 1,000만 달러 시드 투자를 받았다고 밝히고 있습니다. 엔진 자체는 MIT 라이선스의 오픈소스이고, Mirai는 추론 엔진 소개 페이지에서 모델 회사와 연구팀을 대상으로 모델 변환, 최적화, 배포를 상담 문의로 받습니다. 엔진 기능으로는 스트리밍 채팅, JSON 스키마 기반 구조화 출력, 도구 호출, 메모리에 올린 모델을 여러 세션이 공유하는 인스턴스, 그리고 OpenAI 호환 HTTP 서버를 실행하는 CLI가 있습니다. 같은 API에 OpenAI API 키를 설정하면 클라우드 모델도 같은 방식으로 호출할 수 있어서, 앱에서 로컬 모델과 클라우드 모델을 한 인터페이스로 다룰 수 있습니다.
uzu vs. MLX, llama.cpp, Splash
uzu와 자주 비교되는 Apple Silicon 추론 도구의 성격은 다음과 같습니다:
| 항목 | uzu | MLX (mlx-lm) | llama.cpp | Splash |
|---|---|---|---|---|
| 주 용도 | 앱 내장 SDK, macOS 앱, CLI, 로컬 서버 | 파이썬 라이브러리, 로컬 서버 | 크로스플랫폼 라이브러리, 서버 | 맥 데스크톱 앱, 로컬 서버 |
| 대상 기기 | macOS, iOS, Mac Catalyst 26.4 이상 | Apple Silicon 중심 | macOS, Linux, Windows 등 | M3 이상 맥, macOS 26.4 이상 |
| 모델 형식 | lalamo로 변환한 자체 형식 | MLX 형식 (mlx-community 등) | GGUF | 지원하는 5개 계열의 GGUF, MLX 4비트 체크포인트 |
| 추측 디코딩 | 자체 초안 모델 (일부 모델) | mlx-lm의 초안 모델 옵션, oMLX와 MTPLX 같은 확장 | 초안 모델, EAGLE3, MTP, DFlash 등 (서버) | 계열별 DFlash2 초안 모델 자동 선택 |
| 언어 바인딩 | Swift, Python, TypeScript, Rust | Python, C++, C, Swift | C/C++ 중심, 다수 바인딩 | HTTP API |
가장 큰 차이는 형식과 배포 대상입니다. llama.cpp와 MLX는 커뮤니티가 올린 GGUF나 MLX 체크포인트를 그대로 받아 쓰지만, uzu는 lalamo로 변환한 모델만 읽습니다. 그래서 이미 지원되는 블록으로 이루어진 모델은 변환 명령 한 번이면 되지만, 새로운 종류의 레이어가 들어간 모델은 Mirai가 변환 도구와 커널을 함께 추가해야 실행할 수 있습니다. Splash도 지원 모델 계열을 소수로 한정하고 계열마다 맞춘 Metal 커널과 DFlash2 초안 모델을 쓰지만, 커뮤니티의 GGUF와 MLX 체크포인트를 그대로 받는다는 점, 그리고 iPhone 앱용 Swift SDK 없이 맥 전용으로 동작한다는 점에서 uzu와 다릅니다.
uzu를 사용하면 좋을 사용자
uzu가 가장 잘 맞는 경우는 iPhone, iPad, Mac 앱에 소형 LLM을 넣어 네트워크 없이 사용자 기기에서 실행하려는 앱 개발자입니다. Swift Package Manager 한 줄로 엔진과 미리 변환된 Qwen3.5, LFM2.5 체크포인트를 쓸 수 있습니다. iPhone 17 Pro Max에서 측정한 Mirai의 데이터에서도 uzu는 대부분 모델에서 MLX Swift와 llama.cpp보다 빠릅니다. M5 이후 칩의 맥에서 Qwen3.6 27B 같은 지원 모델을 로컬 코딩 에이전트 백엔드로 쓰려는 개발자에게도 추측 디코딩 덕분에 선택지가 됩니다.
Linux나 Windows 서버, 또는 Mirai가 아직 변환하지 않은 모델을 바로 돌려야 하는 팀에게는 uzu가 아직 적절한 선택지가 아닙니다. PyPI 휠과 npm 패키지가 macOS용만 배포되고, 변환된 모델도 Qwen, LFM, Muse-Glimmer 계열을 중심으로 한 30여 개 체크포인트(실험판 포함)에 머물러 있기 때문입니다. 또한 Mirai가 밝힌 양자화 보정 데이터(OpenHermes-2.5)와 품질 평가(MMLU-Pro, Lmsys-Chat-1M 기반 KL)는 영어 중심입니다. 그래서 한국어 서비스에 쓰려면 같은 프롬프트로 원본 모델과 출력 품질을 직접 비교해 보는 편이 안전합니다(Mirai가 공개한 데이터 구성에서 끌어낸 편집자의 판단입니다).
uzu의 모델 변환과 Mirai 양자화 형식
Mirai의 FAQ에 따르면 lalamo가 만드는 형식은 통일된 블록들로 이루어진 중간 표현(Intermediate Representation)이고, 엔진은 블록마다 백엔드별 커널을 둡니다. 저장소의 crates/uzu-engine에는 임베딩, 트랜스포머 레이어, MLP, 토큰 믹서 같은 블록 단위 구성과 함께 metal, cpu, webgpu 백엔드 디렉토리가 있습니다. 다만 README가 지원 백엔드로 밝힌 것은 metal과 cpu이고, WebGPU 런타임은 2026년 10월 28일에 병합된 상태입니다.
Mirai가 배포하는 체크포인트는 두 가지 양자화(Quantization) 형식입니다. Mirai-M은 4비트 영점(zero point)과 bf16 스케일을 쓰는 4비트 비대칭 정수 양자화이고(Qwen3.6-27B-M 모델 카드 기준 그룹 크기 64), Mirai-L은 8비트 대칭 양자화입니다. 두 형식 모두 블록 크기 32의 랜덤 하다마드 변환(Random Hadamard Transform)으로 이상치(outlier)를 줄인 뒤 양자화합니다. Mirai는 이 블록 크기를 GPU 워프 폭에 맞춰, 변환을 RMSNorm과 행렬 곱 커널 안에 합쳐 넣었다고 설명합니다. 정식 형식에서는 3, 5, 6비트 같은 중간 비트 수를 커널 효율 때문에 일부러 쓰지 않았다고 밝혔고, 가중치당 2.4비트의 Mirai S 형식은 Qwen3.8 27B 실험판(8.45GB)으로만 따로 공개되어 있습니다.
양자화 절차는 2단계로 구성되어 있습니다: 먼저 2차 정보를 쓰는 YAQA 알고리즘을 JAX로 다시 구현한 학습 후 양자화(Post-Training Quantization)를 적용합니다. 이어서 원본 모델이 생성한 응답으로 양자화 그룹의 스케일과 영점을 짧게 다시 맞추는 양자화 인식 증류(Quantization-Aware Distillation)를 거칩니다. Mirai의 양자화 글에 따르면 Qwen3.5 0.8B와 2B의 Mirai-M은 llama.cpp의 Q4_K_M과 품질이 비슷하면서 크기가 약 20% 작고, 4B는 Q3_K_M과 Q4_0 사이에 놓입니다. 8비트 Mirai-L은 MLX 8비트, Unsloth UD-Q8_K_XL과 품질 차이를 구분할 수 없다고 밝히고 있으며, 이 비교는 MMLU-Pro와 원본 대비 KL 발산(KL Divergence)으로 측정했습니다.
uzu의 추측 디코딩 구조
추측 디코딩은 작은 초안 모델이 다음 토큰 여러 개를 미리 제안하고, 본 모델이 한 번의 순전파로 그 제안을 검증해 받아들이는 기법입니다. 모델에 내장된 MTP(Multi-Token Prediction)가 한 번에 3~4개 토큰을 제안하는 것과 달리, Mirai는 한 번에 16~32개 토큰이라는 큰 예산을 쓴다고 설명합니다. 검증할 토큰이 많아지면 큰 행렬 곱(GEMM) 커널을 쓸 수 있고, Mirai는 이를 M5 칩 GPU의 Neural Accelerator가 제공하는 int8 행렬 곱 경로에 올렸다고 설명합니다. 이를 위해 uzu는 추론 중 활성값도 8비트로 동적 양자화하며, 이 경로는 M5 이후 칩을 전제로 합니다.
초안 모델은 DFlash-Weaver라는 이름의 하이브리드 구조로, Mirai는 이 방식을 Trees from Marginals 논문으로 따로 공개했습니다. DFlash (
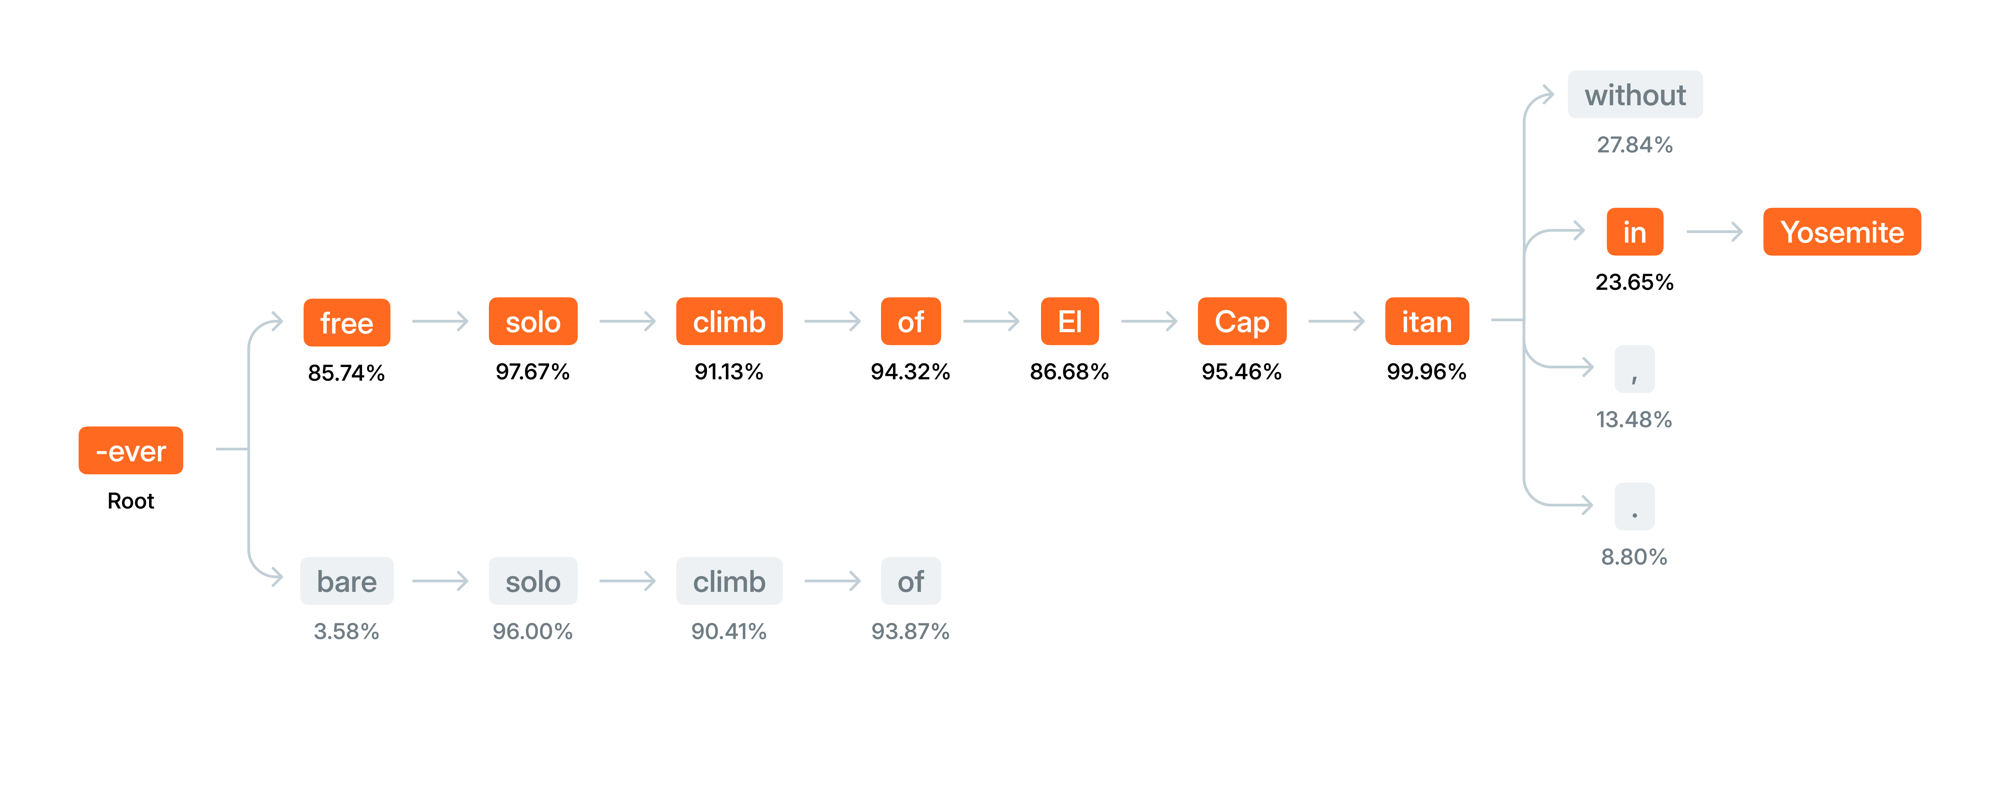
 DFlash: 블록 확산(Block Diffusion) 기반으로 LLM 추론 속도를 높이는 오픈소스 라이브러리 (feat. Z.ai)) 방식의 병렬 초안 모델이 위치별 상위 후보를 내면, 5,670만 파라미터의 작은 자기회귀 트랜스포머(Weaver)가 그 후보들을 하나의 트리로 연결합니다. 초안이 확신할 때는 긴 사슬을, 확신이 낮을 때는 가지가 넓게 퍼지는 트리를 만들도록 트리 모양을 바꾸는데, Mirai는 에이전트 코딩에서는 긴 사슬이, 창작 글쓰기에서는 넓은 트리가 나온다고 설명합니다. 아래 그림은 Mirai가 공개한 초안 트리 예시로, 주황색 노드가 본 모델이 받아들인 경로입니다:
Qwen3.6은 순환 상태를 가진 Gated DeltaNet 레이어를 섞은 하이브리드 구조입니다. Mirai는 이 레이어의 출력을 트리 전체에 대해 한 번에 계산하는 되돌리기 없는(rollback-free) 검증 커널을 Metal로 구현했습니다. 트리의 노드마다 상태를 저장하는 대신 QKV 벡터를 캐시해 두고, 상태 갱신은 채택된 경로가 정해진 다음 순전파로 미뤘다고 밝히고 있습니다. 초안 모델 가중치는 Hugging Face의 Qwen3.6-27B-M 저장소 안 speculator/ 디렉토리에 본 모델과 함께 들어 있습니다. 2026년 10월 20일 기준 벤치마크 데이터에서 추측 디코딩 결과가 있는 모델은 Qwen3.5 9B, Qwen3.6 27B, Qwen3.8 27B, Muse-Glimmer 30B 4종이고, 측정 기기도 M5와 M6 계열뿐입니다.
uzu 벤치마크
Mirai는 Apple Silicon LLM 벤치마크 페이지에 13개 기기와 24개 체크포인트의 측정값을 공개합니다. 모두 Mirai가 자체적으로 측정해 공개한 값입니다. 측정 방법 절에 따르면 각 구성은 약 1,357 토큰 프롬프트와 최대 4,096 토큰 출력으로 3회 실행하고, 매 실행 전 CPU와 GPU 온도가 60°C 아래로 내려갈 때까지 기다립니다. 출력 속도 항목에는 AppWorld, TerminalBench, WritingBench 등 공개 평가의 흔적에서 만든 Mirai 자체 데이터 혼합을 쓴다는 설명이 함께 있습니다. uzu는 CLI로, MLX는 mlx-lm으로, llama.cpp는 llama-cpp-python(자기회귀)과 llama.cpp 서버(추측 디코딩)로 실행했습니다.
Mirai의 추론 엔진 페이지는 M5 Max 128GB에서 Qwen3.6 27B 출력 속도를 uzu 142 tok/s, MLX 33 tok/s로 나란히 보여 줍니다. 그런데 벤치마크 데이터를 열어 보면 uzu의 142는 추측 디코딩 값이고 MLX의 33은 자기회귀 값입니다. 같은 기기와 모델의 측정값을 모드별로 나누면 다음과 같습니다:
| 엔진 (버전) | 모델 체크포인트 | 자기회귀 출력 (tok/s) | 추측 디코딩 출력 (tok/s) | 입력 (tok/s) | 메모리 (GiB) |
|---|---|---|---|---|---|
| uzu (0.6.9) | trymirai/Qwen3.6-27B-M | 35.6 | 142.3 | 1,665 | 15.63 |
| MLX (0.32.4) | mlx-community/Qwen3.6-27B-4bit | 33.1 | 해당 없음 | 988 | 16.26 |
| llama.cpp | unsloth Q4_K_S (추측 디코딩은 MTP 포함판) | 30.8 | 48.1 | 716 | 17.36 |
| MTPLX (2.12.2) | MTPLX 최적화판 | 해당 없음 | 60.8 | 910 | 20.59 |
| oMLX (0.7.0) | mlx-community 4bit + DFlash 초안 | 해당 없음 | 64.0 | 959 | 19.09 |
같은 자기회귀 방식에서 uzu는 MLX보다 약 8% 빠릅니다. 추측 디코딩끼리 비교하면 uzu는 oMLX의 2.2배, llama.cpp의 3.0배입니다. 엔진마다 쓰는 4비트 체크포인트가 서로 다르다는 점도 함께 봐야 합니다. Mirai는 llama.cpp용으로 자체 KL 평가 도구 기준으로 가장 가까운 양자화판을 골랐다고 설명합니다.
전체 데이터로 넓히면 경향이 더 분명합니다. MLX 결과가 함께 있는 218개 기기와 모델 쌍에서 uzu와 MLX의 자기회귀 출력 속도 비율은 중앙값 1.08배(최소 0.94배, 최대 1.64배)이고, 15개 쌍에서는 MLX가 더 빠릅니다. 입력 속도는 칩 세대에 따라 갈립니다. M5와 M6 계열에서는 uzu가 중앙값 1.5~1.6배 빠르지만, M1부터 M4까지의 4비트 모델에서는 0.87~0.99배로 MLX가 같거나 더 빠릅니다. M5부터 int8 연산 경로를 쓴다는 Mirai의 설명과 맞는 분포입니다.
Qwen3.8 27B를 M5 Max에서 돌린 결과에서는 Splash ( Splash: 범용 엔진 대신 모델마다 커널과 초안 모델을 새로 만드는 Apple Silicon 추론 엔진) 1.4.0이 110 tok/s로 uzu(123 tok/s)에 가장 가깝습니다. Splash가 README에 밝힌 M5 Pro 수치(초당 74토큰)는 Splash 1.0을 코딩 프롬프트로 잰 값이라, Mirai가 같은 M5 Pro에서 자체 데이터 혼합으로 잰 Splash 1.4.0 값(58 tok/s)과 조건이 다릅니다. Mirai도 추측 디코딩의 이득이 코딩과 수학에서 가장 크다고 밝힌 만큼, 측정 데이터가 바뀌면 두 엔진의 격차도 달라질 수 있습니다.
uzu 설치와 사용
파이썬에서는 uv로 설치합니다. PyPI의 uzu 0.6.15 휠은 Python 3.12 이상, macOS 26 이상(arm64, x86_64)용만 있습니다:
uv add uzu==0.6.15
아래는 모델을 내려받아 대화 한 번을 실행하는 README의 빠른 시작 예제입니다:
import asyncio

from uzu import ChatConfig, ChatMessage, ChatReplyConfig, Engine, EngineConfig


async def main() -> None:
    engine_config = EngineConfig.create()
    engine = await Engine.create(engine_config)

    model = await engine.model("alibaba:qwen3.5:0.8b:mirai:mirai-m:4")
    if model is None:
        return

    async for update in (await engine.download(model)).iterator():
        print(f"\rDownload progress: {update.progress:.2%}", end="", flush=True)
    print()

    session = await engine.chat(model, ChatConfig.create())

    messages = [
        ChatMessage.system().with_text("You are a helpful assistant"),
        ChatMessage.user().with_text("Tell me a short, funny story about a robot"),
    ]

    replies = await session.reply(messages, ChatReplyConfig.create())
    if not replies:
        return

    message = replies[-1].message
    print(f"Reasoning: {message.reasoning}")
    print(f"Text: {message.text}")


if __name__ == "__main__":
    asyncio.run(main())
Swift 앱에서는 Swift Package Manager에 https://github.com/trymirai/uzu.git 을 0.6.15 이상으로 추가하고, TypeScript(Node.js)에서는 pnpm add @trymirai/uzu@0.6.15 로 설치합니다. 구조화 출력은 ChatReplyConfig.create().with_grammar(Grammar.JsonSchema(schema_string)) 처럼 JSON 스키마 문자열을 넘기고, 도구 호출은 @uzu_tool_function 데코레이터를 붙인 파이썬 함수를 session.add_tool() 로 등록합니다. 네 언어의 전체 예제는 README의 Examples 절에 있습니다.
Apple Silicon 맥(macOS 26 이상)에서는 Homebrew로 Mirai 앱과 mirai CLI를 함께 설치할 수 있고, Mirai의 모델 카드도 이 방법을 가장 쉬운 경로로 안내합니다:
brew install mirai
mirai --model trymirai/Qwen3.6-27B-M
소스에서 직접 빌드하려면 저장소의 CLI를 실행합니다. 모델을 고르고 내려받아 대화하는 대화형 앱이 실행되고, server 서브커맨드를 쓰면 OpenAI 호환 서버로 실행할 수 있습니다. 저장소는 Rust nightly 툴체인을 쓰므로(rust-toolchain.toml), README는 먼저 cargo tools setup 으로 필요한 도구를 설치하라고 안내합니다:
cargo run --release -p cli -- --model trymirai/Qwen3.5-4B-M
cargo run --release -p cli -- server --model trymirai/Qwen3.5-4B-M --host 0.0.0.0 --port 8080
서버는 기본으로 127.0.0.1:8000 에서 POST /v1/chat/completions (스트리밍 지원)와 GET /v1/models 를 제공합니다. 직접 변환한 모델을 쓰려면 lalamo 저장소에서 uv run lalamo convert meta-llama/Llama-3.2-1B-Instruct 처럼 변환합니다. 한 가지 확인할 점은 저장소의 Cargo.toml이 바인딩, CLI, 고수준 uzu 크레이트를 crates/legacy/ 아래 재작성 대상으로 분류하고 있다는 것입니다. 지금 쓰는 API가 다음 버전에서 바뀔 수 있으므로, 앱에 넣을 때는 버전을 고정해 두는 편이 좋습니다.
uzu의 라이선스
uzu는 MIT 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다.
단, Mirai가 배포하는 변환 체크포인트는 원본 모델의 라이선스를 따르므로(예: Qwen3.6-27B-M은 Apache-2.0), 앱에 넣을 모델마다 Hugging Face 모델 카드의 라이선스를 확인해야 합니다.
 Mirai의 uzu 추론 엔진 소개 페이지 (uzu를 만든 Mirai의 제품 페이지)
 Mirai 문서 사이트 (uzu, lalamo, CLI 안내)
 uzu 추측 디코딩의 기반 논문 (Trees from Marginals)
 uzu 프로젝트 GitHub 저장소
 uzu용 Mirai 변환 모델 다운로드
더 읽어보기
-
DFlash: 블록 확산(Block Diffusion) 기반으로 LLM 추론 속도를 높이는 오픈소스 라이브러리 (feat. Z.ai)
-
cider: Apple Silicon M5의 INT8 TensorOps로 LLM prefill 속도를 끌어올리는 MLX W8A8 추론 SDK
-
mlxcel: 애플 실리콘에 최적화된 Rust 기반의 LLM/VLM 추론 런타임 및 서버 (feat. lablup)
-
Rapid-MLX: Apple Silicon 맥에서 로컬 LLM을 OpenAI 호환 서버로 띄우는 추론 엔진
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글은 파이토치 한국 사용자 모임 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
