Xiaomi-Robotics-1 소개
새 가전제품을 집에 들이면 설명서를 처음부터 끝까지 읽지는 않습니다. 그동안 만져 온 기계들의 감각이 몸에 남아 있어서, 버튼 몇 개만 눌러 보면 대충 짐작이 가기 때문입니다. 로봇에게는 그 축적이 없습니다. Xiaomi-Robotics-1(이하 XR-1) 은 그 축적을 데이터의 양으로 만들어 주려는 시도로, 사람이 손에 쥐고 다니는 그리퍼로 모은 10만 시간 분량의 실세계 조작 궤적을 사전학습에 사용한 비전-언어-행동(Vision-Language-Action, VLA) 모델입니다. Xiaomi 로보틱스 팀이 2026년 7월 16일 기술 보고서를 공개했고, 8월 3일에는 코드와 체크포인트를 Apache 2.0 라이선스로 함께 열었습니다.
이 논문이 붙잡고 있는 질문은 하나로 압축됩니다. "로봇 정책 모델에도 언어 모델과 같은 스케일링이 통하는가, 그리고 그 이득이 검증 손실이 아니라 실제 로봇의 성공률까지 이어지는가" 입니다. 스케일링 자체를 주장하는 로봇 논문은 이전에도 있었지만, 데이터량과 모델 크기를 각각 통제한 사전학습 실험과 그 체크포인트를 이어받은 실제 로봇 평가를 한 편에서 나란히 붙인 사례는 드물었습니다.
로봇 학습의 데이터 병목
지난 몇 년간 대형 언어 모델(Large Language Model, LLM)과 비전-언어 모델(Vision-Language Model, VLM)의 성능은 데이터, 파라미터, 연산을 함께 키우면 예측 가능하게 좋아진다는 경험 법칙 위에서 올라왔습니다. 로봇 학습에서도 같은 길을 가려는 시도가 이어졌습니다. 실제로 \pi_0 와 \pi_{0.5}, GR00T N1 같은 VLA 모델과 월드-행동 모델(World-Action Model, WAM) 계열은 학습 데이터가 커질수록 정책이 더 잘 일반화된다는 초기 증거를 계속 내놓았습니다.
문제는 로봇에는 웹이 없다는 점입니다. 지금까지 로봇 데이터를 모으는 지배적인 방식은 원격 조작(Teleoperation) 이었습니다. 사람이 조종기를 잡고 실제 로봇을 움직여 시연을 기록하는 방식인데, 로봇 한 대가 있어야 한 시간의 데이터가 나오므로 수집 속도가 하드웨어 대수에 그대로 묶입니다. 비용도 비싸지만 더 곤란한 것은 다양성입니다. 로봇을 놓아둔 실험실 몇 곳에서, 미리 정해 둔 몇 가지 과제만 반복해서 찍게 되므로 데이터가 좁은 구간에 몰리고 중복이 심해집니다.
두 번째 갈래는 사람의 1인칭 조작 영상을 가져다 쓰는 쪽입니다. 사람이 물건을 다루는 영상은 인터넷에도, 웨어러블 카메라에도 얼마든지 있습니다. 다만 영상에는 로봇이 따라 할 수 있는 행동 값이 붙어 있지 않아서, 표현 정렬이나 모션 리타게팅으로 사람 손의 움직임을 로봇 관절 값으로 변환하는 단계를 한 번 더 거쳐야 합니다. 이 변환 과정에서 오차가 끼고, 사람 손과 로봇 그리퍼의 자유도 차이가 그대로 남습니다.
세 번째 갈래가 이 논문이 선택한 UMI(Universal Manipulation Interface) 입니다. UMI는 사람이 손에 쥐고 다니는 집게형 그리퍼에 카메라를 달아 놓은 장치로, 로봇 없이도 실제 환경에서 조작 궤적을 그대로 기록합니다. 집게의 자세가 궤적에 직접 기록되므로 사람 손의 관절을 추정해 로봇 관절 값으로 변환하는 단계가 필요 없고, 장치가 가벼워 가정, 상업 시설, 공장, 사무실, 야외까지 들고 나갈 수 있습니다. 물론 UMI 그리퍼의 행동이 곧 로봇의 행동은 아니어서 몸체를 옮기는 정렬은 여전히 남지만, 그 일은 뒤에서 볼 사후 학습이 맡습니다.
그런데 UMI에도 남은 병목이 하나 있었습니다. 언어 라벨링 입니다. 기존 방식은 사람이 긴 영상을 과제 의미 단위로 잘라 내고 구간마다 지시문을 적어야 하는데, 이 작업량은 데이터 시간에 비례해 늘어납니다. 10만 시간 규모에서는 현실적으로 불가능합니다.
XR-1의 발상 전환은 여기에 있습니다. 연구팀은 사람이 궤적을 자르고 이름 붙이는 일을 아예 포기했습니다. 대신 궤적을 기계적으로 같은 길이의 조각으로 자른 뒤, VLM에게 그 조각 안에서 "장면이 어떤 상태에서 어떤 상태로 바뀌었는가" 를 서술하게 시켰습니다. 과제 이름을 붙이는 대신 상태 변화를 묘사하게 한 것인데, 이렇게 하면 잘린 위치가 과제 경계와 맞지 않아도 라벨이 항상 성립합니다. 어떤 조각이든 그 안에서 무언가는 움직였고, 그 움직임을 문장으로 적을 수 있기 때문입니다.
로봇 파운데이션 모델의 두 갈래
이 논문이 어디에 서 있는지 먼저 짚어 두면 뒤의 설계 선택들이 읽기 쉬워집니다. 논문은 로봇 파운데이션 모델을 두 갈래로 정리합니다. 하나는 월드-행동 모델(World-Action Model, WAM) 로, 사전학습된 영상 모델을 토대로 미래 관측이나 환경 동역학을 명시적으로 예측하고 그 예측을 행동 생성에 활용합니다. 초기 연구는 언어로 지정한 목표에서 시각적 계획을 먼저 만들고 이를 실행 가능한 행동으로 옮겼으며, 이후에는 미래 예측과 행동 생성을 한꺼번에 모델링하는 방향, 3차원 기하 구조를 명시적으로 끌어들이는 방향, 영상과 행동이 섞인 대규모 이종 데이터로 학습해 제로샷 일반화를 노리는 방향으로 갈라졌습니다.
다른 하나가 XR-1이 속한 VLA 갈래입니다. 사전학습된 VLM을 백본으로 삼아, 그 안에 이미 들어 있는 의미 지식을 행동 예측에 끌어다 쓰는 방식입니다. 논문은 최근 VLA 연구의 개선 방향을 세 축으로 정리합니다. 첫째는 추론 지향으로, 체화 추론 토큰이나 시각적 생각의 사슬 같은 중간 표현을 두어 의미와 공간, 시간 추론을 돕습니다. 둘째는 행동 표현으로, 행동을 단순히 이산화하는 방식의 한계를 학습형 토크나이저나 Flow Matching으로 넘어섭니다. 셋째는 여러 로봇 몸체의 데이터를 아우르는 대규모 사전학습입니다.
XR-1은 이 세 축 중 하나를 새로 제안하기보다, 세 축과 직교하는 질문을 고릅니다. 저자들이 "보완적인 질문" 이라 부른 것, 곧 로봇 파운데이션 모델의 스케일링 거동 자체입니다. 그래서 방법론의 개별 부품은 대부분 기존 연구에서 가져온 것이고(MoT, Flow Matching, Choice Policies), 새로 만든 것은 그 스케일링을 실제로 시험해 볼 수 있게 해 주는 데이터 파이프라인입니다.
두 단계로 나눈 학습 레시피
XR-1은 언어 모델의 학습 방식을 그대로 빌려 와 학습을 2단계로 나눕니다.
사전학습(Pre-training) 은 폭을 담당합니다. 로봇 없이 모은 10만 시간의 UMI 궤적과 자동 생성한 상태 전이 문장으로 학습해서, "현재 관측을 언어가 지정한 목표 상태로 바꾸는 행동" 을 만드는 일반적인 능력을 갖춥니다. 다만 이 단계의 모델이 만들어 내는 것은 UMI 그리퍼의 행동이고, 조건으로 받는 문장도 사람이 로봇에게 던지는 명령문이 아니라 상태 변화를 적어 놓은 서술문입니다.
사후 학습(Post-training) 은 정렬을 담당합니다. 약 10,000시간의 이종 몸체(Cross-Embodiment) 데이터로 두 가지 간극을 메웁니다. 하나는 몸체 정렬 로, UMI 그리퍼용 행동을 실제 모바일 매니퓰레이터와 양팔 로봇의 행동 공간으로 옮기는 일입니다. 다른 하나는 명령 정렬 로, 사전학습에서 쓰던 서술형 상태 전이 문장을 사람이 실제로 로봇에게 던지는 명령형 지시문으로 바꾸는 일입니다.
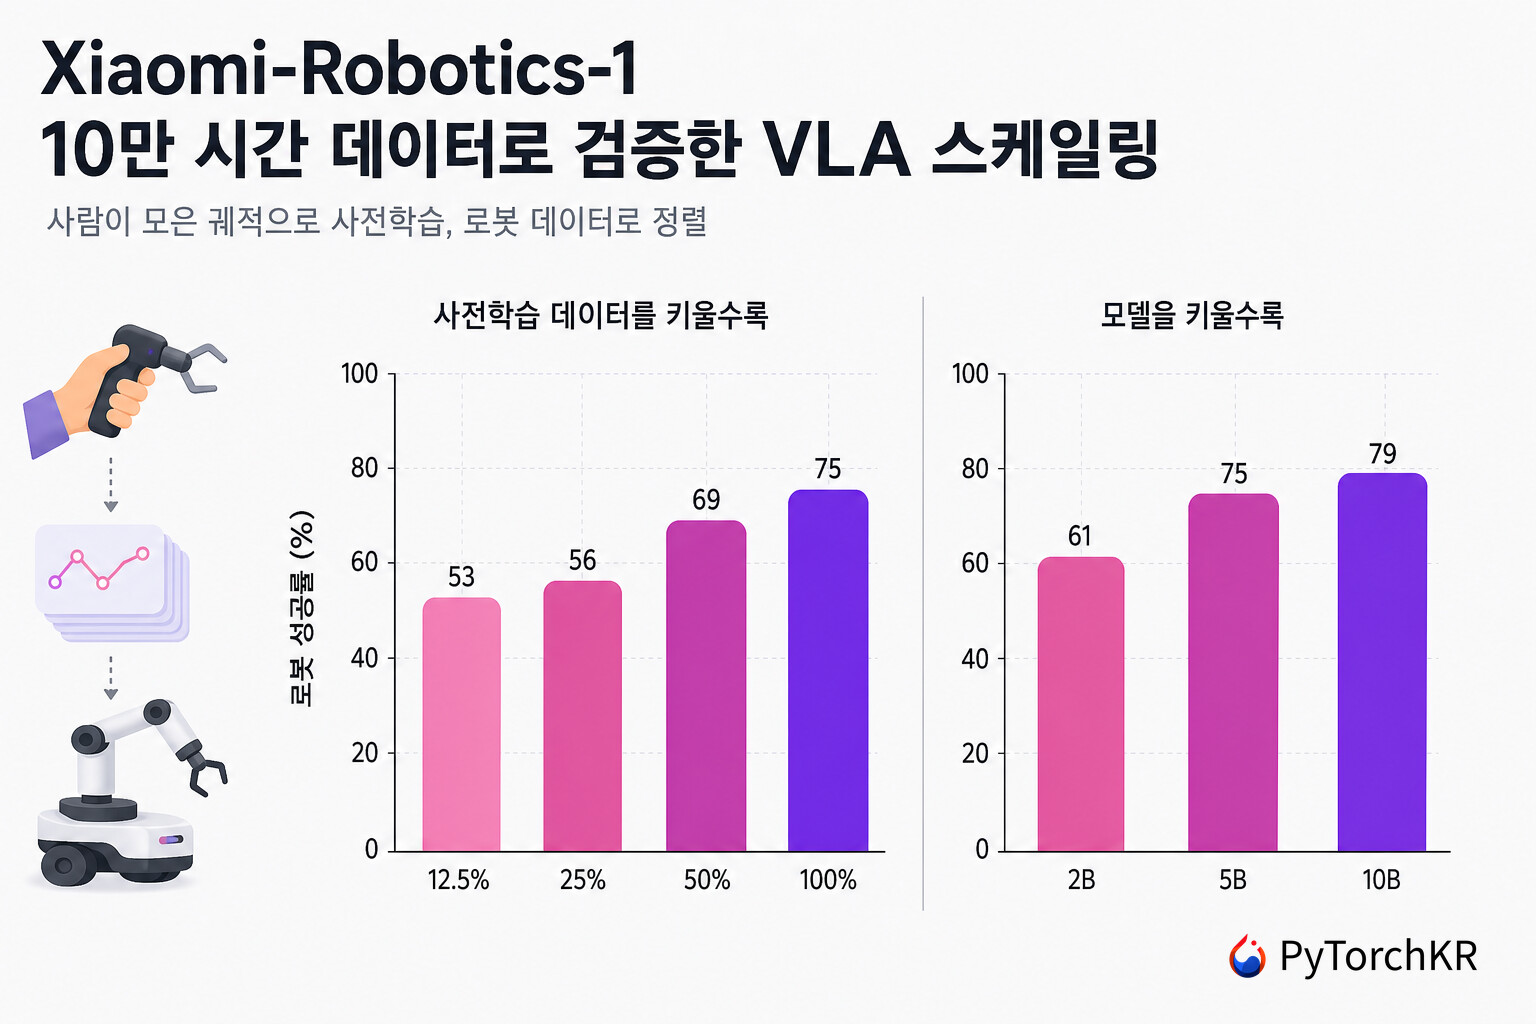
결과부터 말하면, 사전학습 단계에서 데이터와 모델을 키울수록 검증 행동 오차가 계속 내려갔고, 그 순서가 사후 학습 이후의 실제 로봇 성공률에서도 그대로 유지되었습니다. 처음 보는 환경에서 별도 학습 없이 바로 투입했을 때 성공률은 사전학습을 하지 않은 기준선의 26\% 에서 사전학습 데이터를 다 쓴 모델의 75\% 까지 올라갔고, 모델을 2B에서 10B로 키우면 61\% 에서 79\% 가 되었습니다. 평균 성공률 기준으로 네 가지 시뮬레이션 벤치마크 모두에서 1위를 기록했고, 특히 RoboCasa365에서 기존 최고 46.6\% 를 57.4\% 로 끌어올렸습니다.
XR-1의 모델 구조
VLM과 DiT를 한 몸에 묶은 Mixture-of-Transformers
XR-1은 Mixture-of-Transformers(MoT) 구조를 씁니다. 사전학습된 VLM인 Qwen3-VL 과 확산 트랜스포머(Diffusion Transformer, DiT) 를 나란히 두고, 두 갈래가 파라미터는 따로 갖되 어텐션으로 연결되는 방식입니다. XR-1에서는 DiT가 VLM의 KV 캐시를 참조하는 한쪽 방향으로 정보가 흐릅니다. 흔히 쓰는 "VLM이 특징을 뽑아 주면 별도 정책 헤드가 받아서 행동을 낸다" 식의 2단 구성과 달리, 두 갈래가 같은 토큰 시퀀스 위에서 함께 돌아갑니다.
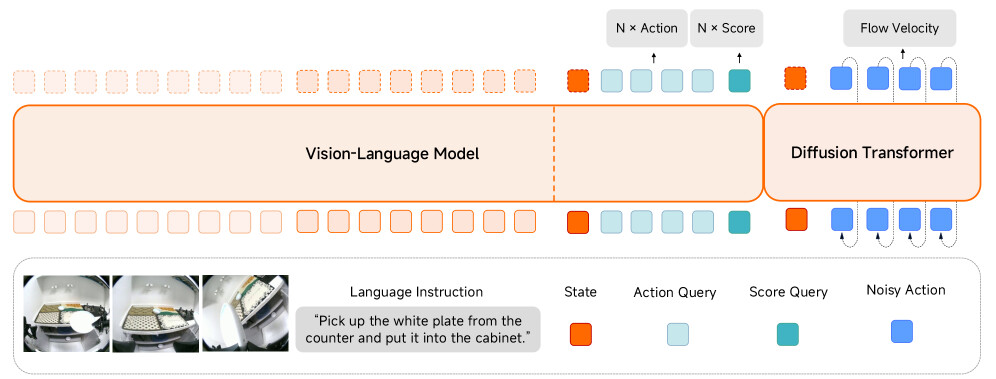
설계에서 눈에 띄는 부분은 DiT의 레이어 수를 VLM과 똑같이 맞추되 히든 크기는 더 작게 잡았다는 점입니다. 논문이 밝힌 이유는 추론 속도입니다. 로봇 제어는 언어 생성과 달리 제어 주기를 놓치면 그 자체로 실패이므로, 이런 비대칭 설계가 성능보다 지연 시간을 먼저 보는 선택으로 읽힙니다.
그렇다면 모델은 무엇을 보고 무엇을 아는 걸까요. 논문 본문은 관측을 \boldsymbol{o}_t 라는 기호로만 두고 구성을 설명하지 않지만, Figure 2와 공개된 코드를 보면 짜맞출 수 있습니다. 아키텍처 그림에는 이미지 3장이 나란히 들어가고, 배포 코드의 클라이언트 API도 이미지 3장을 받습니다. 1인칭 시점과 좌우 손목 시점입니다. 여기에 로봇의 자체 상태(Proprioceptive State)가 따라붙는데, 좌우 팔의 관절 각도, 그리퍼 개폐 위치, 엔드 이펙터의 위치와 회전 행렬로 구성되고 허리 위치는 선택입니다.
모델은 이 관측 \boldsymbol{o}_t 와 언어 지시문 l 을 입력받아 행동 청크 \boldsymbol{a}_{t:t+H} 의 로그 우도를 최대화하도록 학습합니다. 한 번에 한 스텝이 아니라 미래 H 스텝을 묶어서 예측하는 행동 청크 방식이라, 매 스텝 모델을 다시 돌리지 않아도 되고 궤적의 시간적 일관성도 유지됩니다.
Flow Matching으로 행동을 만들어 내는 DiT
DiT는 앞서 본 자체 상태 \boldsymbol{s}_t 와 VLM이 만든 KV 캐시를 조건으로 받아, Flow Matching 방식으로 행동 청크를 생성합니다. 손실 함수는 노이즈가 섞인 행동에서 깨끗한 행동으로 향하는 속도장을 맞추는 형태입니다.
여기서 \tau 는 Flow Matching의 타임스텝이고, 노이즈 행동은 \tilde{\boldsymbol{a}}^{\tau}_{t:t+H} = \tau \boldsymbol{a}_{t:t+H} + (1-\tau)\boldsymbol{\epsilon} 로, \boldsymbol{\epsilon} \sim \mathcal{N}(\boldsymbol{0}, \boldsymbol{I}) 입니다. 타임스텝을 균등하게 뽑지 않고 u \sim \text{Beta}(1.5, 1) 에서 뽑아 \tau = (1-u) \times 0.999 로 변환하는데, 이렇게 하면 노이즈가 많이 낀 구간에 학습 가중치가 더 실립니다. 행동 생성에서 어려운 쪽은 거의 완성된 궤적을 다듬는 단계가 아니라 노이즈에서 대략의 형태를 잡아내는 초반 단계이므로, 그쪽에 표본을 몰아 주는 셈입니다.
타임스텝 조건은 adaLN(Adaptive Layer Normalization) 으로 DiT에 주입합니다. 추론할 때는 순수 노이즈에서 출발해 5스텝 오일러 적분으로 깨끗한 행동을 복원하며, 스텝 크기는 \Delta\tau = 0.2 입니다. 확산 모델치고 5스텝은 매우 적은 편인데, 제어 주기를 지키기 위한 타협으로 보입니다.
Choice Policies 보조 손실, 그리고 DiT의 어텐션에서 행동 토큰을 뺀 이유
DiT만으로 학습하면 수렴이 느립니다. VLM이 뽑아 주는 표현이 행동 생성에 유용한 방향으로 정렬되기까지 오래 걸리기 때문입니다. 연구팀은 Choice Policies 를 가져와 VLM 자체에도 행동을 예측하게 하는 보조 과제를 붙였습니다. 로봇 상태를 다층 퍼셉트론(MLP)으로 토큰 하나로 만들어 비전-언어 토큰 뒤에 붙이고, 그 뒤에 행동 쿼리 토큰과 스코어 쿼리 토큰을 이어 붙입니다. 행동 쿼리 토큰의 출력에서 K 개의 후보 행동 청크가 나오고, 스코어 쿼리 토큰에서 각 후보의 점수가 나옵니다.
학습은 승자 독식(Winner-Takes-All) 방식입니다. K 개 후보 중 정답과의 L_1 거리가 가장 작은 하나만 행동 손실에 넣고, 나머지는 건드리지 않습니다. 스코어 쪽 회귀 목표 s_k 는 k 번째 후보와 정답 사이의 L_1 거리 그 자체입니다. 즉 모델은 여러 개의 답을 내놓으면서 동시에 "이 답이 얼마나 틀렸을지" 를 스스로 예측하도록 배웁니다. 조작 과제에는 정답이 하나가 아닌 경우가 흔한데, 후보를 여러 개 두면 서로 다른 해법을 평균 내 버리는 문제를 피할 수 있습니다.
여기서 이 논문이 보고한 흥미로운 실패 사례가 하나 나옵니다. 연구팀은 처음에 DiT 토큰이 VLM 쪽 행동 관련 토큰의 KV 캐시까지 볼 수 있게 두었는데, 그렇게 하면 오히려 성능이 떨어졌습니다. 저자들의 가설은 지름길(Shortcut) 입니다. DiT가 시각 정보와 언어 정보에 스스로 근거를 대는 대신, VLM이 이미 만들어 놓은 행동을 그대로 베끼는 쪽으로 학습이 흘러갔다는 것입니다. 해법은 단순했습니다. 행동 관련 토큰을 DiT의 어텐션 계산에서 아예 제외해서, DiT가 언어 지시문과 시각 관측의 표현만 보도록 묶어 놓았습니다. 보조 손실이 VLM의 표현은 바꾸되 DiT의 입력 경로에는 끼어들지 못하게 한 구성입니다.
크기 변형 3종
스케일링 실험을 위해 세 가지 크기를 준비했습니다. VLM과 DiT의 레이어 수는 언제나 같고, 히든 크기만 달라집니다.
| 모델 | 레이어 수 | VLM 히든 | VLM 파라미터 | DiT 히든 | DiT 파라미터 | 전체 |
|---|---|---|---|---|---|---|
| Xiaomi-Robotics-1-2B | 28 | 2048 | 2.1B | 1024 | 470M | 2.6B |
| Xiaomi-Robotics-1-5B | 36 | 2560 | 4.4B | 1024 | 604M | 5.1B |
| Xiaomi-Robotics-1-10B | 36 | 4096 | 8.8B | 2048 | 1.5B | 10.5B |
위 표에서 DiT가 전체 파라미터의 12\% 에서 18\% 정도만 차지한다는 점이 눈에 띕니다. 무게 중심은 여전히 VLM 쪽에 있고, DiT는 그 표현을 연속적인 행동 값으로 옮기는 얇은 층에 가깝습니다. 공개된 체크포인트는 5B 변형이며, VLM 백본으로 Qwen/Qwen3-VL-4B-Instruct 를 사용합니다.
10만 시간을 라벨링하는 법
UMI로 모은 사전학습 데이터
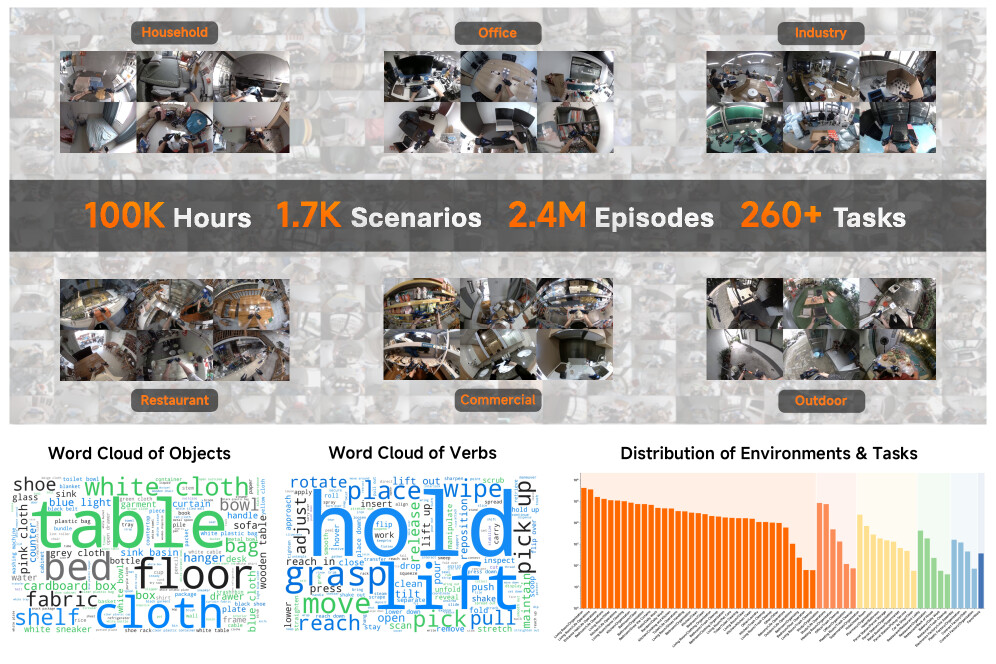
사전학습 데이터셋은 UMI 핸드헬드 그리퍼와 1인칭 카메라로 모은 10만 시간 이상의 실세계 조작 궤적입니다. 논문 Figure 3이 밝힌 규모는 1,700개 시나리오, 240만 에피소드, 260개 이상의 과제입니다. 환경 구성은 가정, 상업 시설, 공장, 사무실, 식당, 야외까지 걸쳐 있습니다.
같은 그림의 워드클라우드를 보면 데이터의 성격이 드러납니다. 물체 쪽에서는 table, floor, cloth, bed, shelf 같은 생활 공간의 표면과 천 종류가 크게 잡히고, 동사 쪽에서는 hold, lift, grasp, place, move가 지배적입니다. 정교한 도구 조작보다는 집안일에서 반복되는 잡기와 옮기기가 데이터의 중심입니다. 뒤에서 볼 실험 결과가 소파 정리나 신발 정리 같은 과제에 몰려 있는 이유이기도 합니다.
상태 전이를 서술하게 만든 자동 라벨링 파이프라인
라벨링 파이프라인은 두 단계로 돌아갑니다. 먼저 각 궤적을 같은 길이의 구간으로 자릅니다. 과제 의미를 보고 자르는 것이 아니라 기계적으로 등분합니다. 그다음 Qwen3.5-27B 에게 각 구간 안에서 그리퍼와 상호작용한 물체의 상태 변화를 서술하게 시킵니다.
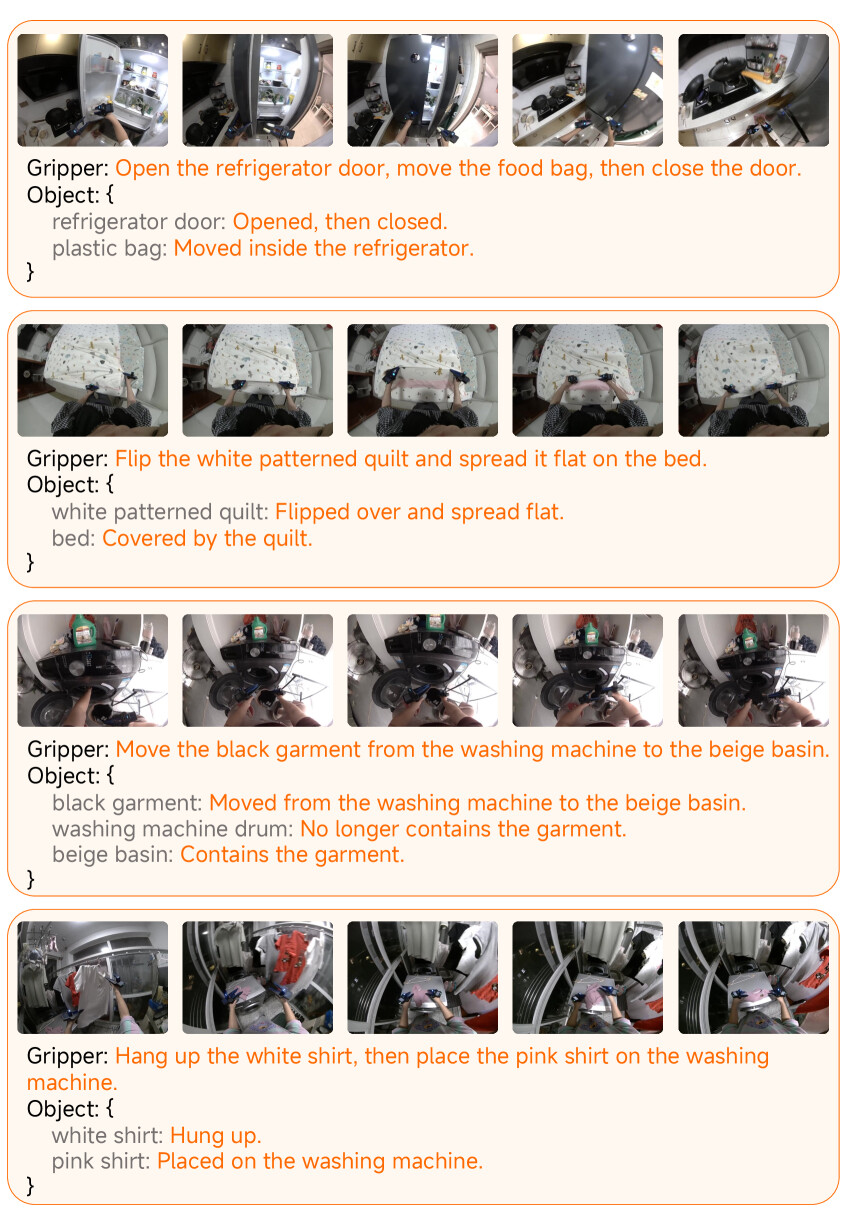
위 그림에서 라벨의 형태를 확인할 수 있습니다. 라벨은 자유 문장 하나가 아니라 두 부분으로 나뉩니다. Gripper 항목에는 그리퍼가 무엇을 했는지가 한 문장으로 들어가고("Open the refrigerator door, move the food bag, then close the door."), Object 항목에는 장면에 등장한 물체마다 어떤 상태로 바뀌었는지가 따로 적힙니다("refrigerator door: Opened, then closed. / plastic bag: Moved inside the refrigerator."). 손의 움직임과 세계의 변화를 분리해 기록하는 구조입니다.
이 구조가 왜 중요한지는 학습 목표를 떠올리면 분명해집니다. 모델이 배워야 하는 것은 "이 과제의 이름은 무엇인가" 가 아니라 "지금 보이는 장면을 문장이 말하는 상태로 바꾸려면 어떤 행동을 내야 하는가" 입니다. 물체별 상태 변화가 명시되어 있으면 목표 상태가 훨씬 촘촘하게 지정되고, 같은 "문 열기" 라도 냉장고 문인지 세탁기 문인지, 열기만 하는지 닫기까지 하는지가 라벨 안에서 구분됩니다.
속도 문제도 정면으로 다뤘습니다. 연구팀은 구간 자르기와 캡션 생성을 분리한 생산자-소비자(Producer-Consumer) 파이프라인을 만들었습니다. CPU 워커 스레드가 구간별 클립을 메모리 파일시스템에 잘라 놓는 동안, 클라이언트 스레드는 수백 개의 캡션 요청을 동시에 띄워 둡니다. 디스크 입출력과 GPU 추론이 서로를 기다리지 않게 한 구성인데, 이 파이프라인으로 10만 시간이 넘는 전체 코퍼스를 약 2주 만에 라벨링했습니다.
사전학습 목적 함수와 배치 구성
사전학습의 전체 손실은 세 항의 합입니다.
앞의 두 항은 앞에서 본 DiT의 Flow Matching 손실과 VLM의 회귀 손실입니다. 세 번째 L_{\text{NTP}} 는 다음 토큰 예측 손실로, 사전학습된 VLM의 비전-언어 능력이 행동 학습 과정에서 지워지는 것을 막기 위한 항입니다. 학습 데이터는 이전 연구인 Xiaomi-Robotics-0 에서 정제한 고품질 비전-언어 데이터셋을 그대로 씁니다. 가중치 \lambda 는 0.1 로 두었고, 비전-언어 데이터와 UMI 궤적의 샘플링 비율은 1:9입니다.
처리량을 짜내기 위한 구현 기법도 두 가지 언급됩니다. 하나는 배치 안의 모든 비전-언어 토큰을 시퀀스 하나로 묶어(packing) VLM을 한 번만 통과시키는 방식입니다. 다른 하나는 표본당 Flow Matching 타임스텝을 4개씩 뽑는 방식입니다. VLM 쪽 연산이 DiT보다 훨씬 비싸므로, 비싼 VLM 순전파 한 번의 결과인 KV 캐시를 재사용해 저렴한 DiT 순전파를 여러 번 돌려 비용을 상각합니다.
사후 학습: 로봇 몸체와 명령문에 맞추기
사후 학습 데이터셋은 약 10,000시간 규모이며 세 갈래로 구성됩니다.
- 자체 수집 로봇 데이터 7,200시간 이상: 모바일 매니퓰레이터와 양팔 로봇으로 실제 가정 환경에서 모았습니다. 소파 정리, 신발장 정리, 주방 도구 치우기 같은 집안일 과제입니다. 사람이 잘라 놓은 영상 클립에 Qwen3.5로 지시문을 붙였습니다.
- 사람이 라벨링한 UMI 데이터 1,000시간 이상: 구간 경계와 지시문을 모두 사람이 직접 달았습니다. 사전학습의 자동 라벨과 달리 사람이 로봇에게 실제로 말하는 방식에 가깝습니다.
- 공개 로봇 데이터셋: Bridge V2, RT-1, DROID 를 포함했습니다. 궤적 안에서 아무 일도 일어나지 않는 유휴 구간은 걸러 냈습니다.
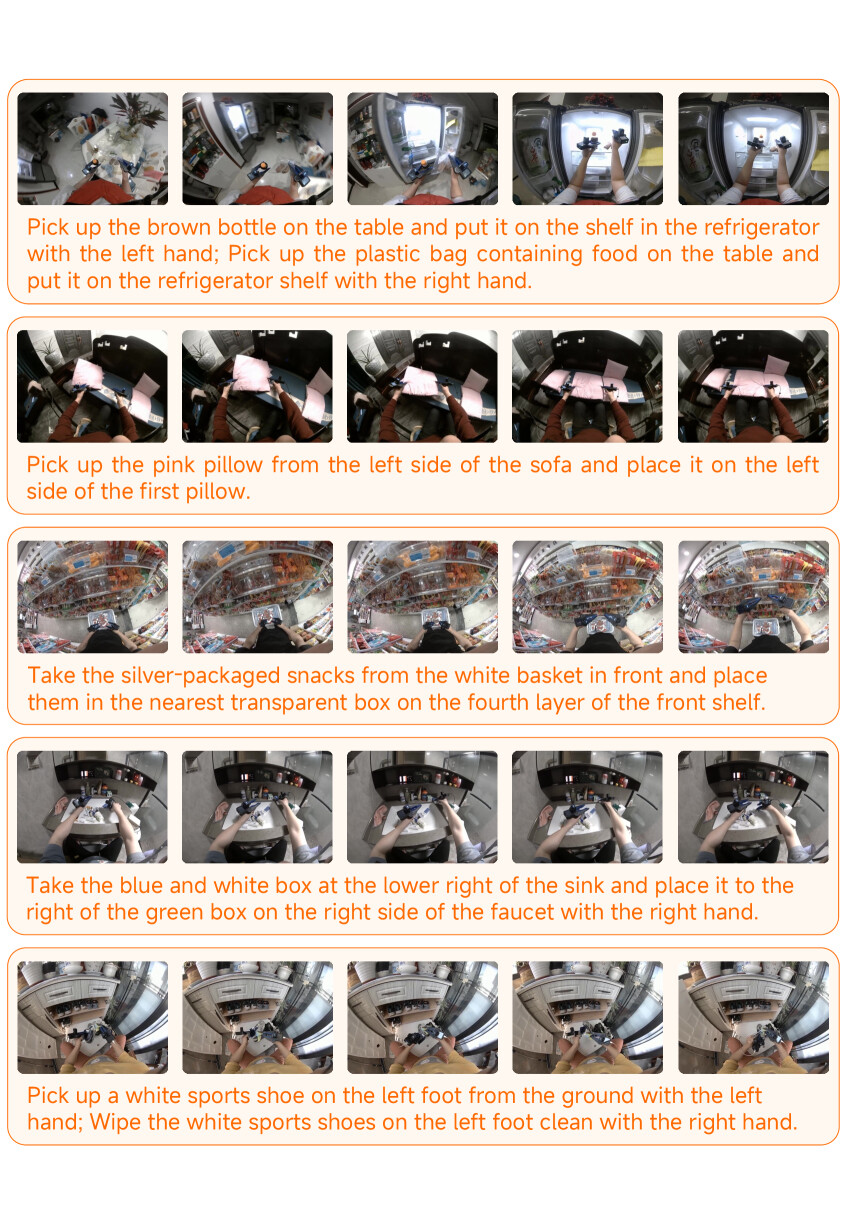
앞서 본 사전학습 라벨과 위 그림을 나란히 놓으면 두 단계의 차이가 분명해집니다. 사전학습 라벨이 그리퍼 서술과 물체별 상태 변화로 나뉜 구조화된 기록이었다면, 사후 학습 라벨은 사람이 던지는 한 덩어리 명령문입니다. 그것도 상당히 구체적입니다. "앞쪽 흰 바구니에서 은색 포장 과자를 꺼내 앞쪽 선반 네 번째 층의 가장 가까운 투명 상자에 넣어라" 처럼 층수와 상대 위치가 들어가고, "탁자 위의 갈색 병을 왼손으로 집어 냉장고 선반에 놓고, 탁자 위의 음식이 든 비닐봉지를 오른손으로 집어 냉장고 선반에 놓아라" 처럼 어느 손을 쓸지까지 지정합니다. 명령 정렬 단계가 하는 일은 결국 이런 문장을 읽고 그대로 실행하는 능력을 붙이는 것입니다.
샘플링 비율은 비전-언어 데이터, 공개 로봇 데이터, 지시문 라벨 UMI 데이터, 자체 로봇 데이터가 각각 0.5 대 0.5 대 0.5 대 8.5입니다. 자체 수집 로봇 데이터에 압도적인 무게가 실려 있는데, 사후 학습의 목적이 폭을 넓히는 것이 아니라 이미 갖춘 능력을 실제 로봇 쪽으로 옮기는 것이기 때문입니다. 다만 자체 로봇 데이터를 통째로 넣으면 과적합이 생겨서, 전체에서 다양성이 확보되도록 부분집합을 뽑아 썼다고 밝히고 있습니다.
이종 로봇의 행동 공간을 통일하기
여러 종류의 로봇 데이터를 한 모델에 넣으려면 행동 표현이 통일되어야 합니다. XR-1은 팔의 행동을 절대 좌표가 아니라 현재 상태 기준의 상대 엔드 이펙터(End-Effector, EE) 자세 변화로 표현합니다.
여기서 {}^{\text{EE}}_{\text{Base}}\boldsymbol{T}_t 는 현재 시점 t 에서 베이스 기준 엔드 이펙터의 자세이고, \hat{\boldsymbol{T}}_{t+i} 는 t+i 시점의 목표 자세입니다. 절대 좌표를 쓰지 않는 이유는 분명합니다. 컵을 앞으로 미는 똑같은 동작이라도 로봇을 놓아둔 위치나 팔의 링크 길이가 다르면 절대 좌표 값은 전혀 다른 숫자가 됩니다. 반면 현재 자세를 기준으로 한 변화량은 하드웨어가 달라도 비슷한 값으로 모입니다. 여기에 더해 모든 로봇 데이터와 UMI 데이터에서 엔드 이펙터 좌표계의 방향을 하나로 통일했습니다. 그 결과 "엔드 이펙터 기준으로 앞으로 밀기" 같은 비슷한 팔 동작은 하드웨어가 무엇이든 같은 행동 값으로 표현됩니다.
모바일 로봇의 경우 베이스는 속도로, 허리는 위치의 상대 변화량으로 표현합니다. 로봇마다 행동 차원 수 자체가 다른 문제는 통일된 행동 벡터 하나를 정의해 두고, 해당 로봇에 없는 차원은 손실 계산에서 마스킹하는 방식으로 처리했습니다. 공개된 사후 학습 코드의 기본 설정을 보면 이 통일 벡터의 차원이 60이고 행동 청크 길이가 30입니다.
실험 결과: 스케일링은 실제 로봇까지 이어지는가
논문의 실험은 네 가지 질문에 답하도록 설계되어 있습니다. 사전학습에서 데이터와 모델을 키우면 좋아지는가, 더 강한 사전학습 모델이 사후 학습 후에도 더 나은가, 최소한의 데이터로 새 과제에 적응하는가, 그리고 기존 로봇 파운데이션 모델과 비교하면 어떤가입니다.
사전학습 단계의 데이터 및 모델 스케일링
먼저 짚어 둘 것이 있습니다. 스케일링 실험은 10만 시간 전체가 아니라 약 20,000시간의 부분집합 위에서 진행되었습니다. 연산 예산 때문입니다. 데이터 스케일링 실험은 이 20,000시간의 12.5\%, 25\%, 50\%, 100\% 를 각각 사용했고, 모델 스케일링 실험은 세 가지 크기 모두 같은 20,000시간으로 학습했습니다. 아래에서 나오는 100\% 는 10만 시간이 아니라 20,000시간이라는 뜻입니다.
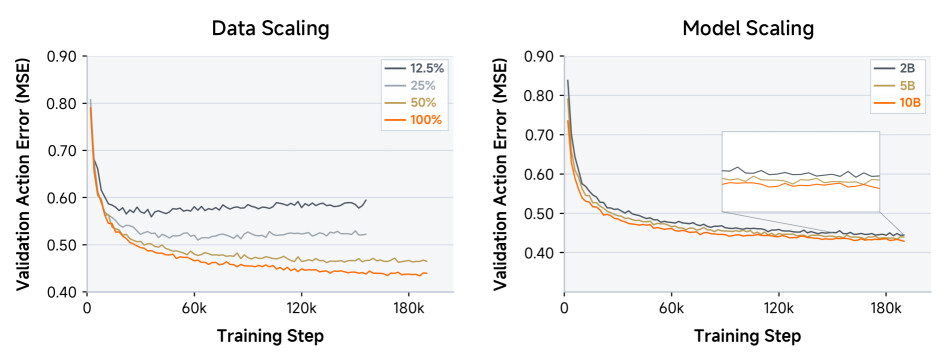
평가 지표는 별도로 떼어 둔 검증 집합에서 Flow Matching이 예측한 행동과 정답 사이의 평균 제곱 오차(MSE)입니다. 위 그림 왼쪽에서 데이터 스케일링 결과를 볼 수 있습니다. 12.5\% 와 25\% 설정은 검증 오차가 내려가다가 다시 올라갑니다. 과적합입니다. 연구팀은 이 두 설정의 학습을 중간에 종료했습니다. 반면 50\% 와 100\% 설정은 끝까지 단조 감소했고, 100\% 쪽이 더 가파르게 떨어졌습니다.
MSE라는 지표만으로는 모델이 무엇을 배웠는지 감이 오지 않으므로, 논문은 Figure 6에 정성 결과를 함께 실었습니다. 사전학습만 마친 모델이 검증 집합의 UMI 장면에서 상태 전이 문장을 조건으로 받아 그리퍼 궤적을 예측한 예시들인데, 감자를 냉장고에 넣기, 흰 천을 펴서 표면을 닦기, 노란 수건을 들어 반으로 접기처럼 문장이 지정한 방향으로 궤적이 뻗어 나갑니다. 이 단계에서 이미 언어가 행동을 끌고 가는 것은 확인되지만, 아직 UMI 그리퍼의 궤적일 뿐입니다.
오른쪽 모델 스케일링 결과는 결이 조금 다릅니다. 2B에서 5B, 10B로 갈수록 검증 오차가 일관되게 낮아지기는 하지만, 곡선 사이의 간격이 데이터 스케일링 때만큼 벌어지지 않습니다. 확대 삽입 그림으로 봐야 겨우 구분될 정도입니다. 저자들의 해석은 이렇습니다. 수십억 파라미터 규모의 모델 용량은 이미 현재 데이터셋의 분포를 담아내기에 충분하며, 따라서 추가 일반화를 막고 있는 것은 모델이 아니라 데이터의 양 이라는 것입니다. 논문은 이 결과가 모델 스케일링의 가치를 깎아내리는 것이 아니라, 대규모의 다양한 데이터를 모으는 일에 우선순위를 두어야 한다는 뜻이라고 정리합니다.
사후 학습 후 처음 보는 환경에서의 실제 로봇 성능
여기서부터가 이 논문의 핵심 주장입니다. 사전학습에서 관찰한 스케일링이 실제 로봇 성능까지 전달되는지 확인하는 실험입니다. 평가 과제는 신발 정리(Shoe Storage), 가방 싸기(Bag Packing), 책상 정리(Table Organization), 소파 정리(Sofa Tidying)의 4가지입니다. 과제 자체는 사후 학습 데이터에 들어 있지만, 평가에 쓰인 환경과 물체 인스턴스는 학습 중에 본 적이 없습니다. 과제별 미세조정이나 환경별 미세조정도 하지 않고 그대로 투입했습니다.
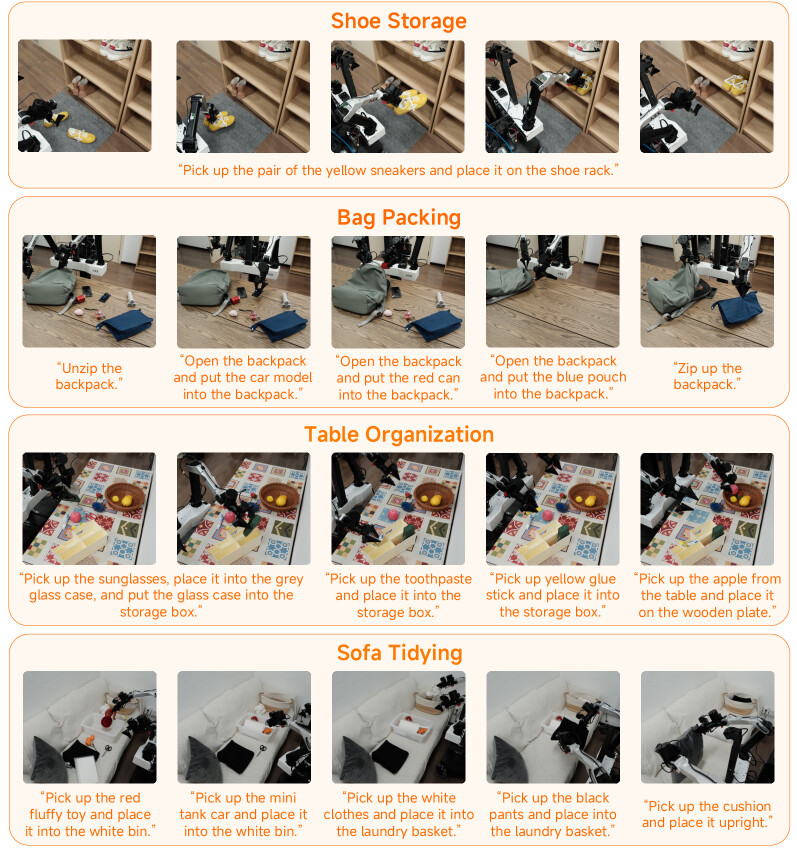
위 그림에서 과제의 실제 형태를 알아볼 수 있습니다. 4가지 과제의 길이는 고르지 않습니다. 신발 정리는 "Pick up the pair of the yellow sneakers and place it on the shoe rack."(노란 운동화 한 켤레를 집어 신발장에 놓아라) 처럼 지시문 하나로 끝나지만, 가방 싸기는 배낭 지퍼를 열고 물건 3개를 차례로 넣은 뒤 다시 잠그는 5단계 지시로 이루어집니다. 책상 정리에는 선글라스를 집어 회색 안경 케이스에 넣고 그 케이스를 다시 수납 상자에 넣으라는 식으로, 한 문장 안에 두 단계가 들어 있는 지시도 섞여 있습니다. 이 평가가 재는 것이 단순한 집기와 놓기가 아니라 순차적인 지시 이행이라는 뜻입니다.
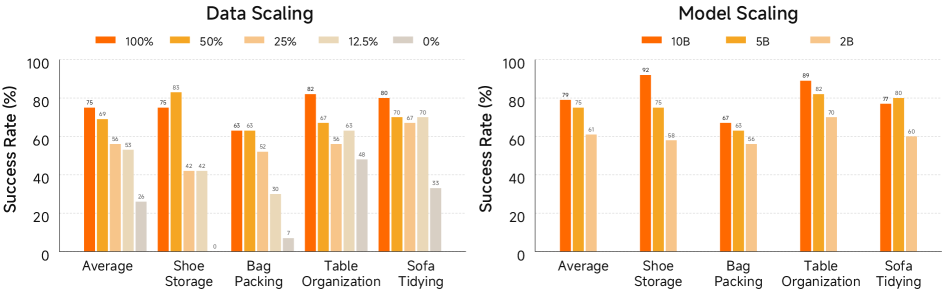
사전학습 데이터량을 바꿔 가며 5B 모델을 사후 학습한 결과입니다. 기준선은 행동 사전학습 없이 Qwen3-VL 가중치에서 바로 사후 학습을 시작한 모델입니다.
| 과제 | 사전학습 없음 | 12.5% | 25% | 50% | 100% |
|---|---|---|---|---|---|
| 평균 | 26 | 53 | 56 | 69 | 75 |
| 신발 정리 | 0 | 42 | 42 | 85 | 75 |
| 가방 싸기 | 7 | 30 | 53 | 65 | 65 |
| 책상 정리 | 48 | 63 | 56 | 67 | 82 |
| 소파 정리 | 35 | 70 | 67 | 70 | 80 |
전체 성공률은 사전학습 데이터가 늘어남에 따라 단조 증가합니다. 사전학습이 없으면 26\%, 데이터를 다 쓰면 75\% 입니다. 이득이 가장 크게 나타나는 곳은 접촉이 많은 과제입니다. 신발 정리에서 기준선은 0\% 로 완전히 실패했지만, 사전학습을 거친 모델은 75\% 에 도달했습니다. 데이터의 12.5\% 만 써도 기준선의 두 배를 넘습니다(26\% 대 53\% ). 한계 이득이 점차 완만해지기는 하지만 포화 조짐은 없습니다. 50\% 에서 100\% 로 데이터를 두 배 늘렸을 때 6 퍼센트포인트가 더 올랐습니다.
모델 크기를 바꾼 실험도 같은 방향입니다. 세 변형 모두 20,000시간으로 사전학습한 체크포인트에서 출발했습니다.
| 과제 | 2B | 5B | 10B |
|---|---|---|---|
| 평균 | 61 | 75 | 79 |
| 신발 정리 | 58 | 75 | 92 |
| 가방 싸기 | 56 | 65 | 67 |
| 책상 정리 | 70 | 82 | 89 |
| 소파 정리 | 60 | 80 | 77 |
전체 성공률이 61\%, 75\%, 79\% 로 올라갑니다. 여기서도 신발 정리의 상승 폭이 가장 큽니다(58\% 에서 75\%, 다시 92\% ). 4가지 과제 중 3가지에서 모델이 커질수록 좋아졌고, 소파 정리에서만 5B와 10B가 80\% 와 77\% 로 비슷했습니다.
흥미로운 대목은 사전학습 단계에서 모델 스케일링의 효과가 데이터 스케일링보다 작아 보였는데, 사후 학습 후 실제 로봇 성능에서는 61\% 에서 79\% 로 18 퍼센트포인트나 벌어졌다는 점입니다. 검증 집합의 MSE 차이가 미미해 보여도 실제 로봇에서는 성공과 실패를 가르는 차이일 수 있다는 뜻이며, 오프라인 지표만으로 정책을 고르면 안 되는 이유이기도 합니다.
신규 과제 미세조정: 과제당 10시간 미만으로
로봇 파운데이션 모델의 존재 이유 중 하나는 새 과제를 적은 데이터로 배우는 것입니다. 이를 확인하기 위해 자체 로봇 데이터셋에서 완전히 제외해 둔 4가지 새 과제를 골라, 네 과제의 데이터를 한 모델에 함께 미세조정했습니다. 학습에는 Xiaomi-Robotics-0이 제안한 비동기 학습 레시피를 썼습니다. 과제마다 성격이 다릅니다.
- 휴대폰 포장(Phone Packing): 양팔 협응이 필요합니다.
- 세탁물 넣기(Laundry Loading): 여러 단계의 지시를 따라야 하는 장기 과제(Long-Horizon)이며, 로봇이 이동까지 해야 합니다.
- 프린터 용지 보충(Printer Refilling): 잘 휘는 종이 다발을 다뤄야 합니다.
- 상자 담기(Box Packing): 여러 물체 사이에서 언어 지시와 실제 물체를 정확히 연결해야 합니다.
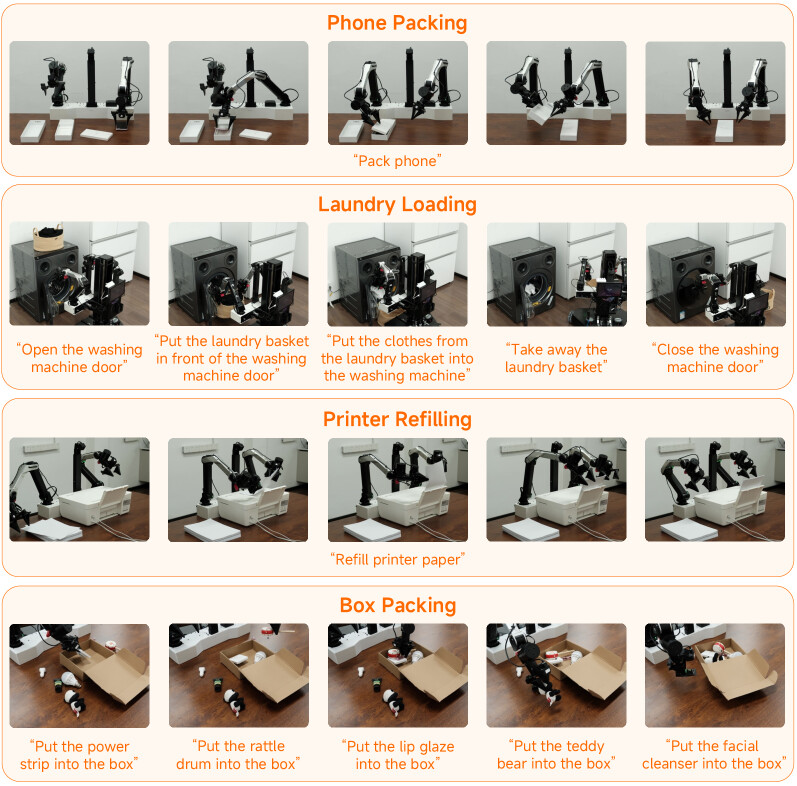
지시문의 형태도 과제마다 다릅니다. 휴대폰 포장과 프린터 용지 보충은 "Pack phone", "Refill printer paper" 처럼 한 마디로 끝나고, 나머지 둘은 단계별 지시가 순서대로 주어집니다. 세탁물 넣기는 세탁기 문 열기, 빨래 바구니를 문 앞으로 옮기기, 옷을 세탁기에 넣기, 바구니 치우기, 문 닫기의 5단계이며, 상자 담기는 멀티탭, 딸랑이 북, 립글로스, 곰인형, 클렌징폼처럼 서로 다른 물체 5개를 이름으로 지정합니다.
데이터 효율을 재기 위해 두 가지 설정을 두었습니다. 고데이터 설정은 4가지 과제를 합쳐 총 144시간이고, 저데이터 설정은 여기서 과제별로 25\% 만 뽑은 총 36시간입니다. 저데이터 설정의 과제당 평균은 10시간 미만이며, 가장 많은 프린터 용지 보충조차 10.3 시간뿐입니다. 비교 대상은 \pi_{0.5} 와 자사 이전 모델인 Xiaomi-Robotics-0 이며, \pi_{0.5} 는 공식 OpenPI 미세조정 절차를 따랐습니다. 과제마다 10회씩 시행했고, 성공률과 함께 과제별 마일스톤 달성 정도를 나타내는 진행도(Progress)를 함께 보고합니다.
진행도의 채점 기준은 위 단계들을 그대로 씁니다. 세탁물 넣기와 상자 담기는 5단계에 각각 20점씩 균등 배분하고, 프린터 용지 보충은 종이 집기, 양팔 사이 인계, 한쪽 끝을 트레이에 끼우기, 용지 다발을 완전히 밀어 넣기, 두 팔을 원위치로 되돌리기에 각각 20점, 20점, 20점, 30점, 10점을 줍니다. 마지막 항목처럼 팔을 안전한 자세로 되돌리는 것까지 점수에 넣기 때문에, 성공률이 0인 시행도 진행도는 0이 아닐 수 있습니다.
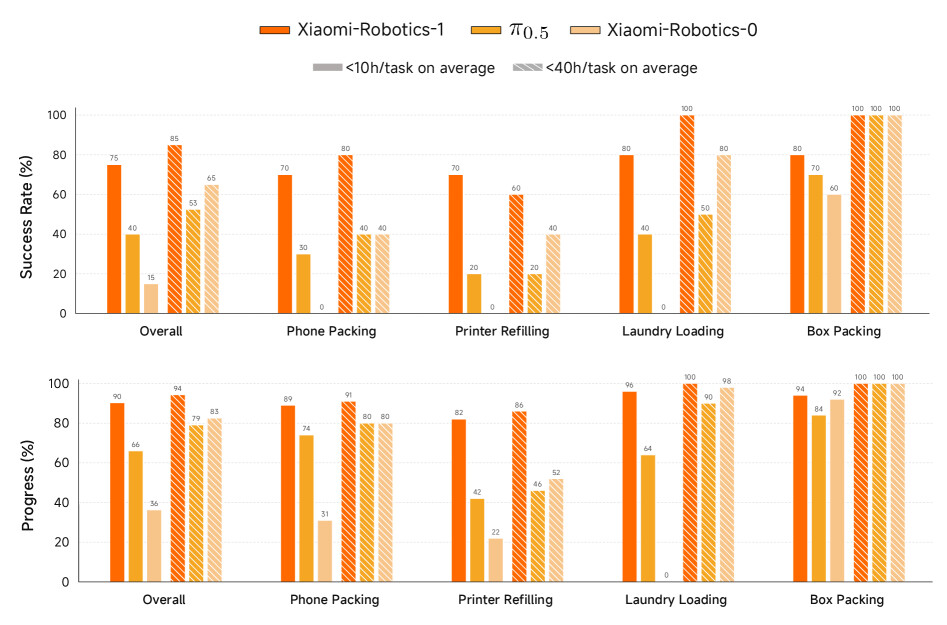
성공률을 정리하면 아래와 같습니다. 각 칸은 "저데이터 / 고데이터" 순서입니다.
| 과제 | XR-1 | \pi_{0.5} | Xiaomi-Robotics-0 |
|---|---|---|---|
| 전체 | 75 / 85 | 40 / 53 | 15 / 65 |
| 휴대폰 포장 | 70 / 80 | 30 / 40 | 0 / 40 |
| 프린터 용지 보충 | 70 / 60 | 20 / 20 | 0 / 40 |
| 세탁물 넣기 | 80 / 100 | 40 / 50 | 0 / 80 |
| 상자 담기 | 80 / 100 | 70 / 100 | 60 / 100 |
저데이터 설정에서 XR-1은 평균 성공률 75\%, 진행도 90\% 를 기록했습니다. 같은 예산에서 \pi_{0.5} 는 성공률 40\%, 진행도 66\% 입니다. 격차가 가장 큰 곳은 손재주와 이동이 함께 필요한 과제입니다. 프린터 용지 보충에서는 최고 기준선의 20\% 를 70\% 로 끌어올렸는데, 휘는 물체를 다루는 능력이 사전학습에서 왔다고 볼 만한 지점입니다. 앞서 본 데이터 워드클라우드에서 cloth와 fabric 같은 천 종류가 크게 잡혔던 것과도 이어집니다. 세탁물 넣기에서는 저데이터 설정에서도 성공률 80\%, 진행도 96\% 를 기록했습니다. 이 과제는 어느 단계에서든 실패할 수 있는 긴 과제인데, \pi_{0.5} 는 세탁기 문을 여는 단계에서 막혔고 Xiaomi-Robotics-0은 저데이터 설정에서 아예 완수하지 못했습니다.
상자 담기는 모든 방법이 비교적 잘 해냈고, 데이터를 늘리면 셋 다 100\% 에 도달합니다. 과제 난이도가 낮으면 파운데이션 모델의 이점이 줄어든다는 뜻으로, 데이터 효율의 가치는 어려운 과제에서 나타난다는 점을 보여 줍니다.
시뮬레이션 벤치마크 4종
실제 로봇 실험은 재현이 어렵기 때문에, 논문은 공개 시뮬레이션 벤치마크 4종에서도 평가했습니다. 저장소와 프로젝트 페이지는 2026년 7월 15일 기준으로 RoboCasa365와 RoboDojo 리더보드에서 1위라고 밝히고 있습니다. 2위 대비 상대 개선 폭은 RoboCasa가 2.6\%, RoboCasa365가 23.2\%, VLABench가 11.1\%, RoboDojo가 58.3\% 입니다. 절대 수치로는 비슷해 보여도 벤치마크가 어려워질수록 격차가 커지는 모양새입니다.
RoboCasa 는 사실적인 주방 환경의 단일 팔 조작 벤치마크로, 집기와 놓기부터 관절 물체 조작, 가전 조작, 커피 만들기까지 24가지 과제를 담고 있습니다. 일반화를 재기 위해 평가는 학습 때 보지 못한 물체 인스턴스로 진행하며, 5개 평가 장면 중 2개는 스타일 자체가 학습 데이터에 없던 장면입니다. 공식 합성 시연 300개로 학습하고, 5개 평가 장면에서 과제당 100 에피소드의 평균 성공률을 보고합니다.
| 방법 | 평균 성공률 (%) |
|---|---|
| UVA | 50.0 |
| UWM | 60.8 |
| \pi_{0.5} | 62.1 |
| \pi_0-FAST | 63.6 |
| GR00T N1.6 | 66.2 |
| Cosmos Policy | 67.1 |
| RLDX-1 | 70.6 |
| World2Act | 72.6 |
| Xiaomi-Robotics-1 | 74.5 |
RoboCasa365 는 RoboCasa를 365개 과제, 2,500개 이상의 절차적 생성 주방 장면, 3,200개 물체 인스턴스로 확장한 벤치마크입니다. 평가는 학습 중 본 원자 과제 18개, 본 조합 과제 16개, 보지 못한 조합 과제 16개로 나뉩니다. 마지막 항목은 이미 배운 원자 스킬을 재조합해 새로운 장기 과제를 푸는 제로샷 능력을 봅니다. 학습에는 공식 공개 데이터셋의 과제당 시연 100개를 썼습니다.
| 방법 | 평균 | 원자 과제 | 조합(학습됨) | 조합(미학습) |
|---|---|---|---|---|
| Diffusion Policy | 6.1 | 15.7 | 0.2 | 1.3 |
| \pi_{0.5} | 16.9 | 39.6 | 7.1 | 1.2 |
| GigaWorld-Policy 0.1 | 20.7 | 44.4 | 11.8 | 2.9 |
| GR00T-N1.6 | 21.9 | 51.1 | 9.4 | 1.7 |
| WorldDreamer | 35.3 | 66.3 | 26.7 | 9.0 |
| Qwen-RobotManip | 35.9 | 68.6 | 20.1 | 14.9 |
| RLDX-1 | 36.0 | 67.6 | 27.9 | 8.5 |
| ABot-M0.5 | 40.4 | 75.9 | 38.3 | 2.7 |
| ABot-M0.6 | 46.6 | 79.4 | 48.3 | 7.9 |
| Xiaomi-Robotics-1 | 57.4 | 80.2 | 57.1 | 32.1 |
위 표에서 가장 눈여겨볼 열은 맨 오른쪽의 조합(미학습)입니다. 기존 최고 성적이 14.9\% 였는데 XR-1은 32.1\% 로 두 배 이상입니다. 원자 과제에서는 80.2\% 대 79.4\% 로 큰 차이가 없다는 점과 함께 보면 해석이 분명해집니다. 개별 스킬의 숙련도보다 스킬을 재조합하는 능력에서 격차가 벌어집니다. 사전학습 데이터가 특정 과제로 잘려 있지 않고 상태 전이라는 연속적인 단위로 라벨링되어 있다는 점이, 과제 경계를 넘나드는 조합 능력과 무관하지 않아 보입니다.
VLABench 는 언어 조건부 조작을 평가하는 벤치마크로, 100개 과제 범주와 2,000개 이상의 물체 인스턴스를 담고 있습니다. 암묵적 의도가 들어간 지시문, 여러 단계 추론이 필요한 장기 과제, 상식 추론과 범주 수준 일반화를 요구하는 설정을 다섯 가지 트랙으로 나눠 평가합니다. 성공률(SR) 외에 두 지표를 더 씁니다. 진행 점수(PS)는 과제를 얼마나 완수했는지를, 의도 점수(IS)는 지시문의 의도를 얼마나 정확히 이해했는지를 봅니다. XR-1은 In-distribution 트랙의 공식 학습 세트(10개 과제, 과제당 500 시연)만으로 학습했고, ERVLA 처럼 생각의 사슬(Chain-of-Thought, CoT) 라벨을 50\% 확률로 함께 학습시켰습니다. 각 과제를 다섯 트랙 모두에서 트랙당 50 에피소드씩 평가하므로, 과제당 250회, 전체 2,500회의 시행이 이뤄집니다.
| 방법 | 평균 SR | 평균 PS | 평균 IS |
|---|---|---|---|
| \pi_0-FAST | 39.8 | 49.5 | 58.6 |
| \pi_{0.5} | 48.1 | 62.3 | 64.9 |
| ERVLA | 53.2 | 65.9 | 70.4 |
| Xiaomi-Robotics-1 | 59.1 | 70.3 | 69.9 |
평균 성공률(SR)과 진행 점수(PS)에서 1위이지만, 의도 점수(IS)는 ERVLA에 0.5 점 뒤집니다. 트랙별 성공률을 펼쳐 보면 승부가 갈리는 지점이 더 분명해집니다.
| 트랙 | \pi_{0.5} | ERVLA | Xiaomi-Robotics-1 |
|---|---|---|---|
| In-distribution | 65.4 | 69.7 | 75.6 |
| Cross-Category | 38.2 | 47.0 | 53.0 |
| Commonsense | 43.9 | 44.0 | 48.4 |
| Instruction | 48.2 | 58.0 | 55.8 |
| Texture | 44.9 | 47.4 | 62.6 |
| 평균 | 48.1 | 53.2 | 59.1 |
XR-1이 가장 크게 앞서는 트랙은 텍스처로, 최고 기준선보다 15.2 퍼센트포인트 높습니다. 범주 교차에서도 6.0 퍼센트포인트 앞섭니다. 물체의 겉모습이나 배경이 바뀌어도 잘 버틴다는 뜻이고, 1,700개 시나리오에서 모은 사전학습 데이터의 시각적 다양성이 여기에 기여했다고 볼 수 있습니다.
반대로 다섯 트랙을 전부 이긴 것은 아닙니다. Instruction 트랙에서는 ERVLA가 성공률 58.0\% 로 XR-1의 55.8\% 를 앞서고, 진행 점수와 의도 점수에서도 ERVLA가 위입니다(각각 70.2 대 66.8, 73.8 대 70.2 ). In-distribution 의도 점수에서는 XR-1의 79.8 이 ERVLA의 84.2 뿐 아니라 \pi_{0.5} 의 80.4 보다도 낮습니다. Instruction 트랙은 지시문에 담긴 암묵적 의도를 읽어 내는 능력을 재는 자리인데, 체화 생각의 사슬을 정면으로 다룬 ERVLA가 바로 그 지점에서 강한 것은 자연스럽습니다. XR-1이 이기는 곳은 시각적 변화에 대한 견고함이고, 지는 곳은 지시문 해석의 깊이입니다.
RoboDojo 는 시뮬레이션과 실제 로봇을 함께 다루는 벤치마크이며, XR-1은 이 중 시뮬레이션 부분에서만 평가했습니다. 42개 이상의 과제를 다섯 가지 능력 축으로 나눠 놓았습니다. 일반화는 물체와 배치가 바뀌었을 때의 견고함, 정밀은 세밀한 제어, 장기 과제는 여러 단계의 실행, 기억은 이전 상태에 의존하는 조작, 개방형은 열린 지시 이행을 봅니다. 아래는 각 축의 점수입니다.
| 방법 | 일반화 | 정밀 | 장기 과제 | 기억 | 개방형 | 평균 |
|---|---|---|---|---|---|---|
| Xiaomi-Robotics-0 | 7.43 | 8.42 | 13.51 | 5.07 | 0.22 | 6.93 |
| X-VLA | 10.48 | 18.32 | 16.53 | 4.76 | 0.55 | 10.13 |
| \pi_{0.5} | 13.37 | 12.40 | 23.54 | 5.78 | 1.98 | 11.41 |
| Spatial Forcing | 14.12 | 17.33 | 23.26 | 5.43 | 1.78 | 12.38 |
| Hy-Embodied-0.5-VLA | 11.77 | 13.81 | 25.74 | 13.37 | 0.65 | 13.07 |
| Xiaomi-Robotics-1 | 23.55 | 26.69 | 38.39 | 7.81 | 3.94 | 20.07 |
평균 점수 20.07 은 2위인 13.07 을 7.00 점 앞선 수치이며, 평균 성공률로는 13.93\% 대 8.80\% 입니다. 다섯 축 중 넷에서 1위인데, 기억 축에서만 Hy-Embodied-0.5-VLA에 밀립니다. 이유는 논문이 직접 밝히고 있습니다. RoboDojo 평가에서 과거 관측을 전혀 넣지 않았기 때문 입니다. 현재 프레임만 보는 정책이 상태 의존적 조작을 요구하는 축에서 불리한 것은 당연하며, 그런 조건에서도 나머지 모델들은 모두 앞섰습니다. 위 표에 같은 팀의 이전 모델인 Xiaomi-Robotics-0을 함께 넣어 두었는데, 평균 6.93 에서 20.07 로 세 배 가까이 올랐습니다. 사전학습 데이터의 규모와 라벨링 방식을 바꾼 것이 같은 팀의 직전 세대와 비교해도 큰 차이를 만들었다는 뜻입니다.
10분을 넘기는 방 규모 장기 과제
표에 들어가지 않은 결과가 하나 더 있습니다. 논문은 XR-1을 태운 로봇이 방 하나를 돌아다니며 여행 가방을 싸는 과제 를 사람의 개입 없이 끝까지 수행했다고 보고합니다. 소요 시간은 10분을 넘고, 프로젝트 페이지에 편집하지 않은 원본 영상이 올라와 있습니다. 앞서 본 평가 과제들이 길어도 5단계 안쪽이었던 것과 비교하면 규모가 다른 과제입니다.
다만 이 결과에는 수치가 붙어 있지 않습니다. 몇 번 시도해 몇 번 성공했는지, 실패했을 때 어느 단계에서 무너졌는지가 논문에 없으므로 정량 결과가 아니라 시연으로 읽는 편이 맞습니다.
한계와 함께 읽어야 할 점
이 논문은 스케일링이 통한다는 결론을 상당히 조심스럽게 제시하는 편이지만, 결과를 받아들일 때 함께 봐야 할 지점들이 있습니다.
스케일링 곡선은 20,000시간에서 그렸습니다. 앞서 언급했듯 데이터 스케일링과 모델 스케일링 실험은 모두 약 20,000시간 부분집합 위에서 이루어졌습니다. 10만 시간 전체로 사전학습한 모델의 처음 보는 환경 성공률은 논문에 따로 나오지 않습니다. 제목과 초록의 10만 시간은 공개된 체크포인트가 실제로 학습한 데이터량이고, 스케일링 곡선의 가로축과는 다른 숫자입니다. 50\% 에서 100\% 로 갈 때 6 퍼센트포인트가 올랐다는 관찰을 다섯 배 더 큰 규모까지 그대로 외삽할 수 있을지는 이 논문만으로 알 수 없습니다.
실제 로봇 평가의 시행 횟수가 적거나 밝혀지지 않았습니다. 신규 과제 미세조정 실험은 과제당 10회 시행입니다. 성공률 70\% 와 80\% 의 차이가 시행 한 번 차이라는 뜻입니다. 처음 보는 환경에서의 사후 학습 평가는 시행 횟수 자체가 논문에 명시되어 있지 않습니다. 실제로 표에는 순서를 뒤집는 값들이 섞여 있습니다. 신발 정리에서 사전학습 데이터 50\% 모델이 85\% 로 100\% 모델의 75\% 보다 높고, 프린터 용지 보충에서는 저데이터 설정의 70\% 가 고데이터 설정의 60\% 보다 높습니다. 저자들도 이 개별 값들을 근거로 삼지 않고 평균의 단조 증가만 주장하지만, 과제별 수치를 인용할 때는 표본 크기를 함께 기억해 둘 필요가 있습니다.
어떤 체크포인트로 낸 결과인지 밝히지 않은 실험이 있습니다. 스케일링 실험은 어느 데이터 비율과 어느 모델 크기를 썼는지 분명히 적어 두었지만, 신규 과제 미세조정과 시뮬레이션 벤치마크는 "사후 학습을 마친 모델" 이라고만 하고 크기도 사전학습 규모도 명시하지 않습니다. Hugging Face에 올라온 벤치마크 체크포인트가 모두 5B로 표시되어 있어 5B로 짐작할 수는 있지만, 논문만으로는 확정되지 않습니다. 표의 수치를 특정 변형의 성능으로 인용하려면 이 점을 감안해야 합니다.
관측 구성이 본문에 없습니다. 논문은 관측을 \boldsymbol{o}_t 라는 기호로만 두고, 카메라를 몇 대 어떻게 배치했는지, 사전학습의 UMI 관측과 사후 학습의 로봇 관측을 어떤 방식으로 맞췄는지 설명하지 않습니다. 앞서 본 것처럼 아키텍처 그림과 배포 코드에서 이미지 3장이라는 사실은 확인되지만, 그것이 두 학습 단계 모두에 해당하는지는 알 수 없습니다. 행동 공간을 통일하는 절차는 수식까지 적어 둔 것과 대비되는 공백이고, 직접 재현하려는 쪽에서는 가장 먼저 막힐 지점입니다.
행동 사전학습 없는 기준선이 다소 약합니다. 데이터 스케일링 실험의 0\% 지점은 Qwen3-VL 가중치에서 곧바로 사후 학습을 시작한 모델입니다. 로봇 데이터로 사전학습한 다른 공개 모델을 같은 사후 학습 절차에 태워 비교한 것은 아니므로, 26\% 에서 75\% 라는 상승 폭 전부를 UMI 사전학습의 고유한 기여로 읽기는 어렵습니다.
UMI 데이터가 담지 못하는 영역이 있습니다. 사전학습 데이터의 동사 분포는 잡기, 들기, 옮기기에 집중되어 있습니다. UMI 그리퍼는 두 손가락 집게이고 촉각 센서가 없으므로, 손가락 여러 개를 써야 하는 정교한 조작이나 촉각 피드백에 의존하는 작업은 애초에 데이터에 들어오지 않습니다. 논문이 보고한 강점이 집안일 정리 과제에 몰려 있는 것은 방법의 한계라기보다 데이터의 성격이 그대로 드러난 결과에 가깝습니다.
과거 관측을 쓰지 않습니다. RoboDojo의 기억 축 결과가 보여 주듯, 현재 XR-1은 관측 이력을 입력에 넣지 않습니다. "아까 꺼낸 물건을 원래 자리에 돌려놓아라" 처럼 이전 상태를 기억해야 하는 과제는 구조적으로 불리합니다. 논문도 이를 인정하고 있으며, 이력을 다루는 확장이 자연스러운 다음 단계로 보입니다.
초록과 표의 숫자가 어긋난 곳이 하나 있습니다. 프로젝트 페이지에 올라온 PDF는 초록과 서론 모두 RoboCasa365 성공률을 57.6\% 로 적었습니다. arXiv v2는 초록만 57.4\% 로 고쳤고 서론은 그대로 57.6\% 입니다. 실제 결과 표와 프로젝트 페이지 본문, GitHub 저장소가 모두 57.4\% 이므로 이 글은 57.4\% 를 따랐습니다.
이런 유보 사항들을 감안하더라도, 이 논문이 로봇 학습에 남기는 메시지는 분명합니다. 로봇 데이터가 부족한 이유는 세상에 조작 행위가 부족해서가 아니라 그것을 기록하고 이름 붙이는 방법이 비쌌기 때문이며, 수집 장치를 사람 손에 쥐여 주고 라벨링을 VLM에게 맡기면 그 비용 구조가 바뀝니다. 그리고 비용 구조가 바뀌자 언어 모델에서 보던 익숙한 그림, 즉 데이터를 넣을수록 좋아지고 아직 포화하지 않은 곡선이 로봇에서도 나타났습니다. 남은 질문은 그 곡선이 어디까지 이어지는가인데, 그 답은 다음 논문의 가로축이 얼마나 길어지는지가 알려 줄 것입니다.
Xiaomi-Robotics-1 설치 및 사용 방법
XR-1의 사후 학습과 배포 코드는 GitHub 저장소의 xr1/ 디렉터리에 있습니다. Python 3.9 이상과 CUDA GPU가 필요하며, transformers 는 4.57.1 로 고정해야 합니다. 다른 버전은 검증되지 않았습니다.
git clone https://github.com/XiaomiRobotics/Xiaomi-Robotics-1.git
cd Xiaomi-Robotics-1/xr1

pip install -e .
pip install flash-attn --no-build-isolation
VLM 백본인 Qwen/Qwen3-VL-4B-Instruct 가 Hugging Face나 로컬 캐시에서 접근 가능해야 합니다. 체크포인트는 Xiaomi-Robotics-1-5B 를 받아 pretrained_ckpt/model_states.pt 로 저장합니다. 사후 학습 데모 데이터셋 도 함께 공개되어 있으며, 에피소드 하나는 메타데이터 JSON 하나와 1인칭, 왼손목, 오른손목 카메라의 동기화된 영상 3개로 구성됩니다.
학습은 런처 스크립트로 실행합니다. 비동기 학습이 기본값입니다.
wandb login

RESOURCE_GPU=1 bash scripts/train.sh \
  trainer.project="xiaomi-robotics-1" \
  trainer.exp_name="posttrain" \
  trainer.default_root_dir="outputs" \
  data=load_washer \
  model=posttrain \
  model.params.pretrained="pretrained_ckpt/model_states.pt"
자체 데이터로 학습하려면 configs/data/load_washer.yaml 을 수정합니다. 데이터 경로와 함께, 묶인 상대 행동의 스텝별 평균 및 표준편차와 로봇 상태의 분위수를 채워 넣어야 합니다. 기본 형상은 행동이 (30, 60), 상태가 (1, 60) 입니다.
배포는 클라이언트-서버 런타임으로 이뤄지며 tmux 가 필요합니다.
bash scripts/deploy.sh outputs/project_xiaomi-robotics-1/posttrain 1 1
클라이언트 API는 PIL 이미지 3장과 지시문, 현재 로봇 상태를 받아 행동을 돌려줍니다. 로봇 상태에는 좌우 팔 관절 각도, 그리퍼 위치, 엔드 이펙터 위치와 회전 행렬이 들어가고 허리 위치는 선택입니다. 비동기 실행을 쓰려면 정규화하지 않은 (N, 60) 형태의 행동 접두를 함께 넘깁니다.
벤치마크 재현을 위한 체크포인트와 평가 가이드는 RoboCasa, RoboCasa365, VLABench 세 가지에 대해 각각 제공되며, 모두 5B로 표시되어 있습니다. RoboDojo는 공식 저장소의 문서를 따르라고 안내하고 있습니다.
 Xiaomi-Robotics-1: Scaling Vision-Language-Action Models with over 100K Hours of Real-World Trajectories 논문
Xiaomi-Robotics-0: An Open-Sourced Vision-Language-Action Model with Real-Time Execution 논문
 Xiaomi-Robotics-1 프로젝트 홈페이지
 Xiaomi-Robotics-1 GitHub 저장소
 Xiaomi-Robotics-1 컬렉션 (Hugging Face)
Xiaomi-Robotics-1-5B 모델 (Hugging Face)
 Xiaomi-Robotics-1 사후 학습 데모 데이터셋 (Hugging Face)
Universal Manipulation Interface 논문
더 읽어보기
-
Physical AI 연구 한 번에 살펴보기 1편: LLM 월드 지식에서 VLA와 월드 모델, 체화 에이전트까지
-
World Action Model의 부상: 비디오 백본으로 로봇 정책을 학습하는 두 번째 레시피 (feat. NVIDIA)
-
BitRobot, 실제 가정의 500시간 휴머노이드 로봇 데이터셋 HIW-500 공개 (feat. Unitree)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
논문의 주장이나 벤치마크에 대한 의견, 직접 재현해보신 결과가 있다면  파이토치 한국 사용자 모임
 회원들을 위해 댓글로 공유해주세요!
