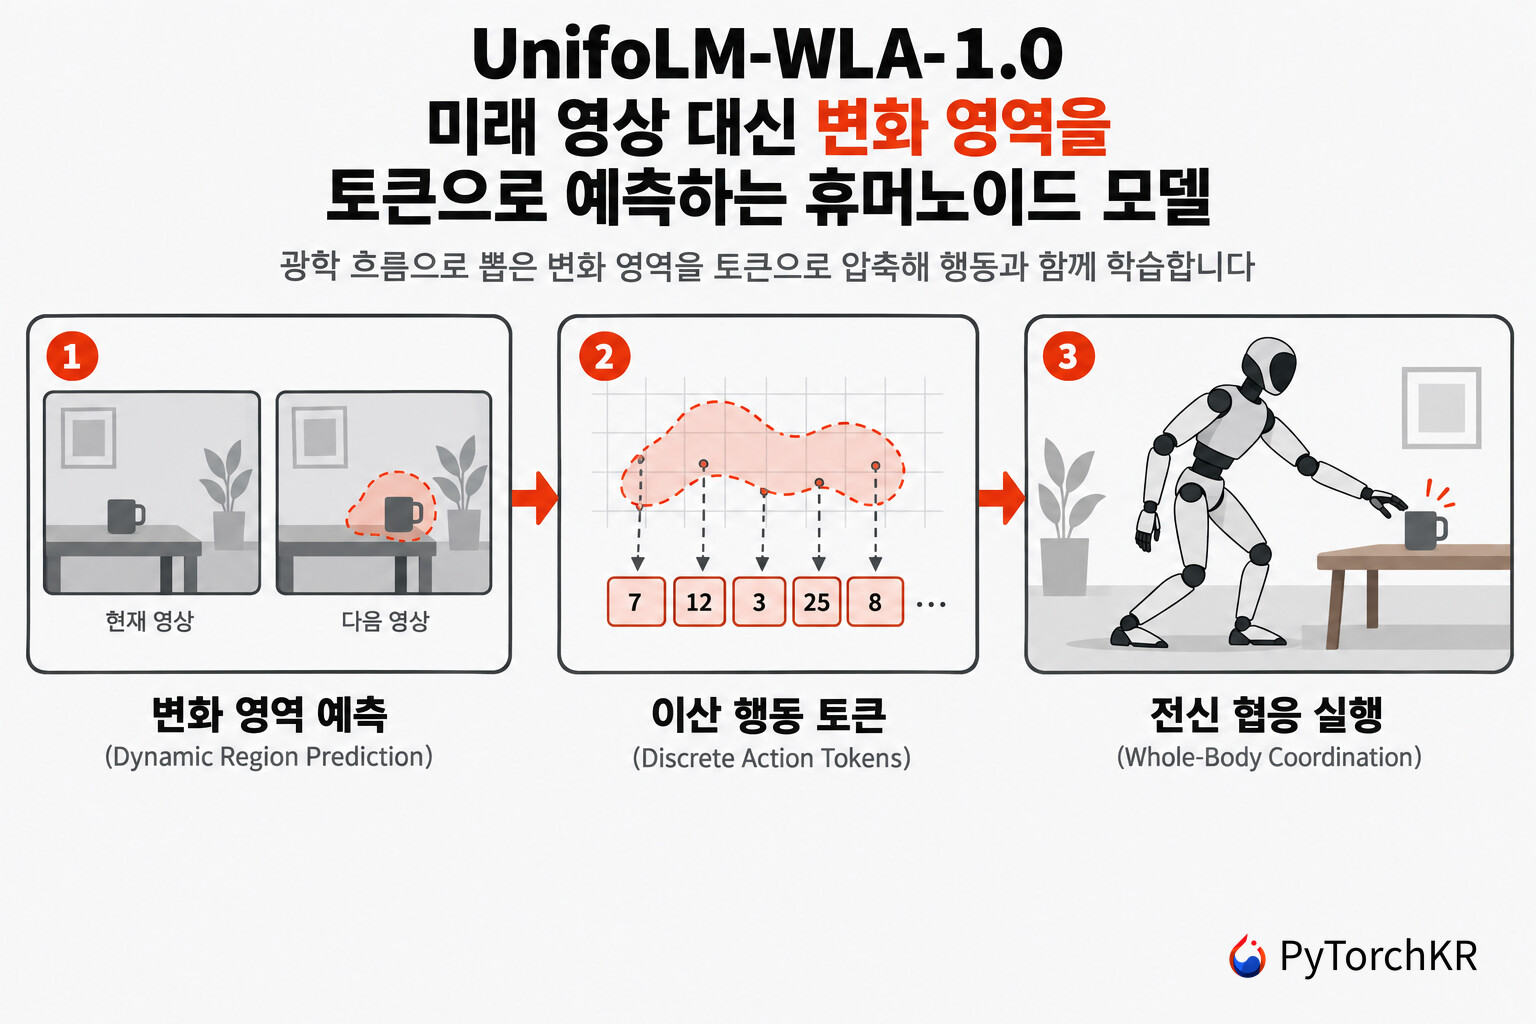
UnifoLM-WLA-1.0 소개
UnifoLM-WLA-1.0은 중국의 휴머노이드 로봇 제조사 Unitree Robotics가 2026년 9월 11일에 공개한 60억(6B) 파라미터 규모의 범용 휴머노이드 로봇 파운데이션 모델입니다. 약 2,500시간 분량의 실기(real-robot) 데이터로 학습해, 한 개의 모델이 탁상 조작 54개와 전신 이동 조작 10개를 합친 64개 작업을 수행하고, 2지 그리퍼와 여러 종류의 5지 손을 함께 지원한다는 것이 발표의 핵심입니다.
이름의 WLA가 무엇의 약자인지는 프로젝트 페이지에도 저장소에도 적혀 있지 않습니다. 다만 Figure AI의 Helix나 Google DeepMind의 Gemini Robotics 2처럼 널리 쓰이는 시각-언어-행동(Vision-Language-Action, VLA) 에서 첫 글자만 W로 바뀐 이름이고, 페이지가 설명하는 내용도 그 차이에 정확히 대응합니다. 로봇 정책이 잘 동작하려면 지금 무엇이 보이는지를 아는 것만으로는 부족하고, 자기가 이렇게 움직였을 때 장면이 어떻게 바뀌는지까지 알아야 한다는 것이 최근 2년간 여러 연구가 공유해 온 문제의식입니다. 이 문제의식을 다룬 계보는 PyTorchKR에 정리한 World Action Model 흐름에서 한 번에 확인할 수 있습니다.
Unitree는 이 문제를 이미 한 번 다뤘습니다. 2025년 9월에 공개한 UnifoLM-WMA-0가 그것으로, 저장소 제목이 밝히듯 월드 모델 행동(World-Model-Action, WMA) 프레임워크였습니다. 비디오 확산 모델을 월드 모델로 두고 미래 상호작용 영상을 생성한 뒤, 그 표현을 행동 헤드에 연결하는 구조입니다. 영상을 통째로 생성하는 방식은 직관적이지만 비싸고 느립니다. UnifoLM-WLA-1.0이 1년 만에 내놓은 답은 방향이 다릅니다. 미래 장면 전체를 생성하는 대신, 앞으로 바뀔 영역(dynamic region)만 골라 이산 토큰으로 압축해 예측합니다. 그러면 월드 모델이 별도 비디오 생성기가 아니라 비전-언어 모델(VLM) 안의 토큰 예측 과제가 되고, 행동 토큰과 같은 시퀀스 안에서 함께 학습됩니다.
이 글에서는 공개된 모델 가중치와 저장소, 기술 문서, 데이터셋을 직접 확인해 이 구조가 실제로 어떻게 구현되어 있는지, 그리고 발표가 주장하는 성능 중 무엇이 검증 가능하고 무엇이 아직 확인할 수 없는지를 정리합니다.
무엇이 공개되었고 무엇이 아직 공개되지 않았는가
게시물 앞머리에서 공개 범위를 먼저 정리합니다. GitHub 저장소의 표지 이미지에는 "Fully Open Source" 라는 문구가 큼직하게 박혀 있지만, 2026년 9월 15일 기준으로 실제 공개된 것은 최종 모델이 아니라 그 앞 단계 두 개입니다.
| 구성요소 | 상태 | 비고 |
|---|---|---|
| UnifoLM-ER-1 (4B) | 공개 | 공간 인지 담당 VLM, Apache 2.0 |
| UnifoLM-ER-Flow | 공개 | 변화 영역 및 행동 토큰까지 정렬된 VLM, Apache 2.0 |
| UnifoLM-WLA-Base (6B) | 미공개 | 데모 영상의 주인공인 최종 모델 |
| 사후 학습(post-train) 코드 | 미공개 | 저장소에 학습 및 추론 코드 없음 |
| UniBot-V1 Challenge 데이터셋 | 공개 | 탁상 조작 32종 |
| UnifoLM_WBT_Dataset | 공개 | 전신 원격조작 54종 |
즉, 지금 내려받아 돌려볼 수 있는 것은 인지와 표현 학습 단계까지이고, 그 위에 얹히는 행동 전문가(action expert)와 이를 학습시킨 코드는 아직 없습니다. 저장소에는 README와 라이선스, 그리고 뒤에서 자세히 다룰 데이터 처리 명세 문서만 들어 있습니다. 앞선 UnifoLM-WMA-0가 학습, 추론, 체크포인트, 배포를 모두 공개했던 것과 비교하면 이번 공개는 단계적 공개의 첫 번째 배치에 가깝습니다.
3단 구조: ER-1에서 ER-Flow로, 그리고 WLA로
UnifoLM-WLA-1.0은 한 번에 학습한 단일 모델이 아니라 세 단계를 쌓아 올린 결과입니다. 각 단계가 무엇을 더하는지 먼저 보면 이후 설명이 훨씬 따라가기 쉽습니다.
1단계, UnifoLM-ER-1: Qwen3-VL-4B를 베이스로 500만 개 이상의 체화 인지 샘플을 학습시킨 체화 추론(Embodied Reasoning, ER) 모델입니다. 이미지 위의 점 예측, 객체 검출, 다중 이미지 추론, 2D 궤적 예측, 3D 객체 검출, 다중 이미지 공간 질의응답을 다루며, 일반 이미지-텍스트 데이터와 함께 학습해 범용 비전-언어 능력을 유지하려 했습니다.
2단계, UnifoLM-ER-Flow: ER-1의 어휘에 두 종류의 토큰을 추가합니다. 하나는 미래 변화 영역을 나타내는 마스크 토큰이고, 다른 하나는 로봇 동작을 이산화한 행동 토큰입니다. 시각, 언어, 미래 변화, 행동이 하나의 VLM 시퀀스 안에서 정렬됩니다.
3단계, UnifoLM-WLA-1.0: ER-Flow를 멀티모달 백본으로 두고, 그 위에 MMDiT(Multimodal Diffusion Transformer) 기반의 흐름 디코더를 행동 전문가로 연결합니다. MMDiT는 Stable Diffusion 3 논문에서 제안된 구조로, 서로 다른 모달리티에 별도 가중치를 두면서 어텐션만 공유하는 방식입니다. 여기서는 이산 토큰이 아니라 연속적인 행동 값을 흐름 매칭(flow matching)으로 생성하는 역할을 맡습니다.
공개된 두 체크포인트의 실제 크기를 재 보면 이 3단 구조가 숫자로도 맞아떨어집니다. ER-1의 safetensors 인덱스는 총 8.88GB(bfloat16)로 약 44.4억 파라미터, ER-Flow는 9.68GB로 약 48.4억 파라미터입니다. 차이인 약 4억 파라미터는 ER-Flow에서 임베딩과 묶여 있지 않은 별도 lm_head(152,960 x 2,560, 약 3.92억)와 로봇 상태 투영기가 차지합니다. 발표가 말하는 6B와 ER-Flow의 4.84B 사이의 약 1.2B가 MMDiT 행동 전문가의 몫으로 남습니다.
공간을 이해하는 눈: UnifoLM-ER-1과 16개 벤치마크
ER-1은 16개 멀티모달 인지 벤치마크에서 평가되었고, 발표는 "오픈소스 모델 중 7개에서 선두" 라고 밝히고 있습니다. 모델 카드에 실린 전체 표를 열 단위로 다시 계산해 보면 이 주장은 정확합니다. 다만 표를 그대로 옮기는 것보다, 자기 베이스 모델인 Qwen3-VL-4B와 나란히 놓는 것이 이 모델이 무엇을 얻고 무엇을 내줬는지를 훨씬 선명하게 보여줍니다.
아래 표의 베이스 대비 열은 Qwen3-VL-4B 점수와의 비교이고, 다른 오픈소스 최고 열은 ER-1을 제외한 공개 모델 중 최고 점수입니다. 위쪽 7행이 ER-1이 오픈소스 1위를 차지한 항목입니다.
| 벤치마크 | UnifoLM-ER-1-4B | Qwen3-VL-4B | 베이스 대비 | 다른 오픈소스 최고 |
|---|---|---|---|---|
| RefSpatial-Bench | 61.7 | 46.6 | 상승 | Thinker-4B 61.0 |
| Where2Place | 82.0 | 63.0 | 상승 | Embodied-R1.5-8B 74.0 |
| Pixmo-Point | 73.8 | 48.3 | 상승 | Embodied-R1.5-8B 64.8 |
| BLINK | 93.4 | 85.0 | 상승 | Cosmos3-Super-64B 90.3 |
| EmbSpatial | 88.9 | 79.6 | 상승 | Hy-Embodied-VLM 30B-A3B 82.7 |
| RoboSpatial | 73.1 | 61.7 | 상승 | Thinker-4B 70.8 |
| VSR | 88.1 | 81.6 | 상승 | RoboBrain2.0-7B 84.0 |
| RoboVQA | 62.4 | 47.7 | 상승 | Thinker-4B 62.7 |
| Ego-Plan2 | 55.1 | 40.7 | 상승 | Thinker-4B 63.7 |
| CV-Bench | 88.6 | 85.1 | 상승 | Hy-Embodied-VLM 30B-A3B 89.7 |
| SAT | 76.0 | 68.7 | 상승 | Cosmos-R1-7B 82.7 |
| ERQA | 50.0 | 41.3 | 상승 | Hy-Embodied-VLM 30B-A3B 60.8 |
| VSI-Bench | 54.2 | 59.3 | 하락 | Molmo2-ER-4B 74.5 |
| RealWorldQA | 69.8 | 71.0 | 하락 | Thinker-4B 71.9 |
| MME | 2223.3 | 2325.2 | 하락 | Qwen3-VL-8B 2412.5 |
| MMMU_VAL | 54.7 | 57.8 | 하락 | Qwen3-VL-8B 62.3 |
위 표를 통해 세 가지를 확인할 수 있습니다.
첫째, 베이스 모델 대비 16개 중 12개가 올랐고 4개가 내려갔습니다. 오른 12개는 대부분 공간 지시와 위치 특정에 관한 것으로, Pixmo-Point는 48.3에서 73.8로, Where2Place는 63.0에서 82.0으로 20점 가까이 올랐습니다. 4B 크기 모델이 파라미터가 훨씬 많은 30B급 오픈소스 모델을 EmbSpatial과 RoboSpatial에서 앞섰습니다.
둘째, 내려간 4개는 전부 범용 시각-언어 능력을 재는 항목입니다. MMMU_VAL은 57.8에서 54.7로, MME는 2325.2에서 2223.3으로 떨어졌습니다. 모델 카드는 "범용 비전-언어 능력을 보존하면서" 학습했다고 적고 있지만, 측정 가능한 대가가 실제로 존재합니다. 흥미로운 것은 VSI-Bench가 59.3에서 54.2로 떨어졌다는 점입니다. VSI-Bench 역시 공간 지능을 재지만 영상 기반이라, 이미지 단위 공간 인지에 집중한 학습이 시간 축을 가로지르는 공간 추론까지 끌어올리지는 못했음을 시사합니다.
셋째, BLINK 열은 다른 열과 같은 기준으로 읽으면 안 됩니다. 모델 카드의 각주는 BLINK 점수가 "상대 깊이(Relative Depth)와 공간 관계(Spatial Relation) 하위 과제만 평균한 값" 이며 해당 표시가 붙은 행은 모두 자체 측정이라고 밝히고 있습니다. 19개 행 중 14개에 이 표시가 붙어 있고, 표시가 없는 RoboBrain2.0(83.9), Robix(87.6), Thinker-4B(84.6) 등 5개 행은 표가 공식 기술 보고서 출처로 표기한 행들입니다. 서로 다른 지표가 한 열에 섞여 있으므로, ER-1의 93.4를 표시 없는 행들과 직접 비교하는 것은 성립하지 않습니다.
영상을 만들지 않는 월드 모델: 변화 영역 예측
이름에서 V가 W로 바뀐 이유에 해당하는 부분이 여기입니다. 기존 월드 모델 계열은 다음 프레임 혹은 다음 몇 초의 영상을 생성하도록 학습합니다. 정보량은 많지만 로봇이 실제로 신경 써야 할 부분과 배경 벽지를 똑같은 비용으로 예측하게 되고, 추론 시간도 길어집니다.
UnifoLM-ER-Flow는 이 문제를 예측 대상을 줄이는 것으로 해결합니다. 절차는 다음과 같습니다.
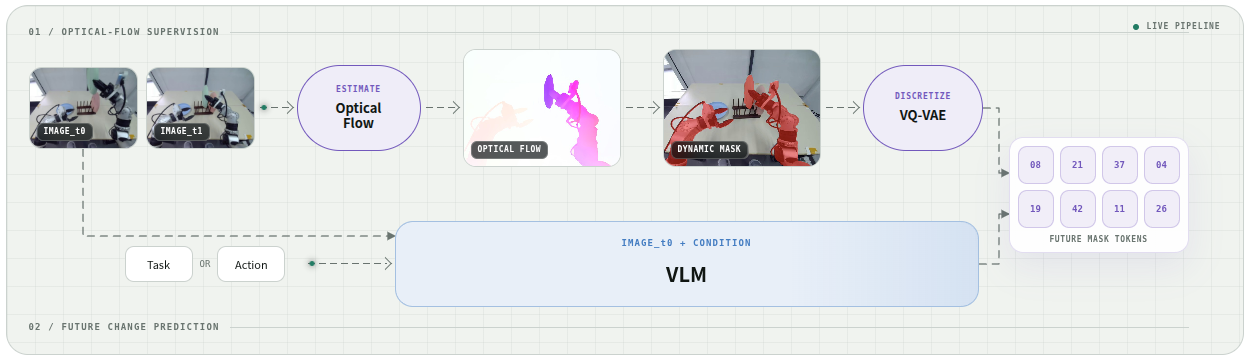
- 시점 t0과 t1의 로봇 시점 이미지 사이에서 광학 흐름(Optical Flow) 을 추정합니다. 픽셀이 어디로 얼마나 움직였는지를 나타내는 벡터장입니다.
- 흐름의 크기가 큰 영역을 변화 영역 마스크(dynamic mask) 로 분리합니다. 그림에서 붉게 칠해진 부분이 상호작용 주체와 그로 인해 바뀐 장면입니다.
- 이 마스크를 VQ-VAE(Vector Quantized Variational AutoEncoder)로 인코딩해 고정 길이의 이산 토큰 열로 압축합니다.
- VLM은 현재 이미지 t0과 조건(작업 설명 문장 또는 행동)을 입력받아, 미래 변화 영역에 해당하는 마스크 토큰을 직접 생성합니다.
공개된 ER-Flow 토크나이저를 열어 보면 이 설계가 그대로 확인됩니다. <seg_begin>과 <seg_end> 로 감싸인 <seg000>부터 <seg255>까지 256개의 세그먼트 코드가 어휘에 추가되어 있습니다. VQ-VAE 코드북의 크기가 256이라는 뜻이고, 마스크 한 장은 이 256개 중에서 고른 인덱스들의 나열로 바뀝니다. 모델은 이 인덱스를 언어 토큰과 똑같은 방식으로 예측합니다.
접근 방식의 차이가 만드는 결과는 분명합니다. 영상 생성 월드 모델은 다음 순간에 무엇이 보일지를 픽셀 단위로 답하고, 변화 영역 예측은 무엇이 달라질지를 수백 개의 정수로 답합니다. 뒤쪽이 훨씬 싸고, 로봇 정책이 실제로 필요로 하는 정보에 가깝습니다. 반면 장면의 세부 질감이나 가려진 물체의 모습처럼 픽셀 단위 예측에서만 얻을 수 있는 정보는 포기하게 됩니다. 같은 문제를 언어를 인터페이스로 삼아 푸는 접근은 Qwen-RobotWorld에서 확인할 수 있습니다.
프로젝트 페이지는 학습된 예측기가 실제로 어떤 영역을 짚는지 네 개의 데모로 보여 줍니다. 아래 탁자 정리 작업에서는 붉은 마스크가 움직이는 양팔과 함께, 로봇이 집어 옮기는 접시까지 덮습니다. 반대로 탁자 상판과 뒤쪽 벽면은 거의 포함되지 않습니다. 화면 좌측 하단 라벨이 밝히듯 2배속으로 재생된 영상입니다.
수건을 접는 작업에서는 마스크가 양팔과 그리퍼를 따라 이동하고, 아직 정지해 있는 수건 본체는 마스크 바깥에 남습니다. 광학 흐름으로 뽑은 영역인 만큼 실제로 움직인 것만 들어가고, 앞으로 조작될 대상이라도 지금 정지해 있으면 빠집니다.
연속 동작을 토큰으로: RVQ 기반 이산 행동 학습
월드 모델 쪽이 마스크 토큰을 다뤘다면, 행동 쪽은 잔차 벡터 양자화(Residual Vector Quantization, RVQ) 를 씁니다. 연속적인 관절 궤적을 그대로 언어 모델에 넣을 수 없으니, 코드북으로 양자화한 뒤 남은 오차를 다시 양자화하는 방식을 반복해 이산 토큰 열로 바꿉니다.
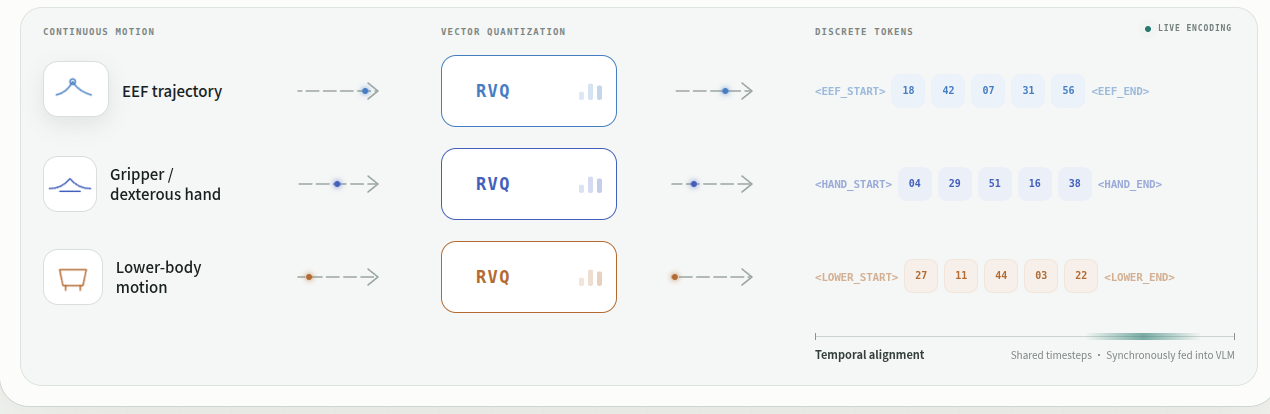
여기서 중요한 설계 결정은 행동 공간을 하나로 묶지 않고 셋으로 나눈 것입니다. 말단 장치(End-Effector, EEF) 자세, 말단 장치 관절, 하체 관절 각각에 독립적인 RVQ 모델을 학습시킵니다. 팔의 정밀한 위치 제어와 다리의 보행 리듬은 값의 분포와 시간 규모가 전혀 다르기 때문에, 하나의 코드북으로 묶으면 어느 한쪽이 희생됩니다. 세 토큰 열은 같은 시간 축을 공유하며 VLM에 동시에 입력됩니다.
공개된 토크나이저의 어휘를 직접 확인하면 이 분할이 정확히 몇 개의 코드로 이뤄져 있는지까지 알 수 있습니다. 프로젝트 페이지의 도식에는 <EEF_START>, <HAND_START>, <LOWER_START> 처럼 단순화된 이름이 그려져 있지만, 실제 어휘에 들어 있는 것은 파이프 문자를 포함한 형태입니다.
# 구간 경계 토큰
<|EEF_START|> <|EEF_END|>      # 말단 장치 자세
<|HAND_START|> <|HAND_END|>    # 그리퍼 / 5지 손
<|LOW_START|> <|LOW_END|>      # 하체

# 코드북 (각 256개)
<|POS_0|>  ... <|POS_255|>     # 말단 장치 위치
<|ROT_0|>  ... <|ROT_255|>     # 말단 장치 회전
<|HAND_0|> ... <|HAND_255|>    # 손 동작
<|LOW_0|>  ... <|LOW_255|>     # 하체 동작

# 보조 토큰
<|SEP_VQ|> <|robot_state|> <|robot_state_implicit_stats|>
발표 설명은 말단 장치 자세를 하나의 구성요소로 서술하지만, 어휘에서는 위치(POS)와 회전(ROT)이 각각 256개 코드로 분리되어 있습니다. 회전은 주기적이고 위치는 그렇지 않으니 코드북을 나누는 편이 자연스럽습니다. 세그먼트 코드까지 합치면 ER-Flow의 어휘에는 토큰 ID 151669번부터 152959번까지, 정확히 1,291개의 특수 토큰이 베이스 Qwen3-VL 위에 추가되어 있습니다.
로봇의 현재 상태는 토큰이 아니라 별도 경로로 들어갑니다. ER-Flow의 config.json에는 robot_state_dim이 120으로 지정되어 있고, 가중치 파일에는 robot_state_projector라는 2층 MLP가 실제로 들어 있습니다. 텐서 형상을 직접 읽어 보면 120차원 입력을 2,560차원(모델의 은닉 차원)으로 올린 뒤 한 번 더 2,560차원으로 변환하는 구조입니다. 이렇게 투영된 벡터가 <|robot_state|> 토큰 자리에 주입됩니다.
# UnifoLM-ER-Flow model.safetensors 헤더에서 읽은 실제 텐서 형상
robot_state_projector.net.0.weight  BF16  [2560, 120]
robot_state_projector.net.0.bias    BF16  [2560]
robot_state_projector.net.2.weight  BF16  [2560, 2560]
robot_state_projector.net.2.bias    BF16  [2560]
서로 다른 로봇을 한 좌표계로: 54차원 행동과 60차원 상태
여러 로봇 형태의 데이터를 하나의 모델로 학습하려면 먼저 좌표계와 차원을 통일해야 합니다. Unitree는 이 작업을 어떻게 했는지를 로봇 행동, 상태, 통계량 처리 명세라는 1,500줄 넘는 문서로 공개했습니다. 코드가 아직 없는 상태에서 이 문서가 사실상 가장 구체적인 재현 자료입니다.
명세의 뼈대는 간단합니다. 모든 미래 행동은 54차원 벡터로, 모든 현재 상태는 60차원 벡터로 표현하고, 로봇마다 사용할 수 없는 모듈은 불리언 마스크로 표시합니다. 행동 54차원의 배치는 다음과 같습니다.
| 구간 | 차원 | 모듈 | 표현 |
|---|---|---|---|
[0:6], [13:19] |
6 + 6 | 좌우 말단 장치 | 현재 상태 기준 상대 xyz + 회전 벡터 |
[6:7], [19:20] |
1 + 1 | 좌우 그리퍼 | 스칼라, 정규화 후 이진화 선택 |
[7:13], [20:26] |
6 + 6 | 좌우 5지 손 | 원시 행동 앞 6개 성분 |
[26:29], [29:32] |
3 + 3 | 허리, 몸통 | 앞 3개 성분 |
[32:34] |
2 | 베이스 병진 | 베이스 선속도 명령 vx, vy |
[34:35] |
1 | 베이스 회전 | 베이스 요레이트 명령 omega_z |
[35:41] |
6 | 베이스 자세 | 현재 상태 기준 상대 자세 |
[41:42] |
1 | 높이 | 스칼라 |
[42:48], [48:54] |
6 + 6 | 좌우 다리 | 관절 행동 앞 6개 성분 |
상태 60차원은 말단 장치 자세를 xyz와 회전 6D 표현(Rotation-6D) 으로 9차원씩 담고, 베이스의 중력 방향과 정규화된 각속도 6차원을 포함합니다. 여기에 같은 크기의 유효성 마스크를 합치면 앞서 본 robot_state_dim 120과 자릿수가 맞습니다.
명세에서 특히 눈여겨볼 규칙이 몇 가지 있습니다.
- 오른팔에 거울 좌표계를 쓰지 않습니다. 좌우 말단 장치 모두 로봇 베이스 좌표계 기준으로 x는 앞, y는 왼쪽, z는 위입니다. 같은 성분의 부호가 양팔에서 같은 물리적 의미를 가져야 한다고 명시하고 있습니다.
- 말단 장치와 베이스 자세만 상대 SE(3) 변환으로 바꿉니다. 그리퍼, 손, 허리, 몸통, 속도 명령, 높이, 다리는 원본 데이터셋의 제어 의미를 그대로 유지합니다.
- 정규화 방식이 모듈마다 다릅니다. 상대 자세 행동은 전역 Z-점수, 나머지 일반 행동과 상태는 1분위와 99분위를 쓰는 분위수 최소최대 정규화가 기본값입니다. 극단값에 통계가 흔들리는 것을 막기 위한 선택입니다.
- 같은 로봇 형태의 여러 작업 통계를 합칠 때 작업별 가중치를 동일하게 둡니다. 에피소드 수가 많은 작업이 통계를 독점하지 않도록 하는 장치이고, 명세는 이 등가중 가정의 한계까지 별도 절로 설명합니다.
- 회전 표현은 정규화하지 않습니다. 상태의 말단 장치 자세 9차원 중 앞 3개 xyz만 통계로 정규화하고, 뒤 6개의 회전 6D는 원본 그대로 둡니다. 원본 포즈가 RPY든 쿼터니언이든 회전 벡터든 그 통계는 회전 6D와 차원도 기하도 맞지 않기 때문입니다. 중력 방향 3차원도 데이터셋 통계 대신 단위 노름 정규화만 적용합니다.
- 그리퍼 이진화에는 히스테리시스가 들어갑니다. 정규화된 값이 0.9를 넘으면 열림, -0.9 미만이면 닫힘으로 확정하고, 그 사이의 애매한 구간은 시퀀스 끝에서부터 거꾸로 훑어 가장 가까운 미래의 확정 상태로 채웁니다. 파지 도중의 중간값이 진동으로 번역되는 것을 막는 처리입니다.
- 기본 설정은 30fps, 30스텝 행동 청크입니다. 한 번 예측할 때 약 1초 구간의 행동을 내놓는 셈이고, 원본 프레임률이 다르면 구간별 선형 보간으로 리샘플링하되 범위를 벗어나는 지점은 외삽하지 않고 끝값을 씁니다.
문서는 마지막에 17개 항목의 준수 체크리스트로 끝납니다. 행동 54차원과 상태 60차원, 회전 6D가 회전 행렬의 앞 두 열이라는 것, 상대 자세가 T_t^{-1}T_{t+k} 로 계산된다는 것처럼 구현이 어긋나기 쉬운 지점을 한 줄씩 규정해 둔 목록이라, 이 명세를 실제로 옮길 생각이라면 이 목록부터 보는 편이 빠릅니다.
이 문서는 UnifoLM에만 해당하는 내용이 아니라, 여러 로봇 데이터를 섞어 학습하려는 팀이라면 어떤 결정을 내려야 하는지를 보여 주는 체크리스트에 가깝습니다. LeRobot 포맷으로 데이터를 모으고 있다면 한 번 읽어 둘 만합니다.
2,500시간의 실기 데이터, 그리고 공개된 몫
프로젝트 페이지는 WLA-1.0이 약 2,500시간의 고품질 실기 데이터로 학습되었다고 밝히고 있습니다. 출처로는 Unitree 공개 데이터셋과 BitRobot-HIW-500이 명시되어 있습니다. HIW는 실환경 휴머노이드(Humanoids In-the-Wild) 의 약자로, 실제 가정에서 수집한 500시간 규모의 데이터셋이며 PyTorchKR에도 별도로 정리한 적이 있습니다.
그렇다면 이 2,500시간 중 실제로 받아볼 수 있는 몫은 얼마나 될까요. 명시된 두 출처와 이번 릴리스에 묶인 컬렉션을 각각 전수 조회했습니다. 아래 수치는 모두 저장소마다 meta/info.json에 적힌 프레임 수를 30fps로 나눈 값입니다.
| 출처 | 저장소 수 | 에피소드 | 프레임 | 환산 시간 |
|---|---|---|---|---|
| 이번 릴리스, UniBot-V1 Challenge | 32 | 33,276 | 18,282,246 | 약 169시간 |
| 이번 릴리스, UnifoLM_WBT_Dataset | 54 | 12,556 | 12,872,122 | 약 119시간 |
| Unitree 계정 공개 데이터셋 전체 | 135 | 58,846 | 42,766,153 | 약 396시간 |
| BitRobot HIW-500, LeRobot 변환본 | 1 | 23,743 | 40,839,947 | 약 378시간 |
세 번째 행은 앞의 두 행을 포함한 Unitree 계정 전체입니다. 저장소 138개 중 에피소드 메타데이터가 있는 135개를 집계했고, 나머지 3개는 시뮬레이션 자산과 모델 파일이라 제외했습니다. 네 번째 행의 HIW-500은 BitRobot이 CC BY 4.0으로 배포하는 별도 데이터셋으로, 데이터셋 카드는 500시간 이상이라고 적고 있고 LeRobot 변환본의 메타데이터를 그대로 더하면 378시간이 나옵니다.
겹치지 않는 3행과 4행을 합치면 약 774시간, HIW-500 쪽을 카드 표기대로 500시간으로 잡으면 약 896시간입니다. 학습에 쓰였다는 2,500시간의 3분의 1 안팎이 공개 경로로 확인되는 셈입니다. 발표가 데이터 출처로 이름을 올린 두 곳이 모두 실제로 내려받을 수 있는 자료라는 뜻이기도 합니다. 다만 나머지 3분의 2는 여전히 비공개이고, 공개 계획에서 Unitree-Manipulation-Dataset 항목도 아직 체크되지 않은 상태입니다. 참고로 2,500시간은 로봇을 직접 굴려 모은 실기 데이터라, 사람 영상처럼 로봇 없이 모은 데이터로 규모를 키우는 Xiaomi-Robotics-1 같은 접근의 시간 수치와 같은 자로 재면 안 됩니다.
데이터 자체의 구성은 꽤 충실합니다. 예를 들어 G1_WBT_Inspire_Hang_Up_Clothes는 LeRobot v3.0 포맷으로 200 에피소드, 132,565 프레임을 담고 있고, 머리 스테레오 좌우와 양 손목까지 카메라 네 대의 영상에 상체, 하체, 다리, 손, 말단 장치 자세를 나눠 기록합니다. 저장소 이름의 Inspire, Brainco, Dex1은 각각 다른 손과 그리퍼 하드웨어를 뜻하며, 같은 작업을 서로 다른 말단 장치로 수집한 쌍이 여럿 존재합니다. 프로젝트 페이지가 내세우는 말단 장치 간 일반화를 학습시키려는 의도가 데이터 구성에서 드러납니다.
다만 라이선스 표기는 고르지 않습니다. 86개 저장소 중 명시적으로 Apache 2.0을 달고 있는 것은 13개뿐이고, 나머지 73개는 라이선스 필드가 비어 있습니다. 내려받는 것 자체는 막히지 않지만, 상업적 활용을 검토한다면 개별 저장소 상태를 다시 확인해야 합니다.
실기 평가: 한 모델로 64개 작업
프로젝트 페이지는 Unitree G1 실기에서 수행한 64개 작업의 영상을 모두 공개합니다. 전신 이동 조작 10종은 쓰레기 버리기, 세탁기에 옷 넣기, 신발 정리, 화장실 정리, 주방 정리, 침구 정리, 채소 가져오기, 서류철을 캐비닛에 넣기, 선반에 물건 올리기, 소파 쿠션 정리입니다. 아래는 쓰레기를 버리는 작업으로, 로봇이 걸어서 이동한 뒤 상체로 조작하는 과정이 한 번에 이어집니다.
전신 조작 영상에는 카메라 화면과 함께 정책 실행 로그가 겹쳐져 있는데, 여기에 페이지 본문에는 적혀 있지 않은 정보가 들어 있습니다. 로그를 확대해 읽으면 다음과 같은 줄이 반복됩니다.
16:58:48.191 INFO  [Policy] -> send action to client
16:58:48.191 INFO  [Policy] inference latency: 107.63 ms
16:58:48.191 INFO  [Client] -> running policy inference ...
16:58:48.191 INFO  [Policy]  injected camera frames: ['left_wrist', 'right_w...
16:58:48.191 INFO  [Server] <- recv obs from client | keys=['left_wrist', 'r...
16:58:47.227 INFO  [Policy] -> send action to client
16:58:47.227 INFO  [Policy] inference latency: 99.09 ms
세 가지를 읽어 낼 수 있습니다. 첫째, 정책이 로봇 위가 아니라 클라이언트와 서버로 분리된 구조에서 돌아갑니다. 로봇이 관측을 보내면 서버가 행동을 돌려주는 방식입니다. 둘째, 추론 지연은 100ms 안팎입니다. 프로젝트 페이지의 2분 49초짜리 공식 데모 영상까지 프레임을 훑어 보면 대체로 95ms에서 135ms 사이를 오갑니다. 셋째, 행동을 보내는 시각이 16:58:46.149, 47.227, 48.191로 약 1초 간격입니다. 이는 처리 명세의 기본값인 30fps 기준 30스텝 행동 청크, 즉 약 1초 분량과 정확히 맞아떨어집니다. 영상 라벨도 Autonomous, 1x Speed로 배속이 아님을 밝히고 있습니다.
탁상 조작 54종은 수건과 옷과 바지 접기, 접시 수납, 배터리 끼우기, 종이컵 수거, 풍차 분해, 초록 블록 찾기, 꽃꽂이, 필통 정리, 탁구채 정리, 공구 벽 정리, 휴대폰 포장, 미니 골대에 공 넣기, 플러그 꽂기, 약 따르기, 책 꽂기, 컨베이어 벨트에서 과자 집기, 삼각형 그리기, 화이트보드 지우기, 망고 집기, 컵 걸기, 랜선 뽑기, 지퍼 잠그기 등으로 이어집니다. 다음은 수건 접기 작업으로, 2지 그리퍼를 단 G1이 펼쳐진 수건을 두 번 접어 마무리합니다. 이쪽 영상은 Autonomous, 2x Speed 라벨이 붙은 2배속입니다.
여기서 한 가지 분명히 해 둘 것이 있습니다. 프로젝트 페이지와 저장소, 그리고 2분 49초짜리 공식 발표 영상 어디에도 작업별 성공률이나 베이스라인 정책과의 비교 수치가 없습니다. 영상이 표로 제시하는 정량 수치는 앞서 다룬 체화 추론 벤치마크 하나뿐이고, 조작 성능은 전부 시연 장면으로만 제시됩니다. 공개된 것은 성공한 시연 영상과 작업 목록이며, "64개 작업을 한 모델이 수행한다" 는 주장의 근거는 현재로서는 영상뿐입니다. 로봇 정책 평가에서 시연 영상과 통계적 성공률 사이의 거리가 얼마나 먼지는 Anthropic의 Embody 벤치마크 분석이나 실행 중 실패 복구를 다룬 Zetta 같은 글에서 이미 여러 차례 확인된 바 있습니다. 기술 보고서가 나오기 전까지는 이 부분을 열어 둔 채로 읽는 편이 안전합니다.
지금 시도해 볼 수 있는 것
공개된 두 모델은 모두 Qwen3VLForConditionalGeneration 아키텍처를 그대로 쓰기 때문에, Transformers로 별도 코드 없이 불러올 수 있습니다. ER-1은 4B급이라 bfloat16 기준 약 9GB로, 16GB VRAM GPU에서도 여유 있게 돌아갑니다.
from transformers import AutoModelForImageTextToText, AutoProcessor

model_id = "unitreerobotics/UnifoLM-ER-1"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForImageTextToText.from_pretrained(model_id, dtype="bfloat16", device_map="auto")
ER-1은 공간 질의응답과 점 예측, 2D 궤적 예측을 위해 학습된 모델이므로, 로봇 없이도 "이 사진에서 컵을 놓을 만한 빈 자리를 가리켜라" 같은 질의로 성능을 가늠할 수 있습니다. 로봇 내비게이션 쪽 소형 모델과의 비교가 궁금하다면 LightNav-0이 비슷한 크기대의 참고점이 됩니다.
ER-Flow는 사정이 다릅니다. 행동 토큰과 <|robot_state|> 주입 경로를 쓰려면 120차원 상태 벡터를 만들고 RVQ 코드북으로 행동을 인코딩하는 전처리가 필요한데, 그 코드가 아직 공개되지 않았습니다. 명세 문서를 보고 직접 구현할 수는 있지만, 코드북 가중치 자체가 체크포인트에 포함되어 있지 않으므로 완전한 왕복은 지금 시점에서 불가능합니다. 사후 학습 코드 공개를 기다려야 하는 부분입니다.
정리
UnifoLM-WLA-1.0은 월드 모델을 영상 생성기에서 떼어내 VLM 안의 토큰 예측 과제로 옮겨 놓았고, 행동 역시 부위별 RVQ 코드북으로 이산화해 같은 시퀀스에 얹었습니다. 그 결과 인지, 미래 예측, 행동이 하나의 백본을 공유하게 되었고, 54차원 행동과 60차원 상태라는 통일 규격이 서로 다른 말단 장치의 데이터를 한 모델로 묶는 접착제 역할을 합니다. 이 설계는 공개된 토크나이저 어휘와 가중치 형상, 그리고 1,500줄짜리 처리 명세로 상당 부분 검증할 수 있습니다.
동시에 확인할 수 없는 것도 분명합니다. 데모 영상의 주인공인 6B WLA-Base는 아직 없고, 학습 코드도, 작업별 성공률도 없습니다. 공개 데이터는 학습에 쓰인 2,500시간의 3분의 1 안팎까지 확인되지만 나머지는 비공개이고, Unitree 쪽 데이터셋 저장소는 대부분 라이선스 표기가 없습니다. 지금 공개된 ER-1과 ER-Flow는 최종 모델이 아니라 그 앞 단계를 열어 둔 것에 가까우며, 이 글의 검증 범위도 거기까지입니다.
라이선스
UnifoLM-ER-1과 UnifoLM-ER-Flow 모델 가중치는 Hugging Face 모델 카드에 Apache License 2.0으로 표기되어 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다.
다만 GitHub 저장소 자체는 Creative Commons BY-NC-SA 4.0으로 배포되고 있어 조건이 다릅니다. 저장소에 담긴 README와 처리 명세 문서는 출처를 표시하고 동일 조건으로 공유하는 한 이용할 수 있지만 상업적 이용은 허용되지 않습니다. 모델을 쓰는 것과 문서를 가져다 쓰는 것의 조건이 다르므로 구분해서 확인하시기 바랍니다.
데이터셋은 앞서 정리한 대로 86개 저장소 중 13개만 Apache 2.0을 명시하고 나머지는 라이선스 표기가 없습니다.
 UnifoLM-WLA-1.0 프로젝트 홈페이지
 UnifoLM-WLA GitHub 저장소
 UnifoLM-WLA-1.0 모델 및 데이터셋 컬렉션
 Unitree General-Purpose Humanoid Foundation Model YouTube 영상
더 읽어보기
-
Robot Action, State, and Statistics Processing Specification (영문)
-
BitRobot, 실제 가정의 500시간 휴머노이드 로봇 데이터셋 HIW-500 공개 (feat. Unitree)
-
Qwen3-VL: Alibaba Qwen팀이 공개한 더 선명한 시각, 더 깊은 생각, 더 넓은 행동이 가능한 Multimodal LLM
-
World Action Model의 부상: 비디오 백본으로 로봇 정책을 학습하는 두 번째 레시피 (feat. NVIDIA)
-
Qwen-RobotWorld: 자연어를 행동 인터페이스로 삼은 임바디드 월드 모델 (feat. Qwen Team)
-
Physical AI 연구 한 번에 살펴보기 1편: LLM 월드 지식에서 VLA와 월드 모델, 체화 에이전트까지
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
