핵심 요약
- Bespoke Labs가 Bespoke Nimble 저장소에 Jev식 결정 모델의 학습 데이터, 학습 레시피, 서빙 코드를 공개했습니다. 모델은 Qwen3.5-9B에 LoRA를 붙인 Bespoke-Nimble-9B이고, 답을 생성하지 않고 허용된 답 토큰의 로짓만 읽어 확률을 냅니다.
- 학습 데이터 2,676개는 거의 같은 두 예제에서 사실 하나만 바꿔 정답을 뒤집는 대조 데이터 큐레이션으로 만들었습니다. 라벨은 모두 모델이 검사한 합성 라벨이며, 사람이 검토하지 않았습니다.
- 자체 홀드아웃 324개에서 기준 라벨 일치율은 90.12%로, 기반 모델(66.36%)보다 높고 Jev 1.13.0(93.21%)보다 낮았습니다. 사람이 라벨을 단 공개 벤치마크 13개에서는 매크로 평균 74.8%로 Jev(76.0%)에 1.2%p 뒤졌습니다.
- 가중치 라이선스는 버전마다 다릅니다. 9B와 v2는 Apache 2.0, v3는 CC BY-NC 4.0(비상업)이고, 최신 v4와 v4-max는 가중치 없이 유료 API로만 제공됩니다.
Bespoke Nimble 소개
Bespoke Nimble 은 텍스트와 질문 목록(스키마)을 받아, 질문마다 정해진 선택지 중 하나를 고르고 각 선택지의 확률을 돌려주는 결정 모델(Decision Model) 입니다. 추론 과정을 글로 쓰지 않고 한 단계로 답하므로, 라우팅, 정책 확인, 분류, 등급 매기기처럼 코드가 바로 받아 쓸 판단에 맞습니다.
이 형태는 TypeSafe가 9월 14일에 공개한 비공개 모델 Jev에서 왔습니다. Jev와 그 System One 방식은 Jev 소개 글에서 다뤘습니다. Jev가 가중치를 공개하지 않자 커뮤니티에서 재현 프로젝트가 수십 개 나왔습니다. Decision Index와 JevBench로 오픈 결정 모델을 비교한 글에서는 Nimble도 "학습한 헤드와 파인튜닝" 계열의 한 항목으로 짧게 소개했습니다. 이 글은 그 Nimble을 따로 다룹니다.
Nimble을 만든 Bespoke Labs는 MiniCheck 연구진과 함께 사실 검증 모델 Bespoke-MiniCheck를 만들었습니다. 저자들은 서빙 방식과 데이터 큐레이션이 MiniCheck에서 많은 영향을 받았다고 밝힙니다.
저장소의 목적도 성능 경쟁보다 레시피 공개에 있습니다. 저자들은 "Jev에서 증류하지 않았다"고 적었습니다. 여기서 증류(Distillation) 는 큰 모델의 출력을 작은 모델이 따라 배우게 하는 학습 방법입니다. 저자들은 데이터 제작, 학습, 서빙 방법을 보여 주는 것이 저장소의 목적이라고 설명합니다. 또 하루 만에 만든 저장소라 거친 부분이 있을 수 있다고도 적었습니다.
이 저장소에서 가장 자세히 설명하는 부분은 데이터를 만드는 방법 입니다. Nimble은 정답 확률을 줄 교사 모델이 없다는 조건에서 시작해, 정답이 뒤집히는 예제 쌍을 직접 만들어 판별력을 학습시킵니다.

생성 없이 답 토큰의 로짓만 읽는 서빙 방식
Nimble에 넘기는 입력은 판단할 텍스트(컨텍스트)와 평평한(flat) 스키마입니다. 스키마의 각 필드는 선택지 목록에서 고르는 enum 이거나 참과 거짓을 고르는 boolean 입니다. 중첩 필드는 쓸 수 없습니다. 아래는 저장소 README의 예시입니다.
schema = {
    "priority": {
        "type": "enum",
        "choices": ["HIGH", "LOW"],
        "description": "Urgency based on current business impact.",
        "choice_descriptions": {
            "HIGH": "A critical business operation is currently blocked.",
            "LOW": "An optional enhancement with no current business impact.",
        },
    },
    "requires_review": {
        "type": "boolean",
        "description": "Whether customers are unable to complete a purchase.",
    },
}
result = scorer.score("The payment service is down for all customers.", schema)
print(result["output"])
print(result["fields"]["priority"]["scores"])  # Candidate probabilities.
print(result["fields"]["priority"]["logits"])
출력은 {"priority": "HIGH", "requires_review": true} 같은 형태입니다. 동작 원리는 단순합니다. 프롬프트 안에서 각 선택지에 A, B, C 같은 토큰 하나짜리 코드 를 붙이고, 모델이 다음 토큰으로 내놓는 로짓 중 허용된 코드의 로짓만 읽습니다. 그 로짓에 소프트맥스를 씌워 확률을 만들고, 가장 높은 코드를 선택지로 되돌립니다. 모델이 JSON을 생성하지 않으므로 파싱할 텍스트도 없습니다.
맥(Apple Silicon)용 ParallelScorer 는 MLX로 동작하며, 공통 컨텍스트와 스키마를 한 번만 프리필(prefill)하고 필드별 짧은 접미부만 한 번에 배치로 평가합니다. 프리필은 모델이 프롬프트를 읽어 KV 캐시를 채우는 단계입니다. 출력층도 전체 248,320개 어휘가 아니라 허용된 코드 토큰의 행만 계산합니다. CUDA용 스코어러는 필드마다 전체 프롬프트를 다시 읽습니다. 어느 쪽이든 필드는 서로의 답을 보지 못하므로, 필드 간 일관성은 사용하는 코드에서 따로 확인해야 합니다.
저자들이 Apple M5 Pro(64GB)에서 잰 공유 프리픽스 효과는 다음과 같습니다. 이 측정은 스코어링 가이드 기준으로 Qwen3.5-4B 기반 체크포인트에서 한 합성 벤치마크입니다.
| 필드 수 | 공유 프리픽스 토큰 | 병렬 | 필드마다 독립 실행 | 속도 향상 |
|---|---|---|---|---|
| 1 | 239 | 0.139초 | 0.102초 | 0.74배 |
| 3 | 433 | 0.232초 | 0.514초 | 2.22배 |
| 8 | 950 | 0.438초 | 2.905초 | 6.63배 |
| 8 | 1,953 | 0.853초 | 6.180초 | 7.25배 |
필드가 하나뿐이면 독립 실행이 더 빠릅니다. 필드가 많고 컨텍스트가 길수록 이득이 커집니다. 저자들은 8필드 긴 컨텍스트에서 얻은 7.25배 중 대부분이 프리필을 반복하지 않은 데서 나왔다고 설명합니다.
대조 데이터 큐레이션: 사실 하나를 바꿔 정답을 뒤집는다
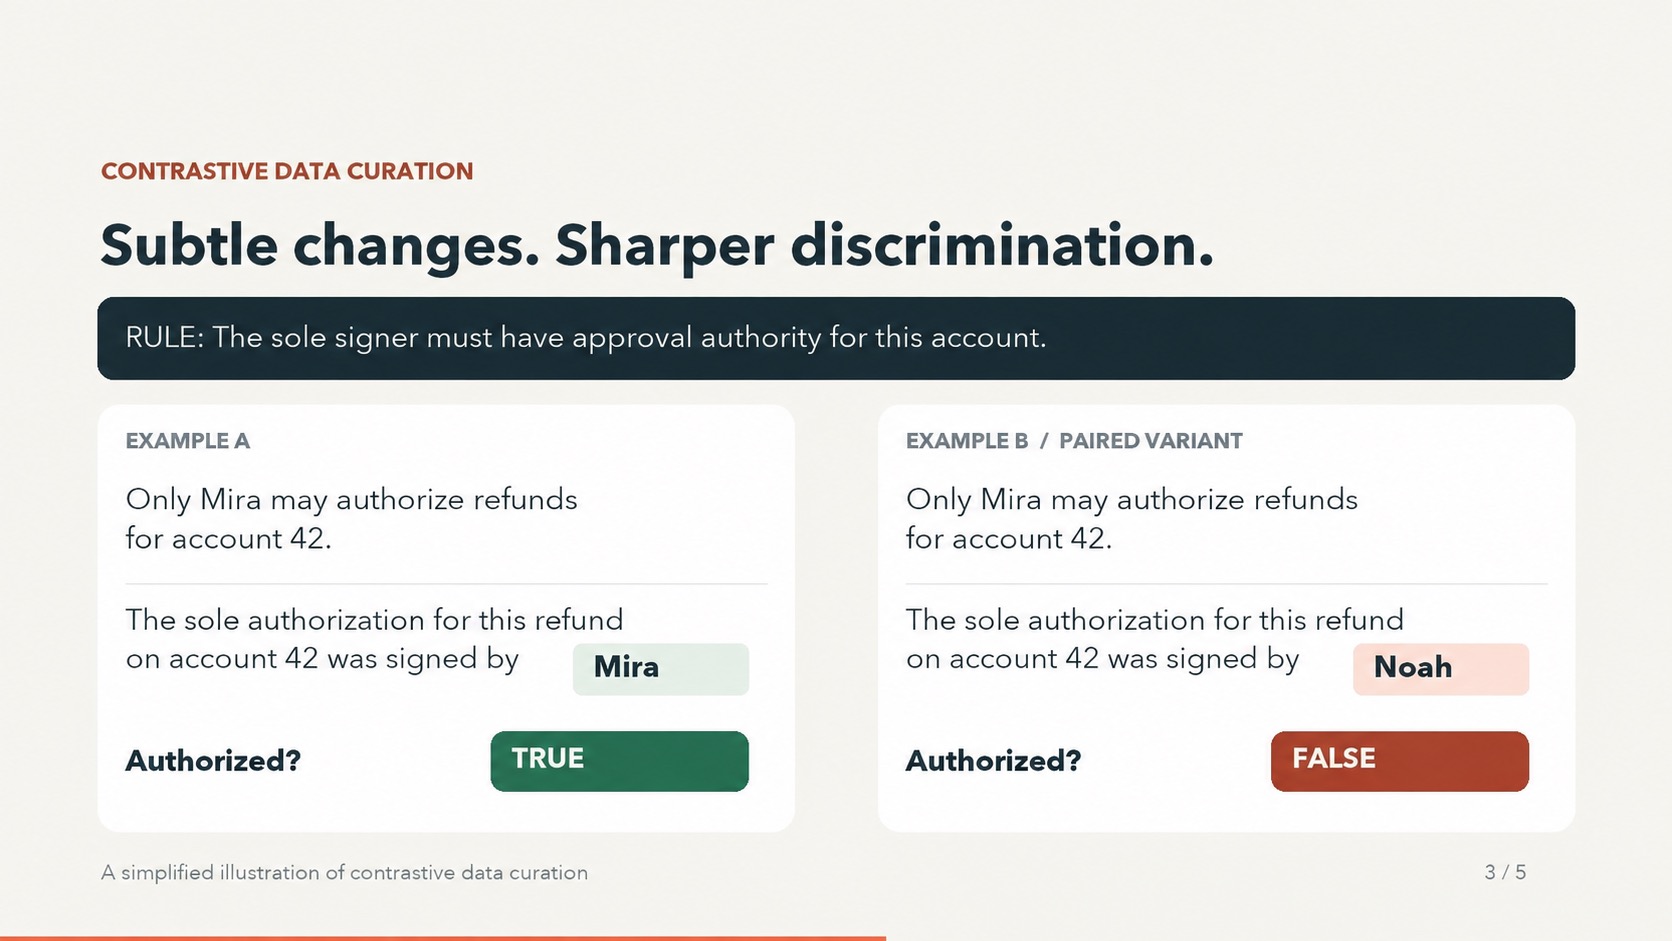
결정 모델을 학습할 때 가장 쉬운 방법은 Jev 같은 교사 모델의 확률을 따라 배우게 하는 것입니다. Nimble은 이 방법을 쓰지 않았기 때문에, 교사 확률 없이도 모델의 로짓이 판단 근거에 민감하게 반응하도록 만들어야 했습니다. 저자들의 답은 대조 데이터 큐레이션(Contrastive Data Curation) 입니다. 질문과 정책은 그대로 두고, 근거 문장 하나에서 사실 하나만 바꿔 정답이 달라지는 예제 두 개를 한 쌍으로 만드는 방법입니다. 이 쌍에서 모델은 어떤 근거가 결정을 바꿔야 하는지 배웁니다.
저장소의 예시는 환불 승인 규칙입니다. 규칙은 계정 42의 환불을 Mira만 승인할 수 있다는 것이고, 두 예제는 서명자 이름 하나만 다릅니다.
| 근거 | 첫 번째 예제 | 바꾼 예제 |
|---|---|---|
| 환불 승인 권한 | Only Mira may authorize refunds for account 42. | 같음 |
| 승인 기록 | The sole authorization for this refund on account 42 was signed by Mira . | The sole authorization for this refund on account 42 was signed by Noah . |
| 환불이 승인되었는가? | true |
false |
저자들은 이 과정을 34초짜리 무음 영상으로도 설명합니다: 대조 데이터 큐레이션 설명 영상 (GitHub)
큐레이션 파이프라인은 Choice, Noul(참/거짓), Score(순서 있는 등급) 세 질문 유형에 모두 쓰이며 네 단계로 이뤄집니다:
- 결정 규칙 확인: 학습 소스의 스키마와 정책에서 출발해, 규칙이 기대는 기본 사실을 적고 규칙이 서로 다른 답으로 이어질 수 있는지 확인합니다.
- 쌍 만들기: 둘 다 있어야 답이 나오는 근거 문장 두 개를 쓰고, 그중 한 문장에서 최대 여덟 단어를 바꿔 초점 사실(Focus Fact) 하나를 바꿉니다. 그래서 라벨도 바뀝니다.
- 두 예제 검사: 별도의 모델 호출로 각 예제의 사실, 정책과의 일관성, 답을 암시하는 문구가 없는지 확인합니다. 이어서 근거 문장을 하나씩 지웠을 때 초점 사실이 "알 수 없음"이 되는지 봅니다. 다른 문장이 답을 흘리지 않는다는 확인입니다.
- 라벨 만들기: 검사를 통과한 사실에 검사를 통과한 규칙을 코드로 적용해 라벨을 만듭니다. 모든 검사를 통과하고 두 라벨이 다른 쌍만 남깁니다.
근거를 지운 예제는 검사용으로만 쓰고 학습 데이터에는 넣지 않습니다. 저자들은 근거가 없다는 것이 답이 거짓이라거나 점수가 낮다는 뜻은 아니라고 설명합니다. 모든 모델 요청과 응답, 검사 결과를 저장하므로 전체 과정을 오프라인에서 재현할 수 있습니다.
공개된 데이터는 학습 세트 2,676개(1,338쌍)와 홀드아웃 324개입니다. 학습 세트는 상거래, 교육, 공공 서비스 등 10개 분야에 걸쳐 있고, 홀드아웃은 그중 6개 분야만 다룹니다. 질문 유형별 개수는 다음과 같습니다.
| 질문 유형 | 판단 | 학습 | 홀드아웃 |
|---|---|---|---|
| Choice | 후보 중 하나 선택 | 856 | 146 |
| Noul (참/거짓) | 조건이 성립하는지 판단 | 888 | 114 |
| Score | 순서 있는 루브릭 등급 판단 | 932 | 64 |
| 합계 | 2,676 | 324 |
한계도 원문에 분명히 적혀 있습니다. 라벨은 모두 합성 라벨이며, 모델이 검사했고 사람은 검토하지 않았습니다. 저자들은 "같은 모델을 따로 호출해도 같은 실수를 할 수 있으므로 검사가 일부 오류를 놓칠 수 있다"고 적었습니다. 학습 소스 계열(source family) 34개는 홀드아웃의 계열과 겹치지 않도록 나눴고, 이를 확인하는 오프라인 검증 명령도 함께 제공합니다.
학습 레시피: 답 토큰에만 거는 LoRA 미세조정
학습은 Qwen3.5-9B에 LoRA를 붙이고, 허용된 후보 코드의 로짓에 대해서만 교차 엔트로피를 최적화합니다. 정답은 위에서 만든 하드 라벨이며 Jev에서 나온 값이 아닙니다. 저장소에는 Jev 확률도 저장되어 있지만, 저자들은 이를 향후 소프트 타깃 증류에 쓸 수 있는 자료로만 남겨 두었습니다.
최종 레시피는 LoRA 랭크 16, 학습률 5e-5, 유효 배치 크기 8, 시드 17, 1에폭입니다. 하이퍼파라미터 선택 때 쓴 3에폭 선형 학습률 스케줄을 유지한 채 1에폭(335회 업데이트)에서 멈춥니다. BF16과 2,048토큰 프롬프트 한도로 학습했고, 튜닝은 L40S, 최종 학습과 평가는 H100에서 했습니다. 학습 가이드에 그대로 실행할 수 있는 명령이 있습니다.
python -m nimble.training.schema_train train \
  --model Qwen/Qwen3.5-9B \
  --revision c202236235762e1c871ad0ccb60c8ee5ba337b9a \
  --data-dir data \
  --validation data/eval.jsonl \
  --output-dir .cache/runs/nimble-9b-new \
  --learning-rate 5e-5 --lora-rank 16 --seed 17 \
  --batch-size 2 --gradient-accumulation 4 --max-length 2048 \
  --max-steps 1005 --warmup-steps 101 --save-steps 335 --stop-after-epochs 1
다른 미세조정 방법은 Unsloth의 결정 모델 미세조정 가이드에 있습니다. 학습 없이 범용 LLM을 결정 모델로 쓰는 방법은 LLM-as-Jev에서 비교해 볼 수 있습니다.
성능 평가: 자체 홀드아웃과 사람 라벨 공개 벤치마크
자체 홀드아웃 324개: 기반 모델보다 23.8%p 높다
저자들은 같은 324개 예제와 같은 기준 라벨로 7개 모델을 비교했습니다.
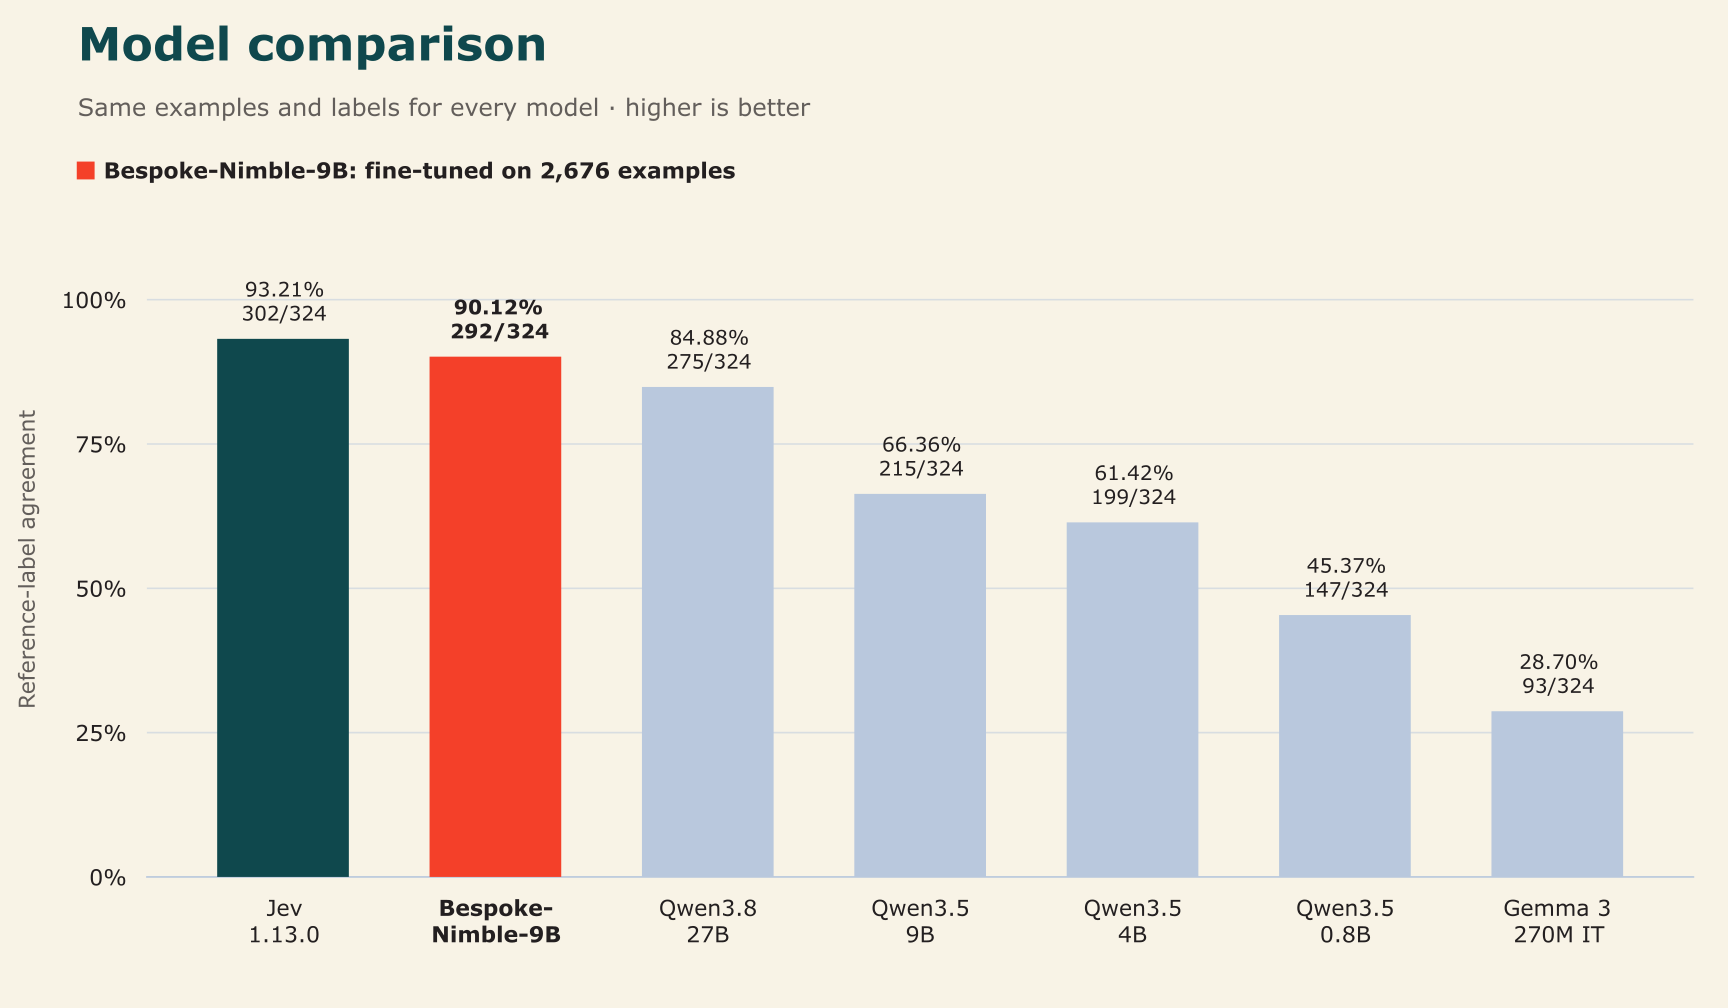
| 모델 | 일치 개수 | 일치율 |
|---|---|---|
| Gemma 3 270M IT | 93/324 | 28.70% |
| Qwen3.5-0.8B | 147/324 | 45.37% |
| Qwen3.5-4B | 199/324 | 61.42% |
| Qwen3.5-9B (기반 모델) | 215/324 | 66.36% |
| Qwen3.8-27B | 275/324 | 84.88% |
| Bespoke-Nimble-9B | 292/324 | 90.12% |
| Jev 1.13.0 | 302/324 | 93.21% |
Nimble은 미세조정하지 않은 27B 모델보다 17개를 더 맞혔고, Jev보다는 10개를 덜 맞혔습니다. 그러나 이 숫자는 좁은 시험입니다. 저자들도 기준 라벨이 합성 라벨이고, 324개가 162쌍이며, 모두 6개 소스 계열에서만 나왔다고 밝힙니다. 측정 조건도 완전히 같지는 않습니다. 미세조정하지 않은 모델은 H100에서 FP32로 후보 점수를 계산했고, Nimble은 이전 H100 실행의 BF16 결과를 재사용했으며, Jev는 이전 API 실행 결과를 재사용했습니다. 또 v2 모델 카드는 이 홀드아웃이 개발 과정에서 여러 번 검토되었기 때문에 이후 비교의 독립성이 제한된다고 적고 있습니다.
사람 라벨 공개 벤치마크 13개: 평균은 Jev에 1.2%p 뒤진다
합성 라벨의 한계를 보완하려고, 외부 기여자 Edgar Dyck이 공개 벤치마크 모음을 추가했습니다. 기여자는 PR #2에서 이 벤치마크 전체를 Claude Code 에이전트로 만들고 실행했으며, 코드는 한 줄씩이 아니라 결과와 구조만 검토했다고 밝혔습니다. 사람이 라벨을 단 공개 데이터셋 13개 부분집합, 총 3,880개 레코드에서 Bespoke-Nimble-9B와 Jev 1.13.0을 같은 레코드, 같은 문구로 실행한 결과입니다. 13개 모두 Nimble의 학습 분야 밖의 과제입니다. 과제에는 의도 분류(MASSIVE 영어와 독일어), 지문 기반 예/아니오(BoolQ), 답변 가능 여부(SQuAD 2.0), 유해성 판단(Civil Comments), 안전성(Nemotron Content Safety V2), 루브릭 등급(HelpSteer2, SummEval)이 들어 있습니다.
| 그룹 | 부분집합 수 | Nimble 매크로 평균 | Jev 매크로 평균 |
|---|---|---|---|
| 전체 | 13 | 74.8% | 76.0% |
| Choice | 5 | 81.6% | 82.9% |
| Noul | 5 | 80.2% | 84.6% |
| Score | 3 | 54.6% | 50.1% |
전체 평균에서는 Jev가 1.2%p 앞섭니다. 질문 유형별로 보면 Jev는 참/거짓 판단에서 4.4%p 앞서고, Nimble은 루브릭 등급 판단 세 부분집합에서 앞섭니다. 정확 McNemar 검정에서 p가 0.05 미만인 부분집합은 다섯 개였습니다. 그중 네 개(civil_comments, paws, massive-de-DE, vitaminc-dev)에서는 Jev가, 하나(summeval-relevance)에서는 Nimble이 앞섰습니다. 차이가 가장 큰 것은 Civil Comments로, Nimble 70.3%, Jev 81.0%였습니다. 이 데이터는 89%가 비유해 댓글이어서, 적은 수의 유해 댓글을 어떻게 판단하느냐가 정확도를 좌우합니다.
Nimble이 앞선 루브릭 등급 결과에는 저자들이 직접 단 단서가 있습니다. 저자들은 SummEval 부분집합이 기사 15개(summeval-relevance)와 9개(summeval-consistency)에서만 나와, p값이 작아도 그 차이를 믿기 어렵다고 밝힙니다. 또 5단계 루브릭에서 등급을 정확히 맞힌 비율은 두 모델 모두 낮아서, 확률로 가중한 등급의 절대 오차(MAE)를 보라고 권합니다. 이 기준으로는 HelpSteer2에서 비슷하고, summeval-relevance 는 Nimble이, summeval-consistency 는 Jev가 낫습니다.
확률의 품질에서는 차이가 더 분명합니다. 기대 보정 오차(Expected Calibration Error, ECE)는 모델이 말한 확률과 실제 정답률의 차이를 구간별로 평균한 값으로, 낮을수록 확률을 믿을 수 있습니다. Jev는 13개 중 11개 부분집합에서 ECE가 낮았고, 10개에서 Brier 점수가 낮았습니다. 단, 이 비교에서 Nimble은 온도 1.0의 원래 확률로 실행했고, 뒤에서 설명할 온도 보정은 아직 이 벤치마크에 적용하지 않았습니다. 지연 시간도 비교하지 않았습니다. Nimble은 16GB 소비자 GPU에서 층 일부를 시스템 메모리로 내려 실행했기 때문입니다.
한국어 사용자가 볼 부분: 언어만 바꿔도 정확도가 떨어진다
이 벤치마크에는 같은 MASSIVE 발화 350개를 영어와 독일어로 각각 판단한 쌍 비교가 있습니다. 발화 내용은 같고 언어만 다릅니다. Nimble은 독일어로 바꾸면 3.5%p 떨어졌습니다(86.9%에서 83.4%, p = 0.023). 영어로만 맞힌 발화가 18개, 독일어로만 맞힌 발화가 6개였습니다. Jev는 0.5%p만 떨어졌고 통계적으로 유의하지 않았습니다(p = 0.82).
모델 카드의 language 필드는 영어(en)만 적혀 있고, 공개된 학습 데이터 2,676개에는 한글이 들어간 예제가 하나도 없습니다. 한국어로 측정한 결과는 공개되지 않았습니다. 독일어 결과로 미루어 보면, 한국어 분류나 라우팅에 쓰려면 자체 데이터로 먼저 정확도를 확인해야 합니다. 이 판단은 공개된 독일어 결과에 근거한 해석이며, 한국어 결과를 측정한 것은 아닙니다.
확률 온도 보정과 그 범위
Nimble이 돌려주는 확률은 정답일 확률이 아닙니다. 사용자가 준 선택지끼리 합이 1이 되도록 정규화한 값입니다. 저자들은 원래 릴리스(리비전 93ec5d6)에 온도 스케일링(Temperature Scaling) 을 적용했습니다. 소프트맥스 전에 로짓을 온도 T 로 나누는 방법으로, T 가 1보다 크면 확률이 덜 극단적이 됩니다. 순위는 바뀌지 않으므로 고르는 답은 그대로이고 확률만 바뀝니다.
학습 데이터와 홀드아웃 어디에도 없는 300개씩 두 세트를 썼습니다. 첫 세트에서 로그 손실이 가장 낮은 온도를 고르고, 두 번째 세트에서 로그 손실이 내려가고 Brier 점수가 오르지 않을 때만 채택한다는 규칙을 미리 정했습니다. 결과는 T = 2.179 입니다. 보정 전에는 고른 답의 평균 확률이 0.89였지만 실제로 맞힌 비율은 73%였습니다.
| 세트 | 지표 | T = 1 | T = 2.179 |
|---|---|---|---|
| 두 번째 세트 (300) | ECE | 0.128 | 0.066 |
| 두 번째 세트 (300) | 로그 손실 | 0.692 | 0.555 |
| 두 번째 세트 (300) | Brier 점수 | 0.348 | 0.295 |
| 홀드아웃 (324) | ECE | 0.052 | 0.054 |
| 홀드아웃 (324) | 로그 손실 | 0.318 | 0.259 |
| 홀드아웃 (324) | Brier 점수 | 0.154 | 0.144 |
모든 질문 유형이 좋아지지는 않았습니다. 홀드아웃의 루브릭 등급 질문 64개에서는 확률이 지나치게 낮아져 ECE가 0.105에서 0.177로 올랐습니다. 또 온도는 어댑터를 병합하지 않은 CUDA 경로에서 맞췄고, 호스팅 API와 로컬 퀵스타트가 쓰는 병합 가중치에서는 다시 확인하지 않았습니다.
버전마다 온도 정책도 다릅니다. 9월 24일 Hugging Face 저장소의 main 브랜치에 올라온 최신 9B 체크포인트는 별도 보정 없이 T = 1.0 을 쓰고, 모델 카드는 2.179를 재사용하지 말라고 적었습니다. v2는 같은 2.179를 그대로 옮겨 쓰는데, v2 모델 카드는 이것이 v2에 맞춰 따로 맞춘 값이 아니라고 밝힙니다. 어느 버전이든 확률을 임계값과 비교하는 코드라면, 그 임계값을 자기 데이터로 다시 확인해야 합니다.
추론 지연 시간
저자들이 요청별로 저장한 시간으로 계산한 예제당 지연 시간입니다. 각 예제에는 질문이 하나씩만 있습니다.
| 모델 | 환경 | 예제 수 | 중앙값 | p95 |
|---|---|---|---|---|
| Qwen3.5-9B | H100 | 324 | 58.1ms | 75.8ms |
| Bespoke-Nimble-9B | H100 | 120 | 106.0ms | 119.8ms |
| Bespoke-Nimble-9B | M5 Pro 64GB | 324 | 444.0ms | 981.0ms |
| Jev 1.13.0 | TypeSafe API | 324 | 246.7ms | 347.4ms |
| DeepSeek-V4.1-Flash | OpenRouter, 추론 medium, 다른 평가 세트 | 100 | 2,896.4ms | 15,065.4ms |
텍스트를 생성하는 범용 LLM은 수 초가 걸리지만, 결정 모델은 수백 밀리초 안에 답합니다. 다만 저자들은 이 값들이 통제된 서빙 벤치마크가 아니라고 밝힙니다. Nimble H100 행은 120개만 측정했고, Jev는 네트워크 전송 시간이 포함된 API 측정입니다. 같은 9B 크기인 Qwen3.5-9B와 Nimble의 차이(58.1ms 대 106.0ms)도 측정 실행이 달라 원인을 원문에서 확인할 수 없습니다.
버전과 라이선스: 어떤 Nimble을 쓸 수 있나
Nimble은 9월 18일 첫 공개 이후 한 달 사이에 네 번 바뀌었고, 버전마다 공개 범위와 라이선스가 다릅니다. 이 글의 학습 레시피와 평가 수치는 대부분 원래 릴리스(2,676개로 학습한 9B) 의 것이라는 점에 주의해야 합니다.
| 버전 | 공개 형태 | 라이선스 | 확인할 점 |
|---|---|---|---|
| Bespoke-Nimble-9B, 원래 릴리스 | LoRA 어댑터, revision="original-2676" |
Apache 2.0 | 이 글의 레시피와 324개 평가 대상. 공개 벤치마크도 9월 24일 교체 전에 측정. 학습 프롬프트 2,048토큰 |
| Bespoke-Nimble-9B, 현재 기본 브랜치 | LoRA 어댑터(약 165MiB), 9월 24일 교체 | Apache 2.0 | 8,192토큰, 필드당 선택지 255개, T = 1.0. 이 체크포인트의 평가 결과는 README에 따로 없음 |
| Bespoke-Nimble-9B-v2 | LoRA 어댑터, Ollama에서 ollama pull nimble |
Apache 2.0 | 8,192토큰, 선택지 255개(서빙 기준), 원래 릴리스의 온도 2.179를 옮겨 씀. 모델 카드는 이전 체크포인트보다 낫다고 주장하지 않음 |
| Bespoke-Nimble-9B-v3 | LoRA 어댑터 | CC BY-NC 4.0 | 상업적 이용 불가. Decision Index 0.2.1 자체 실행 56.88점 |
| Nimble-v4 (9B), v4-max (27B) | 유료 API만, 가중치 미공개 | 상용 서비스 | 입력 100만 토큰당 0.04달러, 0.09달러. 출력 토큰은 무료 |
Ollama로 받는 v2는 학습 데이터부터 원래 릴리스와 다릅니다. v2 저장소의 training_summary.json 에 따르면 v2는 4,926개 예제로 학습했습니다. 구성은 original 2,826개, contrastive-addition 1,000개, longform-pilot 100개, decision-skills-local 1,000개입니다. 공개된 학습 데이터는 2,676개뿐이므로, v2 학습 데이터 중 적어도 2,250개는 공개되지 않았습니다. 또 같은 저장소의 evaluation_summary.json 에는 324개 평가 세트의 정확도가 82.7%로 적혀 있어, 원래 릴리스의 90.12%보다 낮습니다. 모델 카드 본문은 이 수치를 다루지 않으므로, Ollama로 받은 모델에서 이 글의 324개 결과를 그대로 기대하면 안 됩니다.
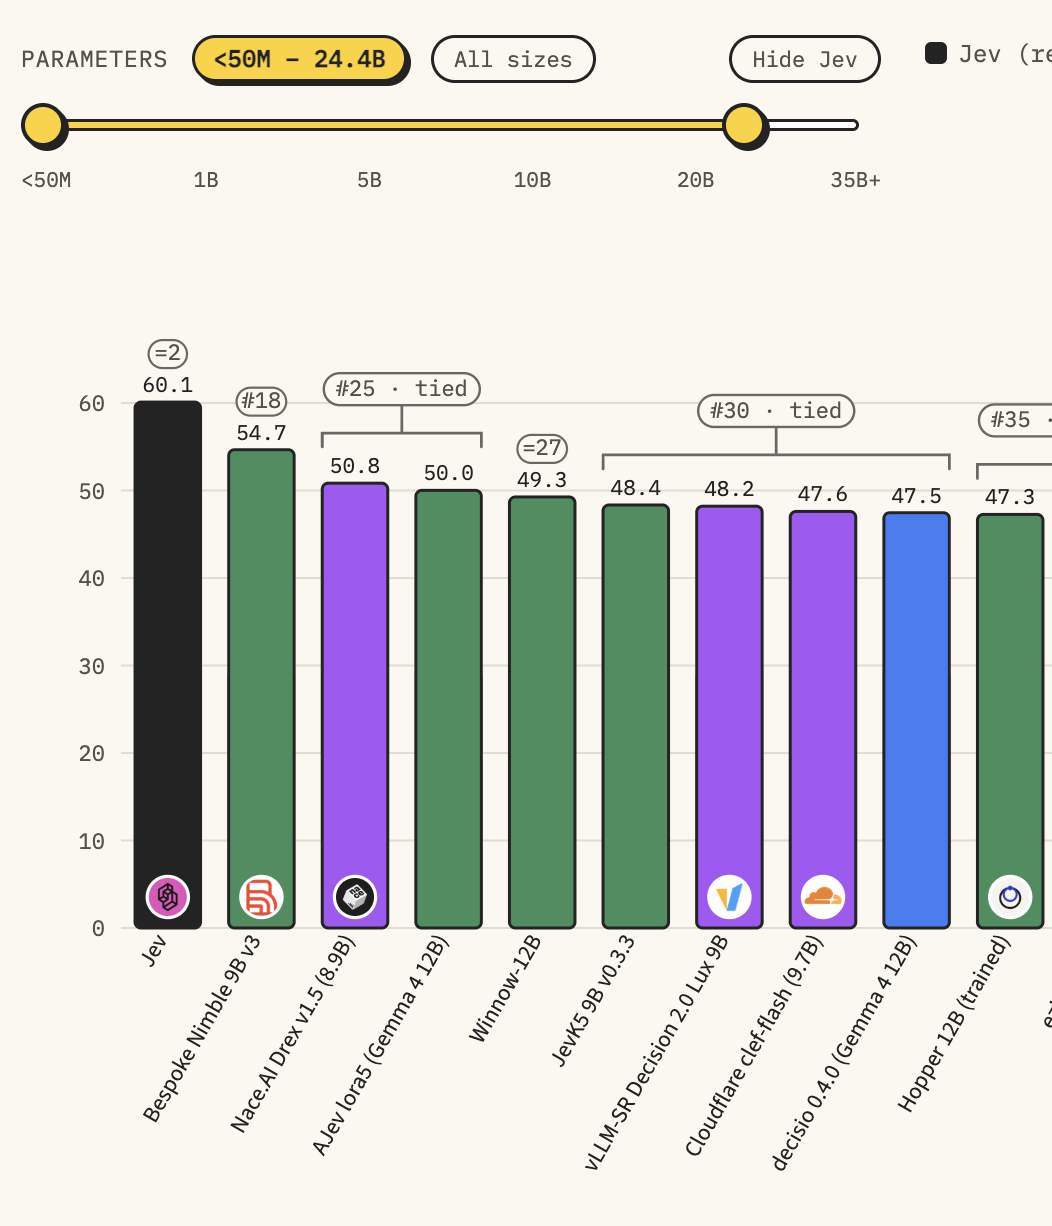
v3의 Decision Index 점수는 두 가지입니다. 대시보드에서 25B 이하로 거른 화면에서는 54.7점으로 오픈 모델 중 가장 높았고(Jev 60.1), Bespoke Labs가 H100에서 직접 실행해 공개한 결과는 56.88점입니다. v4에 대해서는 README가 Decision Index 공개 스위트에서 v4-max 68.46점, v4 63.70점(Jev 1.13은 57.96점)이라고 적었지만, 저자들이 10월 12일에 직접 잰 값이고 아직 대시보드에 오르지 않았다고 밝힙니다.
라이선스와 관련해 한 가지 더 확인할 점이 있습니다. 모델 가중치에는 라이선스가 명시되어 있습니다. 하지만 GitHub 저장소 자체에는 이 글을 쓰는 시점에 LICENSE 파일이 없습니다(GitHub API의 license 값도 null). 저장소의 학습, 서빙 코드를 제품에 가져다 쓰려면 저작자에게 조건을 먼저 확인해야 합니다. 저장소에 들어 있는 에이전트 스킬 파일만 MIT로 표기되어 있습니다.
직접 써 보는 세 가지 방법
로컬에서 Ollama로 실행하기: 9월 29일 Ollama가 Nimble을 추가해 ollama pull nimble 로 받을 수 있습니다. Ollama의 결정 모델은 CLI가 아니라 TypeSafe Jev API와 같은 형식의 /v1/systemone 엔드포인트로 호출합니다. Ollama 라이브러리 페이지 기준으로 한 요청에 질문 64개까지, Choice와 Score는 선택지 2~26개를 받습니다.
curl http://localhost:11434/v1/systemone -d '{
  "model": "nimble",
  "state": "Our checkout has returned 500 errors since 9am.",
  "questions": {
    "label": {
      "type": "choice",
      "instructions": "Which label fits this ticket?",
      "criteria": {"billing": null, "bug": null, "account": null}
    }
  }
}'
저장소 코드로 실행하기: Python 3.12가 필요하고, 맥에서는 Apple Silicon, 리눅스에서는 BF16을 지원하는 NVIDIA GPU가 필요합니다. 양자화하지 않은 9B 가중치만 약 18GB입니다. 먼저 README의 퀵스타트 스크립트로 기반 모델을 받아 어댑터를 CPU에서 병합해야 합니다. 이때 기반 가중치와 병합 가중치를 둘 다 담을 디스크 공간과 추가 RAM이 필요합니다. 병합한 뒤에는 맥은 ParallelScorer, 리눅스는 CudaCandidateScorer 에 저장된 설정을 넘깁니다. ParallelScorer() 를 인자 없이 부르면 Nimble이 아니라 기준선으로 쓴 Qwen3.5-4B가 로드된다는 점에 주의합니다.
공개 데모와 API로 확인하기: 브라우저 데모는 API 키 없이 H100 한 장에서 동작하며, 2분 동안 요청이 없으면 잠들어 처음에는 503이 나올 수 있습니다. 이 데모가 서빙하는 것은 최신 체크포인트가 아니라 원래 릴리스(리비전 93ec5d6)입니다. v4 계열은 Bespoke Labs 콘솔에서 키를 받아 https://api.bespokelabs.ai/v1/systemone 로 호출하며, 이메일을 인증한 새 계정에는 1달러 크레딧이 주어집니다.
정리: 레시피 공개로서의 가치와 남은 확인 사항
Nimble에서 가장 쓸모 있는 부분은 모델 점수보다 교사 확률 없이 결정 모델을 학습시키는 데이터 제작 절차 가 재현 가능한 형태로 공개되었다는 점입니다. 쌍을 만드는 규칙, 근거를 지워 정보 유출을 확인하는 검사, 모든 모델 호출 기록이 함께 공개되어 다른 분야나 다른 언어로 같은 방법을 옮겨 볼 수 있습니다.
반면 숫자를 읽을 때는 조건을 함께 봐야 합니다. 324개 홀드아웃 결과는 합성 라벨과 6개 계열에 한정되고, 사람 라벨 공개 벤치마크에서는 평균 정확도와 확률 보정 모두 Jev에 뒤집니다. 또 공개 가중치 중 가장 점수가 높은 v3는 비상업 라이선스이고, 가장 높은 점수를 주장하는 v4는 가중치가 없는 API입니다. 상업 서비스에 가중치를 직접 배포하려면 Apache 2.0인 9B와 v2를 기준으로 판단해야 합니다.
 Bespoke Nimble GitHub 저장소
 Bespoke-Nimble-9B 모델 카드
 Ollama nimble 모델 페이지
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
Jev와 유사한 오픈소스 결정 모델에 대한 정리: Decision Index와 JevBench로 비교한 결정 모델 성능 비교
-
Unsloth, LLM을 Laya, Clef와 같인 Jev식 결정 모델을 미세조정하고 로컬에서 서빙하는 학습 가이드 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
