핵심 요약
- Unsloth의 결정 모델 학습 가이드가 공개되었습니다. Qwen, Gemma, Llama 같은 LLM에 작은 결정 헤드를 붙여 LoRA로 학습하면, 문장 대신 선택지별 확률을 돌려주는 Jev식 결정 모델이 됩니다.
- 학습은 Unsloth 앱의 Train 탭에서
Train as를Decision model로 바꾸거나, 파이썬에서FastDecisionModel과DecisionTrainer를 써서 진행합니다. 무료 Colab 및 Kaggle 노트북도 함께 제공됩니다. - Unsloth가 공개한 결과에서 Qwen3.5-0.8B는 typed-decisions 정확도가 36%에서 73%로, BANKING77은 7%에서 74%로 올랐습니다. 다만 typed-decisions의 정답은 4B급 교사 모델이 매긴 것이고, 데이터셋 저자가 밝힌 상한은 0.735입니다.
- 로컬 서빙 문서에 따르면, 학습한 모델과 오픈 가중치 모델 Laya, Clef를 로컬 Jev 호환 API(
/v1/systemone)로 서빙할 수 있습니다. 기존typesafe-sdk코드는 주소만 바꾸면 됩니다. - 결정 모델 관련 코드는 unsloth 저장소에 있습니다. 저장소 핵심 패키지는 Apache 2.0이지만, 결정 모델 소스 파일 머리말에는
AGPL-3.0-only가 적혀 있습니다.
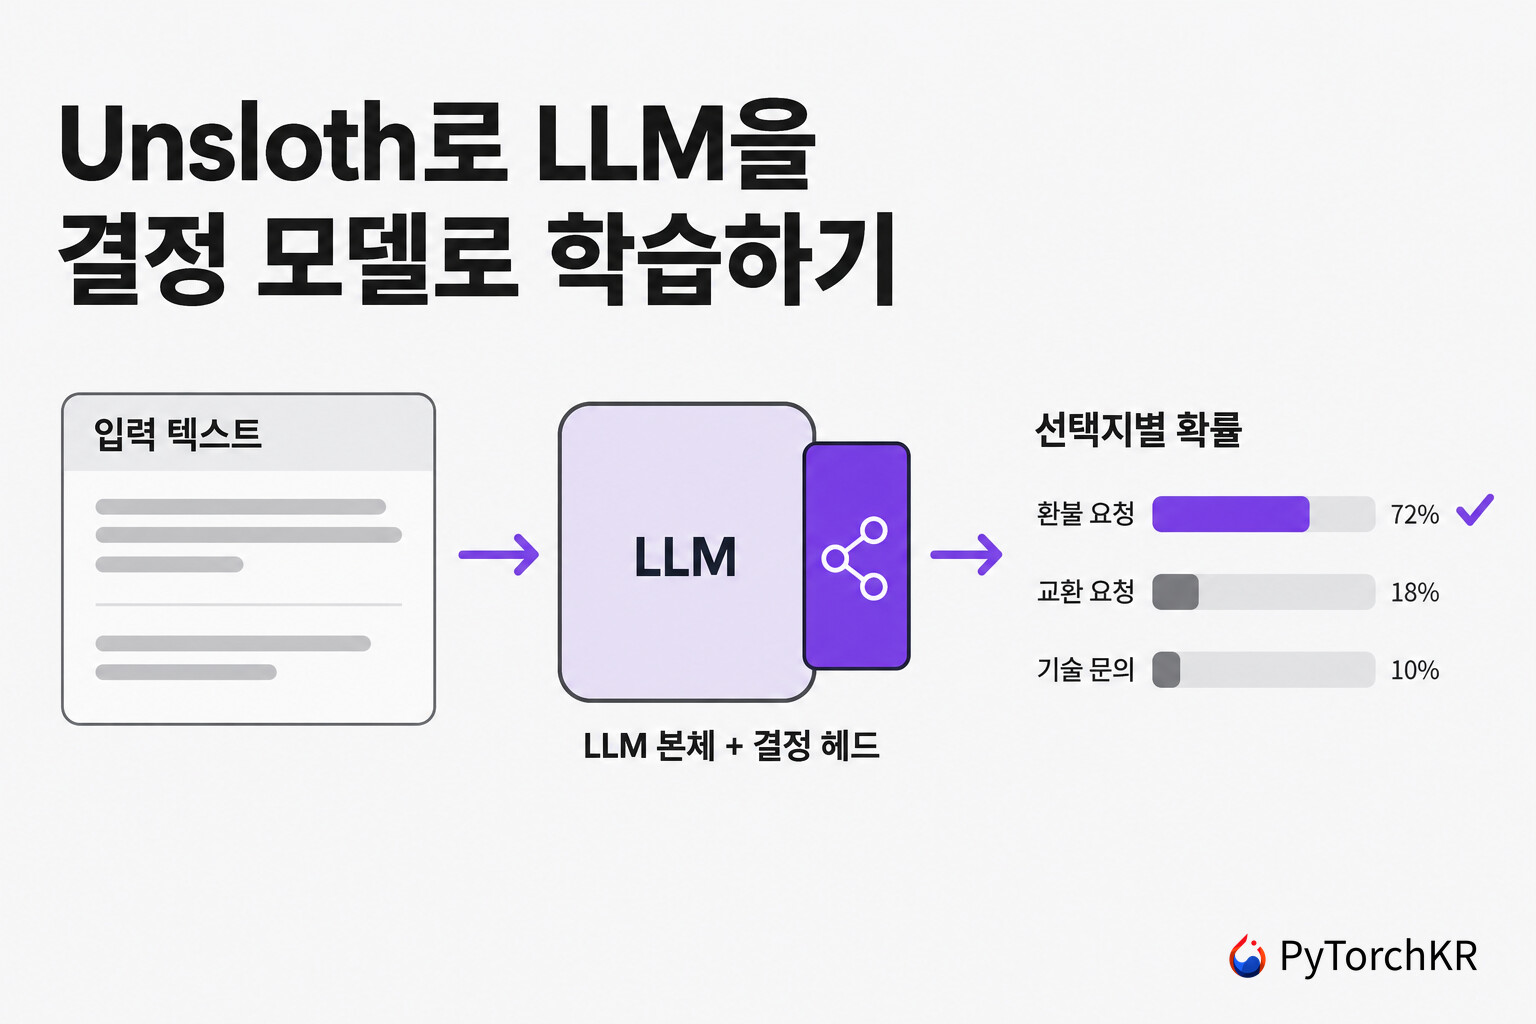
Unsloth의 결정 모델 학습 기능 소개
Unsloth가 LLM을 결정 모델(Decision Model) 로 미세조정(Fine-tuning)하는 기능과, 그 모델을 로컬에서 Jev 호환 API로 서빙하는 기능을 추가했습니다. 결정 모델은 문장을 쓰는 대신, 입력을 읽고 미리 정한 선택지마다 확률을 돌려주는 모델입니다. 고객 문의 분류나 에이전트의 도구 호출 승인처럼 정해진 보기 중 하나를 고르는 판단에 쓰입니다.
이런 판단은 지금까지 주로 두 가지 방법으로 처리했습니다. 하나는 채팅 LLM에게 답을 문장이나 JSON으로 쓰게 한 뒤 파싱하는 방법입니다. 이 방법은 토큰을 생성하는 시간이 들고, 출력 형식이 어긋날 위험이 남으며, 모델이 얼마나 확신하는지를 숫자로 얻기 어렵습니다. 다른 하나는 작업마다 BERT 계열 분류기를 따로 학습하는 방법인데, 질문이나 선택지가 바뀔 때마다 다시 학습해야 합니다.
2026년 9월 TypeSafe AI가 공개한 Jev (
 Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI))는 그 중간을 택했습니다. 요청할 때마다 질문과 선택지를 자유롭게 정의하고, 응답으로는 선택지별 확률만 받습니다. Jev는 가중치가 공개되지 않은 API 모델이라, 이후 Jev와 같은 형식으로 동작하는 오픈 모델이 잇따라 나왔습니다. 오픈 인코더 기반의 Laya ( Laya: 텍스트 생성 없이 한 번의 순전파로 결정을 내리는 Jev 호환 오픈 가중치 모델과 로컬 실행 도구들)와 Cloudflare가 Apache 2.0으로 공개한 Clef가 대표적입니다.
이번 Unsloth 업데이트는 이 흐름에서 두 가지를 더합니다. 첫째, 이미 공개된 결정 모델을 쓰는 데서 끝나지 않고 자신의 데이터로 결정 모델을 직접 학습할 수 있게 했습니다. 둘째, Unsloth Studio 안에 Jev와 같은 요청 형식을 받는 Decision API를 넣어, 학습한 모델이나 Laya를 기존 Jev 연동 코드에 그대로 연결할 수 있게 했습니다. 아래에서는 결정 모델의 질문 형식과 동작 원리를 먼저 정리하고, 학습 방법, 공개된 결과를 읽을 때 확인할 조건, 로컬 서빙 순서로 살펴봅니다.
결정 모델의 질문 형식: noul, choice, score
결정 모델에 보내는 요청은 상태(State) 와 질문(Questions) 두 부분으로 구성됩니다. 상태는 판단 대상이 되는 텍스트나 JSON이고, 질문은 그 상태에 대해 답할 항목들입니다. 질문은 Jev가 정한 System One 형식을 따르며 아래 세 가지 유형이 있습니다:
| 유형 | 용도 | 돌려받는 값 |
|---|---|---|
noul |
예 또는 아니오 | "예"일 확률(0~1) |
choice |
여러 선택지 중 하나 고르기 | 가장 확률이 높은 선택지와 선택지별 확률 |
score |
순서가 있는 등급 매기기 | 등급별 확률과, 확률로 가중 평균한 등급 값(0부터 셈) |
choice와 score는 confidence 값도 함께 돌려줍니다. 1에 가까우면 한 답이 두드러진다는 뜻이고, 0에 가까우면 확률이 고르게 퍼져 있다는 뜻입니다. Unsloth 문서는 실제 동작을 결정할 때 confidence가 아니라 선택지별 probabilities 값을 기준으로 삼으라고 권합니다. 예를 들어 technical 확률이 0.8을 넘을 때만 버그 리포트를 만드는 식입니다. 한 요청에는 질문을 최대 64개, choice 하나에 선택지를 최대 255개, score 하나에 등급을 최대 10개까지 넣을 수 있습니다.
이 글에 등장하는 결정 모델 3종의 차이는 다음과 같습니다:
| 모델 | 개발 | 구조 | 크기 | 공개 형태 |
|---|---|---|---|---|
| Jev () |
TypeSafe AI | 비공개 | 비공개 | 유료 API |
| Laya () |
Convai Innovations | ModernBERT-large 또는 mmBERT-base 인코더 + 결정 헤드 | 322M~421M | Apache 2.0 오픈 가중치 |
| Clef, Clef-flash | Cloudflare | Qwen3.8-27B 또는 Qwen3.5-9B 본체 + 결정 헤드 | 27B, 9B | Apache 2.0 오픈 가중치, Workers AI |
Unsloth가 이번에 추가한 학습 기능은 이 중 Clef와 같은 구조를 따릅니다. 즉, 인코더가 아니라 디코더 LLM을 본체로 쓰고 그 위에 결정 헤드를 붙입니다.
동작 방식: LLM 본체에 Clef식 결정 헤드를 붙인다
Unsloth 문서의 설명을 정리하면 다음과 같습니다. 입력 상태를 하나의 프롬프트에 넣고, 그 뒤에 모든 질문과 선택지를 이어 붙입니다. LLM은 이 프롬프트를 한 번만 읽습니다. 그 다음, Cloudflare의 Clef와 같은 설계인 작은 결정 헤드(Decision Head) 가 각 질문과 선택지 위치에서 LLM의 출력(마지막 은닉 상태)을 보고 모든 선택지에 점수를 매깁니다. 여러 질문을 따로따로 풀지 않고 한꺼번에 판단한다는 점이 특징입니다.
이 구조에서는 LLM이 다음 토큰을 예측하는 단계가 필요하지 않습니다. 문서는 이 모델이 텍스트를 생성하지 않으므로 LLM의 단어 예측 단계에 메모리를 쓰지 않는다고 설명합니다. 아래 서빙 절의 Decision API 응답에서도 "output_tokens": 0 으로 표시됩니다.
저장소의 unsloth/models/decision_from_lm.py 를 보면, 일반 언어 모델에 새로 초기화한 결정 헤드를 붙여, Clef 체크포인트와 같은 방식으로 학습, 평가, 저장할 수 있는 모델을 만든다고 적혀 있습니다. 헤드의 기본 크기도 코드 주석에 나와 있습니다. 폭 1024, 라우팅 층 2개와 디코더 층 4개, 어텐션 헤드 16개로 구성되며, 본체의 은닉 차원이 3072보다 작은 소형 모델에는 폭 512를 씁니다. 학습할 때는 본체에 LoRA 어댑터를 달고, 새 헤드는 별도의 학습률(기본 1e-4)로 함께 학습합니다.
학습 없이 범용 LLM의 토큰 확률만 읽어 결정 모델처럼 쓰는 방법과, 미세조정이 실제로 필요한 조건에 관해서는 다음 글을 참고해주세요:
Unsloth Studio에서 결정 모델 학습하고 Decision API로 연결하기
코드 없이 학습하려면 Unsloth의 화면(UI)을 씁니다. 원문은 macOS, Windows, Linux를 지원하는 무료 오픈소스 앱인 Unsloth Desktop(베타)을 내려받는 것을 가장 쉬운 방법으로 안내합니다. 직접 설치하려면 macOS, Linux, WSL에서는 다음 명령을 실행합니다:
curl -fsSL https://unsloth.ai/install.sh | sh
Windows PowerShell에서는 다음 명령을 실행합니다:
irm https://unsloth.ai/install.ps1 | iex
설치한 뒤에는 아래 순서로 학습합니다.
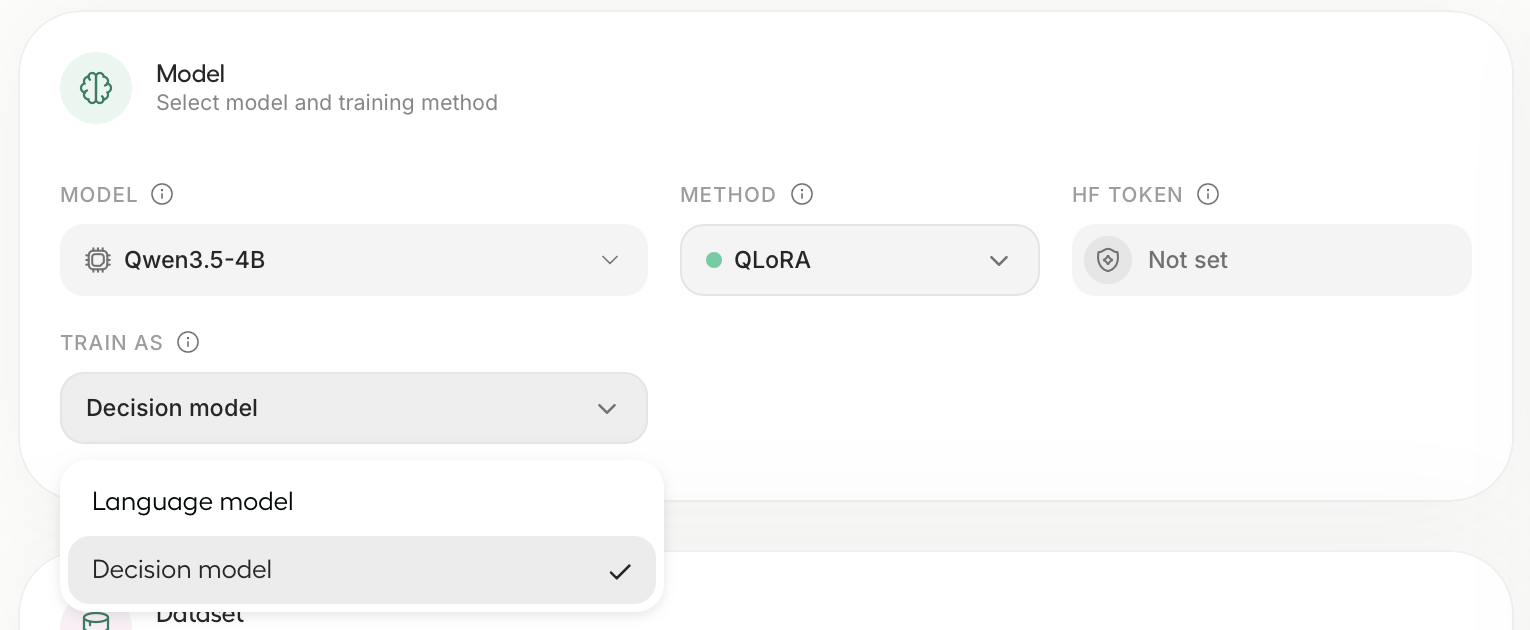
- Train 탭에서
unsloth/Qwen3.5-4B와 같은 LLM을 고릅니다. - Train as 를 Decision model 로 바꿉니다. Unsloth가 권장 설정을 자동으로 채웁니다.
- 데이터셋 파일을 올리거나 Hugging Face에서 데이터셋을 고릅니다. typed-decisions를 쓴다면 Subset 을
all로 지정합니다. - Start Training 을 누릅니다.
학습이 끝나면 Studio가 학습에서 떼어 둔 검증 데이터(Held-out) 에서 학습 전후 정확도를 보여주고, 모델의 확신도를 실제 정답률에 맞추는 보정(Calibration) 까지 수행합니다. 아래 원문 스크린숏은 17 스텝짜리 짧은 실행으로, 검증 정확도가 0.37에서 0.54로 오르고 보정 오차가 0.09로 표시되었습니다.
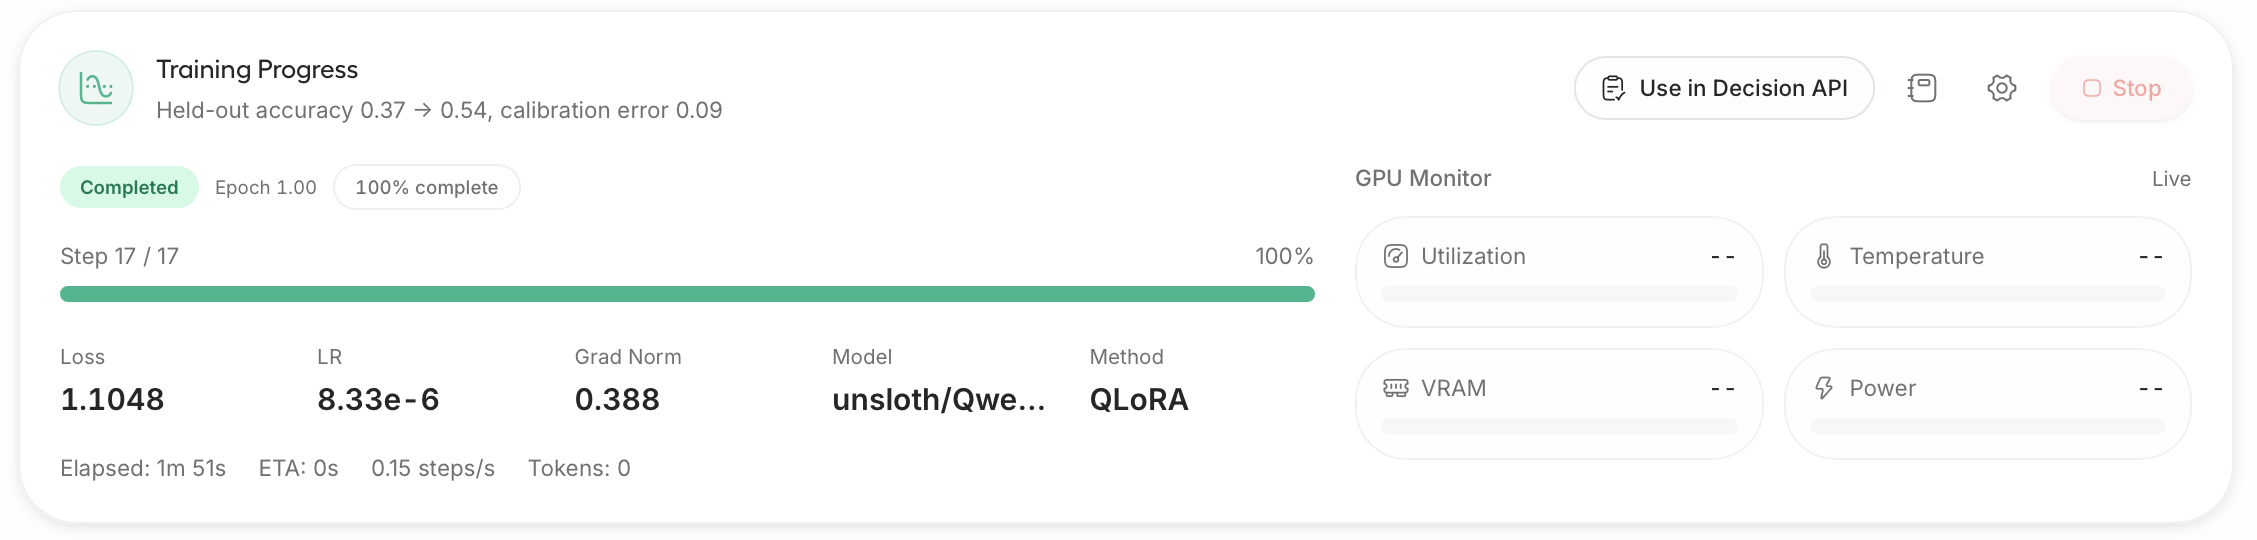
학습이 끝난 화면에서 Use in Decision API 를 누르면, 모델 이름을 laya, default, jev-latest 로 보낸 요청이 방금 학습한 모델로 전달됩니다. 학습한 모델은 Settings → API 의 Decision API → Model 목록에도 실행 이름으로 나타납니다. Decision API의 Try It 창에서는 상태와 질문을 입력해 결과를 바로 확인할 수 있습니다.
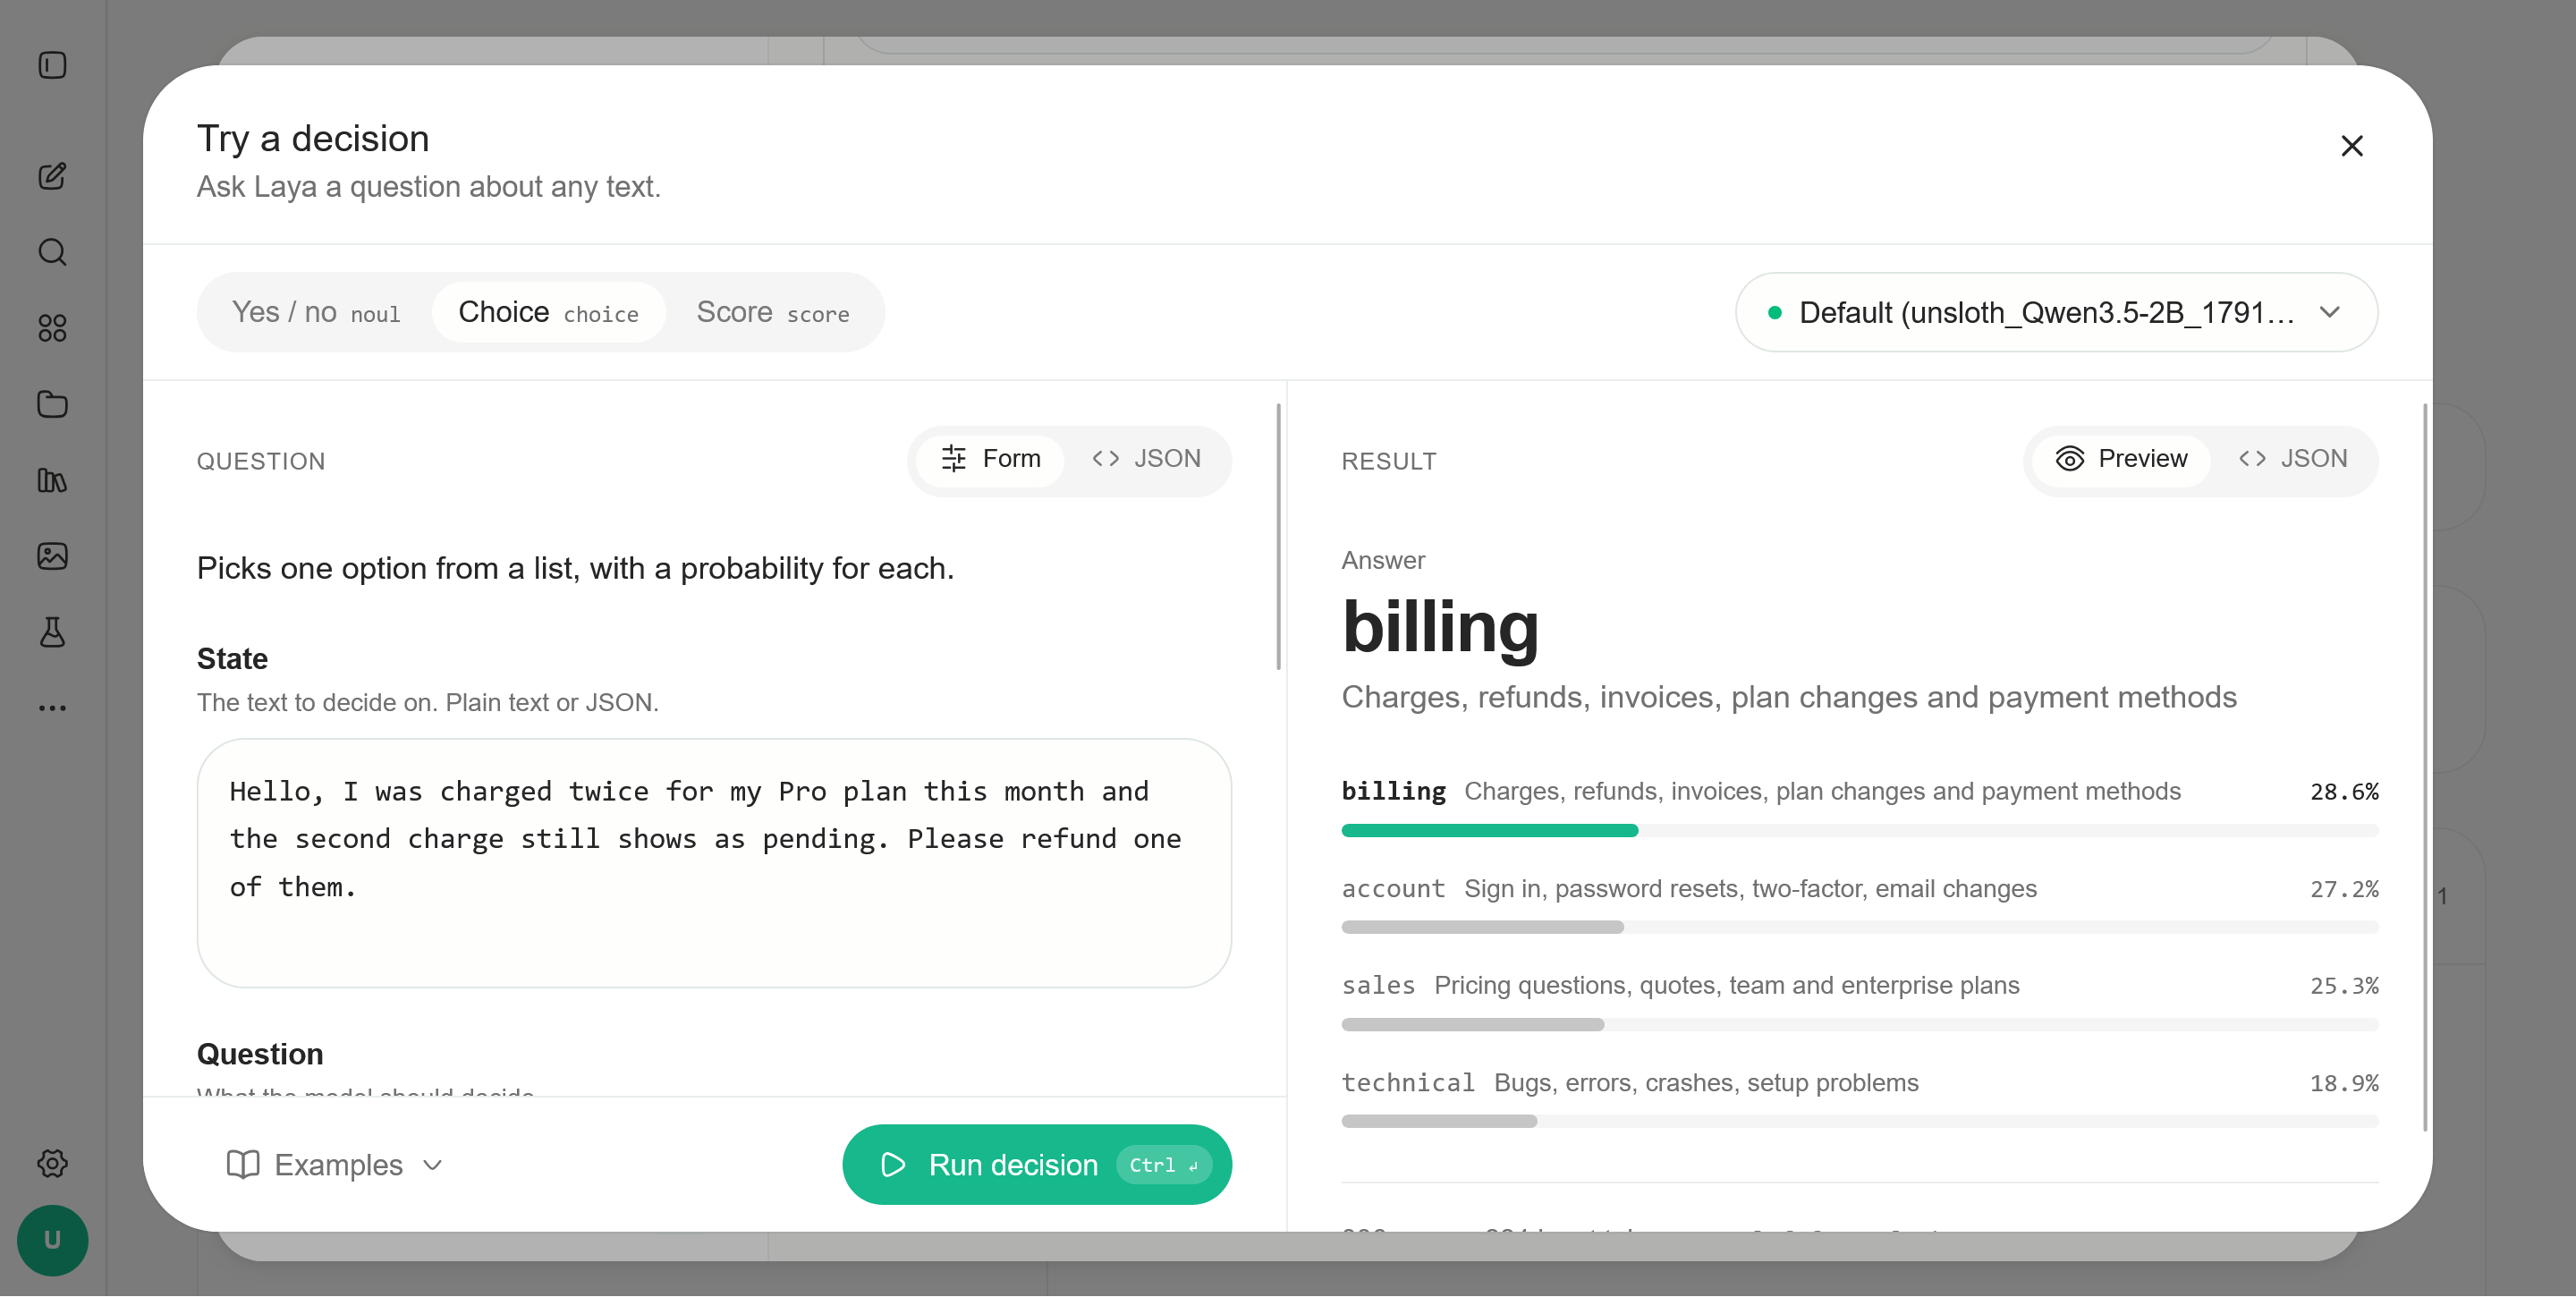
위 스크린숏은 원문 문서에 실린 그대로인데, 답은 billing 이지만 확률이 28.6%, 27.2%, 25.3%, 18.9%로 거의 고르게 나뉘어 있습니다. 선택지가 4개일 때 무작위로 고르면 25%이므로, 이 결과만으로는 모델이 billing 을 뚜렷하게 구분했다고 보기 어렵습니다. 앞서 권한 대로 확률 기준값을 두고 쓴다면, 이런 응답은 사람에게 넘기거나 다른 경로로 처리하게 됩니다.
GPU가 없는 환경이라면, Unsloth가 제공하는 무료 노트북으로 같은 과정을 진행할 수 있습니다. Google Colab 노트북과 Kaggle 노트북은 Qwen3.5-4B로 데이터 준비, 학습, 내보내기를 단계별로 다루고, Unsloth Studio Colab 노트북에서는 Studio 화면을 그대로 쓸 수 있습니다.
코드로 학습하기: FastDecisionModel과 DecisionTrainer
파이썬에서 학습하려면 먼저 pip install --upgrade unsloth 로 Unsloth를 설치하거나 업데이트합니다. 아래는 원문 가이드의 학습 코드입니다. 기존 Unsloth의 FastLanguageModel 사용법과 거의 같고, 데이터셋을 build_dataset 으로 변환한 뒤 DecisionTrainer 로 학습한다는 점이 다릅니다:
from unsloth import FastDecisionModel, DecisionTrainer, is_bfloat16_supported
from datasets import load_dataset
from transformers import TrainingArguments

model, tokenizer = FastDecisionModel.from_pretrained(
    model_name = "unsloth/Qwen3.5-4B",
    max_seq_length = 2048,
    load_in_4bit = True,
)

model = FastDecisionModel.get_peft_model(
    model,
    r = 16,
    lora_alpha = 16,
    lora_dropout = 0,
    use_gradient_checkpointing = "unsloth",
    random_state = 3407,
)

dataset = load_dataset("LocalLLaMA/typed-decisions", "all", split = "train")
items, report = FastDecisionModel.build_dataset(dataset, tokenizer, model)
print(f"Skipped {report['skipped']} of {report['total']} decisions")

train_items, eval_items = FastDecisionModel.split_holdout(items, seed = 3407)
print(f"{len(train_items)} training rows, {len(eval_items)} held out")

from transformers import TrainingArguments

trainer = DecisionTrainer(
    model = model,
    processing_class = tokenizer,
    train_dataset = train_items,
    eval_dataset = eval_items,
    args = TrainingArguments(
        per_device_train_batch_size = 2,
        gradient_accumulation_steps = 4, # Use GA to mimic batch size!
        warmup_steps = 10,
        # num_train_epochs = 2, # Set this for 1 full training run.
        max_steps = 240,
        learning_rate = 2e-5,
        lr_scheduler_type = "cosine",
        weight_decay = 0.01,
        bf16 = is_bfloat16_supported(),
        fp16 = not is_bfloat16_supported(),
        eval_strategy = "epoch",
        logging_steps = 1,
        output_dir = "outputs",
        report_to = "none", # Use TrackIO/WandB etc
        seed = 3407,
    ),
)
trainer_stats = trainer.train()
Llama나 Gemma 4를 쓰려면 model_name 을 unsloth/Llama-3.2-3B-Instruct 또는 unsloth/gemma-4-E4B-it 로 바꿉니다. 원문은 Unsloth가 미세조정할 수 있는 다른 LLM도 같은 방식으로 동작할 것이라고 설명합니다. 자신의 데이터를 쓸 때는 각 행에 상태(state), 판단할 질문(questions), 정답 분포(gold)를 담습니다. 이 형식은 Laya, Clef의 학습 데이터 형식과 같습니다.
학습이 끝나면 split_holdout 이 떼어 둔 데이터로 보정을 수행합니다. 출력에는 검증 정확도, 보정 오차(ECE), 손실이 담깁니다:
metrics = FastDecisionModel.calibrate(model, tokenizer, eval_items)
print(metrics) # held-out accuracy, calibration error (ece) and loss
저장은 두 가지입니다. save_pretrained 는 LoRA 어댑터와 헤드만 저장하고, save_pretrained_merged 는 16비트 전체 모델을 저장합니다. 다시 불러올 때는 기본 모델과 같은 방법을 씁니다:
model.save_pretrained("qwen-decisions")
model.save_pretrained_merged("qwen-decisions-merged")
# model.push_to_hub("hf_username/qwen-decisions", token = "hf_...")
model, tokenizer = FastDecisionModel.from_pretrained("qwen-decisions", load_in_4bit = True)
저장소에는 이 밖에 Apple Silicon의 MLX에서 쓰는 decision_mlx.py 와, llama.cpp의 /v1/systemone 용 GGUF 내보내기 모듈 decision_gguf.py 도 있습니다. 다만 원문 가이드에는 이 둘의 사용법이 나오지 않습니다.
추론(Inference)할 때는 predict 에 상태와 질문을 데이터셋과 같은 형식으로 넘깁니다. 아래 예시는 고객 문의 하나에 대해 담당 팀(choice), 환불 요청 여부(noul), 긴급도(score) 세 질문을 한 번에 묻습니다:
FastDecisionModel.for_inference(model)
answers = FastDecisionModel.predict(
    model,
    tokenizer,
    "Hi, I was charged twice for invoice #4411. Please refund the duplicate today.",
    {
        "team": {
            "type": "choice",
            "instructions": "Which team should handle this?",
            "criteria": {
                "billing": "invoices, payments, refunds",
                "technical": "bugs, outages, errors",
                "sales": "pricing, new plans",
            },
        },
        "refund": {"type": "noul", "instructions": "Does the customer ask for a refund?"},
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this?",
            "criteria": ["not urgent", "soon", "today"],
        },
    },
)
for name, result in answers.items():
    print(name, result["answer"], {k: round(v, 3) for k, v in result["probabilities"].items()})
answer 에는 choice 라면 선택지 키가, noul 이라면 True 또는 False 가, score 라면 등급 번호가 들어갑니다. 정답이 있는 테스트 세트로 정확도를 재려면 evaluate 를 씁니다:
test = load_dataset("LocalLLaMA/typed-decisions", "all", split = "test")
test_items, _ = FastDecisionModel.build_dataset(test, tokenizer, model)
print(FastDecisionModel.evaluate(model, tokenizer, test_items))
코드로 학습한 모델을 Decision API로 서빙하려면, 앞에서 저장한 병합 모델 폴더를 환경 변수로 지정하고 Studio를 실행합니다. 그 다음 Settings → API 에서 Decision API를 켜면 됩니다:
UNSLOTH_SYSTEMONE_MODEL=/path/to/qwen-decisions-merged unsloth studio -H 0.0.0.0 -p 8888
LLM 기반 결정 모델은 GPU가 있어야 하고, 첫 요청에서 모델을 불러오느라 몇 분이 걸릴 수 있습니다. 또한 학습 작업이 GPU를 쓰는 동안에는 Decision API가 기다렸다가, 학습이 끝나면 다시 응답합니다.
원문이 권하는 설정은 다음과 같습니다:
- 4비트 LoRA, 랭크 16, 학습률 2e-4로 시작합니다. 새 헤드의 학습률은 기본 1e-4이며
DecisionTrainer의head_learning_rate로 바꿀 수 있습니다. - typed-decisions에서는 2 에포크(Epoch)를 썼습니다. 데이터가 더 적다면 3~4 에포크를 시도합니다.
- 빠르게 시험하려면
max_steps = 60으로 지정합니다. 원문에 따르면 Qwen3.5-4B가 NVIDIA L4 GPU에서 10분 만에 76%에 도달했습니다. - 메모리가 부족하다면, 배치 크기를 절반으로 줄이고 그래디언트 누적(Gradient Accumulation)을 두 배로 늘립니다.
max_seq_length는 학습 중 가장 긴 입력 길이입니다. 이보다 긴 입력은 질문과 선택지를 남기고 입력의 뒷부분을 잘라냅니다. 추론 시에는 최대 16,384 토큰까지 읽습니다.
원문이 공개한 결과와 읽을 때 확인할 조건
Unsloth는 LLM에 Clef 헤드를 붙여 LoRA(r=64)로 1 에포크만 학습한 결과를 공개했습니다. 테스트 세트는 typed-decisions 2,000개, BANKING77 500개, CLINC150 500개로 모두 3,000행이며, 학습 데이터와 겹치지 않도록 정리(Decontamination)했다고 밝혔습니다. 학습 데이터로는 typed-decisions에 더해 ag_news, arc, banking77, boolq, clinc150, commonsense_qa, mmlu, mnli, prompt_injections, snli, sst5, wanli 의 12개 공개 데이터셋을 섞었습니다.
| 모델 | typed-decisions | BANKING77 | CLINC150 | 검증 정확도 |
|---|---|---|---|---|
| Qwen3.5-0.8B | 36% → 73% | 7% → 74% | 19% → 76% | 78% |
| Qwen3.5-2B | 33% → 78% | 1% → 58% | 1% → 62% | 81% |
다른 모델까지 넣은 테스트 정확도, GPU 메모리(VRAM) 사용량, 학습 시간은 다음과 같습니다. 원문은 다른 LLM도 같은 방식으로 학습할 수 있고, Laya나 Clef 같은 기존 결정 모델을 추가로 미세조정할 수도 있다고 밝힙니다. 표의 마지막 행이 Laya를 추가로 미세조정한 결과입니다:
| 모델 | 테스트 정확도 | GPU 메모리(VRAM) | 학습 시간 |
|---|---|---|---|
| Qwen3.5-0.8B | 78% | 4GB | 42분 |
| Qwen3.5-2B | 81% | 8GB | 40분 |
| Llama 3.2 3B | 79% | 4.1GB | 30분 |
| Gemma 4 E4B | 77% | 14.4GB | 49분 |
| Laya (미세조정) | 77% | 2.5GB | 10분 |
Qwen3.5-0.8B는 1 에포크 학습만으로 BANKING77과 CLINC150에서 70%대에 올랐습니다. 반면 더 큰 Qwen3.5-2B는 typed-decisions에서는 더 높았지만 BANKING77 58%, CLINC150 62%에 그쳐, 모델이 크다고 모든 데이터셋에서 앞서지는 않았습니다. 이 수치를 자신의 작업에 옮기기 전에 아래 네 가지를 확인할 필요가 있습니다.
첫째, typed-decisions의 정답은 사람이 아니라 교사 모델이 매긴 것입니다. typed-decisions 데이터셋 카드에 따르면, 정답 분포는 "대략 4B급 성능의 교사 모델" 이 같은 사례를 세 번 판정한 결과의 평균입니다. 그래서 이 점수는 정답률이 아니라 교사와의 일치도를 잽니다. 데이터셋 저자는 교사 모델의 자기 일치도인 0.735를 사실상의 상한으로 둡니다. 그리고 "0.735를 크게 넘는 점수는 모델이 교사의 버릇을 학습하고 있다는 뜻" 이라고 적었습니다. Qwen3.5-2B의 78%는 이 상한을 넘는 값입니다.
같은 데이터셋 카드의 미세조정 표에는 Qwen3.5-4B 기반 od1-typed-decisions 가 0.797, laya-typed-decisions 가 0.766으로 올라 있습니다. Unsloth의 73~78%도 이들과 비슷한 수준입니다.
둘째, 원문이 말하는 무작위 수준의 기준선은 선택지를 고르게 찍는 경우입니다. 원문은 학습 전 정확도 30~37%를 무작위 수준이라고 설명합니다. 데이터셋 카드의 균등 분포 기준선은 0.308로 이 설명과 맞습니다. 그러나 입력을 보지 않고 학습 데이터의 레이블 빈도만 답하는 기준선은 0.470입니다. 학습 후 수치는 이 0.470과 함께 비교하는 편이 정확합니다.
셋째, 원문 안에서 학습 설정이 세 가지로 다르게 적혀 있습니다. 결과 표는 LoRA r=64, 1 에포크로 학습했다고 밝힙니다. 반면 Studio 안내는 "결과를 재현하려면" 에포크 2, LoRA 랭크 16, 학습률 2e-4로 지정하라고 합니다. 코드 예시는 또 max_steps = 240, learning_rate = 2e-5 를 씁니다. 저장소의 Studio 기본 설정 파일(llm_decision_defaults.yaml)은 LoRA r=64, 1 에포크, 학습률 1e-4로, 결과 표의 설명과 일치합니다. 수치를 재현하려면 어느 설정을 쓸지 먼저 정해야 합니다.
넷째, 소개 문구에 나오는 Qwen3.8은 측정 대상에 없습니다. 원문 첫 문단은 Qwen3.8과 Gemma 4를 결정 모델로 바꿀 수 있다고 소개하지만, 공개된 표는 Qwen3.5(0.8B, 2B), Llama 3.2 3B, Gemma 4 E4B의 결과입니다. Gemma 4도 E4B 한 크기만 측정되었습니다.
여러 오픈 결정 모델을 같은 기준으로 비교한 리더보드는 다음 글을 참고해주세요:
로컬에서 Laya와 Clef 서빙하기: Jev 호환 Decision API
두 번째 문서는 학습보다 서빙을 다룹니다. Unsloth Studio를 쓰면 Laya와 Clef를 TypeSafe 호환 Jev API로 노출할 수 있어, 기존 Jev 연동 코드가 로컬 서버를 가리키게 바꾸기만 하면 동작합니다. 문서는 모든 데이터가 기기 안에 머물며 CPU, 통합 메모리(Unified Memory), GPU 환경을 모두 지원한다고 설명합니다.
Unsloth가 안내하는 Laya 모델은 세 가지입니다:
| 모델 | 최소 RAM | 크기 | 용도 |
|---|---|---|---|
| Multilingual (기본) | 4GB | 678 MB | 대부분의 작업. 100개 이상 언어, 1,024 토큰 컨텍스트 |
| English | 5GB | 846 MB | 영어 전용. 더 큰 인코더, 512 토큰 컨텍스트 |
| Typed decisions | 5GB | 846 MB | 영어 전용. 청구서, 보안 사고, 고객 서비스, 에이전트 실행 기록 |
기본 실행 장치는 CPU이며, Run on 을 GPU로 바꾸면 더 빨리 응답합니다. GPU 메모리가 부족해지면 Laya는 CPU로 돌아가 계속 응답합니다. 앞에서 학습한 LLM 기반 결정 모델과 달리 Laya는 인코더 모델이라 GPU 없이도 쓸 수 있다는 점이 차이입니다.
서빙은 아래 순서로 진행합니다.
- 앞 절의 설치 명령으로 Unsloth를 설치합니다.
- Settings → API → Decision API 에서 Serve requests 를 켭니다. 다운로드를 확인하면 기본 Laya 모델(678 MB)을 내려받습니다.
- 같은 화면의 Access tokens 에서 API 키를 확인합니다. localhost에서 키 없이 쓰려면 Keyless API access → Chat and inference 를 켭니다.
http://localhost:8888/v1/systemone으로 결정 요청을 보냅니다.
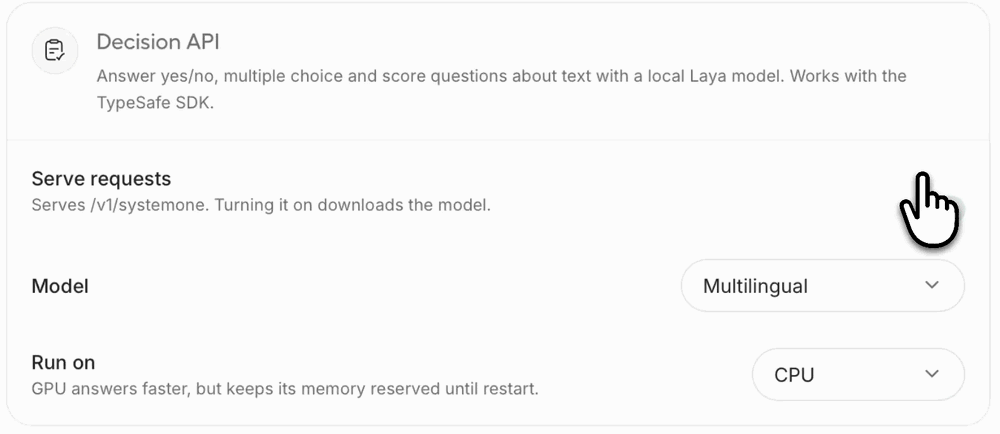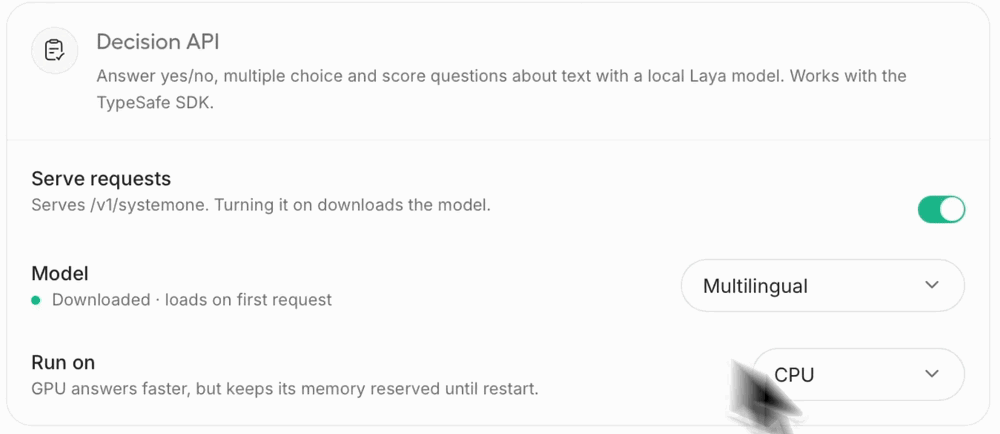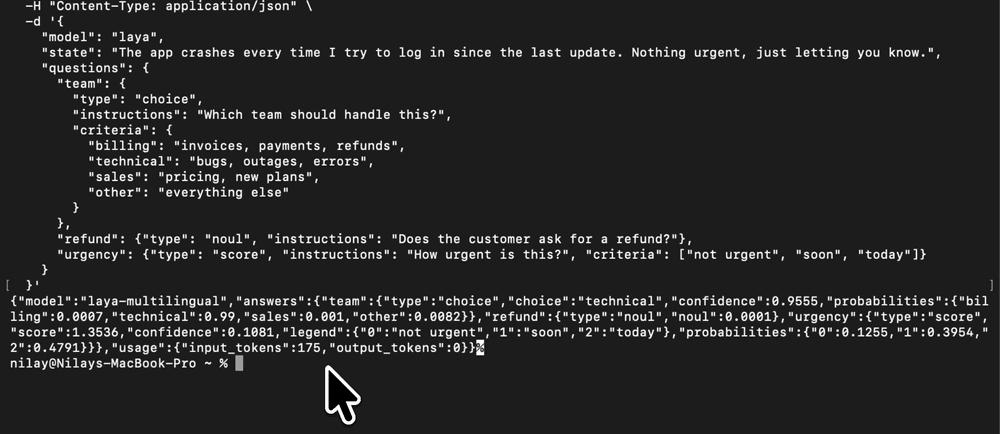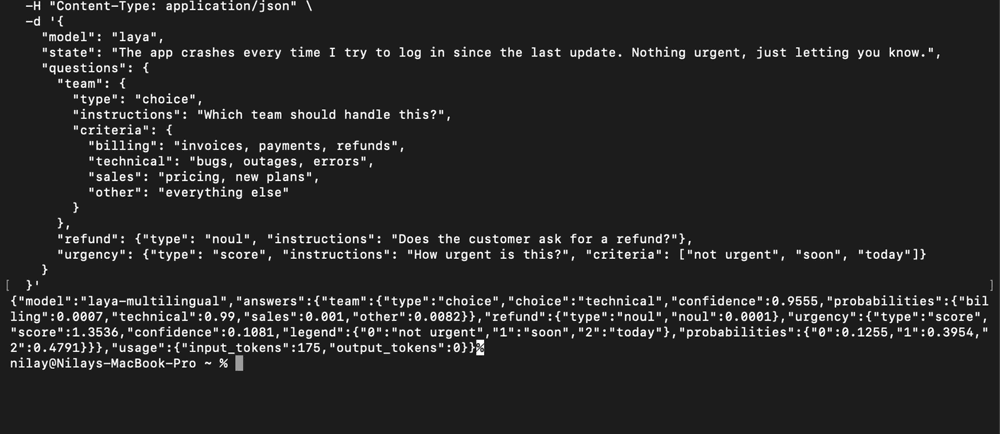
아래 요청은 고객 문의 하나에 대해 담당 팀 분류, 환불 요청 여부, 긴급도를 한 번에 묻습니다:
curl http://localhost:8888/v1/systemone \
  -H "Authorization: Bearer sk-unsloth-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "laya",
    "state": "Hi, I was charged twice for my March invoice (#4411). Please refund the duplicate today.",
    "questions": {
      "team": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing": "invoices, payments, refunds",
          "technical": "bugs, outages, errors",
          "sales": "pricing, new plans",
          "other": "everything else"
        }
      },
      "refund": {"type": "noul", "instructions": "Does the customer ask for a refund?"},
      "urgency": {"type": "score", "instructions": "How urgent is this?", "criteria": ["not urgent", "soon", "today"]}
    }
  }'
응답은 다음과 같습니다. refund 는 환불 요청일 확률 0.9794를, urgency 는 등급별 확률을 가중 평균한 1.9005를 돌려줍니다:
{
  "model": "laya-multilingual",
  "answers": {
    "team": {"type": "choice", "choice": "billing", "confidence": 1.0, "probabilities": {"billing": 1.0, "technical": 0.0, "sales": 0.0, "other": 0.0}},
    "refund": {"type": "noul", "noul": 0.9794},
    "urgency": {"type": "score", "score": 1.9005, "confidence": 0.698, "legend": {"0": "not urgent", "1": "soon", "2": "today"}, "probabilities": {"0": 0.004, "1": 0.0915, "2": 0.9045}}
  },
  "usage": {"input_tokens": 172, "output_tokens": 0}
}
문서에 따르면 첫 요청은 모델을 불러오느라 10~20초가 걸리고, 그 뒤로는 대부분의 CPU에서 1초보다 훨씬 짧게 응답합니다. state 에는 문자열이나 임의의 JSON을 넣을 수 있습니다. model 에 laya, default, jev-latest 를 넣으면 설정에서 고른 모델로 가고, laya-multilingual, laya-english, laya-typed-decisions 처럼 이름을 지정할 수도 있습니다.
이미 Jev를 쓰고 있다면, pip install typesafe-sdk 로 SDK를 설치합니다. 그 다음 환경 변수 두 개만 바꾸면 기존 코드가 Unsloth로 요청을 보냅니다. SDK 기본 모델인 jev-latest 는 Settings에서 고른 모델로 연결됩니다:
export TYPESAFE_BASE_URL=http://localhost:8888
export TYPESAFE_API_KEY=sk-unsloth-YOUR_KEY
문서는 Jev와 다른 점 두 가지를 밝힙니다. 첫째, confidence 를 계산하는 식이 달라서 Jev에서 맞춘 기준값을 그대로 옮기면 안 되고, probabilities 를 기준으로 다시 정해야 합니다. 둘째, choice 의 선택지들이 고정된 토큰 예산을 나눠 쓰므로, 설명이 붙은 선택지가 20개를 넘으면 레이블 설명이 잘립니다.
Unsloth와 결정 모델들의 라이선스
unsloth 저장소는 Apache 2.0과 AGPL-3.0의 이중 라이선스를 씁니다. README에 따르면 핵심 Unsloth 패키지는 Apache 2.0이고, Unsloth Studio UI 같은 일부 선택 구성 요소는 AGPL-3.0입니다. 다만 2026년 10월 12일 기준으로 결정 모델 학습 코드(unsloth/models/decision.py, decision_from_lm.py, clef.py 등)와 Studio의 Decision API 코드는 파일 머리말에 SPDX-License-Identifier: AGPL-3.0-only 가 적혀 있습니다. 결정 모델 기능을 사내 서비스나 제품에 넣으려면 이 파일들의 라이선스 조건을 따로 확인해야 합니다.
Laya와 Clef 가중치는 모두 Apache 2.0으로 공개되어 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 예제에 쓰인 typed-decisions 데이터셋도 Apache 2.0입니다.
 Unsloth 결정 모델 학습 가이드 (Train your own Decision Model)
Unsloth 로컬 결정 모델 서빙 문서 (Laya + Jev API)
 Unsloth GitHub 저장소
 typed-decisions 데이터셋 (Hugging Face)
더 읽어보기
-
Introducing Clef: Cloudflare's first open-source decision models, now on Workers AI · Changelog
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
Laya: 텍스트 생성 없이 한 번의 순전파로 결정을 내리는 Jev 호환 오픈 가중치 모델과 로컬 실행 도구들
-
Jev와 유사한 오픈소스 결정 모델에 대한 정리: Decision Index와 JevBench로 비교한 결정 모델 성능 비교
-
Liquid AI, 문장 생성 대신 Jev 호환 API로 분류 / 라우팅 / 점수를 처리하는 결정 모델 d1 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
