핵심 요약
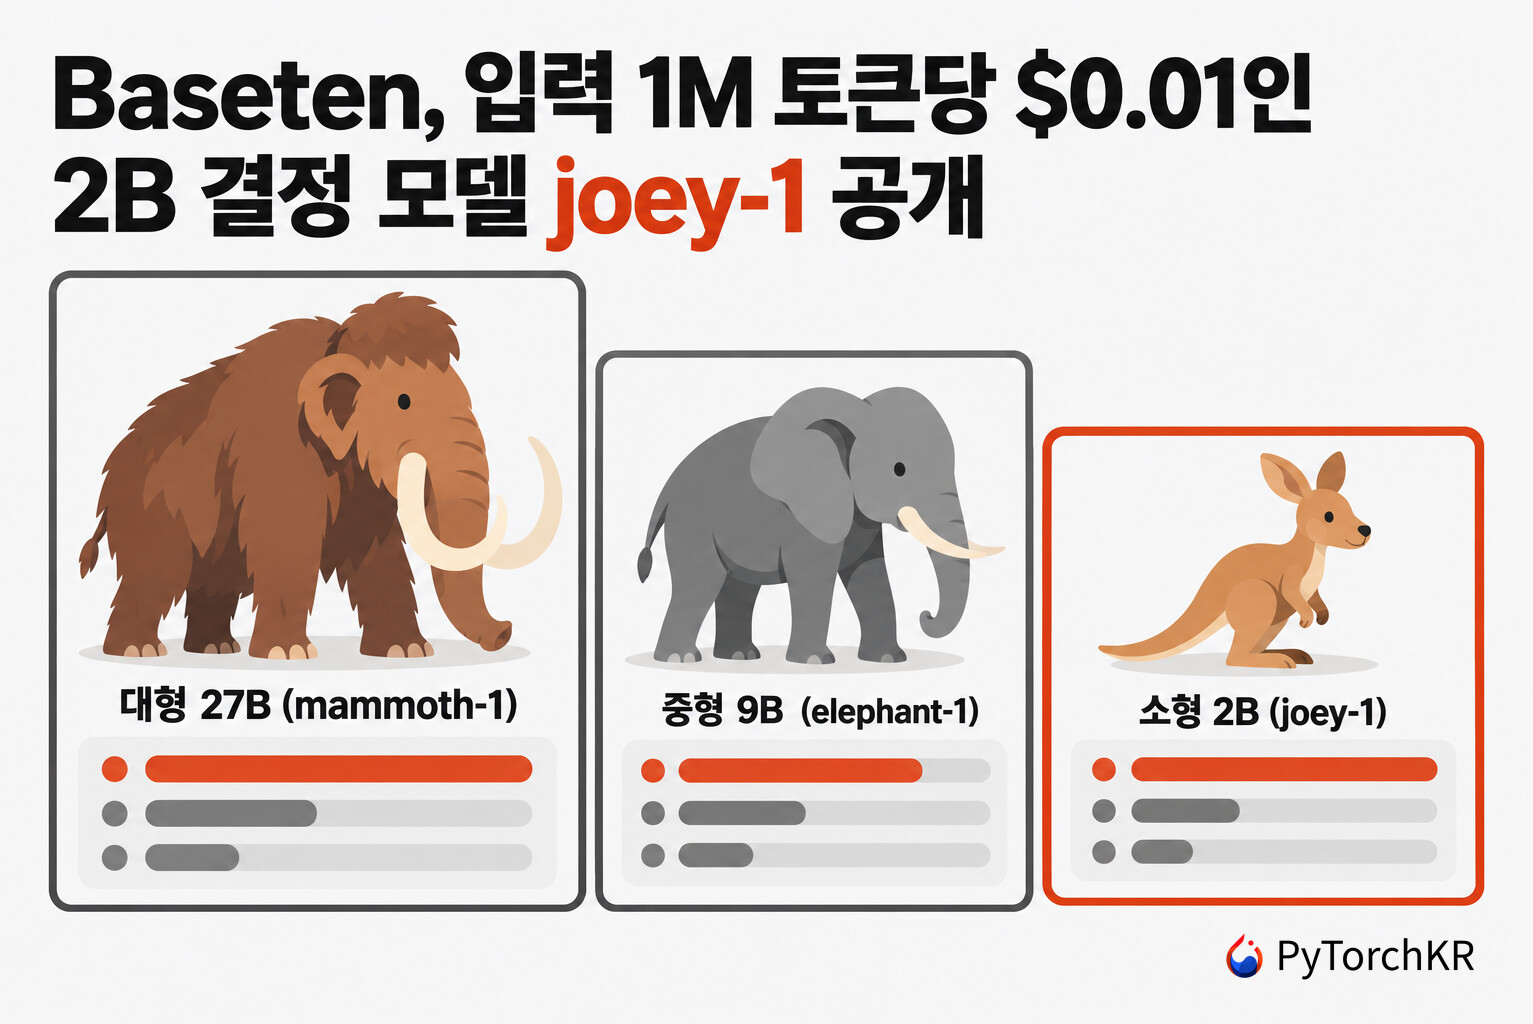
- Baseten이 10월 29일 joey-1 발표 글에서 Qwen3.5-2B를 후학습한 결정 모델 joey-1을 공개했습니다. 가중치는 Hugging Face에 있고, Baseten Model APIs 가격은 입력 100만 토큰당 $0.01입니다.
- joey-1은 일주일 앞서 나온 mammoth-1(27B), elephant-1(9B)과 같은 데이터 621만 건과 같은 학습 레시피를 씁니다. 학습 방법은 Base Labs 기술 글에 정리돼 있습니다.
- Baseten은 2,000토큰 요청의 P50(중앙값) 지연 시간을 20ms로, elephant-1(49ms)보다 약 2.5배 빠르다고 밝혔습니다. 반복 호출이 많은 분류와 라우팅을 joey-1이 먼저 받고, 확신이 낮을 때만 큰 모델로 넘기는 구성을 제안합니다.
- 모델 카드가 내세운 Decision Index 63.30은 공개 분할 점수입니다. 10월 29일 리더보드 데이터에서 순위에 쓰는 비공개 Full 점수는 35.91(247개 중 149번째)이고, 새 영역 테스트 점수는 10.2입니다.
- 모델 카드가 선언한 언어는 영어뿐이고, 원문 어디에도 한국어 평가는 없습니다. 컨텍스트는 Model APIs와 자체 호스팅 모두 16,384토큰입니다.
Baseten joey-1 소개
joey-1 은 문장을 생성하지 않고, 미리 정한 선택지마다 확률을 매겨 돌려주는 2B 규모의 결정 모델(Decision Model) 입니다. 지원 티켓을 어느 팀에 보낼지, 메시지를 차단할지, 요청을 승인할지처럼 프로그램이 답을 바로 받아 다음 동작을 정하는 작업에 맞춰 만들었습니다. 추론 인프라 회사 Baseten의 사내 연구 조직 Base Labs가 학습했습니다.
결정 모델이라는 형식은 2026년 9월 TypeSafe AI가 공개한 Jev와 System One API에서 시작했습니다. 그 뒤 Liquid AI의 d1과 d1-3B, Microsoft의 Microsoft-Decision-1, Bespoke Labs의 Nimble 같은 모델이 뒤따랐습니다. 오픈 모델들은 Decision Index와 JevBench 비교 글에서 정리한 두 리더보드로 주로 비교합니다.
Baseten은 10월 21일 mammoth-1(27B)과 elephant-1(9B)을 먼저 내놓았고, 여드레 뒤인 10월 29일 joey-1을 더했습니다. 세 모델은 같은 데이터 믹스로 학습했고 API도 같아서, 모델 이름 한 줄만 바꿔 옮겨 갈 수 있다고 Baseten은 설명합니다. 발표 글은 Max Kirkby와 Charles O'Neill이 썼습니다.
이 글은 joey-1 발표 글, Hugging Face 모델 카드, mammoth-1과 elephant-1의 학습을 설명한 Base Labs 기술 글을 함께 정리했습니다. Baseten 문서와 저장소의 실행 파일, Decision Index 원자료, Artificial Analysis 공식 리더보드도 대조했습니다. 직접 실행한 측정은 없습니다.
결정 모델이 텍스트 대신 확률을 돌려주는 방식
상태와 질문을 넣으면 선택지별 확률이 나온다
결정 모델 요청은 상태(state) 와 질문 묶음으로 이루어집니다. 상태는 지원 티켓이나 문서 같은 입력이고, 텍스트나 JSON, 이미지를 넣을 수 있습니다. 질문마다 선택지가 있고, 모델은 선택지마다 확률을 돌려줍니다. 일반 LLM도 같은 판단을 할 수 있지만 답을 텍스트로 생성한 뒤 파싱해야 합니다. 따로 요청하지 않으면 그 텍스트에는 믿을 만한 확신도도 없다고 Base Labs는 지적합니다.
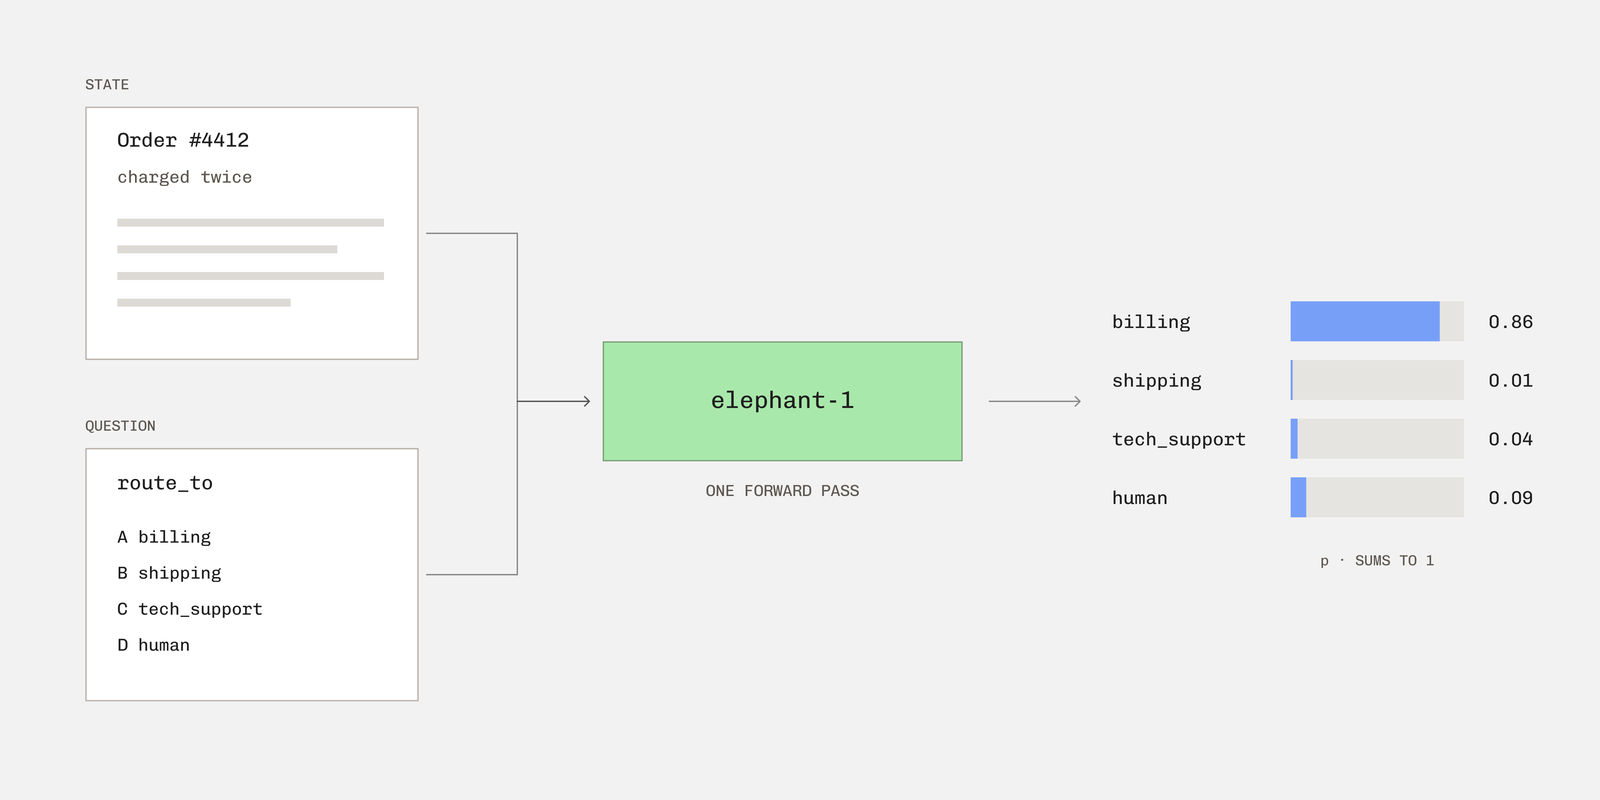
질문 유형은 Jev와 같은 세 가지입니다. API에서 예/아니오 유형의 이름은 noul 입니다.
| 유형 | API type |
선택지 | 돌려받는 값 |
|---|---|---|---|
| 선택 | choice |
이름 붙은 선택지 1~255개 | 고른 선택지, 선택지별 확률, 확신도 |
| 예/아니오 | noul |
참, 거짓 | 참일 확률 하나 |
| 점수 | score |
순서 있는 단계 2~10개 | 확률 가중 평균 단계, 단계별 확률, 확신도 |
여기서 확신도(confidence)는 고른 선택지의 확률이 아닙니다. 기술 글은 선택지가 k 개일 때 확신도를 다음처럼 정의합니다. 균등하게 찍으면 0, 한 선택지에 확률이 전부 몰리면 1입니다.
Baseten 문서도 임계값 판단에는 probabilities[choice] 를 쓰고, confidence 는 분포가 얼마나 몰렸는지를 나타낸다고 구분합니다.
상태는 한 번만 읽고, 질문마다 접미 문맥만 더 계산한다
요청 하나는 시스템 프롬프트와 상태를 담은 공유 접두 문맥(shared prefix) 하나와, 질문마다 붙는 접미 문맥(suffix)으로 나뉩니다. 접미 문맥에는 질문 지시문과 A, B, C 같은 글자를 붙인 선택지가 들어갑니다. 모델은 접미 문맥 끝 답 위치에서 LM 헤드 로짓 중 선택지 글자의 로짓만 골라 소프트맥스를 취합니다.
h_{t^\ast} 는 답 위치의 마지막 은닉 상태, W_U 는 LM 헤드, \ell_i 는 i 번째 선택지 글자입니다. 접두 문맥은 한 번만 처리해 캐시를 재사용하므로, 질문을 하나 더 붙일 때 추가 비용은 그 질문의 접미 문맥 순전파뿐입니다. Baseten 문서도 같은 상태에 대한 질문을 한 요청에 묶으라고 안내하고, 입력 토큰은 접두 문맥을 한 번만 셉니다. 출력 토큰은 질문당 하나로 집계됩니다.
전체 어텐션 층만 블록 양방향 마스크로 바꿨다
기반 모델 Qwen3.5는 Gated DeltaNet(GDN) 층 세 개 뒤에 전체 어텐션 층 하나가 오는 단위를 반복하는 하이브리드 구조입니다. GDN은 순환 방식으로 동작하는 인과적(causal) 선형 어텐션 층입니다. mammoth-1은 이 단위를 16번(64층), elephant-1은 8번(32층) 반복합니다. joey-1은 기술 글에 구조 설명이 없지만, 저장소의 config.json 을 보면 24층 중 6층이 전체 어텐션이라 같은 3:1 패턴을 6번 반복합니다.
Base Labs는 전체 어텐션 층의 마스크만 바꿨습니다. 접두 문맥 토큰을 블록 0, 접미 문맥 토큰을 블록 1이라 할 때, 토큰 i 는 b(j) \le b(i) 인 토큰 j 를 모두 볼 수 있습니다. 기존 인과 마스크는 j \le i 만 허용합니다. 즉 각 토큰은 자기 블록 전체와 앞 블록을 봅니다.

이렇게 바꾸면 두 가지가 달라집니다. 첫째, 질문을 인코딩할 때 뒤에 오는 선택지까지 함께 봅니다. 둘째, 접두 문맥은 접미 문맥을 보지 않으므로 접두 문맥 캐시가 모든 질문에서 같아 공유할 수 있습니다. 기술 글은 이 방식이 T5 논문의 prefix-LM 마스크를 두 블록으로 일반화한 것이고, Perplexity의 Decider v1.1도 비슷하게 바꿨다고 밝힙니다. GDN 층은 그대로 인과적으로 둡니다.
데이터를 고정하고 마스크만 바꾼 비교에서 Decision Index 공개 문항 1만 개 표본 점수는 인과 마스크 44.8, 블록 양방향 마스크 48.6이었습니다. 9B 모델에 초기 데이터 믹스(Mix 1)를 쓴 결과이고, 기술 글은 이것이 한 번만 돌린 실험이라고 적었습니다.
세 모델의 크기, 가격, 지연 시간 비교
세 모델은 같은 데이터와 손실 함수를 쓰고, 기반 모델 크기와 학습 설정만 다릅니다. 아래 표는 모델 카드, 기술 글, Baseten 모델 라이브러리 페이지, Hugging Face 저장소의 파일 크기를 모은 것입니다.
| 항목 | joey-1 | elephant-1 | mammoth-1 |
|---|---|---|---|
| 기반 모델 | Qwen3.5-2B | Qwen3.5-9B | Qwen3.5-27B |
| 공개일 | 2026년 10월 29일 | 2026년 10월 21일 | 2026년 10월 21일 |
| 가중치 파일 크기 | 5.44GB | 18.8GB | 54.7GB |
| Model APIs 입력 100만 토큰당 | $0.01 | $0.035 | $0.10 |
| P50 지연 시간 (Baseten 측정) | 20ms | 49ms | 발표에 언급 없음 |
| 학습 스텝 (1에폭) | 43,390 | 5,546 | 9,859 |
| 최대 학습률 | 1e-5 | 3.5e-6 | 2.7e-6 |
| 학습 하드웨어 | H100 16장 | H100 128장 | GB300 72장 |
지연 시간은 Baseten이 프로덕션 규모에서 평균 2,000토큰 요청을 처리할 때의 종단 간 P50이라고만 밝혔고, 측정 조건의 세부는 공개하지 않았습니다. 라이브러리 페이지 기준으로 출력 토큰과 캐시된 입력 토큰은 $0.00입니다. 문서에 따르면 service_tier 를 flex 로 두면 기본 가격의 약 90%, priority 로 두면 기본 2배입니다.
발표 글은 비용 예시도 들었습니다. 지원 티켓 1,000만 건을 건당 약 500토큰으로 분류하면 월 50억 토큰이고, joey-1로는 월 약 $50, mammoth-1로는 약 $500입니다. Baseten은 이런 경우 joey-1을 1차 모델로 두고, joey-1의 확신이 낮을 때 elephant-1이나 mammoth-1로 넘기는 구성을 권합니다. 발표 글이 joey-1로 옮길 만하다고 꼽은 조건은 두 가지입니다. 결정 횟수가 많아 호출당 비용이 사업성을 좌우하는 경우, 그리고 그 결정이 다른 응답의 앞 단계라서 지연 시간이 매 응답에 더해지는 경우입니다.
621만 건의 학습 데이터를 만든 방법
네 가지 범주와 고친 데이터
Base Labs는 데이터 작업을 "스위스 치즈의 구멍 메우기(plugging the holes in the Swiss cheese)" 라고 부릅니다. 모델을 학습한 뒤 약점과 실패 유형을 찾습니다. 그 약점을 겨냥한 합성 데이터를 에이전트로 만들고 다시 학습하며, 이 과정을 반복합니다. 최종 데이터 믹스는 여덟 번째 시도인 Mix 8이고 621만 건입니다.
| 범주 | 건수 | 비율 | 내용 |
|---|---|---|---|
| 핵심 결정 기술 | 362만 | 58.3% | 지식과 추론, 언어, 도구와 자동화, 검색과 분류, 예술과 사람의 취향 다섯 영역의 합성 데이터 |
| 안전과 판단 보류 | 100만 | 16.1% | 유해 요청 분류, 쓸 도구가 없을 때 도구 호출 거부, 모를 때 답하지 않기 |
| 채점과 전문 분야 | 100만 | 16.1% | 루브릭 채점, 답 비교, 법률, 금융, 의료 분야의 답 평가 |
| 공개 결정 데이터 | 59만 | 9.5% | 상업 이용이 가능한 공개 데이터셋 61개의 93개 작업, 추론 문제, 커뮤니티 결정 데이터셋 25개 |
공개 데이터셋의 3분의 1에는 사람 투표로 만든 소프트 레이블이 있습니다. 합성 문제 중 일부는 모델이 아니라 프로그램이 정답을 계산합니다. 예를 들어 사기 티켓의 비율과 환불 언급 비율을 상태에 주고 환불을 언급한 티켓이 사기일 확률을 묻는 문제는 프로그램이 정확한 답을 계산합니다.
생성한 데이터가 거치는 품질 단계
새로 만든 데이터는 같은 파이프라인을 지납니다. 생성에는 DeepSeek V4-Pro나 GLM-5.3 같은 모델을 썼습니다. 검사 하나로는 잘못된 예시를 다 잡지 못하므로 여러 검사를 겹쳤다고 Base Labs는 설명합니다.

- 레이블: 프로그램으로 정답을 계산하거나, 판정 모델 다섯 개에게 선택지 순서를 섞어 물어 네 개 이상이 의도한 답을 고를 때만 남깁니다.
- 정제: 여전히 모호하거나 정답이 둘 이상인 예시를 버립니다.
- 오염 제거: 평가에 쓰는 Jev Decision Index와 Artificial Analysis Decision Index와 겹치는 예시를 지웁니다.
- 검토: 별도 에이전트가 레이블을 다시 도출합니다. 선택지만 보고 정답을 알 수 있는 지름길 문제도 찾습니다.
- 시험 학습: 새 데이터 소스마다 이전 모델에서 240스텝을 짧게 학습해 보고 넣을지 정합니다.
한 바퀴를 돈 뒤에는 자체 결정 벤치마크, Decision Index, Artificial Analysis Decision Index 복제판 세 가지로 모델을 재고, 가장 약한 곳을 다음 데이터 소스로 정합니다. 기술 글은 이 과정이 대부분 에이전트로 돌아간다고 적었습니다.
데이터를 늘리는 것과 고치는 것의 효과
아래 그림은 9B 모델로 믹스마다 잰 Decision Index 공개 문항 점수입니다. 데이터를 16배 늘린 Mix 4까지 점수가 45.5에서 66.0으로 올랐고, 그 뒤 Mix 7까지 7.9점이 더 올랐습니다. 기술 글은 뒤쪽 상승이 주로 데이터를 고친 결과라고 해석합니다. 판단 보류 학습을 처음 넣은 Mix 5는 행을 4%만 늘리고 5.5점을 올렸습니다. Mix 7에서는 데이터 소스 253개를 전부 다시 감사해 틀린 레이블, 정답 노출, 형식 오류를 고쳤습니다.
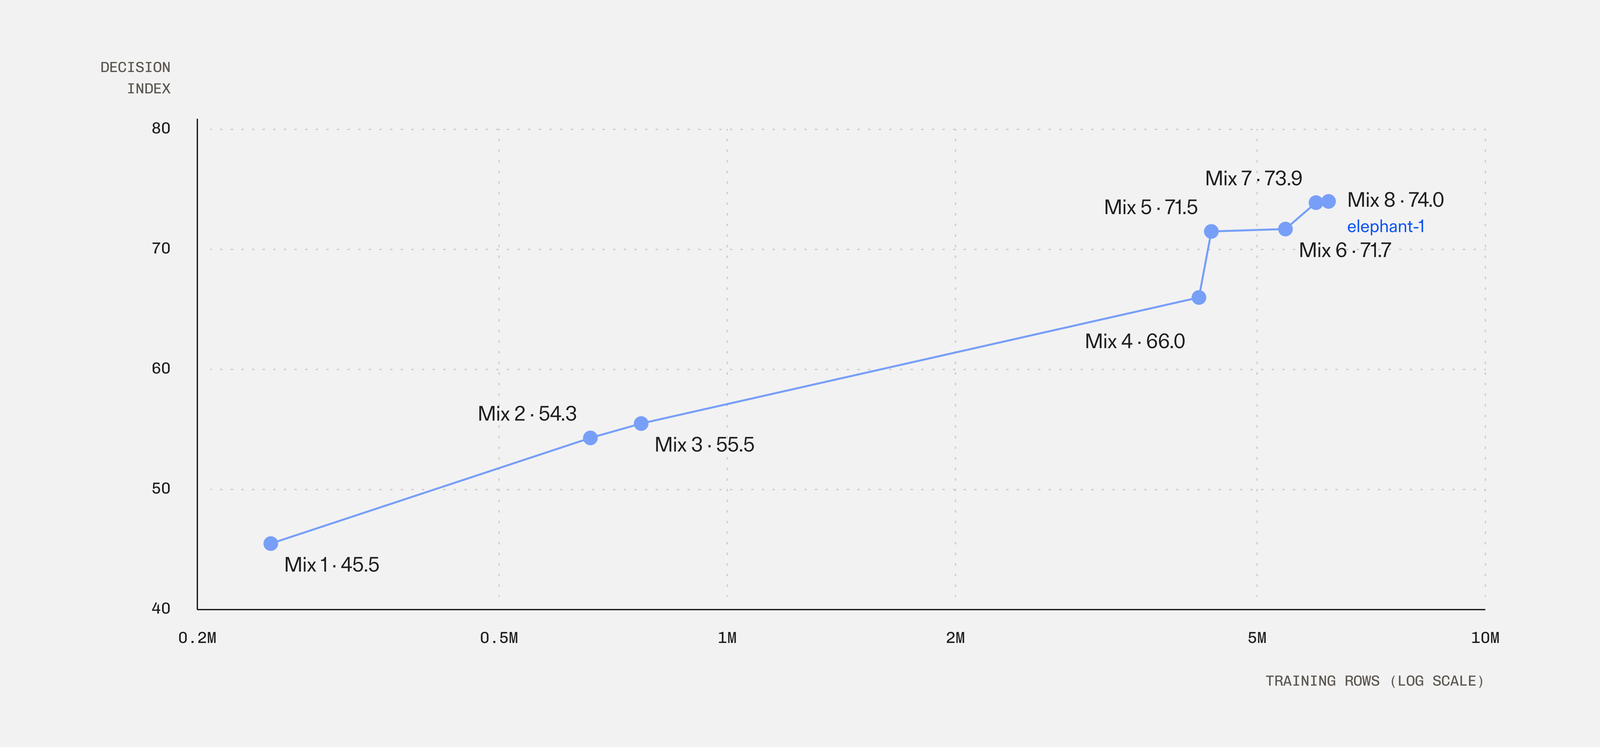
두 가지를 함께 봐야 합니다. 이 점수는 Base Labs가 직접 돌린 공개 문항(0.3판, HLE 제외) 결과입니다. 또 Mix 2부터 블록 양방향 마스크를 함께 썼으므로 Mix 2의 상승이 데이터만의 효과는 아닙니다.
"모르겠음"을 학습시키는 방법과 손실 함수
결정 모델은 보통 "모르겠음" 같은 선택지를 거의 고르지 않습니다. Base Labs는 여러 방법을 비교한 끝에 가장 단순한 신호가 가장 잘 맞았다고 밝힙니다. 선택지 중 가장 높은 확률이 임계값 \tau(0.5보다 조금 낮은 값)보다 낮으면 모델이 정답을 모른다고 봅니다.
이 신호를 학습 데이터로 바꾸는 방법은 이렇습니다. 판단 보류 데이터셋의 문제에 "모르겠음" 선택지를 무작위로 넣고, 정답을 무작위로 뺍니다. 정답이 빠졌거나, 정답이 있어도 기존 모델의 정답 확률이 \tau 보다 낮으면 "모르겠음"에 확률 100%를 줍니다. 아니면 원래 목표 분포를 유지하고 "모르겠음"에는 0%를 줍니다.
손실 함수는 교차 엔트로피에 브라이어 점수(Brier score) 항을 더한 것입니다. 브라이어 점수는 예측 확률과 정답 분포의 차이를 제곱해 더한 값으로, 틀린 선택지에 준 확률을 절대량으로 벌합니다.
Base Labs는 브라이어 항이 과신을 줄인다고 설명합니다. 학습은 비전 인코더를 고정하고 나머지를 전체 미세조정(fine-tuning) 했습니다. 상태를 직렬화하는 형식은 무작위로 바꿨고, 엔티티 목록을 고르는 선택 문제에는 50% 확률로 방해 선택지를 더했습니다.
벤치마크 수치를 읽을 때 확인할 점
모델 카드와 발표 글의 순위는 두 리더보드에서 왔습니다. 첫째는 Hugging Face의 apolinário가 운영하는 커뮤니티 리더보드 Jev Decision Index입니다. 둘째는 Artificial Analysis Decision Index입니다. 두 곳 모두 원자료를 받아 볼 수 있어서, 10월 29~31일 기준으로 직접 대조했습니다.
Decision Index: 공개 분할 점수와 Full 점수는 다르다
Decision Index는 두 종류의 점수를 함께 보여 줍니다. 공개 분할(public split) 은 누구나 내려받을 수 있는 공개 벤치마크 37개의 점수입니다. Full 점수 는 공개되지 않은 테스트로 매기며, 같은 기술을 재는 비공개 테스트 60%와 새 영역의 비공개 과제 40%로 구성됩니다. 리더보드 변경 기록에 따르면 10월 19일 0.4판부터 공개 분할은 함께 표시만 하고 순위에는 쓰지 않습니다. 변경 기록은 이를 "순위가 전적으로 아무도 학습할 수 없는 테스트에 기댄다" 고 설명합니다. 10월 21일 0.4.1판에서는 새 영역 테스트를 더 넓고 어렵게 바꿔 모든 모델의 새 영역 점수가 내려갔습니다.
joey-1 모델 카드의 "Best model under 4B on the Jev Decision Index 0.4 public split: 63.30" 은 공개 분할 점수입니다. 아래 표는 리더보드 원자료(data/index.json, 10월 29일 14시 UTC 생성, 0.4.1판)에서 Baseten 세 모델과 카드가 비교한 모델, 비슷한 크기의 모델을 뽑은 것입니다. 파라미터 수는 리더보드가 집계한 값입니다.
| 모델 | 파라미터 | 공개 분할 | Full | 같은 기술(비공개) | 새 영역(비공개) | 공개와 Full 차이 |
|---|---|---|---|---|---|---|
| mammoth-1 | 27.4B | 75.34 | 68.44 | 66.26 | 56.27 | 6.9 |
| Perplexity Decider v1.2 | 26.1B | 67.74 | 67.98 | 64.30 | 57.76 | -0.2 |
| elephant-1 | 9.4B | 72.24 | 60.26 | 62.44 | 44.41 | 12.0 |
| Jev 1.14 | 비공개 | 60.70 | 60.24 | 59.28 | 48.26 | 0.5 |
| Cloudflare Clef | 27.8B | 61.71 | 54.92 | 53.11 | 45.06 | 6.8 |
| Perplexity Decider Flash v1.2 | 4.5B | 60.06 | 54.29 | 56.16 | 40.02 | 5.8 |
| Jeffan-4B-2010 | 4.2B | 64.85 | 52.21 | 58.03 | 33.52 | 12.6 |
| StartLux-Decision v1.1 2B | 2.3B | 59.23 | 40.11 | 51.52 | 17.04 | 19.1 |
| joey-1 | 2.7B | 63.30 | 35.91 | 50.16 | 10.20 | 27.4 |
| LiquidAI d1-3B | 3.1B | 48.99 | 31.12 | 41.23 | 11.47 | 17.9 |
표에서 확인되는 것은 세 가지입니다.
첫째, 공개 분할만 보면 카드의 주장은 맞습니다. 리더보드가 집계한 파라미터 수로 4B 미만인 모델 중 joey-1의 63.30이 가장 높습니다. 다만 카드의 "230개 중 37위" 는 10월 29일 데이터에서 247개 중 47위입니다. 4.2B인 Jeffan-4B-2010은 64.85로 더 높지만 4B를 넘습니다.
둘째, Full 점수로는 순서가 달라집니다. joey-1은 35.91로 247개 모델 항목 중 149번째입니다. 카드 표에서 joey-1 아래에 있던 Cloudflare Clef(54.92), Jev 1.14(60.24), Perplexity Decider Flash v1.2(54.29)가 모두 joey-1보다 높습니다. 4B 미만끼리 비교해도 StartLux-Decision v1.1 2B(40.11)와 Standard One 3B SH v4(39.79)가 joey-1보다 높습니다.
셋째, joey-1의 공개 점수와 Full 점수 차이는 27.4점으로 표에서 가장 큽니다. 새 영역 점수 10.2는 같은 2~3B대인 d1-3B(11.47)와 비슷하고 StartLux 2B(17.04)보다 낮습니다. 이 차이의 원인은 공개된 자료만으로 단정할 수 없습니다. 다만 Base Labs가 데이터 루프의 측정 지표 셋 중 하나로 Decision Index 공개 문항을 썼다는 점은 기술 글에 적혀 있습니다. Base Labs는 평가 벤치마크와의 중복을 제거했다고도 밝혔습니다.
mammoth-1과 elephant-1의 순위도 그 사이에 바뀌었습니다. 기술 글과 Baseten 발표 글은 0.4판 기준으로 mammoth-1이 Full 71.24로 208개 중 1위라고 썼습니다. 0.4.1판의 10월 29일 데이터에서 mammoth-1은 Full 68.44로 점수 순 9위이고, 리더보드가 0.9점 이내를 동률로 묶는 규칙으로는 세 번째 묶음입니다. 공개 분할에서는 여전히 1위(75.34)입니다. elephant-1은 Full 60.26으로 48번째이며 Jev 1.14와 같은 동률 묶음입니다. 이 리더보드는 판이 자주 바뀌므로, 도입을 판단할 때는 그 시점의 Full 점수를 다시 확인해야 합니다.
Artificial Analysis Decision Index: 복제판과 공식 리더보드
모델 카드의 Artificial Analysis 점수(joey-1 62.9, elephant-1 65.2, mammoth-1 65.9)는 모두 Base Labs가 자체 복제한 평가로 잰 값입니다. 발표 글의 아래 차트도 Baseten 모델은 복제판 점수로, 다른 모델은 10월 20일 Artificial Analysis 공식 리더보드 점수로 그렸습니다. 두 출처가 한 차트에 섞여 있습니다.
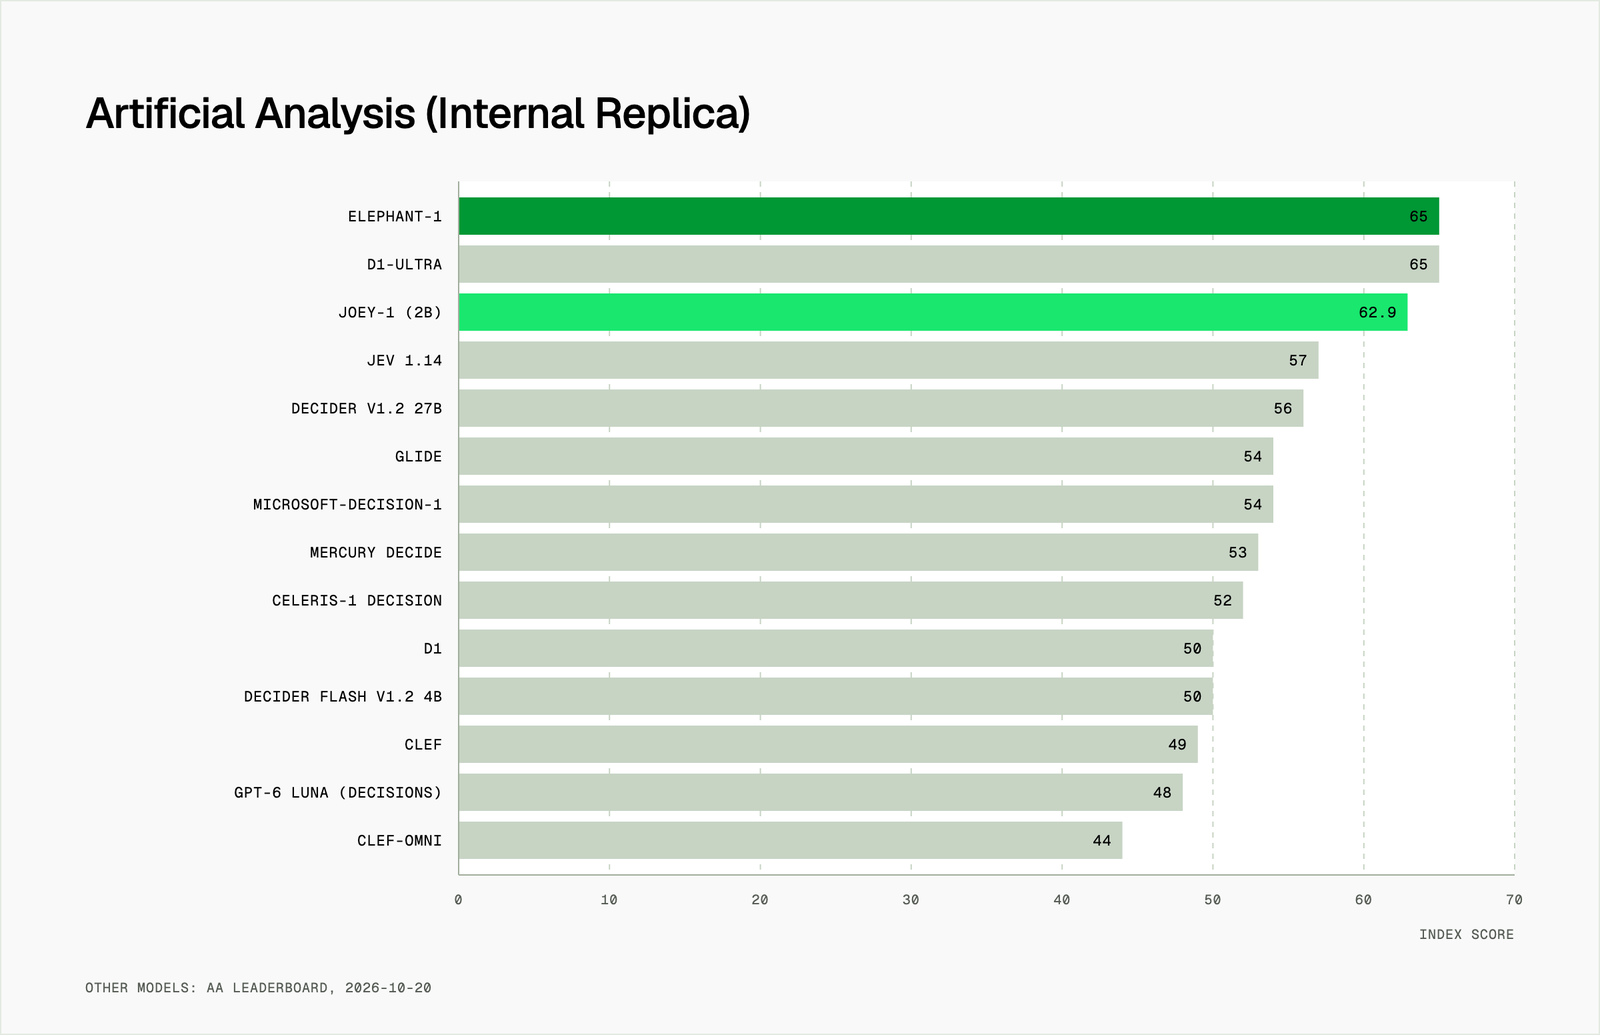
10월 31일에 조회한 Artificial Analysis 공식 리더보드에는 joey-1과 mammoth-1이 없습니다. Baseten이 사전에 Artificial Analysis와 함께 잰 elephant-1만 Elephant 9B라는 이름으로 올라 있습니다. 점수는 64.69로 d1-ultra(65.25), SubQ Snap 1.1(65.00)에 이어 3위입니다. 차트에 없는 SubQ Snap 1.1과 Drex Max(63.74)가 언제 등재됐는지는 확인하지 못했습니다.
이 지수는 네 평가를 25%씩 반영합니다. AA-Omniscience-Decision(정확도 12.5% + 환각하지 않는 비율(non-hallucination rate) 12.5%), HLE-MultiChoice, When2Call, WildGuardTest입니다.
공식 리더보드의 세부 점수를 보면 elephant-1의 AA-Omniscience 정확도는 11.6%로 d1-ultra(31.6%)나 Jev 1.14(33.8%)보다 크게 낮습니다. 반면 환각하지 않는 비율은 93.2%로 d1-ultra(84.5%), Jev 1.14(37.2%)보다 높습니다. 즉 elephant-1은 지식 문제에서 답을 맞히기보다 답하지 않는 쪽으로 점수를 얻습니다. 판단 보류 학습의 효과로 읽을 수 있지만, 지식이 필요한 결정에 쓰려면 이 정확도를 먼저 봐야 합니다. joey-1은 같은 레시피를 더 작은 모델에 적용했고, 모델 카드도 지식이 더 필요한 작업에는 elephant-1이나 mammoth-1을 쓰라고 안내합니다.
또 다른 독립 리더보드 JevBench의 측정
다른 커뮤니티 리더보드인 JevBench도 세 모델을 쟀습니다. 10월 31일 기준 v1.8.2에서 mammoth-1은 Capability 85.2로 오픈 가중치 보드 1위입니다. joey-1은 10월 27일 측정분으로 Capability 57.8이 표시되지만, 그 회차를 기준 척도에 맞추는 작업이 끝나지 않아 순위는 매기지 않았습니다.
사용 방법: Model APIs, 자체 호스팅, 미세조정
Baseten Model APIs로 호출하기
Baseten Model APIs는 모델을 따로 배포하지 않고 바로 호출하는 방식입니다. 데이터 미보관(Zero Data Retention)이 기본으로 켜져 있습니다. 세 모델의 슬러그는 decision-models/baseten-joey-2b-latest, decision-models/baseten-elephant-9b-latest, decision-models/baseten-mammoth-27b-latest 이고, 컨텍스트 한도는 모두 16,384토큰입니다.
아래는 Baseten 문서의 cURL 예제에서 model 값만 joey-1 슬러그로 바꾼 것입니다. BASETEN_API_KEY 환경 변수에 Baseten API 키가 있어야 합니다. 경로가 /v1/systemone 이고 요청 필드가 Jev와 같아서, Jev용으로 짠 요청 본문을 엔드포인트, 인증 헤더, model 값만 바꿔 보낼 수 있는 구조입니다.
curl --fail-with-body https://inference.baseten.co/v1/systemone \
  -H "Authorization: Bearer $BASETEN_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "decision-models/baseten-joey-2b-latest",
    "service_tier": "default",
    "state": "I was charged twice for my subscription. Please refund the duplicate charge.",
    "questions": {
      "route": {
        "type": "choice",
        "instructions": "Which team should handle this request?",
        "criteria": {
          "billing": "Billing, payments, and refunds",
          "technical_support": "Technical troubleshooting"
        }
      },
      "refund": {
        "type": "noul",
        "instructions": "Is the customer asking for a refund?"
      },
      "urgency": {
        "type": "score",
        "instructions": "How urgent is the request?",
        "criteria": [
          "Routine request",
          "Needs attention today",
          "Immediate emergency"
        ]
      }
    }
  }'
응답의 answers 에는 질문 이름마다 답이 들어갑니다. choice 는 고른 선택지와 probabilities, noul 은 예일 확률, score 는 0부터 시작하는 단계의 기댓값과 단계별 확률입니다. 문서는 probabilities[choice] 가 0.9 이상이면 자동 라우팅하고 아니면 사람에게 보내는 예제를 듭니다. 임계값은 레이블이 있는 예시로 시험해 정하라고 안내합니다. Python 예제는 baseten-performance-client, JavaScript 예제는 @basetenlabs/performance-client 패키지를 씁니다.
전용 배포(dedicated deployment)를 쓰면 미세조정한 가중치를 올릴 수 있고, 발표 글에 따르면 컨텍스트가 262k까지 열립니다.
직접 내려받아 서빙하기
가중치 저장소에는 서빙 런타임 설치 스크립트 setup.sh 가 함께 들어 있습니다. CUDA GPU 한 장과 pytorch/pytorch:2.8.0-cuda12.8-cudnn9-devel 이미지가 필요합니다. 스크립트는 Qwen 기반 오픈 결정 모델 프로젝트 OneJev(Apache-2.0)의 코드를 고정 커밋으로 받아 결정 판독(readout)과 어텐션 마스크를 더하는 serve.patch 를 적용하고, 평가 도구 decision-index도 설치합니다. 스크립트 주석은 이 구성을 Base Labs가 실험에 쓴 그대로 고정한 것이라고 설명하고, 미세조정 쿡북도 OneJev를 학습 코드로 씁니다.
hf download baselabs/joey-1 --local-dir joey-1 && bash joey-1/setup.sh
from qev.engine import DecisionEngine
from qev.schema import SystemOneRequest

engine = DecisionEngine("baselabs/joey-1", device="cuda:0")

questions = {
    "refund": {"type": "noul", "instructions": "Is the customer asking for a refund?"},
    "team": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {"billing": "Charges, refunds, invoices",
                     "technical": "App or site faults",
                     "fraud": "Suspected unauthorised use"},
    },
    "urgency": {
        "type": "score",
        "instructions": "How urgent is this?",
        "criteria": ["Can wait", "Today", "Blocking the customer now"],
    },
}
resp, _ = engine.decide(SystemOneRequest(
    state="I was charged twice this month, please refund one of them.", questions=questions))
print(resp.answers)
모델 카드에 따르면 학습한 길이 한도를 넘는 요청은 잘라서 처리하지 않고 거부합니다. 저장소의 engine.py 는 질문이 많은 큰 요청에서 32비트 인덱싱이 넘치면 질문을 순차 처리로 바꿔 다시 계산하는 예외 처리를 담고 있습니다.
내 데이터로 미세조정하기
joey-1과 elephant-1은 Baseten Training Jobs에서 추가 학습할 수 있습니다. joey-1 미세조정 쿡북은 은행 고객 의도 77종을 분류하는 BANKING77 데이터로 예제를 구성했습니다. 기본 설정은 H100 4장, 2,000행(24스텝)이고, 설치를 포함해 약 6분이 걸린다고 적혀 있습니다. 학습률은 1e-6이고, 학습 전후로 테스트 500행의 정확도, 음의 로그 가능도(NLL), 기대 보정 오차(ECE)를 로그에 남깁니다.
baseten train init --example joey-1-sft
cd joey-1-sft
baseten train push --config config.py
자기 데이터로 학습하려면 prepare_data.py 가 train.jsonl 과 test.jsonl 을 쓰도록 고칩니다. 학습한 체크포인트는 deploy/config.yaml 로 elephant-1 Model API와 같은 Infinity 서버에 올리고, 같은 /v1/systemone 요청을 받습니다.
joey-1을 1차 분류기로 쓰기 전에 확인할 점
언어: 세 모델 카드의 language 필드는 모두 영어(en) 하나입니다. 기술 글과 발표 글에도 한국어나 다국어 평가는 없습니다. Qwen3.5 기반이라 한국어 입력이 동작할 수는 있지만, 보장된 범위는 아닙니다. 한국어 티켓이나 문서를 분류하려면 레이블이 있는 한국어 예시로 정확도와 임계값을 먼저 재야 합니다.
비공개 테스트 성능: Decision Index에서 joey-1은 같은 기술의 비공개 테스트(50.16)에서도 공개 점수(63.30)보다 낮고, 새 영역(10.2)에서는 더 크게 떨어집니다. 처음 보는 유형의 결정에서 성능이 크게 떨어질 수 있다는 신호로 읽는 편이 안전합니다. Baseten이 제안한 대로 확률이 낮으면 큰 모델이나 사람에게 넘기는 구성을 함께 설계해야 합니다.
이미지 입력: 세 모델 카드는 모두 "텍스트와 이미지 결정으로 언어 모델을 전체 미세조정했다" 고 적었습니다. 그런데 10월 21일 기술 글의 향후 계획 절은 mammoth-1과 elephant-1이 "텍스트만으로 학습했다" 고 쓰고, 이미지와 영상 상태 학습을 앞으로 할 일로 꼽았습니다. joey-1의 이미지 학습 범위와 이미지 결정 벤치마크 점수는 원문에서 확인되지 않습니다.
컨텍스트 길이: Model APIs 한도와 학습 길이는 16,384토큰입니다. 전용 배포의 262k 컨텍스트는 발표 글의 설명이며, 16,384토큰을 넘는 길이에서 보정(calibration)을 잰 결과는 공개되지 않았습니다.
라이선스
joey-1, elephant-1, mammoth-1의 Hugging Face 모델 카드는 라이선스를 MIT로 선언하고 있어, 카드 기준으로는 상업적 용도를 포함해 자유롭게 사용하고 수정할 수 있습니다. 다만 세 저장소 모두 LICENSE 파일은 따로 없습니다. 기반 모델 Qwen3.5-2B, 9B, 27B는 Apache License 2.0으로 배포됩니다. 자체 호스팅에 쓰는 OneJev는 Apache-2.0, decision-index와 Baseten 쿡북 저장소는 MIT입니다.
 Decisions for a penny: introducing joey-1 소개 블로그
 mammoth-1 and elephant-1: frontier decision models 기술 글
 joey-1 모델 카드
 Baseten Decision models 문서
 joey-1 미세조정 쿡북 GitHub 저장소
더 읽어보기
-
The top ranked decision models in the world: mammoth-1 and elephant-1 (Baseten 블로그, 영문)
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
Jev와 유사한 오픈소스 결정 모델에 대한 정리: Decision Index와 JevBench로 비교한 결정 모델 성능 비교
-
Microsoft, Jev 호환 API의 결정 모델 Microsoft-Decision-1 출시 (입력 1M 토큰당 $0.042)
-
Liquid AI, 엣지 기기에서 한 번의 순전파로 판단하는 결정 모델 d1-3B와 d1-omni-600M 공개
-
Bespoke Labs, 사실 하나만 바꾼 대조 데이터로 만든 9B 결정 모델 Nimble과 학습 레시피 공개
-
Unsloth, LLM을 Laya, Clef와 같인 Jev식 결정 모델을 미세조정하고 로컬에서 서빙하는 학습 가이드 공개
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
 파이토치 한국 사용자 모임
 이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일
 로 보내드립니다! 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
