핵심 요약
- DeepSeek이 2026년 10월 20일 공개한 DeepInfer는 DeepSeek-V4.1-Flash의 대규모 운영 서비스를 실제로 구동하는 추론 프레임워크입니다. 이번 공개 범위는 오프라인 추론입니다. 지원 모델은 DeepSeek-V4.1-Flash 하나이고, 지원 하드웨어는 NVIDIA SM100 GPU(B200, GB200 같은 Blackwell 데이터센터 GPU)와 Huawei Ascend 950 NPU입니다.
- 온라인 서비스에 필요한 KV 캐시 시스템, 비전 인코더/프리필/디코드 분리 배포, 데이터 병렬 복제본 간 부하 분산은 공개되지 않았습니다. 지금 V4.1-Flash를 API로 서빙해야 하는 팀에게는 이미 이 모델을 지원하는 vLLM이나 SGLang이 현실적인 선택지입니다.
- 저장소에는 DeepSeek의 커널 라이브러리, 어텐션 데이터 병렬화와 MoE 전문가 병렬화, DSpark 추측 디코딩, SWA 바운디드 리플레이, 배치 불변 추론, 구조화 출력이 들어 있습니다.
- 함께 공개된 배포 Q&A 문서는 디코드 64~128 GPU의 Wide-EP 구성, 약 100PiB 규모의 3FS KV 캐시 저장소 같은 운영 구성을 밝힙니다. DeepSeek은 클러스터 하나가 하루 155조 토큰을 처리한다고 밝혔습니다.
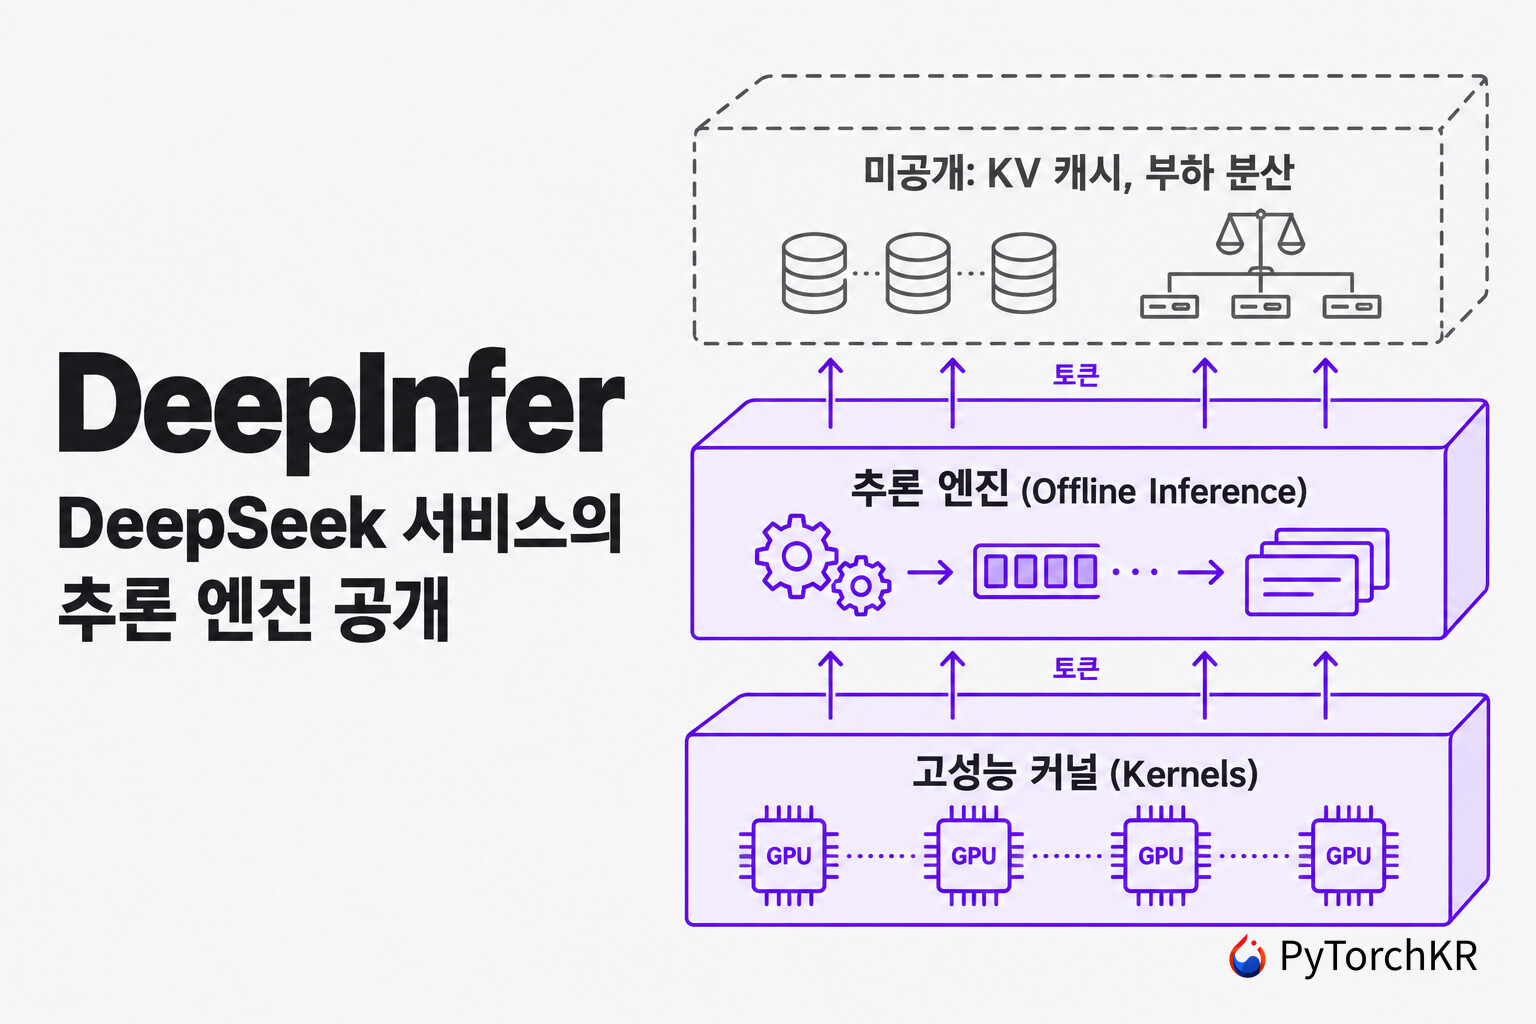
DeepInfer 소개
거대한 전문가 혼합(Mixture-of-Experts, MoE) 모델을 많은 사용자에게 싸게 서빙하려면 커널 하나를 빠르게 만드는 것만으로는 부족합니다. 연산 커널, GPU 간 통신, 요청 스케줄링, KV 캐시(Key-Value Cache) 저장소가 서로 맞물려 전체 처리량을 결정하기 때문입니다. DeepSeek은 그동안 이 문제를 이루는 부품을 하나씩 공개해 왔습니다. 2025년 초부터 FlashMLA (
 FlashMLA: Hopper GPU를 위한 고성능 MLA 디코딩 커널 (feat. DeepSeek)), DeepEP ( DeepEP: 효율적인 Mixture-of-Experts 병렬 통신 라이브러리 (feat. DeepSeek)), DeepGEMM ( DeepGEMM: NVIDIA Hopper GPU에서 효율적인 FP8 연산을 위한 GEMM 커널 라이브러리 (feat. DeepSeek)) 같은 커널 라이브러리를 냈고, DeepSeek-V3/R1 추론 시스템 개요도 공개했습니다. 그러나 이 부품들을 묶어 실제 서비스를 실행하는 엔진은 공개하지 않았습니다. 이번에 소개하는 DeepInfer 는 DeepSeek이 DeepSeek-V4.1-Flash 서비스에 쓰는 바로 그 추론 프레임워크를 공개한 저장소입니다.
DeepInfer는 고성능 커널과 추론 엔진을 결합한 구조입니다. 커널 계층에는 DeepSeek이 따로 공개해 온 커널 라이브러리가 서브모듈로 들어 있습니다. 엔진 계층에는 분산 추론, 추측 디코딩(Speculative Decoding), SWA 바운디드 리플레이(SWA Bounded Replay), 비동기 스케줄링, 구조화 출력(Structured Output)이 구현되어 있습니다. DeepSeek은 DeepInfer가 처음에는 주로 vLLM을 바탕으로 만들어졌고 SGLang과 TensorRT-LLM에서도 아이디어를 얻었다고 밝혔습니다. 함께 공개한 배포 Q&A 문서에 따르면 DeepInfer 기반 클러스터 하나가 현재 하루 155조 토큰을 처리하고, GPU 시간당 전체 매출은 할인 시간대(valley) 가격 기준 38달러입니다. 이 수치는 DeepSeek이 자체적으로 밝힌 운영 지표이며 외부에서 검증할 방법은 없습니다.
다만 이번 공개는 운영 시스템 전체가 아닙니다. 공개된 범위는 오프라인 추론입니다. 온라인 서비스에 필요한 KV 캐시 시스템, 비전 인코더/프리필/디코드(VE/P/D) 분리 배포, 데이터 병렬 복제본 간 부하 분산은 포함되지 않았습니다.
분리 배포에 대해서는 "필요한 엔진 기능 대부분은 이미 구현되어 있다" 고 적혀 있지만, 이를 묶는 구성 요소는 빠져 있습니다. DeepSeek은 KV 캐시 관리와 부하 분산 구성 요소가 내부 인프라와 강하게 얽혀 있어 아직 전부 공개하지 않았다고 설명하고, 대신 그 설계를 배포 Q&A 문서로 정리했습니다. 저장소의 진입점 디렉토리 deepinfer/entrypoints/ 에도 오프라인용 llm.py 하나만 있습니다. 저장소 안의 HTTP 인터페이스는 기본으로 꺼져 있는 프로파일링용 profile_server.py뿐이고, 추론 요청을 받는 API 서버는 없습니다. 지원 모델은 DeepSeek-V4.1-Flash 하나이며, DeepSeek은 앞으로 나올 모델의 추론 코드와 성능 개선도 DeepInfer로 계속 공개하겠다고 밝혔습니다.
DeepInfer vs. vLLM
DeepSeek-V4.1-Flash를 직접 운영하려는 팀이 먼저 비교할 대상은 vLLM과 SGLang입니다. 두 저장소 모두 이미 DeepSeek-V4.1 전용 모델 코드를 갖고 있습니다. vLLM은 DeepSeek-V4.1-Flash 레시피에서 지원 하드웨어와 최소 버전(0.31.0)을 명시하고 있어, 공개된 정보만으로 비교할 수 있습니다. 주요 항목별 차이는 다음과 같습니다:
| 항목 | DeepInfer | vLLM |
|---|---|---|
| 만든 곳 | DeepSeek (자사 운영 서비스 엔진) | vLLM 커뮤니티 (범용 서빙 엔진) |
| 지원 모델 | DeepSeek-V4.1-Flash 하나 | DeepSeek-V4.1-Flash를 포함한 다수 모델 |
| 지원 하드웨어 | NVIDIA SM100 GPU, Huawei Ascend 950 NPU | 레시피 기준 NVIDIA H100/H200/B200/B300/GB200/GB300, AMD MI300X~MI355X 검증 |
| 공개된 실행 형태 | 오프라인 배치 추론 (Python LLM 클래스) |
OpenAI 호환 API 서버 |
| 분리 배포와 KV 캐시 계층 | 미공개 (엔진 기능 대부분은 구현) | 레시피에 프리필/디코드 분리 클러스터(pd_cluster) 전략과 KV 오프로딩(CPU, 파일 시스템) 검증 표기 |
| 근거 | DeepSeek 운영 서비스에서 쓰는 코드 | 커뮤니티가 각 하드웨어에서 검증한 구성 |
SGLang 저장소에도 DeepSeek-V4.1 설정과 멀티모달 프로세서 코드가 있고, V4.1 관련 PR도 여러 건 열려 있습니다. 두 엔진의 일반적인 차이는 vLLM과 SGLang 비교 글에 정리되어 있습니다.
DeepInfer와 vLLM의 차이는 성능보다 공개 범위와 하드웨어에서 먼저 드러납니다. DeepInfer는 DeepSeek이 운영에 쓰는 코드라서 커널 선택과 기본 설정의 근거가 분명합니다. 그러나 지금 상태로는 API를 받는 서비스를 바로 띄울 수 없고, 지원 하드웨어 목록에 Hopper 세대 GPU가 없습니다. README와 배포 Q&A 문서에는 같은 하드웨어에서 DeepInfer와 vLLM, SGLang을 비교한 수치가 없으므로, 성능 차이는 직접 측정해야 합니다.
DeepInfer를 사용하면 좋을 사용자
DeepInfer가 맞는 독자는 SM100 GPU나 Ascend 950 NPU로 DeepSeek-V4.1-Flash를 대규모로 운영하려는 팀입니다. 이 팀은 DeepSeek이 운영 환경에서 쓰는 커널 조합, 병렬화 설정, 추측 디코딩 스케줄링을 그대로 가져와 자기 서빙 계층 아래에 둘 수 있습니다. 같은 모델을 다른 엔진으로 서빙하는 팀에게도 배포 Q&A 문서는 쓸모가 있습니다. 프리필과 디코드의 GPU 비율, 전문가 병렬화 크기, KV 캐시 저장소의 용량과 수명 같은 운영 수치를 DeepSeek이 직접 공개한 자료는 드물기 때문입니다. 배치 구성과 무관하게 같은 결과를 내는 배치 불변 추론은 재현 가능한 평가가 필요한 연구자에게도 관련이 있습니다.
반대로 Hopper GPU만 있는 팀이나 지금 바로 API 서빙이 필요한 팀에게는 DeepInfer가 아직 적절한 선택지가 아닙니다. H100, H200으로 운영하거나 OpenAI 호환 API를 바로 열어야 한다면 V4.1-Flash 레시피가 있는 vLLM이나 SGLang이 현실적입니다. 또한 DeepInfer 저장소는 공개된 지 며칠 되지 않았고, DeepSeek의 다른 모델은 지원하지 않습니다.
DeepInfer의 구성: 커널과 병렬화
커널 계층
DeepInfer의 커널 계층은 DeepSeek이 따로 공개해 온 라이브러리를 서브모듈로 가져와 빌드합니다. 각 라이브러리의 역할은 다음과 같습니다:
- FlashMLA, DeepGEMM, DeepEP: 각각 어텐션 커널, 행렬 곱셈(GEMM)과 Mega MoE 같은 텐서 코어 커널, MoE 전문가 간 통신 라이브러리입니다. Ascend용으로는
DeepEP-Ascend,DeepGEMM-Ascend서브모듈이 따로 있습니다. - TileKernels ( TileKernels: DeepSeek AI가 공개한, LLM 연산을 위한 고성능 TileLang 기반 GPU 커널 라이브러리): TileLang으로 작성한 LLM 연산 커널 라이브러리입니다. DeepInfer는 여기에 더해 자체 TileLang 커널을
tilelang_ops디렉토리에 두고 있습니다. - DeepSelect: DeepSeek 희소 어텐션(DeepSeek Sparse Attention, DSA)과 샘플러에 쓰는 TopK 커널입니다.
배포 Q&A 문서는 공개 버전과 내부 버전의 차이도 밝힙니다. DeepGEMM과 FlashMLA의 내부 버전은 공개 버전과 대체로 같지만, 공개된 FlashMLA에는 손으로 튜닝한 SASS(NVIDIA GPU의 기계어 수준 어셈블리) 최적화 하나가 빠져 있어 디코딩 커널이 5~10% 느립니다. DeepSeek은 종단 간(End-to-End) 성능 차이는 최대 5% 수준이라고 설명합니다. 또한 스케일업 도메인 안에서는 EP 크기나 배치 크기와 관계없이 Mega MoE가 퓨전하지 않은 MoE보다 훨씬 빠르다고 밝혔습니다.
FlashMLA는 2026년 9월 30일 릴리스에서 Hopper 아키텍처와 DeepSeek V3, V3.2, V4.0 지원을 제거했고 KV 캐시 형식도 바꿨습니다. 위에서 링크한 PyTorchKR의 FlashMLA, DeepGEMM 글은 2025년의 Hopper용 첫 공개판을 다루므로, 지금 DeepInfer가 쓰는 버전과는 대상 하드웨어와 모델이 다릅니다.
병렬화 구성
DeepInfer는 어텐션 부분에 데이터 병렬화(Data Parallelism, DP)와 균형 컨텍스트 병렬화(Context Parallelism, CP)를 지원합니다. MoE 부분에는 전문가 병렬화(Expert Parallelism, EP)와 EPLB를 지원합니다. EP64 처럼 약어 뒤에 붙은 숫자는 그 병렬화에 참여하는 GPU 수입니다. EPLB(Expert-Parallel Load Balancer)는 자주 호출되는 전문가의 복제본을 여러 GPU에 두어 부하를 고르게 맞추는 기법으로, DeepSeek이 2025년에 별도 라이브러리로도 공개했습니다.
운영 환경의 병렬화 설정은 배포 Q&A 문서에 나와 있습니다. 프리필은 HBM이 허용하는 한 가장 작은 EP2~8/DP2~8을 쓰고, 디코드는 가용 GPU가 허용하는 한 가장 큰 EP64~128/DP64~128을 씁니다. DeepSeek은 디코드의 이 구성을 Wide-EP 라고 부르며, 운영 환경에서는 텐서 병렬화(Tensor Parallelism, TP)와 CP를 아직 쓰지 않는다고 밝혔습니다. 프리필과 디코드의 GPU 비율은 대략 1:1이어서, 효율적으로 운영할 수 있는 최소 단위는 프리필 64 GPU와 디코드 64 GPU입니다.
EPLB는 GPU마다 여분의 전문가 자리를 두고, 최근 구간의 전문가별 부하를 모아 주기적으로 전문가를 다시 배치합니다. 프리필은 GPU당 여분 4개에서 시작해 100스텝 동안 통계를 모으고 1,000스텝마다 재배치하며, 디코드는 GPU당 여분 1개, 1,000스텝 통계, 10,000스텝 재배치를 씁니다. DeepSeek은 가장 느린 랭크를 평균으로 나눈 불균형 지표 moe_lb 가 프리필에서 1.045~1.074, 디코드에서 1.090이었다고 밝혔습니다.
DeepInfer의 엔진 기능
엔진 기능과 켜는 방법
DeepInfer의 엔진 기능은 대부분 환경 변수로 켜고 끕니다. README에 정리된 기능과 설정 방법은 다음과 같습니다:
| 기능 | 하는 일 | 켜는 방법 |
|---|---|---|
| DSpark와 신뢰도 기반 검증 | 초안 토큰으로 디코딩을 가속하고, 신뢰도 추정값으로 검증할 토큰을 고름 | DEEPINFER_ENABLE_MTP_VARLEN=1, 최대 초안 길이는 DEEPINFER_USE_NEXTN_DECODE (기본 5) |
| 디코더 SWA 바운디드 리플레이 | 프롬프트 끝부분만 다시 계산해 디코더 프리필 연산을 줄임 | DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact, DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140 (V4.1 기본값) |
| 비동기 스케줄링 | CPU의 배치 스케줄링을 GPU 실행과 겹침 | 기본으로 켜져 있음 |
| 배치 불변 추론 | 배치 구성이 달라도 모델 결과를 똑같이 유지 | DEEPINFER_BATCH_INVARIANT=1 (NVIDIA만) |
| 결정적 샘플링 | 같은 입력 토큰과 샘플링 파라미터에 같은 출력 | DEEPINFER_BATCH_INVARIANT=1 DEEPINFER_ENABLE_MTP_VARLEN=0 과 고정 seq_seed (NVIDIA만) |
| 구조화 출력 | 정규식, JSON 스키마, EBNF(Extended Backus-Naur Form) 문법으로 출력을 제약 | SamplingParams 에 so_args={"schema_type": ..., "schema": ...} 전달 |
구조화 출력은 XGrammar로 문법을 컴파일하고, 디코딩 스텝마다 허용 토큰 마스크를 샘플링에 적용합니다. 배치 불변 추론과 결정적 샘플링은 NVIDIA에서만 동작하고, 결정적 샘플링을 켜려면 DSpark의 가변 길이 검증을 꺼야 합니다.
SWA 바운디드 리플레이
DeepSeek-V4.1-Flash는 전체 문맥을 보는 전역 어텐션과 최근 구간만 보는 슬라이딩 윈도우 어텐션(Sliding-Window Attention, SWA)을 함께 씁니다. 프리픽스 캐시가 적중해도 SWA의 KV 캐시가 없으면 그 구간을 다시 계산해야 하는데, 정확히 복원하려면 계산량이 문맥 길이와 레이어 수에 비례합니다. 배포 Q&A 문서에 따르면 디코더 SWA KV를 정확히 다시 만들려면 마지막 2,560개 토큰을 디코더 20개 레이어에 다시 통과시켜야 합니다.
SWA 바운디드 리플레이는 최근 128개 토큰만 다시 계산합니다. 이때 어텐션 윈도우도 그 128개 토큰 안으로 잘라서 근사적인 SWA KV 캐시를 만듭니다. 위치 s부터 다시 계산할 때 위치 i의 쿼리는 max(s, i−127)부터 i까지의 키만 봅니다. 그래서 재계산 비용이 문맥 길이와 레이어 수에 상관없이 일정해집니다.
DeepSeek은 이 방식을 인코더와 디코더 두 곳에 씁니다. 인코더 쪽에서는 SWA KV 캐시가 없을 때 적중한 프리픽스의 마지막 128개 토큰을 다시 계산합니다. 디코더 쪽에서는 매 프리필마다 프롬프트의 마지막 128개 토큰만 디코더 레이어에서 다시 계산합니다. 디코더 쪽 결과는 디코드에만 쓰고 프리픽스 캐시에는 넣지 않으며, DeepSeek은 이것으로 전체 프리필 연산이 거의 절반으로 줄었다고 설명합니다.
README의 기본 설정이 140개 토큰을 남기는 것도 이 구조에서 나옵니다. 남기는 접미부는 SWA 윈도우에 최대 역추적(backtracking) 길이를 더한 만큼을 덮어야 합니다. 배포 Q&A 문서의 적중 정책에서도 길이 L인 입력의 최대 적중 길이를 L − 134(128개 토큰 윈도우와 추측 디코딩 역추적 6개 토큰)로 제한합니다. 이렇게 만든 SWA KV 캐시는 정확한 재계산 결과가 아니라 근사값이라는 점도 Q&A 문서에 명시되어 있습니다.
DSpark 가변 길이 검증
DeepSeek-V4.1-Flash의 추측 디코딩 방식인 DSpark는 초안 모델이 한 번에 토큰 5개를 만들고 본 모델이 이를 검증합니다. 초안 토큰이 받아들여질 확률은 요청과 위치마다 다르므로, 항상 5개를 모두 검증하면 받아들여질 가능성이 낮은 토큰에도 검증 연산을 쓰게 됩니다. DSpark는 신뢰도 헤드(Confidence Head)로 초안 토큰마다 수락률을 예측합니다. 그다음 프로파일링한 하드웨어 처리량 곡선과 이 예측값을 바탕으로, 유효 처리량이 가장 커지는 앞부분만 골라 검증합니다.
DeepSeek은 이 가변 길이 검증을 고정 5개 검증과 비교한 결과를 공개했습니다. 아래 표는 EP64/DP64 벤치마크 데이터로 계산한 추정치이며, 랭크당 동시 시퀀스 수(conc) 순서는 원문을 따랐습니다:
| conc (랭크당 시퀀스) | 평균 검증 길이 (고정 → 가변) | 평균 수락 길이 (고정 → 가변) | 추정 처리량 변화 |
|---|---|---|---|
| 16 | 5 → 4.44 | 3.32 → 3.24 | −1.5% |
| 32 | 5 → 3.65 | 3.25 → 3.17 | +1.6% |
| 48 | 5 → 3.94 | 3.30 → 3.26 | +3.6% |
| 60 | 5 → 3.58 | 3.30 → 3.21 | +5.4% |
| 72 | 5 → 3.24 | 3.29 → 3.12 | +6.7% |
| 96 | 5 → 3.24 | 3.30 → 3.15 | +11.0% |
가변 길이 검증은 스텝당 검증하는 초안 토큰 수를 약 30% 줄이면서 평균 수락 길이는 거의 유지합니다. 운영 지점인 랭크당 약 60개 동시 시퀀스에서 처리량 이득은 4~7%로 추정됩니다. 다만 동시 시퀀스가 16개로 적을 때는 1.5% 손해이므로, 이 기능의 이득은 배치가 클수록 커집니다.
DeepInfer 벤치마크
DeepSeek이 README에 공개한 벤치마크는 프리필은 SM100 GPU 4개, 디코드는 SM100 GPU 64개에서 측정했고, 각각 하나의 스케일업 도메인 안에서 실행했습니다. 모델은 DeepSeek-V4.1-Flash, 문맥 길이는 131,072 토큰입니다. 측정 스크립트는 examples/sweep/run_sweep.sh로 공개되어 있습니다.
아래 그림은 프리필 단계의 처리량과 지연 시간입니다. 가로축은 Latency (ms / prefill step), 세로축은 Non-cached Input Throughput (tokens/s/GPU)이고, 점 옆 숫자는 DP 랭크당 배치 토큰 수입니다:
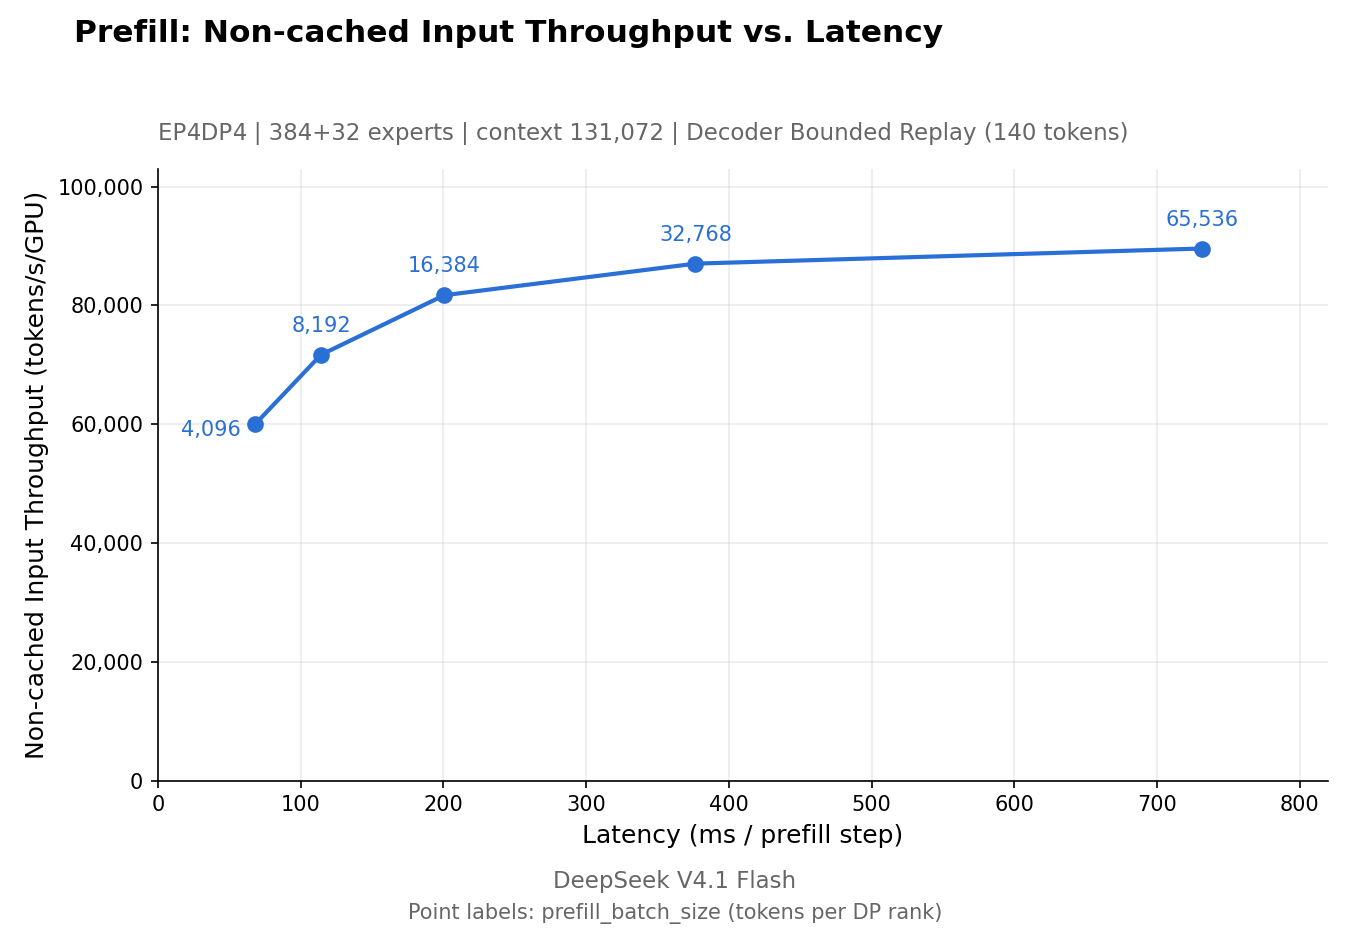
EP4DP4 구성에서 배치가 4,096 토큰이면 스텝당 약 68ms가 걸리고, GPU당 초당 약 6만 토큰을 처리합니다. 배치를 65,536 토큰으로 키우면 스텝당 약 730ms에 GPU당 약 9만 토큰까지 올라갑니다. 이 측정은 디코더 바운디드 리플레이(140 토큰)를 켠 상태입니다.
다음 그림은 배포 Q&A 문서에 실린 디코드 단계 비교로, README의 디코드 곡선(EP64DP64)에 EP8DP8 결과를 겹친 것입니다. 가로축은 Per-User Speed (tokens/s/user), 세로축은 Output Throughput (tokens/s/GPU)이고, 점 옆 숫자는 DP 랭크당 요청 수입니다:
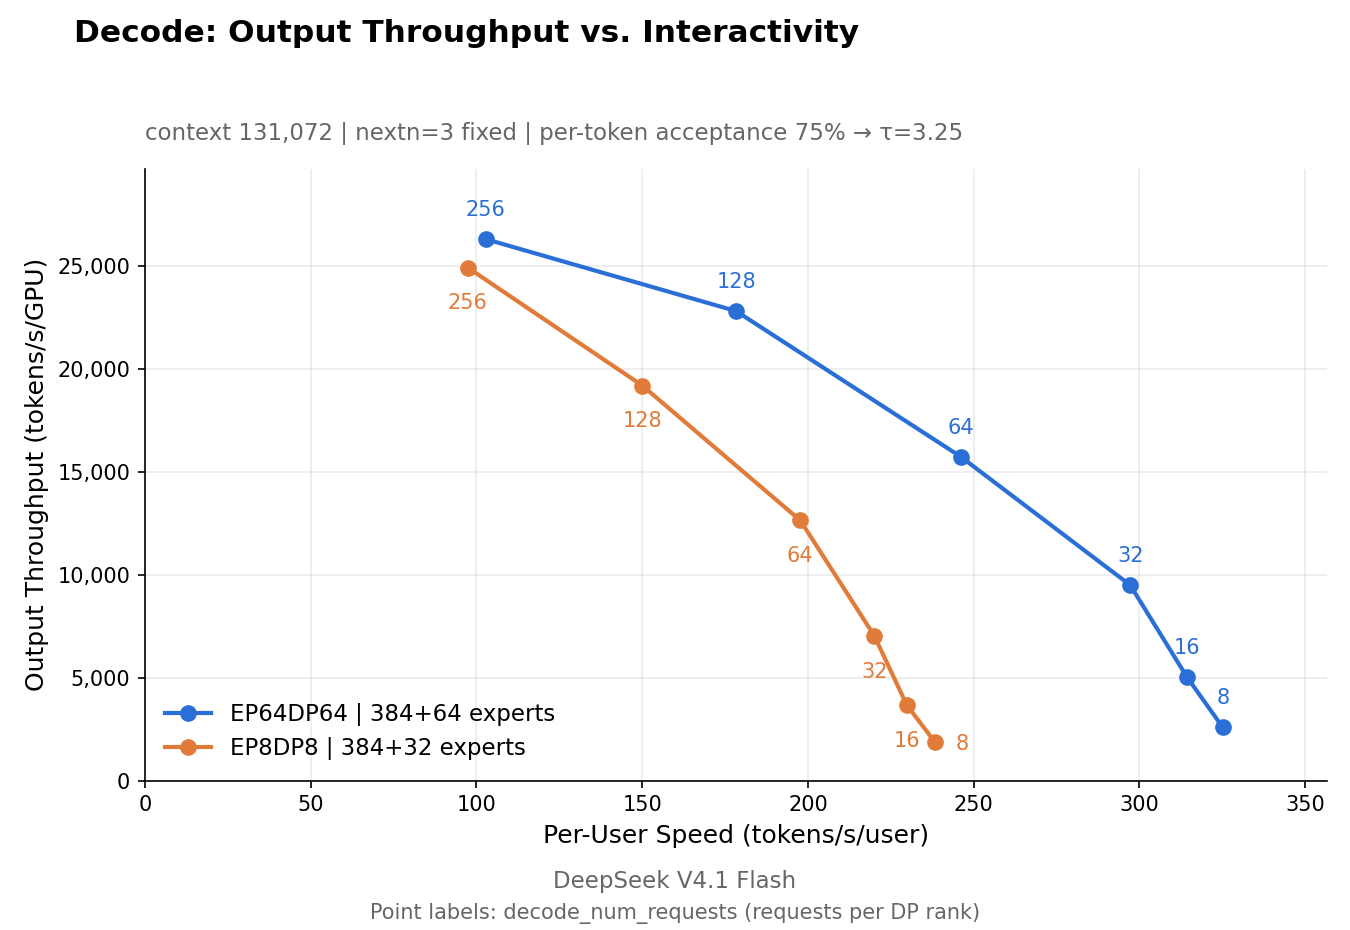
랭크당 64개 요청에서 EP64DP64는 GPU당 초당 약 15,700 토큰, 사용자당 초당 약 246 토큰을 냈고, EP8DP8은 약 12,700 토큰과 약 198 토큰이었습니다. 랭크당 256개 요청까지 늘리면 EP64DP64가 GPU당 약 26,300 토큰에 이릅니다. DeepSeek은 Wide-EP가 MoE 전문가 부분의 스텝당 메모리 트래픽을 크게 줄여 처리량을 높인다고 설명합니다.
디코드 수치를 읽을 때는 측정 조건 하나를 함께 봐야 합니다. 그림 위에 적힌 대로 이 곡선은 초안 길이를 3으로 고정하고 초안 토큰당 수락률을 75%로 가정해 계산한 값 입니다. plot_pareto.py는 측정한 초당 스텝 수에 τ = 1 + 3 × 0.75 = 3.25를 곱해 처리량을 구합니다. 실제 수락률은 프롬프트와 작업에 따라 달라지므로, 이 곡선은 실측 처리량이 아니라 수락률 가정을 둔 환산치입니다.
DeepSeek-V4.1-Flash 운영 배포 구성
배포 Q&A 문서는 DeepInfer 저장소에 포함되지 않은 서비스 계층의 설계를 설명합니다. 아래 그림은 DeepSeek-V4.1-Flash 추론 시스템의 전체 구조로, 검은 화살표는 요청(Request), 파란 화살표는 KV 캐시(KVCache)의 이동입니다:
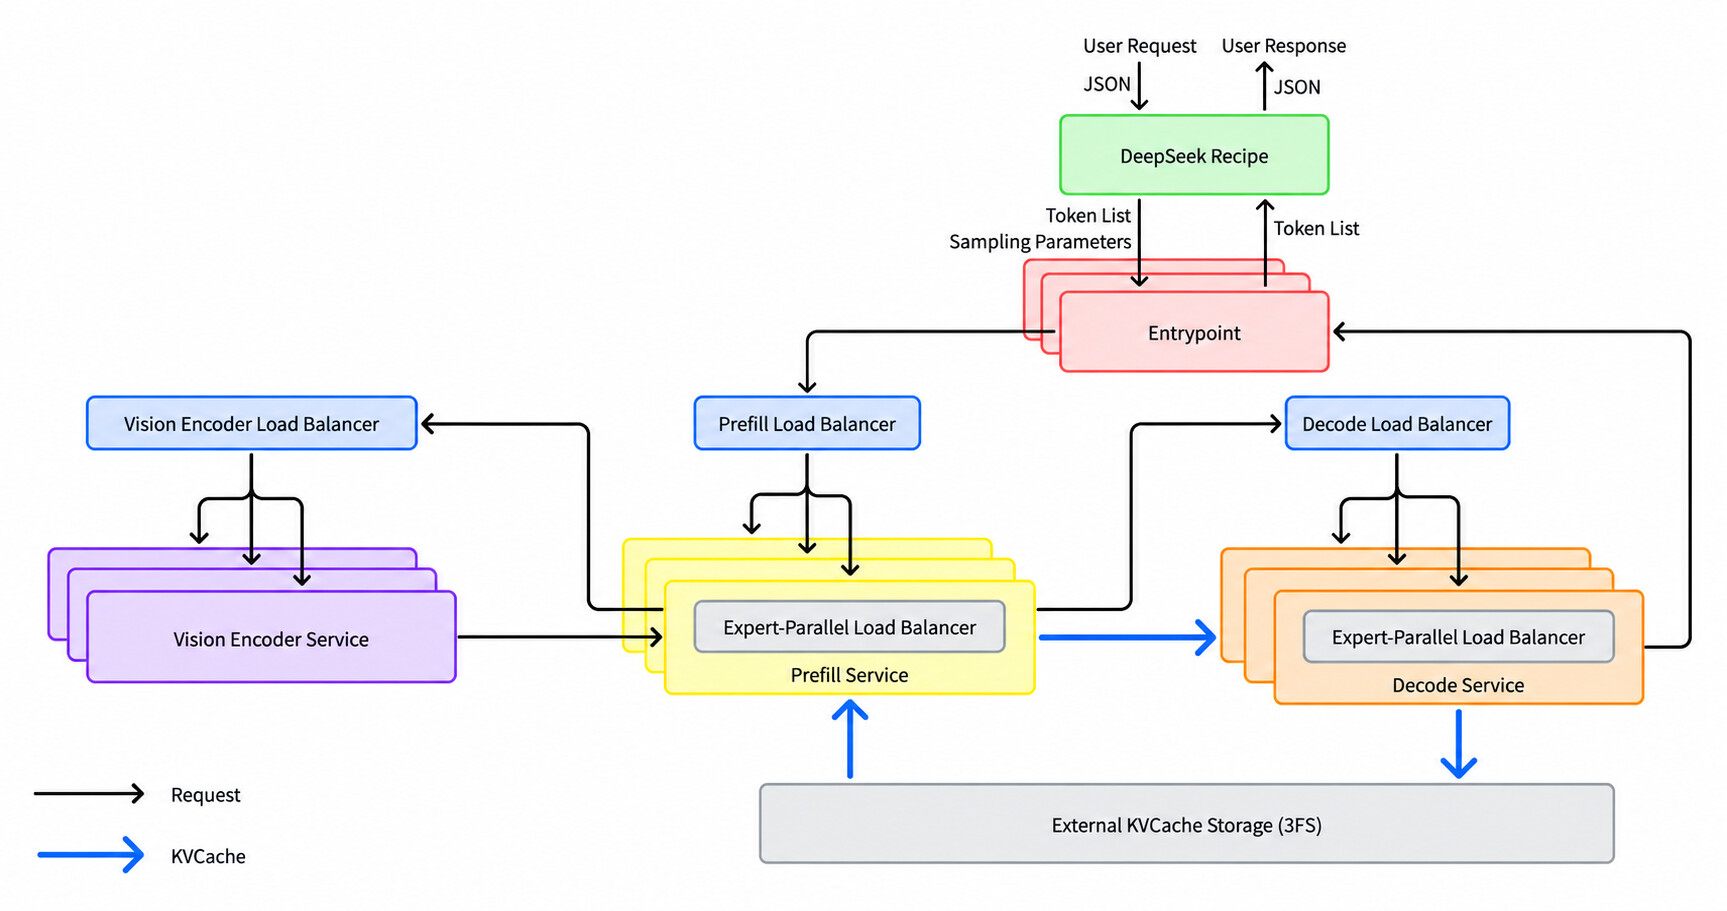
요청은 deepseek-recipe에서 토큰 목록으로 바뀌어 Entrypoint로 들어갑니다. deepseek-recipe는 이번에 함께 공개된 Rust 라이브러리입니다. Messages, Chat Completions, Responses API 요청을 DeepSeek 모델의 프롬프트와 토큰 ID로 바꾸고, 모델 출력을 다시 각 API 형식의 응답으로 바꿉니다. 사용자 입력이나 도구 결과에 들어 있는 <|User|> 같은 특수 토큰 문자열은 일반 토큰으로 인코딩해, 텍스트로 제어 토큰을 주입하지 못하게 합니다. Entrypoint는 프리필, 디코드, 비전 인코더 부하 분산기로 요청을 보내고, 프리필 서비스와 디코드 서비스는 외부 KV 캐시 저장소(3FS)와 KV 캐시를 주고받습니다. 이 구조에서 DeepInfer가 담당하는 부분은 각 서비스 안에서 돌아가는 엔진이고, 부하 분산기와 KV 캐시 저장소는 공개되지 않았습니다.
KV 캐시 저장소에 대해 배포 Q&A 문서가 밝힌 주요 수치는 다음과 같습니다:
- 저장 위치: 블록 KV 캐시는 전용 3FS 저장소 클러스터에, SWA KV 캐시는 그것을 만든 머신의 호스트 메모리에 둡니다. 3FS는 10+2 이레이저 코딩(Erasure Coding)으로 데이터를 저장합니다.
- 용량과 수명: 3FS가 KV 캐시용으로 약 100PiB의 SSD 공간을 제공하고, 캐시 수명(TTL)은 에이전트 트래픽 3일, 챗봇 트래픽 7일입니다. 챗봇 트래픽에 3일 TTL을 적용하면 KV 캐시 적중률이 0.5~1% 떨어진다고 합니다.
- 저장 서버 사양: 서버당 30.73TB SSD 20개, 읽기 40GB/s와 쓰기 5GB/s 이상, 24시간 분량을 담을 용량을 권장합니다. 운영 환경에서는 온라인 GPU당 논리 용량 약 14.4TB를 씁니다.
- 데이터센터 간 배치: V4.1-Flash가 KV 캐시를 크게 압축했기 때문에 프리필과 디코드를 다른 데이터센터에 나눠 두는 것도 가능하며, GPU 8개당 약 400Gbps의 연결 대역폭을 권장합니다.
부하 분산 쪽에서는 프리필 요청을 문맥 길이 기준 4개 구간(16K 미만, 16~64K, 64~256K, 256K 이상)으로 나눕니다. 디코드 요청은 요청 수와 KV 캐시 총길이를 함께 고려해 GPU에 배정합니다. DeepSeek은 이렇게 해서 완벽하게 균형이 맞는 오프라인 벤치마크 성능의 약 80%에 도달한다고 밝혔습니다. 비전 인코더를 분리해 배포하는 구조의 효과와 조건은 E-P-D 분리 서빙 글에서 따로 다룬 바 있습니다.
DeepInfer 설치와 오프라인 추론
DeepInfer를 빌드하려면 Linux, GCC 13.0 이상, Python 3.12가 필요하고, NVIDIA는 CUDA 13, Ascend는 CANN 9.2가 필요합니다. 빈 Python 3.12 환경을 만들어 활성화한 뒤, 가속기 종류를 환경 변수로 지정하고 빌드 스크립트를 실행합니다:
# Use `ascend` instead for the Ascend platform
# Keep it exported in the environment where you run DeepInfer
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
build.sh 는 플랫폼별 의존성을 설치하고 서브모듈 커널 라이브러리와 DeepInfer 확장을 빌드합니다. NVIDIA 쪽 의존성에는 PyTorch 2.13.0(CUDA 13.2 빌드)이 고정되어 있습니다. 이 DEEPINFER_ACCELERATOR 값은 빌드뿐 아니라 DeepInfer를 실행하는 환경에서도 계속 export되어 있어야 합니다.
오프라인 추론 예제는 다음과 같이 실행합니다. 처음 실행하면 기본 체크포인트인 deepseek-ai/DeepSeek-V4.1-Flash-1017 을 Hugging Face 캐시로 내려받습니다. 로컬 사본을 쓰려면 DEEPINFER_HF_MODEL_DIR 을 지정합니다:
python examples/offline_inference.py
examples/README.md는 병렬화 구성을 바꾸는 예도 함께 제공합니다:
python examples/offline_inference.py --ep 8
python examples/offline_inference.py --ep 2 --dp 8
python examples/offline_inference.py --ep 2 --cp 8
벤치마크는 examples/benchmark.py 로 실행하며, 병렬화 규모는 명령행 인자가 아니라 WORLD_SIZE 와 CUDA_VISIBLE_DEVICES 로 정해집니다. 저장소의 eval/ 디렉토리에는 AIME 2026, HLE, GPQA Diamond를 DeepInfer 오프라인 배치 API로 평가하는 스크립트가 있습니다. DeepSeek은 기본 설정의 Pass@1 기준값으로 AIME 2026 99.9%, GPQA Diamond 93.4%, HLE-Full 42.6%를 제시합니다. DeepSeek은 이 값이 배포가 올바르게 구성되었는지 확인하는 점검용 기준이며, 생성의 무작위성 때문에 실행마다 조금씩 달라질 수 있다고 설명합니다.
DeepInfer의 라이선스
DeepInfer는 Apache-2.0 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다. 기본 체크포인트인 DeepSeek-V4.1-Flash-1017 모델 가중치는 별도로 MIT 라이선스로 공개되어 있습니다.
 DeepSeek V4.1 Flash 추론 배포 Q&A 문서 (DeepInfer 저장소)
 DeepInfer GitHub 저장소
 DeepSeek-V4.1-Flash-1017 모델 다운로드 (DeepInfer 기본 체크포인트)
더 읽어보기
-
DeepSeek-V4.1-Flash, KV 캐시를 토큰당 890바이트로 줄이고 플래그십 V4-Pro를 대체하는 552B 규모의 MoE 모델
-
EPLB: MoE 모델에서 GPU들 간의 부하를 분배(Load Balancing)하는 라이브러리 (feat. DeepSeek)
-
E-P-D 분리 서빙: 비전 인코더를 떼어내 TTFT를 최대 93% 줄이는 조건과 오히려 느려지는 조건 (feat. NVIDIA Dynamo)
-
vLLM과 SGLang 중 무엇을 골라야 할까? Red Hat이 공개한 PagedAttention과 RadixAttention의 차이와 벤치마크 해석법
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임 은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일
 로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.

 아래
 쪽에 좋아요
 를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
