핵심 요약
- Microsoft가 2026년 10월 9일 Microsoft-Decision-1 발표 글에서 문장 대신 선택지별 확률을 돌려주는 결정 모델을 정식(GA) 출시했습니다. Qwen3.5-9B를 후학습했고, 가중치는 배포하지 않습니다.
- 요청 형식은 Jev와 같습니다.
state와questions를 보내고,noul,choice,score세 가지 질문 유형으로 답을 받습니다. 엔드포인트 경로도/systemone입니다. - Microsoft가 고른 공개, 비공개 벤치마크 36개(147,137문항)에서 평균 정확도 83.5%로 1위였고, Jev 1.13.0은 82.3%였습니다. 보정(calibration) 점수는 92.2로 3위입니다. 반면 독립 리더보드 JevBench의 10월 10일 측정에서는 Jev급 비용, 지연 시간 상한 안에 드는 API 결정 모델 14개 중 7위(Capability 70.8)로, Jev(77.1)와 OpenAI Decisions(73.5)보다 낮았습니다.
- Microsoft Foundry와 OpenRouter에서 쓸 수 있고, 입력 100만 토큰당 $0.042이며 출력 토큰은 무료입니다. 입력은 텍스트만 받고, 컨텍스트는 32,768토큰입니다.
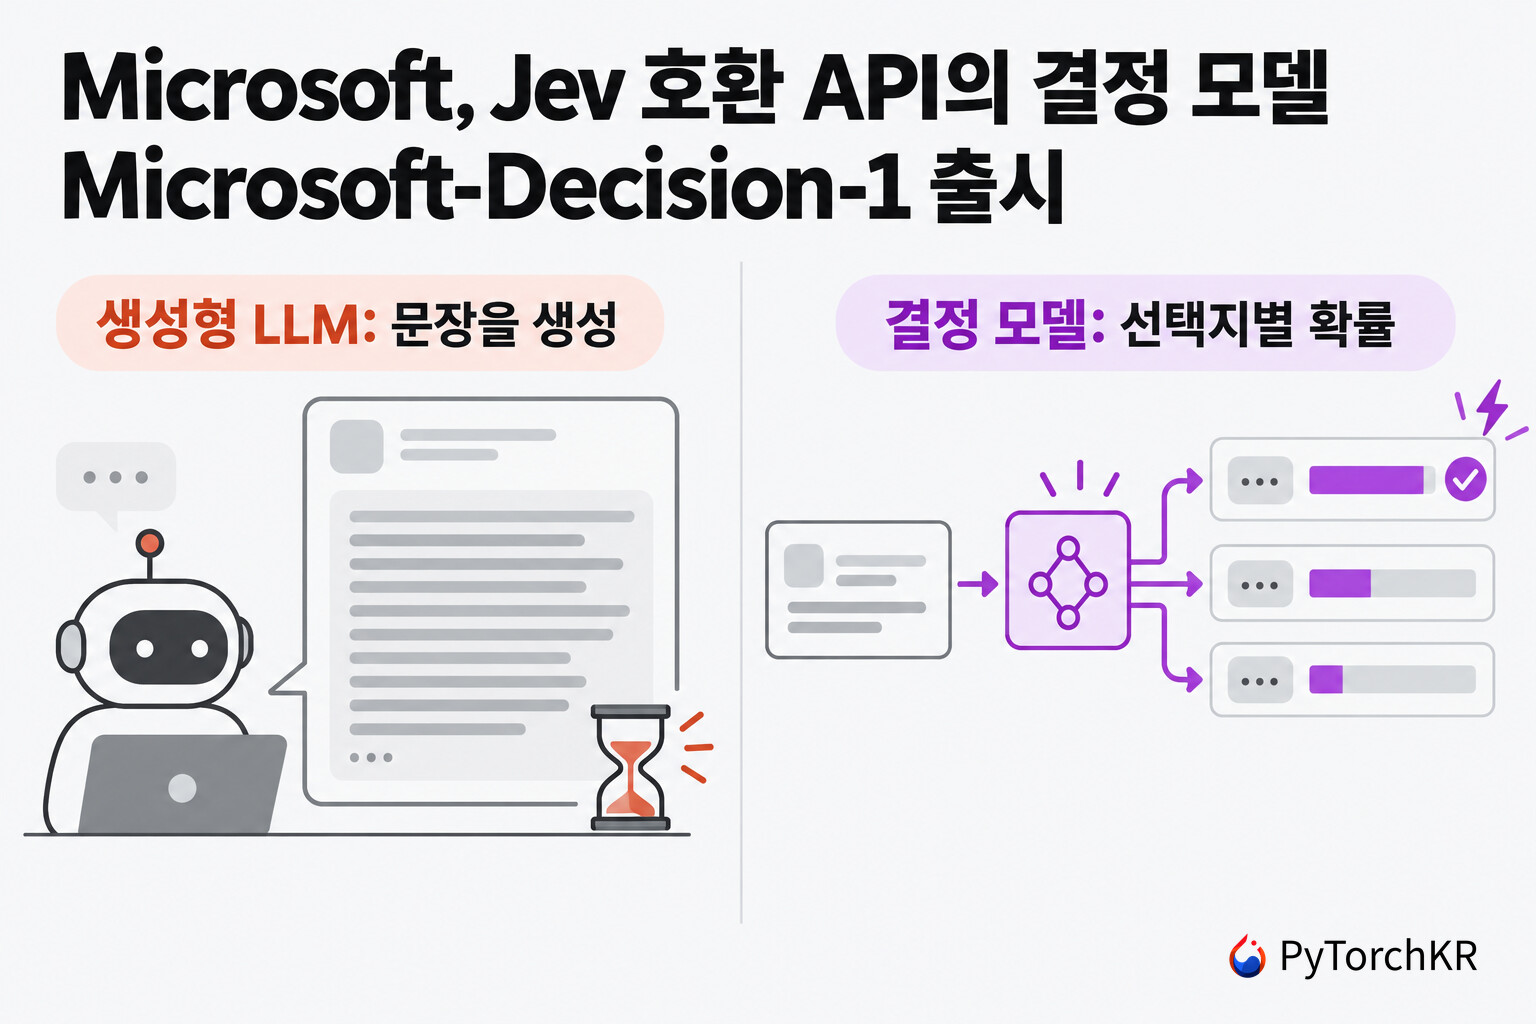
Microsoft-Decision-1 소개
Microsoft-Decision-1 은 문장을 생성하지 않고, 정해진 선택지마다 확률을 매겨 돌려주는 결정 모델(Decision Model) 입니다. 분류, 라우팅, 우선순위 지정, 검증, 워크플로우 제어처럼 프로그램이 답을 바로 받아 다음 동작을 정하는 작업을 위해 만들어졌습니다.
이 부류의 모델은 2026년 9월 TypeSafe AI가 공개한 Jev에서 시작했습니다. 그 뒤 Liquid AI가 Jev 호환 API의 d1과 오픈 가중치 d1-3B를 내놓았습니다. 오픈소스 쪽에서도 재현 모델이 수십 개 나왔고, 이들은 Decision Index와 JevBench 비교 글에서 정리했습니다. OpenAI도 DevDay에서 Decisions API를 발표했습니다. 이번 Microsoft-Decision-1은 대형 클라우드 사업자가 이 부류의 모델을 정식 출시(GA) 상품으로 낸 사례입니다.
발표 글은 Microsoft CTO 오피스의 Achint Srivastava(VP of Software Engineering)가 썼습니다. Microsoft는 Qwen3.5-9B를 단일 패스 결정 채점(single-pass decision scoring) 용으로 후학습했다고 밝혔습니다. 곧 Microsoft AI(MAI)와 OpenAI 모델 등 다른 기반 모델 위에서 다시 만들 계획이라고도 적었습니다. Foundry 모델 카드에 따르면 후학습 데이터는 Microsoft의 오픈 데이터 절차를 거친 공개 데이터셋과 Microsoft가 만든 합성 데이터이고, 고객 데이터는 쓰지 않았습니다. 모델 카드의 출시일은 10월 8일입니다.
이 글은 발표 글, Microsoft Learn 사용 문서, Foundry 모델 카드를 바탕으로 정리했습니다. 발표 글이 화면에서만 보여 준 차트 위젯 6개와 데모 영상 3개의 수치도 함께 확인했고, JevBench의 독립 측정 결과를 덧붙였습니다.
요청 형식: Jev와 같은 state, questions, 세 가지 질문 유형
Microsoft Learn 문서는 이 모델의 요청 방식을 "system-one API와 비슷하다" 고 설명합니다. 실제로 필드 구성을 TypeSafe 문서의 Choice 페이지와 비교하면 같습니다. 요청은 평가할 내용인 state(텍스트나 JSON), 배포 이름인 model, 질문 사전인 questions 로 이루어집니다. 질문마다 type, instructions, criteria 를 적습니다. Jev의 엔드포인트가 https://api.typesafe.ai/v1/systemone 이고, Microsoft의 엔드포인트는 <Foundry 리소스 엔드포인트>/providers/microsoft/v1/systemone 입니다.
필드 구성만 보면, Jev용으로 짠 요청 본문은 엔드포인트, 인증 헤더, model 값을 바꿔 그대로 보낼 수 있는 구조입니다. 응답은 Microsoft 문서에 따르면 질문 이름을 키로 쓰는 answers 객체에 배포된 모델 이름과 토큰 사용량이 붙는 형태입니다. 다만 Jev 응답에 있는 confidence 필드는 Microsoft 문서에 언급되지 않으므로, 응답을 파싱하는 코드는 직접 확인해야 합니다.
| 질문 유형 | 묻는 것 | 돌려받는 값 | 문서의 사용 예 |
|---|---|---|---|
noul |
참인가? | 0~1 사이의 확률 | 도구 호출이 운영 데이터를 건드리는가, 문서에 프롬프트 인젝션이 있는가 |
choice |
어느 선택지인가? | 선택된 항목 하나와 항목별 확률 | 티켓 라우팅, 의도 분류, 모델이나 도구 선택 |
score |
얼마나인가? | 순서 척도 위의 값과 단계별 확률 | 대기열 우선순위, 모델 출력 채점, 심각도 평가 |
아래는 문서의 choice 예제입니다. 지원 티켓을 어느 팀으로 보낼지 묻습니다.
curl "$AZURE_ENDPOINT/providers/microsoft/v1/systemone" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $AZURE_ENTRA_TOKEN" \
  -d '{
    "model": "'"$DEPLOYMENT_NAME"'",
    "state": "The API returns 500 on every call.",
    "questions": {
      "team": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
          "billing": "Charges, invoices, and refunds",
          "engineering": "Bugs, errors, and outages",
          "support": "How-to and account questions"
        }
      }
    }
  }'
model 에는 모델 이름이 아니라 내가 만든 배포 이름 을 넣습니다. score 의 결과는 단계 번호를 확률로 가중 평균한 값입니다. 예를 들어 네 단계 척도라면 0부터 3 사이의 값이 나오고, 단계와 단계 사이 값도 나올 수 있습니다. 문서는 이 점수를 절대 등급보다는 상대 순서와 임계값 판단에 쓰라고 권합니다. 같은 state 에 대한 질문 여러 개는 한 요청으로 묶을 수 있습니다. 문서의 예는 한 티켓에 대해 담당 팀(choice), 심각도(score), 재문의 여부(noul)를 한 번에 묻습니다.
Microsoft가 공개한 벤치마크: 정확도 1위, 보정 3위
발표 글의 첫 차트는 정확도, 지연 시간, 보정 점수를 한 표에 놓았습니다. 정확도는 학습에 쓰지 않은 공개, 비공개 벤치마크 36개(147,137문항)의 평균입니다. 발표 글은 처음 게시된 뒤 정확도와 보정 비교에 Jev를 추가하도록 수정되었습니다(편집자 주). 비교 대상은 Jev 1.13.0, OpenAI의 GPT-6 Luna Decisions, 그리고 오픈 가중치 결정 모델 다섯 개입니다. Quyet-1.0-Large, Surogate Rune 26B-A4B, deck-31B, H2O-Lightning-4B, Strands-Decider 2B가 여기에 들어갑니다.
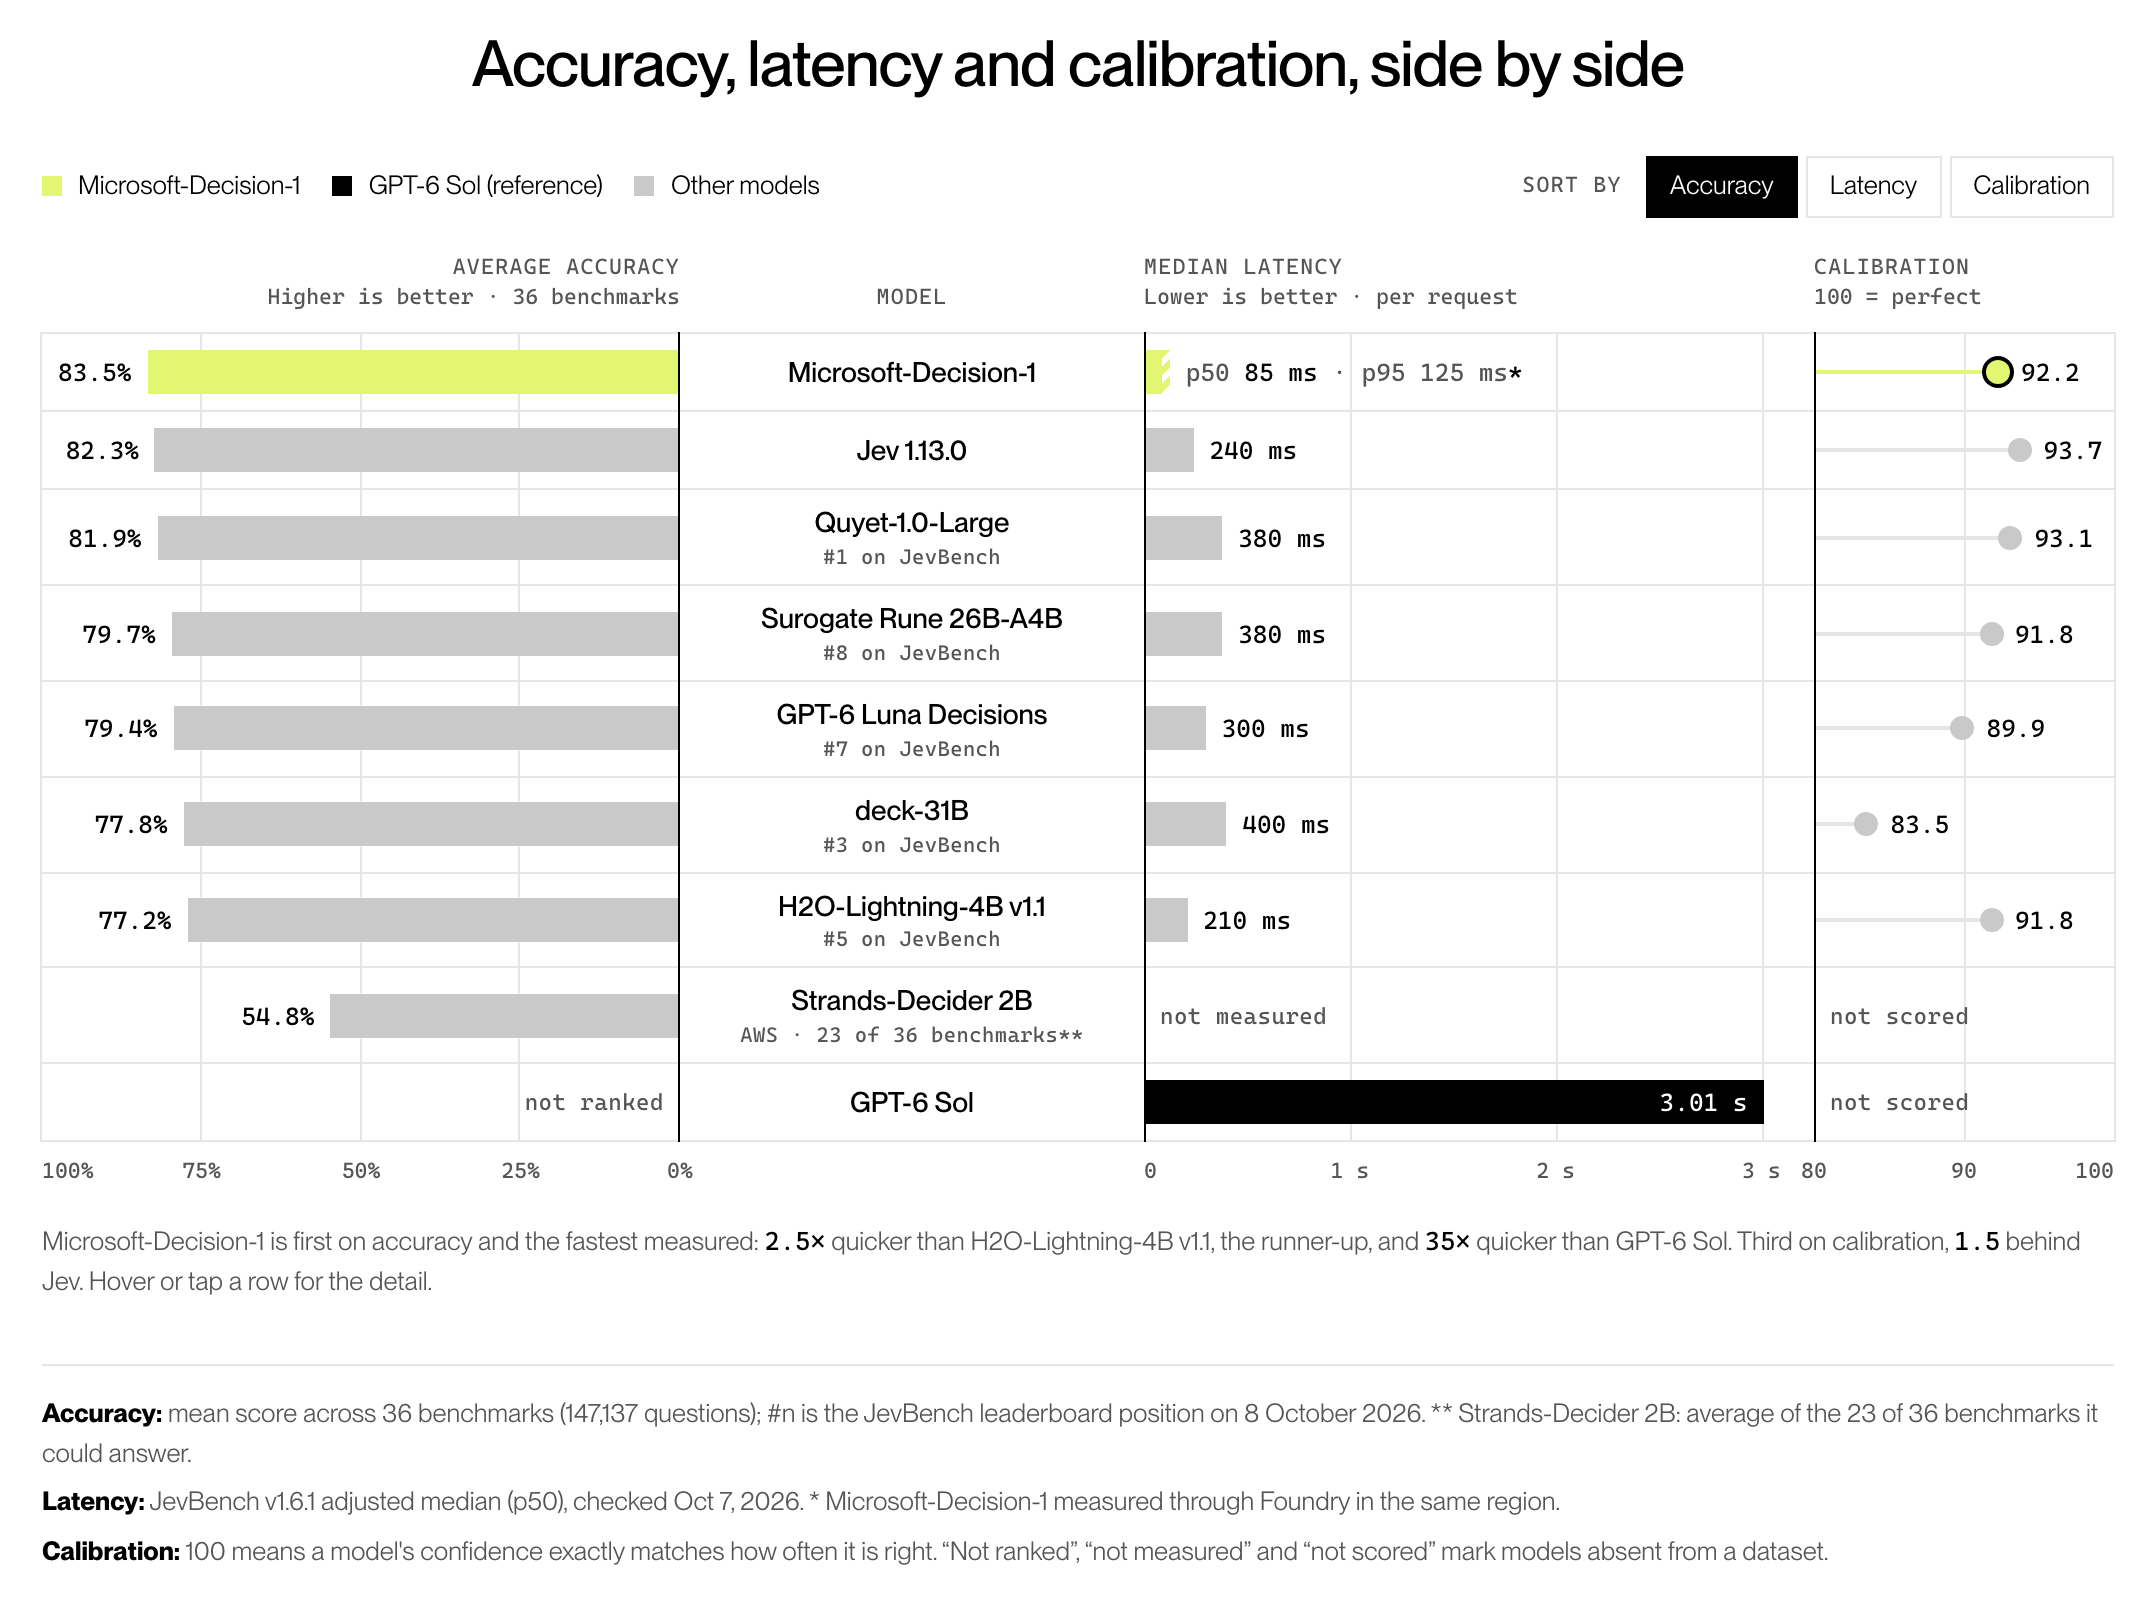
| 모델 | 평균 정확도 | 지연 시간 p50 | 보정 점수 |
|---|---|---|---|
| Microsoft-Decision-1 | 83.5% | 85ms (p95 125ms, Microsoft 측정) | 92.2 |
| Jev 1.13.0 | 82.3% | 240ms | 93.7 |
| Quyet-1.0-Large | 81.9% | 380ms | 93.1 |
| Surogate Rune 26B-A4B | 79.7% | 380ms | 91.8 |
| GPT-6 Luna Decisions | 79.4% | 300ms | 89.9 |
| deck-31B | 77.8% | 400ms | 83.5 |
| H2O-Lightning-4B v1.1 | 77.2% | 210ms | 91.8 |
| Strands-Decider 2B | 54.8% (36개 중 23개만 응답) | 측정 안 함 | 측정 안 함 |
| GPT-6 Sol | 순위 없음 | 3.01s | 측정 안 함 |
정확도 차이는 크지 않습니다. 2위 Jev와는 1.2%p, 3위 Quyet-1.0-Large와는 1.6%p입니다. 보정 점수는 1.5점 차이로 Jev가 앞섭니다. 보정(calibration) 은 모델이 말한 확률이 실제 정답률과 얼마나 맞는지를 나타냅니다. 문서는 "90%라고 예측한 결정은 대표적인 사례 10번 중 9번 정도 맞아야 한다" 고 설명합니다. 확률을 기준으로 자동 처리, 보류, 사람 검토를 가르는 애플리케이션이라면 정확도만큼 이 점수를 봐야 합니다.
비교 조건에서 확인할 점
이 차트를 읽을 때 확인해야 할 조건이 세 가지 있습니다.
첫째, 36개 벤치마크는 Microsoft가 직접 고른 시험지 입니다. 발표 글은 라우팅, 순위, 긴 컨텍스트, 다국어, 분포 밖(out-of-distribution) 과제, 추론(reasoning), 안전을 포함한다고만 밝혔고, 벤치마크 목록과 채점 코드는 공개하지 않았습니다. 차트에 붙은 #1 on JevBench 같은 표기는 다른 모델들의 JevBench 순위(10월 8일 기준)일 뿐, Microsoft-Decision-1의 JevBench 순위가 아닙니다. JevBench가 직접 잰 Microsoft-Decision-1의 결과는 아래 절에 정리했습니다.
Foundry 모델 카드의 Benchmarks 탭은 결과를 "선도적인 결정 모델과 대등하고(on par), 같은 방법으로 평가한 다른 오픈 결정 모델보다 앞선다" 고 더 조심스럽게 적었습니다. 같은 탭은 추론, 규칙 적용, 프롬프트 형식 변화에 대한 견고성이 가장 강하고, 전문 분야 지식 과제에서 약하다고 밝혔습니다. 비교한 모델 모두에 같은 하네스로 같은 요청을 보냈고 쌍체 통계 검정으로 결과를 확인했다고도 적었지만, 벤치마크 목록과 결과 파일은 이 탭에도 없습니다.
둘째, 지연 시간은 측정 주체와 방식이 서로 다릅니다. 다른 모델의 수치는 JevBench v1.6.1의 adjusted median 이고, Microsoft-Decision-1만 Microsoft가 같은 리전의 Foundry를 통해 직접 쟀습니다. JevBench는 직접 띄운 오픈 모델의 지연 시간을 2배로 늘리고 0.15초를 더하는 보정으로 API 서비스와 비교할 수 있게 맞춥니다.
JevBench 데이터에 따르면 H2O-Lightning-4B v1.1은 RTX 5090 한 장에서 루프백으로 잰 원래 p50이 약 29ms였고, 보정 후 값이 210ms입니다. JevBench도 이 보정이 하드웨어 차이를 맞춘 값이 아니라 가정이라고 밝혔습니다. 그러므로 "H2O-Lightning-4B보다 2.5배 빠르다" 는 문장은 같은 조건에서 잰 비교가 아닙니다. 운영사가 직접 서비스하는 Jev 1.13.0(240ms)은 JevBench도 보정 없이 쟀으므로, API 대 API 비교로는 이쪽이 더 가깝습니다.
셋째, 정확도 표에 범용 LLM이 없습니다. 발표 글은 "LLM과 다른 결정 모델을 모두 능가한다" 고 썼습니다. 그러나 차트에서 GPT-6 Sol은 지연 시간 기준선으로만 나오고, 정확도 칸은 not ranked 입니다. LLM과의 품질 비교는 뒤에 나오는 사내 사례에서만 나옵니다. 거기서도 표현은 "대등하다(competitive)" 입니다.
독립 측정: JevBench에서는 Jev급 API 결정 모델 14개 중 7위
JevBench는 Microsoft-Decision-1을 10월 10일에 Foundry API로 직접 측정했습니다. 공통 문항 1,500개를 썼고, 다른 API 행과 같은 방식으로 채점했습니다. JevBench의 Capability는 지능(intelligence)과 보정 점수의 평균이고, 여기에 비용과 속도까지 더한 종합 점수(Composite)를 따로 냅니다. Capability 순위는 비용과 지연 시간이 Jev 기준의 상한 안에 드는 API 모델 14개 안에서 매깁니다. 아래 표는 그중 이 글과 관련 있는 모델만 골랐습니다.
| 모델 | Capability (14개 중 순위) | 지능 | 보정 | p50 지연 | 1천 건당 비용 |
|---|---|---|---|---|---|
| Jev 1.13.0 | 77.1 (2위, 기준 모델) | 63.6 | 90.6 | 0.24s | $0.032 |
| Liquid AI d1 | 74.4 (3위) | 62.1 | 86.8 | 0.3s | $0.017 |
| OpenAI Decisions | 73.5 (6위) | 56.9 | 90.1 | 0.3s | $0.052 |
| Microsoft-Decision-1 | 70.8 (7위) | 57.2 | 84.4 | 0.5s | $0.019 |
이 14개 중 1위는 Levanto Labs의 Sage 1.3.0(78.6)입니다. 상한을 넘는 모델 중에는 추론을 켠 wity-1(79.3)처럼 점수가 더 높은 모델도 있습니다. Microsoft-Decision-1은 비용 점수가 높아 종합 점수로는 27개 API 행 중 6위(69.1)였습니다.
다만 Microsoft 차트와 결과가 가장 크게 갈리는 곳은 보정 점수입니다. Microsoft 측정에서는 Jev와 1.5점 차이였지만, JevBench에서는 84.4 대 90.6입니다. 지연 시간도 Microsoft가 같은 리전에서 잰 85ms와 달리 JevBench에서는 0.5초였습니다. JevBench 페이지에는 측정 리전이나 배포 유형이 적혀 있지 않습니다. OpenAI Decisions는 600문항으로 측정해 점수를 보정(equated)했으므로, 이 행과의 비교는 조건이 완전히 같지 않습니다.
JevBench는 세부 분석도 공개했습니다. 이 값은 무작위 수준을 0, 만점을 100으로 맞춘 점수이고, 종합 점수에는 들어가지 않습니다. 질문 유형별로는 공개 문항 기준 choice 82.4, score 62.7, noul 51.5로, 참/거짓 확률을 묻는 noul 이 가장 약했습니다. 비공개 문항에서는 세 유형 모두 더 낮았습니다(65.8, 45.6, 37.6). 용도별로는 검색 결과 관련도(Search & retrieval) 85.3, LLM 가드레일 69.7, 모델 라우팅 64.3이 높았고, 수요 예측(Demand forecasting) 0.0, 코드 린팅 19.8, 금융 범죄 29.0이 낮았습니다. 주제별로는 수학과 숫자(Math & numbers)가 20.7로 가장 낮았습니다.
견고성과 안전성: 수치는 본문에만 있다
발표 글은 품질 외에 두 가지를 더 쟀습니다. 견고성 은 같은 뜻의 입력에 같은 결정을 내리는지를 봅니다. 발표 글은 운영 환경에서 상태와 지시문이 다르게 표현되고, 선택지 설명이나 순서, 키 이름이 바뀌고, 형식 잡음이 섞인다고 설명합니다. 시험에서는 같은 요청을 여덟 가지 방식으로 바꿔 보냈고, 그 결과 평균 1.3%의 경우에 결정이 바뀌었고, 선택지 설명을 바꿔 쓰거나 순서를 뒤집거나 섞었을 때는 한 번도 바뀌지 않았다고 합니다. 안전성(Safety) 은 유해 콘텐츠, 탈옥 시도, 프롬프트 인젝션을 다루는 11개 벤치마크의 5,250개 요청으로 시험했습니다. 발표 글은 "유해한 행동을 거부하면서 높은 유용성을 유지했다" 고만 적었고, 거부율이나 과잉 차단 비율은 밝히지 않았습니다.
데모와 사내 적용 사례
의도 분류 데모: 10건에 182ms와 6.24s
첫 번째 데모는 사용자 요청 10건을 지원 범주에 맞추는 의도 분석(intent analysis) 입니다. 영상 화면에서 Microsoft-Decision-1은 10건을 182ms에 끝냈고, GPT-6 Sol은 6.24초가 걸렸습니다. 두 모델이 붙인 범주는 10건 모두 같았습니다. 다만 10건은 시연용 예시이므로, 정확도를 판단할 근거로 쓰기는 어렵습니다.
컴퓨터 사용 데모: 결정 모델이 행동을 고르고 Sol이 글을 쓴다
두 번째 데모는 테스트용 쇼핑몰에서 배낭을 사고 배송 정보를 채워 주문을 마치는 브라우저 작업입니다. 화면을 보면 비교 대상은 Microsoft-Decision-1 단독이 아닙니다. 한쪽은 Microsoft-Decision-1과 Sol의 조합으로, 클릭이나 입력 같은 행동은 Microsoft-Decision-1이 고르고 입력할 글은 Sol이 범위를 정해 씁니다. 다른 쪽은 Sol 추론 에이전트 단독입니다. 둘 다 10단계 만에 주문을 끝냈고, 모델 시간은 13.9초 대 35.1초, 추정 비용은 $0.0034 대 $0.0140이었습니다. 실행 환경은 로컬 테스트 페이지(127.0.0.1)였고, 데모 화면에는 "Built to explore. Not to benchmark." 라는 문구가 있습니다.
사내 사례 네 가지
Microsoft는 사내에서 시험한 결과도 네 가지 공개했습니다. 모두 Microsoft 내부 측정이며, 데이터셋이나 평가 방법은 공개되지 않았습니다.
- 데이터 라벨링 (XBOX Research): 설문, Steam, Twitter/X에서 모은 1만 건 이상의 피드백을 연구자가 정한 주제로 분류했습니다. 품질은 GPT-6 Sol과 대등했고, 속도는 14배 이상 빠르고 비용은 200분의 1 수준이었다고 합니다. 차트에 나온 세 데이터셋(리뷰 753건, 341건, 게시물 1,030건)에서는 한 건당 143~188ms 대 2.6~2.8초였습니다. 비용은 데이터셋당 0.5~1.3센트 대 $1.03~$2.92입니다.
- 품질 관리 (Copilot 팀): 채팅과 에이전트 응답의 품질을 채점하는 작업에서 GPT-5.6 Luna와 대등하고 100배 빨랐다고 합니다.
- 장애 대응: 온콜 엔지니어가 로그, 티켓, 메시지 등에서 관련 지식을 찾는 작업에서 LLM보다 더 낫고 빨랐다고만 밝혔고, 수치는 없습니다.
- 과학적 발견 (Microsoft Discovery): 에이전트가 이전 실험을 루브릭으로 채점하고 계획을 고치는 적응형 재계획(adaptive replanning) 기능에 썼습니다. LLM 채점보다 46배 일관되고 3배 빨랐으며, 재계획 전체로는 4배 가까이 빨라졌다고 합니다.
발표 글은 이 밖에 시도해 볼 만한 용도 16가지도 나열했습니다. 에이전트의 다음 단계를 계속, 중단, 재시도, 위임 중에서 고르는 에이전트 제어, 요청마다 모델을 고르는 모델 라우팅, AI 응답 채점, 검색 관련도 평가, 코드 스캔, 화면에서 다음 UI 동작 고르기, 정해진 로봇 동작 중 하나 고르기 같은 항목이 들어 있습니다.
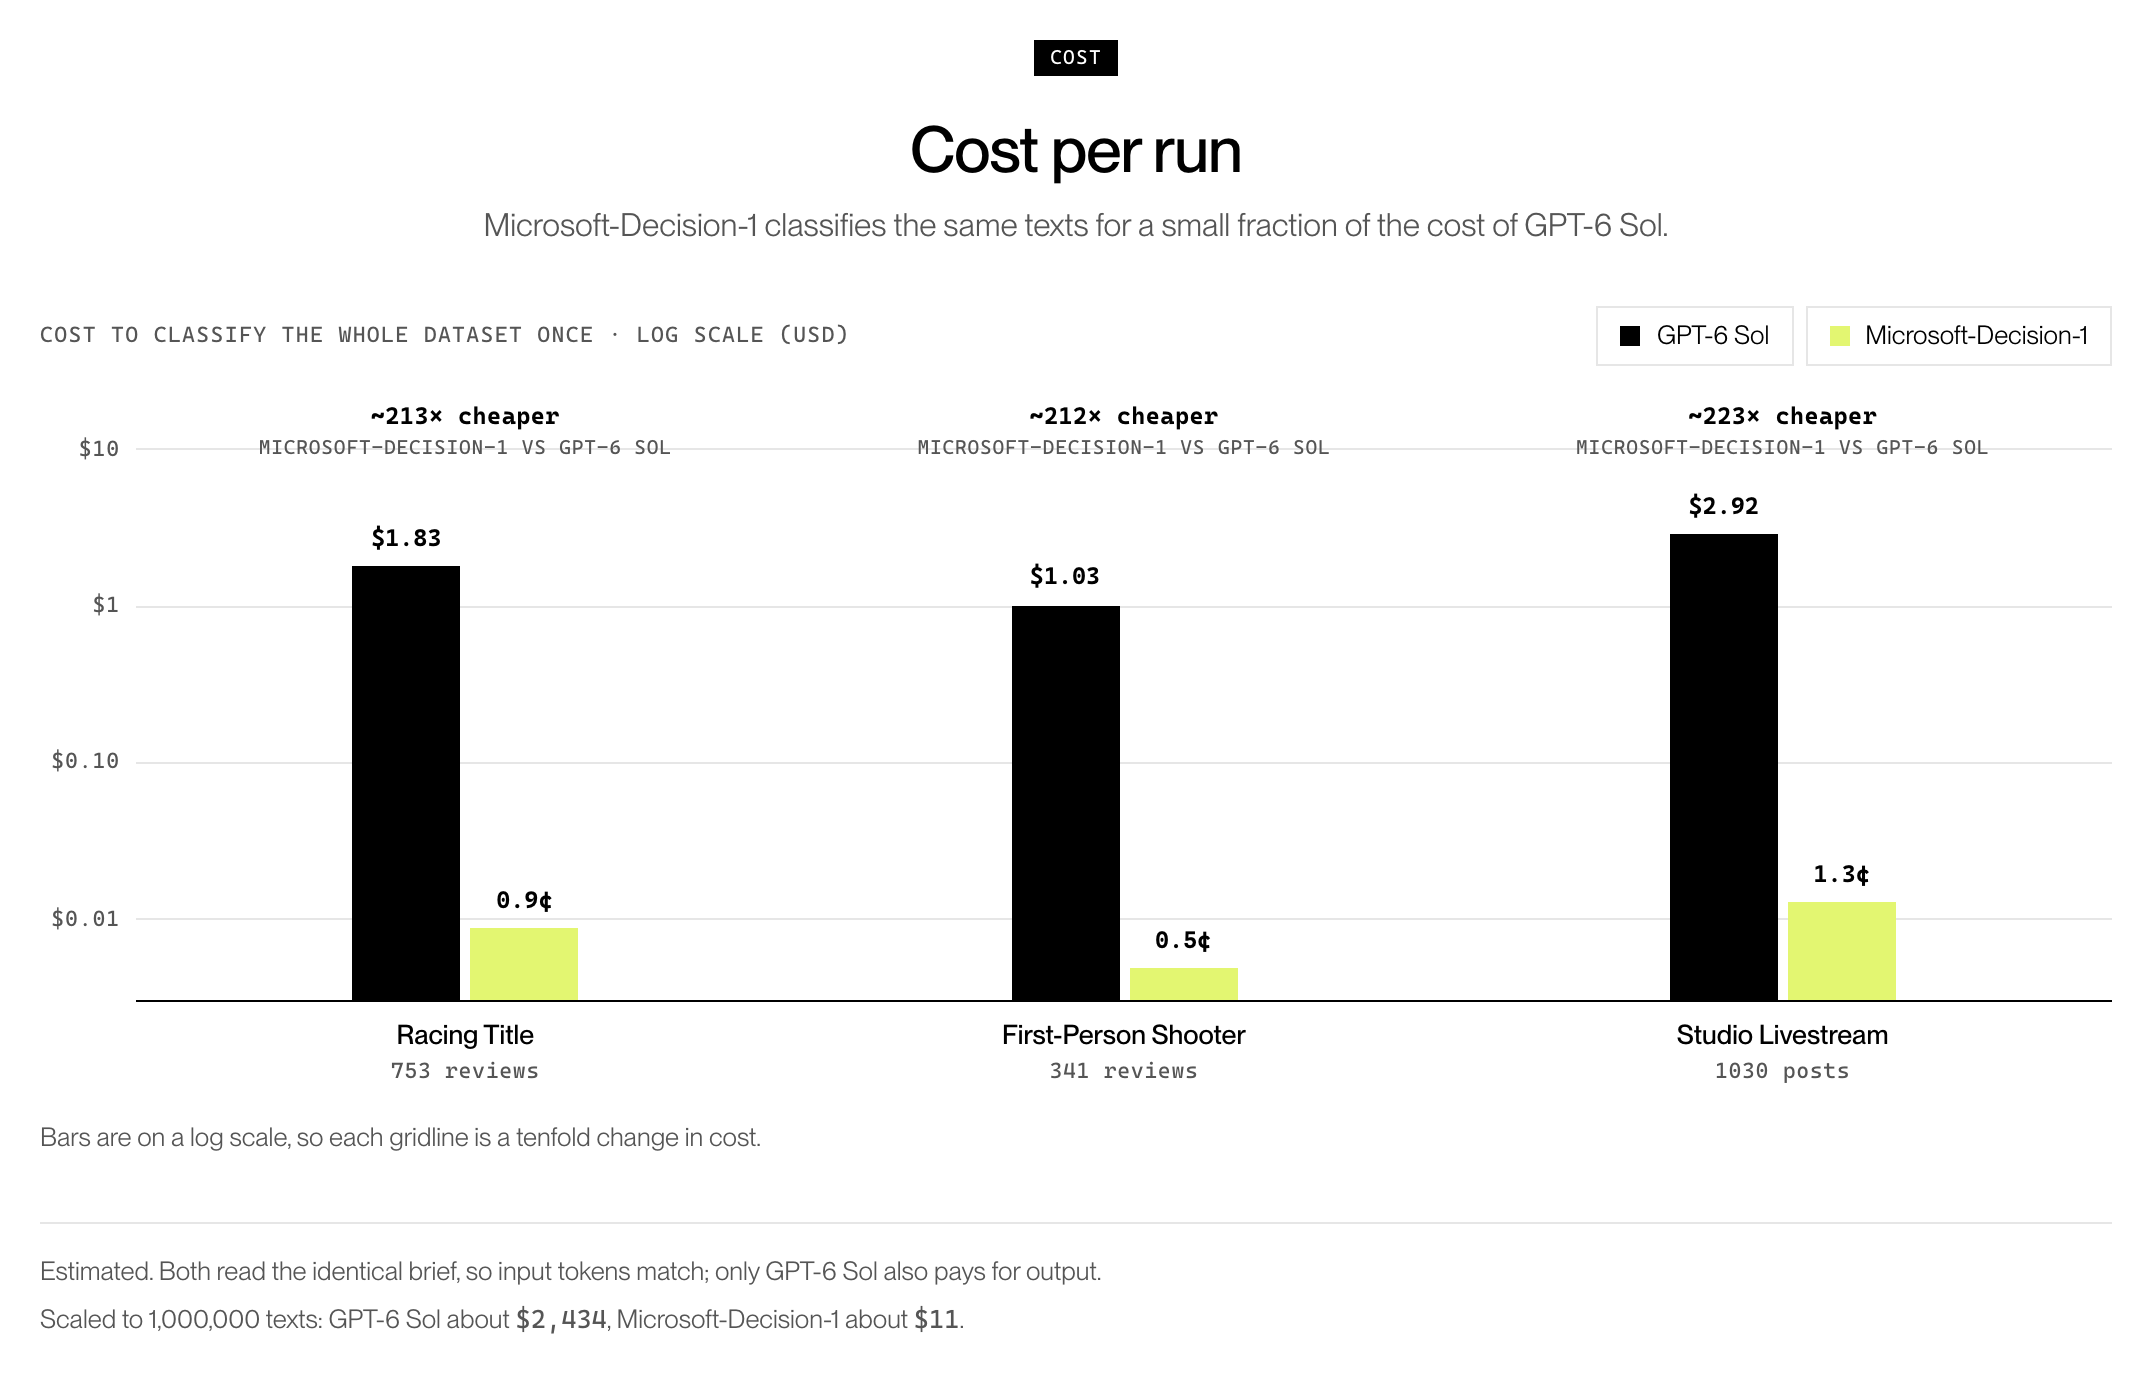
비용 차트의 수치는 추정치(Estimated)입니다. 두 모델이 같은 지시문을 읽으므로 입력 토큰은 같고, 출력 비용은 GPT-6 Sol만 낸다는 가정입니다. 이 가정으로 100만 건을 분류하면 GPT-6 Sol은 약 $2,434, Microsoft-Decision-1은 약 $11이 듭니다. 비용 차이 대부분은 출력 토큰에서 나옵니다. 따라서 LLM 쪽에서 출력을 선택지 하나로 짧게 묶으면 격차는 줄어듭니다.
가격과 사용 방법
가격 은 입력 100만 토큰당 $0.042이고, 출력 토큰은 받지 않습니다. 결정 모델은 문장을 생성하지 않으므로, 비용은 사실상 state 와 질문 정의의 길이로 정해집니다. 쓸 수 있는 경로는 두 가지입니다.
- Microsoft Foundry: 모델 카탈로그에서 배포합니다. 배포 유형은
GlobalStandard와 일부 리전의DataZoneStandard입니다. 배포하려면 결제 수단이 있는 Azure 구독과 Foundry 프로젝트, 배포 권한(Cognitive Services Contributor 역할)이 필요합니다. 인증은 Microsoft Entra ID(권장)나 API 키로 합니다. 문서는 지연 시간을 줄이려면 애플리케이션과 가까운 리전에 Foundry 리소스를 두라고 권합니다. 지역성이 중요하면 가장 가까운 데이터 존의DataZoneStandard를 쓰라고 하며, 이때 추론은 그 데이터 존 안에서 처리됩니다. 다만 배포 유형이 낮은 지연 시간을 보장하지는 않으므로 직접 측정하라고 적었습니다.GlobalStandard는 추론이 어느 리전에서든 처리될 수 있어 지연 시간이 길어지거나 들쭉날쭉할 수 있다고 적었습니다. 발표 글의 85ms가 같은 리전에서 잰 값이라는 점과 함께 볼 대목입니다. - OpenRouter: 10월 11일 OpenRouter API 기준으로 제공자는 Azure 하나이고, 컨텍스트 길이는 32,768토큰, 입력 형식은 텍스트입니다.
Azure CLI로 배포하는 명령은 다음과 같습니다.
az cognitiveservices account deployment create \
  --name <ACCOUNT_NAME> \
  --resource-group <RESOURCE_GROUP> \
  --deployment-name <DEPLOYMENT_NAME> \
  --model-name "Microsoft-Decision-1" \
  --model-format Microsoft \
  --model-version "1" \
  --sku-name GlobalStandard \
  --sku-capacity 1
Learn 문서에는 레이블이 붙은 예시로 정확도와 지연 시간 중앙값을 재는 지원 티켓 분류 예제(support_ticket_classifier.py)도 있습니다. 문서는 이 예시를 실제 업무의 대표 데이터로 바꾼 뒤에 배포 결정을 내리라고 안내합니다.
문서와 모델 카드가 밝힌 한계, 도입 전 확인할 것
Microsoft Learn 문서와 Foundry 모델 카드는 알려진 한계 네 가지를 똑같이 적었습니다.
- 공정성: 기반 모델과 학습 데이터의 편향이 반영될 수 있으므로, 점수를 개인에 대한 결정의 유일한 근거로 쓰지 말라고 합니다.
- 표현 민감도: 질문과 선택지를 어떻게 쓰고 어떤 순서로 놓느냐에 따라 점수가 바뀔 수 있습니다. 질문을 잘못 써도 점수는 나옵니다.
- 신뢰성: 보정은 익숙한 유형의 과제에서 가장 잘 맞습니다. 모델은 이유를 설명하지 않고, 오래된 지식에 의존할 수 있습니다.
- 유해 콘텐츠: 안전 필터로 쓰면 미묘한 유해 콘텐츠를 놓치거나 무해한 콘텐츠를 막을 수 있습니다.
모델 카드는 성능이 떨어질 수 있는 영역으로 영어가 아닌 언어(특히 자원이 적은 언어), 의료, 법률, 금융 같은 전문 분야, 서로 겹치거나 모호한 선택지를 꼽았습니다. 번역, 요약, 대화, 열린 질문 답변처럼 닫힌 선택지가 없는 작업과, 입력에 없는 지식이 필요한 작업은 사용 범위 밖이라고 밝혔습니다. 신용, 고용, 주거, 보험, 교육, 의료, 법적 권리처럼 사람에게 중대한 결정에서는 이 모델을 유일한 판단 근거로 쓰지 말고 사람이 실질적으로 검토하라는 권고는 Learn 문서와 모델 카드에 함께 있습니다.
표현 민감도 항목은 발표 글의 견고성 결과(선택지 순서를 섞어도 결정이 바뀌지 않음)와 결이 다릅니다. 발표 글은 평균 결정 변경률을 말하고, 문서는 점수 자체가 움직일 수 있다는 점을 말합니다. 문서가 권하는 대로 선택지 순서를 무작위로 바꿔 결과가 달라지는지 직접 시험하는 편이 안전합니다. 확신할 수 없을 때 고를 수 있도록 cannot tell 같은 기권 선택지를 넣는 것도 문서의 권고입니다.
한국어 사용자라면 언어 지원도 확인해야 합니다. 모델 카드에 따르면 Microsoft-Decision-1은 영어에 최적화되어 있고, 한국어, 중국어, 일본어를 포함한 22개 언어로 평가했습니다. 언어별 점수는 공개하지 않았습니다. 기반 모델인 Qwen3.5-9B는 200개가 넘는 언어를 지원하지만, 카드는 언어마다 커버리지, 품질, 보정이 다를 수 있다고 적었습니다. 확률 임계값도 작업, 언어, 도메인, 위험 수준에 맞춰 따로 정하라고 권합니다.
JevBench의 언어별 분석에서 Microsoft-Decision-1의 한국어 점수는 33.1(75문항)로, Jev(29.8)와 OpenAI Decisions(23.8)보다 높았습니다. Jev급 14개 중에서는 Mercury Decide(42.8)와 Sage 1.3.0(36.1)에 이어 세 번째입니다. 그러나 같은 모델의 영어 점수 56.8보다는 크게 낮고, 언어별 문항이 100개 미만이라 참고 수준입니다. 한국어 티켓이나 리뷰를 분류하려면 레이블이 붙은 한국어 표본으로 정확도와 보정을 먼저 재 보시기 바랍니다.
결정 모델을 이미 쓰고 있다면, Microsoft-Decision-1의 실질적인 의미는 같은 요청 형식을 Azure의 계약, 리전, 인증 체계 안에서 쓸 수 있게 되었다는 점입니다. 성능 우위는 Microsoft가 고른 시험지 기준이고 차이도 1~2%p 수준입니다. 독립 측정인 JevBench에서는 Jev와 OpenAI Decisions보다 낮았으므로, 도입 전에 내 데이터로 비교해 보는 것이 맞습니다. 여러분은 분류나 라우팅에 결정 모델과 LLM 중 어떤 것을 쓰고 계신가요?
 Introducing Microsoft-Decision-1, our model for fast decision-making 소개 블로그
 Deploy and use Microsoft-Decision-1 in Microsoft Foundry 문서
 Microsoft Foundry의 Microsoft-Decision-1 모델 카탈로그
 JevBench의 Microsoft-Decision-1 측정 결과
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
Liquid AI, 문장 생성 대신 Jev 호환 API로 분류 / 라우팅 / 점수를 처리하는 결정 모델 d1 공개
-
Liquid AI, 엣지 기기에서 한 번의 순전파로 판단하는 결정 모델 d1-3B와 d1-omni-600M 공개
-
Jev와 유사한 오픈소스 결정 모델에 대한 정리: Decision Index와 JevBench로 비교한 결정 모델 성능 비교
-
OpenAI, API 가격을 절반으로 낮춘 GPT-6 Sol과 Luna 출시: 추론 강도별 과제당 비용으로 본 성능과 정렬
-
OpenAI DevDay 2026 발표 25가지 총정리: 상시 에이전트 dots부터 GPT-6.1 Sol, 플러그인 확장까지
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다. 
이 글은  파이토치 한국 사용자 모임
 이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일
 로도 보내드립니다!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
