핵심 요약
- NVIDIA가 Cosmos 3 인터랙티브 월드 시뮬레이션 소개 글과 기술 보고서로 Cosmos3-Nano(16B) 기반 체크포인트 4종을 소개했습니다. 자율주행용 Transfer-Auto와 Sim-Auto, 로봇용 Sim-Transfer와 Sim-Bimanual이며, 가중치는 OpenMDW-1.1 라이선스로 상업적 이용이 가능합니다.
- 핵심은 영상 전체를 한 번에 만드는 양방향 생성 모델을 4단계 사후 학습으로 짧은 조각 단위의 인과적 생성 모델로 바꾼 것입니다. 정책이나 사람이 새 행동과 제어 입력을 보내면 모델이 다음 영상 조각을 4번의 디노이징으로 생성하고, 정책은 그 영상을 다시 관측으로 받습니다.
- 실시간 여부는 모델마다 다릅니다. Sim-Bimanual은 GB300 1장(640×352)에서 48.1 FPS로 30 FPS 영상 속도를 넘습니다. Sim-Auto는 카메라 1대일 때만 GB200 1장으로 실시간 목표를 맞추고, 카메라 7대와 LiDAR는 GB200 16장으로도 16.7 FPS입니다. Sim-Transfer는 GB200 1장에서 15.85 FPS입니다.
- 빠르게 만든 만큼 품질이 줄어듭니다. Sim-Auto는 원본인 Transfer-Auto보다 FID, 영상 품질 점수, LiDAR 지표가 낮고, 영상 품질 점수와 카메라 간 일치도는 이전 세대 기준선보다도 낮습니다. 보고서는 정책 학습과 평가에 실제로 쓸 수 있는지는 별도 검증이 필요하다고 밝힙니다.
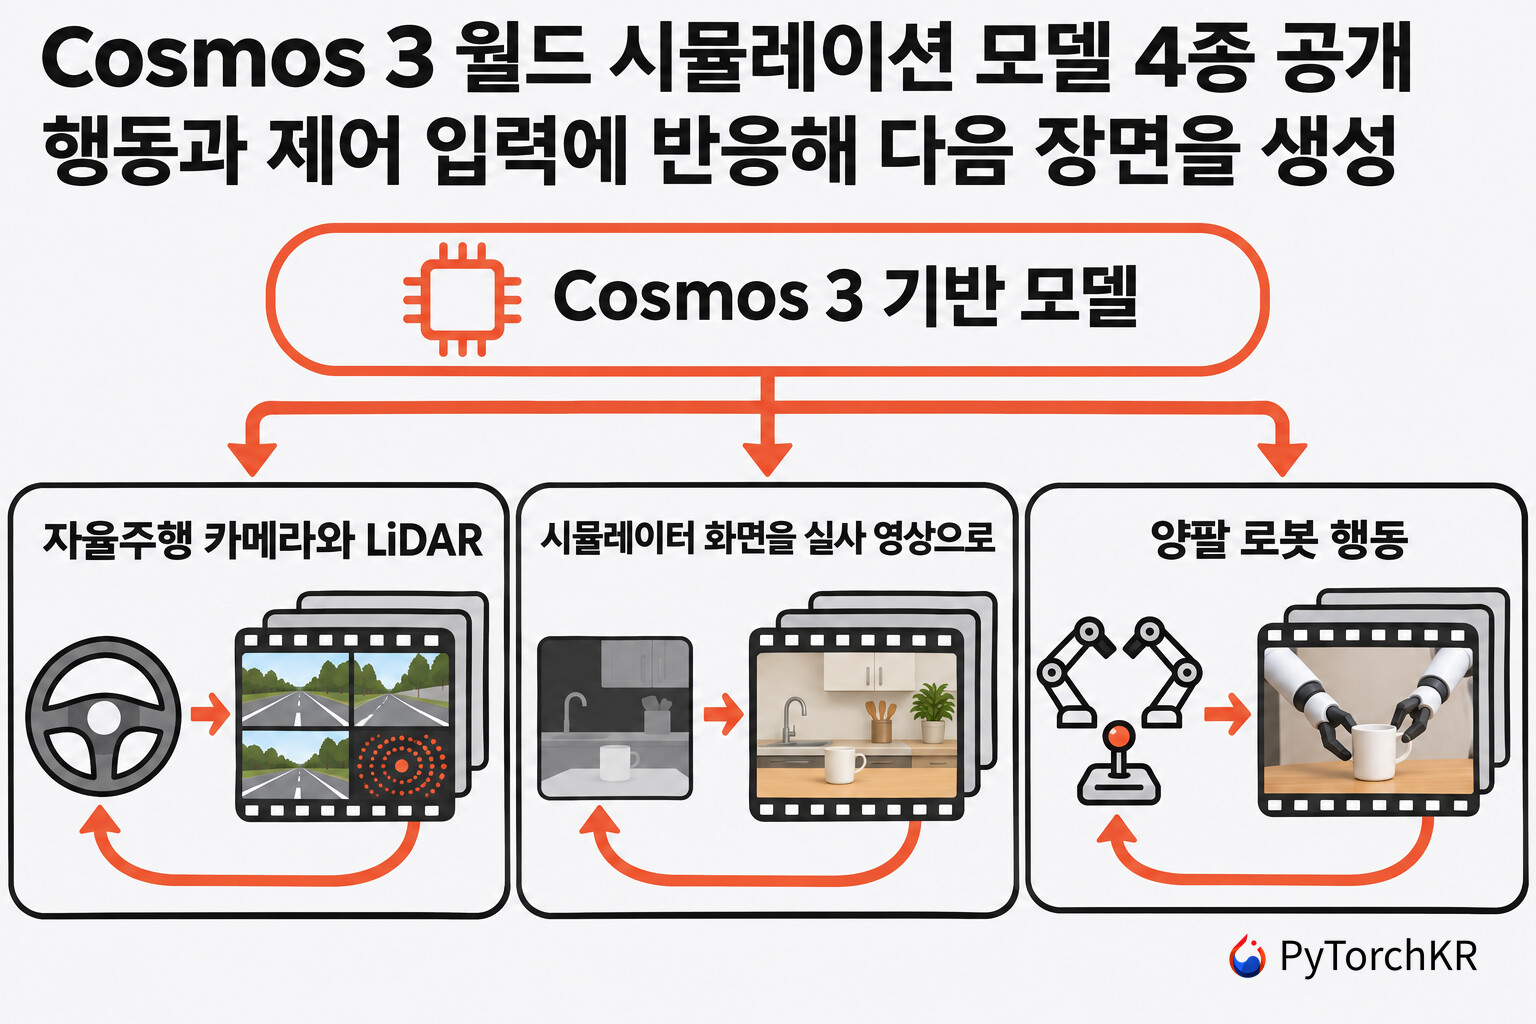
Cosmos 3 인터랙티브 월드 시뮬레이션 소개
로봇과 자율주행차의 정책(policy)을 시험하려면, 정책이 행동할 때마다 그 결과로 바뀐 장면을 다시 보여 주는 환경이 필요합니다. 정책은 카메라나 센서 관측을 입력으로 받아 다음 행동을 출력하는 모델입니다. 실제 차량과 로봇으로 이 과정을 반복하면 비용이 크고 사람과 장비가 위험해질 수 있습니다. 그래서 물리 시뮬레이터를 쓰는데, 시뮬레이터 화면은 실제 카메라 영상과 생김새가 달라서 시뮬레이터에서 잘 동작한 정책이 실제 환경에서는 다르게 동작하기도 합니다.
월드 모델(World Model) 은 이 간극을 영상 생성으로 메우려는 접근입니다. 월드 모델은 현재 관측과 행동을 받아 다음 관측을 예측하는 생성 모델입니다. NVIDIA는 2026년 5월 말 Cosmos 3(
 NVIDIA Cosmos 3: 물리 추론과 월드 생성, 행동 생성을 하나로 통합한 피지컬 AI 오픈 모델)를 공개하면서 이해, 생성, 행동 예측을 한 모델에 담았습니다. 다만 기본 Cosmos 3 생성기는 영상 클립 전체를 한꺼번에 디노이징하는 양방향(Bidirectional) 모델입니다. 클립의 뒤쪽 프레임까지 함께 보고 앞쪽 프레임을 만들기 때문에, 행동이 한 걸음씩 들어오는 상호작용 환경에는 그대로 쓸 수 없습니다. 기술 보고서의 비교 실험에서도 기본 모델은 약 120프레임 블록 단위로 영상을 만들고, 블록마다 디노이징을 50번 반복했습니다.
이번에 소개할 체크포인트 4종은 Cosmos3-Nano를 상호작용 시뮬레이터로 바꾼 예시 모델입니다. NVIDIA는 Hugging Face 컬렉션에 2026년 10월 20일 가중치를 올렸고, 11월 4일 자 기술 보고서와 11월 5일 Hugging Face 블로그 글로 설명을 공개했습니다. 기술 보고서는 시뮬레이션 모델을 Sim-Bimanual, Sim-Transfer, Sim-Auto의 세 가지 예시로 설명합니다. 네 번째 체크포인트인 Transfer-Auto는 Sim-Auto를 만드는 과정의 중간 산출물(0단계 양방향 모델)이면서, 그 자체로 오프라인 합성 데이터 생성에 쓰는 모델입니다. NVIDIA 기술 블로그는 수술 로봇용 Cosmos3-H-Embodied-Nano와 이를 인과 증류한 Cosmos3-H-Dreams도 함께 소개합니다. 두 모델은 이번 4종과 따로 공개됐고, 라이선스도 NVIDIA Open Model License로 다릅니다.
같은 범주의 공개 모델로는 앞서 소개한 LingBot-World 2.0이 있으며, 이 모델은 Sim-Bimanual의 비교 대상으로도 등장합니다.
네 체크포인트의 입력과 출력
네 모델 모두 Cosmos3-Nano에서 출발하며, 모델 카드 기준 학습 가능한 파라미터 수는 16B입니다. Hugging Face 저장소 기준 체크포인트 크기는 약 32~34GB이고 접근 승인 없이 내려받을 수 있습니다.
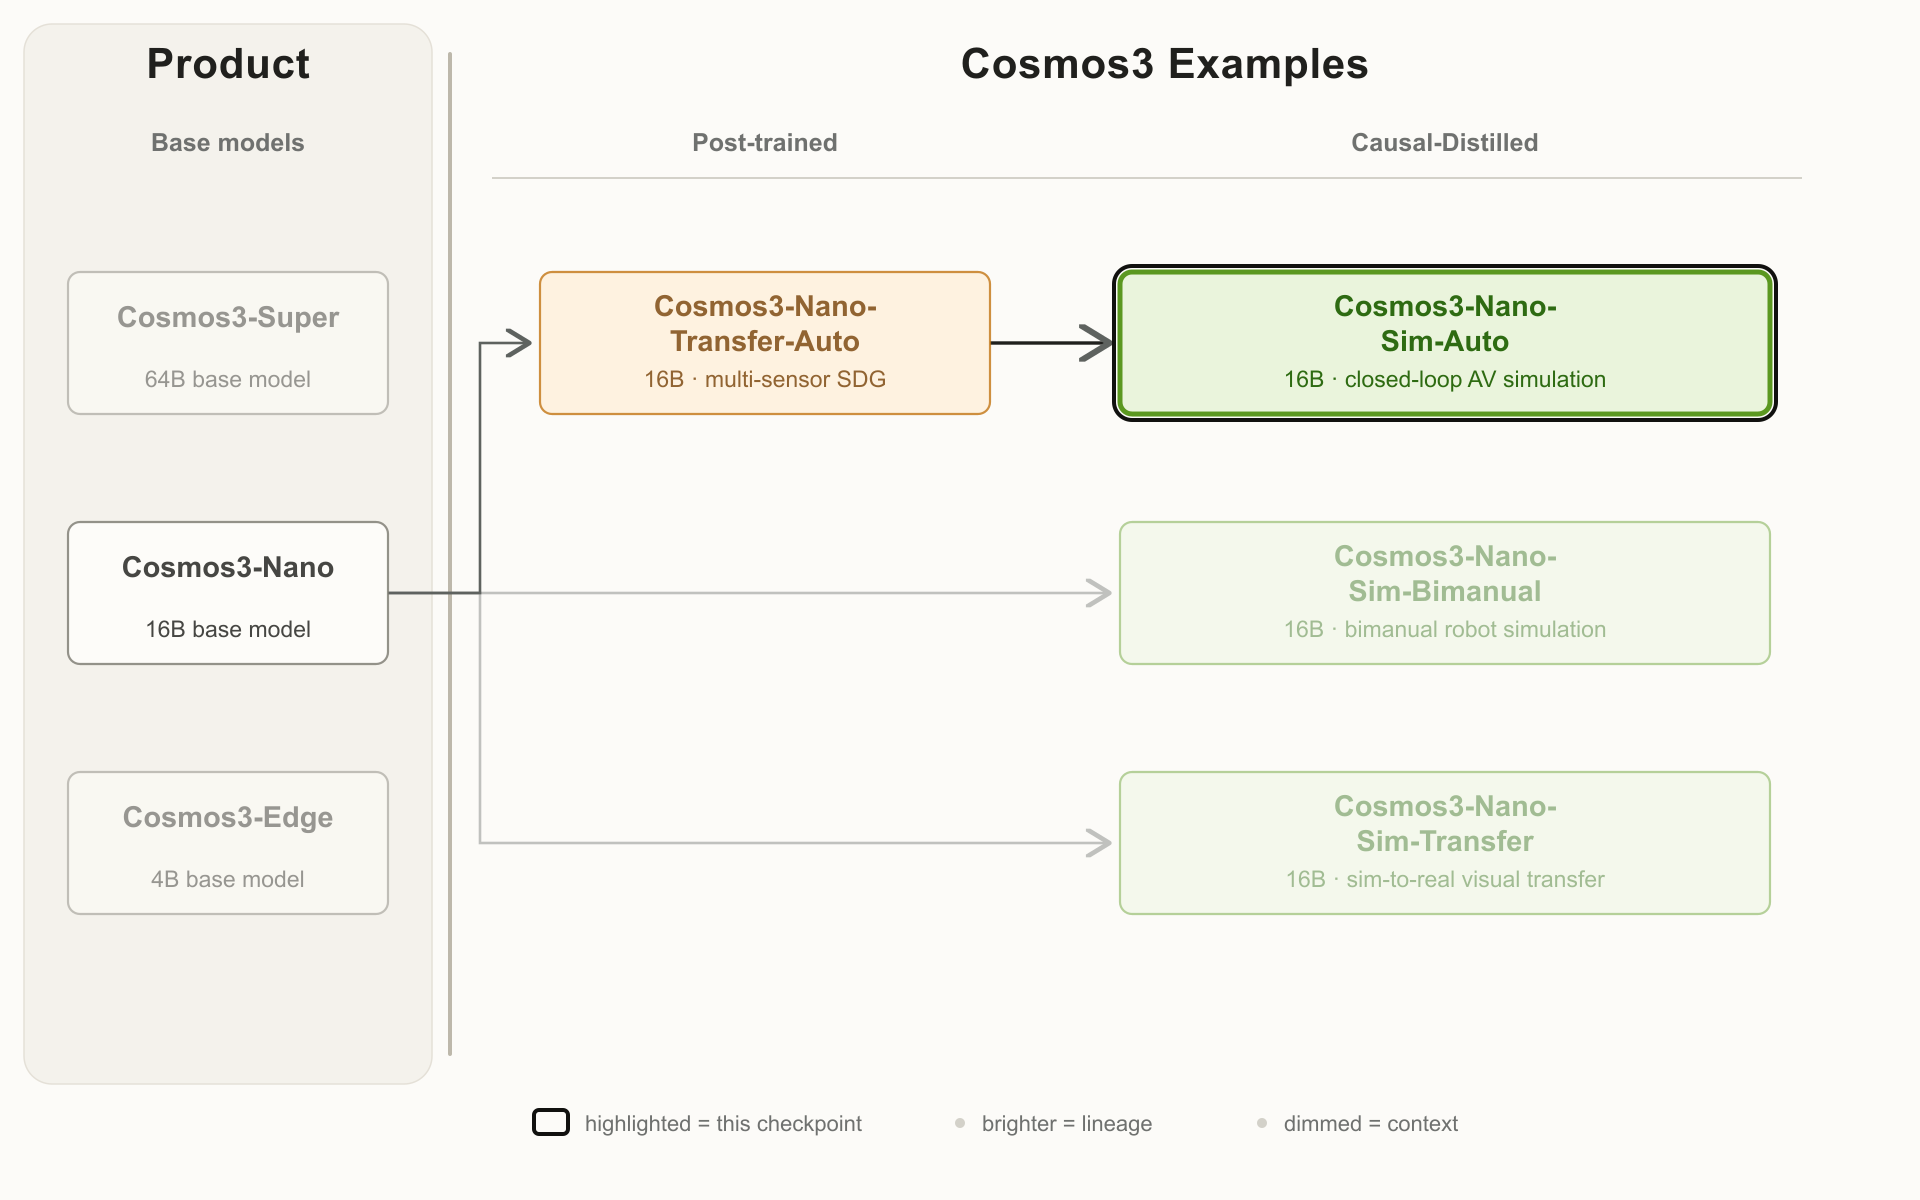
위 그림은 Sim-Auto 모델 카드에 실린 계보도이며, 굵은 테두리가 Sim-Auto입니다. Sim-Bimanual과 Sim-Transfer는 Cosmos3-Nano에서 바로 사후 학습과 인과 증류를 거치고, Sim-Auto만 Transfer-Auto를 한 번 거칩니다.
| 모델 | 입력 | 출력 | 생성 방식 | 용도 |
|---|---|---|---|---|
| Transfer-Auto | 텍스트, 카메라별 WSM 제어 영상, LiDAR용 HD 지도 range map, 선택적 첫 프레임 RGB | 최대 11개 카메라 영상과 LiDAR | 양방향, 클립 전체 생성 | 오프라인 합성 데이터 |
| Sim-Auto | Transfer-Auto와 같음 | 최대 11개 카메라 영상과 LiDAR | 인과, 0.4초(12프레임) 조각 | 폐루프 주행 시뮬레이션 |
| Sim-Transfer | 시뮬레이터가 렌더링한 깊이, 분할, 윤곽선, 블러 영상 중 하나와 텍스트 | RGB 영상 | 인과, 4프레임 조각 | 시뮬레이터 화면을 실사풍 영상으로 |
| Sim-Bimanual | 첫 이미지, 59차원 행동(로봇 팔 또는 카메라 자세), 선택적 텍스트 | 480p 영상 | 인과, 8프레임 조각 | 행동에 따른 다음 관측 예측 |
세 시뮬레이션 모델(Sim-*)은 모두 조각마다 4번의 디노이징으로 영상을 만들며, 분류기 없는 가이던스(Classifier-Free Guidance, CFG) 를 쓰지 않습니다. CFG는 조건을 준 예측과 주지 않은 예측을 모두 계산해 조건의 영향을 키우는 기법으로, 디노이징마다 계산량이 늘어납니다. Transfer-Auto는 35번의 디노이징과 CFG를 쓰는 기존 방식 그대로입니다.
자율주행: Transfer-Auto로 데이터를 만들고 Sim-Auto로 주행을 이어 갑니다
WSM 제어 영상과 Transfer-Auto
두 자율주행 모델은 장면의 구조를 WSM(World Scenario Map) 이라는 제어 영상으로 받습니다. WSM은 차선, 도로 경계, 횡단보도, 표지판, 신호등과 주변 객체의 3D 직육면체(cuboid)를 각 카메라 시점으로 렌더링한 영상입니다. 즉, WSM이 "어디에 무엇이 있고 어떻게 움직이는지"를 정하고, 텍스트 프롬프트는 날씨, 조명, 시간대 같은 겉모습을 정합니다. 같은 도로와 차량 궤적을 유지한 채 낮 장면을 비 오는 밤 장면으로 바꾸는 식으로 학습과 평가 데이터를 늘릴 수 있습니다.
Cosmos3-Nano-Transfer-Auto는 NVIDIA Hyperion 8.1 카메라 구성(전방 광각 120°, 전방 망원 30°, 측면, 후방, 어안 200° 4대 등 최대 11대)과 128채널 회전형 LiDAR를 지원합니다. LiDAR까지 만들려면 카메라 제어와 정렬된 HD 지도 range map을 함께 넣어야 합니다.
Transfer-Auto는 오프라인 생성용이라 느립니다. 모델 카드의 vLLM-Omni 측정에서 카메라 7대 720p 영상과 LiDAR 201프레임을 만드는 데 GB200 4장으로 16분 50초, H100 8장으로 22분 12초가 걸렸습니다. 생성 길이는 문서마다 다르게 적혀 있습니다. NVIDIA 기술 블로그는 최대 400프레임이라고 쓰고, 모델 카드는 시점당 최대 300프레임이라고 씁니다.
Sim-Auto: 정책의 행동에 따라 다음 0.4초를 생성합니다
Cosmos3-Nano-Sim-Auto는 Transfer-Auto를 인과적 모델로 증류한 스트리밍 버전입니다. 한 번에 0.4초 분량, 즉 카메라마다 12프레임과 LiDAR 4스윕을 생성합니다. 주행 정책이나 핸들 입력이 바뀌면 시뮬레이션 런타임이 WSM을 다시 렌더링하고, Sim-Auto가 그 WSM으로 다음 조각을 만들어 정책에게 돌려줍니다. 아래 영상은 소개 글의 Sim-Auto 절에 실린 예시로, 11개 카메라 영상과 LiDAR 조감도를 함께 보여 줍니다.

위 그림은 NVIDIA 기술 블로그에 실린 구성도입니다. 가운데 그림이 시뮬레이터가 렌더링한 WSM이고, 오른쪽이 Sim-Auto가 만든 카메라 영상과 LiDAR입니다. 다만 기술 보고서에는 이 구성으로 주행 정책을 평가한 실험이 없습니다. 보고서가 측정한 것은 미리 준비한 WSM 제어를 넣었을 때의 영상 품질과 처리 속도입니다. 사람이 직접 운전해 보려면 FlashDreams의 Interactive Drive 데모를 로컬에서 실행해야 하며, VRAM 80GB 이상 GPU, CUDA 13, Vulkan이 필요합니다.
아래 표는 기술 보고서와 모델 카드의 다중 카메라 영상 품질 결과 일부입니다. 720p, 어안 카메라를 뺀 7개 시점, 297프레임, 텍스트로만 생성(T2V)한 조건입니다.
| 모델 | Frame FID ↓ | FVD (I3D) ↓ | DOVER technical ↑ | 교차 시점 Sampson 오차 (2쌍) ↓ |
|---|---|---|---|---|
| Cosmos-Transfer2.5-2B Multiview (guidance 3) | 61.9 | 772 | 8.56 | 2.51 |
| Cosmos3-Nano-Transfer-Auto (guidance 3) | 45.5 | 488 | 9.01 | 2.01 |
| Cosmos3-Nano-Sim-Auto (4스텝, guidance 1) | 48.6 | 480 | 7.30 | 2.60 |
Transfer-Auto는 이전 세대 다중 시점 모델인 Cosmos-Transfer2.5보다 모든 지표가 좋습니다. 반면 Sim-Auto는 FID와 FVD는 기준선보다 좋지만, 영상 품질 점수(DOVER)와 카메라 사이의 기하 일치도(교차 시점 Sampson 오차)는 기준선보다 나쁩니다. 기준선은 다른 프롬프트를 쓰고 29프레임 단위로 자기회귀 생성했으므로 조건이 완전히 같지는 않습니다.
LiDAR에서 Sim-Auto는 LiDAR 생성 모델 LidarVerse보다 분포 지표 5개가 모두 좋지만, 생성한 LiDAR로 측정한 객체 검출 F1은 0.188로 LidarVerse(0.200~0.201)보다 조금 낮습니다. LidarVerse 수치는 평가 부분집합이 다릅니다. Transfer-Auto와 비교하면 모든 LiDAR 지표가 낮으며, 보고서는 증류 과정에서 LiDAR 품질을 지키는 일을 향후 과제로 적었습니다. 사람 평가에서 Sim-Auto는 Cosmos-Transfer2.5보다 장면 요소와 교차 시점 항목에서 모두 높은 점수를 받았지만, 노면 일치율(87.0%)과 날씨 일치율(81.0%)은 두 비교 모델보다 낮았습니다.
실시간이 되려면 12프레임 조각을 400ms 안에 만들어야 합니다. FlashDreams 0.2 릴리스 후보 런타임으로 측정했을 때, 카메라 1대 RGB는 GB200 1장에서 조각당 364ms(32.6 FPS)로 이 목표를 맞췄습니다. 카메라 7대와 LiDAR를 GB200 16장(4노드)에 나눠 832×480으로 생성하면 조각당 701ms, 16.7 FPS로 목표에 못 미칩니다. 이 측정은 제어 입력을 미리 준비해 둔 조건이고, 카메라 7대까지만 측정했습니다. 모델 카드의 vLLM-Omni 단일 GPU 측정에서는 카메라 7대와 LiDAR가 GB200에서 2.2 FPS이며, 카드는 다중 GPU 최적화가 진행 중이라고 적었습니다.
장시간 안정성은 1시간 연속 생성으로 확인했습니다. 첫 조각과 가장 최근 조각만 기억하는 작은 캐시로 두 장면을 1시간 동안 생성했을 때 품질 지표가 계속 나빠지지는 않았습니다. 다만 이 실험은 WSM 제어와 캡션을 반복 재생한 조건이며, 보고서는 긴 롤아웃에서 물체 모양과 물리적 타당성이 나빠질 수 있다고 함께 적었습니다.
다른 차량과 센서 구성에 맞추려면
Sim-Auto의 시점 임베딩은 학습에 쓴 고정된 카메라 구성에 맞춰져 있고, LiDAR 토크나이저는 Pandar128 센서 데이터로 학습했습니다. 그래서 다른 차량의 카메라 배치에 쓰려면 사후 학습이 필요합니다. NVIDIA가 권장하는 순서는 내 데이터로 Transfer-Auto를 먼저 사후 학습하고, 그 모델을 인과 학습과 증류로 Sim-Auto 형태로 바꾸는 것입니다. 보고서 본문 표는 Transfer-Auto와 Sim-Auto 학습에 GB200 512장을 썼다고 적었고, 부록의 단계별 표는 일관성 증류 단계에 768장을 배정했습니다.
로봇: 시뮬레이터 화면을 바꾸는 Sim-Transfer와 행동에서 화면을 만드는 Sim-Bimanual
로봇용 두 모델은 역할이 다릅니다. Sim-Transfer는 물리 시뮬레이터가 계산한 장면을 실사풍 영상으로 바꾸고, 물리와 상태 계산은 시뮬레이터에 그대로 남깁니다. Sim-Bimanual은 시뮬레이터 없이 현재 장면과 행동만으로 다음 화면을 예측합니다.
Sim-Transfer: 물리는 시뮬레이터가, 겉모습은 모델이 맡습니다
Cosmos3-Nano-Sim-Transfer는 Isaac Lab과 같은 시뮬레이터가 렌더링한 제어 영상 하나와 텍스트 프롬프트를 받아 RGB 영상을 만듭니다. 제어 영상은 네 종류 중 하나를 고릅니다.
- 깊이(Depth): 카메라로부터의 상대 거리
- 분할(Segmentation): 영역과 물체 경계
- 윤곽선(Edge): 장면의 외곽선
- 블러(Blur): 대략적인 겉모습과 배치
시뮬레이터 상태가 갱신되면 새 제어 영상이 들어오고, 모델은 이전에 만든 영상을 이력으로 참조해 다음 4프레임을 만듭니다. 아래 두 영상은 깊이와 분할 제어로 만든 예시입니다.
제어를 얼마나 잘 따르는지는 TransferBench(AgiBot, Ego-Exo4D, OpenDV 원본 600개 × 제어 4종, 2,400개 영상)에서 기본 Cosmos3-Nano와 비교했습니다. 아래 표는 모델 카드의 두 표를 합친 것입니다.
| 모델 | DOVER ↑ | 분할 mIoU ↑ | 블러 SSIM ↑ | 윤곽선 F1 ↑ | 깊이 SI-RMSE ↓ | 시간 Sampson 오차 ↓ |
|---|---|---|---|---|---|---|
| Cosmos3-Nano | 10.359606 | 0.643263 | 0.855906 | 0.214024 | 0.842346 | 0.081045 |
| Cosmos3-Nano-Sim-Transfer | 10.175942 | 0.73776 | 0.88665 | 0.340696 | 0.619426 | 0.096544 |
제어 충실도 지표 4개는 모두 좋아졌습니다. NVIDIA가 프로젝트 페이지에서 내세운 윤곽선 F1 59.2% 향상과 깊이 오차 26.5% 감소가 이 표의 값입니다. 대신 영상 품질(DOVER), 프롬프트 충실도, 프레임 사이의 기하 일치도(시간 Sampson 오차)는 기본 모델보다 낮습니다. 보고서의 단계별 표를 보면 증류하기 전 양방향 교사 모델이 최종 모델보다 9개 지표 모두에서 좋습니다. 600프레임 장시간 생성에서는 영상 품질(DOVER 11.5036 대 9.1682)과 시간 Sampson 오차(0.081120 대 0.150449)가 기본 모델보다 크게 나빴고, 깊이 오차도 약간 나빴습니다.
정책 평가 실험도 있습니다. GR00T N1.7 정책이 Unitree G1 휴머노이드로 사과를 집어 옮기는 Isaac Lab 과제에서, 물리는 그대로 두고 정책이 보는 화면만 Isaac 기본 렌더링에서 Sim-Transfer 영상으로 바꿨습니다. 같은 32개 시작 상태에서 성공 횟수가 22회(68.8%)에서 27회(84.4%)로 늘었습니다. 이 결과를 해석할 때는 세 가지 조건을 함께 봐야 합니다.
-
장면 프롬프트를 이 32개 시작 상태와 15,000스텝 정책으로 맞춘 뒤 같은 상태에서 측정했습니다. 보고서도 표 설명에 보정 세트 결과라고 적었습니다.
-
장면 외형을 바꾼 비교에서 초록 사과 조건은 Isaac 렌더링 20회 대 Sim-Transfer 24회였지만, 빨간 접시 조건은 22회 대 19회로 Isaac 렌더링이 앞섰습니다.
-
정책 체크포인트 6개 중 3개는 좋아지고 2개는 나빠졌으며 1개는 같았습니다.
보고서 부록에는 실패 사례도 정리돼 있습니다. 긴 생성에서 얼룩과 잔상이 생기고, 120프레임 남짓한 짧은 생성에서도 없던 물체가 나타나거나 지나가는 차량의 형태가 바뀌었습니다. 시뮬레이터에서는 로봇이 신발을 손에 들어 올렸는데, 프롬프트가 신발이 조리대 위에 있다고 묘사하자 생성 영상이 신발을 조리대 위에 그린 사례도 있습니다. 텍스트가 제어 영상보다 우선한 경우로, 이런 화면이 정책 루프에 들어가면 정책은 시뮬레이터 상태와 다른 장면을 보게 됩니다.
속도는 GB200 1장에서 640×640, 깊이 제어, 컴파일과 CUDA Graph, 싱크 1개와 최근 49개 잠재 위치만 남기는 이력 창 조건으로 15.85 FPS(조각 간격 p50 240ms, 최대 메모리 할당 52.7GiB)입니다. 30 FPS 영상 기준으로는 생성 시간이 영상 길이의 약 1.89배 걸립니다. 전체 이력을 유지하면 11.41 FPS이고, 모델 카드의 기본 서빙은 컴파일하지 않는 eager 모드입니다. 모델 카드는 GB200 1장에서 최대 8개 환경을 묶어 처리하도록 설계했다고 적었고, vLLM-Omni 기준 단일 GPU 480p 처리량은 GB200 24.5 FPS, H100 14.6 FPS입니다.
Sim-Bimanual: 행동과 카메라 이동을 한 시퀀스로 받습니다
Cosmos3-Nano-Sim-Bimanual은 첫 이미지와 행동 시퀀스를 받아, 양팔 로봇이 움직였을 때 장면이 어떻게 바뀌는지 영상으로 예측합니다. 행동은 59차원 벡터 하나로 표현합니다. 카메라 자세 9차원, 오른손 손목 자세와 손가락 끝 5개 위치 24차원과 그리퍼 너비, 왼손도 같은 구성입니다. 로봇 조작과 카메라 이동을 같은 벡터 형식으로 표현합니다. 그래서 한 롤아웃 안에서 10초 조작, 10초 시점 이동, 다시 10초 조작처럼 두 동작을 섞을 수 있습니다. 소개 글과 공개된 행동 스키마에는 AgiBot과 YAM 로봇이 들어 있지만 모델 카드의 지원 로봇 항목에는 AgiBot만 적혀 있으며, 학습 시에는 59차원을 64차원으로 채워(padding) 씁니다.
위 영상은 소개 글과 모델 카드에 실린 생성 결과로, 위쪽 두 개는 AgiBot, 아래쪽 두 개는 YAM 예시입니다. 카메라 이동 성능은 LingBot-World 2.0, Sana-WM과 비교했습니다. ATE(Absolute Trajectory Error), RTE(Relative Translation Error), RRE(Relative Rotation Error)는 생성 영상에서 추정한 카메라 궤적이 입력 궤적과 얼마나 다른지 재는 지표입니다.
| PAI-Bench-G I2V (300개) | Video Quality ↑ | ATE ↓ | RTE ↓ | RRE ↓ | Perceptual Drift ↓ |
|---|---|---|---|---|---|
| LingBot-World 2.0 | 65.3577 | 4.1698 | 0.0596 | 0.1781 | 0.0209 |
| Sana-WM | 65.2090 | 6.4823 | 0.1284 | 0.1601 | 0.0299 |
| Cosmos3-Nano-Sim-Bimanual | 73.9099 | 4.7072 | 0.0545 | 0.1002 | 0.0210 |
영상 품질은 8점 이상 높지만, 절대 위치 오차(ATE)와 시간에 따른 품질 저하(Perceptual Drift)는 LingBot-World 2.0이 조금 낫습니다. Sana-WM-Bench의 쉬운 분할과 어려운 분할에서는 Sim-Bimanual이 대부분의 지표에서 앞섰습니다.
로봇 조작은 AgiBot-World(186개 에피소드, 30초 구간 232개)에서 같은 행동 시퀀스를 넣었을 때 실제 영상과 얼마나 비슷한지로 비교했습니다.
| AgiBot-World | Video Quality ↑ | PSNR (dB) ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|---|
| DreamDojo 2B | 74.5327 | 12.1016 | 0.6405 | 0.3766 |
| DreamDojo 14B | 74.9390 | 12.3561 | 0.6635 | 0.3586 |
| Cosmos3-Nano-Sim-Bimanual | 76.0884 | 14.4138 | 0.6839 | 0.3454 |
AgiBot-GEAR에서도 5개 지표 모두 DreamDojo보다 좋았습니다. 비교 대상인 DreamDojo는 양방향 교사 모델이고 백본, 학습 데이터, 추론 설정이 모두 다릅니다. 보고서는 PSNR과 같은 참조 영상 비교 지표가 행동을 잘 따르는지 보는 대리 지표일 뿐, 접촉이나 과제 성공을 검증하지는 않는다고 밝힙니다.
속도는 GB300 1장, 640×352, 4스텝, 64 잠재 프레임 이력 창, 경량 디코더 TAEHV Super 조건에서 48.1 FPS입니다. Wan 2.2 디코더를 쓰면 35.0 FPS입니다. 8프레임 조각 하나를 166ms(p50)에 만들고, 이 조각은 30 FPS 기준 267ms 분량이므로 영상 속도보다 빠릅니다. 프로젝트 페이지는 이 166ms를 "지연(latency)"으로 표기하지만, 보고서 정의로는 조각 처리 시간입니다. 행동을 모으고 조각을 예약하고 화면에 표시하는 시간은 포함하지 않습니다. 모델 카드의 vLLM-Omni 단일 GPU 480p 처리량은 GB200 54.1 FPS, H100 32.6 FPS, RTX PRO 6000 20.6 FPS, H20 10.7 FPS입니다.
양방향 생성 모델을 스트리밍 모델로 바꾸는 4단계 레시피
세 Sim 모델은 같은 사후 학습 레시피를 공유하고, Transfer-Auto는 그 0단계에 해당합니다. 레시피는 교사 강제와 셀프 포싱을 묶은 증류 방법인 Causal-rCM을 따릅니다.
조각 단위 생성과 KV 캐시
먼저 생성 단위를 영상 전체에서 짧은 조각(Chunk) 으로 바꿉니다. Cosmos 3의 영상 토크나이저는 첫 프레임을 잠재 프레임 1개로, 이후 4프레임마다 잠재 프레임 1개로 압축합니다. 조각 크기는 Sim-Transfer가 잠재 프레임 1개, Sim-Bimanual이 2개, Sim-Auto가 3개입니다. 조각이 작을수록 새 입력을 더 자주 반영하고, 조각이 크면 화질에 유리할 수 있습니다.
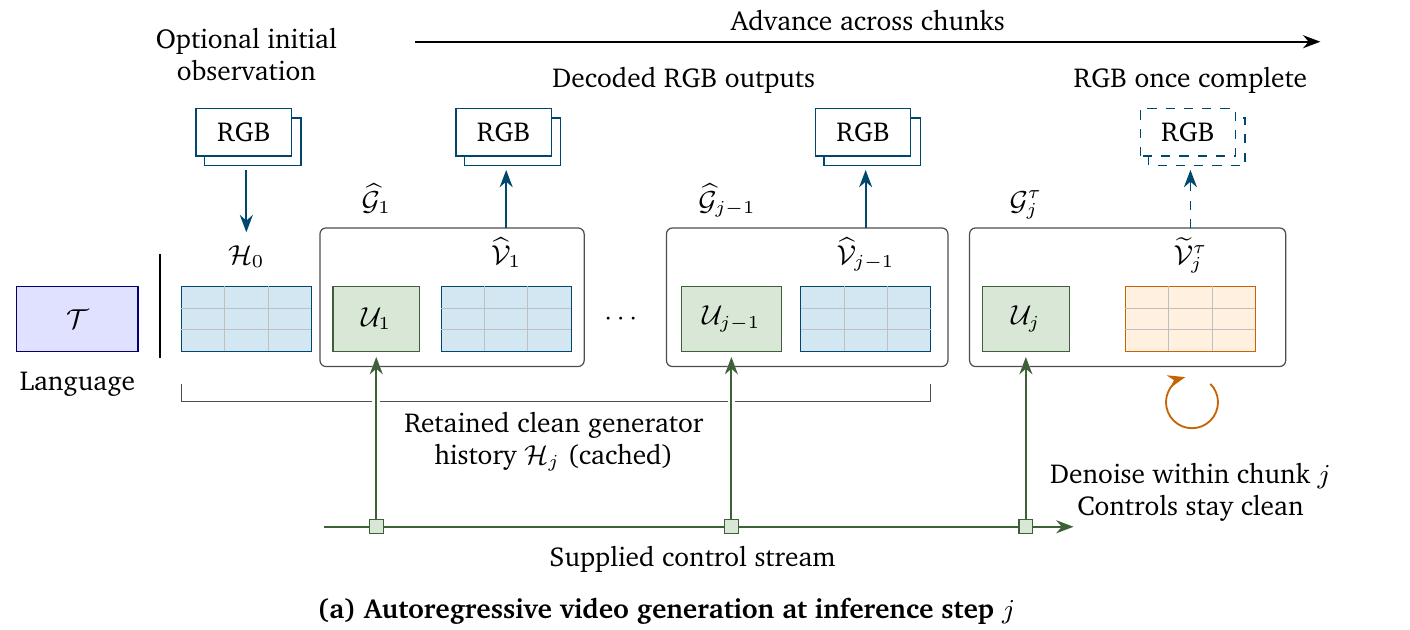
위 그림은 추론 단계 j 에서 일어나는 일을 보여줍니다. 지금 만드는 조각은 같은 구간의 제어 입력(행동이나 제어 영상)과 이미 만든 과거 조각만 볼 수 있고, 미래 조각은 볼 수 없습니다. 이를 시간 인과적 어텐션(Temporal-causal Attention) 이라고 합니다. 과거 조각의 어텐션 키와 값은 KV 캐시(Key-Value Cache) 에 저장해 다시 계산하지 않습니다. 캐시가 무한히 커지지 않도록 처음 몇 개 항목을 고정으로 남기고(어텐션 싱크, Attention Sink) 나머지는 최근 항목만 유지합니다. 이 방식은 StreamingLLM에서 온 것으로, 오래된 관측을 모델이 잊는다는 대가가 있습니다.
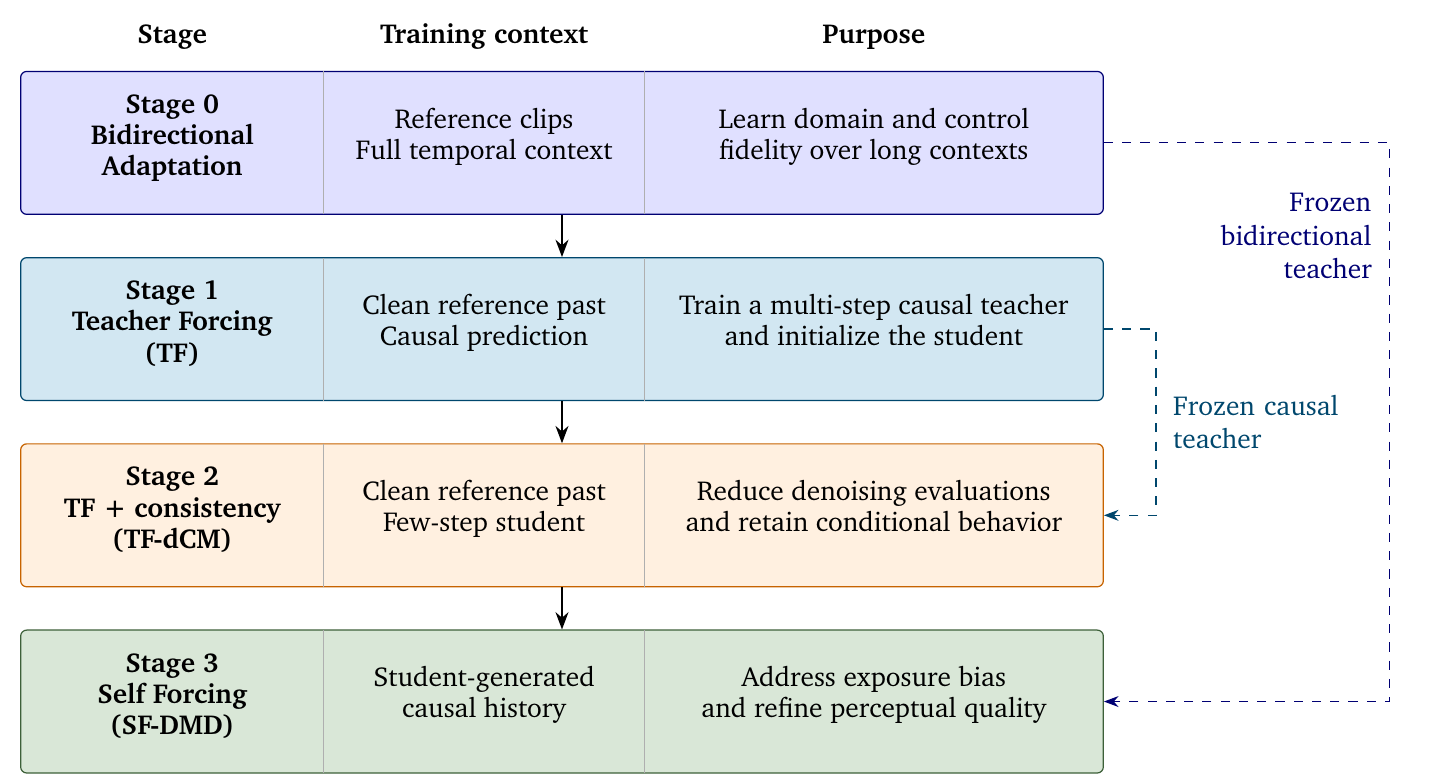
4단계 학습
-
0단계, 양방향 적응: 기존 방식대로 클립 전체를 보며 도메인 데이터와 제어 입력의 관계를 학습합니다. 이 모델이 3단계의 고정 교사가 되며, 자율주행에서는 이 결과물이 Transfer-Auto입니다.
-
1단계, 교사 강제(Teacher Forcing): 실제 녹화된 과거 프레임을 이력으로 주고 다음 조각을 예측하게 합니다. 아직 디노이징을 수십 번(Sim-Bimanual은 35번) 하는 인과적 모델입니다.
-
2단계, 일관성 증류(Consistency Distillation): 1단계 모델을 고정 교사로 두고, 디노이징을 4번만 하는 학생 모델을 학습합니다. 일관성 증류는 여러 단계로 노이즈를 제거하는 교사의 경로를 학생이 적은 단계로 따라가도록 학습하는 방법입니다.
-
3단계, 셀프 포싱(Self Forcing): 학생이 실제 녹화 대신 자신이 만든 영상 을 이력으로 삼아 다음 조각을 만들도록 학습합니다. 손실은 분포 정합 증류(Distribution Matching Distillation, DMD) 로, 학생 롤아웃의 분포를 0단계 교사의 분포에 맞춥니다. 이를 위해 따로 학습하는 보조 점수 모델이 하나 더 필요합니다.
3단계가 필요한 이유는 노출 편향(Exposure Bias) 때문입니다. 1, 2단계에서는 깨끗한 실제 영상을 이력으로 받지만, 실제 사용에서는 모델이 만든 영상이 이력이 됩니다. 앞 조각에서 물체를 조금 틀리게 그리면 그 오류가 다음 조각의 입력이 되어 쌓입니다. Self Forcing은 학습 단계부터 자기 출력을 이력으로 쓰게 해 이 차이를 줄이는 방법입니다. Sim-Bimanual의 단계별 비교(AgiBot-GEAR 30개)에서 영상 품질 점수는 양방향 73.385, 1단계 72.367, 2단계 72.375로 내려갔다가 3단계에서 74.251로 올라갔습니다.
디노이징 횟수를 줄이는 것만으로 속도가 결정되지는 않습니다. Sim-Bimanual의 조각 하나(167ms) 가운데 디노이징은 약 89ms이고, 완성된 조각의 키와 값을 캐시에 다시 쓰는 갱신 단계가 69ms를 차지했습니다. Sim-Auto도 제어 입력 처리와 KV 캐시 갱신이 컴파일되지 않은 병목으로 남아 있습니다.
직접 실행하고 내 데이터에 맞추려면
공통 요구 사항은 Linux, NVIDIA Hopper 또는 Blackwell GPU, Docker와 NVIDIA Container Toolkit입니다. 추론 엔진으로는 PyTorch, vLLM-Omni( vLLM-Omni 기술 보고서: 음성, 이미지, 영상, 로봇 행동 모델을 한 런타임에서 서빙하는 구조), SGLang을 지원합니다. 모델 카드의 빠른 시작 예제는 GB200 1장에서 시험한 것이며, 소개 글은 이 구성이 최소 메모리 사양은 아니라고 밝힙니다. 아래는 Sim-Bimanual 모델 카드의 vLLM-Omni 서버 실행 명령입니다.
docker run --runtime nvidia --gpus all --ipc=host \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env "HF_TOKEN=$HF_TOKEN" \
  --env VLLM_OMNI_VIDEO_SYNC_TIMEOUT=1800 \
  -p 127.0.0.1:8000:8000 \
  vllm/vllm-omni:cosmos3 \
  vllm serve nvidia/Cosmos3-Nano-Sim-Bimanual \
    --omni --model-class-name Cosmos3NanoSimBimanualPipeline \
    --deploy-config /app/vllm-omni/vllm_omni/deploy/cosmos3_nano_sim_bimanual_windowed.yaml \
    --no-guardrails \
    --host 0.0.0.0 --port 8000 --init-timeout 1800
--deploy-config 는 한 번에 요청 하나, 64 잠재 프레임 KV 캐시와 어텐션 싱크 8개 구성을 고릅니다. 모델 카드에 따르면 이 창 없이 901프레임 이력을 모두 유지하면 141GB GPU에서도 메모리가 부족합니다. --no-guardrails 는 Cosmos3의 텍스트와 영상 안전 검사를 끕니다. 서버를 띄운 뒤에는 카드의 Python 클라이언트 예제로 AgiBot 혼합 행동 예시(초기 이미지 1장, 정규화된 59차원 행동 900개, 901프레임)를 생성할 수 있습니다. 나머지 세 모델도 각 모델 카드에 같은 형식의 예제가 있으며, 자율주행 두 모델의 빠른 시작 예제는 카메라 영상만 만들고 LiDAR 생성은 노트북 예제에서 다룹니다.
NVIDIA는 에이전트용 문서도 함께 공개했습니다. Cosmos Framework 저장소의 .agents/skills/ 아래에 모델별 추론 스킬, 사후 학습 스킬, 노트북 예제가 있습니다. 소개 글은 코딩 에이전트에게 스킬 경로와 데이터셋 위치를 주고 작업을 맡기는 방식을 안내합니다.
소개 글에 따르면 사후 학습 레시피는 Cosmos3-Nano 또는 호환 가중치에서 시작하며 위 4단계를 모두 다룹니다. 소개 글은 긴 학습 전에 샘플 검증과 학습 재시작을 먼저 시험하고, 품질은 학습에 쓰지 않은 에피소드로 평가하라고 권합니다. 짧은 실행이 성공했다는 것은 코드가 실행된다는 뜻이지 학습이 수렴했다는 뜻은 아니기 때문입니다. 보고서의 Sim-Bimanual 부록 실험에서는 rank 16 LoRA가 전체 미세조정(Full Fine-tuning)보다 영상 품질이 낮았습니다(74.979 대 77.086).
정리: 공개된 것과 아직 검증되지 않은 것
NVIDIA는 같은 사후 학습 레시피를 로봇 조작, 시뮬레이터 화면 변환, 다중 카메라와 LiDAR 주행에 적용했지만, 시뮬레이터로서의 쓸모는 아직 일부만 확인됐습니다. 정책 피드백을 실제로 측정한 실험은 Sim-Transfer의 Isaac Lab 과제 하나이며, 그 결과도 프롬프트를 맞춘 시작 상태에서 나왔습니다. 보고서 스스로 접촉 역학, 과제 성공, 폐루프 정책 동작은 별도 평가가 필요하다고 적고 있습니다. 직접 쓰려는 팀이라면 자기 정책과 과제로 실제 환경 결과와 시뮬레이터 결과가 같은 순위를 내는지부터 확인해야 합니다.
라이선스
네 체크포인트와 Cosmos Framework 코드는 OpenMDW-1.1 라이선스로 공개되어, 라이선스 조건 안에서 연구 목적은 물론 상업적 용도로도 사용할 수 있습니다.
 Cosmos 3 인터랙티브 월드 시뮬레이션 소개 블로그
 Interactive World Simulation with Cosmos for Physical AI 기술 보고서 (PDF)
 프로젝트 페이지
 Cosmos3 Examples 모델 컬렉션 (Hugging Face)
 Cosmos Framework GitHub 저장소
NVIDIA 기술 블로그: Build World Models for Interactive Simulation with NVIDIA Cosmos
 Cosmos Labs 라이브 방송 다시 보기 YouTube 영상
더 읽어보기
-
World Action Model의 부상: 비디오 백본으로 로봇 정책을 학습하는 두 번째 레시피 (feat. NVIDIA)
-
LingBot-World 2.0: 720p 60fps 실시간으로 끝없이 조작 가능한 세계를 생성하는 14B 월드 모델
-
Nano World Model: Diffusion Forcing 기반의 미니멀한 비디오 월드 모델 학습 저장소
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임 에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일
 로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!

 아래
 쪽에 좋아요
 를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
